
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 5/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
2.2 Квантование модели
2.2.1 Основные понятия квантования
2.2.1.1 Определение квантования
Квантование модели — преобразование параметров или активаций модели глубокого обучения из представления с плавающей точкой в представление с фиксированной точкой, например из FP32 в INT8. Оно уменьшает потребление памяти, сжимает модель и ускоряет инференс, но обычно приводит к некоторой потере точности.
По виду функции отображения значений с плавающей точкой в фиксированную точку различают линейное и нелинейное квантование. К распространённым нелинейным методам относятся экспоненциальное квантование, квантование по кодовой книге и кусочно-линейное квантование. RKNN-Toolkit2 поддерживает только линейное квантование. В нём интервалы между значениями с фиксированной точкой одинаковы: например, линейное квантование INT8 равномерно делит диапазон на 256 значений, поэтому его также называют равномерным. В зависимости от того, равна ли нулевая точка 0, линейное квантование бывает симметричным или асимметричным. Симметричное квантование — упрощённый вариант асимметричного. Асимметричное обычно лучше обрабатывает неравномерные распределения данных и потому чаще используется на практике.
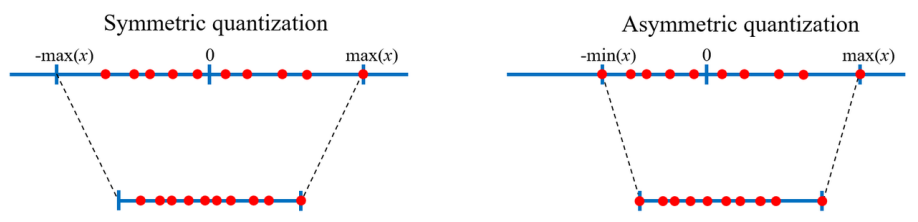
Рисунок 2-2. Линейное симметричное и асимметричное квантование
2.2.1.2 Вычисления при квантовании
Для примера линейного асимметричного квантования преобразование значения с плавающей точкой в знаковое число с фиксированной точкой определяется следующим образом:
x_int = clamp(round(x / s) + z; -2^(b-1), 2^(b-1)-1) (6-1)
Здесь x — значение с плавающей точкой, x_int — квантованное число с фиксированной точкой, round обозначает округление до ближайшего целого, s — масштаб квантования, z — нулевая точка, b — разрядность квантования (например, для INT8 b=8). Операция ограничения clamp определяется так:
clamp(x; a, c) = a, if x < a; x, if a <= x <= c; c, if x > c. (6-2)
Обратное преобразование числа с фиксированной точкой в число с плавающей точкой называется деквантованием:
x ≈ x_hat = s × (x_int - z) (6-3)
Значение x̂ также называют псевдоквантованным значением с плавающей точкой. Из-за округления и ограничения при квантовании x̂ не совпадает с x в точности; разность называется ошибкой квантования.
Пусть диапазон квантования равен (q_min, q_max), а диапазон ограничения — (c_min, c_max). Тогда параметры s и z вычисляются так:
s = (q_max - q_min) / (c_max - c_min) = (q_max - q_min) / (2^b - 1) (6-4)
z = c_max - round(q_max / s) OR z = c_min - round(q_min / s) (6-5)
Диапазон ограничения определяется квантованным типом данных; например, для INT8 он равен (-128, 127). Диапазон квантования определяется выбранным алгоритмом. При z=0 приведённые определения превращаются в определения линейного симметричного квантования.
2.2.1.3 Гранулярность квантования
Гранулярность определяет, какие параметры тензора с плавающей точкой квантуются совместно. RKNN-Toolkit2 поддерживает Per-Layer / Per-Channel / Group. При Per-Layer все каналы весов или активаций слоя квантуются совместно с общими параметрами. При Per-Channel каждый выходной канал весов слоя квантуется независимо с собственными параметрами. Group применяется только к весам линейных слоёв: дополнительно к Per-Channel элементы каждого выходного канала разбиваются на группы, и каждая группа квантуется независимо.
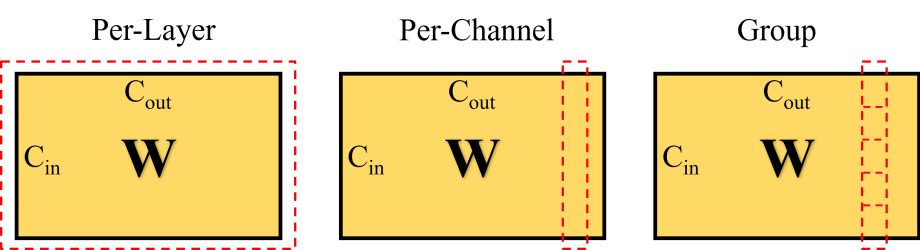
Рисунок 2-3. Квантование Per-Layer, Per-Channel и Group
Примечание: в RKNN-Toolkit2 Group и Per-Channel применяются только к весам. Активации и промежуточные значения по-прежнему используют Per-Layer. Group действует только для линейных слоёв в режиме w4a16.
2.2.1.4 Алгоритмы квантования
Алгоритм квантования определяет отображение тензоров с плавающей точкой в малобитное представление с фиксированной точкой и находит параметры для заданной формы квантования, например линейной. По реализации различают обучение с учётом квантования и квантование после обучения. Первое корректирует параметры модели и квантования во время обучения для повышения точности; обычно оно требует глубокого понимания процесса обучения и большого объёма данных, поэтому редко применяется непосредственно в инструментах развёртывания. Квантование после обучения обычно требует лишь небольшого калибровочного набора либо обходится без него и позволяет получить параметры с небольшими затратами. RKNN-Toolkit2 поддерживает четыре таких алгоритма: Normal / KL-Divergence / MMSE / GDQ.
2.2.2 Обзор процесса квантования
RKNN-Toolkit2 использует квантование после обучения (PTQ): внутреннее квантование выполняется вместе с преобразованием модели. Сначала модель с плавающей точкой загружается в Toolkit, затем квантование и экспорт RKNN выполняются по цепочке rknn.config() → rknn.load_xxx() → rknn.build() → rknn.export_rknn(). Общий процесс:
Floating-point model ──▶ rknn.config() to configure quantization parameters ──▶
rknn.load_xxx() to load the model ──▶ rknn.build(do_quantization=True, dataset=...)
to quantize and build ──▶ rknn.export_rknn() to export the RKNN model
Основные элементы процесса квантования и их настройка:
Тип данных квантования: задаётся через quantized_dtype в rknn.config(). Поддерживаются w8a8, w4a16, w8a16 и другие типы; см. 2.2.3.1 «Типы данных».
Алгоритм: задаётся через quantized_algorithm в rknn.config(). Поддерживаются Normal / KL-Divergence / MMSE / GDQ; принципы приведены в 2.2.1.4, подробности — в 2.2.3.2.
Гранулярность: задаётся через quantized_method в rknn.config(). Поддерживаются layer (Per-Layer), channel (Per-Channel) и group{SIZE} (Group).
Калибровочный набор: задаётся параметром dataset в rknn.build() и используется для вычисления параметров квантования активаций; см. 2.2.3.3 «Подготовка калибровочных данных».
Гибридное квантование: назначает более точные типы данных чувствительным к квантованию слоям, уменьшая потерю точности; см. 2.2.4.
Обучение с учётом квантования (QAT): вставляет узлы имитации квантования при обучении и дообучает параметры модели; подходит, если PTQ не обеспечивает требуемую точность. См. 2.2.5.
2.2.3 Внутренний процесс квантования
2.2.3.1 Типы данных
Внутреннее квантование RKNN-Toolkit2 поддерживает w8a8, w4a16, w8a16, w4a8, w16a16i и w16a16i_dfp; значение по умолчанию — w8a8. w4/w8/w16 означает квантование весов в int4/int8/int16; a8/a16 означает представление активаций в int8/float16. Типы описаны ниже:
w8a8 (по умолчанию): веса и активации используют 8-битное асимметричное квантование. Не поддерживается RK2118.
w4a16: веса используют 4-битное асимметричное квантование, активации — 16-битную плавающую точку. Только RK3576 / RV1126B.
w8a16: веса используют 8-битное асимметричное квантование, активации — 16-битную плавающую точку. Только RK3562.
w4a8: веса используют 4-битное, а активации — 8-битное асимметричное квантование. Пока не поддерживается.
w16a16i: веса и активации используют 16-битное асимметричное квантование. Только RV1103 / RV1106.
w16a16i_dfp: веса и активации используют 16-битное динамическое квантование с фиксированной точкой. Только RV1103 / RV1106.
2.2.3.2 Внутренние алгоритмы квантования
Поддерживаются четыре алгоритма: Normal / KL-Divergence / MMSE / GDQ.
Normal непосредственно определяет диапазон по минимальному и максимальному значениям с плавающей точкой. Он не вносит ошибку отсечения, но чувствителен к выбросам; работает быстро и подходит для общих случаев. Диапазон вычисляется так:
q_min = min V (6-6)
q_max = max V (6-7)
Здесь V — тензор с плавающей точкой.
KL-Divergence определяет диапазон, сравнивая распределения значений с плавающей и фиксированной точкой, изменяя пороги и минимизируя KL-дивергенцию. Он лучше приспосабливается к неравномерным распределениям и снижает влияние отдельных выбросов, но немного медленнее Normal.
argmin_(q_min,q_max) H(Ψ(V), Ψ(V_int)) (6-8)
Здесь H(·,·) — KL-дивергенция, Ψ(·) отображает данные в дискретное распределение, а V_int — квантованный тензор с фиксированной точкой.
MMSE определяет диапазон, минимизируя среднеквадратичную ошибку между исходными значениями с плавающей точкой и деквантованными значениями. Обычно он обеспечивает более высокую точность, но требует большего объёма вычислений, работает медленнее и расходует больше памяти. При выбросах часто превосходит KL-Divergence.
argmin_(q_min,q_max) ||V - V_hat(q_min,q_max)||_F² (6-9)
| Здесь V̂(q_min,q_max) — результат квантования и деквантования V, а | · | _F — норма Фробениуса. |
GDQ действует только при quantized_dtype=w4a16 или w8a16 и эффективно повышает точность квантования весов. Рекомендуется более 200 изображений. Подробности алгоритма приведены в «03_RKNN2_Toolkit_Python_API_Reference_V2.5.0».
Рекомендуется сначала использовать Normal; при проблемах точности попробовать KL-Divergence, MMSE или GDQ. Для w4a16 / w8a16 рекомендуется сначала попробовать GDQ.
2.2.3.3 Подготовка калибровочных данных
Калибровочный набор используется для определения диапазона квантования активаций. Он должен охватывать различные распределения данных реального применения модели: например, для классификации нужны изображения разных классов из реальных сценариев. Обычно рекомендуется 20–200 изображений с корректировкой по времени работы алгоритма. Для GDQ рекомендуется более 200 изображений. Для других алгоритмов увеличение набора увеличивает время, но не обязательно повышает точность.
Калибровочные данные задаются текстовым файлом: запишите пути к изображениям jpg/png или файлам npy в файл .txt, по одному пути на строку:
a.jpg
b.jpg
При нескольких входах разделяйте файлы каждого входа пробелами:
a0.jpg a1.jpg
b0.jpg b1.jpg
2.2.3.4 Конкретный пример
Пример 1: внутреннее квантование ResNet50:
from rknn.api import RKNN

model_path = "resnet50-v2-7.onnx" ## Floating-point ONNX model exported in advance
output_path = 'resnet50-v2-7.rknn'
DATASET_PATH = '../../../datasets/imagenet/ILSVRC2012_img_val_samples/dataset_20.txt'

# Create RKNN object
rknn = RKNN(verbose=False)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[[255*0.485, 255*0.456, 255*0.406]],
           std_values=[[255*0.229, 255*0.224, 255*0.225]],
           target_platform="rk3588",
           quantized_dtype='w8a8', ## "w4a16", "w8a16" etc. are optional (subject to actual platform support)
           quantized_algorithm='normal', ## "MMSE", "KL-Divergence", "GDQ" are optional
           quantized_method='channel',)
print('done')

# Load model
print('--> Loading model')
ret = rknn.load_onnx(model=model_path, inputs=['data'], input_size_list=[[1, 3,
224, 224]])

if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset=DATASET_PATH)
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')

# Export rknn model
print('--> Export rknn model')
ret = rknn.export_rknn(output_path)
if ret != 0:
    print('Export rknn model failed!')
    exit(ret)
print('done')
2.2.4 Смешанное квантование
Гибридное квантование использует разные типы данных для разных слоёв. Слои, плохо поддающиеся квантованию, представляются с более высокой точностью, что уменьшает общую потерю точности. Однако это создаёт дополнительные накладные расходы, а пользователь должен определить тип квантования каждого слоя.
2.2.4.1 Применение смешанного квантования
Для лучшего баланса производительности и точности RKNN-Toolkit2 предоставляет смешанное квантование. По результатам анализа точности пользователь может вручную задать, должен ли квантоваться каждый слой.
Поддерживаются следующие способы использования:
-
Заменить выбранные квантованные слои неквантованными, например с вычислениями FLOAT16. Поскольку вычислительная мощность NPU в неквантованном режиме ниже, скорость инференса несколько уменьшится.
-
Также можно менять параметры квантования каждого слоя, однако это не рекомендуется.
2.2.4.2 Порядок использования смешанного квантования
Использование смешанного квантования состоит из четырёх шагов.
1 Загрузить исходную модель и создать конфигурацию квантования, временный файл модели и файл данных. Порядок вызовов интерфейсов:
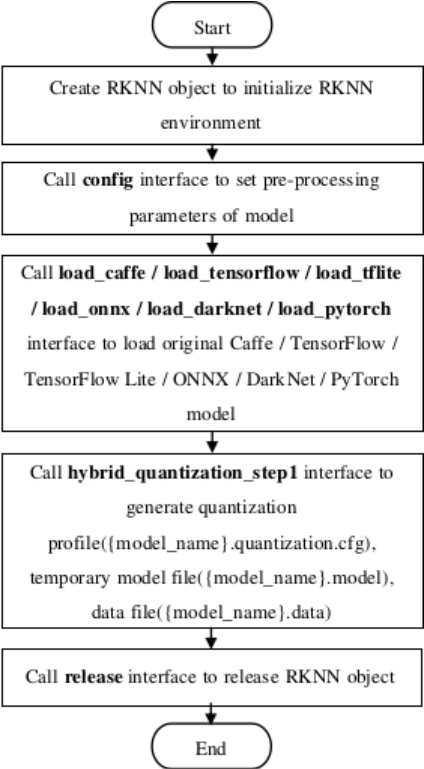
Рисунок 2-4. Гибридное квантование, шаг 1
1 Изменить конфигурационный файл, созданный на первом шаге.
После вызова hybrid_quantization_step1 на первом шаге в текущем каталоге создаётся {model_name}.quantization.cfg. Формат файла:
custom_quantize_layers:
  Conv__350:0: float16
  Conv__358:0: float16
  ....
quantize_parameters:
  ....
  FeatureExtractor/MobilenetV2/Conv/Relu6:0:
    qtype: asymmetric_quantized
    qmethod: layer
    dtype: int8
    min:
    - 0.0
    max:
    - 6.0
    scale:
    - 0.023529411764705882
    zero_point:
    - -128
  ....
В разделе “custom_quantize_layers” можно добавить пользовательские слои квантования: после имени тензора указать тип квантования. Тип операций соответствующего слоя будет изменён на заданный. Сейчас доступен тип “float16”.
Раздел “quantize_parameters” содержит параметры каждого тензора в формате “tensor_name: quantization_properties_and_parameters”. “min” и “max” — границы диапазона квантования. Имена выходных тензоров можно найти в результатах анализа точности либо открыв временный файл {model_name}.model в Netron.
1 Создать модель RKNN. Порядок вызовов интерфейсов:
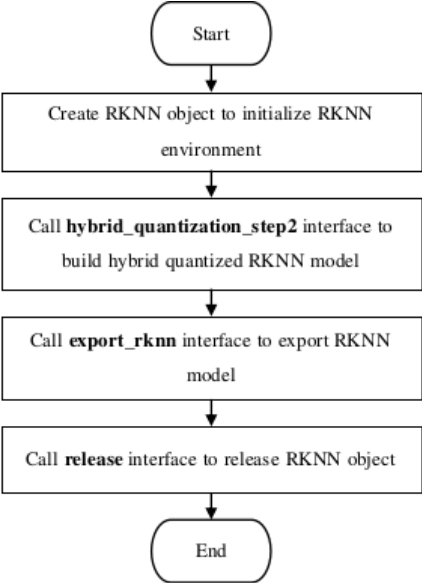
Рисунок 2-5. Гибридное квантование, шаг 3
1 Выполнить инференс моделью RKNN, созданной на третьем шаге.
Примечание: в проекте RKNN-Toolkit2 есть пример смешанного квантования в каталоге “examples/functions/hybrid_quant”. Его можно использовать как образец.
2.2.4.3 Автоматическое смешанное квантование
Для упрощения гибридного квантования и устранения переполнений RKNN-Toolkit2 предоставляет автоматическое гибридное квантование. Интерфейс auto_hybrid автоматически корректирует модель во время квантования по порогам евклидова и косинусного расстояния. Для неквантованной модели он проверяет каждый слой на переполнение fp16 и переводит такие слои на вычисления int16.
Сейчас поддерживаются следующие варианты использования:
- Во время квантования гибридная модель автоматически корректируется по порогам евклидова и косинусного расстояния. Сейчас поддерживается только автоматический переход от int8 к fp16.
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', auto_hybrid=True)
Пороги косинусного и евклидова расстояния задаются в config через auto_hybrid_cos_thresh и auto_hybrid_euc_thresh. Косинусный порог по умолчанию равен 0.98, евклидов порог по умолчанию отключён. Поэтому по умолчанию в fp16 переводятся только операторы с показателем косинусной точности ниже указанного порога, а евклидов порог не влияет на результат. Если он включён, в fp16 переводятся операторы, у которых косинусное расстояние ниже косинусного порога либо евклидово расстояние выше евклидова порога.
- Для неквантованной модели проверяется переполнение fp16 каждого слоя; переполняющиеся слои переводятся на int16. Для вычисления диапазона каждого слоя необходимо предоставить dataset.
ret = rknn.build(do_quantization=False, dataset='./dataset.txt', auto_hybrid=True)
Максимум и минимум каждого слоя вычисляются по заданным входным данным. Если они выходят за верхнюю или нижнюю границу fp16, соответствующие операторы переводятся на int16.
2.2.5 Обучение с учётом квантования (QAT)
2.2.5.1 Введение в QAT
Quantization-Aware Training (QAT) направлено на устранение потери точности при низкоразрядном квантовании. Такая потеря возникает при переходе от диапазона чисел с плавающей точкой к фиксированной точке. При QAT ошибка квантования включается в функцию потерь обучения, что позволяет обучать модель с параметрами квантования.
Сравнение с квантованием после обучения (PTQ), предоставляемым RKNN-Toolkit2:
| Метод квантования | Дообучение в исходном фреймворке | Набор данных | Изменение весов | Функция потерь | Производительность |
|---|---|---|---|---|---|
| Квантование после обучения (PTQ) | Нет | Небольшой объём неразмеченных данных | Нет | Не применяется | Оптимальная |
| Обучение с учётом квантования (QAT) | Да | Полный обучающий набор | Да | Ошибка квантования включена в функцию потерь обучения | При наличии операторов без поддержки QAT производительность несколько ниже PTQ |
2.2.5.2 Принцип QAT
При QAT все веса хранятся и вычисления выполняются в формате с плавающей точкой, что обеспечивает корректное обратное распространение ошибки и эффективное обучение. В отличие от обычного обучения, QAT вставляет модули FakeQuantize в пригодные для квантования места модели, имитируя потерю точности при переходе к фиксированной точке. Это позволяет функции потерь учитывать и оптимизировать квантование, сохраняя точность инференса после преобразования модели в фиксированную точку.
QAT широко применяется и поддерживается основными фреймворками инференса. Подробные инструкции доступны по следующим ссылкам.
Pytorch - https://pytorch.org/blog/quantization-in-practice/#quantization-aware-training-qat
Paddle - https://paddleslim.readthedocs.io/zh-cn/develop/api_cn/dygraph/quanter/qat.html
TensorFlow: https://www.tensorflow.org/model_optimization/guide/quantization/training
2.2.5.3 Рекомендации по применению QAT
QAT требует дополнительного кода обучения, а код некоторых открытых репозиториев может конфликтовать с этой возможностью. Поэтому рекомендуется использовать QAT для квантования только при одновременном выполнении двух условий:
-
Диагностика точности согласно главе 5.1 подтвердила, что PTQ в RKNN не обеспечивает требуемую точность.
-
Проверка гибридного квантования согласно 2.2.4 подтвердила, что оно не обеспечивает одновременно нужную точность и производительность.
2.2.5.4 Пример реализации и настройки QAT
Ниже приведена документация QAT различных фреймворков. При практическом использовании руководствуйтесь официальными инструкциями.
PyTorch: https://pytorch.org/docs/stable/quantization.html (PyTorch имеет несколько наборов интерфейсов квантования. RKNN поддерживает модели, созданные интерфейсом FX, в частности prepare_qat_fx и связанными интерфейсами.)
Paddle: https://www.paddlepaddle.org.cn/tutorials/projectdetail/3949129#anchor-14
TensorFlow: https://www.tensorflow.org/model_optimization/guide/quantization/training
На примере PyTorch показаны процесс реализации QAT и важные замечания.
# for 1.10 <= torch <= 1.13
import torch
class M(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.conv = torch.nn.Conv(3, 8, 3, 1)

    def forward(self, x):
        x = self.conv(x)
        return x

# initialize a floating point model
float_model = M().train()

from torch.quantization import quantize_fx, QConfig, FakeQuantize, MovingAverageMinMaxObserver, MovingAveragePerChannelMinMaxObserver

qconfig = QConfig(activation=FakeQuantize.with_args(observer=
        MovingAverageMinMaxObserver,
        quant_min=0,
        quant_max=255,
        reduce_range=False), # reudece_range -> the default is True

 weight=FakeQuantize.with_args(observer=
      MovingAveragePerChannelMinMaxObserver,
      quant_min=-128,
      quant_max=127,
      dtype=torch.qint8,
      qscheme=torch.per_channel_affine,
      #qscheme->the default is torch.per_channel_symmetric
      reduce_range=False))
qconfig_dict = {"": qconfig}
model_qat = quantize_fx.prepare_qat_fx(float_model, qconfig_dict)

# define the training loop for quantization aware training
def train_loop(model, train_data):
    model.train()
for image, target in data_loader:
    ...
# Run training
train_loop(model_qat, train_loop)

model_qat = quantize_fx.convert_fx(model_qat)
В приведённом коде все операции соответствуют официальным примерам, кроме настройки qconfig под оборудование RKNN. В qconfig внесены два основных изменения:
Для квантования активаций reduce_range задан как False. При False эффективный диапазон составляет от -128 до 127; при True — от -64 до 63, что ухудшает квантование. Оборудование RKNN поддерживает reduce_range = False.
Для квантования весов qscheme задан как torch.per_channel_affine. Значение по умолчанию torch.per_channel_symmetric фиксирует zero_point на 0, но RKNN поддерживает ненулевую zero_point. Поэтому выбран torch.per_channel_affine.
2.2.5.5 Операторы, поддерживаемые QAT
На примере PyTorch: сначала Conv и Linear с весами квантуются по правилам QAT, затем проверяются остальные операторы. Если они отвечают обычным правилам квантования, применяется обычное квантование. Оператор, не удовлетворяющий ни QAT, ни обычным правилам, сохраняет вычисления FP32.
Поддержка различается между фреймворками. Подробности для используемых фреймворка и версии доступны по ссылкам:
Pytorch: https://github.com/pytorch/pytorch/blob/main/torch/ao/quantization/quantization_mappings.py
Paddle: https://github.com/PaddlePaddle/Paddle/blob/86df789a567f1285101c57b6e3ada4b952c58f48/python/paddle/quantization/config.py
Tensorflow: https://www.tensorflow.org/model_optimization/api_docs/python/tfmot/quantization/keras/QuantizeConfig
2.2.5.6 Обработка операторов с плавающей точкой в модели QAT
Если оператор QAT-модели нельзя квантовать, он вычисляется с плавающей точкой. При преобразовании таких операторов в RKNN следует рассмотреть два случая.
- До и после него находятся квантуемые операторы:
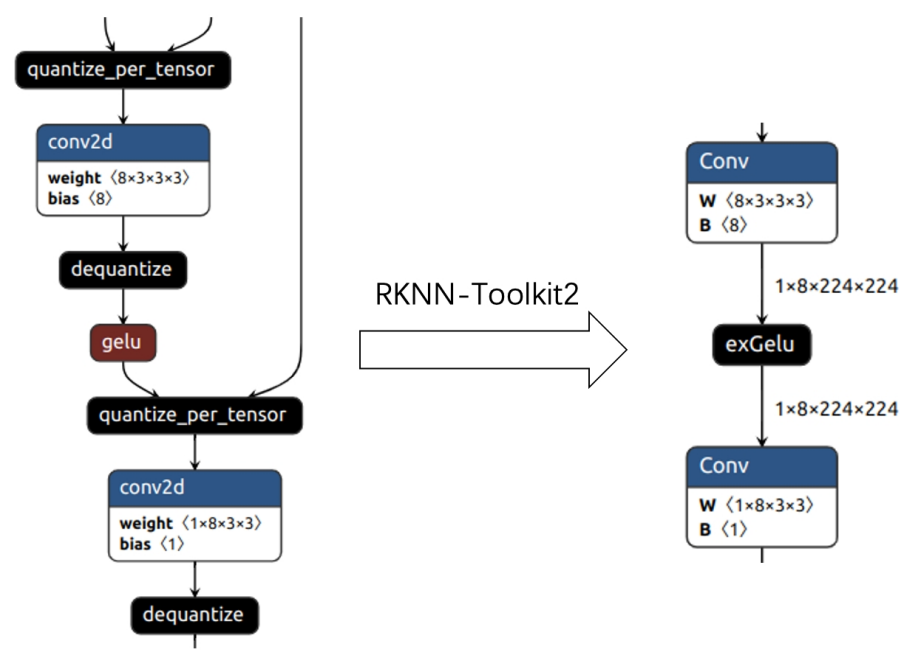
Рисунок 2-6. Оператор QAT между квантуемыми операторами
Слева на рисунке gelu исходной модели является оператором с плавающей точкой, а окружающие conv — квантованными. При загрузке модели RKNN-Toolkit2 преобразует расположенный между ними оператор в квантованный для повышения производительности инференса. Согласно исходному руководству, это не влияет на точность. После преобразования структура RKNN соответствует правой части рисунка.
1 До или после находятся неквантуемые операторы:
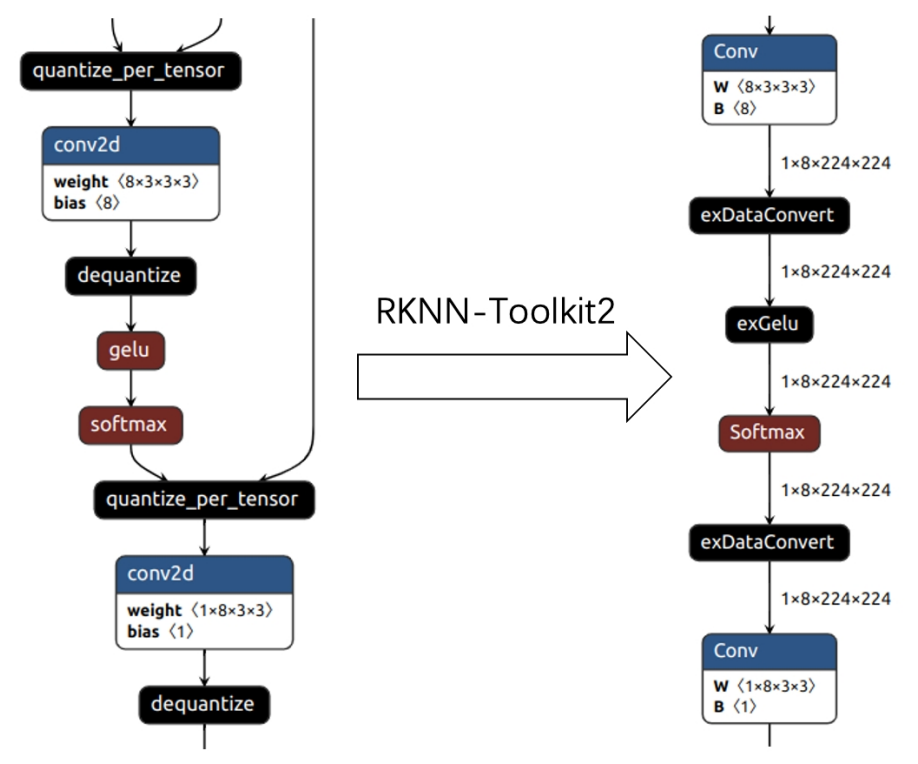
Рисунок 2-7. Оператор QAT рядом с неквантуемыми операторами
Слева на рисунке gelu и softmax — операторы с плавающей точкой, а conv до и после них квантованы. Поскольку параметры квантования gelu и softmax отсутствуют, RKNN-Toolkit2 оставляет их с плавающей точкой. После преобразования, как показано справа, RKNN вставляет деквантование перед gelu и квантование после softmax. Эти дополнительные операторы увеличивают время выполнения.
2.2.5.7 Практические выводы по QAT
- Настройка QAT
Для хорошего результата QAT часто требует настройки под особенности аппаратуры. Для RKNPU рекомендуется задавать qconfig по коду и пояснениям раздела 2.2.5.4 «Пример реализации и настройка QAT».
- Сохранённые в модели параметры квантования могут требовать повторной корректировки
Например, записанные для sigmoid параметры могут отличаться от реально используемых при инференсе. В официальном коде (https://github.com/pytorch/pytorch/blob/main/aten/src/ATen/native/quantized/cpu/qsigmoid.cpp) параметры sigmoid корректируются во время инференса: min устанавливается в 0, max — в 1.
При преобразовании QAT-моделей RKNN-Toolkit2 корректирует параметры таких операторов на стадии преобразования, приближая результаты к исходному инференсу PyTorch.