
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 6/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
2.3 Оценка модели
2.3.1 Инференс модели
После преобразования исходной модели в RKNN можно выполнить инференс в симуляторе или на плате и проверить результаты после постобработки. Если они неверны, выполните анализ точности квантованной модели и проверьте предобработку и постобработку. Основные параметры интерфейсов инференса описаны ниже.
Интерфейс инициализации rknn.init_runtime() принимает следующие параметры:
target: целевая аппаратная платформа. По умолчанию None — используется симулятор. Для получения реальных результатов на плате задайте соответствующую платформу: RK3562 / RK3566 / RK3568 / RK3588 / RK3576 / RV1103 / RV1103B / RV1106 / RV1106B / RV1126B.
device_id: идентификатор устройства, по умолчанию None. Если задан target, выбирается единственное подключённое устройство. При нескольких подключённых устройствах нужно указать нужный идентификатор. Для сетевого подключения через ADB сначала вручную выполните adb connect [IP], затем укажите идентификатор, обычно [IP] или [IP:Port]. Команда adb devices показывает все подключённые устройства.
perf_debug: включает отладочный режим оценки производительности; по умолчанию False. Исходный текст указывает вызов rknn.val_perf(), возвращающий общее время модели. При True можно получить время каждого слоя; на RV1103, RV1103B, RV1106 и RV1106B это не поддерживается.
eval_mem: включает режим оценки памяти; по умолчанию False. После установки True можно вызвать rknn.eval_memory(), чтобы получить потребление памяти моделью во время выполнения.
Интерфейс rknn.inference() принимает следующие параметры:
inputs: список входов для инференса в формате ndarray.
data_format: список форматов размещения входных данных; действует только для четырёхмерных входов. Допустимы NCHW и NHWC. По умолчанию None: все входы имеют формат NHWC.
Пример кода:
ret = rknn.init_runtime(target=platform, device_id='515e9b401c060c0b')

# Preprocess
image_src = cv2.imread(IMG_PATH)
img = preprocess(image_src)

# Inference
outputs = rknn.inference(inputs=[img])

# Postprocess
outputs = postprocess(outputs)
Примечания: 1. Если на RV1103 / RV1106 возникает ошибка “E RKNN: failed to allocate fd, ret: -1, errno: 12”, перед инференсом на подключённой плате можно выполнить в её терминале RkLunch-stop.sh, чтобы закрыть другие приложения, потребляющие память. Обновление rknn_server до 2.1.0 также может уменьшить эту проблему.
- В версии ARM64 для rknn.init_runtime() параметр device_id не требуется.
2.3.2 Анализ точности модели
При проблемах с результатами инференса квантованной модели используйте rknn.accuracy_analysis() для анализа точности каждого слоя операторов.
Интерфейс rknn.accuracy_analysis() принимает следующие параметры:
inputs: список путей к входным файлам форматов jpg, png, bmp или npy.
output_dir: каталог сохранения результатов анализа; по умолчанию ‘./snapshot’.
target: целевая аппаратная платформа. По умолчанию None — анализ выполняется в симуляторе. Если задана платформа RK3562 / RK3566 / RK3568 / RK3588 / RK3576 / RV1103 / RV1103B / RV1106 / RV1106B / RV1126B, получаются результаты каждого слоя при выполнении на ней и проводится анализ точности.
device_id: идентификатор устройства, по умолчанию None. Если задан target, выбирается единственное устройство. При нескольких устройствах задайте нужный идентификатор. Для сетевого ADB-подключения сначала выполните adb connect [IP], затем укажите идентификатор, обычно [IP] либо [IP]:[Port].
Примечания:
-
Анализ может завершиться ошибкой, если модель слишком велика и на плате недостаточно места. Проверьте свободное место командой df -h в терминале платы. При необходимости удалите ненужные файлы, чтобы раздел с output_dir вмещал файлы результатов.
-
После загрузки модели через rknn.load_rknn() анализ точности недоступен, поскольку в RKNN-модели отсутствуют сведения исходной модели.
-
В версии ARM64 rknn.accuracy_analysis() не требует device_id; эта версия не поддерживает анализ на другом устройстве, подключённом через ADB.
Пример кода:
ret = rknn.accuracy_analysis(inputs=[img_path], target=platform, device_id='515e9b401c060c0b')
Результаты анализа точности показаны ниже.
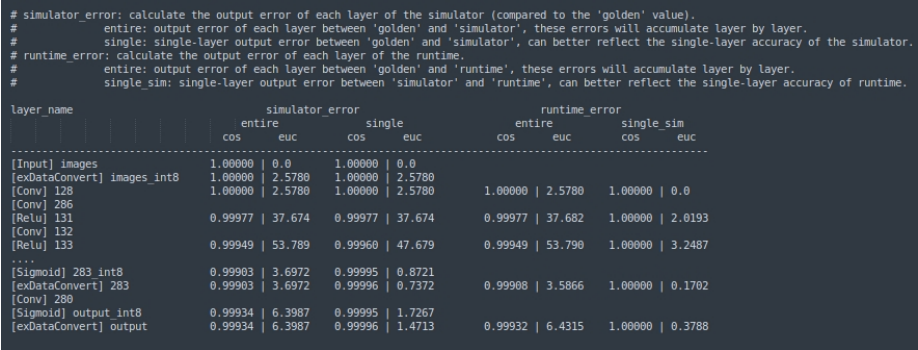
Рисунок 2-8. Результаты анализа точности
Полный анализ включает результаты симулятора и платы. Каждый из них содержит сравнение инференса всей цепочки и послойное сравнение. Подробности:
simulator_error:
entire: косинусное и евклидово расстояния между результатом симулятора и эталоном для цепочки от входного до текущего слоя.
single: косинусное и евклидово расстояния между результатом симулятора и эталоном, когда текущему слою подан эталонный вход.
runtime_error:
entire: косинусное и евклидово расстояния между реальным результатом на плате и эталоном для цепочки от входного до текущего слоя.
single: косинусное и евклидово расстояния между результатом текущего слоя на плате и эталоном при эталонном входе этого слоя.
2.3.3 Оценка производительности модели
rknn.eval_perf() выводит текущие аппаратные частоты и результаты оценки производительности. Параметр fix_freq определяет, следует ли пытаться зафиксировать частоты CPU/NPU/DDR: True включает фиксацию, False отключает; по умолчанию True. Если при инициализации rknn.init_runtime() задан perf_debug=True, выводятся время каждого слоя и общее время. При False выводится только общее время.
Примечание:
- RV1103 / RV1103B / RV1106 / RV1106B не поддерживают perf_debug=True и выводят только общее время модели.
Пример кода:
ret = rknn.init_runtime(target=platform, perf_debug=True)
perf_detail = rknn.eval_perf()
Ниже для RK3588 показаны частоты, выводимые eval_perf; поддерживаемые частоты зависят от прошивки. У CPU RK3588 архитектура big.LITTLE, поэтому для CPU выводится несколько значений в KHz, а частоты NPU и DDR приведены в Hz.
CPU Current Frequency List:
  - 1800000
  - 2256000
  - 2304000
NPU Current Frequency List:
  - 1000000000
DDR Current Frequency List:
  - 2112000000
Результаты оценки производительности:
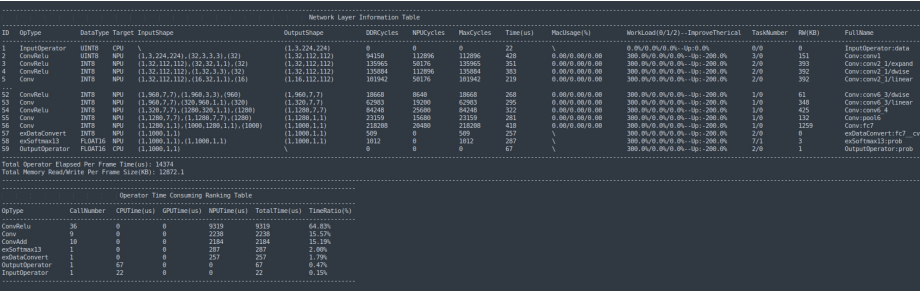
Рисунок 2-9. Результаты оценки производительности
Поля результатов описаны в следующей таблице:
Таблица 2-2. Поля результатов оценки производительности
| Поле | Описание |
|---|---|
| ID | Идентификатор оператора |
| OpType | Тип оператора |
| DataType | Тип входных данных |
| Target | Аппаратура выполнения оператора (CPU/NPU/GPU) |
| InputShape | Форма входа |
| OutputShape | Форма выхода |
| DDRCycles | Число тактов чтения/записи DDR |
| NPUCycles | Число вычислительных тактов NPU |
| MaxCycles | Максимум из DDRCycles и NPUCycles |
| Time(us) | Время вычисления оператора (us) |
| MacUsage(%) | Использование MAC |
| WorkLoad(0/1/2) | Нагрузка ядер 0/1/2, только RK3588 |
| WorkLoad(0/1) | Нагрузка ядер 0/1, только RK3576 |
| TaskNumber | Число задач NPU |
| RW(KB) | Общий объём прочитанных и записанных данных (KB) |
| FullName | Полное имя оператора |
| Total Operator Elapsed Per Frame Time(us) | Общее время инференса одного кадра модели |
| Total Memory Read/Write Per Frame Size(KB) | Общий объём обмена с памятью на кадр инференса модели |
| CallNumber | Число выполнений оператора в одном кадре |
| CPUTime(us) | Общее время оператора на CPU в одном кадре |
| GPUTime(us) | Общее время оператора на GPU в одном кадре |
| NPUTime(us) | Общее время оператора на NPU в одном кадре |
| TotalTime(us) | Общее время оператора в одном кадре |
| TimeRatio(%) | Доля общего времени оператора в общем времени одного кадра |
2.3.4 Оценка использования памяти моделью
rknn.eval_memory() получает результаты оценки памяти модели. Если при инициализации rknn.init_runtime() задан eval_mem=True, выводится потребление памяти каждой частью.
Пример кода:
ret = rknn.init_runtime(target=platform, eval_mem=True)
memory_detail = rknn.eval_memory()
Результаты оценки памяти:
======================================================
      Memory Profile Info Dump
======================================================
NPU model memory detail(bytes):
  Weight Memory: 8.67 MiB
  Internal Tensor Memory: 7.42 MiB
  Other Memory: 3.03 MiB
  Total Memory: 19.12 MiB

INFO: When evaluating memory usage, we need consider
the size of model, current model size is: 11.86 MiB
======================================================
Описание полей результатов оценки памяти:
Таблица 2-3. Поля результатов оценки памяти
| Поле | Описание |
|---|---|
| Total Weight Memory | Память весов модели (MB) |
| Total Internal Tensor Memory | Память промежуточных тензоров (MB) |
| Other Memory | Прочая память, например конфигурация регистров, входные и выходные тензоры (MB) |
| Total Memory | Общая память модели (MB) |