
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 7/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
3. Развёртывание на плате
3.1 Основы развёртывания Runtime
Раздел объясняет основные понятия RKNN Runtime, необходимые для развёртывания на плате через C API или Toolkit Lite: жизненный цикл модели и контекста, тензоры и форматы данных, память входов и выходов, синхронный и асинхронный инференс, обработку ошибок и правила освобождения ресурсов.
3.1.1 Жизненный цикл модели и контекста
rknn_context — основной дескриптор RKNN Runtime, представляющий экземпляр контекста выполнения. Через него выполняются загрузка модели, запрос атрибутов и инференс. При развёртывании строго соблюдайте цикл «создать → использовать → уничтожить», чтобы избежать утечек ресурсов и ошибок выполнения.
Создание: rknn_init() инициализирует контекст и загружает модель RKNN. После успешной инициализации готовы веса и необходимая для выполнения внутренняя память.
Использование: запросите атрибуты входов и выходов через rknn_query(), затем многократно выполняйте инференс через общий API (rknn_inputs_set() / rknn_run() / rknn_outputs_get()) либо API нулевого копирования (rknn_set_io_mem() + rknn_run()). Дескриптор остаётся тем же. На RK3588 / RK3576 перед инференсом можно выбрать ядра NPU через rknn_set_core_mask(); см. 4.1.2.
Уничтожение: после завершения всех задач вызовите rknn_destroy(), чтобы уничтожить контекст и освободить всю память модели. После этого дескриптор использовать нельзя.
3.1.2 Тензоры и форматы размещения данных
Входы и выходы RKNN-модели представлены тензорами. Перед развёртыванием запросите через rknn_query() атрибуты rknn_tensor_attr: имя, форму, тип данных (dtype), размещение (layout) и параметры квантования (qnt_type / qnt_info). Подготавливайте входы и интерпретируйте выходы в соответствии с ними.
Тип данных (dtype): FP32 / FP16 / INT8 / INT16 / UINT8 и другие; определяется настройкой квантования при преобразовании. По умолчанию квантованные модели используют INT8 с асимметричным квантованием.
Размещение (layout): главным образом NCHW, NHWC, NC1HWC2 и UNDEFINE. NC1HWC2 — специальный аппаратный формат памяти RKNPU, описанный ниже.
В настоящее время RKNN имеет четыре формата размещения: NHWC, NCHW, NC1HWC2 и UNDEFINE.
NHWC и NCHW широко используются в глубоком обучении и здесь отдельно не объясняются. Рассмотрим хранение и преобразование формата NC1HWC2, предназначенного для аппаратуры RKNPU.
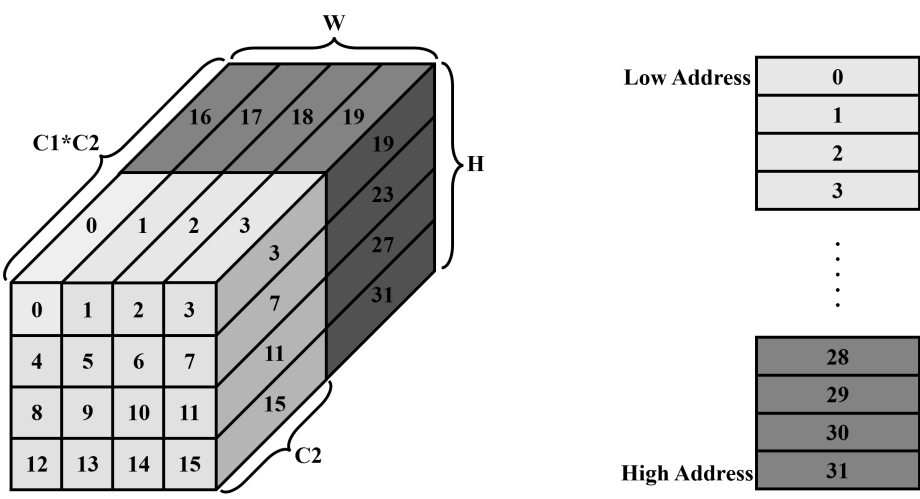
Рисунок 3-1. Размещение и хранение NC1HWC2 в RKNPU
На рисунке 3-1 число 0 обозначает блок: одновременно хранятся C2 элементов, причём C2 зависит от платформы. Правила выбора C2 приведены в таблице 3-1, а C1 равно C/C2 с округлением вверх. Порядок хранения совпадает с возрастанием номеров на схеме: сначала блоки 0–15, затем 16–31. Например, на RK3568 для признаков (1, 13, 4, 4) типа int8 формат NC1HWC2 имеет форму (1, 2, 4, 4, 8): C2=8, C1=2. В блоках 16–31 действительны только первые 5 элементов каждого блока C2, оставшиеся 3 добавлены для выравнивания.
Таблица 3-1. Значения C2 для аппаратных платформ
| RK2118 | RK3566/RK3568 | RK3588/RK3576/RV1126B | RV1103B/RV1106B | RV1103/RV1106 | RK3562 | |
|---|---|---|---|---|---|---|
| int8 | / | 8 | 16 | 8 | 16 | 16 |
| float16 | 4 | 4 | 8 | / | 8 | 8 |
Далее подробно рассмотрено преобразование размещения NC1HWC2 в NCHW и NHWC в памяти.
Для примера возьмём признаки (1, 13, 2, 2) на RK3568. С учётом правил выравнивания соответствующая форма NC1HWC2 равна (1, 2, 2, 2, 8). На следующей схеме красным отмечены недействительные элементы, добавленные для выравнивания.
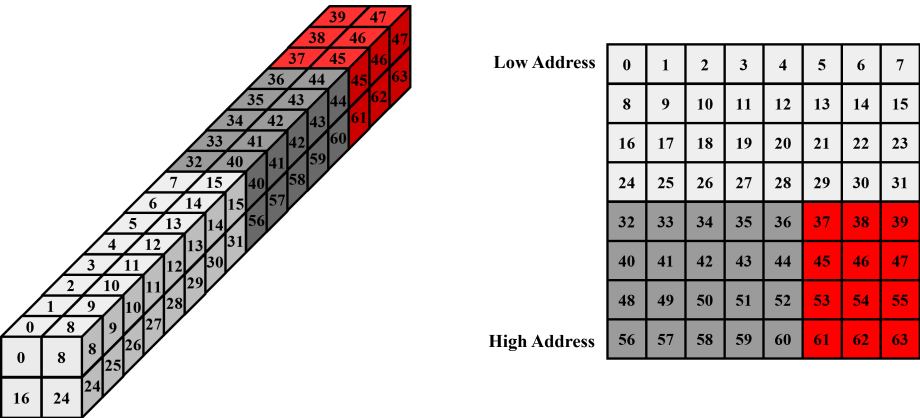
Рисунок 3-2. Развёрнутое размещение NC1HWC2
После удаления недействительных данных и преобразования в NCHW, то есть (1, 13, 2, 2), расположение в памяти будет следующим:
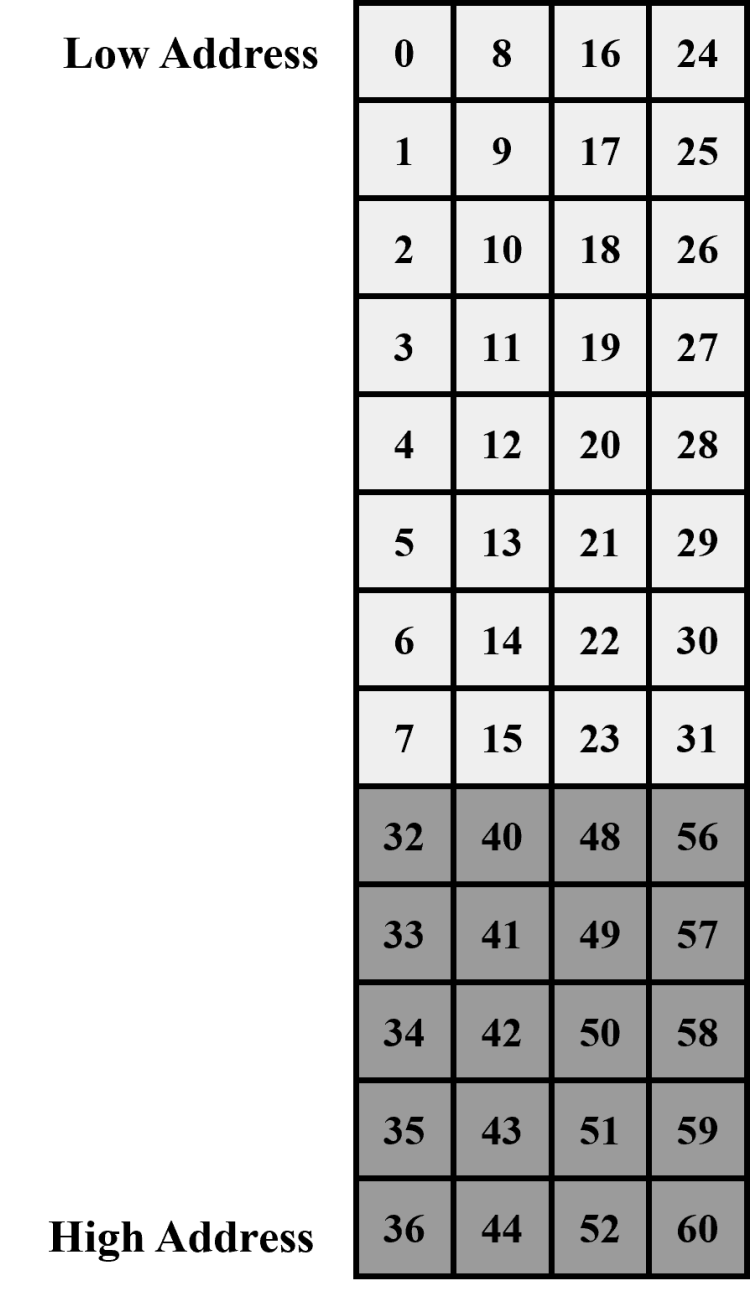
Рисунок 3-3. Размещение NCHW
После удаления недействительных данных и преобразования в NHWC, то есть (1, 2, 2, 13), расположение в памяти будет следующим:
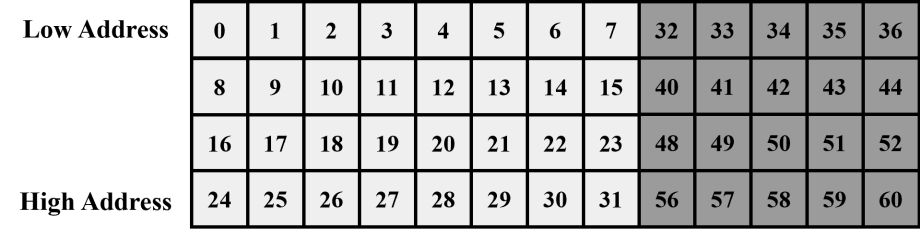
Рисунок 3-4. Размещение NHWC
Пример кода преобразования:
NC1HWC2 → NCHW: пример преобразования данных int8 из NC1HWC2 в NCHW:
/*
 *src: represents the address of the NC1HWC2 input tensor
 *dst: represents the address of the NCHW output tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NCHW
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NCHW(const int8_t* src, int8_t* dst, int* dims, int channel, int h,
int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int c = 0; c < channel; ++c) {
      int plane = c / C2;
      const int8_t* src_c = plane * hw_src * C2 + src;
      int offset = c % C2;
      for (int cur_h = 0; cur_h < h; ++cur_h)
        for (int cur_w = 0; cur_w < w; ++cur_w) {
         int cur_hw = cur_h * w + cur_w;
         dst[c * hw_dst + cur_h * w + cur_w] = src_c[C2 * cur_hw + offset];
        }
    }
  }
  return 0;
}
NC1HWC2 → NHWC: пример преобразования данных int8 из NC1HWC2 в NHWC:
/*
 *src: represents the address of the NC1HWC2 input tensor
 *dst: represents the address of the NCHW output tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NHWC
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NHWC(const int8_t* src, int8_t* dst, int* dims, int channel, int h,
int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int cur_h = 0; cur_h < h; ++cur_h) {
      for (int cur_w = 0; cur_w < w; ++cur_w) {
        int cur_hw = cur_h * dims[3] + cur_w;
        for (int c = 0; c < channel; ++c) {
         int plane = c / C2;
         const auto* src_c = plane * hw_src * C2 + src;
         int offset = c % C2;
         dst[cur_h * w * channel + cur_w * channel + c] = src_c[C2 * cur_hw + offset];
        }
      }
    }
  }
  return 0;
}
3.1.3 Память входов и выходов
В RKNN Runtime данные входов и выходов передаются через объекты памяти. Общий API и API нулевого копирования различаются управлением памятью:
Общий API с внутренним копированием: пользователь готовит входной буфер, на который указывает buf структуры rknn_input. При rknn_inputs_set() Runtime копирует данные во вход модели. После инференса rknn_outputs_get() выделяет выходную память и копирует результаты. После использования обязательно вызовите rknn_outputs_release(). Преобразование типа, размещения и нормализация выполняются внутри Runtime. Этот простой способ подходит большинству сценариев.
API нулевого копирования: доступная NPU память выделяется через rknn_create_mem() либо внешняя физическая память подключается через rknn_create_mem_from_fd() / rknn_create_mem_from_phys(), затем связывается с тензорами через rknn_set_io_mem(). NPU читает и записывает её напрямую, исключая внутреннее копирование и повышая производительность. Размер, тип и размещение должны точно соответствовать атрибутам тензора.
Рекомендация: для обычного развёртывания и некритичной производительности используйте простой и надёжный общий API. Для максимальной производительности и устранения времени копирования используйте нулевое копирование; см. 3.1.6.
Правила освобождения памяти:
-
Выходная память общего API освобождается через rknn_outputs_release() после постобработки; память входов и выходов API нулевого копирования — через rknn_destroy_mem().
-
Память необходимо освободить до уничтожения контекста через rknn_destroy(), иначе возможны утечки ресурсов.
-
Повторное использование освобождённой памяти приводит к неопределённому поведению.
3.1.4 Синхронный и асинхронный инференс
rknn_run() в RKNN Runtime — синхронный блокирующий вызов. Вызывающий поток ждёт окончания текущего инференса NPU; после возврата можно получить результаты без дополнительной синхронизации.
По описанию этой версии Runtime асинхронный интерфейс инференса не предоставляется. Для параллельных задач, например захвата и предобработки следующего кадра, используйте потоки приложения: отдельный поток выполняет rknn_run(), основной готовит данные, а очереди между производителем и потребителем образуют конвейер для повышения пропускной способности.
Примечание: нельзя одновременно вызывать rknn_run() из нескольких потоков для одного контекста. Для параллельного инференса создайте отдельный контекст каждого потока через rknn_dup_context(); см. 5.3.4 «Многопоточное повторное использование контекста RKNN».
3.1.5 Обработка ошибок и освобождение ресурсов
Обработка ошибок
Функции RKNN C API возвращают код int: RKNN_SUCCESS (0) означает успех, отрицательные значения — ошибки. Проверяйте результат каждого вызова. При ошибке не продолжайте последующие операции, а переходите к очистке ресурсов и выходу, чтобы избежать неопределённого поведения в ошибочном состоянии.
Полные определения кодов приведены в «05_RKNN2_Runtime_C_API_Reference_V2.5.0». Для диагностики задайте перед запуском RKNN_LOG_LEVEL=5, чтобы получить подробный послойный журнал. Разбор типичных ошибок приведён в 5.4.
Пример обработки ошибок инициализации с переходом к очистке:
int ret = rknn_init(&ctx, model, model_len, 0, NULL);
if (ret != RKNN_SUCCESS) {
    printf("rknn_init failed! ret=%d\n", ret);
    goto out;
}
Освобождение ресурсов
Ресурсы нужно освобождать в правильном порядке. Рекомендуется единая ветвь очистки с переходом goto, чтобы ресурсы корректно освобождались как при успехе, так и при ошибке.
Общий API: сначала rknn_outputs_release() освобождает выходные данные, затем rknn_destroy() уничтожает контекст.
out:
    // Release the output data memory (general API)
    rknn_outputs_release(ctx, io_num.n_output, outputs);
    // Destroy the context
    if (ctx) rknn_destroy(ctx);
API нулевого копирования: сначала последовательно освободите входную и выходную память через rknn_destroy_mem(), затем уничтожьте контекст.
out:
    // Release the input/output memory (zero-copy API; input_mems/output_mems are rknn_tensor_mem pointers returned by rknn_create_mem())
    for (int i = 0; i < io_num.n_input; i++) {
        rknn_destroy_mem(ctx, input_mems[i]);
    }
    for (int i = 0; i < io_num.n_output; i++) {
        rknn_destroy_mem(ctx, output_mems[i]);
    }
    // Destroy the context
    if (ctx) rknn_destroy(ctx);
Примечание: после уничтожения контекста нельзя обращаться ни к каким выделенным через него ресурсам. Убедитесь, что все они освобождены заранее.