
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 8/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
3.1.6 Интерфейс нулевого копирования RKNN Runtime
3.1.6.1 Введение в нулевое копирование
RK3562 / RK3566 / RK3568 / RK3576 / RK3588 / RV1126B предоставляют общий API и API нулевого копирования; серии RV1103 / RV1106 поддерживают API нулевого копирования. Примеры находятся в examples/rknn_zero_copy проекта rknpu2. Репозиторий и дополнительные сведения: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2.
При инференсе RKNN исходные данные проходят обработку входа, выполнение модели NPU и обработку выхода. В зависимости от входного формата и квантования интерфейсы реализуют два процесса: общий API и нулевое копирование, показанные на рисунках 3-5 и 3-6. Главное различие состоит в том, что при каждом обновлении кадра общий интерфейс копирует данные внешнего модуля во входную память NPU Runtime, а интерфейс нулевого копирования непосредственно использует заранее выделенную память — самим Runtime либо внешним фреймворком, например DRM. Это сокращает копирование, повышает производительность и уменьшает расход пропускной способности. Если входные данные имеют только виртуальный адрес, доступен лишь общий API; при физическом адресе или fd доступны оба. Смешивать вызовы двух групп API нельзя.
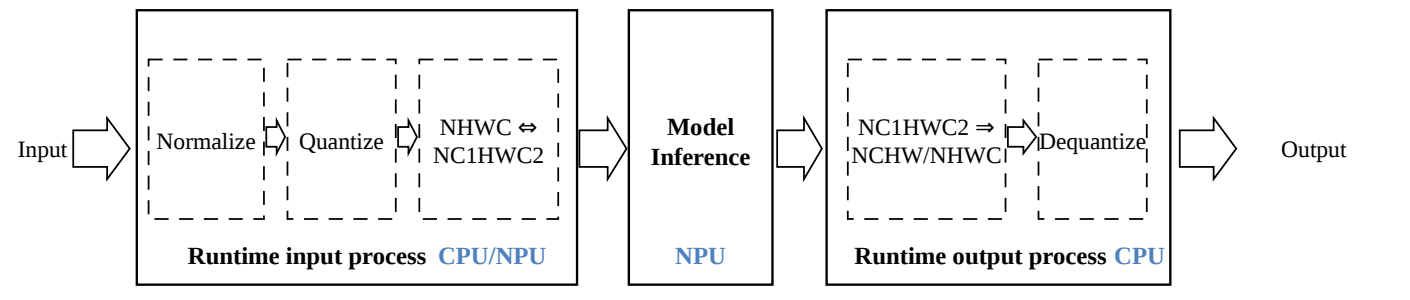
Рисунок 3-5. Обработка данных общего API
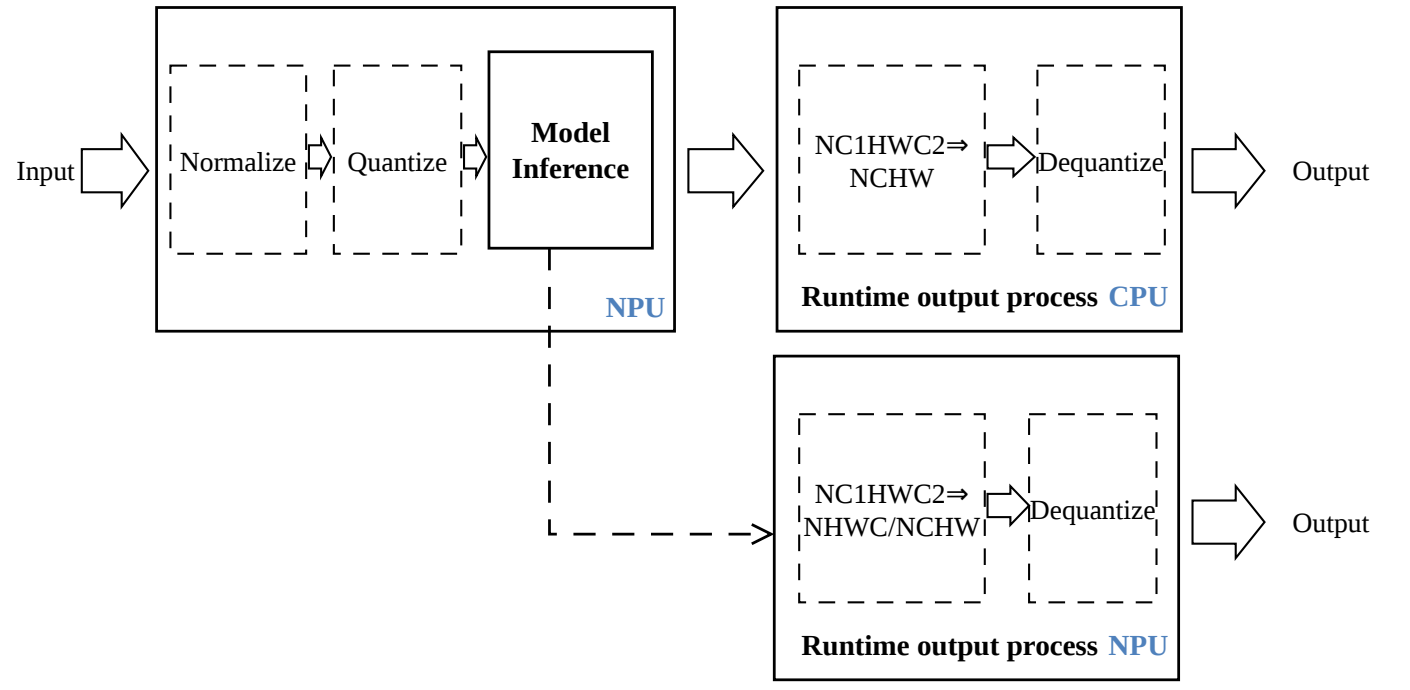
Рисунок 3-6. Обработка данных API нулевого копирования
1 Обычный API
В общем API, показанном на рисунке 3-5, нормализация, квантование, преобразование размещения и деквантование выполняются на CPU, а модель — на NPU. Если соблюдены требования входа нулевого копирования, нормализация и квантование выполняются на NPU, но CPU всё равно копирует входные данные в буфер модели.
1 API нулевого копирования
Нулевое копирование на рисунке 3-6 оптимизирует общий процесс: нормализация, квантование и инференс выполняются на NPU, а преобразование размещения выхода и деквантование — на CPU или NPU. Обработка входного потока эффективнее общего API.
Условия использования нулевого копирования приведены в таблице:
Таблица 3-2. Требования к входу нулевого копирования
| Размерность входа | RV1103B / RV1106B / RK3566 / RK3568 | RK3562 / RK3576 / RK3588 / RV1103 / RV1106 / RV1126B |
|---|---|---|
| 4 измерения, 1, 3 или 4 канала | Ширина выровнена по 8 байтам | Ширина выровнена по 16 байтам |
| Не 4 измерения | Общий размер выровнен по 8 байтам | Общий размер выровнен по 16 байтам |
3.1.6.2 Процесс нулевого копирования C API
API нулевого копирования использует структуру rknn_tensor_memory, создаваемую и настраиваемую до инференса; после него читаются данные соответствующей памяти. В зависимости от самостоятельного выделения памяти входов, выходов, весов и промежуточных результатов, а также её представления через fd или физический адрес, существуют три типичных процесса на рисунках 3-7–3-9. Красным выделены добавленные для нулевого копирования интерфейсы и структуры, курсивом — структуры, передаваемые между вызовами.
Входная и выходная память выделяется Runtime
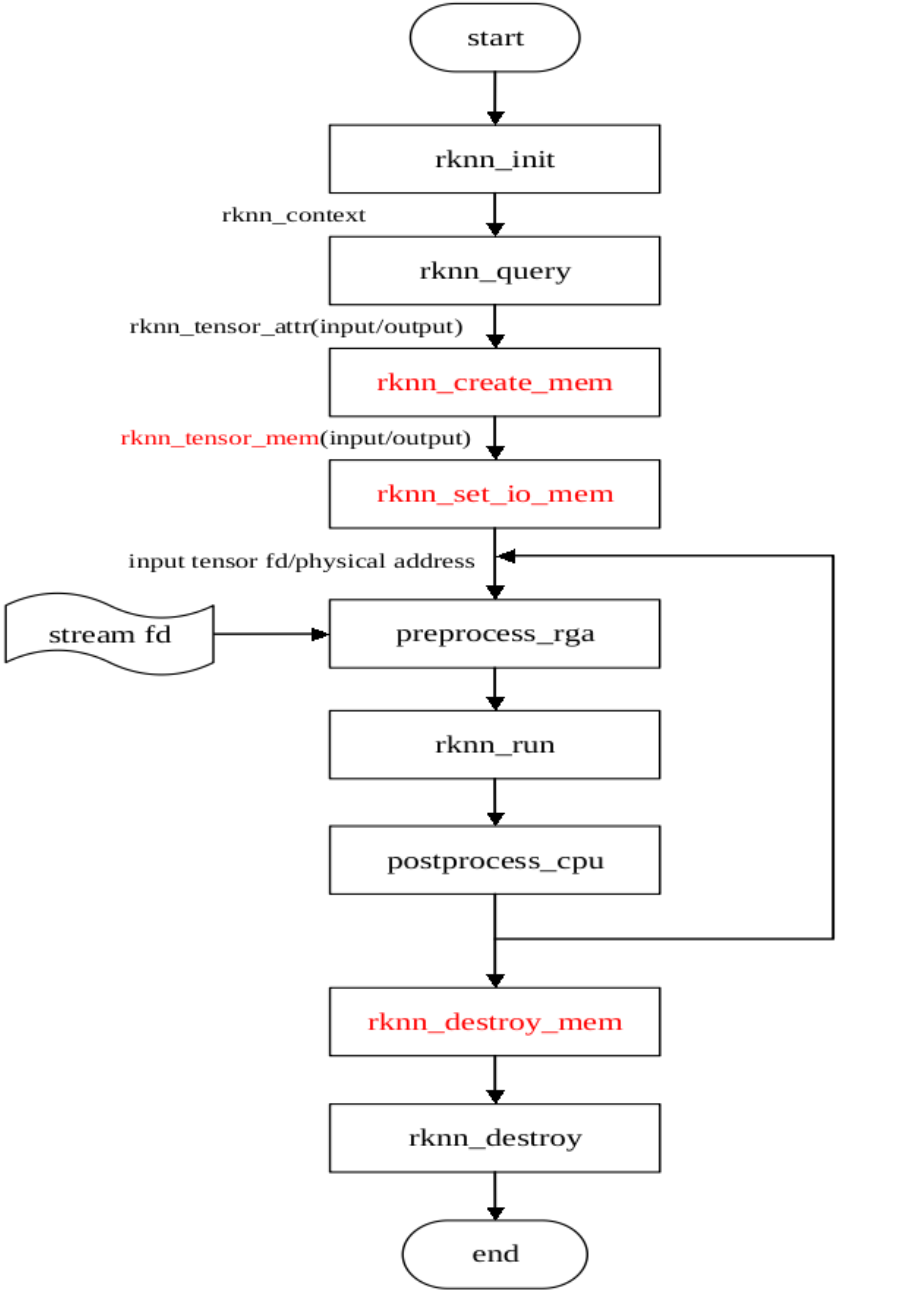
Рисунок 3-7. Вызовы API нулевого копирования: внутреннее выделение входной и выходной памяти
На рисунке 3-7 Runtime выделяет входную и выходную память: rknn_create_mem() создаёт rknn_tensor_memory, а rknn_set_io_mem() устанавливает структуры входа и выхода.
Созданная rknn_create_mem() структура содержит файловый дескриптор и физический адрес. RGA использует память NPU: preprocess_rga() обозначает интерфейс RGA, stream_fd — память входного источника RGA, postprocess_cpu() — постобработку на CPU.
Внешнее выделение входной и выходной памяти
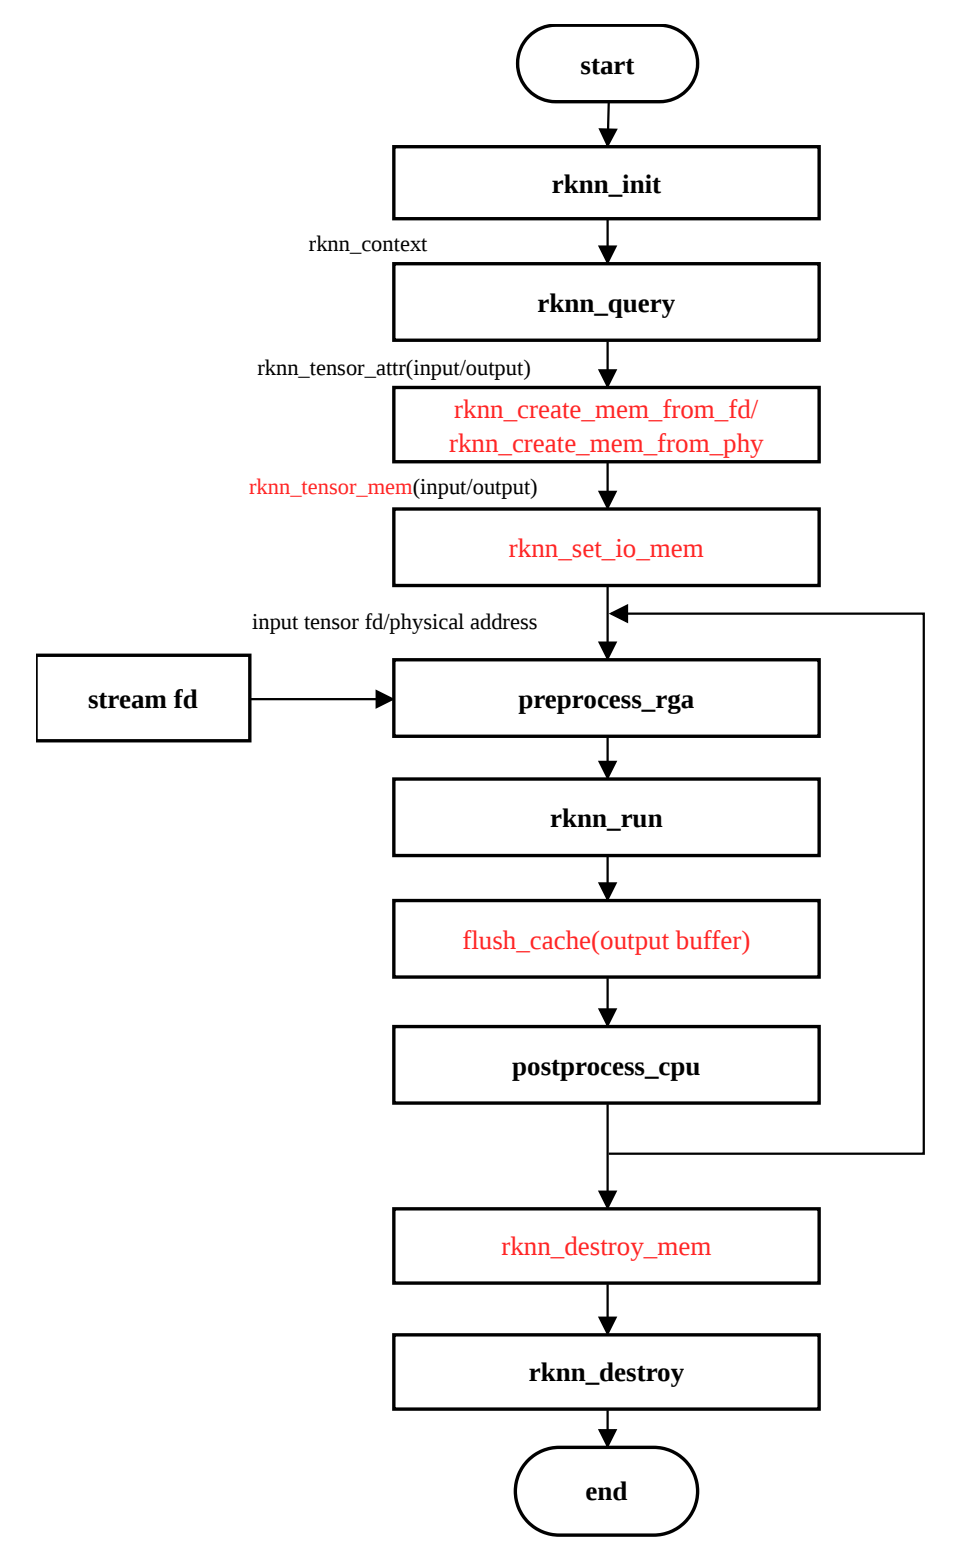
Рисунок 3-8. Вызовы API нулевого копирования: внешнее выделение входной и выходной памяти
На рисунке 3-8 при внешнем выделении памяти rknn_create_mem_from_fd() / rknn_create_mem_from_phys() создают rknn_tensor_memory, а rknn_set_io_mem() устанавливает структуры входа и выхода. flush_cache означает, что пользователь должен вызвать подходящий выделенной памяти интерфейс обслуживания выходного кэша.
Внешнее выделение памяти входов, выходов, весов и промежуточных результатов
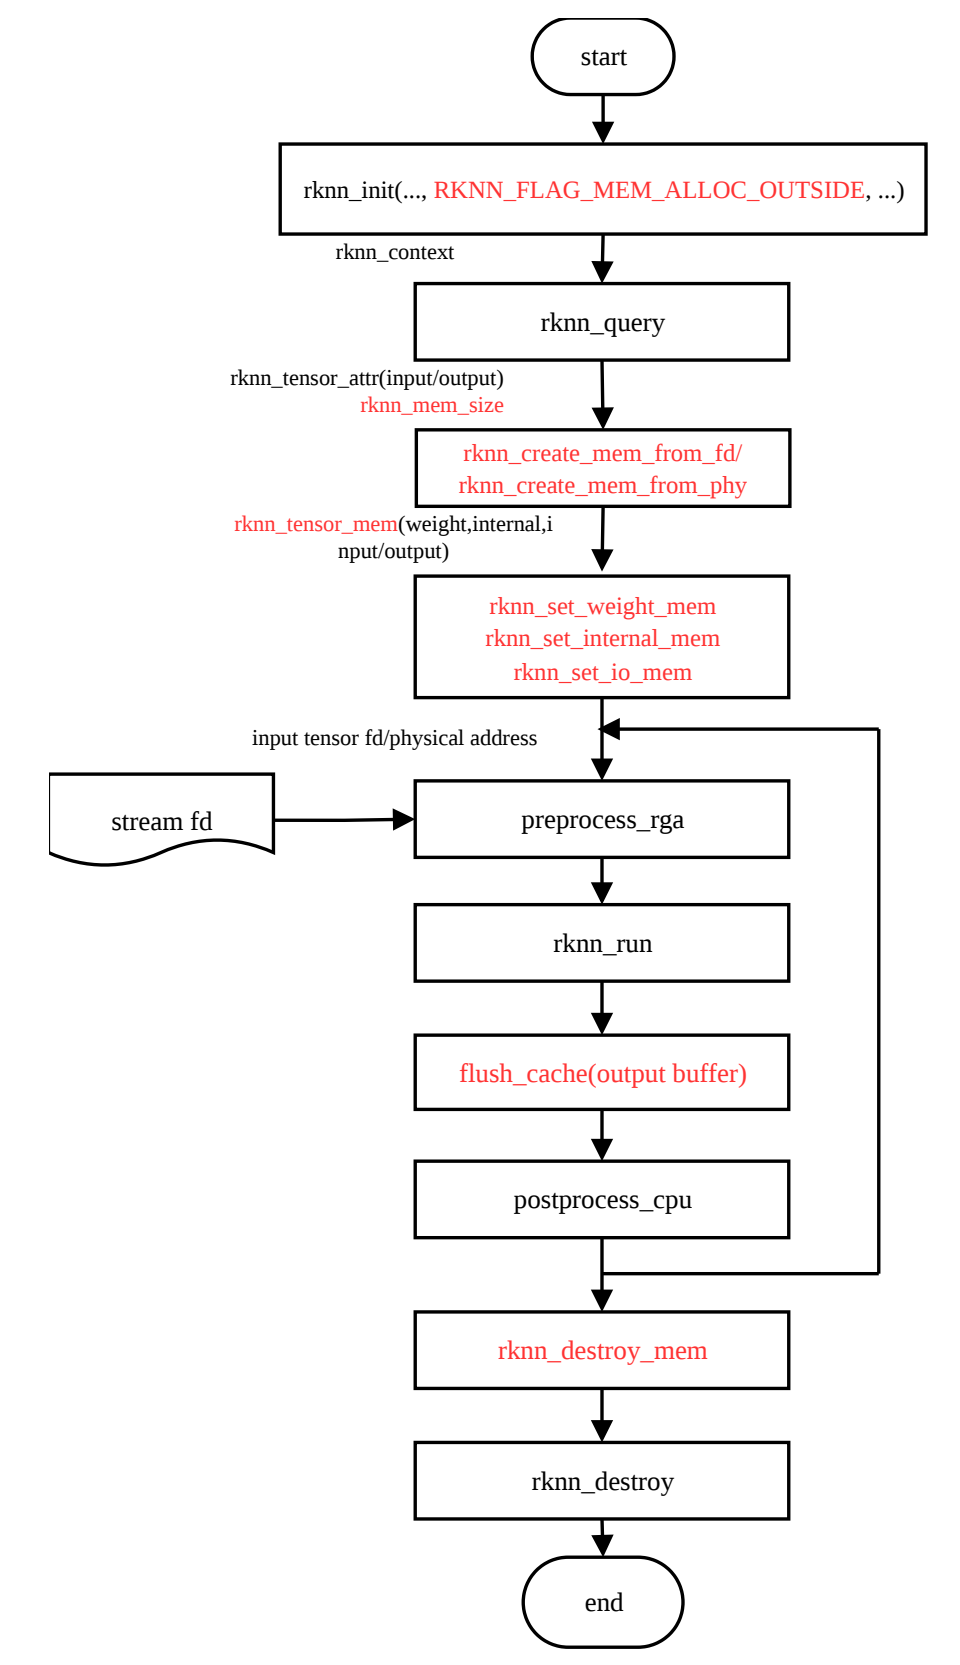
Рисунок 3-9. Вызовы API нулевого копирования: внешнее выделение входов, выходов, весов и промежуточных результатов
На рисунке 3-9 внешняя память подключается через rknn_create_mem_from_fd() / rknn_create_mem_from_phys(), создающие rknn_tensor_memory. rknn_set_io_mem() задаёт входы и выходы, а rknn_set_weight_mem() / rknn_set_internal_mem() — память весов и промежуточных результатов.
3.1.6.3 Использование C API нулевого копирования
Рассмотрим использование на примере рисунка 3-7 с внутренним выделением памяти входов и выходов:
rknn_query()
Вход:
Запрашивайте атрибуты через RKNN_QUERY_NATIVE_INPUT_ATTR, не RKNN_QUERY_INPUT_ATTR. Требуемая предобработка зависит от полученного fmt (layout). Такой запрос возвращает наиболее эффективные для аппаратуры тип и размещение входа.
Варианты входа rknn_query():
a. RKNN_TENSOR_NCHW: обычно четырёхмерный вход bool или int64. Данные NPU также должны быть организованы в NCHW.
b. RKNN_TENSOR_NHWC: обычно четырёхмерный вход float32/float16/int8/uint8 с 1, 3 или 4 каналами. Данные передаются в NHWC. При pass_through=1 ширину может потребоваться выровнять по stride согласно запрошенному w_stride.
c. RKNN_TENSOR_NC1HWC2: обычно четырёхмерный вход float16/int8, число каналов не равно 1, 3 или 4. При pass_through=0 вход организуется в NHWC, а интерфейс преобразует его на CPU в NC1HWC2. При pass_through=1 требуется NC1HWC2, и пользователь выполняет преобразование самостоятельно.
d. RKNN_TENSOR_UNDEFINED: обычно вход не четырёхмерный. Данные передаются в формате входа модели ONNX. NPU не выполняет обработку mean/std и преобразование размещения.
Если нужна конфигурация входа, отличная от полученной rknn_tensor_attr, структуру можно изменить. Допустимые изменения типов приведены в таблице 3-3. Особенно важно: если запрошен uint8, а передавать нужно float32, размер в rknn_tensor_attr увеличивается в четыре раза, тип меняется на RKNN_TENSOR_FLOAT32. После изменения эффективность аппаратуры уже не оптимальна: интерфейс выполняет преобразование типа на CPU.
Таблица 3-3. Допустимые изменения типа входа
| Тип пользователя / тип модели | bool | int8 | float16 | int16 | int32 | Int64 |
|---|---|---|---|---|---|---|
| bool | Y | |||||
| int8 | Y | |||||
| uint8 | Y | Y | ||||
| float32 | Y | Y | ||||
| float16 | Y | |||||
| int16 | Y | |||||
| int32 | Y | |||||
| Int64 | Y |
Выход:
Запрашивайте атрибуты через RKNN_QUERY_NATIVE_OUTPUT_ATTR, не RKNN_QUERY_OUTPUT_ATTR. Требуемая постобработка зависит от fmt (layout). Запрос возвращает наиболее эффективные для аппаратуры размещение и тип выхода.
Если четырёхмерный выход нужен в NHWC, используйте RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR: так выход NHWC можно получить напрямую.
Варианты выхода rknn_query():
a. RKNN_TENSOR_NC1HWC2: обычно четырёхмерный выход float16/int8. Для NCHW пользователь должен выполнить внешнее преобразование NC1HWC2 → NCHW.
b. RKNN_TENSOR_UNDEFINED: обычно выход не четырёхмерный, тип float16/int8. Внешнее преобразование размещения не требуется.
c. RKNN_TENSOR_NCHW: обычно четырёхмерный выход float16/int8. Внешнее преобразование размещения не требуется.
d. RKNN_TENSOR_NHWC: обычно четырёхмерный выход float16/int8. Такой результат обычно получается при запросе через RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR.
Если требуемая конфигурация выхода отличается от rknn_tensor_attr, структуру можно изменить согласно таблицам 3-5 и 3-4. Особенно важно: при запрошенном int8 и требуемом float32 размер увеличивается в четыре раза, тип меняется на RKNN_TENSOR_FLOAT32. После этого аппаратная эффективность уже не оптимальна: преобразование выполняет CPU внутри интерфейса.
Таблица 3-5. Допустимые изменения типа выхода
| Тип пользователя / тип модели | bool | int8 | float16 | int16 | int32 | Int64 |
|---|---|---|---|---|---|---|
| bool | Y | |||||
| int8 | Y | |||||
| uint8 | ||||||
| float32 | Y | Y | ||||
| float16 | Y | |||||
| int16 | Y | |||||
| int32 | Y | |||||
| Int64 | Y |
Таблица 3-4. Допустимые изменения размещения выхода
| Размещение пользователя / модели | NC1HWC2 | NCHW | NHWC | UNDEFINE |
|---|---|---|---|---|
| NC1HWC2 | Y | |||
| NCHW | Y | Y | ||
| NHWC | Y | |||
| UNDEFINE | Y |
Поддерживаемые NPU конфигурации выхода нулевого копирования приведены для RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B в таблице 3-6, а для RV1106/RV1106B/RV1103/RV1103B — в таблице 3-7.
Таблица 3-6. Конфигурации выхода NPU нулевого копирования для RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B
| Тип модели | Тип выхода | Размерность выхода | Поддерживаемое размещение выхода |
|---|---|---|---|
| Модель int8 | int8/float16/float32 | 4 измерения | NCHW/NC1HWC2/NHWC |
| Модель int8 | int8/float16/float32 | Не 4 измерения | UNDEFINE |
| Модель float16 | float16/float32 | 4 измерения | NCHW/NC1HWC2/NHWC |
| Модель float16 | float16/float32 | Не 4 измерения | UNDEFINE |
Таблица 3-7. Конфигурации выхода NPU нулевого копирования для RV1103/RV1103B/RV1106/RV1106B
| Тип модели | Тип выхода | Размерность выхода | Поддерживаемое размещение выхода |
|---|---|---|---|
| Модель int8 | int8/float16 | 4 измерения | NCHW/NC1HWC2/NHWC |
| Модель int8 | int8/float16 | Не 4 измерения | UNDEFINE |
rknn_create_mem
Структуру rknn_tensor_memory создают и настраивают до инференса, а затем читают память результатов. Если тип и размещение, запрошенные через RKNN_QUERY_NATIVE_INPUT_ATTR и RKNN_QUERY_NATIVE_OUTPUT_ATTR, не изменяются, выделяйте память размера size_with_stride. При изменении типа или размещения нужен соответствующий размер: например, при переходе выхода int8 → float32 он увеличивается в четыре раза.
rknn_set_io_mem
rknn_set_io_mem() задаёт структуру rknn_tensor_mem с информацией о входной и выходной памяти модели. Как и rknn_init(), её достаточно вызвать один раз в начале, после чего rknn_run() можно выполнять многократно.