
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 13/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
4.1.3 Динамическая форма
4.1.3.1 Введение в динамическую форму
Динамическая форма позволяет менять форму входных данных во время выполнения, обрабатывая переменные размеры и повышая гибкость модели. Когда RKNN поддерживал только статические формы, для нескольких входных форм требовались отдельные модели и контексты инференса. С динамической формой достаточно одной модели RKNN размером, близким к статической, и одного контекста, что экономит Flash и DDR. Это важно для обработки изображений и последовательностей. Типичные сценарии:
Переменная длина последовательности, например NLP-модели BERT и GPT.
Переменные пространственные размеры, например сегментация и перенос стиля.
Изменяемый размер batch в пакетных моделях.
Обнаружение объектов с переменным числом выходов.
4.1.3.2 Требования к версии RKNN SDK и платформе
Версия RKNN-Toolkit2 >=1.5.0
Версия RKNPU Runtime (librknnrt.so) >=1.5.0
Функцию поддерживают NPU платформ RK3562/RK3566/RK3568/RK3576/RK3588/RK3588S/RV1126B.
4.1.3.3 Создание модели RKNN с динамической формой
Создание RKNN-модели с динамической формой через Python API RKNN-Toolkit2:
1 Убедитесь, что модель поддерживает динамическую форму.
Даже исходную статическую модель RKNN-Toolkit2 может расширить до динамической. Сначала убедитесь, что операторы и подграфы не ограничивают изменение формы: например, форму константы менять нельзя, и инструмент выдаст ошибку преобразования. При неподдерживаемом расширении измените архитектуру по сообщению об ошибке и переобучите модель. Рекомендуется исходная модель с динамической формой.
- Задайте используемые формы входа
Из-за NPU произвольные изменения формы невозможны: задаётся ограниченный набор форм. При нескольких входах число форм каждого входа должно совпадать. Пример преобразования Caffe через Python:
# Python
dynamic_input = [
    [[1,3,224,224]], # set the first shape for all inputs
    [[1,3,192,192]], # set the second shape for all inputs
    [[1,3,160,160]], # set the third shape for all inputs
]

# Pre-process config
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82],
quant_img_RGB2BGR=True, dynamic_input=dynamic_shapes)
Эта конфигурация создаёт модель с тремя формами: [1,3,224,224], [1,3,192,192], [1,3,160,160].
dynamic_input следует layout исходного фреймворка. Например, для RGB 224x224 вход TensorFlow/TFLite — [1,224,224,3], ONNX — [1,3,224,224].
1 Квантование
При квантовании после задания форм укажите калибровочный набор. Инструмент использует максимальное разрешение — группу с наибольшей суммой размеров всех входов. Например, первый вход имеет [1,224]/[1,112], второй [1,40]/[1,80]. Суммы групп: 1224+140=264 и 1112+180=192 (так напечатано в PDF; знаки умножения в оригинале отсутствуют, запись требует проверки). Первая больше, поэтому квантование использует [1,224] и [1,40].
Для jpg/png допустимы разные разрешения: до квантования инструмент меняет размер изображений до максимального через resize OpenCV.
Для npy необходимо использовать максимальную входную форму. После квантования все формы используют при инференсе одинаковый набор параметров квантования.
Максимальная входная форма также печатается при rknn.config:
W config: The 'dynamic_input' function has been enabled, the MaxShape is dynamic_input[0] = [[1,224],[1,40]]!
The following functions are subject to the MaxShape:
1. The quantified dataset needs to be configured according to MaxShape
2. The eval_perf or eval_memory return the results of MaxShape
- Оценка инференса или анализ точности
При инференсе или анализе точности подайте входы одной из групп форм шага 2. Интерфейсы используются как для статической модели и здесь повторно не описываются.
Полный пример динамической формы: https://github.com/airockchip/rknn-toolkit2/tree/master/rknn-toolkit2/examples/functions/dynamic_shape
4.1.3.4 Развертывание через C API
После получения модели с динамической формой разверните ее через RKNPU2 C API. В зависимости от интерфейса используются обычный API или нулевое копирование.
4.1.3.4.1 Обычный API
Развёртывание динамической модели через общий API показано ниже:
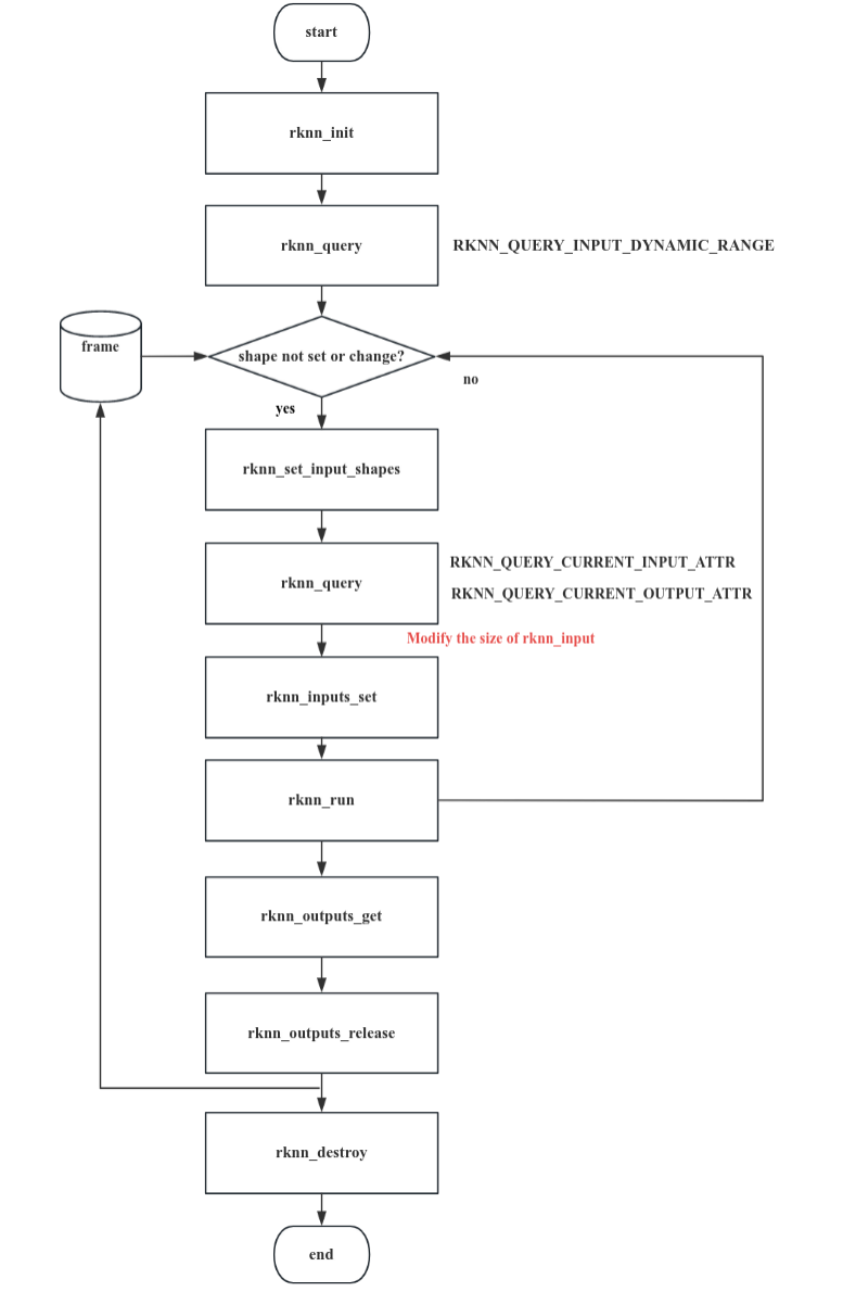
Рисунок 4-5. Общий API для динамической формы входа
После загрузки динамической RKNN-модели форму можно менять во время выполнения. Сначала rknn_query() запрашивает поддерживаемые формы. Список каждого входа возвращается как rknn_input_range с именем, layout, числом и значениями форм. Затем передайте в rknn_set_input_shapes() указатель на массив rknn_tensor_attr с формами каждого входа, задавая текущую форму. После успешной настройки снова вызовите rknn_query() для актуальных форм входов/выходов.
Завершите инференс по общему API. При смене формы заново задайте её, подготовьте данные нового размера и вызовите rknn_inputs_set(). Без смены формы повторять rknn_set_input_shapes() не требуется.
1 Инициализация
Инициализируйте динамическую модель через rknn_init().
Ограничения инициализации контекста динамической модели:
Общие веса не поддерживаются: нельзя инициализировать с RKNN_FLAG_SHARE_WEIGHT_MEM.
Повторное использование контекста не поддерживается; см. rknn_dup_context.
2. Запросите поддерживаемые сочетания входных форм
После инициализации rknn_query() возвращает формы каждого входа через rknn_input_range с именем, layout, числом и значениями форм. Пример C:
// Query the input shapes supported by the model
rknn_input_range dyn_range[io_num.n_input];
memset(dyn_range, 0, io_num.n_input * sizeof(rknn_input_range));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
    dyn_range[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_DYNAMIC_RANGE, &dyn_range[i], sizeof(rknn_input_range));
    if (ret != RKNN_SUCC)
    {
        fprintf(stderr, "rknn_query error! ret=%d\n", ret);
        return -1;
    }
    dump_input_dynamic_range(&dyn_range[i]);
}
Примечание: формы нескольких входов сопоставляются строго по порядку, не перекрёстно. Например, первая форма первого входа сочетается только с первой формой второго. Для A=[1,224]/[1,112] и B=[1,40]/[1,80] поддерживаются только две следующие группы:
Форма A = [1,224], форма B=[1,40]
Форма A = [1,112], форма B=[1,80]
3 Установка формы входа
При первой установке входов или изменении их формы вызовите rknn_set_input_shapes(). После загрузки динамической модели форму можно менять во время выполнения. Передайте массив rknn_tensor_attr всех входов: dims, n_dims и fmt каждого элемента описывают текущую форму. Пример C:
/**
 dynamic inputs shape range:
 index=0, name=data, shape_number=2, range=[[1, 224, 224, 3],[1, 112, 224, 3]], fmt = NHWC
**/
input_attrs[0].dims[0] = 1;
input_attrs[0].dims[1] = 224;
input_attrs[0].dims[2] = 224;
input_attrs[0].dims[3] = 3;
input_attrs[0].fmt=RKNN_TENSOR_NHWC;
ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
if (ret < 0) {
  fprintf(stderr, "rknn_set_input_shapes error! ret=%d\n", ret);
  return -1;
}
io_num.n_input — число входов, input_attrs — массив rknn_tensor_attr входов модели.
Примечание: заданная форма должна присутствовать в списке шага 2.
После успешной установки формы снова запросите формы входа/выхода через rknn_query. Пример C:
// Get the input and output shapes of the current inference
rknn_tensor_attr cur_input_attrs[io_num.n_input];
memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
    cur_input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));
    if (ret < 0)
    {
        printf("rknn_init error! ret=%d\n", ret);
        return -1;
    }
    dump_tensor_attr(&cur_input_attrs[i]);
}
rknn_tensor_attr cur_output_attrs[io_num.n_output];
memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_output; i++)
{
    cur_output_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &(cur_output_attrs[i]), sizeof(rknn_tensor_attr));
    if (ret != RKNN_SUCC)
    {
        printf("rknn_query fail! ret=%d\n", ret);
        return -1;
    }
    dump_tensor_attr(&cur_output_attrs[i]);
}
Примечания:
rknn_set_input_shape требует fmt=NHWC для четырёхмерного входа и UNDEFINED для остальных размерностей.
До rknn_set_input_shapes результаты запросов с префиксом RKNN_QUERY_CURRENT недействительны.
4 Инференс
После установки текущей формы предположим, что сведения о входном тензоре находятся в cur_input_attrs. Пример C для обычного API:
// Set input information
rknn_input inputs[io_num.n_input];
memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
for (int i = 0; i < io_num.n_input; i++)
{
    int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] : cur_input_attrs[i].dims[2];
    int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] : cur_input_attrs[i].dims[3];
    cv::resize(imgs[i], imgs[i], cv::Size(width, height));
    inputs[i].index = i;
    inputs[i].pass_through = 0;
    inputs[i].type = RKNN_TENSOR_UINT8;
    inputs[i].fmt = RKNN_TENSOR_NHWC;
    inputs[i].buf = imgs[i].data;
    inputs[i].size = imgs[i].total() * imgs[i].channels();
}

// Convert the input data into the correct format and put it into the input buffer
ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
if (ret < 0)
{
    printf("rknn_input_set fail! ret=%d\n", ret);
    return -1;
}

// Run inference
printf("Begin perf ...\n");
double total_time = 0;
for (int i = 0; i < loop_count; ++i)
{
    int64_t start_us = getCurrentTimeUs();
    ret = rknn_run(ctx, NULL);
    int64_t elapse_us = getCurrentTimeUs() - start_us;
    if (ret < 0)
    {
        printf("rknn run error %d\n", ret);
        return -1;
    }
    total_time += elapse_us / 1000.f;
    printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f
* 1000.f / elapse_us);
}
printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);

// Get output results
rknn_output outputs[io_num.n_output];
memset(outputs, 0, io_num.n_output * sizeof(rknn_output));
for (uint32_t i = 0; i < io_num.n_output; ++i)
{
    outputs[i].want_float = 1;
    outputs[i].index = i;
    outputs[i].is_prealloc = 0;
}

ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0)
{
    printf("rknn_outputs_get fail! ret=%d\n", ret);
    return ret;
}

// Release the output buffer
ret = rknn_outputs_release(ctx, io_num.n_output, outputs);
4.1.3.4.2 API нулевого копирования
Для zero-copy после инициализации запросите формы через rknn_query() и выделите входную/выходную память через rknn_create_mem(). Передайте массив rknn_tensor_attr с формами всех входов в rknn_set_input_shapes(), затем снова запросите установленные формы через rknn_query(). Наконец задайте память через rknn_set_io_mem(). При каждой смене формы повторно задайте форму, подготовьте данные нового размера и снова вызовите rknn_set_io_mem(). Если форма не меняется, повторять rknn_set_input_shapes() не нужно. Типичная последовательность:
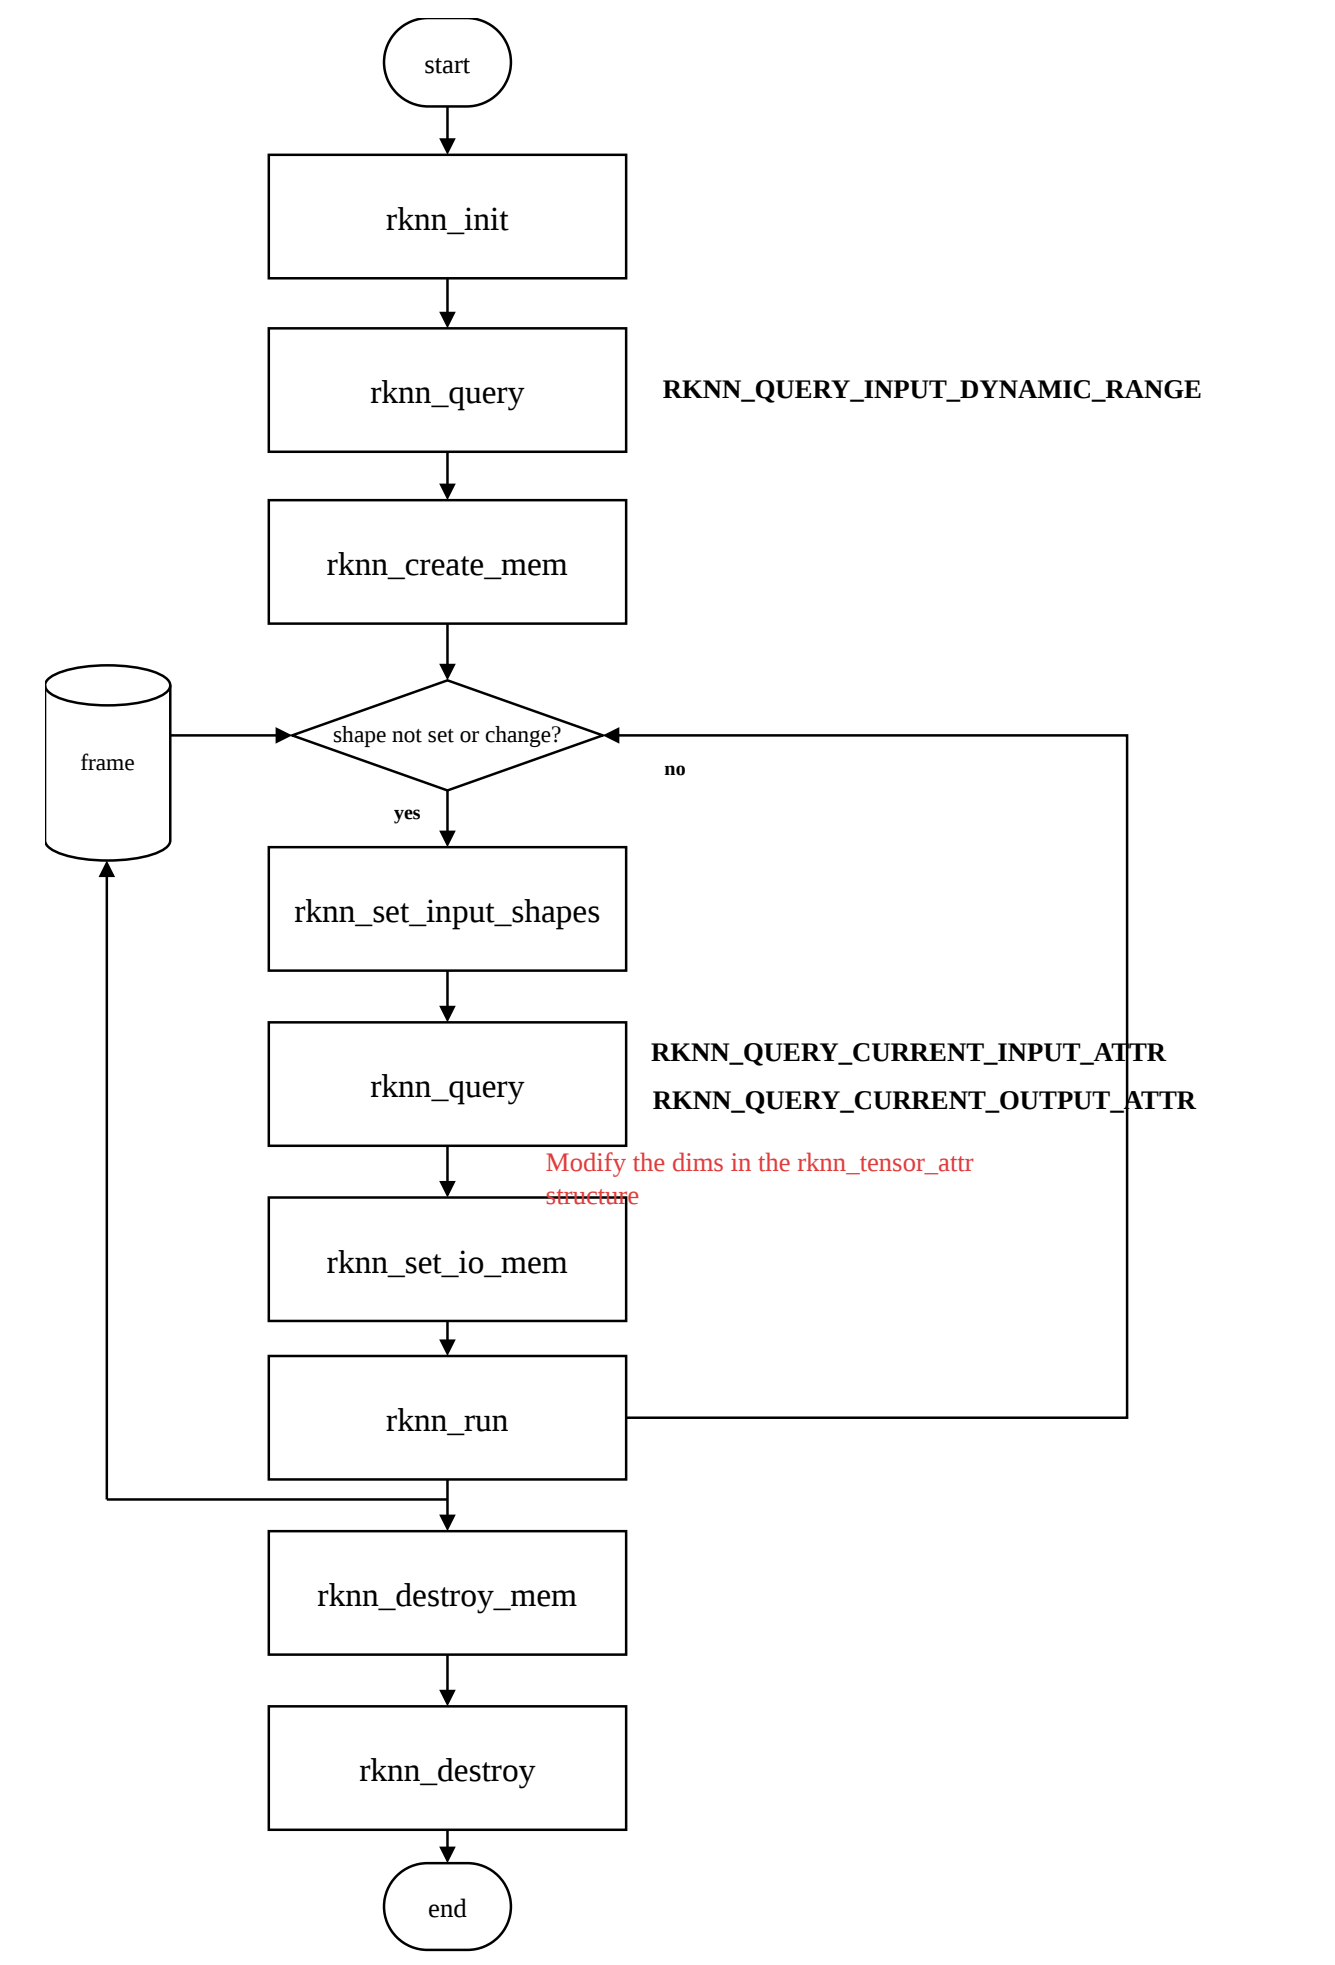
Рисунок 4-6. Zero-copy API динамической формы входа
Инициализация, запрос сочетаний входных форм и установка формы совпадают с общим API выше и повторно не описываются.
После настройки формы используются другие интерфейсы. Пример zero-copy на C:
// Create the largest input tensor memory
rknn_tensor_mem *input_mems[io_num.n_input];
for (int i = 0; i < io_num.n_input; i++) {
    // default input type is int8 (normalize and quantize need compute in outside)
    // if set uint8, will fuse normalize and quantize to npu
    input_attrs[i].type = RKNN_TENSOR_UINT8;
    // default fmt is NHWC, npu only support NHWC in zero copy mode
    input_attrs[i].fmt = RKNN_TENSOR_NHWC;
    input_mems[i] = rknn_create_mem(ctx, input_attrs[i].size_with_stride);
...
// Create the largest output tensor memory
rknn_tensor_mem *output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
    // default output type is depend on model, this require float32 to compute top5
    // allocate float32 output tensor
    int output_size = output_attrs[i].size * sizeof(float);
    output_mems[i] = rknn_create_mem(ctx, output_size);
...
// Load the input and set the model input shape, which is called once each time the input shape is switched
for (int s = 0; s < shape_num; ++s) {
    for (int i = 0; i < io_num.n_input; i++) {
        for (int j = 0; j < input_attrs[i].n_dims; ++j) {
           input_attrs[i].dims[j] = shape_range[i].dyn_range[s][j];
    .....
    ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
    if (ret < 0) {
        fprintf(stderr, "rknn_set_input_shape error! ret=%d\n", ret);
        return -1;
    ....
    // Get the input and output shapes of the current inference
    printf("current input tensors:\n");
    rknn_tensor_attr cur_input_attrs[io_num.n_input];
    memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
    for (uint32_t i = 0; i < io_num.n_input; i++) {
        cur_input_attrs[i].index = i;
        // query info
        ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));
        if (ret < 0) {
           printf("rknn_init error! ret=%d\n", ret);
           return -1;
        dump_tensor_attr(&cur_input_attrs[i]);
        ...
        printf("current output tensors:\n");
    rknn_tensor_attr cur_output_attrs[io_num.n_output];
    memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
    for (uint32_t i = 0; i < io_num.n_output; i++) {
        cur_output_attrs[i].index = i;
        // query info
        ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &
(cur_output_attrs[i]), sizeof(rknn_tensor_attr));
        if (ret != RKNN_SUCC) {
           printf("rknn_query fail! ret=%d\n", ret);
           return -1;
        ...
        dump_tensor_attr(&cur_output_attrs[i]);
    // Specify the number of NPU cores, only 3588/3576 is supported
    rknn_set_core_mask(ctx, (rknn_core_mask)core_mask);
    // Set input information
    rknn_input inputs[io_num.n_input];
    memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
    std::vector<cv::Mat> resize_imgs;
    resize_imgs.resize(io_num.n_input);
    for (int i = 0; i < io_num.n_input; i++) {
        int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] : cur_input_attrs[i].dims[2];
        int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] : cur_input_attrs[i].dims[3];
        int stride = cur_input_attrs[i].w_stride;
        cv::resize(imgs[i], resize_imgs[i], cv::Size(width, height));
        int input_size = resize_imgs[i].total() * resize_imgs[i].channels();
        // Copy external data to the zero-copy input buffer
        if (width == stride)
           memcpy(input_mems[i]->virt_addr, resize_imgs[i].data, input_size);
        else {
           int height = cur_input_attrs[i].dims[1];
           int channel = cur_input_attrs[i].dims[3];
           // copy from src to dst with stride
           uint8_t *src_ptr = resize_imgs[i].data;
           uint8_t *dst_ptr = (uint8_t *)input_mems[i]->virt_addr;
           // width-channel elements
           int src_wc_elems = width * channel;
           int dst_wc_elems = stride * channel;
           for (int b = 0; b < cur_input_attrs[i].dims[0]; b++) {
               for (int h = 0; h < height; ++h) {
                   memcpy(dst_ptr, src_ptr, src_wc_elems);
                   src_ptr += src_wc_elems;
                   dst_ptr += dst_wc_elems;
           ....
    // Update the input zero-copy buffer memory
    for (int i = 0; i < io_num.n_input; i++) {
        cur_input_attrs[i].type = RKNN_TENSOR_UINT8;
        ret = rknn_set_io_mem(ctx, input_mems[i], &cur_input_attrs[i]);
        if (ret < 0) {
           printf("rknn_set_io_mem fail! ret=%d\n", ret);
           return -1;
     ....
    // Update the output zero-copy buffer memory
    for (uint32_t i = 0; i < io_num.n_output; ++i) {
        // default output type is depend on model, this require float32 to compute top5
        cur_output_attrs[i].type = RKNN_TENSOR_FLOAT32;
        cur_output_attrs[i].fmt = RKNN_TENSOR_NCHW;
        // set output memory and attribute
        ret = rknn_set_io_mem(ctx, output_mems[i], &cur_output_attrs[i]);
        if (ret < 0) {
           printf("rknn_set_io_mem fail! ret=%d\n", ret);
           return -1;
      ....
    // Inference
    printf("Begin perf ...\n");
    double total_time = 0;
    for (int i = 0; i < loop_count; ++i) {
        int64_t start_us = getCurrentTimeUs();
        ret = rknn_run(ctx, NULL);
        int64_t elapse_us = getCurrentTimeUs() - start_us;
        if (ret < 0) {
           printf("rknn run error %d\n", ret);
           return -1;
        ...
        total_time += elapse_us / 1000.f;
        printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f * 1000.f / elapse_us);
    printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);
Примечания:
-
Форма и размер входного буфера rknn_set_io_mem() при динамической форме:
-
После инициализации, но до rknn_set_input_shapes(), RKNN_QUERY_INPUT_ATTR/RKNN_QUERY_OUTPUT_ATTR в rknn_query() обычно возвращают максимальные формы. Их размеры можно использовать для выделения памяти. Для нескольких входов некоторые формы могут не быть максимальными: найдите максимум среди поддерживаемых вариантов и выделите максимальную входную/выходную память.
-
Для нечетырёхмерного входа используйте fmt=UNDEFINED и буфер исходной формы модели, размер которого вычисляется по форме и типу.
-
Четырёхмерный вход поддерживает fmt=NHWC или NC1HWC2 с соответствующим буфером и размером. Форму и размер получите запросом соответствующих полей rknn_query.
-
RKNN_QUERY_CURRENT_INPUT_ATTR/RKNN_QUERY_CURRENT_OUTPUT_ATTR возвращают исходные формы модели в NHWC или UNDEFINED. RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR/RKNN_QUERY_CURRENT_NATIVE_OUTPUT_ATTR возвращают формы для максимально эффективного чтения NPU в NHWC или NC1HWC2.
-
При NHWC-буфере rknn_set_io_mem() поля shape и fmt структуры rknn_tensor_attr задаются по RKNN_QUERY_CURRENT_INPUT_ATTR; при NC1HWC2 — по RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR.
Полный пример динамической формы C API: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_dynamic_shape_input_demo