
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 22/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
Вопросы, обработка ошибок и справочные ресурсы
5.4 Частые вопросы и обработка ошибок
5.4.1 Проблемы окружения NPU SDK
Совместимость версий
Драйвер ядра NPU и Runtime
Рекомендуется драйвер ядра NPU 0.9.2 или новее. При проблемах сначала обновите его до последней версии.
Совместимость моделей, экспортированных RKNN-Toolkit2, с версиями Runtime приведена ниже.
Таблица 5-6. Соответствие моделей RKNN версиям Runtime
| Версия модели RKNN | Версия Runtime |
|---|---|
| 1.2.0 | >=1.2.0 и <=1.5.0 |
| 1.3.0 | >=1.3.0 и <=1.5.0 |
| 1.4.0 | >=1.4.0 и <=1.5.0 |
| 1.5.0 | 1.5.0 |
| 1.5.2 | >=1.5.2 |
| 1.6.0 | >=1.5.2 |
| 2.0.0 | >=2.0.0 |
| 2.1.0 | >=2.0.0 |
Как обновить драйвер ядра NPU
Для обновления драйвера NPU рекомендуется обновить всю прошивку; соответствующую прошивку может предоставить поставщик.
Использование NPU в Docker на плате
Для доступа приложения Docker к NPU на плате при запуске контейнера необходимо отобразить ресурсы NPU. Пример команды:
docker run -t -i --privileged -v /dev/dri/renderD129:/dev/dri/renderD129 -v /proc/device-
tree/compatible:/proc/device-tree/compatible -v /usr/lib/librknnrt.so:/usr/lib/librknnrt.so ai_application:v1.0.0
/bin/bash
Учитывайте параметры: - /dev/dri/renderD129: узел NPU RK3588, необходимый Runtime для включения NPU. - /proc/device-tree/compatible: файл с моделью SoC; RKNN-Toolkit Lite2 и другие компоненты определяют SoC по нему. - /usr/lib/librknnrt.so: библиотека Runtime, через которую RKNN-Toolkit Lite2 и RKNPU2 C API используют NPU. - ai_application:v1.0.0: имя и версия образа запускаемого контейнера.
5.4.2 Проблемы установки RKNN-Toolkit2
Слишком строгие зависимости RKNN-Toolkit2 препятствуют установке
Если библиотеки зависимостей установлены, но некоторые версии не соответствуют требованиям, можно добавить “no-deps” к команде установки Python-библиотеки, чтобы пропустить проверку среды. Например:
pip install rknn-toolkit2*.whl --no-deps
Примечания о зависимости PyTorch
Загрузка моделей PyTorch в RKNN-Toolkit2 зависит от PyTorch. Есть модели с плавающей точкой и квантованные модели, включая QAT и PTQ.
Для моделей, экспортированных PyTorch 1.6.0, рекомендуется понизить используемую RKNN-Toolkit2 версию PyTorch до 1.6.0, чтобы избежать ошибок загрузки.
Для QAT/PTQ-моделей рекомендуется экспорт через PyTorch 1.10~1.13.1 и обновление зависимости RKNN-Toolkit2 до PyTorch 1.10~1.13.1.
Версия PyTorch при экспорте исходной модели должна по возможности совпадать с версией зависимости RKNN-Toolkit2.
Рекомендуемые версии PyTorch: 1.6.0, 1.9.0, 1.10 и 1.13.1.
Примечания о зависимости TensorFlow
Загрузка моделей TensorFlow зависит от TensorFlow. Совместимость версий обычно низкая, и другие версии могут вызывать ошибки загрузки RKNN-Toolkit2. Рекомендуется, чтобы версия экспорта модели совпадала с версией TensorFlow, от которой зависит RKNN-Toolkit2.
Проблемы версии TensorFlow обычно проявляются на этапе “rknn.load_tensorflow()”; сообщение указывает путь к зависимости TensorFlow.
Рекомендуются TensorFlow 2.6.2 или 2.8.0.
Правила именования установочных пакетов RKNN-Toolkit2. На примере версии
1.5.2 правила именования wheel-пакета RKNN-Toolkit2 следующие:
rknn_toolkit2-1.5.2+b642f30c-cp38-cp38-linux_x86_64.whl
rknn_toolkit2: имя инструмента.
1.5.2: номер версии.
b642f30c: идентификатор commit.
cp<xx>-cp<xx>: версия Python; например, cp38-cp38 означает Python 3.8.
linux_x86_64: тип системы и архитектура CPU.
Выбирайте пакет под операционную систему, архитектуру CPU и версию Python; иначе установка завершится ошибкой.
Есть ли версия RKNN-Toolkit2 для ARM Linux
Версии RKNN-Toolkit2 для ARM Linux нет. Для Python-вывода на ARM Linux можно установить RKNN-Toolkit-lite2.
Не устанавливается зависимость bfloat16
При установке библиотеки bfloat16 возникает следующая ошибка:
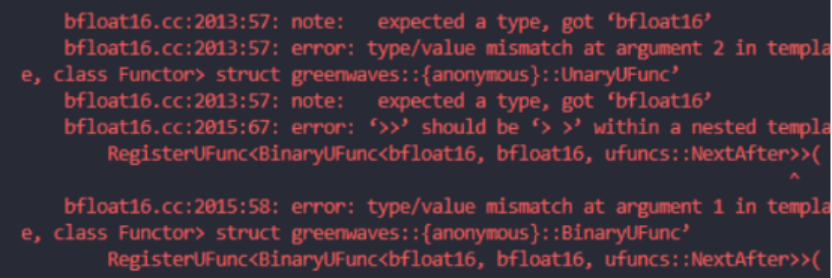
Рисунок 5-19. Журнал ошибки установки bfloat16
Измените источник pip на зеркало Alibaba либо обновите RKNN-Toolkit2 до 1.5.0 или новее: в этих версиях зависимость от bfloat16 удалена.
5.4.3 Описание параметров преобразования модели
Раздел описывает часто используемые параметры преобразования модели.
Параметры, определяемые моделью
Интерфейсы rknn.config() и rknn.build() влияют на результат преобразования модели.
Входные и выходные узлы, заданные в rknn.load_onnx() и rknn.load_tensorflow(), влияют на преобразование.
Входные размеры, заданные в rknn.load_pytorch() и rknn.load_tensorflow(), влияют на преобразование.
Базовый порядок преобразования модели:
-
Подготовьте калибровочные данные и файл dataset.txt.
-
Определите платформу NPU, например RK3566 или RV1106, и задайте target_platform в rknn.config().
-
Для трёхканального изображения на входе и калибровочных изображений jpg/png уточните RGB или BGR, чтобы определить значение quant_img_RGB2BGR в rknn.config().
-
Уточните параметры нормализации обучения и задайте mean_values и std_values в rknn.config.
-
Уточните входной размер модели и задайте соответствующий параметр load, например input_size_list в rknn.load_pytorch().
-
Определите разрядность квантования для quantized_dtype в rknn.config(). Шаг можно пропустить для неквантованной или уже квантованной загружаемой модели.
-
Выберите алгоритм квантования для quantized_algorithm в rknn.config(). Шаг можно пропустить для неквантованной или уже квантованной загружаемой модели.
-
Решите, нужно ли квантование, и задайте do_quantization в rknn.build(). При квантовании обязательно задайте dataset с калибровочными данными.
9. Совместимость моделей RKNN между платформами
Для target_platform в rknn.config() действуют следующие отношения совместимости:
Модели RK3566 и RK3568 взаимно совместимы.
Модели RK3588 и RK3588S взаимно совместимы.
Модели RV1103 и RV1106 взаимно совместимы.
10. Формат и требования калибровочных данных квантования
Доступны два формата: изображения jpg/png, читаемые RKNN-Toolkit2 через OpenCV, и npy, читаемый через numpy.
Для входа, отличного от RGB/BGR-изображения, рекомендуется numpy npy.
11. Заполнение dataset.txt для моделей с несколькими входами
dataset.txt задаёт пути к данным квантования. Одна строка соответствует одному набору входов; несколько входов модели записывают в одну строку через пробелы.
Пример двух наборов для модели с одним входом:
sampleA.npy
sampleB.npy
Для модели с тремя входами два набора записываются так:
sampleA_in0.npy sampleA_in1.npy sampleA_in2.npy
sampleB_in0.npy sampleB_in1.npy sampleB_in2.npy
12 Проверка quant_img_RGB2BGR в rknn.config()
При калибровке изображениями jpg/png необходимо учитывать quant_img_RGB2BGR.
Если обучение использовало RGB, задайте quant_img_RGB2BGR=False либо не задавайте его. При выводе через Python или RKNPU2 C API также подавайте RGB.
Если обучение использовало BGR, задайте quant_img_RGB2BGR=True. При выводе через Python или RKNPU2 C API тоже подавайте BGR: параметр влияет только на чтение калибровочных изображений.
При калибровке в numpy npy рекомендуется не использовать quant_img_RGB2BGR, чтобы избежать путаницы.
13 Порядок применения mean, std и quant_img_RGB2BGR в rknn.config()
quant_img_RGB2BGR управляет только преобразованием каналов при чтении калибровочных изображений и не влияет на другие этапы. Поэтому Python-интерфейс RKNN-Toolkit2 и RKNPU2 C API лишь вычитают mean, затем делят на std; перестановки каналов не выполняется.
14. Настройка mean_values и std_values в rknn.config() для входа не с тремя каналами или нескольких входов
Формат mean_values и std_values одинаков. Рассмотрим mean_values.
Для N входных каналов mean_values равен [[channel_1, channel_2, channel_3, channel_4, …, channel_n]].
При нескольких входах значение mean_values равно [[channel_1, channel_2, channel_3, channel_4, …, channel_n], [channel_1, channel_2, channel_3, channel_4, …, channel_n]].
15. Выбор алгоритма коррекции параметров квантования и количества калибровочных изображений
quantized_algorithm в rknn.config() предоставляет normal, mmse и kl_divergence; по умолчанию normal. normal — обычная коррекция параметров; mmse многократно вычисляет промежуточные слои и обрезает веса в определённом диапазоне для повышения точности. mmse не гарантирует улучшения, но использует больше памяти и дольше преобразует модель, чем normal. kl_divergence немного медленнее normal, но намного быстрее mmse и может помочь при неравномерном распределении признаков.
Начните с normal; при плохом результате попробуйте mmse или kl_divergence.
Для normal или kl_divergence рекомендуются 20–200 наборов данных, для mmse — 20–50.
16. Различия ввода и вывода квантованных и неквантованных моделей
При обычном RKNPU2 C API, без pass_through и zero_copy, тип входных данных, например uint8 или float, не зависит от квантования модели. Выход можно автоматически преобразовать в float32 либо получить напрямую в типе выходного узла. Python-интерфейс немного отличается. Соотношения следующие:
Таблица 5-7. Различия Python-интерфейса и обычного C API
| После квантования модели | Python-вывод (rknn.inference()) | C API-вывод (rknn.run()), без pass_through и zero_copy |
|---|---|---|
| Ограничен ли тип входа | Ограничений нет. rknn.inference() принимает numpy-массив с собственным атрибутом типа данных; вход автоматически преобразуется в формат, требуемый моделью RKNN. | Ограничений нет. rknn_tensor_type в rknn_inputs можно задать как RKNN_TENSOR_FLOAT32, RKNN_TENSOR_FLOAT16, RKNN_TENSOR_INT8, RKNN_TENSOR_UIN8, RKNN_TENSOR_INT16 согласно фактическому входу. Затем данные автоматически преобразуются в формат модели RKNN. |
| Меняется ли тип выхода | Нет. Независимо от квантования Python-интерфейс rknn.inference() всегда возвращает float; другой тип выбрать нельзя. | Да. Через rknn outputs attr в RKNPU2 C API можно задать want_float=1 для float. После квантования можно выбрать want_float=0 и получить исходные данные последнего узла, например int8 при квантовании i8. |
| Меняется ли формат входа (NCHW, NHWC) | Нет. Независимо от квантования data_format в rknn.inference() можно задать как nchw или nhwc. | Нет. Независимо от квантования rknn_tensor_format структуры rknn inputs можно задать как NCHW или NHWC. |
Есть ли режим онлайн-предкомпиляции
RKNN-Toolkit2 экспортирует только офлайн-предкомпилированные модели, а онлайн-предкомпиляция, доступная в RKNN-Toolkit1, не поддерживается. Поэтому выбора между режимами нет.
Можно ли использовать модель RKNN-Toolkit на RK3566
Нет.
Модели RKNN-Toolkit предназначены для RK1806 / RK1808 / RK3399Pro / RV1109 / RV1126. RK3566 требует RKNN-Toolkit2, модели которого применимы к RK3566 / RK3568 / RK3588 / RK3588S / RV1103 / RV1106 / RK3562 / RK3576 / RV1126B.
Инструкции по RKNN-Toolkit доступны в проекте:
https://github.com/airockchip/rknn-toolkit
Инструкции по RKNN-Toolkit2 доступны в проекте:
https://github.com/airockchip/rknn-toolkit2
5.4.4 Вопросы о фреймворках глубокого обучения
5.4.4.1 ФРЕЙМВОРКИ ГЛУБОКОГО ОБУЧЕНИЯ И ИХ ВЕРСИИ, ПОДДЕРЖИВАЕМЫЕ RKNN-TOOLKIT2
См. главу 2.1.
5.4.4.2 Список поддерживаемых операторов каждого фреймворка
Уровень поддержки разных фреймворков в RKNN-Toolkit2 различается. Подробности приведены в документе RKNNToolkit2_OP_Support по ссылке:
https://github.com/airockchip/rknn-toolkit2/blob/master/doc/
5.4.4.3 Вопросы о преобразовании моделей ONNX
Ошибка «Error parsing message» при загрузке модели
Например, преобразование модели examples/onnx/resnet50v2 завершается с сообщением:
E load_onnx: Catch exception when loading onnx model: /rknn_resnet_demo/resnet50v2.onnx!

E lod_onnx: Traceback (most recent call last):

E load_onnx: File "rknn/api/rknn_base.py", line 1094, in rknn.api.rknn_base.RKNNBase.load_onnx

E load_onnx: File "/usr/local/lib/python3.6/dist-packages/onnx/__init__.py", line 115, in load_model

……

E load_onnx: google.protobuf.message.DecoderError: Error parsing message
Возможно, resnet50v2.onnx повреждён или загружен не полностью. Скачайте модель заново и проверьте MD5, например:
22ed6e6a8fb9192f0980acca0c941414 resnet50v2.onnx
Поддерживается ли динамическая форма входа?
Например, вход ONNX [-1, 3, -1, -1] означает, что batch, height и width не фиксированы. RKNN-Toolkit2 до версии 1.5.2 не поддерживает динамическую форму входа.
Начиная с 1.5.2 динамические входные формы поддерживаются параметром dynamic_input в rknn.config(); подробнее см. 4.1.3.
Ошибка при задании собственного выходного узла
Например, вызов rknn.load_onnx() с параметром outputs приводит к следующей ошибке:
E load_onnx: the '378' in outputs=['378', '439', '500'] is invalied!
Журнал сообщает, что выходной узел 378 недействителен. Параметр outputs должен содержать правильное имя выходного узла.
5.4.4.4 Вопросы о преобразовании моделей Pytorch
Ошибка загрузки модели Pytorch: у torch._C нет атрибута _jit_pass_inline
Журнал ошибки:
'torch._C' has no attribute '_jit_pass_inline'
Обновите PyTorch до 1.6.0 или новее.
Формат сохранения моделей Pytorch
Сейчас поддерживаются только модели, экспортированные через torch.jit.trace(). torch.save() сохраняет лишь словарь весов без структуры сети; такой файл нельзя корректно импортировать и преобразовать в RKNN.
Сбой PytorchStreamReader при преобразовании
Журнал ошибки:
E Catch exception when loading pytorch model: ./mobilenet0.25_Final.pth!

E Traceback (most recent call last):

……

E cpp_module = torch._C.import_ir_module(cu, f, map_location, extra_files)

E RuntimeError: [enforce fail at inline container.cc:137]. PytorchStreamReader failed reading zip archive: faild
finding central directory frame #0 ……
Причина — отсутствие сведений о структуре сети в модели PyTorch.
Обычно .pth содержит только веса, без структуры сети. Для экспорта полной модели сначала инициализируйте структуру, затем загрузите веса .pth через net.load_state_dict(). Закрепите структуру и веса через torch.jit.trace(), затем сохраните с помощью torch.jit.save() трассированную модель в .pt, пригодный для преобразования в RKNN через rknn.load_pytorch().
KeyError при преобразовании
Журнал ошибки:
E Traceback (most recent call last):

……

E KeyError: 'aten::softmax'
Сообщение вида KeyError: ‘aten::xxx’ означает, что текущая версия не поддерживает этот оператор. При обновлениях RKNN-Toolkit2 такие ошибки исправляются; используйте последнюю версию.
Ошибка «Syntax error in input! LexToken(xxx)» при преобразовании
Журнал ошибки:
WARNING: Token 'COMMENT' defined, but not used

WARNING: There is 1 unused token

!!!!! Illegal character '"'

Syntax error in input! LexToken(NAMED_IDENTIFIER, 'fc', 1, 27)

!!!!! Illegal character '"'
Причин может быть несколько. Проверяйте в следующем порядке:
) Сеть создана без наследования torch.nn.module. Создайте её на основе класса torch.nn.module и затем сформируйте pt-файл через torch.jit.trace().
) Обновите RKNN-Toolkit2 до 1.4.0 или новее. Для torch рекомендуются 1.6.0, 1.9.0, 1.10.0 или 1.13.1.
5.4.4.5 Вопросы о преобразовании моделей Tensorflow
Ошибка модели Tensorflow1.x
При загрузке модели tensorflow1.x через rknn.load_tensorflow() появляется сообщение:
E load_tensorflow: Catch exception when loading tensorflow model: ./yolov3_mobilenetv2.pb!

E load_tensorflow: Traceback (most recent call last):

……

E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects to be colocated with unknown node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'

E load_tensorflow: During handling of the above exception, another exception occurred:

E load_tensorflow: Traceback (most recent call last):

E load_tensorflow: File "rknn/api/rknn_base.py", line 990, in rknn.api.rknn_base.RKNNBase.load_tensorflow

……

E load_tensorflow: return func(*args, **kwargs)

E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
431, in import_graph_def

E load_tensorflow: raise ValueError(str(e))

E load_tensorflow: ValueError: Node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects
to be colocated with unknown node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'
Рекомендация:
Если установлен TensorFlow 1.x, обновите его до TensorFlow 2.x.
Обновите RKNN-Toolkit2/RKNPU2 до последней версии.
Ошибка TransformGraph
Журнал ошибки:
Traceback (most recent call last):

File "test.py", line 80, in <module>

input_size_list=[[1, 368, 368, 3]])

File "/usr/local/lib/python3.6/site-packages/rknn/api/rknn.py", line 68, in
load_tensorflow

input_size_list=input_size_list, outputs=outputs)

File "rknn/api/rknn_base.py", line 940, in
rknn.api.rknn_base.RKNNBase.load_tensorflow

File "/usr/local/lib/python3.6/dist-
packages/tensorflow/tools/graph_transforms/__init__", line 51, in
TransformGraph.transforms_string, status)

File "/usr/local/lib/python3.6/dist-
packages/tensorflow/python/framework/errors_impl.py". ;ome 548, in __exit__

C_api.TF_GetCode(self.status.status)

Tensorflow.python.framework.error_impl.InvalidArgumentError: Beta input to batch
norm has bad shape: [24]
Причины:
) RKNN-Toolkit2 вызывает собственную функцию TensorFlow TransformGraph для оптимизации модели, но вызов завершается ошибкой.
) Возможно, версия TensorFlow, использованная при экспорте, несовместима с установленной версией.
Рекомендация:
Экспортируйте модель через TensorFlow 1.14.0 либо найдите аналогичную модель в другом фреймворке глубокого обучения.
Ошибка “Shape must be rank 4 but is rank 0”
При загрузке модели pb следующей командой:
  rknn.load_tensorflow(tf_pb='./model.pb',

  inputs=["X","Y"],

  outputs=['generator/xs'],

  input_size_list=1, INPUT_SIZE, INPUT_SIZE, 3)
Возникает ошибка:
  E load_tensorflow: Catch exception when loading tensorflow model: ./model.pb!

  E load_tensorflow: Traceback (most recent call last):

  E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
427, in import_graph_def

  E load_tensorflow: graph._c_graph, serialized, options) # pylint: disable=protected-access

  E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Shape must be rank 4 but is
rank 0 for 'generator/conv2d_3/Conv2D' (op: 'Conv2D') with input shapes: [], [7,7,3,32].
Возможно, модель имеет несколько входов, а input_size_list в rknn.load_tensorflow() заполнен не по спецификации. См. следующий пример в examples/functions/multi_input_test:
  rknn.load_tensorflow(tf_pb='./conv_128.pb',

  inputs=['input1', 'input2', 'input3', 'input4'],

  outputs=['output'],

  input_size_list=[[1, 128, 128, 3], [1, 128, 128, 3],

  [1, 128, 128, 3], [1, 128, 128, 1]])
Диагностика ошибок загрузки модели
Сначала убедитесь, что исходный фреймворк корректно загружает и вызывает модель.
Затем обновите RKNN-Toolkit2 до последней версии. Неподдерживаемые слои или операторы должны быть указаны в отладочном журнале. При необходимости вызовите RKNN(verbose=True), чтобы получить более подробные журналы преобразования.
Если проблема остаётся, передайте версию RKNN-Toolkit2 и подробный журнал ошибок команде разработки Rockchip NPU.
5.4.5 Проблемы квантования модели
Влияние квантования на размер модели
Возможны два случая. Если импортируется квантованная модель, do_quantization=False в rknn.build() использует её параметры квантования. Если импортируется модель с плавающей точкой, квантование не выполняется, но веса преобразуются из float32 в float16 почти без потери точности. В обоих случаях размер модели и занимаемое ею пространство уменьшаются.
Должны ли изображения для квантования иметь тот же размер, что и вход модели?
Не нужно.
RKNN-Toolkit2 автоматически изменяет размеры изображений. Однако это может изменить информацию изображения и повлиять на точность квантования, поэтому лучше использовать изображения требуемого входного размера.
Если калибровочные данные — не изображения, например npy, их форма должна совпадать с входом модели.
Нужно ли менять калибровочные данные согласно rknn_batch_size?
Не нужно.
Параметр rknn_batch_size в rknn.build() меняет только размерность batch экспортируемой модели RKNN — с 1 на rknn_batch_size — и не влияет на квантование. Поэтому данные калибровки готовят как для модели без пакетной обработки.
При квантовании программа преобразования зависает или принудительно завершается
В ходе квантования RKNN-Toolkit2 выделяет участки системной памяти, из-за чего программа может зависнуть или быть завершена системой.
Решение: увеличьте оперативную память компьютера или виртуальную память (раздел swap).
5.4.6 Проблемы преобразования модели
Типичные ошибки преобразования из-за программных дефектов
Ошибка, подобная следующей, вероятно связана с дефектом текущей версии. Попробуйте последнюю версию RKNN-Toolkit2.
Ошибка вида infer_shapes
  (op_type:Mul, name:Where_2466_mul): Inferred elem type differs from existing elem type: (FLOAT) vs
(INT64)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1555, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 5409, in rknn.api.graph_optimizer.GraphOptimizer.run

  E build: File "rknn/api/graph_optimizer.py", line 5123, in
rknn.api.graph_optimizer.GraphOptimizer._fuse_ops

  E build: File "rknn/api/ir_graph.py", line 180, in rknn.api.ir_graph.IRGraph.rebuild

  E build: File "rknn/api/ir_graph.py", line 140, in rknn.api.ir_graph.IRGraph._clean_model

  E build: File "rknn/api/ir_graph.py", line 56, in rknn.api.ir_graph.IRGraph.infer_shapes

  E build: File "/home/anaconda3/envs/rk2/lib/python3.6/site-packages/onnx/shape_inference.py", line 35, in
infer_shapes

  E build: inferred_model_str = C.infer_shapes(model_str, check_type)

  E build: RuntimeError: Inferred elem type differs from existing elem type: (FLOAT) vs (INT64)
или:
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1643, in
rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 6256, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops
E build: File "rknn/api/ir_graph.py", line 285, in
rknn.api.ir_graph.IRGraph.rebuild
E build: File "rknn/api/ir_graph.py", line 149, in
rknn.api.ir_graph.IRGraph._clean_model
E build: File "rknn/api/ir_graph.py", line 62, in
rknn.api.ir_graph.IRGraph.infer_shapes
E build: File "/usr/local/lib/python3.6/dist-packages/onnx/shape_inference.py",
line 35, in infer_shapes
E build: inferred_model_str = C.infer_shapes(model_str, check_type)
E build: RuntimeError: Inferred shape and existing shape differ in rank: (0) vs
(3)
или:
  (op_type:ReduceMax, name:ReduceMax_18): Interred shape and existing shape differ in rank: (3) vs (0)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  ……

  E build: RuntimeError: Interred shape and existing shape differ in rank: (3) vs (0)
Ошибка вида _p_fuse_two_mul
  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 6197, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops

  E build: File "rknn/api/graph_optimizer.py", line 204, in rknn.api.graph_optimizer._p_fuse_two_mul

  E build: ValueError: non-broadcastable output operand with shape () doesn't match the broadcast shape
(3,2)
Ошибка вида «Segmentation fault»
Например, ошибка при преобразовании picodet:
I _fold_constant remove nodes = ['Shape_0', 'Gather_4', 'Shape_1', 'Gather_6',
'Unsqueeze_0', 'Concat_8', 'Cast_3']
**Segmentation fault (Core dumped)**
Ошибка вида _p_fuse_mul_into_conv
E build: Catch exception when building RKNN model:

……
E build: ValueError: non broadcastable output operand whith shape (1,258,1,256) doesn`t match the
broadcast shape (80256,258,1,256)
Как определить поддержку оператора в RKNN
Попробуйте преобразовать модель: при отсутствии поддержки появится соответствующее сообщение.
Также см. «06_RKNN2_Supported_Operators_and_Constraints_Reference_V2.5.0» со списками поддержки операторов фреймворков и подробными ограничениями операторов RKNN.
Сообщение об отсутствии поддержки Expand при преобразовании
Рекомендации:
1) Новые версии поддерживают Expand на CPU. Попробуйте обновить RKNN-Toolkit2 / RKNPU2 до последней версии.
2) Измените модель: используйте repeat вместо expand.
Сообщение “Meet unsupported dims in reducesum” при преобразовании
При преобразовании появляется Meet unsupported dims in reducesum, dims: 6, например:
D RKNN: [14:54:19.434] >>>>>> start: N4rknn17RKNNInitCastConstE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn17RKNNInitCastConstE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn20RKNNMultiSurfacePassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn20RKNNMultiSurfacePassE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn14RKNNTilingPassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn14RKNNTilingPassE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn23RKNNProfileAnalysisPassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn23RKNNProfileAnalysisPassE
D RKNN: [14:54:19.434] >>>>>> start: OpEmit
E RKNN: [14:54:19.438] Meet unsupported dims in reducesum, dims: 6
Aborted (core dumped)
RKNN пока не поддерживает шестимерные OP. В большинстве случаев доступны только четыре измерения.
Ошибка преобразования из-за операторов постобработки, например NonMaxSuppression
Операторы постобработки, такие как NonMaxSuppression, пока не поддерживаются RKNN.
Подграф постобработки можно удалить, например:
rknn.load_onnx(model='picodet_xxx.onnx', outputs=['concat_4.tmp_0', 'tmp_16'])
Удалённый подграф выполняется отдельно на CPU.
Ошибка вида «invalid expand shape»
Например, при преобразовании rvm_mobilenetv3_fp32.onnx возникает ошибка:
[E:onnxruntime:, sequential_executor.cc:333 Execute] Non-zero status code
returned while running Expand node. Name:'Expand_294' Status Message: invalid
expand shape

E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1638, in
rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 5529, in
rknn.api.graph_optimizer.GraphOptimizer.fold_constant
E build: File "rknn/api/session.py", line 69, in rknn.api.session.Session.run
E build: File "/home/cx/work/tools/Anaconda3/envs/rknn/lib/python3.8/site-
packages/onnxruntime/capi/onnxruntime_inference_collection.py", line 124, in
run
E build: return self._sess.run(output_names, input_feed, run_options)
E build: onnxruntime.capi.onnxruntime_pybind11_state.InvalidArgument:
[ONNXRuntimeError] : 2 : INVALID_ARGUMENT : Non-zero status code returned while
running Expand node. Name:'Expand_294' Status Message: invalid expand shape
Входное значение downsample_ratio меняет размер промежуточных признаков, поэтому граф фактически динамический. Рекомендуется изменить логику downsample_ratio и не управлять формой промежуточных признаков значением входа. После обновления RKNN-Toolkit2 до 1.5.2 динамические формы можно использовать для имитации динамического графа. При этом также нужно изменить downsample_ratio: значения входа не должны менять промежуточные формы; сейчас поддерживается лишь изменение формы самого входа.
Ошибка mean_values в rknn.config()
Параметры mean/std заданы так:
rknn.config(mean_values=[128, 128, 128], std_values=[128, 128, 128])
Затем возникает ошибка преобразования:
--> Loading model

transpose_input for input_1: shape must be rank 4, ignored

E load_tflite: The len of mean_values ([128, 128, 128]) for input 0 is wrong, expect 32!
Возможно, вход модели не является трёхканальным изображением, например форма 1x32 с нерастровыми данными. В таком случае:
Задавайте mean_values / std_values по количеству входных каналов.
Если mean/std не нужны, mean_values / std_values можно не указывать в rknn.config(); обычно mean/std применяются только к изображениям.
Ошибка для OP размерности больше 4, например 5 или 6
Для моделей с OP размерности больше 4, например 5 или 6, возникает ошибка:
E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1580, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/rknn_base.py", line 341, in rknn.api.rknn_base.RKNNBase._generate_rknn

E build: File "rknn/api/rknn_base.py", line 307, in rknn.api.rknn_base.RKNNBase._biild_rknn

E build: IndexError: vector::_M_range_check: __n (which is 4) >= this->size() (which is 4)
RKNN пока не поддерживает OP более чем с 4 измерениями. Такие узлы можно удалить вручную.
Поддерживает ли RKNN динамическую свёртку
RK3588/RK3576/RV1126B поддерживают динамическую свёртку с group=1. Другие платформы пока не поддерживаются.
Ошибка «Not support input data type ‘float16’»
При преобразовании PyTorch-модели с весами float16 в RKNN возникает ошибка:
--> Building model

E build: Not support input data type 'float16'

W build: ==================== WARN(3) =================

E rknn-toolkit2 version: 1.3.0-11912b58

E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/graph_optimizer.py", line 5524, in rknn.api.graph_optimizer.GraphOptimzer.fold_constant

E build: File "rknn/api/load_checker.py", line 63, in rknn.api.load_checker.create_random_data

E build: File "rknn/api/rknn_log.py", line 113, in rknn.api.rknn_log.RKNNLog.e

E build: ValueError: Not support input data type 'float16'!
RKNN-Toolkit2 пока не поддерживает PyTorch-модели с весами float16; замените тип на float32.
Ошибки динамического графа
Если при преобразовании модели возникает ошибка следующего вида:
E build: ValueError: The Op of 'NonZero' is not support! it will cause the graph to be a dynamic graph!
Этот OP указывает на динамический граф. Измените модель вручную: замените OP другим или удалите его.
Размер модели RKNN
Преобразованная RKNN-модель может быть больше исходной, причём размер иногда зависит от входной формы. Это нормально: кроме весов и графа RKNN содержит множество настроек регистров NPU. Разложение OP и другие операции повышения эффективности также увеличивают модель.
5.4.7 Инференс в симуляторе или на устройстве
Терминология
Инференс в симуляторе: RKNN-Toolkit2 предоставляет на Linux x86_64 симулятор для выполнения моделей без отладочной платы. Его результаты могут отличаться от результатов платы; предпочтительнее инференс через подключённую плату или непосредственно на ней.
Инференс через подключённую плату: плата подключена к PC, а модель запускается и результаты получаются через Python API RKNN-Toolkit2.
Инференс на плате: результаты получают через C API RKNPU2.
Результаты симулятора отличаются от результатов подключённой платы
Это может означать, что результаты на плате неверны.
Из-за различий аппаратуры и драйверов полное совпадение результатов симулятора и платы не гарантируется. Однако слишком большая разница, вероятно, вызвана ошибкой драйвера платы. Сообщите о ней команде RK NPU для анализа и отладки.
Как работает инференс через подключённую плату
RKNN-Toolkit2 связывается с rknn_server на плате. Модель и входные данные передаются с PC на плату, где RKNPU2 C API выполняет инференс. Затем результат отправляется обратно на PC.
Различия результатов инференса через подключённую плату и непосредственно на плате
Инференс через подключённую плату основан на RKNPU2 C API, поэтому теоретически результаты должны совпадать. При большой разнице проверьте предобработку, тип данных и расположение данных (NCHW, NHWC).
Очень небольшие различия нормальны: они могут возникать из-за разных библиотек чтения изображений, преобразования типов и т. п.
Инференс непосредственно на плате быстрее, чем через подключённую плату
Инференс через подключённую плату включает дополнительные копирование и передачу данных, поэтому уступает прямому запуску RKNPU2 C API на плате. Реальную производительность NPU следует оценивать по инференсу через RKNPU2 C API непосредственно на плате.
Получение более подробного журнала
При инференсе через подключённую плату инициализация и запуск модели выполняются главным образом на плате, где создаётся и основная часть журнала.
Для подробной отладочной информации войдите в ОС платы через последовательный порт. Выполните две следующие команды настройки переменных окружения для журналирования. Не закрывайте окно последовательного порта и запустите инференс через подключённую плату: сообщения об ошибках платы появятся в этом окне.
export RKNN_LOG_LEVEL=5

restart_rknn.sh
Расположение данных для пакетного инференса
Расположение входных данных rknn.inference можно задать как NCHW или NHWC через 1data_format=’NCHW’ либо data_format=’NHWC’. По умолчанию используется NHWC.
В rknn-toolkit2 модели ONNX с 4D-входами при преобразовании обычно используют NCHW. Однако при инференсе RKNN по умолчанию используется NHWC, и инструментарий внутри преобразует NCHW в NHWC. Если явно задать data_format=’NCHW’, это преобразование пропускается и вход используется как есть в NCHW. Примеры см. в обсуждении GitHub: https://github.com/airockchip/rknn-toolkit2/issues/220.
5.4.8 Типичные проблемы оценки модели
Точность квантованной модели ниже ожидаемой
См. главу 5.1 этого документа.
Квантованные модели каких фреймворков поддерживаются
RKNN-Toolkit2 начиная с 1.4 поддерживает квантованные модели TensorFlow, TensorFlow Lite и PyTorch.
Не удаётся подключиться к устройству при отладке с платой
При анализе точности с платой через rknn.accuracy_analysis() возникает ошибка:
  E accuracy_analysis: Connect to Device Failure (-1)

  E accuracy_analysis: Catch exception when init runtime!

  E accuracy_analysis: Traceback (most recent call last):

  E accuracy_analysis: File "rknn/api/rknn_base.py", line 2001, in rknn.api.rknn_base.RKNNBase.init_runtime

  E accuracy_analysis: File "rknn/api/rknn_runtime.py", line 194, in
rknn.api.rknn_runtime.RKNNRuntime.__init__

  E accuracy_analysis: File "rknn/api/rknn_platform.py", line 331, in rknn.api.rknn_platform.start_ntp_or_adb
Либо при выводе через rknn.inference возникает ошибка:
I target set by user is: rk3568
I Starting ntp or adb, target is RK3568
I Device [0c6a9900ef4871e1] not found in ntb device list.
I Start adb...
I Connect to Device success!
I NPUTransfer: Starting NPU Transfer Client, Transfer version 2.1.0
(b5861e7@2020-11-23T11:50:36)
D NPUTransfer: Transfer spec = local:transfer_proxy
D NPUTransfer: ERROR: socket read fd = 3, n = -1: Connection reset by peer
D NPUTransfer: Transfer client closed fd = 3

E RKNNAPI: rknn_init, server connect fail! ret = -9(ERROR_PIPE)!
E init_runtime: Catch exception when init_runtime!
E init_runtime: Traceback (most recent call last):
E init_runtime: File "rknn/api/rknn_base.py", line 2001, in
rknn.api.rknn_base.RKNNBase.init_runtime
E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in
rknn.api.rknn_runtime.RKNNRuntime.build_graph
E init_runtime: Exception: RKNN init failed. error code:
RKNN_ERR_DEVICE_UNAVAILABLE
Возможно, RKNN Server не запущен на плате. Запустите его согласно 1.2.2.
При отладке с платой rknn_init возвращает -6 или ошибку model invalid
Сообщение об ошибке:
E RKNNAPI: rknn_init, msg_load_ack fail, ack = 1(ACK_FAIL), expect 0(ACK_SUCC)!

D NPUTransfer: Transfer client closed, fd = 4

E init_runtime: Catch exception when init runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 2011, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_MODEL_INVALID
Эта ошибка обычно возникает в следующих случаях:
Версии RKNN-Toolkit2 и драйверов при генерации модели должны соответствовать друг другу. Рекомендуется обновить RKNN-Toolkit2 / RKNPU2 и прошивку платы до последних версий.
Неверный target_platform: если он не задан в rknn.config(), модель работает только на RK3566/RK3568. Для других платформ, например RK3588/RK3588S/RV1103/RV1106/RK3562, задайте соответствующее значение при вызове rknn.config().
В Docker причиной может быть незавершённый процесс npu_transfer_proxy на хосте, нарушающий обмен. Выйдите из контейнера, завершите этот процесс на хосте и снова запустите скрипт вывода в контейнере.
Возможна проблема самой модели. Подключитесь к плате по последовательному порту, задайте RKNN_LOG_LEVEL=5 и выполните restart_rknn.sh. Повторите запуск, сохраните подробные журналы и передайте их команде Rockchip NPU.
При отладке с платой rknn_init() возвращает device unavailable
Сообщение об ошибке:
E RKNNAPI: rknn_init, msg_ioctl_ack fail, data_len = 104985, except 102961!

D NPUTransfer: Transfer client closed, fd = 3

E init_runtime: Catch exception when init_runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 1961, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 360, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_DEVICE_UNAVAILABLE
Причины разнообразны. Выполните следующие проверки:
Убедитесь, что RKNN-Toolkit2 / RKNPU2 и прошивка платы обновлены. Проверка версий компонентов описана в 1.2.2.
Устройство должно быть видно и в adb devices, и в rknn.list_devices(); target и device_id в rknn.init_runtime() должны быть корректны.
Ошибка Runtime “Invalid RKNN model version 6”
Runtime выводит ошибку:
  Loading model …

  E RKNN: [09:13:25.728] 6, 1

  E RKNN: [09:13:25.728] Invalid RKNN model version 6

  E RKNN: [06:28:39.049] rknn_init, load model failed!

  Exception: RKNN init failed. error code: RKNN_ERR_FAIL
Причина:
Версия модели несовместима с RKNN Runtime.
Рекомендация:
Обновите модель и Runtime с учётом совместимости в разделе 16.1 либо одновременно обновите оба компонента до последней версии.
Ошибка Runtime “Invalid RKNN format”
Runtime выводит ошибку:
Loading model …

E RKNN: [06:28:39.048] parseRKNN from buffer: Invalid RKNN format!

E RKNN: [06:28:39.049] rknn_init, load model failed!

rknn_init error ret=-1
Причина:
1) target_platform в rknn.config() при преобразовании может быть неверным или отсутствовать; без настройки используется RK3566.
2) Версия Runtime несовместима с RKNN-Toolkit2.
Рекомендация:
) Задайте правильный target_platform.
2) RKNN-Toolkit2 и Runtime следует обновлять совместно до одной версии.
Время rknn.inference() не соответствует теоретической скорости rknn.eval_perf()
rknn.inference() выполняет вывод через PC + adb, добавляя постоянные затраты передачи данных. Поэтому время отличается от теоретического rknn.eval_perf().
Для реалистичной частоты кадров тестируйте непосредственно на плате через RKNPU2 C API.
Поддержка нескольких batch в rknn.inference()
Начиная с RKNN-Toolkit2 1.4.0 количество входных изображений задаётся при построении модели. Подробнее см. описание rknn.build в руководстве API RKNN-Toolkit2.
Если rknn_batch_size больше 1, например 4, измените Python-вызов вывода с:
outputs = rknn.inference(inputs=[img])
на:
img = np.expand_dims(img, 0)

img = np.concatenate((img, img, img, img), axis=0)

outputs = rknn.inference(inputs=[img])
Полный пример: examples/functions/multi_batch/
Выполнение нескольких моделей RKNN
Для двух и более моделей создайте несколько объектов RKNN. Один объект соответствует одной модели, подобно контексту. Каждая модель независимо инициализируется, выполняет вывод и получает результаты в своём контексте. На NPU эти модели выполняются последовательно.
Вывод очень длительный и результаты неверны
Если вывод занимает более 20s и результаты неверны, обычно причина — NPU Hang. Попробуйте последнюю версию RKNN-Toolkit2 / RKNPU2.
Неверные результаты с платой при трёхмерном входе
Для трёхмерного входа симулятор может работать правильно, а плата — нет. Возможная причина — пока неполная поддержка трёхмерного входа NPU; она будет улучшена позже.
Рекомендация:
Сначала измените вход модели на четырёхмерный.
Попробуйте последнюю версию RKNN-Toolkit2 / RKNPU2.
Результаты с платой неверны и различаются при каждом запуске
Если после преобразования ONNX в RKNN симулятор даёт стабильный правильный результат, а плата — нестабильный неверный, возможен дефект драйвера NPU на плате. Обновите драйвер ядра NPU и RKNN-Toolkit2 / RKNPU2.
Потеря точности в модели с большим числом Resize OP
После преобразования ONNX-модели с большим числом Resize в RKNN точность может снизиться. Возможные причины:
1) NPU пока не поддерживает аппаратный Resize; поддержка планируется. Конвертер заменяет Resize на ConvTranspose, вызывая небольшую потерю точности.
2) Несколько последовательных Resize накапливают ошибки и могут сильнее снизить точность.
Рекомендация:
1) По возможности избегайте Resize, например замените его на ConvTranspose до обучения.
2) Добавьте optimization_level=2 в rknn.config(). Resize будет выполняться на CPU без потери точности, но с потерей производительности.
Все результаты nan после установки do_quantization=False
Если при do_quantization=True в rknn.build() результаты нормальны, а при False становятся nan, возможно, при fp16-вычислениях выход промежуточных слоёв, например свёртки, выходит за диапазон fp16 (65536), например -51597~75642.
Рекомендация:
При обучении следите, чтобы промежуточные выходы помещались в fp16; обычно помогает слой BN.
Результаты моделей QAT и RKNN различаются
Если классификатор QAT в PyTorch после преобразования даёт иные результаты RKNN, возможно, в PyTorch не задано engine=’qnnpack’. Метод вывода RKNN ближе к qnnpack.
Как узнать потребление памяти работающей модели
Используйте rknn.eval_memory(). Поле Total в журнале показывает общий расход памяти.
Различия измерений при включённом и выключенном perf_debug в rknn.init_runtime()
perf_debug добавляет сбор информации каждого слоя и может отключать некоторые механизмы параллелизма. Поэтому время больше, чем при perf_debug=False.
Главная цель perf_debug — найти слои, занимающие большую долю времени, и на этой основе разработать план оптимизации.
После перезапуска docker ранее работавший вывод с платой зависает при инициализации среды?
При перезапуске docker npu_transfer_proxy остаётся в состоянии, похожем на аварийное завершение. RKNN Server платы не распознаёт разрыв соединения с хостом. Перезапустите плату, чтобы сбросить состояние соединения RKNN Server.
5.4.9 Вопросы по использованию C API
Освобождает ли rknn_outputs_release() массив rknn_output?
rknn_outputs_release() используется вместе с rknn_outputs_get() и освобождает только буфер в массиве rknn_output. Аналогичная ситуация у rknn_destroy_mem().
Как выделить память правильного размера через rknn_create_mem?
Для входов действует правило: у квантованной модели rknn_create_mem() выделяет память по size_with_stride из rknn_tensor_attr; у неквантованной — по n_bytes_type * n_elems.
Для выходов rknn_create_mem() выделяет память по n_bytes_type * n_elems.
Как заполнять входные данные?
В общем API для 4-мерного входа fmt=NHWC: порядок заполнения [batch, height, width, channel]. Для входа, отличного от 4D, fmt=UNDEFINED, то есть данные следуют исходной форме модели.
В zero-copy API для входа 4D fmt может быть NHWC/NC1HWC2. Заполнение при fmt=NC1HWC2 описано в разделе «RKNN Runtime Zero Copy». Для входа, отличного от 4D, fmt=UNDEFINED, то есть используется исходная форма модели.
Как использовать pass_through?
Формат входа получают командой RKNN_NATIVE_INPUT_ATTR функции rknn_query(). Для 4-мерной формы при числе каналов 1, 3 или 4 требуется NHWC, при других значениях — NC1HWC2. Для формы, отличной от 4 измерений, рекомендуется UNDEFINED.
Кроме того, в режиме pass_through квантованные модели обычно задают dtype входного Tensor как INT8, а неквантованные — как FLOAT16.
Как устранить ошибку «failed to submit»?
Если ошибка возникает на первом слое свёртки при zero-copy, возможно, для входного тензора выделено недостаточно памяти. Используйте size_with_stride из атрибутов тензора для выделения.
Если ошибка возникает в промежуточном NPU-слое, возможна неверная конфигурация модели. В журнале можно найти ссылку на последний SDK. Рекомендуется обновить инструментарий либо назначить этот слой CPU при преобразовании RKNN-модели.
Как устранить «Meet unsupport xxx operator»?
При такой ошибке запуска демонстрации на плате её Runtime (librknnrt.so) обычно не поддерживает оператор. Сначала обновите инструментарий RKNN, заново преобразуйте модель и повторите запуск демонстрации.
Если ошибка сохраняется в последнем наборе инструментов, добавьте реализацию оператора самостоятельно по 4.2.1 либо сообщите команде RKNN через redmine.
Поддерживает ли модель с динамической формой внешнюю память в процессе zero-copy
Версии до 1.6.0 этого не поддерживают. Более поздние версии позволяют инициализировать контекст с флагом RKNN_FLAG_MEM_ALLOC_OUTSIDE.
Оценка производительности пользовательского оператора в Runtime
Задайте RKNN_LOG_LEVEL=4 или выше и запустите тестовый пример C API. Он выведет производительность каждого слоя, включая пользовательский оператор.
Примечание: время пользовательского оператора включает действия внутри обратного вызова compute. Для GPU-оператора это, например, время clImportMemoryARM, преобразований расположения и типов входных и выходных данных, а также выполнения самого GPU-ядра OpenCL.
5.5 Связанные ресурсы
RKNN: https://github.com/airockchip/rknn-toolkit2
RKNN_Model_Zoo: https://github.com/airockchip/rknn_model_zoo
RGA: https://github.com/airockchip/librga