
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 5/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
2.2 Modellquantisierung
2.2.1 Grundbegriffe der Quantisierung
2.2.1.1 Definition der Quantisierung
Bei der Modellquantisierung werden Gleitkommaparameter oder Aktivierungen eines Deep-Learning-Modells in Festkommadarstellungen umgewandelt, beispielsweise FP32 in INT8. Dies verringert den Speicherverbrauch, komprimiert das Modell und beschleunigt die Inferenz, verursacht jedoch gewöhnlich einen gewissen Genauigkeitsverlust.
Je nach Abbildungsfunktion zwischen Gleitkomma- und Festkommawerten unterscheidet man lineare und nichtlineare Quantisierung. Häufige nichtlineare Verfahren sind exponentielle Quantisierung, Codebuchquantisierung und stückweise lineare Quantisierung. RKNN-Toolkit2 unterstützt ausschließlich lineare Quantisierung. Dabei sind die Abstände zwischen Festkommawerten gleich: INT8 unterteilt den Quantisierungsbereich beispielsweise gleichmäßig in 256 Werte. Daher spricht man auch von gleichmäßiger Quantisierung. Je nachdem, ob der Quantisierungsnullpunkt 0 ist, wird zwischen symmetrischer und asymmetrischer linearer Quantisierung unterschieden. Die symmetrische Variante ist eine Vereinfachung der asymmetrischen. Asymmetrische Quantisierung verarbeitet ungleichmäßige Datenverteilungen gewöhnlich besser und wird deshalb in der Praxis häufiger eingesetzt.
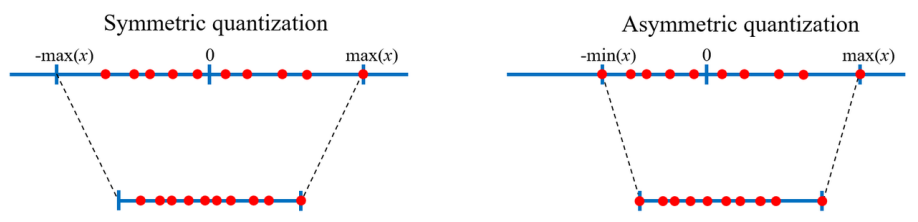
Abbildung 2-2: Lineare symmetrische und asymmetrische Quantisierung
2.2.1.2 Berechnung der Quantisierung
Am Beispiel der linearen asymmetrischen Quantisierung wird ein Gleitkommawert wie folgt in einen vorzeichenbehafteten Festkommawert umgewandelt:
x_int = clamp(round(x / s) + z; -2^(b-1), 2^(b-1)-1) (6-1)
Dabei ist x der Gleitkommawert, x_int der quantisierte Festkommawert, round die Rundung auf die nächste ganze Zahl, s der Quantisierungsskalierungsfaktor, z der Nullpunkt und b die Bitbreite; bei INT8 gilt beispielsweise b=8. Die Begrenzungsoperation clamp ist definiert als:
clamp(x; a, c) = a, if x < a; x, if a <= x <= c; c, if x > c. (6-2)
Die Rückwandlung eines Festkommawerts in einen Gleitkommawert heißt Dequantisierung:
x ≈ x_hat = s × (x_int - z) (6-3)
x̂ wird auch als pseudoquantisierter Gleitkommawert bezeichnet. Wegen Rundung und Begrenzung während der Quantisierung ist x̂ nicht exakt gleich x; die Differenz heißt Quantisierungsfehler.
Sei der Quantisierungsbereich (q_min, q_max) und der Begrenzungsbereich (c_min, c_max). Die Parameter s und z werden dann wie folgt berechnet:
s = (q_max - q_min) / (c_max - c_min) = (q_max - q_min) / (2^b - 1) (6-4)
z = c_max - round(q_max / s) OR z = c_min - round(q_min / s) (6-5)
Der Begrenzungsbereich ergibt sich aus dem quantisierten Datentyp; bei INT8 ist er beispielsweise (-128, 127). Der Quantisierungsbereich hängt vom gewählten Algorithmus ab. Mit z=0 ergeben diese Definitionen die lineare symmetrische Quantisierung.
2.2.1.3 Quantisierungsgranularität
Die Granularität legt fest, welche Parameter eines Gleitkommatensors gemeinsam quantisiert werden. RKNN-Toolkit2 unterstützt Per-Layer / Per-Channel / Group. Bei Per-Layer werden alle Kanäle der Gewichte oder Aktivierungen einer Schicht gemeinsam mit denselben Parametern quantisiert. Per-Channel quantisiert jeden Ausgabekanal der Schichtgewichte unabhängig mit eigenen Parametern. Group gilt nur für Gewichte linearer Schichten: Zusätzlich zur Aufteilung nach Ausgabekanälen werden die Elemente jedes Kanals in Gruppen aufgeteilt, die unabhängig quantisiert werden.
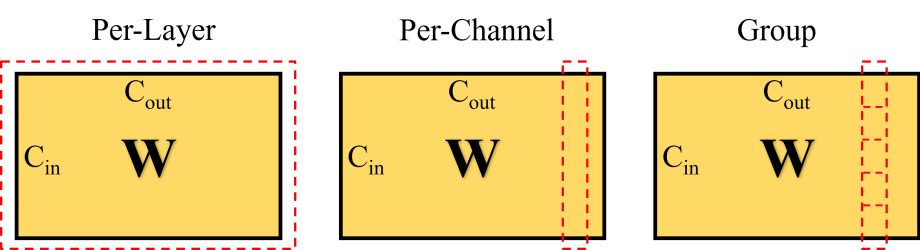
Abbildung 2-3: Per-Layer-, Per-Channel- und Group-Quantisierung
Hinweis: In RKNN-Toolkit2 gelten Group und Per-Channel nur für Gewichte. Aktivierungen und Zwischenwerte verwenden weiterhin Per-Layer. Group ist nur für lineare Schichten unter w4a16 wirksam.
2.2.1.4 Quantisierungsalgorithmen
Ein Quantisierungsalgorithmus bestimmt die Abbildung von Gleitkommatensoren auf Festkommadarstellungen mit geringer Bitbreite und die zugehörigen Parameter für eine vorgegebene Quantisierungsform, etwa lineare Quantisierung. Man unterscheidet quantisierungsbewusstes Training und Quantisierung nach dem Training. Ersteres passt Modell- und Quantisierungsparameter während des Trainings zur Verbesserung der Genauigkeit an. Es erfordert meist ein tiefes Verständnis der Trainingspipeline und viele Trainingsdaten und wird daher selten direkt in Bereitstellungswerkzeugketten eingesetzt. Quantisierung nach dem Training benötigt gewöhnlich nur einen kleinen oder gar keinen Kalibrierungsdatensatz und ermittelt die Parameter mit geringem Aufwand. RKNN-Toolkit2 unterstützt vier entsprechende Algorithmen: Normal / KL-Divergence / MMSE / GDQ.
2.2.2 Überblick über den Quantisierungsablauf
RKNN-Toolkit2 verwendet Post-Training Quantization (PTQ): Die interne Quantisierung erfolgt zusammen mit der Modellkonvertierung. Zunächst wird das Gleitkommamodell in das Toolkit geladen; Quantisierung und RKNN-Export erfolgen über rknn.config() → rknn.load_xxx() → rknn.build() → rknn.export_rknn(). Der Gesamtablauf lautet:
Floating-point model ──▶ rknn.config() to configure quantization parameters ──▶
rknn.load_xxx() to load the model ──▶ rknn.build(do_quantization=True, dataset=...)
to quantize and build ──▶ rknn.export_rknn() to export the RKNN model
Wesentliche Bestandteile des Quantisierungsablaufs und ihre Konfiguration:
Quantisierungsdatentyp: über quantized_dtype in rknn.config() konfiguriert. Unterstützt werden w8a8, w4a16, w8a16 und weitere Typen; siehe 2.2.3.1 „Datentypen“.
Algorithmus: über quantized_algorithm in rknn.config() konfiguriert. Unterstützt werden Normal / KL-Divergence / MMSE / GDQ; Grundlagen stehen in 2.2.1.4, Einzelheiten in 2.2.3.2.
Granularität: über quantized_method in rknn.config() konfiguriert. Unterstützt werden layer (Per-Layer), channel (Per-Channel) und group{SIZE} (Group).
Kalibrierungsdatensatz: über dataset in rknn.build() angegeben; dient zur Berechnung der Quantisierungsparameter der Aktivierungen. Siehe 2.2.3.3 „Kalibrierungsdaten vorbereiten“.
Hybride Quantisierung: weist quantisierungsempfindlichen Schichten genauere Datentypen zu, um Genauigkeitsverluste zu mindern; siehe 2.2.4.
Quantisierungsbewusstes Training (QAT): fügt während des Trainings Fake-Quantisierungsknoten ein und passt Modellparameter an. Geeignet, wenn PTQ die Genauigkeitsanforderungen nicht erfüllt; siehe 2.2.5.
2.2.3 Interner Quantisierungsablauf
2.2.3.1 Datentypen
Die interne Quantisierung von RKNN-Toolkit2 unterstützt w8a8, w4a16, w8a16, w4a8, w16a16i und w16a16i_dfp; Standard ist w8a8. w4/w8/w16 bezeichnet die Quantisierung der Gewichte auf int4/int8/int16, a8/a16 die Darstellung der Aktivierungen als int8/float16. Die Typen werden nachfolgend beschrieben:
w8a8 (Standard): Gewichte und Aktivierungen verwenden asymmetrische 8-Bit-Quantisierung. Auf RK2118 nicht unterstützt.
w4a16: asymmetrisch auf 4 Bit quantisierte Gewichte, Aktivierungen als 16-Bit-Gleitkommawerte. Nur RK3576 / RV1126B.
w8a16: asymmetrisch auf 8 Bit quantisierte Gewichte, Aktivierungen als 16-Bit-Gleitkommawerte. Nur RK3562.
w4a8: asymmetrische 4-Bit-Quantisierung der Gewichte und asymmetrische 8-Bit-Quantisierung der Aktivierungen. Noch nicht unterstützt.
w16a16i: asymmetrische 16-Bit-Quantisierung der Gewichte und Aktivierungen. Nur RV1103 / RV1106.
w16a16i_dfp: dynamische 16-Bit-Festkommaquantisierung der Gewichte und Aktivierungen. Nur RV1103 / RV1106.
2.2.3.2 Interne Quantisierungsalgorithmen
Unterstützt werden vier Algorithmen: Normal / KL-Divergence / MMSE / GDQ.
Normal bestimmt den Bereich direkt aus dem kleinsten und größten Gleitkommawert. Es entsteht kein Abschneidefehler, allerdings ist das Verfahren ausreißerempfindlich. Es ist schnell und für allgemeine Fälle geeignet. Der Bereich wird wie folgt berechnet:
q_min = min V (6-6)
q_max = max V (6-7)
Dabei ist V der Gleitkommatensor.
KL-Divergence bestimmt den Bereich durch Vergleich der Verteilungen von Gleitkomma- und Festkommawerten, Anpassung der Schwellenwerte und Minimierung der KL-Divergenz. Das Verfahren passt sich ungleichmäßigen Verteilungen besser an und mindert den Einfluss einzelner Ausreißer, ist aber etwas langsamer als Normal.
argmin_(q_min,q_max) H(Ψ(V), Ψ(V_int)) (6-8)
H(·,·) ist die KL-Divergenz, Ψ(·) bildet Daten auf eine diskrete Verteilung ab, und V_int ist der quantisierte Festkommatensor.
MMSE bestimmt den Bereich durch Minimierung des mittleren quadratischen Fehlers zwischen ursprünglichen und dequantisierten Gleitkommawerten. Es erzielt gewöhnlich höhere Genauigkeit, benötigt aber mehr Berechnungen und Speicher und ist langsamer. Bei Ausreißern liefert es häufig bessere Ergebnisse als KL-Divergence.
argmin_(q_min,q_max) ||V - V_hat(q_min,q_max)||_F² (6-9)
| V̂(q_min,q_max) ist die quantisierte und wieder dequantisierte Form von V; | · | _F bezeichnet die Frobeniusnorm. |
GDQ wirkt nur bei quantized_dtype=w4a16 oder w8a16 und kann die Genauigkeit der Gewichtsquantisierung verbessern. Empfohlen werden mehr als 200 Bilder. Einzelheiten enthält „03_RKNN2_Toolkit_Python_API_Reference_V2.5.0“.
Beginnen Sie mit Normal und versuchen Sie bei Genauigkeitsproblemen KL-Divergence, MMSE oder GDQ. Bei w4a16 / w8a16 sollte zuerst GDQ ausprobiert werden.
2.2.3.3 Kalibrierungsdaten vorbereiten
Der Kalibrierungsdatensatz bestimmt den Quantisierungsbereich der Aktivierungen. Er sollte die unterschiedlichen Datenverteilungen der tatsächlichen Anwendung abdecken, bei einer Klassifikation beispielsweise Bilder verschiedener Klassen aus realen Szenarien. Üblicherweise werden 20–200 Bilder empfohlen, angepasst an die Laufzeit des Algorithmus. Für GDQ werden mehr als 200 Bilder empfohlen. Bei anderen Algorithmen verlängert ein größerer Datensatz die Laufzeit, verbessert aber nicht zwangsläufig die Genauigkeit.
Kalibrierungsdaten werden als Textdatei angegeben: Schreiben Sie die Pfade zu jpg-/png-Bildern oder npy-Dateien in eine .txt-Datei, einen Pfad je Zeile:
a.jpg
b.jpg
Bei mehreren Eingaben werden die Dateien der einzelnen Eingaben durch Leerzeichen getrennt:
a0.jpg a1.jpg
b0.jpg b1.jpg
2.2.3.4 Konkretes Beispiel
Beispiel 1: interner Quantisierungsablauf für ResNet50:
from rknn.api import RKNN

model_path = "resnet50-v2-7.onnx" ## Floating-point ONNX model exported in advance
output_path = 'resnet50-v2-7.rknn'
DATASET_PATH = '../../../datasets/imagenet/ILSVRC2012_img_val_samples/dataset_20.txt'

# Create RKNN object
rknn = RKNN(verbose=False)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[[255*0.485, 255*0.456, 255*0.406]],
           std_values=[[255*0.229, 255*0.224, 255*0.225]],
           target_platform="rk3588",
           quantized_dtype='w8a8', ## "w4a16", "w8a16" etc. are optional (subject to actual platform support)
           quantized_algorithm='normal', ## "MMSE", "KL-Divergence", "GDQ" are optional
           quantized_method='channel',)
print('done')

# Load model
print('--> Loading model')
ret = rknn.load_onnx(model=model_path, inputs=['data'], input_size_list=[[1, 3,
224, 224]])

if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset=DATASET_PATH)
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')

# Export rknn model
print('--> Export rknn model')
ret = rknn.export_rknn(output_path)
if ret != 0:
    print('Export rknn model failed!')
    exit(ret)
print('done')
2.2.4 Gemischte Quantisierung
Hybride Quantisierung verwendet unterschiedliche Datentypen für verschiedene Schichten. Für ungeeignete Schichten werden genauere Datentypen eingesetzt, um den Genauigkeitsverlust zu mindern. Dies verursacht jedoch zusätzlichen Aufwand; außerdem muss der Benutzer den Quantisierungsdatentyp jeder Schicht festlegen.
2.2.4.1 Verwendung der gemischten Quantisierung
Für ein besseres Verhältnis zwischen Leistung und Genauigkeit bietet RKNN-Toolkit2 gemischte Quantisierung. Anhand der Genauigkeitsanalyse kann man manuell festlegen, ob jeder Layer quantisiert werden soll.
Folgende Anwendungen werden unterstützt:
-
Bestimmte quantisierte Schichten durch nicht quantisierte Schichten ersetzen, etwa mit FLOAT16-Berechnung. Da die NPU bei nicht quantisierten Berechnungen weniger Rechenleistung bietet, sinkt die Inferenzgeschwindigkeit etwas.
-
Die Quantisierungsparameter einzelner Schichten können ebenfalls geändert werden; dies wird jedoch nicht empfohlen.
2.2.4.2 Ablauf der gemischten Quantisierung
Die Verwendung umfasst vier Schritte.
1 Das ursprüngliche Modell laden und Quantisierungskonfiguration, temporäre Modelldatei sowie Datendatei erzeugen. Die Aufrufreihenfolge lautet:
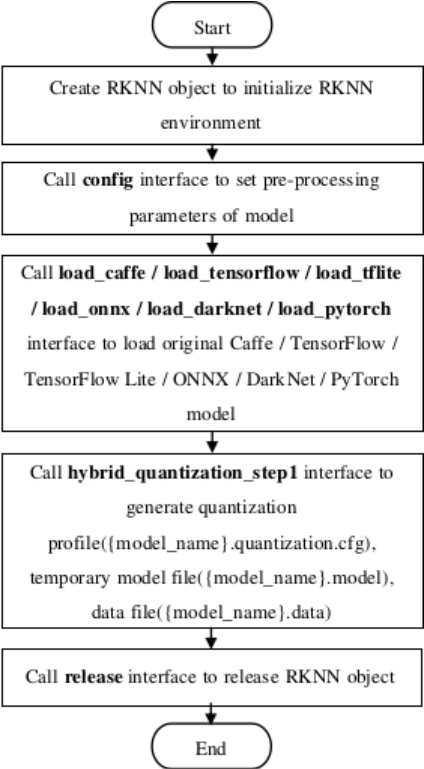
Abbildung 2-4: Hybride Quantisierung, Schritt 1
1 Die im ersten Schritt erzeugte Konfigurationsdatei bearbeiten.
Nach dem Aufruf von hybrid_quantization_step1 im ersten Schritt entsteht im aktuellen Verzeichnis die Datei {model_name}.quantization.cfg. Ihr Format lautet:
custom_quantize_layers:
  Conv__350:0: float16
  Conv__358:0: float16
  ....
quantize_parameters:
  ....
  FeatureExtractor/MobilenetV2/Conv/Relu6:0:
    qtype: asymmetric_quantized
    qmethod: layer
    dtype: int8
    min:
    - 0.0
    max:
    - 6.0
    scale:
    - 0.023529411764705882
    zero_point:
    - -128
  ....
Im Abschnitt “custom_quantize_layers” können benutzerdefinierte Quantisierungslayer ergänzt werden: Auf den Tensornamen folgt der Quantisierungstyp. Dadurch wird der Berechnungstyp des zugehörigen Layers geändert. Derzeit ist “float16” verfügbar.
Der Abschnitt “quantize_parameters” enthält die Parameter jedes Tensors im Format “tensor_name: quantization_properties_and_parameters”. “min” und “max” sind die Grenzen des Quantisierungsbereichs. Die Ausgabetensornamen lassen sich den Analyseergebnissen entnehmen oder durch Öffnen der temporären Datei {model_name}.model in Netron ermitteln.
1 Das RKNN-Modell erzeugen. Die Aufrufreihenfolge lautet:
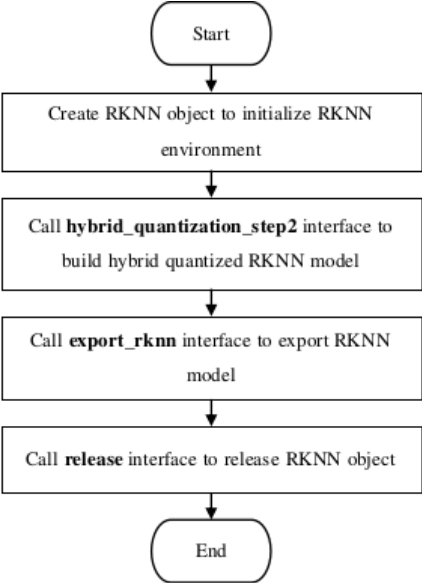
Abbildung 2-5: Hybride Quantisierung, Schritt 3
1 Mit dem im dritten Schritt erzeugten RKNN-Modell die Inferenz ausführen.
Hinweis: Das RKNN-Toolkit2-Projekt enthält im Verzeichnis “examples/functions/hybrid_quant” ein Beispiel zur gemischten Quantisierung, das als Vorlage dienen kann.
2.2.4.3 Automatische gemischte Quantisierung
Zur Vereinfachung der hybriden Quantisierung und Behebung von Überläufen bietet RKNN-Toolkit2 automatische hybride Quantisierung. auto_hybrid passt das Modell während der Quantisierung anhand von Schwellenwerten für euklidischen und Kosinusabstand automatisch an. Bei einem nicht quantisierten Modell prüft es jede Schicht auf fp16-Überlauf und stellt betroffene Schichten auf int16-Berechnung um.
Derzeit werden folgende Anwendungen unterstützt:
- Während der Quantisierung wird das hybride Modell anhand der Schwellenwerte für euklidischen und Kosinusabstand automatisch angepasst. Derzeit wird nur die automatische Umstellung von int8 auf fp16 unterstützt.
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', auto_hybrid=True)
Die Schwellenwerte werden in config über auto_hybrid_cos_thresh und auto_hybrid_euc_thresh eingestellt. Der Kosinusschwellenwert beträgt standardmäßig 0.98; der euklidische Schwellenwert ist standardmäßig deaktiviert. Damit werden zunächst nur Operatoren mit Kosinusgenauigkeit unterhalb des angegebenen Schwellenwerts auf fp16 umgestellt; der euklidische Schwellenwert hat dabei keinen Einfluss. Ist er aktiviert, werden Operatoren auf fp16 umgestellt, wenn ihr Kosinusabstand unter dem Kosinus- schwellenwert liegt oder ihr euklidischer Abstand den euklidischen Schwellenwert überschreitet.
- Bei nicht quantisierten Modellen wird jede Schicht auf fp16-Überlauf geprüft; betroffene Schichten werden auf int16 umgestellt. Zur Berechnung des Wertebereichs jeder Schicht muss ein dataset bereitgestellt werden.
ret = rknn.build(do_quantization=False, dataset='./dataset.txt', auto_hybrid=True)
Maximum und Minimum jeder Schicht werden anhand der Eingabedaten berechnet. Überschreiten sie die obere oder untere fp16-Grenze, werden die zugehörigen Operatoren auf int16 umgestellt.
2.2.5 Quantisierungsbewusstes Training (QAT)
2.2.5.1 Einführung in QAT
Quantization-Aware Training (QAT) soll Genauigkeitsverluste bei Quantisierung mit geringer Bitbreite behandeln. Diese entstehen bei der Überführung des Gleitkommawertebereichs in Festkommazahlen. QAT bezieht den Quantisierungsfehler in die Trainingsverlustfunktion ein und ermöglicht so das Training eines Modells mit Quantisierungsparametern.
Vergleich mit der von RKNN-Toolkit2 angebotenen Quantisierung nach dem Training (PTQ):
| Quantisierungsmethode | Nachtraining im ursprünglichen Framework | Datensatz | Anpassung der Gewichtsparameter | Verlustfunktion | Leistung |
|---|---|---|---|---|---|
| Quantisierung nach dem Training (PTQ) | Nein | Wenige unbeschriftete Daten | Nein | Nicht relevant | Optimal |
| Quantisierungsbewusstes Training (QAT) | Ja | Vollständiger Trainingsdatensatz | Ja | Der Quantisierungsverlust ist in der Trainingsverlustfunktion enthalten | Bei Operatoren ohne QAT-Unterstützung ist die Leistung etwas geringer als bei PTQ |
2.2.5.2 QAT-Prinzip
Bei QAT bleiben Gewichte und Berechnungen im Gleitkommaformat, damit Rückpropagation und Training korrekt funktionieren. Anders als beim gewöhnlichen Gleitkommatraining fügt QAT an quantisierbaren Stellen FakeQuantize-Module ein, die den Genauigkeitsverlust beim Übergang zu Festkommawerten simulieren. So kann die Verlustfunktion die Quantisierung berücksichtigen und optimieren, sodass die Inferenzergebnisse nach der Umwandlung in ein Festkommamodell genau bleiben.
QAT wird breit eingesetzt und von gängigen Inferenzframeworks unterstützt. Ausführliche Anleitungen sind über folgende Links verfügbar.
Pytorch - https://pytorch.org/blog/quantization-in-practice/#quantization-aware-training-qat
Paddle - https://paddleslim.readthedocs.io/zh-cn/develop/api_cn/dygraph/quanter/qat.html
TensorFlow: https://www.tensorflow.org/model_optimization/guide/quantization/training
2.2.5.3 Hinweise zur Verwendung von QAT
QAT benötigt zusätzlichen Trainingscode; außerdem kann Code mancher Open-Source-Repositories damit kollidieren. Deshalb sollte QAT zur Modellquantisierung erst erwogen werden, wenn beide folgenden Bedingungen erfüllt sind:
-
Die Genauigkeitsdiagnose nach Abschnitt 5.1 bestätigt, dass RKNN-PTQ die Genauigkeitsanforderungen nicht erfüllt.
-
Ein Versuch mit hybrider Quantisierung nach 2.2.4 bestätigt, dass diese die Anforderungen an Genauigkeit und Leistung nicht erfüllt.
2.2.5.4 QAT-Implementierungsbeispiel und Konfiguration
Nachfolgend finden Sie die QAT-Dokumentation verschiedener Frameworks. Für die konkrete Verwendung ist die offizielle Dokumentation maßgeblich.
PyTorch: https://pytorch.org/docs/stable/quantization.html (PyTorch besitzt mehrere Quantisierungsschnittstellen. RKNN unterstützt derzeit quantisierte Modelle aus der FX-Schnittstelle, insbesondere prepare_qat_fx und den zugehörigen Schnittstellen.)
Paddle: https://www.paddlepaddle.org.cn/tutorials/projectdetail/3949129#anchor-14
TensorFlow: https://www.tensorflow.org/model_optimization/guide/quantization/training
Am Beispiel von PyTorch werden der QAT-Ablauf und wichtige Hinweise erläutert.
# for 1.10 <= torch <= 1.13
import torch
class M(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.conv = torch.nn.Conv(3, 8, 3, 1)

    def forward(self, x):
        x = self.conv(x)
        return x

# initialize a floating point model
float_model = M().train()

from torch.quantization import quantize_fx, QConfig, FakeQuantize, MovingAverageMinMaxObserver, MovingAveragePerChannelMinMaxObserver

qconfig = QConfig(activation=FakeQuantize.with_args(observer=
        MovingAverageMinMaxObserver,
        quant_min=0,
        quant_max=255,
        reduce_range=False), # reudece_range -> the default is True

 weight=FakeQuantize.with_args(observer=
      MovingAveragePerChannelMinMaxObserver,
      quant_min=-128,
      quant_max=127,
      dtype=torch.qint8,
      qscheme=torch.per_channel_affine,
      #qscheme->the default is torch.per_channel_symmetric
      reduce_range=False))
qconfig_dict = {"": qconfig}
model_qat = quantize_fx.prepare_qat_fx(float_model, qconfig_dict)

# define the training loop for quantization aware training
def train_loop(model, train_data):
    model.train()
for image, target in data_loader:
    ...
# Run training
train_loop(model_qat, train_loop)

model_qat = quantize_fx.convert_fx(model_qat)
Im obigen Code folgen alle Operationen den offiziellen Beispielen, abgesehen von der Anpassung von qconfig an RKNN-Hardware. Dabei gibt es zwei wesentliche Änderungen:
Bei der Aktivierungsquantisierung wird reduce_range auf False gesetzt. Mit False reicht der effektive Bereich von -128 bis 127, mit True nur von -64 bis 63, was schlechtere Quantisierungsergebnisse bewirkt. RKNN-Hardware unterstützt reduce_range = False.
Für die Gewichtsquantisierung wird qscheme auf torch.per_channel_affine gesetzt. Das voreingestellte torch.per_channel_symmetric fixiert zero_point auf 0; RKNN-Hardware unterstützt jedoch auch andere Nullpunkte. Deshalb wird torch.per_channel_affine gewählt.
2.2.5.5 Von QAT unterstützte Operatoren
Bei PyTorch werden zunächst Conv- und Linear-Operatoren mit Gewichten nach QAT-Regeln quantisiert. Danach werden weitere Operatoren geprüft und gegebenenfalls regulär quantisiert. Erfüllt ein Operator weder QAT- noch reguläre Quantisierungsregeln, verbleibt er bei FP32-Berechnungen.
Der Unterstützungsumfang unterscheidet sich je nach Framework. Einzelheiten zu Framework und Version finden sich unter:
Pytorch: https://github.com/pytorch/pytorch/blob/main/torch/ao/quantization/quantization_mappings.py
Paddle: https://github.com/PaddlePaddle/Paddle/blob/86df789a567f1285101c57b6e3ada4b952c58f48/python/paddle/quantization/config.py
Tensorflow: https://www.tensorflow.org/model_optimization/api_docs/python/tfmot/quantization/keras/QuantizeConfig
2.2.5.6 Behandlung von Gleitkommaoperatoren im QAT-Modell
Kann ein Operator in einem QAT-Modell nicht quantisiert werden, wird er als Gleitkommaoperation ausgeführt. Bei der Konvertierung solcher Operatoren nach RKNN sind zwei Fälle zu berücksichtigen.
- Davor und danach stehen quantisierbare Operatoren:
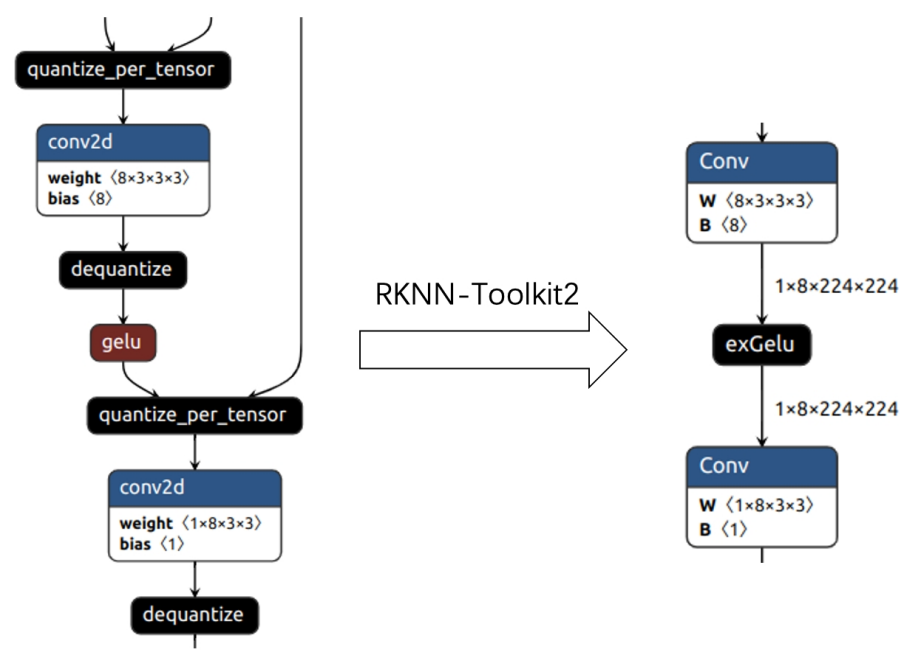
Abbildung 2-6: QAT-Operator zwischen quantisierbaren Operatoren
Links in der Abbildung ist gelu ein Gleitkommaoperator, während die umgebenden conv-Operatoren quantisiert sind. Beim Laden konvertiert RKNN-Toolkit2 den dazwischenliegenden Gleitkommaoperator in einen quantisierten Operator, um die Inferenzleistung zu verbessern. Laut Originalhandbuch beeinflusst dies die Genauigkeit nicht. Nach der Konvertierung entspricht die RKNN-Struktur der rechten Bildhälfte.
1 Davor oder danach befinden sich nicht quantisierbare Operatoren:
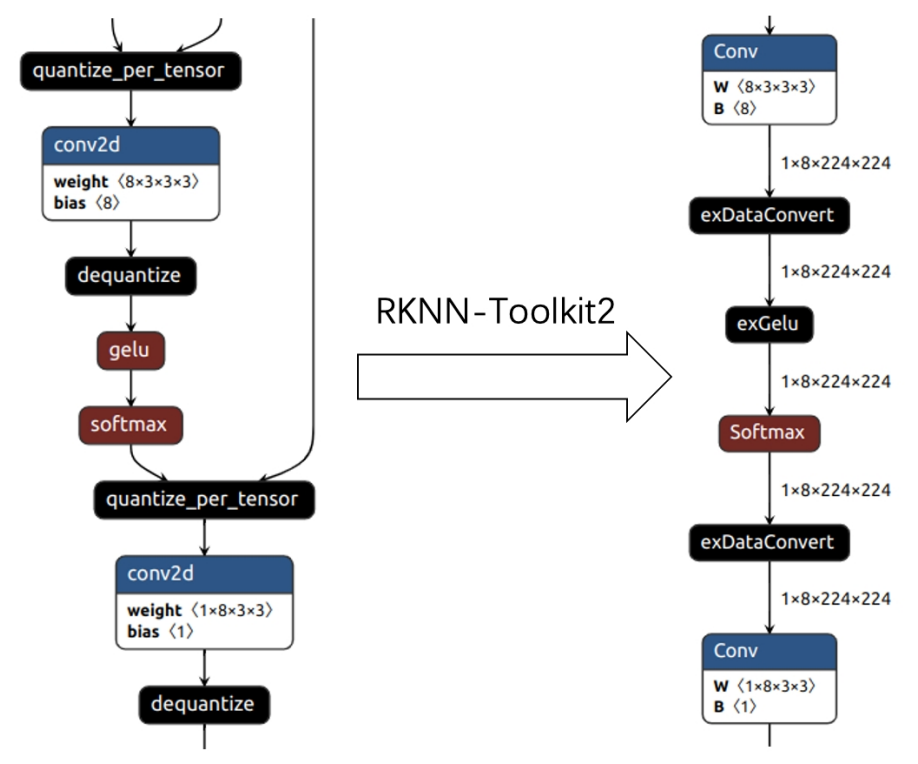
Abbildung 2-7: QAT-Operator neben nicht quantisierbaren Operatoren
Links sind gelu und softmax Gleitkommaoperatoren; die conv-Operatoren davor und danach sind quantisiert. Da Quantisierungsparameter für gelu und softmax fehlen, belässt RKNN-Toolkit2 beide im Gleitkommaformat. Nach der Konvertierung fügt das RKNN-Modell wie rechts gezeigt vor gelu eine Dequantisierung und nach softmax eine Quantisierung ein. Diese zusätzlichen Operatoren verursachen zusätzliche Laufzeit.
2.2.5.7 Zusammenfassung der QAT-Erfahrungen
- QAT-Konfiguration
Für gute Ergebnisse muss QAT häufig an die Hardwareeigenschaften angepasst werden. Für RKNPU sollten die qconfig-Parameter anhand des Codes in Abschnitt 2.2.5.4 „QAT-Implementierungsbeispiel und Konfiguration“ eingestellt werden.
- Im Modell gespeicherte Quantisierungsparameter können eine nachträgliche Anpassung benötigen
Beispielsweise können die für sigmoid gespeicherten Parameter von den tatsächlich bei der Inferenz verwendeten abweichen. Im offiziellen Code (https://github.com/pytorch/pytorch/blob/main/aten/src/ATen/native/quantized/cpu/qsigmoid.cpp) werden die sigmoid-Parameter während der Inferenz angepasst: min wird auf 0 und max auf 1 gesetzt.
Bei der Konvertierung von QAT-Modellen passt RKNN-Toolkit2 die Parameter solcher Operatoren bereits während der Modellkonvertierung an, damit die Ergebnisse denen der ursprünglichen PyTorch-Inferenz näherkommen.