
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 5/22
量化、混合量化与 QAT
2.2 模型量化
2.2.1 量化基本概念
2.2.1.1 量化定义
模型量化是指将深度学习模型中的浮点参数或者激活值转换为定点表示,如将 FP32 转换为 INT8 等。量化能够降低内存占用,实现模型压缩和推理加速,但通常会带来一定程度的精度损失。
根据浮点参数与定点数之间映射函数的形式,量化可分为线性量化与非线性量化。常见的非线性量化包括指数量化、码本量化、分段线性量化等。RKNN-Toolkit2 仅支持线性量化。在线性量化中,定点数之间的间隔是均匀的,例如 INT8 线性量化将量化范围均匀划分为 256 个数,因此也称为均匀量化。根据量化零点是否为 0,线性量化可分为对称量化与非对称量化。对称量化是非对称量化的简化形式,非对称量化通常能更好地处理数据分布不均匀的情况,因此实际使用中多采用非对称量化方案。
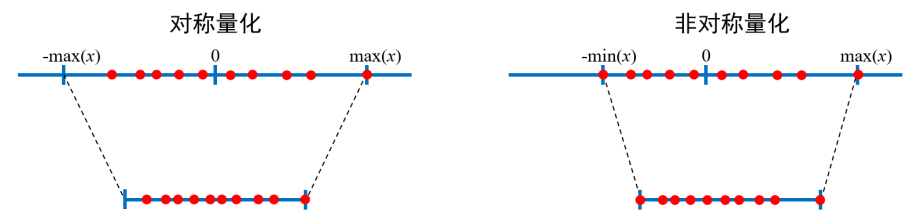
图2-2 线性对称量化和线性非对称量化
2.2.1.2 量化计算
以线性非对称量化为例,浮点数量化为有符号定点数的计算如下:
x_int = clamp(round(x / s) + z; -2^(b-1), 2^(b-1)-1) (6-1)
其中x为浮点数,x int为量化定点数,⌊⋅⌉为四舍五入运算,s为量化比例因子,z为量化零点,b为量化位宽,如INT8数据类型中b为8;clamp为截断运算,具体定义如下:
clamp(x; a, c) = a, if x < a; x, if a <= x <= c; c, if x > c. (6-2)
从定点数转换为浮点数称为反量化过程,具体定义如下:
x ≈ x_hat = s × (x_int - z) (6-3)
其中 xˆ 也被称为伪量化浮点数。易知,由于量化计算中的取整操作与截断操作,xˆ 与 x 并不相等,两者间的差异也被称为量化误差。
设量化范围为 (q_min, q_max),截断范围为 (c_min, c_max),量化参数 s 和 z 的计算公式如下:
s = (q_max - q_min) / (c_max - c_min) = (q_max - q_min) / (2^b - 1) (6-4)
z = c_max - round(q_max / s) OR z = c_min - round(q_min / s) (6-5)
其中截断范围是根据量化的数据类型决定,例如INT8的截断范围为(-128, 127);量化范围根据不同的量化算法确定。令上述定义公式中的z=0,即可得到线性对称量化的计算定义。
2.2.1.3 量化粒度
量化粒度表示模型浮点张量中,哪些参数作为一个整体进行量化。RKNN-Toolkit2中支持Per-Layer / Per-Channel / Group 三种量化粒度。Per-Layer量化是将网络层权重或者激活的所有通道作为一个整体进行量化,所有通道共享相同的量化参数。Per-Channel量化是将网络层的权重的各个输出通道独立进行量化,每个通道有自己的量化参数。Group量化仅针对线性层权重,是在Per-Channel量化的基础上,对每个输出通道的元素进行分组,每个分组独立进行量化。
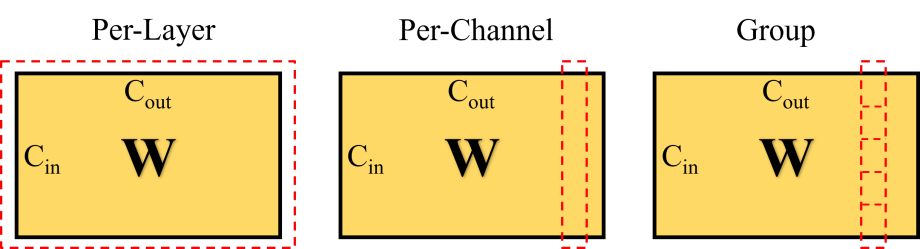
图2-3 Per-Layer量化、Per-Channel量化和Group量化
说明:RKNN-Toolkit2 中的 Group 量化和 Per-Channel 量化仅针对权重;激活值和中间值仍采用 Per-Layer 量化;Group 量化仅在 w4a16 条件下对线性层有效。
2.2.1.4 量化算法
量化算法是指在给定量化形式下(如线性量化),求解浮点 Tensor 到低比特定点数表示及其量化参数的方案。按实现方式,可分为量化感知训练与训练后量化两类。量化感知训练通过在训练过程中微调模型参数和量化参数以提升精度,通常需要深入理解训练流程并依赖大量训练数据,因此很少在模型部署工具链中直接使用。训练后量化则通常只需少量校准数据,甚至无需校准数据,通过较低成本的计算得到量化参数。在 RKNN-Toolkit2 中支持四种训练后量化算法:Normal / KL-Divergence / MMSE 和 GDQ。
2.2.2 量化流程概览
RKNN-Toolkit2 采用训练后量化(PTQ)方式,量化随模型转换一并完成,提供内部量化流程:先将浮点模型加载到 Toolkit 中,通过 rknn.config() → rknn.load_xxx() → rknn.build() → rknn.export_rknn() 完成量化并导出 RKNN 模型。整体量化流程为:
浮点模型 ──▶ rknn.config()配置量化参数 ──▶ rknn.load_xxx()加载模型 ──▶
rknn.build(do_quantization=True, dataset=...)量化并构建 ──▶ rknn.export_rknn()导出RKNN
模型
量化流程涉及的关键要素及其配置位置如下:
量化数据类型:通过 rknn.config() 的 quantized_dtype 配置,RKNN-Toolkit2支持w8a8,w4a16,w8a16等多种量化数据类型(见2.2.3.1 数据类型)。
量化算法:通过 rknn.config() 的 quantized_algorithm 配置,支持Normal / KL-Divergence /MMSE / GDQ四种训练后量化算法(原理见2.2.1.4 量化算法,具体说明见2.2.3.2 内部量化算法)。
量化粒度:通过 rknn.config() 的 quantized_method 配置,支持layer(Per-Layer)/ channel(Per-Channel)/ group{SIZE}(Group)三种粒度。
量化校正集:通过 rknn.build() 的 dataset 参数指定,用于计算激活值的量化参数(见2.2.3.3 校准数据准备)。
混合量化:对量化敏感的层指定高精度数据类型,缓解精度损失(见2.2.4 混合量化)。
量化感知训练(QAT):在训练阶段插入伪量化节点并微调模型参数,适用于训练后量化无法满足精度要求的场景(见2.2.5 量化感知训练)。
2.2.3 内部量化流程
2.2.3.1 数据类型
RKNN-Toolkit2 内部量化支持的量化数据类型有 w8a8 , w4a16 , w8a16 , w4a8 , w16a16i 和w16a16i_dfp ,默认值为 w8a8 。其中 w4/w8/w16 代表权重量化为对应位宽(int4/int8/int16),a8/a16代表激活量化为 int8/float16 类型。各量化数据类型说明如下:
w8a8(默认):权重为 8bit 非对称量化精度,激活值为 8bit 非对称量化精度。RK2118 不支持。
w4a16:权重为 4bit 非对称量化精度,激活值为 16bit 浮点精度。仅 RK3576 / RV1126B 支持。
w8a16:权重为 8bit 非对称量化精度,激活值为 16bit 浮点精度。仅 RK3562 支持。
w4a8:权重为 4bit 非对称量化精度,激活值为 8bit 非对称量化精度。暂不支持。
w16a16i:权重为 16bit 非对称量化精度,激活值为 16bit 非对称量化精度。仅 RV1103 / RV1106 支持。
w16a16i_dfp:权重为 16bit 动态定点量化精度,激活值为 16bit 动态定点量化精度。仅 RV1103 /RV1106 支持。
2.2.3.2 内部量化算法
内部量化共支持 Normal / KL-Divergence / MMSE / GDQ 四种量化算法:
Normal:通过计算浮点值的最大值和最小值直接确定量化范围。该算法不会产生截断误差,但对异常值敏感,运行速度快,适用于一般场景。量化范围计算公式为:
q_min = min V (6-6)
q_max = max V (6-7)
其中 V 为浮点数Tensor。
KL-Divergence:通过比较浮点值和定点值的分布,调整阈值并最小化 KL 散度来确定量化范围。该算法更适应非均匀数据分布,能够缓解少数异常值的影响,运行速度略慢于 Normal。
argmin_(q_min,q_max) H(Ψ(V), Ψ(V_int)) (6-8)
其中 H(⋅,⋅) 为KL散度计算公式,Ψ(⋅) 为分布函数,将对应数据计算为离散分布,V int 为量化定点数Tensor。
MMSE:通过最小化浮点值与反量化后浮点值之间的均方误差来确定量化范围。该算法通常精度更高,但需要较多计算资源,运行速度较慢、内存开销较大。相比 KL-Divergence,它在异常值场景下往往有更好的精度表现。
argmin_(q_min,q_max) ||V - V_hat(q_min,q_max)||_F² (6-9)
其中 Vˆ (q min , q max ) 为 V 的量化、反量化形式,∥⋅∥ F 为F范数。
GDQ:仅在 quantized_dtype 为 w4a16 和 w8a16 时有效,能够有效提高 w4a16 和 w8a16 的权重量化精度,推荐量化数据集量为 200 张以上。GDQ 量化算法的详细说明请参考《03_RKNN2_Toolkit_Python_API_参考_V2.5.0》手册。
建议用戶优先使用 Normal 算法,当遇到量化精度问题时可尝试 KL-Divergence、MMSE 或 GDQ;使用w4a16 / w8a16 量化时可优先尝试 GDQ 算法。
2.2.3.3 校准数据准备
对于内部量化流程,校准数据集用于计算激活值的量化范围。选择时应覆盖模型实际应用场景的不同数据分布,例如分类模型的校准数据应包含实际场景中的不同类别图片。一般推荐校准数据集数量为 20~200 张,可根据量化算法的运行时间适当调整;使用 GDQ 量化算法时,推荐量化数据集量为 200 张以上。对其它量化算法来说,增加校准数据集数量会增加运行时间,但不一定能提高精度。
内部量化校准数据目前支持文本文件格式,用戶可以将用于校准的图片(jpg 或 png 格式)或 npy 文件路径写入 .txt 文件。文本文件中每一行为一条路径信息,如:
a.jpg
b.jpg
如有多个输入,则每个输入对应的文件用空格隔开,如:
a0.jpg a1.jpg
b0.jpg b1.jpg
2.2.3.4 具体示例
示例1:ResNet50 内部量化流程示例:
from rknn.api import RKNN

model_path = "resnet50-v2-7.onnx" ## 提前导出的浮点ONNX模型
output_path = 'resnet50-v2-7.rknn'
DATASET_PATH = '../../../datasets/imagenet/ILSVRC2012_img_val_samples/dataset_20.txt'

# Create RKNN object
rknn = RKNN(verbose=False)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[[255*0.485, 255*0.456, 255*0.406]],
           std_values=[[255*0.229, 255*0.224, 255*0.225]],
           target_platform="rk3588",
           quantized_dtype='w8a8', ## "w4a16", "w8a16" 等可选(以实际平台支 持为准)
           quantized_algorithm='normal', ## "MMSE", "KL-Divergence", "GDQ" 可选
           quantized_method='channel',)
print('done')

# Load model
print('--> Loading model')
ret = rknn.load_onnx(model=model_path, inputs=['data'], input_size_list=[[1, 3, 224,
224]])

if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset=DATASET_PATH)
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')

# Export rknn model
print('--> Export rknn model')
ret = rknn.export_rknn(output_path)
if ret != 0:
    print('Export rknn model failed!')
    exit(ret)
print('done')
2.2.4 混合量化
混合量化对模型不同层采用不同的量化数据类型,将不适合量化的层使用较高精度的数据类型表达,以此缓解模型量化精度损失的问题,但混合精度量化会增加额外开销,并且需要用戶确定不同层的量化数据类型。
2.2.4.1 混合量化用法
为了在性能和精度之间做更好的平衡,RKNN-Toolkit2提供了混合量化功能,用戶可以通过精度分析的输出结果来手动指定各层是否进行量化。
目前混合量化功能支持如下用法:
-
将指定的量化层改成非量化层,如用 FLOAT16 进行计算。(因NPU上非量化算力较低,所以推理速度会有一定降低)。
-
每一层的量化参数也可以进行修改。(量化参数不建议修改)
2.2.4.2 混合量化使用流程
使用混合量化功能时,具体分四步进行。
- 加载原始模型,生成量化配置文件、临时模型文件和数据文件。具体的接口调用流程如下:
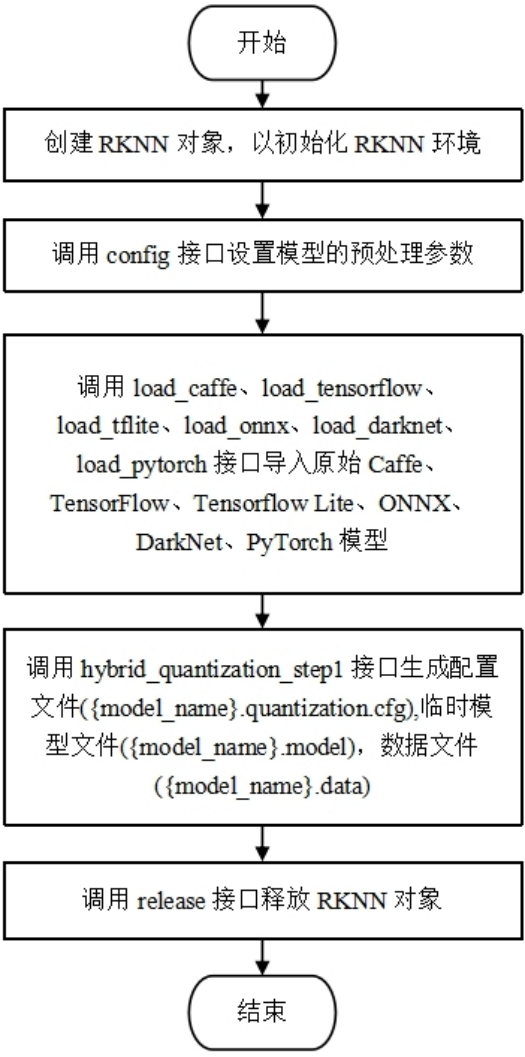
图2-4 混合量化第一步
- 修改第一步生成的量化配置文件。
第一步调用混合量化接口hybrid_quantization_step1完成后会在当前目录下生成名为{model_name}.quantization.cfg 的配置文件。配置文件格式如下:
custom_quantize_layers:
    Conv__350:0: float16
    Conv__358:0: float16
    ....
quantize_parameters:
    ....
    FeatureExtractor/MobilenetV2/Conv/Relu6:0:
       qtype: asymmetric_quantized
       qmethod: layer
       dtype: int8
       min:
       - 0.0
       max:
       - 6.0
       scale:
       - 0.023529411764705882
       zero_point:
       - -128
       ....
custom_quantize_layers下每一行可按照tensor名: 量化类型的格式添加自定义量化层,该tensor对应层的运算类型即改为指定运算类型。目前量化数据类型可选择float16。
quantize_parameters下是模型中每个tensor的量化参数。每个tensor的量化参数按照tensor名: 量化属性和参数的格式呈现。其中min/max代表量化范围的最小最大值,tensor名可根据精度分析输出结果查看或使用Netron打开临时模型文件{model_name}.model查看对应输出tensor名。
- 生成 RKNN 模型。具体的接口调用流程如下:
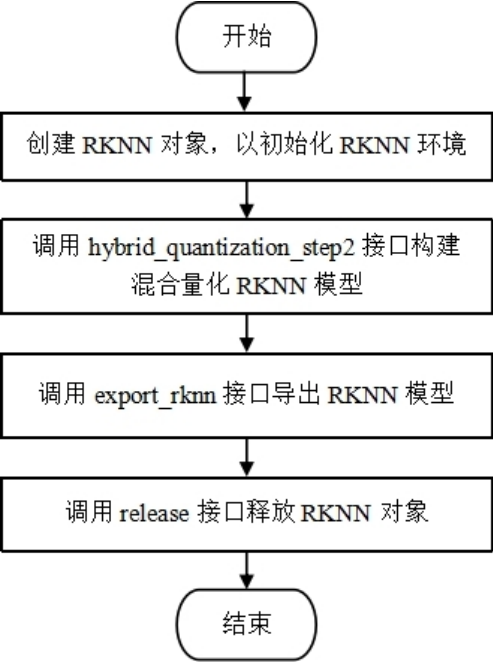
图2-5 混合量化第三步
- 使用第三步生成的 RKNN 模型进行推理。
注:RKNN-Toolkit2工程中examples/functions/hybrid_quant目录下提供了一个混合量化的例子,具体可以参考该例子对模型进行混合量化。
2.2.4.3 自动混合量化
为了方便混合量化的使用以及解决模型溢出问题,RKNN-Toolkit2提供了自动混合量化功能。用戶可以通过auto_hybrid 接口,在模型量化时通过欧式距离和余弦距离的阈值来自动调整混合量化模型;在模型非量化时会检查模型逐层是否fp16溢出,将溢出层转换为int16计算。
目前自动混合量化功能支持如下用法:
- 模型量化时通过欧式距离和余弦距离的阈值来自动调整混合量化模型,目前仅支持从int8量化自动调整为fp16.
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', auto_hybrid=True)
其中余弦距离和欧式距离的阈值可通过config接口中的auto_hybrid_cos_thresh和auto_hybrid_euc_thresh设置,余弦距离阈值默认为0.98, 欧式距离阈值默认不开启。即默认只对余弦距离精度小于指定阈值的算子转换为fp16,此时欧式距离阈值不起作用。当欧式距离阈值开启时会对小于余弦距离阈值或大于欧式距离阈值的算子转换为fp16。
- 模型非量化时检查模型逐层是否fp16溢出,将溢出层转换为int16计算,此时需要提供数据集用于计算逐层的数值范围
ret = rknn.build(do_quantization=False, dataset='./dataset.txt', auto_hybrid=True)
根据给定的输入计算逐层的最大值和最小值,当最大值或最小值超出fp16的上值或下值时会将对应层的算子转换为int16。
2.2.5 量化感知训练
2.2.5.1 QAT简介
量化感知训练(英文名称 Quantization-aware Training,简称 QAT)是一种量化训练方式,该方式旨在解决低比特量化的精度损失问题。低比特量化会掉精度,是因为值域从浮点数调整到定点数时会有精度损失,QAT训练时会将量化误差计入训练的损失函数,训练出一个带量化参数的模型。
与 RKNN-Toolkit2 工具提供的后训练量化(英文名称 Post Training Quantization,简称 PTQ)对比,两种量化方法的特点如下:
| 量化方法 | 基于原始框架二 次训练 | 数据集 | 权重参数是否 被调整 | 损失函数 | 性能 |
|---|---|---|---|---|---|
| 后训练量化 (PTQ) | 不需要 | 少量未标注数 据 | 否 | 无关 | 最优 |
| 量化感知训练 (QAT) | 需要 | 完整的训练数 据集 | 是 | 量化损失计入训练 损失函数 | 存在算子不支持QAT时, 性能略弱于 PTQ |
2.2.5.2 QAT原理
量化感知训练时,所有权重的存放格式、算子的计算单元都是按照浮点数进行的,这是为了保证反向传播功能可以正常生效、模型的训练可以正常进行。与训练浮点模型不同,在模型可被量化的位置上,量化感知训练会插入FakeQuantize模块进行伪量化操作,模拟浮点数调整到定点数的精度损失,使其能被损失函数识别、优化,最终使模型转为定点模型时仍可以保持准确的推理结果。
量化感知训练目前已被广泛使用,各主流推理框架皆有实现,可参考下文所列链接获取更详细的使用说明:
Pytorch - https://pytorch.org/blog/quantization-in-practice/#quantization-aware-training-qat
Paddle - https://paddleslim.readthedocs.io/zh-cn/develop/api_cn/dygraph/quanter/qat.html
Tensorflow - https://www.tensorflow.org/model_optimization/guide/quantization/training
2.2.5.3 QAT使用依据
由于 QAT 需要增加额外的训练代码,且部分开源仓库的代码可能与QAT功能存在冲突,推荐在同时满足以下两种情况时,考虑使用QAT训练进行模型量化:
-
参考章节5.1进行量化精度排查,确认RKNN的 PTQ 功能不满足精度要求。
-
尝试章节2.2.4进行混合量化,确认RKNN的混合量化功能不满足精度、性能要求。
2.2.5.4 QAT实现简例及配置说明
以下是各框架 QAT 功能的说明文档,实际使用请以官方文档为准:
Pytorch: https://pytorch.org/docs/stable/quantization.html (Pytorch目前存在多套量化接口,RKNN目前支持 FX 接口生成的量化模型,即 prepare_qat_fx 接口及其配套接口)
Paddle: https://www.paddlepaddle.org.cn/tutorials/projectdetail/3949129#anchor-14
Tensorflow: https://www.tensorflow.org/model_optimization/guide/quantization/training
这里我们以 Pytorch 为例,说明实现 QAT 的流程及一些需要注意的地方。
# for 1.10 <= torch <= 1.13
import torch
class M(torch.nn.Module):
    def __init__(self):
       super().__init__()
       self.conv = torch.nn.Conv(3, 8, 3, 1)
    def forward(self, x):
       x = self.conv(x)
       return x

# initialize a floating point model
float_model = M().train()

from torch.quantization import quantize_fx, QConfig, FakeQuantize, MovingAverageMinMaxObserver, MovingAveragePerChannelMinMaxObserver

qconfig = QConfig(activation=FakeQuantize.with_args(observer=
           MovingAverageMinMaxObserver,
           quant_min=0,
           quant_max=255,
           reduce_range=False), #reudece_range 默认是True
weight = FakeQuantize.with_args(observer=
           MovingAveragePerChannelMinMaxObserver,
           quant_min=-128,
           quant_max=127,
           dtype=torch.qint8,
           qscheme=torch.per_channel_affine, #参数qscheme默认是 torch.per_channel_symmetric
       reduce_range=False))

qconfig_dict = {"": qconfig}

model_qat = quantize_fx.prepare_qat_fx(float_model, qconfig_dict)

# define the training loop for quantization aware training
def train_loop(model, train_data):
    model.train()

for image, target in data_loader:
    ...

# Run trainin
train_loop(model_qat, train_loop)

model_qat = quantize_fx.convert_fx(model_qat)
以上流程代码中,除了qconfig的配置针对RKNN硬件做了部分调整,其余操作均按照官方代码的指引实现。qconfig中主要有以下两处改动:
activation量化配置指定reduce_range为False。reduce_range为False时,有效量化数值范围为-128~127;reduce_range为True时,有效量化数值范围为-64~63,量化效果较差。RKNN 硬件支持reduce_range为False。
weight量化配置指定qscheme为torch.per_channel_affine。默认的torch.per_channel_symmetric会限制zero_point固定为0,RKNN硬件支持zero_point非0,故选择torch.per_channel_affine。
2.2.5.5 QAT支持的算子
以 Pytorch 为例,使用 QAT 量化的过程中,先对带有权重参数的 Conv, Linear 采取 QAT 规则量化,再检验其他算子,若符合常规量化规则,则对其采用常规量化。在算子不符合 QAT 或常规量化规则的情况下,算子会维持 FP32 的计算规则。
不同框架的支持情况存在差异,用戶可以参考以下链接,根据使用的框架及版本,查寻更详细的量化算子支持情况。
Pytorch:https://github.com/pytorch/pytorch/blob/main/torch/ao/quantization/quantization_mappings.py
Paddle:https://github.com/PaddlePaddle/Paddle/blob/86df789a567f1285101c57b6e3ada4b952c58f48/python/paddle/quantization/config.py
Tensorflow:https://www.tensorflow.org/model_optimization/api_docs/python/tfmot/quantization/keras/QuantizeConfig
2.2.5.6 QAT模型中浮点算子的处理
QAT模型中,当算子无法量化,会采用浮点进行计算。这类算子在转为RKNN模型时,分为两种情况讨论。
- 前后为可量化算子:
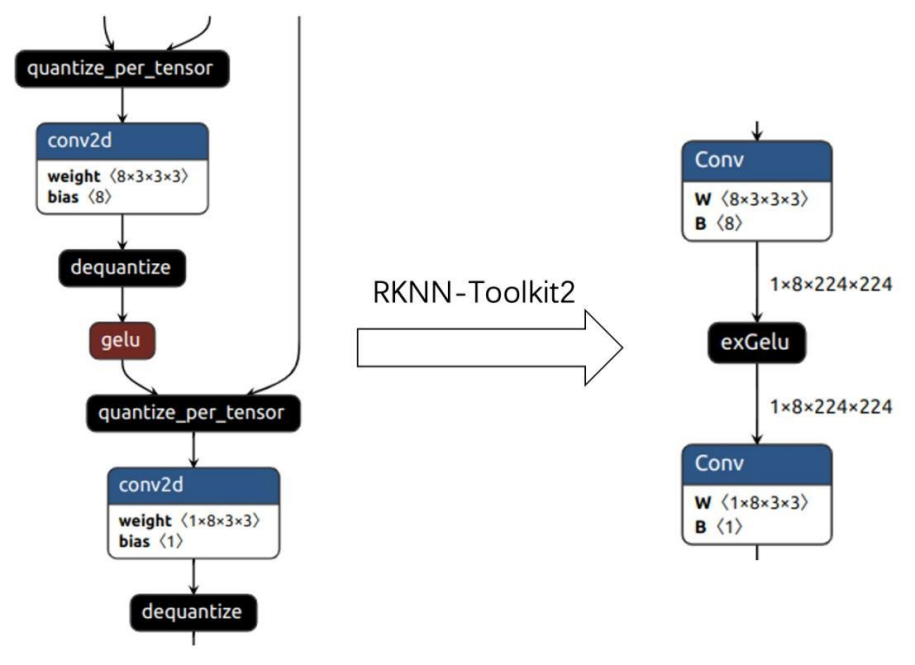
图2-6 QAT OP 前后为可量化算子状态
如上图左边所示,图中的 gelu 算子在原模型中为浮点算子,其前后的 conv 为量化算子,RKNN-Toolkit2 在加载模型时,会将两个已量化算子中间的浮点算子转为量化算子,提升推理性能,这个操作不会影响精度。转为RKNN 模型后,结构如上图右边所示。
- 前后存在非量化算子:
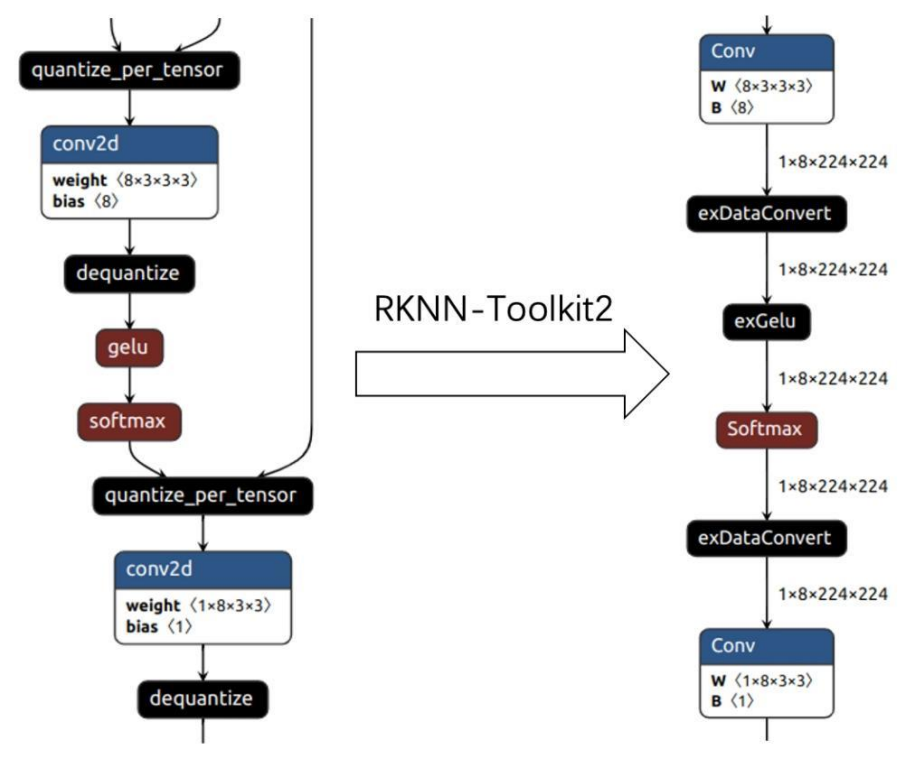
图2-7 QAT OP 前后为非量化算子状态
如上图左边所示,图中的 gelu、softmax 算子在原模型中为浮点算子,其前后的 conv 为量化算子,RKNN-Toolkit2 在加载模型时,由于 gelu、softmax 中间的量化参数缺失,gelu、softmax 仍保持浮点类型。转为RKNN 模型后结构如上图右边所示,图中 RKNN 模型在 gelu 的前面插入反量化算子,softmax后面插入量化算子,这些插入的量化、反量化算子都会增加额外的耗时。
2.2.5.7 QAT经验总结
- QAT 配置
根据不同硬件的特性,QAT训练往往需要调整配置才能达到更好的效果。对于RKNPU而言,建议参考2.2.5.4QAT实现简例及配置说明的代码说明配置qconfig参数。
- 模型中保存的量化参数可能需要二次调整
以 sigmoid 为例子,模型中 sigmoid 算子记录的量化参数可能不是实际推理时使用的量化参数。在官方的代码(https://github.com/pytorch/pytorch/blob/main/aten/src/ATen/native/quantized/cpu/qsigmoid.cpp)中,sigmoid 的量化参数在推理时会进行调整,将 min 置为0,max 置为1。
针对这类算子,RKNN-Toolkit2 在转换 QAT 模型时,会在模型转换阶段调整其量化参数,使推理结果和Pytorch 原始推理结果更接近。