
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 14/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
Многопакетный инференс
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
4.1.4 Использование Multi-Batch
4.1.4.1 Принцип Multi-Batch
NPU RK3588 имеет 3 ядра, RK3576 — 2. Для эффективного использования предусмотрен многопакетный инференс. При включении rknn_dup_context копирует только Internal контекста, а Weight используется совместно. При rknn_batch_size=2 создаётся одна копия, при rknn_batch_size>=3 — две, поскольку одновременно работают не более трёх ядер и дополнительные копии тратят память. core_mask каждого контекста устанавливается в 0 для автоматического планирования между ядрами. При rknn_run() создаётся пул потоков; три потока одновременно выполняют инференс трёх контекстов.
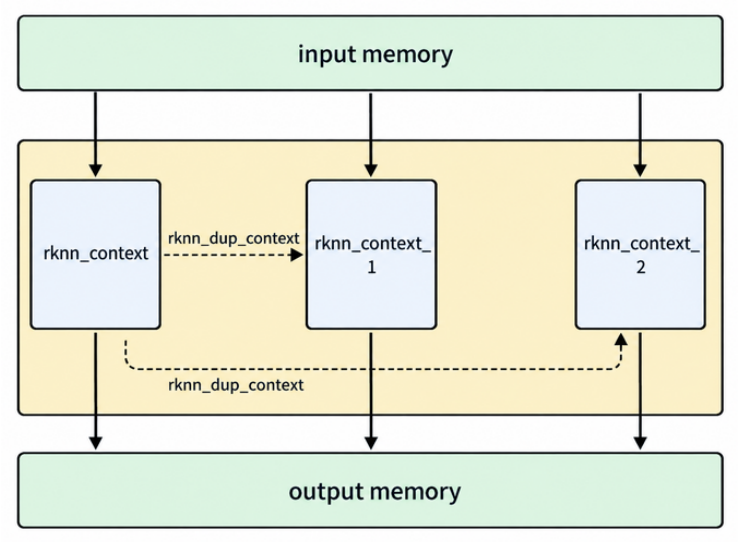
Рисунок 4-7. Внутренний принцип Multi-Batch
4.1.4.2 Использование Multi-Batch
Порядок использования Multi-Batch:
1 Включите Multi-Batch в Python:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', rknn_batch_size=3)
Для оптимальной производительности rknn_batch_size рекомендуется кратным 3 на RK3588 и кратным 2 на RK3576.
2 Рекомендуется интерфейс нулевого копирования.
4.1.4.3 Входы и выходы Multi-Batch
При Multi-Batch запрашиваемые размеры входа/выхода увеличиваются в rknn_batch_size раз. Каждый внутренний контекст вычисляет собственное входное смещение, читает свои данные, затем вычисляет выходное смещение и записывает результат. Для второго batch входное смещение равно input_size/rknn_batch_size, выходное — output_size/rknn_batch_size.
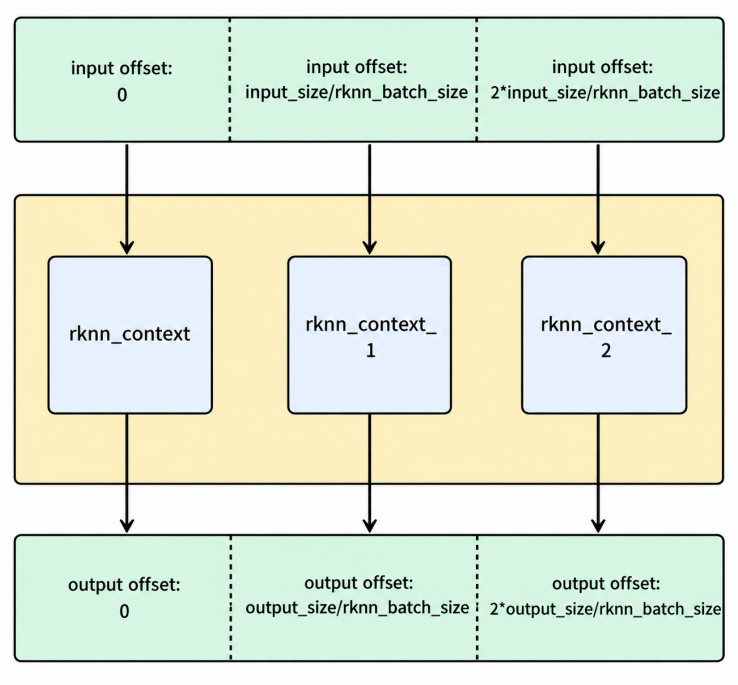
Рисунок 4-8. Внутренние смещения входа и выхода Multi-Batch