
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 17/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
4.2 Расширения и безопасность
4.2.1 Пользовательские операторы
4.2.1.1 Введение
RKNN SDK позволяет определять и выполнять пользовательские операторы при инференсе RKNN-моделей. Они расширяют функциональность и позволяют оптимизировать вычисления под CPU или GPU, используя ресурсы для ускорения. Разработка требует глубокого понимания вычислений глубокого обучения и особенностей целевого оборудования для обеспечения корректности и производительности. Пока поддерживаются только пользовательские операторы ONNX.
Работа с пользовательскими операторами включает два основных этапа:
Зарегистрируйте операторы через RKNN-Toolkit2 и экспортируйте модель RKNN.
Реализуйте оператор на C, загрузите, зарегистрируйте и выполните его через RKNN API.
Общий процесс показан ниже:
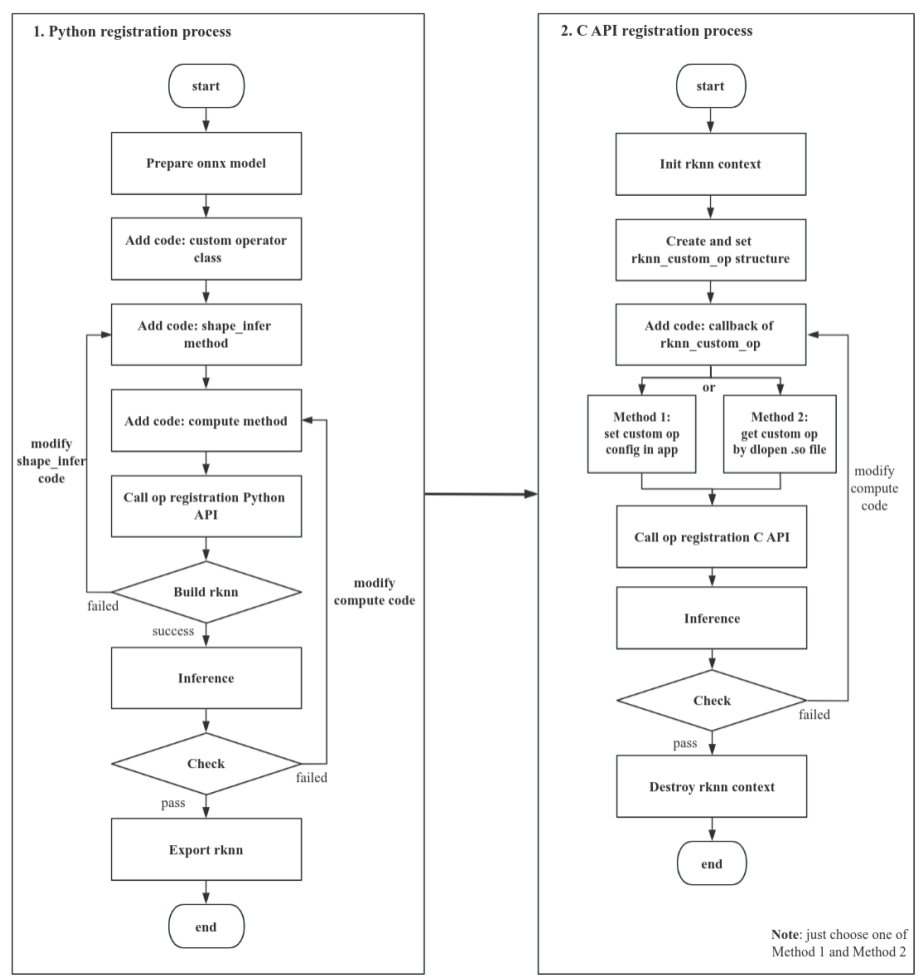
Рисунок 4-12. Полный процесс регистрации пользовательских операторов
4.2.1.2 Общий процесс
4.2.1.2.1 Регистрация операторов в RKNN-Toolkit2 и экспорт модели RKNN
1 Подготовьте onnx-модель: по спецификации ONNX задайте тип op, имя, атрибуты, число входов/выходов пользовательского оператора и вставьте его в нужную позицию графа. Создайте и экспортируйте модель через API пакета onnx.
2 Реализуйте Python-класс оператора, прежде всего shape_infer() и compute(), и зарегистрируйте его через rknn.reg_custom_op().
3 После успешного rknn.build() выполните инференс; при ошибке проверьте shape_infer() шага 2. Запустите симуляцию. Если результат правильный, экспортируйте модель через rknn.export_rknn(); иначе проверьте compute() шага 2.
4.2.1.2.2 Реализация оператора на C, загрузка, регистрация и выполнение через RKNN API.
1 Реализуйте оператор на C на основе rknn_custom_op из rknn_custom_op.h, затем заполните сведения rknn_custom_op.
2 Зарегистрируйте сведения rknn_custom_op через rknn_register_custom_ops().
3 Постройте и выполните модель по процессу обычного API или нулевого копирования. Для проверки оператора можно включить подробный журнал и dump модели.
4.2.1.2.3 Инференс или анализ точности с подключенным устройством через RKNN-Toolkit2
Для анализа точности модели с пользовательским оператором на подключённой плате скомпилируйте реализацию callback в .so, поместите по заданному пути и перезапустите rknn_server. Подробности в 4.2.1.4.4.
4.2.1.3 Процесс Python
Пользовательские операторы поддерживаются только моделями onnx; можно добавлять нестандартные для ONNX операторы, поддерживаемые RKNN.
Такой оператор отсутствует в стандартном списке ONNX. Помимо ONNX spec он должен соответствовать правилам:
op_type не должен совпадать со стандартным оператором ONNX. Рекомендуется префикс cst.
Оператор должен быть связан с другими операторами с определенными формами, типами и прочими характеристиками входов/выходов.
Входные атрибуты поддерживают отдельные значения или массивы bool, int32, float32 и int64.
Константные входы поддерживают bool, int32, float32 и int64. Это типы неквантованной модели ONNX.
Поскольку оператор не входит в ONNX SPEC, модель с ним нужно создать и экспортировать через ONNX API либо API другой среды.
Для удобства пример слегка изменяет Softmax и строит ONNX-модель с нестандартным оператором cstSoftmax. Способ изменения следующий:
import onnx

path="test_softmax.onnx"
model=onnx.load(path)

for node in model.graph.node:
  if node.op_type =="Softmax":
    node.op_type = "cstSoftmax"
    ... # Modify the attribute definition of cstSoftmax, etc
onnx.save(model, "./test_softmax_custom.onnx")
После создания модели откройте ее в Netron и проверьте соответствие оператора требованиям. Затем реализуйте класс, например для пользовательского Softmax:
import numpy as np
from rknn.api.custom_op import get_node_attr
class cstSoftmax:
  op_type = 'cstSoftmax'
  def shape_infer(self, node, in_shapes, in_dtypes):
    out_shapes = in_shapes.copy()
    out_dtypes = in_dtypes.copy()
    return out_shapes, out_dtypes
  def compute(self, node, inputs):
    x = inputs[0]
    axis = get_node_attr(node, 'axis')
    x_max = np.max(x, axis=axis, keepdims=True)
    tmp = np.exp(x - x_max)
    s = np.sum(tmp, axis=axis, keepdims=True)
    outputs = [tmp / s]
    return outputs
Пользовательский оператор должен быть классом Python.
Класс должен содержать строковую переменную op_type, совпадающую с именем типа оператора в ONNX.
Класс должен содержать shape_infer(self, node, in_shapes, in_dtypes); имена функции и параметров должны точно совпадать, иначе возникнет ошибка. Функция выводит формы оператора. node — объект узла ONNX с атрибутами и сведениями о входах/выходах. in_shapes — формы всех входов в формате [shape_0, shape_1, …], каждая shape также является списком. in_dtypes — типы всех входов в формате [dtype_0, dtype_1, …], каждый dtype имеет тип numpy dtype. Функция возвращает формы и dtype всех выходов в тех же форматах, что in_shapes и in_dtypes.
Класс оператора должен содержать compute(self, node, inputs); имена функции и параметров должны точно совпадать, иначе возникает ошибка. Метод выполняет инференс оператора. node — узел ONNX с атрибутами и сведениями о входах/выходах оператора. inputs — входные данные в виде [array_0, array_1, …], элементы списка — numpy.ndarray. Функция возвращает все выходные данные в таком же формате.
Для получения пользовательских атрибутов используйте from rknn.api.custom_op import get_node_attr.
Зарегистрируйте готовый класс через rknn.reg_custom_op(), затем вызовите rknn.build() для преобразования и создания RKNN. Класс обеспечивает функции преобразования и инференса модели. Пример с пользовательским Softmax:
from rknn.api import RKNN
# Create RKNN object
rknn = RKNN(verbose=True)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82], quant_img_RGB2BGR=True,
target_platform='rk3566')
print('done')

print('--> Register cstSoftmax op')
ret = rknn.reg_custom_op(cstSoftmax())
if ret != 0:
  print('Register cstSoftmax op failed!')
  exit(ret)
print('done')

print('--> Loading model')
ret = rknn.load_onnx(model='mobilenet_v2.onnx')
if ret != 0:
  print('Load model failed!')
  exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
if ret != 0:
  print('Build model failed!')
  exit(ret)
print('done')
rknn.reg_custom_op() вызывается между rknn.config() и rknn.load_xxx().
4.2.1.4 Развертывание через C API
Получив RKNN-модель с пользовательскими операторами, переходите к C API. Структуры и интерфейсы находятся в rknn_custom_op.h, который нужно включить в программу. Процесс регистрации и использования показан ниже:
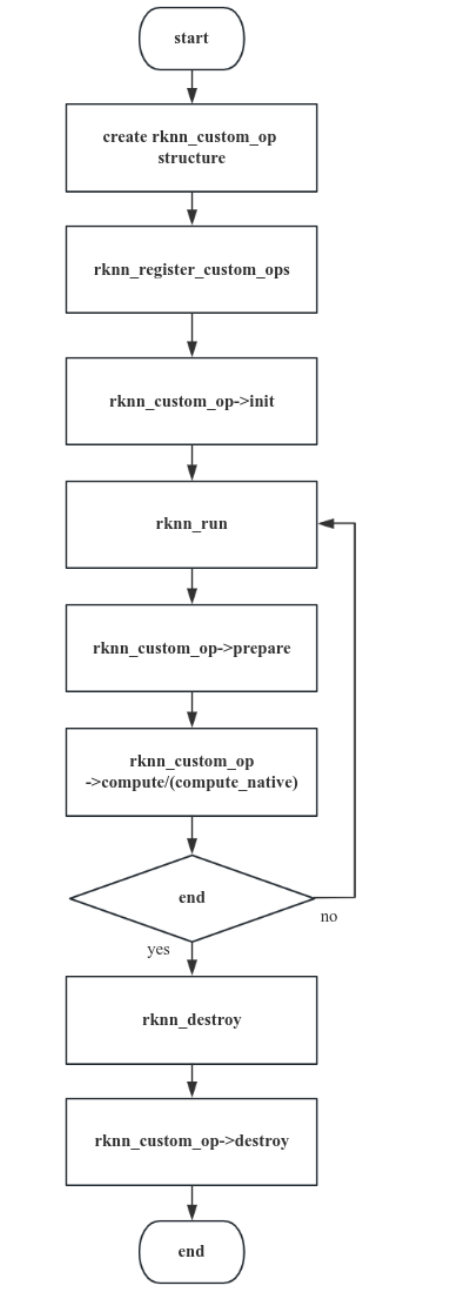
Рисунок 4-13. Последовательность C API регистрации пользовательских операторов
4.2.1.4.1 Инициализация структуры пользовательского оператора
После создания контекста rknn создайте rknn_custom_op и задайте следующие сведения:
version: версия оператора.
target: исполнительная среда оператора; поддерживаются CPU и GPU.
op_type: тип оператора, совпадающий с типом в модели ONNX.
cl_kernel_name: имя функции cl_kernel кода OpenCL; обязательно при регистрации GPU-оператора.
cl_kernel_source: полный путь к .cl-файлу либо строка ядра OpenCL. При cl_source_size=0 это путь к .cl, при cl_source_size>0 — строка кода OpenCL. Обязательно для GPU-оператора.
cl_source_size: размер cl_kernel_source. Специальное значение 0 означает, что cl_kernel_source является путем.
cl_build_options: строка параметров компиляции ядра OpenCL; обязательно для GPU-оператора.
init: необязательный callback, однократно вызываемый в rknn_register_custom_ops.
prepare: необязательный callback предварительной обработки. Каждый rknn_run выполняет сначала prepare, затем compute/compute_native.
compute: обязательный вычислительный callback. Входы и выходы — NCHW float32; если вход/выход ONNX имеет тип int64, данные будут int64.
compute_native: зарезервировано; установите NULL.
destroy: необязательный callback, выполняемый один раз в rknn_destory; написание имени сохранено из оригинала.
Параметры callback-функций init/prepare/compute:
rknn_custom_op_context* op_ctx: контекст callback-функции оператора.
rknn_custom_op_tensor* inputs: данные и сведения входных тензоров.
uint32_t n_inputs: число входов оператора.
rknn_custom_op_tensor* outputs: данные и сведения выходных тензоров.
uint32_t n_outputs: число выходов оператора.
destroy имеет только один параметр: rknn_custom_op_context* op_ctx.
rknn_custom_op_context
Содержит target (устройство исполнения), контекст GPU, частный контекст оператора и priv_data. Разработчик управляет присваиванием, чтением, записью и уничтожением priv_data. Контекст GPU содержит указатели cl_context, cl_command_queue и cl_kernel, из которых соответствующие объекты OpenCL получают приведением типов.
priv_data — необязательный указатель. Обычно ресурс создают в init(), его адрес сохраняют в priv_data, используют в prepare()/compute() и освобождают в destroy().
rknn_custom_op_tensor
Описывает входной/выходной тензор: имя, форму, размер, параметры квантования, виртуальный базовый адрес, fd, смещение данных и другие сведения.
В compute() не нужно выделять память входных и выходных тензоров: данные по виртуальному адресу уже подготовлены. Эффективный адрес тензора = виртуальный базовый адрес + смещение данных. virt_addr члена mem — базовый адрес, offset члена mem — смещение в байтах. Во время callback адрес входа указывает на выход предыдущего оператора, а адрес выхода — на данные, которые получит следующий оператор.
rknn_custom_op_attr
Для получения атрибутов вызовите rknn_custom_op_get_op_attr() с полем атрибута. Результат представлен rknn_custom_op_attr. Его void-буфер, dtype и число элементов описывают участок памяти. Приведением типа указателя в C/C++ согласно dtype можно получить массив нужного числового типа.
4.2.1.4.1.1 Callback Init
Используется для разбора сведений оператора либо инициализации временных и входных/выходных буферов, например выделения временной памяти. Пример init:
Оператор CPU
/**
* cpu kernel init callback for custom op
*/
int custom_op_init_callback(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
              rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("custom_op_init_callback\n");
  // create tmp buffer
  float* tmp_buffer = (float*)malloc(inputs[0].attr.n_elems * sizeof(float));
  op_ctx->priv_data = tmp_buffer;
  return 0;
}
Оператор GPU
/**
* opencl kernel init callback for custom op
* */
int relu_init_callback_gpu(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
             rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("relu_init_callback_gpu\n");
  // 获取opencl context
  cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

  // create tmp cl buffer
  cl_mem* memObject = (cl_mem*)malloc(sizeof(cl_mem) * 2);
  memObject[0] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, inputs[0].attr.size, NULL, NULL);
  memObject[1] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, outputs[0].attr.size, NULL, NULL);
  op_ctx->priv_data = memObject;
  return 0;
}
4.2.1.4.1.2 Callback Prepare
Этот callback вызывается для каждого кадра инференса; в оригинале также указано, что он пока зарезервирован для будущего использования.
4.2.1.4.1.3 Callback Compute
Это вычислительная функция оператора. Разработчик реализует kernel с входами/выходами float32 в NCHW или UNDEFINED.
- Callback compute (CPU). Пример CPU-функции compute для пользовательского слоя softmax:
/**
 * float32 kernel implemetation sample for custom op
 * */
int compute_custom_softmax_float32(rknn_custom_op_context* op_ctx,
rknn_custom_op_tensor* inputs, uint32_t n_inputs,
                                 rknn_custom_op_tensor* outputs, uint32_t
n_outputs)
{
  unsigned char* in_ptr = (unsigned char*)inputs[0].mem.virt_addr +
inputs[0].mem.offset;
  unsigned char* out_ptr = (unsigned char*)outputs[0].mem.virt_addr +
outputs[0].mem.offset;
  int axis = 0;
  const float* in_data = (const float*)in_ptr;
  float* out_data = (float*)out_ptr;
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  rknn_custom_op_attr op_attr;
  rknn_custom_op_get_op_attr(op_ctx, "axis", &op_attr);
  if (op_attr.n_elems == 1 && op_attr.dtype == RKNN_TENSOR_INT64) {
    axis = ((int64_t*)op_attr.data)[0];
  }

  printf("op name = %s, axis = %d\n", name.c_str(), axis);
  float* tmp_buffer = (float*)op_ctx->priv_data;
  // kernel implemetation for custom op
  {
    int inside = 1;
    int outside = 1;
    int channel = 1;

    while (axis < 0) {
      axis += inputs[0].attr.n_dims;
    }

    for (int i = 0; i < axis; i++) {
      outside *= inputs[0].attr.dims[i];
    }
    channel = inputs[0].attr.dims[axis];
    for (int i = axis; i < inputs[0].attr.n_dims; i++) {
      inside *= inputs[0].attr.dims[i];
    }

    for (int y = 0; y < outside; y++) {
      const float* src_y = in_data + y * inside;
      float* dst_y = out_data + y * inside;
      float max_data = -FLT_MAX;
      float sum_data = 0.0f;

      for (int i = 0; i < inside; ++i) {
        max_data = fmaxf(max_data, src_y[i]);
      }
      for (int i = 0; i < inside; ++i) {
        tmp_buffer[i] = expf(src_y[i] - max_data);
        sum_data += tmp_buffer[i];
      }
      for (int i = 0; i < inside; ++i) {
        dst_y[i] = tmp_buffer[i] / sum_data;
      }
    }
  }
  return 0;
}
- Callback compute (GPU)
Для GPU в callback выполняются следующие шаги:
Разработчик получает OpenCL cl_context, cl_command_queue и cl_kernel из gpu_ctx в rknn_custom_op_context. При этом необходимы преобразования типов данных.
При необходимости создайте буферы cl_mem для входов или выходов оператора.
Задайте аргументы функции cl_kernel.
Входные буферы аргументов OpenCL-kernel пока поддерживают только float, другие типы не поддерживаются.
При zero-copy clImportMemoryARM отображает память входного тензора в cl_mem. Данные уже находятся в тензоре, повторное копирование не нужно. Это можно выполнить в init: сохранить cl_mem в priv_data, затем прочитать и использовать priv_data в compute.
Выполните cl_kernel блокирующим способом.
Входные данные CL kernel имеют layout NCHW.
Если после GPU данные читает CPU, перед чтением сбросьте кэш выходного тензора вызовом rknn_mem_sync.
Пример GPU-функции compute для пользовательского слоя relu:
/**
 * opencl kernel init callback for custom op
 * */
int compute_custom_relu_float32(rknn_custom_op_context* op_ctx,
rknn_custom_op_tensor* inputs, uint32_t num_inputs,
                              rknn_custom_op_tensor* outputs, uint32_t
num_outputs)
{
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  // get context
  cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

  // get command queue
  cl_command_queue queue = (cl_command_queue)op_ctx->gpu_ctx.cl_command_queue;

  // get kernel
  cl_kernel kernel = (cl_kernel)op_ctx->gpu_ctx.cl_kernel;

  // import input/output buffer
  const cl_import_properties_arm props[3] = {
    CL_IMPORT_TYPE_ARM,
    CL_IMPORT_TYPE_DMA_BUF_ARM,
    0,
  };

  cl_int status;
  cl_mem inObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props,
&inputs[0].mem.fd,
                                    inputs[0].mem.offset + inputs[0].mem.size,
&status);
  if (status != CL_SUCCESS) {
    printf("Tensor: %s clImportMemoryARM failed\n", inputs[0].attr.name);
  }
  cl_mem outObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props,
&outputs[0].mem.fd,
                                     outputs[0].mem.offset + outputs[0].mem.size,
&status);
  if (status != CL_SUCCESS) {
    printf("Tensor: %s clImportMemoryARM failed\n", outputs[0].attr.name);
  }

  int in_type_bytes = get_type_bytes(inputs[0].attr.type);
  int out_type_bytes = get_type_bytes(outputs[0].attr.type);
  int in_offset = inputs[0].mem.offset / in_type_bytes;
  int out_offset = outputs[0].mem.offset / out_type_bytes;
  unsigned int elems = inputs[0].attr.n_elems;

  // set kernel args
  int argIndex = 0;
  clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &inObject);
  clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &outObject);
  clSetKernelArg(kernel, argIndex++, sizeof(int), &in_offset);
  clSetKernelArg(kernel, argIndex++, sizeof(int), &out_offset);
  clSetKernelArg(kernel, argIndex++, sizeof(unsigned int), &elems);
  // set global worksize
  const size_t global_work_size[3] = {elems, 1, 1};

  // enqueueNDRangeKernel
  clEnqueueNDRangeKernel(queue, kernel, 1, NULL, global_work_size, NULL, 0, NULL,
NULL);

  // finish command queue
  clFinish(queue);

  // //cpu access data after sync to device
  // rknn_mem_sync(&outputs[0].mem, RKNN_MEMORY_SYNC_FROM_DEVICE);
  // // save output npy
  // char output_path[PATH_MAX];
  // sprintf(output_path, "%s/cpu_output%d.npy", ".", 0);
  // unsigned char* out_data = (unsigned char*)outputs[0].mem.virt_addr+outputs[0].mem.offset;
  // save_npy(output_path, (float*)out_data, &inputs[0].attr);
  return 0;
}
4.2.1.4.1.4 Callback Destroy
Освобождает временные либо входные/выходные буферы пользовательского оператора. Пример освобождения временного буфера:
Оператор CPU
/**
* cpu kernel destroy callback for custom op
*/
int custom_op_destroy_callback(rknn_custom_op_context* op_ctx)
{
  printf("custom_op_destroy_callback\n");
  // clear tmp buffer
  free(op_ctx->priv_data);
  return 0;
}
Оператор GPU
/**
* opencl kernel destroy callback for custom op
*/
int relu_destroy_callback_gpu(rknn_custom_op_context* op_ctx)
{
  // clear tmp buffer
  printf("relu_destroy_callback_gpu\n");
  cl_mem* memObject = (cl_mem*)op_ctx->priv_data;
  clReleaseMemObject(memObject[0]);
  clReleaseMemObject(memObject[1]);
  free(memObject);
  return 0;
}
4.2.1.4.2 Регистрация пользовательского оператора
После настройки rknn_custom_op зарегистрируйте его в rknn_context через rknn_register_custom_ops(). Можно одновременно зарегистрировать несколько операторов.
После реализации compute CPU-оператора зарегистрируйте cstSoftmax и ArgMax, например:
Оператор CPU
// CPU operators
rknn_custom_op user_op[2];
memset(user_op, 0, 2 * sizeof(rknn_custom_op));
strncpy(user_op[0].op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op[0].version = 1;
user_op[0].target = RKNN_TARGET_TYPE_CPU;
user_op[0].init = custom_op_init_callback;
user_op[0].compute = compute_custom_softmax_float32;
user_op[0].destroy = custom_op_destroy_callback;

strncpy(user_op[1].op_type, "ArgMax", RKNN_MAX_NAME_LEN - 1);
user_op[1].version = 1;
user_op[1].target = RKNN_TARGET_TYPE_CPU;
user_op[1].init = custom_op_init_callback;
user_op[1].compute = compute_custom_argmax_float32;
user_op[1].destroy = custom_op_destroy_callback;

ret = rknn_register_custom_ops(ctx, user_op, 2);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
Оператор GPU
Ядро OpenCL GPU-оператора регистрируется строкой-константой или путем к файлу. При cl_source_size=0 в rknn_custom_op поле cl_kernel_source обозначает путь; при cl_source_size>0 — строку функции ядра. Пример строки ядра relu:
char* cl_kernel_source = "#pragma OPENCL EXTENSION cl_arm_printf : enable"
    "#pragma OPENCL EXTENSION cl_khr_fp16 : enable "
    " __kernel void relu_float(__global const float* input, __global float* output, int "
    "in_offset, int out_offset, const unsigned int elems) "
    "{"
    " int gid = get_global_id(0);"
    " if (gid < elems) {"
    " float in_value = input[in_offset + gid];"
    " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
    " }"
    "}"
    "__kernel void relu_half(__global const half* input, __global half* output, int in_offset, "
    "int out_offset, const unsigned int elems)"
    "{"
    " int gid = get_global_id(0);"
    " if (gid < elems) {"
    " half in_value = input[in_offset + gid];"
    " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
    " }"
    "}";
После реализации ядра OpenCL и GPU callback compute заполните массив rknn_custom_op и зарегистрируйте GPU-оператор. Пример:
// GPU operators
rknn_custom_op user_op[1];
memset(user_op, 0, sizeof(rknn_custom_op));
strncpy(user_op->op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op->version = 1;
user_op->target = RKNN_TARGET_TYPE_GPU;
user_op->init = relu_init_callback_gpu;
user_op->compute = compute_custom_relu_float32;
user_op->destroy = relu_destroy_callback_gpu;
#ifdef LOAD_FROM_PATH
user_op->cl_kernel_source = "./custom_op.cl";
user_op->cl_source_size = 0;
#else
user_op->cl_kernel_source = cl_kernel_source;
user_op->cl_source_size = strlen(cl_kernel_source);
#endif
strcpy(user_op->cl_kernel_name, "relu_float");

ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
До регистрации четко определите op_type, подготовьте сведения оператора и массив rknn_custom_op. Каждый тип регистрируется один раз; несколько операторов того же типа в сети не требуют повторной регистрации.
4.2.1.4.3 Инференс модели
После регистрации всех операторов выполните инференс через обычный API или API нулевого копирования.
4.2.1.4.4 Анализ точности с подключенным устройством
Для отладки пользовательских операторов с подключенной платой нужен rknn_server версии >= 1.6.0.
При отладке с платой RKNN Server вызывает dlopen для библиотеки пользовательского оператора в специальном каталоге и получает сведения об операторе. Для регистрации через плагин необходимо реализовать get_rknn_custom_op.
Для анализа точности модели с такими операторами на подключенном устройстве:
- Реализуйте get_rknn_custom_op() и нужные callback, скомпилируйте библиотеку для целевой системы. Имя должно начинаться с librkcst_, например librkcst_relu.so.
2 Поместите плагин в /vendor/lib64/ для Android arm64-v8a либо /usr/lib/rknpu/op_plugins для Linux.
- Используйте Python API RKNN-Toolkit2 на хосте для анализа точности на подключённом устройстве.
Пример get_rknn_custom_op:
std::vector<std::string> get_all_plugin_paths(std::string plugin_dir)
{
  std::vector<std::string> plugin_paths;
  if (access(plugin_dir.c_str(), 0) != 0) {
    fprintf(stderr, "Can not access plugin directory: %s, please check it!\n",
plugin_dir.c_str());
  }

  DIR* dir;
  struct dirent* ent;
  const char* prefix = RKNN_CSTOP_PLUGIN_PREFIX; // All library file names should start with this prefix

  if ((dir = opendir(plugin_dir.c_str())) != NULL) {
    while ((ent = readdir(dir)) != NULL) {
      if (ent->d_type == DT_REG) {
        const char* filename = ent->d_name;
        size_t len = strlen(filename);

        if (len > 10 && strncmp(filename, prefix, strlen(prefix)) == 0) {
         printf("Found plugin: %s file in %s\n", filename, plugin_dir.c_str());
         plugin_paths.push_back(plugin_dir + "/" + filename);
        }
      }
    }
    closedir(dir);
  } else {
    fprintf(stderr, "Unable to open directory");
  }

  return plugin_paths;
}

// the default path of the custom operator plugin libraries
std::string plugin_dir =
#if defined(__ANDROID__)
# if defined(__aarch64__)
    "/vendor/lib64/";
# else
    "/vendor/lib/";
# endif // __aarch64__
#elif defined(__linux__)
    "/usr/lib/rknpu/op_plugins/";
#endif

std::vector<std::string> plugin_paths = get_all_plugin_paths(plugin_dir);
std::vector<void*> so_handles;
for (auto path : plugin_paths) {
printf("load plugin %s\n", path.c_str());
void* plugin_lib = dlopen(path.c_str(), RTLD_NOW);
char* error = dlerror();
if (error != NULL) {
    fprintf(stderr, "dlopen %s fail: %s.\nPlease try to set 'export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:%s'\n",
           path.c_str(), error, plugin_dir.c_str());
    dlclose(plugin_lib);
    return -1;
}
printf("dlopen %s successfully!\n", path.c_str());
get_custom_op_func custom_op_func = (get_custom_op_func)dlsym(plugin_lib,
"get_rknn_custom_op");
error = dlerror();
if (error != NULL) {
    fprintf(stderr, "dlsym fail: %s\n", error);
    dlclose(plugin_lib);
    return -1;
}

rknn_custom_op* user_op = custom_op_func();
ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
    printf("rknn_register_custom_ops fail! ret = %d\n", ret);
    return -1;
}
so_handles.push_back(plugin_lib);
}
Примечания к плагину:
Одна библиотека регистрирует только один оператор. Для нескольких операторов создайте несколько библиотек.
Имя библиотеки должно начинаться с librkcst_ и заканчиваться .so.
При реализации на C++ перед и после определения функции добавьте следующие макросы, чтобы C-интерфейс правильно открывал символы:
#ifdef __cplusplus
extern "C" {
#endif

//code

#ifdef __cplusplus
} // extern "C"
#endif
Если dlopen не загружает библиотеку, проверьте LD_LIBRARY_PATH и наличие каталога плагина в перечисленных путях.