
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 20/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
5.2 Анализ и оптимизация производительности
После получения корректных результатов развёрнутой модели обычно требуется улучшить производительность. Раздел описывает настройку в рамках полного процесса оптимизации, затем подробно рассматривает наиболее частые операции: анализ производительности, оптимизацию графа и оптимизацию операторов. Полный процесс показан ниже:
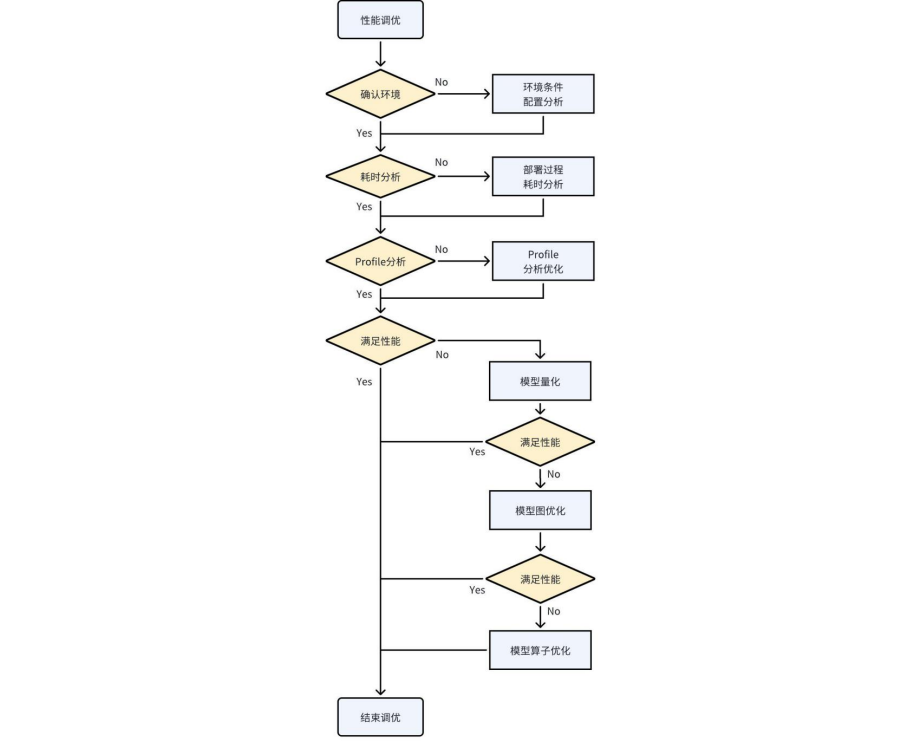
Рисунок 5-2. Процесс оптимизации производительности модели
5.2.1 Порядок анализа производительности модели
5.2.1.1 Проверка среды выполнения
Перед анализом и оптимизацией установите базовые условия тестовой среды. Измерения имеют смысл только при одинаковых условиях. Например, без фиксации частот производительность одной и той же модели значительно колеблется; время серии тестов нельзя считать средним временем одного кадра.
При проверке и настройке тестовой среды учитывайте следующие аспекты:
Проверка и настройка частот CPU, DDR и NPU
Фиксированная частота напрямую влияет на скорость: более высокая частота обычно повышает производительность, но зависимость нелинейна. Повышение частоты также увеличивает энергопотребление. Команды фиксации частот: https://github.com/airockchip/rknn_model_zoo/blob/main/scaling_frequency.sh
Можно также включить режим производительности следующей командой:
echo performance | tee $(find /sys/ -name *governor) /dev/null || true
Проверка версии драйвера ядра NPU
Оптимизация некоторых функций и операторов зависит от версии драйвера ядра: новые версии позволяют использовать новые низкоуровневые реализации. Проверьте, достаточно ли актуален драйвер. Сейчас рекомендуется версия новее 0.9.2; это обновление не является обязательным.
Команды проверки версии драйвера ядра:
cat /sys/kernel/debug/rknpu/version # for RK3566/RK3568/RK3588/RK3562/RK3576
cat /proc/rknpu/version # for RV1106 series/RV1103 series/RV1126B
- Проверка загрузки NPU
Загрузка NPU — доля времени выполнения задач за единицу времени; она отражает занятость NPU. Низкая загрузка означает длительное ожидание задач. Проверьте затраты времени на копирование ввода/вывода, предобработку и постобработку приложения. Повысить загрузку можно также многопоточной обработкой.
Загрузка NPU не равна фактическому использованию MAC. Использование MAC показывает эффективность выполнения задач аппаратными блоками NPU.
Команды проверки загрузки NPU:
cat /sys/kernel/debug/rknpu/load
# or
cat /proc/debug/rknpu/load
5.2.1.2 Анализ времени развёртывания
Общее время делится на работу приложения, копирование входов/выходов и инференс модели. Распределение времени помогает определить приоритеты оптимизации. Каждый этап можно измерить временными метками в приложении.
Время приложения:
Это время инференс-процесса, не связанное с NPU: обычно предобработка, постобработка и логика программы. Пользователь полностью контролирует эту часть. Если её доля велика, помимо упрощения и оптимизации кода можно ускорить отдельные операции специализированным оборудованием.
Например, матричные умножения и сложения можно ускорить через Matmul API с участием NPU, а масштабирование изображений — через RGA.
Время копирования входов/выходов:
Обычный API копирует данные между входной/выходной памятью и памятью NPU; это время можно вывести при вызове API. Оно зависит от DDR и CPU. Для малых данных затраты невелики, для больших ими нельзя пренебрегать. Поэтому рекомендуется zero-copy API.
При zero-copy NPU напрямую обращается к входной/выходной памяти. Подробнее см. раздел интерфейса RKNN Runtime Zero-Copy.
Время инференса:
Время инференса NPU зависит от размера модели, версии оптимизаций компилятора и других факторов. Время, выводимое RKNN LOG, различается при разных RKNN_LOG_LEVEL, поскольку вывод журнала сам занимает время.
Обычно для измерения одного кадра задают уровень LOG 1 и усредняют несколько запусков.
5.2.2 Анализ производительности
5.2.2.1 Получение профиля
Чтобы узнать послойное время вывода, перед запуском программы введите следующую команду для подробного вывода информации:
export RKNN_LOG_LEVEL=4
./run_rknn_test ./test.rknn ./input.jpg
На Android подробные журналы после запуска можно получить через logcat.
При использовании RKNN-Toolkit2 время каждого слоя получают следующим способом:
rknn.init_runtime(target=platform, perf_debug=True)
rknn.eval_perf()
Отчёт анализа показан ниже; приведены только части, относящиеся к производительности.
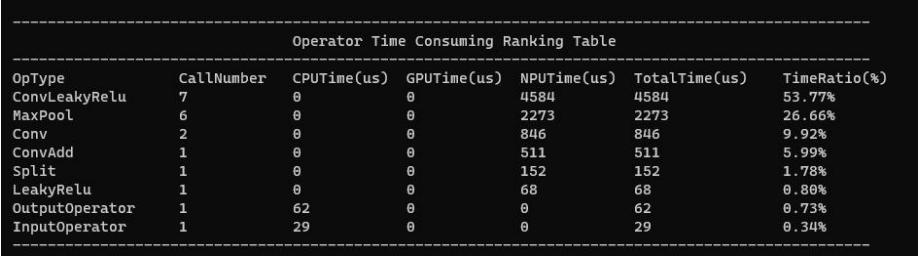
Рисунок 5-3. Отчёт анализа производительности
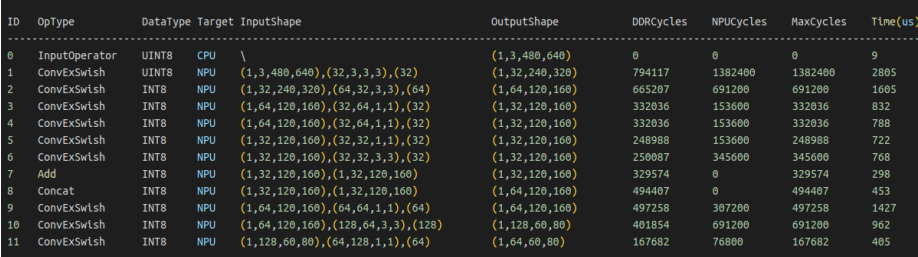
Рисунок 5-4. Отчёт анализа производительности
Общий и послойный профили позволяют быстро найти нужные данные и выбрать приоритеты оптимизации. После получения профиля исследуйте время каждого слоя для поиска дорогих операторов, влияние операторов вне NPU и узкие места операторов NPU. Далее эти аспекты рассмотрены подробно.
5.2.2.2 Послойный анализ времени
В столбце Time на рисунке можно найти наиболее длительные операторы и оптимизировать их первыми. По Op Type проверьте, относятся ли они к одному OpType, чтобы оптимизировать их совместно.
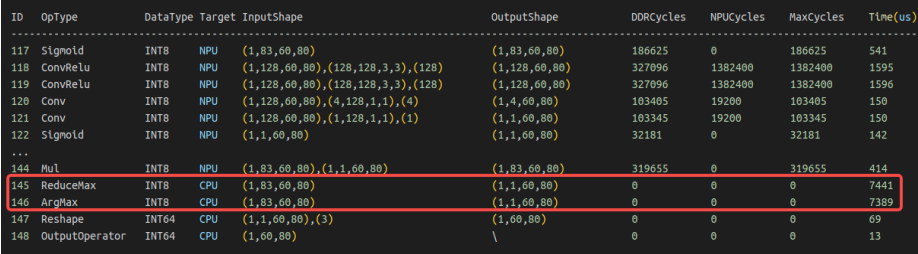
Рисунок 5-5. Анализ длительных операторов
Длительный оператор не обязательно неэффективен: некоторые требуют большого объёма вычислений. При высокой загрузке MAC стоит уменьшить размер или масштаб оператора. Однако если длительные операторы имеют очень низкую загрузку, именно они должны стать приоритетом оптимизации.
5.2.2.3 Влияние операторов CPU
На рисунке некоторые длительные операторы выполняются на CPU. Перенос на NPU может значительно уменьшить их влияние. Как правило, многие проблемы производительности решаются после переноса CPU-операторов на NPU; уделяйте времени CPU-операторов особое внимание.
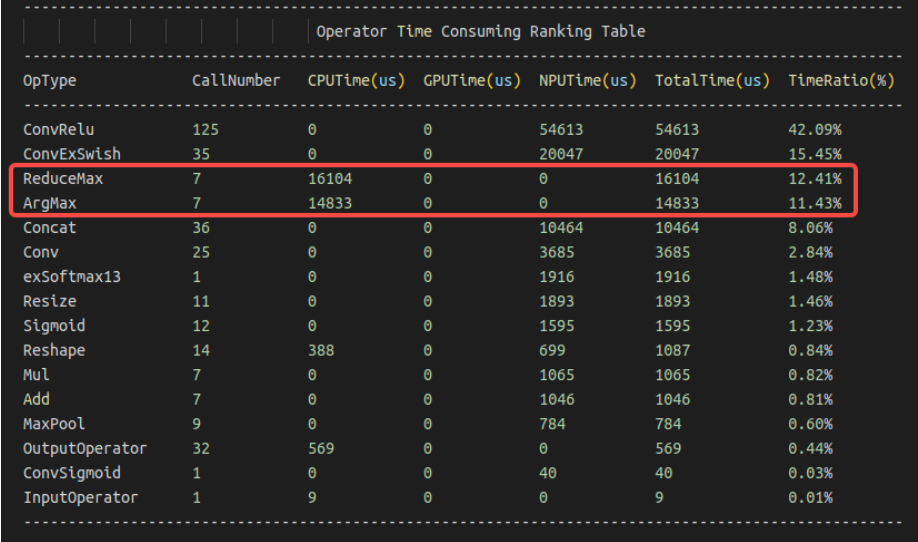
Рисунок 5-6. Анализ производительности CPU-операторов
Обычно оператор выполняется вне NPU по следующим причинам:
Размер оператора превышает предел; проверьте ограничения размеров в документе OpList.
Выполнение оператора на NPU пока не поддерживается; проверьте OpList. Можно создать issue в проекте Github.
Поддержку исключают аппаратные ограничения NPU; проверьте возможность эквивалентной замены алгоритма поддерживаемой реализацией.
5.2.2.4 Анализ узких мест операторов NPU
Для длительных операторов NPU столбцы DDR Cycles/NPU Cycles/Total Cycles позволяют определить теоретическое ограничение: пропускная способность или вычислительная мощность. DDR Cycles выражает время чтения и записи слоя в тактах NPU, поэтому его можно непосредственно сравнивать с NPU Cycles.
Как показано ниже:
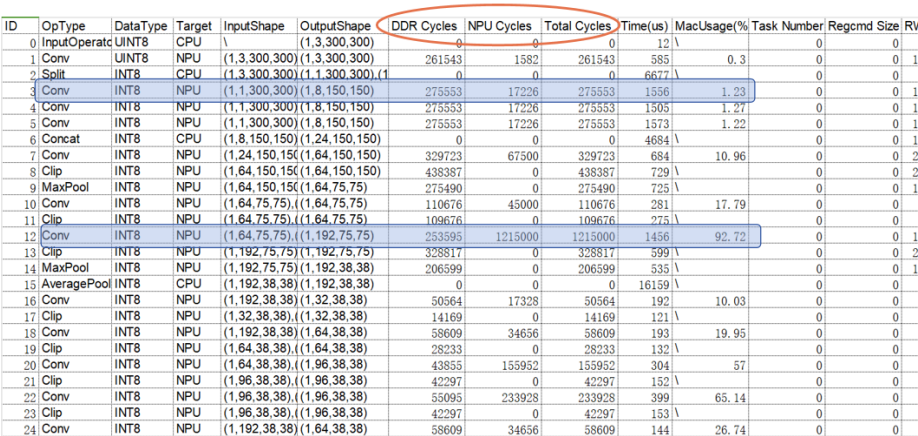
Рисунок 5-7. Анализ узких мест операторов NPU
У третьего слоя DDR Cycles значительно больше NPU Cycles: чтение и запись занимают больше тактов, чем вычисления. Следовательно, этот Conv ограничен пропускной способностью.
У двенадцатого слоя DDR Cycles значительно меньше NPU Cycles: обмен данными занимает меньше тактов, чем вычисления. Следовательно, этот Conv ограничен вычислительной мощностью.
Сейчас NPU Cycles в основном показывает такты Conv; другие типы операторов будут добавляться постепенно.
5.2.3 Ускорение квантованием
Квантование существенно уменьшает вычисления и расход пропускной способности. Кроме того, вычислительная мощность INT8 у NPU значительно выше FP16, поэтому модель может сильно ускориться. Рекомендуется развёртывать квантованные модели; способы описаны во введении в квантование.
5.2.4 Оптимизация графа
Оптимизация графа позволяет координировать улучшения модели в целом. После выявления длительных операторов или подграфов граф можно преобразовывать разными способами. Основные цели — убрать избыточные операторы, перенести операции на NPU и использовать эффективные для оборудования операторы. Цели иногда противоречат друг другу: перенос на NPU может потребовать дополнительных операторов. Это формально увеличивает их число, но оправдано улучшением общей производительности инференса.
RKNN-Toolkit2 уже частично оптимизирует граф при преобразовании модели. Однако этот процесс не универсален: в неучтённых сценариях остаются лишние операции. Пользователь может предварительно оптимизировать граф по идеям этого раздела. Методы носят ознакомительный, необязательный характер и применяются гибко по ситуации.
5.2.4.1 Перенос OP на NPU
Для операторов вне NPU можно выполнить эквивалентные преобразования графа, заменив их операторами, поддерживаемыми NPU, и тем самым перенести вычисления на NPU.
Например, в shufflenetv2_0.5 операция channel shuffle заменяется приближённой свёрткой с весами 0/1, переставляющей данные. Если Transpose и Reshape недоступны на NPU, их можно объединить в Conv, выполняющий ту же перестановку.
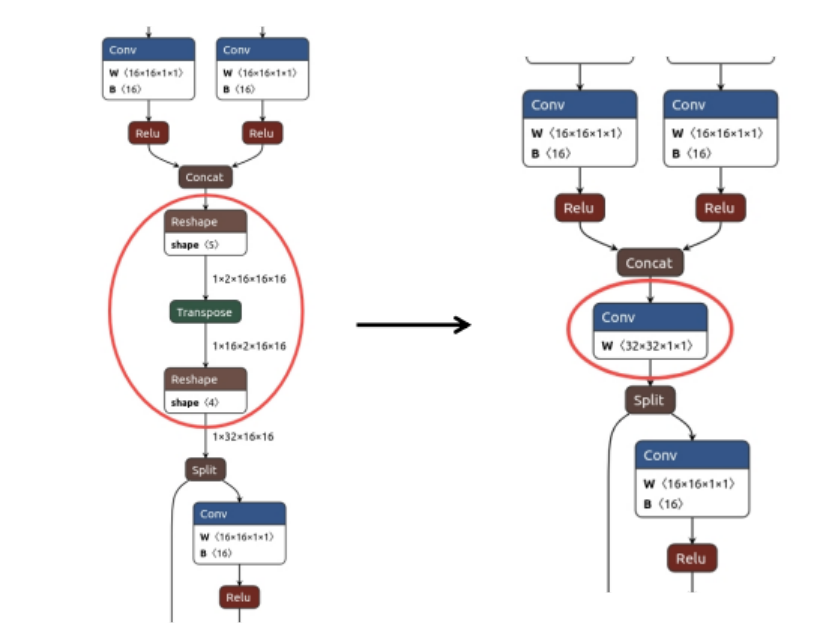
Рисунок 5-8. Перестановка данных свёрткой
5.2.4.2 Аппаратное слияние при проектировании сети и оптимизации графа
NPU поддерживает слияние некоторых сочетаний операторов. Порядок операций можно подстроить под правила слияния NPU, чтобы получить такую оптимизацию.
Программный стек RKNN оптимизирует граф, но не охватывает все случаи. Иногда структура графа теоретически допускает слияние и упрощение, которые итоговая оптимизация не выполняет. Ручная корректировка алгоритма позволяет быстро устранить такую проблему.
Например, перестановка Transpose и Clip без изменения результата позволяет слить Conv и Clip и повысить производительность.
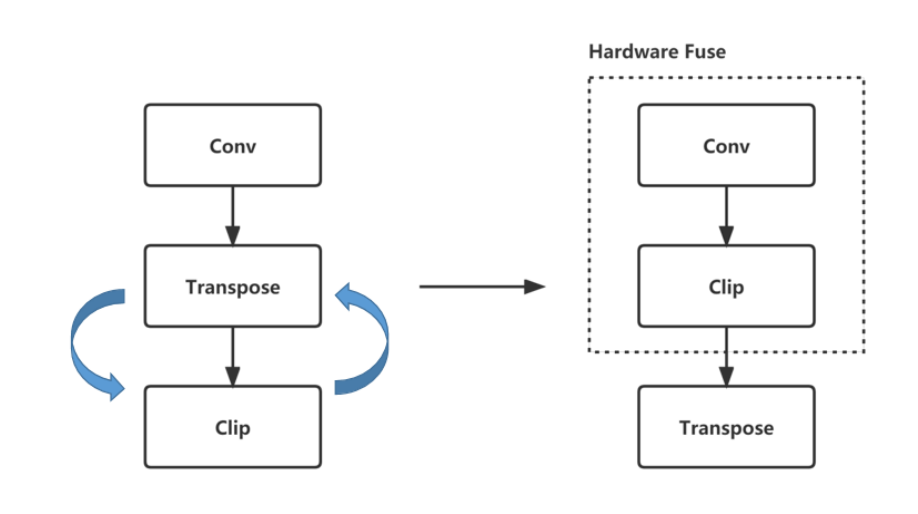
Рисунок 5-9. Оптимизация и слияние графа операторов
Учитывайте правила слияния при проектировании. Правила следующие:
| Поддерживаемые правила слияния | Правила слияния, запланированные на будущее |
|---|---|
| Conv+Relu | Activation+Add(Mul) |
| Conv+PRelu(LeakyRelu) | Add(Mul)+Activation |
| Conv+Clip | Conv+Mul |
| Conv+Sigmoid(Tanh/Elu/Silu…) | Conv+Activation+Mul |
| Conv+Add | Conv+Activation+Pooling |
| Conv+Activation+Add | Conv+Activation+Add(Mul)+Pooling |
5.2.4.3 Преобразование подграфа
При проектировании участка графа иногда предпочитают наглядность, не учитывая влияние на реальную производительность, и получают сложные избыточные структуры. Эквивалентное преобразование подграфа в один OP уменьшает число вычислительных шагов и оптимизирует выполнение.
На рисунке показано эквивалентное преобразование Yolov5-nano: несколько сложных извлечений данных Slice объединяются в новый Conv, значительно упрощая граф.
Источник решения: https://github.com/ultralytics/yolov5/issues/4825
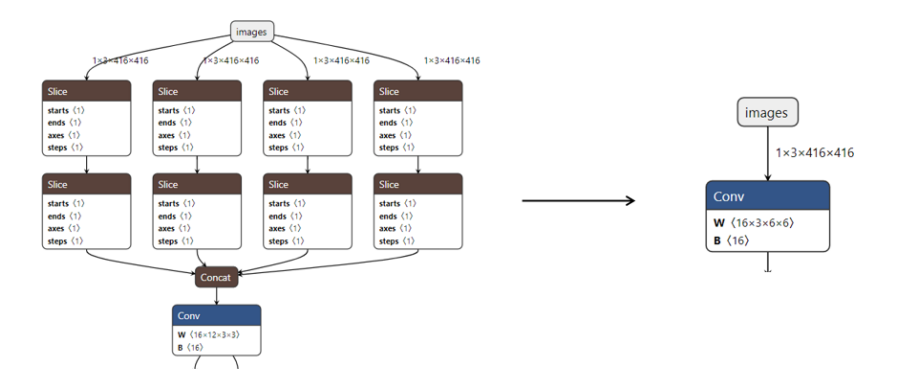
Рисунок 5-10. Эквивалентное преобразование графа операторов
5.2.4.4 «Приведение подобных» и «Вынесение общего множителя»
Последовательные вычисления некоторых операторов можно упростить и объединить в один оператор: например, Reshape, Transpose, Slice и некоторые Add/Mul/Sub/Div.
На рисунке простая перестановка графа позволяет объединить однотипные операторы.
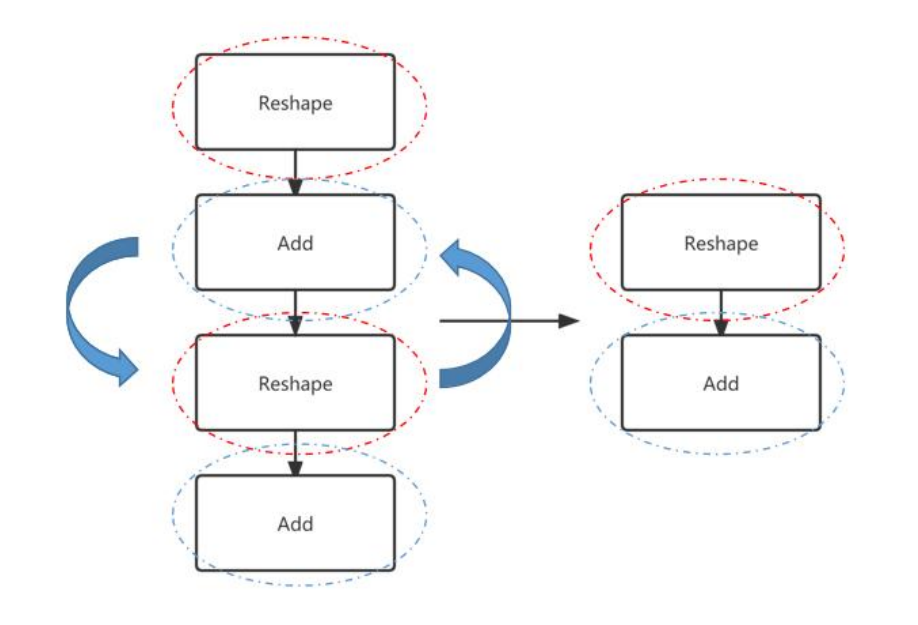
Рисунок 5-11. Объединение однотипных операторов
В некоторых графах есть общие части с однотипными операциями; их можно переставить и выделить в одну операцию.
На рисунке изменение порядка операторов позволяет вынести повторяющиеся однотипные операторы, чтобы выполнять операцию только один раз.
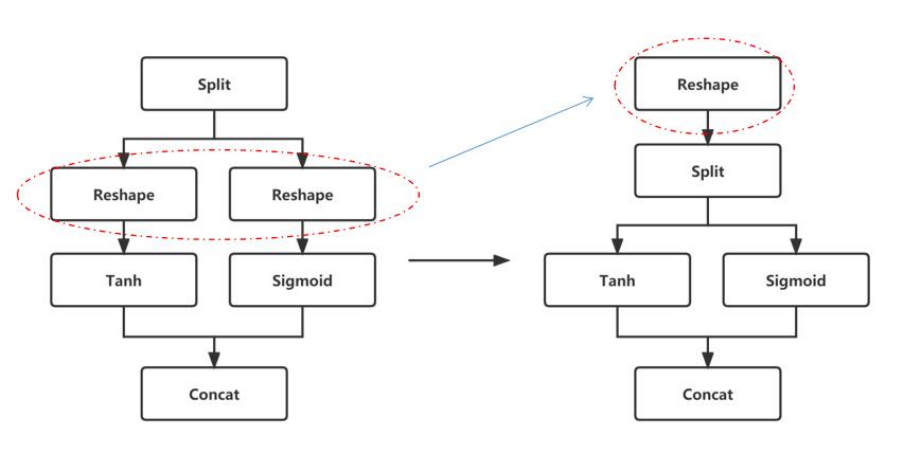
Рисунок 5-12. Объединение повторяющихся операторов
5.2.5 Оптимизация отдельных операторов
Оптимизация операторов — точная адресная настройка, изменяющая отдельные операторы для повышения производительности. Чаще всего выбирают размеры, при которых аппаратная реализация наиболее эффективна. Например, при близких размерах время выровненного и невыровненного оператора может сильно отличаться: для невыровненных размеров аппаратуре нужны дополнительные избыточные действия ради корректности. Поэтому выбор размеров существенно влияет на модель. Следующие подходы позволяют учитывать это заранее.
5.2.5.1 Размеры OP, удобные для DDR (необязательно)
Некоторые выровненные размеры повышают не только эффективность вычислений NPU, но и удобство чтения/записи DDR. При одинаковой пропускной способности более эффективный обмен повышает использование DDR и производительность. Ниже приведены рекомендуемые, но необязательные правила размеров.
Выравнивание channel по требуемой кратности
Таблицы выравнивания приведены ниже:
Таблица 5-1. RK3566/RK3568
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Входной channel | Выходной channel | Входной и выходной channel | Входной и выходной channel |
| Int8 | 32 | 16 | 32 | 8 |
| Int16 | 16 | 8 | 16 | 4 |
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Входной channel | Выходной channel | Входной и выходной channel | Входной и выходной channel |
| Float16 | 16 | 8 | 16 | 4 |
| BFloat16 | 16 | 8 | 16 | 4 |
Таблица 5-2. RK3588/RK3576/RV1126B
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Входной channel | Выходной channel | Входной и выходной channel | Входной и выходной channel |
| Int8 | 32 | 32 | 64 | 16 |
| Int16 | 32 | 16 | 32 | 8 |
| Float16 | 32 | 16 | 32 | 8 |
| BFloat16 | 32 | 16 | 32 | 8 |
| TFloat32 | 16 | 16 | 16 | 4 |
Таблица 5-3. RV1106/RV1103
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Входной channel | Выходной channel | Входной и выходной channel | Входной и выходной channel |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 16 | 16 | 16 | 8 |
Таблица 5-4. RK3562
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Входной channel | Выходной channel | Входной и выходной channel | Входной и выходной channel |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 32 | 8 | 16 | 8 |
| Float16 | 32 | 8 | 16 | 8 |
| BFloat16 | 32 | 8 | 16 | 8 |
| TFloat32 | 16 | 8 | 8 | 4 |
4 Выравнивание по 4 при Height * Width > 1
Для одинакового объёма вычислений большее Width и меньшее Height удобнее для DDR. На рисунке эффективность свёртки справа выше, чем слева.
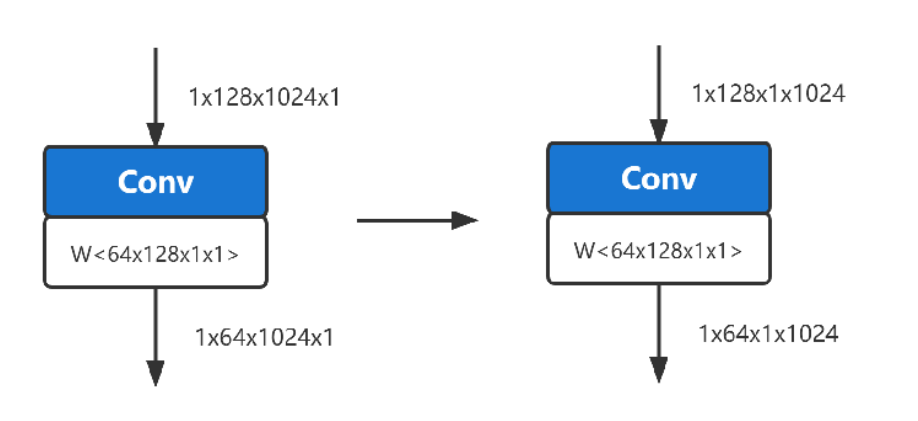
Рисунок 5-13. Сравнение свёрток одинакового масштаба
5.2.5.2 Проектирование операторов с высокой утилизацией
Для высокого использования вычислительных ресурсов нужно избегать неэффективных операторов и выбирать размеры, обеспечивающие высокую утилизацию. Далее перечислены нежелательные операторы и рассмотрена связь размера свёртки с утилизацией.
Избегайте неэффективных операторов
По возможности уменьшайте количество следующих трёх типов операторов.
Таблица 5-5. Три типа неэффективных операторов
| Перемещение данных | Изменение размера | Функция активации, отличная от Relu |
|---|---|---|
| Transpose | Resize | Sigmoid |
| Reshape | Tile | Tanh |
| Split | Pooling | Softplus |
| Concat | Pad | Hardswish |
Связь размера свёртки с утилизацией
На свёртку влияют и вычислительная мощность, и пропускная способность. Поэтому при оценке производительности часто используют утилизацию MAC как показатель использования аппаратной вычислительной мощности.
Эта связь рассматривается как ориентир при проектировании моделей. Ниже приведены приблизительные рекомендации на основе эмпирических данных:
Обозначения: KH — высота ядра, KW — ширина ядра, KC — число каналов ядра, type_bytes — разрядность веса, делённая на 8, Ksize — KW или KH, Kstride — шаг в направлении KW или KH.
Если число каналов входного и выходного Tensor свёртки отвечает требованиям выравнивания (см. таблицу в 8.4.1), утилизация выше.
При числе каналов входного Tensor < 256 утилизация относительно высокая. При > 512 она постепенно снижается с ростом числа каналов.
Для размера весов утилизация относительно высока при KH* KW * KC * type_bytes < 6K Bytes. После превышения некоторого размера она заметно падает.
Чем больше отношение Ksize / Kstride, тем выше утилизация. Например, Ksize=3, Kstride=1 лучше, чем Ksize=2, Kstride=1.
Утилизация снижается при Height * Width выходного Tensor < 16.
Чем больше Channel выходного Tensor, тем выше утилизация.
Выше отдельные размеры рассматривались независимо. Реальная утилизация MAC свёртки в развёрнутой модели определяется сочетанием многих факторов.
5.2.5.3 Слияние подграфов
Стек RKNN распознаёт определённые связи в графе и преобразует их в пользовательские операторы, как показано ниже. Если слияние не произошло, проверьте, не отличаются ли связи, из-за чего шаблон не совпал.
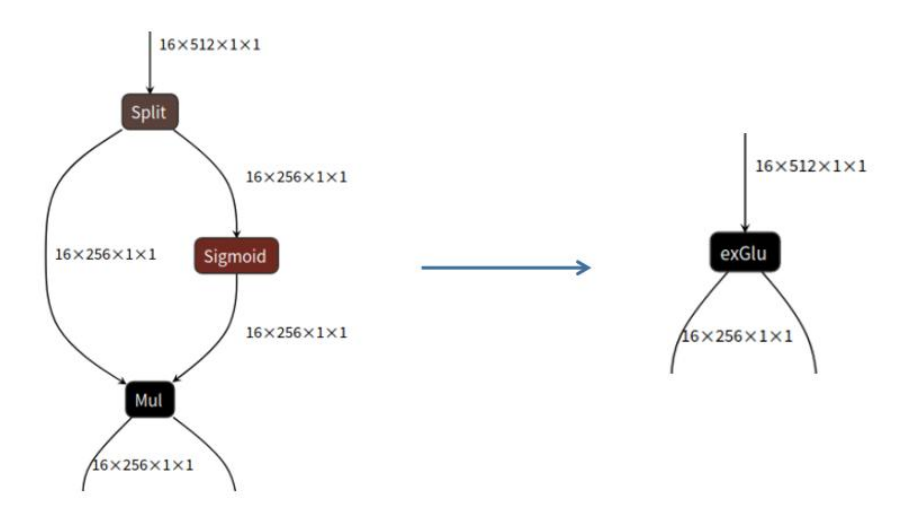
Рисунок 5-14. Слияние подграфа Glu
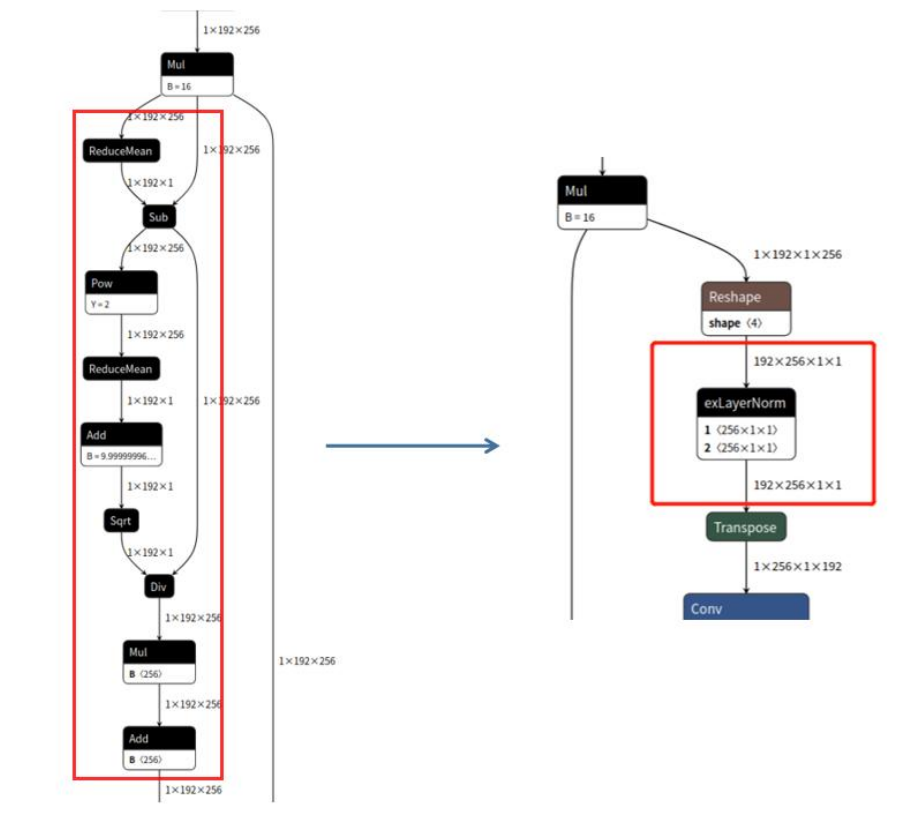
Рисунок 5-15. Слияние подграфа LayerNorm
В настоящее время поддерживаются следующие правила слияния подграфов:
Split + Sigmoid + Mul -> GLU
ReduceMean + Sub + Pow + ReduceMean + Add + Sqrt + Div (+ Mul + Add) -> LayerNorm