
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 16/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
4.1.6 Согласованность кэшируемой памяти
Если CPU и NPU обращаются к одной кэшируемой памяти, CPU сохраняет данные в кэше. Несогласованность данных DDR, читаемых NPU, с кэшем CPU вызывает ошибки чтения. Поэтому интерфейс обновления кэша должен обеспечивать согласованность данных CPU и NPU. Здесь описаны направление синхронизации и использование rknn_mem_sync.
4.1.6.1 Направление синхронизации кэшируемой памяти
После записи CPU перед доступом NPU данные кэша CPU должны быть синхронизированы в DDR: направление CPU→NPU. После записи NPU перед чтением CPU нужно обеспечить согласованность DDR и кэша CPU: направление NPU→CPU. RKNN C API предоставляет перечисление rknn_mem_sync_mode для выбора направления. Структура:
/*
  The mode to sync cacheable rknn memory.
*/
typedef enum _rknn_mem_sync_mode {
RKNN_MEMORY_SYNC_TO_DEVICE = 0x1, /* the mode used for consistency of device access after CPU accesses
data. */
RKNN_MEMORY_SYNC_FROM_DEVICE = 0x2, /* the mode used for consistency of CPU access after device
accesses data. */
RKNN_MEMORY_SYNC_BIDIRECTIONAL =
  RKNN_MEMORY_SYNC_TO_DEVICE | RKNN_MEMORY_SYNC_FROM_DEVICE, /* the mode used for
consistency of data access
between device and CPU in both directions. */
} rknn_mem_sync_mode;
RKNN_MEMORY_SYNC_TO_DEVICE: синхронизация от CPU к NPU.
RKNN_MEMORY_SYNC_FROM_DEVICE: синхронизация от NPU к CPU.
RKNN_MEMORY_SYNC_BIDIRECTIONAL: двунаправленная синхронизация NPU и CPU. Используется, если направление данных неизвестно.
Если направление известно, рекомендуется однонаправленное обновление кэша CPU, чтобы избежать потерь производительности от лишних операций.
4.1.6.2 Синхронизация кэшируемой памяти
Определив направление, синхронизируйте память через rknn_mem_sync. Форма интерфейса:
int rknn_mem_sync(rknn_context context, rknn_tensor_mem* mem, rknn_mem_sync_mode mode);
Здесь context — контекст (на платформах, отличных от RV1103/RV1103B/RV1106/RV1106B, по умолчанию NULL), mem — указатель типа rknn_tensor_mem*, возвращаемый rknn_create_mem, а mode задаёт направление синхронизации данных.
4.1.7 Разреженный инференс модели
Функция автоматически разреживает веса Torch-модели во время обучения и использует разреженный инференс RKNN для сокращения времени. Сейчас поддерживаются только RK3576 и RK1126B (обозначение оригинала).
4.1.7.1 Принцип разреживания
Веса обнуляются во время обучения заданным пользователем способом: 4:2 по входам, 4:2 по выходам, 16:4 входы–выходы или 16:4 выходы–входы. Принцип 4:2 по входам показан на рисунке 4-9: из каждых четырёх последовательных весов по входному направлению два обнуляются. Если выбранное направление не выровнено по 4, выполняется дополнение.
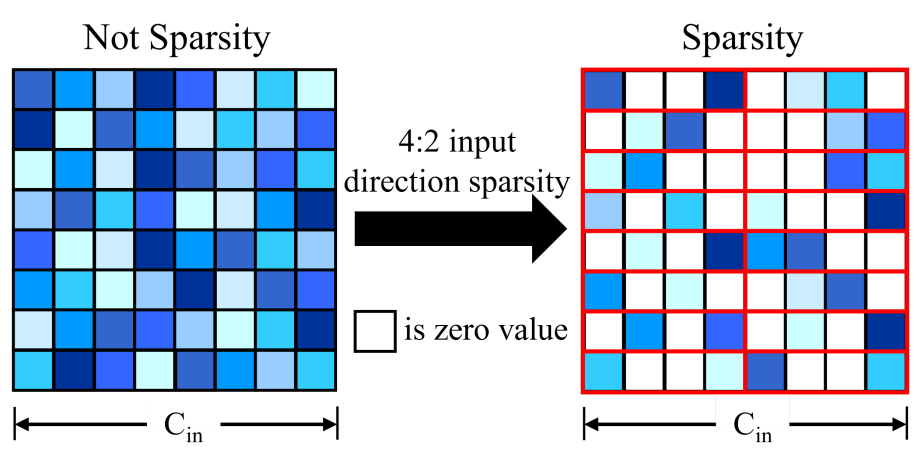
Рисунок 4-9. Принцип разреживания 4:2 по входам
Четыре метода приведены в таблице 4-8. Направления относятся к весам: для двумерной свёртки C_out×C_in×K_h×K_w вход — C_in, выход — C_out. Для разреженности 75% предварительная модель может быть плотной или разреженной. Рекомендуется модель, разреженная в одном направлении: это уменьшает потерю точности.
Таблица 4-8. Методы разреживания весов
| Метод разреживания | Степень разреженности | Описание |
|---|---|---|
| Разреживание 4:2 по входам | 50% | Разреживание весов по входному направлению |
| Разреживание 4:2 по выходам | 50% | Разреживание весов по выходному направлению |
| Разреживание 16:4 входы–выходы | 75% | Сначала 4:2 по входам, затем 4:2 по выходам |
| Разреживание 16:4 выходы–входы | 75% | Сначала 4:2 по выходам, затем 4:2 по входам |
4.1.7.2 Обучение разреженной модели
- Убедитесь в доступности cuda и установите autosparsity для своей версии Python.
pip install autosparsity-1.0-cp38-cp38m-linux_x86_64.whl
Пакет установки autosparsity находится по адресу https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/packages
- Пример обучения разреженных весов: resnet50 из torchvision с 4:2 по входам.
import torch
import torchvision.models as models
from autosparsity.sparsity import sparsity_model

if __name__ == "__main__":
  model = models.resnet50(pretrained=True).cuda()
  optimizer = None
  mode = 0
  sparsity_model(model, optimizer, mode)
  model.eval()
  x = torch.randn((1,3,224,224)).cuda()
  torch.onnx.export(
  model, x, 'resnet50.onnx', input_names=['inputs'], output_names=['outputs']
  )
Для собственной модели добавьте sparsity_model до обучения. Пример:
# insert model autosparsity code before training
    import torch
    import torchvision.models as models
    from autosparsity.sparsity import sparsity_model

    ...

    model = models.resnet34(pretrained=True).cuda()
    mode = 0
    sparsity_model(model, optimizer, mode)

# normal training
    x, y = DataLoader(args)
    for epoch in range(epochs):
        y_pred = model(x)
        loss = loss_func(y_pred, y)
        loss.backward()
        optimizer.step()
    ...
Примечание: разреженное обучение Attention требует хорошо обученной исходной модели. Сначала обучите модель с хорошей точностью, затем выполняйте разреженное обучение на её основе.
Параметры sparsity_model:
Таблица 4-9. Параметры функции sparsity_model
| Параметры | Описание |
|---|---|
| model | Исходная модель для обучения |
| Параметры | Описание |
|---|---|
| optimizer | Исходный оптимизатор; по умолчанию None |
| mode | Метод разреживания: 0, 1, 2, 3; по умолчанию 0. 0: 4:2 по входам (50%); 1: 4:2 по выходам (50%); 2: 16:4 входы–выходы (75%); 3: 16:4 выходы–входы (75%). |
| verbose | Уровень журнала: 0, 1, 2, 3; по умолчанию 2. 0: ошибки; 1: ошибки и предупреждения; 2: ошибки, предупреждения и информация. |
| whitelist | Список модулей для разреживания: 1d conv, 2d conv, 3d conv, linear, MultiheadAttention. По умолчанию [torch.nn.Linear, torch.nn.Conv2d]. |
| allowed_layer_names | Имена разрешённых слоёв. Если заданы пользователем, разреживаются только они. По умолчанию None. |
| disallowed_layer_names | Имена запрещённых слоёв. Указанные слои пропускаются. По умолчанию []. |
| fast | True включает быстрый расчёт маски, по умолчанию False. Стандартный метод не работает для некоторых моделей; при ошибке разреживания попробуйте True. |
4.1.7.3 Использование разреженного инференса RKNN
sparse_infer в config() RKNN-Toolkit2 включает или выключает разреженный инференс. Значения True/False, по умолчанию False. Пример включения:
rknn.config(target_platform=’rk3576’, sparse_infer=True)
Полный Python-пример: https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/examples
Для C API сначала создайте RKNN-модель с sparse_infer=True в config() RKNN-Toolkit2, затем используйте обычный общий или zero-copy процесс.
В Python verbose=True при создании RKNN включает журнал разреженности каждого слоя; для C API задайте RKNN_LOG_LEVEL=4. Пример журнала:
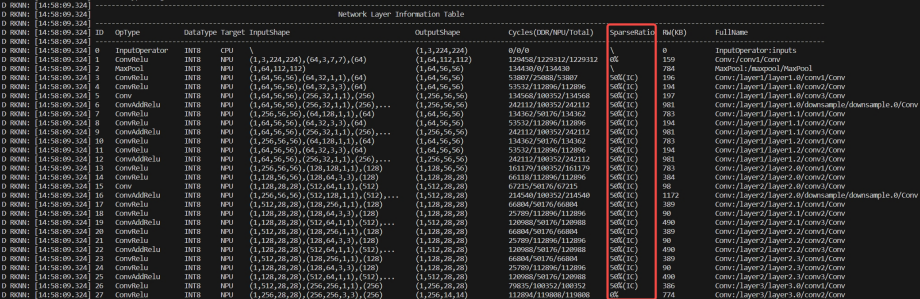
Рисунок 4-10. Python-журнал разреживания 4:2 по входам
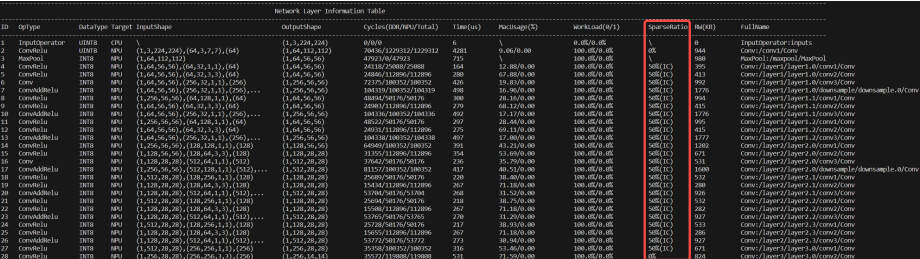
Рисунок 4-11. Журнал C API для разреживания 4:2 по входам
SparseRation обозначает разреженность: 4:2 по входам — 50% (IC), 4:2 по выходам — 50% (OC), оба порядка 16:4 — 75%. 0% означает отсутствие разреживания.
4.1.7.4 Ограничения разреженного инференса RKNN
Разреженный инференс основан на NPU и ограничен её спецификациями. На RK3576 сейчас поддерживается только 2d Conv с group=1. Остальные ограничения:
Таблица 4-10. Ограничения разреженного инференса RKNN
| Число каналов | Тип данных | |
|---|---|---|
| Разреживание 4:2 по входам | Вход и выход выровнены по 32 | Поддерживается только Int8; Float16 не поддерживается |
| Разреживание 4:2 по выходам | Вход и выход выровнены по 32 | Поддерживается только Int8; Float16 не поддерживается |
| Разреживание 16:4 входы–выходы | Вход и выход выровнены по 32 | Поддерживается только Int8; Float16 не поддерживается |
| Разреживание 16:4 выходы–входы | Вход и выход выровнены по 32 | Поддерживается только Int8; Float16 не поддерживается |