
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 11/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
4. Расширенные возможности и расширения
4.1 Расширенные возможности Runtime
4.1.1 API умножения матриц
Matmul API — отдельный набор C API Runtime для матричного умножения на NPU (RK2118 и серии RV1103/RV1106 пока не поддерживаются). Это важная операция линейной алгебры: C=AB, где A имеет размер M×K, B — K×N, C — M×N.
4.1.1.1 Возможности и применение
Matmul API преимущественно используется для вычислений параметров в глубоком обучении. Например, основные блоки распространённой архитектуры Transformer — механизм самовнимания и полносвязные слои прямого распространения — интенсивно используют матричное умножение. Поэтому его эффективность определяет общую производительность Transformer. Особенности Matmul API:
Эффективность: реализация на RKNPU сочетает высокую производительность с низким энергопотреблением.
Гибкость: загрузка RKNN-модели не нужна. Поддерживаются типичные для периферийных вычислений входы int4, int8 и float16, отдельный API выделения памяти и механизм внешней памяти, позволяющие пользователю управлять и повторно использовать память входов/выходов матриц.
4.1.1.2 Схема Matmul API
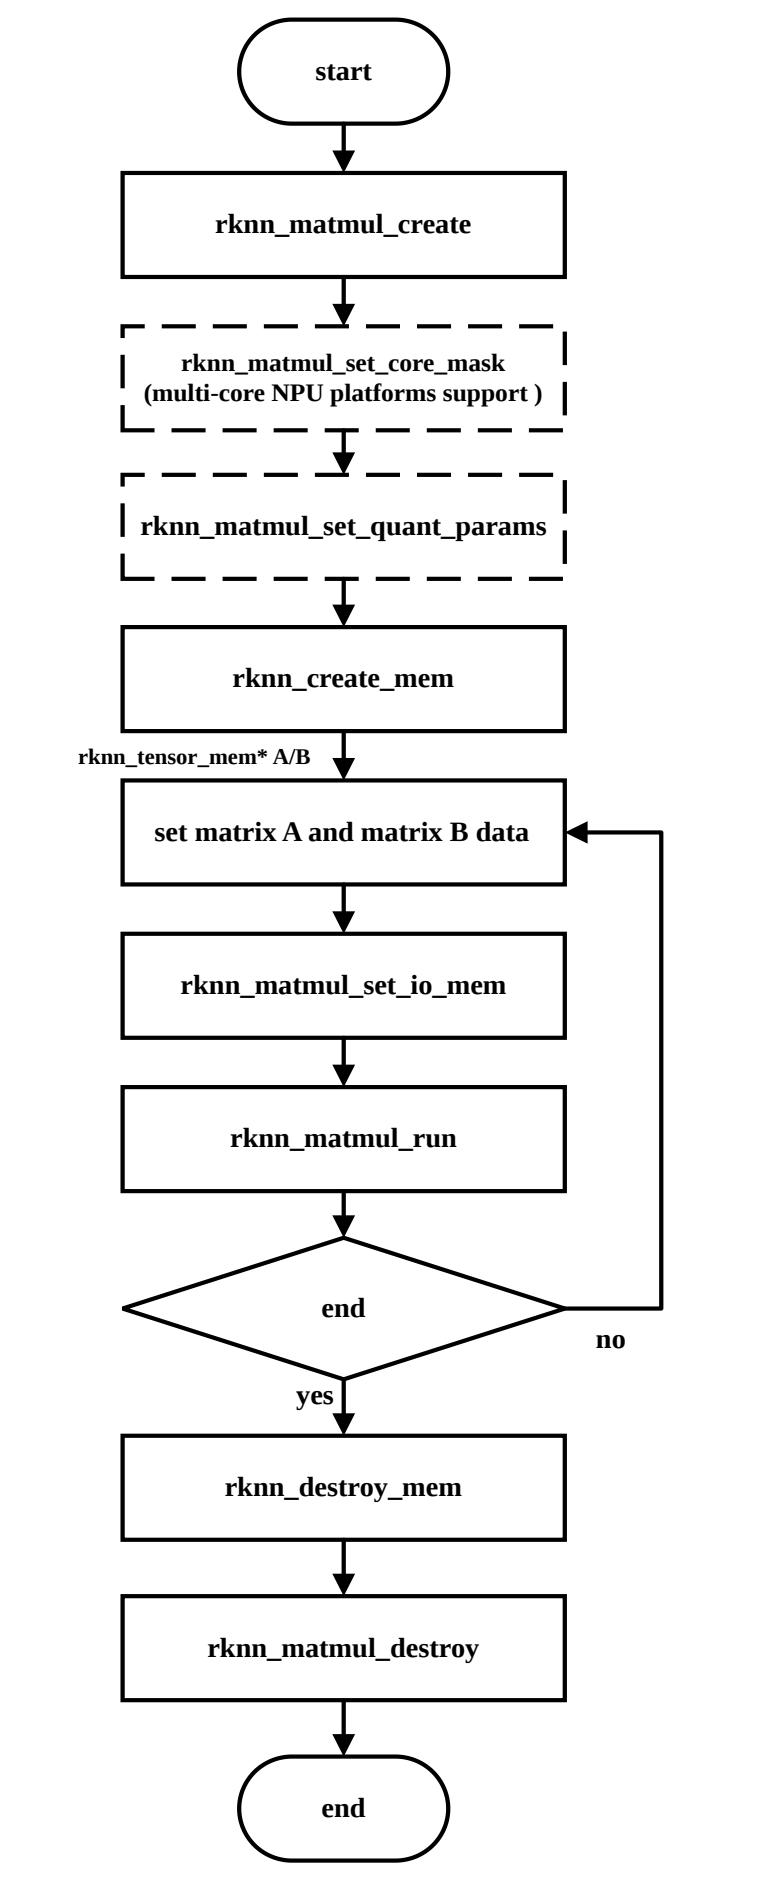
Рисунок 4-1. Базовая последовательность Matmul API
Структуры и интерфейсы Matmul API находятся в rknn_matmul_api.h; при компиляции программы включите этот заголовок. Базовая последовательность Matmul API показана выше.
Обычная последовательность работы с Matmul API:
-
Создайте контекст: задайте rknn_matmul_info с M, K, N, типами и компоновками входных/выходных матриц и другими сведениями. Вызовите rknn_matmul_create. После инициализации получите указатель rknn_matmul_io_attr со сведениями о тензорах входных/выходных матриц.
-
Задайте ядро NPU (только для многоядерных платформ): вызовите rknn_matmul_set_core_mask с маской нужного ядра. Без этого вызова на многоядерной NPU автоматически выбирается свободное ядро.
-
Задайте параметры квантования A, B и C: передайте в rknn_matmul_set_quant_params структуру rknn_quant_params соответствующих матриц. Без вызова для каждой матрицы действуют scale=1.0, zero_point=0.
-
Создайте память входа/выхода через rknn_create_mem по размерам из сведений о тензорах матриц.
-
Заполните входы A и B согласно форме и типу данных; установите параметры квантования для квантованных значений.
-
Задайте память через rknn_matmul_set_io_mem: входная матрица с данными и выходная память записываются в контекст. Помимо адресов интерфейс переставляет данные согласно настроенному layout, поэтому его вызывают после заполнения или обновления входа. Это отличается от rknn_set_io_mem в zero-copy API.
-
После настройки входной/выходной памяти вызовите rknn_matmul_run для матричного умножения.
-
После умножения прочитайте результат из выходной памяти согласно настроенному layout.
-
По завершении освободите память через rknn_destroy_mem и контекст через rknn_matmul_destroy.
4.1.1.3 Расширенное использование Matmul API
При создании контекста задайте rknn_matmul_info. Структура описывает размеры матричного умножения, типы и компоновки входных/выходных матриц. B_layout и AC_layout включают высокопроизводительные компоновки. Определение приведено в таблице:
Таблица 4-1. Структура rknn_matmul_info
| Member | Тип данных | Описание |
|---|---|---|
| M | int32_t | Число строк A |
| K | int32_t | Число столбцов A |
| Member | Тип данных | Описание |
|---|---|---|
| N | int32_t | Число столбцов B |
| type | rknn_matmul_type | Типы входных и выходных матриц: RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32: A=float16, B=float16, C=float32. RKNN_INT8_MM_INT8_TO_INT32: A=int8, B=int8, C=int32. RKNN_INT8_MM_INT8_TO_INT8: A=int8, B=int8, C=int8. RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16: A=float16, B=float16, C=float16. RKNN_FLOAT16_MM_INT8_TO_FLOAT32: A=float16, B=int8, C=float32. RKNN_FLOAT16_MM_INT8_TO_FLOAT16: A=float16, B=int8, C=float16. RKNN_FLOAT16_MM_INT4_TO_FLOAT32: A=float16, B=int4, C=float32. RKNN_FLOAT16_MM_INT4_TO_FLOAT16: A=float16, B=int4, C=float16. RKNN_INT8_MM_INT8_TO_FLOAT32: A=int8, B=int8, C=float32. RKNN_INT4_MM_INT4_TO_INT16: A=int4, B=int4, C=int16. RKNN_INT8_MM_INT4_TO_INT32: A=int8, B=int4, C=int32. |
| B_layout | int16_t | Layout B: RKNN_MM_LAYOUT_NORM: исходная форма KxN; RKNN_MM_LAYOUT_NATIVE: высокопроизводительная форма; RKNN_MM_LAYOUT_TP_NORM: транспонированная форма NxK. |
| B_quant_type | int16_t | Квантование B: RKNN_QUANT_TYPE_PER_LAYER_SYM: симметричное Per-Layer; RKNN_QUANT_TYPE_PER_LAYER_ASYM: асимметричное Per-Layer; RKNN_QUANT_TYPE_PER_CHANNEL_SYM: симметричное Per-Channel; RKNN_QUANT_TYPE_PER_CHANNEL_ASYM: асимметричное Per-Channel; RKNN_QUANT_TYPE_PER_GROUP_SYM: симметричное Per-Group; RKNN_QUANT_TYPE_PER_GROUP_ASYM: асимметричное Per-Group. |
| Member | Тип данных | Описание |
|---|---|---|
| AC_layout | int16_t | Layout A и C: RKNN_MM_LAYOUT_NORM: исходные формы; RKNN_MM_LAYOUT_NATIVE: высокопроизводительные формы. Подробнее в 4.1.1.4 «Высокопроизводительные компоновки данных». |
| AC_quant_type | int16_t | Квантование A и C: RKNN_QUANT_TYPE_PER_LAYER_SYM: симметричное Per-Layer; RKNN_QUANT_TYPE_PER_LAYER_ASYM: асимметричное Per-Layer. |
| iommu_domain_id | int32_t | Индекс домена адресного пространства IOMMU контекста. Пространства однозначно соответствуют контекстам и имеют размер 4GB каждое. Параметр нужен главным образом для больших A/B/C, когда память NPU в одном домене превышает 4GB и требуется другой домен. |
| group_size | int16_t | Число элементов группы; действует только при включённом групповом квантовании. |
| reserved | int8_t[] | Зарезервированное поле |
Исходная форма A — MxK, B — KxN, C — MxN.
4.1.1.3.1 Умножение матриц с заданными параметрами квантования
Если результат высокой разрядности нужно квантовать до низкой, например при A, B и C типа int8, задайте параметры квантования. Это scale и zero_point структуры rknn_quant_params. Для A и C они задаются rknn_matmul_set_quant_params. После успешной настройки параметры B в режиме Per-Channel можно прочитать через rknn_matmul_get_quant_params. Определение rknn_quant_params:
Таблица 4-2. Структура rknn_quant_params
| Member | Тип данных | Описание |
|---|---|---|
| name | char[] | Имя матрицы |
| scale | float* | Начальный адрес массива scale |
| scale_len | int32_t | Длина массива scale |
| zp | int32_t* | Начальный адрес массива zero_point |
| zp_len | int32_t | Длина массива zero_point |
Matmul поддерживает Per-Layer, Per-Channel и Per-Group. Различия параметров:
Per-Layer: длина массивов scale и zp равна 1.
Per-Channel: длина массивов scale и zp равна N.
Per-Group: длина scale и zp равна N*K/group_size. group_size задаёт число элементов в группе, использующих одинаковые параметры. В массивах сначала хранятся параметры K/group_size групп, затем N параметров квантования.
Каждый метод может быть симметричным (все zp=0) или асимметричным (не все zp=0).
4.1.1.3.2 Умножение матриц с динамической формой входа
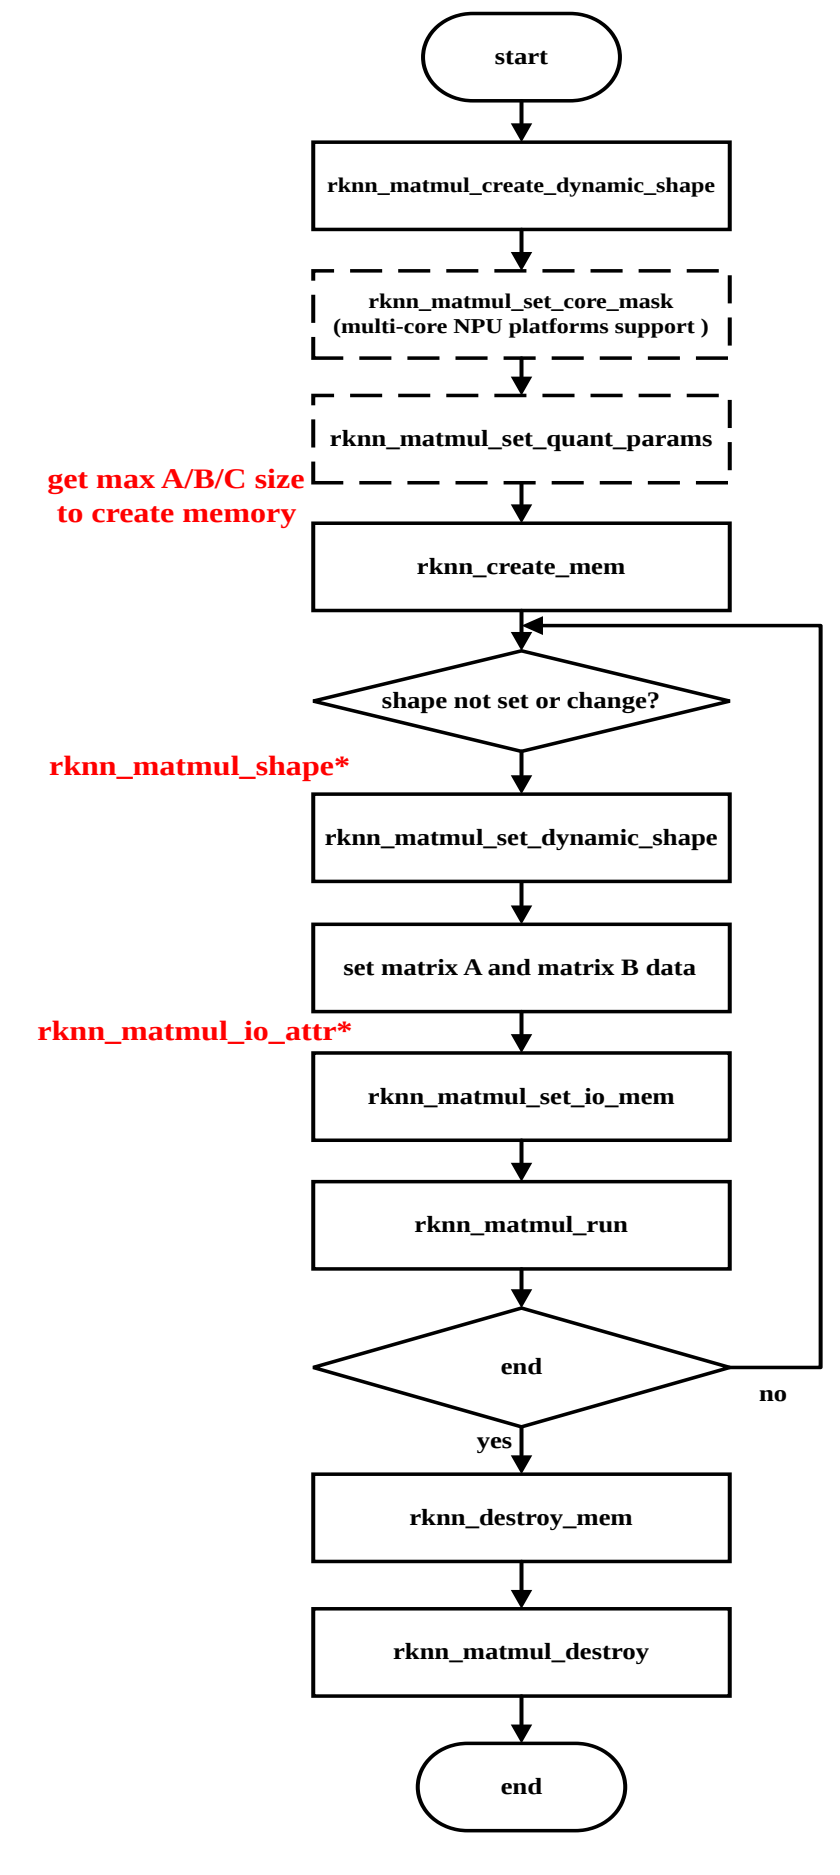
Рисунок 4-2. Matmul API для динамической формы входа
Процесс для динамической формы показан выше. Отличия от базового Matmul API:
-
Создание контекста: задайте число и набор форм, а также rknn_matmul_info с типами, layout входов/выходов и другими сведениями. M, K и N в rknn_matmul_info для динамической формы задавать не требуется. Вызовите rknn_matmul_create_dynamic_shape. Полученный массив rknn_matmul_io_attr содержит сведения о входных/выходных матрицах для всех настроенных форм.
-
Выделение памяти: сначала найдите максимальные размеры тензоров в массиве rknn_matmul_io_attr, затем создайте память через rknn_create_mem по максимальным размерам входных/выходных матриц.
3 Задайте текущую форму входа через rknn_matmul_set_dynamic_shape, передав указатель rknn_matmul_shape.
4 Настройте память через rknn_matmul_set_io_mem: заполненная входная матрица и выходная память записываются в контекст. rknn_tensor_mem указывает на ранее созданную память максимального размера, а rknn_matmul_tensor_attr содержит атрибуты матриц для текущей формы.
4.1.1.4 Высокопроизводительное расположение данных
NPU имеет специализированную архитектуру: чтение исходных форм MxK/KxN и запись C как MxN не оптимальны. Специальный layout повышает производительность. AC_layout управляет высокопроизводительным размещением A и C, B_layout — B. Для исходных A=MxK, B=KxN, C=MxN требуются следующие компоновки:
1 При AC_layout=RKNN_MM_LAYOUT_NORM и B_layout=RKNN_MM_LAYOUT_NORM формы A, B и C равны [M,K], [K,N] и [M,N].
-
При AC_layout=RKNN_MM_LAYOUT_NATIVE и B_layout=RKNN_MM_LAYOUT_NATIVE формы для платформ и типов приведены ниже. Результаты деления округляются вверх, лишние элементы заполняются 0.
-
При B_layout=RKNN_MM_LAYOUT_NORM B имеет форму [K,N], а при RKNN_MM_LAYOUT_TP_NORM — [N,K]. Второй вариант эффективнее.
Таблица 4-3. Высокопроизводительные формы A, B, C по платформам
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| A форма (int4) | пока не поддерживается | пока не поддерживается | [K/32,M,32] | [K/32,M,32] |
| B форма (int4) | пока не поддерживается | пока не поддерживается | [N/64,K/32,64,32]* | [N/64,K/32,64,32] |
| C форма (int16) | пока не поддерживается | пока не поддерживается | [N/8,M,8] | [N/8,M,8] |
| A форма (int8) | [K/16,M,16] | [K/8,M,8] | [K/16,M,16] | [K/16,M,16] |
| B форма (int8) | [N/16,K/32,16,32] | [N/16,K/32,16,32] | [N/32,K/32,32,32]* | [N/32,K/32,32,32] |
| C форма (int32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
| A форма (float16) | [K/8,M,8] | [K/4,M,4] | [K/8,M,8] | [K/8,M,8] |
| B форма (float16) | [N/8,K/32,8,32] | [N/8,K/16,8,16] | [N/16,K/32,16,32] | [N/16,K/32,16,32] |
| C форма (float32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
Примечание:
Таблица относится к одинаковым типам A и B. RK3576/RV1126B поддерживают разнородные типы входов. В этом случае layout B совпадает с layout B для одинаковых типов, соответствующих типу C. Например, A=int4, B=float16, C=float32 дают B=[N/16,K/32,16,32]. rknn_B_normal_layout_to_native_layout преобразует исходную форму B в высокопроизводительную.
Для RK3566/RK3568 и int8 соответствие элементов A при преобразовании [M,K] → [K/8,M,8] показано ниже:
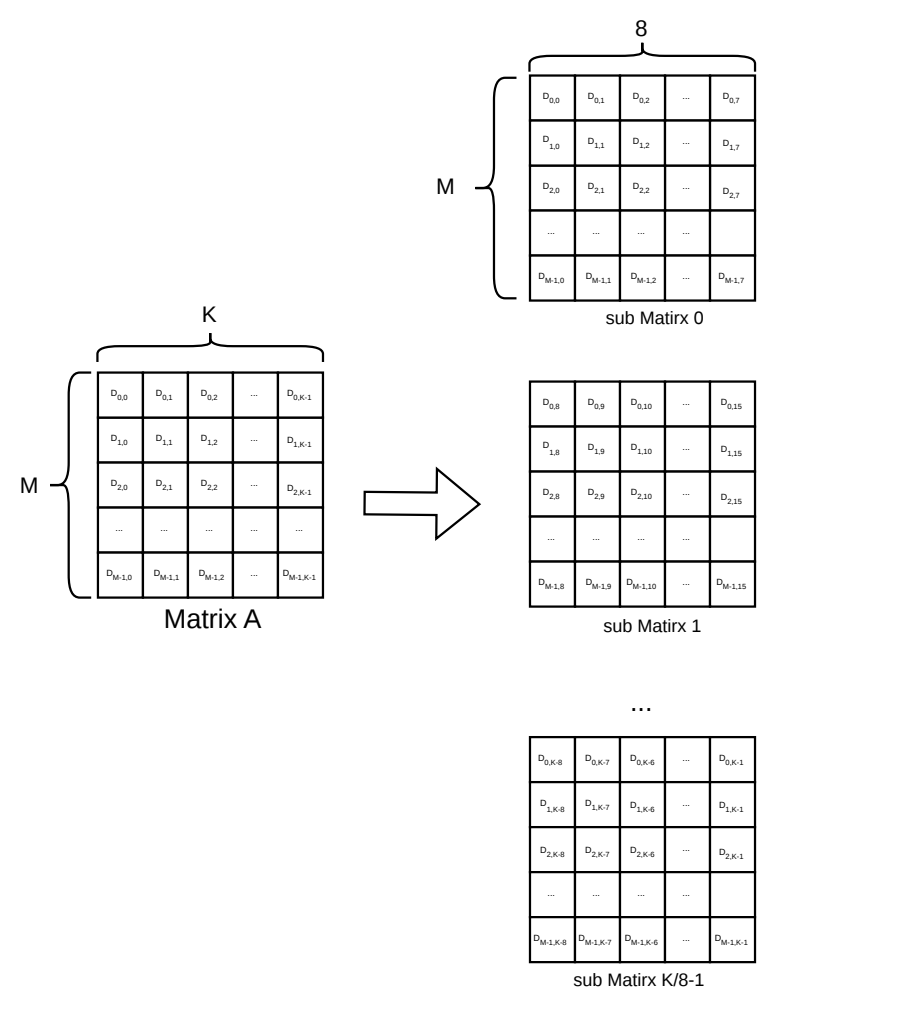
Рисунок 4-3. Преобразование элементов A типа int8 из [M,K] в [K/8,M,8]
Элемент (i,j) матрицы A обозначен Di,j. Слева форма [M,K], справа K/8 малых матриц [M,8], расположенных сверху вниз.
Пример преобразования A или C из исходной формы в высокопроизводительную:
template <typename Ti, typename To>
void norm_layout_to_perf_layout(Ti *src, To *dst, int32_t M, int32_t K, int32_t
subK){
    int outter_size = (int)std::ceil(K * 1.0f / subK);
    for (int i = 0; i < outter_size; i++)
    {
        for (int m = 0; m < M; m++)
        {
           for (int j = 0; j < subK; j++)
           {
               int ki = i * subK + j;
               if (ki >= K)
               {
                 dst[i * M * subK + m * subK + j] = 0;
               }
               else
               {
                 dst[i * M * subK + m * subK + j] = src[m * K + ki];
               }
           }
        }
    }
}
Для RK3566/RK3568 и int8 соответствие элементов B при переходе [K,N] → [N/16,K/32,16,32] показано ниже:
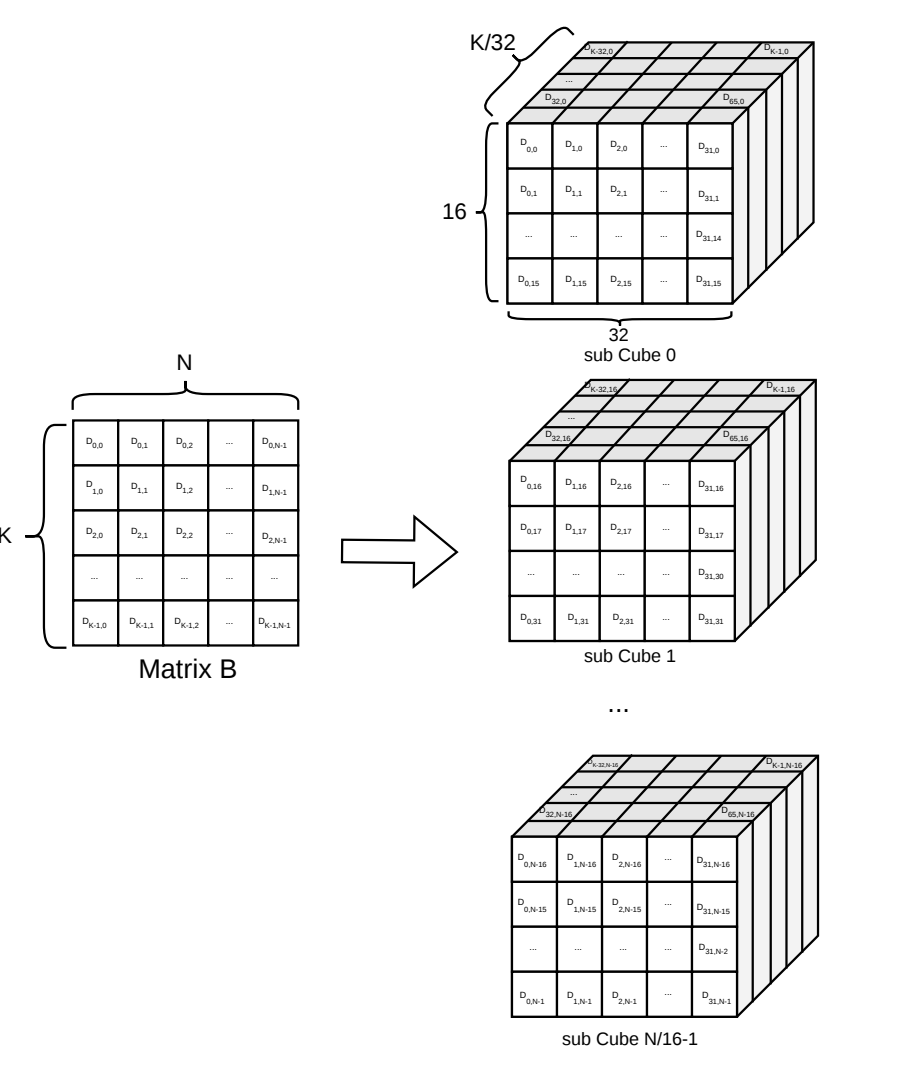
Рисунок 4-4. Преобразование int8-матрицы B из [K,N] в [N/16,K/32,16,32]
Элемент (i,j) матрицы B обозначен Di,j. Слева форма [K,N], справа N/16 малых блоков [K/32,16,32], расположенных сверху вниз.
Пример преобразования B из исходной формы в высокопроизводительную:
template <typename Ti, typename To>
voi norm_layout_to_native_layout(Ti *src, To *dst, int32_t K, int32_t N, int32_t
subN, int32_t subK)
{
    int N_remain = (int)std::ceil(N * 1.0f / subN);
    int K_remain = (int)std::ceil(K * 1.0f / subK);
    for (int i = 0; i < N_remain; i++)
    {
        for (int j = 0; j < K_remain; j++)
        {
           for (int n = 0; n < subN; n++)
           {
               int ni = i * subN + n;
               for (int k = 0; k < subK; k++)
               {
                   int ki = j * subK + k;
                   if (ki < K && ni < N)
                   {
                       dst[((i * K_remain + j) * subN + n) * subK + k] = src[ki * N + ni];
                   }
                   else
                   {
                       dst[((i * K_remain + j) * subN + n) * subK + k] = 0;
                   }
               }
           }
        }
    }
}
Примечание:
Полный пример Matmul API: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_matmul_api_demo.
4.1.1.4.1 Ограничения спецификации матриц
Matmul основан на архитектуре NPU и ограничен аппаратными спецификациями. Ограничения параметров:
AC_layout и B_layout задаются независимо. Оригинал утверждает: AC_layout и B_layout поддерживают RKNN_MM_LAYOUT_NORM или RKNN_MM_LAYOUT_TP_NORM на всех платформах; при этом все платформы, кроме RK3566/RK3568, поддерживают RKNN_MM_LAYOUT_TP_NORM.
Matmul поддерживает разные разрядности входов/выходов. Сочетания по платформам:
Таблица 4-4. Поддерживаемые Matmul сочетания типов A, B, C
| Порядковый номер | RK356X | RK3576/RV1126B | RK3588 |
|---|---|---|---|
| 1 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 |
| 2 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 |
| 3 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_INT8_MM_INT8_TO_INT32 | |
| 4 | RKNN_FLOAT16_MM_INT8_TO_FLOAT32 | RKNN_INT8_MM_INT8_TO_FLOAT32 | |
| 5 | RKNN_FLOAT16_MM_INT4_TO_FLOAT16 | RKNN_INT8_MM_INT8_TO_INT8 | |
| 6 | RKNN_FLOAT16_MM_INT4_TO_FLOAT32 | RKNN_INT4_MM_INT4_TO_INT16 | |
| 7 | RKNN_INT8_MM_INT4_TO_INT32 |
RK356X означает RK3562/RK3566/RK3568. float16 соответствует IEEE-754; подробности формата см. IEEE-754 half.
Ограничения размеров K и N:
Таблица 4-5. Ограничения K и N по платформам
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| K ограничение размера (int4) | пока не поддерживается | пока не поддерживается | * | 32-aligned |
| K ограничение размера (int8) | K <= 10240 и K mod 32 = 0 | K <= 10240 и K mod 32 = 0 | 32-aligned | 32-aligned |
| K ограничение размера (float16) | K <= 10240 и K mod 32 = 0 | K <= 10240 и K mod 32 = 0 | 32-aligned | 32-aligned |
| N ограничение размера (int4) | пока не поддерживается | пока не поддерживается | * | N <= 8192 и N mod 64 = 0 |
| N ограничение размера (int8) | N <= 4096 и N mod 16 = 0 | N <= 4096 и N mod 16 = 0 | N <= 4096 и N mod 32 = 0 | N <= 4096 и N mod 32 = 0 |
| N ограничение размера (float16) | N <= 4096 и N mod 16 = 0 | N <= 4096 и N mod 16 = 0 | N <= 4096 и N mod 32 = 0 | N <= 4096 и N mod 32 = 0 |
Примечание:
- означает такие же ограничения размера и выравнивания B, как для соответствующего типа A на той же платформе. Например, для RKNN_FLOAT16_MM_INT4_TO_FLOAT32 ограничения B совпадают с RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32.
Для RK3588:
При K > 8192 матрица B делится на T сегментов,
int T = std::ceil(K / 8192);
Например: normal layout -> native layout, K = 20488, N = 4096, T = 3; данные делятся на 3 сегмента.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
Преобразование K,N выполняется следующим образом:
                     (8196, 4096) (4096 / subN, 8196 / subK, subN, subK)
 (K, N) = (20488, 4096)->(8196, 4096)->(4096 / subN, 8196 / subK, subN, subK)
         normal layout (4096, 4096) (4096 / subN, 4096 / subK, subN, subK)
                   T normal layout T native layout
Для прямого преобразования данных рекомендуется rknn_B_normal_layout_to_native_layout.
Для RK3576/RV1126B: при K > 4096 B делится на T сегментов,
int T = std::ceil(K / 4096);
Например: normal layout -> native layout, K = 10240, N = 2048, T = 3; данные делятся на 3 сегмента.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
Преобразование K,N выполняется следующим образом:
                        (4096, 2048) (2048 / subN, 4096 / subK, subN, subK)
(K, N) = (10240, 2048) -> (4096, 2048) -> (2048 / subN, 4096 / subK, subN, subK)
        normal layout (2048, 2048) (2048 / subN, 2048 / subK, subN, subK)
                     T normal layout T native layout
Для прямого преобразования данных рекомендуется rknn_B_normal_layout_to_native_layout.