
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 4/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
2. Преобразование, квантование и оценка моделей
2.1 Преобразование обычных моделей
RKNN-Toolkit2 предоставляет преобразование моделей, анализ производительности, развёртывание, отладку и другие возможности. В этом разделе рассматривается преобразование моделей — одна из основных функций RKNN-Toolkit2. Она позволяет преобразовывать модели глубокого обучения из различных фреймворков в формат RKNN для выполнения на RKNPU. Общая последовательность: подготовка модели → настройка параметров преобразования → загрузка и построение модели → экспорт модели RKNN → проверка результата преобразования. Следующая схема поясняет эту последовательность.
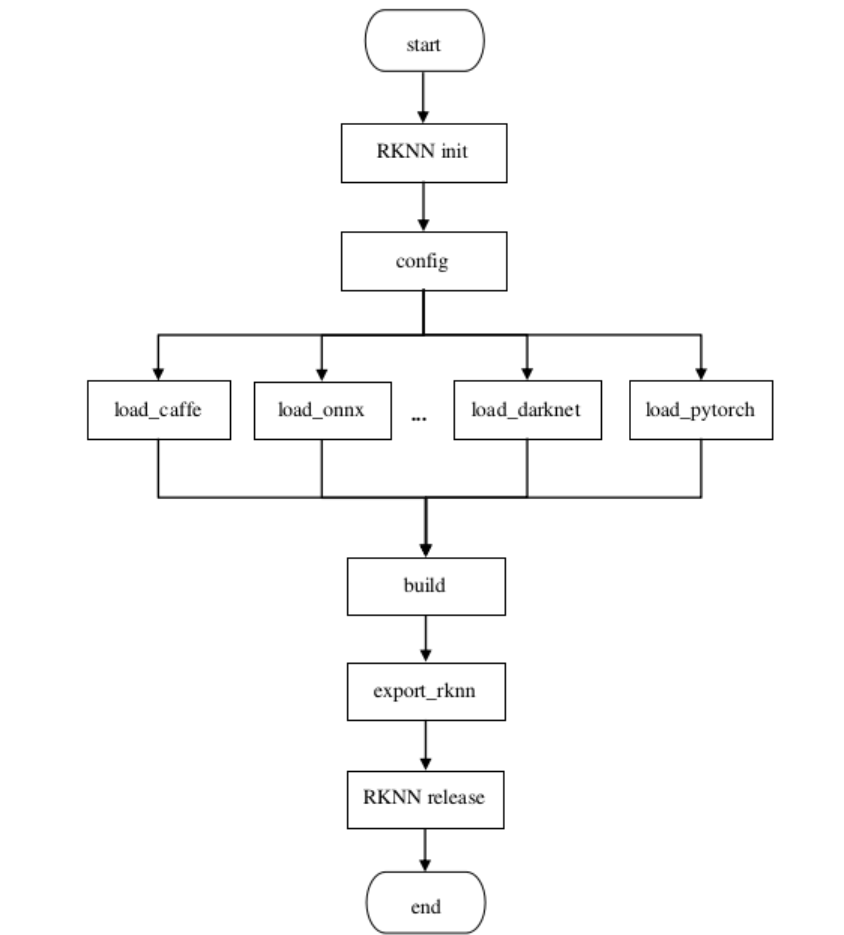
Рисунок 2-1. Последовательность преобразования модели
RKNN-Toolkit2 поддерживает преобразование моделей следующих распространенных сред глубокого обучения:
Caffe
TensorFlow
TensorFlow Lite
ONNX
PyTorch
Darknet
Модель можно обучить с помощью перечисленных фреймворков либо получить предварительно обученную модель и преобразовать её в формат RKNN. Это упрощает развёртывание и выполнение инференса на платформе RKNPU.
2.1.1 Подготовка модели
Исходными данными для преобразования служит оригинальная модель, обученная или экспортированная фреймворком глубокого обучения. Перед преобразованием выполните следующую подготовку:
Источник модели: используйте модель, обученную или полученную в одном из поддерживаемых RKNN-Toolkit2 фреймворков (Caffe / TensorFlow / TensorFlow Lite / ONNX / PyTorch / DarkNet), и убедитесь, что инференс корректно работает в исходном фреймворке.
Входные и выходные данные: определите имена входных и выходных узлов, формы входных тензоров, типы данных и т. п. Некоторые фреймворки требуют явно передать эти сведения при загрузке, например inputs / outputs / input_size_list для TensorFlow и input_size_list для PyTorch. Эти сведения понадобятся при настройке и вызове API загрузки.
Проверка модели: перед преобразованием рекомендуется изучить структуру модели, например в Netron, чтобы убедиться в корректном экспорте и поддержке операторов. Для ONNX можно сначала с помощью onnxruntime проверить, что результаты инференса совпадают с результатами исходного фреймворка.
2.1.2 Настройка преобразования
Перед преобразованием задайте конфигурацию, обеспечивающую правильность и производительность преобразования модели. Интерфейс rknn.config() позволяет указать средние входные значения, нормализацию, квантование и другие параметры. Некоторые распространенные параметры:
mean_values и std_values задают средние значения и нормализацию входа. Они используются при квантовании, поэтому при инференсе через C API повторно вычитать среднее и нормализовать изображение не нужно; это сокращает время развертывания.
quant_img_RGB2BGR определяет, следует ли сначала преобразовывать RGB в BGR при загрузке калибровочного изображения для квантования. Значение по умолчанию — false. Настройка действует при калибровке квантования, но не на стадии инференса: при инференсе это преобразование необходимо выполнять самостоятельно во входной предобработке. Подробные замечания приведены в разделе 5.4.3. Примечание: При quant_img_RGB2BGR=True сначала выполняется преобразование RGB2BGR, а затем операции mean_values и std_values.
target_platform задает целевую платформу модели RKNN. Поддерживаются RV1103, RV1103B, RV1106, RV1106B, RV1126B, RK2118, RK3562, RK3566, RK3568, RK3576 и RK3588.
quantized_algorithm задаёт алгоритм, используемый для вычисления параметров квантования каждого слоя. Допустимы normal, mmse, kl_divergence и gdq; по умолчанию используется normal. Исходный текст отсылает за подробностями к разделам 3.1.7, 6.1 и 6.2.
quantized_method поддерживает layer, channel или group{SIZE} и определяет способ совместного использования параметров весами слоя. Значение по умолчанию — channel. Исходный текст отсылает к разделам 3.1.7, 6.1 и 6.2.
optimization_level изменяет уровень оптимизации модели и позволяет отключить часть или все правила оптимизации при преобразовании. Значение по умолчанию 3 включает все оптимизации. При 2 или 1 отключаются некоторые оптимизации, способные влиять на точность отдельных моделей. При 0 отключены все оптимизации.
quantized_dtype задает тип квантования. Поддерживается INT8 с линейным асимметричным квантованием; значение по умолчанию ‘asymmetric_quantized-8’.
custom_string добавляет пользовательскую строку в модель RKNN, например информацию о версии модели. Строка доступна через запрос RKNN_QUERY_CUSTOM_STRING, что позволяет особым образом обрабатывать разные модели при развертывании. По умолчанию None.
dynamic_input поддерживает динамический ввод, имитируя его по нескольким заданным пользователем наборам форм входных тензоров. Значение по умолчанию — None. Подробности приведены в разделе 4.1.3.
Полное описание rknn.config() приведено в руководстве «03_RKNN2_Toolkit_Python_API_Reference_V2.5.0». Выше перечислены лишь некоторые часто используемые параметры.
Пример кода:
rknn.config(
    mean_values=[[103.94, 116.78, 123.68]],
    std_values=[[58.82, 58.82, 58.82]],
    quant_img_RGB2BGR=False,
    target_platform='rk3566')
2.1.3 Загрузка и построение модели
1 Инициализация объекта RKNN:
На этой стадии сначала необходимо инициализировать объект RKNN — это первый шаг всей последовательности:
Для инициализации объекта RKNN используется конструктор RKNN(). Ему можно передать параметры verbose и verbose_file.
Параметр verbose определяет, выводить ли подробный журнал на экран.
Если задан verbose_file и verbose имеет значение True, журнал также записывается в указанный файл.
Пример кода:
rknn = RKNN(verbose=True, verbose_file='./mobilenet_build.log')
2. Интерфейсы загрузки моделей
Для импорта файлов модели следует использовать интерфейс соответствующего фреймворка. RKNN-Toolkit2 предоставляет интерфейсы загрузки Caffe, TensorFlow, TensorFlow Lite, ONNX, PyTorch и других форматов. Ниже они кратко описаны.
Интерфейс загрузки модели Caffe:
Модель Caffe загружается через rknn.load_caffe().
Необходимо указать путь к файлу модели с расширением .prototxt и файлу весов с расширением .caffemodel.
При нескольких входных слоях можно задать порядок имен этих слоев.
Пример кода:
ret = rknn.load_caffe(model='./mobilenet_v2.prototxt', blobs='./mobilenet_v2.caffemodel')
Интерфейс загрузки модели TensorFlow:
Модель TensorFlow загружается через rknn.load_tensorflow().
Необходимо указать путь к файлу модели TensorFlow с расширением .pb, имена и формы входных узлов, а также имена выходных узлов.
Пример кода:
ret = rknn.load_tensorflow(tf_pb='./ssd_mobilenet_v1_coco_2017_11_17.pb',
              inputs=['Preprocessor/sub'],
              outputs=['concat', 'concat_1'],
              input_size_list=[[1, 300, 300, 3]])
Интерфейс загрузки модели TensorFlow Lite:
Модель TensorFlow Lite загружается через rknn.load_tflite().
Необходимо указать путь к файлу модели TensorFlow Lite с расширением .tflite.
Пример кода:
ret = rknn.load_tflite(model='./mobilenet_v1.tflite')
Интерфейс загрузки ONNX: используйте rknn.load_onnx() и укажите путь к файлу модели ONNX с расширением .onnx.
Пример кода:
ret = rknn.load_onnx(model='./arcface.onnx')
Интерфейс загрузки модели DarkNet:
Модель DarkNet загружается через rknn.load_darknet().
Необходимо указать путь к файлу модели с расширением .cfg и файлу весов с расширением .weights.
Пример кода:
ret = rknn.load_darknet(model='./yolov3-tiny.cfg', weight='./yolov3.weights')
Интерфейс загрузки PyTorch: используйте rknn.load_pytorch() и укажите путь к файлу модели с расширением .pt. Модель должна быть представлена в формате torchscript.
Пример кода:
ret = rknn.load_pytorch(model='./resnet18.pt', input_size_list=[[1, 3, 224, 224]])
Выберите интерфейс, соответствующий фреймворку модели, чтобы обеспечить корректность преобразования.
3. Построение модели RKNN
После загрузки исходной модели создайте модель RKNN через rknn.build(). На этом этапе можно включить квантование, чтобы уменьшить размер модели и повысить производительность на RKNPU. Параметры rknn.build() описаны ниже:
do_quantization: определяет, выполнять ли квантование модели. Рекомендуется True.
dataset: задаёт набор данных для калибровки квантования. Он описывается текстовым файлом.
Пример dataset.txt:
./imgs/ILSVRC2012_val_00000665.JPEG
./imgs/ILSVRC2012_val_00001123.JPEG
./imgs/ILSVRC2012_val_00001129.JPEG
./imgs/ILSVRC2012_val_00001284.JPEG
./imgs/ILSVRC2012_val_00003026.JPEG
./imgs/ILSVRC2012_val_00005276.JPEG
Пример кода:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
2.1.4 Экспорт модели RKNN
После построения модели через rknn.build() её можно экспортировать в файл с расширением .rknn через rknn.export_rknn() для последующего развёртывания. Параметры rknn.export_rknn():
export_path: путь к экспортируемому файлу модели.
cpp_gen_cfg: определяет, создавать ли при экспорте пример развёртывания на C++.
Пример кода:
ret = rknn.export_rknn(export_path='./mobilenet_v1.rknn')
После завершения преобразования вызовите release(), чтобы освободить ресурсы объекта RKNN:
rknn.release()
2.1.5 Проверка результата преобразования
После экспорта модели RKNN рекомендуется проверить результат преобразования:
Проверка инференса в симуляторе: на ПК инициализируйте симулятор через rknn.init_runtime(target=None), выполните rknn.inference() и сравните выход с результатом исходной модели в её фреймворке. Согласованность можно оценить по косинусному расстоянию, чтобы проверить, не появились ли ошибки при преобразовании.
Проверка на подключённой плате: соедините плату разработки с ПК по USB и выполните инференс через rknn.init_runtime(target=xxx), чтобы проверить результаты на реальном NPU.
Примечание: подробные методы анализа точности, производительности и памяти приведены в разделе 2.3 «Оценка модели».
2.1.6 Инструмент преобразования rknn_convert
rknn_convert — набор распространённых инструментов преобразования моделей в составе RKNN-Toolkit2. Они инкапсулируют перечисленные выше API: достаточно отредактировать соответствующий модели файл yml и выполнить одну команду. Ниже приведён пример использования rknn_convert и поддерживаемые параметры команды:
python -m rknn.api.rknn_convert -t rk3588 -i ./model_config.yml -o ./output_path
Эти команды и параметры позволяют преобразовать модель в RKNN и сохранить её по заданному пути. Поддерживаются следующие параметры:
-i: путь к конфигурационному файлу модели (.yml).
-o: путь вывода преобразованной модели.
-t: target_platform; целевая платформа rv1103, rv1103b, rv1106, rv1106b, rv1126b, rk2118, rk3562, rk3566, rk3568, rk3576 или rk3588.
-e: необязательная оценка времени выполнения и потребления памяти на подключённой плате; для включения укажите -e. Обязательно подключите соответствующую плату и правильно задайте target_platform, иначе возникнет ошибка. При нескольких устройствах задайте идентификатор устройства через -d.
-a: необязательная оценка точности созданной модели rknn. Для оценки в симуляторе укажите -a “xx1.jpg xx2.jpg”. Для оценки на подключённой плате используйте вместе с -d.
-v: необязательный вывод подробного журнала на экран; для включения укажите -v.
-d: для одного устройства adb укажите -d, для нескольких — -d device_id. Идентификатор device_id можно узнать командой adb devices.
Ниже приведён пример конфигурационного файла yml (object_detection.yml):
models:
   # model output name
   name: object_detection
   # Original model framework
   platform: onnx
   # Model input file path
   model_file_path: ./object_detection.onnx
   # Describe information such as input and output shapes
   subgraphs:
     # model input tensor shape
     input_size_list:
       - 1,3,512,512
     # input tensor name
     inputs:
       - data
     # output tensor name
     outputs:
       - conv6-1
       - conv6-2
       - conv6-3
   # quantification flag
   quantize: true
   # Quantify dataset file path (relative yml path)
   dataset: ./dataset.txt
   configs:
     quantized_dtype: asymmetric_quantized-8
     # rknn.config mean_values
     mean_values: [127.5,127.5,127.5]
     # rknn.config std_values
     std_values: [128.0,128.0,128.0]
     # rknn.config quant_img_RGB2BGR
     quant_img_RGB2BGR: false
     # rknn.config quantized_algorithm
     quantized_algorithm: normal
В конфигурации указаны имя модели, исходный фреймворк, пути к файлам, сведения о входах и выходах, необходимость квантования и другие данные. Отредактируйте её с учётом требований конкретной модели.
Параметры настройки преобразования модели перечислены в следующей таблице:
Таблица 2-1. Параметры конфигурации преобразования модели rknn_convert
| Параметр | Заполняемое значение |
|---|---|
| -name | Имя выходной модели |
| -platform | Фреймворк исходной модели: tensorflow, tflite, caffe, onnx, pytorch, darknet |
| -model_file_path | Путь к исходной модели из одного файла, например tensorflow, tflite, onnx, pytorch |
| -quantize | Включать ли квантование |
| -dataset | Путь к файлу набора квантования относительно конфигурации yml. Обязателен при включённом accuracy_analysis |
| -prototxt_file_path | Файл prototxt модели при platform=caffe |
| -caffemodel_file_path | Файл caffemodel модели, если platform имеет значение caffe |
| -darknet_cfg_path | Файл cfg модели, если platform имеет значение darknet |
| -darknet_weights_path | Файл весов модели, если platform имеет значение darknet |
| -subgraphs | Описывает формы входов и выходов и другие сведения. За исключением отдельных фреймворков этот параметр и его подпараметры обычно не заполняются: используются значения модели по умолчанию |
| —-input_size_list | Форма входного тензора (подпараметр) |
| —-inputs | Имя входного тензора (подпараметр) |
| —-outputs | Имя выходного тензора (подпараметр) |
| -configs | Соответствующая конфигурация rknn.config() |
| —-quantized_dtype | Тип квантования. Для RKNN_toolkit2 допустимо [asymmetric_quantized-8]. Если значение не указано, используется значение по умолчанию (подпараметр) |
| —-mean_values | Средние значения для нормализации входа. Для RGB-модели с одним входом, например, [123.675,116.28,103.53]; при нескольких входах — [[123,116,103], [255,255,255]] (подпараметр) |
| —-std_values | Значения стандартного отклонения для нормализации входа. Для RGB-модели с одним входом, например, [58.395,58.295,58.391]; при нескольких входах — [[127,127,127], [255,255,255]] (подпараметр) |
| —-quant_img_RGB2BGR | Определяет, преобразовывать ли калибровочные изображения из RGB в BGR при загрузке для квантования. По умолчанию False (подпараметр) |
| —-quantized_algorithm | Алгоритм квантования: [‘normal’, ‘kl_divergence’, ‘mmse’]; по умолчанию normal (подпараметр) |
| —-quantized_method | Метод квантования. Для RKNN_toolkit2 варианты [‘layer’, ‘channel’]; по умолчанию channel (подпараметр) |
| —-optimization_level | Уровень оптимизации. Значение по умолчанию 3 включает все стандартные варианты оптимизации (подпараметр) |
| —-model_pruning | Прореживание модели для уменьшения её размера. По умолчанию false; для включения задайте true (подпараметр) |
| —-quantize_weight | Если quantize=false, уменьшает размер модели rknn путём квантования некоторых весов. По умолчанию false; для включения задайте true (подпараметр) |
| —-single_core_mode | Определяет, создавать ли только одноядерную модель, что может уменьшить размер и потребление памяти модели RKNN. По умолчанию False. В настоящее время действует для RK3588/RK3576 (подпараметр) |
2.1.7 Возможности квантования RKNN-Toolkit2
RKNN-Toolkit2 предоставляет несколько методов и алгоритмов квантования, выбираемых параметрами quantized_algorithm и quantized_method в rknn.config(). Здесь описаны распространённые алгоритмы Normal / MMSE / KL-Divergence и методы Layer / Channel. Алгоритм GDQ и метод Group описаны в разделе 2.2.3 «Внутренний процесс квантования». Ниже рассмотрены перечисленные алгоритмы и методы квантования признаков:
Алгоритмы квантования
Алгоритм Normal непосредственно определяет границы диапазона квантования по максимальному и минимальному значениям признаков модели с плавающей точкой. Он быстр, но хуже работает при несбалансированном распределении признаков. Обычно рекомендуется набор примерно из 20–100 изображений.
Алгоритм MMSE определяет границы диапазона, минимизируя среднеквадратичную ошибку между исходными значениями с плавающей точкой и значениями после квантования и обратного преобразования. Это в некоторой степени уменьшает потерю точности из-за крупных выбросов. Итерационный перебор делает алгоритм медленнее, но точность обычно выше, чем у normal. Обычно рекомендуется 20–50 изображений; количество можно менять с учётом времени квантования.
Алгоритм KL-Divergence представляет значения признаков с плавающей и фиксированной точкой как два распределения, обновляет их, изменяя пороги, и выбирает границы диапазона по сходству распределений, измеряемому KL-дивергенцией. Он медленнее normal, но значительно быстрее mmse и может заметно улучшить результат при неравномерном распределении признаков. Обычно рекомендуется 20–100 изображений.
Методы квантования:
Layer: все каналы одного слоя сети квантуются совместно и используют общие параметры квантования.
Channel: каждый выходной канал слоя квантуется независимо и имеет собственные параметры квантования. Как правило, точность выше, чем у Layer.
Выбирайте алгоритм и метод квантования признаков с учётом требований и фактических результатов для модели. Подробности приведены в главе 2.2 «Квантование модели».
Алгоритм GDQ действует только для w4a16 и w8a16 и может эффективно повысить точность квантования весов в этих режимах. Рекомендуемый набор содержит более 200 изображений. Подробности приведены в разделе 2.2.3.2 «Внутренние алгоритмы квантования».
2.1.8 Прореживание модели
Прореживание бывает с потерями и без потерь. RKNN-Toolkit2 использует вариант без потерь: размер модели и объем вычислений уменьшаются без снижения точности с плавающей точкой. Точность квантованной модели может даже улучшиться.
Однако прореживание без потери качества применимо не ко всем моделям. По степени разреженности весов оно удаляет веса и каналы признаков, которые не влияют на модель, уменьшая её размер и объём вычислений. После включения прореживания (параметр model_pruning в rknn.config() установлен в True) модель автоматически прореживается во время преобразования с учётом разреженности весов.
При успешном прореживании выводится результат:
I model_pruning results:

I Weight: -1.12145 MB (-6.9%)

I GFLOPs: -0.15563 (-13.4%)
Здесь удалено 1.12145 MB весов, то есть 6.9%, а объем вычислений уменьшен на 0.15563 GFLOPs, то есть 13.4%.
При недостаточной разреженности обработка не выполняется и сообщение не выводится. Поэтому эта настройка не мешает обычному преобразованию модели.
2.1.9 Редактирование модели ONNX
После преобразования некоторых моделей в RKNN могут оставаться лишние операции, обычно reshape и transpose у входов и выходов, снижающие производительность. Интерфейс onnx_edit в RKNN-Toolkit2 изменяет определения входных и выходных размерностей ONNX-модели, чтобы при последующем преобразовании получить более производительную RKNN-модель с меньшим числом лишних reshape и transpose.
2.1.9.1 Описание интерфейса
Пример использования:
from rknn.utils import onnx_edit
ret = onnx_edit(model = './concat_block.onnx',
  export_path = './concat_block_edited.onnx',
  inputs_transform = {'k_in': 'a,b,c,d->1,ad,b,c'},
  outputs_transform = {'k_cache': 'a,b,c,d->1,ab,c,d'},
  dataset = './dataset.txt'
)
Model задаёт изменяемую модель; обязательный параметр.
Export_path задаёт путь создаваемой модели; обязательный параметр.
Inputs_transform — словарь формул преобразования входов: ключ — имя узла, значение — формула. Необязательный параметр, по умолчанию пустой словарь.
Outputs_transform — словарь формул преобразования выходов. Необязательный параметр, по умолчанию пустой словарь.
В dataset указывается файл со списком путей к входным данным. Требования к формату совпадают с требованиями параметра dataset в rknn.build. Если он задан, onnx_edit не только изменяет определения входов и выходов модели, но и соответствующие данные dataset, создавая новый набор данных в каталоге на том же уровне, что export_path. Его можно использовать для проверки и квантования новой модели. Параметр необязателен и по умолчанию пуст.
2.1.9.2 Формулы преобразования
В inputs_transform и outputs_transform интерфейса onnx_edit задаются формулы, по синтаксису похожие на оператор einsum. Например, ‘a,b,c,d->1,ad,b,c’ преобразует исходные размерности ‘a,b,c,d’ в ‘1,ad,b,c’. Правила записи:
Формула состоит из двух частей, разделённых ‘->’: слева исходная символьная форма, справа преобразованная.
Допустимы только символы [a-z], ‘,’ и ‘1’. Другие цифры не поддерживаются, поскольку одинаковые числовые символы не позволяют определить контекст transpose.
Символы [a-z] независимы и не имеют порядка: ‘a,b->b,a’ и ‘c,a->a,c’ обозначают одно преобразование.
Исходная форма слева разделяется запятыми на n частей; n должно соответствовать числу измерений модели. Для входа [32,4,1,64] допустимы ‘a,b,c,d’ или ‘a,b,1,d’.
Каждый исходный символ, кроме ‘1’, должен присутствовать в преобразованной форме. Например, ‘a,1,c,d->ac,d,1’ допустимо, а ‘a,1,c,d->ac,1’ — нет: отсутствует ‘d’.
В преобразованную форму можно вставить любое число ‘1’ для добавления измерений, например ‘a,b,c-> a,1,cb,1,1’.
Для разбиения измерения исходная форма допускает несколько букв и присваивания. Например, при входе [32,4,1,64] формула ‘ab,c,d,qk[a=2,k =8]->aq,cd,1,kb’ разбивает 32 на 2x16 и 64 на 8x8, затем выполняет transpose и reshape. Часть ‘[ ]’ содержит присваивания, разделённые запятыми. Некоторые значения можно не задавать: они выводятся автоматически. Если a=2 и из модели известно ab=32, выводится b=16. Недопустимая полученная размерность вызывает ошибку: при ab=32 и a=5 получается b=6.4, но размерность должна быть целым числом.
2.1.9.3 Примеры формул преобразования
Преобразование 3-мерного входа в 4-мерный: ‘a,b,c->a,b,1,c’
Преобразование 5-мерного входа в 4-мерный: ‘a,b,c,d,e->ab,c,d,e’
Операция transpose(0,3,1,2): ‘a,b,c,d->a,d,b,c’
Перестановка и объединение измерений: ‘a,b,c,d->d,acb,1’
Разбиение, перестановка и объединение измерений: ‘a,bc,de,f[b=2,d=4]->ab,fe,dc,1’