
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 21/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
9. Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
5.3 Анализ и оптимизация памяти
5.3.1 Состав памяти и методы анализа
5.3.1.1 Состав памяти при выполнении модели RKNN
Память времени выполнения RKNN в основном состоит из четырёх частей: веса и внутренние тензоры, конфигурации регистров, входные тензоры и выходные тензоры. Обычно память создаётся при rknn_init.
5.3.1.2 Анализ памяти модели
После rknn_init() при необходимости проверить выделенную модели память или выделить веса внешним способом вызовите rknn_query с RKNN_QUERY_MEM_SIZE. Так запрашиваются веса и внутренняя память модели без входов/выходов, а также занятые при инференсе DMA- и SRAM-память. Для SRAM возвращается 0, если она не включена либо функция отсутствует.
Пример кода:
 rknn_context ctx = 0;

 // Load RKNN Model
 int ret = rknn_init(&ctx, model_path, 0, NULL, NULL);
 if (ret < 0) {
    printf("rknn_init fail! ret=%d\n", ret);
    return -1;
 }

 // Get weight and internal mem size
 rknn_mem_size mem_size;
 ret = rknn_query(ctx, RKNN_QUERY_MEM_SIZE, &mem_size, sizeof(mem_size));
 if (ret != RKNN_SUCC) {
    printf("rknn_query fail! ret=%d\n", ret);
    return -1;
 }
 printf("total weight size: %d, total internal size: %d\n", mem_size.total_weight_size, mem_size.total_internal_size);
5.3.2 Использование памяти, выделенной извне
5.3.2.1 Внешнее выделение памяти входов и выходов
Как описано в разделе «Процесс zero-copy C API», при использовании zero-copy API память входных и выходных тензоров можно выделить извне и настроить для NPU. См. схему в этом разделе. Внешнее выделение памяти доступно только через zero-copy API. Оно предназначено прежде всего для случаев, когда пользователь должен сам выделить память NPU вместо выделения через rknn_create_mem().
Внешняя память может описываться физическими адресами или fd и подключается главным образом двумя интерфейсами:
rknn_create_mem_from_phys(): создание структуры rknn_tensor_mem по физическому адресу
rknn_create_mem_from_fd(): создание структуры rknn_tensor_mem по fd
Ниже пример выделения памяти через mpi mmz. rknn_create_mem_from_phys() импортирует физический адрес внешней памяти и создаёт rknn_tensor_mem с её физическими характеристиками. Пример кода:
// Create input tensor memory
rknn_tensor_mem* input_mems[1];
// default input type is int8 (normalize and quantize need compute in outside)
// if set uint8, will fuse normalize and quantize to npu
input_attrs[0].type = input_type;
// default fmt is NHWC, npu only support NHWC in zero copy mode
input_attrs[0].fmt = input_layout;

input_mems[0] = rknn_create_mem_from_phys(ctx, input_phys, input_virt, input_attrs[0].size_with_stride);

...

// Create output tensor memory
rknn_tensor_mem* output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
    output_mems[i] = rknn_create_mem_from_phys(ctx, output_physs[i], output_virts[i], output_attrs[i].size);
}

// Set input tensor memory
ret = rknn_set_io_mem(ctx, input_mems[0], &input_attrs[0]);
if (ret < 0) {
    printf("rknn_set_io_mem fail! ret=%d\n", ret);
    return -1;
}

// Set output tensor memory
for (uint32_t i = 0; i < io_num.n_output; ++i) {
    // set output memory and attribute
    ret = rknn_set_io_mem(ctx, output_mems[i], &output_attrs[i]);
    if (ret < 0) {
        printf("rknn_set_io_mem fail! ret=%d\n", ret);
        return -1;
    }
}
Кроме физического адреса, для внешней памяти можно использовать fd. Пример кода:
int mb_flags = RK_MMZ_ALLOC_TYPE_CMA | RK_MMZ_ALLOC_UNCACHEABLE;

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, mem_size.total_weight_size, mb_flags);
if (ret < 0) {
    printf("RK_MPI_MMZ_Alloc failed, ret: %d\n", ret);
    return ret;
}

void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
if (weight_virt == NULL) {
    printf("RK_MPI_MMZ_Handle2VirAddr failed!\n");
    return -1;
}

int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
if (weight_fd < 0) {
    printf("RK_MPI_MMZ_Handle2Fd failed!\n");
    return -1;
}

weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);

int mb_flags = RK_MMZ_ALLOC_TYPE_CMA | RK_MMZ_ALLOC_UNCACHEABLE;

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, mem_size.total_weight_size, mb_flags);
if (ret < 0) {
    printf("RK_MPI_MMZ_Alloc failed, ret: %d\n", ret);
    return ret;
}

void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
if (weight_virt == NULL) {
    printf("RK_MPI_MMZ_Handle2VirAddr failed!\n");
    return -1;
}

int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
if (weight_fd < 0) {
    printf("RK_MPI_MMZ_Handle2Fd failed!\n");
    return -1;
}

weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);
5.3.2.2 Внешнее выделение памяти модели
Как указано в 9.1, память модели состоит из internal memory и weight memory. Чтобы использовать внешне выделенную память модели, задайте память весов и внутреннюю память через rknn_set_weight_mem() и rknn_set_internal_mem(). Пример:
// Load RKNN Model
ret = rknn_init(&ctx, model_virt, model_size, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
TIME_END(rknn_init);
if (ret < 0) {
    printf("rknn_init fail! ret=%d\n", ret);
    return -1;
}

//query and inset input / output tensor
...

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, SIZE_ALIGN_128(mem_size.total_weight_size), mb_flags);
void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
ret = rknn_set_weight_mem(ctx, weight_mem);
if (ret < 0) {
    printf("rknn_set_weight_mem fail! ret=%d\n", ret);
    return -1;
}
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);

// Allocate internal memory in outside
MB_BLK internal_mb;
rknn_tensor_mem* internal_mem;
ret = RK_MPI_MMZ_Alloc(&internal_mb, SIZE_ALIGN_128(mem_size.total_internal_size), mb_flags);
void* internal_virt = RK_MPI_MMZ_Handle2VirAddr(internal_mb);
int internal_fd = RK_MPI_MMZ_Handle2Fd(internal_mb);

internal_mem = rknn_create_mem_from_fd(ctx, internal_fd, internal_virt, mem_size.total_internal_size, 0);
ret = rknn_set_internal_mem(ctx, internal_mem);
if (ret < 0) {
    printf("rknn_set_internal_mem fail! ret=%d\n", ret);
    return -1;
}
printf("internal mb info: virt = %p, fd = %d, size: %d\n", internal_virt, internal_fd, mem_size.total_internal_size);
5.3.3 Повторное использование внутренней памяти
RKNN API позволяет управлять памятью NPU извне. Флаг RKNN_FLAG_INTERNAL_ALLOC_OUTSIDE указывает, что память промежуточных признаков модели выделяется внешним способом. Типичные сценарии:
При развёртывании пользователь выделяет всю NPU-память сам, что позволяет согласованно распределить память всей системы.
При последовательном выполнении нескольких моделей память промежуточных признаков повторно используется между контекстами. Это особенно полезно при жёстком дефиците памяти, например на RV1103/RV1106.
На рисунке Internal Tensor модели 1 занимает больше места, чем модели 2. При последовательном запуске достаточно одного общего блока по адресам 0x00000000~0x000c4000. После окончания модели 1 этот блок используется моделью 2 для чтения и записи Internal Tensor, экономя память.
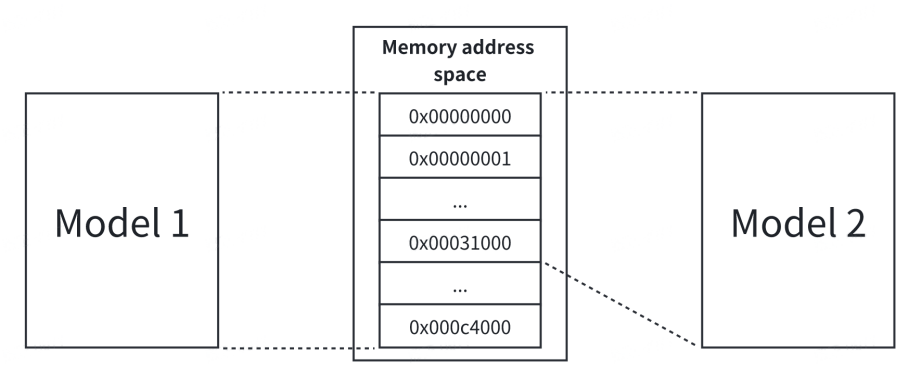
Рисунок 5-16. Две модели используют одно адресное пространство для Internal Tensor
Пусть пути моделей 1 и 2 — model_path_a и model_path_b. Пример кода:
rknn_init(&ctx_a, model_path_a, 0, RKNN_FLAG_INTERNAL_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_a, RKNN_QUERY_MEM_SIZE, &mem_size_a, sizeof(mem_size_a));
rknn_init(&ctx_b, model_path_b, 0, RKNN_FLAG_INTERNAL_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_b, RKNN_QUERY_MEM_SIZE, &mem_size_b, sizeof(mem_size_b));

// Get the largest internal size of the two models
max_internal_size = MAX(mem_size_a.total_internal_size,
mem_size_b.total_internal_size);
internal_mem_max = rknn_create_mem(ctx_a, max_internal_size);

// Set the internal memory of model a
internal_mem_a = rknn_create_mem_from_fd(ctx_a, internal_mem_max->fd, internal_mem_max->virt_addr, mem_size_a.total_internal_size, 0);
rknn_set_internal_mem(ctx_a, internal_mem_a);

// Set the internal memory of model b
internal_mem_b = rknn_create_mem_from_fd(ctx_b, internal_mem_max->fd, internal_mem_max->virt_addr, mem_size_b.total_internal_size, 0);
rknn_set_internal_mem(ctx_b, internal_mem_b);
5.3.4 Повторное использование контекста RKNN в нескольких потоках
При многопоточности несколько потоков могут одновременно выполнять одну модель. Отдельная инициализация контекста в каждом потоке расходует много памяти. Совместное использование контекста исключает повторное создание структур и снижает расход памяти Runtime. RKNN API предоставляет следующий интерфейс повторного использования контекста:
int rknn_dup_context(rknn_context* context_in,rknn_context* context_out)
context_in — уже инициализированный контекст, context_out — контекст, повторно использующий context_in. На рисунке структуры моделей совпадают, поэтому контексты можно использовать повторно.
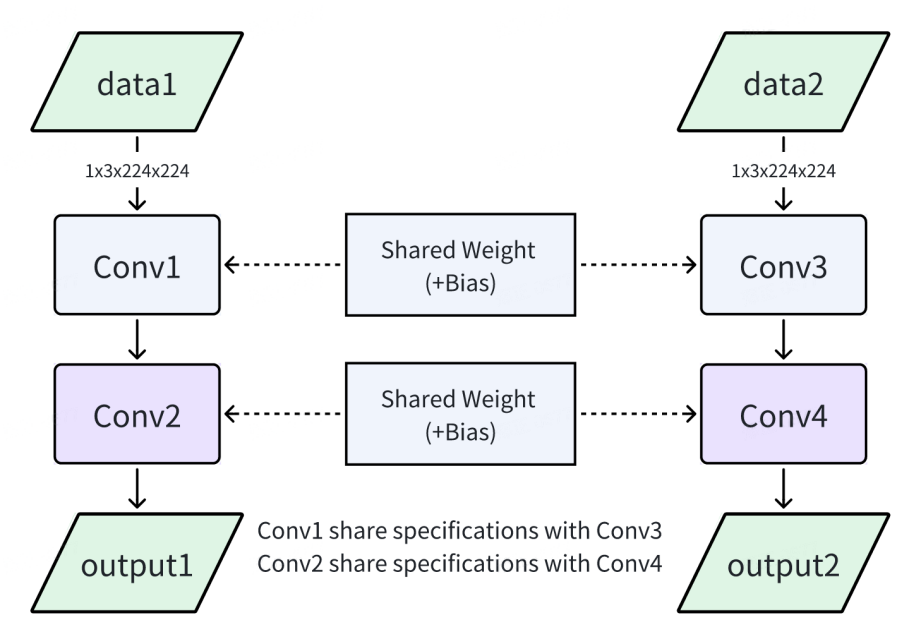
Рисунок 5-17. Повторное использование контекста двух одинаковых моделей
5.3.5 Общие веса моделей с разным разрешением
Модели разного разрешения с одинаковыми весами могут совместно использовать веса для экономии памяти. В RKNPU SDK <= 1.5.0 это позволяло динамически переключать разрешения с меньшим расходом памяти. После 1.5.0 механизм заменён функцией динамических форм.
На следующей схеме веса моделей A и B полностью совпадают.
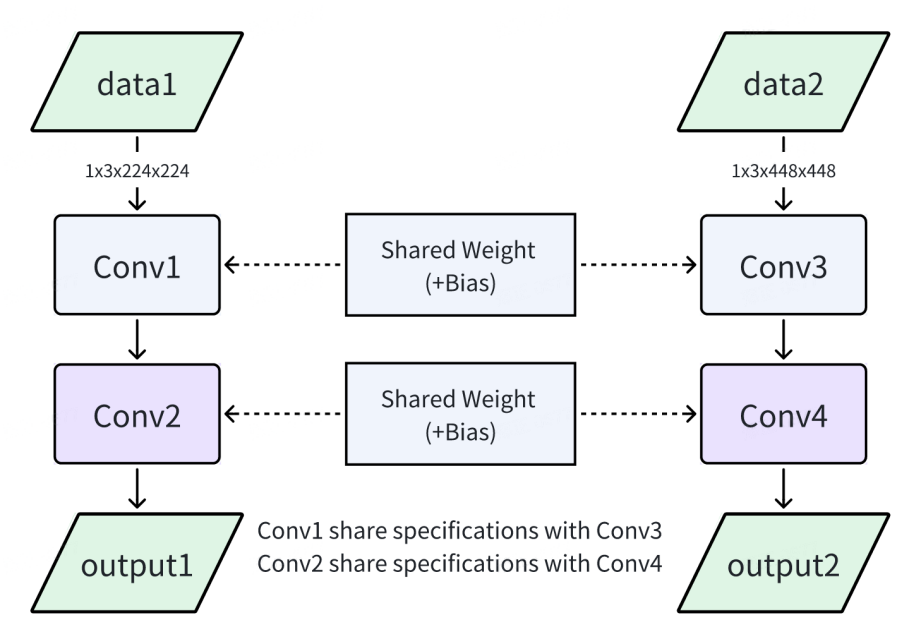
Рисунок 5-18. Совместные веса двух моделей разного разрешения
Для совместного использования весов моделей разного разрешения выполните следующие шаги:
-
При преобразовании назначьте одну модель master и задайте remove_weight=False в rknn.config; другую назначьте slave с remove_weight=True. Master содержит веса, slave не содержит весов свёрточных операторов.
-
При развёртывании сначала инициализируйте master, затем slave. Для slave используйте флаг RKNN_FLAG_SHARE_WEIGHT_MEM и дополнительный параметр rknn_init_extend со значением контекста master. Пути master и slave обозначим model_A и model_B. Пример:
rknn_context context_A;
rknn_context context_B;
ret = rknn_init(&context_A,model_A,0,0,NULL);
...
rknn_init_extend extend;
extend.ctx = context_A;
ret = rknn_init(&context_B,model_B,0,RKNN_FLAG_SHARE_WEIGHT_MEM,&extend);