
Справочник платформы по руководству Rockchip RKNN2 SDK V2.5.0. Рассматриваются только перечисленные в исходном документе SoC, Linux/Android Runtime и Toolkit. Возможности действуют при указанных в каждом разделе условиях для чипа, SDK, драйвера и ядра и не означают поддержку всех плат ArmSoM. Перед развёртыванием проверьте BSP, драйвер NPU, Runtime и версию модели конкретной платы. Проверка на оборудовании ArmSoM не проводилась; журналы, показатели и примеры взяты из оригинала.
Источники и вычитка: китайская версия следует китайскому V2.5.0 (182 страницы), английская, русская и немецкая — английскому V2.5.0 (208 страниц). Различия оригиналов сохранены; сведения старой версии не выдаются за новые. Китайские рисунки взяты из китайского PDF, остальные — из английского, включая отдельно извлечённые векторные схемы. Номера разделов и формул сохранены. Некоторые ссылки используют старую нумерацию; примеры динамической формы содержат «1224+140=264», утверждения о TP_NORM противоречат друг другу, а init()/rknn.val_perf() отличаются от последующих описаний API. Эти сомнения сохранены: перед выполнением проверьте реальные заголовки и справочник V2.5.0. Код и параметры сохранены, разрывы PDF и продолжения таблиц восстановлены.
RKNN2 SDK V2.5.0 · 9/22
1. Программный стек и основные понятия
2. Среда разработки, версии и подключение платы
3. Процесс разработки и выбор интерфейса
4. Преобразование моделей и редактирование ONNX
5. Квантование, гибридное квантование и QAT
6. Инференс, оценка точности, производительности и памяти
7. Жизненный цикл Runtime, размещение данных и память
8. Нулевое копирование и ограничения входов/выходов
Развёртывание через C API и генерация кода
10. Развёртывание Python через Toolkit Lite2
11. Matmul API и размещение матриц
12. Многоядерная настройка NPU и производительность
13. Модели с динамической формой и развёртывание
16. Согласованность кэша и разреженный инференс
17. Пользовательские операторы: Python и C API
18. Развёртывание зашифрованных моделей
20. Анализ производительности и оптимизация сети
21. Анализ, совместное использование и повторное использование памяти
22. Вопросы, обработка ошибок и справочные ресурсы
3.2 Развёртывание обычных моделей через C API
Раздел описывает развёртывание через общий C API: инициализацию модели, подготовку входов и выходов, инференс и обработку результатов. Этот процесс подходит для промышленного развёртывания и задач, чувствительных к производительности. Порядок вызовов C API нулевого копирования приведён в 3.1.6.
3.2.1 Полная последовательность вызовов
Типичная последовательность: инициализация модели → запрос атрибутов входов и выходов → подготовка и установка входов → инференс → получение выходов → постобработка → освобождение ресурсов. Общая схема:
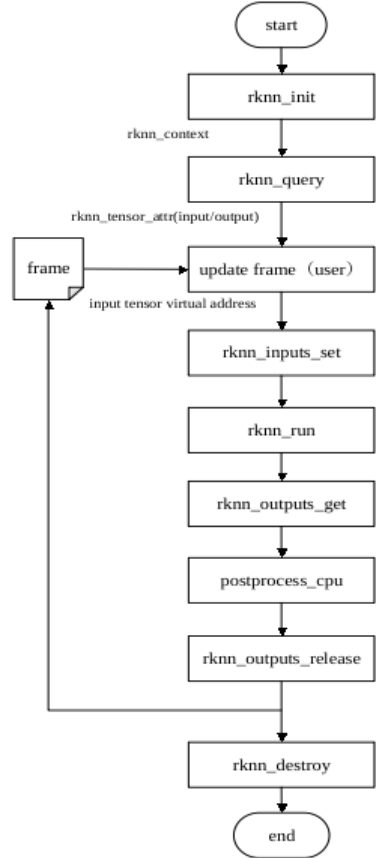
Рисунок 3-10. Последовательность общего API
Последовательность общего API RKNN:
-
Инициализируйте модель через rknn_init().
-
Запросите атрибуты входов и выходов через rknn_query().
3 Предварительная обработка входа;
-
Задайте входные данные через rknn_inputs_set().
-
Выполните инференс через rknn_run().
-
Получите результаты через rknn_outputs_get().
7 Последующая обработка выхода;
-
Освободите выходную память через rknn_outputs_release().
-
Уничтожьте RKNN через rknn_destroy().
Последовательность показана на рисунке 3-10.
Пример кода последовательности общего API:
// Init RKNN model
ret = rknn_init(&ctx, model, model_len, 0, NULL);

// Get Model Input Output Number
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// Get Model Input Info
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
    input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}

// Get Model Output Info
rknn_tensor_attr output_attrs[io_num.n_output];
memset(output_attrs, 0, sizeof(output_attrs));
for (int i = 0; i < io_num.n_output; i++)
{
    output_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_OUTPUT_ATTR, &(output_attrs[i]), sizeof(rknn_tensor_attr));
}

rknn_input inputs[io_num.n_input];
rknn_output outputs[io_num.n_output];
memset(inputs, 0, sizeof(inputs));
memset(outputs, 0, sizeof(outputs));

// Pre-process
// Read Image
image_buffer_t src_image;
memset(&src_image, 0, sizeof(image_buffer_t));
ret = read_image(image_path, &src_image);

// Set Input Data
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(rknn_ctx, io_num.n_input, inputs);

// Run
ret = rknn_run(rknn_ctx, nullptr);

// Get Output Data
ret = rknn_outputs_get(rknn_ctx, io_num.n_output, outputs, NULL);

// Post-process
post_process(outputs, results);

// Release RKNN Output
rknn_outputs_release(rknn_ctx, io_num.n_output, outputs);

if (rknn_ctx != 0)
{
    rknn_destroy(rknn_ctx);
}
3.2.2 Инициализация модели
rknn_init() загружает модель RKNN и создаёт контекст выполнения. Это необходимая предпосылка всех последующих операций.
rknn_init() поддерживает два способа загрузки:
Из пути файла: передайте строку пути к .rknn через model и задайте size=0. Runtime самостоятельно прочитает файл.
Из памяти: прочитайте .rknn в память, передайте указатель через model, а длину через size. Подходит для предварительно загруженной модели либо модели, расшифрованной кодом приложения.
flag задаёт флаги инициализации, например сбор производительности RKNN_FLAG_COLLECT_PERF_MASK или внешнее выделение памяти RKNN_FLAG_MEM_ALLOC_OUTSIDE. Для обычной инициализации передайте 0. ext содержит расширенную информацию; обычно передают NULL.
rknn_context ctx;
int ret = rknn_init(&ctx, "./model.rknn", 0, 0, NULL);
if (ret != RKNN_SUCCESS) {
    printf("rknn_init failed! ret=%d\n", ret);
    goto out;
}
На RK3588 / RK3576 после инициализации можно выбрать ядра NPU через rknn_set_core_mask(). Выбор должен соответствовать конфигурации преобразования модели; см. 4.1.2.
3.2.3 Подготовка входов и выходов
После инициализации запросите атрибуты входов и выходов и подготовьте соответствующие входные данные.
1. Запрос атрибутов входов и выходов
Через rknn_query() сначала запросите количество тензоров с RKNN_QUERY_IN_OUT_NUM, затем атрибуты каждого с RKNN_QUERY_INPUT_ATTR / RKNN_QUERY_OUTPUT_ATTR: форму, dtype, layout, параметры квантования и т. п. Используйте их для организации входов и разбора выходов.
// Query the number of inputs and outputs
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// Query each input tensor's attributes
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
    input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}
2. Подготовка и установка входных данных
После предобработки, например изменения размера и цветового пространства, заполните rknn_input и передайте её Runtime через rknn_inputs_set():
index: индекс входа.
buf / size: указатель на данные и размер в байтах. Размер равен числу элементов, умноженному на число байтов элемента.
type: тип входных данных, например RKNN_TENSOR_UINT8. При отличии от входного типа модели Runtime преобразует данные автоматически.
fmt: размещение входных данных, например RKNN_TENSOR_NHWC. Для четырёхмерного входа укажите правильное размещение, для остальных — RKNN_TENSOR_UNDEFINED.
pass_through: пропускать ли внутреннюю предобработку Runtime — нормализацию, преобразование типа и размещения.
rknn_input inputs[io_num.n_input];
memset(inputs, 0, sizeof(inputs));
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
Примечание:
Если при преобразовании через rknn.config() заданы mean_values и std_values, общий API автоматически нормализует данные при инференсе. Приложению не нужна отдельная mean/std-обработка, что сокращает работу по развёртыванию.
Порядок каналов RGB / BGR должен совпадать с настройкой обучения. quant_img_RGB2BGR действует при квантовании, но не при инференсе; преобразование каналов выполняет пользователь.
Для нулевого копирования память выделяется через rknn_create_mem() и связывается через rknn_set_io_mem(). Размер, dtype и размещение должны точно совпадать с запрошенными атрибутами; см. 3.1.6.
3.2.4 Выполнение инференса
После установки входов вызовите rknn_run(). Это синхронный блокирующий вызов; при возврате текущий инференс завершён.
ret = rknn_run(ctx, nullptr);
if (ret < 0) {
    printf("rknn_run failed! ret=%d\n", ret);
    goto out;
}
На многоядерных RK3588 / RK3576 перед инференсом задайте маску ядер через rknn_set_core_mask(); см. 3.2.2. Измерение времени через RKNN_QUERY_PERF_RUN и журналы RKNN_LOG_LEVEL описано в 5.2.
3.2.5 Обработка выходов
После инференса получите выходы через rknn_outputs_get(), выполните постобработку и освободите память через rknn_outputs_release().
rknn_output outputs[io_num.n_output];
memset(outputs, 0, sizeof(outputs));
outputs[0].want_float = 1;
ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0) {
    printf("rknn_outputs_get failed! ret=%d\n", ret);
    goto out;
}

// Post-processing (e.g. argmax for classification, NMS for detection)
post_process(outputs, results);

// Release output memory
rknn_outputs_release(ctx, io_num.n_output, outputs);
Замечания по чтению выходов:
Тип данных: при want_float=1 Runtime возвращает float32. При want_float=0 возвращается исходный тип выхода модели: INT8 для квантованных моделей, float16 для неквантованных. Для деквантования используйте scale / zero_point из запрошенных атрибутов тензора.
Размещение: общий API возвращает исходное размещение модели, обычно NCHW для четырёхмерных выходов. Постобработка должна учитывать этот формат.
Освобождение: память, полученная через rknn_outputs_get(), выделяется Runtime и должна освобождаться через rknn_outputs_release(). API нулевого копирования читает непосредственно связанную память и не требует этого шага.
3.2.6 Генерация C-кода развёртывания
В RKNN-Toolkit2 2.0.0 добавлен интерфейс Codegen для генерации кода развёртывания модели и упрощения начала работы. Он построен поверх CAPI с нулевым копированием; стиль интерфейса соответствует примерам RKNN_Model_Zoo. Сгенерированный код позволяет непосредственно измерять производительность и проверять точность инференса, а также служит основой для собственной разработки.
Пример использования:
ret = rknn.codegen(output_path='./rknn_app_demo',
          inputs=['../../caffe/mobilenet_v2/dog_224x224.jpg'], overwrite=True)
Перед codegen необходимо вызвать rknn.export для сохранения RKNN-модели. Имя rknn.export сохранено из текста оригинала.
output_path задаёт каталог вывода; его имя выбирает пользователь.
Inputs содержит список путей входных данных модели и может быть пустым. Поддерживаются jpg/png/npy. Для npy размерности данных должны соответствовать размерностям входа модели.
При overwrite=True файлы в каталоге output_path перезаписываются. Значение по умолчанию — False.
Для компиляции и тестирования сгенерированного кода следуйте README.md в созданном каталоге.
Если inputs содержит допустимые данные, пример после инференса оценивает различия результатов CAPI и симулятора RKNN-Toolkit2, сравнивая косинусное сходство каждого выхода.
Ограничений по аппаратной платформе NPU нет; на плате требуется Linux или Android.
Поддерживаются квантованные и неквантованные модели.