
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 22/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
FAQ, Fehlerbehandlung und Referenzen
5.4 Häufige Fragen und Fehlerbehandlung
5.4.1 Probleme mit der NPU-SDK-Umgebung
Versionskompatibilität
NPU-Kerneltreiber und Runtime
Empfohlen wird NPU-Kerneltreiber 0.9.2 oder neuer. Aktualisieren Sie ihn bei Problemen zunächst auf die neueste Version.
Die Kompatibilität der von RKNN-Toolkit2 exportierten Modelle mit Runtime-Versionen ist nachfolgend angegeben.
Tabelle 5-6. Zuordnung von RKNN-Modellen und Runtime-Versionen
| RKNN-Modellversion | Runtime-Version |
|---|---|
| 1.2.0 | >=1.2.0 und <=1.5.0 |
| 1.3.0 | >=1.3.0 und <=1.5.0 |
| 1.4.0 | >=1.4.0 und <=1.5.0 |
| 1.5.0 | 1.5.0 |
| 1.5.2 | >=1.5.2 |
| 1.6.0 | >=1.5.2 |
| 2.0.0 | >=2.0.0 |
| 2.1.0 | >=2.0.0 |
NPU-Kerneltreiber aktualisieren
Zum Aktualisieren des NPU-Treibers wird ein vollständiges Firmware-Update empfohlen. Die passende Firmware kann der Anbieter bereitstellen.
NPU-Nutzung in Docker auf der Platine
Für NPU-Zugriff einer Docker-Anwendung auf der Platine müssen beim Containerstart die NPU-Ressourcen eingebunden werden. Beispielbefehl:
docker run -t -i --privileged -v /dev/dri/renderD129:/dev/dri/renderD129 -v /proc/device-
tree/compatible:/proc/device-tree/compatible -v /usr/lib/librknnrt.so:/usr/lib/librknnrt.so ai_application:v1.0.0
/bin/bash
Beachten Sie: - /dev/dri/renderD129: NPU-Geräteknoten des RK3588; die Runtime benötigt ihn zum Aktivieren der NPU. - /proc/device-tree/compatible: enthält das SoC-Modell; Komponenten wie RKNN-Toolkit Lite2 lesen daraus die SoC-Information. - /usr/lib/librknnrt.so: Runtime-Bibliothek, über die RKNN-Toolkit Lite2 und die RKNPU2 C API NPU-Ressourcen nutzen. - ai_application:v1.0.0: Name und Version des Container-Images.
5.4.2 Installationsprobleme bei RKNN-Toolkit2
Zu strenge RKNN-Toolkit2-Abhängigkeiten verhindern die Installation
Sind alle Abhängigkeiten installiert, stimmen aber einzelne Versionen nicht mit den Anforderungen überein, kann “no-deps” an den Installationsbefehl angehängt werden, um die Umgebungsprüfung zu überspringen. Beispiel:
pip install rknn-toolkit2*.whl --no-deps
Hinweise zur PyTorch-Abhängigkeit
Das Laden von PyTorch-Modellen in RKNN-Toolkit2 hängt von PyTorch ab. Es gibt Gleitkommamodelle und quantisierte Modelle einschließlich QAT und PTQ.
Für mit PyTorch 1.6.0 exportierte Modelle wird empfohlen, die PyTorch-Abhängigkeit von RKNN-Toolkit2 auf 1.6.0 zurückzusetzen, um Ladefehler zu vermeiden.
Für QAT/PTQ-Modelle empfehlen wir den Export mit PyTorch 1.10~1.13.1 und dieselbe Aktualisierung der PyTorch-Abhängigkeit von RKNN-Toolkit2.
Die zum Export des Originalmodells verwendete PyTorch-Version sollte möglichst mit der PyTorch-Abhängigkeit von RKNN-Toolkit2 übereinstimmen.
Empfohlene PyTorch-Versionen: 1.6.0, 1.9.0, 1.10 und 1.13.1.
Hinweise zur TensorFlow-Abhängigkeit
Das Laden von TensorFlow-Modellen hängt von TensorFlow ab. Da die Versionskompatibilität meist eingeschränkt ist, können andere Versionen Ladefehler in RKNN-Toolkit2 verursachen. Die Exportversion sollte daher der TensorFlow-Abhängigkeit von RKNN-Toolkit2 entsprechen.
TensorFlow-Versionsprobleme treten meist bei “rknn.load_tensorflow()” auf; die Meldung verweist auf den TensorFlow-Abhängigkeitspfad.
Empfohlen werden TensorFlow 2.6.2 oder 2.8.0.
Benennungsregeln der RKNN-Toolkit2-Installationspakete. Am Beispiel der Version
1.5.2 gelten folgende Benennungsregeln für das RKNN-Toolkit2-Wheel:
rknn_toolkit2-1.5.2+b642f30c-cp38-cp38-linux_x86_64.whl
rknn_toolkit2: Werkzeugname.
1.5.2: Versionsnummer.
b642f30c: Commit-ID.
cp<xx>-cp<xx>: passende Python-Version; cp38-cp38 bezeichnet beispielsweise Python 3.8.
linux_x86_64: Systemtyp und CPU-Architektur.
Wählen Sie das Paket passend zu Betriebssystem, CPU-Architektur und Python-Version; andernfalls schlägt die Installation fehl.
Gibt es RKNN-Toolkit2 für ARM Linux
RKNN-Toolkit2 besitzt keine ARM-Linux-Version. Für Python-Inferenz unter ARM Linux kann RKNN-Toolkit-lite2 installiert werden.
Installation der bfloat16-Abhängigkeit schlägt fehl
Bei der Installation der bfloat16-Bibliothek tritt folgender Fehler auf:
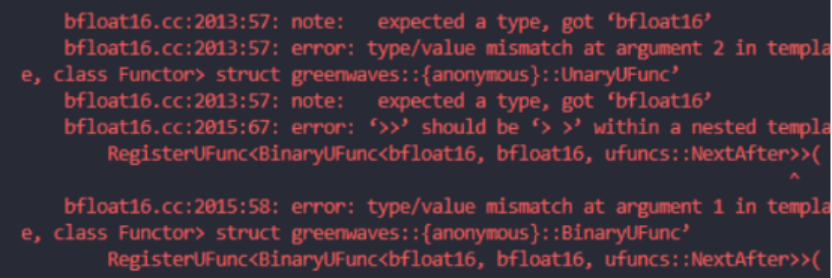
Abbildung 5-19. Fehlerprotokoll der bfloat16-Installation
Wechseln Sie die pip-Quelle zum Alibaba-Spiegel oder aktualisieren Sie RKNN-Toolkit2 auf 1.5.0 oder neuer; ab dieser Version entfällt die bfloat16-Abhängigkeit.
5.4.3 Beschreibung der Modellkonvertierungsparameter
Dieser Abschnitt beschreibt häufig verwendete Parameter der Modellkonvertierung.
Vom Modell bestimmte Parameter
Die Schnittstellen rknn.config() und rknn.build() beeinflussen das Konvertierungsergebnis.
Die in rknn.load_onnx() und rknn.load_tensorflow() festgelegten Ein- und Ausgabeknoten beeinflussen die Konvertierung.
Die in rknn.load_pytorch() und rknn.load_tensorflow() festgelegten Eingabegrößen beeinflussen die Konvertierung.
Grundlegende Schritte der Modellkonvertierung:
-
Bereiten Sie Quantisierungsdaten und dataset.txt vor.
-
Bestimmen Sie die NPU-Plattform, etwa RK3566 oder RV1106, und setzen Sie target_platform in rknn.config().
-
Bei dreikanaligen Eingabebildern und Kalibrierungsdaten als jpg/png prüfen Sie RGB oder BGR, um den Wert von quant_img_RGB2BGR in rknn.config() festzulegen.
-
Prüfen Sie die Normalisierungsparameter des Trainings und setzen Sie mean_values und std_values in rknn.config.
-
Bestimmen Sie die Modelleingabegröße und tragen Sie sie in den passenden load-Parameter ein, etwa input_size_list in rknn.load_pytorch().
-
Bestimmen Sie die Quantisierungsbitbreite für quantized_dtype in rknn.config(). Bei nicht quantisierten oder bereits quantisiert geladenen Modellen entfällt dieser Schritt.
-
Wählen Sie den Quantisierungsalgorithmus für quantized_algorithm in rknn.config(). Bei nicht quantisierten oder bereits quantisiert geladenen Modellen entfällt dieser Schritt.
-
Entscheiden Sie über die Quantisierung und setzen Sie do_quantization in rknn.build(). Bei Quantisierung muss auch dataset die Kalibrierungsdaten angeben.
9. Plattformübergreifende Kompatibilität von RKNN-Modellen
Für target_platform in rknn.config() gelten folgende Kompatibilitäten:
Modelle für RK3566 und RK3568 sind untereinander kompatibel.
Modelle für RK3588 und RK3588S sind untereinander kompatibel.
Modelle für RV1103 und RV1106 sind untereinander kompatibel.
10. Format und Anforderungen der Quantisierungskalibrierungsdaten
Es gibt zwei Formate: jpg/png-Bilder, die RKNN-Toolkit2 über OpenCV liest, und npy, das über numpy gelesen wird.
Für Eingaben, die keine RGB/BGR-Bilder sind, wird numpy npy empfohlen.
11. Ausfüllen von dataset.txt für Modelle mit mehreren Eingaben
dataset.txt gibt die Pfade zu den Quantisierungsdaten an. Eine Zeile entspricht einem Eingabesatz; mehrere Modelleingaben stehen in derselben Zeile und werden durch Leerzeichen getrennt.
Beispiel zweier Datensätze für ein Modell mit einer Eingabe:
sampleA.npy
sampleB.npy
Für ein Modell mit drei Eingaben werden zwei Datensätze wie folgt eingetragen:
sampleA_in0.npy sampleA_in1.npy sampleA_in2.npy
sampleB_in0.npy sampleB_in1.npy sampleB_in2.npy
12 quant_img_RGB2BGR in rknn.config() prüfen
Bei jpg/png-Kalibrierungsbildern muss quant_img_RGB2BGR berücksichtigt werden.
Bei RGB-Training setzen Sie quant_img_RGB2BGR=False oder lassen den Parameter weg. Auch bei Inferenz über Python oder RKNPU2 C API sind RGB-Bilder einzugeben.
Bei BGR-Training setzen Sie quant_img_RGB2BGR=True. Auch über Python oder RKNPU2 C API sind BGR-Bilder einzugeben; der Parameter wirkt nur beim Lesen der Kalibrierungsbilder.
Bei numpy-npy-Kalibrierungsdaten sollte quant_img_RGB2BGR zur Vermeidung von Verwechslungen nicht verwendet werden.
13 Berechnungsreihenfolge von mean, std und quant_img_RGB2BGR in rknn.config()
quant_img_RGB2BGR steuert nur die Kanalumwandlung beim Lesen der Kalibrierungsbilder und beeinflusst keine anderen Schritte. Deshalb subtrahieren die RKNN-Toolkit2-Inferenzschnittstelle und die RKNPU2 C API lediglich mean und dividieren danach durch std; eine Kanalumwandlung erfolgt nicht.
14. Festlegen von mean_values und std_values in rknn.config() bei Eingaben ohne drei Kanäle oder bei mehreren Eingaben
mean_values und std_values verwenden dasselbe Format. Als Beispiel dient mean_values.
Bei N Eingabekanälen lautet mean_values [[channel_1, channel_2, channel_3, channel_4, …, channel_n]].
Bei mehreren Eingaben lautet mean_values: [[channel_1, channel_2, channel_3, channel_4, …, channel_n], [channel_1, channel_2, channel_3, channel_4, …, channel_n]].
15. Auswahl des Korrekturalgorithmus für Quantisierungsparameter und der Anzahl von Kalibrierungsbildern
quantized_algorithm in rknn.config() bietet normal, mmse und kl_divergence; Standard ist normal. normal korrigiert Parameter konventionell; mmse berechnet Zwischenlayer iterativ und begrenzt Gewichte auf einen Bereich, um die Genauigkeit zu erhöhen. mmse garantiert keine Verbesserung, benötigt aber mehr Speicher und Konvertierungszeit als normal. kl_divergence dauert etwas länger als normal, jedoch deutlich kürzer als mmse, und kann bei ungleichmäßiger Merkmalsverteilung helfen.
Beginnen Sie mit normal; bei schlechtem Ergebnis probieren Sie mmse oder kl_divergence.
Für normal oder kl_divergence werden 20–200 Datensätze empfohlen, für mmse 20–50.
16. Unterschiede der Ein- und Ausgaben quantisierter und nicht quantisierter Modelle
Bei der allgemeinen RKNPU2 C API ohne pass_through und zero_copy ist der Eingabedatentyp, etwa uint8 oder float, unabhängig von der Modellquantisierung. Die Ausgabe kann automatisch in float32 konvertiert oder direkt im Datentyp des Ausgabeknotens ausgegeben werden. Die Python-Schnittstelle unterscheidet sich geringfügig. Es gelten folgende Zusammenhänge:
Tabelle 5-7. Unterschiede zwischen Python-Inferenzschnittstelle und allgemeiner C API
| Nach Modellquantisierung | Python-Inferenz (rknn.inference()) | C-API-Inferenz (rknn.run()), ohne pass_through und zero_copy |
|---|---|---|
| Ist der Eingabetyp beschränkt | Keine Beschränkung. rknn.inference() erhält ein numpy-Array mit eigenem Datentypattribut; die Eingabe wird automatisch in das vom RKNN-Modell benötigte Format konvertiert. | Keine Beschränkung. rknn_tensor_type in rknn_inputs kann passend zur tatsächlichen Eingabe auf RKNN_TENSOR_FLOAT32, RKNN_TENSOR_FLOAT16, RKNN_TENSOR_INT8, RKNN_TENSOR_UIN8 oder RKNN_TENSOR_INT16 gesetzt werden. Die Daten werden anschließend automatisch ins Modellformat konvertiert. |
| Ändert sich der Ausgabetyp | Nein. Unabhängig von der Quantisierung liefert rknn.inference() in Python immer float; andere Datentypen sind nicht wählbar. | Ja. Über rknn outputs attr der RKNPU2 C API kann want_float=1 für float gesetzt werden. Nach Quantisierung liefert want_float=0 die Rohdaten des letzten Knotens, beispielsweise int8 bei i8-Quantisierung. |
| Ändert sich das Eingabeformat (NCHW, NHWC) | Nein. Unabhängig von der Quantisierung kann data_format in rknn.inference() nach Bedarf nchw oder nhwc sein. | Nein. Unabhängig von der Quantisierung kann rknn_tensor_format der Struktur rknn inputs nach Bedarf NCHW oder NHWC sein. |
Gibt es einen Online-Vorkompilierungsmodus
RKNN-Toolkit2 exportiert nur offline vorkompilierte Modelle. Online-Vorkompilierung wie in RKNN-Toolkit1 wird nicht unterstützt; eine Modusauswahl besteht daher nicht.
Kann ein mit RKNN-Toolkit konvertiertes Modell auf RK3566 verwendet werden
Nein.
RKNN-Toolkit-Modelle gelten für RK1806 / RK1808 / RK3399Pro / RV1109 / RV1126. RK3566 benötigt RKNN-Toolkit2; dessen Modelle gelten für RK3566 / RK3568 / RK3588 / RK3588S / RV1103 / RV1106 / RK3562 / RK3576 / RV1126B.
Hinweise zu RKNN-Toolkit stehen im folgenden Projekt:
https://github.com/airockchip/rknn-toolkit
Hinweise zu RKNN-Toolkit2 stehen im folgenden Projekt:
https://github.com/airockchip/rknn-toolkit2
5.4.4 Häufige Fragen zu Deep-Learning-Frameworks
5.4.4.1 UNTERSTÜTZTE DEEP-LEARNING-FRAMEWORKS UND VERSIONEN VON RKNN-TOOLKIT2
Siehe Kapitel 2.1.
5.4.4.2 Unterstützte Operatoren je Framework
RKNN-Toolkit2 unterstützt verschiedene Frameworks in unterschiedlichem Umfang. Details enthält das Dokument RKNNToolkit2_OP_Support unter folgendem Link:
https://github.com/airockchip/rknn-toolkit2/blob/master/doc/
5.4.4.3 Fragen zur Konvertierung von ONNX-Modellen
„Error parsing message“ beim Laden des Modells
Beispielsweise schlägt die Konvertierung des Modells examples/onnx/resnet50v2 mit folgender Meldung fehl:
E load_onnx: Catch exception when loading onnx model: /rknn_resnet_demo/resnet50v2.onnx!

E lod_onnx: Traceback (most recent call last):

E load_onnx: File "rknn/api/rknn_base.py", line 1094, in rknn.api.rknn_base.RKNNBase.load_onnx

E load_onnx: File "/usr/local/lib/python3.6/dist-packages/onnx/__init__.py", line 115, in load_model

……

E load_onnx: google.protobuf.message.DecoderError: Error parsing message
Möglicherweise ist resnet50v2.onnx beschädigt oder nicht vollständig heruntergeladen. Laden Sie das Modell erneut herunter und prüfen Sie den MD5-Wert, beispielsweise:
22ed6e6a8fb9192f0980acca0c941414 resnet50v2.onnx
Werden dynamische Eingabeformen unterstützt?
Eine ONNX-Eingabeform [-1, 3, -1, -1] bedeutet beispielsweise, dass batch, height und width nicht festgelegt sind. RKNN-Toolkit2 vor Version 1.5.2 unterstützt keine dynamischen Eingabeformen.
Ab 1.5.2 werden dynamische Eingabeformen über dynamic_input in rknn.config() unterstützt; Details siehe 4.1.3.
Fehler beim Festlegen eines eigenen Ausgabeknotens
Beispielsweise erzeugt rknn.load_onnx() mit gesetztem outputs-Parameter folgenden Fehler:
E load_onnx: the '378' in outputs=['378', '439', '500'] is invalied!
Das Protokoll meldet, dass Ausgabeknoten 378 ungültig ist. outputs muss auf den korrekten Namen des Ausgabeknotens gesetzt werden.
5.4.4.4 Fragen zur Konvertierung von Pytorch-Modellen
Fehler beim Laden eines Pytorch-Modells: torch._C besitzt kein Attribut _jit_pass_inline
Fehlerprotokoll:
'torch._C' has no attribute '_jit_pass_inline'
Aktualisieren Sie PyTorch auf 1.6.0 oder neuer.
Speicherformat von Pytorch-Modellen
Derzeit werden nur mit torch.jit.trace() exportierte Modelle unterstützt. torch.save() speichert lediglich das Wörterbuch der Gewichtsparameter ohne Netzwerkstruktur. Es lässt sich deshalb nicht regulär importieren und in ein RKNN-Modell konvertieren.
PytorchStreamReader-Fehler bei der Konvertierung
Fehlerprotokoll:
E Catch exception when loading pytorch model: ./mobilenet0.25_Final.pth!

E Traceback (most recent call last):

……

E cpp_module = torch._C.import_ir_module(cu, f, map_location, extra_files)

E RuntimeError: [enforce fail at inline container.cc:137]. PytorchStreamReader failed reading zip archive: faild
finding central directory frame #0 ……
Ursache ist, dass das PyTorch-Modell keine Informationen zur Netzwerkstruktur enthält.
Eine .pth-Datei enthält meist nur Gewichte, keine Netzstruktur. Initialisieren Sie für einen vollständigen Export zunächst die Struktur und laden Sie .pth über net.load_state_dict(). Fixieren Sie Struktur und Gewichte mit torch.jit.trace() und speichern Sie anschließend mit torch.jit.save() das getracete Modell als .pt, damit rknn.load_pytorch() es in RKNN konvertieren kann.
KeyError bei der Konvertierung
Fehlerprotokoll:
E Traceback (most recent call last):

……

E KeyError: 'aten::softmax'
Eine Meldung wie KeyError: ‘aten::xxx’ bedeutet, dass die aktuelle Version diesen Operator nicht unterstützt. Solche Fehler werden mit RKNN-Toolkit2-Updates behoben; verwenden Sie die neueste Version.
„Syntax error in input! LexToken(xxx)“ bei der Konvertierung
Fehlerprotokoll:
WARNING: Token 'COMMENT' defined, but not used

WARNING: There is 1 unused token

!!!!! Illegal character '"'

Syntax error in input! LexToken(NAMED_IDENTIFIER, 'fc', 1, 27)

!!!!! Illegal character '"'
Dieser Fehler kann mehrere Ursachen haben. Prüfen Sie in folgender Reihenfolge:
) Das Netzwerk wurde nicht von torch.nn.module abgeleitet. Erstellen Sie es durch Ableitung von torch.nn.module und erzeugen Sie danach die pt-Datei mit torch.jit.trace().
) Aktualisieren Sie RKNN-Toolkit2 auf 1.4.0 oder neuer. Empfohlene torch-Versionen sind 1.6.0, 1.9.0, 1.10.0 oder 1.13.1.
5.4.4.5 Fragen zur Konvertierung von Tensorflow-Modellen
Fehler mit einem Tensorflow1.x-Modell
Beim Laden eines tensorflow1.x-Modells über rknn.load_tensorflow() erscheint folgende Meldung:
E load_tensorflow: Catch exception when loading tensorflow model: ./yolov3_mobilenetv2.pb!

E load_tensorflow: Traceback (most recent call last):

……

E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects to be colocated with unknown node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'

E load_tensorflow: During handling of the above exception, another exception occurred:

E load_tensorflow: Traceback (most recent call last):

E load_tensorflow: File "rknn/api/rknn_base.py", line 990, in rknn.api.rknn_base.RKNNBase.load_tensorflow

……

E load_tensorflow: return func(*args, **kwargs)

E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
431, in import_graph_def

E load_tensorflow: raise ValueError(str(e))

E load_tensorflow: ValueError: Node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects
to be colocated with unknown node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'
Empfehlung:
Wenn TensorFlow 1.x installiert ist, aktualisieren Sie auf TensorFlow 2.x.
Aktualisieren Sie RKNN-Toolkit2/RKNPU2 auf die neueste Version.
TransformGraph-Fehler
Fehlerprotokoll:
Traceback (most recent call last):

File "test.py", line 80, in <module>

input_size_list=[[1, 368, 368, 3]])

File "/usr/local/lib/python3.6/site-packages/rknn/api/rknn.py", line 68, in
load_tensorflow

input_size_list=input_size_list, outputs=outputs)

File "rknn/api/rknn_base.py", line 940, in
rknn.api.rknn_base.RKNNBase.load_tensorflow

File "/usr/local/lib/python3.6/dist-
packages/tensorflow/tools/graph_transforms/__init__", line 51, in
TransformGraph.transforms_string, status)

File "/usr/local/lib/python3.6/dist-
packages/tensorflow/python/framework/errors_impl.py". ;ome 548, in __exit__

C_api.TF_GetCode(self.status.status)

Tensorflow.python.framework.error_impl.InvalidArgumentError: Beta input to batch
norm has bad shape: [24]
Ursachen:
) RKNN-Toolkit2 ruft zur Modelloptimierung die native TensorFlow-Funktion TransformGraph auf, die jedoch fehlschlägt.
) Möglicherweise ist die beim Export verwendete TensorFlow-Version nicht mit der installierten Version kompatibel.
Empfehlung:
Exportieren Sie das Modell mit TensorFlow 1.14.0 oder suchen Sie ein entsprechendes Modell in einem anderen Deep-Learning-Framework.
Fehler “Shape must be rank 4 but is rank 0”
Beim Laden des pb-Modells mit folgendem Befehl:
  rknn.load_tensorflow(tf_pb='./model.pb',

  inputs=["X","Y"],

  outputs=['generator/xs'],

  input_size_list=1, INPUT_SIZE, INPUT_SIZE, 3)
Folgender Fehler tritt auf:
  E load_tensorflow: Catch exception when loading tensorflow model: ./model.pb!

  E load_tensorflow: Traceback (most recent call last):

  E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
427, in import_graph_def

  E load_tensorflow: graph._c_graph, serialized, options) # pylint: disable=protected-access

  E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Shape must be rank 4 but is
rank 0 for 'generator/conv2d_3/Conv2D' (op: 'Conv2D') with input shapes: [], [7,7,3,32].
Möglicherweise besitzt das Modell mehrere Eingaben und input_size_list von rknn.load_tensorflow() wurde nicht gemäß Vorgabe ausgefüllt. Siehe folgendes Beispiel in examples/functions/multi_input_test:
  rknn.load_tensorflow(tf_pb='./conv_128.pb',

  inputs=['input1', 'input2', 'input3', 'input4'],

  outputs=['output'],

  input_size_list=[[1, 128, 128, 3], [1, 128, 128, 3],

  [1, 128, 128, 3], [1, 128, 128, 1]])
Fehlersuche beim Laden von Modellen
Prüfen Sie zunächst, ob das ursprüngliche Framework das Modell korrekt laden und aufrufen kann.
Aktualisieren Sie anschließend RKNN-Toolkit2 auf die neueste Version. Nicht unterstützte Schichten oder Operatoren sollten im Debug-Protokoll erscheinen. Aktivieren Sie bei Bedarf mit RKNN(verbose=True) ausführlichere Konvertierungsprotokolle.
Bleibt das Problem bestehen, übermitteln Sie die RKNN-Toolkit2-Version und das ausführliche Fehlerprotokoll an das Rockchip-NPU-Entwicklungsteam.
5.4.5 Probleme bei der Modellquantisierung
Auswirkung der Quantisierung auf die Modellgröße
Es gibt zwei Fälle. Bei einem importierten quantisierten Modell verwendet do_quantization=False in rknn.build() dessen Quantisierungsparameter. Bei einem Gleitkommamodell erfolgt keine Quantisierung, die Gewichte werden jedoch nahezu ohne Genauigkeitsverlust von float32 in float16 umgewandelt. Beide Fälle reduzieren die Modellgröße und damit den Speicherbedarf.
Müssen Quantisierungsbilder dieselbe Größe wie die Modelleingabe haben?
Nicht erforderlich.
RKNN-Toolkit2 passt die Bildgröße automatisch an. Dies kann jedoch Bildinformationen verändern und die Quantisierungsgenauigkeit beeinflussen. Bilder in der passenden Eingabegröße sind daher vorzuziehen.
Bei Kalibrierungsdaten in einem Nicht-Bildformat, etwa npy, muss die Form mit der Modelleingabe übereinstimmen.
Müssen Kalibrierungsdaten an rknn_batch_size angepasst werden?
Nicht erforderlich.
rknn_batch_size in rknn.build() ändert nur die batch-Dimension des endgültig exportierten RKNN-Modells von 1 auf rknn_batch_size und beeinflusst die Quantisierung nicht. Kalibrierungsdaten werden daher wie für ein Modell ohne Batch-Verarbeitung vorbereitet.
Konvertierungsprogramm hängt oder wird während der Quantisierung beendet
Während der Modellquantisierung reserviert RKNN-Toolkit2 Bereiche des Systemspeichers. Dadurch kann das Programm hängen oder vom System beendet werden.
Lösung: Vergrößern Sie den Arbeitsspeicher oder den virtuellen Speicher (Swap-Partition).
5.4.6 Probleme bei der Modellkonvertierung
Häufige Konvertierungsfehler durch Programmfehler
Ein Konvertierungsfehler wie der folgende wird wahrscheinlich durch einen Fehler der aktuellen Version verursacht. Probieren Sie die neueste RKNN-Toolkit2-Version.
Fehler im Zusammenhang mit infer_shapes
  (op_type:Mul, name:Where_2466_mul): Inferred elem type differs from existing elem type: (FLOAT) vs
(INT64)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1555, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 5409, in rknn.api.graph_optimizer.GraphOptimizer.run

  E build: File "rknn/api/graph_optimizer.py", line 5123, in
rknn.api.graph_optimizer.GraphOptimizer._fuse_ops

  E build: File "rknn/api/ir_graph.py", line 180, in rknn.api.ir_graph.IRGraph.rebuild

  E build: File "rknn/api/ir_graph.py", line 140, in rknn.api.ir_graph.IRGraph._clean_model

  E build: File "rknn/api/ir_graph.py", line 56, in rknn.api.ir_graph.IRGraph.infer_shapes

  E build: File "/home/anaconda3/envs/rk2/lib/python3.6/site-packages/onnx/shape_inference.py", line 35, in
infer_shapes

  E build: inferred_model_str = C.infer_shapes(model_str, check_type)

  E build: RuntimeError: Inferred elem type differs from existing elem type: (FLOAT) vs (INT64)
oder:
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1643, in
rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 6256, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops
E build: File "rknn/api/ir_graph.py", line 285, in
rknn.api.ir_graph.IRGraph.rebuild
E build: File "rknn/api/ir_graph.py", line 149, in
rknn.api.ir_graph.IRGraph._clean_model
E build: File "rknn/api/ir_graph.py", line 62, in
rknn.api.ir_graph.IRGraph.infer_shapes
E build: File "/usr/local/lib/python3.6/dist-packages/onnx/shape_inference.py",
line 35, in infer_shapes
E build: inferred_model_str = C.infer_shapes(model_str, check_type)
E build: RuntimeError: Inferred shape and existing shape differ in rank: (0) vs
(3)
oder:
  (op_type:ReduceMax, name:ReduceMax_18): Interred shape and existing shape differ in rank: (3) vs (0)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  ……

  E build: RuntimeError: Interred shape and existing shape differ in rank: (3) vs (0)
Fehler im Zusammenhang mit _p_fuse_two_mul
  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 6197, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops

  E build: File "rknn/api/graph_optimizer.py", line 204, in rknn.api.graph_optimizer._p_fuse_two_mul

  E build: ValueError: non-broadcastable output operand with shape () doesn't match the broadcast shape
(3,2)
Fehler wie „Segmentation fault“
Beispiel eines Fehlers bei der picodet-Konvertierung:
I _fold_constant remove nodes = ['Shape_0', 'Gather_4', 'Shape_1', 'Gather_6',
'Unsqueeze_0', 'Concat_8', 'Cast_3']
**Segmentation fault (Core dumped)**
Fehler im Zusammenhang mit _p_fuse_mul_into_conv
E build: Catch exception when building RKNN model:

……
E build: ValueError: non broadcastable output operand whith shape (1,258,1,256) doesn`t match the
broadcast shape (80256,258,1,256)
So prüfen Sie die Operatorunterstützung in RKNN
Konvertieren Sie das Modell direkt; fehlende Unterstützung wird durch eine entsprechende Meldung angezeigt.
Siehe auch „06_RKNN2_Supported_Operators_and_Constraints_Reference_V2.5.0“ mit Operatorlisten der Frameworks und detaillierten RKNN-Operatorgrenzen.
Meldung über fehlende Expand-Unterstützung bei der Konvertierung
Empfehlungen:
1) Neuere Versionen unterstützen Expand auf der CPU. Aktualisieren Sie versuchsweise RKNN-Toolkit2 / RKNPU2.
2) Ändern Sie das Modell und verwenden Sie repeat statt expand.
Meldung “Meet unsupported dims in reducesum” bei der Konvertierung
Bei der Konvertierung erscheint Meet unsupported dims in reducesum, dims: 6, beispielsweise:
D RKNN: [14:54:19.434] >>>>>> start: N4rknn17RKNNInitCastConstE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn17RKNNInitCastConstE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn20RKNNMultiSurfacePassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn20RKNNMultiSurfacePassE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn14RKNNTilingPassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn14RKNNTilingPassE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn23RKNNProfileAnalysisPassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn23RKNNProfileAnalysisPassE
D RKNN: [14:54:19.434] >>>>>> start: OpEmit
E RKNN: [14:54:19.438] Meet unsupported dims in reducesum, dims: 6
Aborted (core dumped)
RKNN unterstützt derzeit keine sechsdimensionalen OPs; meist werden nur vier Dimensionen unterstützt.
Konvertierungsfehler durch Nachverarbeitungsoperatoren wie NonMaxSuppression
Nachverarbeitungsoperatoren wie NonMaxSuppression werden derzeit von RKNN nicht unterstützt.
Der Nachverarbeitungsteilgraph kann entfernt werden, beispielsweise:
rknn.load_onnx(model='picodet_xxx.onnx', outputs=['concat_4.tmp_0', 'tmp_16'])
Der entfernte Teilgraph wird separat auf der CPU ausgeführt.
Fehler wie „invalid expand shape“
Beispielsweise tritt beim Konvertieren von rvm_mobilenetv3_fp32.onnx folgender Fehler auf:
[E:onnxruntime:, sequential_executor.cc:333 Execute] Non-zero status code
returned while running Expand node. Name:'Expand_294' Status Message: invalid
expand shape

E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1638, in
rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 5529, in
rknn.api.graph_optimizer.GraphOptimizer.fold_constant
E build: File "rknn/api/session.py", line 69, in rknn.api.session.Session.run
E build: File "/home/cx/work/tools/Anaconda3/envs/rknn/lib/python3.8/site-
packages/onnxruntime/capi/onnxruntime_inference_collection.py", line 124, in
run
E build: return self._sess.run(output_names, input_feed, run_options)
E build: onnxruntime.capi.onnxruntime_pybind11_state.InvalidArgument:
[ONNXRuntimeError] : 2 : INVALID_ARGUMENT : Non-zero status code returned while
running Expand node. Name:'Expand_294' Status Message: invalid expand shape
Der Eingabewert downsample_ratio verändert die Größe von Zwischenmerkmalen; der Graph ist damit dynamisch. Ändern Sie die downsample_ratio-Logik so, dass Eingabewerte keine Zwischenformen steuern. Nach Aktualisierung auf RKNN-Toolkit2 1.5.2 können dynamische Shapes einen dynamischen Graphen nachbilden. Auch dabei muss downsample_ratio so geändert werden, dass Eingabewerte keine Zwischenformen steuern; derzeit ist nur eine veränderliche Eingabeform unterstützt.
mean_values-Fehler in rknn.config()
mean/std sind wie folgt eingestellt:
rknn.config(mean_values=[128, 128, 128], std_values=[128, 128, 128])
Danach tritt folgender Konvertierungsfehler auf:
--> Loading model

transpose_input for input_1: shape must be rank 4, ignored

E load_tflite: The len of mean_values ([128, 128, 128]) for input 0 is wrong, expect 32!
Möglicherweise ist die Modelleingabe kein dreikanaliges Bild, beispielsweise nicht bildförmige Daten mit Shape 1x32. Dann gilt:
Setzen Sie mean_values / std_values entsprechend der Eingabekanalzahl.
Sind mean/std nicht erforderlich, können mean_values / std_values in rknn.config() entfallen; mean/std wirken normalerweise nur bei Bildeingaben.
Fehler bei OPs mit mehr als 4 Dimensionen, etwa 5 oder 6
Enthält das Modell OPs mit mehr als 4 Dimensionen, etwa 5 oder 6, tritt folgender Fehler auf:
E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1580, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/rknn_base.py", line 341, in rknn.api.rknn_base.RKNNBase._generate_rknn

E build: File "rknn/api/rknn_base.py", line 307, in rknn.api.rknn_base.RKNNBase._biild_rknn

E build: IndexError: vector::_M_range_check: __n (which is 4) >= this->size() (which is 4)
RKNN unterstützt derzeit keine OPs mit mehr als 4 Dimensionen. Diese Knoten können manuell entfernt werden.
Unterstützt RKNN dynamische Faltung
RK3588/RK3576/RV1126B unterstützen dynamische Faltung mit group=1. Andere Plattformen werden noch nicht unterstützt.
Fehler „Not support input data type ‘float16’“
Beim Konvertieren eines PyTorch-Modells mit float16-Gewichten nach RKNN tritt folgender Fehler auf:
--> Building model

E build: Not support input data type 'float16'

W build: ==================== WARN(3) =================

E rknn-toolkit2 version: 1.3.0-11912b58

E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/graph_optimizer.py", line 5524, in rknn.api.graph_optimizer.GraphOptimzer.fold_constant

E build: File "rknn/api/load_checker.py", line 63, in rknn.api.load_checker.create_random_data

E build: File "rknn/api/rknn_log.py", line 113, in rknn.api.rknn_log.RKNNLog.e

E build: ValueError: Not support input data type 'float16'!
RKNN-Toolkit2 unterstützt PyTorch-Modelle mit float16-Gewichten noch nicht; ändern Sie sie in float32.
Fehler im Zusammenhang mit dynamischen Graphen
Wenn bei der Modellkonvertierung ein Fehler wie der folgende auftritt:
E build: ValueError: The Op of 'NonZero' is not support! it will cause the graph to be a dynamic graph!
Dieser OP weist auf einen dynamischen Graphen hin. Ändern Sie das Modell manuell, indem Sie den OP ersetzen oder entfernen.
Größe des RKNN-Modells
Das konvertierte RKNN-Modell kann größer als das Original sein, teilweise abhängig von der Eingabeform. Das ist normal: Neben Gewichten und Graph enthält es viele NPU-Registerkonfigurationen. Auch OP-Zerlegungen und andere Maßnahmen zur höheren Laufzeiteffizienz vergrößern das Modell.
5.4.7 Inferenz im Simulator oder auf dem Gerät
Begriffserklärung
Simulator-Inferenz: RKNN-Toolkit2 stellt unter Linux x86_64 einen Simulator bereit, der Modellinferenz ohne Entwicklungsboard ermöglicht. Die Ergebnisse können vom Board abweichen; Inferenz über ein verbundenes Board oder direkt darauf wird bevorzugt.
Inferenz mit verbundenem Board: Das Board ist mit dem PC verbunden; Modellinferenz und Ergebnisabruf erfolgen über die RKNN-Toolkit2 Python API.
Inferenz direkt auf dem Board: Die Ergebnisse werden über das RKNPU2 C API ermittelt.
Simulator-Ergebnisse weichen vom verbundenen Board ab
Dies kann bedeuten, dass die Ergebnisse auf dem Board falsch sind.
Wegen Unterschieden in Hardware und Treibern sind identische Ergebnisse nicht garantiert. Große Abweichungen deuten jedoch wahrscheinlich auf einen Fehler im Boardtreiber hin. Melden Sie das Problem dem RK-NPU-Team zur Analyse und Fehlersuche.
Funktionsweise der Inferenz mit verbundenem Board
RKNN-Toolkit2 kommuniziert mit rknn_server auf dem Board. Modell und Eingabedaten werden vom PC übertragen; anschließend führt RKNPU2 C API die Inferenz auf dem Board aus. Nach Abschluss werden die Ergebnisse an den PC zurückgesendet.
Unterschiede zwischen Inferenz über ein verbundenes Board und direkt auf dem Board
Inferenz mit verbundenem Board basiert auf RKNPU2 C API. Theoretisch sollten die Ergebnisse daher übereinstimmen. Prüfen Sie bei großen Abweichungen Vorverarbeitung, Datentyp und Datenanordnung (NCHW, NHWC).
Sehr kleine Abweichungen sind normal. Sie können etwa durch unterschiedliche Bibliotheken zum Lesen von Bildern oder zur Datentypkonvertierung entstehen.
Direkte Board-Inferenz ist schneller als Inferenz über ein verbundenes Board
Inferenz mit verbundenem Board benötigt zusätzliche Datenkopien und Übertragungen und ist daher langsamer als die direkte Ausführung mit RKNPU2 C API. Maßgeblich für die tatsächliche NPU-Leistung ist deshalb die direkte Board-Inferenz mit RKNPU2 C API.
Ausführlichere Protokolle erhalten
Bei Inferenz mit verbundenem Board finden Modellinitialisierung und Inferenz überwiegend auf dem Entwicklungsboard statt. Auch die meisten Protokolle entstehen dort.
Melden Sie sich für detaillierte Board-Debug-Informationen über die serielle Schnittstelle am Betriebssystem an. Führen Sie die folgenden zwei Befehle zum Setzen der Protokollierungsvariablen aus. Lassen Sie das serielle Fenster geöffnet und starten Sie die Inferenz mit verbundenem Board. Board-Fehlermeldungen erscheinen dann in diesem Fenster:
export RKNN_LOG_LEVEL=5

restart_rknn.sh
Datenlayout für Batch-Inferenz
Das Eingabelayout von rknn.inference kann über 1data_format=’NCHW’ oder data_format=’NHWC’ als NCHW beziehungsweise NHWC festgelegt werden. Standard ist NHWC.
In rknn-toolkit2 verwenden ONNX-Modelle mit 4D-Eingaben bei der Konvertierung normalerweise NCHW. Bei RKNN-Inferenz ist das Standardlayout jedoch NHWC, und das Toolkit konvertiert intern NCHW zu NHWC. Wird data_format=’NCHW’ ausdrücklich gesetzt, entfällt diese Standardkonvertierung und die Eingabe wird unverändert als NCHW verwendet. Beispiele enthält die GitHub-Diskussion: https://github.com/airockchip/rknn-toolkit2/issues/220.
5.4.8 Häufige Probleme bei der Modellbewertung
Genauigkeit des quantisierten Modells schlechter als erwartet
Siehe Kapitel 5.1 dieses Dokuments.
Welche Frameworks für quantisierte Modelle werden unterstützt
RKNN-Toolkit2 ab 1.4 unterstützt quantisierte Modelle aus TensorFlow, TensorFlow Lite und PyTorch.
Geräteverbindung bei der Platinen-Debugging-Sitzung schlägt fehl
Bei der Genauigkeitsanalyse mit angeschlossener Platine über rknn.accuracy_analysis() tritt folgender Fehler auf:
  E accuracy_analysis: Connect to Device Failure (-1)

  E accuracy_analysis: Catch exception when init runtime!

  E accuracy_analysis: Traceback (most recent call last):

  E accuracy_analysis: File "rknn/api/rknn_base.py", line 2001, in rknn.api.rknn_base.RKNNBase.init_runtime

  E accuracy_analysis: File "rknn/api/rknn_runtime.py", line 194, in
rknn.api.rknn_runtime.RKNNRuntime.__init__

  E accuracy_analysis: File "rknn/api/rknn_platform.py", line 331, in rknn.api.rknn_platform.start_ntp_or_adb
Oder bei der Inferenz über rknn.inference tritt folgender Fehler auf:
I target set by user is: rk3568
I Starting ntp or adb, target is RK3568
I Device [0c6a9900ef4871e1] not found in ntb device list.
I Start adb...
I Connect to Device success!
I NPUTransfer: Starting NPU Transfer Client, Transfer version 2.1.0
(b5861e7@2020-11-23T11:50:36)
D NPUTransfer: Transfer spec = local:transfer_proxy
D NPUTransfer: ERROR: socket read fd = 3, n = -1: Connection reset by peer
D NPUTransfer: Transfer client closed fd = 3

E RKNNAPI: rknn_init, server connect fail! ret = -9(ERROR_PIPE)!
E init_runtime: Catch exception when init_runtime!
E init_runtime: Traceback (most recent call last):
E init_runtime: File "rknn/api/rknn_base.py", line 2001, in
rknn.api.rknn_base.RKNNBase.init_runtime
E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in
rknn.api.rknn_runtime.RKNNRuntime.build_graph
E init_runtime: Exception: RKNN init failed. error code:
RKNN_ERR_DEVICE_UNAVAILABLE
Möglicherweise läuft RKNN Server auf der Platine nicht. Starten Sie den Dienst gemäß 1.2.2.
Bei angeschlossener Platine schlägt rknn_init mit -6 oder model invalid fehl
Fehlermeldung:
E RKNNAPI: rknn_init, msg_load_ack fail, ack = 1(ACK_FAIL), expect 0(ACK_SUCC)!

D NPUTransfer: Transfer client closed, fd = 4

E init_runtime: Catch exception when init runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 2011, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_MODEL_INVALID
Dieser Fehler tritt üblicherweise in folgenden Fällen auf:
Bei der Modellerzeugung müssen RKNN-Toolkit2- und Treiberversionen zueinander passen. Empfohlen wird die Aktualisierung von RKNN-Toolkit2 / RKNPU2 und Platinen-Firmware auf die neuesten Versionen.
Falsches target_platform: Ohne Angabe in rknn.config() läuft das Modell nur auf RK3566/RK3568. Für andere Plattformen wie RK3588/RK3588S/RV1103/RV1106/RK3562 muss der passende Wert in rknn.config() gesetzt werden.
In Docker kann ein nicht beendeter npu_transfer_proxy-Prozess auf dem Host die Kommunikation stören. Verlassen Sie den Container, beenden Sie den Prozess auf dem Host und starten Sie das Inferenzskript erneut im Container.
Auch das Modell selbst kann fehlerhaft sein. Verbinden Sie sich seriell mit der Platine, setzen Sie RKNN_LOG_LEVEL=5 und führen Sie restart_rknn.sh aus. Starten Sie das Programm erneut, sichern Sie die detaillierten Protokolle und geben Sie sie an das Rockchip-NPU-Team weiter.
rknn_init() meldet bei angeschlossener Platine device unavailable
Fehlermeldung:
E RKNNAPI: rknn_init, msg_ioctl_ack fail, data_len = 104985, except 102961!

D NPUTransfer: Transfer client closed, fd = 3

E init_runtime: Catch exception when init_runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 1961, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 360, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_DEVICE_UNAVAILABLE
Die Ursachen sind vielfältig. Prüfen Sie Folgendes:
Stellen Sie sicher, dass RKNN-Toolkit2 / RKNPU2 und die Platinen-Firmware aktuell sind. Die Versionsabfrage der Komponenten ist in 1.2.2 beschrieben.
Das Gerät muss sowohl in adb devices als auch in rknn.list_devices() sichtbar sein; target und device_id in rknn.init_runtime() müssen stimmen.
Runtime-Fehler “Invalid RKNN model version 6”
Die Runtime meldet folgenden Fehler:
  Loading model …

  E RKNN: [09:13:25.728] 6, 1

  E RKNN: [09:13:25.728] Invalid RKNN model version 6

  E RKNN: [06:28:39.049] rknn_init, load model failed!

  Exception: RKNN init failed. error code: RKNN_ERR_FAIL
Ursache:
Die Modellversion ist mit RKNN Runtime inkompatibel.
Empfehlung:
Aktualisieren Sie Modell und Runtime entsprechend der Kompatibilität in Abschnitt 16.1 oder beide gleichzeitig auf die neueste Version.
Runtime-Fehler “Invalid RKNN format”
Die Runtime meldet folgenden Fehler:
Loading model …

E RKNN: [06:28:39.048] parseRKNN from buffer: Invalid RKNN format!

E RKNN: [06:28:39.049] rknn_init, load model failed!

rknn_init error ret=-1
Ursache:
1) target_platform in rknn.config() kann bei der Konvertierung falsch gesetzt sein oder fehlen; ohne Angabe gilt RK3566.
2) Die Runtime-Version ist mit RKNN-Toolkit2 inkompatibel.
Empfehlung:
) Setzen Sie den korrekten target_platform.
2) RKNN-Toolkit2 und Runtime sollten gemeinsam auf dieselbe Version aktualisiert werden.
Laufzeit von rknn.inference() weicht von der theoretischen Geschwindigkeit von rknn.eval_perf() ab
rknn.inference() führt die Platineninferenz über PC + adb aus und verursacht festen Übertragungsaufwand. Daher weicht die Laufzeit vom theoretischen Wert von rknn.eval_perf() ab.
Für eine realistischere Bildrate testen Sie direkt auf der Platine mit der RKNPU2 C API.
Multi-Batch-Unterstützung von rknn.inference()
Ab RKNN-Toolkit2 1.4.0 kann die Anzahl der Eingabebilder beim Modellaufbau angegeben werden. Details stehen bei rknn.build im RKNN-Toolkit2-API-Handbuch.
Ist rknn_batch_size größer als 1, etwa 4, ändern Sie den Python-Inferenzaufruf von:
outputs = rknn.inference(inputs=[img])
zu:
img = np.expand_dims(img, 0)

img = np.concatenate((img, img, img, img), axis=0)

outputs = rknn.inference(inputs=[img])
Vollständiges Beispiel: examples/functions/multi_batch/
Ausführen mehrerer RKNN-Modelle
Für zwei oder mehr Modelle werden mehrere RKNN-Objekte benötigt. Ein Objekt entspricht ähnlich einem Kontext genau einem Modell. Jedes Modell initialisiert sich, führt Inferenz aus und erhält Ergebnisse in seinem eigenen Kontext, ohne andere zu beeinflussen. Auf der NPU laufen die Modelle seriell.
Inferenz dauert sehr lange und liefert falsche Ergebnisse
Dauert die Inferenz länger als 20s und sind die Ergebnisse falsch, liegt meist ein NPU-Hang-Fehler vor. Probieren Sie die neueste Version von RKNN-Toolkit2 / RKNPU2.
Falsche Ergebnisse mit angeschlossener Platine bei dreidimensionaler Eingabe
Bei dreidimensionaler Eingabe kann der Simulator korrekte Ergebnisse liefern, die Platine jedoch nicht. Mögliche Ursache ist die noch unvollständige NPU-Unterstützung für dreidimensionale Eingaben; sie soll später verbessert werden.
Empfehlung:
Ändern Sie die Modelleingabe zunächst auf vier Dimensionen.
Probieren Sie die neueste Version von RKNN-Toolkit2 / RKNPU2.
Ergebnisse mit angeschlossener Platine sind falsch und bei jedem Lauf unterschiedlich
Liefert der Simulator nach ONNX-RKNN-Konvertierung stets korrekte, gleiche Ergebnisse, die Platine jedoch wechselnde falsche, kann ein NPU-Kerneltreiberfehler vorliegen. Aktualisieren Sie den Treiber auf der Platine sowie RKNN-Toolkit2 / RKNPU2.
Genauigkeitsverlust bei vielen Resize-OPs
Bei vielen Resize-OPs in einem ONNX-Modell kann die Genauigkeit nach RKNN-Konvertierung sinken. Mögliche Ursachen:
1) Die NPU unterstützt derzeit kein hardwareseitiges Resize; dies soll später folgen. Der Konverter ersetzt Resize durch ConvTranspose, was geringfügige Genauigkeit kostet.
2) Mehrere aufeinanderfolgende Resize-Operationen akkumulieren Fehler und können größere Genauigkeitsverluste verursachen.
Empfehlung:
1) Vermeiden Sie möglichst Resize, etwa durch Ersatz mit ConvTranspose vor dem Training.
2) Setzen Sie optimization_level=2 in rknn.config(). Resize läuft dann auf der CPU ohne Genauigkeitsverlust, jedoch mit geringerer Leistung.
Alle Ergebnisse sind nan nach do_quantization=False
Sind Ergebnisse mit do_quantization=True in rknn.build() normal, mit False aber nan, kann der Ausgabebereich von Zwischenlayern wie Faltungen bei fp16-Berechnung den fp16-Bereich (65536) überschreiten, beispielsweise -51597~75642.
Empfehlung:
Achten Sie beim Training darauf, dass Zwischenausgaben im darstellbaren fp16-Bereich bleiben; meist hilft ein BN-Layer.
Ergebnisse von QAT- und RKNN-Modell unterscheiden sich
Liefert ein in PyTorch mit QAT trainierter Klassifikator nach RKNN-Konvertierung andere Ergebnisse, fehlt möglicherweise engine=’qnnpack’ bei der PyTorch-Inferenz. Die RKNN-Methode entspricht eher qnnpack.
Speicherverbrauch des laufenden Modells ermitteln
Verwenden Sie rknn.eval_memory(). Der Protokolleintrag Total zeigt den gesamten Speicherverbrauch.
Unterschiedliche Messwerte mit aktiviertem oder deaktiviertem perf_debug in rknn.init_runtime()
perf_debug ergänzt Debugcode zum Sammeln von Layerinformationen und kann Parallelmechanismen deaktivieren. Daher ist die Laufzeit länger als bei perf_debug=False.
perf_debug dient vor allem dazu, Layer mit hohem Zeitanteil zu erkennen und darauf einen Optimierungsplan aufzubauen.
Nach docker-Neustart bleibt zuvor funktionierende Platineninferenz bei der Umgebungsinitialisierung hängen?
Beim docker-Neustart bleibt npu_transfer_proxy in einem Zustand ähnlich einem abnormalen Abbruch. RKNN Server auf der Platine erkennt die getrennte Hostverbindung nicht. Starten Sie die Platine neu, um den Verbindungszustand zurückzusetzen.
5.4.9 Häufige Fragen zur Verwendung des C API
Gibt rknn_outputs_release() das Array rknn_output frei?
rknn_outputs_release() wird zusammen mit rknn_outputs_get() verwendet und gibt nur den Puffer im rknn_output-Array frei. Entsprechendes gilt für rknn_destroy_mem().
Wie erzeugt rknn_create_mem Speicher in passender Größe?
Für Eingaben gilt: Bei einem quantisierten RKNN-Modell reserviert rknn_create_mem() Speicher anhand von size_with_stride in rknn_tensor_attr, bei einem nicht quantisierten Modell anhand von n_bytes_type * n_elems.
Für Ausgaben reserviert rknn_create_mem() Speicher anhand von n_bytes_type * n_elems.
Wie werden die Eingabedaten gefüllt?
Beim allgemeinen API gilt für 4-dimensionale Eingaben fmt=NHWC, also die Reihenfolge [batch, height, width, channel]. Für Eingaben ungleich 4D gilt fmt=UNDEFINED; die Daten folgen der ursprünglichen Modellform.
Beim Zero-Copy-API kann fmt für 4D-Eingaben NHWC/NC1HWC2 sein. Zum Füllen bei fmt=NC1HWC2 siehe „RKNN Runtime Zero Copy“. Für Eingaben ungleich 4D gilt fmt=UNDEFINED; die Daten folgen der ursprünglichen Modellform.
Wie wird pass_through verwendet?
Das Eingabeformat wird mit RKNN_NATIVE_INPUT_ATTR über rknn_query() abgefragt. Bei einer 4-dimensionalen Form erfordern Kanalzahlen 1, 3 und 4 das Layout NHWC, andere Kanalzahlen NC1HWC2. Bei einer Form ungleich 4 Dimensionen wird UNDEFINED empfohlen.
Im pass_through-Modus wird dtype des Eingabe-Tensors bei quantisierten Modellen üblicherweise als INT8, bei nicht quantisierten als FLOAT16 angegeben.
Wie wird der Fehler „failed to submit“ behoben?
Tritt der Fehler in der ersten Faltungsschicht bei Zero-Copy auf, wurde möglicherweise zu wenig Speicher für den Eingabetensor reserviert. Verwenden Sie dafür size_with_stride aus den Tensorattributen.
Tritt der Fehler in einer mittleren NPU-Schicht auf, ist möglicherweise die Modellkonfiguration falsch. Im Fehlerprotokoll finden Sie einen Link zum neuesten SDK. Aktualisieren Sie die Werkzeugkette oder weisen Sie diese Schicht bei der RKNN-Konvertierung der CPU zu.
Wie wird „Meet unsupport xxx operator“ behoben?
Tritt dieser Fehler beim Demo auf dem Board auf, unterstützt dessen Runtime (librknnrt.so) den Operator meist nicht. Aktualisieren Sie zuerst die RKNN-Werkzeugkette, konvertieren Sie das Modell erneut und führen Sie das Demo nochmals aus.
Bleibt der Fehler im neuesten Toolchain bestehen, implementieren Sie den Operator gemäß 4.2.1 selbst oder melden Sie ihn dem RKNN-Team über redmine.
Unterstützt ein Modell mit dynamischen Shapes externen Speicher im zero-copy-Ablauf
Versionen vor 1.6.0 unterstützen dies nicht. Spätere Versionen unterstützen die Kontextinitialisierung mit RKNN_FLAG_MEM_ALLOC_OUTSIDE.
Laufzeitbewertung eines benutzerdefinierten Operators
Setzen Sie RKNN_LOG_LEVEL=4 oder höher und starten Sie das C-API-Testdemo. Es gibt die Leistung jeder Schicht einschließlich des benutzerdefinierten Operators aus.
Hinweis: Die gemessene Zeit eines benutzerdefinierten Operators umfasst die Arbeiten im compute-Callback. Bei GPU-Operatoren zählen dazu beispielsweise clImportMemoryARM, Layout- und Datentypkonvertierungen für Ein- und Ausgaben sowie die eigentliche Ausführungszeit des OpenCL-GPU-Kernels.
5.5 Weiterführende Ressourcen
RKNN: https://github.com/airockchip/rknn-toolkit2
RKNN_Model_Zoo: https://github.com/airockchip/rknn_model_zoo
RGA: https://github.com/airockchip/librga