
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 22/22
常见问题、错误处理与参考资源
5.4 常见问题与错误处理
5.4.1 NPU环境准备问题
版本兼容性
NPU内核驱动和Runtime版本兼容
建议将NPU内核驱动升级到0.9.2或之后的版本。在遇到问题时,先更新到最新版本的NPU内核驱动。
RKNN-Toolkit2导出的模型和Runtime版本之间的兼容关系如下表所示
表5-6 RKNN模型和Runtime版本对应关系
| RKNN模型版本 | Runtime版本 |
|---|---|
| 1.2.0 | >=1.2.0 and <=1.5.0 |
| 1.3.0 | >=1.3.0 and <=1.5.0 |
| 1.4.0 | >=1.4.0 and <=1.5.0 |
| 1.5.0 | 1.5.0 |
| 1.5.2 | >=1.5.2 |
| 1.6.0 | >=1.5.2 |
| 2.0.0 | >=2.0.0 |
| 2.1.0 | >=2.0.0 |
如何更新NPU内核驱动
建议升级完整固件以更新NPU驱动,对应固件可以找厂商提供。
板端docker环境中如何使用NPU
在板端使用docker部署应用时,如果要使用NPU资源,需要在启动容器时,映射NPU相关资源,参考命令如下:
docker run -t -i --privileged -v /dev/dri/renderD129:/dev/dri/renderD129 -v /proc/device-
tree/compatible:/proc/device-tree/compatible -v /usr/lib/librknnrt.so:/usr/lib/librknnrt.so ai_application:v1.0.0
/bin/bash
关注以下参数: - /dev/dri/renderD129:RK3588 NPU设备节点,Runtime依赖该节点以使能NPU。 - /proc/device-tree/compatible:该文件记录SOC型号,RKNN-Toolkit Lite2等组件依赖该文件获取当前SOC信息。 - /usr/lib/librknnrt.so:Runtime库存放位置,RKNN-Toolkit Lite2和RKNPU2 C API依赖该文件以使用NPU资源。 - ai_application:v1.0.0:待启动容器所使用的镜像名和版本。
5.4.2 工具安装问题
RKNN-Toolkit2依赖的环境限制太严格,导致无法成功安装
在所有依赖库都已安装、但部分库的版本和要求不匹配时,可以尝试在安装指令后面加上”no-deps”参数,取消安装Python库时的环境检查。如:
pip install rknn-toolkit2*.whl --no-deps
PyTorch依赖说明
RKNN-Toolkit2的PyTorch模型加载功能,依赖于PyTorch。PyTorch的模型分为浮点模型和已量化模型(包含QAT及PTQ量化模型)。
对于PyTorch 1.6.0导出的模型,建议将RKNN-Toolkit2依赖的PyTorch版本降级至1.6.0以免出现加载失败的问题。
对于已量化模型(QAT、PTQ),我们推荐使用PyTorch 1.10~1.13.1导出模型,并将RKNN-Toolkit2依赖的PyTorch版本升级至1.10~1.13.1。
另外在加载PyTorch模型时,建议导出原模型的PyTorch版本,要与RKNN-Toolkit2依赖的PyTorch版本尽量一致。
推荐使用的PyTorch版本为1.6.0、1.9.0、1.10或1.13.1版本。
TensorFlow依赖说明
RKNN-Toolkit2的TensorFlow模型加载功能依赖于TensorFlow。由于TensorFlow各版本之间的兼容性一般,其他版本可能会造成RKNN-Toolkit2模型加载异常,所以在加载TensorFlow模型时,建议导出原模型的TensorFlow版本,要与RKNN-Toolkit2依赖的TensorFlow版本一致。
对于TensorFlow版本引发的问题,通常会体现在”rknn.load_tensorflow()”阶段,且出错信息会指向依赖的TensorFlow路径。
推荐使用的TensorFlow版本为2.6.2或2.8.0。
RKNN-Toolkit2安装包命名规则 以1.5.2版本的发布件为例,RKNN-Toolkit2 wheel包命令规则如下:
rknn_toolkit2-1.5.2+b642f30c-cp38-cp38-linux_x86_64.whl
rknn_toolkit2: 工具名称。
1.5.2: 版本号。
b642f30c: 提交号。
cp<xx>-cp<xx>: 适用的Python版本,例如cp38-cp38表示适用的Python版本是3.8。
linux_x86_64: 系统类型和CPU架构。
请按照自己所用的操作系统、CPU架构和Python版本安装对应的工具包,否则安装会失败。
RKNN-Toolkit2是否有ARM Linux版本
RKNN-Toolkit2没有ARM Linux版,如果需要在ARM Linux上使用Python接口进行推理,可以安装RKNN-Toolkit-lite2,该工具可以在ARM Linux上用Python运行推理。
bfloat16依赖库安装不上
bfloat16的依赖库安装出错,如下:
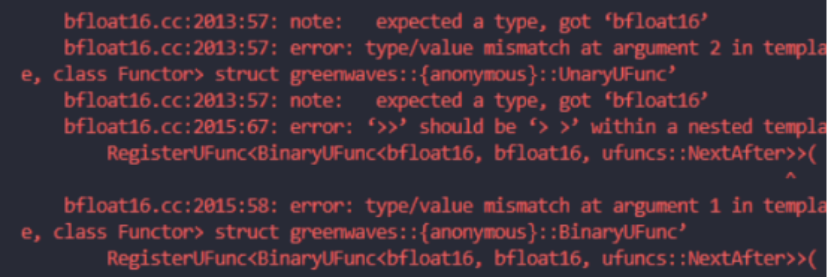
图5-19 bfloat16依赖库安装失败日志更换pip源为阿里源,或者更新RKNN-Toolkit2至1.5.0以及之后的版本(1.5.0以及之后的版本已经去除bfloat16库的依赖)。
5.4.3 模型转换常用参数说明
本章节主要覆盖模型转换阶段常用参数的使用说明。
根据模型确定参数
模型转换时,”rknn.config()”和”rknn.build()”接口会影响模型转换结果。
“rknn.load_onnx()”,”rknn.load_tensorflow()”指定输入输出节点,会影响模型转换结果。
“rknn.load_pytorch()”,”rknn.load_tensorflow()”指定输入的尺寸大小会影响模型转换结果。
可以参考以下基本步骤进行模型转换:
-
准备量化数据,提供dataset.txt文件。
-
确定模型要使用的NPU平台,如RK3566、RV1106等,并填写rknn.config()接口中的target_platform参数。
-
当输入是3通道的图像,且量化数据采用的是图片格式(如jpg、png格式)时,需要确认模型的输入是RGB还是BGR,以决定rknn.config()接口中quant_img_RGB2BGR参数的值。
-
确认模型训练时候的归一化参数,以决定rknn.config接口中的mean_values和std_values参数的值。
-
确认模型输入的尺寸信息,填入load接口相应参数中,如rknn.load_pytorch()接口中的input_size_list参数。
-
确认模型要量化比特数,以决定rknn.config()接口中的quantized_dtype参数的值。不对模型进行量化或加载的是已量化模型时可以忽略此步骤。
-
确认模型量化时使用的量化算法,以决定rknn.config()接口中quantized_algorithm参数的值。不对模型进行量化或加载已量化模型时可以忽略此步骤。
-
确认是否对模型进行量化,以决定rknn.build()接口中do_quantization参数的值。选择对模型进行量化时,需要额外填写rknn.build()接口中的dataset参数,指定量化正数据。
9. RKNN模型的跨平台兼容性
对于rknn.config()的target_platform设置的平台参数,兼容性关系如下:
RK3566、RK3568平台使用的模型是相互兼容的。
RK3588、RK3588S平台使用的模型是相互兼容的。
RV1103、RV1106平台使用的模型是相互兼容的。
10. 量化校正数据的格式及要求
量化校正数据的格式有两种选择,一种是图片格式(jpg,png),RKNN-Toolkit2会调用OpenCV接口进行读取;另一种是npy格式,RKNN-Toolkit2会调用numpy接口进行读取。
对于非RGB/BGR图片输入的模型,建议使用numpy的npy格式提供量化数据。
11. 多输入模型dataset.txt文件的填写方式
模型量化需要用dataset.txt文件指定量化数据的路径。规则为一行作为一组输入,模型存在多输入时,多个输入写在同一行,并用空格隔开。
如单输入模型,使用两组量化数据:
sampleA.npy
sampleB.npy
如三个输入的模型,两组量化数据按如下方式填写:
sampleA_in0.npy sampleA_in1.npy sampleA_in2.npy
sampleB_in0.npy sampleB_in1.npy sampleB_in2.npy
12. 确认rknn.config()的quant_img_RGB2BGR参数
采用图片(jpg,png)作为量化数据时,需要考虑设置quant_img_RGB2BGR参数。
模型采用RGB图片进行训练时,则quant_img_RGB2BGR参数设为False或不设置。且在使用Pythoninference接口或RKNPU2 C API进行推理时,输入RGB图片。
模型采用BGR图片进行训练时,则quant_img_RGB2BGR参数设为True。但在使用Python inference接口或RKNPU2 C API进行推理时,同样需要输入BGR图片(quant_img_RGB2BGR只会影响从量化校正集读入的图像)。
若量化数据采用numpy的npy格式,则建议不要使用quant_img_RGB2BGR参数,避免产生使用混乱的问题。
13. rknn.config()的mean、std和quant_img_RGB2BGR的计算顺序问题
因为quant_img_RGB2BGR只控制在量化过程中读取校正集图像时是否要进行转换通道,并不会影响其他的步骤。因此对于RKNN-Toolkit2的inference接口及 RKNPU2 C API,对输入数据都只先进行减均值(mean)、再除标准差(std)的操作,并没有通道转换的操作。
14. 模型是非3通道输入或多输入时,rknn.config()的mean_values和std_values的设置问题
mean_values和std_values的设置格式是一致的。以mean_values为例子。
假设输入有N个通道,则mean_values的值为[[channel_1, channel_2, channel_3, channel_4, …,channel_n]]。
存在多输入时,则mean_values的值为[[channel_1, channel_2, channel_3, channel_4, …,channel_n], [channel_1, channel_2, channel_3, channel_4, …, channel_n]]。
15. 量化参数矫正算法和量化图片数量的选取
RKNN-Toolkit2中量化算法(rknn.config()的quantized_algorithm)参数提供三种算法进行参数矫正,分别为normal、mmse和kl_divergence,默认使用normal。normal为常规的量化参数矫正算法;而mmse会迭代中间层的计算结果,对权重数值进行一定范围的裁剪,以获得更高的推理精度。使用mmse不一定能提升量化精度,但相比normal方式,量化时会占用更多的内存、耗费更⻓的模型转换时间;使用kl_divergence量化算法所用时间会比normal多一些,但比mmse会少很多,在某些场景下(feature分布不均匀时)可以得到较好的改善效果。
建议先使用normal算法,如果量化效果不佳,可尝试使用mmse或kl_divergence算法。
使用normal或kl_divergence算法时,推荐给出20-200组数据进行量化。使用mmse量化时,推荐使用20-50组数据进行量化。
16. 量化模型与非量化模型,推理时输入输出的差异
调用通用RKNPU2 C API时(指不使用pass_through、zero_copy的方式调用C API),输入数据的数据类型(如uint8数据,float数据)与模型的量化与否没有关系。输出数据的数据类型可以选择自动处理成float32格式,也可以选择直接输出模型推理结果,此时数据类型与输出节点的数据类型一致。使用Python推理接口会有点差异,具体关系如下表:
表5-7 Python推理接口和通用C API接口区别
| 模型量化后 | Python推理 (rknn.inference()) | C API推理(rknn.run()) (非pass_through、 zero_copy) |
|---|---|---|
| 输入类型是否有 限制 | 无限制。 rknn.inference()的输入为numpy 数组,本身带有data type属性,该 输入会自动转成RKNN模型需要的数 据格式。 | 无限制。 rknn_inputs的rknn_tensor_type参数可以根据实际输入,指 定RKNN_TENSOR_FLOAT32、RKNN_TENSOR_FLOAT16、 RKNN_TENSOR_INT8、RKNN_TENSOR_UIN8、 RKNN_TENSOR_INT16。指定后,会将输入自动转成RKNN 模型需要的数据格式。 |
| 输出类型是否变 化 | 无变化。 无论模型量化与否,Python的 rknn.inference()接口总是返回 float类型输出。无法选择其他数据 类型。 | 有变化。 RKNPU2 C API的rknn outputs attr,可以设置 want_float=1,得到float类型的输出。而量化后,可以设置 want_float=0,此时可以输出最后一个节点的原始输出数据, 如i8量化时,输出int8数据。 |
| 输入format是 否有变化 (NCHW, NHWC) | 无变化。 无论模型量化与否, rknn.inference()接口的 data_format参数,可以根据需要 设置为nchw或nhwc。 | 无变化。 无论模型量化与否,rknn inputs结构体的 rknn_tensor_format参数,可以根据需要设置为NCHW或 NHWC。 |
是否存在在线预编译的模式
RKNN-Toolkit2只支持导出离线预编译的模型,不支持导出在线预编译的模型(RKNN-Toolkit1支持),因此并不存在离线预编译和在线预编译的模式选择。
RKNN-Toolkit转出来的RKNN模型可以在RK3566平台上使用吗
不可以。
RKNN-Toolkit转出来的RKNN模型适用于RK1806 / RK1808 / RK3399Pro / RV1109 / RV1126等平台;RK3566平台需要用RKNN-Toolkit2转出来的RKNN模型。RKNN-Toolkit2转出来的RKNN模型适用于RK3566 / RK3568 / RK3588 / RK3588S / RV1103 / RV1106 / RK3562 / RK3576 / RV1126B 等平台。
RKNN-Toolkit工具的使用说明请参考以下工程:
https://github.com/airockchip/rknn-toolkit
RKNN-Toolkit2工具的使用说明请参考以下工程:
https://github.com/airockchip/rknn-toolkit2
5.4.4 模型加载问题
5.4.4.1 RKNN-TOOLKIT2支持的深度学习框架和对应版本
请参考2.1 通用模型转换章节。
5.4.4.2 各框架的OP支持列表
RKNN-Toolkit2对不同框架的支持程度有差异,详细信息可以参考以下目录中的RKNNToolkit2_OP_Support文档:
https://github.com/airockchip/rknn-toolkit2/blob/master/doc/
5.4.4.3 ONNX模型转换常见问题
加载模型时出现“Error parsing message”报错
转换examples/onnx/resnet50v2模型时,提示加载失败:
E load_onnx: Catch exception when loading onnx model: /rknn_resnet_demo/resnet50v2.onnx!
E lod_onnx: Traceback (most recent call last):
E load_onnx: File "rknn/api/rknn_base.py", line 1094, in rknn.api.rknn_base.RKNNBase.load_onnx
E load_onnx: File "/usr/local/lib/python3.6/dist-packages/onnx/__init__.py", line 115, in load_model
……
E load_onnx: google.protobuf.message.DecoderError: Error parsing message
原因可能是resnet50v2.onnx模型损坏导致(如没下载全),需要重新下载该模型,并确保其MD5值正确,如:
22ed6e6a8fb9192f0980acca0c941414 resnet50v2.onnx
是否支持动态的输入shape
1.5.2之前的RKNN-Toolkit2不支持动态的输入shape,比如onnx输入维度为[-1, 3, -1, -1],表示batch、height和width维度是不固定的。
1.5.2以及之后的版本可以通过rknn.config()的dynamic_input参数进行动态输入shape的仿真,详见
4.1.3 动态Shape章节。
自定义输出节点时报错
rknn.load_onnx()时传入outputs参数进行模型的裁剪,但报如下错误:
E load_onnx: the '378' in outputs=['378', '439', '500'] is invalied!
日志提示输出节点378是无效的,因此outputs参数需设置正确的输出节点名称。
5.4.4.4 PYTORCH模型转换常见问题
加载Pytorch模型时出现torch._C没有jit_pass_inline属性的错误
错误日志如下:
'torch._C' has no attribute '_jit_pass_inline'
请将PyTorch升级到1.6.0或之后的版本。
Pytorch模型的保存格式
目前只支持 torch.jit.trace() 导出的模型。 torch.save() 接口仅保存权重参数字典,缺乏网络结构信息,无法被正常导入并转成RKNN模型。
转换时遇到PytorchStreamReader失败的错误
详细错误如下:
E Catch exception when loading pytorch model: ./mobilenet0.25_Final.pth!
E Traceback (most recent call last):
……
E cpp_module = torch._C.import_ir_module(cu, f, map_location, extra_files)
E RuntimeError: [enforce fail at inline container.cc:137]. PytorchStreamReader failed reading zip archive: faild
finding central directory frame ……
出错原因是输入的PyTorch模型没有网络结构信息。
通常pth只有权重,并没有网络结构信息。对于已保存的模型权重文件,可以通过初始化对应的网络结构,再使用net.load_state_dict()加载pth权重文件。最后通过torch.jit.trace()接口将网络结构和权重参数固化成一个pt文件。得到torch.jit.trace()处理过以后的pt文件,就可以用rknn.load_pytorch()接口将其转为RKNN模型。
转换时遇到KeyError的错误
错误日志如下:
E Traceback (most recent call last):
……
E KeyError: 'aten::softmax'
出现形如KeyError: ‘aten::xxx’的错误信息时,表示该算子当前版本还不支持。RKNN-Toolkit2在每次版本升级时都会修复此类bug,请使用最新版本的RKNN-Toolkit2试试。
转换时遇到”Syntax error in input! LexToken(xxx)”的错误
错误日志如下:
WARNING: Token 'COMMENT' defined, but not used
WARNING: There is 1 unused token
!!!!! Illegal character '"'
Syntax error in input! LexToken(NAMED_IDENTIFIER, 'fc', 1, 27)
!!!!! Illegal character '"'
该错误的原因有很多种,请按照以下顺序排查:
1)未继承torch.nn.module创建网络。请继承torch.nn.module基类来创建网络,然后再用torch.jit.trace()生成pt文件。
2)更新RKNN-Toolkit2 1.4.0或之后的版本,torch建议使用1.6.0,1.9.0,1.10.0或1.13.1版本。
5.4.4.5 TENSORFLOW模型转换常见问题
Tensorflow1.x模型报错
使用rknn.load_tensorflow()接口加载tensorflow1.x模型如出现报错提示:
E load_tensorflow: Catch exception when loading tensorflow model: ./yolov3_mobilenetv2.pb!
E load_tensorflow: Traceback (most recent call last):
……
E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects to be colocated with unknown node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'
E load_tensorflow: During handling of the above exception, another exception occurred:
E load_tensorflow: Traceback (most recent call last):
E load_tensorflow: File "rknn/api/rknn_base.py", line 990, in rknn.api.rknn_base.RKNNBase.load_tensorflow
……
E load_tensorflow: return func(*args, **kwargs)
E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
431, in import_graph_def
E load_tensorflow: raise ValueError(str(e))
E load_tensorflow: ValueError: Node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects
to be colocated with unknown node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'
建议: - 如当前安装的是1.x的TensorFlow,请安装2.x的TensorFlow。 - 更新RKNN-Toolkit2 /RKNPU2至最新版本。 - TransformGraph类似的报错
TensorFlow的模型转成RKNN时报错:
Traceback (most recent call last):
File "test.py", line 80, in <module>
input_size_list=[[1, 368, 368, 3]])
File "/usr/local/lib/python3.6/site-packages/rknn/api/rknn.py", line 68, in load_tensorflow
input_size_list=input_size_list, outputs=outputs)
File "rknn/api/rknn_base.py", line 940, in rknn.api.rknn_base.RKNNBase.load_tensorflow
File "/usr/local/lib/python3.6/dist-packages/tensorflow/tools/graph_transforms/__init__", line 51, in
TransformGraph.transforms_string, status)
File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/errors_impl.py". ;ome 548, in __exit__
C_api.TF_GetCode(self.status.status)
Tensorflow.python.framework.error_impl.InvalidArgumentError: Beta input to batch norm has bad shape: [24]
原因:
1)该模型直接调用TensorFlow原生的TransformGraph类进行优化时,也会报上面的错误(RKNN-Toolkit2里同样会调用TransformGraph进行优化,因此也会报同样的错误)。
2)可能是模型生成时的TensorFlow版本与目前安装的版本已经不兼容了。
建议:使用1.14.0的TensorFlow版本重新生成该模型,或者寻找其他框架的同类型模型。
“Shape must be rank 4 but is rank 0”报错
加载pb模型时:
rknn.load_tensorflow(tf_pb='./model.pb',
           inputs=["X","Y"],
           outputs=['generator/xs'],
           input_size_list=1, INPUT_SIZE, INPUT_SIZE, 3)
会产生报错:
E load_tensorflow: Catch exception when loading tensorflow model: ./model.pb!
E load_tensorflow: Traceback (most recent call last):
E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
427, in import_graph_def
E load_tensorflow: graph._c_graph, serialized, options) # pylint: disable=protected-access
E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Shape must be rank 4 but is
rank 0 for 'generator/conv2d_3/Conv2D' (op: 'Conv2D') with input shapes: [], [7,7,3,32].
原因可能是该模型是多输入模型,rknn.load_tensorflow()的input_size_list没按规范填写,可以参考examples/functions/multi_input_test里的以下用法:
rknn.load_tensorflow(tf_pb='./conv_128.pb',
           inputs=['input1', 'input2', 'input3', 'input4'],
           outputs=['output'],
           input_size_list=[[1, 128, 128, 3], [1, 128, 128, 3],
                   [1, 128, 128, 3], [1, 128, 128, 1]])
加载模型出错时的排查步骤
首先确认原始深度学习框架是否可以加载该模型并进行正确的推理,检查原始模型是否有问题。
其次请将RKNN-Toolkit2升级到最新版本。如果模型有RKNN-Toolkit2不支持的层(或OP),通过打开调试日志开关,在日志中可以看到哪一个算子是RKNN-Toolkit2不支持的。
如果仍无法解决,请将使用的RKNN-Toolkit2版本和详细的错误日志反馈给瑞芯微NPU开发团队。
5.4.5 模型量化问题
量化对模型体积的影响
分两种情况,当导入的模型是量化的模型时,rknn.build()接口的do_quantization=False会使用该模型里面的量化参数。当导入的模型是浮点的模型时,do_quantization=False不会做量化的操作,但是会把权重从float32转成float16,这块几乎不会有精度损失。这两种情况都减少了模型权重的体积,从而使得整个模型占用空间变小。
模型量化时,图片是否需要和模型输入的尺寸一致
不需要。RKNN-Toolkit2会自动对这些图片进行缩放处理。但是缩放操作也可能会使图片信息发生改变,对量化精度产生一定影响,所以最好使用尺寸相近的图片。
如果时非图像格式的校正数据,如npy格式,则需要与模型输入的shape一致。
量化校正集是否需要根据rknn_batch_size参数进行修改
不需要。
rknn.build() 的 rknn_batch_size 参数只会修改最后导出的RKNN模型的batch维(由1改为rknn_batch_size ),并不会影响量化阶段的流程,因此量化校正集还是按照 batch 为1的方式来设置即可。
模型量化时,程序运行一段时间后被kill掉或程序卡住
在模型量化过程中,RKNN-Toolkit2会申请较多的系统内存,有可能造成程序被kill掉或卡住。
解决方法:增加电脑内存或增大虚拟内存(交换分区)。
5.4.6 模型转换问题
常见转换bug报错的问题
如遇到如下类似转换报错,很可能是由于当前版本存在bug,可尝试将RKNN-Toolkit2更新至最新版本。
infer_shapes类似错误
(op_type:Mul, name:Where_2466_mul): Inferred elem type differs from existing elem type: (FLOAT) vs (INT64)
E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1555, in rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 5409, in rknn.api.graph_optimizer.GraphOptimizer.run
E build: File "rknn/api/graph_optimizer.py", line 5123, in rknn.api.graph_optimizer.GraphOptimizer._fuse_ops
E build: File "rknn/api/ir_graph.py", line 180, in rknn.api.ir_graph.IRGraph.rebuild
E build: File "rknn/api/ir_graph.py", line 140, in rknn.api.ir_graph.IRGraph._clean_model
E build: File "rknn/api/ir_graph.py", line 56, in rknn.api.ir_graph.IRGraph.infer_shapes
E build: File "/home/anaconda3/envs/rk2/lib/python3.6/site-packages/onnx/shape_inference.py", line 35, in
infer_shapes
E build: inferred_model_str = C.infer_shapes(model_str, check_type)
E build: RuntimeError: Inferred elem type differs from existing elem type: (FLOAT) vs (INT64)
或:
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 6256, in rknn.api.graph_optimizer.GraphOptimizer.fuse_ops
E build: File "rknn/api/ir_graph.py", line 285, in rknn.api.ir_graph.IRGraph.rebuild
E build: File "rknn/api/ir_graph.py", line 149, in rknn.api.ir_graph.IRGraph._clean_model
E build: File "rknn/api/ir_graph.py", line 62, in rknn.api.ir_graph.IRGraph.infer_shapes
E build: File "/usr/local/lib/python3.6/dist-packages/onnx/shape_inference.py", line 35, in infer_shapes
E build: inferred_model_str = C.infer_shapes(model_str, check_type)
E build: RuntimeError: Inferred shape and existing shape differ in rank: (0) vs (3)
或:
(op_type:ReduceMax, name:ReduceMax_18): Interred shape and existing shape differ in rank: (3) vs (0)
E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
……
E build: RuntimeError: Interred shape and existing shape differ in rank: (3) vs (0)
- _p_fuse_two_mul类似错误
E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 6197, in rknn.api.graph_optimizer.GraphOptimizer.fuse_ops
E build: File "rknn/api/graph_optimizer.py", line 204, in rknn.api.graph_optimizer._p_fuse_two_mul
E build: ValueError: non-broadcastable output operand with shape () doesn't match the broadcast shape (3,2)
“Segmentation fault”类似错误
如picodet模型转换报错:
I _fold_constant remove nodes = ['Shape_0', 'Gather_4', 'Shape_1', 'Gather_6', 'Unsqueeze_0', 'Concat_8', 'Cast_3']
**Segmentation fault (Core dumped)**
_p_fuse_mul_into_conv类似错误
  E build: Catch exception when building RKNN model:
  ……
  E build: ValueError: non broadcastable output operand whith shape (1,258,1,256) doesn`t match the broadcast
shape (80256,258,1,256)
怎么判断算子RKNN是否支持
直接进行模型的转换,如果不支持会有相关提示。
也可参考《06_RKNN2_算子支持与约束参考_V2.5.0》,该文档包含各个框架的算子支持列表及详细的RKNN算子规格约束。
转换时提示Expand算子不支持
建议:
1)新版本已经支持CPU的Expand,可尝试更新RKNN-Toolkit2 / RKNPU2至最新版本。
2)修改模型,采用repeat算子来替代expand算子。
转换时提示”Meet unsupported dims in reducesum”
模型转换出现 Meet unsupported dims in reducesum, dims: 6 ,具体如下:
D RKNN: [14:54:19.434] >>>>>> start: N4rknn17RKNNInitCastConstE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn17RKNNInitCastConstE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn20RKNNMultiSurfacePassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn20RKNNMultiSurfacePassE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn14RKNNTilingPassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn14RKNNTilingPassE
D RKNN: [14:54:19.434] >>>>>> start: N4rknn23RKNNProfileAnalysisPassE
D RKNN: [14:54:19.434] <<<<<< end: N4rknn23RKNNProfileAnalysisPassE
D RKNN: [14:54:19.434] >>>>>> start: OpEmit
E RKNN: [14:54:19.438] Meet unsupported dims in reducesum, dims: 6
Aborted (core dumped)
目前RKNN不支持6维的OP,大多数情况下只支持4维。
因NonMaxSuppression等后处理Op导致转换报错
NonMaxSuppression 等后处理Op,RKNN目前不支持。
可以将图的后处理子图部分移除,如:
rknn.load_onnx(model='picodet_xxx.onnx', outputs=['concat_4.tmp_0', 'tmp_16'])
移除的子图在cpu端另行进行处理。
“invalid expand shape”类似报错
例如 rvm_mobilenetv3_fp32.onnx 转换时出现以下报错:
[E:onnxruntime:, sequential_executor.cc:333 Execute] Non-zero status code returned while running Expand node.
Name:'Expand_294' Status Message: invalid expand shape

E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 5529, in rknn.api.graph_optimizer.GraphOptimizer.fold_constant
E build: File "rknn/api/session.py", line 69, in rknn.api.session.Session.run
E build: File "/home/cx/work/tools/Anaconda3/envs/rknn/lib/python3.8/site-
packages/onnxruntime/capi/onnxruntime_inference_collection.py", line 124, in run
E build: return self._sess.run(output_names, input_feed, run_options)
E build: onnxruntime.capi.onnxruntime_pybind11_state.InvalidArgument: [ONNXRuntimeError] : 2 :
INVALID_ARGUMENT : Non-zero status code returned while running Expand node. Name:'Expand_294' Status
Message: invalid expand shape
因为downsample_ratio的输入值会改变模型中间feature的size,所以说这种图本质上是动态图。建议修改模型downsample_ratio的逻辑,不要用输入的数值来控制中间feature的shape。如需使用动态图功能,可在更新1.5.2的RKNN-Toolkit2后,使用动态shape的功能来模拟动态图(同样需要修改模型downsample_ratio的逻辑,不要用输入的数值来控制中间feature的shape,目前动态shape功能只支持输入的shape是可变的情况)。
rknn.config()的mean_values报错提示
设置 mean/std 为:
rknn.config(mean_values=[128, 128, 128], std_values=[128, 128, 128])
时转换模型报错:
--> Loading model
transpose_input for input_1: shape must be rank 4, ignored
E load_tflite: The len of mean_values ([128, 128, 128]) for input 0 is wrong, expect 32!
原因可能是模型的输入不是3通道图像数据(例如输入shape是1x32,非图像数据),此时:
需要根据输入通道个数来设置 mean_values / std_values 。
如果模型不需要指定 mean/std , rknn.config() 可以不设置 mean_values / std_values( mean/std 一般只对图像输入有效)。
模型存在4维以上Op时报错(如5维或6维)
当模型存在4维以上Op时(如5维或6维),会有如下报错:
E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1580, in rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/rknn_base.py", line 341, in rknn.api.rknn_base.RKNNBase._generate_rknn
E build: File "rknn/api/rknn_base.py", line 307, in rknn.api.rknn_base.RKNNBase._biild_rknn
E build: IndexError: vector::_M_range_check: __n (which is 4) >= this->size() (which is 4)
RKNN目前暂不支持4维以上的OP,可以手工将这些节点去掉。
RKNN是否支持动态卷积
目前 RK3588/RK3576/RV1126B 平台支持 group 参数为1的动态卷积。其他平台暂不支持。
“Not support input data type ‘float16’“报错
pytorch训练的权重类型为float16的模型,在转换RKNN时出现以下报错:
--> Building model
E build: Not support input data type 'float16'
W build: ==================== WARN(3) =================
E rknn-toolkit2 version: 1.3.0-11912b58
E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):
E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build
E build: File "rknn/api/graph_optimizer.py", line 5524, in rknn.api.graph_optimizer.GraphOptimzer.fold_constant
E build: File "rknn/api/load_checker.py", line 63, in rknn.api.load_checker.create_random_data
E build: File "rknn/api/rknn_log.py", line 113, in rknn.api.rknn_log.RKNNLog.e
E build: ValueError: Not support input data type 'float16'!
目前RKNN-Toolkit2还还不支持float16的权重类型的Pytorch模型,需改为float32。
动态图相关报错
转换模型时,如果出现以下类似报错:
E build: ValueError: The Op of 'NonZero' is not support! it will cause the graph to be a dynamic graph!
说明包含该OP的模型为动态图,需要手动修改模型,用其他OP替换或将其移除。
RKNN模型大小问题
模型转换结束后,可能存在转换出来的RKNN模型比原始模型大的现象,甚至跟模型的输入shape也有关系,这种现象是正常的。因为RKNN模型里不仅仅包含权重和图结构信息,还会有很多NPU的寄存器配置信息,并且为了提高运行效率,可能也会做OP的拆解等操作,这些都会导致RKNN模型变大。
5.4.7 模拟器推理及连板推理的说明
术语说明
模拟器推理: RKNN-Toolkit2 在 Linux x86_64 平台提供模拟器功能,可以在没有开发板的情况下进行模型推理,获取推理结果。(该功能输出结果未必与连板或板端一致,更推荐使用连板推理或板端推理)。
连板推理:指在开发板已连接电脑的情况下,调用 RKNN-Toolkit2 的 Python API 推理模型,获取推理结果。
板端推理:指在开发板上调用 RKNPU2 的 C API 接口推理模型,获取推理结果。
模拟器推理结果与连板推理结果不一致
发生此情况时,可能意味着板端的结果不正确。
由于硬件和驱动的差异,模拟器不保证可以和板端获取一模一样的结果。但如果差异实在太大,则大概率是板端驱动Bug导致,可以将问题反馈给RK的NPU团队进行分析。
连板推理的工作原理
使用连板推理时,RKNN-Toolkit2会与板端的RKNN Server进行通信,通信时会将模型、模型的输入由PC端传至板端,随后调用RKNPU2 C API进行模型推理,板端推理完成后将结果回传至PC端。
连板推理与板端推理结果有差异
连板推理是基于RKNPU2 C API实现的,理论上连板推理结果会与RKNPU2 C API推理结果一致。当这两者出现较大差异时,请确认输入的预处理、数据类型、数据的排布方式(NCHW,NHWC)是否有差异。
需指出,如差异很小且发生在小数点后3位及之后的数值上,则属于正常现象。差异可能产生在使用不同的库读取图片、转换数据类型等步骤上。
板端推理的速度比连板推理更快
由于连板推理存在额外的数据拷贝、传输过程,会导致连板推理的性能不如板端的RKNPU2 C API推理性能。因此,NPU实际推理性能以RKNPU2 C API的推理性能为准。
涉及连板调试、连板推理功能时,获取详细的错误日志
连板推理时,模型的初始化、推理等操作主要在开发板上完成,此时日志信息主要产生在板端上。
为了获取具体的板端调试信息,可以通过串口进入开发板操作系统。然后执行以下两条命令设置获取日志的环境变量。保持串口窗口不要关闭,再进行连板调试,此时板端的错误信息就会显示在串口窗口上:
export RKNN_LOG_LEVEL=5
restart_rknn.sh
连板推理数据的排布方式说明
rknn.inference 在连板推理时输入数据的排布方式可选择为NCHW或NHWC,即data_format=’NCHW’ 或 data_format=’NHWC’ ,默认为NHWC。因为rknn-toolkit2中在转换时onnx模型的4维输入默认都是NCHW的格式,在使用rknn进行inference时输入排布方式默认为NHWC,内部会进行对应的格式转换,如果在inference中设置的data_format=’NCHW’,则输入数据不进行默认的NCHW到NHWC的转换。具体例子可参考“https://github.com/airockchip/rknn-toolkit2/issues/220”
5.4.8 模型评估常见问题
量化模型精度不及预期
参考本文档的第5.1章节。
支持哪些框架的已量化模型
RKNN-Toolkit2 1.4及之后的版本支持TensorFlow、TensorFlow Lite和PyTorch框架的已量化模型。
连板调试时,连接设备失败
连板精度分析( rknn.accuracy_analysis() )时出现如下报错:
E accuracy_analysis: Connect to Device Failure (-1)
E accuracy_analysis: Catch exception when init runtime!
E accuracy_analysis: Traceback (most recent call last):
E accuracy_analysis: File "rknn/api/rknn_base.py", line 2001, in rknn.api.rknn_base.RKNNBase.init_runtime
E accuracy_analysis: File "rknn/api/rknn_runtime.py", line 194, in rknn.api.rknn_runtime.RKNNRuntime.__init__
E accuracy_analysis: File "rknn/api/rknn_platform.py", line 331, in rknn.api.rknn_platform.start_ntp_or_adb
或连板推理( rknn.inference )时出现如下报错:
I target set by user is: rk3568
I Starting ntp or adb, target is RK3568
I Device [0c6a9900ef4871e1] not found in ntb device list.
I Start adb...
I Connect to Device success!
I NPUTransfer: Starting NPU Transfer Client, Transfer version 2.1.0
(b5861e7@2020-11-23T11:50:36)
D NPUTransfer: Transfer spec = local:transfer_proxy
D NPUTransfer: ERROR: socket read fd = 3, n = -1: Connection reset by peer
D NPUTransfer: Transfer client closed fd = 3

E RKNNAPI: rknn_init, server connect fail! ret = -9(ERROR_PIPE)!
E init_runtime: Catch exception when init_runtime!
E init_runtime: Traceback (most recent call last):
E init_runtime: File "rknn/api/rknn_base.py", line 2001, in
rknn.api.rknn_base.RKNNBase.init_runtime
E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in
rknn.api.rknn_runtime.RKNNRuntime.build_graph
E init_runtime: Exception: RKNN init failed. error code:
RKNN_ERR_DEVICE_UNAVAILABLE
原因可能是板端未开启RKNN Server服务,请根据1.2.2章节相关说明运行板端RKNN Server服务。
连板调试时,rknn_init失败,返回-6或模型非法的错误
错误信息如下:
E RKNNAPI: rknn_init, msg_load_ack fail, ack = 1(ACK_FAIL), expect 0(ACK_SUCC)!
D NPUTransfer: Transfer client closed, fd = 4
E init_runtime: Catch exception when init runtime!
E init_runtime: Traceback (most recent call last):
E init_runtime: File "rknn/api/rknn_base.py", line 2011, in rknn.api.rknn_base.RKNNBase.init_runtime
E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in rknn.api.rknn_runtime.RKNNRuntime.build_graph
E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_MODEL_INVALID
出现该错误一般有以下几种情况:
在生成rknn模型时,不同版本的RKNN-Toolkit2和驱动是有对应关系的,建议将RKNN-Toolkit2 /RKNPU2和开发板的固件都升级到最新的版本。
没有正确设置 target_platform 。例如不设置 rknn.config() 接口中的 target_platform时,生成的RKNN模型只能在RK3566/RK3568上运行。如果要在其他平台上运行(如RK3588/RK3588S/RV1103/RV1106/RK3562),则需要在调用 rknn.config() 接口时设置相应的 target_platform 。
如果是在Docker容器中推理时出现该问题,有可能是因为宿主机上的 npu_transfer_proxy 进程没有结束,导致通信异常。可以先退出Docker容器,将宿主机上的 npu_transfer_proxy 进程结束掉,然后再进入容器执行推理脚本。
也可能是RKNN模型本身有问题。此时可以用串口连到开发板,在设置环境变量RKNN_LOG_LEVEL=5 后执行 restart_rknn.sh ,然后重跑程序并将产生的详细日志记录下来,反馈给瑞芯微NPU团队。
连板调试时,rknn_init()失败,返回设备不可用的错误
错误信息如下:
E RKNNAPI: rknn_init, msg_ioctl_ack fail, data_len = 104985, except 102961!
D NPUTransfer: Transfer client closed, fd = 3
E init_runtime: Catch exception when init_runtime!
E init_runtime: Traceback (most recent call last):
E init_runtime: File "rknn/api/rknn_base.py", line 1961, in rknn.api.rknn_base.RKNNBase.init_runtime
E init_runtime: File "rknn/api/rknn_runtime.py", line 360, in rknn.api.rknn_runtime.RKNNRuntime.build_graph
E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_DEVICE_UNAVAILABLE
该问题的原因比较复杂,请按以下方式排查:
确保RKNN-Toolkit2 / RKNPU2及开发板的系统固件都已经升级到最新版本。各组件版本查询方法请参考
1.2.2章节。
另外,需要确保 adb devices 或 rknn.list_devices() 都能看到设备,并且rknn.init_runtime() 的 target 和 device_id 设置正确。
Runtime出现”Invalid RKNN model version 6”报错
Runtime上出现以下报错:
Loading model …
E RKNN: [09:13:25.728] 6, 1
E RKNN: [09:13:25.728] Invalid RKNN model version 6
E RKNN: [06:28:39.049] rknn_init, load model failed!
Exception: RKNN init failed. error code: RKNN_ERR_FAIL
原因:
模型版本与RKNN Runtime不兼容
建议:
参考16.1章节的版本兼容性来升级对应的模型和Runtime版本,或者直接将2者同时升级至最新版本
Runtime出现”Invalid RKNN format”报错
Runtime上出现以下报错:
Loading model …
E RKNN: [06:28:39.048] parseRKNN from buffer: Invalid RKNN format!
E RKNN: [06:28:39.049] rknn_init, load model failed!
rknn_init error ret=-1
原因:
1)可能是模型转换时的 rknn.config() 的 target_platform 没有设置对,或没有设置(如没有设置默认是RK3566)。
2)Runtime版本与RKNN-Toolkit2不兼容。
建议:
1)设置正确的 target_platform 。
2)RKNN-Toolkit2与Runtime要一起更新到同一个版本。
rknn.inference()耗时与rknn.eval_perf()理论速度不一致
因为 rknn.inference() 使用PC + adb的方式进行连板推理,存在着一些固定的数据传输开销,因此与 rknn.eval_perf() 理论速度不一致。
对于更真实的帧率,建议直接在开发板上使用RKNPU2 C API进行测试。
rknn.inference()对多batch的支持
RKNN-Toolkit2 1.4.0及之后的版本,可以在构建RKNN模型时就指定输入图片的数量,详细用法参考RKNN-Toolkit2 API手册中关于 rknn.build 接口的说明。
另外,当 rknn_batch_size 大于1(如等于4时),Python里推理的调用要由:
outputs = rknn.inference(inputs=[img])
修改为:
img = np.expand_dims(img, 0)
img = np.concatenate((img, img, img, img), axis=0)
outputs = rknn.inference(inputs=[img])
完整示例请参考: examples/functions/multi_batch/
运行多个RKNN模型
运行两个或多个模型时,需要创建多个RKNN对象。一个RKNN对象对应一个模型,类似一个上下文。每个模型在各自的上下文里初始化模型,推理,获取推理结果,互不干涉。这些模型在NPU上推理时是串行进行的。
模型推理的耗时非常⻓,而且得到的结果错误
如果推理耗时超过20s,且结果错误,这通常是NPU出现了NPU Hang的BUG。如果遇到该问题,可以尝试更新RKNN-Toolkit2 / RKNPU2到最新版本。
模型输入为3维情况下,连板推理结果错误
模型的输入为3维情况下,如出现Simulator的仿真结果正确,但连板推理结果错误的情况。原因可能是当前NPU的输入3维支持还不完善,后面会完善3维的支持。
建议:
先将模型输入改为4维。
更新RKNN-Toolkit2 / RKNPU2至最新版本进行尝试。
连板推理结果错误,并且每次都不一致
ONNX模型转RKNN后,用Simulator的仿真结果正确,并且每次结果都一致。但在连板推理时结果错误,并且每次都不一致。这种问题可能是板端NPU内核驱动bug导致,此时需要更新板端的NPU内核驱动,并且需要一并更新最新的RKNN-Toolkit2 / RKNPU2。
模型存在较多的Resize OP时,出现精度下降问题
当ONNX模型里存在较多的Resize OP时,转换为RKNN后出现精度下降。可能的原因是:
1)精度下降是因为NPU目前还不支持硬件级别 Resize (后续会支持),转换工具会将 Resize 转为ConvTranspose ,会导致一点点的精度丢失。
2)如模型有多个串联的 Resize ,则可能会累积了太多误差导致精度下降比较多。
建议:
1)目前尽量避免 Resize 的使用(如将 Resize 改为 ConvTranspose 再进行训练)
2)可以在 rknn.config() 里加入 optimization_level=2 的参数,此时 Resize Op 会走CPU,精度不会掉,但会导致性能下降。
do_quantization设为False以后推理结果都为nan
rknn.build() 接口中的 do_quantization 设为 True 时推理结果没有异常,但设为 False 以后推理结果就都变为 nan 了。原因可能是 do_quantization=False 时,RKNN模型的运算类型是fp16的,但该模型的中间层(如卷积)输出的范围可能超出了fp16(65536)的范围(如-51597~75642)。
建议:
训练的时候需要保证中间层的输出不超过fp16的表达范围(一般通过添加BN层来解决该问题)。
QAT模型与RKNN模型结果不一致
在Pytroch框架下使用QAT训练了一个分类模型并转为RKNN模型,对该模型使用Pytorch和RKNN分别进行推理,发现得到的结果不一样,原因可能是Pytorch的推理没有设置 engine=’qnnpack’ ,因为RKNN的推理方式与 qnnpack 更为贴近。
怎么获取模型运行时候内存占用率
可以使用 rknn.eval_memory() 接口,输出的日志里有个Total项,就是总的占用大小。
性能评估时,开启或关闭rknn.init_runtime()的perf_debug参数,性能数据的差异
开启 perf_debug 时,为了收集每层的信息,会添加一些调试代码,并且可能禁用一些并行的机制,因此耗时比 perf_debug=False 时多一些。
开启 perf_debug 的主要作用是看模型中是否有耗时占比比较多的层,以此为依据来设计优化方案。
环境用的docker,之前连板推理正常,重启docker后,推理时卡在初始化环境阶段?
因为docker重启时 npu_transfer_proxy 类似于异常退出的状态,导致开发板上的RKNN Server无法检测到上端连接已经断开,这时需要重启下开发板,重置RKNN Server的连接状态。
5.4.9 C API使用常见问题
rknn_outputs_release()是否会释放rknn_output数组
rknn_outputs_release() 与 rknn_outputs_get() 配合调用,它只释放 rknn_output 数组里的buf。类似的情况还有 rknn_destroy_mem() 。
rknn_create_mem如何创建合适的大小的内存?
对于输入而言,一般原则是:如果是量化RKNN模型, rknn_create_mem() 使用rknn_tensor_attr 的 size_with_stride 分配内存;非量化模型 rknn_create_mem() 使用用戶填充的数据类型的 字节数 * n_elems 分配内存。
对于输出而言, rknn_create_mem() 使用用戶填充的数据类型的 字节数 * n_elems 分配内存。
输入数据如何填充?
| fmt=NHWC | |
|---|---|
| fmt=UNDEFINED |
如果使用零拷贝API,对于四维形状输入, fmt=NHWC/NC1HWC2 。 fmt=NC1HWC2 时如何填充数据请参考《RKNN Runtime零拷贝调用》章节。非四维输入形状, fmt=UNDEFINED ,按照模型的原始形状填充数据。
pass_through如何使用?
输入数据格式由 rknn_query() 的 RKNN_NATIVE_INPUT_ATTR 命令获取。如果是4维形状:对于通道值为1、3、4,layout要求使用 NHWC ,其他通道值要求使用 NC1HWC2 ;如果是非4维形状,建议指定layout=UNDEFINED 。
另外,在 pass_through 模式下,量化模型通常指定输入Tensor的 dtype 为 INT8 ,非量化模型通常指定输入Tensor的 dtype 为 FLOAT16 。
出现”failed to submit”错误如何处理?
如果错误出现在第一层卷积并且使用零拷贝接口,可能的原因是输入tensor内存分配不够导致,此时应该使用tensor属性中的 size_with_stride 分配内存。
如果错误出现在中间的NPU层,可能的原因是模型配置出错,此时可在错误日志中找到最新的SDK网盘链接,建议升级最新工具链或者在转换RKNN模型时将该层指定到CPU上运行。
出现”Meet unsupport xxx operator”错误如何处理?
在板端运行demo出现类似的报错时,一般是板端的 Runtime(librknnrt.so) 不支持该算子。建议用戶先更新RKNN 相关工具链到最新版本,再重新转换模型,并在板端重跑demo。
如果最新的工具链还出现同样报错,则用戶需要自行添加该算子的实现,可以参考4.2.1 自定义算子 章节来自定义实现算子,或者通过redmine上报给RKNN 团队。
动态shape模型是否支持在零拷贝流程中使用外部分配的内存?
1.6.0之前版本不支持,1.6.0版本开始支持使用 RKNN_FLAG_MEM_ALLOC_OUTSIDE 标志初始化上下文。
自定义算子性能评估(runtime)
自定义算子的性能可以在板端上设定 RKNN_LOG_LEVE=4 或 5 以上, 并运行测试demo, runtime库就会自动打印出每层耗时信息, 包含自定义OP的耗时。
注意: 这层自定义OP的耗时包含compute回调函数在内的所有耗时, 以GPU OP为例子, 耗时会包含compute回调函数在内, 包括 clImportMemoryARM 函数的, 以及数据格式和类型的转换的耗时(包含给输入输出的转换)和最后GPU OP的kernel运行耗时。
5.5 相关资源
RKNN:https://github.com/airockchip/rknn-toolkit2。
Model Zoo:https://github.com/airockchip/rknn_model_zoo。
RGA:https://github.com/airockchip/librga。