
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 6/22
推理、精度、性能与内存评估
2.3 模型评估
2.3.1 模型推理验证
原始模型转换为RKNN模型后,可在模拟器或开发板上进行推理,对推理结果进行后处理检验其是否正确。若推理结果不正确,可以对量化模型进行精度分析和查看前后处理流程是否正确。模型推理阶段使用到的主要接口相关参数说明如下:
运行时初始化接口 rknn.init_runtime() 参数如下:
target:目标硬件平台。默认值为 None ,推理在模拟器上进行。如果要获取板端实际推理结果,则该参数需要填入相应的平台(RK3562 / RK3566 / RK3568 / RK3588 / RK3576 / RV1103 / RV1103B /RV1106 / RV1106B / RV1126B)。
device_id:设备编号。默认值为 None 。若有设置target则选择唯一一台设备进行推理。如果电脑连接多台设备连板推理时,需要指定填入相应的设备ID。若通过网络adb连接设备进行模型推理,则需要用戶手动执行命令 adb connect [IP] 连接网络设备后再填入设备编号,通常为 [IP] 或 [IP:Port]的形式。使用 adb devices 命令可以列出所有已连接设备。
perf_debug:进行性能评估时是否开启 debug 模式。默认值为 False ,调用 rknn.val_perf() 接口可以获取模型运行的总时间。设为 True 时,可以获取到每一层的运行时间,RV1103、RV1103B、RV1106和RV1106B平台不支持。
eval_mem:是否进入内存评估模式。默认值为 False 。设为 True 进入内存评估模式后,可以调用rknn.eval_memory() 接口获取模型运行时的内存使用情况。
推理接口 rknn.inference() 参数如下:
inputs:待推理的输入列表,格式为ndarray。
data_format:输入数据的layout列表,只对4维的输入有效,格式为“ NCHW ”或“ NHWC ”。默认值为None ,表示所有输入的layout都为 NHWC 。
示例代码:
ret = rknn.init_runtime(target=platform, device_id='515e9b401c060c0b')

# Preprocess
image_src = cv2.imread(IMG_PATH)
img = preprocess(image_src)

# Inference
outputs = rknn.inference(inputs=[img])

# Postprocess
outputs = postprocess(outputs)
注意事项: 1.在RV1103 / RV1106平台上推理时若遇到”E RKNN: failed to allocate fd, ret: -1, errno:12”报错,可以在开发板终端运行RkLunch-stop.sh,关闭其他占用内存的应用后再连板推理。将rknn_server更新到2.1.0版本也可以缓解该问题。
2.在ARM64版本中 rknn.init_runtime() 无需添加device_id
2.3.2 精度评估
若量化模型推理结果有问题,可以使用 rknn.accuracy_analysis() 接口进行精度分析,查看每层算子的精度。
精度分析接口 rknn.accuracy_analysis() 参数如下:
inputs:输入文件路径列表(格式包括 jpg 、 png 、 bmp 和 npy )。
output_dir:分析结果保存目录,默认值为’ ./snapshot ‘。
target:目标硬件平台。默认值为 None ,使用仿真器进行精度分析。如果设置了target(RK3562 /RK3566 / RK3568 / RK3588 / RK3576 / RV1103 / RV1103B / RV1106 / RV1106B / RV1126B),则会获取运行时每一层的结果,并进行精度分析。
device_id:设备编号。默认值为 None 。若有设置target则选择唯一一台设备进行精度分析。如果电脑连接多台设备时,需要指定相应的设备ID。若通过网络adb连接设备进行精度分析,则需要用戶手动执行命令 adb connect [IP] 连接网络设备后再填入设备编号,通常为 [IP] 或 [IP]:[Port] 的形式。
注意事项:
1.精度分析时可能会因为模型太大且开发板上存储容量不够导致运行失败,可在开发板终端上使用 df -h 命令来确认存储容量,若空间不足请删除无用文件保证 output_dir 对应分区有足够的存储空间用于保存结果文件。
2.通过 rknn.load_rknn() 加载RKNN模型后,因RKNN模型缺失原始模型信息,因此无法使用模型精度分析功能。
3.在ARM64版本中 rknn.accuracy_analysis() 无需添加device_id,并且该版本不支持adb设备连接到其他设备做精度分析。
示例代码:
ret = rknn.accuracy_analysis(inputs=[img_path], target=platform, device_id='515e9b401c060c0b')
精度分析结果如下图
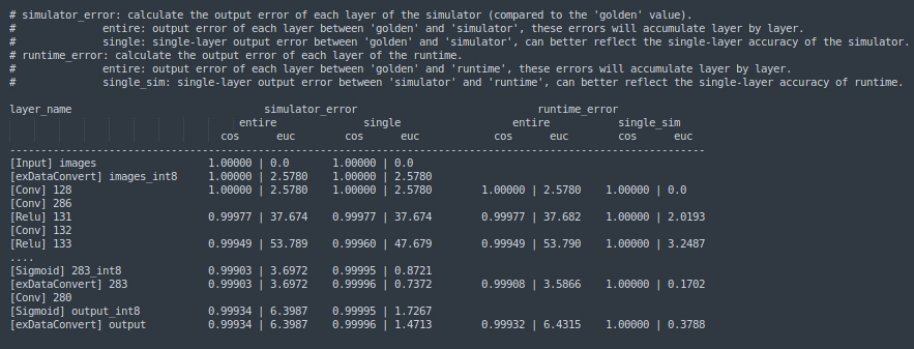
图2-8 精度分析结果
完整的精度分析包括模拟器精度分析结果和板端精度分析结果,同时模拟器和板端的精度分析结果都分为完整模型推理结果对比和逐层推理结果对比。详细说明如下:
simulator_error:
entire: 从输入层到当前层 simulator 结果与 golden 结果对比的余弦距离和欧氏距离。
single: 当前层使用 golden 输入时,simulator 结果与 golden 结果对比的余弦距离和欧氏距离。
runtime_error:
entire: 从输入层到当前层板端实际推理结果与 golden 结果对比的余弦距离和欧氏距离。
single: 当前层使用 golden 输入时,板端当前层实际推理结果与 golden 结果对比的余弦距离和欧氏距离。
2.3.3 性能评估
接口 rknn.eval_perf() 会输出当前的硬件频率并获取模型的性能评估结果, fix_freq 参数表示是否需要尝试对硬件(包括CPU/NPU/DDR)定频,如果要对硬件定频则设置成 True ,否则设置成 False ,默认值为True 。若初始化时 rknn.init_runtime() 的 perf_debug 参数设置为 True ,将输出每一层的耗时情况和总耗时情况,若为 False 则只输出总耗时情况。
注意:
1.平台RV1103 / RV1103B / RV1106 / RV1106B不支持 perf_debug 为 True 模式,只能输出模型总耗时情况。
示例代码:
ret = rknn.init_runtime(target=platform, perf_debug=True)
perf_detail = rknn.eval_perf()
以RK3588为例,执行eval_perf后输出的硬件频率如下(不同固件支持的频率可能会有所差异),其中,由于RK3588 CPU是大小核架构,CPU频率栏会输出多个频率值,单位为KHz,而NPU和DDR频率单位都是Hz。
CPU Current Frequency List:
  - 1800000
  - 2256000
  - 2304000
NPU Current Frequency List:
  - 1000000000
DDR Current Frequency List:
  - 2112000000
性能评估结果如下:
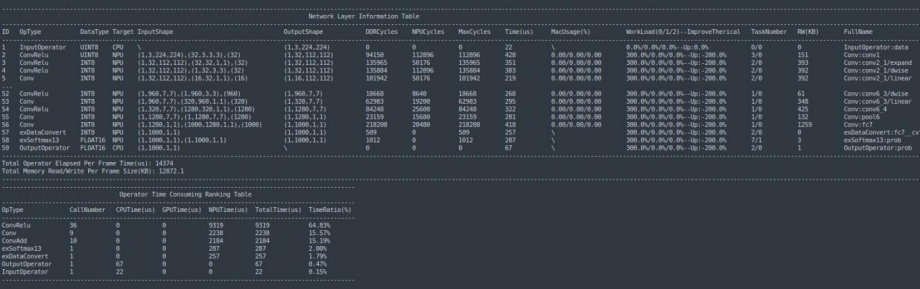
图2-9 性能评估结果
性能评估结果各字段说明如下表:
表2-2 性能评估结果各字段说明
| 字段 | 详细说明 |
|---|---|
| ID | 算子编号 |
| OpType | 算子类型 |
| DataType | 输入的数据类型 |
| Target | 算子运行的硬件(CPU/NPU/GPU) |
| InputShape | 输入形状 |
| OutputShape | 输出形状 |
| DDRCycles | DDR读写时钟周期数 |
| NPUCycles | NPU计算时钟周期数 |
| MaxCycles | DDR Cycles和NPU Cycles的最大值 |
| Time(us) | 算子计算耗时(us) |
| MacUsage(%) | MAC使用率 |
| WorkLoad(0/1/2) | 0/1/2核负载情况(仅RK3588平台) |
| WorkLoad(0/1) | 0/1核负载情况(仅RK3576平台) |
| TaskNumber | NPU任务数 |
| RW(KB) | 读写的数据总量(KB) |
| FullName | 算子全名 |
| Total Operator Elapsed Per Frame Time(us) | 模型推理的单帧总耗时 |
| Total Memory Read/Write Per Frame Size(KB) | 模型推理的单帧总带宽消耗 |
| CallNumber | 单帧内该算子运行次数 |
| CPUTime(us) | 单帧内该算子在CPU上的总耗时 |
| GPUTime(us) | 单帧内该算子在GPU上的总耗时 |
| NPUTime(us) | 单帧内该算子在NPU上的总耗时 |
| TotalTime(us) | 单帧内该算子的总耗时 |
| TimeRatio(%) | 单帧内该算子的总耗时与单帧总耗时的比值 |
2.3.4 内存评估
接口 rknn.eval_memory() 可以获取模型的内存消耗评估结果。初始化时 rknn.init_runtime() 的eval_mem 参数设置为 True ,将输出各部分内存消耗情况。
示例代码:
ret = rknn.init_runtime(target=platform, eval_mem=True)
memory_detail = rknn.eval_memory()
内存评估结果如下:
======================================================
      Memory Profile Info Dump
======================================================
NPU model memory detail(bytes):
  Weight Memory: 8.67 MiB
  Internal Tensor Memory: 7.42 MiB
  Other Memory: 3.03 MiB
  Total Memory: 19.12 MiB

INFO: When evaluating memory usage, we need consider
the size of model, current model size is: 11.86 MiB
======================================================
内存评估结果各字段说明如下:
表2-3 内存评估结果各字段说明
| 字段 | 详细说明 |
|---|---|
| Total Weight Memory | 模型中权重的内存占用(MB) |
| Total Internal Tensor Memory | 模型中间 tensor 内存占用(MB) |
| Other Memory | 其他内存占用(例如寄存器配置、输入输出tensor)(MB) |
| Total Memory | 模型的内存总占用(MB) |