
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 6/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
2.3 Modellbewertung
2.3.1 Modellinferenz
Nach der Konvertierung nach RKNN kann die Inferenz im Simulator oder auf dem Entwicklungsboard ausgeführt werden. Prüfen Sie die Ergebnisse nach der Nachverarbeitung. Bei falschen Ergebnissen analysieren Sie die Genauigkeit des quantisierten Modells und prüfen Vor- und Nachverarbeitung. Die wesentlichen Parameter der Inferenzschnittstellen sind nachfolgend beschrieben.
Die Initialisierungsschnittstelle rknn.init_runtime() hat folgende Parameter:
target: Zielhardwareplattform. Standard None verwendet den Simulator. Für tatsächliche Ergebnisse auf dem Board muss die entsprechende Plattform angegeben werden: RK3562 / RK3566 / RK3568 / RK3588 / RK3576 / RV1103 / RV1103B / RV1106 / RV1106B / RV1126B.
device_id: Gerätekennung, Standard None. Bei gesetztem target wird das einzige angeschlossene Gerät ausgewählt. Sind mehrere Geräte angeschlossen, muss die passende Kennung angegeben werden. Bei einer Netzwerkverbindung über ADB zunächst manuell adb connect [IP] ausführen und anschließend die Kennung angeben, gewöhnlich [IP] oder [IP:Port]. adb devices listet alle verbundenen Geräte auf.
perf_debug: aktiviert den Debugmodus bei der Leistungsbewertung; Standard False. Der Originaltext nennt rknn.val_perf() zur Ausgabe der Gesamtlaufzeit des Modells. Mit True lässt sich die Laufzeit jeder Schicht ermitteln; RV1103, RV1103B, RV1106 und RV1106B unterstützen dies nicht.
eval_mem: aktiviert den Speicherbewertungsmodus; Standard False. Nach Setzen auf True kann rknn.eval_memory() den Speicherverbrauch des Modells zur Laufzeit ermitteln.
Die Schnittstelle rknn.inference() hat folgende Parameter:
inputs: Liste der Inferenzeingaben im ndarray-Format.
data_format: Liste der Layouts der Eingabedaten; nur für vierdimensionale Eingaben wirksam. Zulässig sind NCHW und NHWC. Standard None bedeutet NHWC für alle Eingaben.
Codebeispiel:
ret = rknn.init_runtime(target=platform, device_id='515e9b401c060c0b')

# Preprocess
image_src = cv2.imread(IMG_PATH)
img = preprocess(image_src)

# Inference
outputs = rknn.inference(inputs=[img])

# Postprocess
outputs = postprocess(outputs)
Hinweise: 1. Bei der Fehlermeldung “E RKNN: failed to allocate fd, ret: -1, errno: 12” auf RV1103 / RV1106 kann vor der Inferenz RkLunch-stop.sh im Board-Terminal ausgeführt werden, um andere speicherintensive Anwendungen zu schließen. Auch ein Update von rknn_server auf 2.1.0 kann das Problem mindern.
- In der ARM64-Version benötigt rknn.init_runtime() kein device_id.
2.3.2 Analyse der Modellgenauigkeit
Bei Problemen mit den Inferenzergebnissen eines quantisierten Modells kann rknn.accuracy_analysis() die Genauigkeit jeder Operatorschicht untersuchen.
Die Schnittstelle rknn.accuracy_analysis() hat folgende Parameter:
inputs: Liste der Eingabedateipfade; unterstützte Formate sind jpg, png, bmp und npy.
output_dir: Verzeichnis für die Analyseergebnisse; Standard ‘./snapshot’.
target: Zielhardwareplattform. Standard None verwendet den Simulator für die Genauigkeitsanalyse. Bei Angabe von RK3562 / RK3566 / RK3568 / RK3588 / RK3576 / RV1103 / RV1103B / RV1106 / RV1106B / RV1126B werden die Laufzeitergebnisse jeder Schicht auf dieser Plattform ermittelt und analysiert.
device_id: Gerätekennung, Standard None. Bei gesetztem target wird das einzige Gerät ausgewählt. Bei mehreren Geräten muss die gewünschte Kennung angegeben werden. Für ADB über das Netzwerk zunächst adb connect [IP] ausführen, dann die Kennung angeben, gewöhnlich [IP] oder [IP]:[Port].
Hinweise:
-
Die Analyse kann scheitern, wenn das Modell zu groß und der Speicherplatz des Boards unzureichend ist. Prüfen Sie den freien Platz im Board-Terminal mit df -h. Entfernen Sie bei Bedarf unnötige Dateien, sodass die Partition mit output_dir genügend Platz für die Ergebnisdateien bietet.
-
Nach dem Laden mit rknn.load_rknn() ist die Genauigkeitsanalyse nicht möglich, da dem RKNN-Modell Informationen des ursprünglichen Modells fehlen.
-
In der ARM64-Version benötigt rknn.accuracy_analysis() kein device_id. Diese Version unterstützt keine Genauigkeitsanalyse auf einem weiteren über ADB verbundenen Gerät.
Codebeispiel:
ret = rknn.accuracy_analysis(inputs=[img_path], target=platform, device_id='515e9b401c060c0b')
Die Ergebnisse der Genauigkeitsanalyse sind nachfolgend dargestellt.
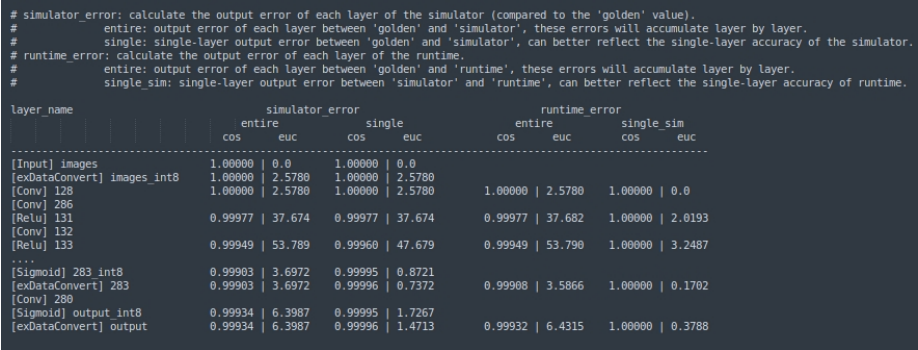
Abbildung 2-8: Ergebnisse der Genauigkeitsanalyse
Eine vollständige Analyse enthält Ergebnisse des Simulators und des Boards. Beide umfassen den Vergleich der gesamten Inferenzkette sowie den schichtweisen Vergleich. Im Einzelnen:
simulator_error:
entire: Kosinus- und euklidischer Abstand zwischen Simulatorergebnis und Referenzergebnis für die Kette von der Eingabeschicht bis zur aktuellen Schicht.
single: Kosinus- und euklidischer Abstand zwischen Simulatorergebnis und Referenzergebnis, wenn die aktuelle Schicht die Referenzeingabe erhält.
runtime_error:
entire: Kosinus- und euklidischer Abstand zwischen tatsächlichem Board-Ergebnis und Referenzergebnis für die Kette von der Eingabeschicht bis zur aktuellen Schicht.
single: Kosinus- und euklidischer Abstand zwischen dem Board-Ergebnis der aktuellen Schicht und dem Referenzergebnis bei Referenzeingabe dieser Schicht.
2.3.3 Bewertung der Modellleistung
rknn.eval_perf() gibt die aktuellen Hardwarefrequenzen und die Leistungsbewertung aus. fix_freq bestimmt, ob die Frequenzen von CPU/NPU/DDR nach Möglichkeit festgesetzt werden: True aktiviert dies, False deaktiviert es; Standard True. Wurde rknn.init_runtime() mit perf_debug=True initialisiert, erscheinen die Laufzeit jeder Schicht und die Gesamtlaufzeit. Bei False wird nur die Gesamtlaufzeit ausgegeben.
Hinweis:
- RV1103 / RV1103B / RV1106 / RV1106B unterstützen perf_debug=True nicht und geben nur die Gesamtlaufzeit des Modells aus.
Codebeispiel:
ret = rknn.init_runtime(target=platform, perf_debug=True)
perf_detail = rknn.eval_perf()
Nachfolgend stehen die von eval_perf ausgegebenen Frequenzen am Beispiel RK3588; unterstützte Frequenzen können je nach Firmware variieren. Wegen der big.LITTLE-CPU-Architektur erscheinen mehrere CPU-Frequenzen in KHz; NPU- und DDR-Frequenzen werden in Hz ausgegeben.
CPU Current Frequency List:
  - 1800000
  - 2256000
  - 2304000
NPU Current Frequency List:
  - 1000000000
DDR Current Frequency List:
  - 2112000000
Ergebnisse der Leistungsbewertung:
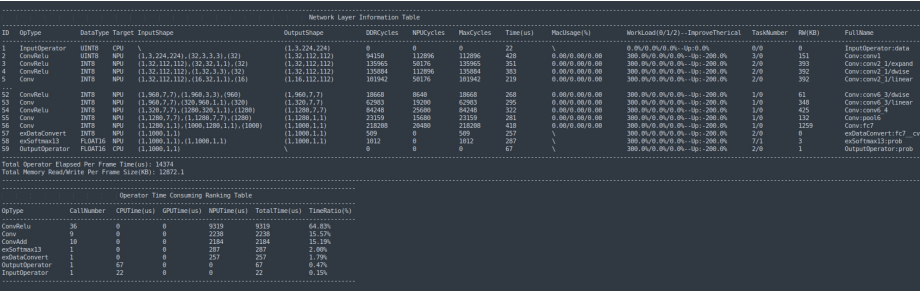
Abbildung 2-9: Ergebnisse der Leistungsbewertung
Die folgende Tabelle beschreibt die Ergebnisfelder:
Tabelle 2-2: Felder der Leistungsbewertung
| Feld | Beschreibung |
|---|---|
| ID | Operator-ID |
| OpType | Operatortyp |
| DataType | Eingabedatentyp |
| Target | Hardware für die Operatorausführung (CPU/NPU/GPU) |
| InputShape | Eingabeform |
| OutputShape | Ausgabeform |
| DDRCycles | Anzahl der DDR-Lese-/Schreibtakte |
| NPUCycles | Anzahl der NPU-Rechentakte |
| MaxCycles | Maximum aus DDRCycles und NPUCycles |
| Time(us) | Rechenzeit des Operators (us) |
| MacUsage(%) | MAC-Auslastung |
| WorkLoad(0/1/2) | Auslastung der Kerne 0/1/2, nur RK3588 |
| WorkLoad(0/1) | Auslastung der Kerne 0/1, nur RK3576 |
| TaskNumber | Anzahl der NPU-Aufgaben |
| RW(KB) | Insgesamt gelesene und geschriebene Datenmenge (KB) |
| FullName | Vollständiger Operatorname |
| Total Operator Elapsed Per Frame Time(us) | Gesamte Operatorlaufzeit je Inferenzframe des Modells |
| Total Memory Read/Write Per Frame Size(KB) | Gesamte Speicherlese-/Schreibmenge je Inferenzframe des Modells |
| CallNumber | Anzahl der Operatorausführungen innerhalb eines Frames |
| CPUTime(us) | Gesamte CPU-Laufzeit des Operators innerhalb eines Frames |
| GPUTime(us) | Gesamte GPU-Laufzeit des Operators innerhalb eines Frames |
| NPUTime(us) | Gesamte NPU-Laufzeit des Operators innerhalb eines Frames |
| TotalTime(us) | Gesamtlaufzeit des Operators innerhalb eines Frames |
| TimeRatio(%) | Anteil der gesamten Operatorlaufzeit an der Gesamtlaufzeit eines Frames |
2.3.4 Bewertung des Modellspeicherverbrauchs
rknn.eval_memory() ermittelt die Speicherbewertung des Modells. Wurde rknn.init_runtime() mit eval_mem=True initialisiert, wird der Speicherverbrauch der einzelnen Bestandteile ausgegeben.
Codebeispiel:
ret = rknn.init_runtime(target=platform, eval_mem=True)
memory_detail = rknn.eval_memory()
Ergebnisse der Speicherbewertung:
======================================================
      Memory Profile Info Dump
======================================================
NPU model memory detail(bytes):
  Weight Memory: 8.67 MiB
  Internal Tensor Memory: 7.42 MiB
  Other Memory: 3.03 MiB
  Total Memory: 19.12 MiB

INFO: When evaluating memory usage, we need consider
the size of model, current model size is: 11.86 MiB
======================================================
Beschreibung der Felder der Speicherbewertung:
Tabelle 2-3: Felder der Speicherbewertung
| Feld | Beschreibung |
|---|---|
| Total Weight Memory | Speicherverbrauch der Modellgewichte (MB) |
| Total Internal Tensor Memory | Speicherverbrauch der Zwischentensoren (MB) |
| Other Memory | Sonstiger Speicher, etwa Registerkonfiguration sowie Ein- und Ausgabetensoren (MB) |
| Total Memory | Gesamter Speicherverbrauch des Modells (MB) |