
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 13/22
动态 Shape 模型与部署
4.1.3 动态Shape
4.1.3.1 动态SHAPE功能介绍
动态shape是指模型输入数据的形状在运行时可以改变。它可以帮助处理输入数据大小不固定的情况,增加模型的灵活性。在之前仅支持静态shape的RKNN模型情况下,如果用戶需要使用多个输入shape,传统的做法是生成多个RKNN模型,在模型部署时初始化多个上下文分别执行推理,而在引入动态shape后,用戶可以只保留一份与静态shape RKNN模型大小接近的动态shape RKNN模型,并使用一个上下文进行推理,从而节省Flash占用和DDR占用,动态shape在图像处理和序列模型推理中具有重要的作用,它的典型应用场景包括:
序列⻓度改变的模型,常见于NLP模型,例如BERT, GPT
空间维度变化的模型,例如分割和⻛格迁移
带Batch模型,Batch维度上变化
可变输出数量的目标检测模型
4.1.3.2 RKNN SDK版本和平台要求
RKNN-Toolkit2版本>=1.5.0
RKNPU Runtime库(librknnrt.so)版本>=1.5.0
RK3562/RK3566/RK3568/RK3576/RK3588/RK3588S/RV1126B平台的NPU支持该功能
4.1.3.3 生成动态SHAPE的RKNN模型
本节介绍使用RKNN-Toolkit2的Python接口生成动态shape的RKNN模型的步骤:
1.确认模型支持动态shape
如果模型文件本身不是动态shape, RKNN-Toolkit2支持扩展成动态shape的RKNN模型。首先,用戶要确认模型本身不存在限制动态shape的算子或子图结构,例如,常量的形状无法改变,RKNN-Toolkit2工具在转换过程会报错,如果遇到不支持动态shape扩展的情况,用戶要根据报错信息,修改模型结构,重新训练模型以支持动态shape。建议使用原始模型本身就是动态shape的模型。
2.设置需要使用的输入形状
由于NPU硬件特性,动态shape RKNN模型不支持输入形状任意改变,要求用戶设置有限个输入形状。对于多输入的模型,每个输入的shape个数要相同。例如,在使用RKNN-Toolkit2转换Caffe模型时,Python代码示例如下:
# Python
dynamic_input = [
  [[1,3,224,224]], # set the first shape for all inputs
  [[1,3,192,192]], # set the second shape for all inputs
  [[1,3,160,160]], # set the third shape for all inputs
]

# Pre-process config
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82], quant_img_RGB2BGR=True,
dynamic_input=dynamic_shapes)
上述接口配置会生成支持3个shape分别是[1,3,224,224]、[1,3,192,192]和[1,3,160,160]的动态shapeRKNN模型。
dynamic_input 中的shape与原始模型框架的layout一致。例如,对于相同的224x224大小的RGB图片做分类,TensorFlow/TFLite模型输入是[1,224,224,3],而ONNX模型输入是[1,3,224,224]。
3.量化
在设置好输入shape后, 如果要做量化,则需要设置量化矫正集数据。工具会读取用戶设置的最大分辨率输入做量化(是所有输入尺寸之和的最大的一组shape)。例如,模型有两个输入,一个输入shape分别是[1,224]和[1,112],另一个输入shape分别[1,40]和[1,80],第一组shape所有输入尺寸之和是1224+140=264,第二组shape所有输入尺寸之和是1112+180=192,第一组shape所有输入尺寸之和更大,因此使用两个输入分别以[1,224]和[1,40]的shape做量化。
如果量化矫正集是jpg/png图片格式,用戶可以使用不同的分辨率的图片做量化,因为工具会对图片使用opencv的resize方法缩放到最大分辨率后做量化。
如果量化矫正集是npy格式,则用戶必须使用最大分辨率输入的shape。量化后,模型内所有shape在运行时使用同一套量化参数进行推理。
另外,输入的最大分辨率shape在调用rknn.config时也会打印出来,如下:
W config: The 'dynamic_input' function has been enabled, the MaxShape is dynamic_input[0] = [[1,224],[1,40]]!
The following functions are subject to the MaxShape:
1. The quantified dataset needs to be configured according to MaxShape
2. The eval_perf or eval_memory return the results of MaxShape
4.推理评估或精度分析
动态shape RKNN模型做推理或做精度分析时,用戶必须提供第2步中设置的其中一组shape的输入。接口使用上与静态shape RKNN模型场景一致,此处不做赘述。
完整的创建动态shape RKNN模型示例,请参考(https://github.com/airockchip/rknn-toolkit2/tree/master/rknn-toolkit2/examples/functions/dynamic_shape)
4.1.3.4 C API部署
得到动态shape RKNN模型后,接着使用RKNPU2 C API进行部署。按照接口形式,分为通用API和零拷贝API部署流程。
4.1.3.4.1 通用API
使用通用API部署动态shape RKNN模型的流程如下图所示:
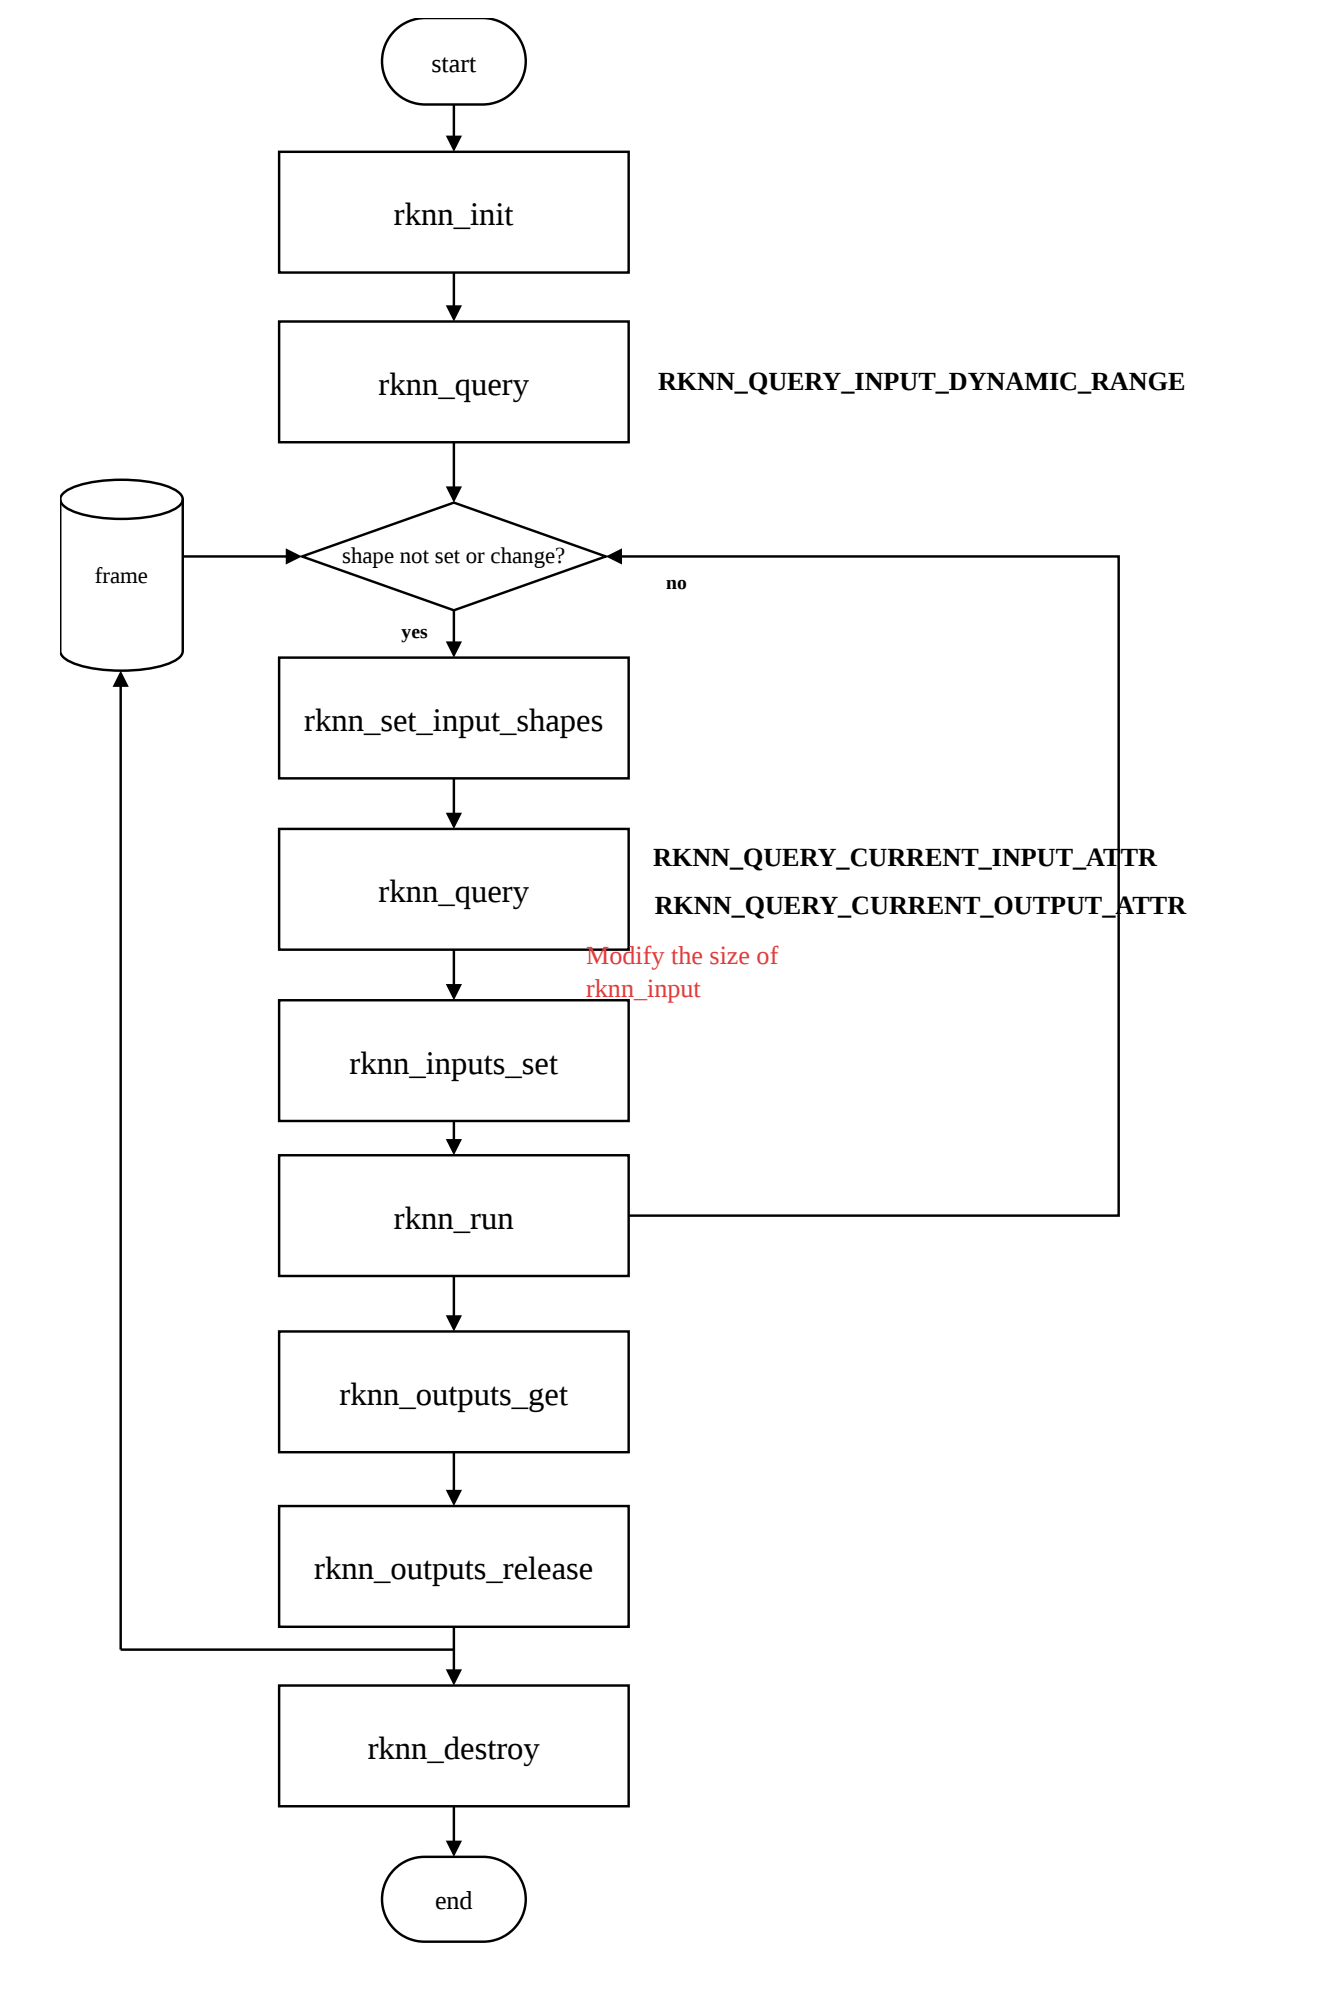
图4-5 动态shape输入接口的通用API调用流程
加载动态shape RKNN模型后,可以在运行时动态修改输入的shape。首先,通过 rknn_query() 可以查询RKNN模型支持的输入shape列表,每个输入支持的shape列表信息以 rknn_input_range 结构体形式返回,它包含了每个输入的名称、数据布局信息、shape个数以及具体shape。接着,通过调用rknn_set_input_shapes() 接口,传入包含每个输入shape信息的 rknn_tensor_attr 数组指针可以设置当前推理使用的shape。在设置输入shape后,可以再次调用 rknn_query() 查询当前设置成功后的输入和输出shape。
最后,按照通用API流程完成推理。每次切换输入shape时,需要再设置一次新的shape,准备新shape大小的数据并再次调用 rknn_inputs_set() 接口。如果推理前不需要切换输入shape,无需重复调用rknn_set_input_shapes() 接口。
1.初始化
调用 rknn_init() 接口初始化动态shape RKNN模型,
对于动态shape RKNN模型,在初始化上下文时有如下限制:
不支持权重共享功能(带 RKNN_FLAG_SHARE_WEIGHT_MEM 标志的初始化)。
不支持上下文复用功能(具体说明见 rknn_dup_context 接口)。
2.查询RKNN模型支持的输入shape组合
初始化成功后,通过 rknn_query() 可以查询到RKNN模型支持的输入shape列表,每个输入支持的shape列表信息以 rknn_input_range 结构体形式返回,它包含了每个输入的名称,layout信息,支持的shape个数以及具体shape。C代码示例如下:
// 查询模型支持的输入shape
rknn_input_range dyn_range[io_num.n_input];
memset(dyn_range, 0, io_num.n_input * sizeof(rknn_input_range));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
  dyn_range[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_INPUT_DYNAMIC_RANGE, &dyn_range[i], sizeof(rknn_input_range));
  if (ret != RKNN_SUCC)
  {
    fprintf(stderr, "rknn_query error! ret=%d\n", ret);
    return -1;
  }
  dump_input_dynamic_range(&dyn_range[i]);
}
注意:对于多输入的模型,所有输入的shape按顺序一一对应,例如,有两个输入、多种shape的RKNN模型,第一个输入的第一个shape与第二个输入的第一个shape组合有效,不存在交叉的shape组合。例如,模型有两个输入A和B,A的shape分别是[1,224]和[1,112],B的shape分别[1,40]和[1,80],此时,只支持以下两组输入shape的情况:
A shape = [1,224],B shape=[1,40]
A shape = [1,112],B shape=[1,80]
3.设置输入shape
在首次设置输入数据或者输入数据shape发生改变时,需要调用 rknn_set_input_shapes() 接口动态修改输入shape。加载动态shape RKNN模型后,可以在运行时动态修改输入的shape。通过调用rknn_set_input_shapes() 接口,传入所有输入的 rknn_tensor_attr 数组,每个rknn_tensor_attr 中的 dims , n_dims 和 fmt 三个成员信息表示了当前推理所用的shape。C代码示例如下:
/**
dynamic inputs shape range:
index=0, name=data, shape_number=2, range=[[1, 224, 224, 3],[1, 112, 224, 3]], fmt =
NHWC
**/
input_attrs[0].dims[0] = 1;
input_attrs[0].dims[1] = 224;
input_attrs[0].dims[2] = 224;
input_attrs[0].dims[3] = 3;
input_attrs[0].fmt=RKNN_TENSOR_NHWC;
ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
if (ret < 0)
{
    fprintf(stderr, "rknn_set_input_shapes error! ret=%d\n", ret);
    return -1;
}
其中, io_num.n_input 是输入数量, input_attrs 是模型输入的 rknn_tensor_attr 结构体数组。
注:这里设置的shape必须包含在第2步查询到的shape列表中。
在设置输入shape后,可以再次调用 rknn_query 查询当前设置成功后的输入和输出shape,C代码示例如下:
// 获取当前次推理的输入和输出shape
rknn_tensor_attr cur_input_attrs[io_num.n_input];
memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
  cur_input_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));
  if (ret < 0)
  {
    printf("rknn_init error! ret=%d\n", ret);
    return -1;
  }
  dump_tensor_attr(&cur_input_attrs[i]);
}
rknn_tensor_attr cur_output_attrs[io_num.n_output];
memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_output; i++)
{
  cur_output_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &(cur_output_attrs[i]), sizeof(rknn_tensor_attr));
  if (ret != RKNN_SUCC)
  {
    printf("rknn_query fail! ret=%d\n", ret);
    return -1;
  }
  dump_tensor_attr(&cur_output_attrs[i]);
}
注意事项:
rknn_set_input_shape 接口要求输入tensor的shape为4维时,fmt使用 NHWC ,非4维时使用UNDEFINED 。
在 rknn_set_input_shapes 尚未调用前,使用带 RKNN_QUERY_CURRENT 前缀的命令查询的shape信息是无效的。
4.推理
在设置好当前输入shape后,假设输入Tensor的shape信息保存在 cur_input_attrs 数组中,以通用API接口为例,C代码示例如下:
// 设置输入信息
rknn_input inputs[io_num.n_input];
memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
for (int i = 0; i < io_num.n_input; i++)
{
    int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] : cur_input_attrs[i].dims[2];
    int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] : cur_input_attrs[i].dims[3];
    cv::resize(imgs[i], imgs[i], cv::Size(width, height));
    inputs[i].index = i;
    inputs[i].pass_through = 0;
    inputs[i].type = RKNN_TENSOR_UINT8;
    inputs[i].fmt = RKNN_TENSOR_NHWC;
    inputs[i].buf = imgs[i].data;
    inputs[i].size = imgs[i].total() * imgs[i].channels();
}

// 将输入数据转换成正确的格式后,放到输入缓冲区
ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
if (ret < 0)
{
    printf("rknn_input_set fail! ret=%d\n", ret);
    return -1;
}

// 进行推理
printf("Begin perf ...\n");
double total_time = 0;
for (int i = 0; i < loop_count; ++i)
{
    int64_t start_us = getCurrentTimeUs();
    ret = rknn_run(ctx, NULL);
    int64_t elapse_us = getCurrentTimeUs() - start_us;
    if (ret < 0)
    {
       printf("rknn run error %d\n", ret);
       return -1;
    }
    total_time += elapse_us / 1000.f;
    printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f
* 1000.f / elapse_us);
}
printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);

// 获取输出结果
rknn_output outputs[io_num.n_output];
memset(outputs, 0, io_num.n_output * sizeof(rknn_output));
for (uint32_t i = 0; i < io_num.n_output; ++i)
{
    outputs[i].want_float = 1;
    outputs[i].index = i;
    outputs[i].is_prealloc = 0;
}

ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0)
{
    printf("rknn_outputs_get fail! ret=%d\n", ret);
    return ret;
}

//释放输出缓冲区buffer
ret = rknn_outputs_release(ctx, io_num.n_output, outputs);
4.1.3.4.2 零拷贝API
对于零拷贝API而言,初始化成功后,通过 rknn_query() 可以查询RKNN模型支持的输入shape列表,调用rknn_create_mem() 接口分配的输入和输出内存。接着,通过调用 rknn_set_input_shapes() 接口,传入包含每个输入shape信息的 rknn_tensor_attr 数组指针可以设置当前推理使用的shape。在设置输入shape后,可以再次调用 rknn_query() 查询设置成功后的输入和输出shape。最后,调用rknn_set_io_mem() 接口设置需要的输入输出内存。每次切换输入shape时,需要再设置一次新的shape,准备新shape大小的数据并再次调用 rknn_set_io_mem() 接口,如果推理前不需要切换输入shape,无需重复调用 rknn_set_input_shapes() 接口。典型用法流程如下图所示:
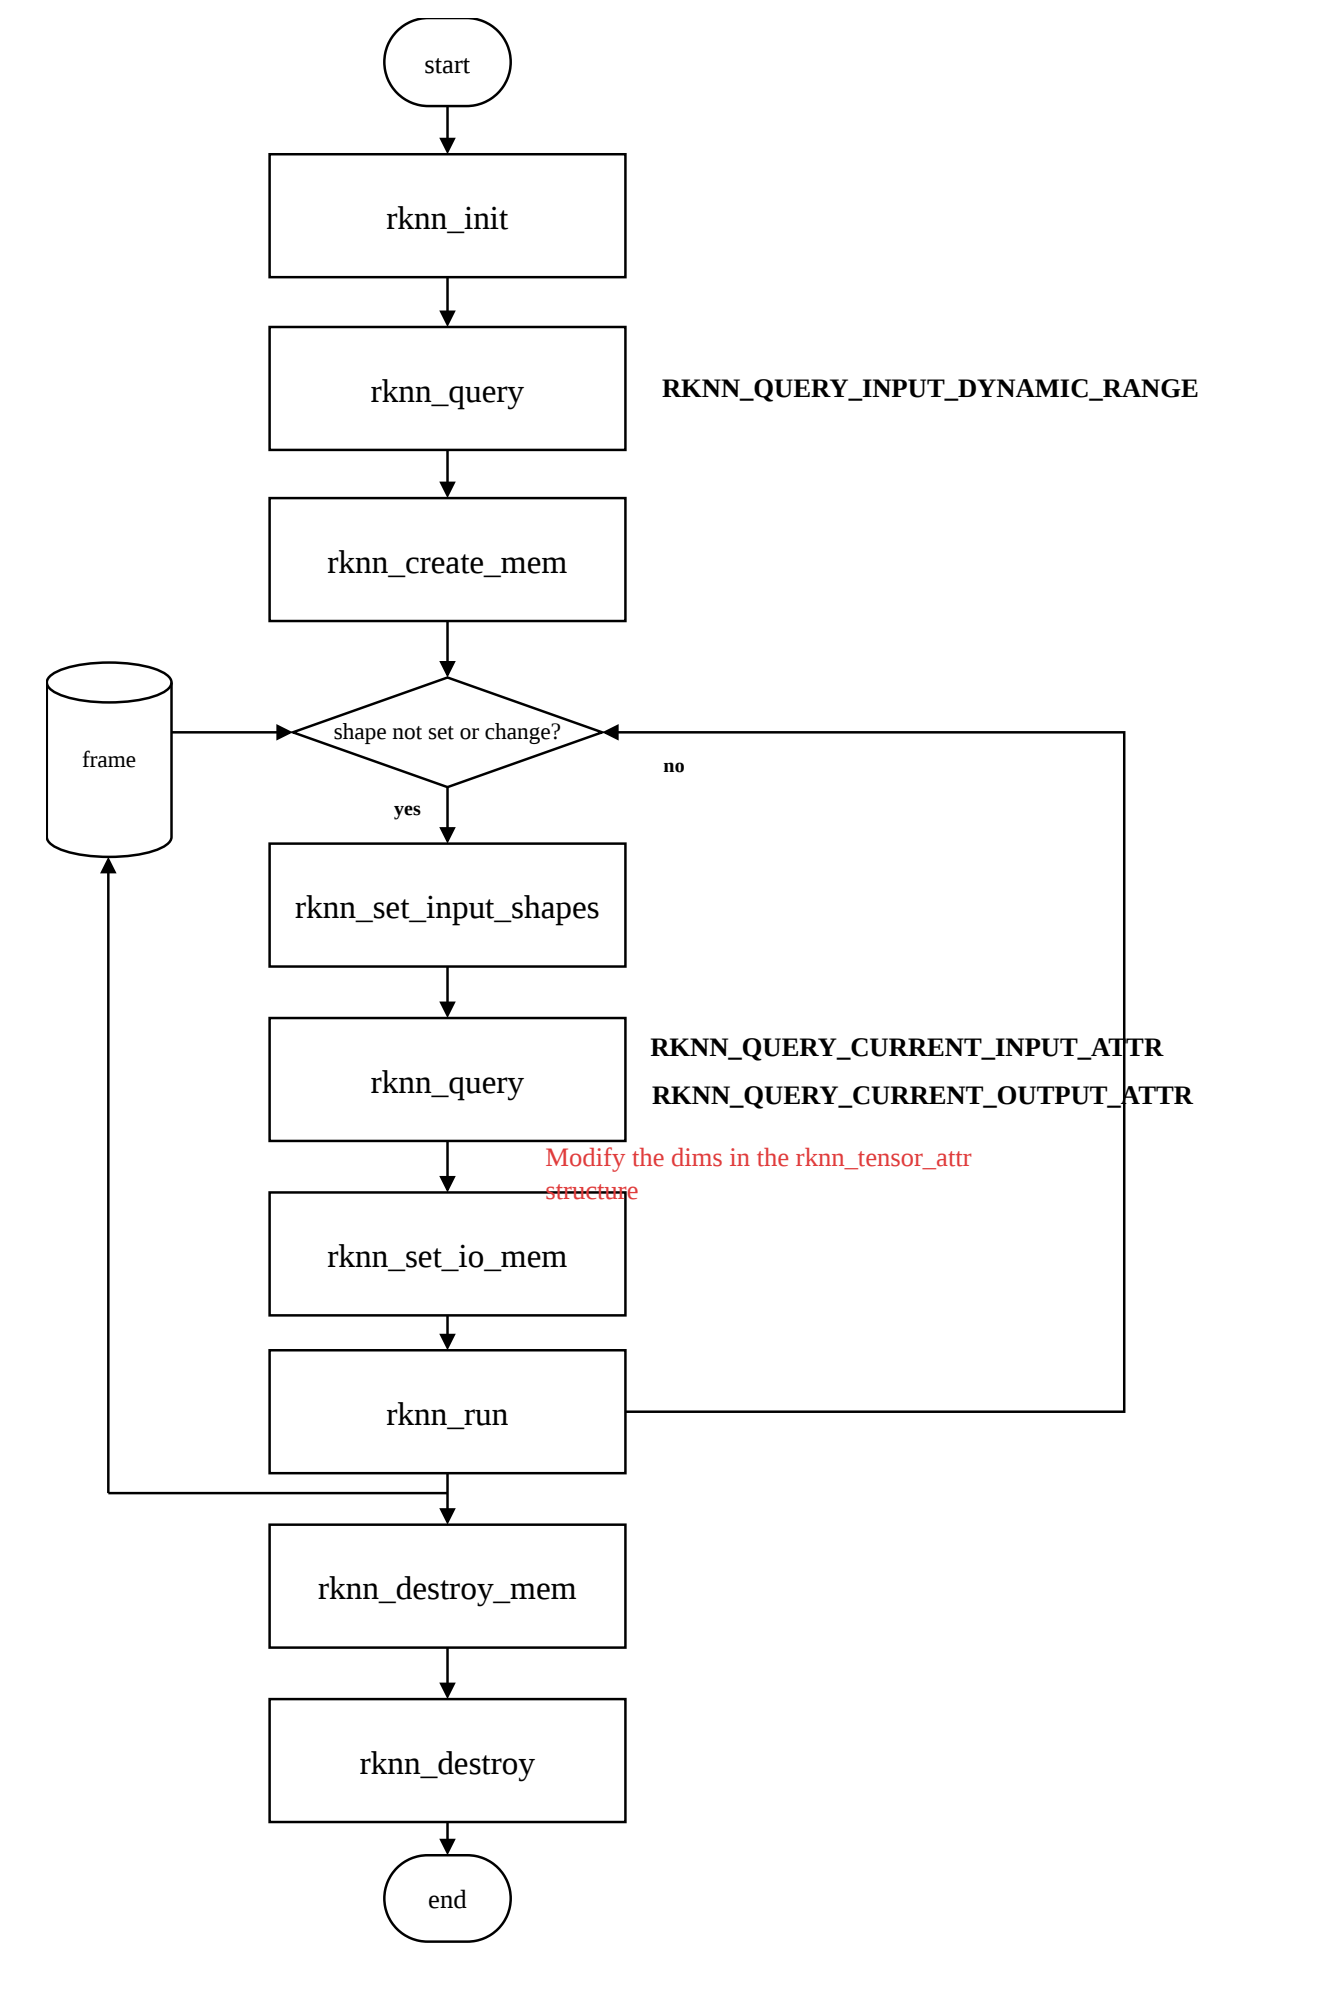
图4-6 动态shape输入接口的零拷贝API调用流程
初始化、查询RKNN模型支持的输入shape组合、设置输入shape使用与上述通用API相同,此处不做赘述。不同之处在于,在设置输入shape后,使用的接口不同。零拷贝推理C代码示例如下:
// 创建最大的输入tensor内存
rknn_tensor_mem *input_mems[io_num.n_input];
for (int i = 0; i < io_num.n_input; i++) {
    // default input type is int8 (normalize and quantize need compute in outside)
    // if set uint8, will fuse normalize and quantize to npu
    input_attrs[i].type = RKNN_TENSOR_UINT8;
    // default fmt is NHWC, npu only support NHWC in zero copy mode
    input_attrs[i].fmt = RKNN_TENSOR_NHWC;
    input_mems[i] = rknn_create_mem(ctx, input_attrs[i].size_with_stride);
...
// 创建最大的输出tensor内存
rknn_tensor_mem *output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
    // default output type is depend on model, this require float32 to compute top5
    // allocate float32 output tensor
    int output_size = output_attrs[i].size * sizeof(float);
    output_mems[i] = rknn_create_mem(ctx, output_size);
...
// 加载输入并设置模型输入shape,每次切换输入shape要调用一次
for (int s = 0; s < shape_num; ++s) {
    for (int i = 0; i < io_num.n_input; i++) {
       for (int j = 0; j < input_attrs[i].n_dims; ++j) {
           input_attrs[i].dims[j] = shape_range[i].dyn_range[s][j];
    .....
    ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
    if (ret < 0) {
       fprintf(stderr, "rknn_set_input_shape error! ret=%d\n", ret);
       return -1;
    ....
    // 获取当前次推理的输入和输出shape
    printf("current input tensors:\n");
    rknn_tensor_attr cur_input_attrs[io_num.n_input];
    memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
    for (uint32_t i = 0; i < io_num.n_input; i++) {
       cur_input_attrs[i].index = i;
       // query info
       ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));
       if (ret < 0) {
           printf("rknn_init error! ret=%d\n", ret);
           return -1;
       dump_tensor_attr(&cur_input_attrs[i]);
       ...
       printf("current output tensors:\n");
    rknn_tensor_attr cur_output_attrs[io_num.n_output];
    memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
    for (uint32_t i = 0; i < io_num.n_output; i++) {
       cur_output_attrs[i].index = i;
       // query info
       ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &
(cur_output_attrs[i]), sizeof(rknn_tensor_attr));
       if (ret != RKNN_SUCC) {
           printf("rknn_query fail! ret=%d\n", ret);
           return -1;
       ...
       dump_tensor_attr(&cur_output_attrs[i]);
    // 指定NPU核心数量,仅3588/3576支持
    rknn_set_core_mask(ctx, (rknn_core_mask)core_mask);
    // 设置输入信息
    rknn_input inputs[io_num.n_input];
    memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
    std::vector<cv::Mat> resize_imgs;
    resize_imgs.resize(io_num.n_input);
    for (int i = 0; i < io_num.n_input; i++) {
       int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] : cur_input_attrs[i].dims[2];
       int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] : cur_input_attrs[i].dims[3];
       int stride = cur_input_attrs[i].w_stride;
       cv::resize(imgs[i], resize_imgs[i], cv::Size(width, height));
       int input_size = resize_imgs[i].total() * resize_imgs[i].channels();
       // 拷⻉外部数据到零拷⻉输入缓冲区
       if (width == stride)
           memcpy(input_mems[i]->virt_addr, resize_imgs[i].data, input_size);
       else {
           int height = cur_input_attrs[i].dims[1];
           int channel = cur_input_attrs[i].dims[3];
           // copy from src to dst with stride
           uint8_t *src_ptr = resize_imgs[i].data;
           uint8_t *dst_ptr = (uint8_t *)input_mems[i]->virt_addr;
           // width-channel elements
           int src_wc_elems = width * channel;
           int dst_wc_elems = stride * channel;
           for (int b = 0; b < cur_input_attrs[i].dims[0]; b++) {
               for (int h = 0; h < height; ++h) {
                   memcpy(dst_ptr, src_ptr, src_wc_elems);
                   src_ptr += src_wc_elems;
                   dst_ptr += dst_wc_elems;
           ....
    // 更新输入零拷⻉缓冲区内存
    for (int i = 0; i < io_num.n_input; i++) {
       cur_input_attrs[i].type = RKNN_TENSOR_UINT8;
       ret = rknn_set_io_mem(ctx, input_mems[i], &cur_input_attrs[i]);
       if (ret < 0) {
           printf("rknn_set_io_mem fail! ret=%d\n", ret);
           return -1;
     ....
    // 更新输出零拷⻉缓冲区内存
    for (uint32_t i = 0; i < io_num.n_output; ++i) {
       // default output type is depend on model, this require float32 to compute top5
       cur_output_attrs[i].type = RKNN_TENSOR_FLOAT32;
       cur_output_attrs[i].fmt = RKNN_TENSOR_NCHW;
       // set output memory and attribute
       ret = rknn_set_io_mem(ctx, output_mems[i], &cur_output_attrs[i]);
       if (ret < 0) {
           printf("rknn_set_io_mem fail! ret=%d\n", ret);
           return -1;
      ....
    // 推理
    printf("Begin perf ...\n");
    double total_time = 0;
    for (int i = 0; i < loop_count; ++i) {
       int64_t start_us = getCurrentTimeUs();
       ret = rknn_run(ctx, NULL);
       int64_t elapse_us = getCurrentTimeUs() - start_us;
       if (ret < 0) {
           printf("rknn run error %d\n", ret);
           return -1;
       ...
       total_time += elapse_us / 1000.f;
       printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f * 1000.f / elapse_us);
    printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);
注意事项:
-
rknn_set_io_mem() 接口在动态shape情况下,输入buffer的shape和大小说明:
-
初始化完成后和调用 rknn_set_input_shapes() 接口前, rknn_query() 接口使用RKNN_QUERY_INPUT_ATTR 和 RKNN_QUERY_OUTPUT_ATTR 查询输入和输出Tensor的shape通常是最大的,用戶可以使用这两个命令获取的大小来分配输入和输出内存。若遇到多输入模型,部分输入的shape可能不是最大的,此时需要搜索支持的shape中最大的规格,并分配最大的输入和输出内存。
-
如果输入是非4维度,使用 fmt=UNDEFINED ,传递原始模型输入shape的buffer,大小则根据输入shape和type计算得到。
-
如果输入是4维度,支持使用 fmt=NHWC 或者 NC1HWC2 , 传递 NHWC 或者 NC1HWC2 shape和对应size的buffer(通过 rknn_query 查询相应字段获取shape和size)。
-
rknn_query() 接口中,标志位为 RKNN_QUERY_CURRENT_INPUT_ATTR 和RKNN_QUERY_CURRENT_OUTPUT_ATTR 时获取原始模型输入/输出的shape,其格式为 NHWC 或者UNDEFINED ;标志位为 RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR 和RKNN_QUERY_CURRENT_NATIVE_OUTPUT_ATTR 时获取NPU以最优性能读取数据时模型输入/输出的shape,其格式为 NHWC 或者 NC1HWC2 。
-
rknn_set_io_mem() 接口中使用的buffer排列格式为 NHWC 时, rknn_tensor_attr 中的shape和fmt需按照 RKNN_QUERY_CURRENT_INPUT_ATTR 查询到的信息进行设置;如果使用的buffer排列格式为 NC1HWC2 时,需要按照 RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR 查询到的信息进行设置。
完整的动态shape C API Demo请参考(https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_dynamic_shape_input_demo)