
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 13/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
4.1.3 Dynamische Form
4.1.3.1 Einführung in dynamische Formen
Dynamische Formen erlauben Änderungen der Eingabeform zur Laufzeit und erhöhen die Flexibilität bei variablen Datengrößen. Als RKNN nur statische Formen unterstützte, waren für mehrere Eingabeformen separate Modelle und Inferenzkontexte erforderlich. Mit dynamischen Formen genügt ein RKNN-Modell ähnlicher Größe wie das statische sowie ein Kontext; dies spart Flash und DDR. Das ist insbesondere für Bildverarbeitung und Sequenzmodelle wichtig. Typische Anwendungen:
Variable Sequenzlängen, etwa in NLP-Modellen wie BERT und GPT.
Variable räumliche Dimensionen, etwa bei Segmentierung und Stilübertragung.
Variable Batch-Dimensionen in Batch-Modellen.
Objekterkennungsmodelle mit variabler Ausgabeanzahl.
4.1.3.2 Anforderungen an RKNN-SDK-Version und Plattform
RKNN-Toolkit2-Version >=1.5.0
Version der RKNPU-Runtime-Bibliothek (librknnrt.so) >=1.5.0
Die NPU der Plattformen RK3562/RK3566/RK3568/RK3576/RK3588/RK3588S/RV1126B unterstützt diese Funktion.
4.1.3.3 RKNN-Modell mit dynamischer Form erzeugen
Erstellen eines RKNN-Modells mit dynamischer Form über die Python-API von RKNN-Toolkit2:
1 Prüfen, ob das Modell dynamische Formen unterstützt.
RKNN-Toolkit2 kann auch ein ursprünglich statisches Modell zu dynamischen Formen erweitern. Zuerst prüfen, dass keine Operatoren oder Teilgraphen die Formänderung beschränken: Die Form einer Konstante lässt sich etwa nicht ändern und führt zu einem Konvertierungsfehler. Bei nicht unterstützter Erweiterung die Struktur entsprechend der Fehlermeldung ändern und das Modell neu trainieren. Ein von Anfang an dynamisches Modell wird empfohlen.
- Verwendete Eingabeformen festlegen
Wegen der NPU-Eigenschaften sind keine beliebigen Formänderungen möglich; eine begrenzte Auswahl ist vorzugeben. Bei mehreren Eingängen muss die Formanzahl je Eingang übereinstimmen. Python-Beispiel einer Caffe-Konvertierung:
# Python
dynamic_input = [
    [[1,3,224,224]], # set the first shape for all inputs
    [[1,3,192,192]], # set the second shape for all inputs
    [[1,3,160,160]], # set the third shape for all inputs
]

# Pre-process config
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82],
quant_img_RGB2BGR=True, dynamic_input=dynamic_shapes)
Diese Konfiguration erzeugt ein Modell mit drei Formen: [1,3,224,224], [1,3,192,192], [1,3,160,160].
dynamic_input folgt dem Layout des ursprünglichen Frameworks. Bei RGB-Bildern 224x224 verwendet TensorFlow/TFLite beispielsweise [1,224,224,3], ONNX [1,3,224,224].
1 Quantisierung
Nach dem Setzen der Formen bei Bedarf den Quantisierungskalibrierungsdatensatz angeben. Verwendet wird die maximale Auflösung, also die Formgruppe mit der größten Summe aller Eingabegrößen. Beispiel: Eingang 1 hat [1,224]/[1,112], Eingang 2 [1,40]/[1,80]. Die Gruppensummen sind 1224+140=264 und 1112+180=192 (so im PDF gedruckt; Multiplikationszeichen fehlen im Original, die Schreibweise ist zu prüfen). Daher wird mit [1,224] und [1,40] quantisiert.
Bei jpg/png sind verschiedene Auflösungen möglich: Vor der Quantisierung skaliert das Werkzeug mit OpenCV resize auf die maximale Auflösung.
Bei npy muss die maximale Eingabeform verwendet werden. Danach verwenden alle Formen zur Laufzeit denselben Quantisierungsparametersatz.
Die maximale Eingabeform wird auch bei rknn.config ausgegeben:
W config: The 'dynamic_input' function has been enabled, the MaxShape is dynamic_input[0] = [[1,224],[1,40]]!
The following functions are subject to the MaxShape:
1. The quantified dataset needs to be configured according to MaxShape
2. The eval_perf or eval_memory return the results of MaxShape
- Inferenzbewertung oder Genauigkeitsanalyse
Für Inferenz oder Genauigkeitsanalyse Eingaben einer der in Schritt 2 gesetzten Formgruppen liefern. Die Schnittstellen entsprechen dem statischen Modellfall und werden hier nicht erneut erläutert.
Vollständiges Beispiel für dynamische Formen: https://github.com/airockchip/rknn-toolkit2/tree/master/rknn-toolkit2/examples/functions/dynamic_shape
4.1.3.4 Bereitstellung über die C-API
Stellen Sie das erzeugte Modell mit dynamischer Form über die RKNPU2-C-API bereit. Je nach Schnittstelle erfolgt dies über die allgemeine API oder Zero-Copy-API.
4.1.3.4.1 Allgemeine API
Bereitstellung eines dynamischen RKNN-Modells über die allgemeine API:
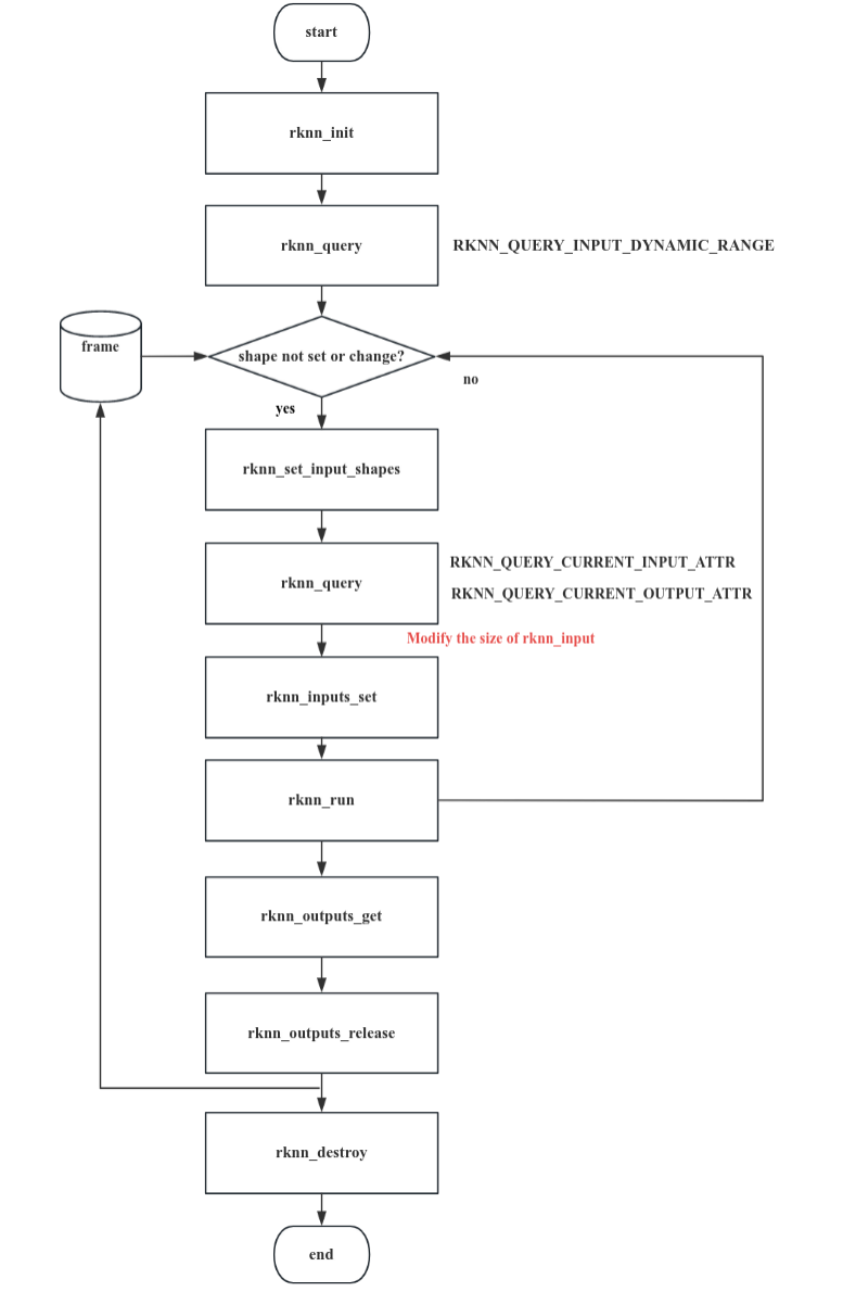
Abbildung 4-5. Allgemeiner API-Ablauf für dynamische Eingabeformen
Nach dem Laden eines dynamischen RKNN-Modells kann die Form zur Laufzeit geändert werden. Zuerst unterstützte Formen mit rknn_query() abfragen. Die Liste jedes Eingangs wird als rknn_input_range mit Name, Layout, Formanzahl und konkreten Formen zurückgegeben. Anschließend den Zeiger auf ein rknn_tensor_attr-Array mit den Eingabeformen an rknn_set_input_shapes() übergeben. Nach erfolgreichem Setzen mit rknn_query() die aktuellen Ein-/Ausgabeformen erneut abfragen.
Die Inferenz gemäß allgemeiner API abschließen. Bei jedem Formwechsel die neue Form setzen, passende Daten vorbereiten und rknn_inputs_set() erneut aufrufen. Ohne Formwechsel ist kein erneutes rknn_set_input_shapes() erforderlich.
1 Initialisierung
Initialisieren Sie das dynamische RKNN-Modell mit rknn_init().
Einschränkungen bei der Kontextinitialisierung dynamischer Modelle:
Gemeinsame Gewichte werden nicht unterstützt: keine Initialisierung mit RKNN_FLAG_SHARE_WEIGHT_MEM.
Kontextwiederverwendung wird nicht unterstützt; siehe rknn_dup_context.
2. Unterstützte Eingabeformkombinationen abfragen
Nach der Initialisierung liefert rknn_query() die Formen jedes Eingangs in rknn_input_range mit Name, Layout, Anzahl und konkreten Formen. C-Beispiel:
// Query the input shapes supported by the model
rknn_input_range dyn_range[io_num.n_input];
memset(dyn_range, 0, io_num.n_input * sizeof(rknn_input_range));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
    dyn_range[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_DYNAMIC_RANGE, &dyn_range[i], sizeof(rknn_input_range));
    if (ret != RKNN_SUCC)
    {
        fprintf(stderr, "rknn_query error! ret=%d\n", ret);
        return -1;
    }
    dump_input_dynamic_range(&dyn_range[i]);
}
Hinweis: Formen mehrerer Eingänge entsprechen einander nach Reihenfolge, ohne Kreuzkombinationen. Die erste Form des ersten Eingangs passt etwa nur zur ersten Form des zweiten. Für A=[1,224]/[1,112] und B=[1,40]/[1,80] werden nur folgende zwei Gruppen unterstützt:
Form A = [1,224], Form B=[1,40]
Form A = [1,112], Form B=[1,80]
3 Eingabeform setzen
Beim ersten Setzen oder Ändern der Eingabeform rknn_set_input_shapes() aufrufen. Nach Laden eines dynamischen Modells kann die Form zur Laufzeit geändert werden. Im übergebenen rknn_tensor_attr-Array aller Eingänge beschreiben dims, n_dims und fmt jedes Elements die aktuelle Form. C-Beispiel:
/**
 dynamic inputs shape range:
 index=0, name=data, shape_number=2, range=[[1, 224, 224, 3],[1, 112, 224, 3]], fmt = NHWC
**/
input_attrs[0].dims[0] = 1;
input_attrs[0].dims[1] = 224;
input_attrs[0].dims[2] = 224;
input_attrs[0].dims[3] = 3;
input_attrs[0].fmt=RKNN_TENSOR_NHWC;
ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
if (ret < 0) {
  fprintf(stderr, "rknn_set_input_shapes error! ret=%d\n", ret);
  return -1;
}
io_num.n_input ist die Eingabeanzahl, input_attrs das rknn_tensor_attr-Array der Modelleingaben.
Hinweis: Die gesetzte Form muss in der in Schritt 2 abgefragten Liste enthalten sein.
Nach erfolgreichem Setzen die Ein-/Ausgabeformen erneut mit rknn_query abfragen. C-Beispiel:
// Get the input and output shapes of the current inference
rknn_tensor_attr cur_input_attrs[io_num.n_input];
memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
    cur_input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));
    if (ret < 0)
    {
        printf("rknn_init error! ret=%d\n", ret);
        return -1;
    }
    dump_tensor_attr(&cur_input_attrs[i]);
}
rknn_tensor_attr cur_output_attrs[io_num.n_output];
memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_output; i++)
{
    cur_output_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &(cur_output_attrs[i]), sizeof(rknn_tensor_attr));
    if (ret != RKNN_SUCC)
    {
        printf("rknn_query fail! ret=%d\n", ret);
        return -1;
    }
    dump_tensor_attr(&cur_output_attrs[i]);
}
Hinweise:
rknn_set_input_shape verlangt fmt=NHWC bei vierdimensionaler Eingabe, andernfalls UNDEFINED.
Vor rknn_set_input_shapes sind Formabfragen mit Präfix RKNN_QUERY_CURRENT ungültig.
4 Inferenz
Nach dem Setzen der aktuellen Form seien die Eingabetensorinformationen in cur_input_attrs gespeichert. C-Beispiel für die allgemeine API:
// Set input information
rknn_input inputs[io_num.n_input];
memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
for (int i = 0; i < io_num.n_input; i++)
{
    int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] : cur_input_attrs[i].dims[2];
    int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] : cur_input_attrs[i].dims[3];
    cv::resize(imgs[i], imgs[i], cv::Size(width, height));
    inputs[i].index = i;
    inputs[i].pass_through = 0;
    inputs[i].type = RKNN_TENSOR_UINT8;
    inputs[i].fmt = RKNN_TENSOR_NHWC;
    inputs[i].buf = imgs[i].data;
    inputs[i].size = imgs[i].total() * imgs[i].channels();
}

// Convert the input data into the correct format and put it into the input buffer
ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
if (ret < 0)
{
    printf("rknn_input_set fail! ret=%d\n", ret);
    return -1;
}

// Run inference
printf("Begin perf ...\n");
double total_time = 0;
for (int i = 0; i < loop_count; ++i)
{
    int64_t start_us = getCurrentTimeUs();
    ret = rknn_run(ctx, NULL);
    int64_t elapse_us = getCurrentTimeUs() - start_us;
    if (ret < 0)
    {
        printf("rknn run error %d\n", ret);
        return -1;
    }
    total_time += elapse_us / 1000.f;
    printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f
* 1000.f / elapse_us);
}
printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);

// Get output results
rknn_output outputs[io_num.n_output];
memset(outputs, 0, io_num.n_output * sizeof(rknn_output));
for (uint32_t i = 0; i < io_num.n_output; ++i)
{
    outputs[i].want_float = 1;
    outputs[i].index = i;
    outputs[i].is_prealloc = 0;
}

ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0)
{
    printf("rknn_outputs_get fail! ret=%d\n", ret);
    return ret;
}

// Release the output buffer
ret = rknn_outputs_release(ctx, io_num.n_output, outputs);
4.1.3.4.2 Zero-Copy-API
Bei Zero-Copy nach der Initialisierung Formen mit rknn_query() abfragen und Speicher mit rknn_create_mem() zuweisen. Ein rknn_tensor_attr-Array aller Eingabeformen an rknn_set_input_shapes() übergeben, anschließend die gesetzten Formen erneut mit rknn_query() abfragen. Schließlich den Speicher mit rknn_set_io_mem() setzen. Bei jedem Formwechsel Form erneut setzen, Daten passender Größe vorbereiten und rknn_set_io_mem() wieder aufrufen. Ohne Formwechsel ist kein erneutes rknn_set_input_shapes() erforderlich. Typischer Ablauf:
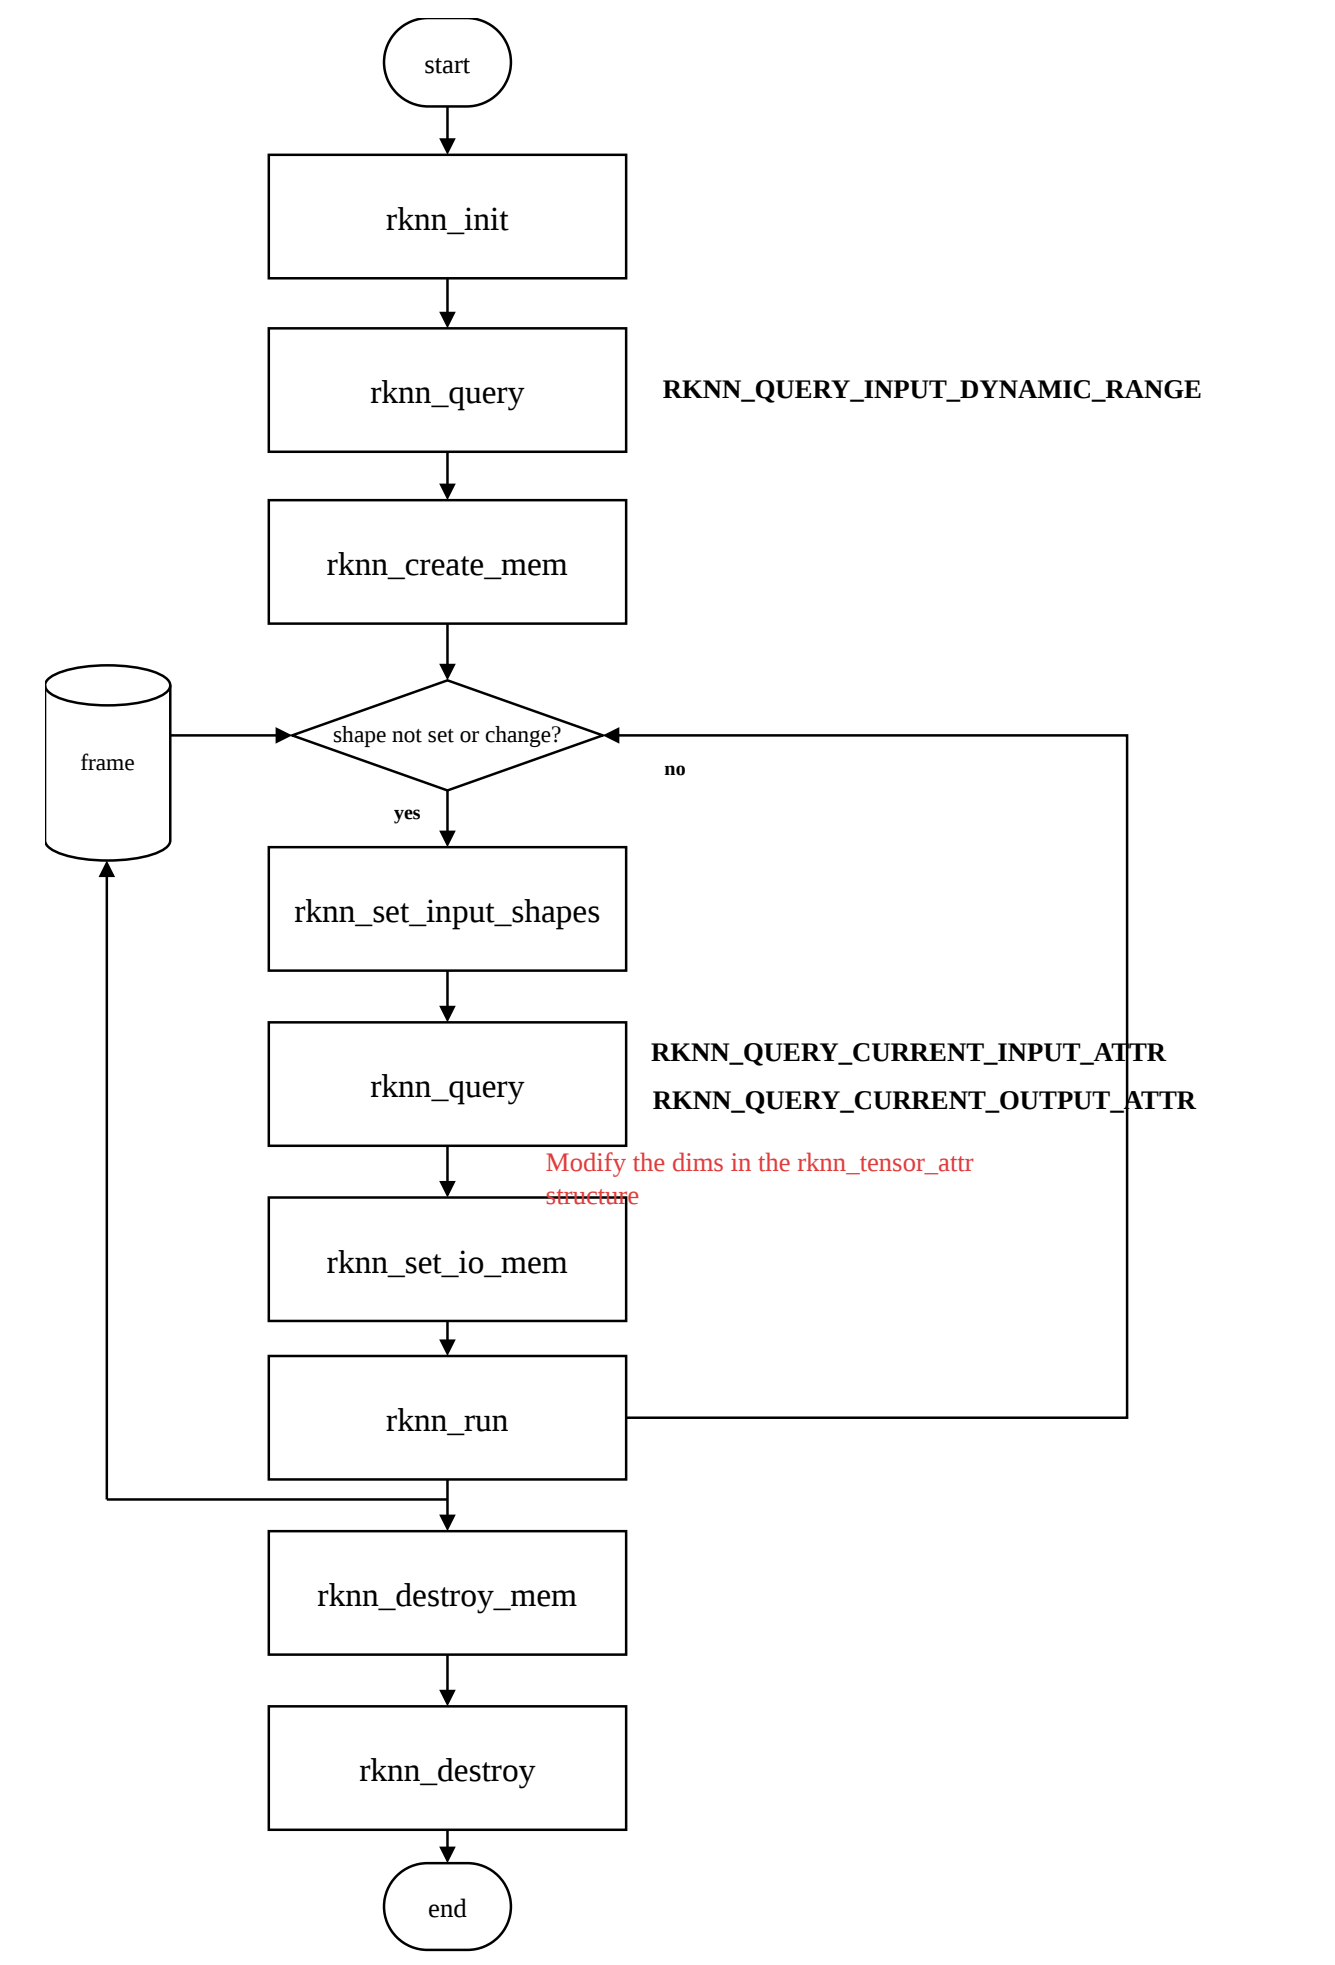
Abbildung 4-6. Zero-Copy-API-Ablauf bei dynamischer Eingabeform
Initialisierung, Abfrage der Formkombinationen und Setzen der Form entsprechen der allgemeinen API oben und werden nicht wiederholt.
Nach dem Setzen der Form werden andere Schnittstellen verwendet. Zero-Copy-C-Beispiel:
// Create the largest input tensor memory
rknn_tensor_mem *input_mems[io_num.n_input];
for (int i = 0; i < io_num.n_input; i++) {
    // default input type is int8 (normalize and quantize need compute in outside)
    // if set uint8, will fuse normalize and quantize to npu
    input_attrs[i].type = RKNN_TENSOR_UINT8;
    // default fmt is NHWC, npu only support NHWC in zero copy mode
    input_attrs[i].fmt = RKNN_TENSOR_NHWC;
    input_mems[i] = rknn_create_mem(ctx, input_attrs[i].size_with_stride);
...
// Create the largest output tensor memory
rknn_tensor_mem *output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
    // default output type is depend on model, this require float32 to compute top5
    // allocate float32 output tensor
    int output_size = output_attrs[i].size * sizeof(float);
    output_mems[i] = rknn_create_mem(ctx, output_size);
...
// Load the input and set the model input shape, which is called once each time the input shape is switched
for (int s = 0; s < shape_num; ++s) {
    for (int i = 0; i < io_num.n_input; i++) {
        for (int j = 0; j < input_attrs[i].n_dims; ++j) {
           input_attrs[i].dims[j] = shape_range[i].dyn_range[s][j];
    .....
    ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
    if (ret < 0) {
        fprintf(stderr, "rknn_set_input_shape error! ret=%d\n", ret);
        return -1;
    ....
    // Get the input and output shapes of the current inference
    printf("current input tensors:\n");
    rknn_tensor_attr cur_input_attrs[io_num.n_input];
    memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
    for (uint32_t i = 0; i < io_num.n_input; i++) {
        cur_input_attrs[i].index = i;
        // query info
        ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));
        if (ret < 0) {
           printf("rknn_init error! ret=%d\n", ret);
           return -1;
        dump_tensor_attr(&cur_input_attrs[i]);
        ...
        printf("current output tensors:\n");
    rknn_tensor_attr cur_output_attrs[io_num.n_output];
    memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
    for (uint32_t i = 0; i < io_num.n_output; i++) {
        cur_output_attrs[i].index = i;
        // query info
        ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &
(cur_output_attrs[i]), sizeof(rknn_tensor_attr));
        if (ret != RKNN_SUCC) {
           printf("rknn_query fail! ret=%d\n", ret);
           return -1;
        ...
        dump_tensor_attr(&cur_output_attrs[i]);
    // Specify the number of NPU cores, only 3588/3576 is supported
    rknn_set_core_mask(ctx, (rknn_core_mask)core_mask);
    // Set input information
    rknn_input inputs[io_num.n_input];
    memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
    std::vector<cv::Mat> resize_imgs;
    resize_imgs.resize(io_num.n_input);
    for (int i = 0; i < io_num.n_input; i++) {
        int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] : cur_input_attrs[i].dims[2];
        int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] : cur_input_attrs[i].dims[3];
        int stride = cur_input_attrs[i].w_stride;
        cv::resize(imgs[i], resize_imgs[i], cv::Size(width, height));
        int input_size = resize_imgs[i].total() * resize_imgs[i].channels();
        // Copy external data to the zero-copy input buffer
        if (width == stride)
           memcpy(input_mems[i]->virt_addr, resize_imgs[i].data, input_size);
        else {
           int height = cur_input_attrs[i].dims[1];
           int channel = cur_input_attrs[i].dims[3];
           // copy from src to dst with stride
           uint8_t *src_ptr = resize_imgs[i].data;
           uint8_t *dst_ptr = (uint8_t *)input_mems[i]->virt_addr;
           // width-channel elements
           int src_wc_elems = width * channel;
           int dst_wc_elems = stride * channel;
           for (int b = 0; b < cur_input_attrs[i].dims[0]; b++) {
               for (int h = 0; h < height; ++h) {
                   memcpy(dst_ptr, src_ptr, src_wc_elems);
                   src_ptr += src_wc_elems;
                   dst_ptr += dst_wc_elems;
           ....
    // Update the input zero-copy buffer memory
    for (int i = 0; i < io_num.n_input; i++) {
        cur_input_attrs[i].type = RKNN_TENSOR_UINT8;
        ret = rknn_set_io_mem(ctx, input_mems[i], &cur_input_attrs[i]);
        if (ret < 0) {
           printf("rknn_set_io_mem fail! ret=%d\n", ret);
           return -1;
     ....
    // Update the output zero-copy buffer memory
    for (uint32_t i = 0; i < io_num.n_output; ++i) {
        // default output type is depend on model, this require float32 to compute top5
        cur_output_attrs[i].type = RKNN_TENSOR_FLOAT32;
        cur_output_attrs[i].fmt = RKNN_TENSOR_NCHW;
        // set output memory and attribute
        ret = rknn_set_io_mem(ctx, output_mems[i], &cur_output_attrs[i]);
        if (ret < 0) {
           printf("rknn_set_io_mem fail! ret=%d\n", ret);
           return -1;
      ....
    // Inference
    printf("Begin perf ...\n");
    double total_time = 0;
    for (int i = 0; i < loop_count; ++i) {
        int64_t start_us = getCurrentTimeUs();
        ret = rknn_run(ctx, NULL);
        int64_t elapse_us = getCurrentTimeUs() - start_us;
        if (ret < 0) {
           printf("rknn run error %d\n", ret);
           return -1;
        ...
        total_time += elapse_us / 1000.f;
        printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f * 1000.f / elapse_us);
    printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);
Hinweise:
-
Form und Größe des Eingabepuffers von rknn_set_io_mem() bei dynamischen Formen:
-
Nach Initialisierung, aber vor rknn_set_input_shapes(), liefern RKNN_QUERY_INPUT_ATTR/RKNN_QUERY_OUTPUT_ATTR über rknn_query() gewöhnlich die größten Formen. Diese Größen können zur Speicherzuweisung dienen. Bei mehreren Eingängen sind einzelne Formen möglicherweise nicht maximal: Den größten unterstützten Bedarf suchen und entsprechend maximalen Ein-/Ausgabespeicher zuweisen.
-
Für nicht vierdimensionale Eingaben fmt=UNDEFINED und einen Puffer der ursprünglichen Modelleingabeform verwenden; die Größe ergibt sich aus Form und Typ.
-
Vierdimensionale Eingaben unterstützen fmt=NHWC oder NC1HWC2 mit entsprechendem Puffer und Größe. Form und Größe über die passenden rknn_query-Felder ermitteln.
-
RKNN_QUERY_CURRENT_INPUT_ATTR/RKNN_QUERY_CURRENT_OUTPUT_ATTR liefern ursprüngliche Modellformen in NHWC oder UNDEFINED. RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR/RKNN_QUERY_CURRENT_NATIVE_OUTPUT_ATTR liefern für effizientes NPU-Lesen optimierte Formen in NHWC oder NC1HWC2.
-
Bei NHWC-Puffern in rknn_set_io_mem() shape und fmt von rknn_tensor_attr anhand RKNN_QUERY_CURRENT_INPUT_ATTR setzen; bei NC1HWC2 anhand RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR.
Vollständiges C-API-Demo für dynamische Formen: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_dynamic_shape_input_demo