
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 17/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
4.2 Erweiterungen und Sicherheit
4.2.1 Benutzerdefinierte Operatoren
4.2.1.1 Einführung
Das RKNN-SDK ermöglicht benutzerdefinierte Operatoren während der RKNN-Inferenz. Sie erweitern Modelle und erlauben CPU-/GPU-spezifische Optimierungen, um Ressourcen besser zu nutzen und Inferenz zu beschleunigen. Ihre Entwicklung erfordert fundierte Kenntnisse der Deep-Learning-Berechnungen und Zielhardware, damit Korrektheit und Leistung gewährleistet sind. Derzeit werden nur benutzerdefinierte Operatoren für ONNX-Modelle unterstützt.
Benutzerdefinierte Operatoren erfordern zwei Hauptschritte:
Benutzerdefinierte Operatoren mit RKNN-Toolkit2 registrieren und das RKNN-Modell exportieren.
Den Operator in C implementieren und über die RKNN-API laden, registrieren und ausführen.
Gesamtablauf:
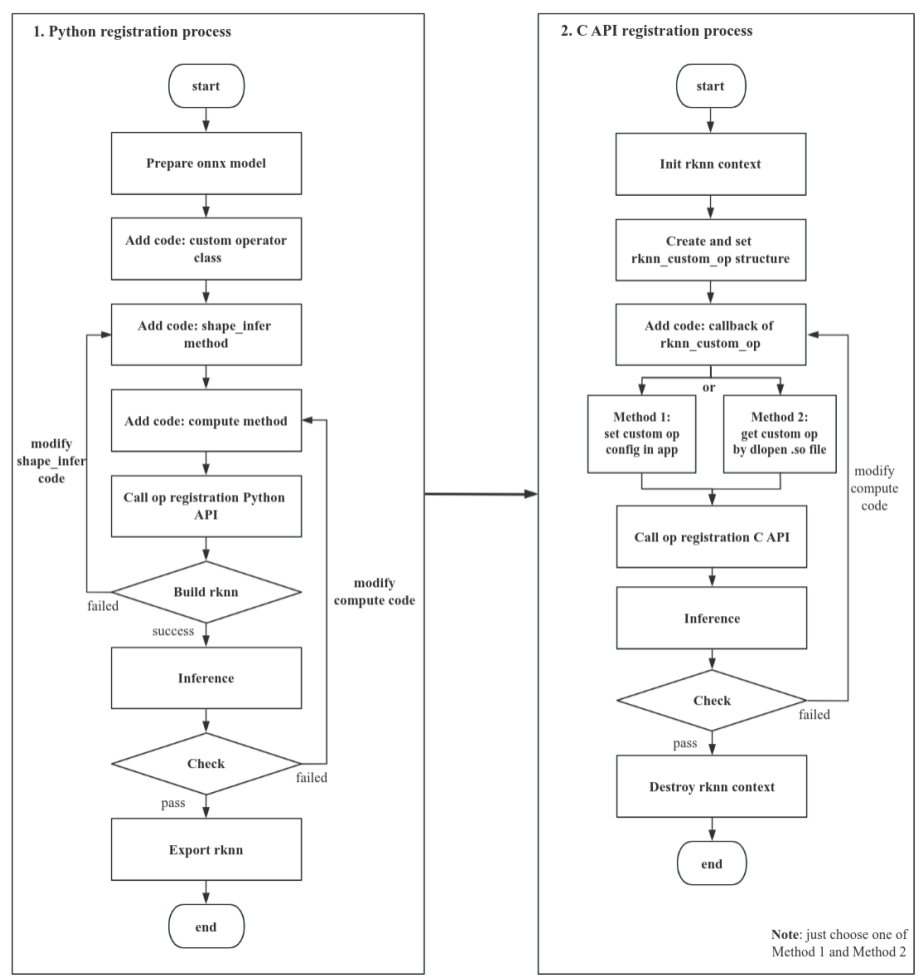
Abbildung 4-12. Vollständiger Registrierungsablauf benutzerdefinierter Operatoren
4.2.1.2 Gesamtablauf
4.2.1.2.1 Operatoren in RKNN-Toolkit2 registrieren und RKNN-Modell exportieren
1 onnx-Modell vorbereiten: Gemäß ONNX-Spezifikation Typ, Name, Attribute und Ein-/Ausgabeanzahl des benutzerdefinierten Operators festlegen und ihn an der gewünschten Position im Graphen einfügen. Das Modell über die API des onnx-Pakets erstellen und exportieren.
2 Die Python-Klasse des Operators, insbesondere shape_infer() und compute(), implementieren und mit rknn.reg_custom_op() registrieren.
3 Nach erfolgreichem rknn.build() kann die Inferenz erfolgen; andernfalls shape_infer() aus Schritt 2 prüfen. Die Simulation ausführen. Bei korrekten Ergebnissen mit rknn.export_rknn() exportieren, andernfalls compute() aus Schritt 2 prüfen.
4.2.1.2.2 C-Implementierung, Laden, Registrieren und Ausführen des Operators über die RKNN-API.
1 Den Operator in C auf Basis von rknn_custom_op aus rknn_custom_op.h implementieren und anschließend die rknn_custom_op-Informationen ausfüllen.
2 Die rknn_custom_op-Informationen mit rknn_register_custom_ops() registrieren.
3 Das Modell gemäß dem allgemeinen API- oder Zero-Copy-Ablauf erstellen und ausführen. Zur Prüfung des Operators können ausführliche Protokollierung und Modelldumps aktiviert werden.
4.2.1.2.3 Inferenz oder Genauigkeitsanalyse mit angeschlossenem Gerät über RKNN-Toolkit2
Für eine Genauigkeitsanalyse mit angeschlossenem Gerät die Callback-Implementierung des benutzerdefinierten Operators in eine .so kompilieren, im vorgesehenen Pfad ablegen und rknn_server neu starten. Details siehe 4.2.1.4.4.
4.2.1.3 Python-Ablauf
Benutzerdefinierte Operatoren werden nur für onnx-Modelle unterstützt. Damit können von RKNN unterstützte Operatoren außerhalb des ONNX-Standards ergänzt werden.
Ein solcher Operator ist nicht in der ONNX-Operatorliste enthalten. Zusätzlich zur ONNX-Spezifikation gelten folgende Regeln:
op_type darf keinem ONNX-Standardoperator entsprechen. Empfohlen wird das Präfix cst.
Der Operator muss mit anderen Operatoren verbunden sein, einschließlich definierter Formen, Datentypen und weiterer Eigenschaften der Ein-/Ausgaben.
Eingabeattribute unterstützen Einzelwerte oder Arrays der Typen bool, int32, float32 und int64.
Konstante Eingaben unterstützen bool, int32, float32 und int64. Gemeint sind die Datentypen des nicht quantisierten ONNX-Modells.
Da der Operator nicht zum ONNX-Standard gehört, muss das Modell mit ihm über die ONNX-API oder die API eines anderen Frameworks erstellt und exportiert werden.
Zur Veranschaulichung wird Softmax leicht verändert und ein ONNX-Modell mit dem nicht standardmäßigen Operator cstSoftmax aufgebaut. Die Änderung erfolgt wie folgt:
import onnx

path="test_softmax.onnx"
model=onnx.load(path)

for node in model.graph.node:
  if node.op_type =="Softmax":
    node.op_type = "cstSoftmax"
    ... # Modify the attribute definition of cstSoftmax, etc
onnx.save(model, "./test_softmax_custom.onnx")
Öffnen Sie das erstellte Modell in Netron und prüfen Sie, ob der Operator die Anforderungen erfüllt. Implementieren Sie anschließend die Klasse, beispielsweise für ein benutzerdefiniertes Softmax:
import numpy as np
from rknn.api.custom_op import get_node_attr
class cstSoftmax:
  op_type = 'cstSoftmax'
  def shape_infer(self, node, in_shapes, in_dtypes):
    out_shapes = in_shapes.copy()
    out_dtypes = in_dtypes.copy()
    return out_shapes, out_dtypes
  def compute(self, node, inputs):
    x = inputs[0]
    axis = get_node_attr(node, 'axis')
    x_max = np.max(x, axis=axis, keepdims=True)
    tmp = np.exp(x - x_max)
    s = np.sum(tmp, axis=axis, keepdims=True)
    outputs = [tmp / s]
    return outputs
Der benutzerdefinierte Operator muss eine Python-Klasse sein.
Die Klasse muss eine Zeichenfolgenvariable op_type enthalten, die dem Operatortypnamen in ONNX entspricht.
Die Klasse muss shape_infer(self, node, in_shapes, in_dtypes) enthalten; Funktions- und Parameternamen müssen exakt übereinstimmen, sonst entsteht ein Fehler. Die Funktion leitet die Operatorformen ab. node ist das ONNX-Knotenobjekt mit Attributen und Ein-/Ausgabeinformationen. in_shapes enthält alle Eingabeformen als [shape_0, shape_1, …], wobei jede shape ebenfalls eine Liste ist. in_dtypes enthält alle Eingabetypen als [dtype_0, dtype_1, …], jeweils als numpy dtype. Die Funktion muss sämtliche Ausgabeformen und dtype-Informationen in denselben Formaten wie in_shapes und in_dtypes zurückgeben.
Die Operatorklasse muss compute(self, node, inputs) enthalten; Funktions- und Parameternamen müssen übereinstimmen, sonst entsteht ein Fehler. Die Funktion führt die Operatorinferenz aus. node ist das ONNX-Knotenobjekt mit Attributen sowie Ein-/Ausgabeinformationen des Operators. inputs enthält die Eingabedaten als [array_0, array_1, …] mit numpy.ndarray-Elementen. Die Funktion muss sämtliche Ausgaben im selben Format zurückgeben.
Benutzerdefinierte Attribute lassen sich mit from rknn.api.custom_op import get_node_attr abrufen.
Registrieren Sie die fertige Klasse mit rknn.reg_custom_op() und rufen Sie anschließend rknn.build() zur Konvertierung und RKNN-Erzeugung auf. Die Klasse ermöglicht die üblichen Modellkonvertierungs- und Inferenzfunktionen. Beispiel mit benutzerdefiniertem Softmax:
from rknn.api import RKNN
# Create RKNN object
rknn = RKNN(verbose=True)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82], quant_img_RGB2BGR=True,
target_platform='rk3566')
print('done')

print('--> Register cstSoftmax op')
ret = rknn.reg_custom_op(cstSoftmax())
if ret != 0:
  print('Register cstSoftmax op failed!')
  exit(ret)
print('done')

print('--> Loading model')
ret = rknn.load_onnx(model='mobilenet_v2.onnx')
if ret != 0:
  print('Load model failed!')
  exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
if ret != 0:
  print('Build model failed!')
  exit(ret)
print('done')
rknn.reg_custom_op() muss zwischen rknn.config() und rknn.load_xxx() aufgerufen werden.
4.2.1.4 Bereitstellung über die C-API
Nach Erzeugen des RKNN-Modells mit benutzerdefinierten Operatoren folgt die C-API-Bereitstellung. Strukturen und Schnittstellen liegen in rknn_custom_op.h, das die Anwendung einbinden muss. Registrierungs- und Nutzungsablauf:
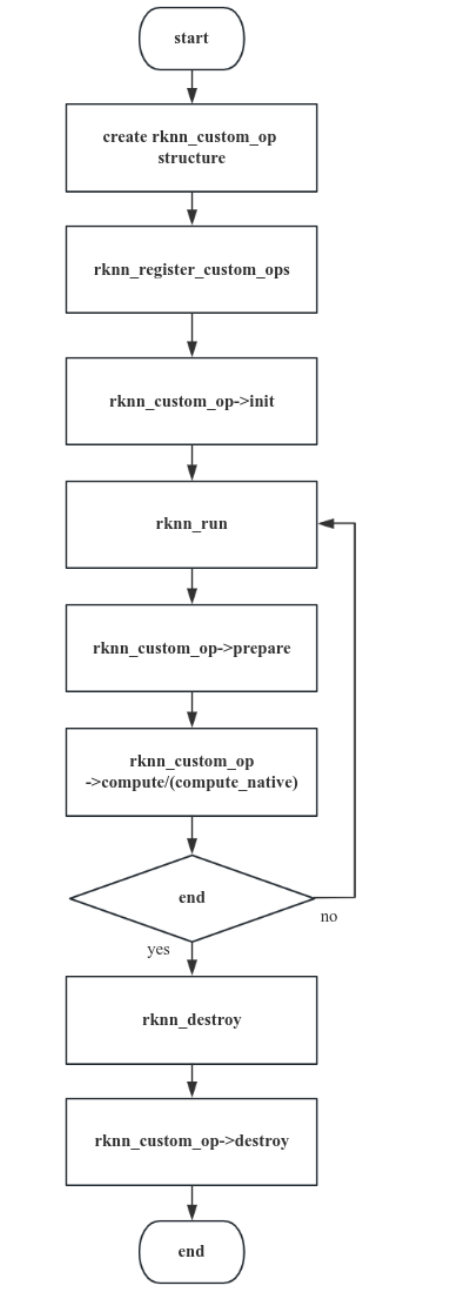
Abbildung 4-13. C-API-Ablauf zur Operatorregistrierung
4.2.1.4.1 Struktur des benutzerdefinierten Operators initialisieren
Erstellen Sie nach dem rknn-Kontext die Struktur rknn_custom_op und setzen Sie folgende Informationen:
version: Version des Operators.
target: Ausführungsbackend des Operators; unterstützt werden CPU und GPU.
op_type: Operatortyp, identisch mit dem Typ im ONNX-Modell.
cl_kernel_name: Name der cl_kernel-Funktion des OpenCL-Codes; bei GPU-Operatorregistrierung erforderlich.
cl_kernel_source: Vollständiger Pfad zur .cl-Datei oder OpenCL-Kernelzeichenfolge. Bei cl_source_size=0 handelt es sich um den .cl-Pfad, bei cl_source_size>0 um den OpenCL-Code als Zeichenfolge. Für GPU-Operatoren erforderlich.
cl_source_size: Größe von cl_kernel_source. Der Sonderwert 0 bedeutet, dass cl_kernel_source ein Pfad ist.
cl_build_options: OpenCL-Kernel-Kompilierungsoptionen als Zeichenfolge; für GPU-Operatoren erforderlich.
init: Optionaler Callback, einmalig in rknn_register_custom_ops aufgerufen.
prepare: Optionaler Vorverarbeitungs-Callback. Jeder rknn_run führt zuerst prepare und anschließend compute/compute_native aus.
compute: Verpflichtender Berechnungs-Callback. Ein- und Ausgaben sind NCHW-float32-Daten; bei int64-Ein-/Ausgaben im ONNX-Modell werden int64-Daten verwendet.
compute_native: Reserviert; auf NULL setzen.
destroy: Optionaler Callback, einmal in rknn_destory ausgeführt; die Schreibweise wurde aus dem Original übernommen.
Parameterdefinitionen der Callbacks init/prepare/compute:
rknn_custom_op_context* op_ctx: Kontextinformationen des Operator-Callbacks.
rknn_custom_op_tensor* inputs: Daten und Informationen der Eingabetensoren.
uint32_t n_inputs: Anzahl der Operatoreingaben.
rknn_custom_op_tensor* outputs: Daten und Informationen der Ausgabetensoren.
uint32_t n_outputs: Anzahl der Operatorausgaben.
destroy besitzt nur einen Parameter: rknn_custom_op_context* op_ctx.
rknn_custom_op_context
Enthält target (Ausführungsgerät), GPU-Kontext, privaten Operatorkontext und priv_data. Zuweisung, Lesen, Schreiben und Freigabe von priv_data verwaltet der Entwickler. Der GPU-Kontext enthält Zeiger auf cl_context, cl_command_queue und cl_kernel; die entsprechenden OpenCL-Objekte werden durch Typumwandlung gewonnen.
priv_data ist ein optionaler Zeiger. Üblicherweise wird die Ressource in init() angelegt, ihre Adresse in priv_data gespeichert, in prepare()/compute() verwendet und in destroy() freigegeben.
rknn_custom_op_tensor
Beschreibt Ein-/Ausgabetensoren mit Name, Form, Größe, Quantisierungsparametern, virtueller Basisadresse, fd, Datenoffset und weiteren Informationen.
In compute() muss kein Speicher für Ein- und Ausgabetensoren erstellt werden; die Daten an der virtuellen Adresse sind bereits vorbereitet. Effektive Tensoradresse = virtuelle Basisadresse + Datenoffset. virt_addr im Mitglied mem bezeichnet die Basisadresse, offset den Datenoffset in Byte. Im Callback zeigt die Eingabeadresse auf die Ausgabe des vorherigen Operators, die Ausgabeadresse auf die Daten für den nächsten Operator.
rknn_custom_op_attr
Zum Abrufen von Attributinformationen rufen Sie rknn_custom_op_get_op_attr() mit dem Attributfeld auf. Das Ergebnis wird durch rknn_custom_op_attr dargestellt. Dessen void-Puffer, dtype und Elementanzahl beschreiben einen Speicherbereich. Durch C/C++-Typumwandlung des Pufferzeigers gemäß dtype erhalten Sie ein Array des entsprechenden Zahlentyps.
4.2.1.4.1.1 Init-Callback
Dient zum Auswerten von Operatorinformationen oder Initialisieren temporärer und Ein-/Ausgabepuffer, etwa zur Allokation eines temporären Puffers. Beispiel für init:
CPU-Operator
/**
* cpu kernel init callback for custom op
*/
int custom_op_init_callback(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
              rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("custom_op_init_callback\n");
  // create tmp buffer
  float* tmp_buffer = (float*)malloc(inputs[0].attr.n_elems * sizeof(float));
  op_ctx->priv_data = tmp_buffer;
  return 0;
}
GPU-Operator
/**
* opencl kernel init callback for custom op
* */
int relu_init_callback_gpu(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
             rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("relu_init_callback_gpu\n");
  // 获取opencl context
  cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

  // create tmp cl buffer
  cl_mem* memObject = (cl_mem*)malloc(sizeof(cl_mem) * 2);
  memObject[0] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, inputs[0].attr.size, NULL, NULL);
  memObject[1] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, outputs[0].attr.size, NULL, NULL);
  op_ctx->priv_data = memObject;
  return 0;
}
4.2.1.4.1.2 Prepare-Callback
Dieser Callback wird für jede Frame-Inferenz aufgerufen; das Original bezeichnet ihn zugleich als derzeit für die Zukunft reserviert.
4.2.1.4.1.3 Compute-Callback
Dies ist die Berechnungsfunktion des Operators. Der Entwickler muss einen Kernel mit float32-Ein-/Ausgaben im Format NCHW oder UNDEFINED implementieren.
- compute-Callback (CPU). Beispiel einer CPU-compute-Funktion für einen benutzerdefinierten Softmax-Layer:
/**
 * float32 kernel implemetation sample for custom op
 * */
int compute_custom_softmax_float32(rknn_custom_op_context* op_ctx,
rknn_custom_op_tensor* inputs, uint32_t n_inputs,
                                 rknn_custom_op_tensor* outputs, uint32_t
n_outputs)
{
  unsigned char* in_ptr = (unsigned char*)inputs[0].mem.virt_addr +
inputs[0].mem.offset;
  unsigned char* out_ptr = (unsigned char*)outputs[0].mem.virt_addr +
outputs[0].mem.offset;
  int axis = 0;
  const float* in_data = (const float*)in_ptr;
  float* out_data = (float*)out_ptr;
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  rknn_custom_op_attr op_attr;
  rknn_custom_op_get_op_attr(op_ctx, "axis", &op_attr);
  if (op_attr.n_elems == 1 && op_attr.dtype == RKNN_TENSOR_INT64) {
    axis = ((int64_t*)op_attr.data)[0];
  }

  printf("op name = %s, axis = %d\n", name.c_str(), axis);
  float* tmp_buffer = (float*)op_ctx->priv_data;
  // kernel implemetation for custom op
  {
    int inside = 1;
    int outside = 1;
    int channel = 1;

    while (axis < 0) {
      axis += inputs[0].attr.n_dims;
    }

    for (int i = 0; i < axis; i++) {
      outside *= inputs[0].attr.dims[i];
    }
    channel = inputs[0].attr.dims[axis];
    for (int i = axis; i < inputs[0].attr.n_dims; i++) {
      inside *= inputs[0].attr.dims[i];
    }

    for (int y = 0; y < outside; y++) {
      const float* src_y = in_data + y * inside;
      float* dst_y = out_data + y * inside;
      float max_data = -FLT_MAX;
      float sum_data = 0.0f;

      for (int i = 0; i < inside; ++i) {
        max_data = fmaxf(max_data, src_y[i]);
      }
      for (int i = 0; i < inside; ++i) {
        tmp_buffer[i] = expf(src_y[i] - max_data);
        sum_data += tmp_buffer[i];
      }
      for (int i = 0; i < inside; ++i) {
        dst_y[i] = tmp_buffer[i] / sum_data;
      }
    }
  }
  return 0;
}
- compute-Callback (GPU)
Für GPU-Operatoren können im Callback folgende Schritte durchgeführt werden:
OpenCL-Objekte cl_context, cl_command_queue und cl_kernel aus gpu_ctx in rknn_custom_op_context abrufen. Dabei sind Datentypumwandlungen erforderlich.
Bei Bedarf cl_mem-Puffer für Operatoreingaben oder -ausgaben erstellen.
Funktionsargumente von cl_kernel setzen.
Eingabepuffer der OpenCL-Kernelargumente unterstützen derzeit nur float, keine anderen Typen.
Bei Zero-Copy bildet clImportMemoryARM den Eingabetensorspeicher auf cl_mem ab. Der Tensor enthält bereits Daten; erneutes Kopieren ist unnötig. Dies kann im init-Callback geschehen: cl_mem in priv_data speichern und priv_data später in compute lesen und verwenden.
cl_kernel blockierend ausführen.
Eingabedaten im CL-Kernel haben das Layout NCHW.
Soll die CPU nach der GPU-Berechnung auf die Daten zugreifen, vor dem Lesen den Cache des Ausgabetensors mit rknn_mem_sync synchronisieren.
Beispiel einer GPU-compute-Funktion für einen benutzerdefinierten ReLU-Layer:
/**
 * opencl kernel init callback for custom op
 * */
int compute_custom_relu_float32(rknn_custom_op_context* op_ctx,
rknn_custom_op_tensor* inputs, uint32_t num_inputs,
                              rknn_custom_op_tensor* outputs, uint32_t
num_outputs)
{
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  // get context
  cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

  // get command queue
  cl_command_queue queue = (cl_command_queue)op_ctx->gpu_ctx.cl_command_queue;

  // get kernel
  cl_kernel kernel = (cl_kernel)op_ctx->gpu_ctx.cl_kernel;

  // import input/output buffer
  const cl_import_properties_arm props[3] = {
    CL_IMPORT_TYPE_ARM,
    CL_IMPORT_TYPE_DMA_BUF_ARM,
    0,
  };

  cl_int status;
  cl_mem inObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props,
&inputs[0].mem.fd,
                                    inputs[0].mem.offset + inputs[0].mem.size,
&status);
  if (status != CL_SUCCESS) {
    printf("Tensor: %s clImportMemoryARM failed\n", inputs[0].attr.name);
  }
  cl_mem outObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props,
&outputs[0].mem.fd,
                                     outputs[0].mem.offset + outputs[0].mem.size,
&status);
  if (status != CL_SUCCESS) {
    printf("Tensor: %s clImportMemoryARM failed\n", outputs[0].attr.name);
  }

  int in_type_bytes = get_type_bytes(inputs[0].attr.type);
  int out_type_bytes = get_type_bytes(outputs[0].attr.type);
  int in_offset = inputs[0].mem.offset / in_type_bytes;
  int out_offset = outputs[0].mem.offset / out_type_bytes;
  unsigned int elems = inputs[0].attr.n_elems;

  // set kernel args
  int argIndex = 0;
  clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &inObject);
  clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &outObject);
  clSetKernelArg(kernel, argIndex++, sizeof(int), &in_offset);
  clSetKernelArg(kernel, argIndex++, sizeof(int), &out_offset);
  clSetKernelArg(kernel, argIndex++, sizeof(unsigned int), &elems);
  // set global worksize
  const size_t global_work_size[3] = {elems, 1, 1};

  // enqueueNDRangeKernel
  clEnqueueNDRangeKernel(queue, kernel, 1, NULL, global_work_size, NULL, 0, NULL,
NULL);

  // finish command queue
  clFinish(queue);

  // //cpu access data after sync to device
  // rknn_mem_sync(&outputs[0].mem, RKNN_MEMORY_SYNC_FROM_DEVICE);
  // // save output npy
  // char output_path[PATH_MAX];
  // sprintf(output_path, "%s/cpu_output%d.npy", ".", 0);
  // unsigned char* out_data = (unsigned char*)outputs[0].mem.virt_addr+outputs[0].mem.offset;
  // save_npy(output_path, (float*)out_data, &inputs[0].attr);
  return 0;
}
4.2.1.4.1.4 Destroy-Callback
Gibt temporäre oder Ein-/Ausgabepuffer des benutzerdefinierten Operators frei. Beispiel zum Freigeben eines temporären Puffers:
CPU-Operator
/**
* cpu kernel destroy callback for custom op
*/
int custom_op_destroy_callback(rknn_custom_op_context* op_ctx)
{
  printf("custom_op_destroy_callback\n");
  // clear tmp buffer
  free(op_ctx->priv_data);
  return 0;
}
GPU-Operator
/**
* opencl kernel destroy callback for custom op
*/
int relu_destroy_callback_gpu(rknn_custom_op_context* op_ctx)
{
  // clear tmp buffer
  printf("relu_destroy_callback_gpu\n");
  cl_mem* memObject = (cl_mem*)op_ctx->priv_data;
  clReleaseMemObject(memObject[0]);
  clReleaseMemObject(memObject[1]);
  free(memObject);
  return 0;
}
4.2.1.4.2 Benutzerdefinierten Operator registrieren
Registrieren Sie die konfigurierte rknn_custom_op-Struktur mit rknn_register_custom_ops() im rknn_context. Mehrere benutzerdefinierte Operatoren können gleichzeitig registriert werden.
Registrieren Sie nach Implementierung des CPU-compute-Callbacks cstSoftmax und ArgMax, beispielsweise:
CPU-Operator
// CPU operators
rknn_custom_op user_op[2];
memset(user_op, 0, 2 * sizeof(rknn_custom_op));
strncpy(user_op[0].op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op[0].version = 1;
user_op[0].target = RKNN_TARGET_TYPE_CPU;
user_op[0].init = custom_op_init_callback;
user_op[0].compute = compute_custom_softmax_float32;
user_op[0].destroy = custom_op_destroy_callback;

strncpy(user_op[1].op_type, "ArgMax", RKNN_MAX_NAME_LEN - 1);
user_op[1].version = 1;
user_op[1].target = RKNN_TARGET_TYPE_CPU;
user_op[1].init = custom_op_init_callback;
user_op[1].compute = compute_custom_argmax_float32;
user_op[1].destroy = custom_op_destroy_callback;

ret = rknn_register_custom_ops(ctx, user_op, 2);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
GPU-Operator
Der OpenCL-Kernel eines GPU-Operators kann als konstante Zeichenfolge oder Dateipfad registriert werden. Bei cl_source_size=0 in rknn_custom_op bezeichnet cl_kernel_source den Pfad; bei cl_source_size>0 die Kernel-Funktionszeichenfolge. Beispiel eines relu-Kernels als Zeichenfolge:
char* cl_kernel_source = "#pragma OPENCL EXTENSION cl_arm_printf : enable"
    "#pragma OPENCL EXTENSION cl_khr_fp16 : enable "
    " __kernel void relu_float(__global const float* input, __global float* output, int "
    "in_offset, int out_offset, const unsigned int elems) "
    "{"
    " int gid = get_global_id(0);"
    " if (gid < elems) {"
    " float in_value = input[in_offset + gid];"
    " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
    " }"
    "}"
    "__kernel void relu_half(__global const half* input, __global half* output, int in_offset, "
    "int out_offset, const unsigned int elems)"
    "{"
    " int gid = get_global_id(0);"
    " if (gid < elems) {"
    " half in_value = input[in_offset + gid];"
    " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
    " }"
    "}";
Nach Implementierung des OpenCL-Kernels und GPU-compute-Callbacks konfigurieren Sie das rknn_custom_op-Array und registrieren den GPU-Operator. Beispiel:
// GPU operators
rknn_custom_op user_op[1];
memset(user_op, 0, sizeof(rknn_custom_op));
strncpy(user_op->op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op->version = 1;
user_op->target = RKNN_TARGET_TYPE_GPU;
user_op->init = relu_init_callback_gpu;
user_op->compute = compute_custom_relu_float32;
user_op->destroy = relu_destroy_callback_gpu;
#ifdef LOAD_FROM_PATH
user_op->cl_kernel_source = "./custom_op.cl";
user_op->cl_source_size = 0;
#else
user_op->cl_kernel_source = cl_kernel_source;
user_op->cl_source_size = strlen(cl_kernel_source);
#endif
strcpy(user_op->cl_kernel_name, "relu_float");

ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
Definieren Sie vor der Registrierung op_type eindeutig, bereiten Sie die Operatorinformationen vor und konfigurieren Sie das rknn_custom_op-Array. Jeder Operatortyp wird einmal registriert; mehrere Operatoren desselben Typs im Netz benötigen keine wiederholte Registrierung.
4.2.1.4.3 Modellinferenz
Nach Registrierung aller Operatoren führen Sie die Inferenz über die allgemeine API oder Zero-Copy-API aus.
4.2.1.4.4 Genauigkeitsanalyse mit angeschlossenem Gerät
Für das Debuggen benutzerdefinierter Operatoren mit angeschlossener Platine ist rknn_server Version >= 1.6.0 erforderlich.
Beim Debuggen mit angeschlossenem Board öffnet RKNN Server die benutzerkompilierte Operator-Pluginbibliothek per dlopen aus einem festgelegten Verzeichnis, um Operatorinformationen zu erhalten. Für diesen Registrierungsweg muss get_rknn_custom_op implementiert werden.
Für die Genauigkeitsanalyse eines Modells mit solchen Operatoren auf dem angeschlossenen Gerät:
- get_rknn_custom_op() und erforderliche Callbacks implementieren und für das Zielsystem zu einer Bibliothek kompilieren. Der Bibliotheksname muss mit librkcst_ beginnen, beispielsweise librkcst_relu.so.
2 Das Plugin unter /vendor/lib64/ für Android arm64-v8a beziehungsweise /usr/lib/rknpu/op_plugins für Linux ablegen.
- Auf dem Host mit der Python-API von RKNN-Toolkit2 eine Genauigkeitsanalyse am angeschlossenen Gerät ausführen.
Beispiel für get_rknn_custom_op:
std::vector<std::string> get_all_plugin_paths(std::string plugin_dir)
{
  std::vector<std::string> plugin_paths;
  if (access(plugin_dir.c_str(), 0) != 0) {
    fprintf(stderr, "Can not access plugin directory: %s, please check it!\n",
plugin_dir.c_str());
  }

  DIR* dir;
  struct dirent* ent;
  const char* prefix = RKNN_CSTOP_PLUGIN_PREFIX; // All library file names should start with this prefix

  if ((dir = opendir(plugin_dir.c_str())) != NULL) {
    while ((ent = readdir(dir)) != NULL) {
      if (ent->d_type == DT_REG) {
        const char* filename = ent->d_name;
        size_t len = strlen(filename);

        if (len > 10 && strncmp(filename, prefix, strlen(prefix)) == 0) {
         printf("Found plugin: %s file in %s\n", filename, plugin_dir.c_str());
         plugin_paths.push_back(plugin_dir + "/" + filename);
        }
      }
    }
    closedir(dir);
  } else {
    fprintf(stderr, "Unable to open directory");
  }

  return plugin_paths;
}

// the default path of the custom operator plugin libraries
std::string plugin_dir =
#if defined(__ANDROID__)
# if defined(__aarch64__)
    "/vendor/lib64/";
# else
    "/vendor/lib/";
# endif // __aarch64__
#elif defined(__linux__)
    "/usr/lib/rknpu/op_plugins/";
#endif

std::vector<std::string> plugin_paths = get_all_plugin_paths(plugin_dir);
std::vector<void*> so_handles;
for (auto path : plugin_paths) {
printf("load plugin %s\n", path.c_str());
void* plugin_lib = dlopen(path.c_str(), RTLD_NOW);
char* error = dlerror();
if (error != NULL) {
    fprintf(stderr, "dlopen %s fail: %s.\nPlease try to set 'export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:%s'\n",
           path.c_str(), error, plugin_dir.c_str());
    dlclose(plugin_lib);
    return -1;
}
printf("dlopen %s successfully!\n", path.c_str());
get_custom_op_func custom_op_func = (get_custom_op_func)dlsym(plugin_lib,
"get_rknn_custom_op");
error = dlerror();
if (error != NULL) {
    fprintf(stderr, "dlsym fail: %s\n", error);
    dlclose(plugin_lib);
    return -1;
}

rknn_custom_op* user_op = custom_op_func();
ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
    printf("rknn_register_custom_ops fail! ret = %d\n", ret);
    return -1;
}
so_handles.push_back(plugin_lib);
}
Hinweise zur Pluginbibliothek:
Eine Pluginbibliothek registriert nur einen Operator. Für mehrere Operatoren mehrere Bibliotheken erstellen.
Der Bibliotheksname muss mit librkcst_ beginnen und auf .so enden.
Bei C++-Implementierung folgende Makros vor und nach der Funktionsdefinition ergänzen, damit die C-Schnittstelle die Symbole korrekt öffnen kann:
#ifdef __cplusplus
extern "C" {
#endif

//code

#ifdef __cplusplus
} // extern "C"
#endif
Falls dlopen die Bibliothek nicht lädt, LD_LIBRARY_PATH prüfen und sicherstellen, dass das Pluginverzeichnis darin enthalten ist.