
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 17/22
自定义算子:Python 与 C API
4.2 扩展与安全
4.2.1 自定义算子
4.2.1.1 自定义算子介绍
RKNN SDK提供了一种自定义算子的机制,它允许开发者在RKNN模型的推理阶段定义和执行自定义的算子。通过实现自定义算子,开发者可以扩展模型功能,并且针对特定硬件(CPU或者GPU)进行优化,以充分利用硬件资源并提高推理速度。同时,开发自定义算子需要深刻的理解深度学习计算原理和目标硬件平台的特性,以确保正确性和性能。目前只支持ONNX模型自定义算子。
RKNN自定义算子主要包括两大步骤:
使用RKNN-Toolkit2注册自定义算子并导出RKNN模型。
编写自定义算子的C代码实现,通过RKNN API加载注册并执行。
整体流程如下图所示:
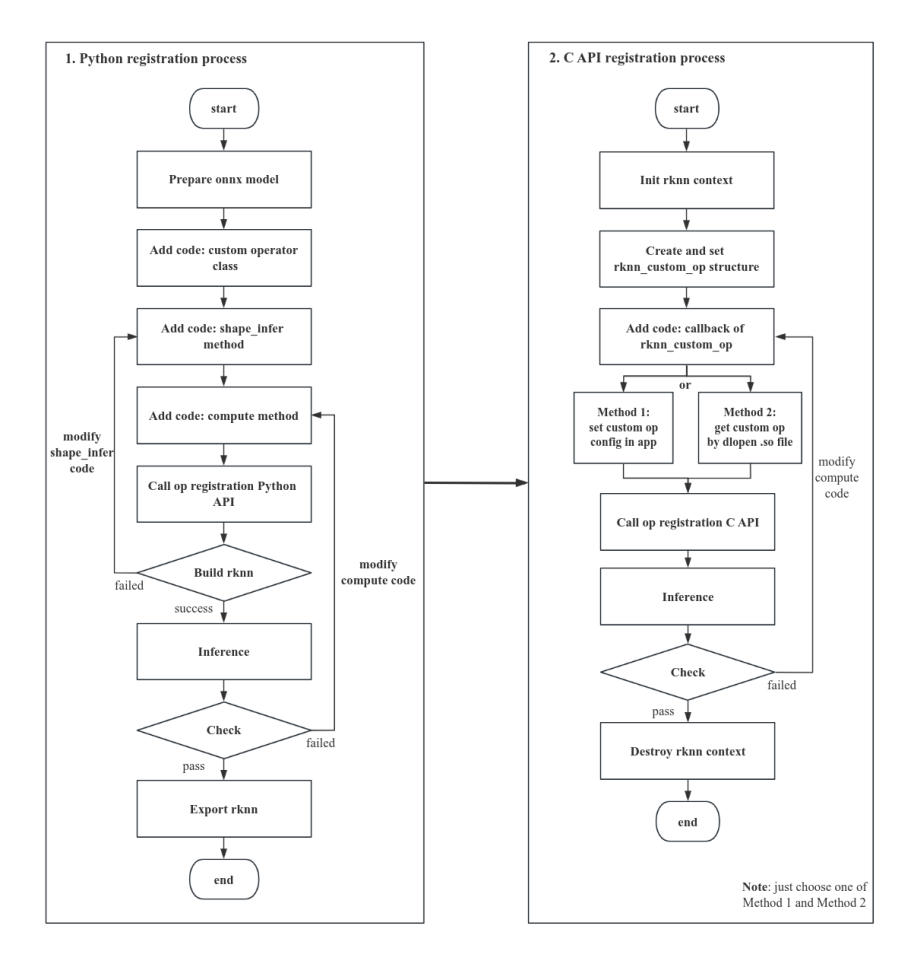
图4-12 注册自定义算子的完整流程
4.2.1.2 整体流程介绍
4.2.1.2.1 使用RKNN-Toolkit2注册自定义算子并导出RKNN模型
-
准备ONNX模型: 按照ONNX模型标准规范, 用戶设计自定义算子的op类型,名字, op属性,输入/输出数量,并将该算子插入到ONNX中的拓扑图位置,用戶使用ONNX包提供的api设计和导出ONNX模型。
-
实现自定义算子Python类, 类里主要包括 shape_infer() 和 compute() 两个函数接口, 并调用rknn.reg_custom_op() 注册该算子。
-
如果 rknn.build() 执行成功,可以进行推理,否则需要检查步骤2的 shape_infer() 代码实现。然后运行仿真,如果仿真结果正确,可以调用 rknn.export_rknn() 接口导出RKNN模型,否则需要检查步骤2的 compute() 代码。
4.2.1.2.2 编写自定义算子的C代码实现,通过RKNN API加载注册并执行
-
根据 rknn_custom_op.h 的 rknn_custom_op 类,编写自定义算子的C代码实现,编写完成后,填写rknn_custom_op 类的信息。
-
调用 rknn_register_custom_ops() 注册 rknn_custom_op 类的信息。
-
参考通用API或零拷贝API的流程,正常构建、推理模型,可以开启模型详细日志和Dump功能确认自定义算子实现的正确性。
4.2.1.2.3 使用RKNN-Toolkit2连板推理或精度分析
若用戶需要对包含自定义算子的模型做Python连板精度分析,需要将自定义算子的回调函数实现代码编译成so后,放在指定的路径,并重启RKNN Server。具体参考4.2.1.4.4 连板精度分析章节。
4.2.1.3 PYTHON端处理
目前只有ONNX模型支持自定义算子,支持用戶添加非ONNX标准的算子。
添加非ONNX标准的自定义算子用于新增一个不存在于ONNX算子列表内的新算子,该算子除了要满足ONNXspec规范以外,还要满足以下规则:
算子的 op_type 不能与ONNX标准算子相同,推荐以” cst “字符开头。
算子与其他算子必须要有连接关系,包含各个输入/输出的shape,数据类型等。
算子输入属性,支持bool、int32、float32、int64类型的单值或者数组。
算子常量输入,支持bool、int32、float32、int64类型,该类型指未量化ONNX模型的数据类型。
因为非ONNX标准算子并不是ONNX SPEC内的标准算子,所以用戶需要自行通过ONNX的API或其他框架的API来构建并导出一个包含非ONNX标准算子的ONNX模型。
这边为方便起见,以一个简单的修改Softmax的定义为示例,来构建一个包含非ONNX标准算子 cstSoftmax的ONNX模型,修改方法如下:
import onnx

path="test_softmax.onnx"
model=onnx.load(path)

for node in model.graph.node:
  if node.op_type =="Softmax":
    node.op_type = "cstSoftmax"
    ... # 修改 cstSoftmax 的属性定义等
onnx.save(model, "./test_softmax_custom.onnx")
在构建完包含自定义算子的ONNX模型后,可使用Netron打开该ONNX模型,并检查该自定义算子是否符合自定义算子的规范,满足规范之后,就可以实现该自定义算子的算子类,具体实现如下(以自定义 Softmax 为例):
import numpy as np
from rknn.api.custom_op import get_node_attr
class cstSoftmax:
    op_type = 'cstSoftmax'
    def shape_infer(self, node, in_shapes, in_dtypes):
       out_shapes = in_shapes.copy()
       out_dtypes = in_dtypes.copy()
       return out_shapes, out_dtypes
    def compute(self, node, inputs):
       x = inputs[0]
       axis = get_node_attr(node, 'axis')
       x_max = np.max(x, axis=axis, keepdims=True)
       tmp = np.exp(x - x_max)
       s = np.sum(tmp, axis=axis, keepdims=True)
       outputs = [tmp / s]
       return outputs
自定义算子必须为一个Python类。
自定义算子类必须包含一个名为 op_type 的字符串变量,与构建的ONNX中自定义算子类型名一致。
自定义算子类必须包含成员函数 shape_infer(self, node, in_shapes, in_dtypes) ,函数名、参数名都必须一致,否则报错。该函数用于自定义算子的shape推理,其中, node 为ONNX的算子节点对象,该对象里包含了自定义算子的属性和输入输出信息; in_shapes 为该算子所有输入的shape信息,格式为[shape_0, shape_1, …],列表内的shape的类型为列表; in_dtypes 为该算子所有输入的dtype信息,格式为[dtype_0, dtype_1, …], 列表内的dtype的类型为numpy的dtype类型。另外该函数需要返回该算子所有输出的shape信息和dtype信息,格式与 in_shapes 和 in_dtypes 一致。
自定义算子类必须包含成员函数 compute(self, node, inputs) ,函数名和参数名都必须一致,否则报错。该函数用于自定义算子的推理。其中, node 为ONNX的算子节点对象,该对象里包含了自定义算子的属性和输入输出信息; inputs 为该算子的输入数据,格式为[array_0, array_1, …],列表内的array的类型为numpy的ndarray类型。另外该函数需要返回该算子所有输出的数据,格式与inputs一致。
如自定义算子含有自定义的属性,可通过 from rknn.api.custom_op import get_node_attr 来获取自定义算子的属性值。
在编写完自定义算子类后,可以通过 rknn.reg_custom_op() 进行算子类的注册,注册完后,就可以调用rknn.build() 转换并生成RKNN模型。自定义算子类可以确保模型的转换和推理等功能的正常。具体实现如下(以自定义 Softmax 为例):
from rknn.api import RKNN
# Create RKNN object
rknn = RKNN(verbose=True)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82],
           quant_img_RGB2BGR=True, target_platform='rk3566')
print('done')

print('--> Register cstSoftmax op')
ret = rknn.reg_custom_op(cstSoftmax())
if ret != 0:
    print('Register cstSoftmax op failed!')
    exit(ret)
print('done')

print('--> Loading model')
ret = rknn.load_onnx(model='mobilenet_v2.onnx')
if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')
rknn.reg_custom_op() 需要在 rknn.config() 和 rknn.load_xxx() 之间调用。
4.2.1.4 C API部署
在得到带自定义算子的RKNN模型后,开始调用C API部署。首先,自定义算子的结构体和接口位于rknn_custom_op.h 头文件,开发者程序需要包含该头文件。注册使用自定义算子的流程如下图所示:
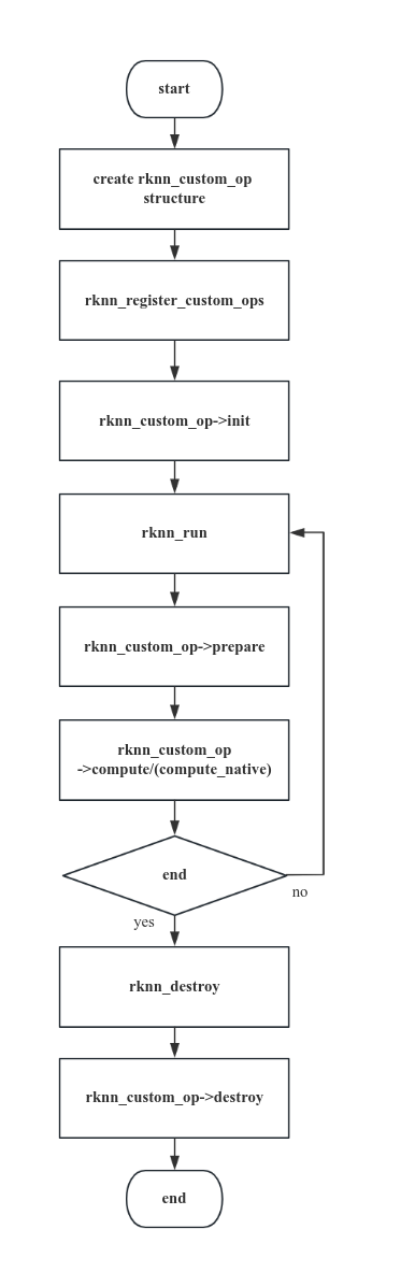
图4-13 注册自定义算子的C API调用流程
4.2.1.4.1 初始化自定义算子结构体
创建 rknn 上下文后,开发者需要创建 rknn_custom_op 结构体,设置自定义算子信息。算子信息包含以下内容:
version:算子的版本号。
target:算子的执行后端,目前支持CPU和GPU。
op_type: 算子的类型,与ONNX模型中的类型字段相同。
cl_kernel_name: OpenCL代码的 cl_kernel 函数名。注册GPU算子时必须配置。
cl_kernel_source:自定义算子的 .cl 文件全路径或者OpenCL kernel字符串。当cl_source_size=0 , 它表示 .cl 文件全路径;当 cl_source_size>0 ,它表示OpenCL kerne代码字符串。注册GPU算子时必须配置。
cl_source_size: cl_kernel_source 的大小。大小等于0是特殊情况,它表示 cl_kernel_source是路径。
cl_build_options: OpenCL kernel编译选项,以字符串形式传入。注册GPU算子时必须配置。
init :可选,在 rknn_register_custom_ops 被调用一次。
prepare:可选,它是预处理回调函数,每次 rknn_run 都会执行 prepare 和compute/compute_native 回调,执行顺序是 prepare 在前, compute/compute_native 在后。
compute:必须实现,算子运算回调函数,它的输入/输出都是 NCHW 的float32格式数据(ONNX模型如果指定输入/输出为int64的数据类型,则int64格式数据)
compute_native: 保留,请设置成 NULL 。
destroy:可选, rknn_destory 中执行一次。
init/prepare/compute回调函数参数定义规范如下:
rknn_custom_op_context* op_ctx : op回调函数的上下文信息
rknn_custom_op_tensor* inputs : op输入tensor数据和信息
uint32_t n_inputs : op输入个数
rknn_custom_op_tensor* outputs : op输出tensor数据和信息
uint32_t n_outputs : op输出个数
destroy回调函数仅 rknn_custom_op_context* op_ctx 一个参数。
rknn_custom_op_context
包含target(执行后端设备)、GPU上下文、自定义算子私有上下文以及 priv_data ,其中 priv_data 由开发者自行管理(赋值,读写,销毁),GPU上下文包含 cl_context 、 cl_command_queue 、 cl_kernel指针,可以通过强制类型转换得到对应的OpenCL对象。
priv_data 是一个用戶可选是否配置的指针,通常的用法是用戶在 init() 回调函数内创建资源,并将priv_data 指向该段内存地址,在 prepare()/compute() 回调函数中操作,最终在 destroy() 回调函数内销毁资源。
rknn_custom_op_tensor
表示输入/输出tensor的信息,包含tensor的名称、形状、大小、量化参数、虚拟基地址、fd、数据偏移等信息。
用戶在回调 compute() 回调函数内无需创建该算子的输入和输出tensor内存。虚拟地址对应的数据在进入compute() 回调函数时已经准备好。虚拟地址的计算公式是Tensor的有效地址=虚拟基地址+数据偏移,mem成员的virt_addr表示虚拟基地址,mem成员的offset表示数据偏移(以字节为单位)。用戶在回调函数内可以读取输入tensor的有效地址,该指向前一层算子已经计算后的输出数据,输出tensor的有效地址指向即将送给下一层算子的输入。
rknn_custom_op_attr
开发者通过调用 rknn_custom_op_get_op_attr() 函数传入属性字段获得属性信息,属性信息用rknn_custom_op_attr 表示, rknn_custom_op_attr 中的 void 类型buffer,dtype以及元素数量表示一块内存段,开发者根据dtype使用C/C++将buffer强制转换指针类型可以得到相应数值类型的数组。
4.2.1.4.1.1 init回调函数
常用于解析算子信息或初始化临时缓冲区或者输入/输出缓冲区buffer。分配临时buffer的 init 回调函数示例代码如下:
CPU算子
/**
 * cpu kernel init callback for custom op
 */
int custom_op_init_callback(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
              rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
 printf("custom_op_init_callback\n");
 // create tmp buffer
 float* tmp_buffer = (float*)malloc(inputs[0].attr.n_elems * sizeof(float));
 op_ctx->priv_data = tmp_buffer;
 return 0;
}
GPU算子
/**
 * opencl kernel init callback for custom op
 * */
int relu_init_callback_gpu(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
 printf("relu_init_callback_gpu\n");
 // 获取opencl context
 cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

 // create tmp cl buffer
 cl_mem* memObject = (cl_mem*)malloc(sizeof(cl_mem) * 2);
 memObject[0] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, inputs[0].attr.size, NULL, NULL);
 memObject[1] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, outputs[0].attr.size, NULL, NULL);
 op_ctx->priv_data = memObject;
 return 0;
}
4.2.1.4.1.2 prepare回调函数
该回调函数每帧推理都会调用,目前为预留实现。
4.2.1.4.1.3 compute回调函数
它是自定义算子的计算函数,开发者必须完成输入/输出是 NCHW 或 UNDEFINED 格式float32数据类型输入输出的核函数。
- compute 回调(CPU)假设开发者想实现一个自定义层,完成softmax功能,CPU算子 compute 函数示例如下:
/**
 * float32 kernel implemetation sample for custom op
 * */
int compute_custom_softmax_float32(rknn_custom_op_context* op_ctx,
rknn_custom_op_tensor* inputs, uint32_t n_inputs,
                                 rknn_custom_op_tensor* outputs, uint32_t
n_outputs)
{
  unsigned char* in_ptr = (unsigned char*)inputs[0].mem.virt_addr +
inputs[0].mem.offset;
  unsigned char* out_ptr = (unsigned char*)outputs[0].mem.virt_addr +
outputs[0].mem.offset;
  int axis = 0;
  const float* in_data = (const float*)in_ptr;
  float* out_data = (float*)out_ptr;
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  rknn_custom_op_attr op_attr;
  rknn_custom_op_get_op_attr(op_ctx, "axis", &op_attr);
  if (op_attr.n_elems == 1 && op_attr.dtype == RKNN_TENSOR_INT64) {
    axis = ((int64_t*)op_attr.data)[0];
  }

  printf("op name = %s, axis = %d\n", name.c_str(), axis);
  float* tmp_buffer = (float*)op_ctx->priv_data;
  // kernel implemetation for custom op
  {
    int inside = 1;
    int outside = 1;
    int channel = 1;

    while (axis < 0) {
      axis += inputs[0].attr.n_dims;
    }

    for (int i = 0; i < axis; i++) {
      outside *= inputs[0].attr.dims[i];
    }
    channel = inputs[0].attr.dims[axis];
    for (int i = axis; i < inputs[0].attr.n_dims; i++) {
      inside *= inputs[0].attr.dims[i];
    }

    for (int y = 0; y < outside; y++) {
      const float* src_y = in_data + y * inside;
      float* dst_y = out_data + y * inside;
      float max_data = -FLT_MAX;
      float sum_data = 0.0f;

      for (int i = 0; i < inside; ++i) {
       max_data = fmaxf(max_data, src_y[i]);
      }
      for (int i = 0; i < inside; ++i) {
       tmp_buffer[i] = expf(src_y[i] - max_data);
       sum_data += tmp_buffer[i];
      }
      for (int i = 0; i < inside; ++i) {
       dst_y[i] = tmp_buffer[i] / sum_data;
      }
    }
  }
  return 0;
}
- compute回调函数(GPU)
对于GPU算子,开发者可以在回调函数中完成以下步骤:
开发者从 rknn_custom_op_context 里的 gpu_ctx 中获取OpenCL的 cl_context ,cl_command_queue 以及 cl_kernel 对象,此过程需要开发者做数据类型转换。
如有必要,用戶自行创建的op输入或输出的 cl_mem 对象缓冲区。
设置 cl_kernel 的函数参数。
OpenCL kernel的函数参数的输入buffer数据目前只能支持float,其他类型暂时还不支持。
对于使用零拷贝的情况下,调用 clImportMemoryARM 可以自行协助用戶把输入tensor的内存映射到OpenCL的 cl_mem 结构体中,输入tensor已包含输入数据,用戶不需要自行再拷贝一次。该过程也可以在init回调函数中处理,然后将 cl_mem 结构体记录到 priv_data 成员,最后在 compute 回调中读取priv_data 并使用它。
以阻塞的形式运行 cl_kernel 。
CL kernel内的输入数据都是以 NCHW 形式排布给出。
如果在GPU运算完后,开发者需要CPU访问数据,需要通过调用 rknn_mem_sync 函数刷新输出Tensor的cache后再读取数据。
假设开发者想实现一个自定义层,完成relu功能,GPU算子compute函数示例如下:
/**
 * opencl kernel init callback for custom op
 * */
int compute_custom_relu_float32(rknn_custom_op_context* op_ctx,
rknn_custom_op_tensor* inputs, uint32_t num_inputs,
                              rknn_custom_op_tensor* outputs, uint32_t
num_outputs)
{
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  // get context
  cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

  // get command queue
  cl_command_queue queue = (cl_command_queue)op_ctx->gpu_ctx.cl_command_queue;

  // get kernel
  cl_kernel kernel = (cl_kernel)op_ctx->gpu_ctx.cl_kernel;

  // import input/output buffer
  const cl_import_properties_arm props[3] = {
    CL_IMPORT_TYPE_ARM,
    CL_IMPORT_TYPE_DMA_BUF_ARM,
    0,
  };

  cl_int status;
  cl_mem inObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props,
&inputs[0].mem.fd,
                                    inputs[0].mem.offset + inputs[0].mem.size,
&status);
  if (status != CL_SUCCESS) {
    printf("Tensor: %s clImportMemoryARM failed\n", inputs[0].attr.name);
  }
  cl_mem outObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props,
&outputs[0].mem.fd,
                                     outputs[0].mem.offset + outputs[0].mem.size,
&status);
  if (status != CL_SUCCESS) {
    printf("Tensor: %s clImportMemoryARM failed\n", outputs[0].attr.name);
  }

  int in_type_bytes = get_type_bytes(inputs[0].attr.type);
  int out_type_bytes = get_type_bytes(outputs[0].attr.type);
  int in_offset = inputs[0].mem.offset / in_type_bytes;
  int out_offset = outputs[0].mem.offset / out_type_bytes;
  unsigned int elems = inputs[0].attr.n_elems;

  // set kernel args
  int argIndex = 0;
  clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &inObject);
  clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &outObject);
  clSetKernelArg(kernel, argIndex++, sizeof(int), &in_offset);
  clSetKernelArg(kernel, argIndex++, sizeof(int), &out_offset);
  clSetKernelArg(kernel, argIndex++, sizeof(unsigned int), &elems);
  // set global worksize
  const size_t global_work_size[3] = {elems, 1, 1};

  // enqueueNDRangeKernel
  clEnqueueNDRangeKernel(queue, kernel, 1, NULL, global_work_size, NULL, 0, NULL,
NULL);

  // finish command queue
  clFinish(queue);

  // //cpu access data after sync to device
  // rknn_mem_sync(&outputs[0].mem, RKNN_MEMORY_SYNC_FROM_DEVICE);
  // // save output npy
  // char output_path[PATH_MAX];
  // sprintf(output_path, "%s/cpu_output%d.npy", ".", 0);
  // unsigned char* out_data = (unsigned char*)outputs[0].mem.virt_addr+outputs[0].mem.offset;
  // save_npy(output_path, (float*)out_data, &inputs[0].attr);
  return 0;
}
4.2.1.4.1.4 destroy回调函数
常用于销毁自定义算子的临时缓冲区或输入/输出buffer。销毁临时buffer的示例代码如下:
CPU算子
/**
 * cpu kernel destroy callback for custom op
 */
int custom_op_destroy_callback(rknn_custom_op_context* op_ctx)
{
 printf("custom_op_destroy_callback\n");
 // clear tmp buffer
 free(op_ctx->priv_data);
 return 0;
}
GPU算子
/**
 * opencl kernel destroy callback for custom op
 */
int relu_destroy_callback_gpu(rknn_custom_op_context* op_ctx)
{
 // clear tmp buffer
 printf("relu_destroy_callback_gpu\n");
 cl_mem* memObject = (cl_mem*)op_ctx->priv_data;
 clReleaseMemObject(memObject[0]);
 clReleaseMemObject(memObject[1]);
 free(memObject);
 return 0;
}
4.2.1.4.2 注册自定义算子
在设置完 rknn_custom_op 结构体后,需要调用 rknn_register_custom_ops() 将其注册到rknn_context 中,该接口支持同时注册多个自定义算子。
在完成CPU的 compute 回调函数后,注册一个名为”cstSoftmax”和“ArgMax”的CPU自定义算子的代码示例如下:
CPU算子
// CPU operators
rknn_custom_op user_op[2];
memset(user_op, 0, 2 * sizeof(rknn_custom_op));
strncpy(user_op[0].op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op[0].version = 1;
user_op[0].target = RKNN_TARGET_TYPE_CPU;
user_op[0].init = custom_op_init_callback;
user_op[0].compute = compute_custom_softmax_float32;
user_op[0].destroy = custom_op_destroy_callback;

strncpy(user_op[1].op_type, "ArgMax", RKNN_MAX_NAME_LEN - 1);
user_op[1].version = 1;
user_op[1].target = RKNN_TARGET_TYPE_CPU;
user_op[1].init = custom_op_init_callback;
user_op[1].compute = compute_custom_argmax_float32;
user_op[1].destroy = custom_op_destroy_callback;

ret = rknn_register_custom_ops(ctx, user_op, 2);
if (ret < 0) {
printf("rknn_register_custom_ops fail! ret = %d\n", ret);
return -1;
}
GPU算子
对于GPU算子而言,支持以常量字符串或者文件路径的两种方式注册OpenCL kernel。当 rknn_custom_op结构体中的 cl_source_size 等于0时, cl_kernel_source 表示OpenCL kernel的文件路径,当cl_source_size 大于0时 cl_kernel_source 表示OpenCL kernel函数字符串。以字符串保存的relu功能的OpenCL kernel的示例代码如下:
char* cl_kernel_source = "#pragma OPENCL EXTENSION cl_arm_printf : enable"
   "#pragma OPENCL EXTENSION cl_khr_fp16 : enable "
   " __kernel void relu_float(__global const float* input, __global float* output, int "
   "in_offset, int out_offset, const unsigned int elems) "
   "{"
   " int gid = get_global_id(0);"
   " if (gid < elems) {"
   " float in_value = input[in_offset + gid];"
   " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
   " }"
   "}"
   "__kernel void relu_half(__global const half* input, __global half* output, int in_offset, "
   "int out_offset, const unsigned int elems)"
   "{"
   " int gid = get_global_id(0);"
   " if (gid < elems) {"
   " half in_value = input[in_offset + gid];"
   " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
   " }"
   "}";
在完成OpenCL kernel函数以及GPU的compute回调函数后,可以设置 rknn_custom_op 结构体数组并注册GPU算子,注册GPU算子示例代码如下:
// GPU operators
rknn_custom_op user_op[1];
memset(user_op, 0, sizeof(rknn_custom_op));
strncpy(user_op->op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op->version = 1;
user_op->target = RKNN_TARGET_TYPE_GPU;
user_op->init = relu_init_callback_gpu;
user_op->compute = compute_custom_relu_float32;
user_op->destroy = relu_destroy_callback_gpu;
#ifdef LOAD_FROM_PATH
user_op->cl_kernel_source = "./custom_op.cl";
user_op->cl_source_size = 0;
#else
user_op->cl_kernel_source = cl_kernel_source;
user_op->cl_source_size = strlen(cl_kernel_source);
#endif
strcpy(user_op->cl_kernel_name, "relu_float");

ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
printf("rknn_register_custom_ops fail! ret = %d\n", ret);
return -1;
}
注册调用该接口前要明确自定义算子的 op_type ,准备好算子信息并配置 rknn_custom_op 数组。每个类型的自定义算子要调用一次注册接口,网络中同一类型的算子仅调用一次。
4.2.1.4.3 模型推理
在注册完所有算子后,可以使用通用API或零拷贝API流程完成推理。
4.2.1.4.4 连板精度分析
自定义算子的连板调试功能要求rknn_server版本>=1.6.0。
连板调试时,RKNN Server会采用dlopen的方式从特定目录打开用戶编译好的自定义算子插件库来获取算子信息,对于插件库方式注册自定义算子,要求用戶必须实现一个名为 get_rknn_custom_op 的函数。
若用戶需要对包含自定义算子的模型做连板精度分析,具体步骤如下:
-
实现一个 get_rknn_custom_op() 函数和必须的回调函数,并编译成对应系统的库,编译的插件库名称必须以”librkcst_“为前缀,例如库名是 librkcst_relu.so 。
-
插件放到 /vendor/lib64/ (Android arm64-v8a)或 /usr/lib/rknpu/op_plugins (Linux)
-
主机端或者上位机使用RKNN-Toolkit2的Python接口执行连板精度分析。
get_rknn_custom_op 函数的示例代码如下:
std::vector<std::string> get_all_plugin_paths(std::string plugin_dir)
{
  std::vector<std::string> plugin_paths;
  if (access(plugin_dir.c_str(), 0) != 0) {
    fprintf(stderr, "Can not access plugin directory: %s, please check it!\n",
plugin_dir.c_str());
  }

  DIR* dir;
  struct dirent* ent;
  const char* prefix = RKNN_CSTOP_PLUGIN_PREFIX; // 所有库文件名应该以此前缀开头

  if ((dir = opendir(plugin_dir.c_str())) != NULL) {
    while ((ent = readdir(dir)) != NULL) {
      if (ent->d_type == DT_REG) {
       const char* filename = ent->d_name;
       size_t len = strlen(filename);

       if (len > 10 && strncmp(filename, prefix, strlen(prefix)) == 0) {
         printf("Found plugin: %s file in %s\n", filename, plugin_dir.c_str());
         plugin_paths.push_back(plugin_dir + "/" + filename);
       }
      }
    }
    closedir(dir);
  } else {
    fprintf(stderr, "Unable to open directory");
  }

  return plugin_paths;
}

// the default path of the custom operator plugin libraries
std::string plugin_dir =
#if defined(__ANDROID__)
# if defined(__aarch64__)
    "/vendor/lib64/";
# else
    "/vendor/lib/";
# endif // __aarch64__
#elif defined(__linux__)
    "/usr/lib/rknpu/op_plugins/";
#endif

std::vector<std::string> plugin_paths = get_all_plugin_paths(plugin_dir);
std::vector<void*> so_handles;
for (auto path : plugin_paths) {
printf("load plugin %s\n", path.c_str());
void* plugin_lib = dlopen(path.c_str(), RTLD_NOW);
char* error = dlerror();
if (error != NULL) {
    fprintf(stderr, "dlopen %s fail: %s.\nPlease try to set 'export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:%s'\n",
           path.c_str(), error, plugin_dir.c_str());
    dlclose(plugin_lib);
    return -1;
}
printf("dlopen %s successfully!\n", path.c_str());
get_custom_op_func custom_op_func = (get_custom_op_func)dlsym(plugin_lib,
"get_rknn_custom_op");
error = dlerror();
if (error != NULL) {
    fprintf(stderr, "dlsym fail: %s\n", error);
    dlclose(plugin_lib);
    return -1;
}

rknn_custom_op* user_op = custom_op_func();
ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
    printf("rknn_register_custom_ops fail! ret = %d\n", ret);
    return -1;
}
so_handles.push_back(plugin_lib);
}
插件库有如下注意事项:
一个自定义算子插件库只能注册一个自定义算子,如果需要注册多个自定义算子,需要创建多个插件库。
插件库的名称必须以”librkcst_“开头,以.so结尾。
如果是C++代码实现的插件库,C接口中为了正确打开函数符号,要在函数定义前后加入如下宏:
#ifdef __cplusplus
extern "C" {
#endif

//code

#ifdef __cplusplus
} // extern "C"
#endif
如果dlopen插件库失败,需要检查是否设置了 LD_LIBRARY_PATH 环境变量,并且检查插件库所在目录是否在环境变量指定的路径。