
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 4/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
2. Modellkonvertierung, Quantisierung und Bewertung
2.1 Allgemeine Modellkonvertierung
RKNN-Toolkit2 bietet Modellkonvertierung, Leistungsanalyse, Bereitstellung, Debugging und weitere Funktionen. Dieser Abschnitt behandelt die Modellkonvertierung als eine der Kernfunktionen von RKNN-Toolkit2. Modelle des Deep Learning aus unterschiedlichen Frameworks lassen sich damit in das RKNN-Format für die Ausführung auf der RKNPU umwandeln. Der allgemeine Ablauf lautet: Modell vorbereiten → Konvertierungsparameter konfigurieren → Modell laden und erstellen → RKNN-Modell exportieren → Konvertierungsergebnis prüfen. Das folgende Ablaufdiagramm erläutert diesen Prozess.
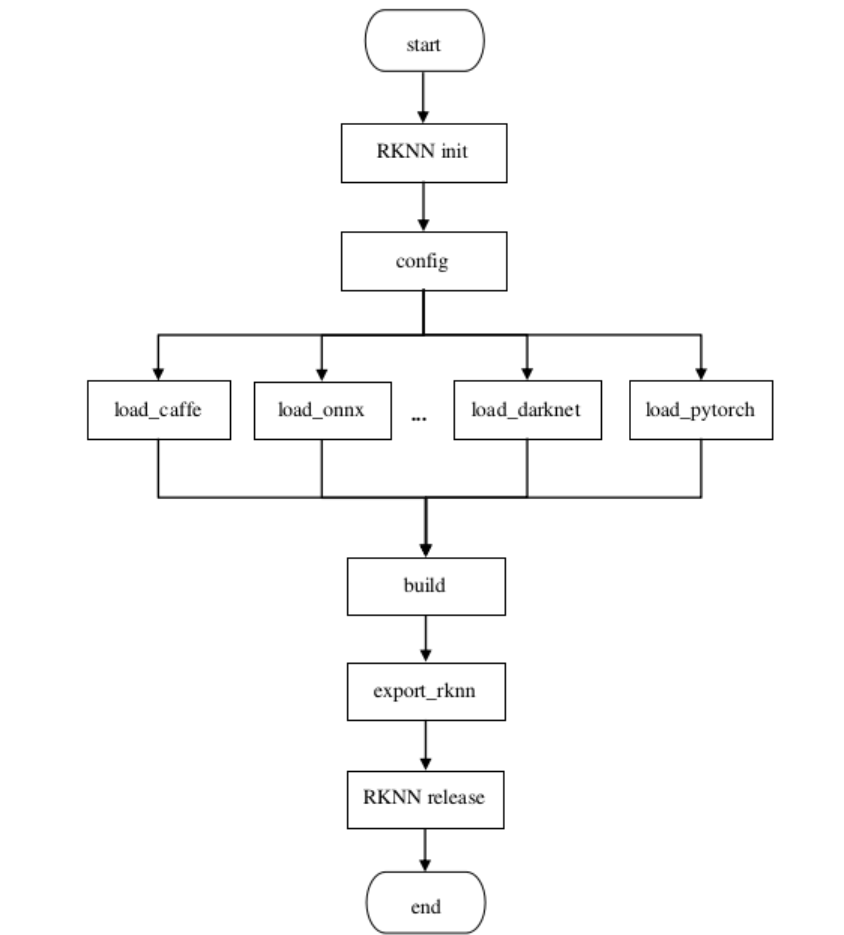
Abbildung 2-1: Ablauf der Modellkonvertierung
RKNN-Toolkit2 unterstützt die Modellkonvertierung für folgende verbreitete Deep-Learning-Frameworks:
Caffe
TensorFlow
TensorFlow Lite
ONNX
PyTorch
Darknet
Mit diesen Frameworks können Modelle trainiert oder vortrainierte Modelle bezogen und in das RKNN-Format konvertiert werden. Dadurch werden Bereitstellung und Inferenz auf der RKNPU-Plattform einfacher und effizienter.
2.1.1 Modellvorbereitung
Eingabe der Konvertierung ist das ursprüngliche, mit einem Deep-Learning-Framework trainierte oder exportierte Modell. Vor der Konvertierung sind folgende Vorbereitungen erforderlich:
Modellquelle: Verwenden Sie ein trainiertes oder vortrainiertes Modell aus einem von RKNN-Toolkit2 unterstützten Framework (Caffe / TensorFlow / TensorFlow Lite / ONNX / PyTorch / DarkNet). Stellen Sie sicher, dass die Inferenz im ursprünglichen Framework korrekt funktioniert.
Ein- und Ausgaben: Ermitteln Sie Namen der Ein- und Ausgabeknoten, Eingabeformen, Datentypen usw. Einige Frameworks benötigen diese Angaben ausdrücklich beim Laden, etwa inputs / outputs / input_size_list bei TensorFlow und input_size_list bei PyTorch. Die nachfolgenden Konfigurations- und Lade-APIs verwenden diese Informationen.
Modellprüfung: Prüfen Sie vor der Konvertierung die Modellstruktur beispielsweise mit Netron, um korrekten Export und Unterstützung der Operatoren zu bestätigen. Bei ONNX-Modellen kann zunächst onnxruntime prüfen, ob die Inferenzergebnisse mit denen des ursprünglichen Frameworks übereinstimmen.
2.1.2 Konvertierung konfigurieren
Vor der Konvertierung sind Einstellungen für die Korrektheit und Leistung der Modellkonvertierung erforderlich. Über rknn.config() lassen sich beispielsweise Eingabemittelwerte, Normalisierung und Quantisierung konfigurieren. Häufig verwendete Parameter:
mean_values und std_values legen Eingabemittelwerte und Normalisierungswerte fest. Sie werden bei der Quantisierung verwendet, sodass beim Inferenzaufruf über die C-API keine erneute Mittelwertsubtraktion und Normalisierung der Bilder nötig ist. Dadurch verkürzt sich die Bereitstellungszeit.
quant_img_RGB2BGR bestimmt, ob beim Laden eines Kalibrierungsbildes für die Quantisierung zunächst RGB in BGR umgewandelt wird. Der Standardwert ist false. Diese Einstellung wirkt bei der Quantisierungskalibrierung, jedoch nicht während der Inferenz. Bei der Inferenz muss die Umwandlung in der eigenen Eingabevorverarbeitung erfolgen. Einzelheiten stehen in Abschnitt 5.4.3. Hinweis: Bei quant_img_RGB2BGR=True erfolgt zuerst die RGB2BGR-Umwandlung, anschließend werden mean_values und std_values angewendet.
target_platform legt die Zielplattform des RKNN-Modells fest. Unterstützt werden RV1103, RV1103B, RV1106, RV1106B, RV1126B, RK2118, RK3562, RK3566, RK3568, RK3576 und RK3588.
quantized_algorithm legt den Algorithmus zur Berechnung der Quantisierungsparameter jeder Schicht fest. Zur Auswahl stehen normal, mmse, kl_divergence und gdq; Standard ist normal. Der Originaltext verweist für Einzelheiten auf die Abschnitte 3.1.7, 6.1 und 6.2.
quantized_method unterstützt layer, channel oder group{SIZE} und bestimmt, wie Gewichte einer Schicht Quantisierungsparameter gemeinsam verwenden. Standard ist channel. Der Originaltext verweist auf die Abschnitte 3.1.7, 6.1 und 6.2.
optimization_level ändert die Optimierungsstufe und ermöglicht das Abschalten einiger oder aller Optimierungsregeln bei der Modellkonvertierung. Der Standardwert 3 aktiviert alle Optimierungen. Bei 2 oder 1 werden einige Optionen deaktiviert, die die Genauigkeit bestimmter Modelle beeinflussen können. Bei 0 sind alle Optimierungen deaktiviert.
quantized_dtype legt den Quantisierungstyp fest. Unterstützt wird INT8 mit linearer asymmetrischer Quantisierung; Standard ist ‘asymmetric_quantized-8’.
custom_string fügt dem RKNN-Modell eine benutzerdefinierte Zeichenfolge hinzu, etwa dessen Versionsinformation. Sie lässt sich mit RKNN_QUERY_CUSTOM_STRING abfragen und ermöglicht eine modellspezifische Behandlung bei der Bereitstellung. Standard ist None.
dynamic_input unterstützt dynamische Eingaben, indem mehrere vom Benutzer vorgegebene Sätze von Eingabeformen verwendet werden. Standard ist None. Einzelheiten stehen in Abschnitt 4.1.3.
Die vollständige Beschreibung von rknn.config() enthält das Handbuch „03_RKNN2_Toolkit_Python_API_Reference_V2.5.0“. Oben sind nur einige häufig verwendete Parameter aufgeführt.
Codebeispiel:
rknn.config(
    mean_values=[[103.94, 116.78, 123.68]],
    std_values=[[58.82, 58.82, 58.82]],
    quant_img_RGB2BGR=False,
    target_platform='rk3566')
2.1.3 Modell laden und erstellen
1 RKNN-Objekt initialisieren:
Zunächst muss das RKNN-Objekt initialisiert werden. Dies ist der erste Schritt des gesamten Ablaufs:
Initialisieren Sie das RKNN-Objekt mit dem Konstruktor RKNN(). Dabei können die Parameter verbose und verbose_file übergeben werden.
verbose bestimmt, ob ausführliche Protokollinformationen auf dem Bildschirm erscheinen.
Ist verbose_file angegeben und verbose auf True gesetzt, werden die Protokollinformationen zusätzlich in die angegebene Datei geschrieben.
Codebeispiel:
rknn = RKNN(verbose=True, verbose_file='./mobilenet_build.log')
2. Schnittstellen zum Laden von Modellen
Verwenden Sie für den Import einer Modelldatei die zum Framework passende Ladeschnittstelle. RKNN-Toolkit2 bietet Schnittstellen für Caffe, TensorFlow, TensorFlow Lite, ONNX, PyTorch und weitere Formate. Diese werden im Folgenden kurz beschrieben.
Ladeschnittstelle für Caffe-Modelle:
Laden Sie ein Caffe-Modell mit rknn.load_caffe().
Geben Sie den Pfad zur Modelldatei mit der Endung .prototxt und zur Gewichtsdatei mit der Endung .caffemodel an.
Bei mehreren Eingabeschichten können Sie die Reihenfolge ihrer Namen angeben.
Codebeispiel:
ret = rknn.load_caffe(model='./mobilenet_v2.prototxt', blobs='./mobilenet_v2.caffemodel')
Ladeschnittstelle für TensorFlow-Modelle:
Laden Sie ein TensorFlow-Modell mit rknn.load_tensorflow().
Geben Sie die TensorFlow-Modelldatei mit der Endung .pb, die Namen und Formen der Eingabeknoten sowie die Namen der Ausgabeknoten an.
Codebeispiel:
ret = rknn.load_tensorflow(tf_pb='./ssd_mobilenet_v1_coco_2017_11_17.pb',
              inputs=['Preprocessor/sub'],
              outputs=['concat', 'concat_1'],
              input_size_list=[[1, 300, 300, 3]])
Ladeschnittstelle für TensorFlow-Lite-Modelle:
Laden Sie ein TensorFlow-Lite-Modell mit rknn.load_tflite().
Geben Sie den Pfad zur TensorFlow-Lite-Modelldatei mit der Endung .tflite an.
Codebeispiel:
ret = rknn.load_tflite(model='./mobilenet_v1.tflite')
Ladeschnittstelle für ONNX: Verwenden Sie rknn.load_onnx() und geben Sie den Pfad zur ONNX-Modelldatei mit der Endung .onnx an.
Codebeispiel:
ret = rknn.load_onnx(model='./arcface.onnx')
Ladeschnittstelle für DarkNet-Modelle:
Laden Sie ein DarkNet-Modell mit rknn.load_darknet().
Geben Sie den Pfad zur Modelldatei mit der Endung .cfg und zur Gewichtsdatei mit der Endung .weights an.
Codebeispiel:
ret = rknn.load_darknet(model='./yolov3-tiny.cfg', weight='./yolov3.weights')
Ladeschnittstelle für PyTorch: Verwenden Sie rknn.load_pytorch() und geben Sie den Pfad zur Modelldatei mit der Endung .pt an. Das Modell muss im torchscript-Format vorliegen.
Codebeispiel:
ret = rknn.load_pytorch(model='./resnet18.pt', input_size_list=[[1, 3, 224, 224]])
Wählen Sie die zum jeweiligen Framework passende Schnittstelle, damit die Modellkonvertierung korrekt erfolgt.
3. RKNN-Modell erstellen
Nach dem Laden des ursprünglichen Modells wird das RKNN-Modell mit rknn.build() erstellt. Dabei kann die Quantisierung aktiviert werden, um die Modellgröße zu reduzieren und die Leistung auf der RKNPU zu verbessern. Die Parameter von rknn.build() sind:
do_quantization: bestimmt, ob das Modell quantisiert wird. Empfohlen wird True.
dataset: gibt den Datensatz für die Quantisierungskalibrierung an. Er wird in einer Textdatei beschrieben.
Beispiel für dataset.txt:
./imgs/ILSVRC2012_val_00000665.JPEG
./imgs/ILSVRC2012_val_00001123.JPEG
./imgs/ILSVRC2012_val_00001129.JPEG
./imgs/ILSVRC2012_val_00001284.JPEG
./imgs/ILSVRC2012_val_00003026.JPEG
./imgs/ILSVRC2012_val_00005276.JPEG
Codebeispiel:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
2.1.4 RKNN-Modell exportieren
Nach dem Erstellen mit rknn.build() kann das Modell mit rknn.export_rknn() als Datei mit der Endung .rknn für die spätere Bereitstellung exportiert werden. Die Parameter von rknn.export_rknn() sind:
export_path: Pfad der exportierten Modelldatei.
cpp_gen_cfg: bestimmt, ob beim Export ein C++-Bereitstellungsbeispiel erzeugt wird.
Codebeispiel:
ret = rknn.export_rknn(export_path='./mobilenet_v1.rknn')
Rufen Sie nach Abschluss der Konvertierung release() auf, um die vom RKNN-Objekt belegten Ressourcen freizugeben:
rknn.release()
2.1.5 Konvertierungsergebnis prüfen
Nach dem Export des RKNN-Modells empfiehlt sich eine Prüfung des Konvertierungsergebnisses:
Inferenzprüfung im Simulator: Initialisieren Sie auf dem PC den Simulator mit rknn.init_runtime(target=None), führen Sie rknn.inference() aus und vergleichen Sie die Ausgabe mit dem ursprünglichen Modell im ursprünglichen Framework. Mit dem Kosinusabstand lässt sich die Übereinstimmung prüfen, um Konvertierungsfehler zu erkennen.
Prüfung mit angeschlossenem Board: Verbinden Sie das Entwicklungsboard über USB mit dem PC und führen Sie die Inferenz über rknn.init_runtime(target=xxx) aus, um die Ergebnisse auf echter NPU-Hardware zu prüfen.
Hinweis: Ausführlichere Verfahren zur Genauigkeits-, Leistungs- und Speicherbewertung stehen in Abschnitt 2.3 „Modellbewertung“.
2.1.6 Modellkonvertierungswerkzeug rknn_convert
rknn_convert ist ein Satz häufig verwendeter Modellkonvertierungswerkzeuge von RKNN-Toolkit2. Die oben genannten APIs werden gekapselt: Nach Bearbeitung der zum Modell gehörenden yml-Konfigurationsdatei genügt ein Befehl zur Konvertierung. Es folgen ein Aufrufbeispiel und die unterstützten Befehlsparameter:
python -m rknn.api.rknn_convert -t rk3588 -i ./model_config.yml -o ./output_path
Mit diesen Befehlen und Parametern werden Modelle in das RKNN-Format konvertiert und unter dem angegebenen Ausgabepfad gespeichert. Die unterstützten Parameter sind:
-i: Pfad zur Modellkonfigurationsdatei (.yml).
-o: Ausgabepfad des konvertierten Modells.
-t: target_platform; Zielplattform rv1103, rv1103b, rv1106, rv1106b, rv1126b, rk2118, rk3562, rk3566, rk3568, rk3576 oder rk3588.
-e: optionale Bewertung von Laufzeit und Speicherverbrauch auf dem angeschlossenen Board; mit -e aktivieren. Das passende Board muss angeschlossen und target_platform korrekt gesetzt sein, sonst tritt ein Fehler auf. Bei mehreren Geräten die Geräte-ID mit -d angeben.
-a: optionale Genauigkeitsbewertung des erzeugten rknn-Modells. Für die Simulatorbewertung -a “xx1.jpg xx2.jpg” angeben. Für die Bewertung auf einem angeschlossenen Board zusammen mit -d verwenden.
-v: optionale ausführliche Protokollausgabe auf dem Bildschirm; mit -v aktivieren.
-d: Bei einem adb-Gerät -d, bei mehreren Geräten -d device_id verwenden. device_id lässt sich mit adb devices ermitteln.
Nachfolgend steht eine beispielhafte yml-Konfigurationsdatei (object_detection.yml):
models:
   # model output name
   name: object_detection
   # Original model framework
   platform: onnx
   # Model input file path
   model_file_path: ./object_detection.onnx
   # Describe information such as input and output shapes
   subgraphs:
     # model input tensor shape
     input_size_list:
       - 1,3,512,512
     # input tensor name
     inputs:
       - data
     # output tensor name
     outputs:
       - conv6-1
       - conv6-2
       - conv6-3
   # quantification flag
   quantize: true
   # Quantify dataset file path (relative yml path)
   dataset: ./dataset.txt
   configs:
     quantized_dtype: asymmetric_quantized-8
     # rknn.config mean_values
     mean_values: [127.5,127.5,127.5]
     # rknn.config std_values
     std_values: [128.0,128.0,128.0]
     # rknn.config quant_img_RGB2BGR
     quant_img_RGB2BGR: false
     # rknn.config quantized_algorithm
     quantized_algorithm: normal
Die Konfiguration enthält Modellname, ursprüngliches Framework, Modelldateipfade, Ein- und Ausgabeinformationen, Quantisierungseinstellung und weitere Angaben. Passen Sie die Datei an die Anforderungen des jeweiligen Modells an.
Die folgende Tabelle beschreibt die Konfiguration der Modellkonvertierung:
Tabelle 2-1: Konfigurationsparameter der Modellkonvertierung mit rknn_convert
| Parameter | Einzutragender Inhalt |
|---|---|
| -name | Name des Ausgabemodells |
| -platform | Framework des ursprünglichen Modells: tensorflow, tflite, caffe, onnx, pytorch, darknet |
| -model_file_path | Pfad der ursprünglichen Modelldatei bei einer einzelnen Datei, etwa tensorflow, tflite, onnx, pytorch |
| -quantize | Ob Quantisierung aktiviert wird |
| -dataset | Pfad zur Quantisierungsdatensatzdatei relativ zur yml-Konfiguration. Bei aktiviertem accuracy_analysis erforderlich |
| -prototxt_file_path | prototxt-Datei des Modells bei platform=caffe |
| -caffemodel_file_path | caffemodel-Datei des Modells, wenn platform auf caffe gesetzt ist |
| -darknet_cfg_path | cfg-Datei des Modells, wenn platform auf darknet gesetzt ist |
| -darknet_weights_path | Gewichtsdatei des Modells, wenn platform auf darknet gesetzt ist |
| -subgraphs | Beschreibt Ein- und Ausgabeformen sowie weitere Angaben. Außer bei bestimmten Frameworks müssen dieser Parameter und seine Unterparameter gewöhnlich nicht ausgefüllt werden; es gelten die Standardwerte des Modells |
| —-input_size_list | Form des Eingabetensors (Unterparameter) |
| —-inputs | Name des Eingabetensors (Unterparameter) |
| —-outputs | Name des Ausgabetensors (Unterparameter) |
| -configs | Zugehörige Konfiguration von rknn.config() |
| —-quantized_dtype | Quantisierungstyp. Bei RKNN_toolkit2 ist [asymmetric_quantized-8] möglich. Ohne Angabe gilt der Standardwert (Unterparameter) |
| —-mean_values | Mittelwerte zur Eingabenormalisierung. Für ein RGB-Modell mit einer Eingabe beispielsweise [123.675,116.28,103.53], bei mehreren Eingaben [[123,116,103], [255,255,255]] (Unterparameter) |
| —-std_values | Standardabweichungen zur Eingabenormalisierung. Für ein RGB-Modell mit einer Eingabe beispielsweise [58.395,58.295,58.391], bei mehreren Eingaben [[127,127,127], [255,255,255]] (Unterparameter) |
| —-quant_img_RGB2BGR | Bestimmt, ob Kalibrierungsbilder beim Laden für die Quantisierung zunächst von RGB nach BGR konvertiert werden. Standard False (Unterparameter) |
| —-quantized_algorithm | Quantisierungsalgorithmus: [‘normal’, ‘kl_divergence’, ‘mmse’]; Standard normal (Unterparameter) |
| —-quantized_method | Quantisierungsmethode. Bei RKNN_toolkit2 sind [‘layer’, ‘channel’] möglich; Standard channel (Unterparameter) |
| —-optimization_level | Optimierungsstufe. Der Standardwert 3 aktiviert alle standardmäßigen Optimierungsoptionen (Unterparameter) |
| —-model_pruning | Beschneidung des Modells zur Größenreduzierung. Standard false; zum Aktivieren true setzen (Unterparameter) |
| —-quantize_weight | Verringert bei quantize=false die Größe des rknn-Modells durch Quantisierung bestimmter Gewichte. Standard false; zum Aktivieren true setzen (Unterparameter) |
| —-single_core_mode | Bestimmt, ob ausschließlich ein Modell für einen Kern erzeugt wird. Dies kann Größe und Speicherbedarf des RKNN-Modells reduzieren. Standard False. Derzeit wirksam für RK3588/RK3576 (Unterparameter) |
2.1.7 Quantisierungsfunktionen von RKNN-Toolkit2
RKNN-Toolkit2 stellt mehrere Quantisierungsmethoden und -algorithmen bereit. Sie werden über quantized_algorithm und quantized_method in rknn.config() gewählt. Dieser Abschnitt beschreibt die gebräuchlichen Algorithmen Normal / MMSE / KL-Divergence und die Methoden Layer / Channel. Der GDQ-Algorithmus und die Group-Quantisierung werden in Abschnitt 2.2.3 „Interner Quantisierungsablauf“ erläutert. Im Folgenden werden die genannten Algorithmen und Verfahren zur Merkmalsquantisierung vorgestellt:
Quantisierungsalgorithmen
Der Normal-Algorithmus bestimmt die Grenzen des Quantisierungsbereichs direkt aus den größten und kleinsten Gleitkommawerten der Modellmerkmale. Er ist schnell, arbeitet jedoch bei unausgeglichenen Merkmalsverteilungen weniger gut. Empfohlen werden gewöhnlich etwa 20–100 Bilder für die Quantisierung.
Der MMSE-Algorithmus bestimmt die Bereichsgrenzen durch Minimierung des mittleren quadratischen Fehlers zwischen ursprünglichen Gleitkommawerten und den nach Quantisierung und Dequantisierung erhaltenen Gleitkommawerten. Große Ausreißer verursachen dadurch teilweise geringere Genauigkeitsverluste. Die iterative vollständige Suche ist langsamer, erzielt aber meist höhere Genauigkeit als normal. Empfohlen werden ungefähr 20–50 Bilder; die Anzahl lässt sich nach der Quantisierungsdauer anpassen.
Der KL-Divergence-Algorithmus betrachtet Gleitkomma- und Festkommawerte der Modellmerkmale als zwei Verteilungen. Er aktualisiert diese durch Anpassung der Schwellenwerte und bestimmt die Bereichsgrenzen anhand ihrer mit der KL-Divergenz gemessenen Ähnlichkeit. Er benötigt mehr Zeit als normal, aber deutlich weniger als mmse, und kann bei ungleichmäßiger Merkmalsverteilung gute Verbesserungen erzielen. Empfohlen werden gewöhnlich 20–100 Bilder.
Quantisierungsmethoden:
Layer: Alle Kanäle einer Netzwerkschicht werden gemeinsam quantisiert und verwenden dieselben Quantisierungsparameter.
Channel: Jeder Ausgabekanal einer Schicht wird unabhängig mit eigenen Quantisierungsparametern quantisiert. Die Genauigkeit ist gewöhnlich höher als bei Layer.
Wählen Sie Algorithmus und Merkmalsquantisierung anhand der Anforderungen und der tatsächlich erzielten Ergebnisse des Modells. Weitere Einzelheiten stehen in Abschnitt 2.2 „Modellquantisierung“.
Der GDQ-Algorithmus gilt nur für w4a16 und w8a16 und kann deren Gewichtsquantisierung deutlich genauer machen. Empfohlen wird ein Datensatz mit mehr als 200 Bildern. Einzelheiten stehen in Abschnitt 2.2.3.2 „Interne Quantisierungsalgorithmen“.
2.1.8 Modell-Pruning
Pruning kann verlustbehaftet oder verlustfrei sein. RKNN-Toolkit2 verwendet verlustfreies Pruning: Modellgröße und Rechenaufwand werden ohne Verschlechterung der Gleitkommagenauigkeit reduziert. Die Quantisierungsgenauigkeit kann sich sogar verbessern.
Verlustfreie Beschneidung ist jedoch nicht bei allen Modellen möglich. Anhand der Gewichtssparsität entfernt sie Gewichte und Merkmalskanäle ohne Einfluss auf das Modell und reduziert dadurch Modellgröße und Rechenaufwand. Nach Aktivierung durch Setzen von model_pruning in rknn.config() auf True) wird das Modell während der Konvertierung automatisch entsprechend seiner Gewichtssparsität beschnitten.
Bei erfolgreichem Pruning erscheint folgendes Ergebnis:
I model_pruning results:

I Weight: -1.12145 MB (-6.9%)

I GFLOPs: -0.15563 (-13.4%)
Hier wurden 1.12145 MB Gewichte beziehungsweise 6.9% entfernt und der Rechenaufwand um 0.15563 GFLOPs beziehungsweise 13.4% verringert.
Bei unzureichender Sparsität erfolgt keine Bearbeitung und auch keine entsprechende Ausgabe. Die Einstellung beeinträchtigt daher die normale Modellkonvertierung nicht.
2.1.9 ONNX-Modell bearbeiten
Nach der Konvertierung einiger Modelle nach RKNN können überflüssige Operationen verbleiben, insbesondere reshape und transpose an Ein- und Ausgängen, die die Inferenzleistung beeinträchtigen. Mit onnx_edit in RKNN-Toolkit2 lassen sich die Ein- und Ausgabedimensionen eines ONNX-Modells ändern, um bei der anschließenden Konvertierung ein leistungsfähigeres RKNN-Modell mit weniger unnötigen reshape- und transpose-Operationen zu erhalten.
2.1.9.1 Schnittstellenbeschreibung
Anwendungsbeispiel:
from rknn.utils import onnx_edit
ret = onnx_edit(model = './concat_block.onnx',
  export_path = './concat_block_edited.onnx',
  inputs_transform = {'k_in': 'a,b,c,d->1,ad,b,c'},
  outputs_transform = {'k_cache': 'a,b,c,d->1,ab,c,d'},
  dataset = './dataset.txt'
)
Model gibt das zu bearbeitende Modell an und ist erforderlich.
Export_path gibt den Ausgabepfad des neuen Modells an und ist erforderlich.
Inputs_transform ist ein Wörterbuch der Eingabetransformationen: Schlüssel ist der Knotenname, Wert die Transformationsformel. Optional; standardmäßig ein leeres Wörterbuch.
Outputs_transform ist ein Wörterbuch der Ausgangstransformationen. Optional; standardmäßig ein leeres Wörterbuch.
dataset gibt eine Datei mit den Pfaden der Eingabedaten an. Es gelten dieselben Formatanforderungen wie für dataset in rknn.build. Wenn angegeben, passt onnx_edit nicht nur die Ein- und Ausgabedefinitionen des Modells, sondern auch die zugehörigen Datensatzdaten an und erzeugt einen neuen Datensatz im Verzeichnis auf derselben Ebene wie export_path. Dieser kann zur Prüfung und Quantisierung des neuen Modells verwendet werden. Der Parameter ist optional und standardmäßig leer.
2.1.9.2 Transformationsformeln
inputs_transform und outputs_transform von onnx_edit enthalten Transformationsformeln mit einer dem Operator einsum ähnlichen Syntax. Beispielsweise transformiert ‘a,b,c,d->1,ad,b,c’ die ursprünglichen Dimensionen ‘a,b,c,d’ nach ‘1,ad,b,c’. Es gelten folgende Regeln:
Die Formel besteht aus zwei durch ‘->’ getrennten Teilen: links die ursprüngliche symbolische Form, rechts die transformierte.
Zulässig sind nur [a-z], ‘,’ und ‘1’. Andere Ziffern werden nicht unterstützt, weil identische Zahlensymbole den Kontext einer transpose-Operation nicht eindeutig bestimmen.
Die Zeichen [a-z] sind unabhängig und besitzen keine Reihenfolge: ‘a,b->b,a’ und ‘c,a->a,c’ bezeichnen dieselbe Transformation.
Die ursprüngliche Form links wird durch ‘,’ in n Teile getrennt; n muss der Dimensionszahl des Modells entsprechen. Für [32,4,1,64] sind beispielsweise ‘a,b,c,d’ oder ‘a,b,1,d’ zulässig.
Jedes ursprüngliche Symbol außer ‘1’ muss in der transformierten Form vorkommen. ‘a,1,c,d->ac,d,1’ ist beispielsweise gültig, ‘a,1,c,d->ac,1’ dagegen ungültig, weil ‘d’ fehlt.
In die transformierte Form dürfen beliebig viele ‘1’ eingefügt werden, um Dimensionen hinzuzufügen, beispielsweise ‘a,b,c-> a,1,cb,1,1’.
Zum Aufteilen einer Dimension erlaubt die ursprüngliche Form mehrere Buchstaben und Zuweisungen. Bei [32,4,1,64] bedeutet ‘ab,c,d,qk[a=2,k =8]->aq,cd,1,kb’: 32 in 2x16 und 64 in 8x8 aufteilen, anschließend transpose und reshape ausführen. Der Teil ‘[ ]’ enthält durch ‘,’ getrennte Zuweisungen. Nicht zugewiesene Werte werden automatisch abgeleitet: Bei a=2 und ab=32 ergibt sich b=16. Ungültige abgeleitete Dimensionen lösen einen Fehler aus: Bei ab=32 und a=5 wäre b=6.4, Dimensionen müssen jedoch ganzzahlig sein.
2.1.9.3 Beispiele für Transformationsformeln
Dreidimensionale Eingabe in vierdimensionale umwandeln: ‘a,b,c->a,b,1,c’
Fünfdimensionale Eingabe in vierdimensionale umwandeln: ‘a,b,c,d,e->ab,c,d,e’
Operation transpose(0,3,1,2): ‘a,b,c,d->a,d,b,c’
Dimensionen vertauschen und zusammenfassen: ‘a,b,c,d->d,acb,1’
Dimensionen aufteilen, vertauschen und zusammenfassen: ‘a,bc,de,f[b=2,d=4]->ab,fe,dc,1’