
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 4/22
模型转换与 ONNX 编辑
2. 模型转换、量化与评估
2.1 通用模型转换
RKNN-Toolkit2提供了丰富的功能,包括模型转换、性能分析、部署调试等。本节将重点介绍RKNN-Toolkit2的模型转换功能。模型转换是RKNN-Toolkit2的核心功能之一,它允许用戶将各种不同框架的深度学习模型转换为RKNN格式以在RKNPU上运行。整体流程为:模型准备 → 配置转换参数 → 加载并构建模型 → 导出RKNN模型→ 验证转换结果。用戶可参考如下模型转换流程图以理解如何进行模型转换。
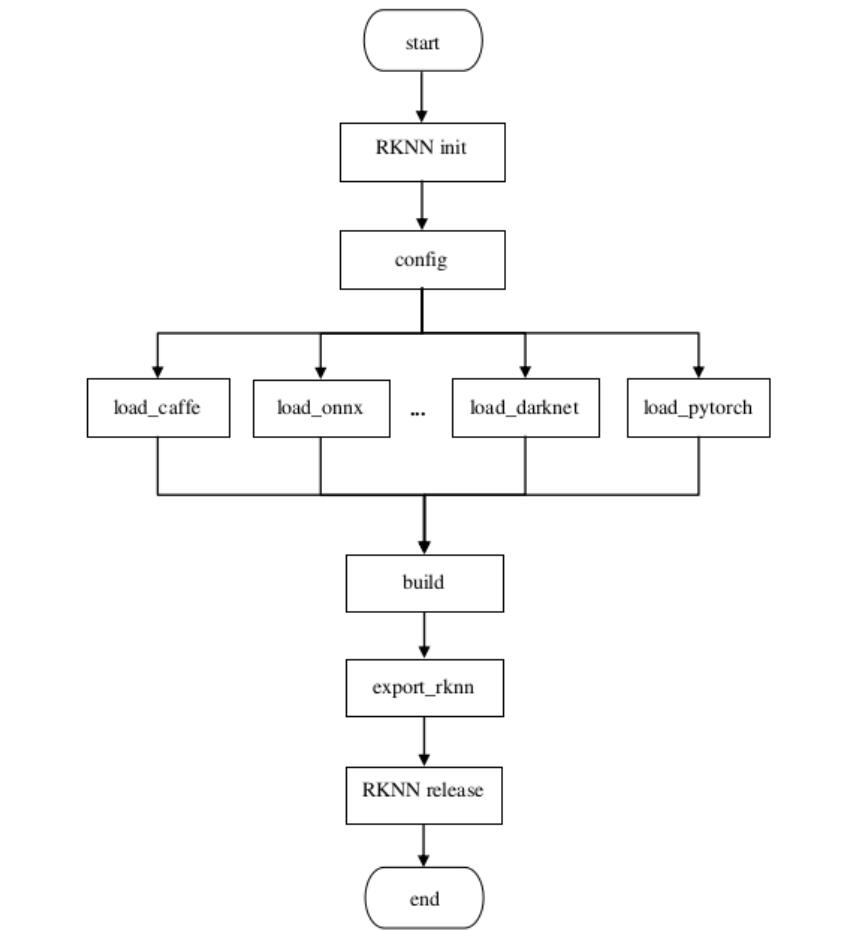
图2-1 模型转换流程图
目前RKNN-Toolkit2支持多个主流深度学习框架的模型转换,包括:
Caffe
TensorFlow
TensorFlow Lite
ONNX
PyTorch
Darknet
用戶可以使用上述框架训练或获取预训练模型并将它们转换为RKNN格式,方便更高效地在RKNPU平台上部署和推理。
2.1.1 模型准备
模型转换的输入为各深度学习框架训练或导出的原始模型。转换前需完成以下准备:
模型来源:使用 RKNN-Toolkit2 所支持框架(Caffe / TensorFlow / TensorFlow Lite / ONNX /PyTorch / DarkNet)训练或获取的预训练模型,并确保模型在原始框架下推理正确。
输入输出信息:明确模型的输入输出节点名称、输入shape、数据类型等信息。部分框架模型加载时需显式指定这些信息(如 TensorFlow 的 inputs / outputs / input_size_list,PyTorch 的input_size_list),后续配置和加载接口会使用到。
模型检查:转换前建议使用 Netron 等工具检查模型结构,确认模型导出正确、算子受支持;对 ONNX 模型可先用 onnxruntime 验证推理结果是否与原始框架一致。
2.1.2 转换配置
在模型转换之前,用戶需要进行一些配置以确保模型转换的正确性和性能。配置参数通过 rknn.config() 接口设置,包括归一化参数、量化方法、目标平台等。下面列出了一些常用的配置参数:
mean_values和std_values: 用于设置输入的均值和归一化值。这些值在量化过程中使用,且C API推理阶段图片不需再做均值和归一化值,减少部署耗时。
quant_img_RGB2BGR: 用于控制量化阶段加载的量化校正图像是否需要进行RGB到BGR的转换,默认值为False。该配置只在量化时生效,模型部署阶段不会生效,需要用戶在处理输入数据时提前做好相应转换。注:quant_img_RGB2BGR = True时输入数据的处理顺序为先做RGB2BGR转换(用戶自行完成)再做归一化操作(运行时内部完成),详细注意事项请参考5.4.3 模型转换常用参数说明章节。
target_platform: 用于指定RKNN模型的目标平台,支持RK2118、RK3562、RK3566、RK3568、RK3576、RK3588、RV1103、RV1103B、RV1106、RV1106B、 RV1126B。
quantized_algorithm: 用于指定计算每一层的量化参数时采用的量化算法,可以选择normal、mmse、kl_divergence或gdq,默认算法为normal,详细说明参考2.1.7 RKNN-Toolkit2模型量化功能、2.2.1量化基本概念和2.2.3 内部量化流程章节。
quantized_method: 支持 layer 、 channel 或 group{SIZE} ,用于每层的权重是否共享参数,默认为 channel ,详细说明见2.1.7 RKNN-Toolkit2模型量化功能、2.2.1 量化基本概念和2.2.3 内部量化流程章节。
optimization_level: 通过修改模型优化等级,可以关掉部分或全部模型转换过程中使用到的优化规则。该参数的默认值为 3,打开所有优化选项,值为2或1时关闭一部分可能会对部分模型精度产生影响的优化选项,值为0时关闭所有优化选项。
quantized_dtype: 用于指定量化类型,目前支持线性非对称量化的INT8,默认为’asymmetric_quantized-8’。
custom_string: 添加自定义字符串信息到RKNN模型,例如模型自身迭代的版本信息等。在模型部署阶段可以通过 rknn_query 接口设置 RKNN_QUERY_CUSTOM_STRING 标志查询这些信息,方便部署时根据模型版本做特殊处理。默认值为 None 。
dynamic_input: 支持动态输入,根据用戶指定的多组输入shape,来模拟动态输入的功能,默认值为None,详细说明见4.1.3 动态Shape章节。
更具体的 rknn.config() 接口配置请参考《03_RKNN2_Toolkit_Python_API_参考_V2.5.0》手册。
示例代码:
rknn.config(
    mean_values=[[103.94, 116.78, 123.68]],
    std_values=[[58.82, 58.82, 58.82]],
    quant_img_RGB2BGR=False,
    target_platform='rk3566')
2.1.3 模型加载和构建
1. 初始化 RKNN 对象
在这一阶段,用戶需要先初始化RKNN对象,这是整个工作流程的第一步:
使用 RKNN() 构造函数来初始化RKNN对象,用戶可以传入参数 verbose 和 verbose_file 。
verbose 参数决定是否在屏幕上显示详细日志信息。
如果设置了 verbose_file 参数并且 verbose 为 True ,日志信息还将写入到指定的文件中。
示例代码:
rknn = RKNN(verbose=True, verbose_file='./mobilenet_build.log')
2. 模型加载接口
用戶需要使用相应的加载接口导入不同框架模型文件。RKNN-Toolkit2提供了不同的加载接口,包括Caffe、TensorFlow、TensorFlow Lite、ONNX、PyTorch等,下面是各种框架的模型加载接口的简要介绍:
Caffe模型加载接口:
使用 rknn.load_caffe() 接口加载Caffe模型。
需要提供模型文件( .prototxt 后缀)路径和权重文件( .caffemodel 后缀)路径。
如果模型有多个输入层,可以指定输入层名称的顺序。
示例代码:
ret = rknn.load_caffe(model='./mobilenet_v2.prototxt', blobs='./mobilenet_v2.caffemodel')
TensorFlow 模型加载接口:
使用 rknn.load_tensorflow() 接口加载TensorFlow模型。
需要提供TensorFlow模型文件( .pb 后缀)路径、输入节点名、输入节点的形状以及输出节点名。
示例代码:
ret = rknn.load_tensorflow(tf_pb='./ssd_mobilenet_v1_coco_2017_11_17.pb', inputs=['Preprocessor/sub'], outputs=
['concat', 'concat_1'], input_size_list=[[1, 300, 300, 3]])
TensorFlow Lite 模型加载接口:
使用 rknn.load_tflite() 接口加载TensorFlow Lite模型。
需要提供TensorFlow Lite模型文件(.tflite后缀)路径。
示例代码:
ret = rknn.load_tflite(model='./mobilenet_v1.tflite')
- ONNX 模型加载接口: - 使用rknn.load_onnx()接口加载ONNX模型。 - 需要提供 ONNX 模型文件(.onnx后缀)路径。
示例代码:
ret = rknn.load_onnx(model='./arcface.onnx')
DarkNet 模型加载接口:
使用 rknn.load_darknet() 接口加载DarkNet模型。
需要提供DarkNet模型文件( .cfg 后缀)路径和权重文件( .weights 后缀)路径。
示例代码:
ret = rknn.load_darknet(model='./yolov3-tiny.cfg', weight='./yolov3.weights')
- PyTorch 模型加载接口: - 使用rknn.load_pytorch()接口加载PyTorch模型。 - 需要提供PyTorch模型文件(.pt后缀)路径,模型必须是torchscript格式的。
示例代码:
ret = rknn.load_pytorch(model='./resnet18.pt', input_size_list=[[1, 3, 224, 224]])
用戶可以根据不同框架的模型选择合适的接口进行加载,确保模型转换的正确性。
3. 构建RKNN模型
用戶加载原始模型后,下一步就是通过 rknn.build() 接口构建RKNN模型。构建模型时,用戶可以选择是否进行量化,量化可以减小模型的大小和提高在RKNPU上的性能。 rknn.build() 接口参数如下:
do_quantization: 该参数控制是否对模型进行量化,建议设置为 True 。
dataset: 该参数指定用于量化校准的数据集,数据集的格式是文本文件。
dataset.txt示例:
./imgs/ILSVRC2012_val_00000665.JPEG
./imgs/ILSVRC2012_val_00001123.JPEG
./imgs/ILSVRC2012_val_00001129.JPEG
./imgs/ILSVRC2012_val_00001284.JPEG
./imgs/ILSVRC2012_val_00003026.JPEG
./imgs/ILSVRC2012_val_00005276.JPEG
示例代码:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
2.1.4 RKNN模型导出
用戶通过 rknn.build() 接口构建了 RKNN 模型后,可以通过 rknn.export_rknn() 接口导出RKNN模型文件( .rknn 后缀),以便后续模型的部署。 rknn.export_rknn() 接口参数如下:
export_path: 导出模型文件的路径。
cpp_gen_cfg: 该参数决定是否在导出模型的同时生成 C++ 部署示例。
示例代码:
ret = rknn.export_rknn(export_path='./mobilenet_v1.rknn')
转换流程完成后,调用 release() 接口释放RKNN对象占用的资源:
rknn.release()
2.1.5 转换结果验证
导出RKNN模型后,建议对转换结果进行验证,确认模型转换正确:
模拟器推理验证:在 PC 上通过 rknn.init_runtime(target=None) 使用模拟器对模型进行推理( rknn.inference() ),将输出与原始模型在原始框架下的推理结果进行对比(可用余弦距离判断一致性),确认转换过程未引入错误。
连板推理验证:将开发板通过 USB 连接到 PC,通过 rknn.init_runtime(target=xxx) 连板推理,验证模型在真实 NPU 上的运行结果。
说明:精度分析、性能评估、内存评估等更详细的评估方法见 2.3 模型评估。
2.1.6 模型转换工具RKNN
rknn_convert 是RKNN-Toolkit2提供的一套常用模型转换工具,通过封装上述API接口,用戶只需编辑模型对应的 yml 配置文件,就可以通过指令转换模型。以下是如何使用 rknn_convert 工具的示例命令以及支持的指令参数:
python -m rknn.api.rknn_convert -t rk3588 -i ./model_config.yml -o ./output_path
通过使用上述命令和参数,用戶可以将模型转换为RKNN格式,并将转换后的模型保存到指定的输出路径。支持的指令参数说明如下:
-i: 模型配置文件(.yml)路径。
-o: 转换后模型输出路径。
-t: target_platform,目标平台可以选择rv1103,rv1103b, rv1106,rv1106b,rv1126b, rk2118,rk3562,rk3566,rk3568,rk3576或rk3588。
-e: (选填) 评估连板运行时model的耗时和内存占用,若开启请输入-e。注:一定要连接相应开发板并正确设置 target_platform ,否则会报错,当有多设备时可通过 -d 参数指定设备ID。
-a: (选填)评估生成的rknn模型精度,开启模拟器精度评估请输入-a “xx1.jpg xx2.jpg”,若要开启连板精度评估请配合-d参数使用。
-v: (选填)指定是否要在屏幕上打印详细日志信息,若开启打印模式请输入-v。
-d: (选填)单个adb设备使用-d,多adb设备使用-d device_id,device_id通过adb devices查询。
下面是一个参考的yml配置文件( object_detection.yml ):
models:
   # model output name
   name: object_detection
   # Original model framework
   platform: onnx
   # Model input file path
   model_file_path: ./object_detection.onnx
   # Describe information such as input and output shapes
   subgraphs:
     # model input tensor shape
     input_size_list:
       - 1,3,512,512
     # input tensor name
     inputs:
       - data
     # output tensor name
     outputs:
       - conv6-1
       - conv6-2
       - conv6-3
   # quantification flag
   quantize: true
   # Quantify dataset file path (relative yml path)
   dataset: ./dataset.txt
   configs:
     quantized_dtype: asymmetric_quantized-8
     # rknn.config mean_values
     mean_values: [127.5,127.5,127.5]
     # rknn.config std_values
     std_values: [128.0,128.0,128.0]
     # rknn.config quant_img_RGB2BGR
     quant_img_RGB2BGR: false
     # rknn.config quantized_algorithm
     quantized_algorithm: normal
这个配置文件包括了模型的名称、原始模型使用的框架、模型文件路径、输入输出信息、是否进行量化等详细信息。用戶可以根据模型的特定需求编辑相应的配置文件。
模型转换配置详见下表:
表2-1 rknn_convert模型转换配置参数说明
| 参数名 | 填写内容 |
|---|---|
| -name | 模型输出名称 |
| -platform | 原始模型使用的框架,支持tensorflow、tflite、caffe、onnx、pytorch、darknet |
| -model_file_path | 原始模型文件路径,适用于单模型文件输入,例:tensorflow、tflite、onnx、 pytorch |
| -quantize | 是否开启量化 |
| -dataset | 量化dataset文件路径(相对yml配置文件路径),若要开启accuracy_analysis此项 必填 |
| -prototxt_file_path | platform为caffe时,模型的prototxt文件 |
| -caffemodel_file_path | platform为caffe时,模型的caffemodel文件 |
| -darknet_cfg_path | platform为darknet时,模型的cfg文件 |
| -darknet_weights_path | platform为darknet时,模型的weight文件 |
| -subgraphs | 描述输入输出shape等信息。除特定框架外,一般情况下该参数及附带的子参数可不 写,使用模型默认值 |
| —-input_size_list(子参数) | 输入tensor的shape |
| —-inputs(子参数) | 输入tensor的名称 |
| —-outputs(子参数) | 输出tensor的名称 |
| -configs | 对应rknn.config()配置 |
| —-quantized_dtype(子参数) | 量化类型,RKNN_toolkit2: 可填写 [asymmetric_quantized-8],不输入用默认值 |
| —-mean_values(子参数) | 输入的均值归一数,模型为单输入RGB如[123.675,116.28,103.53],若为多输入如 [[123,116,103],[255,255,255]] |
| —-std_values(子参数) | 输入的方差归一数,模型为单输入RGB如[58.395,58.295,58.391],若为多输入如 [[127,127,127],[255,255,255]] |
| —-quant_img_RGB2BGR(子 参数) | 用于控制量化时加载量化校正图像时是否需要先进行RGB到 BGR 的转换,默认值是 False |
| —-quantized_algorithm(子参 数) | 量化算法,可选[‘normal’, ‘kl_divergence’, ‘mmse’],默认为 normal |
| —-quantized_method(子参 数) | 量化方式,RKNN_toolkit2可选[‘layer’, ‘channel’],默认为channel |
| —-optimization_level(子参 数) | 设置优化级别。默认为3,表示使用所有默认优化选项 |
| —-model_pruning(子参数) | 修剪模型以减小模型大小,默认为false,开启为true |
| —-quantize_weight(子参数) | 当quantize参数为false时,通过量化一些权重来减小rknn模型的大小。默认为 false,开启为true |
| —-single_core_mode(子参数) | 是否仅生成单核模型,可以减小RKNN模型的大小和内存消耗。默认值为False。目前 对RK3588/RK3576生效。默认值为 False |
2.1.7 RKNN-Toolkit2模型量化功能
RKNN-Toolkit2提供多种量化方式和多种量化算法,用戶可以通过rknn.config()中的quantized_algorithm和quantized_method参数来选择。本节介绍常用的 Normal / MMSE / KL-Divergence 量化算法与 Layer /Channel 量化方式,GDQ 量化算法与 Group 量化方式见2.2.3 内部量化流程。以下是这些量化算法和特征量化方式的介绍:
量化算法:
Normal量化算法:通过计算模型中特征(feature)的浮点数最大值和最小值来确定量化范围的最大值和最小值。算法的特点是速度较快,但是遇到特征分布不均衡时效果较差,推荐量化数据量一般为20-100张左右。
MMSE量化算法:通过最小化浮点数与量化反量化后浮点数的均方误差损失确定量化范围的最大值和最小值,能够一定程度的缓解大异常值带来的量化精度丢失问题。由于采用暴力迭代的方式,速度较慢,但通常会比normal具有更高的精度,推荐量化数据量一般为20-50张左右,用戶也可以根据量化时间⻓短对量化数据量进行适当增减。
KL-Divergence量化算法:将模型特征(feature)中浮点数和定点数抽象成两个分布,通过调整不同的阈值来更新浮点数和定点数的分布,并根据KL散度衡量两个分布的相似性来确定量化范围的最大值和最小值。所用时间会比normal多一些,但比mmse会少很多,在某些场景下(feature分布不均匀时)可以得到较好的改善效果,推荐量化数据量一般为20-100张左右。
量化方式:
Layer量化方式:Layer量化方式将同一层网络的所有通道作为一个整体进行量化,所有通道共享相同的量化参数。
Channel量化方式:Channel量化方式将同一层网络的各个通道独立进行量化,每个通道有自己的量化参数。通常情况下,Channel量化方式比Layer量化方式具有更高的精度。
根据实际的模型量化效果和需求,用戶可以选择合适的量化算法和特征量化方式,更详细的量化说明和原理请见第2.2章(模型量化)。
GDQ量化算法:仅在w4a16和w8a16下有效,能有效提高w4a16和w8a16的权重量化精度,推荐量化数据集量200张以上,详细说明见2.2.3.2 内部量化算法。
2.1.8 模型剪枝
模型剪枝一般可分为有损剪枝和无损剪枝两种方式,RKNN-Toolkit2的模型剪枝为无损剪枝,也就是可以在减小模型大小和计算量的前提下,不会降低模型的浮点精度,甚至可以提高模型的量化精度。
但并不是所有模型都可以进行无损剪枝,无损剪枝是根据模型的权重的稀疏化程度,来去除一些对模型结果不造成影响的权重和Feature通道,以减小模型的大小和模型的计算量。在启用模型剪枝配置后(将rknn.config() 的 model_pruning 参数设为 True ),模型转换时会自动根据权重的稀疏化程度对模型进行剪枝。
如果模型剪枝成功,则会打印剪枝结果,如下:
I model_pruning results:

I Weight: -1.12145 MB (-6.9%)

I GFLOPs: -0.15563 (-13.4%)
其中,Weight剪掉了1.12145 MB(占比6.9%),模型运算量减少0.15563 GFLOPs(占比13.4%)。
如果因模型稀疏化程度不够而剪枝失败,则不会做任何处理(也不会打印上述信息),因此该配置并不会影响正常的模型转换。
2.1.9 ONNX模型编辑
部分模型在转RKNN模型后,可能存在冗余的op,常见于模型的输入输出节点处存在冗余的reshape、transpose op,影响了RKNN模型的推理性能。RKNN-Toolkit2提供了 onnx_edit 接口,用于修改ONNX模型的输入输出的维度定义,使调整后的onnx模型能转出性能更好的RKNN模型,减少冗余的reshape、transpose op。
2.1.9.1 ONNX_EDIT接口说明
使用示例:
from rknn.utils import onnx_edit
ret = onnx_edit(model = './concat_block.onnx',
  export_path = './concat_block_edited.onnx',
  inputs_transform = {'k_in': 'a,b,c,d->1,ad,b,c'},
  outputs_transform = {'k_cache': 'a,b,c,d->1,ab,c,d'},
  dataset = './dataset.txt'
)
model: 填入待修改模型,为必填参数
export_path: 填入新模型的生成路径,为必填参数
inputs_transform: 填入输入节点的变换公式字典, key 为节点名称, value 为变换公式。为可选参数,默认为空字典
outputs_transform: 填入输出节点的变换公式字典。为可选参数,默认为空字典
dataset: 填入输入数据的路径集文件,文件格式要求与 rknn.build 接口对 dataset 的要求一致。填入后, onnx_edit 接口除了对模型的输入输出定义进行调整,也会将 dataset 中对应的数据进行调整,在 export_path 同级目录下生成新的 dataset 数据,可用于新模型的验证、量化。为可选参数,默认为空。
2.1.9.2 ONNX_EDIT变换公式说明
onnx_edit接口中的 inputs_transform 、 outputs_transform 需要填入变换公式。变换公式的定义与einsum 算子的定义类似,例如’ a,b,c,d->1,ad,b,c ‘公式,指将原始的维度为’ a,b,c,d ‘,变换后为’ 1,ad,b,c ‘。变换公式的填写规则如下:
必须有两部分字符组成,并用 ‘->’ 隔开,左边为原始字符shape,右边是变换后字符shape
字符shape里面的符号只允许是 [a-z] 或 ‘,’ ‘1’,除了’1’以外,不支持其他数字shape字符,原因是相同数字字符无法判断 transpose 的前后关系
字符[a-z]认为是独立的,没有顺序关系,即 ‘a,b->b,a’ 和 ‘c,a->a,c’ 表示的是一样的变换
等式左边的原始字符shape,被 ‘,’ 分隔成 n 份,n的个数必须和模型的维度匹配,例如模型输入定义是[32,4,1,64], 输入字符可以是 ‘ a,b,c,d ‘ 或 ‘ a,b,1,d ‘
原始字符shape的每一个符号,除了’1’,都必须存在于变换后字符shape,例如 ‘ a,1,c,d->ac,d,1 ‘是有效的,’ a,1,c,d->ac,1 ‘ 是无效的,缺了 ‘d’
变换后字符shape,允许插入任意个数的 ‘1’,达成扩维效果,例如 ‘ a,b,c-> a,1,cb,1,1 ‘
原始字符shape,允许用多个字母以及赋值公式来表示对shape进行拆分,例如原始输入定义是[32,4,1,64],’ ab,c,d,qk[a=2,k=8]->aq,cd,1,kb ‘,表示将 32 拆分成 2x16,将 64 拆分成8x8,再进行 transpose, reshape 操作。其中 ‘[ ]’ 的部分称为赋值公式,多个公式用 ‘,’ 符号分隔。此外,允许拆分中的某个字符没有赋值,此时会自动推断对应的shape,例如赋值公式只给了 a=2,已知在模型中 ab=32,则自动推断出 b=16;若推断出的shape异常会直接报错,比如 ab=32,若赋值a=5,则 b=6.4,又维度必须是整数,此时会抛出异常错误。
2.1.9.3 变换公式示例
将3维输入修改为4维输入:’a,b,c->a,b,1,c’
将5维输入修改为4维输入:’a,b,c,d,e->ab,c,d,e’
进行transpose(0,3,1,2)操作:’a,b,c,d->a,d,b,c’
Transpose并合并部分维度:’a,b,c,d->d,acb,1’
拆分维度、transpose、合并维度:’a,bc,de,f[b=2,d=4]->ab,fe,dc,1’