
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 16/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
4.1.6 Konsistenz cachefähigen Speichers
Greifen CPU und NPU auf denselben cachefähigen Speicher zu, hält die CPU Daten im Cache. Weichen die von der NPU gelesenen DDR-Daten davon ab, entstehen Lesefehler. Eine Cache-Aktualisierung muss deshalb konsistente Daten für CPU und NPU sicherstellen. Dieser Abschnitt beschreibt Synchronisationsrichtung und Verwendung von rknn_mem_sync.
4.1.6.1 Synchronisationsrichtung cachefähigen Speichers
Nach CPU-Schreibzugriffen müssen die CPU-Cache-Daten vor einem NPU-Zugriff mit DDR synchronisiert werden: Richtung CPU→NPU. Nach NPU-Schreibzugriffen muss vor dem CPU-Lesen die Konsistenz zwischen DDR und CPU-Cache hergestellt werden: Richtung NPU→CPU. Die RKNN-C-API bietet dafür die Enumeration rknn_mem_sync_mode. Datenstruktur:
/*
  The mode to sync cacheable rknn memory.
*/
typedef enum _rknn_mem_sync_mode {
RKNN_MEMORY_SYNC_TO_DEVICE = 0x1, /* the mode used for consistency of device access after CPU accesses
data. */
RKNN_MEMORY_SYNC_FROM_DEVICE = 0x2, /* the mode used for consistency of CPU access after device
accesses data. */
RKNN_MEMORY_SYNC_BIDIRECTIONAL =
  RKNN_MEMORY_SYNC_TO_DEVICE | RKNN_MEMORY_SYNC_FROM_DEVICE, /* the mode used for
consistency of data access
between device and CPU in both directions. */
} rknn_mem_sync_mode;
RKNN_MEMORY_SYNC_TO_DEVICE: Synchronisation von CPU zu NPU.
RKNN_MEMORY_SYNC_FROM_DEVICE: Synchronisation von NPU zu CPU.
RKNN_MEMORY_SYNC_BIDIRECTIONAL: Synchronisation in beide Richtungen zwischen NPU und CPU. Verwendbar, wenn die Datenrichtung nicht sicher bekannt ist.
Ist die Richtung bekannt, wird eine einseitige CPU-Cache-Aktualisierung empfohlen, um Leistungseinbußen durch unnötige Operationen zu vermeiden.
4.1.6.2 Cachefähigen Speicher synchronisieren
Nach Festlegen der Richtung synchronisieren Sie den Speicher mit rknn_mem_sync. Schnittstellenform:
int rknn_mem_sync(rknn_context context, rknn_tensor_mem* mem, rknn_mem_sync_mode mode);
Dabei bezeichnet context den Kontext (auf anderen Plattformen als RV1103/RV1103B/RV1106/RV1106B standardmäßig NULL), mem den von rknn_create_mem zurückgegebenen Zeiger vom Typ rknn_tensor_mem* und mode die Richtung der Datensynchronisierung.
4.1.7 Inferenz mit dünn besetzten Modellen
Die Funktion dünnt Torch-Modellgewichte beim Training automatisch aus und nutzt RKNN-Sparse-Inferenz zur Verkürzung der Laufzeit. Unterstützt werden derzeit nur RK3576 und RK1126B (Quellbezeichnung).
4.1.7.1 Prinzip der Ausdünnung
Gewichte werden während des Trainings benutzerdefiniert auf null gesetzt: 4:2 in Eingaberichtung, 4:2 in Ausgaberichtung, 16:4 Eingabe/Ausgabe oder 16:4 Ausgabe/Eingabe. Das 4:2-Prinzip in Eingaberichtung zeigt Abbildung 4-9: Je zwei von vier aufeinanderfolgenden Gewichten werden auf null gesetzt. Ist die gewählte Richtung nicht auf 4 ausgerichtet, wird aufgefüllt.
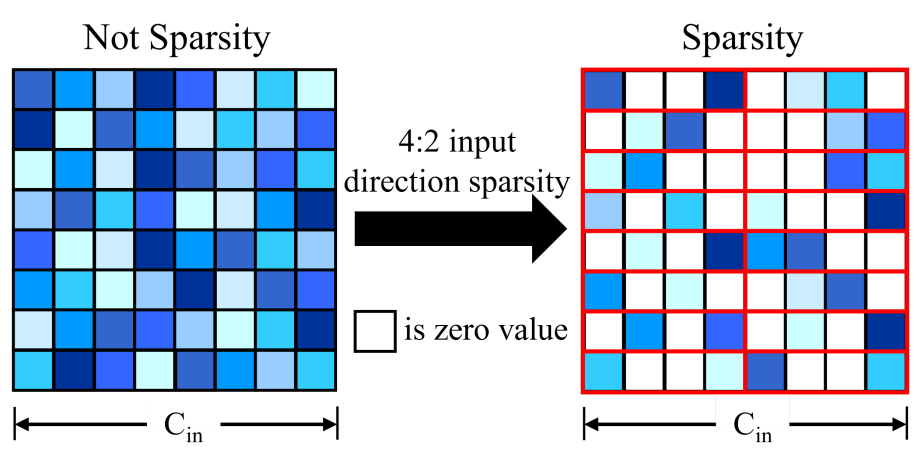
Abbildung 4-9. 4:2-Sparsität in Eingaberichtung
Tabelle 4-8 beschreibt vier Verfahren. Richtungen beziehen sich auf Gewichte: Bei 2D-Faltung C_out×C_in×K_h×K_w ist die Eingaberichtung C_in, die Ausgaberichtung C_out. Für 75% Sparsität kann das vortrainierte Modell dicht oder dünn besetzt sein. Ein einseitig ausgedünntes Modell wird empfohlen, um Genauigkeitsverluste zu verringern.
Tabelle 4-8. Verfahren zur Gewichtssparsifizierung
| Sparsifizierungsverfahren | Sparsitätsgrad | Beschreibung |
|---|---|---|
| 4:2-Sparsifizierung in Eingaberichtung | 50% | Gewichte in Eingaberichtung ausdünnen |
| 4:2-Sparsifizierung in Ausgaberichtung | 50% | Gewichte in Ausgaberichtung ausdünnen |
| 16:4-Sparsifizierung Eingabe/Ausgabe | 75% | Zuerst 4:2 in Eingabe-, dann 4:2 in Ausgaberichtung |
| 16:4-Sparsifizierung Ausgabe/Eingabe | 75% | Zuerst 4:2 in Ausgabe-, dann 4:2 in Eingaberichtung |
4.1.7.2 Training eines dünn besetzten Modells
- Verfügbarkeit von cuda prüfen und autosparsity für die passende Python-Version installieren.
pip install autosparsity-1.0-cp38-cp38m-linux_x86_64.whl
Das Installationspaket für autosparsity befindet sich unter https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/packages
- Beispiel für Training dünn besetzter Gewichte: torchvision-resnet50 mit 4:2 in Eingaberichtung.
import torch
import torchvision.models as models
from autosparsity.sparsity import sparsity_model

if __name__ == "__main__":
  model = models.resnet50(pretrained=True).cuda()
  optimizer = None
  mode = 0
  sparsity_model(model, optimizer, mode)
  model.eval()
  x = torch.randn((1,3,224,224)).cuda()
  torch.onnx.export(
  model, x, 'resnet50.onnx', input_names=['inputs'], output_names=['outputs']
  )
Für eigene Modelle sparsity_model vor dem Training hinzufügen. Beispiel:
# insert model autosparsity code before training
    import torch
    import torchvision.models as models
    from autosparsity.sparsity import sparsity_model

    ...

    model = models.resnet34(pretrained=True).cuda()
    mode = 0
    sparsity_model(model, optimizer, mode)

# normal training
    x, y = DataLoader(args)
    for epoch in range(epochs):
        y_pred = model(x)
        loss = loss_func(y_pred, y)
        loss.backward()
        optimizer.step()
    ...
Hinweis: Sparse-Training von Attention-Modellen setzt ein gut trainiertes Ausgangsmodell voraus. Zunächst ein Modell mit guter Genauigkeit trainieren und erst darauf aufbauend sparsifizieren.
Parameter von sparsity_model:
Tabelle 4-9. Parameter der Funktion sparsity_model
| Parameter | Beschreibung |
|---|---|
| model | Ursprüngliches Trainingsmodell |
| Parameter | Beschreibung |
|---|---|
| optimizer | Ursprünglicher Optimierer; Standard None |
| mode | Sparsifizierungsmethode: 0, 1, 2, 3; Standard 0. 0: 4:2 Eingabe (50%); 1: 4:2 Ausgabe (50%); 2: 16:4 Eingabe/Ausgabe (75%); 3: 16:4 Ausgabe/Eingabe (75%). |
| verbose | Protokollstufe: 0, 1, 2, 3; Standard 2. 0: Fehler; 1: Fehler und Warnungen; 2: Fehler, Warnungen und Informationen. |
| whitelist | Liste sparsifizierbarer Module: 1d conv, 2d conv, 3d conv, linear, MultiheadAttention. Standard [torch.nn.Linear, torch.nn.Conv2d]. |
| allowed_layer_names | Zulässige Layernamen. Bei Benutzervorgabe werden nur diese Layer sparsifiziert. Standard None. |
| disallowed_layer_names | Ausgeschlossene Layernamen. Angegebene Layer werden übersprungen. Standard []. |
| fast | True aktiviert eine schnelle Maskenberechnung, Standard False. Die Standardmethode scheitert bei manchen Modellen; bei Sparsifizierungsfehlern True versuchen. |
4.1.7.3 Dünn besetzte Inferenz mit RKNN verwenden
sparse_infer in config() von RKNN-Toolkit2 aktiviert oder deaktiviert Sparse-Inferenz. Werte True/False, Standard False. Aktivierungsbeispiel:
rknn.config(target_platform=’rk3576’, sparse_infer=True)
Vollständiges Python-Beispiel: https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/examples
Für die C-API zuerst mit sparse_infer=True in RKNN-Toolkit2 config() ein Sparse-RKNN-Modell erzeugen und danach den normalen allgemeinen oder Zero-Copy-Ablauf verwenden.
In Python aktiviert verbose=True beim Erstellen des RKNN-Objekts das Sparsitätsprotokoll jeder Schicht; für die C-API RKNN_LOG_LEVEL=4 setzen. Beispielprotokoll:
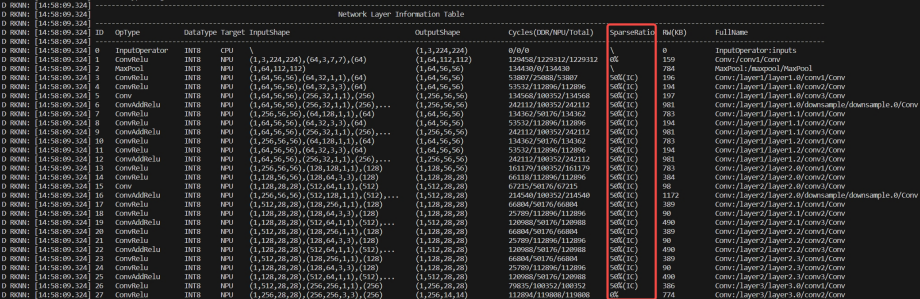
Abbildung 4-10. Python-Protokoll für 4:2-Eingabesparsität
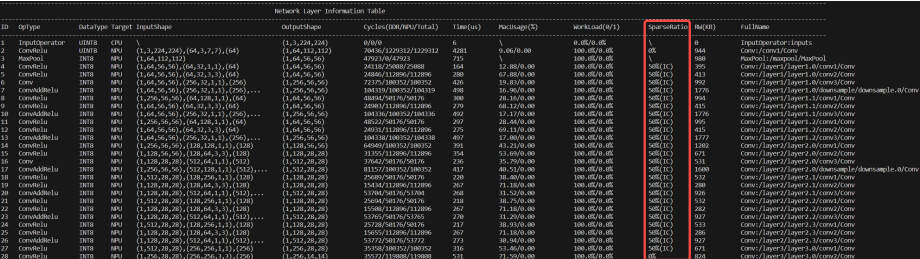
Abbildung 4-11. C-API-Protokoll für 4:2-Eingabesparsität
SparseRation bezeichnet den Sparsitätsgrad: 4:2 Eingabe entspricht 50% (IC), 4:2 Ausgabe 50% (OC), beide 16:4-Reihenfolgen 75%. 0% bedeutet keine Sparsifizierung.
4.1.7.4 Einschränkungen der dünn besetzten RKNN-Inferenz
Sparse-Inferenz basiert auf NPU-Hardware und unterliegt deren Grenzen. RK3576 unterstützt derzeit nur 2d Conv mit group=1. Weitere Einschränkungen:
Tabelle 4-10. Grenzen der RKNN-Sparse-Inferenz
| Kanalanzahl | Datentyp | |
|---|---|---|
| 4:2-Sparsifizierung in Eingaberichtung | Ein- und Ausgabe auf 32 ausgerichtet | Nur Int8 unterstützt; Float16 nicht unterstützt |
| 4:2-Sparsifizierung in Ausgaberichtung | Ein- und Ausgabe auf 32 ausgerichtet | Nur Int8 unterstützt; Float16 nicht unterstützt |
| 16:4-Sparsifizierung Eingabe/Ausgabe | Ein- und Ausgabe auf 32 ausgerichtet | Nur Int8 unterstützt; Float16 nicht unterstützt |
| 16:4-Sparsifizierung Ausgabe/Eingabe | Ein- und Ausgabe auf 32 ausgerichtet | Nur Int8 unterstützt; Float16 nicht unterstützt |