
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 16/22
缓存一致性与稀疏化推理
4.1.6 Cacheable内存一致性
Cacheable内存一致性问题是指当CPU和NPU设备都会访问同一块带cache标志的内存时,CPU会将数据缓存到cache中,如果NPU访问到的DDR数据与CPU cache不一致,会导致读取数据错误。因此要调用刷新cache的接口保证CPU和NPU访问到的DDR内存数据是一致的。本章节介绍了同步数据的方向以及如何使用rknn_mem_sync 接口刷新cache。
4.1.6.1 CACHEABLE内存同步的方向
当CPU写数据到cacheable的内存,之后NPU访问该内存时,要保证CPU cache的数据同步到DDR中,此时同步的方向是指从CPU到NPU设备;当NPU写完数据,CPU开始访问该内存时,要保证DDR的数据与CPU cache中的一致,此时同步的方向是指从NPU设备到CPU。RKNN C API提供了 rknn_mem_sync_mode 枚举类型表示cacheable内存同步的方向,数据结构如下:
/*
 The mode to sync cacheable rknn memory.
*/

typedef enum _rknn_mem_sync_mode {

RKNN_MEMORY_SYNC_TO_DEVICE = 0x1, /* the mode used for consistency of device access after CPU accesses
data. */

RKNN_MEMORY_SYNC_FROM_DEVICE = 0x2, /* the mode used for consistency of CPU access after device
accesses data. */

RKNN_MEMORY_SYNC_SYNC_BIDIRECTIONAL =
  RKNN_MEMORY_SYNC_TO_DEVICE | RKNN_MEMORY_SYNC_FROM_DEVICE, /* the mode used for
consistency of data access
between device and CPU in both directions. */

} rknn_mem_sync_mode;
RKNN_MEMORY_SYNC_TO_DEVICE :表示数据同步方向是CPU到NPU设备
RKNN_MEMORY_SYNC_FROM_DEVICE :表示数据同步方向是NPU设备到CPU
RKNN_MEMORY_SYNC_SYNC_BIDIRECTIONAL:表示数据在NPU和CPU之间双向同步在用戶不确定同步数据的方向时可以使用该枚举
在明确数据同步方向时,建议使用单方向刷新CPU cache模式,能避免多余的刷新CPU cache动作导致性能损耗。
4.1.6.2 同步CACHEABLE内存
明确数据同步方向之后,就可以使用 rknn_mem_sync 接口对cacheable内存做同步。接口形式如下:
int rknn_mem_sync(rknn_context context, rknn_tensor_mem* mem, rknn_mem_sync_mode mode);
其中,context是上下文(在非RV1103系列/RV1106系列平台上默认设置为NULL),mem是rknn_create_mem 接口返回的 rknn_tensor_mem* 指针类型,mode是指同步数据的方向。
4.1.7 模型稀疏化推理
该功能用于Torch模型在训练阶段对模型权重自动稀疏化并使用RKNN进行稀疏化推理,提高模型推理速度。目前该功能仅支持RK3576、RK1126B。
4.1.7.1 稀疏化原理
模型权重稀疏化在训练阶段根据用戶自定义的方式,进行权重置零操作,具体方式有4:2输入方向稀疏化,4:2输出方向稀疏化,16:4输入输出稀疏化,16:4输出输入稀疏化。其中4:2输入方向稀疏化实现原理如图4-9所示,将模型权重沿输入方向,在连续的4个数值中选择两个置零。需要注意的是,当模型权重指定方向非4对齐时,会进行补齐操作。
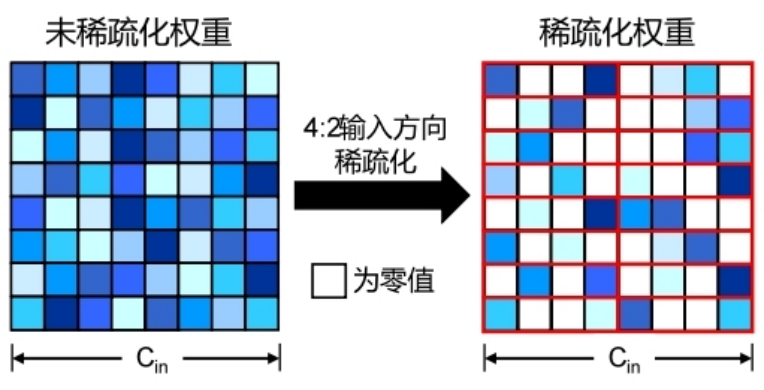
图4-9 4:2 输入方向稀疏化原理图
有关四种权重稀疏化说明如表4-8所示,其中输入输出方向为权重的方向,例如2维卷积shape为C out×C in×Kh×K w,输入方向即C in,输出方向即C out 。在稀疏率为75%的方式中前置训练模型可以是未稀疏化模型也可以是稀疏模型,建议使用单方向稀疏模型作为前置预训练模型,可减少稀疏化后的精度损失。
表4-8 模型权重稀疏化说明
| 稀疏化方式 | 稀疏率 | 说明 |
|---|---|---|
| 4:2输入方向稀疏化 | 50% | 沿输入方向对权重稀疏化 |
| 4:2输出方向稀疏化 | 50% | 沿输出方向对权重稀疏化 |
| 16:4输入输出稀疏化 | 75% | 先沿输入方向4:2稀疏,再沿输出方向4:2稀疏 |
| 16:4输出输入稀疏化 | 75% | 先沿输出方向4:2稀疏,再沿输入方向4:2稀疏 |
4.1.7.2 训练稀疏化模型
1.首先确保cuda可使用并安装对应python版本的autosparsity包
pip install autosparsity-1.0-cp38-cp38m-linux_x86_64.whl
autosparsity安装包路径为:https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/packages
2.以torchvision中的resnet50的4:2 输入方向稀疏化为例,进行权重稀疏化训练
import torch
import torchvision.models as models
from autosparsity.sparsity import sparsity_model

if __name__ == "__main__":

    model = models.resnet50(pretrained=True).cuda()
    optimizer = None
    mode = 0
    sparsity_model(model, optimizer, mode)
    model.eval()
    x = torch.randn((1,3,224,224)).cuda()
    torch.onnx.export(
       model, x, 'resnet50.onnx', input_names=['inputs'], output_names=['outputs']
    )
自定义模型的稀疏化在模型训练之前添加 sparsity_model 函数即可,参考示例如下:
# insert model autosparsity code before training
  import torch
  import torchvision.models as models
  from autosparsity.sparsity import sparsity_model

  ...

  model = models.resnet34(pretrained=True).cuda()
  mode = 0
  sparsity_model(model, optimizer, mode)

# normal training
  x, y = DataLoader(args)
  for epoch in range(epochs):
    y_pred = model(x)
    loss = loss_func(y_pred, y)
    loss.backward()
    optimizer.step()
  ...
注:Attention 模型稀疏化训练依赖于一个已训练好的前置模型。所以在做稀疏化训练之前,请先训练一个效果‘不错’的模型,在该模型基础上进行稀疏化训练。
有关 sparsity_model 函数的参数说明如下:
表4-9 sparsity_model函数各参数说明
| 参数 | 详细说明 |
|---|---|
| model | 原训练模型 |
| optimizer | 原优化器,默认为None |
| mode | 稀疏化方式,可选值为0, 1, 2, 3,默认为0 0: 4:2输入方向稀疏化(50%稀疏率) 1: 4:2输 出方向稀疏化(50%稀疏率) 2: 16:4输入输出稀疏化(75%稀疏率) 3: 16:4输出输入稀疏化 (75%稀疏率) |
| verbose | log等级,可选值为0, 1, 2, 3,默认为2 0: Errors 1: Errors and Warnings 2: Errors, warnings and info |
| 参数 | 详细说明 |
|---|---|
| whitelist | 稀疏化支持的module列表,支持1d conv,2d conv,3d conv, linear, MultiheadAttention,默认[torch.nn.Linear, torch.nn.Conv2d] |
| allowed_layer_names | 允许稀疏化的层名,用戶配置时则只稀疏指定层,默认None |
| disallowed_layer_names | 不允许稀疏化的层名,用戶配置时则会跳过该层,默认[] |
| fast | 设为True代表使用快速方法计算mask,默认为False(默认的mask计算方法针对部分模型 会失效,若稀疏化报错可尝试将该参数设为True) |
4.1.7.3 RKNN稀疏化推理使用方法
通过RKNN-Toolkit2中 config() 接口的“sparse_infer”参数设置模型稀疏化的开启和关闭,对应的参数为True/False ,默认值为 False 。开启稀疏化推理的参考代码如下:
rknn.config(target_platform=’rk3576’, sparse_infer=True)
完整的稀疏化Python推理代码可参考:https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/examples
使用C API进行部署时,首先使用RKNN-Toolkit2在 config() 接口中设置“ sparse_infer ”参数为True生成带稀疏化推理的RKNN模型,之后正常调用通用API接口流程或零拷贝接口流程即可。
| verbose=True | |
|---|---|
| RKNN_LOG_LEVEL=4 |
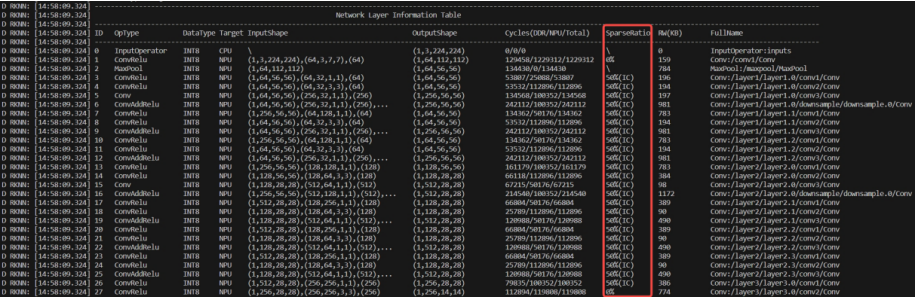
图4-10 4:2 输入方向稀疏化Python打印日志
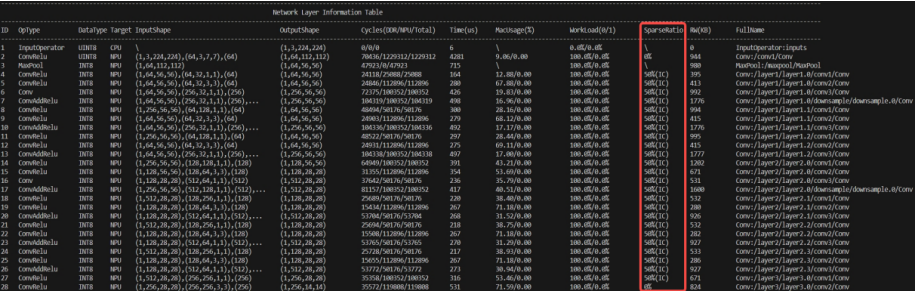
图4-11 4:2 输入方向稀疏化C API打印日志
其中 SparseRation 代表稀疏率,4:2输入方向稀疏化对应50%(IC),4:2输出方向稀疏化对应50%(OC),16:4输入输出稀疏化和16:4输出输入稀疏化对应75%。0%则代表未做稀疏化。
4.1.7.4 RKNN稀疏化推理限制
稀疏化推理是基于NPU的硬件架构实现,受硬件规格限制,RK3576的稀疏化推理目前只支持2d Conv并且group参数为1,其余限制如下:
表4-10 RKNN稀疏化推理限制
| 通道数量 | 数据类型 | |
|---|---|---|
| 4:2输入方向稀疏化 | 输入32对齐,输出32对齐 | 仅支持Int8 不支持Float16 |
| 4:2输出方向稀疏化 | 输入32对齐,输出32对齐 | 仅支持Int8 不支持Float16 |
| 16:4输入输出稀疏化 | 输入32对齐,输出32对齐 | 仅支持Int8 不支持Float16 |
| 16:4输出输入稀疏化 | 输入32对齐,输出32对齐 | 仅支持Int8 不支持Float16 |