
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 9/22
C API 部署与代码生成
3.2 通用模型C API部署
本章节介绍通用C API接口的部署流程,涵盖从模型初始化、输入输出准备、推理执行到输出处理的完整调用过程,适用于生产部署、性能敏感场景。零拷贝C API调用流程请参考3.1.6 章节。
3.2.1 完整调用流程
通用模型 C API 部署的典型调用顺序为:模型初始化 → 查询输入输出属性 → 准备并设置输入 → 推理执行 → 获取输出 → 后处理 → 释放资源。整体流程如下图:
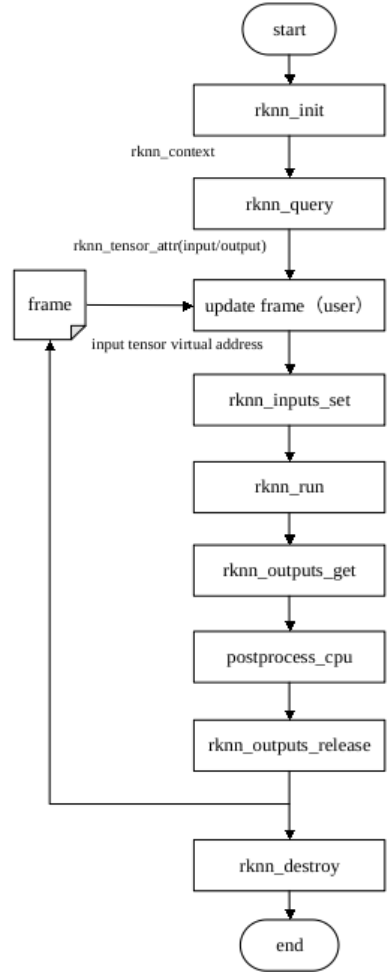
图3-10 通用API调用流程
RKNN通用API接口调用流程:
-
调用 rknn_init() 接口初始化模型;
-
调用 rknn_query() 接口查询模型的输入输出属性;
-
对输入进行前处理;
-
调用 rknn_inputs_set() 接口设置输入数据;
-
调用 rknn_run() 接口进行模型推理;
-
调用 rknn_outputs_get() 接口获取推理结果数据;
-
对输出进行后处理;
-
调用 rknn_outputs_release() 接口释放输出数据内存;
-
调用 rknn_destroy() 接口销毁RKNN;
通用API调用流程如图3-10所示。
通用API调用流程示例代码:
// Init RKNN model
ret = rknn_init(&ctx, model, model_len, 0, NULL);

// Get Model Input Output Number
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// Get Model Input Info
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
    input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}

// Get Model Output Info
rknn_tensor_attr output_attrs[io_num.n_output];
memset(output_attrs, 0, sizeof(output_attrs));
for (int i = 0; i < io_num.n_output; i++)
{
    output_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_OUTPUT_ATTR, &(output_attrs[i]), sizeof(rknn_tensor_attr));
}

rknn_input inputs[io_num.n_input];
rknn_output outputs[io_num.n_output];
memset(inputs, 0, sizeof(inputs));
memset(outputs, 0, sizeof(outputs));

// Pre-process
// Read Image
image_buffer_t src_image;
memset(&src_image, 0, sizeof(image_buffer_t));
ret = read_image(image_path, &src_image);

// Set Input Data
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(rknn_ctx, io_num.n_input, inputs);

// Run
ret = rknn_run(rknn_ctx, nullptr);

// Get Output Data
ret = rknn_outputs_get(rknn_ctx, io_num.n_output, outputs, NULL);

// Post-process
post_process(outputs, results);

// Release RKNN Output
rknn_outputs_release(rknn_ctx, io_num.n_output, outputs);

if (rknn_ctx != 0)
{
    rknn_destroy(rknn_ctx);
}
3.2.2 模型初始化
模型初始化通过 rknn_init() 接口完成,该接口加载RKNN模型并创建运行时上下文,是所有后续操作的前提。
rknn_init() 支持两种模型加载方式:
从文件路径加载: model 参数传入 .rknn 模型文件路径字符串,此时 size 参数传0,由Runtime自行读取模型文件。
从内存加载:将 .rknn 模型文件读入内存后, model 参数传入模型数据指针, size 参数传入数据⻓度。适用于模型已预加载到内存,或模型加密后自行解密再加载的场景。
flag 参数用于指定初始化标志(如运行时性能采集 RKNN_FLAG_COLLECT_PERF_MASK 、用戶自行分配内存RKNN_FLAG_MEM_ALLOC_OUTSIDE 等),默认初始化行为传0; ext 参数为扩展信息,一般传NULL即可。
rknn_context ctx;
int ret = rknn_init(&ctx, "./model.rknn", 0, 0, NULL);
if (ret != RKNN_SUCCESS) {
    printf("rknn_init failed! ret=%d\n", ret);
    goto out;
}
RK3588 / RK3576平台可在初始化后通过 rknn_set_core_mask() 接口指定模型运行的NPU核心,需与模型转换时的配置一致,详见4.1.2 NPU多核。
3.2.3 输入输出准备
模型初始化完成后,需查询模型输入输出属性,并据此准备输入数据。
1. 查询输入输出属性
通过 rknn_query() 接口查询模型的输入输出张量个数和属性:先查询 RKNN_QUERY_IN_OUT_NUM 获取输入输出个数,再逐个查询每个张量的属性( RKNN_QUERY_INPUT_ATTR / RKNN_QUERY_OUTPUT_ATTR ),获取shape、dtype、layout、量化参数等信息,用于组织输入数据和解析输出结果。
// 查询输入输出个数
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// 查询各输入张量属性
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
    input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}
2. 准备并设置输入数据
对输入数据完成前处理(如resize、颜色空间转换等)后,填写 rknn_input 结构体并通过rknn_inputs_set() 接口传递给Runtime:
index :输入索引。
buf / size :输入数据指针与字节数,size等于元素个数乘以单个元素的字节数。
type :输入数据类型(如 RKNN_TENSOR_UINT8 ),若与模型输入类型不一致,Runtime内部自动完成类型转换。
fmt :输入数据布局(如 RKNN_TENSOR_NHWC ),四维输入应指定正确的布局,非四维输入使用RKNN_TENSOR_UNDEFINED 。
pass_through :是否跳过Runtime内部的预处理(归一化、类型转换、布局转换)。
rknn_input inputs[io_num.n_input];
memset(inputs, 0, sizeof(inputs));
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
说明:
若模型转换时已通过 rknn.config() 配置了 mean_values 和 std_values ,通用API推理时Runtime内部会自动完成归一化,应用中无需再做均值方差处理,可有效减少部署耗时。
输入数据的通道顺序(RGB / BGR)需与模型训练时的设置一致;量化时若使用了quant_img_RGB2BGR 参数,注意推理阶段该参数不生效,通道转换需用戶自行完成。
零拷贝API的输入准备方式不同:通过 rknn_create_mem() 分配内存并用 rknn_set_io_mem()绑定,要求内存大小、dtype、layout与查询到的张量属性严格对齐,详见3.1.6 章节。
3.2.4 推理执行
输入设置完成后,通过 rknn_run() 接口执行推理。该接口为同步阻塞式调用,返回时表示本次推理已完成:
ret = rknn_run(ctx, nullptr);
if (ret < 0) {
    printf("rknn_run failed! ret=%d\n", ret);
    goto out;
}
RK3588 / RK3576多核平台需在推理前通过 rknn_set_core_mask() 设置核心掩码(见3.2.2 模型初始化)。推理耗时的统计方法( RKNN_QUERY_PERF_RUN 查询、 RKNN_LOG_LEVEL 日志)见5.2 性能分析与优化。
3.2.5 输出处理
推理完成后,通过 rknn_outputs_get() 接口获取输出数据,获取后进行后处理,使用完毕后必须调用rknn_outputs_release() 释放输出内存。
rknn_output outputs[io_num.n_output];
memset(outputs, 0, sizeof(outputs));
outputs[0].want_float = 1;
ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0) {
    printf("rknn_outputs_get failed! ret=%d\n", ret);
    goto out;
}

// 后处理(如分类的argmax、检测的NMS等)
post_process(outputs, results);

// 释放输出内存
rknn_outputs_release(ctx, io_num.n_output, outputs);
读取输出数据时需注意:
数据类型: want_float = 1 时,Runtime将输出转换为float32类型后返回; want_float = 0时,返回模型原始输出类型(量化模型为INT8量化数据,非量化模型为float16),此时需结合查询到的张量属性中的量化参数(scale / zero_point)自行反量化为浮点值。
数据布局:通用API返回的输出为模型原始layout,四维输出一般为 NCHW ,后处理时需按对应布局解析。
内存释放: rknn_outputs_get() 获取的输出内存由Runtime分配,必须通过rknn_outputs_release() 释放,避免内存泄漏;零拷贝API直接读取绑定的内存,无此步骤。
3.2.6 生成部署C代码
RKNN-Toolkit2 2.0.0版本新增 Codegen 接口,用于生成模型部署代码,简化开发者的上手难度。Codegen基于 CAPI 零拷贝接口进行二次封装,接口⻛格与 RKNN_Model_Zoo 中的 demo 一致。生成的部署代码可用于直接测试性能、验证精度,开发者也可以基于生成的代码进行二次开发。
使用示例:
ret = rknn.codegen(output_path='./rknn_app_demo',
          inputs=['../../caffe/mobilenet_v2/dog_224x224.jpg'], overwrite=True)
调用 codegen 接口前,必须先调用 rknn.export 接口保存RKNN模型。
output_path 为输出文件夹目录,用戶可配置目录名称。
inputs 填写模型输入的路径列表,允许不填。有效文件格式为 jpg / png / npy ,以 npy 文件为输入时, npy 数据的维度信息应与模型输入的维度信息保持一致。
overwrite 设为 True 时,会覆盖 output_path 指定目录下的文件。默认值为 False 。
生成部署代码后,请参考生成目录下的 README.md 文档说明进行编译、测试。
若 inputs 填入有效值,部署代码示例在推理后,会评估C API接口与RKNN-Toolkit2模拟器之间的推理结果差异,评估方式为对比每一个输出的余弦相似度。
无NPU硬件平台限制,要求板端系统为Linux或Android。
支持量化、非量化模型。