
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 9/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
3.2 Allgemeine Modelle mit der C API bereitstellen
Dieser Abschnitt beschreibt die Bereitstellung über die allgemeine C API: Modellinitialisierung, Ein-/Ausgabevorbereitung, Inferenz und Ergebnisverarbeitung. Der Ablauf eignet sich für Produktivbereitstellungen und leistungskritische Anwendungen. Den Zero-Copy-C-API-Ablauf beschreibt Abschnitt 3.1.6.
3.2.1 Vollständiger Aufrufablauf
Typische Reihenfolge: Modell initialisieren → Ein-/Ausgabeattribute abfragen → Eingaben vorbereiten und setzen → Inferenz ausführen → Ausgaben abrufen → nachverarbeiten → Ressourcen freigeben. Der Gesamtablauf ist nachfolgend dargestellt:
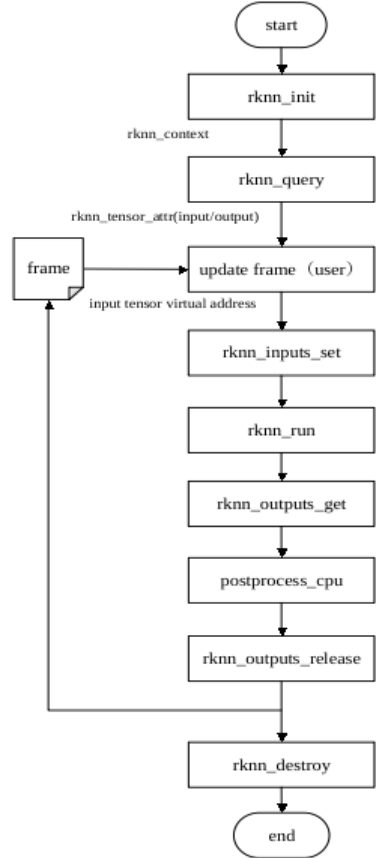
Abbildung 3-10: Aufrufablauf der allgemeinen API
Aufrufablauf der allgemeinen RKNN-API:
-
Modell mit rknn_init() initialisieren.
-
Ein-/Ausgabeattribute mit rknn_query() abfragen.
3 Eingabe vorverarbeiten;
-
Eingabedaten mit rknn_inputs_set() setzen.
-
Inferenz mit rknn_run() ausführen.
-
Inferenzergebnisse mit rknn_outputs_get() abrufen.
7 Ausgabe nachverarbeiten;
-
Ausgabespeicher mit rknn_outputs_release() freigeben.
-
RKNN mit rknn_destroy() zerstören.
Der Ablauf ist in Abbildung 3-10 dargestellt.
Beispielcode für den allgemeinen API-Ablauf:
// Init RKNN model
ret = rknn_init(&ctx, model, model_len, 0, NULL);

// Get Model Input Output Number
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// Get Model Input Info
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
    input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}

// Get Model Output Info
rknn_tensor_attr output_attrs[io_num.n_output];
memset(output_attrs, 0, sizeof(output_attrs));
for (int i = 0; i < io_num.n_output; i++)
{
    output_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_OUTPUT_ATTR, &(output_attrs[i]), sizeof(rknn_tensor_attr));
}

rknn_input inputs[io_num.n_input];
rknn_output outputs[io_num.n_output];
memset(inputs, 0, sizeof(inputs));
memset(outputs, 0, sizeof(outputs));

// Pre-process
// Read Image
image_buffer_t src_image;
memset(&src_image, 0, sizeof(image_buffer_t));
ret = read_image(image_path, &src_image);

// Set Input Data
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(rknn_ctx, io_num.n_input, inputs);

// Run
ret = rknn_run(rknn_ctx, nullptr);

// Get Output Data
ret = rknn_outputs_get(rknn_ctx, io_num.n_output, outputs, NULL);

// Post-process
post_process(outputs, results);

// Release RKNN Output
rknn_outputs_release(rknn_ctx, io_num.n_output, outputs);

if (rknn_ctx != 0)
{
    rknn_destroy(rknn_ctx);
}
3.2.2 Modellinitialisierung
rknn_init() lädt das RKNN-Modell und erstellt den Laufzeitkontext. Dies ist die Voraussetzung für alle nachfolgenden Operationen.
rknn_init() unterstützt zwei Lademodi:
Aus Dateipfad: Übergeben Sie den Pfad der .rknn-Datei als Zeichenkette in model und setzen Sie size=0. Die Runtime liest die Datei selbst.
Aus Speicher: Lesen Sie die .rknn-Datei in den Speicher, übergeben Sie den Datenzeiger in model und die Datenlänge in size. Geeignet für vorgeladene oder im Anwendungscode entschlüsselte Modelle.
flag legt Initialisierungsflags fest, beispielsweise RKNN_FLAG_COLLECT_PERF_MASK zur Leistungserfassung oder RKNN_FLAG_MEM_ALLOC_OUTSIDE für benutzerallokierten Speicher. Für Standardinitialisierung 0 übergeben. ext enthält Erweiterungsinformationen; gewöhnlich wird NULL übergeben.
rknn_context ctx;
int ret = rknn_init(&ctx, "./model.rknn", 0, 0, NULL);
if (ret != RKNN_SUCCESS) {
    printf("rknn_init failed! ret=%d\n", ret);
    goto out;
}
Auf RK3588 / RK3576 können nach der Initialisierung mit rknn_set_core_mask() NPU-Kerne festgelegt werden. Dies muss zur Konfiguration bei der Modellkonvertierung passen; siehe 4.1.2.
3.2.3 Ein-/Ausgaben vorbereiten
Fragen Sie nach der Initialisierung die Ein-/Ausgabeattribute ab und bereiten Sie die Eingabedaten entsprechend vor.
1. Ein-/Ausgabeattribute abfragen
Fragen Sie mit rknn_query() zunächst über RKNN_QUERY_IN_OUT_NUM die Tensoranzahl ab, danach mit RKNN_QUERY_INPUT_ATTR / RKNN_QUERY_OUTPUT_ATTR die Attribute jedes Tensors: Form, dtype, Layout, Quantisierungsparameter usw. Verwenden Sie diese zur Eingabeorganisation und Ausgabeverarbeitung.
// Query the number of inputs and outputs
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// Query each input tensor's attributes
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
    input_attrs[i].index = i;
    ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}
2. Eingabedaten vorbereiten und setzen
Füllen Sie nach der Vorverarbeitung, etwa Größen- und Farbraumänderung, rknn_input aus und übergeben Sie die Struktur mit rknn_inputs_set() an die Runtime:
index: Eingabeindex.
buf / size: Datenzeiger und Größe in Byte. Die Größe entspricht Elementanzahl multipliziert mit Bytezahl je Element.
type: Eingabedatentyp, beispielsweise RKNN_TENSOR_UINT8. Weicht er vom Modelleingabetyp ab, konvertiert die Runtime automatisch.
fmt: Eingabelayout, beispielsweise RKNN_TENSOR_NHWC. Für vierdimensionale Eingaben das korrekte Layout angeben, für andere RKNN_TENSOR_UNDEFINED.
pass_through: bestimmt, ob die interne Runtime-Vorverarbeitung aus Normalisierung, Typ- und Layoutkonvertierung übersprungen wird.
rknn_input inputs[io_num.n_input];
memset(inputs, 0, sizeof(inputs));
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
Hinweis:
Wurden bei der Konvertierung mean_values und std_values in rknn.config() gesetzt, normalisiert die Runtime bei Inferenz über die allgemeine API automatisch. Separate mean/std-Verarbeitung in der Anwendung entfällt und reduziert den Bereitstellungsaufwand.
Die Kanalreihenfolge RGB / BGR muss zur Trainingskonfiguration passen. quant_img_RGB2BGR wirkt bei der Quantisierung, nicht bei der Inferenz; die Kanalumwandlung liegt beim Benutzer.
Für Zero-Copy wird Speicher mit rknn_create_mem() allokiert und mit rknn_set_io_mem() gebunden. Größe, dtype und Layout müssen exakt den abgefragten Attributen entsprechen; siehe 3.1.6.
3.2.4 Inferenz ausführen
Rufen Sie nach Setzen der Eingaben rknn_run() auf. Der Aufruf ist synchron und blockierend; bei Rückkehr ist die aktuelle Inferenz abgeschlossen.
ret = rknn_run(ctx, nullptr);
if (ret < 0) {
    printf("rknn_run failed! ret=%d\n", ret);
    goto out;
}
Auf den Mehrkernplattformen RK3588 / RK3576 setzen Sie vor der Inferenz die Kernmaske mit rknn_set_core_mask(); siehe 3.2.2. Zeitmessung über RKNN_QUERY_PERF_RUN und RKNN_LOG_LEVEL-Protokolle wird in 5.2 beschrieben.
3.2.5 Ausgaben verarbeiten
Rufen Sie nach der Inferenz die Ausgaben mit rknn_outputs_get() ab, führen Sie die Nachverarbeitung aus und geben Sie den Speicher anschließend mit rknn_outputs_release() frei.
rknn_output outputs[io_num.n_output];
memset(outputs, 0, sizeof(outputs));
outputs[0].want_float = 1;
ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0) {
    printf("rknn_outputs_get failed! ret=%d\n", ret);
    goto out;
}

// Post-processing (e.g. argmax for classification, NMS for detection)
post_process(outputs, results);

// Release output memory
rknn_outputs_release(ctx, io_num.n_output, outputs);
Hinweise zum Lesen der Ausgaben:
Datentyp: Bei want_float=1 gibt die Runtime float32 zurück. Bei want_float=0 wird der ursprüngliche Modellausgabetyp zurückgegeben: INT8 bei quantisierten und float16 bei nicht quantisierten Modellen. Zur Dequantisierung verwenden Sie scale / zero_point aus den abgefragten Tensorattributen.
Layout: Die allgemeine API liefert das ursprüngliche Modelllayout, bei vierdimensionalen Ausgaben gewöhnlich NCHW. Die Nachverarbeitung muss dieses entsprechend auswerten.
Freigabe: Der durch rknn_outputs_get() erhaltene Speicher wird von der Runtime allokiert und muss mit rknn_outputs_release() freigegeben werden. Die Zero-Copy-API liest direkt den gebundenen Speicher und benötigt diesen Schritt nicht.
3.2.6 C-Code für die Bereitstellung erzeugen
RKNN-Toolkit2 2.0.0 ergänzt die Schnittstelle Codegen zur Erzeugung von Bereitstellungscode und erleichtert damit den Einstieg. Sie kapselt die Zero-Copy-CAPI; ihr Schnittstellenstil entspricht den Beispielen in RKNN_Model_Zoo. Der erzeugte Code ermöglicht unmittelbare Leistungstests und Genauigkeitsprüfungen und kann als Grundlage für eigene Weiterentwicklungen dienen.
Anwendungsbeispiel:
ret = rknn.codegen(output_path='./rknn_app_demo',
          inputs=['../../caffe/mobilenet_v2/dog_224x224.jpg'], overwrite=True)
Vor codegen muss rknn.export zum Speichern des RKNN-Modells aufgerufen werden. Der Name rknn.export ist aus dem Originaltext übernommen.
output_path bezeichnet das Ausgabeverzeichnis; dessen Namen kann der Benutzer festlegen.
Inputs enthält die Pfadliste der Modelleingaben und darf leer bleiben. Unterstützte Dateiformate sind jpg/png/npy. Bei npy müssen die Datendimensionen mit denen der Modelleingabe übereinstimmen.
Bei overwrite=True werden Dateien im Verzeichnis output_path überschrieben. Standardwert ist False.
Zum Kompilieren und Testen des erzeugten Codes die README.md im Ausgabeverzeichnis beachten.
Enthält inputs gültige Daten, bewertet das Beispiel nach der Inferenz die Unterschiede zwischen CAPI und RKNN-Toolkit2-Simulator anhand der Kosinusähnlichkeit jedes Ausgangs.
Keine Einschränkung auf eine bestimmte NPU-Hardwareplattform; das Board muss Linux oder Android verwenden.
Quantisierte und nicht quantisierte Modelle werden unterstützt.