
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 8/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
3.1.6 Zero-Copy-Schnittstelle der RKNN Runtime
3.1.6.1 Einführung in Zero-Copy
RK3562 / RK3566 / RK3568 / RK3576 / RK3588 / RV1126B bieten die allgemeine und die Zero-Copy-API; die Serien RV1103 / RV1106 unterstützen die Zero-Copy-API. Beispiele stehen unter examples/rknn_zero_copy im Projekt rknpu2. Repository und weitere Informationen: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2.
Bei der RKNN-Inferenz durchlaufen Rohdaten Eingabeverarbeitung, Modellausführung auf der NPU und Ausgabeverarbeitung. Abhängig von Eingabeformat und Quantisierung gibt es zwei Abläufe: allgemeine API und Zero-Copy, dargestellt in Abbildungen 3-5 und 3-6. Der wesentliche Unterschied besteht darin, dass bei jeder Aktualisierung eines Frames die allgemeine API Daten eines externen Moduls in den Eingabespeicher der NPU Runtime kopiert. Zero-Copy verwendet dagegen direkt vorab allokierten Speicher der Runtime oder eines externen Frameworks wie DRM. Dies reduziert Kopien, erhöht die Leistung und senkt den Bandbreitenbedarf. Bei ausschließlich virtueller Eingabeadresse ist nur die allgemeine API möglich; bei physischer Adresse oder fd sind beide möglich. Beide API-Gruppen dürfen nicht gemischt werden.
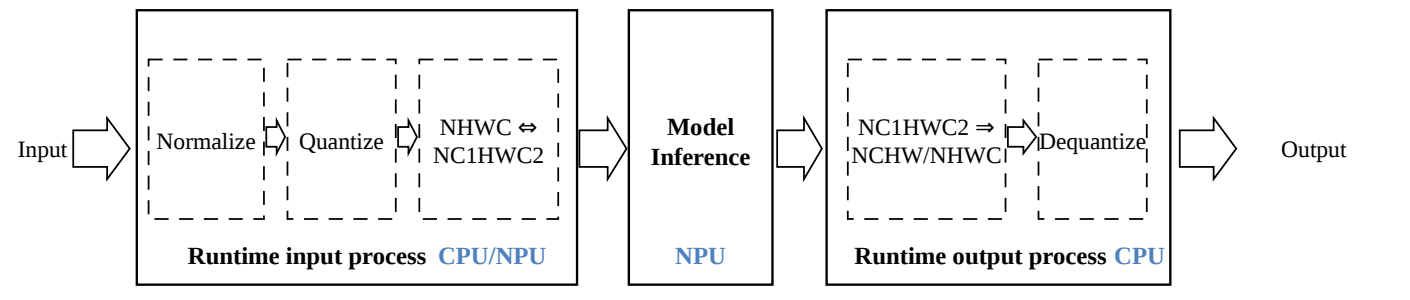
Abbildung 3-5: Datenverarbeitung der allgemeinen API
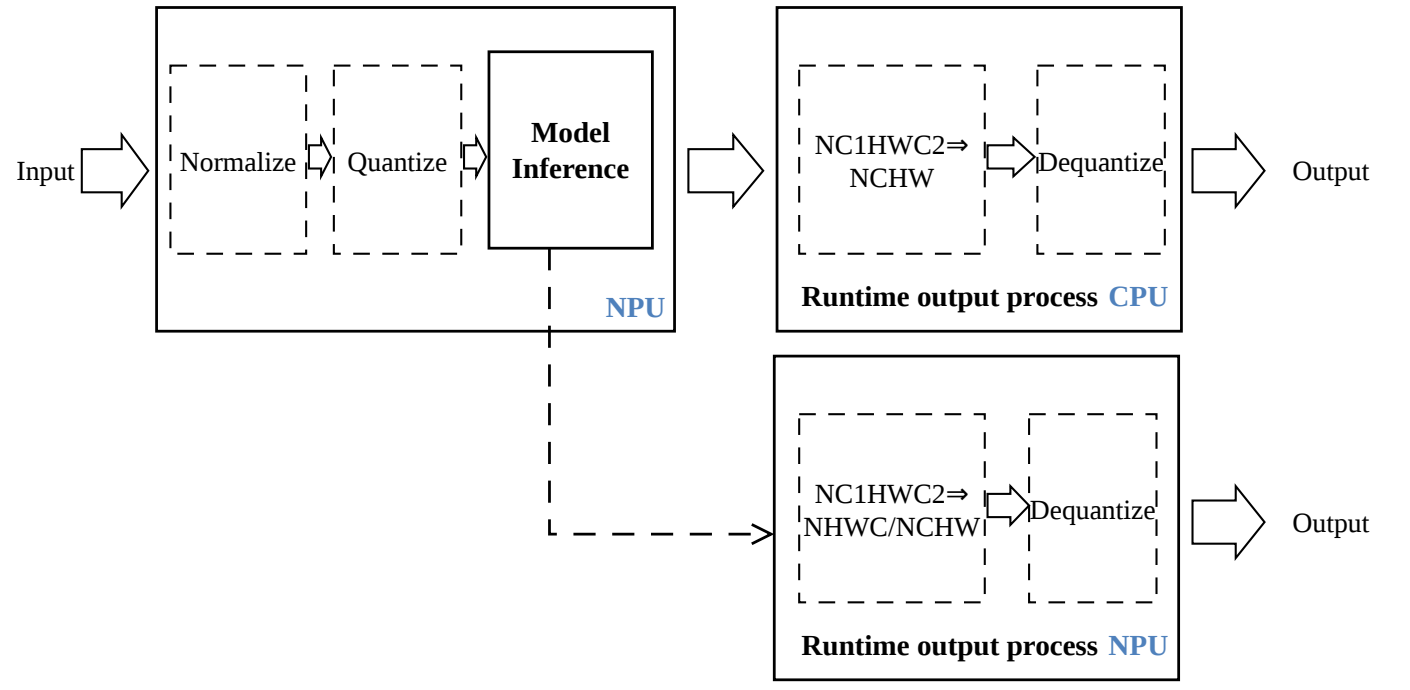
Abbildung 3-6: Datenverarbeitung der Zero-Copy-API
1 Allgemeine API
Bei der allgemeinen API in Abbildung 3-5 erfolgen Normalisierung, Quantisierung, Layoutkonvertierung und Dequantisierung auf der CPU, die Modellinferenz auf der NPU. Sind die Zero-Copy-Eingabeanforderungen erfüllt, laufen Normalisierung und Quantisierung auf der NPU; die CPU muss die Eingabedaten dennoch in den Modellpuffer kopieren.
1 Zero-Copy-API
Zero-Copy in Abbildung 3-6 optimiert diesen Ablauf: Normalisierung, Quantisierung und Modellinferenz laufen auf der NPU, Ausgabelayoutkonvertierung und Dequantisierung auf CPU oder NPU. Der Eingabedatenfluss wird effizienter verarbeitet als mit der allgemeinen API.
Die Voraussetzungen für Zero-Copy stehen in der folgenden Tabelle:
Tabelle 3-2: Anforderungen an Zero-Copy-Eingaben
| Eingabedimensionen | RV1103B / RV1106B / RK3566 / RK3568 | RK3562 / RK3576 / RK3588 / RV1103 / RV1106 / RV1126B |
|---|---|---|
| 4 Dimensionen, 1, 3 oder 4 Kanäle | Breite auf 8 Byte ausgerichtet | Breite auf 16 Byte ausgerichtet |
| Nicht 4-dimensional | Gesamtgröße auf 8 Byte ausgerichtet | Gesamtgröße auf 16 Byte ausgerichtet |
3.1.6.2 Zero-Copy-Ablauf der C-API
Die Zero-Copy-API verwendet rknn_tensor_memory, das vor der Inferenz erstellt und eingerichtet wird; danach werden die zugehörigen Speicherdaten gelesen. Je nachdem, ob Ein-/Ausgabe-, Gewichts- und Zwischenergebnisspeicher selbst allokiert werden und ob fd oder physische Adressen verwendet werden, ergeben sich die drei typischen Abläufe in Abbildungen 3-7 bis 3-9. Rot kennzeichnet zusätzlich benötigte Schnittstellen und Strukturen, Kursivschrift die zwischen Aufrufen übergebenen Strukturen.
Ein-/Ausgabespeicher wird von der Runtime allokiert
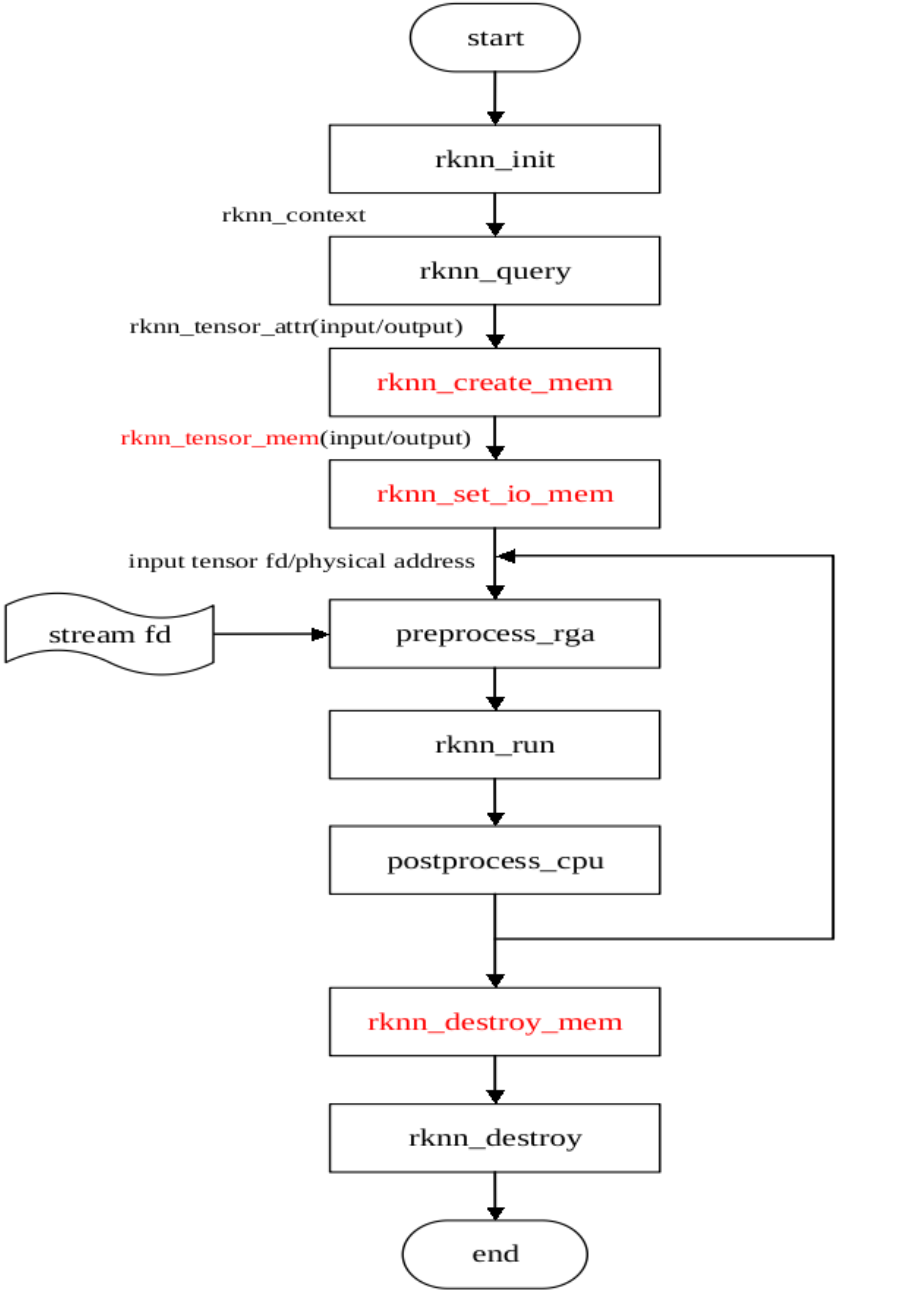
Abbildung 3-7: Zero-Copy-Aufrufablauf mit intern allokiertem Ein-/Ausgabespeicher
In Abbildung 3-7 allokiert die Runtime den Ein-/Ausgabespeicher: rknn_create_mem() erzeugt rknn_tensor_memory, und rknn_set_io_mem() richtet die Ein- und Ausgabestrukturen ein.
Die von rknn_create_mem() erzeugte Struktur enthält Dateideskriptor und physische Adresse. RGA verwendet den NPU-Speicher: preprocess_rga() bezeichnet die RGA-Schnittstelle, stream_fd den Speicher der RGA-Eingabequelle und postprocess_cpu() die Nachverarbeitung auf der CPU.
Extern allokierter Ein-/Ausgabespeicher
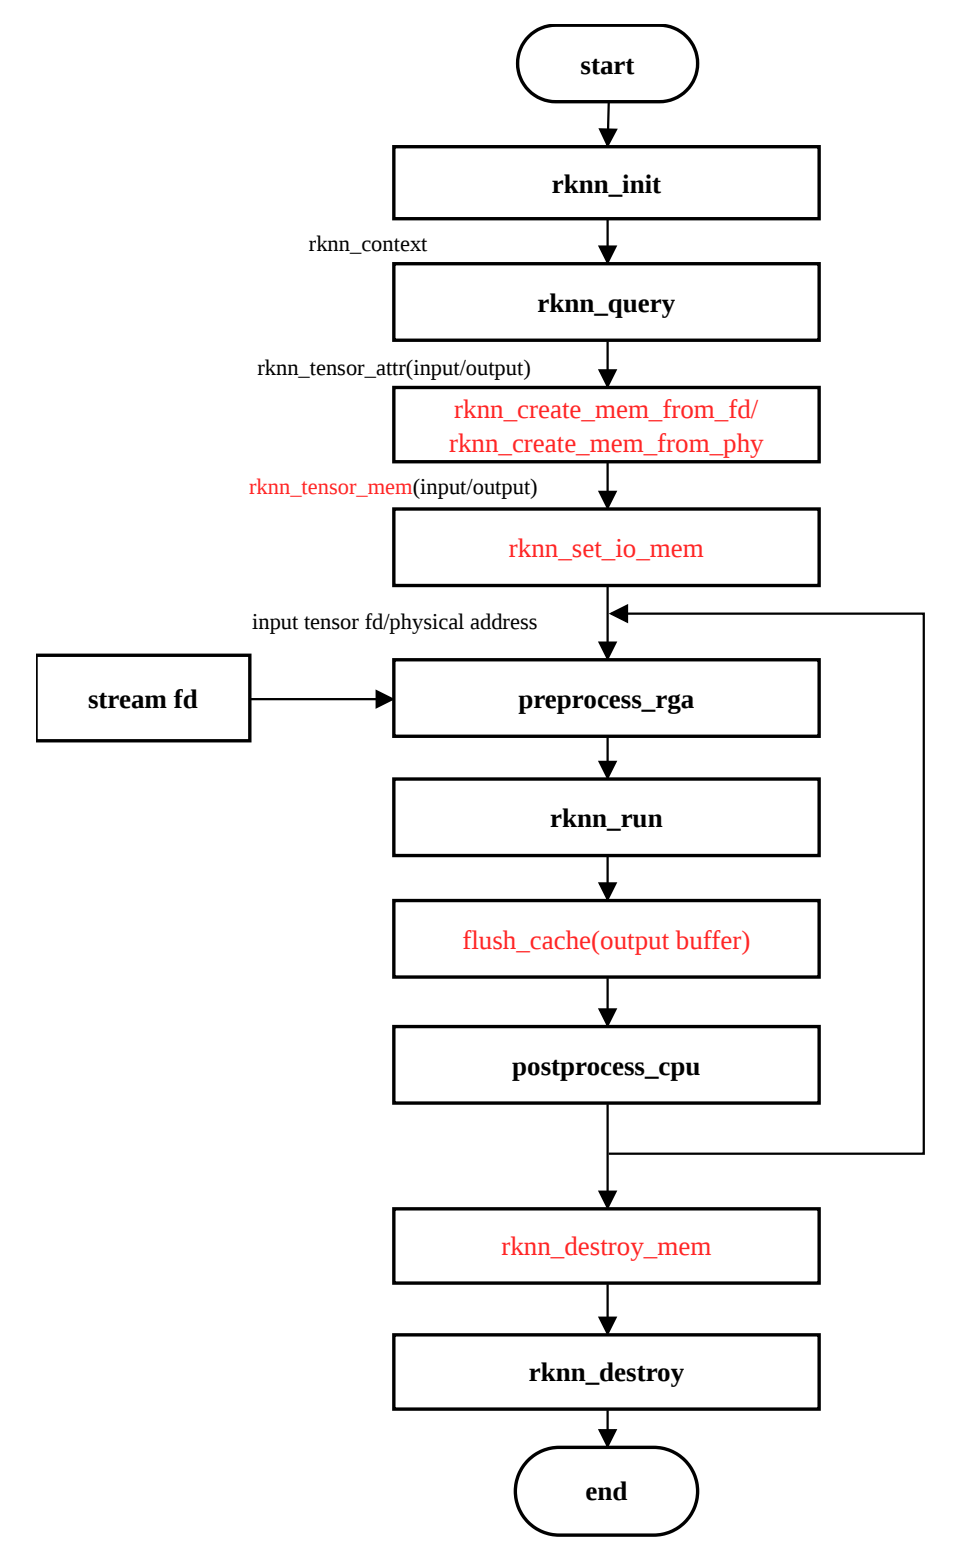
Abbildung 3-8: Zero-Copy-Aufrufablauf mit extern allokiertem Ein-/Ausgabespeicher
In Abbildung 3-8 erzeugen bei extern allokiertem Speicher rknn_create_mem_from_fd() / rknn_create_mem_from_phys() die Struktur rknn_tensor_memory; rknn_set_io_mem() richtet Ein- und Ausgabe ein. flush_cache bedeutet, dass der Benutzer die zum Speichertyp passende Schnittstelle zum Leeren des Ausgabecaches aufrufen muss.
Extern allokierter Speicher für Ein-/Ausgaben, Gewichte und Zwischenergebnisse
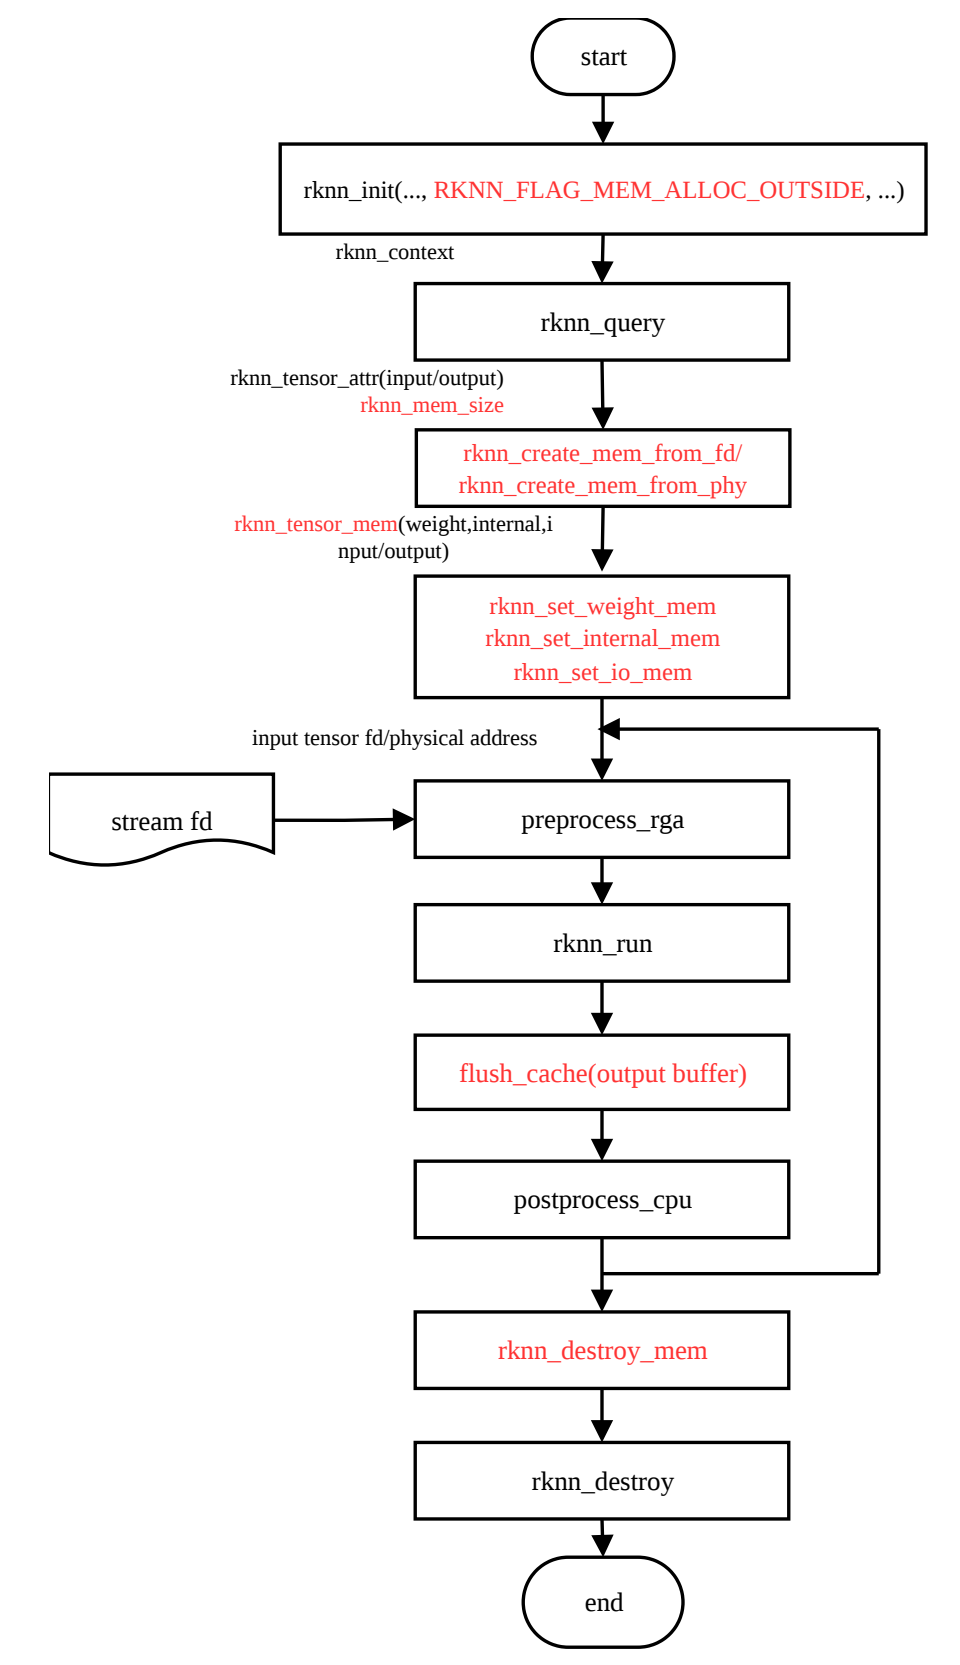
Abbildung 3-9: Zero-Copy-Aufrufablauf mit extern allokierten Ein-/Ausgaben, Gewichten und Zwischenergebnissen
In Abbildung 3-9 wird externer Speicher über rknn_create_mem_from_fd() / rknn_create_mem_from_phys() als rknn_tensor_memory eingebunden. rknn_set_io_mem() richtet Ein-/Ausgaben ein, rknn_set_weight_mem() / rknn_set_internal_mem() den Gewichts- und Zwischenergebnisspeicher.
3.1.6.3 Verwendung der Zero-Copy-C-API
Die Verwendung wird am Beispiel von Abbildung 3-7 mit intern allokiertem Ein-/Ausgabespeicher erläutert:
rknn_query()
Eingabe:
Fragen Sie Attribute mit RKNN_QUERY_NATIVE_INPUT_ATTR ab, nicht mit RKNN_QUERY_INPUT_ATTR. Die erforderliche Vorverarbeitung hängt vom ermittelten fmt (Layout) ab. Diese Abfrage liefert das für die Hardware effizienteste Eingabelayout und den entsprechenden Typ.
Eingabefälle von rknn_query():
a. RKNN_TENSOR_NCHW: gewöhnlich vierdimensionale Eingabe vom Typ bool oder int64. Die an die NPU übergebenen Daten müssen ebenfalls in NCHW angeordnet sein.
b. RKNN_TENSOR_NHWC: gewöhnlich vierdimensionale Eingabe vom Typ float32/float16/int8/uint8 mit 1, 3 oder 4 Kanälen. Daten werden in NHWC übergeben. Bei pass_through=1 muss die Breite gegebenenfalls entsprechend dem abgefragten w_stride ausgerichtet werden.
c. RKNN_TENSOR_NC1HWC2: gewöhnlich vierdimensionale Eingabe vom Typ float16/int8 mit einer Kanalzahl ungleich 1, 3 oder 4. Bei pass_through=0 liegt die Eingabe in NHWC vor; die Schnittstelle konvertiert intern auf der CPU nach NC1HWC2. Bei pass_through=1 muss der Benutzer die Daten selbst in NC1HWC2 bereitstellen.
d. RKNN_TENSOR_UNDEFINED: gewöhnlich keine vierdimensionale Eingabe. Die Daten werden im Eingabeformat des ONNX-Modells übergeben. Die NPU führt weder mean/std-Verarbeitung noch Layoutkonvertierung aus.
Weicht die gewünschte Eingabekonfiguration von der abgefragten rknn_tensor_attr ab, kann die Struktur angepasst werden. Zulässige Typänderungen stehen in Tabelle 3-3. Wichtig: Bei abgefragtem uint8 und gewünschter float32-Eingabe muss die Größe in rknn_tensor_attr vervierfacht und der Typ auf RKNN_TENSOR_FLOAT32 gesetzt werden. Danach ist die Hardwareeffizienz nicht mehr optimal, da die Schnittstelle die Typkonvertierung auf der CPU ausführt.
Tabelle 3-3: Änderbare Eingabedatentypen
| Benutzertyp / abgefragter Modelltyp | bool | int8 | float16 | int16 | int32 | Int64 |
|---|---|---|---|---|---|---|
| bool | Y | |||||
| int8 | Y | |||||
| uint8 | Y | Y | ||||
| float32 | Y | Y | ||||
| float16 | Y | |||||
| int16 | Y | |||||
| int32 | Y | |||||
| Int64 | Y |
Ausgabe:
Fragen Sie die Attribute mit RKNN_QUERY_NATIVE_OUTPUT_ATTR ab, nicht mit RKNN_QUERY_OUTPUT_ATTR. Die erforderliche Nachverarbeitung hängt von fmt (Layout) ab. Diese Abfrage liefert das hardwareseitig effizienteste Ausgabelayout und den entsprechenden Typ.
Wird eine vierdimensionale Ausgabe in NHWC benötigt, verwenden Sie RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR. Damit lässt sich die NHWC-Ausgabe direkt erhalten.
Ausgabefälle von rknn_query():
a. RKNN_TENSOR_NC1HWC2: gewöhnlich vierdimensionale float16-/int8-Ausgabe. Für NCHW muss der Benutzer extern von NC1HWC2 nach NCHW konvertieren.
b. RKNN_TENSOR_UNDEFINED: gewöhnlich keine vierdimensionale Ausgabe, Typ float16/int8. Externe Layoutkonvertierung ist nicht erforderlich.
c. RKNN_TENSOR_NCHW: gewöhnlich vierdimensionale float16-/int8-Ausgabe. Externe Layoutkonvertierung ist nicht erforderlich.
d. RKNN_TENSOR_NHWC: gewöhnlich vierdimensionale float16-/int8-Ausgabe. Dieser Fall tritt meist bei Abfrage über RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR auf.
Weicht die gewünschte Ausgabe von rknn_tensor_attr ab, kann die Struktur entsprechend Tabellen 3-5 und 3-4 geändert werden. Wichtig: Bei abgefragtem int8 und gewünschtem float32 muss die Größe vervierfacht und der Typ auf RKNN_TENSOR_FLOAT32 gesetzt werden. Die Hardwareeffizienz ist danach nicht mehr optimal, da die Schnittstelle intern auf der CPU konvertiert.
Tabelle 3-5: Änderbare Ausgabedatentypen
| Benutzertyp / abgefragter Modelltyp | bool | int8 | float16 | int16 | int32 | Int64 |
|---|---|---|---|---|---|---|
| bool | Y | |||||
| int8 | Y | |||||
| uint8 | ||||||
| float32 | Y | Y | ||||
| float16 | Y | |||||
| int16 | Y | |||||
| int32 | Y | |||||
| Int64 | Y |
Tabelle 3-4: Änderbare Ausgabelayouts
| Benutzerlayout / abgefragtes Modelllayout | NC1HWC2 | NCHW | NHWC | UNDEFINE |
|---|---|---|---|---|
| NC1HWC2 | Y | |||
| NCHW | Y | Y | ||
| NHWC | Y | |||
| UNDEFINE | Y |
Die unterstützten Zero-Copy-NPU-Ausgabekonfigurationen stehen für RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B in Tabelle 3-6 und für RV1106/RV1106B/RV1103/RV1103B in Tabelle 3-7.
Tabelle 3-6: Zero-Copy-NPU-Ausgabekonfigurationen für RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B
| Modelltyp | Ausgabedatentyp | Ausgabedimensionen | Unterstütztes Ausgabelayout |
|---|---|---|---|
| int8-Modell | int8/float16/float32 | 4-dimensional | NCHW/NC1HWC2/NHWC |
| int8-Modell | int8/float16/float32 | Nicht 4-dimensional | UNDEFINE |
| float16-Modell | float16/float32 | 4-dimensional | NCHW/NC1HWC2/NHWC |
| float16-Modell | float16/float32 | Nicht 4-dimensional | UNDEFINE |
Tabelle 3-7: Zero-Copy-NPU-Ausgabekonfigurationen für RV1103/RV1103B/RV1106/RV1106B
| Modelltyp | Ausgabedatentyp | Ausgabedimensionen | Unterstütztes Ausgabelayout |
|---|---|---|---|
| int8-Modell | int8/float16 | 4-dimensional | NCHW/NC1HWC2/NHWC |
| int8-Modell | int8/float16 | Nicht 4-dimensional | UNDEFINE |
rknn_create_mem
rknn_tensor_memory wird vor der Inferenz erstellt und eingerichtet; danach werden die Ergebnisse aus dem Speicher gelesen. Bleiben das über RKNN_QUERY_NATIVE_INPUT_ATTR und RKNN_QUERY_NATIVE_OUTPUT_ATTR abgefragte Layout und der Typ unverändert, genügt Speicher der Größe size_with_stride. Nach Typ- oder Layoutänderungen muss die Größe angepasst werden; beim Wechsel einer Ausgabe von int8 auf float32 etwa auf das Vierfache.
rknn_set_io_mem
rknn_set_io_mem() setzt die Struktur rknn_tensor_mem mit den Ein-/Ausgabespeicherinformationen des Modells. Wie rknn_init() muss es nur einmal zu Beginn aufgerufen werden; anschließend kann rknn_run() wiederholt ausgeführt werden.