
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 1/22
Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
1. Überblick und Entwicklungsvorbereitung
1.1 Überblick über das RKNN2 SDK
1.1.1 Zweck des SDK und typische Anwendungsszenarien
1.1.1.1 Überblick über den RKNN-Softwarestack
Der RKNN-Softwarestack ermöglicht die schnelle Bereitstellung von KI-Modellen auf Rockchip-Chips. Die Gesamtstruktur ist nachfolgend dargestellt:
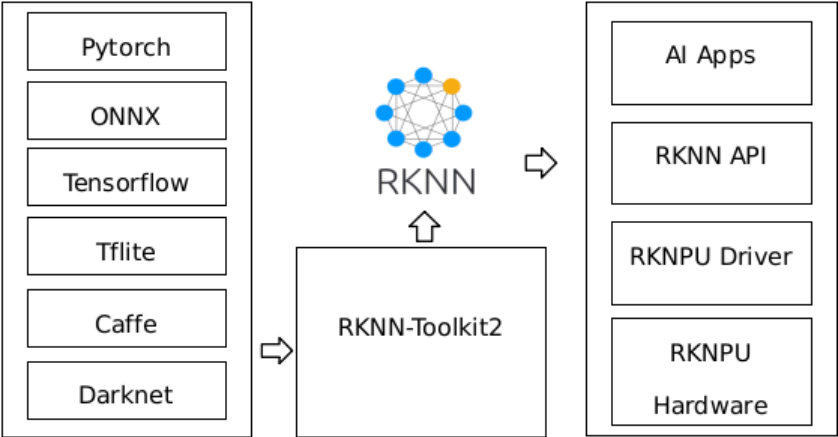
Abbildung 1-1: RKNN-Softwarestack
Um RKNPU zu verwenden, führen Sie zunächst RKNN-Toolkit2 auf dem Computer aus und konvertieren das trainierte Modell in das RKNN-Format. Anschließend stellen Sie es mithilfe der RKNN-C-API oder Python auf der Entwicklungsplatine bereit.
1.1.1.2 Funktionen von RKNN-Toolkit2
RKNN-Toolkit2 ist eine Entwicklungsumgebung für Modellkonvertierung, Inferenz und Modellbewertung auf dem Computer. Das grundlegende Blockdiagramm ist nachfolgend dargestellt:
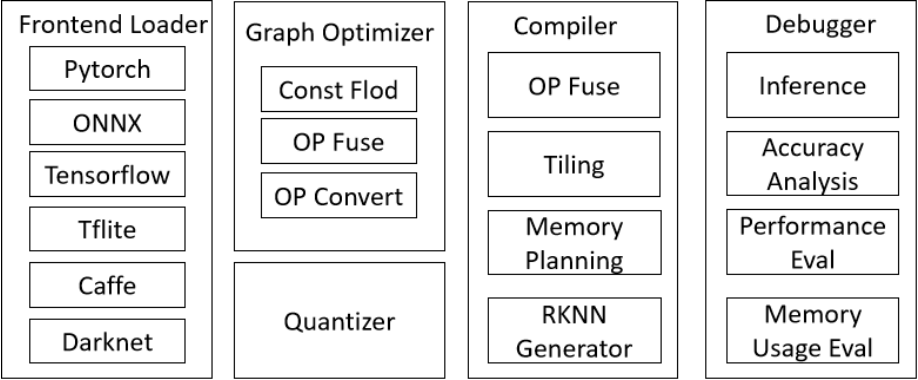
Abbildung 1-2: Softwarediagramm von RKNN-Toolkit2
Die praktische Python-Schnittstelle stellt folgende Funktionen bereit:
1 Modellkonvertierung: Umwandlung von Modellen aus PyTorch, ONNX, TensorFlow, TensorFlow Lite, Caffe, DarkNet und weiteren Formaten in RKNN-Modelle.
2 Quantisierung: Quantisierung von Gleitkommamodellen zu Festkommamodellen. Auch gemischte Quantisierung wird unterstützt.
3 Modellinferenz: Übertragen des RKNN-Modells auf das angegebene NPU-Gerät zur Inferenz und Ergebnisausgabe oder Simulieren der NPU auf dem Computer, um das RKNN-Modell auszuführen und Ergebnisse zu erhalten.
4 Leistungs- und Speicherbewertung: Übertragen des RKNN-Modells auf das angegebene NPU-Gerät, um Leistung und Speicherverbrauch bei der Ausführung auf dem tatsächlichen Gerät zu bewerten.
5 Analyse der Quantisierungsgenauigkeit: Ermittlung des Kosinusabstands und des euklidischen Abstands zwischen den Inferenzergebnissen jeder Schicht des quantisierten Modells und des Gleitkommamodells. Dadurch lassen sich Quantisierungsfehler untersuchen und Informationen zur Verbesserung der Genauigkeit gewinnen.
- Modellverschlüsselung: Das RKNN-Modell wird mit einem hybriden Verfahren aus AES-256-CTR und RSA-OAEP verschlüsselt, um das geistige Eigentum am Modell zu schützen.
1.1.1.3 Funktionen der RKNN Runtime
RKNN Runtime lädt das RKNN-Modell und ruft den NPU-Treiber auf, um es auf der NPU auszuführen. Die Inferenz umfasst die Vorverarbeitung der Rohdaten, die Modellausführung auf der NPU und die Nachverarbeitung der Ausgabe. Abhängig von Eingabeformat und Quantisierung bietet RKNN Runtime zwei Abläufe: allgemeine API und Zero-Copy-API.
Inferenz über die allgemeine API: ein einfacher, leicht nutzbarer Satz von Inferenzschnittstellen mit niedriger Einstiegshürde. Abbildung 1-3 zeigt den Ablauf. Normalisierung, Quantisierung, Layoutkonvertierung und Dequantisierung erfolgen auf der CPU, die eigentliche Modellinferenz auf der NPU.
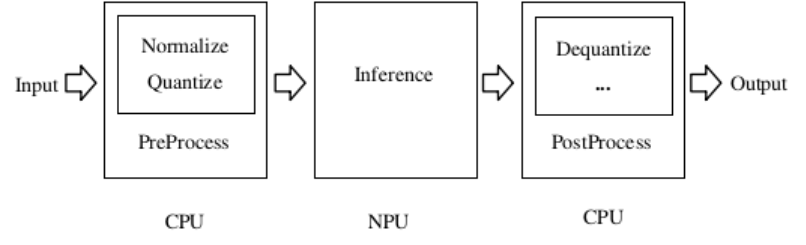
Abbildung 1-3. Datenverarbeitung der allgemeinen API
Inferenz über die Zero-Copy-API: Der Ablauf in Abbildung 1-4 optimiert die Datenverarbeitung der allgemeinen API. Normalisierung, Quantisierung und Modellinferenz erfolgen auf der NPU; die Layoutkonvertierung der NPU-Ausgabe und die Dequantisierung auf CPU oder NPU. Die Zero-Copy-API verarbeitet den Eingabestrom effizienter. Daten können ohne Kopieren zwischen IP-Blöcken fließen und dadurch CPU-Last und DDR-Bandbreitenbedarf verringern. Beispielsweise lassen sich Kamera- oder Decoderdaten ohne Kopie in die NPU importieren.
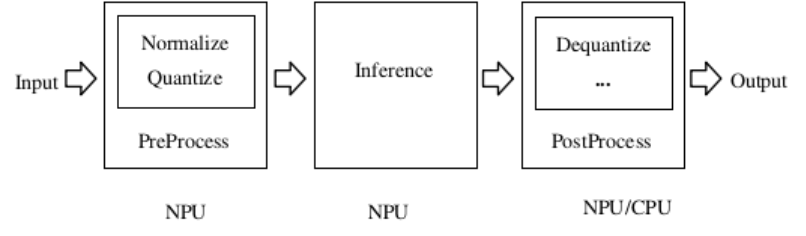
Abbildung 1-4: Datenverarbeitung der Zero-Copy-API
Besitzen die Eingabedaten nur eine virtuelle Adresse, ist ausschließlich die allgemeine API nutzbar. Bei einer physischen Adresse oder einem fd stehen beide APIs zur Verfügung.
1.1.2 Unterstützte Hardwareplattformen und Bereitstellungsarten
Dieses Dokument gilt für folgende Hardwareplattformen:
RV1103, RV1103B, RV1106, RV1106B, RK2118, RK3562, RK3566-Serie, RK3568-Serie, RK3576, RK3588-Serie, RV1126B
Hinweis: RK3566_RK3568 bezeichnet in diesem Dokument die RK3566/RK3568-Serien. RK3588 bezeichnet die RK3588/RK3588S-Serien.
1.1.3 Begriffe, Abkürzungen und Dokumentkonventionen
Dieser Abschnitt erläutert häufig verwendete Begriffe und Abkürzungen.
Hardware und Bereitstellung
Inferenz mit angeschlossenem Board: Der PC ist per USB mit dem Entwicklungsboard verbunden. RKNN-Toolkit2 auf dem PC startet die Inferenz, das Modell läuft auf der NPU des Boards. Dies dient der Modellprüfung und Genauigkeitsanalyse.
Modelle und Tensoren
RKNN-Modell: eine auf RKNPU ausführbare Modelldatei mit der Erweiterung .rknn.
Tensor: eine Datenstruktur für mehrdimensionale Arrays mit Datenspeicher und Attributen wie shape / dtype / layout.
Datentyp (dtype): Typ der Tensorelemente, beispielsweise FP32 / FP16 / INT8 / UINT8.
Datenlayout (layout): Anordnung eines Tensors im Speicher, beispielsweise NCHW / NHWC / NC1HWC2.
NC1HWC2: ein NPU-optimiertes Speicherlayout, das die Kanaldimension blockweise speichert, um den Zugriff effizienter zu machen. Die Unterkanalanzahl der einzelnen Plattformen steht in Abschnitt 3.1.2 zum NPU-Layout.
Quantisierung
Quantisiertes Modell: ein Modell mit Datentypen geringer Präzision wie INT8; für Quantisierung und Dequantisierung werden scale und zero_point benötigt.
Nicht quantisiertes Modell: ein mit FP16 ausgeführtes Modell ohne Quantisierungsparameter.
Dokumentkonventionen
Mit # beginnende Zeilen in Codeblöcken sind Kommentare.
Inhalte in <> sind Parameterplatzhalter und durch tatsächliche Werte zu ersetzen.
Funktions-, Parameter- und Dateinamen stehen in Backticks (`).
Ausführliche API-Parameterbeschreibungen stehen im jeweiligen API-Referenzhandbuch.