
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 3/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
1.3 Entwicklungsablauf und Schnittstellenwahl
1.3.1 Allgemeiner Modellentwicklungsablauf
Das folgende Flussdiagramm zeigt die RKNN-Entwicklungsschritte. Der Ablauf umfasst Modellkonvertierung, Modellbewertung sowie Bereitstellung und Ausführung auf dem Board.
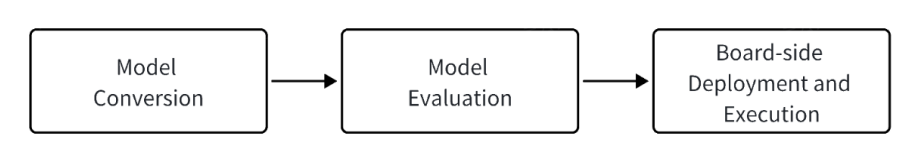
Abbildung 1-5: RKNN-Entwicklungsablauf
1 Modellkonvertierung
In dieser Phase wird das ursprüngliche Deep-Learning-Modell für effiziente RKNPU-Inferenz in RKNN konvertiert. Sie umfasst fünf Schritte:
a. Ausgangsmodell beschaffen: Ein Modell beziehen oder trainieren. Empfohlen werden gängige Frameworks wie ONNX, PyTorch oder TensorFlow.
b. Modell konfigurieren: In RKNN-Toolkit2 beispielsweise Normalisierung, Quantisierung und Zielplattform einstellen.
c. Modell laden: Das Modell über die zum Framework passende Ladeschnittstelle in RKNN-Toolkit2 importieren.
d. Modell bauen: Das RKNN-Modell mit rknn.build() erstellen; optional quantisieren, um die Inferenzleistung auf der Hardware zu verbessern.
e. Modell exportieren: Das RKNN-Modell mit rknn.export_rknn() als .rknn-Datei für die anschließende Bereitstellung speichern.
Einzelheiten stehen in Abschnitt 2.1 zur allgemeinen Modellkonvertierung.
2 Modellbewertung
Diese Phase bewertet Ergebnisgenauigkeit, Inferenzleistung und Speicherbedarf. Die wesentlichen Schritte:
a. Board-Debugging: Über Python die RKNPU-Plattform verbinden, Inferenz ausführen und Ergebnisgenauigkeit prüfen. Ein- und Ausgabeverarbeitung gehören dazu, damit das Modell auf dem Board korrekt läuft.
b. Genauigkeit bewerten: Mit rknn.accuracy_analysis() die Ergebnisse von quantisiertem und Gleitkommamodell vergleichen, um Quantisierungsfehler zu analysieren.
c. Leistung bewerten: rknn.eval_perf() analysiert die Inferenz auf RKNPU und unterstützt Struktur- und Geschwindigkeitsoptimierungen.
d. Speicher bewerten: rknn.eval_memory() ermittelt den Speicherbedarf auf RKNPU und unterstützt Strukturänderungen zur Speicherreduktion.
Einzelheiten siehe 2.3 zur Modellbewertung, 3.2 zur C-API-Bereitstellung allgemeiner Modelle und
3.3 zur Bereitstellung mit Toolkit Lite Python.
3. Bereitstellung und Ausführung auf dem Board:
Diese Phase umfasst die tatsächliche Bereitstellung und Ausführung des Modells, üblicherweise mit folgenden Schritten:
a. Initialisierung: Das RKNN-Modell auf der RKNPU-Plattform laden und die Vorverarbeitung vorbereiten.
b. Vorverarbeitung: Die zu verarbeitenden Daten auf die RKNPU-Plattform laden und die Inferenz vorbereiten.
c. Inferenz: Eingabedaten an das Modell übergeben und die Inferenzergebnisse erhalten.
d. Nachverarbeitung: Inferenzergebnisse nachverarbeiten und an die Anwendung weitergeben.
e. Modell freigeben: Nach der Inferenz die Modellressourcen freigeben, damit das RKNN-Modell für andere Aufgaben verfügbar ist.
Einzelheiten siehe 3.3 zur Bereitstellung mit Toolkit Lite Python.
Diese drei Phasen bilden den vollständigen RKNN-Prozess aus Konvertierung, Debugging, Bewertung und effizienter Bereitstellung von KI-Modellen auf RKNPU.
1.3.2 Schnittstelle auswählen
Das RKNN2 SDK bietet zwei boardseitige Aufrufmöglichkeiten; die Wahl richtet sich nach dem Einsatzszenario:
| Methode | Sprache | Anwendungsfälle |
|---|---|---|
| RKNN Runtime (C API) | C / C++ | Produktivbereitstellung, leistungskritische Anwendungen |
| RKNN-Toolkit Lite2 (Python API) | Python | Schnelle Prüfung auf dem Board, Prototypentwicklung |
Unterschiede:
Leistung: Die C API bietet die höchste Leistung; Toolkit Lite liegt durch den Python-Wrapper etwas darunter.
Entwicklungskomfort: Toolkit Lite ist bequemer durch Python und den Verzicht auf Cross-Compilation. Die C API erfordert Cross-Compilation und Integration in die Board-Anwendung.
Funktionsumfang: Die C API unterstützt sämtliche erweiterten Funktionen wie Zero-Copy, mehrere NPU-Kerne, Matrixmultiplikation, dynamische Formen, SRAM und Modellverschlüsselung. Toolkit Lite dient der schnellen Board-Prüfung und deckt weniger erweiterte Funktionen ab.
Auswahlempfehlungen:
Produktivbetrieb oder leistungskritische Szenarien: Die C API bietet optimale Leistung, vollständige Funktionen und Sicherheitsmerkmale wie verschlüsselte Modellbereitstellung.
Board-Prüfung oder Prototypenentwicklung: Toolkit Lite benötigt keine Cross-Compilation und erlaubt mit einer konvertierten .rknn-Datei eine schnelle Ergebnisprüfung.
Hinweis: Die Schnittstellen sind in 3.2 zur C-API-Bereitstellung und 3.3 zu Toolkit Lite Python ausführlich beschrieben.
1.3.3 Konvertierungs- und Bereitstellungsartefakte
Nach der Modellkonvertierung entstehen folgende Bereitstellungsartefakte:
| Datei/Verzeichnis | Beschreibung |
|---|---|
| .rknn | RKNN-Modelldatei mit Modellstruktur und Gewichten |
| C++-Bereitstellungsbeispiel (optional) | Wird über cpp_gen_cfg in rknn.export_rknn() oder über rknn.codegen() erzeugt; ermöglicht direkte Leistungs- und Genauigkeitsprüfung sowie Weiterentwicklung |
Hinweis: RKNN2 exportiert eine einzelne .rknn-Datei mit Modellstruktur und Gewichten. Diese wird auf das Board übertragen: Die C API lädt sie mit rknn_init(), Toolkit Lite2 laut Quelltext mit init(). Artefakte für verschlüsselte Bereitstellung beschreibt 4.2.2 zur Modellverschlüsselung.