
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 11/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
4. Erweiterte Funktionen und Erweiterungen
4.1 Erweiterte Laufzeitfunktionen
4.1.1 API für Matrixmultiplikation
Matmul ist eine separate C-API der Runtime zur Matrixmultiplikation auf der NPU (RK2118 sowie RV1103-/RV1106-Serien werden noch nicht unterstützt). Diese wichtige Operation der linearen Algebra lautet C=AB: A ist M×K, B ist K×N und C ist M×N.
4.1.1.1 Eigenschaften und Verwendung
Die Matmul-API dient überwiegend Parameterberechnungen im Deep Learning. Die Hauptmodule verbreiteter Transformer-Modelle, Selbstaufmerksamkeit und Feedforward-Netzwerkschichten, verwenden beispielsweise intensiv Matrixmultiplikationen. Deren Effizienz ist daher entscheidend für die Transformer-Gesamtleistung. Eigenschaften der Matmul-API:
Effizient: Die Implementierung auf RKNPU verbindet hohe Leistung mit geringer Leistungsaufnahme.
Flexibel: Kein RKNN-Modell muss geladen werden. Unterstützt werden die für Edge-Computing üblichen Eingabetypen int4, int8 und float16 sowie eine separate Speicherzuweisungsschnittstelle oder externer Speicher. Benutzer können damit Matrix-Ein-/Ausgabespeicher verwalten und wiederverwenden.
4.1.1.2 Flussdiagramm der Matmul-API
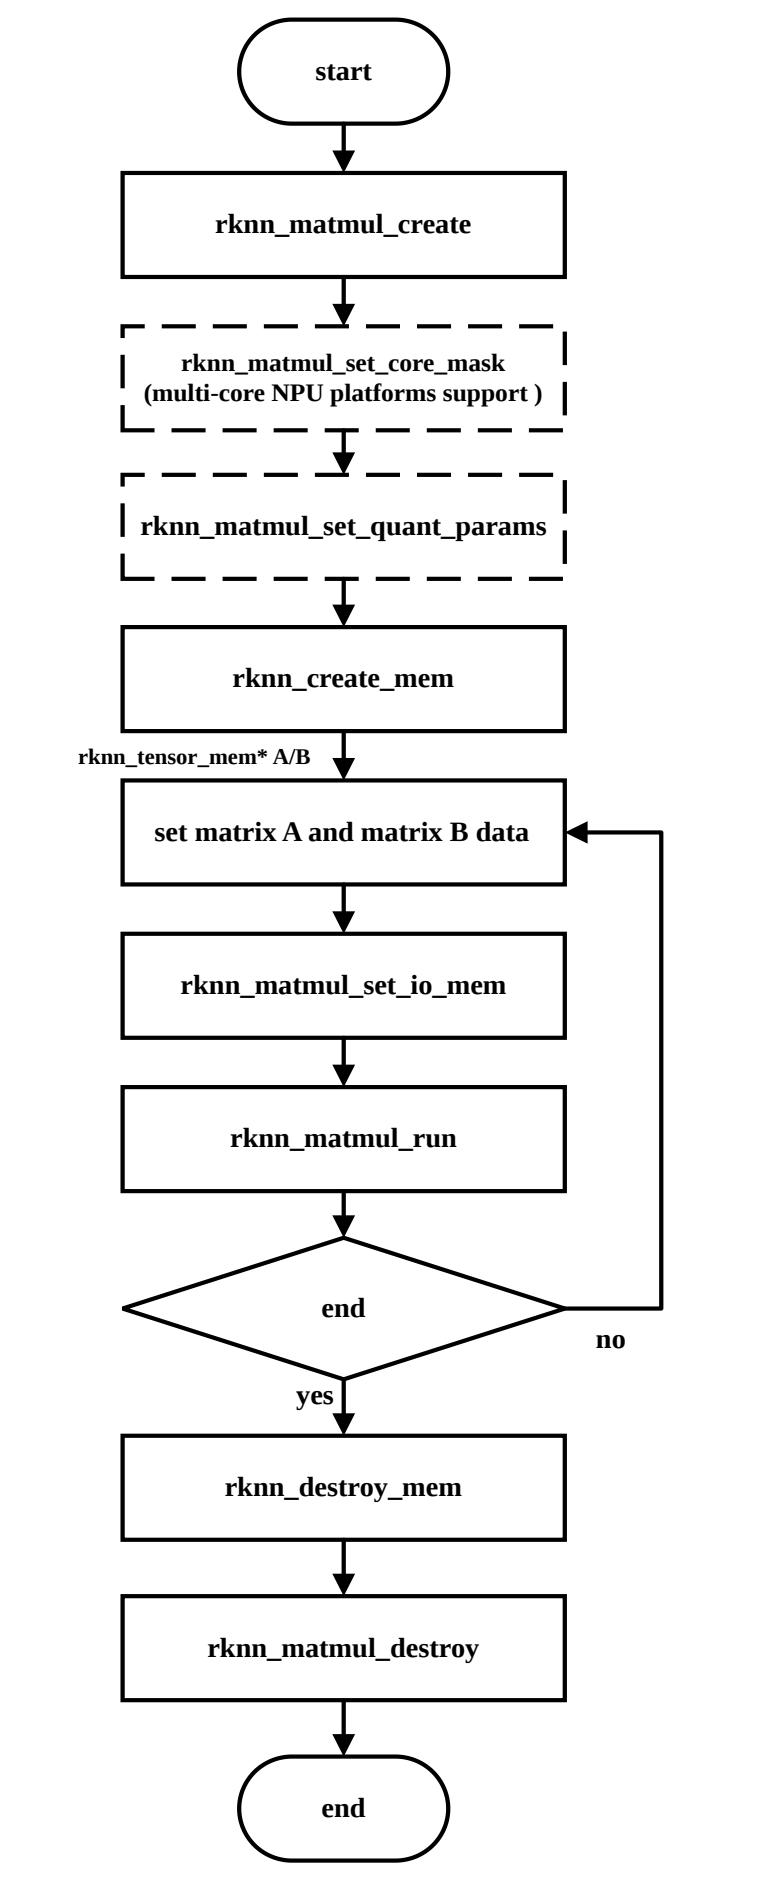
Abbildung 4-1. Grundablauf der Matmul-API
Strukturen und Schnittstellen der Matmul-API befinden sich in rknn_matmul_api.h; diesen Header beim Kompilieren einbinden. Der grundlegende Ablauf der Matmul-API ist oben dargestellt.
Die Matmul-API wird gewöhnlich wie folgt verwendet:
-
Kontext erstellen: rknn_matmul_info mit M, K, N, Datentypen, Layouts der Ein-/Ausgabematrizen und weiteren Angaben setzen. rknn_matmul_create zur Initialisierung aufrufen. Anschließend den Zeiger rknn_matmul_io_attr mit den Tensorinformationen der Ein-/Ausgabematrizen abrufen.
-
NPU-Kern festlegen (nur auf Mehrkernplattformen): rknn_matmul_set_core_mask mit der Maske des gewünschten Kerns aufrufen. Ohne diesen Aufruf wird auf einer Mehrkern-NPU automatisch ein freier Kern gewählt.
-
Quantisierungsparameter von A, B und C setzen: rknn_quant_params der jeweiligen Matrizen an rknn_matmul_set_quant_params übergeben. Ohne Aufruf gelten für jede Matrix scale=1.0, zero_point=0.
-
Ein-/Ausgabespeicher mit rknn_create_mem anhand der Größen aus den Matrixtensorinformationen erzeugen.
-
Eingabematrizen A und B entsprechend Form und Datentyp befüllen und Quantisierungsparameter passend zu den quantisierten Werten setzen.
-
Speicher mit rknn_matmul_set_io_mem setzen: Befüllte Eingabematrix und Ausgabespeicher werden im Kontext hinterlegt. Neben den Adressen ordnet die Schnittstelle Daten gemäß konfiguriertem Layout neu an. Deshalb nach dem Befüllen oder Aktualisieren der Eingabe aufrufen. Dieses Verhalten unterscheidet sich von rknn_set_io_mem der Zero-Copy-API.
-
Nach dem Setzen des Ein-/Ausgabespeichers die Matrixmultiplikation mit rknn_matmul_run ausführen.
-
Nach der Multiplikation das Ergebnis entsprechend dem konfigurierten Layout aus dem Ausgabespeicher lesen.
-
Nach Abschluss Speicher mit rknn_destroy_mem und Kontext mit rknn_matmul_destroy freigeben.
4.1.1.3 Erweiterte Verwendung der Matmul-API
Beim Erstellen des Kontexts rknn_matmul_info setzen. Die Struktur beschreibt den Umfang der Matrixmultiplikation sowie Datentypen und Layouts der Ein-/Ausgabematrizen. B_layout und AC_layout legen leistungsoptimierte Layouts fest. Definition:
Tabelle 4-1. Struktur rknn_matmul_info
| Member | Datentyp | Beschreibung |
|---|---|---|
| M | int32_t | Zeilenanzahl von A |
| K | int32_t | Spaltenanzahl von A |
| Member | Datentyp | Beschreibung |
|---|---|---|
| N | int32_t | Spaltenanzahl von B |
| type | rknn_matmul_type | Datentypen der Ein- und Ausgabematrizen: RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32: A=float16, B=float16, C=float32. RKNN_INT8_MM_INT8_TO_INT32: A=int8, B=int8, C=int32. RKNN_INT8_MM_INT8_TO_INT8: A=int8, B=int8, C=int8. RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16: A=float16, B=float16, C=float16. RKNN_FLOAT16_MM_INT8_TO_FLOAT32: A=float16, B=int8, C=float32. RKNN_FLOAT16_MM_INT8_TO_FLOAT16: A=float16, B=int8, C=float16. RKNN_FLOAT16_MM_INT4_TO_FLOAT32: A=float16, B=int4, C=float32. RKNN_FLOAT16_MM_INT4_TO_FLOAT16: A=float16, B=int4, C=float16. RKNN_INT8_MM_INT8_TO_FLOAT32: A=int8, B=int8, C=float32. RKNN_INT4_MM_INT4_TO_INT16: A=int4, B=int4, C=int16. RKNN_INT8_MM_INT4_TO_INT32: A=int8, B=int4, C=int32. |
| B_layout | int16_t | Layout von B: RKNN_MM_LAYOUT_NORM: ursprüngliche Form KxN; RKNN_MM_LAYOUT_NATIVE: leistungsoptimierte Form; RKNN_MM_LAYOUT_TP_NORM: transponierte Form NxK. |
| B_quant_type | int16_t | Quantisierung von B: RKNN_QUANT_TYPE_PER_LAYER_SYM: symmetrisch Per-Layer; RKNN_QUANT_TYPE_PER_LAYER_ASYM: asymmetrisch Per-Layer; RKNN_QUANT_TYPE_PER_CHANNEL_SYM: symmetrisch Per-Channel; RKNN_QUANT_TYPE_PER_CHANNEL_ASYM: asymmetrisch Per-Channel; RKNN_QUANT_TYPE_PER_GROUP_SYM: symmetrisch Per-Group; RKNN_QUANT_TYPE_PER_GROUP_ASYM: asymmetrisch Per-Group. |
| Member | Datentyp | Beschreibung |
|---|---|---|
| AC_layout | int16_t | Layout von A und C: RKNN_MM_LAYOUT_NORM: ursprüngliche Formen; RKNN_MM_LAYOUT_NATIVE: leistungsoptimierte Formen. Details siehe 4.1.1.4 „Leistungsoptimierte Datenlayouts“. |
| AC_quant_type | int16_t | Quantisierung von A und C: RKNN_QUANT_TYPE_PER_LAYER_SYM: symmetrisch Per-Layer; RKNN_QUANT_TYPE_PER_LAYER_ASYM: asymmetrisch Per-Layer. |
| iommu_domain_id | int32_t | Index der IOMMU-Adressraumdomäne des Kontexts. Adressräume entsprechen Kontexten eins zu eins und sind jeweils 4GB groß. Vor allem für große A/B/C erforderlich, wenn die NPU-Zuweisung 4GB überschreitet und eine andere Domäne benötigt wird. |
| group_size | int16_t | Elementanzahl je Gruppe; nur bei aktivierter Gruppenquantisierung wirksam. |
| reserved | int8_t[] | Reserviertes Feld |
Ursprüngliche Form: A ist MxK, B ist KxN, C ist MxN.
4.1.1.3.1 Matrixmultiplikation mit vorgegebenen Quantisierungsparametern
Wenn das höherbitige Produkt in niedrigere Bitbreite quantisiert werden soll, beispielsweise bei A, B und C vom Typ int8, sind Quantisierungsparameter erforderlich. Dies sind scale und zero_point in rknn_quant_params. Für A und C werden sie mit rknn_matmul_set_quant_params gesetzt. Danach können die Per-Channel-Parameter von B mit rknn_matmul_get_quant_params gelesen werden. Definition von rknn_quant_params:
Tabelle 4-2. Struktur rknn_quant_params
| Member | Datentyp | Beschreibung |
|---|---|---|
| name | char[] | Matrixname |
| scale | float* | Startadresse des Quantisierungsarrays scale |
| scale_len | int32_t | Länge des Quantisierungsarrays scale |
| zp | int32_t* | Startadresse des Quantisierungsarrays zero_point |
| zp_len | int32_t | Länge des Quantisierungsarrays zero_point |
Matmul unterstützt Per-Layer, Per-Channel und Per-Group. Parameterunterschiede:
Per-Layer: Die Arrays scale und zp haben die Länge 1.
Per-Channel: Länge der Arrays scale und zp ist N.
Per-Group: Länge von scale und zp ist N*K/group_size. group_size legt die Elementzahl je Gruppe fest; Elemente einer Gruppe teilen die Parameter. In den Arrays werden zunächst Parameter für K/group_size Gruppen und anschließend N Quantisierungsparameter gespeichert.
Jede Methode kann symmetrisch (alle zp=0) oder asymmetrisch (nicht alle zp=0) sein.
4.1.1.3.2 Matrixmultiplikation mit dynamischer Eingabeform
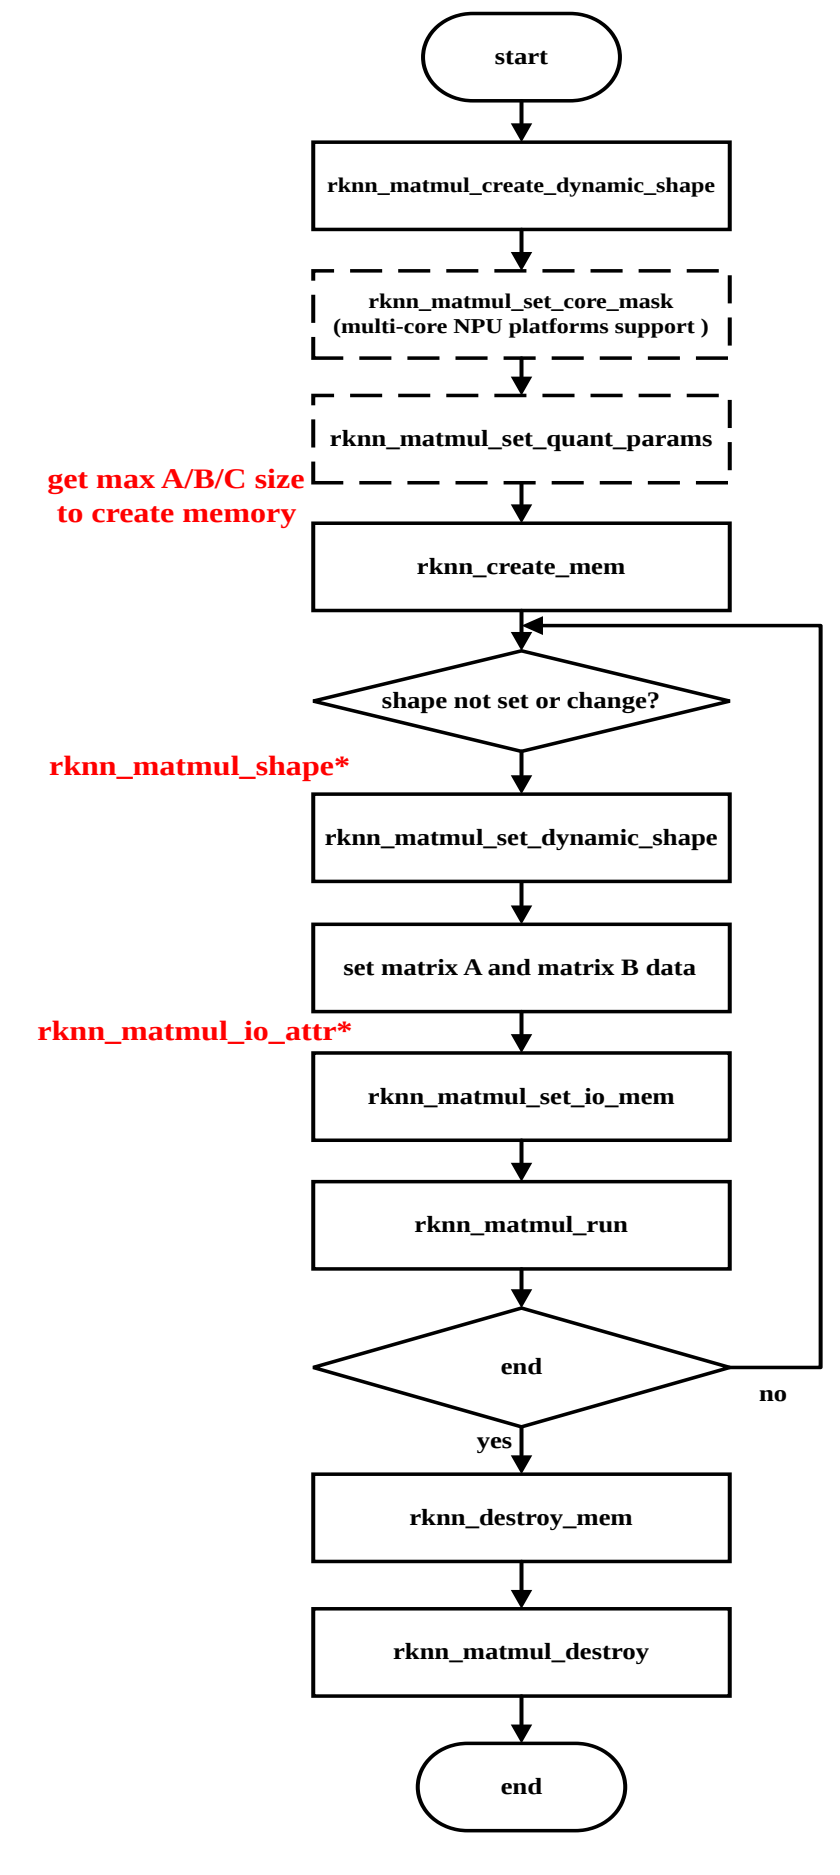
Abbildung 4-2. Matmul-Aufrufablauf bei dynamischer Eingabeform
Der Ablauf für dynamische Formen ist oben dargestellt. Unterschiede zur grundlegenden Matmul-API:
-
Kontext erstellen: Anzahl und Auswahl der Formen sowie rknn_matmul_info mit Datentypen, Ein-/Ausgabelayouts und weiteren Angaben konfigurieren. M, K und N in rknn_matmul_info müssen für dynamische Formen nicht gesetzt werden. rknn_matmul_create_dynamic_shape aufrufen. Das erhaltene Array rknn_matmul_io_attr enthält Ein-/Ausgabematrixinformationen für sämtliche Formkonfigurationen.
-
Speicher erzeugen: Zunächst maximale Tensorgrößen im Array rknn_matmul_io_attr ermitteln, dann mit rknn_create_mem Speicher für die maximalen Ein-/Ausgabematrixgrößen zuweisen.
3 Die aktuelle Eingabeform mit rknn_matmul_set_dynamic_shape und einem Zeiger auf rknn_matmul_shape festlegen.
4 Speicher mit rknn_matmul_set_io_mem setzen: Die gefüllte Eingangsmatrix und der Ausgabespeicher werden in den Kontext eingetragen. rknn_tensor_mem bezeichnet den zuvor angelegten Speicher maximaler Größe; rknn_matmul_tensor_attr enthält die zur aktuellen Form passenden Matrixattribute.
4.1.1.4 Leistungsoptimiertes Datenlayout
Die spezialisierte NPU-Hardware liest MxK/KxN beziehungsweise schreibt C als MxN nicht optimal. Spezielle Layouts erhöhen die Leistung. AC_layout steuert das leistungsoptimierte Layout von A und C, B_layout das von B. Für die ursprünglichen Formen A=MxK, B=KxN, C=MxN gelten folgende Layouts:
1 Bei AC_layout=RKNN_MM_LAYOUT_NORM und B_layout=RKNN_MM_LAYOUT_NORM haben A, B und C die Formen [M,K], [K,N] und [M,N].
-
Bei AC_layout=RKNN_MM_LAYOUT_NATIVE und B_layout=RKNN_MM_LAYOUT_NATIVE gelten die folgenden Layouts je Plattform und Datentyp. Divisionsergebnisse werden aufgerundet, zusätzliche Elemente mit 0 aufgefüllt.
-
B_layout=RKNN_MM_LAYOUT_NORM verwendet für B [K,N], RKNN_MM_LAYOUT_TP_NORM dagegen [N,K]. Letzteres bietet bessere Ausführungseffizienz.
Tabelle 4-3. Leistungsoptimierte Formen von A, B und C je Plattform
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| A Form (int4) | noch nicht unterstützt | noch nicht unterstützt | [K/32,M,32] | [K/32,M,32] |
| B Form (int4) | noch nicht unterstützt | noch nicht unterstützt | [N/64,K/32,64,32]* | [N/64,K/32,64,32] |
| C Form (int16) | noch nicht unterstützt | noch nicht unterstützt | [N/8,M,8] | [N/8,M,8] |
| A Form (int8) | [K/16,M,16] | [K/8,M,8] | [K/16,M,16] | [K/16,M,16] |
| B Form (int8) | [N/16,K/32,16,32] | [N/16,K/32,16,32] | [N/32,K/32,32,32]* | [N/32,K/32,32,32] |
| C Form (int32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
| A Form (float16) | [K/8,M,8] | [K/4,M,4] | [K/8,M,8] | [K/8,M,8] |
| B Form (float16) | [N/8,K/32,8,32] | [N/8,K/16,8,16] | [N/16,K/32,16,32] | [N/16,K/32,16,32] |
| C Form (float32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
Hinweis:
Die Tabelle gilt für gleiche Datentypen von A und B. RK3576/RV1126B unterstützen heterogene Eingaben. Dabei entspricht das leistungsoptimierte B-Layout dem B-Layout des gleichartigen Falls zum Datentyp von C. Beispiel: A=int4, B=float16, C=float32 ergibt B=[N/16,K/32,16,32]. rknn_B_normal_layout_to_native_layout wandelt die ursprüngliche B-Form in dieses Layout um.
Für RK3566/RK3568 und int8 zeigt die folgende Abbildung die Elementzuordnung von A beim Übergang [M,K] → [K/8,M,8]:
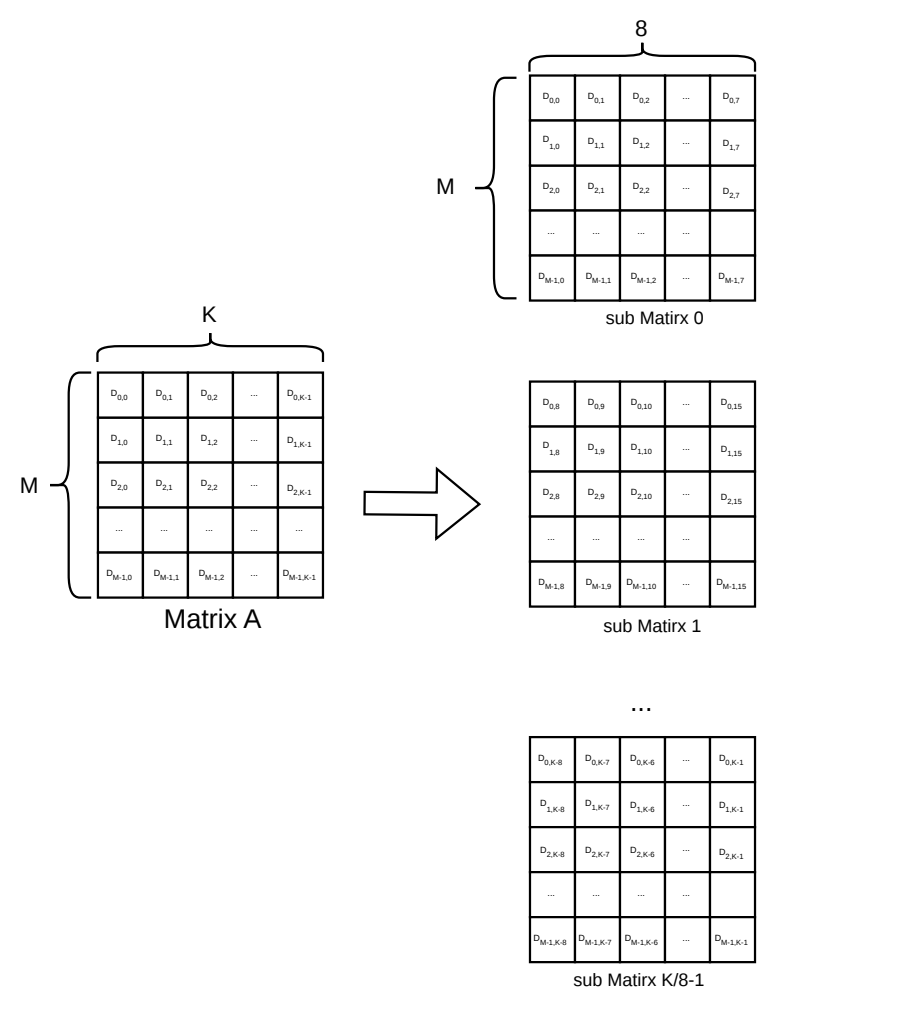
Abbildung 4-3. Elementzuordnung von int8-Matrix A: [M,K] nach [K/8,M,8]
Element (i,j) von A ist Di,j. Links steht die Form [M,K], rechts K/8 kleine Matrizen [M,8] von oben nach unten.
Beispielcode zur Umwandlung von A oder C aus der ursprünglichen in die leistungsoptimierte Form:
template <typename Ti, typename To>
void norm_layout_to_perf_layout(Ti *src, To *dst, int32_t M, int32_t K, int32_t
subK){
    int outter_size = (int)std::ceil(K * 1.0f / subK);
    for (int i = 0; i < outter_size; i++)
    {
        for (int m = 0; m < M; m++)
        {
           for (int j = 0; j < subK; j++)
           {
               int ki = i * subK + j;
               if (ki >= K)
               {
                 dst[i * M * subK + m * subK + j] = 0;
               }
               else
               {
                 dst[i * M * subK + m * subK + j] = src[m * K + ki];
               }
           }
        }
    }
}
Für RK3566/RK3568 und int8 zeigt die folgende Abbildung die B-Elementzuordnung bei [K,N] → [N/16,K/32,16,32]:
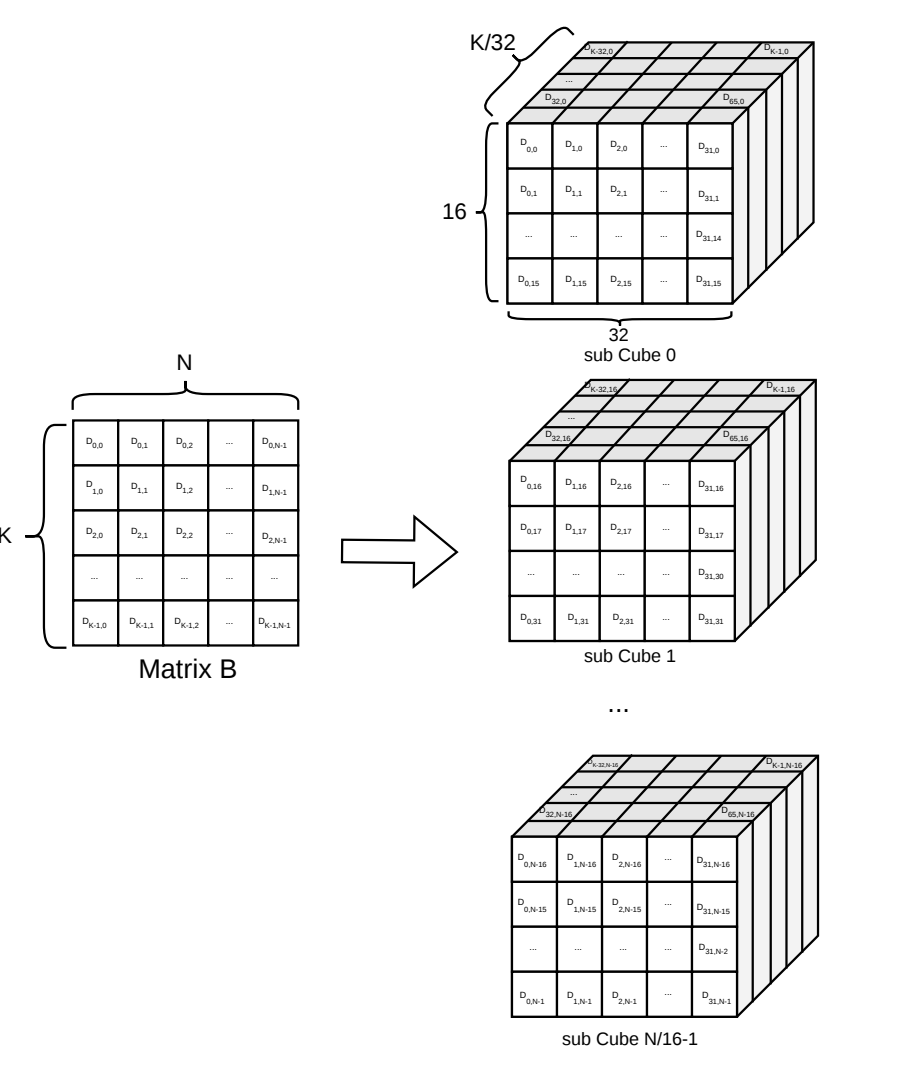
Abbildung 4-4. Elementzuordnung der int8-Matrix B von [K,N] nach [N/16,K/32,16,32]
Element (i,j) von B ist Di,j. Links ist die Form [K,N], rechts N/16 kleine Quader [K/32,16,32] von oben nach unten.
Beispielcode zur Umwandlung von B in die leistungsoptimierte Form:
template <typename Ti, typename To>
voi norm_layout_to_native_layout(Ti *src, To *dst, int32_t K, int32_t N, int32_t
subN, int32_t subK)
{
    int N_remain = (int)std::ceil(N * 1.0f / subN);
    int K_remain = (int)std::ceil(K * 1.0f / subK);
    for (int i = 0; i < N_remain; i++)
    {
        for (int j = 0; j < K_remain; j++)
        {
           for (int n = 0; n < subN; n++)
           {
               int ni = i * subN + n;
               for (int k = 0; k < subK; k++)
               {
                   int ki = j * subK + k;
                   if (ki < K && ni < N)
                   {
                       dst[((i * K_remain + j) * subN + n) * subK + k] = src[ki * N + ni];
                   }
                   else
                   {
                       dst[((i * K_remain + j) * subN + n) * subK + k] = 0;
                   }
               }
           }
        }
    }
}
Hinweis:
Vollständiges Matmul-Beispiel: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_matmul_api_demo.
4.1.1.4.1 Einschränkungen der Matrixspezifikation
Matmul basiert auf der NPU-Architektur und unterliegt Hardwaregrenzen. Parameterbeschränkungen:
AC_layout und B_layout lassen sich unabhängig setzen. Die Quelle behauptet: Beide unterstützen RKNN_MM_LAYOUT_NORM oder RKNN_MM_LAYOUT_TP_NORM auf allen Plattformen; zugleich unterstützen alle Plattformen außer RK3566/RK3568 RKNN_MM_LAYOUT_TP_NORM.
Matmul unterstützt mehrere Ein-/Ausgabebitbreiten. Unterstützte Kombinationen je Plattform:
Tabelle 4-4. Von Matmul unterstützte Typkombinationen für A, B und C
| Laufende Nummer | RK356X | RK3576/RV1126B | RK3588 |
|---|---|---|---|
| 1 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 |
| 2 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 |
| 3 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_INT8_MM_INT8_TO_INT32 | |
| 4 | RKNN_FLOAT16_MM_INT8_TO_FLOAT32 | RKNN_INT8_MM_INT8_TO_FLOAT32 | |
| 5 | RKNN_FLOAT16_MM_INT4_TO_FLOAT16 | RKNN_INT8_MM_INT8_TO_INT8 | |
| 6 | RKNN_FLOAT16_MM_INT4_TO_FLOAT32 | RKNN_INT4_MM_INT4_TO_INT16 | |
| 7 | RKNN_INT8_MM_INT4_TO_INT32 |
RK356X bezeichnet RK3562/RK3566/RK3568. float16 folgt IEEE-754; Formatdetails siehe IEEE-754 half.
Größenbeschränkungen für K und N:
Tabelle 4-5. K-/N-Größenbeschränkungen je Plattform
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| K Größenbegrenzung (int4) | noch nicht unterstützt | noch nicht unterstützt | * | 32-aligned |
| K Größenbegrenzung (int8) | K <= 10240 und K mod 32 = 0 | K <= 10240 und K mod 32 = 0 | 32-aligned | 32-aligned |
| K Größenbegrenzung (float16) | K <= 10240 und K mod 32 = 0 | K <= 10240 und K mod 32 = 0 | 32-aligned | 32-aligned |
| N Größenbegrenzung (int4) | noch nicht unterstützt | noch nicht unterstützt | * | N <= 8192 und N mod 64 = 0 |
| N Größenbegrenzung (int8) | N <= 4096 und N mod 16 = 0 | N <= 4096 und N mod 16 = 0 | N <= 4096 und N mod 32 = 0 | N <= 4096 und N mod 32 = 0 |
| N Größenbegrenzung (float16) | N <= 4096 und N mod 16 = 0 | N <= 4096 und N mod 16 = 0 | N <= 4096 und N mod 32 = 0 | N <= 4096 und N mod 32 = 0 |
Hinweis:
- bezeichnet dieselben Größen- und Ausrichtungsgrenzen für B wie beim Datentyp von A auf derselben Plattform. Beispielsweise gelten für B bei RKNN_FLOAT16_MM_INT4_TO_FLOAT32 dieselben Grenzen wie bei RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32.
Für RK3588:
Bei K > 8192 wird B in T Segmente aufgeteilt,
int T = std::ceil(K / 8192);
Beispiel: normal layout -> native layout, K = 20488, N = 4096, T = 3; die Daten werden in 3 Segmente aufgeteilt.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
K,N werden folgendermaßen umgeformt:
                     (8196, 4096) (4096 / subN, 8196 / subK, subN, subK)
 (K, N) = (20488, 4096)->(8196, 4096)->(4096 / subN, 8196 / subK, subN, subK)
         normal layout (4096, 4096) (4096 / subN, 4096 / subK, subN, subK)
                   T normal layout T native layout
Für die direkte Datenkonvertierung wird rknn_B_normal_layout_to_native_layout empfohlen.
Für RK3576/RV1126B: Bei K > 4096 wird B in T Segmente aufgeteilt,
int T = std::ceil(K / 4096);
Beispiel: normal layout -> native layout, K = 10240, N = 2048, T = 3; die Daten werden in 3 Segmente aufgeteilt.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
K,N werden folgendermaßen umgeformt:
                        (4096, 2048) (2048 / subN, 4096 / subK, subN, subK)
(K, N) = (10240, 2048) -> (4096, 2048) -> (2048 / subN, 4096 / subK, subN, subK)
        normal layout (2048, 2048) (2048 / subN, 2048 / subK, subN, subK)
                     T normal layout T native layout
Für die direkte Datenkonvertierung wird rknn_B_normal_layout_to_native_layout empfohlen.