
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 7/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
3. Bereitstellung auf dem Board
3.1 Grundlagen der Runtime-Bereitstellung
Dieser Abschnitt erläutert die Grundlagen der RKNN Runtime als Voraussetzung für die Bereitstellung auf dem Board über C API oder Toolkit Lite: Lebenszyklus von Modell und Kontext, Tensoren und Datenlayouts, Ein-/Ausgabespeicher, synchrone und asynchrone Inferenz sowie Fehlerbehandlung und Ressourcenfreigabe.
3.1.1 Lebenszyklus von Modell und Kontext
rknn_context ist das zentrale Handle der RKNN Runtime und repräsentiert eine Laufzeitkontextinstanz. Modellladen, Attributabfragen und Inferenz erfolgen über dieses Handle. Halten Sie bei der Bereitstellung den Lebenszyklus „erstellen → verwenden → zerstören“ strikt ein, um Ressourcenlecks und Laufzeitfehler zu vermeiden.
Erstellen: rknn_init() initialisiert den Kontext und lädt das RKNN-Modell. Nach erfolgreicher Initialisierung stehen Gewichte und benötigter interner Laufzeitspeicher bereit.
Verwenden: Fragen Sie Ein-/Ausgabeattribute mit rknn_query() ab und führen Sie wiederholt Inferenz über die allgemeine API (rknn_inputs_set() / rknn_run() / rknn_outputs_get()) oder die Zero-Copy-API (rknn_set_io_mem() + rknn_run()) aus. Das Handle bleibt unverändert. Auf RK3588 / RK3576 lassen sich vor der Inferenz NPU-Kerne mit rknn_set_core_mask() auswählen; siehe 4.1.2.
Zerstören: Nach Abschluss aller Inferenzaufgaben zerstört rknn_destroy() den Kontext und gibt den gesamten Modellspeicher frei. Danach darf das Handle nicht mehr verwendet werden.
3.1.2 Tensoren und Datenlayouts
Ein- und Ausgaben eines RKNN-Modells werden als Tensoren verwaltet. Fragen Sie vor der Bereitstellung mit rknn_query() die Attribute rknn_tensor_attr ab: Name, Form, Datentyp (dtype), Layout und Quantisierungsparameter (qnt_type / qnt_info). Bereiten Sie Eingaben und die Auswertung der Ausgaben entsprechend vor.
Datentyp (dtype): FP32 / FP16 / INT8 / INT16 / UINT8 usw.; wird durch die Quantisierungskonfiguration bei der Konvertierung bestimmt. Quantisierte Modelle verwenden standardmäßig INT8 mit asymmetrischer Quantisierung.
Layout: hauptsächlich NCHW, NHWC, NC1HWC2 und UNDEFINE. NC1HWC2 ist das nachfolgend erläuterte hardwarespezifische Speicherlayout der RKNPU.
RKNN verwendet derzeit vier Datenlayouts: NHWC, NCHW, NC1HWC2 und UNDEFINE.
NHWC und NCHW sind verbreitete Deep-Learning-Layouts und werden hier nicht weiter erläutert. Der Schwerpunkt liegt auf Speicherung und Konvertierung des RKNPU-spezifischen Formats NC1HWC2.
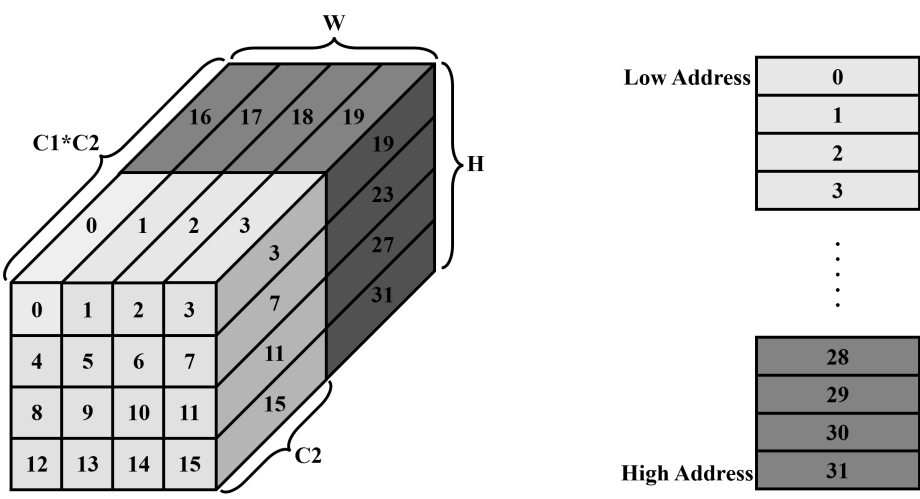
Abbildung 3-1: NC1HWC2-Layout und Speicherung auf der RKNPU
In Abbildung 3-1 bezeichnet die Zahl 0 einen Datenblock mit jeweils C2 Elementen; C2 hängt von der Plattform ab. Tabelle 3-1 enthält die Regeln für C2, während C1 der aufgerundete Wert von C/C2 ist. Die Speicherreihenfolge entspricht den aufsteigenden Nummern: zuerst 0–15, dann 16–31. Für int8-Merkmale der Form (1, 13, 4, 4) auf RK3568 lautet NC1HWC2 beispielsweise (1, 2, 4, 4, 8), also C2=8 und C1=2. In den Blöcken 16–31 sind jeweils nur die ersten 5 Elemente gültig; die übrigen 3 dienen der Ausrichtung.
Tabelle 3-1: C2-Werte verschiedener Hardwareplattformen
| RK2118 | RK3566/RK3568 | RK3588/RK3576/RV1126B | RV1103B/RV1106B | RV1103/RV1106 | RK3562 | |
|---|---|---|---|---|---|---|
| int8 | / | 8 | 16 | 8 | 16 | 16 |
| float16 | 4 | 4 | 8 | / | 8 | 8 |
Nachfolgend wird die Umwandlung des Speicherlayouts NC1HWC2 in NCHW und NHWC erläutert.
Als Beispiel dienen Merkmale der Form (1, 13, 2, 2) auf RK3568. Nach den Ausrichtungsregeln ergibt sich NC1HWC2 als (1, 2, 2, 2, 8). In der folgenden Darstellung kennzeichnet Rot die ungültigen Auffüllelemente zur Ausrichtung.
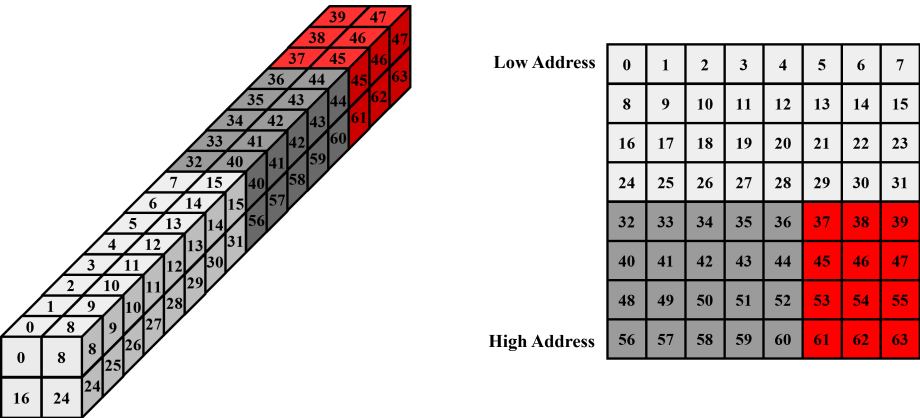
Abbildung 3-2: Aufgefächertes NC1HWC2-Layout
Nach Entfernen der ungültigen Daten und Umwandlung in NCHW, also (1, 13, 2, 2), ergibt sich folgende Speicheranordnung:
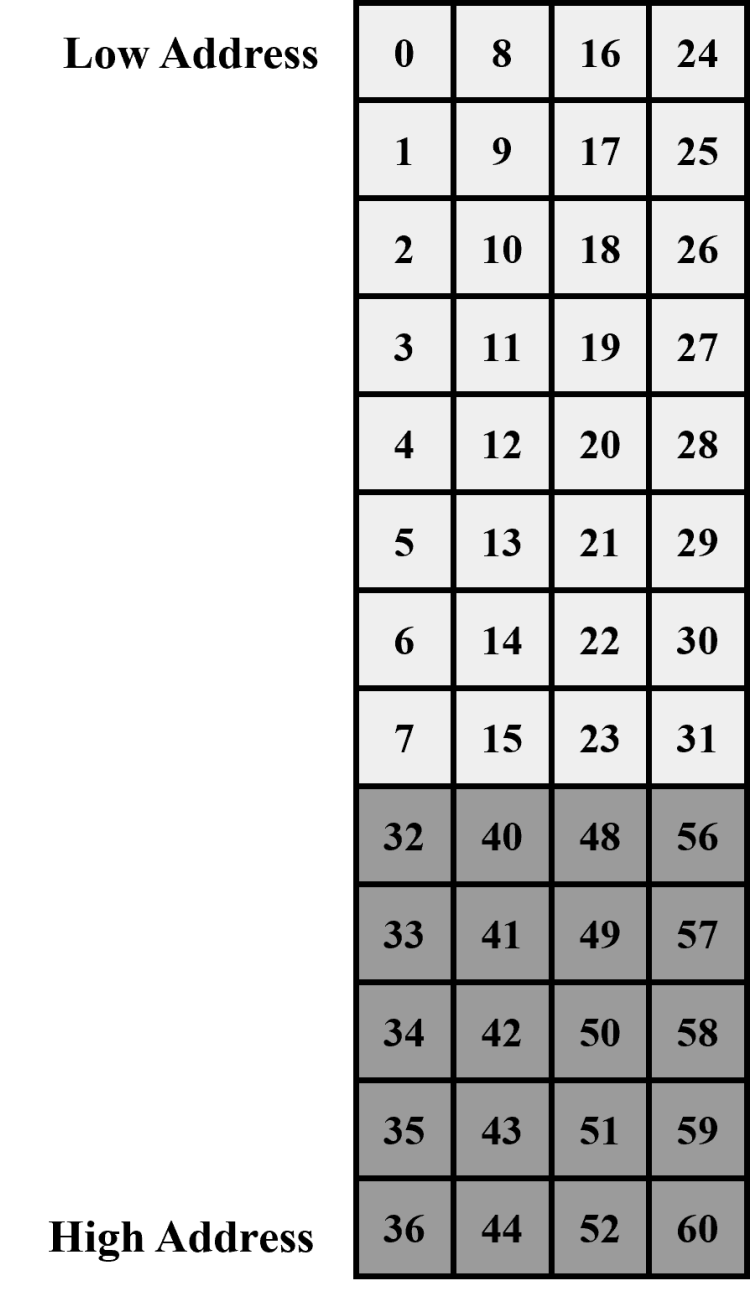
Abbildung 3-3: NCHW-Layout
Nach Entfernen der ungültigen Daten und Umwandlung in NHWC, also (1, 2, 2, 13), ergibt sich folgende Speicheranordnung:
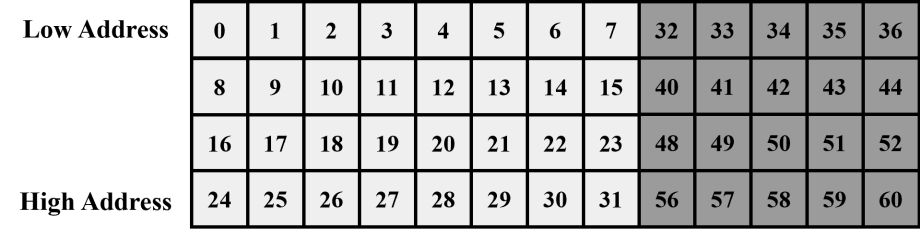
Abbildung 3-4: NHWC-Layout
Beispielcode zur Konvertierung:
NC1HWC2 → NCHW: Beispiel zur Umwandlung von int8-Daten aus NC1HWC2 in NCHW:
/*
 *src: represents the address of the NC1HWC2 input tensor
 *dst: represents the address of the NCHW output tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NCHW
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NCHW(const int8_t* src, int8_t* dst, int* dims, int channel, int h,
int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int c = 0; c < channel; ++c) {
      int plane = c / C2;
      const int8_t* src_c = plane * hw_src * C2 + src;
      int offset = c % C2;
      for (int cur_h = 0; cur_h < h; ++cur_h)
        for (int cur_w = 0; cur_w < w; ++cur_w) {
         int cur_hw = cur_h * w + cur_w;
         dst[c * hw_dst + cur_h * w + cur_w] = src_c[C2 * cur_hw + offset];
        }
    }
  }
  return 0;
}
NC1HWC2 → NHWC: Beispiel zur Umwandlung von int8-Daten aus NC1HWC2 in NHWC:
/*
 *src: represents the address of the NC1HWC2 input tensor
 *dst: represents the address of the NCHW output tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NHWC
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NHWC(const int8_t* src, int8_t* dst, int* dims, int channel, int h,
int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int cur_h = 0; cur_h < h; ++cur_h) {
      for (int cur_w = 0; cur_w < w; ++cur_w) {
        int cur_hw = cur_h * dims[3] + cur_w;
        for (int c = 0; c < channel; ++c) {
         int plane = c / C2;
         const auto* src_c = plane * hw_src * C2 + src;
         int offset = c % C2;
         dst[cur_h * w * channel + cur_w * channel + c] = src_c[C2 * cur_hw + offset];
        }
      }
    }
  }
  return 0;
}
3.1.3 Ein-/Ausgabespeicher
In der RKNN Runtime werden Ein-/Ausgabedaten über Speicherobjekte übergeben. Allgemeine API und Zero-Copy-API unterscheiden sich in der Speicherverwaltung:
Allgemeine API mit interner Kopie: Der Benutzer bereitet einen Eingabepuffer vor, auf den buf in rknn_input verweist. rknn_inputs_set() kopiert die Daten in die Modelleingabe. Nach der Inferenz allokiert rknn_outputs_get() Ausgabespeicher und kopiert die Ergebnisse. Nach Verwendung muss rknn_outputs_release() aufgerufen werden. Typ- und Layoutkonvertierung sowie Normalisierung erfolgen innerhalb der Runtime. Dieses einfache Verfahren eignet sich für die meisten Fälle.
Zero-Copy-API: NPU-zugänglicher Speicher wird mit rknn_create_mem() allokiert oder externer physischer Speicher über rknn_create_mem_from_fd() / rknn_create_mem_from_phys() eingebunden und mit rknn_set_io_mem() an Tensoren gebunden. Die NPU greift direkt darauf zu, wodurch interne Kopien entfallen und die Leistung steigt. Größe, Datentyp und Layout müssen exakt den Tensorattributen entsprechen.
Empfehlung: Für normale Bereitstellung ohne höchste Leistungsanforderungen ist die allgemeine API einfach und zuverlässig. Für maximale Leistung ohne Ein-/Ausgabekopien verwenden Sie Zero-Copy; siehe 3.1.6.
Regeln zur Speicherfreigabe:
-
Ausgabespeicher der allgemeinen API wird nach der Nachverarbeitung mit rknn_outputs_release() freigegeben; Ein-/Ausgabespeicher der Zero-Copy-API mit rknn_destroy_mem().
-
Speicher muss vor dem Kontext mit rknn_destroy() freigegeben werden, sonst können Ressourcenlecks entstehen.
-
Bereits freigegebener Speicher darf nicht erneut verwendet werden; andernfalls ist das Verhalten undefiniert.
3.1.4 Synchrone und asynchrone Inferenz
rknn_run() ist in der RKNN Runtime ein synchroner blockierender Aufruf. Der aufrufende Thread wartet auf den Abschluss der aktuellen NPU-Inferenz; nach der Rückkehr können Ausgaben ohne zusätzliche Synchronisierung gelesen werden.
Laut Beschreibung dieser Runtime-Version gibt es keine asynchrone Inferenzschnittstelle. Sollen Aufgaben wie Aufnahme und Vorverarbeitung des nächsten Frames parallel laufen, verwenden Sie Threads auf Anwendungsebene: Ein eigener Thread führt rknn_run() aus, während der Hauptthread Daten vorbereitet. Warteschlangen zwischen Produzent und Verbraucher bilden eine Pipeline zur Steigerung des Durchsatzes.
Hinweis: Mehrere Threads dürfen rknn_run() nicht gleichzeitig auf demselben Kontext aufrufen. Erstellen Sie für parallele Inferenz mit rknn_dup_context() einen eigenen Kontext je Thread; siehe 5.3.4 „Mehrthread-Wiederverwendung des RKNN-Kontexts“.
3.1.5 Fehlerbehandlung und Ressourcenfreigabe
Fehlerbehandlung
RKNN-C-API-Funktionen liefern einen int-Statuscode: RKNN_SUCCESS (0) bedeutet Erfolg, negative Werte bedeuten Fehler. Prüfen Sie jeden Rückgabewert. Bei Fehlern dürfen nachfolgende Operationen nicht fortgesetzt werden; wechseln Sie zur Ressourcenbereinigung und beenden Sie die Verarbeitung, um undefiniertes Verhalten zu vermeiden.
Vollständige Fehlercodedefinitionen stehen in „05_RKNN2_Runtime_C_API_Reference_V2.5.0“. Setzen Sie zur Diagnose vor dem Start RKNN_LOG_LEVEL=5 für ausführliche schichtweise Debugprotokolle. Häufige Fehler werden in Abschnitt 5.4 erläutert.
Beispiel zur Fehlerbehandlung bei der Initialisierung mit Sprung zur Bereinigung:
int ret = rknn_init(&ctx, model, model_len, 0, NULL);
if (ret != RKNN_SUCCESS) {
    printf("rknn_init failed! ret=%d\n", ret);
    goto out;
}
Ressourcenfreigabe
Ressourcen müssen in der richtigen Reihenfolge freigegeben werden. Empfohlen wird ein gemeinsamer Bereinigungspfad mit goto, damit die Freigabe sowohl im Erfolgs- als auch im Fehlerfall korrekt erfolgt.
Allgemeine API: zuerst rknn_outputs_release() für die Ausgabedaten, anschließend rknn_destroy() für den Kontext.
out:
    // Release the output data memory (general API)
    rknn_outputs_release(ctx, io_num.n_output, outputs);
    // Destroy the context
    if (ctx) rknn_destroy(ctx);
Zero-Copy-API: zuerst Ein- und Ausgabespeicher einzeln mit rknn_destroy_mem() freigeben, danach den Kontext zerstören.
out:
    // Release the input/output memory (zero-copy API; input_mems/output_mems are rknn_tensor_mem pointers returned by rknn_create_mem())
    for (int i = 0; i < io_num.n_input; i++) {
        rknn_destroy_mem(ctx, input_mems[i]);
    }
    for (int i = 0; i < io_num.n_output; i++) {
        rknn_destroy_mem(ctx, output_mems[i]);
    }
    // Destroy the context
    if (ctx) rknn_destroy(ctx);
Hinweis: Nach Zerstörung des Kontexts darf auf keine damit allokierten Ressourcen mehr zugegriffen werden. Stellen Sie sicher, dass alle zuvor freigegeben wurden.