
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 21/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
5.3 Speicheranalyse und -optimierung
5.3.1 Speicheraufteilung und Analysemethoden
5.3.1.1 Speicheraufteilung während der RKNN-Modellausführung
Der Laufzeitspeicher eines RKNN-Modells besteht hauptsächlich aus vier Teilen: Gewichten und internen Tensoren, Registerkonfigurationen, Eingabe- und Ausgabetensoren. Üblicherweise wird er während rknn_init angelegt.
5.3.1.2 Modellspeicher analysieren
Nach rknn_init() bei Bedarf den zugewiesenen Modellspeicher abfragen oder die externe Zuweisung der Gewichte vorbereiten: rknn_query mit RKNN_QUERY_MEM_SIZE aufrufen. Abgefragt werden Gewichte und interner Speicher ohne Ein-/Ausgaben sowie die für die Inferenz belegten DMA- und SRAM-Speicherbereiche. SRAM wird als 0 gemeldet, wenn es nicht aktiviert oder diese Funktion nicht vorhanden ist.
Beispielcode:
 rknn_context ctx = 0;

 // Load RKNN Model
 int ret = rknn_init(&ctx, model_path, 0, NULL, NULL);
 if (ret < 0) {
    printf("rknn_init fail! ret=%d\n", ret);
    return -1;
 }

 // Get weight and internal mem size
 rknn_mem_size mem_size;
 ret = rknn_query(ctx, RKNN_QUERY_MEM_SIZE, &mem_size, sizeof(mem_size));
 if (ret != RKNN_SUCC) {
    printf("rknn_query fail! ret=%d\n", ret);
    return -1;
 }
 printf("total weight size: %d, total internal size: %d\n", mem_size.total_weight_size, mem_size.total_internal_size);
5.3.2 Extern zugewiesenen Speicher verwenden
5.3.2.1 Ein- und Ausgabespeicher extern zuweisen
Wie unter „C API Zero-Copy-Ablauf“ beschrieben, kann Speicher für Ein- und Ausgabetensoren bei Verwendung der zero-copy API extern bereitgestellt und für die NPU konfiguriert werden; siehe dortiges Ablaufdiagramm. Externer Speicher ist nur mit der zero-copy API nutzbar. Dies ist vor allem für Fälle gedacht, in denen der Anwender den NPU-Speicher selbst statt über rknn_create_mem() bereitstellen muss.
Externer Speicher kann über physische Adressen oder fds beschrieben werden und wird hauptsächlich über zwei Schnittstellen eingebunden:
rknn_create_mem_from_phys(): Erzeugt die Struktur rknn_tensor_mem aus einer physischen Adresse
rknn_create_mem_from_fd(): Erzeugt die Struktur rknn_tensor_mem aus einem fd
Das folgende Beispiel legt Speicher mit mpi mmz an. rknn_create_mem_from_phys() importiert die physische Adresse des externen Speichers und erstellt eine rknn_tensor_mem-Struktur mit diesen Speicherinformationen. Beispielcode:
// Create input tensor memory
rknn_tensor_mem* input_mems[1];
// default input type is int8 (normalize and quantize need compute in outside)
// if set uint8, will fuse normalize and quantize to npu
input_attrs[0].type = input_type;
// default fmt is NHWC, npu only support NHWC in zero copy mode
input_attrs[0].fmt = input_layout;

input_mems[0] = rknn_create_mem_from_phys(ctx, input_phys, input_virt, input_attrs[0].size_with_stride);

...

// Create output tensor memory
rknn_tensor_mem* output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
    output_mems[i] = rknn_create_mem_from_phys(ctx, output_physs[i], output_virts[i], output_attrs[i].size);
}

// Set input tensor memory
ret = rknn_set_io_mem(ctx, input_mems[0], &input_attrs[0]);
if (ret < 0) {
    printf("rknn_set_io_mem fail! ret=%d\n", ret);
    return -1;
}

// Set output tensor memory
for (uint32_t i = 0; i < io_num.n_output; ++i) {
    // set output memory and attribute
    ret = rknn_set_io_mem(ctx, output_mems[i], &output_attrs[i]);
    if (ret < 0) {
        printf("rknn_set_io_mem fail! ret=%d\n", ret);
        return -1;
    }
}
Externer Speicher kann statt über die physische Adresse auch über einen fd eingebunden werden. Beispielcode:
int mb_flags = RK_MMZ_ALLOC_TYPE_CMA | RK_MMZ_ALLOC_UNCACHEABLE;

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, mem_size.total_weight_size, mb_flags);
if (ret < 0) {
    printf("RK_MPI_MMZ_Alloc failed, ret: %d\n", ret);
    return ret;
}

void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
if (weight_virt == NULL) {
    printf("RK_MPI_MMZ_Handle2VirAddr failed!\n");
    return -1;
}

int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
if (weight_fd < 0) {
    printf("RK_MPI_MMZ_Handle2Fd failed!\n");
    return -1;
}

weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);

int mb_flags = RK_MMZ_ALLOC_TYPE_CMA | RK_MMZ_ALLOC_UNCACHEABLE;

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, mem_size.total_weight_size, mb_flags);
if (ret < 0) {
    printf("RK_MPI_MMZ_Alloc failed, ret: %d\n", ret);
    return ret;
}

void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
if (weight_virt == NULL) {
    printf("RK_MPI_MMZ_Handle2VirAddr failed!\n");
    return -1;
}

int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
if (weight_fd < 0) {
    printf("RK_MPI_MMZ_Handle2Fd failed!\n");
    return -1;
}

weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);
5.3.2.2 Modellspeicher extern zuweisen
Wie in 9.1 beschrieben, besteht der Modellspeicher aus internal memory und weight memory. Extern bereitgestellter Speicher kann über rknn_set_weight_mem() und rknn_set_internal_mem() für Gewichte und interne Daten festgelegt werden. Beispiel:
// Load RKNN Model
ret = rknn_init(&ctx, model_virt, model_size, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
TIME_END(rknn_init);
if (ret < 0) {
    printf("rknn_init fail! ret=%d\n", ret);
    return -1;
}

//query and inset input / output tensor
...

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, SIZE_ALIGN_128(mem_size.total_weight_size), mb_flags);
void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
ret = rknn_set_weight_mem(ctx, weight_mem);
if (ret < 0) {
    printf("rknn_set_weight_mem fail! ret=%d\n", ret);
    return -1;
}
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);

// Allocate internal memory in outside
MB_BLK internal_mb;
rknn_tensor_mem* internal_mem;
ret = RK_MPI_MMZ_Alloc(&internal_mb, SIZE_ALIGN_128(mem_size.total_internal_size), mb_flags);
void* internal_virt = RK_MPI_MMZ_Handle2VirAddr(internal_mb);
int internal_fd = RK_MPI_MMZ_Handle2Fd(internal_mb);

internal_mem = rknn_create_mem_from_fd(ctx, internal_fd, internal_virt, mem_size.total_internal_size, 0);
ret = rknn_set_internal_mem(ctx, internal_mem);
if (ret < 0) {
    printf("rknn_set_internal_mem fail! ret=%d\n", ret);
    return -1;
}
printf("internal mb info: virt = %p, fd = %d, size: %d\n", internal_virt, internal_fd, mem_size.total_internal_size);
5.3.3 Internen Speicher wiederverwenden
Die RKNN API ermöglicht externe Verwaltung des NPU-Speichers. RKNN_FLAG_INTERNAL_ALLOC_OUTSIDE legt fest, dass der Speicher für Zwischenmerkmale extern bereitgestellt wird. Typische Anwendungsfälle:
Bei der Bereitstellung weist der Benutzer den gesamten NPU-Speicher selbst zu und kann damit die Speicheraufteilung des Gesamtsystems koordinieren.
Bei serieller Ausführung mehrerer Modelle wird der Zwischentensorspeicher zwischen Kontexten wiederverwendet. Das ist besonders bei knappem Speicher, etwa auf RV1103/RV1106, hilfreich.
Im Beispiel benötigt der Internal Tensor von Modell 1 mehr Speicher als der von Modell 2. Bei serieller Ausführung reicht ein gemeinsam genutzter Block im Bereich 0x00000000~0x000c4000. Nach Modell 1 kann Modell 2 darin Internal-Tensor-Daten lesen und schreiben, wodurch Speicher gespart wird.
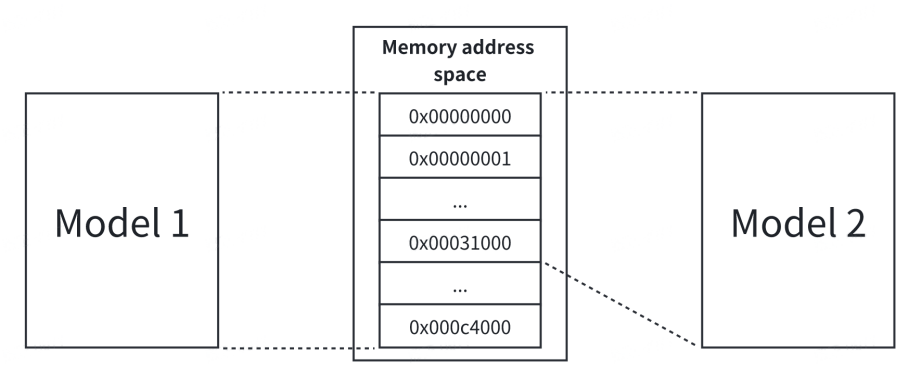
Abbildung 5-16. Zwei Modelle teilen denselben Adressraum für Internal Tensor
Die Modellpfade seien model_path_a und model_path_b. Beispielcode:
rknn_init(&ctx_a, model_path_a, 0, RKNN_FLAG_INTERNAL_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_a, RKNN_QUERY_MEM_SIZE, &mem_size_a, sizeof(mem_size_a));
rknn_init(&ctx_b, model_path_b, 0, RKNN_FLAG_INTERNAL_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_b, RKNN_QUERY_MEM_SIZE, &mem_size_b, sizeof(mem_size_b));

// Get the largest internal size of the two models
max_internal_size = MAX(mem_size_a.total_internal_size,
mem_size_b.total_internal_size);
internal_mem_max = rknn_create_mem(ctx_a, max_internal_size);

// Set the internal memory of model a
internal_mem_a = rknn_create_mem_from_fd(ctx_a, internal_mem_max->fd, internal_mem_max->virt_addr, mem_size_a.total_internal_size, 0);
rknn_set_internal_mem(ctx_a, internal_mem_a);

// Set the internal memory of model b
internal_mem_b = rknn_create_mem_from_fd(ctx_b, internal_mem_max->fd, internal_mem_max->virt_addr, mem_size_b.total_internal_size, 0);
rknn_set_internal_mem(ctx_b, internal_mem_b);
5.3.4 RKNN-Kontext in mehreren Threads wiederverwenden
In mehreren Threads kann dasselbe Modell gleichzeitig ausgeführt werden. Separate Kontexte pro Thread benötigen viel Speicher. Durch Wiederverwendung eines Kontexts lassen sich wiederholte Datenstrukturaufbauten vermeiden und Runtime-Speicher sparen. Die RKNN API stellt dafür folgende Schnittstelle bereit:
int rknn_dup_context(rknn_context* context_in,rknn_context* context_out)
context_in ist der bereits initialisierte Kontext; context_out verwendet context_in wieder. In der Abbildung besitzen beide Kontexte dieselbe Modellstruktur und können daher wiederverwendet werden.
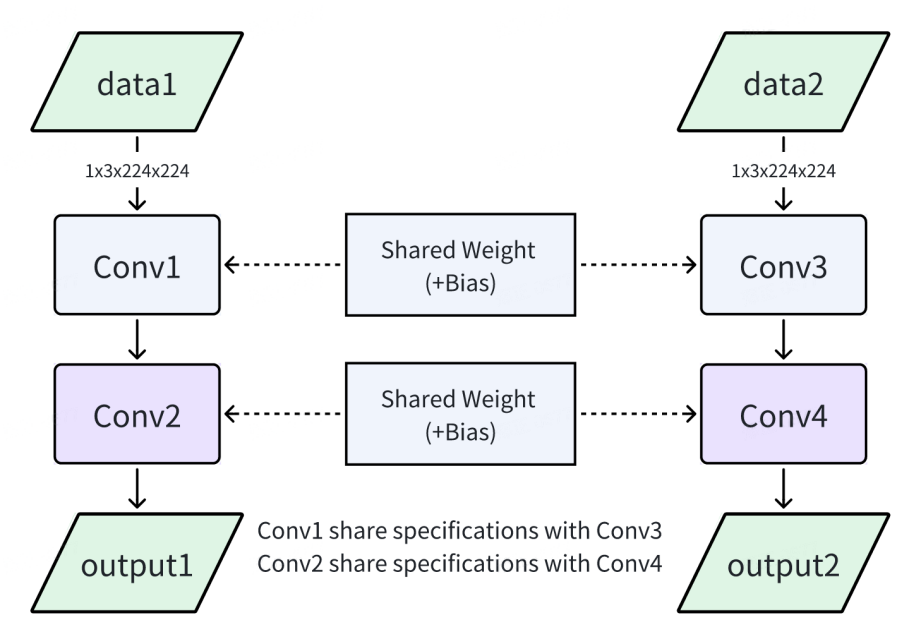
Abbildung 5-17. Kontextwiederverwendung zweier gleicher Modelle
5.3.5 Gewichte zwischen Modellen mit unterschiedlicher Auflösung teilen
Modelle unterschiedlicher Auflösung mit denselben Gewichten können diese zur Speicherersparnis teilen. In RKNPU SDK <= 1.5.0 ermöglichte dies dynamischen Wechsel zwischen Auflösungen mit geringerem Speicherbedarf. Nach 1.5.0 wurde diese Funktion durch dynamische Shapes ersetzt.
Im folgenden Diagramm sind die Gewichte der Modelle A und B vollständig identisch.
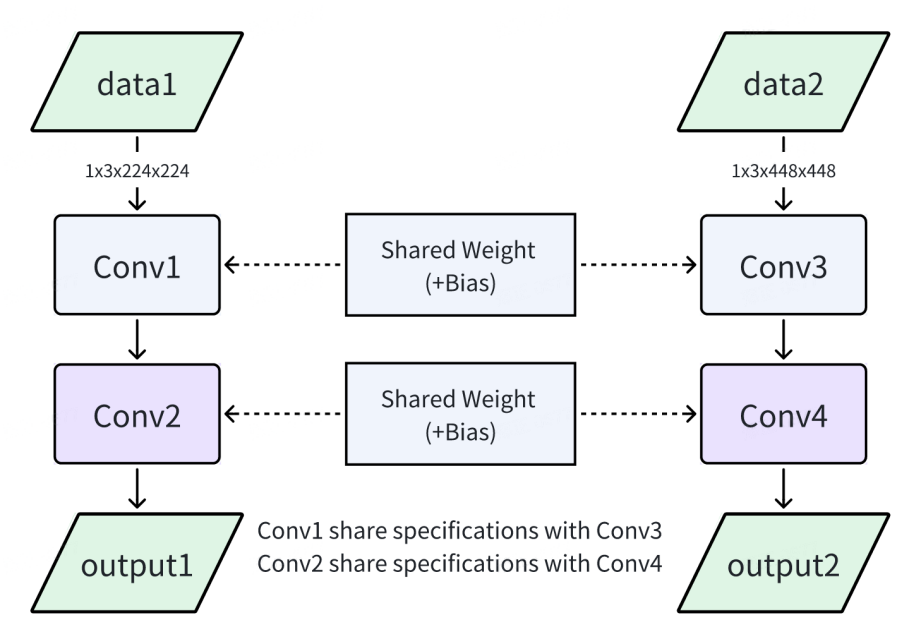
Abbildung 5-18. Gemeinsame Gewichte zweier Modelle unterschiedlicher Auflösung
Für gemeinsame Gewichte bei unterschiedlichen Auflösungen führen Sie folgende Schritte aus:
-
Legen Sie bei der Konvertierung ein Modell als master mit remove_weight=False in rknn.config fest; das andere wird slave mit remove_weight=True. Das Master-RKNN-Modell enthält Gewichte, das Slave-Modell keine Gewichte der Faltungsoperatoren.
-
Initialisieren Sie bei der Bereitstellung zuerst master und dann slave. Für slave verwenden Sie RKNN_FLAG_SHARE_WEIGHT_MEM und den zusätzlichen Parameter rknn_init_extend mit dem Master-Kontext als Wert. Die Pfade heißen im Beispiel model_A und model_B. Beispielcode:
rknn_context context_A;
rknn_context context_B;
ret = rknn_init(&context_A,model_A,0,0,NULL);
...
rknn_init_extend extend;
extend.ctx = context_A;
ret = rknn_init(&context_B,model_B,0,RKNN_FLAG_SHARE_WEIGHT_MEM,&extend);