
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 14/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
20. Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
4.1.4 Multi-Batch verwenden
4.1.4.1 Multi-Batch-Prinzip
RK3588 besitzt 3 NPU-Kerne, RK3576 2. Multi-Batch-Inferenz nutzt diese effizienter. Dabei kopiert rknn_dup_context nur Internal des Kontexts; Weight wird wiederverwendet. Bei rknn_batch_size=2 entsteht eine Kopie, bei rknn_batch_size>=3 zwei, da höchstens drei Kerne gleichzeitig arbeiten und zusätzliche Kopien Speicher verschwenden. core_mask jedes Kontexts wird für automatische Planung zwischen den Kernen auf 0 gesetzt. rknn_run() erstellt intern einen Threadpool; drei Threads führen gleichzeitig die drei Kontexte aus.
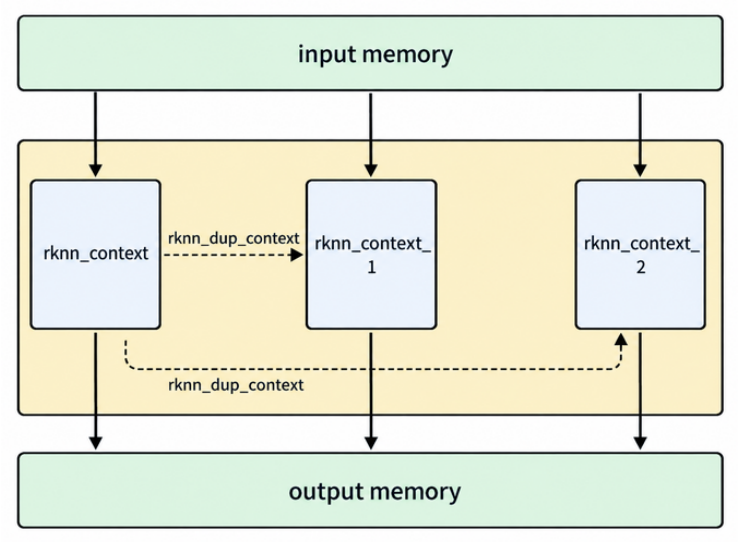
Abbildung 4-7. Internes Multi-Batch-Prinzip
4.1.4.2 Multi-Batch verwenden
Verwendung von Multi-Batch:
1 Multi-Batch in Python aktivieren:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', rknn_batch_size=3)
Für optimale Leistung sollte rknn_batch_size auf RK3588 ein Vielfaches von 3 und auf RK3576 ein Vielfaches von 2 sein.
2 Die Zero-Copy-Schnittstelle wird empfohlen.
4.1.4.3 Multi-Batch-Ein- und Ausgaben
Mit Multi-Batch sind abgefragte Ein-/Ausgabegrößen rknn_batch_size-mal so groß. Jeder interne Kontext berechnet seinen Eingabeoffset, liest die Daten und schreibt das Ergebnis an seinen berechneten Ausgabeoffset. Für den zweiten Batch ist der Eingabeoffset input_size/rknn_batch_size und der Ausgabeoffset output_size/rknn_batch_size.
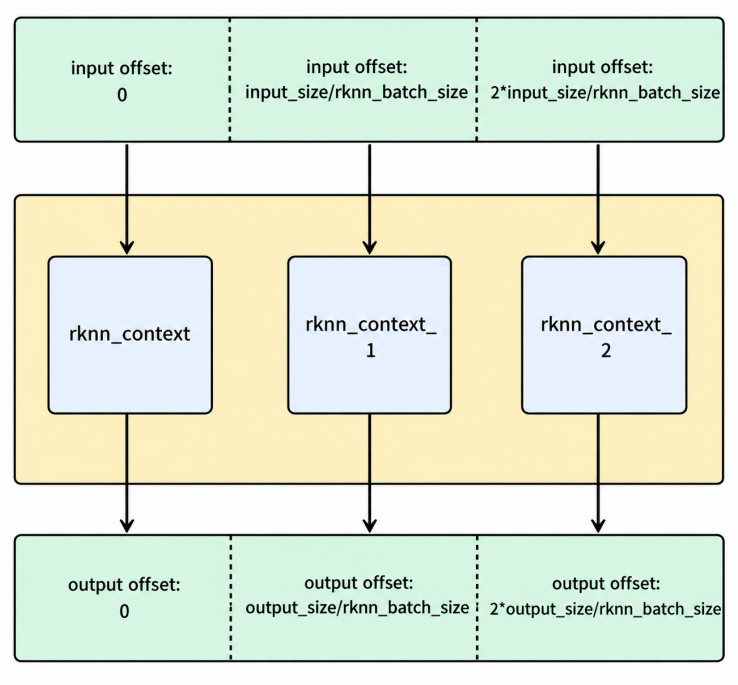
Abbildung 4-8. Interne Multi-Batch-Ein-/Ausgabeoffsets