
Plattformreferenz nach dem Rockchip RKNN2 SDK Development Guide V2.5.0. Erfasst werden nur die im Original genannten SoCs sowie Linux-/Android-Runtime- und Toolkit-Kombinationen. Funktionen gelten unter den jeweiligen Chip-, SDK-, Treiber- und Kernelbedingungen und nicht automatisch für jedes ArmSoM-Board. Prüfen Sie vor der Bereitstellung BSP, NPU-Treiber, Runtime und Modellversion des konkreten Boards. Es erfolgte keine ArmSoM-Hardwarevalidierung; Protokolle, Leistungswerte und Beispiele stammen aus dem Original.
Quellen und Prüfung: Chinesisch folgt der chinesischen V2.5.0 (182 Seiten); Englisch, Russisch und Deutsch folgen der englischen V2.5.0 (208 Seiten). Quellenspezifische technische Angaben bleiben erhalten; Inhalte älterer Versionen werden nicht als neue Fakten dargestellt. Chinesische Abbildungen stammen aus dem chinesischen PDF, EN/RU/DE-Abbildungen aus dem englischen PDF einschließlich separat extrahierter Vektorflussdiagramme. Abschnitts- und Formelnummern bleiben erhalten. Einige Querverweise verwenden alte Kapitelnummern; Dynamic-Shape-Beispiele enthalten „1224+140=264“, TP_NORM-Aussagen widersprechen sich, und init()/rknn.val_perf() weichen von späteren API-Beschreibungen ab. Diese Quellenprobleme bleiben dokumentiert und sind vor Ausführung anhand der tatsächlichen V2.5.0-Header und API-Referenzen zu prüfen. Code und Parameter bleiben erhalten; PDF-Umbrüche und Tabellenfortsetzungen wurden bereinigt.
RKNN2 SDK V2.5.0 · 20/22
1. Softwarestack und Grundbegriffe
2. Entwicklungsumgebung, Versionen und Board-Anbindung
3. Entwicklungsablauf und Schnittstellenwahl
4. Modellkonvertierung und ONNX-Bearbeitung
5. Quantisierung, hybride Quantisierung und QAT
6. Inferenz sowie Genauigkeits-, Leistungs- und Speicherbewertung
7. Runtime-Lebenszyklus, Layouts und Speicher
8. Zero-Copy-Schnittstellen und Ein-/Ausgabebedingungen
9. C-API-Bereitstellung und Codegenerierung
10. Python-Bereitstellung mit Toolkit Lite2
11. Matmul-API und Matrixlayouts
12. NPU-Mehrkernkonfiguration und Leistung
13. Modelle mit dynamischen Formen und Bereitstellung
14. Inferenz mit mehreren Batches
15. NPU-SRAM auf RK3588/RK3576
16. Cache-Kohärenz und Sparse-Inferenz
17. Benutzerdefinierte Operatoren: Python und C API
18. Bereitstellung verschlüsselter Modelle
19. Diagnose von Genauigkeitsproblemen
Leistungsanalyse und Netzwerkoptimierung
21. Speicheranalyse, gemeinsame Nutzung und Wiederverwendung
22. FAQ, Fehlerbehandlung und Referenzen
5.2 Leistungsanalyse und Optimierung
Nach korrekter Ausführung eines bereitgestellten Modells besteht meist weiterer Optimierungsbedarf. Dieser Abschnitt erläutert die Abstimmung im vollständigen Optimierungsprozess und danach die häufigsten Maßnahmen: Leistungsanalyse, Graphoptimierung und Operatoroptimierung. Der gesamte Ablauf ist nachfolgend dargestellt:
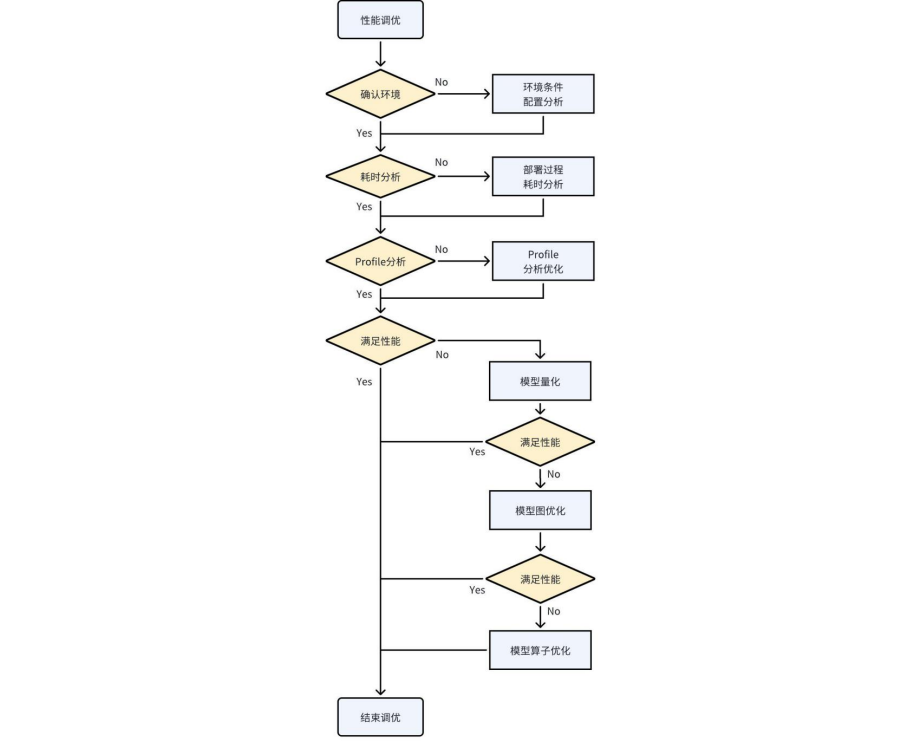
Abbildung 5-2. Ablauf der Modellleistungsoptimierung
5.2.1 Ablauf der Modellleistungsanalyse
5.2.1.1 Laufzeitumgebung prüfen
Vor jeder Leistungsanalyse und Optimierung müssen einheitliche Ausgangsbedingungen der Testumgebung festgelegt werden. Messdaten sind nur bei gleichen Bedingungen aussagekräftig. Ohne feste Frequenzen schwankt beispielsweise die Inferenzleistung desselben Modells stark; die Dauer einer Testserie darf dann nicht als durchschnittliche Einzelbildzeit betrachtet werden.
Bei Abfrage und Einstellung der Testumgebung sind folgende Aspekte zu berücksichtigen:
Abfrage und Einstellung der CPU-, DDR- und NPU-Frequenzen
Die festgelegte Frequenz beeinflusst die Ausführungsgeschwindigkeit direkt; höhere Frequenzen verbessern meist die Leistung, jedoch nicht linear. Gleichzeitig steigt der Energieverbrauch. Befehle zum Festlegen der Frequenzen: https://github.com/airockchip/rknn_model_zoo/blob/main/scaling_frequency.sh
Alternativ lässt sich der Leistungsmodus mit folgendem Befehl aktivieren:
echo performance | tee $(find /sys/ -name *governor) /dev/null || true
Version des NPU-Kerneltreibers prüfen
Optimierungen bestimmter Funktionen und Operatoren hängen von der Kerneltreiberversion ab. Neuere Versionen können aktuelle Optimierungen auf niedriger Ebene nutzen. Prüfen Sie daher, ob eine ausreichend neue Version verwendet wird. Empfohlen wird derzeit eine Version nach 0.9.2; dieses Update ist nicht zwingend erforderlich.
Befehle zur Abfrage der Kerneltreiberversion:
cat /sys/kernel/debug/rknpu/version # for RK3566/RK3568/RK3588/RK3562/RK3576
cat /proc/rknpu/version # for RV1106 series/RV1103 series/RV1126B
- Abfrage der NPU-Auslastung
Die NPU-Auslastung ist der pro Zeiteinheit für Aufgaben verwendete Zeitanteil und beschreibt die Beschäftigung der NPU. Bei geringer Auslastung wartet sie länger auf Aufgaben. Prüfen Sie Kopierzeiten der Ein-/Ausgabe sowie Vor- und Nachverarbeitung. Auch mehrthreadige Verarbeitung in der Anwendung kann die Auslastung erhöhen.
Die NPU-Auslastung entspricht nicht der tatsächlichen MAC-Auslastung. Letztere beschreibt, wie effizient laufende Aufgaben die Hardwareeinheiten der NPU nutzen.
Befehle zur Abfrage der NPU-Auslastung:
cat /sys/kernel/debug/rknpu/load
# or
cat /proc/debug/rknpu/load
5.2.1.2 Analyse der Laufzeitanteile bei der Bereitstellung
Die Gesamtlaufzeit besteht aus Anwendungszeit, Ein-/Ausgabekopierzeit und Modellinferenzzeit. Ihre Verteilung zeigt Optimierungsprioritäten. Die Abschnitte können mit Zeitstempeln im Programm gemessen werden.
Anwendungszeit:
Dies umfasst die nicht NPU-bezogene Zeit des Inferenzablaufs, typischerweise Vorverarbeitung, Nachverarbeitung und Programmlogik. Dieser Teil liegt vollständig unter Benutzerkontrolle. Bei hohem Anteil können neben Codevereinfachung und -optimierung bestimmte Operationen durch Spezialhardware beschleunigt werden.
Beispielsweise können Matrixmultiplikation und -addition mit der Matmul API auf der NPU beschleunigt werden, Bildskalierungen über RGA.
Ein-/Ausgabekopierzeit:
Die allgemeine API kopiert zwischen Ein-/Ausgabespeicher und NPU-Speicher; diese Zeit lässt sich beim API-Aufruf ausgeben. Sie hängt von DDR und CPU ab. Bei kleinen Datenmengen ist sie gering, bei großen nicht vernachlässigbar. Daher werden Zero-Copy-APIs empfohlen.
Bei Zero-Copy greift die NPU direkt auf den Ein-/Ausgabespeicher zu. Einzelheiten stehen im Abschnitt zur RKNN-Runtime-Zero-Copy-Schnittstelle.
Inferenzzeit:
Die NPU-Inferenzzeit hängt unter anderem von Modellgröße und Version der Compileroptimierungen ab. Die von RKNN LOG ausgegebene Zeit unterscheidet sich je nach RKNN_LOG_LEVEL, da Protokollausgaben selbst Zeit benötigen.
Zur Messung der Einzelbildinferenz wird gewöhnlich LOG-Stufe 1 verwendet und über mehrere Durchläufe gemittelt.
5.2.2 Leistungsanalyse
5.2.2.1 Profildaten ermitteln
Um die Inferenzdauer je Layer zu ermitteln, geben Sie vor dem Programmstart folgenden Befehl zur Ausgabe detaillierter Informationen ein:
export RKNN_LOG_LEVEL=4
./run_rknn_test ./test.rknn ./input.jpg
Unter Android lassen sich anschließend detaillierte Protokolle über logcat abrufen.
Mit RKNN-Toolkit2 lässt sich die Zeit jedes Layers wie folgt ermitteln:
rknn.init_runtime(target=platform, perf_debug=True)
rknn.eval_perf()
Der Analysebericht ist nachfolgend dargestellt; gezeigt werden nur die leistungsbezogenen Teile.
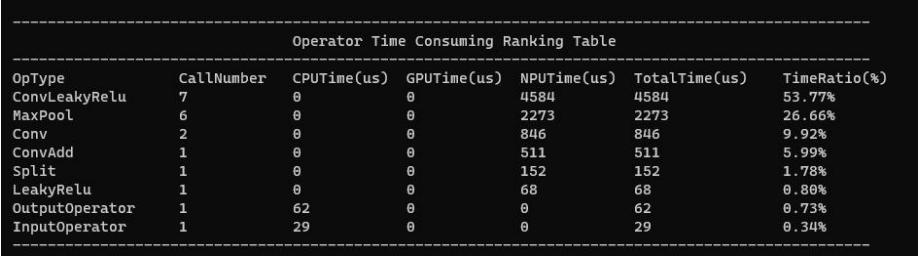
Abbildung 5-3. Leistungsanalysebericht
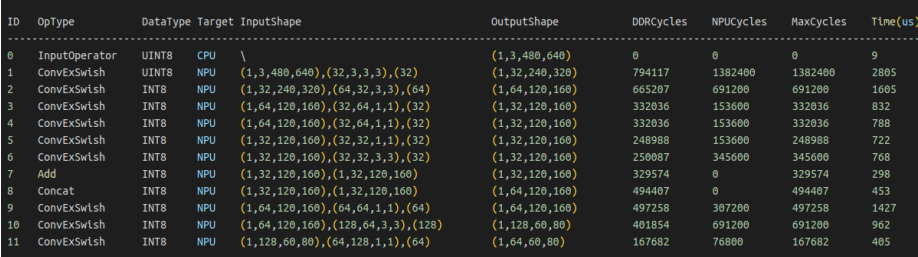
Abbildung 5-4. Leistungsanalysebericht
Gesamt- und Layerprofil liefern schnell die gesuchten Daten und helfen, Optimierungsschwerpunkte zu setzen. Untersuchen Sie anschließend die Layerzeiten auf zeitaufwendige Operatoren, die Auswirkungen von Nicht-NPU-Operatoren und die Engpässe der NPU-Operatoren. Diese Aspekte werden nachfolgend erläutert.
5.2.2.2 Layerweise Zeitanalyse
In der Spalte Time lassen sich besonders zeitaufwendige Operatoren erkennen und zuerst optimieren. Anhand von Op Type prüfen Sie, ob sie demselben OpType angehören und gemeinsam optimiert werden können.
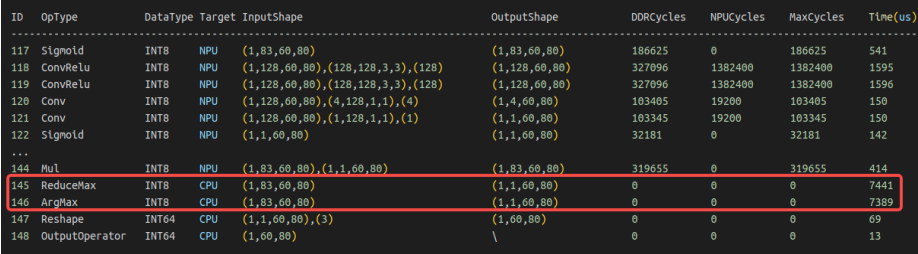
Abbildung 5-5. Analyse zeitaufwendiger Operatoren
Ein zeitaufwendiger Operator ist nicht zwangsläufig ineffizient; manche benötigen viele Berechnungen. Bei hoher MAC-Auslastung sollte eine kleinere Operatorgröße beziehungsweise ein geringerer Umfang erwogen werden. Treten dagegen zeitaufwendige Operatoren mit sehr geringer Auslastung auf, sollten diese im Mittelpunkt der Optimierung stehen.
5.2.2.3 Auswirkungen von CPU-Operatoren
Die Abbildung zeigt zeitaufwendige CPU-Operatoren. Eine Verlagerung auf die NPU kann deren Einfluss deutlich reduzieren. Viele Leistungsprobleme lassen sich bereits dadurch lösen; achten Sie daher besonders auf die Laufzeiten von CPU-Operatoren.
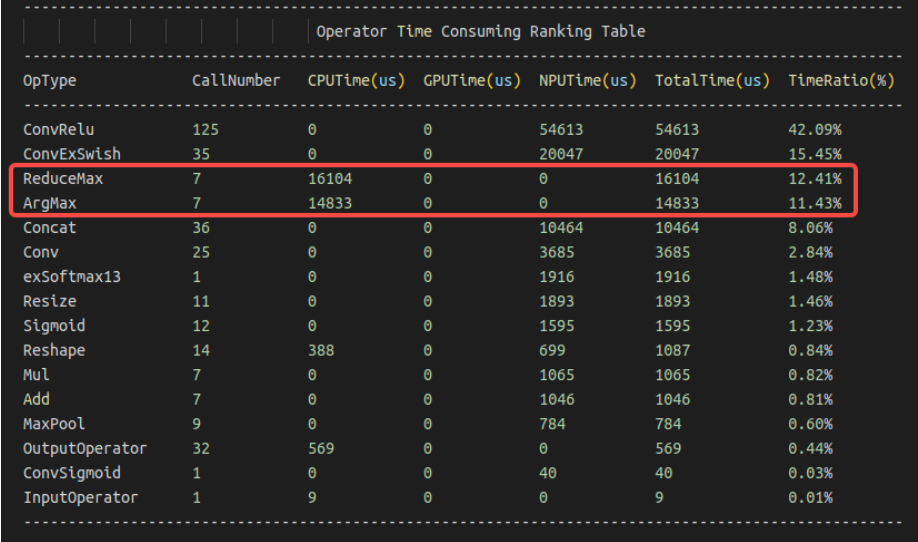
Abbildung 5-6. Leistungsanalyse der CPU-Operatoren
Ein Operator wird normalerweise aus folgenden Gründen außerhalb der NPU ausgeführt:
Die Operatorgröße überschreitet die Grenze; prüfen Sie die Größenbeschränkungen im OpList-Dokument.
Der Operator wird auf der NPU noch nicht unterstützt; prüfen Sie OpList. Im Github-Projekt kann ein Issue erstellt werden.
Hardwaregrenzen der NPU verhindern die Unterstützung; prüfen Sie eine äquivalente, von der NPU unterstützte Implementierung.
5.2.2.4 Engpässe der NPU-Operatoren analysieren
Bei zeitaufwendigen NPU-Operatoren zeigen DDR Cycles/NPU Cycles/Total Cycles, ob theoretisch Bandbreite oder Rechenleistung begrenzen. DDR Cycles ist die für Lese- und Schreibzugriffe des Layers benötigte Zeit, umgerechnet in NPU-Takte, und kann daher direkt mit NPU Cycles verglichen werden.
Wie nachfolgend dargestellt:
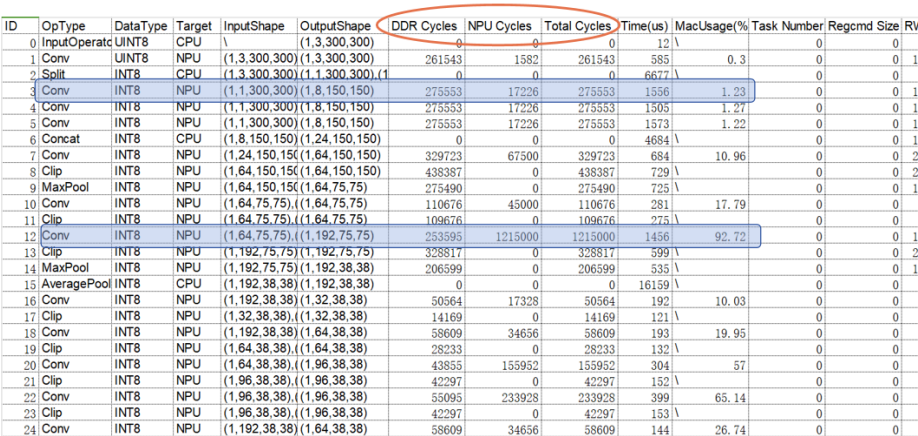
Abbildung 5-7. Engpassanalyse der NPU-Operatoren
Beim dritten Layer ist DDR Cycles deutlich größer als NPU Cycles: Lesen und Schreiben benötigen mehr Takte als die Berechnung. Dieser Conv ist daher bandbreitenbegrenzt.
Beim zwölften Layer ist DDR Cycles deutlich kleiner als NPU Cycles: Datentransfers benötigen weniger Takte als die Berechnung. Dieser Conv ist daher durch die Rechenleistung begrenzt.
Derzeit zeigt NPU Cycles hauptsächlich die Takte von Conv; weitere Operatortypen werden schrittweise ergänzt.
5.2.3 Beschleunigung durch Quantisierung
Quantisierung reduziert Rechenaufwand und Bandbreitenbedarf erheblich. Zudem ist die INT8-Rechenleistung der NPU wesentlich höher als die FP16-Leistung, sodass Modelle deutlich schneller laufen können. Die Bereitstellung quantisierter Modelle wird empfohlen; Vorgehensweisen stehen in der Einführung zur Quantisierung.
5.2.4 Graphoptimierung
Graphoptimierung ermöglicht abgestimmte Verbesserungen des gesamten Modells. Nach der Ermittlung zeitintensiver Operatoren oder Teilgraphen sind verschiedene Umformungen möglich. Ziele sind das Entfernen redundanter Operatoren, das Verlagern auf die NPU und die Nutzung hardwareeffizienter Operatoren. Diese Ziele können sich widersprechen: Eine NPU-Verlagerung benötigt möglicherweise zusätzliche Operatoren. Trotz höherer Operatorzahl kann dies durch bessere Gesamtinferenzleistung sinnvoll sein.
RKNN-Toolkit2 optimiert den Graphen bereits teilweise während der Modellkonvertierung. Dies deckt jedoch nicht alle Fälle ab; in nicht berücksichtigten Szenarien bleiben redundante Operationen. Benutzer können anhand der hier beschriebenen Ideen vorab optimieren. Die Methoden sind nicht verpflichtend und müssen situationsgerecht eingesetzt werden.
5.2.4.1 Nicht-NPU-OPs in NPU-OPs umwandeln
Nicht-NPU-Operatoren können durch äquivalente Graphtransformationen durch unterstützte Operatoren ersetzt werden, um die Berechnung auf die NPU zu verlagern.
Beispielsweise ersetzt im dargestellten shufflenetv2_0.5-Modell eine angenäherte Faltung mit Gewichten 0/1 die channel-shuffle-Operation und ordnet die Daten um. Sind Transpose und Reshape auf der NPU nicht ausführbar, können sie zu einem Conv für diese Umordnung zusammengefasst werden.
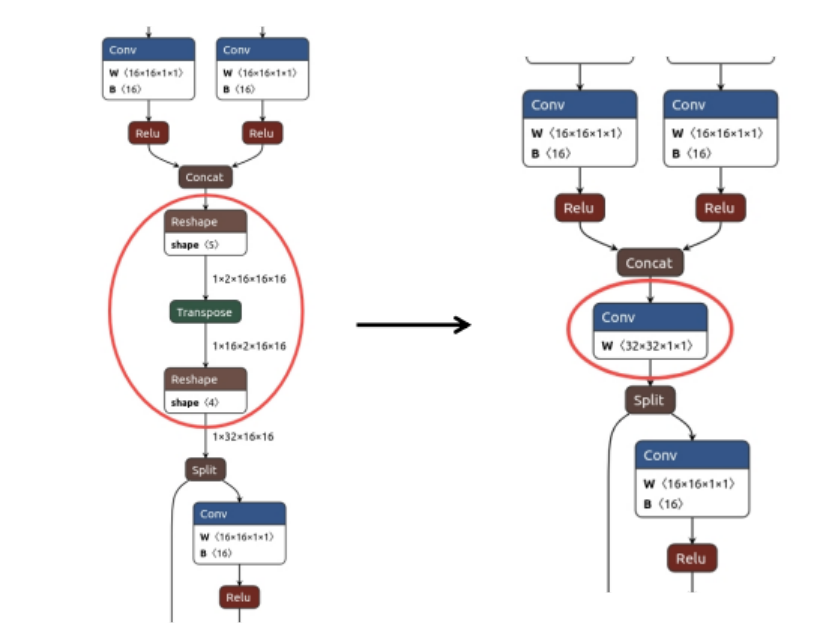
Abbildung 5-8. Datenumordnung durch Faltung
5.2.4.2 Hardware-Fusion für Netzwerkentwurf und Graphoptimierung nutzen
Die NPU unterstützt die Fusion bestimmter Operatorkombinationen. Durch passende Anpassung des Ablaufs an die Fusionsregeln kann diese Optimierung ermöglicht werden.
Der RKNN-Softwarestack optimiert den Graphen, kann aber nicht alle Fälle abdecken. Bestimmte Graphstrukturen lassen sich theoretisch fusionieren und vereinfachen, werden von der abschließenden Graphoptimierung aber nicht zusammengeführt. Eine manuelle Algorithmusanpassung kann dieses Problem schnell lösen.
Beispielsweise lassen sich durch Vertauschen von Transpose und Clip bei unverändertem Ergebnis Conv und Clip fusionieren und die Leistung verbessern.
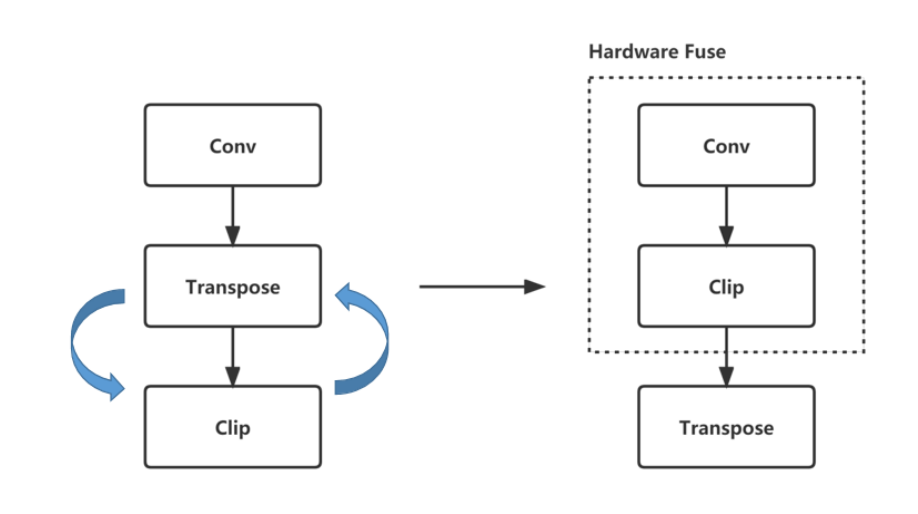
Abbildung 5-9. Graphoptimierung und Operatorfusion
Berücksichtigen Sie beim Entwurf die folgenden Fusionsregeln:
| Unterstützte Fusionsregeln | Für die Zukunft geplante Fusionsregeln |
|---|---|
| Conv+Relu | Activation+Add(Mul) |
| Conv+PRelu(LeakyRelu) | Add(Mul)+Activation |
| Conv+Clip | Conv+Mul |
| Conv+Sigmoid(Tanh/Elu/Silu…) | Conv+Activation+Mul |
| Conv+Add | Conv+Activation+Pooling |
| Conv+Activation+Add | Conv+Activation+Add(Mul)+Pooling |
5.2.4.3 Teilgraphumformung
Beim Entwurf eines Graphbereichs steht manchmal die klare Darstellung im Vordergrund, ohne die Leistung bei der Bereitstellung zu berücksichtigen. Dadurch entstehen komplexe, redundante Strukturen. Eine äquivalente Umwandlung des Teilgraphen in einen einzelnen OP reduziert die Berechnungsschritte und verbessert die Ausführung.
Die Abbildung zeigt eine äquivalente Transformation von Yolov5-nano: Mehrere komplexe Slice-Datenextraktionen werden zu einem neuen Conv zusammengefasst, wodurch der Graph deutlich einfacher wird.
Quelle des Ansatzes: https://github.com/ultralytics/yolov5/issues/4825
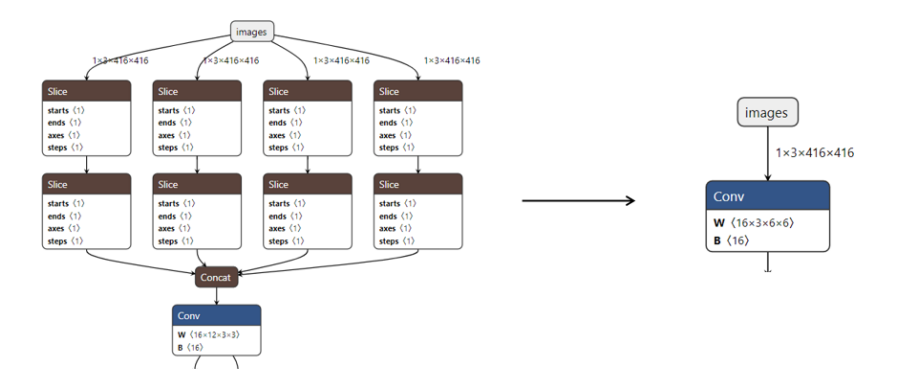
Abbildung 5-10. Äquivalente Operatorgraphtransformation
5.2.4.4 „Gleichartige Terme zusammenfassen“ und „Gemeinsame Faktoren ausklammern“
Mehrere aufeinanderfolgende Berechnungen bestimmter Operatoren können vereinfacht und zu einem Operator zusammengefasst werden, etwa Reshape, Transpose, Slice und bestimmte Add/Mul/Sub/Div.
In der Abbildung lassen sich gleichartige Operatoren durch eine einfache Umordnung des Graphen zusammenfassen.
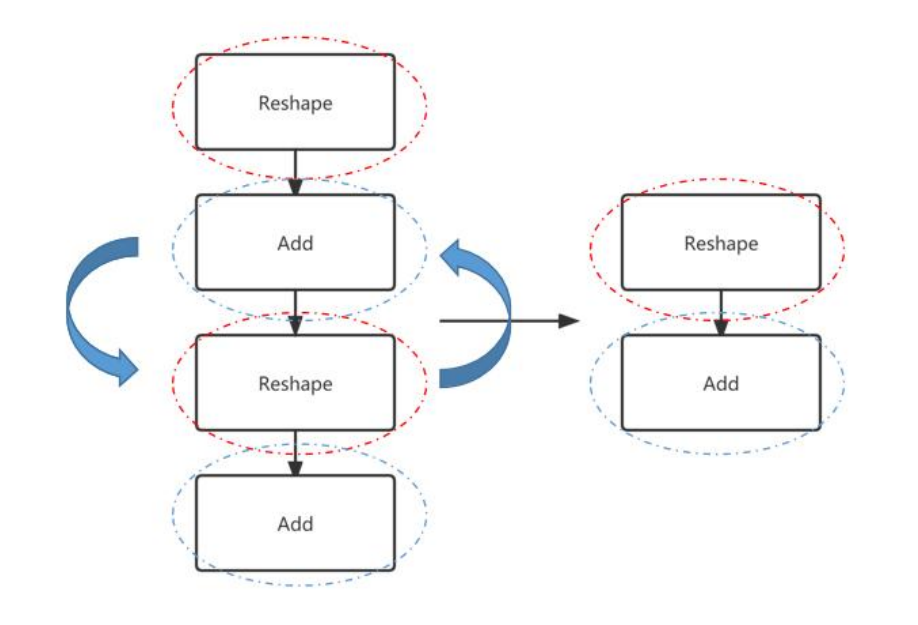
Abbildung 5-11. Zusammenfassen gleichartiger Operatoren
Manche Graphen enthalten gemeinsame Teile mit gleichartigen Operationen, die umgeordnet und zu einer Operation zusammengefasst werden können.
Durch Ändern der Operatorreihenfolge können in der Abbildung wiederholte gleichartige Operatoren herausgezogen werden, sodass die Operation nur einmal ausgeführt wird.
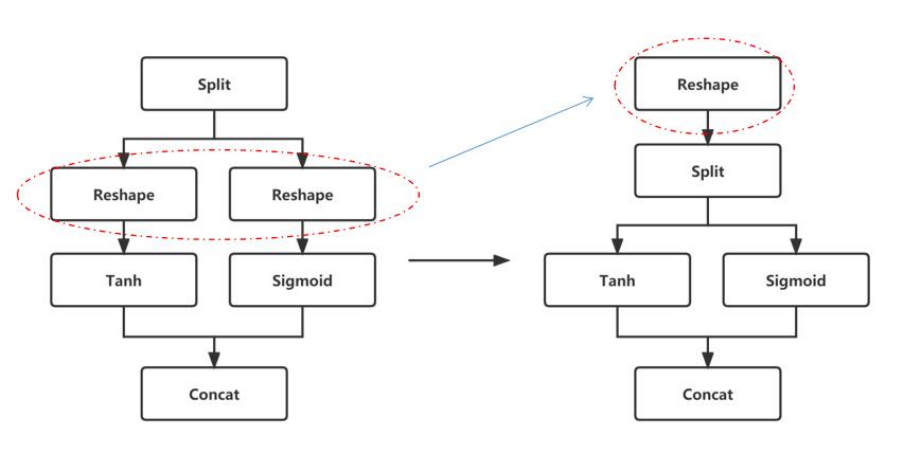
Abbildung 5-12. Zusammenfassen wiederholter Operatoren
5.2.5 Optimierung auf Operatorebene
Operatoroptimierung ist eine gezielte Feinoptimierung einzelner Operatoren zur weiteren Leistungssteigerung. Meist werden Größen so gewählt, dass die Hardware besonders effizient arbeitet. Bei ähnlichem Umfang können ausgerichtete und nicht ausgerichtete Operatoren stark unterschiedliche Laufzeiten haben, weil die Hardware bei nicht ausgerichteten Größen zusätzliche redundante Schritte zur Sicherung der Korrektheit benötigt. Die Größenwahl beeinflusst deshalb die Modellleistung erheblich. Folgende Ansätze helfen bei der frühzeitigen Optimierung.
5.2.5.1 DDR-freundliche OP-Größen (nicht verpflichtend)
Bestimmte ausgerichtete Größen verbessern sowohl die NPU-Berechnung als auch DDR-Lese- und Schreibzugriffe. Bei gleicher Bandbreite erhöhen günstigere Zugriffe deren Nutzungseffizienz und die Leistung. Nachfolgende Größenregeln sind Empfehlungen, keine Pflicht.
Ausrichtung von channel an der erforderlichen Ausrichtungsgröße
Die Ausrichtungstabellen folgen:
Tabelle 5-1. RK3566/RK3568
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabekanal | Ausgabekanal | Ein- und Ausgabekanal | Ein- und Ausgabekanal |
| Int8 | 32 | 16 | 32 | 8 |
| Int16 | 16 | 8 | 16 | 4 |
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabekanal | Ausgabekanal | Ein- und Ausgabekanal | Ein- und Ausgabekanal |
| Float16 | 16 | 8 | 16 | 4 |
| BFloat16 | 16 | 8 | 16 | 4 |
Tabelle 5-2. RK3588/RK3576/RV1126B
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabekanal | Ausgabekanal | Ein- und Ausgabekanal | Ein- und Ausgabekanal |
| Int8 | 32 | 32 | 64 | 16 |
| Int16 | 32 | 16 | 32 | 8 |
| Float16 | 32 | 16 | 32 | 8 |
| BFloat16 | 32 | 16 | 32 | 8 |
| TFloat32 | 16 | 16 | 16 | 4 |
Tabelle 5-3. RV1106/RV1103
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabekanal | Ausgabekanal | Ein- und Ausgabekanal | Ein- und Ausgabekanal |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 16 | 16 | 16 | 8 |
Tabelle 5-4. RK3562
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabekanal | Ausgabekanal | Ein- und Ausgabekanal | Ein- und Ausgabekanal |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 32 | 8 | 16 | 8 |
| Float16 | 32 | 8 | 16 | 8 |
| BFloat16 | 32 | 8 | 16 | 8 |
| TFloat32 | 16 | 8 | 8 | 4 |
4 Ausrichtung auf 4 bei Height * Width > 1
Bei gleichem Berechnungsumfang sind größere Width und kleinere Height günstiger für DDR-Zugriffe. Die Faltung rechts ist in der Abbildung effizienter als die links.
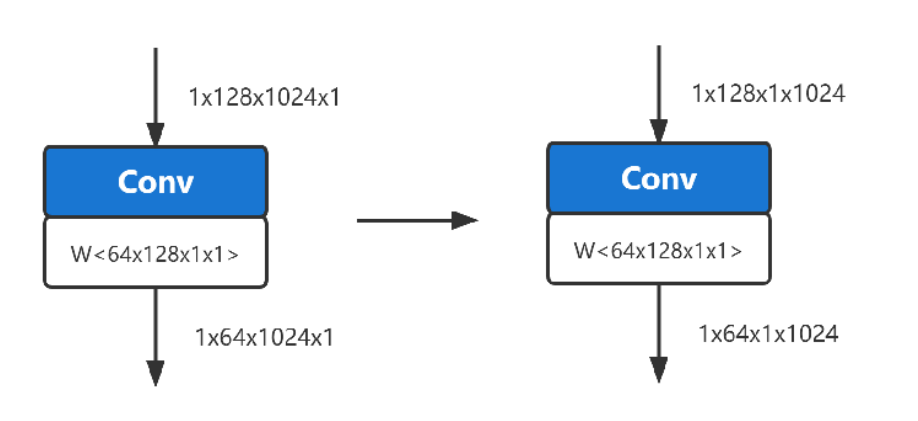
Abbildung 5-13. Vergleich von Faltungen gleichen Umfangs
5.2.5.2 Operatoren mit hoher Ausnutzung entwerfen
Für eine hohe Gesamtausnutzung der Rechenleistung sollten ineffiziente Operatoren vermieden und günstige Größen gewählt werden. Nachfolgend werden möglichst zu vermeidende Operatoren sowie der Zusammenhang zwischen Faltungsgröße und Ausnutzung erläutert.
Ineffiziente Operatoren vermeiden
Reduzieren Sie möglichst die folgenden drei Operatortypen.
Tabelle 5-5. Drei Typen ineffizienter Operatoren
| Datentransfer | Größentransformation | Andere Aktivierungsfunktion als Relu |
|---|---|---|
| Transpose | Resize | Sigmoid |
| Reshape | Tile | Tanh |
| Split | Pooling | Softplus |
| Concat | Pad | Hardswish |
Zusammenhang zwischen Faltungsgröße und Ausnutzung
Faltungsleistung hängt sowohl von Rechenleistung als auch Bandbreite ab. Daher wird häufig die MAC-Ausnutzung verwendet, um die Nutzung der Hardware-Rechenleistung zu beschreiben.
Dieser Zusammenhang dient als Orientierung beim Modellentwurf. Nachfolgend ungefähre Richtwerte auf Basis empirischer Daten:
Bezeichnungen: KH — Kernelhöhe, KW — Kernelbreite, KC — Kernelkanäle, type_bytes — Gewichtsbitbreite geteilt durch 8, Ksize — KW oder KH, Kstride — Schrittweite in KW- oder KH-Richtung.
Erfüllt die Kanalzahl des Eingabe- und Ausgabe-Tensor der Faltung die Ausrichtungsanforderungen (siehe Tabelle in 8.4.1), ist die Ausnutzung höher.
Bei einer Eingabe-Tensor-Kanalzahl < 256 ist die Ausnutzung relativ hoch. Bei > 512 nimmt sie mit zunehmender Kanalzahl allmählich ab.
Bezüglich der Gewichtsgröße ist die Ausnutzung bei KH* KW * KC * type_bytes < 6K Bytes relativ hoch. Oberhalb einer bestimmten Größe sinkt sie deutlich.
Je größer Ksize / Kstride, desto höher die Ausnutzung. Beispielsweise ist Ksize=3, Kstride=1 günstiger als Ksize=2, Kstride=1.
Die Ausnutzung sinkt, wenn Height * Width des Ausgabe-Tensor < 16 ist.
Je größer Channel des Ausgabe-Tensor, desto höher die Ausnutzung.
Oben wurden die Größeneinflüsse einzeln betrachtet. Die tatsächliche MAC-Ausnutzung einer Faltung im bereitgestellten Modell ergibt sich aus dem Zusammenspiel vieler Faktoren.
5.2.5.3 Teilgraphfusion
Der RKNN-Softwarestack erkennt bestimmte Graphbeziehungen und bildet daraus benutzerdefinierte Operatoren, wie nachfolgend gezeigt. Erfolgt die Fusion nicht, prüfen Sie abweichende Verbindungen, die einen Treffer verhindern können.
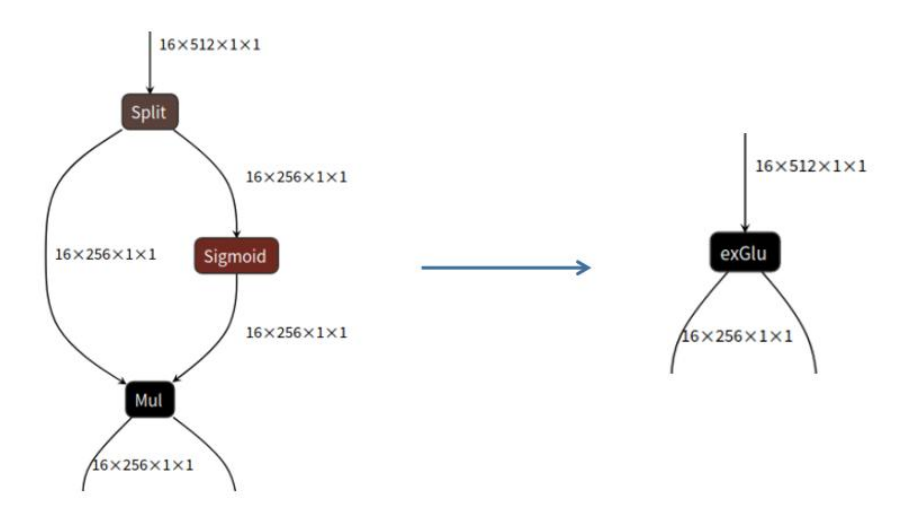
Abbildung 5-14. Fusion des Glu-Teilgraphen
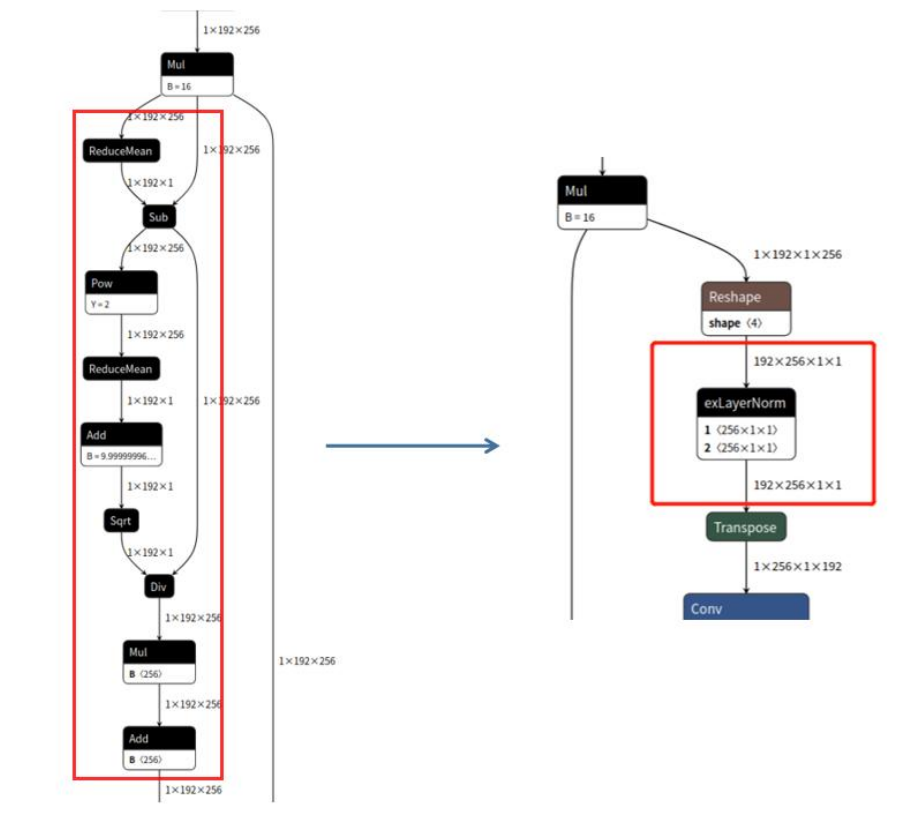
Abbildung 5-15. Fusion des LayerNorm-Teilgraphen
Derzeit werden folgende Teilgraph-Fusionsregeln unterstützt:
Split + Sigmoid + Mul -> GLU
ReduceMean + Sub + Pow + ReduceMean + Add + Sqrt + Div (+ Mul + Add) -> LayerNorm