
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 14/22
多 Batch 推理
4.1.4 多Batch使用说明
4.1.4.1 多BATCH原理
RK3588 NPU内部有3个核心,RK3576 NPU内部有2个核心,为了更高效得利用多核性能,提供了多batch推理功能。当开启多batch推理时,内部会调用 rknn_dup_context 将 context 进行拷贝( rknn_dup_context 只会对 context 的Internal 进行拷贝,Weight会复用)。当rknn_batch_size=2 时,会拷贝1份,当 rknn_batch_size >=3 时,会拷贝2份(同一时刻最多只有3个核心工作,为了避免内存浪费只拷贝2份)。每个context core_mask 会设置成0,让多核内部自动调度。当执行 rknn_run() 时,内部会起一个线程池,同一时刻调用3个线程同时对3个 context 进行推理。
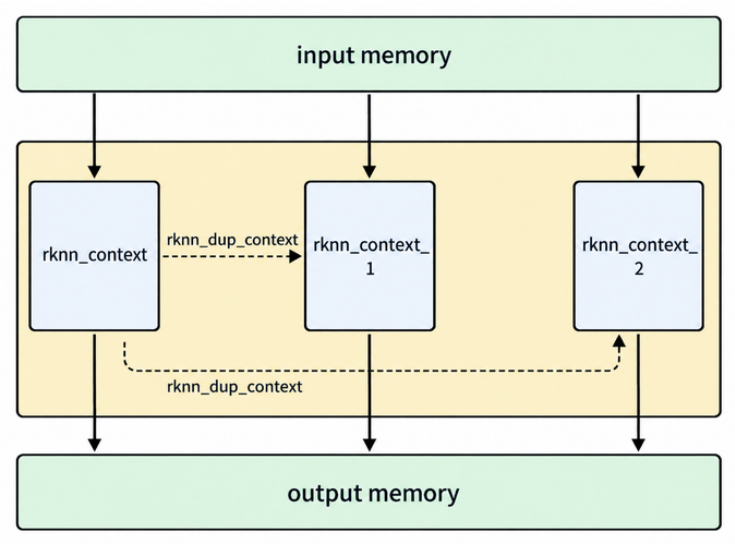
图4-7 多batch内部原理图
4.1.4.2 多BATCH使用方式
多batch使用方式如下:
- Python 端开启多 batch 设置:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', rknn_batch_size=3)
为了达到最优性能,RK3588建议 rknn_batch_size 为3的倍数,RK3576建议 rknn_batch_size 为2的倍数。
- 建议使用零拷贝接口
4.1.4.3 多BATCH输入输出设置
当开启多batch功能时,查询出来的输入输出size是未开启时的 rknn_batch_size 倍。内部每个 context会各自算自己的一个输入偏移量,按照这个输入偏移量取输入数据做推理,然后各自算自己的一个输出偏移量,按照这个输出偏移量写到各自的输出。以第二个batch为例,输入偏移量是查询出来的 input_size 除以rknn_batch_size ,输出偏移量是查询出来的 output_size 除以 rknn_batch_size 。
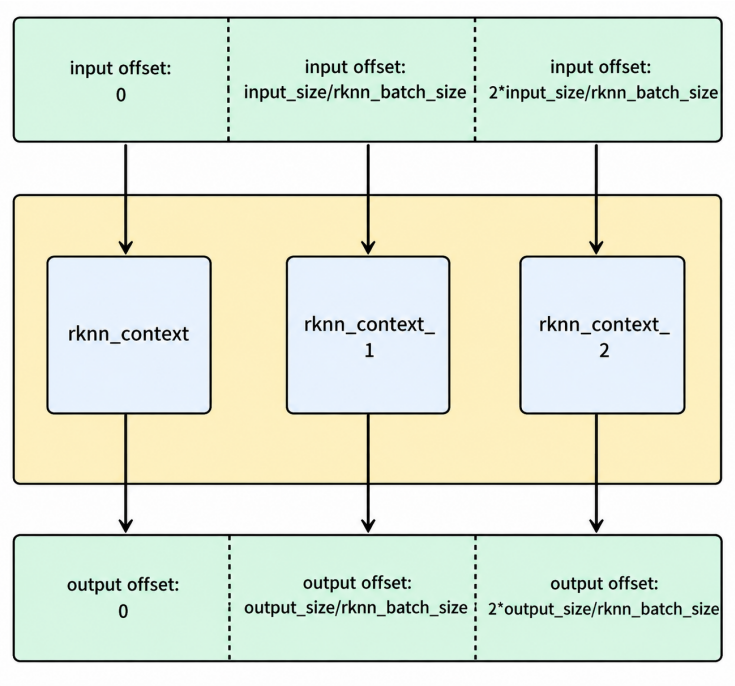
图4-8 多batch内部输入输出地址偏移图