
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 11/22
Matmul API 与矩阵布局
4. 高级功能与扩展
4.1 Runtime高级功能
4.1.1 矩阵乘法接口
Matmul API是Runtime提供的一套单独的C API,用于在NPU上运行矩阵乘法运算,RK2118 / RV1103系列 /RV1106系列暂不支持。矩阵乘法是线性代数中的一种重要操作,该操作定义如下:C=AB。其中,A是一个M×K矩阵,B是一个K×N矩阵,C是一个M×N矩阵。
4.1.1.1 主要用途和特点
Matmul API多用于深度学习中的参数计算任务,例如,在当前被广泛应用的Transformer模型结构的主要模块(自注意力机制和前馈神经网络层)中大量使用了矩阵乘法进行计算,因此矩阵乘法的运算效率对Transfomer模型的整体性能至关重要。Matmul API具有以下特点:
高效:底层使用RKNPU实现,具有高性能低功耗的优点。
灵活:无需加载RKNN模型,支持int4、int8和float16三种边缘端计算常用的输入数据类型,提供单独的内存分配接口或使用外部内存的机制,用戶可管理和复用矩阵的输入输出内存。
4.1.1.2 MATMUL API使用流程
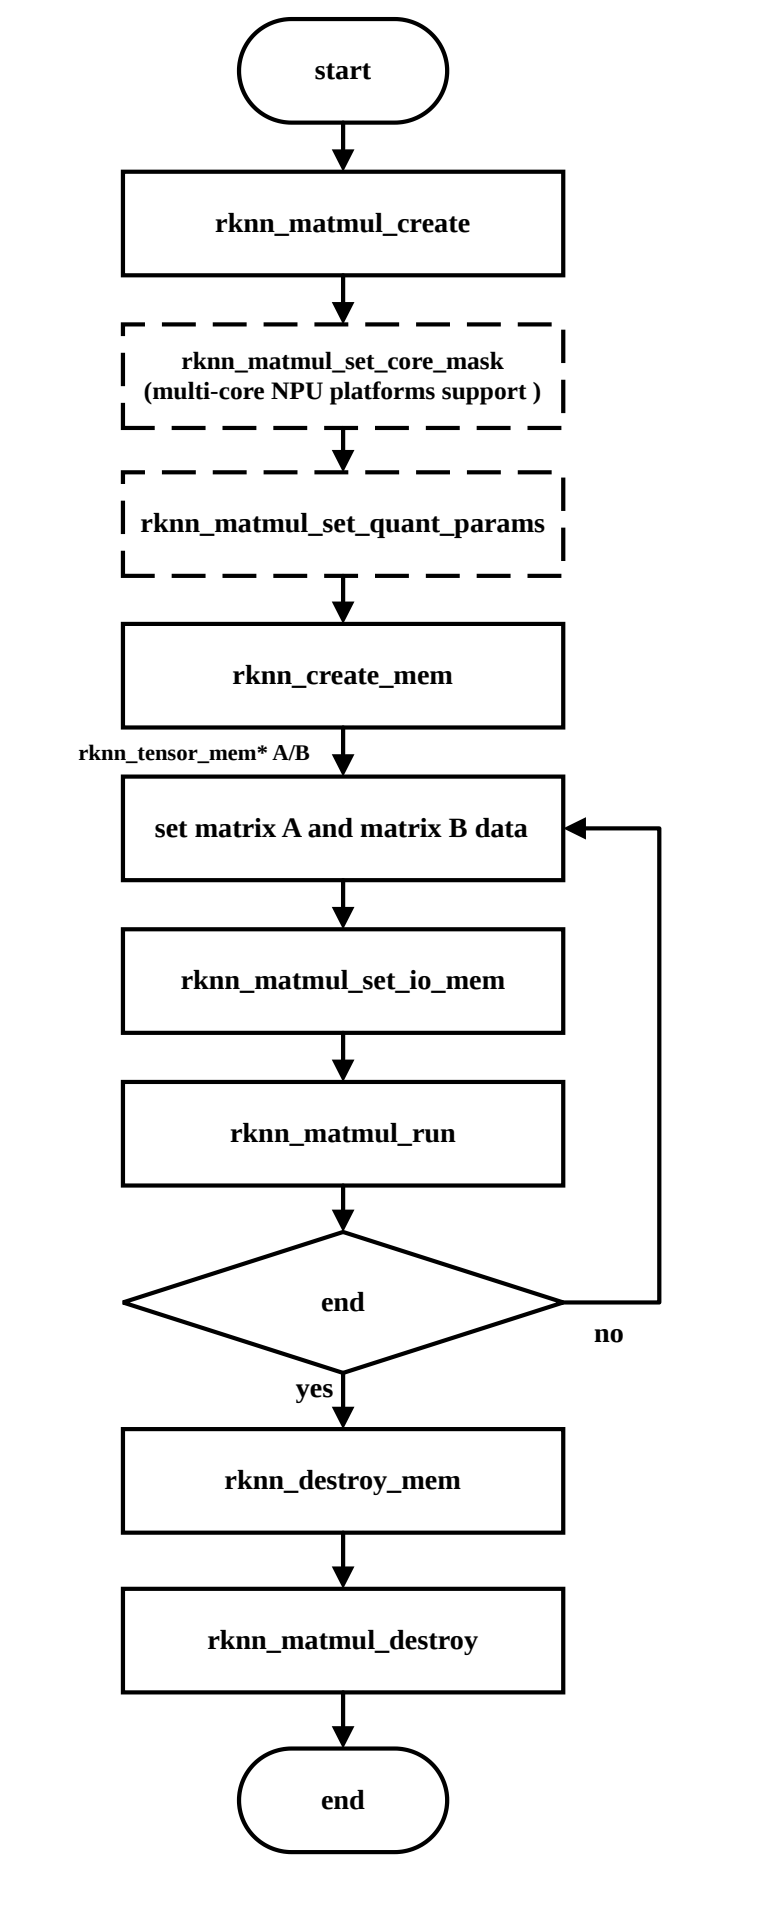
图4-1 Matmul API基础调用流程
首先,Matmul API的结构体和接口位于rknn_matmul_api.h头文件,开发者程序编译时需要包含该头文件。Matmul API基础用法的流程如上图所示。
使用Matmul API通常包括以下步骤:
-
创建上下文:设置rknn_matmul_info结构体,包含M、K、N、输入和输出矩阵的数据类型、输入和输出矩阵使用的数据排列方式等信息,然后,调用rknn_matmul_create接口初始化上下文。在初始化后,获取以rknn_matmul_io_attr结构体指针,它包含了输入和输出矩阵tensor信息。
-
指定运行NPU核(仅多核NPU的芯片平台有效):调用rknn_matmul_set_core_mask,设置掩码来指定某一个NPU核做运算,多核NPU的芯片平台不调用该接口的默认行为是自动选择空闲的核心。
-
设置矩阵A、B和C的量化参数:调用rknn_matmul_set_quant_params传入包含对应矩阵量化参数值的rknn_quant_params结构体,不调用该接口的默认行为是各个矩阵的scale=1.0, zero_point=0。
-
创建输入和输出内存:调用rknn_create_mem接口,根据输入和输出矩阵Tensor信息中的大小创建内存。
-
填充输入数据:根据形状和数据类型填充输入矩阵A和B的数据,并且以量化后的值设置量化参数。
-
设置输入和输出内存:调用rknn_matmul_set_io_mem将填充好数据的输入矩阵记录到上下文中,输出内存也同样记录到上下文中。除了记录内存地址外,该接口还会按照所设置的layout对数据做重新排列,必须在填充或更新输入数据后调用,与零拷贝API中的rknn_set_io_mem接口行为有区别。
-
执行矩阵乘法运算:设置好输入和输出内存后,调用rknn_matmul_run执行矩阵乘法运算。
-
处理输出:执行矩阵乘法运算后,从输出内存中按照所设置的layout来读取结果。
-
销毁资源:执行结束后,调用rknn_destroy_mem和rknn_matmul_destroy分别销毁内存和上下文资源。
4.1.1.3 矩阵乘法高级用法
在创建上下文时,要求用戶设置 rknn_matmul_info 结构体, rknn_matmul_info 表示用于执行矩阵乘法的规格信息,它包含了矩阵乘法的规模、输入和输出矩阵的数据类型和数据排列。其中,B_layout和AC_layout用于设置高性能的数据排列方式。具体的结构体定义如下表所示:
表4-1 rknn_matmul_info结构体定义
| 成员变量 | 数据类型 | 含义 |
|---|---|---|
| M | int32_t | A矩阵的行数 |
| K | int32_t | A矩阵的列数 |
| N | int32_t | B矩阵的列数 |
| 成员变量 | 数据类型 | 含义 |
|---|---|---|
| type | rknn_matmul_type | 输入输出矩阵的数据类型: RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32:表示矩阵A和B是 float16类型,矩阵C是float32类型; RKNN_INT8_MM_INT8_TO_INT32:表示矩阵A和B是int8类型,矩阵C 是int32类型; RKNN_INT8_MM_INT8_TO_INT8:表示矩阵A、B和C是 int8类型; RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16:表示矩阵 A、B和C是float16类型; RKNN_FLOAT16_MM_INT8_TO_FLOAT32: 表示矩阵A是float16类型,矩阵B是int8类型,矩阵C是float32类型; RKNN_FLOAT16_MM_INT8_TO_FLOAT16:表示矩阵A是float16类 型,矩阵B是int8类型,矩阵C是float16类型; RKNN_FLOAT16_MM_INT4_TO_FLOAT32:表示矩阵A是float16类 型,矩阵B是int4类型,矩阵C是float32类型; RKNN_FLOAT16_MM_INT4_TO_FLOAT16:表示矩阵A是float16类 型,矩阵B是int4类型,矩阵C是float16类型; RKNN_INT8_MM_INT8_TO_FLOAT32:表示矩阵A和B是int8类型,矩 阵C是float32类型; RKNN_INT4_MM_INT4_TO_INT16:表示矩阵A和B是int4类型,矩阵C 是int16类型; RKNN_INT8_MM_INT4_TO_INT32:表示矩阵A是int8 类型,B是int4类型,矩阵C是int32类型 |
| B_layout | int16_t | 矩阵B的数据排列方式。 RKNN_MM_LAYOUT_NORM:表示矩阵B按照原始形状排列 ,即KxN的 形状排列; RKNN_MM_LAYOUT_NATIVE:表示矩阵B按照高性能形状排列; RKNN_MM_LAYOUT_TP_NORM:表示矩阵B按照Transpose后的形状 排列,即NxK的形状排列 |
| B_quant_type | int16_t | 矩阵B的量化方式类型。 RKNN_QUANT_TYPE_PER_LAYER_SYM:表示矩阵B按照Per-Layer方 式对称量化; RKNN_QUANT_TYPE_PER_LAYER_ASYM:表示矩阵B按照Per-Layer 方式非对称量化; RKNN_QUANT_TYPE_PER_CHANNEL_SYM:表示矩阵B按照Per- Channel方式对称量化; RKNN_QUANT_TYPE_PER_CHANNEL_ASYM:表示矩阵B按照Per- Channel方式非对称量化; RKNN_QUANT_TYPE_PER_GROUP_SYM:表示矩阵B按照Per-Group 方式对称量化; RKNN_QUANT_TYPE_PER_GROUP_ASYM:表示矩阵B按照Per-Group 方式非对称量化 |
| AC_layout | int16_t | 矩阵A和C的数据排列方式。 RKNN_MM_LAYOUT_NORM:表示矩阵A和C按照原始形状排列; RKNN_MM_LAYOUT_NATIVE:表示矩阵A和C按照高性能形状排列; 详细的排列说明可以参考4.1.1.4 高性能的数据排列方式 |
| AC_quant_type | int16_t | 矩阵A和C的量化方式类型。 RKNN_QUANT_TYPE_PER_LAYER_SYM:表示矩阵A和C按照Per- Layer方式对称量化; RKNN_QUANT_TYPE_PER_LAYER_ASYM:表示矩阵A和C按照Per- Layer方式非对称量化 |
| 成员变量 | 数据类型 | 含义 |
|---|---|---|
| iommu_domain_id | int32_t | 矩阵上下文所在的IOMMU地址空间域的索引。IOMMU地址空间与上下文 一一对应,每个IOMMU地址空间大小为4GB。该参数主要用于矩阵A、B 和C的参数规格较大,某个域内NPU分配的内存超过4GB以后需切换另一 个域时使用。 |
| group_size | int16_t | 一个组的元素数量,仅分组量化开启后生效。 |
| reserved | int8_t[] | 预留字段 |
其中,矩阵A的原始形状是MxK,矩阵B的原始形状是KxN,矩阵C的原始形状是MxN。
4.1.1.3.1 指定量化参数的矩阵乘法
如果矩阵乘积的高比特数据需要根据量化参数量化成低比特数据,例如,矩阵A和B是int8类型,矩阵C是int8类型,需要设置矩阵的量化参数,量化参数由scale和zero_point组成,用rknn_quant_params结构体表示,通过rknn_matmul_set_quant_params接口设置矩阵A和C的量化参数,量化参数设置成功后,Per-Channel量化方式下的矩阵B的量化参数可以通过rknn_matmul_get_quant_params接口读取。rknn_quant_params数据结构定义如下表所示:
表4-2 rknn_quant_params结构体定义
| 成员变量 | 数据类型 | 含义 |
|---|---|---|
| name | char[] | 矩阵的名称 |
| scale | float* | 量化参数scale数组的首地址 |
| scale_len | int32_t | 量化参数scale数组的⻓度 |
| zp | int32_t* | 量化参数zero_point数组的首地址 |
| zp_len | int32_t | 量化参数zero_point数组的⻓度 |
Matmul的量化方式包含Per-Layer方式、Per-Channel方式以及Per-Group方式三种,量化参数差别如下:
Per-Layer方式: scale和zp数组的⻓度为1。
Per-Channel方式: scale和zp数组的⻓度为N。
Per-Group方式: scale和zp数组的⻓度为N*K/group_size,每个组的元素数量由group_size指定,同一个组内的元素共享相同的量化参数,量化参数数组存储方式上,先存储K/group_size个组的量化参数,再存储N个量化参数。
每种量化方式存在对称量化和非对称量化两种方式,对称量化表示zp全为0,非对称量化表示zp不全为0。
4.1.1.3.2 动态shape输入的矩阵乘法
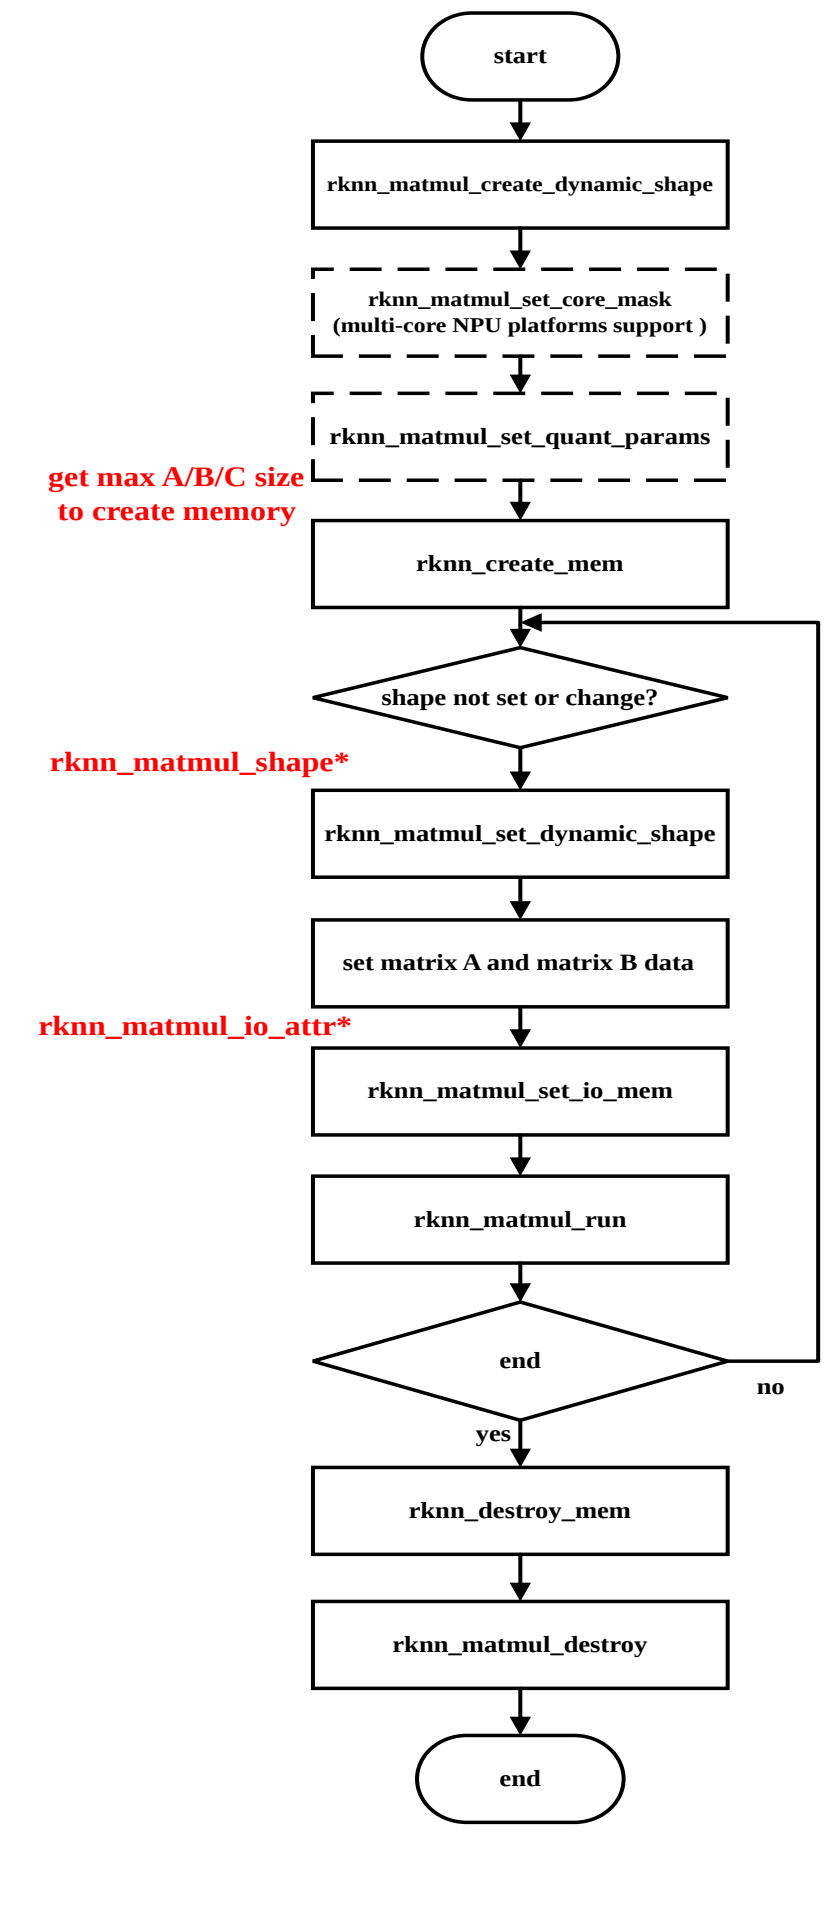
图4-2 动态shape输入的Matmul API调用流程
动态shape输入的Matmul API用法的流程如上图所示。使用动态shape Matmul API与基础的Matmul API的流程差异如下:
-
创建上下文:配置shape数量和所需的shape,设置rknn_matmul_info结构体,包含输入和输出矩阵的数据类型、输入和输出矩阵使用的数据排列方式等信息。注意,动态shape Matmul接口参数rknn_matmul_info中的M、K、N不需要设置。然后,调用rknn_matmul_create_dynamic_shape接口初始化上下文。在初始化后,获取rknn_matmul_io_attr结构体数组,它包含了所有shape配置下的输入和输出矩阵Tensor信息。
-
创建输入和输出内存:首先从rknn_matmul_io_attr结构体数组获取最大的Tensor大小,调用rknn_create_mem接口,使用最大的输入和输出矩阵Tensor大小创建内存。
-
设置输入shape: 通过调用rknn_matmul_set_dynamic_shape接口,传入 rknn_matmul_shape指针,设置当前推理过程使用的shape。
-
设置输入和输出内存:调用rknn_matmul_set_io_mem将填充好数据的输入矩阵记录到上下文中,输出内存也同样记录到上下文中。传入的rknn_tensor_mem参数是前面创建的最大size的输入和输出内存,rknn_matmul_tensor_attr参数是当前shape对应的矩阵属性信息。
4.1.1.4 高性能的数据排列方式
由于NPU是专用的硬件架构,读取MxK和KxN这种原始形状的数据不是最高效的,同样的,写入MxN形状的C矩阵也不是最高效的,用戶使用特殊的数据排列方式可以实现更高的性能。AC_layout参数控制矩阵A和C是否使用高性能数据排列,B_layout参数控制矩阵B是否使用高性能数据排列。 假设矩阵A的原始形状是MxK,矩阵B的原始形状是KxN,矩阵C的原始形状是MxN,要求的数据排列方式如下:
-
若AC_layout=RKNN_MM_LAYOUT_NORM且B_layout=RKNN_MM_LAYOUT_NORM,矩阵A的形状为[M,K],矩阵B的形状为[K,N],矩阵C的形状为[M,N]。
-
若AC_layout=RKNN_MM_LAYOUT_NATIVE且B_layout=RKNN_MM_LAYOUT_NATIVE,不同芯片平台和数据类型下矩阵A、B和C的高性能数据排列如下表所示(表中除法结果都是上取整,多出部分用0补齐):
-
B_layout=RKNN_MM_LAYOUT_NORM和B_layout=RKNN_MM_LAYOUT_TP_NORM的区别在于,前者矩阵B的形状为[K,N],后者矩阵B的形状为[N,K],后者的执行效率更优。
表4-3 各个芯片平台矩阵A、B和C的高性能形状
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| A形状(int4) | 暂不支持 | 暂不支持 | [K/32,M,32] | [K/32,M,32] |
| B形状(int4) | 暂不支持 | 暂不支持 | [N/64,K/32,64,32]* | [N/64,K/32,64,32] |
| C形状(int16) | 暂不支持 | 暂不支持 | [N/8,M,8] | [N/8,M,8] |
| A形状(int8) | [K/16,M,16] | [K/8,M,8] | [K/16,M,16] | [K/16,M,16] |
| B形状(int8) | [N/16,K/32,16,32] | [N/16,K/32,16,32] | [N/32,K/32,32,32]* | [N/32,K/32,32,32] |
| C形状(int32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
| A形状(float16) | [K/8,M,8] | [K/4,M,4] | [K/8,M,8] | [K/8,M,8] |
| B形状(float16) | [N/8,K/32,8,32] | [N/8,K/16,8,16] | [N/16,K/32,16,32] | [N/16,K/32,16,32] |
| C形状(float32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
[!NOTE]
上表中的数据排列方式是A和B“同型”(即A和B相同数据类型)情况下的高性能形状。RK3576/RV1126B支持“异型”输入,即允许A和B有不同的数据类型,在“异型”输入情况下,B的高性能数据排列与C类型对应的“同型”情况下B的形状相同。例如,A是int4类型,B是float16类型,C是float32类型,则B的高性能数据数据排列是[N/16,K/32,16,32]。 rknn_B_normal_layout_to_native_layout 接口提供了对B的原始形状转换成高性能排列的功能。
以RK3566/RK3568平台,int8数据类型为例,矩阵A从[M,K]变换到[K/8,M,8]的元素对应关系如下图所示:
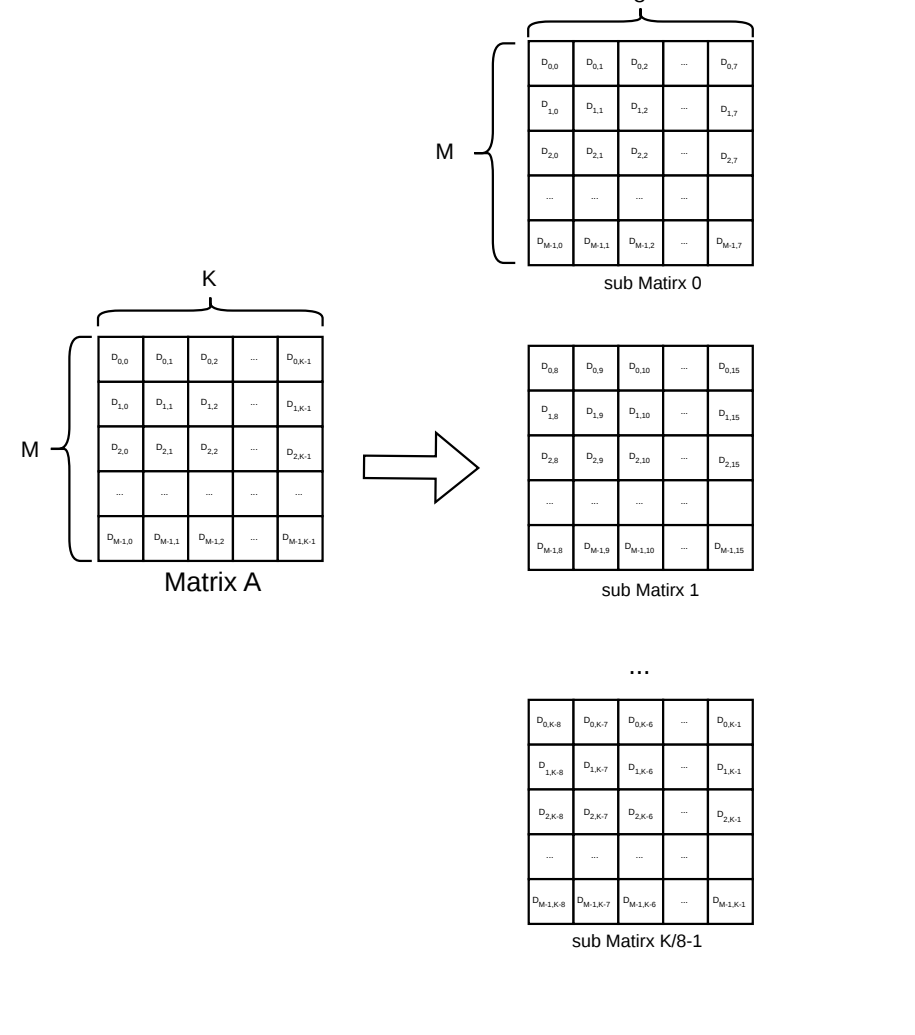
图4-3 int8类型矩阵A从[M,K]变换到[K/8,M,8]的元素对应关系图
其中,矩阵A第(i,j)元素对应的数据为Di,j,左图是shape=[M,K]的矩阵,右图每个小矩阵shape=[M,8],从上到下一共K/8个。
矩阵A或C从原始形状转换成高性能形状的示例代码如下:
template <typename Ti, typename To>
void norm_layout_to_perf_layout(Ti *src, To *dst, int32_t M, int32_t K, int32_t
subK){
    int outter_size = (int)std::ceil(K * 1.0f / subK);
    for (int i = 0; i < outter_size; i++)
    {
       for (int m = 0; m < M; m++)
       {
           for (int j = 0; j < subK; j++)
           {
               int ki = i * subK + j;
               if (ki >= K)
               {
                 dst[i * M * subK + m * subK + j] = 0;
               }
               else
               {
                 dst[i * M * subK + m * subK + j] = src[m * K + ki];
               }
           }
       }
    }
}
以RK3566/RK3568平台,int8数据类型的矩阵B从[K,N]变换到[N/16,K/32,16,32]的元素对应关系如下图所示:
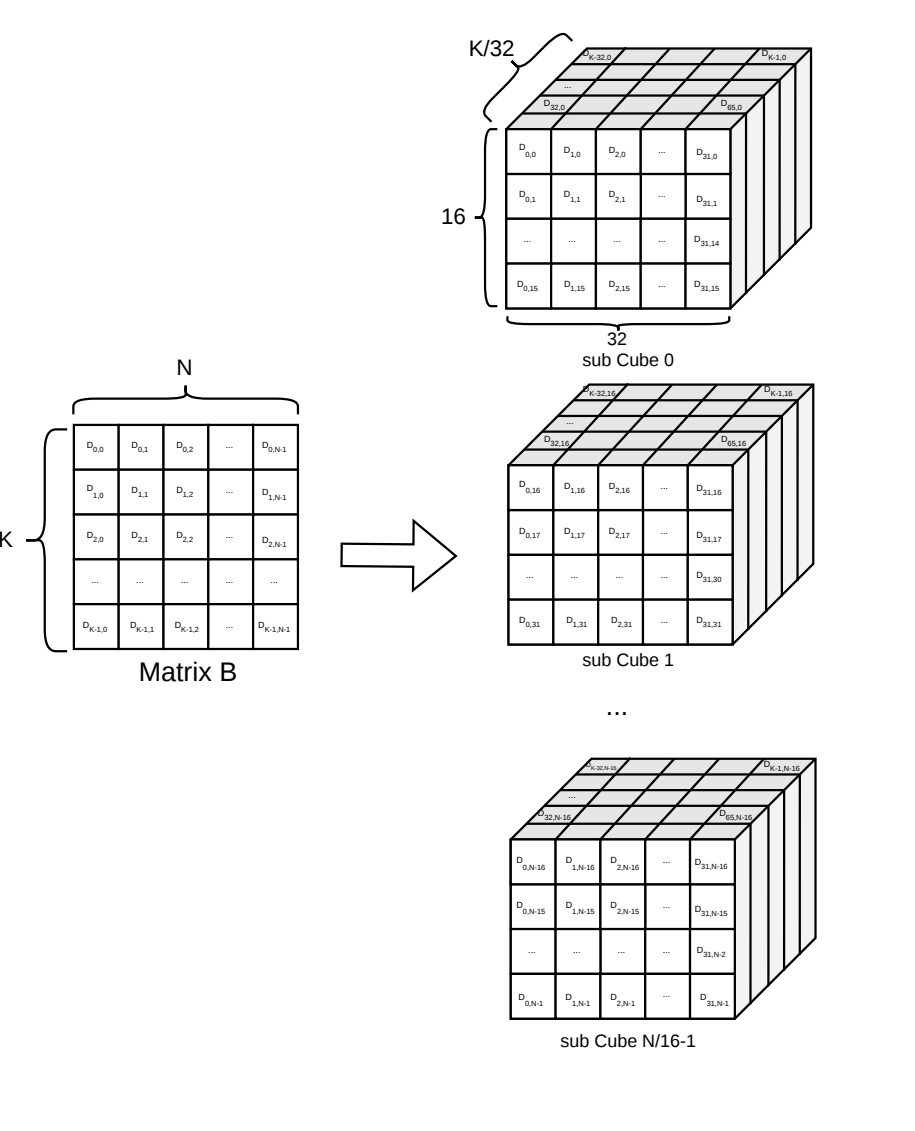
图4-4 int8类型矩阵B从[K,N]变换到[N/16,K/32,16,32]的元素对应关系图
其中,矩阵B第(i,j)元素对应的数据为Di,j,左图是shape=[K,N]的矩阵,右图每个小立方体shape=[K/32,16,32],从上到下一共N/16个。
矩阵B从原始形状转换成高性能形状的示例代码如下:
template <typename Ti, typename To>
voi norm_layout_to_native_layout(Ti *src, To *dst, int32_t K, int32_t N, int32_t
subN, int32_t subK)
{
    int N_remain = (int)std::ceil(N * 1.0f / subN);
    int K_remain = (int)std::ceil(K * 1.0f / subK);
    for (int i = 0; i < N_remain; i++)
    {
       for (int j = 0; j < K_remain; j++)
       {
           for (int n = 0; n < subN; n++)
           {
               int ni = i * subN + n;
               for (int k = 0; k < subK; k++)
               {
                   int ki = j * subK + k;
                   if (ki < K && ni < N)
                   {
                      dst[((i * K_remain + j) * subN + n) * subK + k] = src[ki * N
+ ni];
                   }
                   else
                   {
                      dst[((i * K_remain + j) * subN + n) * subK + k] = 0;
                   }
               }
           }
       }
    }
}
[!NOTE]
Matmul API完整示例代码见 https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_matmul_api_demo。
4.1.1.4.1 矩阵规格限制
Matmul API是基于NPU的硬件架构实现,受硬件规格限制。在参数上有如下几点限制:
AC_layout和B_layout可独立设置。所有硬件平台上的AC_layout和B_layout都支持RKNN_MM_LAYOUT_NORM或者RKNN_MM_LAYOUT_TP_NORM,除了RK3566/RK3568平台外,其他平台都支持RKNN_MM_LAYOUT_TP_NORM。
Matmul接口支持多种输入和输出的数据位宽,目前各个平台支持的矩阵数据类型组合如下表:
表4-4 Matmul接口支持的矩阵A、B和C的数据类型组合
| 序号 | RK356X | RK3576/RV1126B | RK3588 |
|---|---|---|---|
| 1 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 |
| 2 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 |
| 3 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_INT8_MM_INT8_TO_INT32 | |
| 4 | RKNN_FLOAT16_MM_INT8_TO_FLOAT32 | RKNN_INT8_MM_INT8_TO_FLOAT32 | |
| 5 | RKNN_FLOAT16_MM_INT4_TO_FLOAT16 | RKNN_INT8_MM_INT8_TO_INT8 | |
| 6 | RKNN_FLOAT16_MM_INT4_TO_FLOAT32 | RKNN_INT4_MM_INT4_TO_INT16 | |
| 7 | RKNN_INT8_MM_INT4_TO_INT32 |
其中,RK356X表示RK3562/RK3566/RK3568等平台,float16浮点格式遵循IEEE-754标准,具体格式请参考 [IEEE-754 half] (https://en.wikipedia.org/wiki/Half-precision_floating-point_format)。
Matmul中K和N大小限制如下表:
表4-5 各个芯片平台K和N的大小限制
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| K大小限制 (int4) | 暂不支持 | 暂不支持 | * | 32对齐 |
| K大小限制 (int8) | K <= 10240且K mod 32 = 0 | K <= 10240且K mod 32 = 0 | 32对齐 | 32对齐 |
| K大小限制 (float16) | K <= 10240且K mod 32 = 0 | K <= 10240且K mod 32 = 0 | 32对齐 | 32对齐 |
| N大小限制 (int4) | 暂不支持 | 暂不支持 | * | N <= 8192且N mod 64 = 0 |
| N大小限制 (int8) | N <= 4096且N mod 16 = 0 | N <= 4096且N mod 16 = 0 | N <= 4096且N mod 32 = 0 | N <= 4096且N mod 32 = 0 |
| N大小限制 (float16) | N <= 4096且N mod 16 = 0 | N <= 4096且N mod 16 = 0 | N <= 4096且N mod 32 = 0 | N <= 4096且N mod 32 = 0 |
[!NOTE]
*表示大小和对齐限制由同平台下A的数据类型对应的B限制相同。例如,RKNN_FLOAT16_MM_INT4_TO_FLOAT32组合类型B的大小和对齐限制与RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32组合相同。
对于RK3588:
当K > 8192, B 会被分成T段,
int T = std::ceil(K / 8192);
例如: normal layout -> native layout, K = 20488, N = 4096, T = 3, 数据会被分成3段,
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
K,N转变过程如下:
                     (8196, 4096) (4096 / subN, 8196 / subK, subN, subK)
 (K, N) = (20488, 4096)->(8196, 4096)->(4096 / subN, 8196 / subK, subN, subK)
         normal layout (4096, 4096) (4096 / subN, 4096 / subK, subN, subK)
                   T normal layout T native layout
推荐使用rknn_B_normal_layout_to_native_layout接口进行直接数据转换。
对于RK3576/RV1126B: 当K > 4096, B 会被分成T段,
int T = std::ceil(K / 4096);
例如: normal layout -> native layout, K = 10240, N = 2048, T = 3, 数据会被分成3段,
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
K,N转变过程如下:
                     (4096, 2048) (2048 / subN, 4096 / subK, subN, subK)
(K, N) = (10240, 2048) ->(4096, 2048)->(2048 / subN, 4096 / subK, subN, subK)
        normal layout (2048, 2048) (2048 / subN, 2048 / subK, subN, subK)
                    T normal layout T native layout
推荐使用rknn_B_normal_layout_to_native_layout接口进行直接数据转换。