
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 3/22
开发流程与接口选择
1.3 开发流程与接口选择
1.3.1 通用模型开发流程
用戶可参考如下流程图了解RKNN的整体开发步骤,流程主要分为3个部分:模型转换、模型评估和板端部署运行。
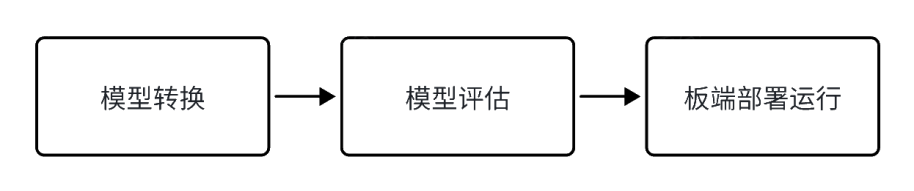
图1-5 RKNN 开发流程图
- 模型转换:
在这一阶段,原始的深度学习模型会被转化为RKNN格式,以便在RKNPU平台上进行高效的推理。这一阶段包括以下5个步骤:
a. 获取原始模型:获取或训练深度学习模型,建议使用主流框架,如ONNX、PyTorch或TensorFlow。
b. 模型配置:在RKNN-Toolkit2中进行必要的配置,如归一化参数、量化参数和目标平台等。
c. 模型加载:使用适当的加载接口将模型导入RKNN-Toolkit2,根据模型框架选择正确的加载接口。
d. 模型构建:通过 rknn.build() 接口构建RKNN模型,可选择是否进行量化,提高模型在硬件上推理的性能。
e. 模型导出:通过 rknn.export_rknn() 接口将RKNN模型导出成一个文件(.rknn 格式),用于后续部署。
具体内容请见2.1 通用模型转换章节内容。
2.模型评估:
该阶段的主要目标是评估模型推理结果的准确性、推理性能和内存占用等关键指标。评估的主要步骤如下:
a. 模型连板调试:使用Python连接RKNPU平台对模型进行推理并验证结果准确性。这个阶段涵盖了输入数据的前处理和输出结果的后处理,以确保模型在板上运行正确。
b. 精度评估:通过 rknn.accuracy_analysis() 接口,比较量化模型与浮点模型推理结果之间的差异,以分析量化误差的来源。
c. 性能评估:通过 rknn.eval_perf() 接口,分析模型在RKNPU平台上的推理性能,帮助用戶进一步优化模型结构,加快推理性能。
d. 内存评估:通过 rknn.eval_memory() 接口,了解模型在RKNPU平台上的内存使用情况,帮助用戶进一步优化模型结构,最小化内存占用。
具体内容请参考2.3 模型评估、3.2 通用模型C API部署和3.3 Toolkit Lite Python部署章节内容。
3. 板端部署运行:
这个阶段涵盖了模型的实际部署和运行。它通常包括以下步骤:
a. 模型初始化:加载RKNN模型到RKNPU平台,准备进行前处理。
b. 模型前处理:加载待推理数据到RKNPU平台,准备进行推理。
c. 模型推理:执行推理操作,将输入数据传递给模型并获取推理结果。
d. 模型后处理:获取推理结果进行后处理,后处理结果传给应用端。
e. 模型释放:在完成推理流程后,释放模型资源,以便其他任务使用RKNN模型。
具体内容请参考3.3 Toolkit Lite Python部署章节内容。
这三个步骤构成了完整的RKNN开发流程,确保人工智能模型能够成功转换、调试、评估和最终在RKNPU上高效部署。
1.3.2 接口选择
RKNN2 SDK 提供两种板端调用方式,用戶根据场景选择:
| 方式 | 语言 | 适用场景 |
|---|---|---|
| RKNN Runtime(C API) | C / C++ | 生产部署、性能敏感场景 |
| RKNN-Toolkit Lite2(Python API) | Python | 板端快速验证、原型开发 |
两者差异:
性能:C API 最优;Toolkit Lite 因 Python 封装开销性能略低。
开发便捷性:Toolkit Lite 更便捷(Python 编程,无需交叉编译);C API 需交叉编译集成到板端应用。
功能完整性:C API 支持完整高级功能(零拷贝、NPU多核、矩阵乘法接口、动态Shape、SRAM、模型加密等);Toolkit Lite 面向板端快速验证,高级功能覆盖较少。
选择建议:
生产部署 / 性能敏感场景:使用 C API,可获得最优性能和完整功能,并支持模型加密部署等安全特性。
板端验证 / 原型开发:使用 Toolkit Lite,无需交叉编译,配合转换好的 .rknn 模型即可在板端快速验证推理结果。
说明:两种接口的详细使用分别见 3.2 通用模型C API部署和 3.3 Toolkit Lite Python部署。
1.3.3 模型转换和部署产物说明
模型转换完成后生成的部署产物如下:
| 文件/目录 | 说明 |
|---|---|
| .rknn | RKNN 模型文件,包含模型结构与权重数据 |
| C++ 部署示例代码 (可选) | 通过 rknn.export_rknn() 的 cpp_gen_cfg 参数或 rknn.codegen() 接口生成,可 直接测试性能、验证精度,也可二次开发 |
说明:RKNN2 导出的模型为单一 .rknn 文件(模型结构与权重一体)。部署时需将 .rknn 模型传输到板端,C API 部署通过 rknn_init() 加载,Toolkit Lite2 部署通过 init() 加载;模型加密部署场景下的产物说明见 4.2.2 模型加密部署。