
平台参考:本文来自 Rockchip RKNN2 SDK V2.5.0 开发指南,涵盖源文明确列出的 SoC、Linux/Android Runtime 和对应 Toolkit。具体功能仅适用于各节列出的芯片、SDK、驱动和内核条件,不能据此推定所有 ArmSoM 板卡支持。部署前需核对实际 ArmSoM 板卡的 BSP、NPU 驱动、Runtime 与模型版本。本篇未进行 ArmSoM 硬件验证;日志、性能数字和示例均来自原稿。
来源与校对:中文遵循中文 V2.5.0(182 页),英文、俄文和德文遵循英文 V2.5.0(208 页);保留各稿技术信息,不将旧版内容补充为新版事实。中文配图取自中文 PDF,英俄德配图取自英文 PDF,含独立提取的矢量流程图。保留原章节和公式编号。原稿部分交叉引用仍指向旧章号,动态 Shape 容量示例写作“1224+140=264”等、TP_NORM 支持说明有矛盾、init()/rknn.val_perf() 等名称与后文 API 不一致;原始信息保留,执行前以实际 V2.5.0 SDK 头文件及 API 手册核对。各部分均保留代码和参数,提取造成的跨页换行与表格续行已整理。
RKNN2 SDK V2.5.0 · 1/22
软件栈与核心概念
1. 概述与开发准备
1.1 RKNN2 SDK概述
1.1.1 SDK定位和典型应用场景
1.1.1.1 RKNN软件栈整体介绍
RKNN软件栈可以帮助用戶快速的将AI模型部署到Rockchip芯片。整体的框架如下:
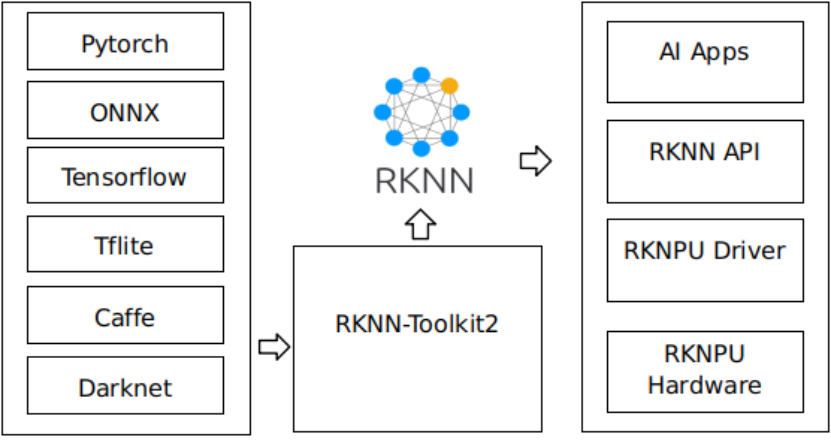
图1-1 RKNN 软件栈
为了使用RKNPU,用戶需要首先在计算机上运行RKNN-Toolkit2工具,将训练好的模型转换为RKNN格式模型,之后使用RKNN C API或Python API在开发板上进行部署。
1.1.1.2 RKNN-TOOLKIT2功能介绍
RKNN-Toolkit2是为用戶提供在计算机上进行模型转换、推理和性能评估的开发套件,RKNN-Toolkit2的主要框
图如下:
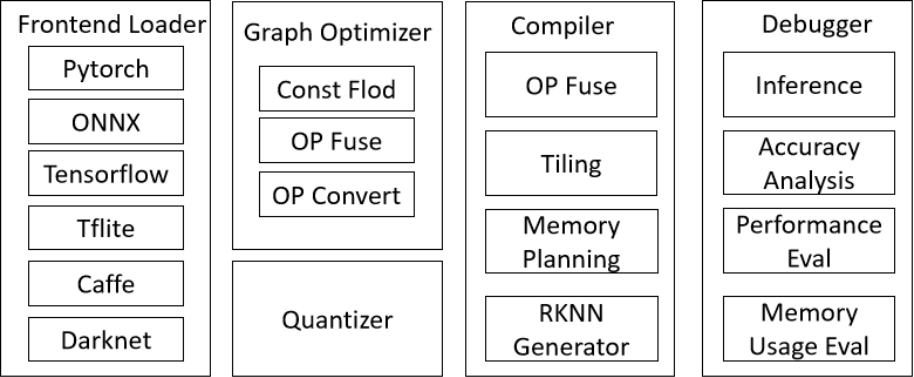
图1-2 RKNN-Toolkit2 软件框图
通过该工具提供的Python接口可以便捷地完成以下功能:
-
模型转换:支持将PyTorch、ONNX、TensorFlow、TensorFlow Lite、Caffe、DarkNet等模型转为RKNN模型。
-
量化功能:支持将浮点模型量化为定点模型,并支持混合量化。
-
模型推理:将RKNN模型分发到指定的NPU设备上进行推理并获取推理结果;或在计算机上仿真NPU运行RKNN模型并获取推理结果。
-
性能和内存评估:将RKNN模型分发到指定NPU设备上运行,以评估模型在实际设备上运行时的性能和内存占用情况。
-
量化精度分析:该功能将给出模型量化后每一层推理结果与浮点模型推理结果的余弦距离和欧氏距离,以便于分析量化误差是如何出现的,为提高量化模型的精度提供思路。
-
模型加密功能:采用AES-256-CTR与RSA-OAEP的混合加密方案对RKNN模型进行加密,保护模型知识产权。
1.1.1.3 RKNN RUNTIME功能介绍
RKNN Runtime负责加载RKNN模型,并调用NPU驱动实现在NPU上推理RKNN模型。推理RKNN模型时,包括原始数据输入预处理、NPU运行模型、输出后处理三项流程。根据不同模型输入格式和量化方式,RKNNRuntime提供通用API和零拷贝API两种处理流程。
通用API推理:提供一套简洁、无⻔槛的推理API,易于使用,流程如图1-3所示。其中对数据的归一化、量化、数据排布格式转换、反量化等均在CPU上运行,模型本身的推理在NPU上运行。
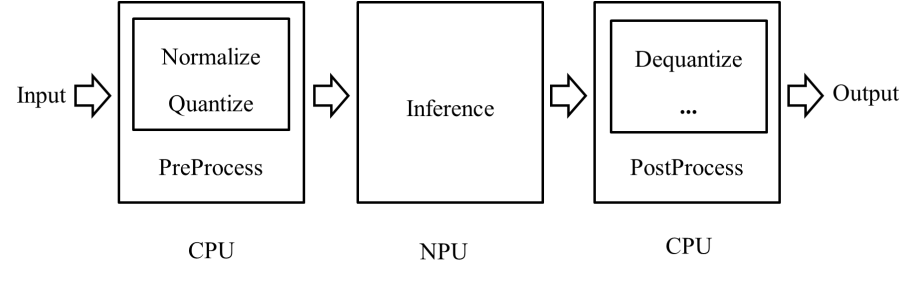
图1-3 通用API的数据处理流程
零拷贝API推理:流程如图1-4所示。优化了通用API的数据处理流程,归一化、量化和模型推理都会在NPU上运行,NPU输出的数据排布格式和反量化过程在CPU或者NPU上运行。零拷贝API对于输入数据流程的处理效率会比通用API高。支持数据在不同的IP核之间流动,没有数据拷贝,减少CPU及DDR带宽消耗。比如通过camera或者解码出来的数据,支持零拷贝导入到NPU中使用。
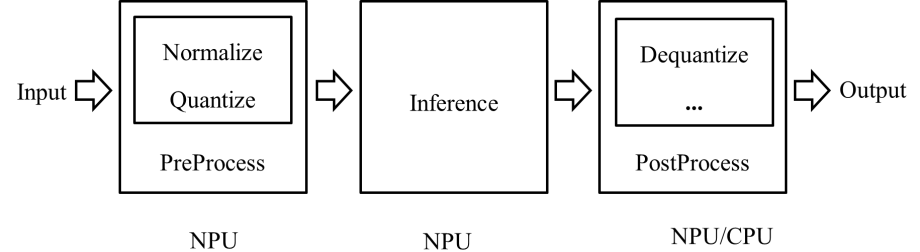
图1-4 零拷贝API数据处理流程
当用戶输入数据只有虚拟地址时,只能使用通用API接口;当用戶输入数据有物理地址或fd时,两组接口都可以使用。
1.1.2 支持的硬件平台和部署模式
本文档适用如下硬件平台:
RK2118、RK3562、RK3566系列、RK3568系列、RK3576、RK3588系列、RV1103、RV1103B、RV1106、RV1106B、RV1126B
注:文档部分地方使用RK3566_RK3568来统一表示RK3566/RK3568系列,使用RK3588来统一表示RK3588/RK3588S系列。
1.1.3 术语、缩略语和文档约定
本节介绍文档中常用的术语与缩略语。
硬件与部署
连板推理:PC 通过 USB 连接开发板,推理由 PC 侧 RKNN-Toolkit2 发起、模型在开发板的 NPU 上执行,用于模型验证和精度分析。
模型与张量
RKNN模型:指运行在RKNPU上的模型文件,后缀名为.rknn。
Tensor(张量):表示多维数组的数据结构,包含数据内存和属性信息(shape / dtype / layout 等)。
数据类型(dtype):张量元素的数据类型,如 FP32 / FP16 / INT8 / UINT8 等。
数据布局(layout):张量在内存中的排列方式,如 NCHW / NHWC / NC1HWC2 等。
NC1HWC2:NPU 优化的内存布局格式,将通道维度分块存储,提升 NPU 访问效率,不同平台的子通道数见 3.1.2 NPU排布。
量化
量化模型:使用 INT8 等低精度数据类型运行的模型,需要 scale 和 zero_point 参数进行量化/反量化。
非量化模型:使用 FP16 数据类型运行的模型,无需量化参数。
文档约定
代码块中以 # 开头的行为注释。
<> 中的内容为参数占位符,需根据实际情况替换。
接口函数名、参数名、文件名等用反引号(`)包裹。
文档中涉及的 API 详细参数说明请参考对应的 API 参考手册。