
本文整理 RK-KF-YF-460 V2.9.0 技术正文。原稿范围为支持 PCIe 的芯片及 Linux 4.4 以上。本文是平台参考;具体 ArmSoM 板卡须核对 SoC、PCIe 布线、SDK/BSP、内核和外设。性能表格均为原厂 EVB 测试,不是 ArmSoM 实测。中文采用中文图,其他语言采用英文图。涉及寄存器、固件、电源策略以及格式化命令,须在备份后的测试设备按实际 BSP 验证。
1. 背景
1.1 简介
本文介绍 RK PCIe 应用相关的性能指标及其测试方法,测试目标为通过简单、准确、可控的应用接口来获取对应的性能指标。其中 “背景” 章节主要介绍测试过程中涉及到的部分知识背景,“传输速率简介” 章节为 PCIe 理论计算数据,其余章节为具体性能指标及其测试方法。
1.2 PCIe sysfs
Linux PCIe 支持 sysfs 接口,主要提供以下资源:
/sys/devices/pci0000:17
|-- 0000:17:00.0
|   |-- class
|   |-- config
|   |-- device
|   |-- enable
|   |-- irq
|   |-- local_cpus
|   |-- remove
|   |-- resource
|   |-- resource0
|   |-- resource1
|   |-- resource2
|   |-- resource2_wc        # 64bits-pref mem resource 并⽀持写缓冲,对于 PCIe mem to dev 操作有优化效果。
|   |-- revision
|   |-- rom
|   |-- subsystem_device
|   |-- subsystem_vendor
|   `-- vendor
`-- ...
详细参考:
2. 传输速率简介
2.1 PCIe 带宽
| PCIe Generation | 编码方案 | 传输速率 | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|---|---|
| 1.0 | 8b/10b | 2.5GT/s | 250MB/s | 500MB/s | 1GB/s | 2GB/s |
| 2.0 | 8b/10b | 5GT/s | 500MB/s | 1GB/s | 2GB/s | 4GB/s |
| 3.0 | 128b/130b | 8GT/s | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
| 4.0 | 128b/130b | 16GT/s | 1.969GB/s | 3.938GB/s | 7.877GB/s | 15.754GB/s |
传输速率传输速率为每秒传输量GT/s,而不是每秒位数Gbps,因为传输量包括不提供额外吞吐量的开销位; 比如 PCIe 1.x和PCIe 2.x使用8b / 10b编码方案,导致占用了20% (2/10)的原始信道带宽。GT/s: Giga transaction per second (千兆传输/秒),即每一秒内传输的次数Gbps : Giga Bits Per Second (千兆位/秒)。GT/s 与Gbps 之间不存在成比例的换算关系PCIe 可用带宽吞吐量 = 传输速率 * 编码方案例如:PCIe 2.0 协议的每一条 Lane 支持 58 / 10 = 4 Gbps = 500 MB/s 的速率,PCIe 2.0 x8通道为例,x8的可用带宽为48 = 32 Gbps = 4 GB/s。
2.2 PCIe TLP 损耗
由于数据经过 Transaction Layer 和 Data Link Layer 后会添加打包信息,例如数据包的包头、包尾( LCRC 和 ECRC等)、数据链路层添加的包编号等等,所以 Data Payload 的真实速率相较于带宽会更低。
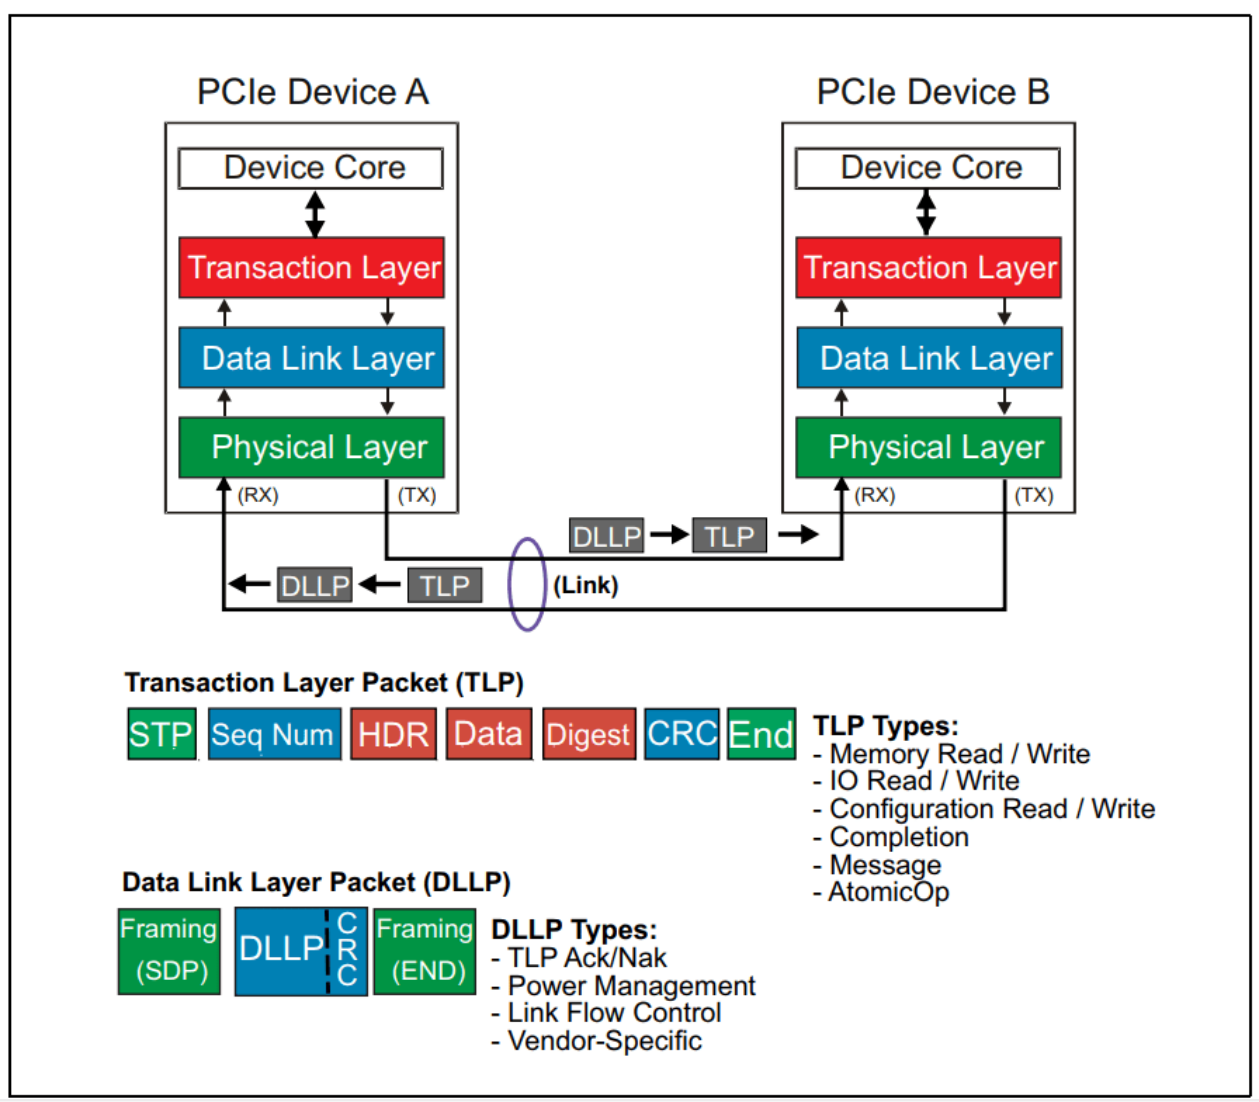
中文原图 — 8
28 Byte TLP overhead 是冗余最大的传输包,包含 the header (16 bytes), the optional ECRC (4 bytes), the LCRC (4bytes), the sequence number (2 bytes) and the framing Symbols STP and END (2 bytes).所以以 Gen3 PCIe 带宽为例:
| PCIe Generation | 编码方案 | 传输速率 | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|---|---|
| 3.0 | 128b/130b | 8GT/s | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
计入 TLP overhead 后:
| PCIe Generation Gen3 | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|
| PCIe 带宽(未计入 TLP overhead) | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
| 256B payload 扣除 TLP 损耗(256/284) | 887.5MB/s | 1.775GB/s | 3.550GB/s | 7.1002GB/s |
| 128B payload 扣除 TLP 损耗(128/156) | 807.8MB/s | 1.616GB/s | 3.232GB/s | 6.464GB/s |
2.3 PCIe 应用场景传输速率
如果再考虑用于 Ack/Nak 和 Flow Control 等的 DLLP 和用于链路训练和 Skip 的 Order Sets 等不定因素对速率的影响,实际数据传输速率会更低。具体应用场景下以 eDMA 传输为最优解。
3. 通用性能优化方向
3.1 CPU 和 DDR 定最高频
请参考 DVFS 及 DRAM 相关源码做调整。
3.2 CPU关闭idle策略
以RK3588 平台为例
/* dtsi 关闭cpu-sleep */
--- a/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
+++ b/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
@@ -585,6 +585,7 @@
idle-states {
    entry-method = "psci";
    CPU_SLEEP: cpu-sleep {
        compatible = "arm,idle-state";
        local-timer-stop;
        arm,psci-suspend-param = <0x0010000>;
        entry-latency-us = <100>;
        exit-latency-us = <120>;
        min-residency-us = <1000>;
+       status = "disabled";
    };
};

/* cmdline关闭ARM默认的wfi, Android平台请修改rk3588-android.dtsi */
--- a/arch/arm64/boot/dts/rockchip/rk3588-linux.dtsi
+++ b/arch/arm64/boot/dts/rockchip/rk3588-linux.dtsi
@@ -12,7 +12,7 @@
chosen: chosen {
-               bootargs = "earlycon=uart8250,mmio32,0xfeb50000 console=ttyFIQ0 irqchip.gicv3_pseudo_nmi=0 root=PARTUUID=614e0000-0000 rw rootwait rcupdate.rcu_expedited=1 rcu_nocbs=all";
+               bootargs = "earlycon=uart8250,mmio32,0xfeb50000 console=ttyFIQ0 irqchip.gicv3_pseudo_nmi=0 root=PARTUUID=614e0000-0000 rw rootwait rcupdate.rcu_expedited=1 rcu_nocbs=all nohlt";
};
3.3 PCIe RC MPS 策略
请参考 《Rockchip_Developer_Guide_PCIe_CN.pdf》文档 “如何配置max payload size ” 章节,可尝试配置为pci=pcie_bus_perf 配置,开启后确认所设定的 MPS 为所有接入的 PCIe 设备都支持的值。
3.4 PCIe 控制器总线 QoS 调节
PCIe 传输尤其是 DMA 传输,当吞吐率提升后会占用 PCIe 控制器到 DRAM 的总线带宽资源,存在和其他 IP 的总线竞争仲裁,如果出现该极端情况,可通过修改 PCIe 控制器总线 QoS 来提高其优先级。调整方法参考本文的附录 “各SoC中PCIe控制器QoS调节寄存器” 部分进行配置。
3.5 PCIe ASPM 调节
PCIe ASPM 功能对传输性能有一定的影响,所以测试时建议关闭 ASPM 功能。实际产品可以在 EP function 驱动中构建测试场景,动态开关 ASPM 支持以保证实时性。
3.6 调整 CPU 策略降低 EP CPU 访问映射地址的抖动
对于存在 PCIe master 与 CPU master 竞争 DRAM 资源的特定场景,可以通过以下配置降低 PCIe 访问的抖动:调整 RC 侧 SOC cache 预取行为,关闭预取调整 RC 侧 SOC write stream 行为,关闭 write stream以上配置在Trust Firmware中修改,需谨慎使用,应确认整体产品是否符合自身要求。
3.7 调整总线策略降低 EP CPU 访问映射地址的抖动
对于 PCIe 抖动行为较为敏感的应用,可以考虑参考本文档附录部分“部分SoC中PCIe相关的DRAM Scheduler aging调节”章节来优化。RK3568 实例:
io -4 -w 0xfe100010 0xff010101 # DDR timing配置,需另沟通,测试时可以先不调
io -4 -w 0xfe10002c 0x1 # aging基数降为1,会影响所有IP
io -4 -w 0xfe100030 0x1 # PCIe所在通道aging系数降为1,基数与系数均为1,为最快响应速度
3.8 关注因PCIe信号异常导致的性能颠簸
查阅《Rockchip_Developer_Guide_PCIe_CN.pdf》文档”内核 稳定性统计信息”章节部分,关注是否有因为PCIe信号问题导致的链路relink或者TLP replay而引入的性能颠簸。如果有相关错包统计较多,应优先解决信号问题之后再进行优化。
4. 限制PCIe总线性能的方法
当PCIe设备进行通信时,如果导致其他实时性要求高的模块受到影响,例如RK3562芯片PCIe模块工作导致VOP闪屏,RK3576芯片PCIe0模块工作导致MIPI CSI录像丢帧,RK3568芯片PCIe模块工作导致GMAC性能波动,RK3588芯片PCIe模块工作导致SATA模块性能下降等等,可以按照以下指南进行逐个测试:参考附录中”各SoC中PCIe控制器QoS调节寄存器”部分,尝试反向降低PCIe接口内存访问的优先级;参考附录中”部分SoC中PCIe控制器shaper调节寄存器”部分,降低PCIe访问粒度来看看是否可以缓解问题。参考附录中”部分SoC中PCIe控制器限制带宽调节寄存器“来限制PCIe的带宽,改善受影响模块以满足产品需求。以上措施均无效果,可以尝试研究是否有配置可以将受影响模块的片内数据访问端口进行迁移,例如已知一些显示模块(vop, vicap等)具备端口迁移的能力。当找到合适的优先级、shaper、带宽配置后,可以在产品板级dts中固化配置参数:
- 查询本文档的附录部分”各SoC中PCIe控制器QoS调节寄存器”章节,获取dtsi中各PCIe控制器所在QoS节点。
- 板级dts引用对应QoS节点,并置入测试可用的优先级和带宽参数,以RK3568 PCIe2x1控制器为例
--- a/arch/arm64/boot/dts/rockchip/rk3568-xxx.dts
+++ b/arch/arm64/boot/dts/rockchip/rk3568-xxx.dts
@@ -2325,16 +2325,25 @@
&qos_pcie2x1{
+       /* 优先级参数 */
+       priority-init = <0x202>;
+       /* 带宽参数 */
+       mode-init = <0x1>;
+       bandwidth-init = <0x100>;
+       saturation-init = <0x100>;
};
- shaper的节点可查询本文档的附录部分”部分SoC中PCIe控制器shaper调节寄存器”章节获取,以RK3562PCIe2x1控制器为例
--- a/arch/arm64/boot/dts/rockchip/rk3562-xxx.dts
+++ b/arch/arm64/boot/dts/rockchip/rk3562-xxx.dts
&shaping_pcie{
+   shaping-init = <0x5>;
};
注意: SoC的dtsi未预留shaping配置节点的平台,无法通过dtsi来固化配置,则请在代码中直接集成寄存器配置。
5. 控制器 - DMA Interface 吞吐率
5.1 理论速率
DMA 传输速率理论上接近 “PCIe TLP 损耗” 计入后的速率,理论值参考 “PCIe TLP 损耗” 章节说明。
5.2 测试方法
5.2.1 标准 EP 测试
测试基于 “标准EP功能件开发” + “内核 DMATEST” 测试:Linux 详细内容参考 《Rockchip_Developer_Guide_PCIe_CN.pdf》相关章节RT-Thread 详细内容参考《Rockchip_Developer_Guide_RT-Thread_PCIe_CN.md》相关章节
5.2.2 其他参数配置
- CPU 和 DDR 定高频
- PCIe RC MPS 策略设置为 pci=pcie_bus_perf
- 为了提高实时性,准确测试 DMA 带宽,使用 PIO 轮询 DMA 完成状态
diff --git a/drivers/pci/controller/dwc/pcie-dw-dmatest.c b/drivers/pci/controller/dwc/pcie-dw-dmatest.c
index 4b0d4d3e01c8..df4595af962e 100644
--- a/drivers/pci/controller/dwc/pcie-dw-dmatest.c
+++ b/drivers/pci/controller/dwc/pcie-dw-dmatest.c
@@ -231,7 +231,7 @@ struct dma_trx_obj *pcie_dw_dmatest_register(struct device *dev, bool irq_en)
        }

        /* Enable IRQ transfer as default */
-       dmatest_dev->irq_en = irq_en;
+       dmatest_dev->irq_en = false;
        cur_dmatest_dev++;

        return obj;
5.3 测试结果
5.3.1 RK3568 - 标准 EP 测试
测试设备RC:RK3568-EVB1-DDR4-V10 PCIe 3.0 2 lanes ARM:1.99G DDR:1.5GEP:RK3568-IOTEST-DDR3-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR:1.0G测试结果
| DMA 大小 | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| 写 | 12.2MB/s | 51.7MB/s | 529.1MB/s | 941.6MB/s | 1418.2MB/s | 1454.3MB/s |
| 读 | 6.0MB/s | 44.3MB/s | 442.3MB/s | 680.5MB/s | 938.9MB/s | 1080.2MB/s |
5.3.2 RK3588 - 标准 EP 测试
测试设备RC:RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8GEP:RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G测试结果
| DMA 大小 | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| 写 | 14.7MB/S | 60.9MB/S | 660.6MB/S | 2313.4MB/S | 3026.1MB/S | 3066.1MB/s |
| 读 | 13.9MB/S | 52.6MB/S | 568.7MB/S | 1490.5MB/S | 1619.8MB/S | 1660.6MB/s |
5.3.3 RK3588 Gen2x1 - 标准 EP 测试
测试设备RC:RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8GEP:RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes(降为 Gen2 1 lanes) 大核 2.4G 小核 1.8G测试结果
| DMA 大小 | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| 写 | 3.8MB/S | 14.6MB/S | 152.7MB/S | 362.6MB/S | 419.5MB/S | 427.1MB/s |
| 读 | 3.8MB/S | 14.7MB/S | 146.8MB/S | 360.5MB/S | 419.2MB/S | 427.3MB/s |
说明:
该测试仅用作测试,理论上 RK3588 PCIe3x4 控制器 DMA 能力以 “RK3588 - 标准 EP 测试” 章节为准
5.3.4 RK1820 Gen2x1 - 标准 EP 测试
测试设备RC:RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8GEP:RK1820-EVB1-V10 PCIe 2.0 1 lanesRK1820 SRAM 内存测试结果
| DMA 大小 | 64B | 256B | 4K | 64KB | 128KB | 512KB |
|---|---|---|---|---|---|---|
| 写 | 10MB/S | 42MB/S | 256MB/S | 400MB/S | 422MB/s | 422MB/s |
| 读 | 8MB/S | 36MB/S | 192MB/S | 310MB/S | 325MB/s | 330MB/s |
说明:该测试仅用作测试,仅与传输带宽相关,应结合实际业务如 chips_connect 驱动进一步测试RK1820 DRAM 内存测试结果
| DMA 大小 | 64B | 256B | 4K | 64KB | 128KB | 512KB |
|---|---|---|---|---|---|---|
| 写 | 10MB/S | 42MB/S | 256MB/S | 401MB/S | 402MB/s | 410MB/s |
| 读 | 8MB/S | 36MB/S | 193MB/S | 314MB/S | 320MB/s | 323MB/s |
说明:该测试仅用作测试,仅与传输带宽相关,应结合实际业务如 chips_connect 驱动进一步测试
6. 控制器 - Bar Interface 吞吐率
6.1 简介
通常用戶最常用的 Bar 访问行为为 Load/Store 32bits 指令,所以该指标以”用戶态 Load/Store 32bits 指令”为测试方案,通过 Linux 提供的 PCIe sysfs 的 pci_mmap_resource 接口做读写测试。
6.2 测试 APP
详细参考附录 “resource_mmap_test.c” 源码,要求确认源码内以下参数:选择 device memory 属性的 mmap Resource,例如:resource2
APP 编译方式参考,以 RK3588 Android 为例:
/home1/ldq/rk-linux/prebuilts/gcc/linux-x86/aarch64/gcc-arm-10.2-2020.11-x86_64-aarch64-none-linux-gnu/bin/aarch64-none-linux-gnu-gcc -mcpu=cortex-a76 -O0 -static -DROPT -o resource_mmap_test resource_mmap_test.c
说明:要求使用 -O0 编译优化等级以避免读写命令被优化
6.3 测试结果
| RC | EP | Store 32bits |
Load 32bits |
|---|---|---|---|
| RK3568 PCIe 3.0 2 lanes |
RK3588 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G |
52.5MB/s | 3.7MB/s |
| RK3568 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G |
36.0MB/s | 2.4MB/s |
| RK3588 PCIe 3.0 4 lanes |
RK3588 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G |
53.3MB/s | 4.2MB/s |
| RK3588 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G |
26.7MB/s | 2.6MB/s |
| RK3528 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G |
67.7MB/s | 2.3MB/s |
| RK3562 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G |
66.3MB/s | 2.3MB/s |
| RK3572 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G |
67.7MB/s | 2.4MB/s |
说明:64bits-pref (resource0..N) 与 32bits-np (resource0..N) 测试结果一致
6.4 性能优化方向
6.4.1 提高数据位宽
简介PCIe Bar 读写速率的瓶颈主要在于 PCIe TLP 数量,而提高 TLP 有效数据负载能降低 TLP 数量,也就是提高总线的Load/Store 请求的数据位宽能减少总的 TLP 数量,常⻅有以下几种用戶访问 PCIe Bar 的行为:
用戶态 Load/Store 数据位宽 32bits,实际以汇编结果为准,例如:
str w1, [x0]
用戶态 Load/Store SIMD 数据位宽 128bits通常为编译器优化后的行为,例如支持 SIMD 的 SOC 选用 -O3 编译优化选项就可能实现,实际以汇编结果为准,例如:
str q1, [x1], #16
内核态 Load/Store 数据位宽 32bits内核态 memset_io/memcpy_fromio 接口测试结果以 RK3588 为例:
| 访问行为 | Store(MB/s) | Load(MB/s) |
|---|---|---|
| 用戶态 Load/Store 32bits | 53 | 4 |
| 用戶态 Load/Store SIMD 128bits | 203 | 16 |
| 内核态 Load/Store 32bits | 53 | 4 |
| 内核态 memset_io/memcpy_fromio | 106 | 7 |
说明:测试环境:RC:RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8GEP:RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes 大核 2.4G 小核 1.8G用戶态 Load/Store 32bits 访问行为,汇编 V8-a 指令参考:
LDR <Wt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
STR <Wt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
用戶态 Load/Store SIMD 128bit 访问行为,汇编 V8-a 指令参考:
LDR <Qt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
STR <Qt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
内核态 Load/Store 32bits
6.4.2 多线程-无效
多个 resource_mmap_test.c 同时运行,读写不同 Bar,通过逻辑分析仪确认,总线利用率没有提高。对于实际带宽没有显著提升(不超过 10%),带宽利用率也没有提升,但是确实看到 TLP 不同 Bar 空间交替的情况。
7. 控制器 - 中断响应速率-ELBI
7.1 简介
DWC PCIe EP 模式下的 ELBI(Endpoint Local Interrupt Bypass)通过EP(Endpoint)的配置空间映射来实现。RC通过写 EP 的配置空间中的 ELBI 映射寄存器来触发 EP 的 ELBI 中断,从而提高 EP 系统的响应性。ELBI 中断响应速率主要取决于 EP 系统总线带宽、设备驱动程序的优化程度以及处理器的处理能力等因素。
7.2 测试 APP
PCIe ELBI RC 端发包代码
#include <linux/kthread.h>

// 创建⼀个新的内核线程来触发ELBI中断
static int pcie_rkep_elbi_test_real(void *p)
{
    struct pcie_rkep *pcie_rkep = (struct pcie_rkep *)p;

    // 在⼀个⽆限循环中,调⽤rockchip_pcie_raise_elbi_irq函数触发ELBI中断(使⽤IRQ号0)
    while(1)
        rockchip_pcie_raise_elbi_irq(pcie_rkep, 0);
}

// 使⽤pcie_rkep_elbi_test_real函数创建⼀个内核线程来触发ELBI中断
static int pcie_rkep_elbi_test(struct pcie_rkep *pcie_rkep)
{
    struct task_struct *tsk;

    // 使⽤pcie_rkep_test函数执⾏⼀些测试操作
    pcie_rkep_test(pcie_rkep);

    // 创建⼀个名为"rkep-elbi"的内核线程,并将pcie_rkep作为参数传递给pcie_rkep_elbi_test_real函数
    tsk = kthread_run(pcie_rkep_elbi_test_real, pcie_rkep, "rkep-elbi");
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }
    return 0;
}
PCIe ELBI RC 端发包代码集成
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
PCIe ELBI EP 端测速代码
#include <linux/kthread.h>

// 创建⼀个新的内核线程来测量ELBI中断的触发频率
static int pcie_rkep_elbi_test_real(void *p)
{
    struct rockchip_pcie *rockchip = (struct rockchip_pcie *)p;
    int cur_count, last_count = rockchip->elbi_count;
    u64 us = 0;

    // 在⼀个⽆限循环中,每隔1秒执⾏以下操作
    while(1) {
        msleep(1000); // 等待1秒

        // 获取当前的ELBI中断计数
        cur_count = rockchip->elbi_count;

        // 如果当前中断计数不为0,则计算上⼀次和当前的中断计数之间的时间间隔(单位:微秒)
        if (cur_count) {
            us = 1000000 / (cur_count - last_count);
        }

        // 打印当前的ELBI中断计数和触发频率
        pr_err("elbi count=%d %lluus\n", cur_count, us);

        // 更新上⼀次的中断计数
        last_count = rockchip->elbi_count;
    }
}

// 使⽤pcie_rkep_elbi_test_real函数创建⼀个内核线程来测量ELBI中断的触发频率
static __maybe_unused int pcie_rkep_elbi_test(struct rockchip_pcie *rockchip)
{
    struct task_struct *tsk;

    // 创建⼀个名为"rkep-elbi"的内核线程,并将rockchip作为参数传递给pcie_rkep_elbi_test_real函数
    tsk = kthread_run(pcie_rkep_elbi_test_real, rockchip, "rkep-elbi");
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
PCIe ELBI EP 端测速代码集成
 static int rockchip_pcie_ep_probe(struct platform_device *pdev)
 {
        struct device *dev = &pdev->dev;
@@ -1276,6 +1316,7 @@ static int rockchip_pcie_ep_probe(struct platform_device *pdev)
                goto deinit_phy;

        rockchip_pcie_add_misc(rockchip);
+       pcie_rkep_elbi_test(rockchip);

        return 0;
7.3 测试结果
| RC | EP | 默认延迟 (us) |
|---|---|---|
| RK3568-EVB1-DDR4-V10 PCIe 3.0 2 lanes ARM:1.99G DDR:1.5G |
RK3568-IOTEST-DDR3-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR:1.0G |
6 |
| RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes 大 核 2.4G 小核 1.8G |
RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes 大 核 2.4G 小核 1.8G |
6 |
说明:请注意,具体的实现和应用场景可能会因系统配置、硬件平台和驱动要求而有所不同。
7.4 性能优化方向
ELBI 中断响应速率主要取决于 EP 系统总线带宽、设备驱动程序的优化程度以及处理器的处理能力等因素。以 RK3588 为例:
| 型号 | 默认延迟 (us) |
寄存器读写速率 (us/s) |
关闭CPU_SLEEP模式延迟 (us) |
CPU定频最高频率延迟 (us) |
|---|---|---|---|---|
| RK3588 | 6 | 2 | 6 | 4 |
说明:寄存器读写速率:调用 ELBI write config 接口的极限速率,即 RC 发起 ELBI 请求的最高速率,但实际由于 EP的中断调度响应时间得到的响应速率会低于此结果
8. 控制器 - 中断响应速率-MSI
8.1 简介
MSI (Message Signaled Interrupt) 是 PCIe 中断传输机制的一种类型。MSI 通过在特定的消息地址上发送中断消息来触发中断。每个设备可以拥有多个消息地址,并且每个地址可以对应一个中断。这样就实现了并行处理中断请求,大大提高了响应速率和系统性能。MSI 中断响应速率取决于 RC 系统总线带宽、设备驱动程序的优化程度以及处理器的处理能力等因素。一般来说,采用 MSI 中断机制的系统可以显著降低中断延迟,并且在高负载情况下仍能保持较好的响应速率。
8.2 测试 APP
PCIe MSI EP 端发包代码
#include <linux/kthread.h>

// PCIe MSI RC端和EP端⽰例代码

static int pcie_rkep_elbi_test_real(void *p)
{
    struct rockchip_pcie *rockchip = (struct rockchip_pcie *)p;

    // EP端循环发送MSI中断到RC端
    while(1) {
        rockchip_pcie_raise_msi_irq(rockchip, 0);
    }
}

static int pcie_rkep_elbi_test(struct rockchip_pcie *rockchip)
{
    struct task_struct *tsk;

    // 创建内核线程来执⾏pcie_rkep_elbi_test_real函数
    tsk = kthread_run(pcie_rkep_elbi_test_real, rockchip, "rkep-elbi");
    // 检查线程创建是否成功
    if (IS_ERR(tsk)) {
        pr_err("Failed to start rkep elbi thread\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
PCIe MSI EP 端发包代码集成
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
PCIe MSI RC 端测速代码
#include <linux/kthread.h>

static int pcie_rkep_elbi_test_real(void *p)
{
    struct pcie_rkep *pcie_rkep = (struct pcie_rkep *)p;
    int cur_count, last_count = pcie_rkep->msi_count;
    u64 us = 0;

    // 在⼀个⽆限循环中执⾏,每秒打印⼀次当前的msi_count值和两次打印之间的时间间隔
    while(1) {
        msleep(1000);
        cur_count = pcie_rkep->msi_count;
        if (cur_count) {
            us = 1000000 / (cur_count - last_count); // 计算时间间隔(微秒)
        }
        pr_err("msi count=%d %lluus\n", cur_count, us); // 打印msi_count和时间间隔
        last_count = pcie_rkep->msi_count;
    }

    return 0;
}

static __maybe_unused int pcie_rkep_elbi_test(struct pcie_rkep *pcie_rkep)
{
    struct task_struct *tsk;
    tsk = kthread_run(pcie_rkep_elbi_test_real, pcie_rkep, "rkep-elbi"); // 创建内核线程来执⾏pcie_rkep_elbi_test_real函数
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
PCIe MSI RC 端测速代码调用处参考
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
8.3 测试结果
| RC | EP | 默认延迟 (us) |
|---|---|---|
| RK3568-EVB1-DDR4-V10 PCIe 3.0 2 lanes ARM:1.99G DDR:1.5G |
RK3568-IOTEST-DDR3-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR:1.0G |
2 |
| RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes 大 核 2.4G 小核 1.8G |
RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes 大 核 2.4G 小核 1.8G |
2 |
说明:请注意,具体的实现和应用场景可能会因系统配置、硬件平台和驱动要求而有所不同。
8.4 性能优化方向
MSI 速率的优化方向同 ELBI 中断优化方向一致,详细参考 “控制器 - 中断响应速率-ELBI” 章节。
9. 控制器 - 外设 CPU 访问映射地址响应速率
9.1 简介
PCIe 支持从 RC 侧通过 Bar Interface 发起 CPU 访问行为来读写外设数据,也支持从 EP 侧通过映射地址发起 CPU 访问行为来读写 RC 侧数据。
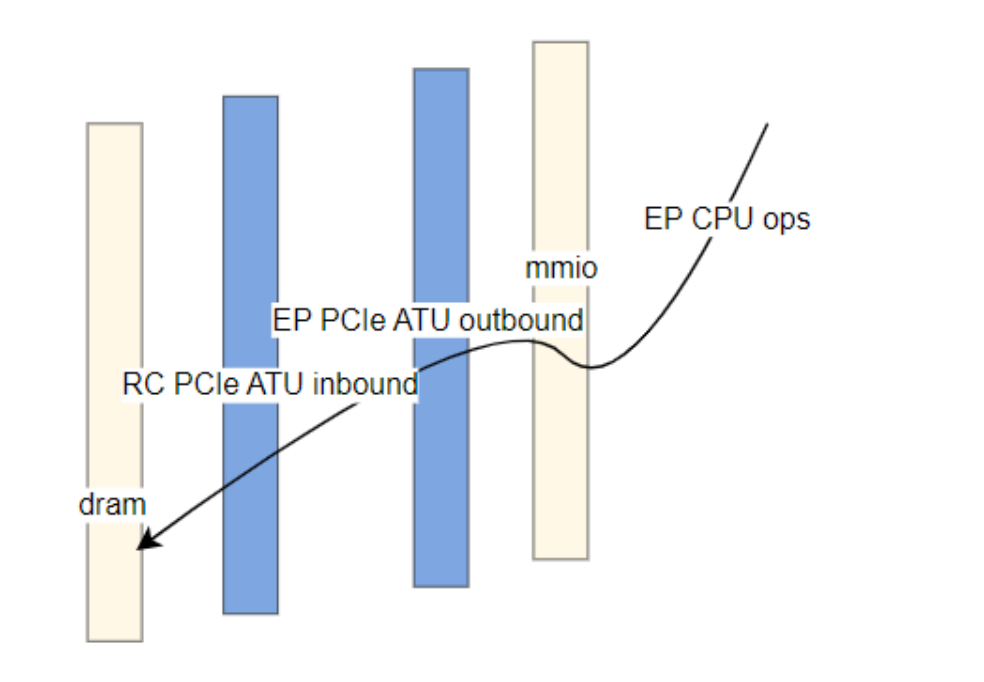
中文原图 — 23
9.2 测试 APP
测试简介RK3588 EP 设定 outbound,使用 CPU 访问 outbound 地址,完成先写后读的一次循环,循环 10000 次。测试命令RC:设置 CPU/DRAM 定高频,默认不添加其余负载,根据自身产品场景添加对应负载EP:u-boot 下进行的 test_memory,EP 测试命令参考:
#define TEST_ITERATIONS 3000000

#define TEST_RECORD_LENGTH 256
static uint32_t record[TEST_RECORD_LENGTH];
static volatile uint32_t value;
static uint32_t max_duration;
static uint32_t total_duration;
static uint32_t loops;

void test_memory(volatile uint32_t *address) {
    ulong duration;
    int i;

    printf("Memory write-read test starting...\n");

    for (i = 0; i < TEST_ITERATIONS; i++) {
        // 获取开始时间
        duration = get_ticks();

        // 写⼊内存
        *address = 0x12345678;

        // 读取内存
        value = *address;

        // 获取结束时间
        duration = get_ticks() - duration;

        // 更新最⼤耗时
        if (duration > max_duration) {
            max_duration = duration;
        }

        // 累加总耗时
        total_duration += duration;
        //printf("Iteration %d: %lu ticks\n", i + 1, duration);
        record[duration]++;
    }

    // 计算平均耗时
    uint32_t average_duration = total_duration / (loops * TEST_ITERATIONS);

    printf("Maximum duration: %u ticks %lu us\n", max_duration, max_duration / (gd->arch.timer_rate_hz / 1000000));
    printf("Average duration: %u ticks %lu us\n", average_duration, average_duration / (gd->arch.timer_rate_hz / 1000000));
    printf("ticks - count (24tick/1us)\n");
    for (i = 0; i < TEST_RECORD_LENGTH; i++) {
        if (record[i])
            printf("%d - %d\n", i, record[i]);
    }
}

static int main(void)
{
        printf("mmio mem\n");
        memset(record, 0, 4 * TEST_RECORD_LENGTH);
        max_duration = 0;
        total_duration = 0;
        for (loops = 1; loops < 1000; loops++) {
            test_memory((volatile u32 *)(0xf0000000));
        }
    }
}
9.3 测试结果
9.3.1 RK3566 Gen2x1
基础环境设备RC: RK_EVB_3566_LP4X_V10 default PCIe Gen2x1 mps 128BEP: RK3588 EVB1 PCIe Gen3x4测试结果
| 简介 | avg(us) | max(us) |
|---|---|---|
| 基础测试 | 1.7 | 2.3 |
| DRAM 负载测试 | 1.9 | 7.9 |
说明:RC 无 DRAM 负载,EP CPU 访问 PCIe 映射空间抖动较小RC 有 DRAM 负载,EP CPU 访问 PCIe 映射空间抖动较大,通常此类问题优化方向为:参考 “调整 CPU 策略降低 EP CPU 访问映射地址的抖动” 章节说明参考 “调整总线策略降低 EP CPU 访问映射地址的抖动” 章节说明RC DRAM 负载测试为 Bit Flip、Rerverd Mem 测试
10. 外设 - NVME 吞吐率
10.1 测试方法
10.1.1 fio 模拟 crystalmark
| 测试项目 | 子 项 |
测试命令 | 单位 |
|---|---|---|---|
| SEQ1M Q32T1 READ |
adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=read -ioengine=libaio -bs=1024K -size=10G -numjobs=1 -runtime=180 -group_reporting -name=read_seq_1024k_q32_t1 | MB/s | |
| SEQ1M Q32T1 WRITE |
adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=write -ioengine=libaio -bs=1024K -size=10G -numjobs=1 -runtime=180 -group_reporting -name=write_seq_1024k_q32_t1 | MB/s | |
| RND4K Q32T1 READ |
吞吐率 | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=randread -ioengine=libaio -bs=4K -size=4G -numjobs=1 -runtime=180 -group_reporting -name=read_rand_4k_q32_t1 | MB/s K(IOPS) |
| RND4K Q32T1 WRITE |
吞吐率 | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=randwrite -ioengine=libaio -bs=4K -size=4G -numjobs=1 -runtime=180 -group_reporting -name=write_rand_4k_q32_t1 | MB/s K(IOPS) |
说明:如果测试环境未安装 libaio,可以使用 psync 替代psync 使用同步方式,多线程模拟同时批量给内核提交 IO 请求libaio 采用 Kernel Native AIO,可以单次批量向内核提交 IO 请求,相较于 psync,开销更小,性能更好,更适合评估 NVMe 性能在线制作 ext4,以 linux 系统为例:
mkfs.ext4 /dev/nvme0n1
mount -t ext4 /dev/nvme0n1 /mnt
在线制作 f2fs,以 Android 系统为例:
make_f2fs /dev/block/nvme0n1
mount -t f2fs -o fsync_mode=nobarrier /dev/block/nvme0n1 /mnt
10.2 测试结果
10.2.1 RK3568 Gen3x2
主机简介RK3568 EVB1 pcie3x2主控Gen3x2 PCIe 传输速率瓶颈主要在 PCIe 控制器,所以测试设备 CPU/DDR 等参数使用默认配置外设三星980 M.2 NVMe SSD 1TBPCIe Gen3x4fio 模拟 crystalmark 8.0.1 测试结果
| APP 测试名 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1510 | \ |
| SEQ1M Q32T1 WRITE | 1488 | \ |
| RND4K Q32T1 READ | 152 | 40 |
| RND4K Q32T1 WRITE | 145 | 37 |
10.2.2 RK3588 Gen3x4
主机简介RK3588 EVB1 pcie3x4 主控 Port0/1 x4 RC定频大核 2.4G 小核 1.8G、mq-deadline、f2fs nobarrier、LPDDR4X, 2112MHz外设三星980 M.2 NVMe SSD 1TBPCIe Gen3x4PC CrystalDiskMark 测试结果:
| PC crystalmark 8.0.1 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 3222 | \ |
| SEQ1M Q32T1 WRITE | 2600 | \ |
| RND4K Q32T1 READ | 708 | \ |
| RND4K Q32T1 WRITE | 486 | \ |
fio 模拟 crystalmark 8.0.1测试结果
| APP 测试名 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 3219.2 | \ |
| SEQ1M Q32T1 WRITE | 3108.7 | \ |
| RND4K Q32T1 READ | 794 | 203 |
| RND4K Q32T1 WRITE | 647 | 165 |
10.2.3 RK3588 Gen3x2
主机简介RK3588 EVB1 pcie3x4 主控 Port0 x2 RC定频大核 2.4G 小核 1.8G、mq-deadline、f2fs nobarrier、LPDDR4X, 2112MHz
外设PHISON 128G BGA SSDPC CrystalDiskMark 测试结果:
| crystalmark 8.0.1 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1615 | \ |
| RND4K Q32T1 READ | 434 | \ |
| SEQ1M Q32T1 WRITE | 626 | \ |
| RND4K Q32T1 WRITE | 230 | \ |
fio 模拟 crystalmark 8.0.1 测试结果
| APP 测试名 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1572.4 | \ |
| SEQ1M Q32T1 WRITE | 600 | \ |
| RND4K Q32T1 READ | 422 | 101 |
| RND4K Q32T1 WRITE | 355 | 90 |
10.2.4 RK3588s Gen2x1
主机简介RK3588s EVB1 pcie2x1l1主控 Port0 x1 RC定频大核 2.4G 小核 1.8G、mq-deadline、f2fs nobarrier、LPDDR4X, 2112MHz外设PHISON 128G BGA SSD。fio 模拟 crystalmark 8.0.1 测试结果
| APP 测试名 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 407 | \ |
| SEQ1M Q32T1 WRITE | 350 | \ |
| RND4K Q32T1 READ | 400 | 102 |
| RND4K Q32T1 WRITE | 134 | 32 |
10.2.5 RK3528 Gen2x1
主机简介RK3528 EVB2 pcie2x1主控Gen2x1 PCIe 传输速率瓶颈完全在 PCIe 控制器,所以测试设备 CPU/DDR 等参数使用默认配置外设三星980 M.2 NVMe SSD 1TBPCIe Gen3x4fio 模拟 crystalmark 8.0.1 测试结果
| APP 测试名 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 410 | \ |
| SEQ1M Q32T1 WRITE | 392 | \ |
| RND4K Q32T1 READ | 327 | 83 |
| RND4K Q32T1 WRITE | 300 | 76 |
10.2.6 RK3562 Gen2x1
主机简介RK3562 EVB1 pcie2x1主控Gen2x1 PCIe 传输速率瓶颈完全在 PCIe 控制器,所以测试设备 CPU/DDR 等参数使用默认配置外设三星980 M.2 NVMe SSD 1TBPCIe Gen3x4fio 模拟 crystalmark 8.0.1 测试结果
| APP 测试名 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 409 | \ |
| SEQ1M Q32T1 WRITE | 391 | \ |
| RND4K Q32T1 READ | 343 | 85 |
| RND4K Q32T1 WRITE | 253 | 63 |
10.2.7 RK3576 Gen2x1
主机简介RK3576 EVB1 pcie2x1主控Gen2x1 PCIe 传输速率瓶颈完全在 PCIe 控制器,所以测试设备 CPU/DDR 等参数使用默认配置外设三星980 M.2 NVMe SSD 1TBPCIe Gen3x4fio 模拟 crystalmark 8.0.1 测试结果
| APP 测试名 | 传输速率MB/s | IOPS(K) |
|---|---|---|
| SEQ1M Q32T1 READ | 397 | \ |
| SEQ1M Q32T1 WRITE | 391 | \ |
| RND4K Q32T1 READ | 313 | 78 |
| RND4K Q32T1 WRITE | 255 | 63 |
11. 附录
11.1 各SoC中PCIe控制器QoS调节寄存器
下表中的寄存器命令范例为配置成所允许的最高优先级,实际请根据测试情况酌情调整
| 芯片 | 控制器 | 寄存器命令 | dtsi中节点 |
|---|---|---|---|
| RK1808 | pcie0 | io -4 0xfe880008 0x303 | qos_pcie |
| RK3528 | pcie2x1 | io -4 0xff280188 0x404 | qos_pcie |
| RK3562 | pcie2x1 | io -4 0xfeea0008 0x404 | qos_pcie |
| RK3566 RK3568 |
pcie2x1 | io -4 0xfe190008 0x80000303 | qos_pcie2x1 |
| RK3566 RK3568 |
pcie3x1 | io -4 0xfe190088 0x80000303 | qos_pcie3x1 |
| RK3566 RK3568 |
pcie3x2 | io -4 0xfe190108 0x80000303 | qos_pcie3x2 |
| RK3576 | pcie0 | io -4 0x27f0a008 0x303 | qos_mmu0 |
| RK3576 | pcie1 | io -4 0x27f0a088 0x303 | qos_mmu1 |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a008 0x404 | qos_gic600_m0 |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a208 0x404 | qos_gic600_m1 |
11.2 部分SoC中PCIe控制器shaper调节寄存器
下表罗列了当前有shaper调节寄存器的芯片,其命令范例为配置成所允许的最大访问粒度(即0xff),允许可配置数值从0x1到0xff,数值越小粒度越细,实际请根据测试情况酌情调整
| 芯片 | 控制器 | 寄存器命令 | dtsi中shaping节点 |
|---|---|---|---|
| RK3562 | pcie2x1 | io -4 0xfeea0088 0xff | shaping_pcie |
| RK3576 | pcie0 | io -4 0x27f0a108 0xff | 无 |
| RK3576 | pcie1 | io -4 0x27f0a188 0xff | 无 |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a088 0xff | 无 |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a288 0xff | 无 |
11.3 部分SoC中PCIe控制器限制带宽调节寄存器
value允许配置的数值范围从0到0x1ff, 数值越小表示将PCIe带宽限制得越低。
| 芯片 | 控制器 | 寄存器命令 |
|---|---|---|
| RK3562 | pcie2x1 | io -4 0xfeea000c 0x1 io -4 0xfeea0010 value io -4 0xfeea0014 value |
| RK3566 RK3568 |
pcie2x1 | io -4 0xfe19000c 0x1 io -4 0xfe190010 value io -4 0xfe190014 value |
| RK3566 RK3568 |
pcie3x1 | io -4 0xfe19008c 0x1 io -4 0xfe190090 value io -4 0xfe190094 value |
| RK3566 RK3568 |
pcie3x2 | io -4 0xfe19010c 0x1 io -4 0xfe190110 value io -4 0xfe190114 value |
| RK3576 | pcie0 | io -4 0x27f0a00c 0x1 io -4 0x27f0a010 value io -4 0x27f0a014 value |
| RK3576 | pcie1 | io -4 0x27f0a08c 0x1 io -4 0x27f0a090 value io -4 0x27f0a094 value |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a00c 0x1 io -4 0xfdf3a010 value io -4 0xfdf3a014 value |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a20c 0x1 io -4 0xfdf3a210 value io -4 0xfdf3a214 value |
11.4 部分SoC中PCIe相关的DRAM Scheduler aging调节
| 芯片 | 控制器 | 寄存器命令 | 备注 |
|---|---|---|---|
| RK3568 | PCIe2x1/PCIe3x2/PCIe3x1 | io -4 0xfe10002c 0x1 io -4 0xfe100030 0x1 |
pipe to DDR的aging0需要调节 |
| RK3588(S) | PCIe1L0/1/2 | io -4 0xfe00002c 0x1 io -4 0xfe00003c 0x1 io -4 0xfe00202c 0x1 io -4 0xfe00203c 0x1 io -4 0xfe00402c 0x1 io -4 0xfe00403c 0x1 io -4 0xfe00602c 0x1 io -4 0xfe00603c 0x1 |
四个channel的port3(aging3)都需要 调节 |
| RK3588(S) | PCIe3x4 PCIe3x2 | io -4 0xfe00002c 0x1 io -4 0xfe000038 0x1 io -4 0xfe00202c 0x1 io -4 0xfe002038 0x1 io -4 0xfe00402c 0x1 io -4 0xfe004038 0x1 io -4 0xfe00602c 0x1 io -4 0xfe006038 0x1 |
四个channel的port2(aging2)都需要 调节 |