
Источник: RK-KF-YF-460 V2.9.0, чипы с PCIe и Linux 4.4 или новее. Это справочник платформы: проверьте SoC платы ArmSoM, разводку PCIe, SDK/BSP, ядро и периферию. Все таблицы производительности относятся к испытаниям EVB производителя, а не ArmSoM. Китайская версия использует китайские рисунки, остальные — английские. Примеры регистров, прошивки, питания и форматирования требуют резервной копии и проверки на тестовом оборудовании с фактическим BSP.
1. Общие сведения
1.1 Введение
Документ описывает показатели производительности приложений RK PCIe и способы их измерения. Цель испытаний — получать соответствующие показатели через простые, точные и управляемые прикладные интерфейсы. Раздел «Общие сведения» содержит необходимые сведения для испытаний, раздел о скоростях передачи — теоретические расчёты PCIe, а остальные разделы — конкретные показатели и методы измерения.
1.2 PCIe sysfs
Linux PCIe поддерживает интерфейс sysfs, предоставляющий главным образом следующие ресурсы:
/sys/devices/pci0000:17
|-- 0000:17:00.0
|   |-- class
|   |-- config
|   |-- device
|   |-- enable
|   |-- irq
|   |-- local_cpus
|   |-- remove
|   |-- resource
|   |-- resource0
|   |-- resource1
|   |-- resource2
|   |-- resource2_wc        # 64bits-pref mem resource and supports write combining, which has an optimization effect on PCIe mem to dev operations.
|   |-- revision
|   |-- rom
|   |-- subsystem_device
|   |-- subsystem_vendor
|   `-- vendor
`-- ...
Подробные сведения:
2. Скорости передачи
2.1 Пропускная способность PCIe
| Поколение PCIe | Кодирование | Скорость передачи | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|---|---|
| 1.0 | 8b/10b | 2.5GT/s | 250MB/s | 500MB/s | 1GB/s | 2GB/s |
| 2.0 | 8b/10b | 5GT/s | 500MB/s | 1GB/s | 2GB/s | 4GB/s |
| 3.0 | 128b/130b | 8GT/s | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
| 4.0 | 128b/130b | 16GT/s | 1.969GB/s | 3.938GB/s | 7.877GB/s | 15.754GB/s |
Скорость передачи выражается в GT/s, а не в битах в секунду Gbps: она включает служебные биты, не увеличивающие полезную пропускную способность. Например, кодирование 8b/10b в PCIe 1.x/2.x занимает 20% (2/10) полосы канала. Источник определяет GT/s как Giga transaction per second, число транзакций в секунду, а Gbps как Giga Bits Per Second, и утверждает отсутствие пропорционального пересчёта. Доступная полоса: Throughput = Transfer Rate * Encoding Scheme. Пример источника для PCIe 2.0 содержит запись «58 / 10 = 4 Gbps = 500 MB/s», а для x8 — «48 = 32 Gbps = 4 GB/s». Эти написания сохранены как неоднозначность оригинала.
2.2 Накладные расходы TLP
После прохождения уровней транзакций и канала к данным добавляется служебная информация: заголовки, окончания пакетов (LCRC, ECRC и т. д.), номера пакетов канального уровня. Поэтому фактическая скорость полезной нагрузки ниже пропускной способности.
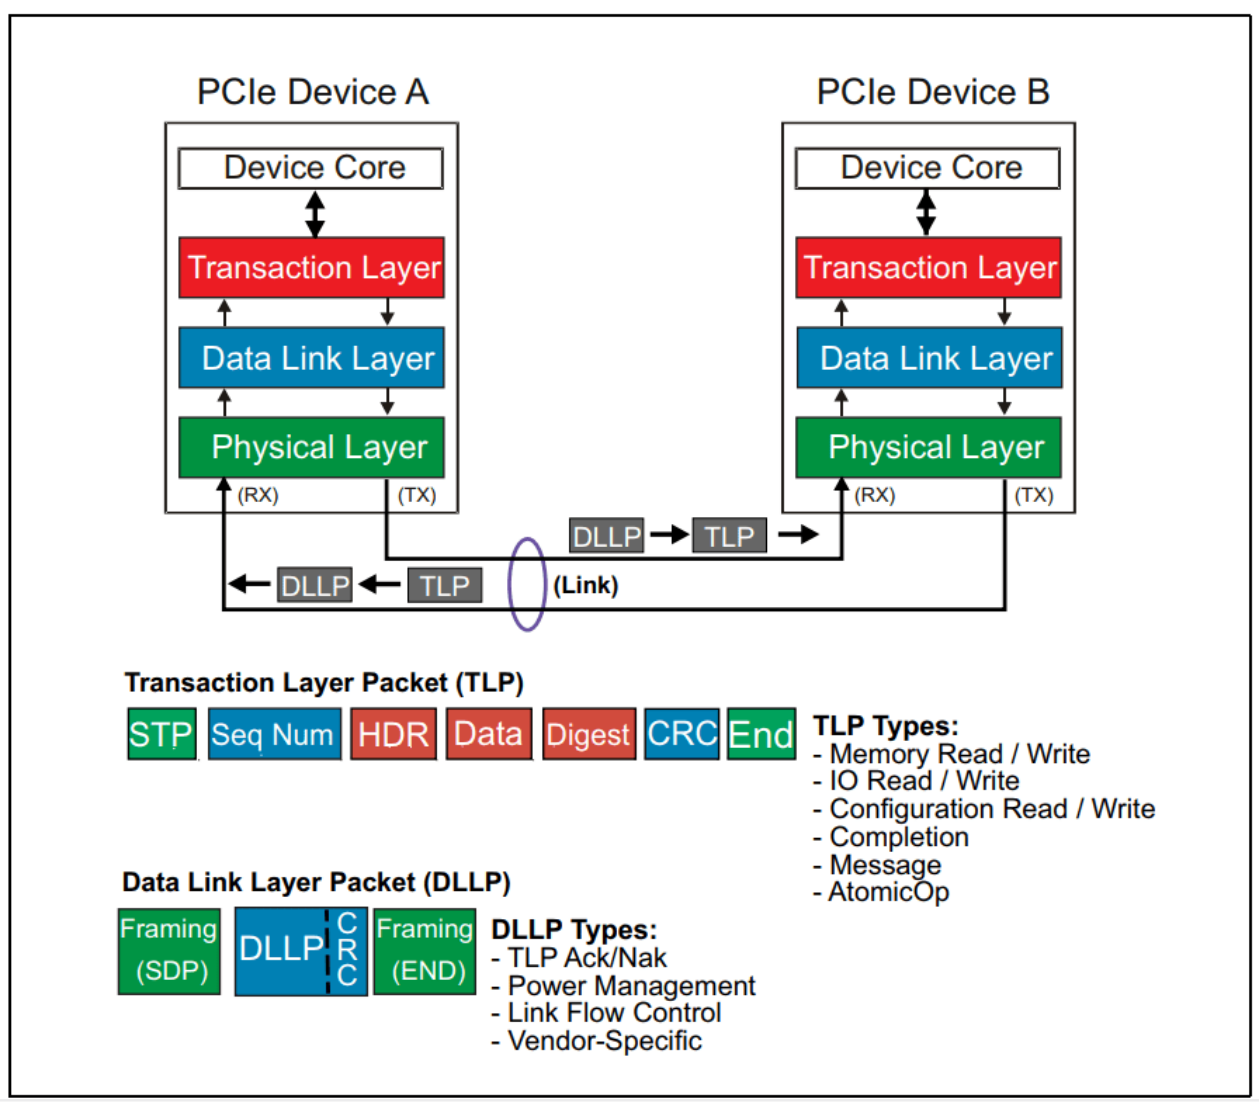
Английский оригинал — 8
Максимальные накладные расходы TLP в 28 байт включают заголовок (16 байт), необязательную ECRC (4 байта), LCRC (4 байта), порядковый номер (2 байта) и символы кадрирования STP и END (2 байта). Рассмотрим пропускную способность PCIe Gen3:
| Поколение PCIe | Кодирование | Скорость передачи | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|---|---|
| 3.0 | 128b/130b | 8GT/s | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
После учёта накладных расходов TLP:
| Поколение PCIe Gen3 | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|
| Полоса PCIe (без расходов TLP) | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
| 256B нагрузка после расходов TLP (256/284) | 887.5MB/s | 1.775GB/s | 3.550GB/s | 7.1002GB/s |
| 128B нагрузка после расходов TLP (128/156) | 807.8MB/s | 1.616GB/s | 3.232GB/s | 6.464GB/s |
2.3 Скорости в сценариях применения PCIe
Если дополнительно учитывать DLLP для Ack/Nak и управления потоком, а также Ordered Sets для обучения линии и Skip, фактическая скорость передачи ещё ниже. В конкретных сценариях оптимальным решением считается передача eDMA.
3. Общие направления оптимизации
3.1 Максимальные частоты CPU и DDR
Для настройки обратитесь к исходному коду DVFS и DRAM.
3.2 Отключение простоя CPU
Пример для платформы RK3588:
/* dtsi disable cpu-sleep */
--- a/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
+++ b/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
@@ -585,6 +585,7 @@
idle-states {
    entry-method = "psci";
    CPU_SLEEP: cpu-sleep {
        compatible = "arm,idle-state";
        local-timer-stop;
        arm,psci-suspend-param = <0x0010000>;
        entry-latency-us = <100>;
        exit-latency-us = <120>;
        min-residency-us = <1000>;
+       status = "disabled";
    };
};

/* cmdline disable ARM's default wfi, for Android platform, please modify rk3588-android.dtsi */
--- a/arch/arm64/boot/dts/rockchip/rk3588-linux.dtsi
+++ b/arch/arm64/boot/dts/rockchip/rk3588-linux.dtsi
@@ -12,7 +12,7 @@
chosen: chosen {
-               bootargs = "earlycon=uart8250,mmio32,0xfeb50000 console=ttyFIQ0 irqchip.gicv3_pseudo_nmi=0 root=PARTUUID=614e0000-0000 rw rootwait rcupdate.rcu_expedited=1 rcu_nocbs=all";
+               bootargs = "earlycon=uart8250,mmio32,0xfeb50000 console=ttyFIQ0 irqchip.gicv3_pseudo_nmi=0 root=PARTUUID=614e0000-0000 rw rootwait rcupdate.rcu_expedited=1 rcu_nocbs=all nohlt";
};
3.3 Политика MPS PCIe RC
См. раздел о настройке Max Payload Size в Rockchip_Developer_Guide_PCIe_CN.pdf. Можно попробовать pci=pcie_bus_perf. После включения убедитесь, что установленный MPS поддерживается всеми подключёнными устройствами PCIe.
3.4 Настройка QoS шины контроллера
Передача PCIe, особенно DMA, при высокой пропускной способности занимает ресурсы шины между контроллером PCIe и DRAM и конкурирует с другими IP-блоками при арбитраже. В таких предельных сценариях можно повысить приоритет, изменив QoS шины контроллера PCIe. Настройки приведены в приложении о регистрах QoS контроллеров PCIe различных SoC.
3.5 Настройка PCIe ASPM
ASPM влияет на производительность передачи, поэтому при испытаниях рекомендуется его отключить. В реальном изделии можно реализовать динамическое переключение ASPM в функциональном драйвере EP и проверить соблюдение требований реального времени в соответствующих тестовых сценариях.
3.6 Политика CPU для уменьшения разброса задержек доступа CPU EP к отображённому адресу
Если мастер PCIe и мастер CPU конкурируют за DRAM, следующие настройки могут уменьшить разброс задержек доступа PCIe: отключить предварительную выборку кеша SoC на стороне RC; отключить потоковую запись SoC на стороне RC. Изменять эти настройки в Trust Firmware следует осторожно, проверяя, что изделие в целом продолжает удовлетворять своим требованиям.
3.7 Политика шины для уменьшения разброса задержек доступа CPU EP к отображённому адресу
Для приложений, чувствительных к разбросу задержек PCIe, см. раздел приложения о настройке DRAM Scheduler Aging для PCIe некоторых SoC. Пример RK3568:
io -4 -w 0xfe100010 0xff010101 # DDR timing configuration, further communication required, can be left unchanged during testing
io -4 -w 0xfe10002c 0x1 # Aging base reduced to 1, which affects all IPs
io -4 -w 0xfe100030 0x1 # The aging coefficient for the channel where PCIe is located is reduced to 1, with both base and coefficient at 1 for the fastest response speed
3.8 Наблюдение за колебаниями производительности из-за нарушений сигнала PCIe
См. раздел статистики стабильности ядра в Rockchip_Developer_Guide_PCIe_CN.pdf: проверьте, связаны ли колебания производительности с сигналами PCIe, например повторным установлением соединения или повторной передачей TLP. При большом числе ошибочных пакетов сначала устраните проблемы сигнала, затем продолжайте оптимизацию.
4. Ограничение производительности шины PCIe
Если обмен PCIe мешает модулям с жёсткими требованиями реального времени — например, вызывает мерцание VOP на RK3562, потерю кадров MIPI CSI из-за PCIe0 на RK3576, колебания GMAC на RK3568 или падение производительности SATA на RK3588 — отдельно испытайте следующие меры. По приложению о QoS уменьшите приоритет доступа PCIe к памяти. По приложению о Shaper уменьшите гранулярность доступа и проверьте результат. По приложению об ограничении полосы ограничьте пропускную способность PCIe, чтобы затронутые модули удовлетворяли требованиям изделия. Если этого недостаточно, проверьте возможность переноса внутрикристальных портов доступа к данным затронутого модуля; такая возможность известна у некоторых модулей отображения, включая vop и vicap. Подобрав приоритет, shaper и полосу, закрепите параметры в DTS платы:
- Найдите QoS-узлы контроллеров PCIe в dtsi по соответствующему приложению.
- В DTS платы сослаться на QoS-узел и задать испытанные параметры приоритета и полосы; пример контроллера RK3568 PCIe2x1:
--- a/arch/arm64/boot/dts/rockchip/rk3568-xxx.dts
+++ b/arch/arm64/boot/dts/rockchip/rk3568-xxx.dts
@@ -2325,16 +2325,25 @@
&qos_pcie2x1{
+       /* Priority parameters */
+       priority-init = <0x202>;
+       /* Bandwidth parameters */
+       mode-init = <0x1>;
+       bandwidth-init = <0x100>;
+       saturation-init = <0x100>;
};
- Узел shaper найдите в соответствующем приложении; пример RK3562 PCIe2x1:
--- a/arch/arm64/boot/dts/rockchip/rk3562-xxx.dts
+++ b/arch/arm64/boot/dts/rockchip/rk3562-xxx.dts
&shaping_pcie{
+   shaping-init = <0x5>;
};
Примечание: если dtsi SoC не предусматривает узел shaping, закрепить настройку через dtsi нельзя; интегрируйте запись регистров непосредственно в код.
5. Контроллер: пропускная способность DMA
5.1 Теоретическая скорость
Теоретически скорость DMA приближается к скорости с учётом накладных расходов TLP; расчёт приведён в разделе «Накладные расходы TLP».
5.2 Метод испытания
5.2.1 Стандартный тест EP
Испытание основано на «Разработке стандартной функции EP» и «Kernel DMATEST». Для Linux см. соответствующие разделы Rockchip_Developer_Guide_PCIe_CN.pdf; для RT-Thread — Rockchip_Developer_Guide_RT-Thread_PCIe_CN.md.
5.2.2 Остальные параметры
- Установить высокие частоты CPU и DDR.
- Установить политику PCIe RC MPS pci=pcie_bus_perf.
- Для улучшения реакции в реальном времени и точного измерения полосы DMA опрашивать завершение DMA через PIO.
diff --git a/drivers/pci/controller/dwc/pcie-dw-dmatest.c b/drivers/pci/controller/dwc/pcie-dw-dmatest.c
index 4b0d4d3e01c8..df4595af962e 100644
--- a/drivers/pci/controller/dwc/pcie-dw-dmatest.c
+++ b/drivers/pci/controller/dwc/pcie-dw-dmatest.c
@@ -231,7 +231,7 @@ struct dma_trx_obj *pcie_dw_dmatest_register(struct device *dev, bool irq_en)
        }

        /* Enable IRQ transfer as default */
-       dmatest_dev->irq_en = irq_en;
+       dmatest_dev->irq_en = false;
        cur_dmatest_dev++;

        return obj;
5.3 Результаты испытаний
5.3.1 RK3568: стандартный тест EP
Оборудование: RC RK3568-EVB1-DDR4-V10, PCIe 3.0 2 lanes, ARM 1.99G, DDR 1.5G; EP RK3568-IOTEST-DDR3-V10, PCIe 3.0 2 lanes, ARM 1.99G, DDR 1.0G. Результаты:
| Размер DMA | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| Запись | 12.2MB/s | 51.7MB/s | 529.1MB/s | 941.6MB/s | 1418.2MB/s | 1454.3MB/s |
| Чтение | 6.0MB/s | 44.3MB/s | 442.3MB/s | 680.5MB/s | 938.9MB/s | 1080.2MB/s |
5.3.2 RK3588: стандартный тест EP
Оборудование: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, большие ядра 2.4G, малые 1.8G; EP RK3588-EVB4-LP4X-V10 с теми же PCIe и частотами ядер.
Результаты:
| Размер DMA | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| Запись | 14.7MB/S | 60.9MB/S | 660.6MB/S | 2313.4MB/S | 3026.1MB/S | 3066.1MB/s |
| Чтение | 13.9MB/S | 52.6MB/S | 568.7MB/S | 1490.5MB/S | 1619.8MB/S | 1660.6MB/s |
5.3.3 RK3588 Gen2x1: стандартный тест EP
Оборудование: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, большие ядра 2.4G, малые 1.8G; EP RK3588-EVB4-LP4X-V10, PCIe 3.0 4 lanes (понижено до Gen2 1 lane), большие ядра 2.4G, малые 1.8G. Результаты:
| Размер DMA | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| Запись | 3.8MB/S | 14.6MB/S | 152.7MB/S | 362.6MB/S | 419.5MB/S | 427.1MB/s |
| Чтение | 3.8MB/S | 14.7MB/S | 146.8MB/S | 360.5MB/S | 419.2MB/S | 427.3MB/s |
Результат только справочный. Возможности DMA контроллера RK3588 PCIe3x4 теоретически следует оценивать по разделу стандартного теста RK3588.
5.3.4 RK1820 Gen2x1: стандартный тест EP
Оборудование: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, большие ядра 2.4G, малые 1.8G; EP RK1820-EVB1-V10, PCIe 2.0 1 lane. Результаты для SRAM RK1820:
| Размер DMA | 64B | 256B | 4K | 64KB | 128KB | 512KB |
|---|---|---|---|---|---|---|
| Запись | 10MB/S | 42MB/S | 256MB/S | 400MB/S | 422MB/s | 422MB/s |
| Чтение | 8MB/S | 36MB/S | 192MB/S | 310MB/S | 325MB/s | 330MB/s |
Тест только справочный и характеризует полосу передачи. Дополнительные испытания должны учитывать реальную задачу, например драйвер chips_connect. Результаты для DRAM RK1820:
| Размер DMA | 64B | 256B | 4K | 64KB | 128KB | 512KB |
|---|---|---|---|---|---|---|
| Запись | 10MB/S | 42MB/S | 256MB/S | 401MB/S | 402MB/s | 410MB/s |
| Чтение | 8MB/S | 36MB/S | 193MB/S | 314MB/S | 320MB/s | 323MB/s |
Тест только справочный и характеризует полосу передачи. Дополнительные испытания должны учитывать реальную задачу, например драйвер chips_connect.
6. Контроллер: пропускная способность BAR
6.1 Введение
Обычный доступ пользователя к BAR — инструкции Load/Store 32bits. Поэтому измерение основано на пользовательских 32-битных Load/Store: чтение и запись выполняются через pci_mmap_resource, предоставляемый Linux PCIe sysfs.
6.2 Тестовое приложение
Подробности приведены в исходнике resource_mmap_test.c из приложения. Проверьте выбор mmap Resource с атрибутами device memory, например resource2. Сборка приложения, пример RK3588 Android:
/home1/ldq/rk-linux/prebuilts/gcc/linux-x86/aarch64/gcc-arm-10.2-2020.11-x86_64-aarch64-none-linux-gnu/bin/aarch64-none-linux-gnu-gcc -mcpu=cortex-a76 -O0 -static -DROPT -o resource_mmap_test resource_mmap_test.c
Требуется уровень оптимизации -O0, чтобы компилятор не оптимизировал команды чтения/записи.
6.3 Результаты испытаний
| RC | EP | Store 32bits | Load 32bits |
|---|---|---|---|
| RK3568 PCIe 3.0 2 lanes | RK3588 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 52.5MB/s | 3.7MB/s |
| RK3568 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 36.0MB/s | 2.4MB/s |
| RK3588 PCIe 3.0 4 lanes | RK3588 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 53.3MB/s | 4.2MB/s |
| RK3588 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 26.7MB/s | 2.6MB/s |
| RK3528 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 67.7MB/s | 2.3MB/s |
| RK3562 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 66.3MB/s | 2.3MB/s |
| RK3572 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 67.7MB/s | 2.4MB/s |
Результаты 64bits-pref (resource0..N) совпадают с 32bits-np (resource0..N).
6.4 Направления оптимизации
6.4.1 Увеличение разрядности данных
Ограничение скорости чтения/записи BAR главным образом связано с числом TLP. Увеличение полезной нагрузки TLP уменьшает их количество: увеличение разрядности запросов Load/Store на шине сокращает общее число TLP. Типичные варианты доступа к BAR: пользовательские Load/Store 32bits; фактическое поведение определяется ассемблерным результатом, например:
str w1, [x0]
Пользовательские SIMD Load/Store 128bits обычно возникают после оптимизации компилятором. Например, на SoC с SIMD это возможно при -O3; фактическое поведение определяется ассемблерным результатом:
str q1, [x1], #16
Load/Store 32bits в ядре. Интерфейсы ядра memset_io/memcpy_fromio. Результаты на примере RK3588:
| Тип доступа | Запись (MB/s) | Чтение (MB/s) |
|---|---|---|
| Пользовательский режим Load/Store 32bits | 53 | 4 |
| Пользовательский режим Load/Store SIMD 128bits | 203 | 16 |
| Режим ядра Load/Store 32bits | 53 | 4 |
| Режим ядра memset_io/memcpy_fromio | 106 | 7 |
Испытательная среда: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, большие ядра 2.4G, малые 1.8G; EP RK3588-EVB4-LP4X-V10, PCIe 3.0 4 lanes, большие ядра 2.4G, малые 1.8G. Пользовательский доступ Load/Store 32bits, пример инструкций V8-a:
LDR <Wt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
STR <Wt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
Пользовательский SIMD Load/Store 128bit, пример инструкций V8-a:
LDR <Qt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
STR <Qt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
Load/Store 32bits в ядре.
6.4.2 Многопоточность: неэффективна
Несколько экземпляров resource_mmap_test.c одновременно читают/пишут разные BAR. Логический анализатор не показал увеличения использования шины. Фактическая полоса существенно не выросла (не более 10%); её использование также не увеличилось, хотя наблюдалось чередование TLP разных пространств BAR.
7. Контроллер: скорость реакции на прерывания ELBI
7.1 Введение
ELBI (Endpoint Local Interrupt Bypass) в режиме DWC PCIe EP реализуется отображением конфигурационного пространства EP. RC записывает в отображённые регистры ELBI этого пространства и вызывает прерывание EP, улучшая реакцию системы EP. Скорость реакции ELBI главным образом зависит от полосы системной шины EP, оптимизации драйвера и вычислительной мощности процессора.
7.2 Тестовое приложение
Код отправки PCIe ELBI на стороне RC:
#include <linux/kthread.h>

// Create a new kernel thread to trigger ELBI interrupts
static int pcie_rkep_elbi_test_real(void *p)
{
    struct pcie_rkep *pcie_rkep = (struct pcie_rkep *)p;

    // In an infinite loop, call the rockchip_pcie_raise_elbi_irq function to trigger ELBI interrupts (using IRQ number 0)
    while(1)
        rockchip_pcie_raise_elbi_irq(pcie_rkep, 0);
}

// Use the pcie_rkep_elbi_test_real function to create a kernel thread to trigger ELBI interrupts
static int pcie_rkep_elbi_test(struct pcie_rkep *pcie_rkep)
{
    struct task_struct *tsk;

    // Use the pcie_rkep_test function to perform some test operations
    pcie_rkep_test(pcie_rkep);

    // Create a kernel thread named "rkep-elbi" and pass pcie_rkep as a parameter to the pcie_rkep_elbi_test_real function
    tsk = kthread_run(pcie_rkep_elbi_test_real, pcie_rkep, "rkep-elbi");
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Интеграция кода отправки PCIe ELBI на стороне RC:
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
Код измерения скорости PCIe ELBI на стороне EP:
#include <linux/kthread.h>

// Create a new kernel thread to measure the triggering frequency of ELBI interrupts
static int pcie_rkep_elbi_test_real(void *p)
{
    struct rockchip_pcie *rockchip = (struct rockchip_pcie *)p;
    int cur_count, last_count = rockchip->elbi_count;
    u64 us = 0;

    // In an infinite loop, perform the following operations every 1 second
    while(1) {
        msleep(1000); // Wait for 1 second

        // Get the current ELBI interrupt count
        cur_count = rockchip->elbi_count;

        // If the current interrupt count is not 0, calculate the time interval between the last and current interrupt counts (in microseconds)
        if (cur_count) {
            us = 1000000 / (cur_count - last_count);
        }

        // Print the current ELBI interrupt count and triggering frequency
        pr_err("elbi count=%d %lluus\n", cur_count, us);

        // Update the last interrupt count
        last_count = rockchip->elbi_count;
    }
}

// Use the pcie_rkep_elbi_test_real function to create a kernel thread to measure the triggering frequency of ELBI interrupts
static __maybe_unused int pcie_rkep_elbi_test(struct rockchip_pcie *rockchip)
{
    struct task_struct *tsk;
    // Create a kernel thread named "rkep-elbi" and pass rockchip as a parameter to the pcie_rkep_elbi_test_real function
    tsk = kthread_run(pcie_rkep_elbi_test_real, rockchip, "rkep-elbi");
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Интеграция кода измерения скорости PCIe ELBI на стороне EP:
 static int rockchip_pcie_ep_probe(struct platform_device *pdev)
 {
        struct device *dev = &pdev->dev;
@@ -1276,6 +1316,7 @@ static int rockchip_pcie_ep_probe(struct platform_device *pdev)
                goto deinit_phy;

        rockchip_pcie_add_misc(rockchip);
+       pcie_rkep_elbi_test(rockchip);

        return 0;
7.3 Результаты испытаний
| RC | EP | Задержка по умолчанию (us) |
|---|---|---|
| RK3568-EVB1-DDR4-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.5G | RK3568-IOTEST-DDR3-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.0G | 6 |
| RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 6 |
Конкретная реализация и сценарии применения зависят от конфигурации системы, аппаратной платформы и требований драйвера.
7.4 Направление оптимизации
Скорость реакции ELBI главным образом зависит от полосы шины EP, оптимизации драйвера и вычислительной мощности. Пример RK3588:
| Модель | Задержка по умолчанию (us) | Скорость чтения/записи регистров (us/s) | Задержка с отключённым CPU_SLEEP (us) | Задержка при максимальной фиксированной частоте CPU (us) |
|---|---|---|---|---|
| RK3588 | 6 | 2 | 6 | 4 |
Скорость чтения/записи регистров — максимальная скорость отправки запросов ELBI со стороны RC через интерфейс ELBI write config. Фактическая скорость реакции ниже из-за времени планирования прерываний EP.
8. Контроллер: скорость реакции на прерывания MSI
8.1 Введение
MSI (Message Signaled Interrupt) — механизм передачи прерываний PCIe: сообщение по специальному адресу вызывает прерывание. Устройство может иметь несколько адресов сообщений, каждый соответствует прерыванию. Это допускает параллельную обработку запросов, повышая скорость реакции и производительность. Скорость реакции MSI зависит от полосы системной шины RC, оптимизации драйвера и мощности процессора. В общем случае MSI позволяет существенно снизить задержку прерываний и сохранить хорошую реакцию даже при большой нагрузке.
8.2 Тестовое приложение
Код отправки PCIe MSI на стороне EP:
#include <linux/kthread.h>

// PCIe MSI RC and EP endpoint example code

static int pcie_rkep_elbi_test_real(void *p)
{
    struct rockchip_pcie *rockchip = (struct rockchip_pcie *)p;

    // EP endpoint continuously sends MSI interrupts to the RC endpoint
    while(1) {
        rockchip_pcie_raise_msi_irq(rockchip, 0);
    }
}

static int pcie_rkep_elbi_test(struct rockchip_pcie *rockchip)
{
    struct task_struct *tsk;

    // Create a kernel thread to execute the pcie_rkep_elbi_test_real function
    tsk = kthread_run(pcie_rkep_elbi_test_real, rockchip, "rkep-elbi");

    // Check if the thread creation was successful
    if (IS_ERR(tsk)) {
        pr_err("Failed to start rkep elbi thread\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Интеграция кода отправки PCIe MSI на стороне EP:
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
Код измерения скорости PCIe MSI на стороне RC:
#include <linux/kthread.h>

static int pcie_rkep_elbi_test_real(void *p)
{
    struct pcie_rkep *pcie_rkep = (struct pcie_rkep *)p;
    int cur_count, last_count = pcie_rkep->msi_count;
    u64 us = 0;

    // Execute in an infinite loop, printing the current msi_count value and the time interval between two prints once per second
    while(1) {
        msleep(1000);
        cur_count = pcie_rkep->msi_count;
        if (cur_count) {
            us = 1000000 / (cur_count - last_count); // Calculate the time interval (microseconds)
        }
        pr_err("msi count=%d %lluus\n", cur_count, us); // Print msi_count and time interval
        last_count = pcie_rkep->msi_count;
    }
    return 0;
}

static __maybe_unused int pcie_rkep_elbi_test(struct pcie_rkep *pcie_rkep)
{
    struct task_struct *tsk;

    tsk = kthread_run(pcie_rkep_elbi_test_real, pcie_rkep, "rkep-elbi"); // Create a kernel thread to execute the pcie_rkep_elbi_test_real function
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Пример вызова кода измерения скорости PCIe MSI на стороне RC:
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
8.3 Результаты испытаний
| RC | EP | Задержка по умолчанию (us) |
|---|---|---|
| RK3568-EVB1-DDR4-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.5G | RK3568-IOTEST-DDR3-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.0G | 2 |
| RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes Большое ядро 2.4G Малое ядро 1.8G | 2 |
Конкретная реализация и сценарии применения зависят от конфигурации системы, аппаратной платформы и требований драйвера.
8.4 Направление оптимизации
Оптимизация скорости MSI аналогична ELBI; подробности см. в разделе о скорости реакции ELBI контроллера.
9. Контроллер: скорость реакции доступа CPU периферии к отображённому адресу
9.1 Введение
PCIe позволяет CPU на стороне RC читать/писать данные периферии через BAR, а также CPU на стороне EP читать/писать данные RC через отображённые адреса.
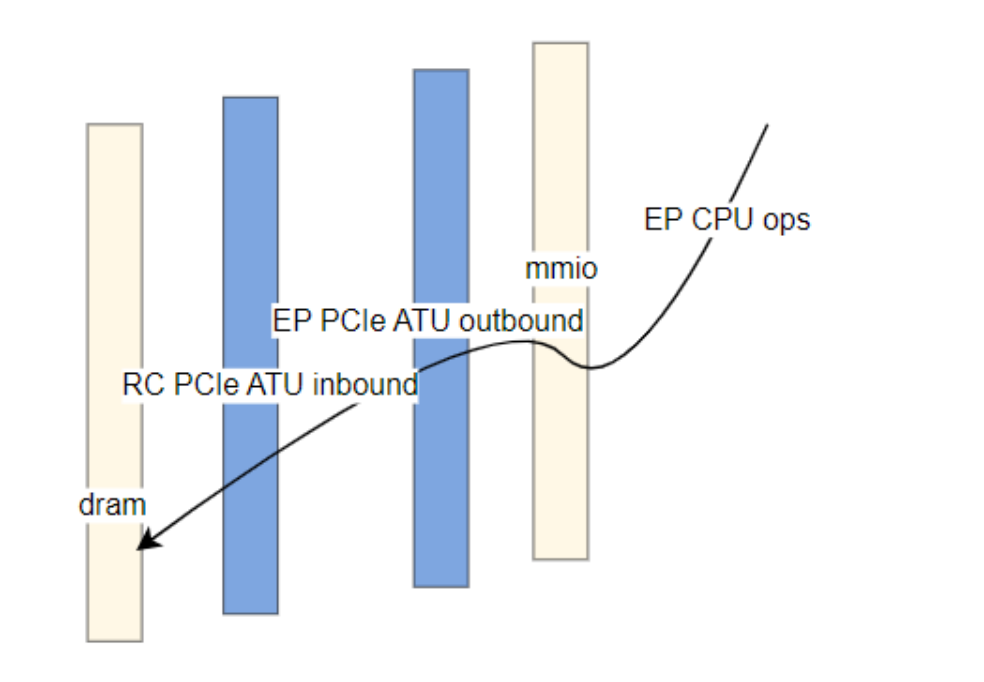
Английский оригинал — 24
9.2 Тестовое приложение
Настройте outbound для RK3588 EP. CPU обращается по outbound-адресу и выполняет запись, затем чтение; цикл повторяется 10 000 раз. Команды испытания RC: установить высокие частоты CPU/DRAM. По умолчанию дополнительной нагрузки нет; добавляйте нагрузки, соответствующие изделию.
EP: test_memory в U-Boot; пример команды EP:
#define TEST_ITERATIONS 3000000

#define TEST_RECORD_LENGTH 256
static uint32_t record[TEST_RECORD_LENGTH];
static volatile uint32_t value;
static uint32_t max_duration;
static uint32_t total_duration;
static uint32_t loops;

void test_memory(volatile uint32_t *address) {
    ulong duration;

    int i;

    printf("Memory write-read test starting...\n");

    for (i = 0; i < TEST_ITERATIONS; i++) {
        // Get start time
        duration = get_ticks();

        // Write to memory
        *address = 0x12345678;

        // Read from memory
        value = *address;

        // Get end time
        duration = get_ticks() - duration;

        // Update maximum duration
        if (duration > max_duration) {
            max_duration = duration;
        }

        // Accumulate total duration
        total_duration += duration;
        //printf("Iteration %d: %lu ticks\n", i + 1, duration);
        record[duration]++;
    }

    // Calculate average duration
    uint32_t average_duration = total_duration / (loops * TEST_ITERATIONS);

    printf("Maximum duration: %u ticks %lu us\n", max_duration, max_duration / (gd->arch.timer_rate_hz / 1000000));
    printf("Average duration: %u ticks %lu us\n", average_duration, average_duration / (gd->arch.timer_rate_hz / 1000000));
    printf("ticks - count (24tick/1us)\n");
    for (i = 0; i < TEST_RECORD_LENGTH; i++) {
        if (record[i])
            printf("%d - %d\n", i, record[i]);
    }
}

static int main(void)
{
        printf("mmio mem\n");
        memset(record, 0, 4 * TEST_RECORD_LENGTH);
        max_duration = 0;
        total_duration = 0;
        for (loops = 1; loops < 1000; loops++) {
            test_memory((volatile u32 *)(0xf0000000));
        }
    }
}
9.3 Результаты испытаний
9.3.1 RK3566 Gen2x1
Базовая среда: RC RK_EVB_3566_LP4X_V10, PCIe Gen2x1 по умолчанию, mps 128B; EP RK3588 EVB1, PCIe Gen3x4. Результаты:
| Описание | Среднее (us) | Максимум (us) |
|---|---|---|
| Базовый тест | 1.7 | 2.3 |
| Тест с нагрузкой DRAM | 1.9 | 7.9 |
Без нагрузки DRAM на RC разброс задержек доступа CPU EP к отображённому пространству PCIe минимален. С нагрузкой DRAM на RC он значителен. Типичные меры: раздел об изменении политики CPU для уменьшения разброса задержек доступа CPU EP; раздел об изменении политики шины для той же цели. Тест нагрузки DRAM RC включает Bit Flip и Reversed Mem.
10. Периферия: пропускная способность NVMe
10.1 Метод испытания
10.1.1 Имитация CrystalMark с fio
| Тест | Подпункт | Команда теста | Единица |
|---|---|---|---|
| SEQ1M Q32T1 READ | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=read -ioengine=libaio -bs=1024K -size=10G -numjobs=1 -runtime=180 -group_reporting -name=read_seq_1024k_q32_t1 | MB/s | |
| SEQ1M Q32T1 WRITE | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=write -ioengine=libaio -bs=1024K -size=10G -numjobs=1 -runtime=180 -group_reporting -name=write_seq_1024k_q32_t1 | MB/s | |
| RND4K Q32T1 READ | Пропускная способность | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=randread -ioengine=libaio -bs=4K -size=4G -numjobs=1 -runtime=180 -group_reporting -name=read_rand_4k_q32_t1 | MB/s K(IOPS) |
| RND4K Q32T1 WRITE | Пропускная способность | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=randwrite -ioengine=libaio -bs=4K -size=4G -numjobs=1 -runtime=180 -group_reporting -name=write_rand_4k_q32_t1 | MB/s K(IOPS) |
Если libaio отсутствует, можно использовать psync. psync синхронно имитирует параллельную пакетную отправку запросов I/O ядру несколькими потоками. libaio использует Kernel Native AIO и отправляет пакет запросов ядру за один раз. По сравнению с psync у него меньше накладных расходов и выше производительность; он лучше подходит для оценки NVMe. Создание ext4 в работающей системе, пример Linux:
mkfs.ext4 /dev/nvme0n1
mount -t ext4 /dev/nvme0n1 /mnt
Создание f2fs в работающей системе, пример Android:
make_f2fs /dev/block/nvme0n1
mount -t f2fs -o fsync_mode=nobarrier /dev/block/nvme0n1 /mnt
10.2 Результаты испытаний
10.2.1 RK3568 Gen3x2
Контроллер хоста RK3568 EVB1 PCIe Gen3x2. Ограничение скорости Gen3x2 главным образом находится в контроллере PCIe, поэтому CPU/DDR испытательного устройства используют параметры по умолчанию. Периферия: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. Результаты имитации CrystalDiskMark 8.0.1 через fio:
| Название теста | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1510 | \ |
| SEQ1M Q32T1 WRITE | 1488 | \ |
| RND4K Q32T1 READ | 152 | 40 |
| RND4K Q32T1 WRITE | 145 | 37 |
10.2.2 RK3588 Gen3x4
Хост RK3588 EVB1 PCIe Gen3x4, Port0/1 x4 RC. Фиксированные частоты: большие ядра 2.4G, малые 1.8G; mq-deadline, f2fs nobarrier, LPDDR4X 2112MHz. Периферия: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. Результаты PC CrystalDiskMark:
| PC CrystalMark 8.0.1 | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 3222 | \ |
| SEQ1M Q32T1 WRITE | 2600 | \ |
| RND4K Q32T1 READ | 708 | \ |
| RND4K Q32T1 WRITE | 486 | \ |
Результаты имитации CrystalMark 8.0.1 через fio:
| Название теста | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 3219.2 | \ |
| SEQ1M Q32T1 WRITE | 3108.7 | \ |
| RND4K Q32T1 READ | 794 | 203 |
| RND4K Q32T1 WRITE | 647 | 165 |
10.2.3 RK3588 Gen3x2
Хост RK3588 EVB1 PCIe3x4, Port0 x2 RC. Фиксированные частоты: большие ядра 2.4G, малые 1.8G; mq-deadline, f2fs nobarrier, LPDDR4X 2112MHz. Периферия: PHISON 128G BGA SSD. Результаты PC CrystalDiskMark:
| CrystalMark 8.0.1 | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1615 | \ |
| RND4K Q32T1 READ | 434 | \ |
| SEQ1M Q32T1 WRITE | 626 | \ |
| RND4K Q32T1 WRITE | 230 | \ |
Результаты имитации CrystalMark 8.0.1 через fio:
| Название теста | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1572.4 | \ |
| SEQ1M Q32T1 WRITE | 600 | \ |
| RND4K Q32T1 READ | 422 | 101 |
| RND4K Q32T1 WRITE | 355 | 90 |
10.2.4 RK3588s Gen2x1
Хост RK3588s EVB1 PCIe2x1l1, Port0 x1 RC. Фиксированные частоты: большие ядра 2.4G, малые 1.8G; mq-deadline, f2fs nobarrier, LPDDR4X 2112MHz.
Периферия: PHISON 128G BGA SSD. Результаты имитации CrystalDiskMark 8.0.1 через fio:
| Название теста | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 407 | \ |
| SEQ1M Q32T1 WRITE | 350 | \ |
| RND4K Q32T1 READ | 400 | 102 |
| RND4K Q32T1 WRITE | 134 | 32 |
10.2.5 RK3528 Gen2x1
Хост RK3528 EVB2, контроллер PCIe Gen2x1. Ограничение скорости Gen2x1 полностью определяется контроллером PCIe, поэтому CPU/DDR и остальные параметры испытательного устройства оставлены по умолчанию. Периферия: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. Результаты имитации CrystalDiskMark 8.0.1 через fio:
| Название теста | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 410 | \ |
| SEQ1M Q32T1 WRITE | 392 | \ |
| RND4K Q32T1 READ | 327 | 83 |
| RND4K Q32T1 WRITE | 300 | 76 |
10.2.6 RK3562 Gen2x1
Хост RK3562 EVB1, контроллер PCIe Gen2x1. Ограничение скорости Gen2x1 полностью определяется контроллером PCIe, поэтому CPU/DDR и остальные параметры испытательного устройства оставлены по умолчанию. Периферия: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4.
Результаты имитации CrystalDiskMark 8.0.1 через fio:
| Название теста | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 409 | \ |
| SEQ1M Q32T1 WRITE | 391 | \ |
| RND4K Q32T1 READ | 343 | 85 |
| RND4K Q32T1 WRITE | 253 | 63 |
10.2.7 RK3576 Gen2x1
Хост RK3576 EVB1, контроллер PCIe Gen2x1. Ограничение скорости Gen2x1 полностью определяется контроллером PCIe, поэтому CPU/DDR и остальные параметры испытательного устройства оставлены по умолчанию. Периферия: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. Результаты имитации CrystalDiskMark 8.0.1 через fio:
| Название теста | Скорость передачи MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 397 | \ |
| SEQ1M Q32T1 WRITE | 391 | \ |
| RND4K Q32T1 READ | 313 | 78 |
| RND4K Q32T1 WRITE | 255 | 63 |
11. Приложение
11.1 Регистры QoS контроллеров PCIe различных SoC
Примеры команд регистров в таблице задают максимальный допустимый приоритет; изменяйте его по условиям испытаний.
| Чип | Контроллер | Команда регистра | Узел в dtsi |
|---|---|---|---|
| RK1808 | pcie0 | io -4 0xfe880008 0x303 | qos_pcie |
| RK3528 | pcie2x1 | io -4 0xff280188 0x404 | qos_pcie |
| RK3562 | pcie2x1 | io -4 0xfeea0008 0x404 | qos_pcie |
| RK3566 RK3568 | pcie2x1 | io -4 0xfe190008 0x80000303 | qos_pcie2x1 |
| RK3566 RK3568 | pcie3x1 | io -4 0xfe190088 0x80000303 | qos_pcie3x1 |
| RK3566 RK3568 | pcie3x2 | io -4 0xfe190108 0x80000303 | qos_pcie3x2 |
| RK3576 | pcie0 | io -4 0x27f0a008 0x303 | qos_mmu0 |
| RK3576 | pcie1 | io -4 0x27f0a088 0x303 | qos_mmu1 |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a008 0x404 | qos_gic600_m0 |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a208 0x404 | qos_gic600_m1 |
11.2 Регистры Shaper контроллеров PCIe некоторых SoC
В таблице перечислены чипы с регистрами shaper. Пример задаёт максимальную допустимую гранулярность доступа 0xff. Допустимы значения от 0x1 до 0xff: меньшее значение означает более мелкую гранулярность. Настраивайте по результатам реальных испытаний.
| Чип | Контроллер | Команда регистра | Узел shaping в dtsi |
|---|---|---|---|
| RK3562 | pcie2x1 | io -4 0xfeea0088 0xff | shaping_pcie |
| RK3576 | pcie0 | io -4 0x27f0a108 0xff | Нет |
| RK3576 | pcie1 | io -4 0x27f0a188 0xff | Нет |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a088 0xff | Нет |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a288 0xff | Нет |
11.3 Регистры ограничения пропускной способности PCIe некоторых SoC
Допустимый диапазон — от 0 до 0x1ff; меньшее значение означает меньший предел пропускной способности PCIe.
| Чип | Контроллер | Команда регистра |
|---|---|---|
| RK3562 | pcie2x1 | io -4 0xfeea000c 0x1 io -4 0xfeea0010 value io -4 0xfeea0014 value |
| RK3566 RK3568 | pcie2x1 | io -4 0xfe19000c 0x1 io -4 0xfe190010 value io -4 0xfe190014 value |
| RK3566 RK3568 | pcie3x1 | io -4 0xfe19008c 0x1 io -4 0xfe190090 value io -4 0xfe190094 value |
| RK3566 RK3568 | pcie3x2 | io -4 0xfe19010c 0x1 io -4 0xfe190110 value io -4 0xfe190114 value |
| RK3576 | pcie0 | io -4 0x27f0a00c 0x1 io -4 0x27f0a010 value io -4 0x27f0a014 value |
| RK3576 | pcie1 | io -4 0x27f0a08c 0x1 io -4 0x27f0a090 value io -4 0x27f0a094 value |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a00c 0x1 io -4 0xfdf3a010 value io -4 0xfdf3a014 value |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a20c 0x1 io -4 0xfdf3a210 value io -4 0xfdf3a214 value |
11.4 Настройка DRAM Scheduler Aging для PCIe некоторых SoC
| Чип | Контроллер | Команда регистра | Примечания |
|---|---|---|---|
| RK3568 | PCIe2x1/PCIe3x2/PCIe3x1 | io -4 0xfe10002c 0x1 io -4 0xfe100030 0x1 |
Требуется настройка aging0 тракта к DDR |
| RK3588(S) | PCIe1L0/1/2 | io -4 0xfe00002c 0x1 io -4 0xfe00003c 0x1 io -4 0xfe00202c 0x1 io -4 0xfe00203c 0x1 io -4 0xfe00402c 0x1 io -4 0xfe00403c 0x1 io -4 0xfe00602c 0x1 io -4 0xfe00603c 0x1 |
Нужна настройка port3 (aging3) всех четырёх каналов |
| RK3588(S) | PCIe3x4 PCIe3x2 | io -4 0xfe00002c 0x1 io -4 0xfe000038 0x1 io -4 0xfe00202c 0x1 io -4 0xfe002038 0x1 io -4 0xfe00402c 0x1 io -4 0xfe004038 0x1 io -4 0xfe00602c 0x1 io -4 0xfe006038 0x1 |
Нужна настройка port2 (aging2) всех четырёх каналов |