
Quelle: RK-KF-YF-460 V2.9.0 für Chips mit PCIe und Linux ab 4.4. Dies ist eine Plattformreferenz: SoC der ArmSoM-Platine, PCIe-Verdrahtung, SDK/BSP, Kernel und Peripherie prüfen. Alle Leistungstabellen stammen aus EVB-Tests des Herstellers, nicht aus ArmSoM-Messungen. Chinesisch verwendet chinesische Abbildungen, die übrigen Sprachen englische. Register-, Firmware-, Energie- und Formatierungsbeispiele erfordern gesicherte Testhardware und Prüfung mit dem tatsächlichen BSP.
1. Hintergrund
1.1 Einleitung
Dieses Dokument beschreibt Leistungskennzahlen von RK-PCIe-Anwendungen und ihre Messverfahren. Ziel ist die Ermittlung der jeweiligen Kennzahlen über einfache, genaue und kontrollierbare Anwendungsschnittstellen. Der Hintergrundabschnitt erläutert das für die Tests benötigte Wissen, der Abschnitt zu Übertragungsraten liefert theoretische PCIe-Berechnungen; die übrigen Abschnitte behandeln konkrete Kennzahlen und Messverfahren.
1.2 PCIe sysfs
Linux PCIe unterstützt die sysfs-Schnittstelle mit hauptsächlich folgenden Ressourcen:
/sys/devices/pci0000:17
|-- 0000:17:00.0
|   |-- class
|   |-- config
|   |-- device
|   |-- enable
|   |-- irq
|   |-- local_cpus
|   |-- remove
|   |-- resource
|   |-- resource0
|   |-- resource1
|   |-- resource2
|   |-- resource2_wc        # 64bits-pref mem resource and supports write combining, which has an optimization effect on PCIe mem to dev operations.
|   |-- revision
|   |-- rom
|   |-- subsystem_device
|   |-- subsystem_vendor
|   `-- vendor
`-- ...
Ausführliche Referenz:
2. Übertragungsraten
2.1 PCIe-Bandbreite
| PCIe-Generation | Kodierung | Übertragungsrate | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|---|---|
| 1.0 | 8b/10b | 2.5GT/s | 250MB/s | 500MB/s | 1GB/s | 2GB/s |
| 2.0 | 8b/10b | 5GT/s | 500MB/s | 1GB/s | 2GB/s | 4GB/s |
| 3.0 | 128b/130b | 8GT/s | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
| 4.0 | 128b/130b | 16GT/s | 1.969GB/s | 3.938GB/s | 7.877GB/s | 15.754GB/s |
Die Übertragungsrate wird in GT/s und nicht in Bit pro Sekunde (Gbps) angegeben: Sie enthält Verwaltungsbits, die keinen zusätzlichen Nutzdurchsatz liefern. Beispielsweise beansprucht 8b/10b bei PCIe 1.x/2.x 20 % (2/10) der Kanalbandbreite. Die Quelle definiert GT/s als Giga transaction per second, Transaktionen pro Sekunde, und Gbps als Giga Bits Per Second und erklärt, es gebe keine proportionale Umrechnung. Verfügbare Bandbreite: Throughput = Transfer Rate * Encoding Scheme. Das Quellenbeispiel für PCIe 2.0 lautet „58 / 10 = 4 Gbps = 500 MB/s“, für x8 „48 = 32 Gbps = 4 GB/s“. Diese Schreibweisen bleiben als Quellenunklarheit erhalten.
2.2 TLP-Overhead
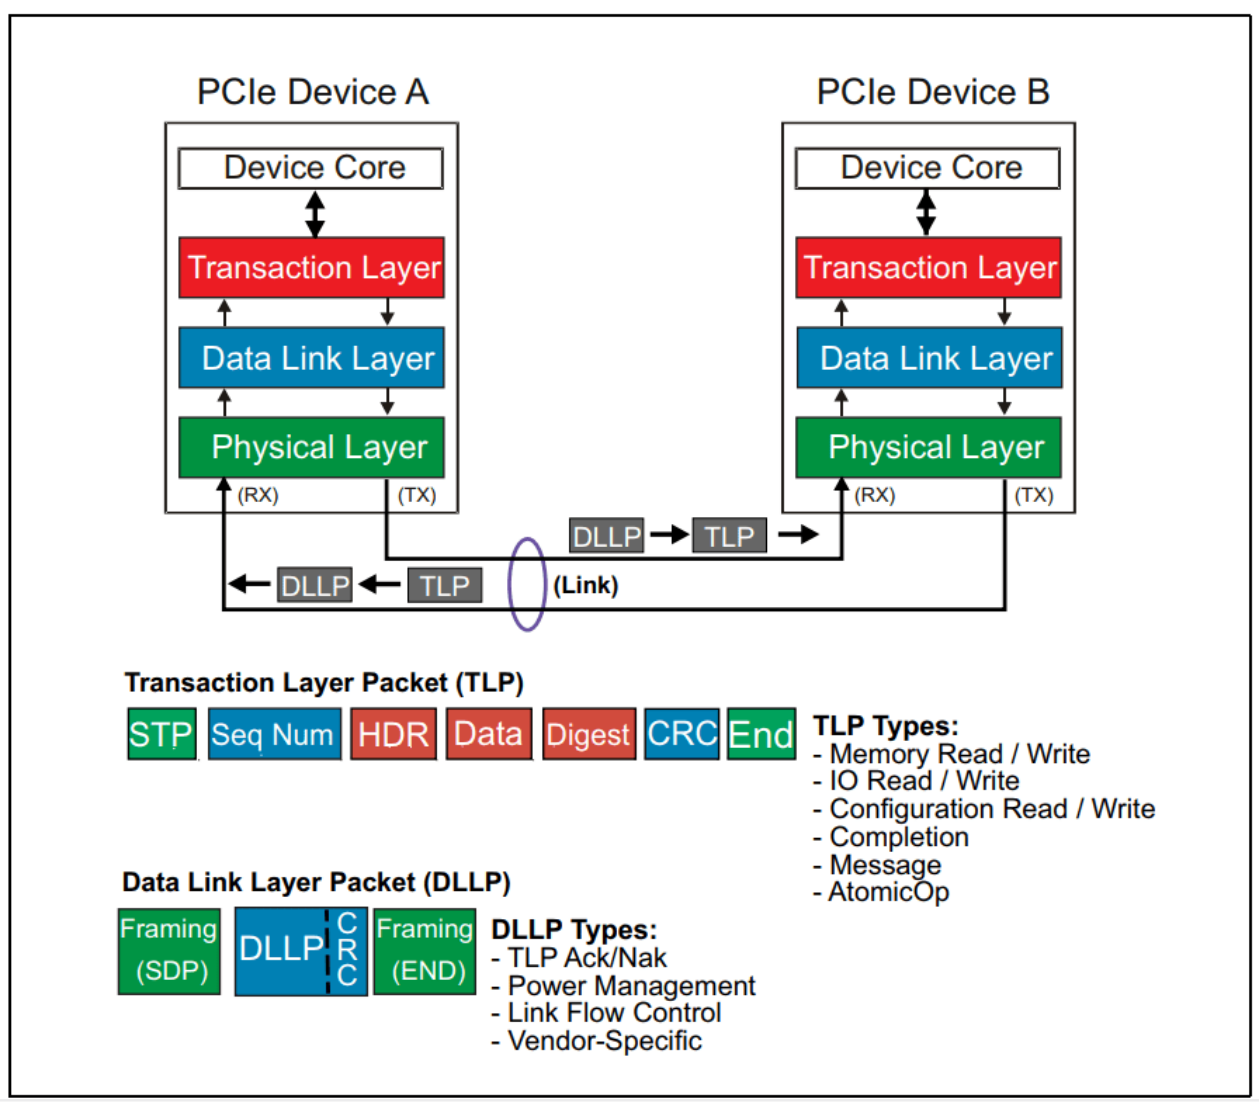
Beim Durchlaufen der Transaktions- und Sicherungsschicht werden Verwaltungsinformationen hinzugefügt, darunter Paketköpfe und -enden (LCRC, ECRC usw.) sowie Paketnummern der Sicherungsschicht. Deshalb liegt die tatsächliche Datenrate der Nutzlast unter der Bandbreite.
Englische Originalabbildung — 8
Die maximalen TLP-Zusatzdaten von 28 Byte umfassen den Header (16 Byte), die optionale ECRC (4 Byte), die LCRC (4 Byte), die Sequenznummer (2 Byte) sowie die Rahmensymbole STP und END (2 Byte). Als Beispiel dient die PCIe-Gen3-Bandbreite:
| PCIe-Generation | Kodierung | Übertragungsrate | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|---|---|
| 3.0 | 128b/130b | 8GT/s | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
Nach Berücksichtigung des TLP-Overheads:
| PCIe-Generation Gen3 | x1 Lane | x2 Lane | x4 Lane | x8 Lane |
|---|---|---|---|---|
| PCIe-Bandbreite (ohne TLP-Overhead) | 984.6MB/s | 1.969GB/s | 3.938GB/s | 7.877GB/s |
| 256B Nutzlast nach TLP-Overhead (256/284) | 887.5MB/s | 1.775GB/s | 3.550GB/s | 7.1002GB/s |
| 128B Nutzlast nach TLP-Overhead (128/156) | 807.8MB/s | 1.616GB/s | 3.232GB/s | 6.464GB/s |
2.3 Übertragungsraten in PCIe-Anwendungsszenarien
Unter zusätzlicher Berücksichtigung der DLLPs für Ack/Nak und Flusssteuerung sowie der Ordered Sets für Linktraining und Skip sinkt die tatsächliche Übertragungsrate weiter. In konkreten Anwendungsszenarien gilt eDMA als optimale Übertragungslösung.
3. Allgemeine Leistungsoptimierung
3.1 Maximale CPU- und DDR-Frequenz
Zur Anpassung den DVFS- und DRAM-Quellcode heranziehen.
3.2 CPU-Idle deaktivieren
Beispiel für die RK3588-Plattform:
/* dtsi disable cpu-sleep */
--- a/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
+++ b/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
@@ -585,6 +585,7 @@
idle-states {
    entry-method = "psci";
    CPU_SLEEP: cpu-sleep {
        compatible = "arm,idle-state";
        local-timer-stop;
        arm,psci-suspend-param = <0x0010000>;
        entry-latency-us = <100>;
        exit-latency-us = <120>;
        min-residency-us = <1000>;
+       status = "disabled";
    };
};

/* cmdline disable ARM's default wfi, for Android platform, please modify rk3588-android.dtsi */
--- a/arch/arm64/boot/dts/rockchip/rk3588-linux.dtsi
+++ b/arch/arm64/boot/dts/rockchip/rk3588-linux.dtsi
@@ -12,7 +12,7 @@
chosen: chosen {
-               bootargs = "earlycon=uart8250,mmio32,0xfeb50000 console=ttyFIQ0 irqchip.gicv3_pseudo_nmi=0 root=PARTUUID=614e0000-0000 rw rootwait rcupdate.rcu_expedited=1 rcu_nocbs=all";
+               bootargs = "earlycon=uart8250,mmio32,0xfeb50000 console=ttyFIQ0 irqchip.gicv3_pseudo_nmi=0 root=PARTUUID=614e0000-0000 rw rootwait rcupdate.rcu_expedited=1 rcu_nocbs=all nohlt";
};
3.3 MPS-Strategie des PCIe-RC
Siehe den Abschnitt zur Konfiguration der Max Payload Size in Rockchip_Developer_Guide_PCIe_CN.pdf. Versuchsweise kann pci=pcie_bus_perf gesetzt werden. Anschließend prüfen, ob der eingestellte MPS von allen angeschlossenen PCIe-Geräten unterstützt wird.
3.4 Bus-QoS des Controllers anpassen
PCIe-Übertragungen, insbesondere DMA, belegen bei hohem Durchsatz Busbandbreite zwischen PCIe-Controller und DRAM und konkurrieren bei der Busarbitrierung mit anderen IP-Blöcken. In solchen Grenzfällen kann der Vorrang durch Anpassung der Bus-QoS des PCIe-Controllers erhöht werden. Die Einstellungen stehen im Anhang zu den PCIe-QoS-Registern der verschiedenen SoCs.
3.5 PCIe-ASPM anpassen
ASPM beeinflusst die Übertragungsleistung und sollte deshalb während der Tests deaktiviert werden. Im tatsächlichen Produkt kann der EP-Funktionstreiber ASPM dynamisch umschalten; geeignete Testszenarien müssen die Echtzeitanforderungen bestätigen.
3.6 CPU-Strategie gegen Jitter beim Zugriff der EP-CPU auf abgebildete Adressen
Wenn PCIe-Master und CPU-Master um DRAM konkurrieren, können folgende Einstellungen den PCIe-Zugriffsjitter reduzieren: Cache-Prefetch des SoC auf der RC-Seite deaktivieren und Write Streaming des SoC auf der RC-Seite deaktivieren. Diese Einstellungen in der Trust Firmware vorsichtig ändern und sicherstellen, dass das Gesamtprodukt weiterhin seine Anforderungen erfüllt.
3.7 Busstrategie gegen Jitter beim Zugriff der EP-CPU auf abgebildete Adressen
Für Anwendungen, die empfindlich auf PCIe-Jitter reagieren, siehe den Anhang zur DRAM-Scheduler-Aging-Anpassung für PCIe einiger SoCs. Beispiel RK3568:
io -4 -w 0xfe100010 0xff010101 # DDR timing configuration, further communication required, can be left unchanged during testing
io -4 -w 0xfe10002c 0x1 # Aging base reduced to 1, which affects all IPs
io -4 -w 0xfe100030 0x1 # The aging coefficient for the channel where PCIe is located is reduced to 1, with both base and coefficient at 1 for the fastest response speed
3.8 Leistungsschwankungen durch fehlerhafte PCIe-Signale überwachen
Anhand des Abschnitts zur Kernel-Stabilitätsstatistik in Rockchip_Developer_Guide_PCIe_CN.pdf prüfen, ob Leistungsschwankungen durch PCIe-Signalprobleme wie erneuten Linkaufbau oder TLP-Replay entstehen. Bei vielen fehlerhaften Paketen zuerst die Signalprobleme beheben und danach die Optimierung fortsetzen.
4. PCIe-Busleistung begrenzen
Wenn PCIe-Verkehr andere Module mit hohen Echtzeitanforderungen beeinträchtigt, etwa VOP-Flimmern beim RK3562, MIPI-CSI-Bildverluste durch PCIe0 beim RK3576, GMAC-Leistungsschwankungen beim RK3568 oder SATA-Leistungseinbußen beim RK3588 verursacht, folgende Maßnahmen einzeln testen. Anhand des QoS-Anhangs den Speicherzugriffs-Vorrang von PCIe senken. Anhand des Shaper-Anhangs die Zugriffsgranularität verkleinern und die Wirkung prüfen. Anhand des Bandbreitenbegrenzungs-Anhangs PCIe begrenzen, bis die betroffenen Module die Produktanforderungen erfüllen. Falls dies nicht hilft, prüfen, ob die chipinternen Datenzugriffsports der betroffenen Module verlegt werden können; einige Anzeigemodule wie vop und vicap besitzen diese Möglichkeit. Geeignete Prioritäts-, Shaper- und Bandbreitenwerte anschließend im Board-DTS festlegen:
- Die QoS-Knoten der PCIe-Controller im dtsi anhand des entsprechenden Anhangs ermitteln.
- Im Board-DTS den QoS-Knoten referenzieren und die getesteten Prioritäts- und Bandbreitenwerte setzen; Beispiel RK3568 PCIe2x1:
--- a/arch/arm64/boot/dts/rockchip/rk3568-xxx.dts
+++ b/arch/arm64/boot/dts/rockchip/rk3568-xxx.dts
@@ -2325,16 +2325,25 @@
&qos_pcie2x1{
+       /* Priority parameters */
+       priority-init = <0x202>;
+       /* Bandwidth parameters */
+       mode-init = <0x1>;
+       bandwidth-init = <0x100>;
+       saturation-init = <0x100>;
};
- Den Shaper-Knoten im entsprechenden Anhang nachschlagen; Beispiel RK3562 PCIe2x1:
--- a/arch/arm64/boot/dts/rockchip/rk3562-xxx.dts
+++ b/arch/arm64/boot/dts/rockchip/rk3562-xxx.dts
&shaping_pcie{
+   shaping-init = <0x5>;
};
Hinweis: Enthält das SoC-dtsi keinen Shaping-Konfigurationsknoten, lässt sich die Einstellung dort nicht festlegen. Die Registerkonfiguration dann direkt in den Code integrieren.
5. Controller: DMA-Durchsatz
5.1 Theoretische Datenrate
Die theoretische DMA-Rate nähert sich der Rate nach Abzug des TLP-Overheads; siehe den Abschnitt zum TLP-Overhead.
5.2 Testverfahren
5.2.1 Standard-EP-Test
Der Test basiert auf der Entwicklung der Standard-EP-Funktion und Kernel DMATEST. Für Linux siehe die entsprechenden Abschnitte in Rockchip_Developer_Guide_PCIe_CN.pdf, für RT-Thread in Rockchip_Developer_Guide_RT-Thread_PCIe_CN.md.
5.2.2 Weitere Parameter
- Hohe CPU- und DDR-Frequenzen einstellen.
- Die PCIe-RC-MPS-Strategie auf pci=pcie_bus_perf setzen.
- Für besseres Echtzeitverhalten und genaue DMA-Bandbreitenmessung den DMA-Abschluss per PIO abfragen.
diff --git a/drivers/pci/controller/dwc/pcie-dw-dmatest.c b/drivers/pci/controller/dwc/pcie-dw-dmatest.c
index 4b0d4d3e01c8..df4595af962e 100644
--- a/drivers/pci/controller/dwc/pcie-dw-dmatest.c
+++ b/drivers/pci/controller/dwc/pcie-dw-dmatest.c
@@ -231,7 +231,7 @@ struct dma_trx_obj *pcie_dw_dmatest_register(struct device *dev, bool irq_en)
        }

        /* Enable IRQ transfer as default */
-       dmatest_dev->irq_en = irq_en;
+       dmatest_dev->irq_en = false;
        cur_dmatest_dev++;

        return obj;
5.3 Testergebnisse
5.3.1 RK3568: Standard-EP-Test
Testgeräte: RC RK3568-EVB1-DDR4-V10, PCIe 3.0 2 lanes, ARM 1.99G, DDR 1.5G; EP RK3568-IOTEST-DDR3-V10, PCIe 3.0 2 lanes, ARM 1.99G, DDR 1.0G. Ergebnisse:
| DMA-Größe | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| Schreiben | 12.2MB/s | 51.7MB/s | 529.1MB/s | 941.6MB/s | 1418.2MB/s | 1454.3MB/s |
| Lesen | 6.0MB/s | 44.3MB/s | 442.3MB/s | 680.5MB/s | 938.9MB/s | 1080.2MB/s |
5.3.2 RK3588: Standard-EP-Test
Testgeräte: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, große Kerne 2.4G, kleine Kerne 1.8G; EP RK3588-EVB4-LP4X-V10 mit denselben PCIe- und Kernfrequenzangaben.
Ergebnisse:
| DMA-Größe | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| Schreiben | 14.7MB/S | 60.9MB/S | 660.6MB/S | 2313.4MB/S | 3026.1MB/S | 3066.1MB/s |
| Lesen | 13.9MB/S | 52.6MB/S | 568.7MB/S | 1490.5MB/S | 1619.8MB/S | 1660.6MB/s |
5.3.3 RK3588 Gen2x1: Standard-EP-Test
Testgeräte: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, große Kerne 2.4G, kleine Kerne 1.8G; EP RK3588-EVB4-LP4X-V10, PCIe 3.0 4 lanes (auf Gen2 1 lane herabgesetzt), große Kerne 2.4G, kleine Kerne 1.8G. Ergebnisse:
| DMA-Größe | 64B | 256B | 4K | 64KB | 1MB | 4MB |
|---|---|---|---|---|---|---|
| Schreiben | 3.8MB/S | 14.6MB/S | 152.7MB/S | 362.6MB/S | 419.5MB/S | 427.1MB/s |
| Lesen | 3.8MB/S | 14.7MB/S | 146.8MB/S | 360.5MB/S | 419.2MB/S | 427.3MB/s |
Dieses Ergebnis dient nur als Referenz. Die DMA-Fähigkeit des RK3588-PCIe3x4-Controllers ist theoretisch anhand des Standardtests für RK3588 zu bewerten.
5.3.4 RK1820 Gen2x1: Standard-EP-Test
Testgeräte: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, große Kerne 2.4G, kleine Kerne 1.8G; EP RK1820-EVB1-V10, PCIe 2.0 1 lane. Ergebnisse für RK1820-SRAM:
| DMA-Größe | 64B | 256B | 4K | 64KB | 128KB | 512KB |
|---|---|---|---|---|---|---|
| Schreiben | 10MB/S | 42MB/S | 256MB/S | 400MB/S | 422MB/s | 422MB/s |
| Lesen | 8MB/S | 36MB/S | 192MB/S | 310MB/S | 325MB/s | 330MB/s |
Der Test dient nur als Referenz für die Übertragungsbandbreite. Weitere Tests müssen reale Anwendungen wie den chips_connect-Treiber einbeziehen. Ergebnisse für RK1820-DRAM:
| DMA-Größe | 64B | 256B | 4K | 64KB | 128KB | 512KB |
|---|---|---|---|---|---|---|
| Schreiben | 10MB/S | 42MB/S | 256MB/S | 401MB/S | 402MB/s | 410MB/s |
| Lesen | 8MB/S | 36MB/S | 193MB/S | 314MB/S | 320MB/s | 323MB/s |
Der Test dient nur als Referenz für die Übertragungsbandbreite. Weitere Tests müssen reale Anwendungen wie den chips_connect-Treiber einbeziehen.
6. Controller: BAR-Durchsatz
6.1 Einleitung
Der häufigste BAR-Zugriff aus Benutzersicht erfolgt über Load/Store mit 32 Bit. Deshalb basiert der Test auf 32-Bit-Load/Store im Userspace; gelesen und geschrieben wird über pci_mmap_resource von Linux PCIe sysfs.
6.2 Testanwendung
Details stehen im Quellcode resource_mmap_test.c im Anhang. Dort eine mmap-Ressource mit Device-Memory-Attributen auswählen, beispielsweise resource2. Übersetzen der Anwendung am Beispiel RK3588 Android:
/home1/ldq/rk-linux/prebuilts/gcc/linux-x86/aarch64/gcc-arm-10.2-2020.11-x86_64-aarch64-none-linux-gnu/bin/aarch64-none-linux-gnu-gcc -mcpu=cortex-a76 -O0 -static -DROPT -o resource_mmap_test resource_mmap_test.c
Die Optimierungsstufe -O0 ist erforderlich, damit Lese- und Schreibbefehle nicht wegoptimiert werden.
6.3 Testergebnisse
| RC | EP | Store 32bits | Load 32bits |
|---|---|---|---|
| RK3568 PCIe 3.0 2 lanes | RK3588 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 52.5MB/s | 3.7MB/s |
| RK3568 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 36.0MB/s | 2.4MB/s |
| RK3588 PCIe 3.0 4 lanes | RK3588 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 53.3MB/s | 4.2MB/s |
| RK3588 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 26.7MB/s | 2.6MB/s |
| RK3528 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 67.7MB/s | 2.3MB/s |
| RK3562 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 66.3MB/s | 2.3MB/s |
| RK3572 PCIe 2.0 1 lane | RK3588 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 67.7MB/s | 2.4MB/s |
Die Ergebnisse für 64bits-pref (resource0..N) stimmen mit 32bits-np (resource0..N) überein.
6.4 Optimierungsrichtungen
6.4.1 Datenbreite erhöhen
Der Engpass beim BAR-Lesen und -Schreiben liegt hauptsächlich in der Anzahl der TLPs. Mehr Nutzdaten je TLP verringern deren Anzahl: Eine größere Datenbreite der Load/Store-Anforderungen auf dem Bus reduziert die Gesamtzahl. Typische BAR-Zugriffe sind Userspace-Load/Store mit 32 Bit; maßgeblich ist das tatsächliche Assemblerergebnis, beispielsweise:
str w1, [x0]
Userspace-SIMD-Load/Store mit 128 Bit entstehen üblicherweise durch Compileroptimierung. Bei einem SoC mit SIMD kann beispielsweise -O3 dies erreichen; maßgeblich ist das Assemblerergebnis:
str q1, [x1], #16
Kernel-Load/Store mit 32 Bit. Kernel-Schnittstellen memset_io/memcpy_fromio. Ergebnisse am Beispiel RK3588:
| Zugriffsart | Schreiben (MB/s) | Lesen (MB/s) |
|---|---|---|
| Benutzermodus Load/Store 32bits | 53 | 4 |
| Benutzermodus Load/Store SIMD 128bits | 203 | 16 |
| Kernelmodus Load/Store 32bits | 53 | 4 |
| Kernelmodus memset_io/memcpy_fromio | 106 | 7 |
Testumgebung: RC RK3588-EVB1-LP4X-V10, PCIe 3.0 4 lanes, große Kerne 2.4G, kleine Kerne 1.8G; EP RK3588-EVB4-LP4X-V10, PCIe 3.0 4 lanes, große Kerne 2.4G, kleine Kerne 1.8G. Userspace-Load/Store mit 32 Bit, V8-a-Assemblerbeispiel:
LDR <Wt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
STR <Wt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
Userspace-SIMD-Load/Store mit 128 Bit, V8-a-Assemblerbeispiel:
LDR <Qt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
STR <Qt>, [<Xn|SP>, (<Wm>|<Xm>){, <extend> {<amount>}}]
Kernel-Load/Store mit 32 Bit.
6.4.2 Multithreading: ohne Wirkung
Mehrere Instanzen von resource_mmap_test.c lesen und schreiben gleichzeitig verschiedene BARs. Der Logikanalysator zeigte keine erhöhte Busauslastung. Die tatsächliche Bandbreite stieg nicht wesentlich (höchstens 10 %), und auch ihre Auslastung nahm nicht zu; ein Wechsel der TLPs zwischen verschiedenen BAR-Räumen war jedoch zu beobachten.
7. Controller: ELBI-Interrupt-Reaktionsrate
7.1 Einleitung
ELBI (Endpoint Local Interrupt Bypass) wird im DWC-PCIe-EP-Modus über die Abbildung des EP-Konfigurationsraums umgesetzt. Der RC löst durch Schreiben der dort abgebildeten ELBI-Register einen EP-Interrupt aus und verbessert damit die Reaktionsfähigkeit des EP-Systems. Die ELBI-Reaktionsrate hängt vor allem von EP-Systembusbandbreite, Treiberoptimierung und Prozessorleistung ab.
7.2 Testanwendung
PCIe-ELBI-Sendecode auf der RC-Seite:
#include <linux/kthread.h>

// Create a new kernel thread to trigger ELBI interrupts
static int pcie_rkep_elbi_test_real(void *p)
{
    struct pcie_rkep *pcie_rkep = (struct pcie_rkep *)p;

    // In an infinite loop, call the rockchip_pcie_raise_elbi_irq function to trigger ELBI interrupts (using IRQ number 0)
    while(1)
        rockchip_pcie_raise_elbi_irq(pcie_rkep, 0);
}

// Use the pcie_rkep_elbi_test_real function to create a kernel thread to trigger ELBI interrupts
static int pcie_rkep_elbi_test(struct pcie_rkep *pcie_rkep)
{
    struct task_struct *tsk;

    // Use the pcie_rkep_test function to perform some test operations
    pcie_rkep_test(pcie_rkep);

    // Create a kernel thread named "rkep-elbi" and pass pcie_rkep as a parameter to the pcie_rkep_elbi_test_real function
    tsk = kthread_run(pcie_rkep_elbi_test_real, pcie_rkep, "rkep-elbi");
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Integration des PCIe-ELBI-Sendecodes auf der RC-Seite:
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
PCIe-ELBI-Geschwindigkeitsmesscode auf der EP-Seite:
#include <linux/kthread.h>

// Create a new kernel thread to measure the triggering frequency of ELBI interrupts
static int pcie_rkep_elbi_test_real(void *p)
{
    struct rockchip_pcie *rockchip = (struct rockchip_pcie *)p;
    int cur_count, last_count = rockchip->elbi_count;
    u64 us = 0;

    // In an infinite loop, perform the following operations every 1 second
    while(1) {
        msleep(1000); // Wait for 1 second

        // Get the current ELBI interrupt count
        cur_count = rockchip->elbi_count;

        // If the current interrupt count is not 0, calculate the time interval between the last and current interrupt counts (in microseconds)
        if (cur_count) {
            us = 1000000 / (cur_count - last_count);
        }

        // Print the current ELBI interrupt count and triggering frequency
        pr_err("elbi count=%d %lluus\n", cur_count, us);

        // Update the last interrupt count
        last_count = rockchip->elbi_count;
    }
}

// Use the pcie_rkep_elbi_test_real function to create a kernel thread to measure the triggering frequency of ELBI interrupts
static __maybe_unused int pcie_rkep_elbi_test(struct rockchip_pcie *rockchip)
{
    struct task_struct *tsk;
    // Create a kernel thread named "rkep-elbi" and pass rockchip as a parameter to the pcie_rkep_elbi_test_real function
    tsk = kthread_run(pcie_rkep_elbi_test_real, rockchip, "rkep-elbi");
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Integration des PCIe-ELBI-Messcodes auf der EP-Seite:
 static int rockchip_pcie_ep_probe(struct platform_device *pdev)
 {
        struct device *dev = &pdev->dev;
@@ -1276,6 +1316,7 @@ static int rockchip_pcie_ep_probe(struct platform_device *pdev)
                goto deinit_phy;

        rockchip_pcie_add_misc(rockchip);
+       pcie_rkep_elbi_test(rockchip);

        return 0;
7.3 Testergebnisse
| RC | EP | Standardlatenz (us) |
|---|---|---|
| RK3568-EVB1-DDR4-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.5G | RK3568-IOTEST-DDR3-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.0G | 6 |
| RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 6 |
Konkrete Implementierung und Anwendungsszenarien hängen von Systemkonfiguration, Hardwareplattform und Treiberanforderungen ab.
7.4 Optimierungsrichtung
Die ELBI-Reaktionsrate hängt hauptsächlich von EP-Busbandbreite, Treiberoptimierung und Prozessorleistung ab. Beispiel RK3588:
| Modell | Standardlatenz (us) | Register-Lese-/Schreibrate (us/s) | Latenz bei deaktiviertem CPU_SLEEP (us) | Latenz bei fester maximaler CPU-Frequenz (us) |
|---|---|---|---|---|
| RK3588 | 6 | 2 | 6 | 4 |
Die Register-Lese-/Schreibrate ist die maximale Rate, mit der der RC ELBI-Anforderungen über ELBI write config erzeugt. Wegen der Interrupt-Scheduling-Reaktionszeit des EP liegt die tatsächlich erreichte Reaktionsrate darunter.
8. Controller: MSI-Interrupt-Reaktionsrate
8.1 Einleitung
MSI (Message Signaled Interrupt) ist ein PCIe-Interruptübertragungsmechanismus: Eine Nachricht an eine bestimmte Adresse löst einen Interrupt aus. Ein Gerät kann mehrere Nachrichtenadressen besitzen, die jeweils einem Interrupt entsprechen. Dies ermöglicht parallele Verarbeitung und verbessert Reaktionsgeschwindigkeit sowie Systemleistung. Die MSI-Reaktionsrate hängt von RC-Systembusbandbreite, Treiberoptimierung und Prozessorleistung ab. Allgemein kann MSI die Interruptlatenz deutlich senken und auch unter hoher Last gute Reaktionsraten erhalten.
8.2 Testanwendung
PCIe-MSI-Sendecode auf der EP-Seite:
#include <linux/kthread.h>

// PCIe MSI RC and EP endpoint example code

static int pcie_rkep_elbi_test_real(void *p)
{
    struct rockchip_pcie *rockchip = (struct rockchip_pcie *)p;

    // EP endpoint continuously sends MSI interrupts to the RC endpoint
    while(1) {
        rockchip_pcie_raise_msi_irq(rockchip, 0);
    }
}

static int pcie_rkep_elbi_test(struct rockchip_pcie *rockchip)
{
    struct task_struct *tsk;

    // Create a kernel thread to execute the pcie_rkep_elbi_test_real function
    tsk = kthread_run(pcie_rkep_elbi_test_real, rockchip, "rkep-elbi");

    // Check if the thread creation was successful
    if (IS_ERR(tsk)) {
        pr_err("Failed to start rkep elbi thread\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Integration des PCIe-MSI-Sendecodes auf der EP-Seite:
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
PCIe-MSI-Geschwindigkeitsmesscode auf der RC-Seite:
#include <linux/kthread.h>

static int pcie_rkep_elbi_test_real(void *p)
{
    struct pcie_rkep *pcie_rkep = (struct pcie_rkep *)p;
    int cur_count, last_count = pcie_rkep->msi_count;
    u64 us = 0;

    // Execute in an infinite loop, printing the current msi_count value and the time interval between two prints once per second
    while(1) {
        msleep(1000);
        cur_count = pcie_rkep->msi_count;
        if (cur_count) {
            us = 1000000 / (cur_count - last_count); // Calculate the time interval (microseconds)
        }
        pr_err("msi count=%d %lluus\n", cur_count, us); // Print msi_count and time interval
        last_count = pcie_rkep->msi_count;
    }
    return 0;
}

static __maybe_unused int pcie_rkep_elbi_test(struct pcie_rkep *pcie_rkep)
{
    struct task_struct *tsk;

    tsk = kthread_run(pcie_rkep_elbi_test_real, pcie_rkep, "rkep-elbi"); // Create a kernel thread to execute the pcie_rkep_elbi_test_real function
    if (IS_ERR(tsk)) {
        pr_err("rkep elbi start rk-pcie thread failed\n");
        return PTR_ERR(tsk);
    }

    return 0;
}
Aufrufbeispiel für den PCIe-MSI-Messcode auf der RC-Seite:
 static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
 {
        int ret, i;
@@ -774,6 +812,7 @@ static int pcie_rkep_probe(struct pci_dev *pdev, const struct pci_device_id *id)
                 pcie_rkep->obj_info->version);

        device_create_file(&pdev->dev, &dev_attr_rkep);
+       pcie_rkep_elbi_test(pcie_rkep);

        return 0;
 err_register_obj:
8.3 Testergebnisse
| RC | EP | Standardlatenz (us) |
|---|---|---|
| RK3568-EVB1-DDR4-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.5G | RK3568-IOTEST-DDR3-V10 PCIe 3.0 2 lanes ARM: 1.99G DDR: 1.0G | 2 |
| RK3588-EVB1-LP4X-V10 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | RK3588-EVB4-LP4X-V10 PCIe 3.0 4 lanes Großer Kern 2.4G Kleiner Kern 1.8G | 2 |
Konkrete Implementierung und Anwendungsszenarien hängen von Systemkonfiguration, Hardwareplattform und Treiberanforderungen ab.
8.4 Optimierungsrichtung
Die MSI-Ratenoptimierung entspricht der ELBI-Optimierung; Einzelheiten stehen im Abschnitt zur ELBI-Interrupt-Reaktionsrate des Controllers.
9. Controller: Reaktionsrate der Peripherie-CPU beim Zugriff auf abgebildete Adressen
9.1 Einleitung
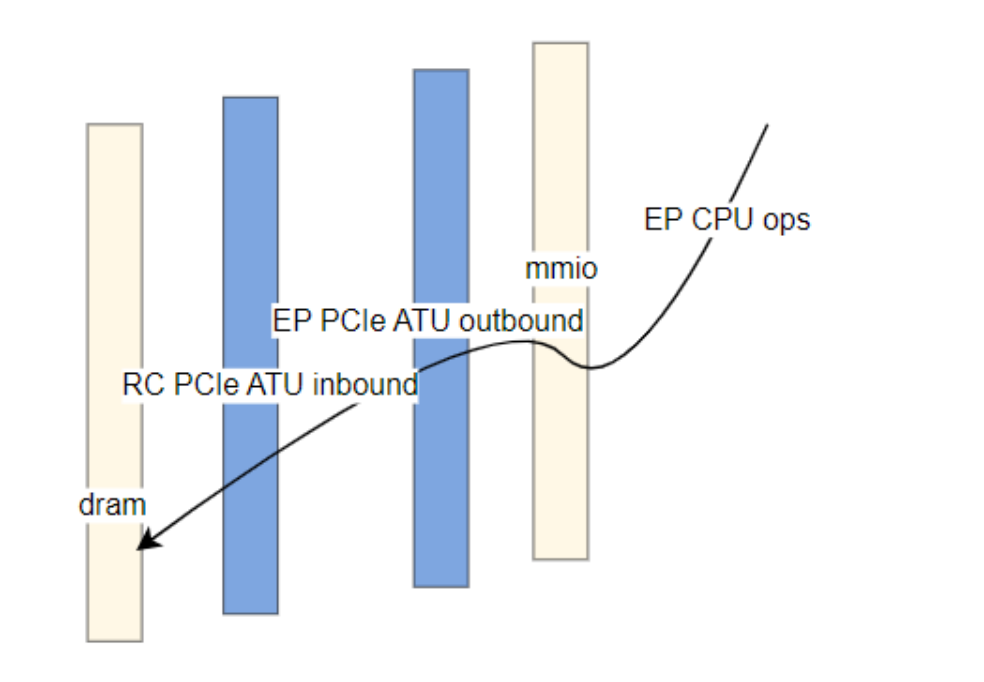
PCIe ermöglicht CPU-Zugriffe auf der RC-Seite über BAR zum Lesen/Schreiben von Peripheriedaten sowie CPU-Zugriffe auf der EP-Seite über abgebildete Adressen zum Lesen/Schreiben von RC-Daten.
Englische Originalabbildung — 24
9.2 Testanwendung
Outbound für RK3588 EP konfigurieren. Die CPU greift auf die Outbound-Adresse zu und schreibt und liest anschließend; diesen Zyklus 10.000-mal wiederholen. RC-Test: CPU/DRAM auf hohe Frequenz setzen. Standardmäßig keine Zusatzlast; Lasten entsprechend dem Produktszenario ergänzen.
EP: test_memory unter U-Boot; EP-Befehlsbeispiel:
#define TEST_ITERATIONS 3000000

#define TEST_RECORD_LENGTH 256
static uint32_t record[TEST_RECORD_LENGTH];
static volatile uint32_t value;
static uint32_t max_duration;
static uint32_t total_duration;
static uint32_t loops;

void test_memory(volatile uint32_t *address) {
    ulong duration;

    int i;

    printf("Memory write-read test starting...\n");

    for (i = 0; i < TEST_ITERATIONS; i++) {
        // Get start time
        duration = get_ticks();

        // Write to memory
        *address = 0x12345678;

        // Read from memory
        value = *address;

        // Get end time
        duration = get_ticks() - duration;

        // Update maximum duration
        if (duration > max_duration) {
            max_duration = duration;
        }

        // Accumulate total duration
        total_duration += duration;
        //printf("Iteration %d: %lu ticks\n", i + 1, duration);
        record[duration]++;
    }

    // Calculate average duration
    uint32_t average_duration = total_duration / (loops * TEST_ITERATIONS);

    printf("Maximum duration: %u ticks %lu us\n", max_duration, max_duration / (gd->arch.timer_rate_hz / 1000000));
    printf("Average duration: %u ticks %lu us\n", average_duration, average_duration / (gd->arch.timer_rate_hz / 1000000));
    printf("ticks - count (24tick/1us)\n");
    for (i = 0; i < TEST_RECORD_LENGTH; i++) {
        if (record[i])
            printf("%d - %d\n", i, record[i]);
    }
}

static int main(void)
{
        printf("mmio mem\n");
        memset(record, 0, 4 * TEST_RECORD_LENGTH);
        max_duration = 0;
        total_duration = 0;
        for (loops = 1; loops < 1000; loops++) {
            test_memory((volatile u32 *)(0xf0000000));
        }
    }
}
9.3 Testergebnisse
9.3.1 RK3566 Gen2x1
Grundumgebung: RC RK_EVB_3566_LP4X_V10, standardmäßig PCIe Gen2x1, mps 128B; EP RK3588 EVB1, PCIe Gen3x4. Ergebnisse:
| Beschreibung | Mittelwert (us) | Maximum (us) |
|---|---|---|
| Grundtest | 1.7 | 2.3 |
| DRAM-Lasttest | 1.9 | 7.9 |
Ohne RC-DRAM-Last ist der Jitter der EP-CPU beim Zugriff auf den abgebildeten PCIe-Raum gering, mit RC-DRAM-Last deutlich. Übliche Maßnahmen stehen in den Abschnitten zur CPU- und Busstrategie gegen diesen Zugriffsjitter. Die RC-DRAM-Lasttests umfassen Bit Flip und Reversed Mem.
10. Peripherie: NVMe-Durchsatz
10.1 Testverfahren
10.1.1 CrystalMark mit fio nachbilden
| Test | Unterpunkt | Testbefehl | Einheit |
|---|---|---|---|
| SEQ1M Q32T1 READ | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=read -ioengine=libaio -bs=1024K -size=10G -numjobs=1 -runtime=180 -group_reporting -name=read_seq_1024k_q32_t1 | MB/s | |
| SEQ1M Q32T1 WRITE | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=write -ioengine=libaio -bs=1024K -size=10G -numjobs=1 -runtime=180 -group_reporting -name=write_seq_1024k_q32_t1 | MB/s | |
| RND4K Q32T1 READ | Durchsatz | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=randread -ioengine=libaio -bs=4K -size=4G -numjobs=1 -runtime=180 -group_reporting -name=read_rand_4k_q32_t1 | MB/s K(IOPS) |
| RND4K Q32T1 WRITE | Durchsatz | adb shell ./data/fio -filename=/mnt/test -direct=1 -iodepth 32 -thread -rw=randwrite -ioengine=libaio -bs=4K -size=4G -numjobs=1 -runtime=180 -group_reporting -name=write_rand_4k_q32_t1 | MB/s K(IOPS) |
Fehlt libaio in der Testumgebung, kann psync verwendet werden. psync simuliert mit mehreren Threads synchron die parallele gebündelte Übergabe von I/O-Anforderungen an den Kernel. libaio nutzt Kernel Native AIO und kann einen ganzen Anforderungsstapel auf einmal übergeben. Gegenüber psync verursacht dies weniger Aufwand, bietet bessere Leistung und eignet sich besser zur NVMe-Bewertung. ext4 im laufenden System erstellen, Beispiel Linux:
mkfs.ext4 /dev/nvme0n1
mount -t ext4 /dev/nvme0n1 /mnt
f2fs im laufenden System erstellen, Beispiel Android:
make_f2fs /dev/block/nvme0n1
mount -t f2fs -o fsync_mode=nobarrier /dev/block/nvme0n1 /mnt
10.2 Testergebnisse
10.2.1 RK3568 Gen3x2
Hostcontroller RK3568 EVB1 PCIe Gen3x2. Der Gen3x2-Übertragungsengpass liegt hauptsächlich im PCIe-Controller; daher werden CPU/DDR mit Standardparametern betrieben. Peripherie: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. Ergebnisse der CrystalDiskMark-8.0.1-Nachbildung mit fio:
| Testname | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1510 | \ |
| SEQ1M Q32T1 WRITE | 1488 | \ |
| RND4K Q32T1 READ | 152 | 40 |
| RND4K Q32T1 WRITE | 145 | 37 |
10.2.2 RK3588 Gen3x4
Host RK3588 EVB1 PCIe Gen3x4, Port0/1 x4 RC. Feste Frequenzen: große Kerne 2.4G, kleine Kerne 1.8G; mq-deadline, f2fs nobarrier, LPDDR4X 2112MHz. Peripherie: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. PC-CrystalDiskMark-Ergebnisse:
| PC CrystalMark 8.0.1 | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 3222 | \ |
| SEQ1M Q32T1 WRITE | 2600 | \ |
| RND4K Q32T1 READ | 708 | \ |
| RND4K Q32T1 WRITE | 486 | \ |
Ergebnisse der CrystalMark-8.0.1-Nachbildung mit fio:
| Testname | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 3219.2 | \ |
| SEQ1M Q32T1 WRITE | 3108.7 | \ |
| RND4K Q32T1 READ | 794 | 203 |
| RND4K Q32T1 WRITE | 647 | 165 |
10.2.3 RK3588 Gen3x2
Host RK3588 EVB1 PCIe3x4, Port0 x2 RC. Feste Frequenzen: große Kerne 2.4G, kleine Kerne 1.8G; mq-deadline, f2fs nobarrier, LPDDR4X 2112MHz. Peripherie: PHISON 128G BGA SSD. PC-CrystalDiskMark-Ergebnisse:
| CrystalMark 8.0.1 | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1615 | \ |
| RND4K Q32T1 READ | 434 | \ |
| SEQ1M Q32T1 WRITE | 626 | \ |
| RND4K Q32T1 WRITE | 230 | \ |
Ergebnisse der CrystalMark-8.0.1-Nachbildung mit fio:
| Testname | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 1572.4 | \ |
| SEQ1M Q32T1 WRITE | 600 | \ |
| RND4K Q32T1 READ | 422 | 101 |
| RND4K Q32T1 WRITE | 355 | 90 |
10.2.4 RK3588s Gen2x1
Host RK3588s EVB1 PCIe2x1l1, Port0 x1 RC. Feste Frequenzen: große Kerne 2.4G, kleine Kerne 1.8G; mq-deadline, f2fs nobarrier, LPDDR4X 2112MHz.
Peripherie: PHISON 128G BGA SSD. Ergebnisse der CrystalDiskMark-8.0.1-Nachbildung mit fio:
| Testname | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 407 | \ |
| SEQ1M Q32T1 WRITE | 350 | \ |
| RND4K Q32T1 READ | 400 | 102 |
| RND4K Q32T1 WRITE | 134 | 32 |
10.2.5 RK3528 Gen2x1
Host RK3528 EVB2, PCIe-Gen2x1-Controller. Der Gen2x1-Übertragungsengpass liegt vollständig im PCIe-Controller; deshalb bleiben CPU/DDR und weitere Testgeräteparameter auf Standardwerten. Peripherie: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. Ergebnisse der CrystalDiskMark-8.0.1-Nachbildung mit fio:
| Testname | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 410 | \ |
| SEQ1M Q32T1 WRITE | 392 | \ |
| RND4K Q32T1 READ | 327 | 83 |
| RND4K Q32T1 WRITE | 300 | 76 |
10.2.6 RK3562 Gen2x1
Host RK3562 EVB1, PCIe-Gen2x1-Controller. Der Gen2x1-Übertragungsengpass liegt vollständig im PCIe-Controller; deshalb bleiben CPU/DDR und weitere Testgeräteparameter auf Standardwerten. Peripherie: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4.
Ergebnisse der CrystalDiskMark-8.0.1-Nachbildung mit fio:
| Testname | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 409 | \ |
| SEQ1M Q32T1 WRITE | 391 | \ |
| RND4K Q32T1 READ | 343 | 85 |
| RND4K Q32T1 WRITE | 253 | 63 |
10.2.7 RK3576 Gen2x1
Host RK3576 EVB1, PCIe-Gen2x1-Controller. Der Gen2x1-Übertragungsengpass liegt vollständig im PCIe-Controller; deshalb bleiben CPU/DDR und weitere Testgeräteparameter auf Standardwerten. Peripherie: Samsung 980 M.2 NVMe SSD 1TB PCIe Gen3x4. Ergebnisse der CrystalDiskMark-8.0.1-Nachbildung mit fio:
| Testname | Übertragungsrate MB/s | IOPS (K) |
|---|---|---|
| SEQ1M Q32T1 READ | 397 | \ |
| SEQ1M Q32T1 WRITE | 391 | \ |
| RND4K Q32T1 READ | 313 | 78 |
| RND4K Q32T1 WRITE | 255 | 63 |
11. Anhang
11.1 PCIe-Controller-QoS-Register verschiedener SoCs
Die Registerbefehlsbeispiele in der Tabelle stellen die höchste zulässige Priorität ein; nach Testbedingungen anpassen.
| Chip | Controller | Registerbefehl | Knoten im dtsi |
|---|---|---|---|
| RK1808 | pcie0 | io -4 0xfe880008 0x303 | qos_pcie |
| RK3528 | pcie2x1 | io -4 0xff280188 0x404 | qos_pcie |
| RK3562 | pcie2x1 | io -4 0xfeea0008 0x404 | qos_pcie |
| RK3566 RK3568 | pcie2x1 | io -4 0xfe190008 0x80000303 | qos_pcie2x1 |
| RK3566 RK3568 | pcie3x1 | io -4 0xfe190088 0x80000303 | qos_pcie3x1 |
| RK3566 RK3568 | pcie3x2 | io -4 0xfe190108 0x80000303 | qos_pcie3x2 |
| RK3576 | pcie0 | io -4 0x27f0a008 0x303 | qos_mmu0 |
| RK3576 | pcie1 | io -4 0x27f0a088 0x303 | qos_mmu1 |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a008 0x404 | qos_gic600_m0 |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a208 0x404 | qos_gic600_m1 |
11.2 PCIe-Controller-Shaper-Register einiger SoCs
Die Tabelle nennt Chips mit Shaper-Registern. Das Befehlsbeispiel setzt die maximal zulässige Zugriffsgranularität 0xff. Zulässig sind 0x1 bis 0xff; kleinere Werte bedeuten feinere Granularität. Nach tatsächlichen Testergebnissen anpassen.
| Chip | Controller | Registerbefehl | Shaping-Knoten im dtsi |
|---|---|---|---|
| RK3562 | pcie2x1 | io -4 0xfeea0088 0xff | shaping_pcie |
| RK3576 | pcie0 | io -4 0x27f0a108 0xff | Keiner |
| RK3576 | pcie1 | io -4 0x27f0a188 0xff | Keiner |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a088 0xff | Keiner |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a288 0xff | Keiner |
11.3 PCIe-Bandbreitenbegrenzungsregister einiger SoCs
Der zulässige Bereich reicht von 0 bis 0x1ff; ein kleinerer Wert bedeutet eine niedrigere PCIe-Bandbreitengrenze.
| Chip | Controller | Registerbefehl |
|---|---|---|
| RK3562 | pcie2x1 | io -4 0xfeea000c 0x1 io -4 0xfeea0010 value io -4 0xfeea0014 value |
| RK3566 RK3568 | pcie2x1 | io -4 0xfe19000c 0x1 io -4 0xfe190010 value io -4 0xfe190014 value |
| RK3566 RK3568 | pcie3x1 | io -4 0xfe19008c 0x1 io -4 0xfe190090 value io -4 0xfe190094 value |
| RK3566 RK3568 | pcie3x2 | io -4 0xfe19010c 0x1 io -4 0xfe190110 value io -4 0xfe190114 value |
| RK3576 | pcie0 | io -4 0x27f0a00c 0x1 io -4 0x27f0a010 value io -4 0x27f0a014 value |
| RK3576 | pcie1 | io -4 0x27f0a08c 0x1 io -4 0x27f0a090 value io -4 0x27f0a094 value |
| RK3588 | PCIe1L0/1/2 | io -4 0xfdf3a00c 0x1 io -4 0xfdf3a010 value io -4 0xfdf3a014 value |
| RK3588 | PCIe3x4 PCIe3x2 | io -4 0xfdf3a20c 0x1 io -4 0xfdf3a210 value io -4 0xfdf3a214 value |
11.4 PCIe-bezogene DRAM-Scheduler-Aging-Anpassung einiger SoCs
| Chip | Controller | Registerbefehl | Anmerkungen |
|---|---|---|---|
| RK3568 | PCIe2x1/PCIe3x2/PCIe3x1 | io -4 0xfe10002c 0x1 io -4 0xfe100030 0x1 |
Aging0 des Pfads zu DDR anpassen |
| RK3588(S) | PCIe1L0/1/2 | io -4 0xfe00002c 0x1 io -4 0xfe00003c 0x1 io -4 0xfe00202c 0x1 io -4 0xfe00203c 0x1 io -4 0xfe00402c 0x1 io -4 0xfe00403c 0x1 io -4 0xfe00602c 0x1 io -4 0xfe00603c 0x1 |
Port3 (aging3) aller vier Kanäle anpassen |
| RK3588(S) | PCIe3x4 PCIe3x2 | io -4 0xfe00002c 0x1 io -4 0xfe000038 0x1 io -4 0xfe00202c 0x1 io -4 0xfe002038 0x1 io -4 0xfe00402c 0x1 io -4 0xfe004038 0x1 io -4 0xfe00602c 0x1 io -4 0xfe006038 0x1 |
Port2 (aging2) aller vier Kanäle anpassen |