
Полный технический текст основан на RKLLM SDK 1.2.3. Китайская статья следует китайскому PDF, английская — английскому; русский и немецкий тексты полностью переведены с английского. Китайская версия использует китайские оригинальные иллюстрации, остальные — английские. Оба PDF имеют версию 1.2.3, но различаются оформлением примеров, комментариями и отдельными описаниями; скрытого смешения нет. В оригинале перечислены RK3576, RK3588, RK3562 и RV1126B, проверка RKNPU 0.9.8, Linux 5.10.209/6.1.84, GCC 10.2 и Android NDK. Это только справочник по адаптации платформ ArmSoM: конкретная плата, SDK/BSP, ядро и модель не проверены. Аппаратных испытаний и измерений не проводилось. Слово «последний» относится к контексту версии оригинала, а не к текущему выпуску.
Предупреждение о примерах оригинала: отступы Python, полноширинная скобка, смешанные константы JSON/Python, типы интерфейсов и перекрёстные ссылки содержат нерешённые вопросы; см. редакторские замечания. Работоспособность примеров не гарантируется. verify=False отключает проверку сертификатов, trust_remote_code=True разрешает внешний код, chmod 777 расширяет права. Замена драйвера, прошивка ядра, прослушивание 0.0.0.0 и публичная ссылка share=True требуют отдельной оценки. Исходные журналы показывают Runtime 1.0.2b9 / driver 0.9.7, отличающиеся от требований текста; это не измерения ArmSoM.
ArmSoM Docs · RKLLM · EDITORIAL-NOTES
1 Введение в RKLLM
1.1 Инструментарий RKLLM
1.1.1 Введение в RKLLM-Toolkit
RKLLM-Toolkit — комплект для квантования и преобразования больших языковых моделей на ПК. Через предоставляемый Python-интерфейс доступны следующие функции:
1) Преобразование моделей: LLM в формате Hugging Face или GGUF преобразуются в RKLLM. Поддерживаемые модели: LLaMA, Qwen, Qwen2, Qwen3, Qwen2-VL, Qwen3-VL, Phi-2, Phi-3, ChatGLM3, Gemma, Gemma2, Gemma3, Gemma3n, InternLM2, TeleChat2, MiniCPM-S, MiniCPM, MiniCPM3, MiniCPM4, DeepSeekOCR, InternVL3. Полученные модели RKLLM загружаются и используются на платформах Rockchip NPU.
2) Квантование: преобразование моделей с плавающей точкой в модели с фиксированной точкой. Поддерживаются:
a. w4a16;
b. групповое w4a16 (размеры групп 32, 64, 128);
c. w8a8;
d. групповое w8a8 (размеры групп 128, 256, 512).
1.1.2 Введение в RKLLM Runtime
RKLLM Runtime загружает модели, полученные преобразованием в RKLLM-Toolkit, и выполняет инференс через Rockchip NPU. Во время инференса пользователь может задавать параметры, способы генерации текста и получать результаты через заранее определённые функции обратного вызова.
1.2 Процесс разработки RKLLM
Разработка RKLLM состоит главным образом из двух этапов: преобразование модели на ПК и развёртывание с выполнением на плате:
1) Преобразование модели на ПК. LLM в формате Hugging Face преобразуется в RKLLM для эффективного выполнения на Rockchip NPU. Этапы:
a. Получение модели:
- открытая LLM в формате Hugging Face;
- самостоятельно обученная модель, сохранённая структура которой соответствует моделям платформы Hugging Face;
- модель GGUF, пока только типов q4_0 и fp16.
b. Загрузка Hugging Face через rkllm.load_huggingface(), GGUF через rkllm.load_gguf().
c. Настройка квантования: rkllm.build() строит модель RKLLM с возможностью квантования для аппаратного развёртывания. При построении выбираются уровень оптимизации и тип квантования.
d. Экспорт через rkllm.export_rkllm() в файл .rkllm для последующего развёртывания.
2) Развёртывание и выполнение на плате. На этом этапе модель фактически развёртывается и выполняется. Обычно выполняются следующие шаги:
a. Инициализация: загрузить модель RKLLM на Rockchip NPU, настроить параметры желаемого способа генерации текста и заранее определить функции обратного вызова для получения результатов в реальном времени.
b. Инференс: передать входные данные в модель и
выполнить инференс. Результаты непрерывно поступают через заданные функции обратного вызова.
c. Освобождение: после завершения инференса освободить ресурсы модели, чтобы другие задачи могли использовать вычислительные ресурсы NPU.
Эти два этапа составляют полный процесс разработки RKLLM и обеспечивают преобразование, отладку и эффективное развёртывание LLM на Rockchip NPU.
1.3 Поддерживаемые аппаратные платформы
Основные аппаратные платформы данного документа: RK3576, RK3588, RK3562, RV1126B.
2 Подготовка среды разработки
Архив инструментария RKLLM содержит установочный whl-пакет RKLLM-Toolkit, файлы библиотеки RKLLM Runtime и примеры кода. Структура каталогов приведена ниже:
doc
└──Rockchip_RKLLM_SDK_CN.pdf   # RKLLM SDK Documentation(Chinese)
└──Rockchip_RKLLM_SDK_EN.pdf   # RKLLM SDK Documentation(English)

examples
├──multimodal_model_demo    # Multimodal Inference Example
├──rkllm_api_demo           # Board-side Inference Example
└──rkllm_server_demo        # RKLLM-Server Deployment Example

rkllm-runtime
│   └── Android
│        └── librkllm_api
│             └──arm64-v8a
│                  └── librkllmrt.so  # 64位 Runtime库
│             └──armeabi-v7a
│                  └── librkllmrt.so   # 32 位Runtime库
│             └──include
│                  └── rkllm.h
│   └── Linux
│        └── librkllm_api
│             └──aarch64
│                  └── librkllmrt.so  # 64位Runtime库
│             └──armhf
│                  └── librkllmrt.so  # 32位Runtime库
│             └──include
│                  └── rkllm.h

rkllm-toolkit
│   └── packages
│        └──rkllm_toolkit-x.x.x-cp3xx-cp3xx-linux_x86_64.whl
│   └── examples

rknpu-driver
└──rknpu_driver_x.x.x_xxxxxxx.tar.bz2

scripts
├──fix_freq_rk3576.sh   # Fixed-frequency Script for RK3576
└──fix_freq_rk3588.sh   # Fixed-frequency Script for RK3588
└──fix_freq_rk3562.sh   # Fixed-frequency Script for RK3562
└──fix_freq_rv1126b.sh  # Fixed-frequency Script for RV1126B
В этой главе описана установка RKLLM-Toolkit и RKLLM Runtime. Использование подробно рассматривается в главе 3.
2.1 Установка RKLLM-Toolkit
В этом разделе показана установка RKLLM-Toolkit командой pip install. Следуйте подробным инструкциям ниже для установки инструментария.
2.1.1 Установка через Pip
2.1.1.1 Установка Miniforge3
Для управления несколькими версиями сред Python рекомендуется miniforge3. Проверьте, установлен ли miniforge3, и версию conda. Если он уже установлен, этот раздел можно пропустить.
conda -V
# If "conda: command not found" is displayed, it indicates that conda is not installed.
# For example, version information could be displayed as conda 23.9.0
Загрузите установочный пакет miniforge3.
wget -c https://mirrors.bfsu.edu.cn/github-release/conda-forge/miniforge/LatestRelease/Miniforge3-Linux-x86_64.sh
Установите miniforge3.
chmod 777 Miniforge3-Linux-x86_64.sh
bash Miniforge3-Linux-x86_64.sh
2.1.1.2 Создание среды Conda RKLLM-Toolkit
Активируйте базовую среду Conda.
source ~/miniforge3/bin/activate # directory of miniforge3
# (base) xxx@xxx-pc:~$
Создайте среду Conda RKLLM-Toolkit с Python 3.8 (рекомендуется).
conda create -n RKLLM-Toolkit python=3.8
Активируйте среду Conda RKLLM-Toolkit.
conda activate RKLLM-Toolkit
# (RKLLM-Toolkit) xxx@xxx-pc:~$
2.1.1.3 Установка RKLLM-Toolkit
В среде Conda RKLLM-Toolkit установите предоставленный
whl-пакет инструментария напрямую через pip. Установщик автоматически загрузит необходимые зависимости RKLLM-Toolkit.
pip3 install rkllm_toolkit-x.x.x-cp3xx-cp3xx-linux_x86_64.whl
Если следующая команда выполняется без ошибок, установка успешна.
python
from rkllm.api import RKLLM
2.2 Использование RKLLM Runtime
В предоставленном инструментарии RKLLM Runtime включает следующие компоненты:
1) librkllmrt.so: библиотека RKLLM Runtime.
2) include/rkllm.h: заголовочный файл librkllmrt.so с описаниями структур и функций. При разработке кода инференса необходимо правильно подключить заголовок и библиотеку для успешной компиляции. Для выполнения нужно перенести библиотеку на плату и указать её расположение следующей переменной окружения:
export LD_LIBRARY_PATH=/path/to/your/lib
2.3 Требования к компиляции RKLLM Runtime
При использовании RKLLM Runtime учитывайте версию gcc. Рекомендуется кросс-компилятор gcc-arm-10.2-2020.11-x86_64-aarch64-none-linux-gnu. Кросс-компиляторы часто обратно совместимы, но не совместимы вперёд, поэтому не используйте версии ниже 10.2. Для компиляции исполняемых файлов Android рекомендуется Android NDK по ссылке загрузки кросс-компилятора Android NDK; рекомендуемая версия r21e. Конкретные способы компиляции также приведены в скриптах каталога
examples/rkllm_api_demo/deploy.
2.4 Обновление ядра
Для предоставленного RKLLM требуется более новая версия драйвера NPU. Перед инференсом с RKLLM Runtime убедитесь, что версия NPU на плате — v0.9.8. Команда проверки:
# Execute the following command to query the NPU kernel version.
cat /sys/kernel/debug/rknpu/version

# Confirm that the command output is as follows:
# RKNPU driver: v0.9.8
Если версия драйвера NPU ниже v0.9.8, загрузите обновлённую официальную прошивку. При неофициальной прошивке требуется обновление ядра. Пакет RKNPU поддерживает kernel-5.10 и kernel-6.1. Для kernel-5.10 рекомендуется соответствующая версия ветки develop-5.10 репозитория GitHub rockchip-linux/kernel, в частности 5.10.209. Для kernel-6.1 рекомендуется, например, 6.1.84. Версию можно проверить в Makefile корня ядра. Порядок обновления:
1) Загрузите rknpu_driver_0.9.8_20241009.tar.bz2.
2) Распакуйте архив и замените драйвер RKNPU в текущем коде ядра (kernel/drivers/rknpu).
3) Перекомпилируйте ядро.
4) Прошейте устройство новым ядром. Если при компиляции возникает ошибка, показанная на рисунке 2-1:
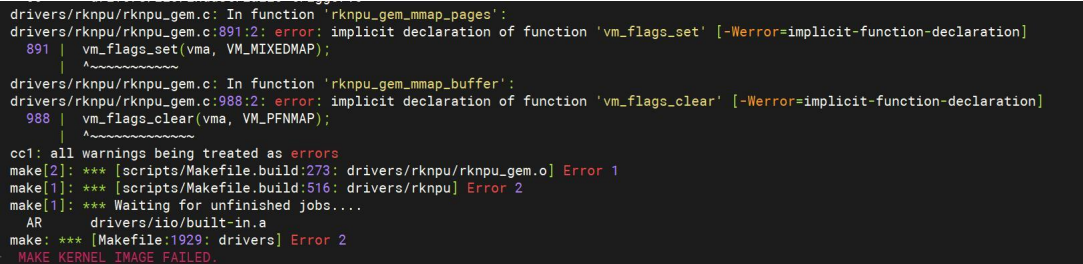
Копируемая расшифровка исходного журнала (не измерение ArmSoM; скрытая учётная запись не восстановлена):
drivers/rknpu/rknpu_gem.c: In function 'rknpu_gem_mmap_pages':
drivers/rknpu/rknpu_gem.c:891:2: error: implicit declaration of function 'vm_flags_set' [-Werror=implicit-function-declaration]
  891 |  vm_flags_set(vma, VM_MIXEDMAP);
      |  ^~~~~~~~~~~~
drivers/rknpu/rknpu_gem.c: In function 'rknpu_gem_mmap_buffer':
drivers/rknpu/rknpu_gem.c:988:2: error: implicit declaration of function 'vm_flags_clear' [-Werror=implicit-function-declaration]
  988 |  vm_flags_clear(vma, VM_PFNMAP);
      |  ^~~~~~~~~~~~~~
cc1: all warnings being treated as errors
make[2]: *** [scripts/Makefile.build:273: drivers/rknpu/rknpu_gem.o] Error 1
make[1]: *** [scripts/Makefile.build:516: drivers/rknpu] Error 2
make[1]: *** Waiting for unfinished jobs....
  AR      drivers/iio/built-in.a
make: *** [Makefile:1929: drivers] Error 2
MAKE KERNEL IMAGE FAILED.
Рисунок 2-1. Пример ошибки компиляции ядра. В этом случае в kernel/include/linux/mm.h следует добавить следующий код из оригинала:
static inline void vm_flags_set(struct vm_area_struct *vma,
                          vm_flags_t flags){
      vma->vm_flags |= flags;
}

static inline void vm_flags_clear(struct vm_area_struct *vma,
                            vm_flags_t flags){
      vma->vm_flags &= ~flags;
}
3 Руководство по использованию RKLLM
3.1 Преобразование модели
RKLLM-Toolkit предоставляет преобразование и квантование моделей. LLM в формате Hugging Face или GGUF преобразуются в RKLLM для развёртывания и выполнения на Rockchip NPU. В этом разделе подробно описана реализация преобразования моделей в RKLLM-Toolkit.
3.1.1 Инициализация RKLLM
Сначала необходимо инициализировать объект RKLLM. В примере для этого используется конструктор RKLLM().
3.1.2 Загрузка моделей
После инициализации вызовите rkllm.load_huggingface() с путём к модели. RKLLM-Toolkit загрузит большую языковую модель в формате Hugging Face или GGUF по соответствующему пути для дальнейшего преобразования и квантования. Определение функции:
Таблица 3-1. Спецификация интерфейса load_huggingface
| Функция | load_huggingface |
|---|---|
| Описание | Загрузка открытых LLM в формате Hugging Face. |
| Параметры | model: путь к файлам LLM для загрузки, дальнейшего преобразования и квантования. model_lora: путь к весам LoRA; при преобразовании model должен указывать соответствующую базовую модель. device: устройство преобразования, cuda или cpu. dtype: тип весов float32, float16 или bfloat16. float16/bfloat16 уменьшают расход памяти, но могут влиять на точность квантования. custom_config: пользовательский конфигурационный файл; см. раздел преобразования пользовательской модели. load_weight: загружать ли веса; при False реальные веса не загружаются. |
| Возвращаемое значение | 0: модель загружена; -1: ошибка загрузки. |
Пример кода:
ret = rkllm.load_huggingface(
   model = './huggingface_model_dir',
   model_lora = './huggingface_lora_model_dir')
if ret != 0:
   print('Load model failed!')
Таблица 3-2. Спецификация интерфейса load_gguf
| Функция | load_gguf |
|---|---|
| Описание | Загрузка открытых LLM в GGUF, поддерживаются q4_0 и fp16. Через этот интерфейс можно также загрузить GGUF-модели LoRA и преобразовать их в RKLLM. |
| Параметры | model: путь к файлам LLM для загрузки, дальнейшего преобразования и квантования. |
| Возвращаемое значение | 0: модель загружена; -1: ошибка загрузки. |
Пример кода:
ret = rkllm.load_gguf(model = './model-Q4_0.gguf')
if ret != 0:
   print('Load model failed!')
3.1.3 Построение модели RKLLM
После загрузки исходной модели через rkllm.load_huggingface() постройте RKLLM-модель функцией rkllm.build(). При преобразовании можно включить квантование для уменьшения размера модели и ускорения инференса на Rockchip NPU. Определение rkllm.build():
Таблица 3-3. Спецификация интерфейса build
| Функция | build |
|---|---|
| Описание | Построение модели RKLLM и настройка квантования при преобразовании. |
| Параметры | do_quantization: выполнять ли квантование; рекомендуется True. optimization_level: оптимизация точности квантования, значения {0, 1}: 0 отключает, 1 включает. Оптимизация точности может снижать производительность инференса. quantized_dtype: тип квантования. Поддерживаются “w4a16”, “w4a16_g32”, “w4a16_g64”, “w4a16_g128”, “w8a8”, “w8a8_g128”, “w8a8_g256”, “w8a8_g512”. “w4a16” — 4-битные веса без квантования активаций; “w4a16_g64” — групповое 4-битное квантование весов с group size=64, без квантования активаций. “w8a8” — 8-битные веса и активации; “w8a8_g128” — их групповое 8-битное квантование с group size=128. RK3576 и RV1126B поддерживают пять типов: “w4a16”, “w4a16_g32”, “w4a16_g64”, “w4a16_g128”, “w8a8”. RK3588 поддерживает четыре: “w8a8”, “w8a8_g128”, “w8a8_g256”, “w8a8_g512”. RK3562 поддерживает “w8a8”, “w4a16_g32”, “w4a16_g64”, “w4a16_g128”, “w4a8_g32”. Для GGUF q4_0 соответствует “w4a16_g32”. Примечание: размер группы должен делить выходную размерность линейного слоя, иначе квантование завершится ошибкой! quantized_algorithm: алгоритм оптимизации точности квантования; варианты “normal”, “grq” или “gdq”. “normal” доступен для всех типов; “gdq” и “grq” — только для “w4a16” и группового “w4a16”. Они требуют высокой вычислительной мощности и GPU-ускорения. grq быстрее gdq и потребляет меньше памяти; для 4-битного квантования предпочтителен grq. LoRA-модули могут повышать точность. Если другая LoRA не импортирована, допустимы алгоритмы “normal_r[164]” или “gdq_r[1~64]”, например “normal_r8”, “grq_r8”, “gdq_r8”. Экспортируются квантованная модель и LoRA, и Runtime загружает обе для инференса. num_npu_core: число ядер NPU для инференса. RK3576: [1, 2]; RK3562: [1]; RK3588: [1, 2, 3]; RV1126B: [1]. extra_qparams: gdq/grq создают кэш квантованных весов *.qparams; путь к нему можно передать для повторного экспорта модели. dataset: набор калибровки квантования в JSON. input — вопрос с подсказкой, target — ответ; несколько записей хранятся словарями в списке. hybrid_rate: доля смешанного квантования (∈[0,1)). При “w4a16”/”w8a8” по этой доле подмешиваются “w4a16_g”/”w8a8_g” для повышения точности; при групповом “w4a16_g”/”w8a8_g” подмешиваются “w4a16”/”w8a8” для ускорения инференса. При hybrid_rate=0 смешивание не выполняется. target_platform: аппаратная платформа выполнения; варианты “RK3576”, “RK3588”, “RK3562”, “RV1126B”. max_context: максимальная длина контекста, до 16,384, с выравниванием по 32. |
| Возвращаемое значение | 0: преобразование и квантование успешны; -1: ошибка преобразования. |
Пример кода:
ret = rkllm.build(
       do_quantization=True,
       optimization_level=1,
       quantized_dtype='w8a8',
       quantized_algorithm="normal",
       num_npu_core=3,
       extra_qparams=None,
       dataset="quant_data.json",
       hybrid_rate=0,
       target_platform='rk3588')
3.1.4 Экспорт модели
После построения модели RKLLM через rkllm.build() пользователь может сохранить модель RKNN в файл .rkllm для последующего развёртывания, вызвав rkllm.export_rkllm(). Определение параметров:
Таблица 3-4. Спецификация интерфейса export_rkllm
| Функция | export_rkllm |
|---|---|
| Описание | Сохранение преобразованной и квантованной модели RKLLM для последующего инференса. |
| Параметры | export_path: путь сохранения экспортируемой модели RKLLM. LoRA-модели автоматически сохраняются с суффиксом _lora в имени файла RKLLM. |
| Возвращаемое значение | 0: экспорт и сохранение успешны; -1: ошибка экспорта. |
Пример кода:
ret = rkllm.export_rkllm(export_path = './model.rkllm')
if ret != 0:
   print('Export model failed!')
3.1.5 Преобразование модели GPTQ
Помимо алгоритмов квантования, предоставленных инструментарием, можно сначала преобразовать модель с плавающей точкой в 4-битную/8-битную модель открытым инструментом AutoGPTQ, а затем преобразовать её в RKLLM. При квантовании через AutoGPTQ необходимо настроить следующие параметры:
bits=4
sym=true
group_size=32/64/128
desc_act=false
bits=8
sym=true
group_size=128/256/512
desc_act=false
Пример преобразования GPTQ-модели формата HuggingFace в RKLLM:
modelpath = '/path/to/Model-Instruct-GPTQ-Int4'
llm = RKLLM()
ret = llm.load_huggingface(model=modelpath, model_lora = None,
device='cuda')
if ret != 0:
   print('Load model failed!')
   exit(ret)
# Build model
dataset = None
qparams = None
target_platform = "RK3576"
optimization_level = 1
quantized_dtype = "w4a16_g32" #w4a16_g64 or w4a16_g128
quantized_algorithm = "normal"
num_npu_core = 2
ret = llm.build(do_quantization=True,
optimization_level=optimization_level, quantized_dtype=quantized_dtype,
             quantized_algorithm=quantized_algorithm,
target_platform=target_platform, num_npu_core=num_npu_core,
extra_qparams=qparams, dataset=dataset)
if ret != 0:
   print('Build model failed!')
   exit(ret)
# Export rkllm model
ret = llm.export_rkllm(f"./{os.path.basename(modelpath)}_{quantized_dtype}_{target_platform}.rkllm")
if ret != 0:
   print('Export model failed!')
   exit(ret)
3.1.6 Преобразование пользовательской модели
Если пользователь изменил структуру или имя модели и итоговая архитектура соответствует приведённой ниже, модель можно преобразовать с помощью пользовательской функции.
           TOKEN_EMBD
             ↓
        embd_scale(optional)
             ↓
         ┌─ x
         │  ↓
         │  ATTN_NORM
         │  ↓
         │  attn
         │  ↓
         │  ATTN_POST_NORM(optional)
         │  ↓
         │  hidden_state_scale(optional)
         │  ↓
         │  cross attn(optional)
         │  ↓
   ┌─   └► +
   │
   │        ↓
   │     FFN_NORM
   │        ↓
   │        MLP
   │        ↓
   │   FFN_POST_NORM(optional)
   │        ↓
   │   hidden_state_scale(optional)
   │        ↓
   └───►   +

             ...
             ↓
         OUTPUT_NORM
             ↓
        lm_head_scale(optional)
             ↓
           OUTPUT
Для модели Qwen соответствующие имена переменных из modeling_qwen.py нужно внести в пользовательский конфигурационный файл следующим образом.
{
   "BLOCKNAME": "QWenBlock",
   "TOKEN_EMBD": "wte",
   "ATTN_NORM": "ln_1",
   "ATTN_Q_NORM": "",
   "ATTN_K_NORM": "",
   "CROSS_ATTN_NORM": "",
   "CROSS_ATTN_Q": "",
   "ATTN_Q": "",
   "ATTN_K": "",
   "ATTN_V": "",
   "ATTN_QKV": "attn.c_attn",
   "ATTN_KV": "",
   "KV_CONTINUOUS": "true",
   "ATTN_OUT": "attn.c_proj",
   "CROSS_ATTN_OUT": "",
   "ATTN_POST_NORM": "",
   "FFN_NORM": "ln_2",
   "FFN_UP": "mlp.w1",
   "FFN_GATE": "mlp.w2",
   "ACT_TYPE": "silu",
   "FFN_DOWN": "mlp.c_proj",
   "FFN_POST_NORM": "",
   "OUTPUT_NORM": "ln_f",
   "OUTPUT": "lm_head"
}
Допустимые ACT_TYPE: [“silu”, “gelu”, “relu”, “fatrelu”, “squarerelu”, “swiglu”]. ATTN_NORM и FFN_NORM поддерживают только RMSNorm.
При использовании ATTN_QKV или ATTN_KV проверьте, можно ли разделить веса на непрерывные K|V. Если они непрерывны, задайте KV_CONTINUOUS=true. Например, веса c_attn модели Qwen хранятся непрерывно и последовательно делятся по размеру на Q, K и V. В модели InternLM2 веса wqkv, напротив, хранятся непрерывными не целиком: Q, K и V чередуются по head_dim.
Определение modeling_qwen.py для Qwen 1.8B:
class QWenLMHeadModel(QWenPreTrainedModel):
     def __init__(self, config):
       super().__init__(config)
         self.transformer = QWenModel(config)
         self.lm_head = nn.Linear(config.hidden_size,
config.vocab_size, bias=False)
class QWenModel(QWenPreTrainedModel):
   _keys_to_ignore_on_load_missing = ["attn.masked_bias"]

   def __init__(self, config):
       super().__init__(config)
       self.wte = nn.Embedding(self.vocab_size, self.embed_dim)
       self.ln_f = RMSNorm(
          self.embed_dim,
          eps=config.layer_norm_epsilon,
       )
class QWenBlock(nn.Module):
   def __init__(self, config):
       super().__init__()
       hidden_size = config.hidden_size
       self.bf16 = config.bf16

       self.ln_1 = RMSNorm(
          hidden_size,
          eps=config.layer_norm_epsilon,
       )
       self.attn = QWenAttention(config)
       self.ln_2 = RMSNorm(
          hidden_size,
          eps=config.layer_norm_epsilon,
       )
       self.mlp = QWenMLP(config)
class QWenAttention(nn.Module):
   def __init__(self, config):
       super().__init__()

       self.c_attn = nn.Linear(config.hidden_size, 3 *
self.projection_size)

       self.c_proj = nn.Linear(
          config.hidden_size, self.projection_size, bias=not
config.no_bias
       )

class QWenMLP(nn.Module):
   def __init__(self, config):
       super().__init__()
       self.w1 = nn.Linear(
          config.hidden_size, config.intermediate_size // 2, bias=not
config.no_bias
       )
       self.w2 = nn.Linear(
          config.hidden_size, config.intermediate_size // 2, bias=not
config.no_bias
       )
       ff_dim_in = config.intermediate_size // 2
       self.c_proj = nn.Linear(ff_dim_in, config.hidden_size, bias=not
config.no_bias)
Для преобразования пользовательских моделей, в том числе с cross-attention, предоставлена эталонная структура модели Hugging Face. Пользовательский конфигурационный файл:
{
   "BLOCKNAME": "CustomDecoderLayer",
   "TOKEN_EMBD": "embed_tokens",
   "ATTN_NORM": "input_layernorm",
   "ATTN_Q_NORM": "",
   "ATTN_K_NORM": "",
   "CROSS_ATTN_NORM": "cross_layernorm",
   "CROSS_ATTN_Q": "cross_attn.cross_q_proj",
   "ATTN_Q": "",
   "ATTN_K": "",
   "ATTN_V": "",
   "ATTN_QKV": "self_attn.qkv_proj",
   "ATTN_KV": "",
   "KV_CONTINUOUS": "true",
   "ATTN_OUT": "self_attn.o_proj",
   "CROSS_ATTN_OUT": "cross_attn.cross_o_proj",
   "ATTN_POST_NORM": "",
   "FFN_NORM": "post_attention_layernorm",
   "FFN_UP": "mlp.up_proj",
   "FFN_GATE": "mlp.gate_proj",
   "ACT_TYPE": "silu",
   "FFN_DOWN": "mlp.down_proj",
   "FFN_POST_NORM": "",
   "OUTPUT_NORM": "norm",
   "OUTPUT": "lm_head"
}
3.1.7 Обновление модели старой версии
Версия 1.0.2 значительно отличается от 1.1 и более новых версий. Функция rkllm.update_rkllm() обновляет модель 1.0.2 до новой версии без этапов загрузки и построения, описанных выше: достаточно вызвать этот интерфейс напрямую. После обновления параметры, например тип квантования модели, не меняются. Описание функции и параметров:
Таблица 3-5. Спецификация интерфейса update_rkllm
| Функция | update_rkllm |
|---|---|
| Описание | Обновление модели 1.0.2 до новой версии. |
| Параметры | model: путь к модели RKLLM версии 1.0.2. |
| Возвращаемое значение | 0: обновление успешно; -1: обновление не удалось. |
Пример кода:
ret = llm.update_rkllm(model = "./model_1.0.2version.rkllm")
if ret != 0:
   print('Load model failed!')
   exit(ret)
3.1.8 Оценка точности симуляции
После построения модели через rkllm.build() можно оценить точность симуляции на ПК функцией rkllm.get_logits(). Определения параметров:
Таблица 3-6. Спецификация интерфейса get_logits
| Функция | get_logits |
|---|---|
| Описание | Оценка точности симуляции на ПК. |
| Параметры | inputs: формат входа симуляции совпадает с инференсом Hugging Face, например {“input_ids”: “”, “top_k”: 1, …}. |
| Возвращаемое значение | Значения logits, полученные моделью. |
Пример использования этой функции для проверки PPL (perplexity) на наборе Wikitext:
def eval_wikitext(llm):
   seqlen = 512
   tokenizer = AutoTokenizer.from_pretrained(
       modelpath,
       trust_remote_code=True
       )
   #Dataset download link:
   #https://huggingface.co/datasets/Salesforce/wikitext/tree/main/wikitext-2-raw-v1
   testenc = load_dataset("parquet", data_files='./wikitext/wikitext-2-raw-1/test-00000-of-00001.parquet', split='train')
   testenc = tokenizer(
       "\n\n".join(testenc['text']),
       return_tensors="pt").input_ids
   nsamples = testenc.numel() // seqlen
   nlls = []
   for i in tqdm(range(nsamples), desc="eval_wikitext: "):
       batch = testenc[:, (i * seqlen): ((i + 1) * seqlen)]
       inputs = {"input_ids": batch}
       lm_logits = llm.get_logits(inputs)
       if lm_logits is None:
          print("get logits failed!")
          return
       shift_logits = lm_logits[:, :-1, :]
       shift_labels = batch[:, 1:].to(lm_logits.device)
       loss_fct = nn.CrossEntropyLoss().to(lm_logits.device)
       loss = loss_fct(shift_logits.view(-1, shift_logits.size(-1)),
shift_labels.view(-1))
       neg_log_likelihood = loss.float() * seqlen
       nlls.append(neg_log_likelihood)
   ppl = torch.exp(torch.stack(nlls).sum() / (nsamples * seqlen))
   print(f'wikitext-2-raw-1-test ppl: {round(ppl.item(), 2)}')
3.1.9 Симуляция инференса модели
После построения модели через rkllm.build() можно выполнить симуляцию инференса на ПК функцией rkllm.chat_model(). Определения параметров:
Таблица 3-7. Спецификация интерфейса chat_model
| Функция | chat_model |
|---|---|
| Описание | Симуляция инференса модели на ПК. |
| Параметры | messages: входной текст с соответствующими подсказками. args: параметры инференса, например параметр выборки top_k. |
| Возвращаемое значение | Значения logits, полученные моделью. |
Пример кода:
args ={
   "max_length":128,
   "top_k":1,
   "temperature":0.8,
   "do_sample":True,
   "repetition_penalty":1.1
   }

mesg = "Human: How’s the weather today?\nAssistant:"
print(llm.chat_model(mesg, args))
Описанные операции охватывают все этапы преобразования и квантования модели в RKLLM-Toolkit. В зависимости от требований и сценария применения можно выбирать разные настройки и методы квантования для дальнейшего развёртывания.
3.2 Реализация инференса на плате
В этой главе описаны общие API. На их основе можно написать C++-код инференса RKLLM на плате и получить результаты. Порядок:
- Определить callback().
- Определить структуру параметров RKLLMParam.
- Инициализировать модель через rkllm_init().
- Выполнить инференс через rkllm_run().
- Обработать результаты реального времени, возвращённые callback().
- Уничтожить модель и освободить ресурсы через rkllm_destroy().
Ниже подробно объясняются каждый этап и задействованные функции.
3.2.1 Определение функции обратного вызова
Функция обратного вызова принимает выходные данные RKLLM в реальном времени. Она привязывается при инициализации и вызывается в ходе инференса, возвращая каждый раз только один токен. Пример вывода результатов в терминал в реальном времени:
int callback(RKLLMResult* result, void* userdata, LLMCallState state)
{
   if(state == LLM_RUN_NORMAL){
       printf("%s", result->text);
   }
   if (state == LLM_RUN_FINISH) {
       printf("finish\n");
   } else if (state == LLM_RUN_ERROR){
       printf("\run error\n");
   }
   return 0;
}
1) LLMCallState — флаг состояния. Определение:
Таблица 3-8. Описание структуры/состояний LLMCallState
| Определение | LLMCallState |
|---|---|
| Описание | Текущее состояние RKLLM. |
| Значения перечисления | LLM_RUN_NORMAL: модель выполняет инференс; LLM_RUN_FINISH: инференс завершён; LLM_RUN_WAITING: текущий декодированный символ не образует полный UTF-8 и должен объединяться со следующим результатом декодирования; LLM_RUN_ERROR: ошибка инференса. |
При разработке callback можно задать разные действия постобработки для разных состояний LLMCallState.
2) RKLLMResult — структура возвращаемого результата. Определение:
Таблица 3-9. Описание структуры/состояний RKLLMResult
| Определение | RKLLMResult |
|---|---|
| Описание | Возвращение результата текущего инференса. |
| Поля структуры | const char* text: текст, сгенерированный текущим инференсом; int32_t token_id: token_id текущего инференса; RKLLMResultLogits logits: данные logits текущего инференса, возвращаются только при RKLLMInferMode=RKLLM_INFER_GET_LOGITS; RKLLMPerfStat perf: статистика производительности в конце инференса, возвращается только в состоянии RKLLM_RUN_FINISH. |
3) RKLLMResultLogits — структура возвращаемого результата. Определение:
Таблица 3-9. Описание структуры/состояний RKLLMResultLogitsStructure
| Определение | RKLLMResultLogits |
|---|---|
| Описание | Возвращение logits текущего инференса. |
| Поля структуры | const float* logits: logits текущего инференса; int vocab_size: token_id текущего инференса (формулировка оригинала); int num_tokens: число возвращённых токенов; размер logits вычисляется по vocab_size и num_tokens. |
При разработке callback можно задать разные действия постобработки в зависимости от значений RKLLMResult.
3.2.2 Определение RKLLMParam
Структура RKLLMParam описывает подробные параметры RKLLM. Определение:
Таблица 3-10. Описание структуры/состояний RKLLMParam
| Определение | RKLLMParam |
|---|---|
| Описание | Подробные параметры модели RKLLM. |
| Поля структуры | const char* model_path: путь к файлу модели RKLLM; int32_t num_npu_core: число ядер NPU при инференсе; RK3576 — [1, 2], RK3588 — [1, 3]; bool use_gpu: использовать ли GPU для ускорения Prefill; по умолчанию false; int32_t max_context_len: максимальная длина контекста при инференсе; int32_t max_new_tokens: максимальное число генерируемых токенов; int32_t top_k: выбор следующего токена только из top-k наиболее вероятных. Это уменьшает риск маловероятного или бессмысленного текста. Большое значение (например 100) учитывает больше вариантов и разнообразит текст; малое (например 10) ограничивает выбор наиболее вероятными и делает текст консервативнее. По умолчанию 40; float top_p: nucleus sampling выбирает следующий токен из группы с суммарной вероятностью не менее p. Метод балансирует разнообразие и качество, учитывая вероятности и число выбираемых токенов. Большое p (например 0.95) разнообразит текст; малое (например 0.5) делает его более сфокусированным и консервативным. По умолчанию 0.9; float temperature: регулирует случайность через распределение вероятностей выходных токенов. Высокая температура (например 1.5) делает текст случайнее и креативнее: при выборе следующего токена учитывается больше маловероятных вариантов, что даёт более разнообразные и неожиданные результаты. Низкая температура (например 0.5) делает вывод сфокусированнее: модель чаще выбирает высоковероятные токены, результат становится последовательнее и предсказуемее. При temperature=0 всегда выбирается самый вероятный следующий токен, поэтому вывод каждый раз одинаков. Для баланса случайности и детерминированности — без чрезмерной однообразности или хаотичности — по умолчанию 0.8; float repeat_penalty: контролирует повторение последовательностей токенов и предотвращает повторяющийся или монотонный текст. Большое значение (например 1.5) сильнее штрафует повторы, малое (например 0.9) мягче. По умолчанию 1.1; float frequency_penalty: штраф за повторение слов/фраз, уменьшающий вероятность частых и увеличивающий вероятность редких. Может разнообразить текст, но также ухудшить понятность или соответствие ожиданиям. Диапазон [-2.0, 2.0], по умолчанию 0; int32_t mirostat: алгоритм удержания качества текста в ожидаемом диапазоне. Балансирует связность и разнообразие, избегая чрезмерных повторов (boredom trap) и несвязности (confusion trap). Значения {0, 1, 2}: 0 выключает, 1 включает mirostat, 2 — mirostat 2.0; float mirostat_tau: целевая энтропия mirostat, представляющая ожидаемую perplexity текста. Её настройка балансирует связность и разнообразие: малое значение делает текст концентрированнее и связнее, большое — разнообразнее, но, возможно, менее связным. По умолчанию 5.0; float mirostat_eta: скорость обучения mirostat, влияющая на реакцию на обратную связь о тексте. Низкая замедляет настройку, высокая делает алгоритм чувствительнее. По умолчанию 0.1; bool skip_special_token: пропускать ли специальные токены без вывода, например <EOS>; bool is_async: использовать ли асинхронный режим; const char img_start: начальный маркер кодирования изображения мультимодального входа; требуется в мультимодальном режиме; const char img_end: конечный маркер кодирования изображения; требуется в мультимодальном режиме; const char img_content*: маркер содержимого изображения; требуется в мультимодальном режиме; n_keep: число начальных элементов кэша, сохраняемых при очистке KV cache. В многошаговом диалоге n_keep не должен быть меньше длины system_prompt; RKLLMExtendParam extend_param: специальные параметры управления инференсом. |
Таблица 3-11. Описание структуры/состояний RKLLMExtendParam
| Определение | RKLLMExtendParam |
|---|---|
| Описание | Специальные параметры управления инференсом. |
| Поля структуры | int32_t base_domain_id: домен, с которого начинается инициализация RKLLM; по умолчанию 0. int8_t embed_flash: хранить словарь модели во flash для экономии памяти; 0 выключает, 1 включает. int8_t enabled_cpus_num: число CPU для инференса. RK3588/3576: 1-8; RK3562: 1-4; по умолчанию 4. uint32_t enabled_cpus_mask: двоичная маска выбора конкретных ядер CPU. В rkllm.h заранее определены макросы номеров CPU; пример формата CPU4 | CPU5 | CPU6 | CPU7. uint8_t n_batch: степень параллелизма инференса, по умолчанию 1. int8_t use_cross_attn: включать ли cross-attention. |
В реальном коде RKLLMParam следует инициализировать функцией rkllm_createDefaultParam(), затем задать параметры модели по требованиям. Пример:
RKLLMParam param = rkllm_createDefaultParam();
param.model_path = "model.rkllm";
param.top_k = 1;
param.max_new_tokens = 256;
param.max_context_len = 512;
3.2.3 Определение входной структуры
Структура RKLLMInput поддерживает четыре типа входных данных: текст, изображение с текстом, идентификаторы токенов и закодированные векторы. Определение:
Таблица 3-12. Описание структуры/состояний RKLLMInput
| Определение | RKLLMInput |
|---|---|
| Описание | Приём входных данных разных форм. |
| Поля структуры | RKLLMInputType input_type: режим входа; const char* role: тип входа, варианты [“user”, “tool”]; bool enable_thinking: включать ли режим thinking Qwen3; union: хранение разных типов входа: const char prompt_input*: текстовая подсказка на естественном языке; RKLLMEmbedInput embed_input: вектор embedding, представляющий обработанные признаки; RKLLMTokenInput token_input: последовательность идентификаторов после токенизации; RKLLMMultiModalInput multimodal_input: мультимодальные данные, например изображения с текстом. |
Таблица 3-13. Описание структуры/состояний RKLLMInputType
| Определение | RKLLMInputType |
|---|---|
| Описание | Тип входных данных. |
| Значения перечисления | RKLLM_INPUT_PROMPT: обычный текст; RKLLM_INPUT_TOKEN: идентификаторы токенов; RKLLM_INPUT_EMBED: закодированные векторы; RKLLM_INPUT_MULTIMODAL: изображения с текстом. |
Обычный текст можно передавать напрямую через input_data. Для идентификаторов токенов, закодированных векторов или изображений с текстом RKLLMInput используется вместе с RKLLMTokenInput, RKLLMEmbedInput и RKLLMMultiModalInput. Подробности:
1) RKLLMTokenInput — входная структура идентификаторов токенов. Определение:
Таблица 3-14. Описание структуры/состояний RKLLMTokenInput
| Определение | RKLLMTokenInput |
|---|---|
| Описание | Приём данных token_id. |
| Поля структуры | int32_t input_ids*: указатель памяти входных идентификаторов токенов. size_t n_tokens: число входных токенов. |
2) RKLLMEmbedInput — входная структура закодированных векторов. Определение:
Таблица 3-15. Описание структуры/состояний RKLLMEmbedInput
| Определение | RKLLMEmbedInput |
|---|---|
| Описание | Приём данных embedding. |
| Поля структуры | float embed*: указатель памяти входных embedding токенов. size_t n_tokens: число входных токенов. |
3) RKLLMMultiModalInput — входная структура изображений с текстом. Определение:
Таблица 3-16. Описание структуры/состояний RKLLMMultiModalInput
| Определение | RKLLMMultiModalInput |
|---|---|
| Описание | Приём изображений и текста. |
| Поля структуры | char prompt: указатель памяти входного текста. float image_embed: указатель памяти embedding входных изображений. size_t n_image_tokens: число токенов embedding изображений. size_t n_image: число входных изображений; поддерживаются несколько последовательных кадров. size_t image_width: ширина изображения, используемая при вычислении embedding и параметров mrope. size_t image_height: высота изображения, используемая при вычислении embedding и параметров mrope. |
RKLLM поддерживает разные режимы инференса через RKLLMInferParam. Во время инференса можно совместно использовать заранее загруженные модели LoRA либо сохранить Prompt Cache для ускорения последующих вызовов. Определение:
Таблица 3-17. Описание структуры/состояний RKLLMInferParam
| Определение | RKLLMInferParam |
|---|---|
| Описание | Различные режимы инференса. |
| Поля структуры | RKLLMInferMode mode: режим инференса; RKLLM_INFER_GENERATE — обычный режим, RKLLM_INFER_GET_LOGITS — режим с дополнительным получением logits. RKLLMLoraParam lora_params: настройки LoRA при инференсе, позволяющие выбрать нужную модель из нескольких загруженных; NULL, если LoRA не требуется. RKLLMPromptCacheParam prompt_cache_params: параметры Prompt Cache при инференсе; NULL, если генерация Prompt Cache не требуется. keep_history: сохранять ли исторический контекст; для многошагового диалога задайте 1. |
Таблица 3-18. Описание структуры/состояний RKLLMLoraParam
| Определение | RKLLMLoraParam |
|---|---|
| Описание | Параметры использования LoRA при инференсе. |
| Поля структуры | const char lora_adapter_name*: имя LoRA, используемой при инференсе. |
Таблица 3-19. Описание структуры/состояний RKLLMPromptCacheParam
| Определение | RKLLMPromptCacheParam |
|---|---|
| Описание | Параметры использования Prompt Cache при инференсе. |
| Поля структуры | int save_prompt_cache: сохранять ли Prompt Cache при инференсе; 1 — да, 0 — нет. const char prompt_cache_path*: путь сохранения Prompt Cache; если не задан, “./prompt_cache.bin”. |
Пример инференса с RKLLMPromptCacheParam:
// Initialize and Set Prompt Cache Parameters(if needed)
RKLLMPromptCacheParam prompt_cache_params;
// Enable saving Prompt Cache
prompt_cache_params.save_prompt_cache = true;
// Specify cache file path
prompt_cache_params.prompt_cache_path = "./prompt_cache.bin";
rkllm_infer_params.prompt_cache_params = &prompt_cache_params;
3.2.4 Инициализация модели
Перед инициализацией заранее определите дескриптор LLMHandle. Он используется при инициализации, инференсе и освобождении ресурсов модели; один и тот же объект LLMHandle должен применяться во всех трёх процессах, иначе корректное выполнение инференса не обеспечивается. Перед инференсом завершите инициализацию модели функцией rkllm_init(). Определение:
Таблица 3-20. Спецификация интерфейса rkllm_init
| Функция | rkllm_init |
|---|---|
| Описание | Инициализация параметров модели и настроек инференса RKLLM. |
| Параметры | LLMHandle* handle: регистрация модели в дескрипторе для последующих вызовов инференса и освобождения; RKLLMParam* param: определённая для модели структура параметров; LLMResultCallback callback: callback для приёма и обработки результатов модели в реальном времени. |
| Возвращаемое значение | 0: нормальная инициализация; -1: ошибка инициализации. |
Пример кода:
LLMHandle llmHandle = nullptr;
rkllm_init(&llmHandle, ¶m, callback);
3.2.5 Инференс модели
После инициализации модели выполните инференс через rkllm_run(). Результаты реального времени обрабатываются callback, определённым при инициализации. Определение rkllm_run():
Таблица 3-21. Спецификация интерфейса rkllm_run
| Функция | rkllm_run |
|---|---|
| Описание | Выполнение инференса инициализированной моделью RKLLM. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации. RKLLMInput rkllm_input: входные данные; см. определение входной структуры в §3.2.3. RKLLMInferParam rkllm_infer_params: параметры инференса; см. §3.2.3. void* userdata: указатель пользовательской функции, обычно NULL по умолчанию. |
| Возвращаемое значение | 0: инференс выполняется нормально; -1: ошибка вызова инференса. |
3.2.6 Прерывание инференса модели
Во время инференса вызов rkllm_abort() прерывает его выполнение. Определение:
Таблица 3-22. Спецификация интерфейса rkllm_abort
| Функция | rkllm_ abort |
|---|---|
| Описание | Прерывание инференса RKLLM. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации. |
| Возвращаемое значение | 0: прерывание успешно; -1: не удалось прервать модель. |
3.2.7 Освобождение модели
После завершения всех вызовов инференса вызовите rkllm_destroy(), чтобы уничтожить модель RKLLM и освободить выделенные вычислительные ресурсы CPU, GPU и NPU для других процессов или моделей. Определение:
Таблица 3-23. Спецификация интерфейса rkllm_destroy
| Функция | rkllm_ destroy |
|---|---|
| Описание | Уничтожение RKLLM-модели и освобождение всех вычислительных ресурсов. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации. |
| Возвращаемое значение | 0: модель успешно уничтожена и освобождена; -1: ошибка освобождения. |
Пример кода:
// llmHandle is the the target handle registered
rkllm_destroy(llmHandle);
3.2.8 Загрузка модели LoRA
RKLLM поддерживает совместную работу моделей LoRA с базовой моделью во время инференса. До вызова rkllm_run можно загрузить LoRA через rkllm_load_lora. Допускается несколько моделей LoRA; каждый вызов rkllm_load_lora загружает одну модель. Определение:
Таблица 3-24. Спецификация интерфейса rkllm_load_lora
| Функция | rkllm_load_lora |
|---|---|
| Описание | Загрузка модели LoRA для базовой модели. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации; см. §3.2.4. RKLLMLoraAdapter lora_adapter*: параметры загрузки LoRA. |
| Возвращаемое значение | 0: LoRA-модель загружена; -1: ошибка загрузки. |
Таблица 3-25. Описание структуры/состояний RKLLMLoraAdapter
| Определение | RKLLMLoraAdapter |
|---|---|
| Описание | Параметры загрузки модели LoRA. |
| Поля структуры | const char* lora_adapter_path: путь к загружаемой LoRA. const char* lora_adapter_name: пользовательское имя LoRA для её выбора при инференсе. float scale: степень изменения параметров базовой модели моделью LoRA при инференсе. |
Пример загрузки LoRA:
RKLLMLoraAdapter lora_adapter;
memset(&lora_adapter, 0, sizeof(RKLLMLoraAdapter));
lora_adapter.lora_adapter_path = "lora.rkllm";
lora_adapter.lora_adapter_name = "lora_name";
lora_adapter.scale = 1.0;
ret = rkllm_load_lora(llmHandle, &lora_adapter);
if (ret != 0) {
   printf("\nload lora failed\n");
}
3.2.9 Загрузка Prompt Cache
Во время инференса этап Prefill обычно требует много вычислений и времени, особенно при длинном Prompt. RKLLM позволяет загружать Prompt Cache из файлов, повторно используя кэш и сокращая Prefill. Перед вызовом rkllm_run правильно настройте prompt_cache_params, чтобы после инференса модель создала соответствующий файл Prompt Cache. При первом выполнении система автоматически создаёт такой файл с промежуточными результатами Prefill, пригодными для последующих задач. В следующих вызовах ранее созданный файл загружается через rkllm_load_prompt_cache. Определения функций:
Таблица 3-26. Спецификация интерфейса rkllm_load_prompt_cache
| Функция | rkllm_load_prompt_cache |
|---|---|
| Описание | Загрузка файла Prompt Cache. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации; см. §3.2.4. const char* prompt_cache_path: путь к загружаемому Prompt Cache. |
| Возвращаемое значение | 0: файл Prompt Cache загружен; -1: ошибка загрузки. |
Таблица 3-27. Спецификация интерфейса rkllm_release_prompt_cache
| Функция | rkllm_release_prompt_cache |
|---|---|
| Описание | Освобождение Prompt Cache. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации; см. §3.2.4. |
| Возвращаемое значение | 0: модель Prompt Cache освобождена; -1: ошибка освобождения модели. |
Примечание: RKLLM определяет совпадающую с prompt_cache начальную часть входа. При фиксированном формате PROMPT_PREFIX + text + PROMPT_POSTFIX можно создать Prompt Cache только для PROMPT_PREFIX и после загрузки повторно использовать его результат. RKLLM поддерживает несколько файлов Prompt Cache: при необходимости загружайте соответствующий файл. При переключении на другой Prompt Cache или отказе от текущего явно вызовите rkllm_release_prompt_cache для освобождения.
Пример загрузки Prompt Cache:
// Initialize and set the Prompt Cache parameters, then call the run interface to generate the Prompt Cache file.

RKLLMPromptCacheParam prompt_cache_params;
// Whether to save the prompt cache
prompt_cache_params.save_prompt_cache = true;
// If you need to save the prompt cache, specify the absolute path of the cache file.
prompt_cache_params.prompt_cache_path = "/data/prompt_cache.bin";
rkllm_infer_params.prompt_cache_params = &prompt_cache_params;
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
rkllm_input.input_type = RKLLM_INPUT_PROMPT;
rkllm_input.prompt_input = (char *)prompt.c_str();
rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);
// Load the prompt cache file to reduce prefill time.
rkllm_load_prompt_cache(llmHandle, "./prompt_cache.bin");
if (ret != 0) {
   printf("\nload Prompt Cache failed\n");
}
rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);
3.2.10 Управление KV Cache
RKLLM позволяет вручную очищать KV cache как для одношагового, так и многошагового диалога. При keep_system_prompt=1 системная подсказка, если она есть, сохраняется; иначе очищается весь кэш. Определение:
Таблица 3-28. Спецификация интерфейса rkllm_clear_kv_cache
| Функция | rkllm_clear_kv_cache |
|---|---|
| Описание | Очистка KV cache. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации; см. §3.2.4. keep_system_prompt: сохранять ли system prompt (1 сохранить, 0 удалить). start_pos: начальный ID удаляемого KV cache, включительно; если не используется, вручную задайте nullptr. end_pos: конечный ID, не включается; если не используется, вручную задайте nullptr. Примечание: удаление KV cache по заданным позициям поддерживается только при приостановке инференса в одношаговом режиме. При заданном диапазоне [start_pos, end_pos) keep_system_prompt игнорируется и удаляется кэш этого диапазона. |
| Возвращаемое значение | 0: KV cache очищен; -1: ошибка очистки. |
3.2.11 Настройка шаблона диалога
Перед обработкой входного текста RKLLM автоматически разбирает и применяет шаблон из поля chat_template файла tokenizer_config.json модели HuggingFace. Для пользовательской настройки шаблон можно сбросить функцией ниже. system_prompt задаёт системную подсказку и поведение модели, prompt_prefix добавляется перед пользовательским вводом, prompt_postfix — после него. После сброса шаблона enable_thinking больше не действует: эту настройку нужно реализовать в своём Prompt. Определение:
Таблица 3-29. Спецификация интерфейса rkllm_set_chat_template
| Функция | rkllm_set_chat_template |
|---|---|
| Описание | Настройка шаблона Prompt. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации; см. §3.2.4. system_prompt: системная подсказка, направляющая поведение модели. prompt_prefix: префикс перед вводом пользователя. prompt_postfix: суффикс после ввода пользователя. |
| Возвращаемое значение | 0: шаблон диалога настроен; -1: ошибка настройки шаблона. |
3.2.12 Настройка Function Calling
RKLLM поддерживает структурированное взаимодействие модели с внешними системами через Function Calling. Это расширяет возможности LLM, в том числе дополнение знаний и точное получение данных. В этом режиме приложение передаёт определения функций модели; на основе запроса пользователя модель определяет необходимость вызова и выдаёт запрос в заданном формате. Приложение вызывает нужную функцию, возвращает результат, после чего модель продолжает диалог с учётом результата. Функция настройки Function Calling:
Таблица 3-30. Спецификация интерфейса rkllm_set_chat_template
| Функция | rkllm_set_function_tools |
|---|---|
| Описание | Настройка Function Calling, включая системную подсказку, определения инструментов и идентификатор ответа инструмента. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации; см. §3.2.4. system_prompt: системная подсказка для поведения модели. tools: строка определений функций в JSON, описывающая доступные функции, их имена, назначение и форматы параметров. tool_response_str: метка результатов вызовов инструментальных функций, отличающая их от обычного содержимого диалога. |
| Возвращаемое значение | 0: настройка успешна; -1: ошибка настройки. |
Пример: сначала настройте инструменты.
std::string system_prompt = "You are Qwen, created by Alibaba Cloud. You are a helpful assistant.\n\nCurrent Date: 2024-09-30";
std::string tools = R"([
   {
       "type": "function",
       "function": {
          "name": "get_current_temperature",
          "description": "Get current temperature at a location.",
          "parameters": {
             "type": "object",
             "properties": {
                 "location": {
                    "type": "string",
                    "description": "The location to get the temperature for, in the format \"City, State, Country\"."
                 },
                 "unit": {
                    "type": "string",
                    "enum": ["celsius", "fahrenheit"],
                    "description": "The unit to return the temperature in. Defaults to \"celsius\"."
                 }
             },
             "required": ["location"]
          }
       }
   },
   {
       "type": "function",
       "function": {
          "name": "get_temperature_date",
          "description": "Get temperature at a location and date.",
          "parameters": {
             "type": "object",
             "properties": {
                 "location": {
                    "type": "string",
                    "description": "The location to get the temperature for, in the format \"City, State, Country\"."
                 },
                 "date": {
                    "type": "string",
                    "description": "The date to get the temperature for, in the format \"Year-Month-Day\"."
                 },
                 "unit": {
                    "type": "string",
                    "enum": ["celsius", "fahrenheit"],
                    "description": "The unit to return the temperature in. Defaults to \"celsius\"."
                 }
             },
             "required": ["location", "date"]
          }
       }
   }
])";

rkllm_set_function_tools(llmHandle, system_prompt.c_str(),
tools.c_str(), "tool_response");
Затем свяжите эту настройку с rkllm_run для реализации цепочки вызовов функций:
// User's question
RKLLMInferParam rkllm_infer_params;
memset(&rkllm_infer_params, 0, sizeof(RKLLMInferParam));
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
rkllm_infer_params.keep_history = 0;

RKLLMInput rkllm_input;
rkllm_input.input_type = RKLLM_INPUT_PROMPT;
rkllm_input.enable_thinking = false;

rkllm_input.role = "user";
rkllm_input.prompt_input = "What's the temperature in San Francisco now? How about tomorrow?";

rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);

// the first call to rkllm_run will return the name of the tool function that needs to be called;

<tool_call>
{"name": "get_current_temperature", "arguments": {"location": "San Francisco"}}
</tool_call>
<tool_call>
{"name": "get_temperature_date", "arguments": {"location": "San Francisco", "date": "2024-10-01"}}
</tool_call>

// return the tool call result to llm, and the role must be set to "tool"

rkllm_input.role = "tool";
rkllm_input.prompt_input = R"([
   {
       "temperature": 26.1,
       "location": "San Francisco",
       "unit": "celsius"
   },
   {
       "temperature": 25.9,
       "location": "San Francisco",
       "date": "2024-09-30",
       "unit": "celsius"
   }
])";

rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);

// final result
"The current temperature in San Francisco is 26.1°C. Tomorrow, the temperature is expected to be 25.9°C."
3.2.13 Настройка перекрёстного внимания
RKLLM поддерживает cross-attention: созданные энкодером K/V cache, маску и позиционную информацию можно передать декодеру следующей функцией. Cross-attention поддерживается только при инференсе пользовательских моделей; преобразование модели описано в §3.1.6.
Таблица 3-31. Спецификация интерфейса rkllm_set_cross_attn_params
| Функция | rkllm_set_cross_attn_params |
|---|---|
| Описание | Настройка параметров cross-attention. |
| Параметры | LLMHandle handle: дескриптор, зарегистрированный при инициализации; см. §3.2.4. RKLLMCrossAttnParam* cross_attn_params: параметры cross-attention. |
| Возвращаемое значение | 0: настройка успешна; -1: ошибка настройки. |
Таблица 3-32. Описание структуры/состояний RKLLMCrossAttnParam
| Функция | RKLLMCrossAttnParam |
|---|---|
| Описание | Параметры cross-attention. |
| Поля структуры | - float* encoder_k_cache: указатель выходного кэша ключей энкодера - float* encoder_v_cache: указатель выходного кэша значений энкодера - float* encoder mask: маска внимания энкодера - int32_t* encoder_pos: позиционная информация входных токенов энкодера - int* num_tokens: число входных токенов энкодера |
3.2.14 Параллельный инференс нескольких пакетов
RKLLM поддерживает одновременный инференс нескольких пакетов; рекомендуется не более 8. Ниже приведён пример для двух пакетов:
- При инициализации модели param.extend_param.n_batch должен быть равен 2.
- При многопакетном инференсе RKLLMInput и RKLLMResult в callback — массивы размером n_batch.
- Результаты всех пакетов возвращаются синхронно в callback. Отрицательный идентификатор токена пакета означает завершение его инференса. Общее выполнение заканчивается только после завершения всех пакетов.
- При обработке текста в callback перед присваиванием проверяйте указатель на null.
#include <string.h>
#include <unistd.h>
#include <string>
#include "rkllm.h"
#include <fstream>
#include <iostream>
#include <csignal>
#include <vector>
using namespace std;
LLMHandle llmHandle = nullptr;
std::string output_texts[10];
int callback(RKLLMResult *result, void *userdata, LLMCallState state)
{
if (state == RKLLM_RUN_FINISH)
{
printf("\nrkllm run finish\n");
} else if (state == RKLLM_RUN_ERROR) {
printf("\nrkllm run error\n");
} else if (state == RKLLM_RUN_NORMAL) {
RKLLMResult batch1 = result[0];
RKLLMResult batch2 = result[1];
if (batch1.text) {
output_texts[0] += batch1.text;
printf("batch 0 %s\n", output_texts[0].c_str());
}
if (batch2.text) {
output_texts[1] += batch2.text;;
printf("batch 1 %s\n", output_texts[1].c_str());
}
}
return 0;
}
int main(int argc, char **argv)
{
if (argc < 4) {
std::cerr << "Usage: " << argv[0] << " model_path max_new_tokens max_context_len\n";
return 1;
}
RKLLMParam param = rkllm_createDefaultParam();
param.model_path = argv[1];
param.top_k = 1;
param.top_p = 0.95;
param.temperature = 0.8;
param.repeat_penalty = 1.1;
param.frequency_penalty = 0.0;
param.presence_penalty = 0.0;
param.max_new_tokens = std::atoi(argv[2]);
param.max_context_len = std::atoi(argv[3]);
param.skip_special_token = true;
param.extend_param.base_domain_id = 0;
param.extend_param.embed_flash = 1;
param.extend_param.n_batch = 2;
int ret = rkllm_init(&llmHandle, ¶m, callback);
if (ret == 0){
printf("rkllm init success\n");
} else {
printf("rkllm init failed\n");
exit_handler(-1);
}
RKLLMInput rkllm_input[2];
memset(&rkllm_input, 0, sizeof(RKLLMInput)*2);
RKLLMInferParam rkllm_infer_params;
memset(&rkllm_infer_params, 0, sizeof(RKLLMInferParam));
output_texts[0].clear();
output_texts[1].clear();
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
rkllm_infer_params.keep_history = 0;
rkllm_input[0].input_type = RKLLM_INPUT_PROMPT;
rkllm_input[0].role = "user";
rkllm_input[0].enable_thinking = false;
rkllm_input[0].prompt_input = "上联: 江边惯看千帆过";
rkllm_input[1].input_type = RKLLM_INPUT_PROMPT;
rkllm_input[1].role = "user";
rkllm_input[1].enable_thinking = false;
rkllm_input[1].prompt_input = "以咏梅为题目,帮我写一首古诗,要求包含梅花、白雪等元素。";
printf("robot: ");
rkllm_run(llmHandle, &rkllm_input[0], &rkllm_infer_params, NULL);
rkllm_destroy(llmHandle);
return 0;
}
3.2.15 Приостановка инференса модели
RKLLM позволяет приостановить одношаговый инференс, вернув 1 из callback. KV cache при этом не очищается: можно изменить входные данные и снова вызвать rkllm_run для продолжения.
3.2.16 Обратный вызов с данными производительности модели
По завершении одного инференса RKLLM может вернуть данные производительности: общее время Prefill и декодирования, число токенов и расход памяти. Структура возвращаемых данных:
Таблица 3-33. Описание структуры/состояний RKLLMPerStat
| Определение | RKLLMPerfStat |
|---|---|
| Описание | Возвращение данных производительности инференса модели. |
| Поля структуры | - float prefill_time_ms: суммарное время Prefill, миллисекунды - int prefill_tokens: общее число токенов Prefill - float generate_time_ms: суммарное время генерации, миллисекунды - int generate_tokens: общее число токенов генерации - float memory_usage_mb: расход памяти при инференсе, измеренный через VmHWM, мегабайты |
3.3 Пример инференса на плате
Каталог examples/rkllm_api_demo содержит C++-проект инференса на плате, обновляемый вместе с этим документом. Скрипты компиляции упрощают сборку проекта и выполнение RKLLM на плате.
3.3.1 Полный код примера проекта
Полный пример C++ находится в example/rkllm_api_demo/deploy/src инструментария. llm_demo.cpp показывает весь процесс инференса LLM: инициализацию, выполнение, обработку вывода через callback и освобождение ресурсов. Используйте соответствующий код как основу пользовательских функций.
3.3.2 Использование примера проекта
В examples/rkllm_api_demo/deploy находятся примеры вызова инференса и скрипты build-android.sh, build-linux.sh. Ниже описано использование примера на основе компиляции
исполняемых файлов Linux скриптом build-linux.sh. Сначала подготовьте кросс-компилятор: по §2.3 рекомендуется версия 10.2 или выше. Перед компиляцией самостоятельно замените путь к кросс-компилятору в build-linux.sh:
# Set the path of the cross-compiler GCC_COMPILER_PATH=~/gcc-arm-10.2-2020.11-x86_64-aarch64-none-linux-gnu/bin/aarch64-none-linux-gnu
Затем запустите компиляцию через build-linux.sh. Полученная программа llm_demo устанавливается в install/demo_linux_aarch64/llm_demo. После этого перенесите исполняемый файл, каталог библиотек и предварительно преобразованную и квантованную через RKLLM-Toolkit модель на плату.
adb push install/demo_Linux_aarch64  /data
adb push /PC/path/to/your/rkllm/model /data/demo_Linux_aarch64
После этих шагов войдите в терминал платы через adb, перейдите в /data/demo_linux_aarch64 и вызовите инференс следующей командой:
adb shell
cd /data/demo_linux_aarch64
export LD_LIBRARY_PATH=./lib
./llm_demo /path/to/your/rkllm/model 1024 2048
Эти операции открывают интерфейс примера инференса, где можно взаимодействовать с моделью на плате и получать результаты RKLLM в реальном времени.
3.3.3 Контроль производительности инференса и просмотр журналов
Для просмотра производительности или журналов RKLLM во время инференса на плате используются следующие команды:
# View only TTFT, TPS, and memory usage data
export RKLLM_LOG_LEVEL=1
# In addition to performance data, also prints cache length and more details
export RKLLM_LOG_LEVEL=2
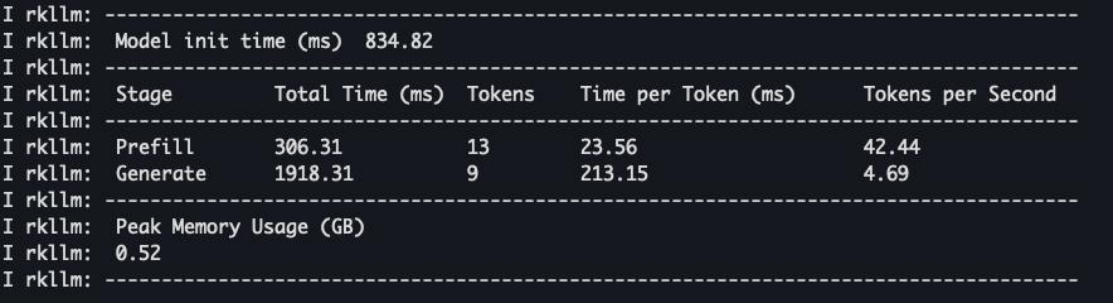
Копируемая расшифровка исходного журнала (не измерение ArmSoM; скрытая учётная запись не восстановлена):
Model initialization: 834.82 ms
Stage       Total Time (ms)  Tokens  Time per Token (ms)  Tokens per Second
Prefill     306.31           13      23.56                42.44
Generate    1918.31          9       213.15               4.69
Peak Memory Usage (GB): 0.52
Рисунок 3-1. Журнал производительности RKLLM на аппаратной платформе
3.4 Реализация сервера на плате
После преобразования модели через RKLLM-Toolkit можно развернуть сервер на плате Linux и предоставить сетевые интерфейсы пользователям локальной сети. Другие пользователи получают доступ к RKLLM по заданному адресу для простого и эффективного взаимодействия. В этом разделе описаны две реализации сервера.
1) RLM-Server-Flask на Flask: клиент и сервер взаимодействуют через API с HTTP-запросами. Пример RKLLM-Server-Flask включает обычный диалог и одношаговый диалог с Function Calling.
2) RKLLM-Server-Gradio на Gradio: пример позволяет быстро создать веб-сервер с визуальным взаимодействием и показывает Gradio API для дальнейшей разработки. Оба варианта находятся в examples/rkllm_server_demo. Каталог содержит код реализаций, скрипты развёртывания одной командой и примеры API-вызовов. Выберите нужный пример для изучения и расширения. Структура каталогов:
examples/rkllm_server_demo
├──rkllm_server          # Board-side Deployment Required Files
│   └── lib                    # RKLLM Runtime
│   └── flask_server.py            # RKLLM-Server-Flask Example
│   └── gradio_server.py           # RKLLM-Server-Gradio Example
├──build_rkllm_server_flask.sh # One-click Deployment Script -Flask
├──build_rkllm_server_gradio.sh# One-click Deployment Script -Gradio
├──chat_api_flask.py           # API Interface Example -Flask
├──chat_api_gradio.py          # API Interface Example -Gradio
└──Readme.md
3.4.1 Пример развёртывания RKLLM-Server-Flask
В примере RKLLM-Server-Flask сервер создаётся на Flask. Клиент использует структуру запрос–ответ для API-доступа, передавая серверу определённые структуры данных. Основное содержимое:
{
   "model": "No models available",
   "messages": [
     {"role": "system",
       "content": "You are a helpful assistant."
     },
     {
       "role": "user",
       "content": "Hello!"
     }
   ],
   "stream": false,
   "enable_thinking": False,
   "tools": None

}
Поля “model” и “stream” задают вызываемую модель и включение потоковой передачи инференса; “content” внутри “messages” содержит пользовательский ввод. “enable_thinking” задаёт глубокое рассуждение при ответе и настраивается с учётом поддержки моделью. “tools” описывает пользовательскую функцию для Function Calling (правила определения см. §3.4.1.3.2). Этот параметр также зависит от поддержки Function Calling моделью; если функция не поддерживается или не используется, задайте “None”.
Структура возвращаемых сервером данных зависит от выбора потокового режима. При непотоковом инференсе возвращаются следующие данные:
{
  "id": "chatcmpl-123",
  "object": "chat.completion",
  "created": 1677652288,
  "model": "gpt-3.5-turbo-0125",
  "system_fingerprint": "fp_44709d6fcb",
  "choices": [{
   "index": 0,
   "message": {
     "role": "assistant",
     "content": "\n\nHello there, how may I assist you today?",},
   "logprobs": null,
   "finish_reason": "stop"
  }],
  "usage": {
   "prompt_tokens": 9,
   "completion_tokens": 12,
   "total_tokens": 21
  }
}
В непотоковом режиме главное содержимое — “messages” в “choices”: это результат инференса модели. В потоковом режиме сервер возвращает объект Response с результатами модели в разные моменты выполнения. Содержимое данных каждого момента:
{
"id": "chatcmpl-123",
  "object": "chat.completion.chunk",
  "created": 1677652288,
  "model": "gpt-3.5-turbo-0125",
  "system_fingerprint": "fp_44709d6fcb",
  "choices": [{
   "index": 0,
   "delta": {
     "role": "assistant",
     "content": "\n\nHello there, how may I assist you today?",},
   "logprobs": null,
   "finish_reason": "stop"
  }]
}
В потоковых данных отслеживайте раздел “delta” внутри “choices”. Пустое значение “finish_reason” (None) означает, что модель ещё выполняет инференс и не завершила генерацию. Только когда “finish_reason”
возвращает “stop”, потоковый инференс считается завершённым. В коде развёртывания RKLLM-Server-Flask и примерах API одинаково определена структура передаваемых данных, что обеспечивает универсальность сервера. Далее отдельно рассматриваются скрипт развёртывания одной командой, важные настройки серверной реализации и клиентские API-скрипты.
3.4.1.1 Сервер: скрипт развёртывания RKLLM-Server-Flask одной командой
Скрипт build_rkllm_server_flask.sh в rkllm_server_demo позволяет быстро развернуть RKLLM-Server-Flask на Linux-плате. Перед его использованием учтите следующее:
1) Подключите плату к сети Ethernet-кабелем. В adb shell вызовите ifconfig и определите её IP-адрес. RKLLM-Server-Flask использует этот адрес для сервера в локальной сети и доступа клиентов.
2) Заранее успешно преобразуйте RKLLM-модель и перенесите её на Linux-плату. Скрипт build_rkllm_server_flask.sh запускается непосредственно на ПК, а не на плате, и быстро развёртывает сервер на плате. Использование:
./build_rkllm_server_flask.sh
   --workshop [RKLLM-Server Working Path]
   --model_path [Absolute Path of Converted RKLLM Model on Board] --platform [Target Platform: RK3588/RK3576/RK3562/RV1126B]
   [--lora_model_path [LoRA Model Path]]
   [--prompt_cache_path [Prompt Cache File Path]]
Параметр workshop задаёт рабочий каталог RKLLM-Server-Flask на плате; model_path — абсолютный путь преобразованной RKLLM-Toolkit модели, которую сервер читает из этого
пути при выполнении. platform — текущая платформа: RK3588, RK3576, RK3562 или RV1126B. Необязательные lora_model_path и prompt_cache_path задают пути для загрузки LoRA или использования Prompt. Простой пример запуска build_rkllm_server_flask.sh:
./build_rkllm_server_flask.sh
   --workshop /path/to/workshop
   --model_path /path/to/model.rkllm
   --platform rk3588
После запуска команды скрипт выполнит следующие шаги:
1) Проверит среду Linux на плате.
2) Автоматически установит Flask, если библиотека ещё не установлена.
3) Передаст необходимые файлы rkllm_server_demo/rkllm_server на плату.
4) Найдёт RKLLM-модель в заданном рабочем каталоге RKLLM-Server-Flask. Сообщение “RKLLM Model has been initialized successfully!” в терминале означает успешный запуск примера RKLLM-Server-Flask.
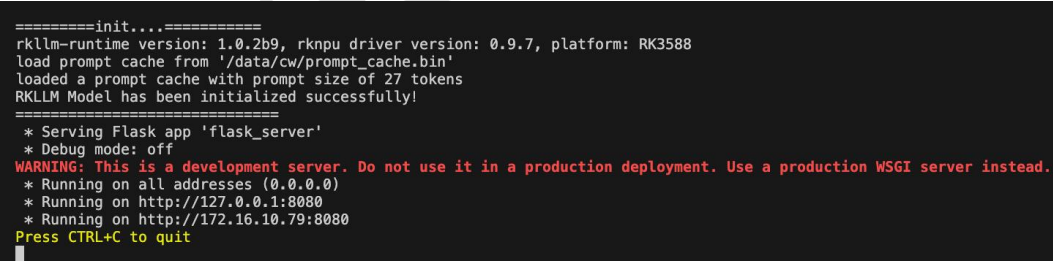
Копируемая расшифровка исходного журнала (не измерение ArmSoM; скрытая учётная запись не восстановлена):
=========init....===========
rkllm-runtime version: 1.0.2b9, rknpu driver version: 0.9.7, platform: RK3588
load prompt cache from '/data/cw/prompt_cache.bin'
loaded a prompt cache with prompt size of 27 tokens
RKLLM Model has been initialized successfully!
===========================
 * Serving Flask app 'flask_server'
 * Debug mode: off
WARNING: This is a development server. Do not use it in a production deployment. Use a production WSGI server instead.
 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:8080
 * Running on http://172.16.10.79:8080
Press CTRL+C to quit
Рисунок 3-2. Успешный запуск RKLLM-Server-Flask в терминале. По коду build_rkllm_server_flask.sh можно изучить процесс развёртывания и гибко адаптировать собственный сервер. Важно: на шаге 3 скрипт автоматически синхронизирует текущую RKLLM Runtime в rkllm_server/lib/librkllmrt.so. Поэтому flask_server.py во время работы вызывает текущую librkllmrt.so.
3.4.1.2 Сервер: реализация примера RKLLM-Server-Flask
Ниже описана реализация примера RKLLM-Server-Flask, чтобы упростить понимание и дальнейшую разработку. Сервер реализован в основном библиотекой Flask; Python ctypes напрямую вызывает библиотеку RKLLM Runtime для инференса. В rkllm_server/flask_server.py для обращения к librkllmrt.so через ctypes необходимо заранее определить Python-структуры по заголовку rkllm.h соответствующей библиотеки. Получив структуру данных пользователя, Flask вызывает функции инференса RKLLM. Основные шаги реализации flask_server.py:
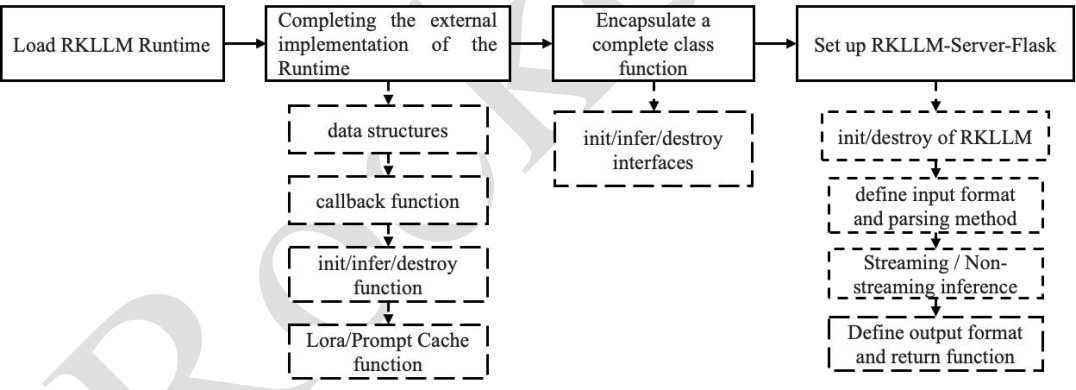
Рисунок 3-3. Процесс реализации развёртывания RKLLM-Server-Flask
1) Загрузка RKLLM Runtime: задайте путь к динамической библиотеке и загрузите librkllmrt.so через ctypes для разбора RKLLM Runtime.
2) Внешняя реализация Runtime: в Python через ctypes определите реализации из заголовков RKLLM Runtime, включая структуры данных, callback, инициализацию, инференс, освобождение и функции загрузки LoRA/Prompt Cache.
3) Инкапсуляция полного класса: на основе типов Runtime и функциональных
интерфейсов шага 2) создайте полный класс, объединяющий инициализацию RKLLM, инференс, освобождение и другие операции для удобства дальнейших вызовов.
4) Настройка RKLLM-Server-Flask: используйте класс шага 3 для построения Flask-сервера. При запуске загрузите модель по параметрам пользователя; определите формат и разбор входа, потоковый/непотоковый инференс, формат результата и callback, а также освобождение RKLLM. Реализации этих модулей образуют основной код rkllm_server/flask_server.py и завершают развёртывание примера. Для разных пользовательских моделей можно менять определения инициализации RKLLM. Этот пример также служит основой собственных серверов.
3.4.1.3 Клиент: пример доступа через API
Файл rkllm_server_demo/chat_api_flask.py содержит обычный диалог (основной код main_demo1) и одношаговый диалог с Function Calling (основной код main_demo2).
3.4.1.3.1 Пример 1 — обычный диалог
Это обычный вопросно-ответный диалог. Подробный порядок работы:
1) Задайте сетевой адрес RKLLM-Server-Flask по IP Linux-платы, порту Flask и имени вызываемой функции.
server_url = 'http://172.16.10.xx:8080/rkllm_chat'
2) Выберите режим API: непотоковая или потоковая передача; по умолчанию непотоковая.
main_demo1(is_streaming=True)
3) Создайте объект сеанса requests.Session() для настройки связи API с сервером. Пользователи могут менять его по требованиям разработки.
session = requests.Session()
session.keep_alive = False  # Close the connection pool
adapter = requests.adapters.HTTPAdapter(max_retries=5)
session.mount('https://', adapter)
session.mount('http://', adapter)
4) Определите структуру данных, отправляемых через API. Доступ к RKLLM-Server-Flask инкапсулируется в этой структуре.
# Prepare the data to be sent
# model: the model defined by the user when setting up RKLLM-Server, which has no effect here
# messages: the questions input by the user; supports adding multiple questions to messages
# stream: whether to enable streaming dialogue, same as the OpenAI interface
# enable_thinking: whether to enable deep thinking
# tools: user's description of custom functions
data = {
   "model": 'your_model_deploy_with_RKLLM_Server',
   "messages": [{"role": "user", "content": user_message}],
   "stream": is_streaming,
   "enable_thinking": False,
   "tools": None
}
5) Отправьте запрос серверу RKLLM-Server-Flask и получите ответ.
responses = session.post(server_url, json=data, headers=headers,
stream=is_streaming, verify=False)
6) Определите способ разбора структуры ответа.
# Parse the response
# Non-streaming transmission
if not is_streaming:
       if responses.status_code == 200:
       print("Q:", data["messages"][-1]["content"])
       print("A:", json.loads(responses.text)["choices"][-1]["message"]["content"])
   else:
       print("Error:", responses.text)

# Streaming transmission
else:
   if responses.status_code == 200:
       print("Q:", data["messages"][-1]["content"])
       print("A:", end="")
       for line in responses.iter_lines():
if line:
             line = json.loads(line.decode('utf-8'))
             if line["choices"][-1]["finish_reason"] != "stop":
                 print(line["choices"][-1]["delta"]["content"], end="")

                 sys.stdout.flush()
   else:
       print('Error:', responses.text)
Шаги 1–6 показывают API-доступ к RKLLM-Server-Flask и могут служить основой пользовательских функций. Обязательно проверьте адрес сервера: IP, порт и имя интерфейса входа. При особых требованиях к обмену согласованно измените структуры данных клиента и сервера для реализации нужных функций.
3.4.1.3.2 Пример 2 — одношаговый диалог с Function Calling
LLM не знает информации, отсутствовавшей в обучающих данных, включая события после обучения. Кроме того, вероятностное обучение может быть недостаточно точным для задач со строгими правилами, например математических вычислений. Function Calling позволяет автоматически запрашивать заранее определённые функции по запросу пользователя и получать более точную актуальную информацию. Здесь используется пример погоды: пользователь спрашивает текущую температуру и температуру завтра в Сан-Франциско. Обычно модель не может ответить на такой запрос реального времени, но у
пользователя есть две функции: получение текущей температуры города и температуры на заданную дату. Модель должна воспользоваться обеими для точного ответа.
1) Задайте адрес RKLLM-Server-Flask по IP Linux-платы, порту Flask и имени вызываемой функции.
server_url = 'http://172.16.10.166:8080/rkllm_chat'
2) Выберите режим API: непотоковая или потоковая передача; по умолчанию непотоковая.
main_demo2(is_streaming=True)
3) Создайте объект сеанса requests.Session() для настройки связи API с сервером. Пользователи могут менять его по требованиям разработки.
session = requests.Session()
session.keep_alive = False
adapter = requests.adapters.HTTPAdapter(max_retries=5)
session.mount('https://', adapter)
session.mount('http://', adapter)
4) Определите функции для LLM: get_current_temperature возвращает текущую температуру заданного города, get_temperature_date — температуру заданного города на заданную дату.
def get_current_temperature(location: str, unit: str = "celsius"):
       """
       Get current temperature at a location.

       Args:
          location: The location to get the temperature for, in the
format "City, State, Country".
          unit: The unit to return the temperature in. Defaults to
"celsius". (choices: ["celsius", "fahrenheit"])

       Returns:
          the temperature, the location, and the unit in a dict
       """
       return {
          "temperature": 26.1,
          "location": location,
          "unit": unit,
       }

def get_temperature_date(location: str, date: str, unit: str =
"celsius"):
       """
       Get temperature at a location and date.

       Args:
          location: The location to get the temperature for, in the
format "City, State, Country".
          date: The date to get the temperature for, in the format
"Year-Month-Day".
          unit: The unit to return the temperature in. Defaults to
"celsius". (choices: ["celsius", "fahrenheit"])

       Returns:
          the temperature, the location, the date and the unit in a
dict
       """
       return {
          "temperature": 25.9,
          "location": location,
          "date": date,
          "unit": unit}
5) Определите описание пользовательской функции. В примере TOOLS содержит описания двух функций. Каждое описание — JSON-объект с двумя полями:
- type: строка типа инструмента; пока допустимо только “function”;
- function: объект с подробным описанием функции и тремя полями: name — строка имени функции, description — строка назначения, parameters — JSON Schema (https://json-schema.org/learn/getting-started-step-by-step) для
описания принимаемых параметров. Построение JSON Schema описано по ссылке; обратите внимание на type, required и enum.
TOOLS = [
       {
          "type": "function",
          "function": {
             "name": "get_current_temperature",
             "description": "Get current temperature at a location.",
             "parameters": {
                 "type": "object",
                 "properties": {
                    "location": {
                       "type": "string",
                       "description": 'The location to get the temperature for, in the format "City, State, Country".',
                    },
                    "unit": {
                       "type": "string",
                       "enum": ["celsius", "fahrenheit"],
                       "description": 'The unit to return the temperature in. Defaults to "celsius".',
                    },
                 },
                 "required": ["location"],
             },
          },
       },
       {
          "type": "function",
          "function": {
             "name": "get_temperature_date",
             "description": "Get temperature at a location and date.",
             "parameters": {
                 "type": "object",
                 "properties": {
                    "location": {
                       "type": "string",
                       "description": 'The location to get the temperature for, in the format "City, State, Country".',
                    },
                    "date": {
                       "type": "string",
                       "description": 'The date to get the temperature for, in the format "Year-Month-Day".',
                    },
                    "unit": {
                       "type": "string",
                       "enum": ["celsius", "fahrenheit"],
                       "description": 'The unit to return the temperature in. Defaults to "celsius".',
                    },
                 },
                 "required": ["location", "date"],
             },
          },
       },
   ]
6) Определите структуру отправляемых данных API. Доступ пользователя
к RKLLM-Server-Flask включается в эту структуру; начните первый вызов LLM.
# Prepare the data to be sent
# model: The model defined by the user when setting up RKLLM-Server, which has no effect here
# messages: Questions entered by the user; this example only supports one question, i.e., a single round of dialogue
# stream: Whether to enable streaming dialogue
# enable_thinking: Whether to enable deep thinking
# tools: User description of custom functions

messages = [
   {"role": "system", "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant.\n\nCurrent Date: 2024-09-30"},
   {"role": "user",  "content": "What's the temperature in San Francisco now? How about tomorrow?"},
   ]

data = {
       "model": 'your_model_deploy_with_RKLLM_Server',
       "messages": messages,
       "stream": False,
       "enable_thinking": False,
       "tools": TOOLS
   }

# Send a POST request
responses = session.post(server_url, json=data, headers=headers,
stream=False, verify=False)
Первый вызов LLM возвращает параметры пользовательской функции:
server_answer = json.loads(responses.text)["choices"][-1]["message"]["content"]
matches = re.findall(r"<tool_call>\s*(\{.*?\})\s*</tool_call>",
''.join(server_answer), re.DOTALL)
print("server_answer:", server_answer, '\n')

'''
The following is the output of print("server_answer:", server_answer,
'\n')

server_answer: <tool_call>
{"name": "get_current_temperature", "arguments": {"location": "San Francisco"}}
</tool_call>
<tool_call>
{"name": "get_temperature_date", "arguments": {"location": "San Francisco", "date": "2024-10-01"}}
</tool_call>
'''
7) Разберите ответ LLM, сформируйте вход для второго вызова и вызовите LLM повторно.
result = [json.loads(match) for match in matches]
for function_call in result:
   messages.append({'role': 'assistant', 'content': '',
'function_call':function_call})

tool_calls = [{'function': result[i]} for i in range(len(result))]
function_call = []
for tool_call in tool_calls:
   if fn_call := tool_call.get("function"):
       fn_name: str = fn_call["name"]
       fn_args: dict = fn_call["arguments"]
       fn_res: str = json.dumps(get_function_by_name(fn_name)(**fn_args))
       messages.append({'role': 'tool', 'name': fn_name,
'content':fn_res})

print("messages:", messages, '\n')

'''
The following is the output of print("messages:", messages, '\n')

messages: [{'role': 'system', 'content': 'You are Qwen, created by
Alibaba Cloud. You are a helpful assistant.\n\nCurrent Date: 2024-09-30'}, {'role': 'user', 'content': "What's the temperature in San Francisco now? How about tomorrow?"}, {'role': 'assistant', 'content':
'', 'function_call': {'name': 'get_current_temperature', 'arguments':
{'location': 'San Francisco'}}}, {'role': 'assistant', 'content': '',
'function_call': {'name': 'get_temperature_date', 'arguments':
{'location': 'San Francisco', 'date': '2024-10-01'}}}, {'role': 'tool',
'name': 'get_current_temperature', 'content': '{"temperature": 26.1,
"location": "San Francisco", "unit": "celsius"}'}, {'role': 'tool',
'name': 'get_temperature_date', 'content': '{"temperature": 25.9,
"location": "San Francisco", "date": "2024-10-01", "unit":
"celsius"}'}]
'''

data = {
"model": 'your_model_deploy_with_RKLLM_Server',
"messages": messages,
"stream": is_streaming,
"enable_thinking": False,
"tools": TOOLS
}

# Send a POST request
responses = session.post(server_url, json=data, headers=headers,
stream=is_streaming, verify=False)
8) Разберите структуру ответа второго вызова, чтобы получить окончательный ответ о текущей и завтрашней температуре в Сан-Франциско.
if not is_streaming:
       # Parse the response
       if responses.status_code == 200:
          print("A:", json.loads(responses.text)["choices"][-1]["message"]["content"])
       else:
          print("Error:", responses.text)
else:
   if responses.status_code == 200:
       print("A:", end="")
       for line in responses.iter_lines():
       if line:
          line = json.loads(line.decode('utf-8'))
          if line["choices"][-1]["finish_reason"] != "stop":
             print(line["choices"][-1]["delta"]["content"], end="")
             sys.stdout.flush()
   else:
       print('Error:', responses.text)

'''
The following is the output of print()

A:The current temperature in San Francisco is 26.1°C. Tomorrow, the temperature is expected to be 25.9°C.
'''
Шаги 1–8 — пример Function Calling с RKLLM-Server-Flask как бэкендом. По нему можно создавать пользовательские функции. Убедитесь, что выбранная LLM поддерживает Function Calling. У моделей с ограниченными возможностями, например Qwen3-0.6B, функция может не сработать: модель после первого вызова может неточно вернуть параметры пользовательских функций.
3.4.2 Пример развёртывания RKLLM-Server-Gradio
Gradio — простая Python-библиотека для быстрого построения интерактивных интерфейсов машинного обучения. Здесь показано быстрое развёртывание RKLLM-Server-Gradio на Linux-устройстве и прямой доступ к модели для инференса в локальной сети. На рисунке ниже — веб-интерфейс после успешного развёртывания.
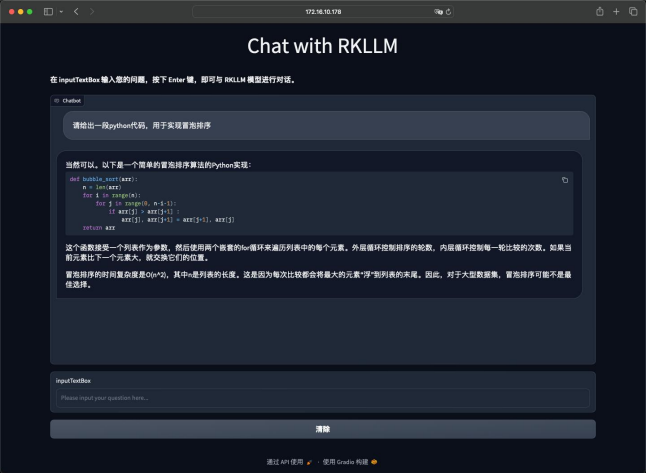
Рисунок 3-4. Внешняя страница доступа к примеру RKLLM-Server. Каталог rkllm_server_demo содержит код RKLLM-Server-Gradio, показанного на рисунке 3-3. Для быстрого развёртывания можно напрямую использовать build_rkllm_server_gradio.sh. После успешного запуска инференс RKLLM доступен через веб-интерфейс или API.
3.4.2.1 Сервер: реализация примера RKLLM-Server-Gradio
Скрипт build_rkllm_server_gradio.sh предназначен для быстрого развёртывания RKLLM-Server-Gradio на Linux-плате. Как и для RKLLM-Server-Flask, перед его использованием учтите следующее:
1) Подключите плату к сети Ethernet-кабелем. В adb shell командой ifconfig определите IP-адрес. RKLLM-Server-Gradio использует этот адрес для сервера локальной сети и клиентских подключений.
2) До запуска скрипта успешно преобразуйте модель RKLLM и передайте её на Linux-плату.
Использование build_rkllm_server_gradio.sh аналогично build_rkllm_server_flask.sh:
./build_rkllm_server_gradio.sh
   --workshop [RKLLM-Server Working Path]
   --model_path [Absolute Path of Converted RKLLM Model on Board] --platform [Target Platform: RK3588/RK3576/RK3562/RV1126B]
   [--lora_model_path [LoRA Model Path]]
   [--prompt_cache_path [Prompt Cache File Path]]
workshop задаёт рабочий каталог RKLLM-Server-Gradio на устройстве; model_path — абсолютный путь преобразованной RKLLM-Toolkit модели, читаемой сервером во время работы; platform — тип платформы, например RK3588, RK3576, RK3562 или RV1126B. Необязательные lora_model_path и prompt_cache_path задают файлы LoRA и Prompt. Для быстрого развёртывания вызовите build_rkllm_server_gradio.sh следующей командой на ПК, не на плате:
./build_rkllm_server_gradio.sh
   --workshop /user/data
   --model_path /user/data/model.rkllm
   --platform rk3588
После запуска команды скрипт выполнит следующие шаги:
1) Проверит среду Linux на плате.
2) Автоматически установит Gradio, если библиотека ещё не установлена.
3) Передаст необходимые файлы rkllm_server_demo/rkllm_server на плату.
4) Найдёт модель RKLLM в заданном рабочем каталоге RKLLM-Server-Gradio. Сообщение “RKLLM Model has been initialized successfully!” в терминале означает успешный запуск примера.
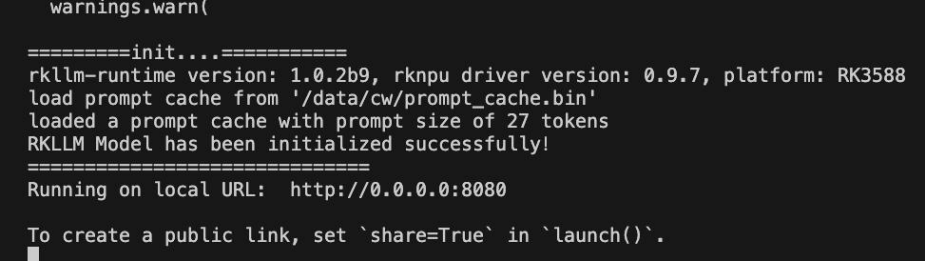
Копируемая расшифровка исходного журнала (не измерение ArmSoM; скрытая учётная запись не восстановлена):
warnings.warn(
=========init....===========
rkllm-runtime version: 1.0.2b9, rknpu driver version: 0.9.7, platform: RK3588
load prompt cache from '/data/cw/prompt_cache.bin'
loaded a prompt cache with prompt size of 27 tokens
RKLLM Model has been initialized successfully!
===========================
Running on local URL:  http://0.0.0.0:8080
To create a public link, set `share=True` in `launch()`.
Рисунок 3-5. Успешный запуск RKLLM-Server-Gradio в терминале. По коду build_rkllm_server_gradio.sh можно изучить развёртывание и гибко создавать собственные серверы. Важно: на шаге 3 скрипт автоматически синхронизирует текущую RKLLM Runtime в rkllm_server/lib/librkllmrt.so. Поэтому gradio_server.py при работе ссылается на эту librkllmrt.so; это нужно учитывать при настройке сервера.
3.4.2.2 Сервер: реализация примера RKLLM-Server-Gradio
Реализация RKLLM-Server-Gradio аналогична RKLLM-Server-Flask: ctypes напрямую вызывает библиотеку RKLLM Runtime для инференса модели. Конкретный процесс показан на рисунке ниже:
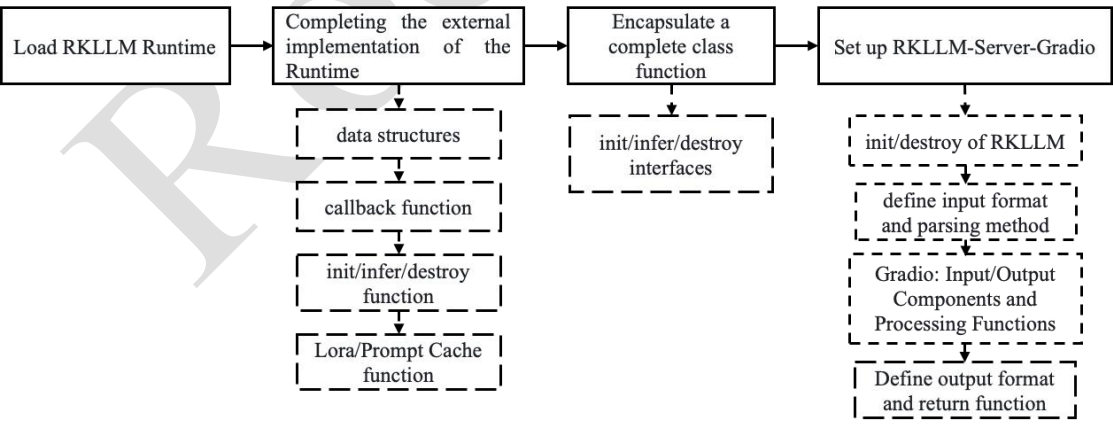
Рисунок 3-6. Процесс реализации развёртывания RKLLM-Server-Flask (так в английском оригинале). Отличие состоит в использовании gradio для сервера и связи с клиентом через простой веб-сервис. Интерфейс Gradio в RKLLM-Server-Gradio требует следующей обработки:
1) Библиотека Gradio полностью реализует передачу входных и выходных данных, поэтому сложную серверную обработку ввода-вывода через Flask определять не нужно.
2) Gradio использует разные управляющие элементы. Для интерфейса вызывайте компоненты Gradio и задавайте условия срабатывания каждого элемента, логику вызова функций и поток данных между компонентами.
Основной код rkllm_server/gradio_server.py показывает реализацию. Изменение инициализации RKLLM позволяет использовать разные модели. Пример RKLLM-Server-Gradio также служит основой собственного развёртывания сервера.
3.4.2.3 Клиент: использование RKLLM-Server-Gradio
После успешного развёртывания RKLLM-Server-Gradio на Linux-плате доступны два способа: интерфейс и API.
1) Интерфейс: после успешного запуска скриптом откройте браузер на любом ПК локальной сети и перейдите к board_IP:8080, например 172.16.10.178:8080 (рисунок 3-2 оригинала). Так можно быстро взаимодействовать с моделью. Gradio автоматически поддерживает Markdown, HTML и другие синтаксисы, адаптируя вывод, включая код и Markdown-текст. При создании RKLLM-Server запускается очередь: запросы нескольких пользователей обрабатываются и возвращаются по порядку поступления. Пока текущий запрос пользователя выполняется (диалог выделен), сервер не принимает следующий ввод этого пользователя.
2) API: в rkllm_server_demo предоставлен chat_api_gradio.py. После установки gradio_client на ПК (pip install gradio_client) доступ к RKLLM-Server возможен только через API, без графического интерфейса, как показано на
следующем рисунке. Перед использованием chat_api_gradio.py замените IP-адрес в коде текущим IP платы, как в следующем примере.
from gradio_client import Client
client = Client("http://172.16.10.xx:8080/")
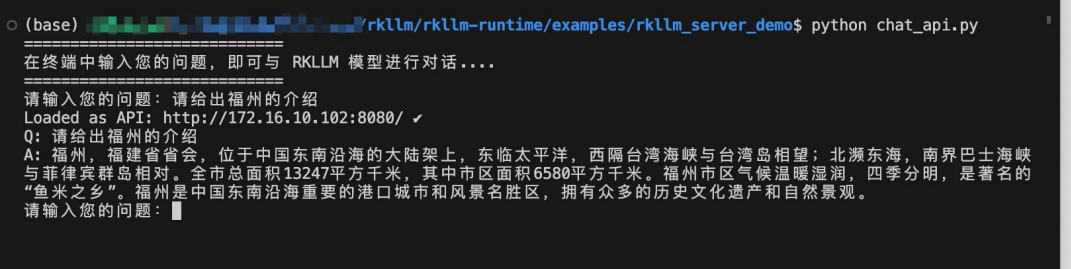
Копируемая расшифровка исходного журнала (не измерение ArmSoM; скрытая учётная запись не восстановлена):
(base) [原图已模糊 / blurred in original]/rkllm/rkllm-runtime/examples/rkllm_server_demo$ python chat_api.py
===========================
在终端中输入您的问题,即可与 RKLLM 模型进行对话....
===========================
请输入您的问题: 请给出福州的介绍
Loaded as API: http://172.16.10.102:8080/ ✓
Q: 请给出福州的介绍
A: 福州,福建省省会,位于中国东南沿海的大陆架上,东临太平洋,西隔台湾海峡与台湾岛相望;北濒东海,南界巴士海峡与菲律宾群岛相对。全市总面积13247平方千米,其中市区面积6580平方千米。福州市气候温暖湿润,四季分明,是著名的“鱼米之乡”。福州是中国东南沿海重要的港口城市和风景名胜区,拥有众多的历史文化遗产和自然景观。
请输入您的问题:
Рисунок 3-7. Вызов RKLLM-Server-Gradio через API в терминале. Выберите подходящий способ: для интерактивных сервисов локальной сети рекомендуется интерфейс; для настройки поведения доступа — API и дальнейшая разработка. Важно: RKLLM-Server-Gradio не определяет структуры отправки и получения данных по образцу OpenAI-API, поэтому эта реализация несовместима с интерфейсом OpenAI-API. Для расширения изучите реализацию chat_api_gradio.py. Если нужна совместимость с OpenAI-API, используйте реализацию RKLLM-Server-Flask.
4 Связанные материалы
RKLLM: https://github.com/airockchip/rknn-llm
RKNN: https://github.com/airockchip/rknn-toolkit2
Указатель ссылок оригинала
developer.arm.com: 10-2-2020-11