
Der vollständige technische Text folgt RKLLM SDK 1.2.3. Chinesisch basiert auf dem chinesischen PDF, Englisch auf dem englischen PDF; Russisch und Deutsch übersetzen den englischen Haupttext vollständig. Chinesisch verwendet chinesische Originalabbildungen, die übrigen Sprachen englische Originalabbildungen. Beide PDFs tragen Version 1.2.3, unterscheiden sich aber in Beispielgestaltung, Kommentaren und einzelnen Beschreibungen; sie wurden nicht stillschweigend vermischt. Die Quelle nennt RK3576, RK3588, RK3562 und RV1126B, die Prüfung von RKNPU 0.9.8 sowie Linux 5.10.209/6.1.84, GCC 10.2 und Android NDK. Dies ist nur eine Referenz zur ArmSoM-Plattformanpassung: Konkrete Platine, SDK/BSP, Kernel und Modellkombination sind nicht verifiziert. Hardwaretests und Messungen wurden nicht durchgeführt. „Neueste“ bezeichnet den Versionskontext der Quelle, nicht den aktuellsten Stand.
Hinweis zu Originalbeispielen: Python-Einrückungen, eine vollbreite Klammer, gemischte JSON/Python-Konstanten, Schnittstellentypen und Querverweise enthalten offene Fragen; siehe Korrekturprotokoll. Die Beispiele sind nicht als direkt lauffähig bestätigt. verify=False deaktiviert die Zertifikatsprüfung, trust_remote_code=True erlaubt externen Code, chmod 777 erweitert Rechte. Treiberaustausch, Kernel-Flashen, Bindung an 0.0.0.0 und öffentliche Freigabe mit share=True sind gesondert zu prüfen. Originalprotokolle zeigen Runtime 1.0.2b9 / driver 0.9.7 und weichen damit vom Haupttext ab; sie sind keine ArmSoM-Messungen.
ArmSoM Docs · RKLLM · EDITORIAL-NOTES
1 Einführung in RKLLM
1.1 RKLLM-Werkzeugkette
1.1.1 Einführung in RKLLM-Toolkit
RKLLM-Toolkit ist ein Entwicklungskit zur Quantisierung und Konvertierung großer Sprachmodelle auf dem PC. Über die bereitgestellte Python-Schnittstelle stehen folgende Funktionen zur Verfügung:
1) Modellkonvertierung: LLMs im Hugging-Face- oder GGUF-Format werden in RKLLM-Modelle konvertiert. Unterstützte Modelle: LLaMA, Qwen, Qwen2, Qwen3, Qwen2-VL, Qwen3-VL, Phi-2, Phi-3, ChatGLM3, Gemma, Gemma2, Gemma3, Gemma3n, InternLM2, TeleChat2, MiniCPM-S, MiniCPM, MiniCPM3, MiniCPM4, DeepSeekOCR, InternVL3. Die konvertierten RKLLM-Modelle können auf Rockchip-NPU-Plattformen geladen und verwendet werden.
2) Quantisierung: Umwandlung von Gleitkomma- in Festkommamodelle. Unterstützt werden:
a. w4a16;
b. gruppiertes w4a16 (Gruppengrößen 32, 64, 128);
c. w8a8;
d. gruppiertes w8a8 (Gruppengrößen 128, 256, 512).
1.1.2 Einführung in RKLLM Runtime
RKLLM Runtime lädt die mit RKLLM-Toolkit konvertierten Modelle und führt die Inferenz über die Rockchip NPU aus. Während der Modellinferenz können Benutzer Inferenzparameter und Textgenerierungsverfahren festlegen und die Ergebnisse über zuvor definierte Callback-Funktionen abrufen.
1.2 RKLLM-Entwicklungsablauf
Der RKLLM-Entwicklungsablauf besteht hauptsächlich aus zwei Phasen: Modellkonvertierung auf dem PC sowie Bereitstellung und Ausführung auf der Platine:
1) Modellkonvertierung auf dem PC. Ein LLM im Hugging-Face-Format wird für effiziente Inferenz auf der Rockchip NPU in RKLLM konvertiert. Schritte:
a. Modellbeschaffung:
- quelloffenes LLM im Hugging-Face-Format;
- selbst trainiertes Modell, dessen gespeicherte Struktur mit Modellen auf der Hugging-Face-Plattform übereinstimmt;
- GGUF-Modell, derzeit nur q4_0 und fp16.
b. Hugging-Face-Modelle mit rkllm.load_huggingface(), GGUF-Modelle mit rkllm.load_gguf() laden.
c. Quantisierung konfigurieren: rkllm.build() erstellt das RKLLM-Modell, optional mit Quantisierung für die Hardwarebereitstellung. Optimierungsstufe und Quantisierungstyp können dabei gewählt werden.
d. Mit rkllm.export_rkllm() als .rkllm-Datei zur späteren Bereitstellung exportieren.
2) Bereitstellung und Ausführung auf der Platine. Diese Phase umfasst die tatsächliche Bereitstellung und Ausführung des Modells, üblicherweise mit folgenden Schritten:
a. Modellinitialisierung: RKLLM-Modell auf der Rockchip NPU laden, Parameter für die gewünschte Textgenerierung konfigurieren und Callback-Funktionen für Echtzeitergebnisse vorab definieren.
b. Modellinferenz: Eingabedaten an das Modell übergeben und
die Modellinferenz ausführen. Über vorab definierte Callback-Funktionen werden fortlaufend Ergebnisse abgerufen.
c. Modellfreigabe: Nach Abschluss der Inferenz Modellressourcen freigeben, damit andere Aufgaben die NPU-Rechenressourcen nutzen können.
Diese beiden Phasen bilden den vollständigen RKLLM-Entwicklungsablauf für Konvertierung, Debugging und effiziente Bereitstellung von LLMs auf der Rockchip NPU.
1.3 Unterstützte Hardwareplattformen
Die in diesem Dokument behandelten Hardwareplattformen sind hauptsächlich RK3576, RK3588, RK3562 und RV1126B.
2 Vorbereitung der Entwicklungsumgebung
Das RKLLM-Werkzeugkettenarchiv enthält das whl-Installationspaket von RKLLM-Toolkit, Dateien der RKLLM-Runtime-Bibliothek und Referenzbeispiele. Die Verzeichnisstruktur lautet:
doc
└──Rockchip_RKLLM_SDK_CN.pdf   # RKLLM SDK Documentation(Chinese)
└──Rockchip_RKLLM_SDK_EN.pdf   # RKLLM SDK Documentation(English)

examples
├──multimodal_model_demo    # Multimodal Inference Example
├──rkllm_api_demo           # Board-side Inference Example
└──rkllm_server_demo        # RKLLM-Server Deployment Example

rkllm-runtime
│   └── Android
│        └── librkllm_api
│             └──arm64-v8a
│                  └── librkllmrt.so  # 64位 Runtime库
│             └──armeabi-v7a
│                  └── librkllmrt.so   # 32 位Runtime库
│             └──include
│                  └── rkllm.h
│   └── Linux
│        └── librkllm_api
│             └──aarch64
│                  └── librkllmrt.so  # 64位Runtime库
│             └──armhf
│                  └── librkllmrt.so  # 32位Runtime库
│             └──include
│                  └── rkllm.h

rkllm-toolkit
│   └── packages
│        └──rkllm_toolkit-x.x.x-cp3xx-cp3xx-linux_x86_64.whl
│   └── examples

rknpu-driver
└──rknpu_driver_x.x.x_xxxxxxx.tar.bz2

scripts
├──fix_freq_rk3576.sh   # Fixed-frequency Script for RK3576
└──fix_freq_rk3588.sh   # Fixed-frequency Script for RK3588
└──fix_freq_rk3562.sh   # Fixed-frequency Script for RK3562
└──fix_freq_rv1126b.sh  # Fixed-frequency Script for RV1126B
Dieses Kapitel beschreibt die Installation von RKLLM-Toolkit und RKLLM Runtime. Die Verwendung wird in Kapitel 3 erläutert.
2.1 Installation von RKLLM-Toolkit
Dieser Abschnitt beschreibt die Installation von RKLLM-Toolkit mit pip install. Die folgenden Schritte führen durch die Installation der Werkzeugkette.
2.1.1 Installation über Pip
2.1.1.1 Installation von Miniforge3
Zur Verwaltung unterschiedlicher Python-Umgebungen wird miniforge3 empfohlen. Prüfen Sie die Installation von miniforge3 und die conda-Version. Bei vorhandener Installation können Sie diesen Abschnitt überspringen.
conda -V
# If "conda: command not found" is displayed, it indicates that conda is not installed.
# For example, version information could be displayed as conda 23.9.0
Installationspaket von miniforge3 herunterladen.
wget -c https://mirrors.bfsu.edu.cn/github-release/conda-forge/miniforge/LatestRelease/Miniforge3-Linux-x86_64.sh
miniforge3 installieren.
chmod 777 Miniforge3-Linux-x86_64.sh
bash Miniforge3-Linux-x86_64.sh
2.1.1.2 RKLLM-Toolkit-Conda-Umgebung erstellen
Conda-Basisumgebung aktivieren.
source ~/miniforge3/bin/activate # directory of miniforge3
# (base) xxx@xxx-pc:~$
Conda-Umgebung RKLLM-Toolkit mit Python 3.8 erstellen (empfohlen).
conda create -n RKLLM-Toolkit python=3.8
RKLLM-Toolkit-Conda-Umgebung aktivieren.
conda activate RKLLM-Toolkit
# (RKLLM-Toolkit) xxx@xxx-pc:~$
2.1.1.3 RKLLM-Toolkit installieren
In der RKLLM-Toolkit-Conda-Umgebung das bereitgestellte
whl-Paket direkt mit pip installieren. Dabei lädt das Installationsprogramm die für RKLLM-Toolkit benötigten Abhängigkeiten automatisch herunter.
pip3 install rkllm_toolkit-x.x.x-cp3xx-cp3xx-linux_x86_64.whl
Wenn der folgende Befehl ohne Fehler ausgeführt wird, war die Installation erfolgreich.
python
from rkllm.api import RKLLM
2.2 Verwendung von RKLLM Runtime
Die bereitgestellte RKLLM-Werkzeugkette enthält für die Laufzeit folgende Komponenten:
1) librkllmrt.so: RKLLM-Runtime-Bibliothek.
2) include/rkllm.h: zu librkllmrt.so gehörende Headerdatei mit Beschreibungen der Strukturen und Funktionen. Für korrekte Kompilierung muss der Bereitstellungscode mit diesem Header und der Bibliothek verknüpft werden. Zur Laufzeit müssen die Bibliotheksdateien auf die Platine übertragen und über folgende Umgebungsvariable bekannt gemacht werden:
export LD_LIBRARY_PATH=/path/to/your/lib
2.3 Kompilierungsanforderungen für RKLLM Runtime
Bei RKLLM Runtime ist die gcc-Version zu beachten. Empfohlen wird der Cross-Compiler gcc-arm-10.2-2020.11-x86_64-aarch64-none-linux-gnu. Cross-Compiler sind häufig rückwärts-, aber nicht vorwärtskompatibel; verwenden Sie daher keine Version unter 10.2. Für ausführbare Android-Dateien wird Android NDK über den angegebenen Downloadlink empfohlen, Version r21e. Konkrete Kompilierungsverfahren stehen außerdem in den Skripten des Verzeichnisses
examples/rkllm_api_demo/deploy.
2.4 Kernel aktualisieren
Das bereitgestellte RKLLM erfordert eine neuere NPU-Treiberversion. Prüfen Sie vor Modellinferenz mit RKLLM Runtime, dass die Version auf der Platine v0.9.8 ist. Abfragebefehl:
# Execute the following command to query the NPU kernel version.
cat /sys/kernel/debug/rknpu/version

# Confirm that the command output is as follows:
# RKNPU driver: v0.9.8
Bei einer NPU-Treiberversion unter v0.9.8 eine aktualisierte offizielle Firmware beziehen. Bei nicht offizieller Firmware muss der Kernel aktualisiert werden. Das RKNPU-Treiberpaket unterstützt kernel-5.10 und kernel-6.1. Für kernel-5.10 wird eine passende Version aus dem Zweig develop-5.10 von GitHub rockchip-linux/kernel empfohlen, insbesondere 5.10.209. Für Kernel 6.1 wird beispielsweise 6.1.84 empfohlen. Die Versionsnummer steht im Makefile des Kernel-Hauptverzeichnisses. Aktualisierungsschritte:
1) rknpu_driver_0.9.8_20241009.tar.bz2 herunterladen.
2) Archiv entpacken und den RKNPU-Treiber im aktuellen Kernelcode (kernel/drivers/rknpu) ersetzen.
3) Kernel neu kompilieren.
4) Neu kompilierten Kernel auf das Gerät schreiben. Falls bei der Kernelkompilierung die in Abbildung 2-1 gezeigte Fehlermeldung auftritt:
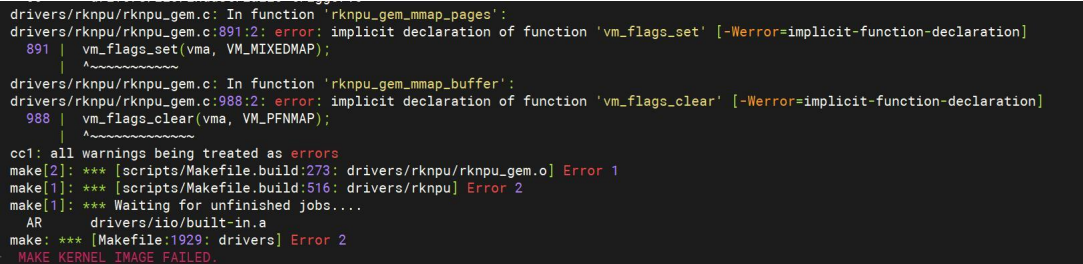
Kopierbare Abschrift des Originalprotokolls (keine ArmSoM-Messung; unkenntliches Konto nicht rekonstruiert):
drivers/rknpu/rknpu_gem.c: In function 'rknpu_gem_mmap_pages':
drivers/rknpu/rknpu_gem.c:891:2: error: implicit declaration of function 'vm_flags_set' [-Werror=implicit-function-declaration]
  891 |  vm_flags_set(vma, VM_MIXEDMAP);
      |  ^~~~~~~~~~~~
drivers/rknpu/rknpu_gem.c: In function 'rknpu_gem_mmap_buffer':
drivers/rknpu/rknpu_gem.c:988:2: error: implicit declaration of function 'vm_flags_clear' [-Werror=implicit-function-declaration]
  988 |  vm_flags_clear(vma, VM_PFNMAP);
      |  ^~~~~~~~~~~~~~
cc1: all warnings being treated as errors
make[2]: *** [scripts/Makefile.build:273: drivers/rknpu/rknpu_gem.o] Error 1
make[1]: *** [scripts/Makefile.build:516: drivers/rknpu] Error 2
make[1]: *** Waiting for unfinished jobs....
  AR      drivers/iio/built-in.a
make: *** [Makefile:1929: drivers] Error 2
MAKE KERNEL IMAGE FAILED.
Abbildung 2-1. Beispiel eines Kernel-Kompilierungsfehlers. In diesem Fall folgenden Originalcode in kernel/include/linux/mm.h ergänzen:
static inline void vm_flags_set(struct vm_area_struct *vma,
                          vm_flags_t flags){
      vma->vm_flags |= flags;
}

static inline void vm_flags_clear(struct vm_area_struct *vma,
                            vm_flags_t flags){
      vma->vm_flags &= ~flags;
}
3 RKLLM-Benutzeranleitung
3.1 Modellkonvertierung
RKLLM-Toolkit bietet Modellkonvertierung und Quantisierung. LLMs im Hugging-Face- oder GGUF-Format werden zur Bereitstellung und Ausführung auf der Rockchip NPU in RKLLM-Modelle konvertiert. Dieser Abschnitt erläutert die konkrete Umsetzung der Modellkonvertierung in RKLLM-Toolkit.
3.1.1 RKLLM initialisieren
Zuerst muss ein RKLLM-Objekt initialisiert werden. Der Beispielcode verwendet dafür den Konstruktor RKLLM().
3.1.2 Modelle laden
Nach der Initialisierung rkllm.load_huggingface() mit dem Modellpfad aufrufen. RKLLM-Toolkit lädt das Sprachmodell im Hugging-Face- oder GGUF-Format anhand des Pfades für weitere Konvertierung und Quantisierung. Die Funktionsdefinition lautet:
Tabelle 3-1. Schnittstellenspezifikation von load_huggingface
| Funktion | load_huggingface |
|---|---|
| Beschreibung | Offene LLMs im Hugging-Face-Format laden. |
| Parameter | model: Pfad zu den LLM-Dateien zum Laden und für weitere Konvertierung und Quantisierung. model_lora: Pfad zu den LoRA-Gewichten; bei der Konvertierung muss model auf das entsprechende Basismodell zeigen. device: Konvertierungsgerät, cuda oder cpu. dtype: Gewichtstyp float32, float16 oder bfloat16. float16/bfloat16 verringern den Speicherbedarf, können aber die Quantisierungsgenauigkeit beeinflussen. custom_config: benutzerdefinierte Konfigurationsdatei; siehe Abschnitt zur benutzerdefinierten Modellkonvertierung. load_weight: Ob Gewichte geladen werden; bei False werden die tatsächlichen Gewichte nicht geladen. |
| Rückgabewert | 0: Modell erfolgreich geladen; -1: Laden fehlgeschlagen. |
Beispielcode:
ret = rkllm.load_huggingface(
   model = './huggingface_model_dir',
   model_lora = './huggingface_lora_model_dir')
if ret != 0:
   print('Load model failed!')
Tabelle 3-2. Schnittstellenspezifikation von load_gguf
| Funktion | load_gguf |
|---|---|
| Beschreibung | Offene LLMs im GGUF-Format laden; q4_0 und fp16 werden unterstützt. Über diese Schnittstelle können auch GGUF-LoRA-Modelle geladen und in RKLLM konvertiert werden. |
| Parameter | model: Pfad zu den LLM-Dateien zum Laden und für weitere Konvertierung und Quantisierung. |
| Rückgabewert | 0: Modell erfolgreich geladen; -1: Laden fehlgeschlagen. |
Beispielcode:
ret = rkllm.load_gguf(model = './model-Q4_0.gguf')
if ret != 0:
   print('Load model failed!')
3.1.3 RKLLM-Modell erstellen
Nach dem Laden des ursprünglichen Modells über rkllm.load_huggingface() wird mit rkllm.build() das RKLLM-Modell erstellt. Optionale Quantisierung kann dabei Modellgröße verringern und Inferenz auf der Rockchip NPU beschleunigen. Definition von rkllm.build():
Tabelle 3-3. Schnittstellenspezifikation von build
| Funktion | build |
|---|---|
| Beschreibung | RKLLM-Modell erstellen und Quantisierungsoperationen während der Konvertierung festlegen. |
| Parameter | do_quantization: Ob Quantisierung ausgeführt wird; True empfohlen. optimization_level: Optimierung der Quantisierungsgenauigkeit, Werte {0, 1}: 0 deaktiviert, 1 aktiviert. Die Genauigkeitsoptimierung kann die Inferenzleistung verringern. quantized_dtype: Quantisierungstyp. Unterstützt werden “w4a16”, “w4a16_g32”, “w4a16_g64”, “w4a16_g128”, “w8a8”, “w8a8_g128”, “w8a8_g256”, “w8a8_g512”. “w4a16” bedeutet 4-Bit-Gewichte ohne Aktivierungsquantisierung; “w4a16_g64” gruppierte 4-Bit-Gewichte mit group size=64 ohne Aktivierungsquantisierung. “w8a8” quantisiert Gewichte und Aktivierungen auf 8 Bit; “w8a8_g128” gruppiert beide mit group size=128. RK3576 und RV1126B unterstützen fünf Typen: “w4a16”, “w4a16_g32”, “w4a16_g64”, “w4a16_g128”, “w8a8”. RK3588 unterstützt vier: “w8a8”, “w8a8_g128”, “w8a8_g256”, “w8a8_g512”. RK3562 unterstützt “w8a8”, “w4a16_g32”, “w4a16_g64”, “w4a16_g128”, “w4a8_g32”. Bei GGUF entspricht q4_0 dem Typ “w4a16_g32”. Hinweis: Die Gruppengröße muss die Ausgabedimension der linearen Schicht teilen, sonst schlägt die Quantisierung fehl! quantized_algorithm: Algorithmus zur Optimierung der Quantisierungsgenauigkeit; mögliche Werte “normal”, “grq” oder “gdq”. “normal” ist für alle Quantisierungstypen möglich; “gdq” und “grq” nur für “w4a16” und gruppiertes “w4a16”. Sie benötigen hohe Rechenleistung und GPU-Beschleunigung. grq ist schneller und speichersparender als gdq und sollte für 4-Bit-Quantisierung bevorzugt werden. LoRA-Module können die Genauigkeit verbessern. Ohne anderes importiertes LoRA-Modell sind Algorithmen wie “normal_r[164]” oder “gdq_r[1~64]” möglich, etwa “normal_r8”, “grq_r8”, “gdq_r8”. Quantisiertes Modell und LoRA-Modell werden beide exportiert und zur Inferenz von der Runtime geladen. num_npu_core: Anzahl der NPU-Inferenzkerne. RK3576: [1, 2]; RK3562: [1]; RK3588: [1, 2, 3]; RV1126B: [1]. extra_qparams: gdq/grq erzeugen einen Cache quantisierter Gewichte als *.qparams; dessen Pfad kann zum erneuten Modellexport angegeben werden. dataset: Quantisierungskalibrierungsdatensatz in JSON. input ist die Frage mit Prompt, target die Antwort; mehrere Einträge liegen als Dictionaries in einer Liste vor. hybrid_rate: Mischquantisierungsanteil (∈[0,1)). Bei “w4a16”/”w8a8” werden entsprechend “w4a16_g”/”w8a8_g” zur Genauigkeitssteigerung beigemischt; bei gruppiertem “w4a16_g”/”w8a8_g” werden “w4a16”/”w8a8” zur Inferenzbeschleunigung beigemischt. Bei hybrid_rate=0 erfolgt keine Mischquantisierung. target_platform: Hardwareplattform der Modellausführung; Optionen “RK3576”, “RK3588”, “RK3562”, “RV1126B”. max_context: maximale Kontextlänge, bis 16,384, muss auf 32 ausgerichtet sein. |
| Rückgabewert | 0: Konvertierung und Quantisierung erfolgreich; -1: Modellkonvertierung fehlgeschlagen. |
Beispielcode:
ret = rkllm.build(
       do_quantization=True,
       optimization_level=1,
       quantized_dtype='w8a8',
       quantized_algorithm="normal",
       num_npu_core=3,
       extra_qparams=None,
       dataset="quant_data.json",
       hybrid_rate=0,
       target_platform='rk3588')
3.1.4 Modell exportieren
Nach dem Erstellen des RKLLM-Modells mit rkllm.build() kann das RKNN-Modell mit rkllm.export_rkllm() zur späteren Bereitstellung als .rkllm-Datei gespeichert werden. Parameterdefinition:
Tabelle 3-4. Schnittstellenspezifikation von export_rkllm
| Funktion | export_rkllm |
|---|---|
| Beschreibung | Konvertiertes und quantisiertes RKLLM-Modell für spätere Inferenz speichern. |
| Parameter | export_path: Speicherpfad der exportierten RKLLM-Modelldatei. LoRA-Modelle werden automatisch mit dem Suffix _lora im RKLLM-Modellnamen gespeichert. |
| Rückgabewert | 0: Export und Speichern erfolgreich; -1: Export fehlgeschlagen. |
Beispielcode:
ret = rkllm.export_rkllm(export_path = './model.rkllm')
if ret != 0:
   print('Export model failed!')
3.1.5 GPTQ-Modell konvertieren
Neben den oben bereitgestellten Quantisierungsalgorithmen kann ein Gleitkommamodell zunächst mit dem quelloffenen Werkzeug AutoGPTQ in ein 4-Bit-/8-Bit-Modell und anschließend in RKLLM konvertiert werden. Bei der AutoGPTQ-Quantisierung müssen folgende Parameter konfiguriert werden:
bits=4
sym=true
group_size=32/64/128
desc_act=false
bits=8
sym=true
group_size=128/256/512
desc_act=false
Beispiel zur Konvertierung eines GPTQ-Modells im HuggingFace-Format in RKLLM:
modelpath = '/path/to/Model-Instruct-GPTQ-Int4'
llm = RKLLM()
ret = llm.load_huggingface(model=modelpath, model_lora = None,
device='cuda')
if ret != 0:
   print('Load model failed!')
   exit(ret)
# Build model
dataset = None
qparams = None
target_platform = "RK3576"
optimization_level = 1
quantized_dtype = "w4a16_g32" #w4a16_g64 or w4a16_g128
quantized_algorithm = "normal"
num_npu_core = 2
ret = llm.build(do_quantization=True,
optimization_level=optimization_level, quantized_dtype=quantized_dtype,
             quantized_algorithm=quantized_algorithm,
target_platform=target_platform, num_npu_core=num_npu_core,
extra_qparams=qparams, dataset=dataset)
if ret != 0:
   print('Build model failed!')
   exit(ret)
# Export rkllm model
ret = llm.export_rkllm(f"./{os.path.basename(modelpath)}_{quantized_dtype}_{target_platform}.rkllm")
if ret != 0:
   print('Export model failed!')
   exit(ret)
3.1.6 Benutzerdefiniertes Modell konvertieren
Wenn Struktur oder Name des Modells geändert wurden und die resultierende Gesamtarchitektur wie unten aufgebaut ist, kann die benutzerdefinierte Funktion zur Konvertierung verwendet werden.
           TOKEN_EMBD
             ↓
        embd_scale(optional)
             ↓
         ┌─ x
         │  ↓
         │  ATTN_NORM
         │  ↓
         │  attn
         │  ↓
         │  ATTN_POST_NORM(optional)
         │  ↓
         │  hidden_state_scale(optional)
         │  ↓
         │  cross attn(optional)
         │  ↓
   ┌─   └► +
   │
   │        ↓
   │     FFN_NORM
   │        ↓
   │        MLP
   │        ↓
   │   FFN_POST_NORM(optional)
   │        ↓
   │   hidden_state_scale(optional)
   │        ↓
   └───►   +

             ...
             ↓
         OUTPUT_NORM
             ↓
        lm_head_scale(optional)
             ↓
           OUTPUT
Am Beispiel von Qwen müssen die entsprechenden Variablennamen aus modeling_qwen.py wie folgt in die benutzerdefinierte Konfigurationsdatei eingetragen werden.
{
   "BLOCKNAME": "QWenBlock",
   "TOKEN_EMBD": "wte",
   "ATTN_NORM": "ln_1",
   "ATTN_Q_NORM": "",
   "ATTN_K_NORM": "",
   "CROSS_ATTN_NORM": "",
   "CROSS_ATTN_Q": "",
   "ATTN_Q": "",
   "ATTN_K": "",
   "ATTN_V": "",
   "ATTN_QKV": "attn.c_attn",
   "ATTN_KV": "",
   "KV_CONTINUOUS": "true",
   "ATTN_OUT": "attn.c_proj",
   "CROSS_ATTN_OUT": "",
   "ATTN_POST_NORM": "",
   "FFN_NORM": "ln_2",
   "FFN_UP": "mlp.w1",
   "FFN_GATE": "mlp.w2",
   "ACT_TYPE": "silu",
   "FFN_DOWN": "mlp.c_proj",
   "FFN_POST_NORM": "",
   "OUTPUT_NORM": "ln_f",
   "OUTPUT": "lm_head"
}
Zulässige Werte für ACT_TYPE: [“silu”, “gelu”, “relu”, “fatrelu”, “squarerelu”, “swiglu”]. ATTN_NORM und FFN_NORM unterstützen nur RMSNorm.
Bei ATTN_QKV oder ATTN_KV muss geprüft werden, ob sich die Gewichte in zusammenhängende K|V-Bereiche aufteilen lassen. Falls ja, KV_CONTINUOUS auf true setzen. Beispielsweise sind die c_attn-Gewichte von Qwen zusammenhängend gespeichert und lassen sich der Größe nach nacheinander in Q, K und V teilen. Die wqkv-Gewichte von InternLM2 sind dagegen nicht zusammenhängend gespeichert; Q, K und V sind nach head_dim verschachtelt.
Definition der Datei modeling_qwen.py für Qwen 1.8B:
class QWenLMHeadModel(QWenPreTrainedModel):
     def __init__(self, config):
       super().__init__(config)
         self.transformer = QWenModel(config)
         self.lm_head = nn.Linear(config.hidden_size,
config.vocab_size, bias=False)
class QWenModel(QWenPreTrainedModel):
   _keys_to_ignore_on_load_missing = ["attn.masked_bias"]

   def __init__(self, config):
       super().__init__(config)
       self.wte = nn.Embedding(self.vocab_size, self.embed_dim)
       self.ln_f = RMSNorm(
          self.embed_dim,
          eps=config.layer_norm_epsilon,
       )
class QWenBlock(nn.Module):
   def __init__(self, config):
       super().__init__()
       hidden_size = config.hidden_size
       self.bf16 = config.bf16

       self.ln_1 = RMSNorm(
          hidden_size,
          eps=config.layer_norm_epsilon,
       )
       self.attn = QWenAttention(config)
       self.ln_2 = RMSNorm(
          hidden_size,
          eps=config.layer_norm_epsilon,
       )
       self.mlp = QWenMLP(config)
class QWenAttention(nn.Module):
   def __init__(self, config):
       super().__init__()

       self.c_attn = nn.Linear(config.hidden_size, 3 *
self.projection_size)

       self.c_proj = nn.Linear(
          config.hidden_size, self.projection_size, bias=not
config.no_bias
       )

class QWenMLP(nn.Module):
   def __init__(self, config):
       super().__init__()
       self.w1 = nn.Linear(
          config.hidden_size, config.intermediate_size // 2, bias=not
config.no_bias
       )
       self.w2 = nn.Linear(
          config.hidden_size, config.intermediate_size // 2, bias=not
config.no_bias
       )
       ff_dim_in = config.intermediate_size // 2
       self.c_proj = nn.Linear(ff_dim_in, config.hidden_size, bias=not
config.no_bias)
Für die Konvertierung benutzerdefinierter Modelle, einschließlich Cross-Attention-Modellen, wird eine Referenzstruktur im Hugging-Face-Format bereitgestellt. Die benutzerdefinierte Konfiguration lautet:
{
   "BLOCKNAME": "CustomDecoderLayer",
   "TOKEN_EMBD": "embed_tokens",
   "ATTN_NORM": "input_layernorm",
   "ATTN_Q_NORM": "",
   "ATTN_K_NORM": "",
   "CROSS_ATTN_NORM": "cross_layernorm",
   "CROSS_ATTN_Q": "cross_attn.cross_q_proj",
   "ATTN_Q": "",
   "ATTN_K": "",
   "ATTN_V": "",
   "ATTN_QKV": "self_attn.qkv_proj",
   "ATTN_KV": "",
   "KV_CONTINUOUS": "true",
   "ATTN_OUT": "self_attn.o_proj",
   "CROSS_ATTN_OUT": "cross_attn.cross_o_proj",
   "ATTN_POST_NORM": "",
   "FFN_NORM": "post_attention_layernorm",
   "FFN_UP": "mlp.up_proj",
   "FFN_GATE": "mlp.gate_proj",
   "ACT_TYPE": "silu",
   "FFN_DOWN": "mlp.down_proj",
   "FFN_POST_NORM": "",
   "OUTPUT_NORM": "norm",
   "OUTPUT": "lm_head"
}
3.1.7 Modell einer älteren Version aktualisieren
Da sich Version 1.0.2 deutlich von Version 1.1 und neueren Versionen unterscheidet, aktualisiert rkllm.update_rkllm() ein 1.0.2-Modell auf die neue Version. Die zuvor beschriebenen Lade- und Erstellungsschritte sind dafür nicht nötig; die Aktualisierung erfolgt direkt über diese Schnittstelle. Parameter wie der Quantisierungstyp bleiben dabei unverändert. Funktion und Parameter:
Tabelle 3-5. Schnittstellenspezifikation von update_rkllm
| Funktion | update_rkllm |
|---|---|
| Beschreibung | Modell von Version 1.0.2 auf die neue Version aktualisieren. |
| Parameter | model: Pfad zum RKLLM-Modell der Version 1.0.2. |
| Rückgabewert | 0: Modellaktualisierung erfolgreich; -1: Aktualisierung fehlgeschlagen. |
Beispielcode:
ret = llm.update_rkllm(model = "./model_1.0.2version.rkllm")
if ret != 0:
   print('Load model failed!')
   exit(ret)
3.1.8 Genauigkeit der Simulation auswerten
Nach dem Erstellen des Modells mit rkllm.build() kann die Simulationsgenauigkeit auf dem PC mit rkllm.get_logits() ausgewertet werden. Parameterdefinitionen:
Tabelle 3-6. Schnittstellenspezifikation von get_logits
| Funktion | get_logits |
|---|---|
| Beschreibung | Simulationsgenauigkeit auf dem PC auswerten. |
| Parameter | inputs: Simulations-Eingabeformat entsprechend der Hugging-Face-Inferenz, etwa {“input_ids”: “”, “top_k”: 1, …}. |
| Rückgabewert | Vom Modell berechnete logits-Werte. |
Beispiel für einen PPL-Test (Perplexität) auf dem Wikitext-Datensatz mit dieser Funktion:
def eval_wikitext(llm):
   seqlen = 512
   tokenizer = AutoTokenizer.from_pretrained(
       modelpath,
       trust_remote_code=True
       )
   #Dataset download link:
   #https://huggingface.co/datasets/Salesforce/wikitext/tree/main/wikitext-2-raw-v1
   testenc = load_dataset("parquet", data_files='./wikitext/wikitext-2-raw-1/test-00000-of-00001.parquet', split='train')
   testenc = tokenizer(
       "\n\n".join(testenc['text']),
       return_tensors="pt").input_ids
   nsamples = testenc.numel() // seqlen
   nlls = []
   for i in tqdm(range(nsamples), desc="eval_wikitext: "):
       batch = testenc[:, (i * seqlen): ((i + 1) * seqlen)]
       inputs = {"input_ids": batch}
       lm_logits = llm.get_logits(inputs)
       if lm_logits is None:
          print("get logits failed!")
          return
       shift_logits = lm_logits[:, :-1, :]
       shift_labels = batch[:, 1:].to(lm_logits.device)
       loss_fct = nn.CrossEntropyLoss().to(lm_logits.device)
       loss = loss_fct(shift_logits.view(-1, shift_logits.size(-1)),
shift_labels.view(-1))
       neg_log_likelihood = loss.float() * seqlen
       nlls.append(neg_log_likelihood)
   ppl = torch.exp(torch.stack(nlls).sum() / (nsamples * seqlen))
   print(f'wikitext-2-raw-1-test ppl: {round(ppl.item(), 2)}')
3.1.9 Simulierte Modellinferenz
Nach dem Erstellen des Modells mit rkllm.build() kann auf dem PC mit rkllm.chat_model() eine simulierte Inferenz ausgeführt werden. Parameterdefinitionen:
Tabelle 3-7. Schnittstellenspezifikation von chat_model
| Funktion | chat_model |
|---|---|
| Beschreibung | Modellinferenz auf dem PC simulieren. |
| Parameter | messages: Eingabetext mit passenden Prompts. args: Inferenzkonfiguration, etwa Samplingparameter wie top_k. |
| Rückgabewert | Vom Modell berechnete logits-Werte. |
Beispielcode:
args ={
   "max_length":128,
   "top_k":1,
   "temperature":0.8,
   "do_sample":True,
   "repetition_penalty":1.1
   }

mesg = "Human: How’s the weather today?\nAssistant:"
print(llm.chat_model(mesg, args))
Die beschriebenen Vorgänge decken sämtliche Schritte der Modellkonvertierung und Quantisierung in RKLLM-Toolkit ab. Je nach Anforderungen und Einsatzszenario können unterschiedliche Konfigurationen und Quantisierungsmethoden zur Vorbereitung der anschließenden Bereitstellung gewählt werden.
3.2 Inferenz auf der Platine implementieren
Dieses Kapitel erläutert die allgemeinen API-Funktionen. Darauf aufbauend kann C++-Code zur RKLLM-Inferenz auf der Platine und zum Abruf der Ergebnisse erstellt werden. Ablauf:
- callback() definieren.
- Parameterstruktur RKLLMParam definieren.
- Modell mit rkllm_init() initialisieren.
- Inferenz mit rkllm_run() ausführen.
- Von callback() zurückgegebene Echtzeitergebnisse verarbeiten.
- Modell mit rkllm_destroy() zerstören und Ressourcen freigeben.
Im Folgenden werden jeder Schritt und die beteiligten Funktionen ausführlich erläutert.
3.2.1 Callback-Funktion definieren
Die Callback-Funktion empfängt RKLLM-Ausgaben in Echtzeit. Sie wird bei der Initialisierung gebunden und während der Modellinferenz fortlaufend aufgerufen, wobei jeweils nur ein Token zurückgegeben wird. Beispiel zur Echtzeitausgabe im Terminal:
int callback(RKLLMResult* result, void* userdata, LLMCallState state)
{
   if(state == LLM_RUN_NORMAL){
       printf("%s", result->text);
   }
   if (state == LLM_RUN_FINISH) {
       printf("finish\n");
   } else if (state == LLM_RUN_ERROR){
       printf("\run error\n");
   }
   return 0;
}
1) LLMCallState ist ein Statuskennzeichen. Definition:
Tabelle 3-8. Struktur-/Statusbeschreibung von LLMCallState
| Definition | LLMCallState |
|---|---|
| Beschreibung | Aktuellen RKLLM-Ausführungszustand anzeigen. |
| Enumerationswerte | LLM_RUN_NORMAL: Modell inferiert; LLM_RUN_FINISH: Inferenz abgeschlossen; LLM_RUN_WAITING: Aktuell decodiertes Zeichen ist kein vollständiges UTF-8-Zeichen und muss mit dem nächsten Decodierergebnis verbunden werden; LLM_RUN_ERROR: Fehler während der Inferenz. |
Beim Entwurf der Callback-Funktion können für unterschiedliche LLMCallState-Zustände unterschiedliche Nachverarbeitungen festgelegt werden.
2) RKLLMResult ist eine Rückgabestruktur. Definition:
Tabelle 3-9. Struktur-/Statusbeschreibung von RKLLMResult
| Definition | RKLLMResult |
|---|---|
| Beschreibung | Ergebnis der aktuellen Inferenz zurückgeben. |
| Strukturfelder | const char* text: Text der aktuellen Inferenz; int32_t token_id: token_id der aktuellen Inferenz; RKLLMResultLogits logits: logits-Informationen der aktuellen Inferenz, nur bei RKLLMInferMode=RKLLM_INFER_GET_LOGITS zurückgegeben; RKLLMPerfStat perf: Leistungsstatistik am Inferenzende, nur im Zustand RKLLM_RUN_FINISH zurückgegeben. |
3) RKLLMResultLogits ist eine Rückgabestruktur. Definition:
Tabelle 3-9. Struktur-/Statusbeschreibung von RKLLMResultLogitsStructure
| Definition | RKLLMResultLogits |
|---|---|
| Beschreibung | logits der aktuellen Inferenz zurückgeben. |
| Strukturfelder | const float* logits: logits der aktuellen Inferenz; int vocab_size: token_id der aktuellen Inferenz (Formulierung des Originals); int num_tokens: Anzahl zurückgegebener Tokens; die logits-Größe lässt sich aus vocab_size und num_tokens berechnen. |
Beim Entwurf der Callback-Funktion können abhängig von den Werten in RKLLMResult unterschiedliche Nachverarbeitungen festgelegt werden.
3.2.2 RKLLMParam definieren
RKLLMParam beschreibt die detaillierten Parameter des RKLLM-Modells. Definition:
Tabelle 3-10. Struktur-/Statusbeschreibung von RKLLMParam
| Definition | RKLLMParam |
|---|---|
| Beschreibung | Detaillierte Parameter des RKLLM-Modells definieren. |
| Strukturfelder | const char* model_path: Pfad zur RKLLM-Modelldatei; int32_t num_npu_core: Anzahl der NPU-Kerne bei der Inferenz; RK3576: [1, 2], RK3588: [1, 3]; bool use_gpu: GPU zur Prefill-Beschleunigung verwenden; Standardwert false; int32_t max_context_len: maximale Kontextlänge bei der Inferenz; int32_t max_new_tokens: maximale Anzahl generierter Tokens; int32_t top_k: Nächstes Token nur aus den k wahrscheinlichsten wählen. Dies verringert das Risiko unwahrscheinlicher oder bedeutungsloser Tokens. Hohe Werte wie 100 berücksichtigen mehr Möglichkeiten und erzeugen vielfältigeren Text; niedrige Werte wie 10 konzentrieren sich auf wahrscheinlichste Tokens und erzeugen konservativeren Text. Standardwert 40; float top_p: Nucleus Sampling wählt das nächste Token aus einer Gruppe mit kumulierter Wahrscheinlichkeit von mindestens p. Durch Berücksichtigung der Tokenwahrscheinlichkeiten und Anzahl abgetasteter Tokens werden Vielfalt und Qualität ausgeglichen. Hohe Werte wie 0.95 erhöhen die Vielfalt, niedrige wie 0.5 erzeugen fokussierteren und konservativeren Text. Standardwert 0.9; float temperature: Steuert Zufälligkeit über die Wahrscheinlichkeitsverteilung der Ausgabetokens. Hohe Temperaturen wie 1.5 erzeugen zufälligeren und kreativeren Text, indem mehr unwahrscheinliche Tokenmöglichkeiten berücksichtigt werden, was vielfältigere und unerwartete Ausgaben ergibt. Niedrige Temperaturen wie 0.5 führen zu fokussierterem, konservativerem Text: Das Modell wählt häufiger wahrscheinliche Tokens und liefert konsistentere, vorhersehbarere Ergebnisse. Bei temperature=0 wird stets das wahrscheinlichste nächste Token gewählt, sodass jede Ausgabe identisch ist. Um Zufälligkeit und Determinismus ohne übermäßige Gleichförmigkeit oder Chaos auszugleichen, gilt standardmäßig 0.8; float repeat_penalty: Steuert Tokenfolgenwiederholungen und verhindert repetitiven oder monotonen Text. Hohe Werte wie 1.5 bestrafen Wiederholungen stärker, niedrige wie 0.9 sind toleranter. Standardwert 1.1; float frequency_penalty: Faktor zur Bestrafung wiederholter Wörter/Phrasen; senkt die Wahrscheinlichkeit häufiger und erhöht die seltener Ausdrücke. Dies kann Vielfalt erhöhen, aber auch schwer verständliche oder unerwartete Texte erzeugen. Bereich [-2.0, 2.0], Standardwert 0; int32_t mirostat: Hält die Textqualität aktiv im erwarteten Bereich. Balanciert Kohärenz und Vielfalt und vermeidet Qualitätsverlust durch übermäßige Wiederholung (boredom trap) oder Inkohärenz (confusion trap). Werte {0, 1, 2}: 0 deaktiviert, 1 mirostat, 2 mirostat 2.0; float mirostat_tau: Zielentropie von mirostat als erwarteter Perplexitätswert des Textes. Damit wird das Verhältnis von Kohärenz und Vielfalt gesteuert: Kleine Werte erzeugen konzentrierteren, kohärenteren Text, hohe Werte erhöhen die Vielfalt, möglicherweise bei geringerer Kohärenz. Standardwert 5.0; float mirostat_eta: Lernrate von mirostat und Reaktionsgeschwindigkeit auf Textfeedback. Kleine Lernraten bewirken langsamere Anpassung, hohe eine empfindlichere Reaktion. Standardwert 0.1; bool skip_special_token: Spezialtokens überspringen und nicht ausgeben, etwa <EOS>; bool is_async: asynchronen Modus verwenden; const char img_start: Startmarkierung der multimodalen Bildkodierung; im multimodalen Eingabemodus erforderlich; const char img_end: Endmarkierung der Bildkodierung; im multimodalen Modus erforderlich; const char img_content*: Inhaltsmarkierung der Bildkodierung; im multimodalen Modus erforderlich; n_keep: Anzahl am Anfang zu erhaltender Cache-Einträge beim Löschen des KV Cache. Bei mehrrundigen Gesprächen muss n_keep mindestens der system_prompt-Länge entsprechen; RKLLMExtendParam extend_param: spezielle Parameter zur Inferenzsteuerung. |
Tabelle 3-11. Struktur-/Statusbeschreibung von RKLLMExtendParam
| Definition | RKLLMExtendParam |
|---|---|
| Beschreibung | Spezielle Parameter zur Inferenzsteuerung. |
| Strukturfelder | int32_t base_domain_id: Domäne, in der die RKLLM-Initialisierung beginnt; Standardwert 0. int8_t embed_flash: Modellvokabular zur Speicherersparnis im Flash ablegen; 0 deaktiviert, 1 aktiviert. int8_t enabled_cpus_num: Anzahl der Inferenz-CPUs. RK3588/3576: 1-8; RK3562: 1-4; Standardwert 4. uint32_t enabled_cpus_mask: Binärmaske zur Auswahl konkreter CPU-Kerne. rkllm.h definiert Makros für CPU-Nummern; Konfigurationsbeispiel CPU4 | CPU5 | CPU6 | CPU7. uint8_t n_batch: Parallelitätsgrad der Inferenz; Standardwert 1. int8_t use_cross_attn: Cross-Attention aktivieren oder deaktivieren. |
Im konkreten Code muss RKLLMParam mit rkllm_createDefaultParam() initialisiert und anschließend müssen die Modellparameter anforderungsgerecht gesetzt werden. Beispiel:
RKLLMParam param = rkllm_createDefaultParam();
param.model_path = "model.rkllm";
param.top_k = 1;
param.max_new_tokens = 256;
param.max_context_len = 512;
3.2.3 Eingabestruktur definieren
Die Eingabestruktur RKLLMInput unterstützt vier Eingabetypen: Text, Bild mit Text, Token-IDs und kodierte Vektoren. Definition:
Tabelle 3-12. Struktur-/Statusbeschreibung von RKLLMInput
| Definition | RKLLMInput |
|---|---|
| Beschreibung | Eingabedaten unterschiedlicher Formen empfangen. |
| Strukturfelder | RKLLMInputType input_type: Eingabemodus; const char* role: Eingabetyp, Optionen [“user”, “tool”]; bool enable_thinking: Thinking-Modus von Qwen3 aktivieren; union: speichert unterschiedliche Eingabetypen: const char prompt_input*: Text-Prompt in natürlicher Sprache; RKLLMEmbedInput embed_input: Embedding-Vektor verarbeiteter Merkmale; RKLLMTokenInput token_input: tokenisierte Tokenfolge; RKLLMMultiModalInput multimodal_input: multimodale Daten, beispielsweise Bilder mit Text. |
Tabelle 3-13. Struktur-/Statusbeschreibung von RKLLMInputType
| Definition | RKLLMInputType |
|---|---|
| Beschreibung | Typ der Eingabedaten angeben. |
| Enumerationswerte | RKLLM_INPUT_PROMPT: reiner Text; RKLLM_INPUT_TOKEN: Token-IDs; RKLLM_INPUT_EMBED: kodierte Vektoren; RKLLM_INPUT_MULTIMODAL: Bilder mit Text. |
Reiner Text kann direkt über input_data übergeben werden. Für Token-IDs, kodierte Vektoren oder Bilder mit Text wird RKLLMInput zusammen mit RKLLMTokenInput, RKLLMEmbedInput und RKLLMMultiModalInput verwendet. Einzelheiten:
1) RKLLMTokenInput ist die Eingabestruktur für Token-IDs. Definition:
Tabelle 3-14. Struktur-/Statusbeschreibung von RKLLMTokenInput
| Definition | RKLLMTokenInput |
|---|---|
| Beschreibung | token_id-Daten empfangen. |
| Strukturfelder | int32_t input_ids*: Speicherzeiger auf Eingabe-Token-IDs. size_t n_tokens: Anzahl der Eingabetokens. |
2) RKLLMEmbedInput ist die Eingabestruktur für kodierte Vektoren. Definition:
Tabelle 3-15. Struktur-/Statusbeschreibung von RKLLMEmbedInput
| Definition | RKLLMEmbedInput |
|---|---|
| Beschreibung | Embedding-Daten empfangen. |
| Strukturfelder | float embed*: Speicherzeiger auf Eingabe-Token-Embeddings. size_t n_tokens: Anzahl der Eingabetokens. |
3) RKLLMMultiModalInput ist die Eingabestruktur für Bilder mit Text. Definition:
Tabelle 3-16. Struktur-/Statusbeschreibung von RKLLMMultiModalInput
| Definition | RKLLMMultiModalInput |
|---|---|
| Beschreibung | Bild- und Textdaten empfangen. |
| Strukturfelder | char prompt: Speicherzeiger auf den Eingabetext. float image_embed: Speicherzeiger auf Eingabe-Bild-Embeddings. size_t n_image_tokens: Anzahl der Tokens der Bild-Embeddings. size_t n_image: Anzahl der Eingabebilder; mehrere aufeinanderfolgende Frames werden unterstützt. size_t image_width: Eingabebildbreite bei der Embedding-Berechnung, für mrope-Berechnungsparameter verwendet. size_t image_height: Eingabebildhöhe bei der Embedding-Berechnung, für mrope-Berechnungsparameter verwendet. |
RKLLM unterstützt verschiedene Inferenzmodi über RKLLMInferParam. Während der Inferenz können vorgeladene LoRA-Modelle gemeinsam verwendet oder ein Prompt Cache zur Beschleunigung späterer Inferenz gespeichert werden. Definition:
Tabelle 3-17. Struktur-/Statusbeschreibung von RKLLMInferParam
| Definition | RKLLMInferParam |
|---|---|
| Beschreibung | Verschiedene Inferenzmodi definieren. |
| Strukturfelder | RKLLMInferMode mode: Inferenzmodus; RKLLM_INFER_GENERATE für normale Inferenz, RKLLM_INFER_GET_LOGITS mit zusätzlichem logits-Abruf. RKLLMLoraParam lora_params: LoRA-Konfiguration während der Inferenz zur Auswahl eines Modells aus mehreren geladenen LoRAs; NULL, wenn nicht benötigt. RKLLMPromptCacheParam prompt_cache_params: Prompt-Cache-Konfiguration während der Inferenz; NULL, wenn keine Cache-Erzeugung erforderlich ist. keep_history: Historischen Kontext behalten; für mehrrundige Gespräche auf 1 setzen. |
Tabelle 3-18. Struktur-/Statusbeschreibung von RKLLMLoraParam
| Definition | RKLLMLoraParam |
|---|---|
| Beschreibung | Parameter zur LoRA-Verwendung während der Inferenz definieren. |
| Strukturfelder | const char lora_adapter_name*: Name der bei der Inferenz verwendeten LoRA. |
Tabelle 3-19. Struktur-/Statusbeschreibung von RKLLMPromptCacheParam
| Definition | RKLLMPromptCacheParam |
|---|---|
| Beschreibung | Parameter zur Prompt-Cache-Verwendung während der Inferenz definieren. |
| Strukturfelder | int save_prompt_cache: Prompt Cache bei der Inferenz speichern; 1 ja, 0 nein. const char prompt_cache_path*: Speicherpfad des Prompt Cache; ohne Angabe “./prompt_cache.bin”. |
Inferenzbeispiel mit RKLLMPromptCacheParam:
// Initialize and Set Prompt Cache Parameters(if needed)
RKLLMPromptCacheParam prompt_cache_params;
// Enable saving Prompt Cache
prompt_cache_params.save_prompt_cache = true;
// Specify cache file path
prompt_cache_params.prompt_cache_path = "./prompt_cache.bin";
rkllm_infer_params.prompt_cache_params = &prompt_cache_params;
3.2.4 Modell initialisieren
Vor der Modellinitialisierung muss ein LLMHandle definiert werden. Dieses Handle dient zur Initialisierung, Inferenz und Ressourcenfreigabe; für einen korrekten Ablauf muss in allen drei Phasen dasselbe LLMHandle-Objekt verwendet werden. Vor der Inferenz muss die Initialisierung mit rkllm_init() abgeschlossen werden. Definition:
Tabelle 3-20. Schnittstellenspezifikation von rkllm_init
| Funktion | rkllm_init |
|---|---|
| Beschreibung | Modellparameter und Inferenzeinstellungen für RKLLM initialisieren. |
| Parameter | LLMHandle* handle: Modell im entsprechenden Handle für spätere Inferenz- und Freigabeaufrufe registrieren; RKLLMParam* param: für das Modell definierte Parameterstruktur; LLMResultCallback callback: Callback zum Empfang und zur Verarbeitung von Echtzeit-Modellausgaben. |
| Rückgabewert | 0: Initialisierung erfolgreich; -1: Initialisierung fehlgeschlagen. |
Beispielcode:
LLMHandle llmHandle = nullptr;
rkllm_init(&llmHandle, ¶m, callback);
3.2.5 Modellinferenz
Nach der Initialisierung kann mit rkllm_run() die Modellinferenz ausgeführt werden. Echtzeitergebnisse werden mit der bei der Initialisierung definierten Callback-Funktion verarbeitet. Definition von rkllm_run():
Tabelle 3-21. Schnittstellenspezifikation von rkllm_run
| Funktion | rkllm_run |
|---|---|
| Beschreibung | Inferenz mit dem initialisierten RKLLM-Modell ausführen. |
| Parameter | LLMHandle handle: bei der Initialisierung registriertes Zielhandle. RKLLMInput rkllm_input: Modelleingabe; siehe Eingabestruktur in Abschnitt 3.2.3. RKLLMInferParam rkllm_infer_params: Inferenzparameter; siehe Abschnitt 3.2.3. void* userdata: benutzerdefinierter Funktionszeiger, üblicherweise standardmäßig NULL. |
| Rückgabewert | 0: Modellinferenz läuft normal; -1: Aufruf der Modellinferenz fehlgeschlagen. |
3.2.6 Modellinferenz unterbrechen
Während der Modellinferenz kann rkllm_abort() zur Unterbrechung aufgerufen werden. Definition:
Tabelle 3-22. Schnittstellenspezifikation von rkllm_abort
| Funktion | rkllm_ abort |
|---|---|
| Beschreibung | RKLLM-Modellinferenz unterbrechen. |
| Parameter | LLMHandle handle: bei der Initialisierung registriertes Zielhandle. |
| Rückgabewert | 0: Unterbrechung erfolgreich; -1: Modellunterbrechung fehlgeschlagen. |
3.2.7 Modell freigeben
Nach Abschluss aller Inferenzaufrufe rkllm_destroy() aufrufen, um das RKLLM-Modell zu zerstören und die belegten CPU-, GPU- und NPU-Rechenressourcen für andere Prozesse oder Modelle freizugeben. Definition:
Tabelle 3-23. Schnittstellenspezifikation von rkllm_destroy
| Funktion | rkllm_ destroy |
|---|---|
| Beschreibung | RKLLM-Modell zerstören und alle Rechenressourcen freigeben. |
| Parameter | LLMHandle handle: bei der Initialisierung registriertes Zielhandle. |
| Rückgabewert | 0: Modell erfolgreich zerstört und freigegeben; -1: Freigabe fehlgeschlagen. |
Beispielcode:
// llmHandle is the the target handle registered
rkllm_destroy(llmHandle);
3.2.8 LoRA-Modell laden
RKLLM unterstützt die gemeinsame Ausführung von LoRA-Modellen mit dem Basismodell während der Inferenz. Vor rkllm_run kann ein LoRA-Modell mit rkllm_load_lora geladen werden. Mehrere LoRA-Modelle sind zulässig; jeder Aufruf von rkllm_load_lora lädt ein Modell. Definition:
Tabelle 3-24. Schnittstellenspezifikation von rkllm_load_lora
| Funktion | rkllm_load_lora |
|---|---|
| Beschreibung | LoRA-Modell für das Basismodell laden. |
| Parameter | LLMHandle handle: bei der Modellinitialisierung registriertes Zielhandle; siehe Abschnitt 3.2.4. RKLLMLoraAdapter lora_adapter*: Parameter zum Laden des LoRA-Modells. |
| Rückgabewert | 0: LoRA-Modell erfolgreich geladen; -1: Laden fehlgeschlagen. |
Tabelle 3-25. Struktur-/Statusbeschreibung von RKLLMLoraAdapter
| Definition | RKLLMLoraAdapter |
|---|---|
| Beschreibung | Parameter beim Laden eines LoRA-Modells konfigurieren. |
| Strukturfelder | const char* lora_adapter_path: Pfad zum zu ladenden LoRA-Modell. const char* lora_adapter_name: benutzerdefinierter LoRA-Name zur Auswahl bei der Inferenz. float scale: Stärke, mit der das LoRA-Modell die Basismodellparameter bei der Inferenz verändert. |
Beispiel zum Laden von LoRA:
RKLLMLoraAdapter lora_adapter;
memset(&lora_adapter, 0, sizeof(RKLLMLoraAdapter));
lora_adapter.lora_adapter_path = "lora.rkllm";
lora_adapter.lora_adapter_name = "lora_name";
lora_adapter.scale = 1.0;
ret = rkllm_load_lora(llmHandle, &lora_adapter);
if (ret != 0) {
   printf("\nload lora failed\n");
}
3.2.9 Prompt Cache laden
Die Prefill-Phase benötigt während der Inferenz häufig viele Rechenressourcen und Zeit, insbesondere bei langen Prompts. RKLLM kann Prompt Cache aus Dateien laden, um zwischengespeicherte Inhalte wiederzuverwenden und Prefill zu verkürzen. Vor rkllm_run müssen prompt_cache_params korrekt konfiguriert werden, damit nach der Inferenz die entsprechende Cache-Datei erzeugt wird. Beim ersten Lauf erstellt das System automatisch eine Prompt-Cache-Datei mit wiederverwendbaren Prefill-Zwischenergebnissen. Für spätere Aufgaben wird diese Datei mit rkllm_load_prompt_cache geladen. Funktionsdefinitionen:
Tabelle 3-26. Schnittstellenspezifikation von rkllm_load_prompt_cache
| Funktion | rkllm_load_prompt_cache |
|---|---|
| Beschreibung | Prompt-Cache-Datei laden. |
| Parameter | LLMHandle handle: bei der Modellinitialisierung registriertes Zielhandle; siehe Abschnitt 3.2.4. const char* prompt_cache_path: Pfad zur zu ladenden Prompt-Cache-Datei. |
| Rückgabewert | 0: Prompt-Cache-Datei erfolgreich geladen; -1: Laden fehlgeschlagen. |
Tabelle 3-27. Schnittstellenspezifikation von rkllm_release_prompt_cache
| Funktion | rkllm_release_prompt_cache |
|---|---|
| Beschreibung | Prompt Cache freigeben. |
| Parameter | LLMHandle handle: bei der Modellinitialisierung registriertes Zielhandle; siehe Abschnitt 3.2.4. |
| Rückgabewert | 0: Prompt-Cache-Modell erfolgreich freigegeben; -1: Modellfreigabe fehlgeschlagen. |
Hinweis: RKLLM erkennt den Anfang der Eingabe, der mit prompt_cache übereinstimmt. Bei einem festen Format PROMPT_PREFIX + text + PROMPT_POSTFIX kann ein Cache nur für PROMPT_PREFIX erzeugt und nach dem Laden dessen Ergebnis wiederverwendet werden. RKLLM unterstützt mehrere Prompt-Cache-Dateien; laden Sie jeweils die benötigte Datei. Beim Wechsel zu einem anderen Cache oder wenn der geladene Cache nicht mehr benötigt wird, muss er ausdrücklich mit rkllm_release_prompt_cache freigegeben werden.
Beispiel zum Laden des Prompt Cache:
// Initialize and set the Prompt Cache parameters, then call the run interface to generate the Prompt Cache file.

RKLLMPromptCacheParam prompt_cache_params;
// Whether to save the prompt cache
prompt_cache_params.save_prompt_cache = true;
// If you need to save the prompt cache, specify the absolute path of the cache file.
prompt_cache_params.prompt_cache_path = "/data/prompt_cache.bin";
rkllm_infer_params.prompt_cache_params = &prompt_cache_params;
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
rkllm_input.input_type = RKLLM_INPUT_PROMPT;
rkllm_input.prompt_input = (char *)prompt.c_str();
rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);
// Load the prompt cache file to reduce prefill time.
rkllm_load_prompt_cache(llmHandle, "./prompt_cache.bin");
if (ret != 0) {
   printf("\nload Prompt Cache failed\n");
}
rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);
3.2.10 KV-Cache-Verwaltung
RKLLM erlaubt die manuelle Löschung des KV Cache für ein- und mehrrundige Gespräche. Bei keep_system_prompt=1 bleibt ein vorhandener System-Prompt erhalten; andernfalls wird der gesamte Cache gelöscht. Funktionsdefinition:
Tabelle 3-28. Schnittstellenspezifikation von rkllm_clear_kv_cache
| Funktion | rkllm_clear_kv_cache |
|---|---|
| Beschreibung | KV Cache löschen. |
| Parameter | LLMHandle handle: bei der Modellinitialisierung registriertes Zielhandle; siehe Abschnitt 3.2.4. keep_system_prompt: System-Prompt behalten (1 behalten, 0 löschen). start_pos: Startpositions-ID des zu löschenden KV Cache, einschließlich; bei Nichtverwendung ausdrücklich auf nullptr setzen. end_pos: Endpositions-ID, ausschließlich; bei Nichtverwendung ausdrücklich auf nullptr setzen. Hinweis: Positionsbezogenes Löschen wird nur bei pausierter Inferenz im einrundigen Modus unterstützt. Bei Angabe von [start_pos, end_pos) wird keep_system_prompt ignoriert und der Cache dieses Bereichs gelöscht. |
| Rückgabewert | 0: KV Cache erfolgreich gelöscht; -1: Löschen fehlgeschlagen. |
3.2.11 Chat-Vorlage konfigurieren
Vor der Verarbeitung von Eingabetext analysiert RKLLM automatisch das Feld chat_template in tokenizer_config.json des HuggingFace-Modells und wendet die Prompt-Vorlage an. Bei Bedarf kann sie mit folgender Funktion neu gesetzt werden. system_prompt steuert als System-Prompt das Modellverhalten; prompt_prefix steht vor, prompt_postfix hinter der Benutzereingabe. Nach dem Zurücksetzen der Vorlage ist enable_thinking unwirksam und muss im benutzerdefinierten Prompt konfiguriert werden. Definition:
Tabelle 3-29. Schnittstellenspezifikation von rkllm_set_chat_template
| Funktion | rkllm_set_chat_template |
|---|---|
| Beschreibung | Prompt-Vorlage festlegen. |
| Parameter | LLMHandle handle: bei der Modellinitialisierung registriertes Zielhandle; siehe Abschnitt 3.2.4. system_prompt: System-Prompt zur Steuerung des Modellverhaltens. prompt_prefix: Präfix vor der Benutzereingabe. prompt_postfix: Suffix nach der Benutzereingabe. |
| Rückgabewert | 0: Chat-Vorlage erfolgreich gesetzt; -1: Setzen fehlgeschlagen. |
3.2.12 Function Calling konfigurieren
RKLLM unterstützt über Function Calling die strukturierte Interaktion zwischen Modell und externen Systemen. Dies erweitert LLM-Fähigkeiten etwa für Wissensanreicherung und präzisen Datenabruf. Im aktivierten Modus übergibt die Anwendung Funktionsdefinitionen an das Modell. Anhand der Benutzerfrage entscheidet das Modell, ob ein Aufruf nötig ist, und gibt eine Anfrage im festgelegten Format aus. Die Anwendung ruft die entsprechende Funktion auf und liefert das Ergebnis zurück, worauf das Modell das Gespräch fortsetzt. Konfigurationsfunktion:
Tabelle 3-30. Schnittstellenspezifikation von rkllm_set_chat_template
| Funktion | rkllm_set_function_tools |
|---|---|
| Beschreibung | Function Calling konfigurieren, einschließlich System-Prompt, Werkzeugdefinitionen und Werkzeugantwortkennzeichnung. |
| Parameter | LLMHandle handle: bei der Modellinitialisierung registriertes Zielhandle; siehe Abschnitt 3.2.4. system_prompt: System-Prompt zur Modellsteuerung. tools: JSON-formatierte Funktionsdefinitionszeichenkette mit verfügbaren Funktionen, Namen, Zwecken und Parameterformaten. tool_response_str: Kennzeichnung von Werkzeugaufrufergebnissen zur Unterscheidung von normalen Gesprächsinhalten. |
| Rückgabewert | 0: Konfiguration erfolgreich; -1: Konfiguration fehlgeschlagen. |
Beispiel: Zunächst die Werkzeuge konfigurieren.
std::string system_prompt = "You are Qwen, created by Alibaba Cloud. You are a helpful assistant.\n\nCurrent Date: 2024-09-30";
std::string tools = R"([
   {
       "type": "function",
       "function": {
          "name": "get_current_temperature",
          "description": "Get current temperature at a location.",
          "parameters": {
             "type": "object",
             "properties": {
                 "location": {
                    "type": "string",
                    "description": "The location to get the temperature for, in the format \"City, State, Country\"."
                 },
                 "unit": {
                    "type": "string",
                    "enum": ["celsius", "fahrenheit"],
                    "description": "The unit to return the temperature in. Defaults to \"celsius\"."
                 }
             },
             "required": ["location"]
          }
       }
   },
   {
       "type": "function",
       "function": {
          "name": "get_temperature_date",
          "description": "Get temperature at a location and date.",
          "parameters": {
             "type": "object",
             "properties": {
                 "location": {
                    "type": "string",
                    "description": "The location to get the temperature for, in the format \"City, State, Country\"."
                 },
                 "date": {
                    "type": "string",
                    "description": "The date to get the temperature for, in the format \"Year-Month-Day\"."
                 },
                 "unit": {
                    "type": "string",
                    "enum": ["celsius", "fahrenheit"],
                    "description": "The unit to return the temperature in. Defaults to \"celsius\"."
                 }
             },
             "required": ["location", "date"]
          }
       }
   }
])";

rkllm_set_function_tools(llmHandle, system_prompt.c_str(),
tools.c_str(), "tool_response");
Anschließend während der Inferenz mit rkllm_run zur Function-Calling-Kette verbinden:
// User's question
RKLLMInferParam rkllm_infer_params;
memset(&rkllm_infer_params, 0, sizeof(RKLLMInferParam));
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
rkllm_infer_params.keep_history = 0;

RKLLMInput rkllm_input;
rkllm_input.input_type = RKLLM_INPUT_PROMPT;
rkllm_input.enable_thinking = false;

rkllm_input.role = "user";
rkllm_input.prompt_input = "What's the temperature in San Francisco now? How about tomorrow?";

rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);

// the first call to rkllm_run will return the name of the tool function that needs to be called;

<tool_call>
{"name": "get_current_temperature", "arguments": {"location": "San Francisco"}}
</tool_call>
<tool_call>
{"name": "get_temperature_date", "arguments": {"location": "San Francisco", "date": "2024-10-01"}}
</tool_call>

// return the tool call result to llm, and the role must be set to "tool"

rkllm_input.role = "tool";
rkllm_input.prompt_input = R"([
   {
       "temperature": 26.1,
       "location": "San Francisco",
       "unit": "celsius"
   },
   {
       "temperature": 25.9,
       "location": "San Francisco",
       "date": "2024-09-30",
       "unit": "celsius"
   }
])";

rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);

// final result
"The current temperature in San Francisco is 26.1°C. Tomorrow, the temperature is expected to be 25.9°C."
3.2.13 Cross-Attention konfigurieren
RKLLM unterstützt Cross-Attention. Vom Encoder erzeugter K/V Cache, Maske und Positionsinformationen können mit folgender Funktion für die Cross-Attention-Berechnung an den Decoder übergeben werden. Unterstützt wird dies nur bei benutzerdefinierten Modellen; die Modellkonvertierung beschreibt Abschnitt 3.1.6.
Tabelle 3-31. Schnittstellenspezifikation von rkllm_set_cross_attn_params
| Funktion | rkllm_set_cross_attn_params |
|---|---|
| Beschreibung | Cross-Attention-Parameter konfigurieren. |
| Parameter | LLMHandle handle: bei der Modellinitialisierung registriertes Zielhandle; siehe Abschnitt 3.2.4. RKLLMCrossAttnParam* cross_attn_params: Cross-Attention-Parameter. |
| Rückgabewert | 0: Konfiguration erfolgreich; -1: Konfiguration fehlgeschlagen. |
Tabelle 3-32. Struktur-/Statusbeschreibung von RKLLMCrossAttnParam
| Funktion | RKLLMCrossAttnParam |
|---|---|
| Beschreibung | Cross-Attention-Parameter. |
| Strukturfelder | - float* encoder_k_cache: Zeiger auf den Ausgabe-Key-Cache des Encoders - float* encoder_v_cache: Zeiger auf den Ausgabe-Value-Cache des Encoders - float* encoder mask: Attention-Maske des Encoders - int32_t* encoder_pos: Positionsinformationen der Encoder-Eingabetokens - int* num_tokens: Anzahl der Encoder-Eingabetokens |
3.2.14 Parallele Inferenz mehrerer Batches
RKLLM unterstützt gleichzeitige Inferenz mehrerer Batches; empfohlen sind höchstens 8. Nachfolgend ein Beispiel für zwei Batches:
- Bei der Modellinitialisierung muss param.extend_param.n_batch auf 2 gesetzt werden.
- Bei Inferenz mehrerer Batches sind RKLLMInput und RKLLMResult im Callback Arrays der Größe n_batch.
- Die Ergebnisse aller Batches werden synchron im Callback zurückgegeben. Eine negative Token-ID eines Batches zeigt dessen Abschluss an. Die Inferenz endet erst, wenn alle Batches fertig sind.
- Vor einer Zuweisung des zurückgegebenen Textes im Callback prüfen, ob der Zeiger null ist.
#include <string.h>
#include <unistd.h>
#include <string>
#include "rkllm.h"
#include <fstream>
#include <iostream>
#include <csignal>
#include <vector>
using namespace std;
LLMHandle llmHandle = nullptr;
std::string output_texts[10];
int callback(RKLLMResult *result, void *userdata, LLMCallState state)
{
if (state == RKLLM_RUN_FINISH)
{
printf("\nrkllm run finish\n");
} else if (state == RKLLM_RUN_ERROR) {
printf("\nrkllm run error\n");
} else if (state == RKLLM_RUN_NORMAL) {
RKLLMResult batch1 = result[0];
RKLLMResult batch2 = result[1];
if (batch1.text) {
output_texts[0] += batch1.text;
printf("batch 0 %s\n", output_texts[0].c_str());
}
if (batch2.text) {
output_texts[1] += batch2.text;;
printf("batch 1 %s\n", output_texts[1].c_str());
}
}
return 0;
}
int main(int argc, char **argv)
{
if (argc < 4) {
std::cerr << "Usage: " << argv[0] << " model_path max_new_tokens max_context_len\n";
return 1;
}
RKLLMParam param = rkllm_createDefaultParam();
param.model_path = argv[1];
param.top_k = 1;
param.top_p = 0.95;
param.temperature = 0.8;
param.repeat_penalty = 1.1;
param.frequency_penalty = 0.0;
param.presence_penalty = 0.0;
param.max_new_tokens = std::atoi(argv[2]);
param.max_context_len = std::atoi(argv[3]);
param.skip_special_token = true;
param.extend_param.base_domain_id = 0;
param.extend_param.embed_flash = 1;
param.extend_param.n_batch = 2;
int ret = rkllm_init(&llmHandle, ¶m, callback);
if (ret == 0){
printf("rkllm init success\n");
} else {
printf("rkllm init failed\n");
exit_handler(-1);
}
RKLLMInput rkllm_input[2];
memset(&rkllm_input, 0, sizeof(RKLLMInput)*2);
RKLLMInferParam rkllm_infer_params;
memset(&rkllm_infer_params, 0, sizeof(RKLLMInferParam));
output_texts[0].clear();
output_texts[1].clear();
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
rkllm_infer_params.keep_history = 0;
rkllm_input[0].input_type = RKLLM_INPUT_PROMPT;
rkllm_input[0].role = "user";
rkllm_input[0].enable_thinking = false;
rkllm_input[0].prompt_input = "上联: 江边惯看千帆过";
rkllm_input[1].input_type = RKLLM_INPUT_PROMPT;
rkllm_input[1].role = "user";
rkllm_input[1].enable_thinking = false;
rkllm_input[1].prompt_input = "以咏梅为题目,帮我写一首古诗,要求包含梅花、白雪等元素。";
printf("robot: ");
rkllm_run(llmHandle, &rkllm_input[0], &rkllm_infer_params, NULL);
rkllm_destroy(llmHandle);
return 0;
}
3.2.15 Modellinferenz pausieren
RKLLM kann die Inferenz im einrundigen Modus durch Rückgabe von 1 im Callback pausieren. Der KV Cache bleibt dabei erhalten; die Eingabe kann geändert und die Inferenz mit einem erneuten rkllm_run fortgesetzt werden.
3.2.16 Callback für Modellleistungsdaten
RKLLM kann am Ende einer einzelnen Inferenz Leistungsdaten zurückgeben: Gesamtzeit von Prefill und Decodierung, Tokenanzahl und Speicherbedarf. Die Rückgabestruktur ist wie folgt definiert:
Tabelle 3-33. Struktur-/Statusbeschreibung von RKLLMPerStat
| Definition | RKLLMPerfStat |
|---|---|
| Beschreibung | Leistungsdaten der Modellinferenz zurückgeben. |
| Strukturfelder | - float prefill_time_ms: gesamte Prefill-Zeit in Millisekunden - int prefill_tokens: gesamte Tokenanzahl in der Prefill-Phase - float generate_time_ms: gesamte Generierungszeit in Millisekunden - int generate_tokens: gesamte Tokenanzahl in der Generierungsphase - float memory_usage_mb: mit VmHWM gemessener Inferenzspeicherbedarf in Megabyte |
3.3 Beispiel für Inferenz auf der Platine
Das Verzeichnis examples/rkllm_api_demo enthält das C++-Projekt für Inferenz auf der Platine und wird gemeinsam mit dieser Dokumentation aktualisiert. Kompilierungsskripte erleichtern den Projektaufbau und die Ausführung des RKLLM-Modells auf der Platine.
3.3.1 Vollständiger Code des Beispielprojekts
Das vollständige C++-Beispiel liegt unter example/rkllm_api_demo/deploy/src der Werkzeugkette. llm_demo.cpp zeigt den gesamten LLM-Inferenzablauf: Initialisierung, Inferenz, Ausgabeverarbeitung über Callbacks und Ressourcenfreigabe. Der entsprechende Code kann als Grundlage für eigene Funktionen verwendet werden.
3.3.2 Anleitung zum Beispielprojekt
Unter examples/rkllm_api_demo/deploy befinden sich Beispielcode für Inferenzaufrufe sowie build-android.sh und build-linux.sh. Die Verwendung wird nachfolgend anhand der Kompilierung
ausführbarer Linux-Dateien mit build-linux.sh beschrieben. Zunächst einen Cross-Compiler bereitstellen; Abschnitt 2.3 empfiehlt Version 10.2 oder höher. Vor der Kompilierung den Pfad zum Cross-Compiler in build-linux.sh anpassen:
# Set the path of the cross-compiler GCC_COMPILER_PATH=~/gcc-arm-10.2-2020.11-x86_64-aarch64-none-linux-gnu/bin/aarch64-none-linux-gnu
Anschließend die Kompilierung mit build-linux.sh starten. Das erzeugte Programm llm_demo wird unter install/demo_linux_aarch64/llm_demo installiert. Danach ausführbare Datei, Bibliotheksverzeichnis und das zuvor mit RKLLM-Toolkit konvertierte und quantisierte Modell auf die Platine übertragen.
adb push install/demo_Linux_aarch64  /data
adb push /PC/path/to/your/rkllm/model /data/demo_Linux_aarch64
Nach diesen Schritten über adb das Terminal der Platine öffnen, nach /data/demo_linux_aarch64 wechseln und die Modellinferenz mit folgendem Befehl aufrufen:
adb shell
cd /data/demo_linux_aarch64
export LD_LIBRARY_PATH=./lib
./llm_demo /path/to/your/rkllm/model 1024 2048
Damit wird die Beispiel-Inferenzoberfläche geöffnet, über die mit dem Modell auf der Platine interagiert und dessen Echtzeitergebnisse abgerufen werden können.
3.3.3 Inferenzleistung überwachen und Protokolle anzeigen
Zur Anzeige von RKLLM-Leistungsdaten oder Protokollen während der Inferenz auf der Platine dienen folgende Befehle:
# View only TTFT, TPS, and memory usage data
export RKLLM_LOG_LEVEL=1
# In addition to performance data, also prints cache length and more details
export RKLLM_LOG_LEVEL=2
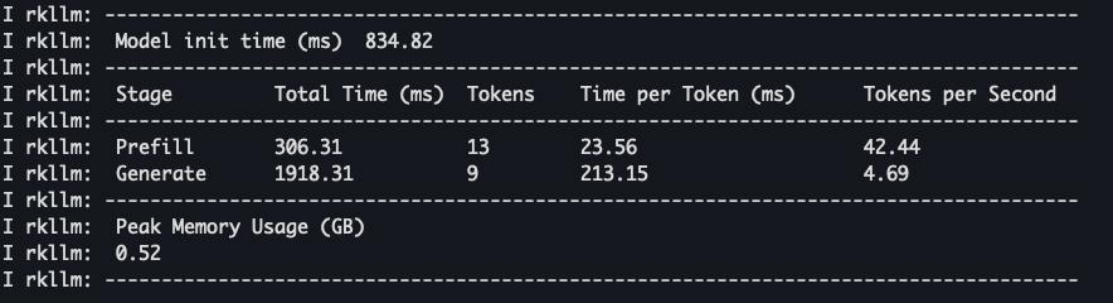
Kopierbare Abschrift des Originalprotokolls (keine ArmSoM-Messung; unkenntliches Konto nicht rekonstruiert):
Model initialization: 834.82 ms
Stage       Total Time (ms)  Tokens  Time per Token (ms)  Tokens per Second
Prefill     306.31           13      23.56                42.44
Generate    1918.31          9       213.15               4.69
Peak Memory Usage (GB): 0.52
Abbildung 3-1. RKLLM-Inferenzleistungsprotokoll auf der Hardwareplattform
3.4 Server auf der Platine implementieren
Nach der Modellkonvertierung mit RKLLM-Toolkit kann auf einer Linux-Entwicklungsplatine ein Server eingerichtet werden, der Netzwerkschnittstellen für alle Teilnehmer im lokalen Netz bereitstellt. Andere Benutzer können über die angegebene Adresse auf das RKLLM-Modell zugreifen und einfach interagieren. Dieser Abschnitt beschreibt zwei Serverimplementierungen.
1) RLM-Server-Flask auf Basis von Flask: Client und Server greifen mittels Anfragen über die API aufeinander zu. Das bereitgestellte RKLLM-Server-Flask-Beispiel enthält ein normales Gespräch und ein einrundiges Gespräch mit Function Calling.
2) RKLLM-Server-Gradio auf Basis von Gradio: Das Beispiel ermöglicht den schnellen Aufbau eines Webservers mit visueller Interaktion und zeigt die Gradio-API für Weiterentwicklungen. Beide Implementierungen liegen in examples/rkllm_server_demo. Das Verzeichnis enthält Implementierungscode, Ein-Klick-Bereitstellungsskripte und API-Aufrufbeispiele. Wählen Sie das passende Beispiel als Referenz und zur Weiterentwicklung. Verzeichnisstruktur:
examples/rkllm_server_demo
├──rkllm_server          # Board-side Deployment Required Files
│   └── lib                    # RKLLM Runtime
│   └── flask_server.py            # RKLLM-Server-Flask Example
│   └── gradio_server.py           # RKLLM-Server-Gradio Example
├──build_rkllm_server_flask.sh # One-click Deployment Script -Flask
├──build_rkllm_server_gradio.sh# One-click Deployment Script -Gradio
├──chat_api_flask.py           # API Interface Example -Flask
├──chat_api_gradio.py          # API Interface Example -Gradio
└──Readme.md
3.4.1 Bereitstellungsbeispiel für RKLLM-Server-Flask
Das RKLLM-Server-Flask-Beispiel verwendet Flask zum Serveraufbau. Der Client überträgt für den API-Zugriff Daten im Anfrage-Antwort-Verfahren und sendet bestimmte Datenstrukturen an den Server. Die wichtigsten Inhalte sind:
{
   "model": "No models available",
   "messages": [
     {"role": "system",
       "content": "You are a helpful assistant."
     },
     {
       "role": "user",
       "content": "Hello!"
     }
   ],
   "stream": false,
   "enable_thinking": False,
   "tools": None

}
“model” und “stream” legen Modell und Streaming-Inferenz fest; “content” in “messages” enthält die Benutzereingabe. “enable_thinking” steuert vertieftes Nachdenken beim Antworten und muss passend zur Modellunterstützung gesetzt werden. “tools” beschreibt die benutzerdefinierte Funktion für Function Calling (Definitionsregeln in Abschnitt 3.4.1.3.2). Auch dieser Parameter hängt von der Unterstützung durch das Modell ab; bei fehlender Unterstützung oder Nichtverwendung auf “None” setzen.
Die Rückgabestruktur des Servers hängt davon ab, ob Streaming gewählt wurde. Bei nicht streamender Inferenz werden folgende Daten zurückgegeben:
{
  "id": "chatcmpl-123",
  "object": "chat.completion",
  "created": 1677652288,
  "model": "gpt-3.5-turbo-0125",
  "system_fingerprint": "fp_44709d6fcb",
  "choices": [{
   "index": 0,
   "message": {
     "role": "assistant",
     "content": "\n\nHello there, how may I assist you today?",},
   "logprobs": null,
   "finish_reason": "stop"
  }],
  "usage": {
   "prompt_tokens": 9,
   "completion_tokens": 12,
   "total_tokens": 21
  }
}
Ohne Streaming ist “messages” in “choices” der wichtigste Inhalt und enthält das Inferenzergebnis des Modells. Bei Streaming gibt der Server ein Response-Objekt mit Modellausgaben zu verschiedenen Zeitpunkten der Inferenz zurück. Die Daten zu jedem Zeitpunkt lauten:
{
"id": "chatcmpl-123",
  "object": "chat.completion.chunk",
  "created": 1677652288,
  "model": "gpt-3.5-turbo-0125",
  "system_fingerprint": "fp_44709d6fcb",
  "choices": [{
   "index": 0,
   "delta": {
     "role": "assistant",
     "content": "\n\nHello there, how may I assist you today?",},
   "logprobs": null,
   "finish_reason": "stop"
  }]
}
Bei Streaming-Daten ist der Abschnitt “delta” innerhalb von “choices” zu beachten. Ein leeres “finish_reason” (None) bedeutet, dass das Modell noch inferiert und die Generierung nicht abgeschlossen ist. Erst wenn “finish_reason”
“stop” zurückgibt, gilt die Streaming-Inferenz als beendet. Bereitstellungscode und API-Zugriffsbeispiele von RKLLM-Server-Flask verwenden identische Übertragungsstrukturen für einen universell nutzbaren Server. Nachfolgend werden Ein-Klick-Bereitstellungsskript, wichtige Servereinstellungen und der Aufbau der Client-API-Skripte getrennt erläutert.
3.4.1.1 Server: Ein-Klick-Bereitstellungsskript für RKLLM-Server-Flask
Das Skript build_rkllm_server_flask.sh in rkllm_server_demo richtet RKLLM-Server-Flask schnell auf einer Linux-Platine ein. Vor der Verwendung ist Folgendes zu beachten:
1) Platine per Ethernet-Kabel mit dem Netzwerk verbinden. In adb shell mit ifconfig ihre IP-Adresse bestimmen. RKLLM-Server-Flask verwendet diese Adresse für den Server im lokalen Netz und für Clientzugriffe.
2) RKLLM-Modell vorab erfolgreich konvertieren und vor dem Skriptaufruf auf die Linux-Platine übertragen. build_rkllm_server_flask.sh wird direkt auf dem PC, nicht auf der Platine, aufgerufen und stellt den Server auf der Platine bereit. Verwendung:
./build_rkllm_server_flask.sh
   --workshop [RKLLM-Server Working Path]
   --model_path [Absolute Path of Converted RKLLM Model on Board] --platform [Target Platform: RK3588/RK3576/RK3562/RV1126B]
   [--lora_model_path [LoRA Model Path]]
   [--prompt_cache_path [Prompt Cache File Path]]
workshop legt das Arbeitsverzeichnis von RKLLM-Server-Flask auf der Platine fest; model_path den absoluten Pfad zum mit RKLLM-Toolkit konvertierten Modell, das der Server von diesem
Pfad zur Laufzeit liest. platform bezeichnet die aktuelle Plattform: RK3588, RK3576, RK3562 oder RV1126B. Die optionalen Parameter lora_model_path und prompt_cache_path geben Pfade zum Laden von LoRA beziehungsweise zur Prompt-Nutzung an. Einfaches Beispiel für build_rkllm_server_flask.sh:
./build_rkllm_server_flask.sh
   --workshop /path/to/workshop
   --model_path /path/to/model.rkllm
   --platform rk3588
Nach dem Aufruf führt das Bereitstellungsskript folgende Schritte aus:
1) Linux-Umgebung auf der Platine prüfen.
2) Flask automatisch installieren, falls noch nicht vorhanden.
3) Benötigte Dateien aus rkllm_server_demo/rkllm_server auf die Platine übertragen.
4) RKLLM-Modell im festgelegten Arbeitsverzeichnis von RKLLM-Server-Flask referenzieren. Die Terminalmeldung “RKLLM Model has been initialized successfully!” zeigt den erfolgreichen Start des Beispiels an.
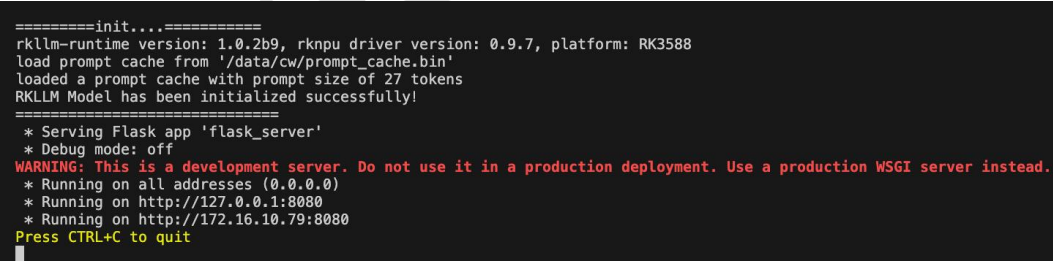
Kopierbare Abschrift des Originalprotokolls (keine ArmSoM-Messung; unkenntliches Konto nicht rekonstruiert):
=========init....===========
rkllm-runtime version: 1.0.2b9, rknpu driver version: 0.9.7, platform: RK3588
load prompt cache from '/data/cw/prompt_cache.bin'
loaded a prompt cache with prompt size of 27 tokens
RKLLM Model has been initialized successfully!
===========================
 * Serving Flask app 'flask_server'
 * Debug mode: off
WARNING: This is a development server. Do not use it in a production deployment. Use a production WSGI server instead.
 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:8080
 * Running on http://172.16.10.79:8080
Press CTRL+C to quit
Abbildung 3-2. Erfolgreicher Start von RKLLM-Server-Flask im Terminal. Der Code von build_rkllm_server_flask.sh erläutert den Bereitstellungsablauf und ermöglicht eine flexible Anpassung eigener Server. Wichtig: In Schritt 3 synchronisiert das Skript die aktuelle RKLLM Runtime automatisch nach rkllm_server/lib/librkllmrt.so. Damit ruft flask_server.py zur Laufzeit die aktuelle librkllmrt.so auf.
3.4.1.2 Server: Implementierung des RKLLM-Server-Flask-Beispiels
Im Folgenden wird die Implementierung von RKLLM-Server-Flask erläutert, um Codeverständnis und Weiterentwicklung zu erleichtern. Der Server basiert hauptsächlich auf Flask; für Inferenz ruft Python ctypes die RKLLM-Runtime-Bibliothek direkt auf. Für den ctypes-Aufruf von librkllmrt.so in rkllm_server/flask_server.py müssen die entsprechenden Python-Strukturen vorab anhand der zugehörigen Headerdatei rkllm.h definiert werden. Nach Empfang der Benutzerdatenstruktur ruft Flask die Funktionen zur RKLLM-Inferenz auf. Hauptschritte von flask_server.py:
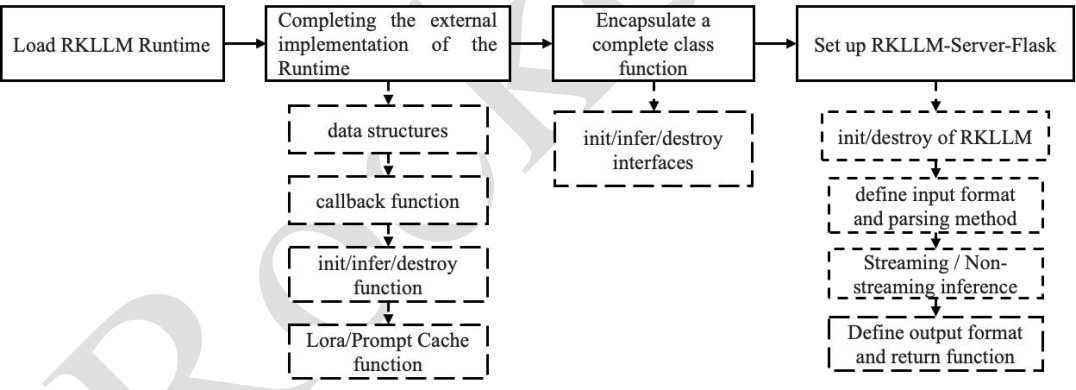
Abbildung 3-3. Ablauf der RKLLM-Server-Flask-Bereitstellungsimplementierung
1) RKLLM Runtime laden: Bibliothekspfad setzen und librkllmrt.so mit ctypes laden, um RKLLM Runtime zu erschließen.
2) Externe Runtime-Implementierung vervollständigen: In Python mit ctypes die Definitionen aus den RKLLM-Runtime-Headern abbilden, darunter Datenstrukturen, Callbacks, Initialisierung, Inferenz, Freigabe sowie Ladefunktionen für LoRA/Prompt Cache.
3) Vollständige Klasse kapseln: Auf Grundlage der verschiedenen Runtime-Datentypen und Funktions-
schnittstellen aus Schritt 2) eine vollständige Klasse erstellen, die Initialisierung, Inferenz, Freigabe und weitere RKLLM-Vorgänge für spätere Aufrufe integriert.
4) RKLLM-Server-Flask einrichten: Mit der Klasse aus Schritt 3 den Flask-Server aufbauen. Dazu beim Start das Modell anhand von Benutzerparametern laden, Eingabeformat und Parser definieren, Streaming- und Nicht-Streaming-Inferenz unterscheiden, Rückgabeformat und Callback-Implementierung festlegen sowie RKLLM freigeben. Diese Module bilden den Hauptcode von rkllm_server/flask_server.py und vervollständigen die Beispielbereitstellung. Für andere eigene Modelle können die RKLLM-Initialisierungsdefinitionen angepasst werden; das Beispiel dient auch als Vorlage für eigene Server.
3.4.1.3 Client: Beispiel für API-Zugriff
rkllm_server_demo/chat_api_flask.py enthält ein normales Gespräch (Hauptcode main_demo1) und ein einrundiges Gespräch mit Function Calling (Hauptcode main_demo2).
3.4.1.3.1 Beispiel 1 - normales Gespräch
Das Beispiel zeigt einen gewöhnlichen Frage-Antwort-Dialog. Der Ablauf wird nachfolgend erläutert:
1) Netzwerkadresse von RKLLM-Server-Flask anhand der IP der Linux-Platine, des Flask-Ports und des aufzurufenden Funktionsnamens festlegen.
server_url = 'http://172.16.10.xx:8080/rkllm_chat'
2) API-Zugriffsmodus wählen: Nicht-Streaming oder Streaming; Standard ist Nicht-Streaming.
main_demo1(is_streaming=True)
3) Sitzungsobjekt requests.Session() für die Kommunikation zwischen API und Server definieren. Benutzer können es entsprechend ihren Entwicklungsanforderungen anpassen.
session = requests.Session()
session.keep_alive = False  # Close the connection pool
adapter = requests.adapters.HTTPAdapter(max_retries=5)
session.mount('https://', adapter)
session.mount('http://', adapter)
4) Struktur zur Kapselung der bei API-Aufrufen gesendeten Daten definieren. Der Zugriff auf RKLLM-Server-Flask wird in dieser Struktur verpackt.
# Prepare the data to be sent
# model: the model defined by the user when setting up RKLLM-Server, which has no effect here
# messages: the questions input by the user; supports adding multiple questions to messages
# stream: whether to enable streaming dialogue, same as the OpenAI interface
# enable_thinking: whether to enable deep thinking
# tools: user's description of custom functions
data = {
   "model": 'your_model_deploy_with_RKLLM_Server',
   "messages": [{"role": "user", "content": user_message}],
   "stream": is_streaming,
   "enable_thinking": False,
   "tools": None
}
5) Anfrage an RKLLM-Server-Flask senden und Rückgabedaten abrufen.
responses = session.post(server_url, json=data, headers=headers,
stream=is_streaming, verify=False)
6) Verfahren zum Parsen der Rückgabestruktur definieren.
# Parse the response
# Non-streaming transmission
if not is_streaming:
       if responses.status_code == 200:
       print("Q:", data["messages"][-1]["content"])
       print("A:", json.loads(responses.text)["choices"][-1]["message"]["content"])
   else:
       print("Error:", responses.text)

# Streaming transmission
else:
   if responses.status_code == 200:
       print("Q:", data["messages"][-1]["content"])
       print("A:", end="")
       for line in responses.iter_lines():
if line:
             line = json.loads(line.decode('utf-8'))
             if line["choices"][-1]["finish_reason"] != "stop":
                 print(line["choices"][-1]["delta"]["content"], end="")

                 sys.stdout.flush()
   else:
       print('Error:', responses.text)
Die Schritte 1–6 zeigen den API-Zugriff auf RKLLM-Server-Flask und können als Grundlage eigener Funktionen dienen. Die konkrete Serveradresse muss geprüft werden: IP, Port und die Eingabeschnittstelle des Servers. Bei besonderen Anforderungen an Sende-/Empfangsstrukturen müssen Client und Server passend angepasst werden, um eigene Funktionen umzusetzen.
3.4.1.3.2 Beispiel 2 - einrundiges Gespräch mit Function Calling
LLMs kennen keine Informationen außerhalb ihrer Trainingsdaten, einschließlich Ereignissen nach Trainingsabschluss. Ihr probabilistisches Lernen kann zudem für streng regelbasierte Aufgaben wie mathematische Berechnungen zu ungenau sein. Function Calling erlaubt dem Modell, anhand der Benutzeranfrage vordefinierte Funktionen für genauere und aktuelle Informationen aufzurufen. Als Beispiel dient eine Wetterabfrage nach der aktuellen und morgigen Temperatur in San Francisco. Normalerweise kann das Modell solche Echtzeitfragen nicht beantworten; der
Benutzer verfügt jedoch über zwei Funktionen: eine für die aktuelle Stadttemperatur und eine für eine bestimmte Datumsangabe. Das Modell soll mit diesen Funktionen eine genaue Antwort erzeugen.
1) RKLLM-Server-Flask-Adresse anhand der IP der Linux-Platine, des Flask-Ports und des aufzurufenden Funktionsnamens festlegen.
server_url = 'http://172.16.10.166:8080/rkllm_chat'
2) API-Zugriffsmodus wählen: Nicht-Streaming oder Streaming; Standard ist Nicht-Streaming.
main_demo2(is_streaming=True)
3) Sitzungsobjekt requests.Session() für die Kommunikation zwischen API und Server definieren. Benutzer können es entsprechend ihren Entwicklungsanforderungen anpassen.
session = requests.Session()
session.keep_alive = False
adapter = requests.adapters.HTTPAdapter(max_retries=5)
session.mount('https://', adapter)
session.mount('http://', adapter)
4) Aufzurufende Funktionen definieren: get_current_temperature liefert die aktuelle Temperatur einer angegebenen Stadt; get_temperature_date die Temperatur einer angegebenen Stadt zu einem angegebenen Datum.
def get_current_temperature(location: str, unit: str = "celsius"):
       """
       Get current temperature at a location.

       Args:
          location: The location to get the temperature for, in the
format "City, State, Country".
          unit: The unit to return the temperature in. Defaults to
"celsius". (choices: ["celsius", "fahrenheit"])

       Returns:
          the temperature, the location, and the unit in a dict
       """
       return {
          "temperature": 26.1,
          "location": location,
          "unit": unit,
       }

def get_temperature_date(location: str, date: str, unit: str =
"celsius"):
       """
       Get temperature at a location and date.

       Args:
          location: The location to get the temperature for, in the
format "City, State, Country".
          date: The date to get the temperature for, in the format
"Year-Month-Day".
          unit: The unit to return the temperature in. Defaults to
"celsius". (choices: ["celsius", "fahrenheit"])

       Returns:
          the temperature, the location, the date and the unit in a
dict
       """
       return {
          "temperature": 25.9,
          "location": location,
          "date": date,
          "unit": unit}
5) Beschreibung der benutzerdefinierten Funktionen definieren. TOOLS enthält im Beispiel zwei Funktionsbeschreibungen. Jede ist ein JSON-Objekt mit zwei Feldern:
- type: Zeichenkette für den Werkzeugtyp, derzeit nur “function” zulässig;
- function: Objekt zur detaillierten Funktionsbeschreibung mit drei Feldern: name als Funktionsname, description als Zweckbeschreibung und parameters als JSON Schema (https://json-schema.org/learn/getting-started-step-by-step) zur
Beschreibung der akzeptierten Parameter. Der verlinkte Leitfaden erklärt den Aufbau von JSON Schema; wichtige Felder sind type, required und enum.
TOOLS = [
       {
          "type": "function",
          "function": {
             "name": "get_current_temperature",
             "description": "Get current temperature at a location.",
             "parameters": {
                 "type": "object",
                 "properties": {
                    "location": {
                       "type": "string",
                       "description": 'The location to get the temperature for, in the format "City, State, Country".',
                    },
                    "unit": {
                       "type": "string",
                       "enum": ["celsius", "fahrenheit"],
                       "description": 'The unit to return the temperature in. Defaults to "celsius".',
                    },
                 },
                 "required": ["location"],
             },
          },
       },
       {
          "type": "function",
          "function": {
             "name": "get_temperature_date",
             "description": "Get temperature at a location and date.",
             "parameters": {
                 "type": "object",
                 "properties": {
                    "location": {
                       "type": "string",
                       "description": 'The location to get the temperature for, in the format "City, State, Country".',
                    },
                    "date": {
                       "type": "string",
                       "description": 'The date to get the temperature for, in the format "Year-Month-Day".',
                    },
                    "unit": {
                       "type": "string",
                       "enum": ["celsius", "fahrenheit"],
                       "description": 'The unit to return the temperature in. Defaults to "celsius".',
                    },
                 },
                 "required": ["location", "date"],
             },
          },
       },
   ]
6) Struktur für die beim API-Aufruf gesendeten Daten definieren. Der Benutzerzugriff
auf RKLLM-Server-Flask wird darin verpackt; damit den ersten LLM-Aufruf starten.
# Prepare the data to be sent
# model: The model defined by the user when setting up RKLLM-Server, which has no effect here
# messages: Questions entered by the user; this example only supports one question, i.e., a single round of dialogue
# stream: Whether to enable streaming dialogue
# enable_thinking: Whether to enable deep thinking
# tools: User description of custom functions

messages = [
   {"role": "system", "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant.\n\nCurrent Date: 2024-09-30"},
   {"role": "user",  "content": "What's the temperature in San Francisco now? How about tomorrow?"},
   ]

data = {
       "model": 'your_model_deploy_with_RKLLM_Server',
       "messages": messages,
       "stream": False,
       "enable_thinking": False,
       "tools": TOOLS
   }

# Send a POST request
responses = session.post(server_url, json=data, headers=headers,
stream=False, verify=False)
Der erste LLM-Aufruf liefert die Eingabeparameter der benutzerdefinierten Funktion zurück:
server_answer = json.loads(responses.text)["choices"][-1]["message"]["content"]
matches = re.findall(r"<tool_call>\s*(\{.*?\})\s*</tool_call>",
''.join(server_answer), re.DOTALL)
print("server_answer:", server_answer, '\n')

'''
The following is the output of print("server_answer:", server_answer,
'\n')

server_answer: <tool_call>
{"name": "get_current_temperature", "arguments": {"location": "San Francisco"}}
</tool_call>
<tool_call>
{"name": "get_temperature_date", "arguments": {"location": "San Francisco", "date": "2024-10-01"}}
</tool_call>
'''
7) LLM-Rückgabe parsen, Eingabe für den zweiten Aufruf erstellen und LLM erneut aufrufen.
result = [json.loads(match) for match in matches]
for function_call in result:
   messages.append({'role': 'assistant', 'content': '',
'function_call':function_call})

tool_calls = [{'function': result[i]} for i in range(len(result))]
function_call = []
for tool_call in tool_calls:
   if fn_call := tool_call.get("function"):
       fn_name: str = fn_call["name"]
       fn_args: dict = fn_call["arguments"]
       fn_res: str = json.dumps(get_function_by_name(fn_name)(**fn_args))
       messages.append({'role': 'tool', 'name': fn_name,
'content':fn_res})

print("messages:", messages, '\n')

'''
The following is the output of print("messages:", messages, '\n')

messages: [{'role': 'system', 'content': 'You are Qwen, created by
Alibaba Cloud. You are a helpful assistant.\n\nCurrent Date: 2024-09-30'}, {'role': 'user', 'content': "What's the temperature in San Francisco now? How about tomorrow?"}, {'role': 'assistant', 'content':
'', 'function_call': {'name': 'get_current_temperature', 'arguments':
{'location': 'San Francisco'}}}, {'role': 'assistant', 'content': '',
'function_call': {'name': 'get_temperature_date', 'arguments':
{'location': 'San Francisco', 'date': '2024-10-01'}}}, {'role': 'tool',
'name': 'get_current_temperature', 'content': '{"temperature": 26.1,
"location": "San Francisco", "unit": "celsius"}'}, {'role': 'tool',
'name': 'get_temperature_date', 'content': '{"temperature": 25.9,
"location": "San Francisco", "date": "2024-10-01", "unit":
"celsius"}'}]
'''

data = {
"model": 'your_model_deploy_with_RKLLM_Server',
"messages": messages,
"stream": is_streaming,
"enable_thinking": False,
"tools": TOOLS
}

# Send a POST request
responses = session.post(server_url, json=data, headers=headers,
stream=is_streaming, verify=False)
8) Rückgabestruktur des zweiten LLM-Aufrufs parsen, um die abschließende Antwort zur aktuellen und morgigen Temperatur in San Francisco zu erhalten.
if not is_streaming:
       # Parse the response
       if responses.status_code == 200:
          print("A:", json.loads(responses.text)["choices"][-1]["message"]["content"])
       else:
          print("Error:", responses.text)
else:
   if responses.status_code == 200:
       print("A:", end="")
       for line in responses.iter_lines():
       if line:
          line = json.loads(line.decode('utf-8'))
          if line["choices"][-1]["finish_reason"] != "stop":
             print(line["choices"][-1]["delta"]["content"], end="")
             sys.stdout.flush()
   else:
       print('Error:', responses.text)

'''
The following is the output of print()

A:The current temperature in San Francisco is 26.1°C. Tomorrow, the temperature is expected to be 25.9°C.
'''
Die Schritte 1–8 zeigen Function Calling mit RKLLM-Server-Flask als Backend und dienen als Grundlage für eigene Funktionen. Das gewählte LLM muss Function Calling unterstützen. Bei weniger leistungsfähigen Modellen wie Qwen3-0.6B kann es fehlschlagen, weil das Modell nach dem ersten Aufruf die Eingabeparameter der benutzerdefinierten Funktionen nicht korrekt zurückgibt.
3.4.2 Bereitstellungsbeispiel für RKLLM-Server-Gradio
Gradio ist eine einfach nutzbare Python-Bibliothek zum schnellen Aufbau interaktiver Oberflächen für Machine-Learning-Modelle. Dieser Abschnitt zeigt die schnelle Bereitstellung von RKLLM-Server-Gradio auf Linux und direkten Zugriff auf die Modellinferenz im lokalen Netz. Die folgende Abbildung zeigt die Weboberfläche nach erfolgreicher Bereitstellung.
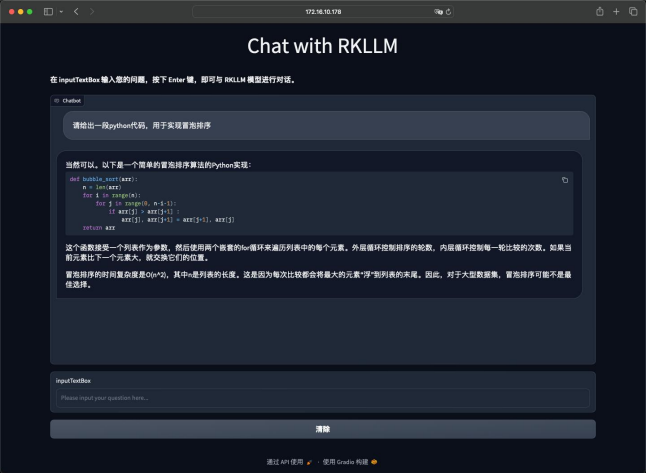
Abbildung 3-4. Externe Zugriffsseite des RKLLM-Server-Beispiels. rkllm_server_demo enthält den Implementierungscode des in Abbildung 3-3 gezeigten RKLLM-Server-Gradio-Beispiels. Zur schnellen Einrichtung kann build_rkllm_server_gradio.sh direkt verwendet werden. Nach erfolgreicher Bereitstellung ist Inferenz über Weboberfläche oder API möglich.
3.4.2.1 Server: Implementierung des RKLLM-Server-Gradio-Beispiels
build_rkllm_server_gradio.sh dient zur schnellen Einrichtung von RKLLM-Server-Gradio auf einer Linux-Platine. Wie bei RKLLM-Server-Flask sind vor dem Aufruf folgende Punkte zu beachten:
1) Platine per Ethernet-Kabel mit dem Netzwerk verbinden. In adb shell mit ifconfig die IP-Adresse ermitteln. RKLLM-Server-Gradio verwendet diese Adresse für den Server im lokalen Netz und Clientzugriffe.
2) Vor dem Skriptaufruf das RKLLM-Modell erfolgreich konvertieren und auf die Linux-Platine übertragen.
Die Verwendung von build_rkllm_server_gradio.sh entspricht build_rkllm_server_flask.sh:
./build_rkllm_server_gradio.sh
   --workshop [RKLLM-Server Working Path]
   --model_path [Absolute Path of Converted RKLLM Model on Board] --platform [Target Platform: RK3588/RK3576/RK3562/RV1126B]
   [--lora_model_path [LoRA Model Path]]
   [--prompt_cache_path [Prompt Cache File Path]]
workshop legt das Arbeitsverzeichnis von RKLLM-Server-Gradio auf dem Gerät fest; model_path den absoluten Pfad zum mit RKLLM-Toolkit konvertierten Modell, das der Server zur Laufzeit liest; platform den Plattformtyp, etwa RK3588, RK3576, RK3562 oder RV1126B. Die optionalen Parameter lora_model_path und prompt_cache_path geben LoRA- und Prompt-Dateien an. Zur schnellen Bereitstellung build_rkllm_server_gradio.sh mit folgendem Befehl auf dem PC, nicht auf der Platine, aufrufen:
./build_rkllm_server_gradio.sh
   --workshop /user/data
   --model_path /user/data/model.rkllm
   --platform rk3588
Nach dem Aufruf führt das Bereitstellungsskript folgende Schritte aus:
1) Linux-Umgebung auf der Platine prüfen.
2) Gradio automatisch installieren, falls noch nicht vorhanden.
3) Benötigte Dateien aus rkllm_server_demo/rkllm_server auf die Platine übertragen.
4) RKLLM-Modell im voreingestellten Arbeitsverzeichnis von RKLLM-Server-Gradio referenzieren. Die Terminalmeldung “RKLLM Model has been initialized successfully!” zeigt den erfolgreichen Start des Beispiels an.
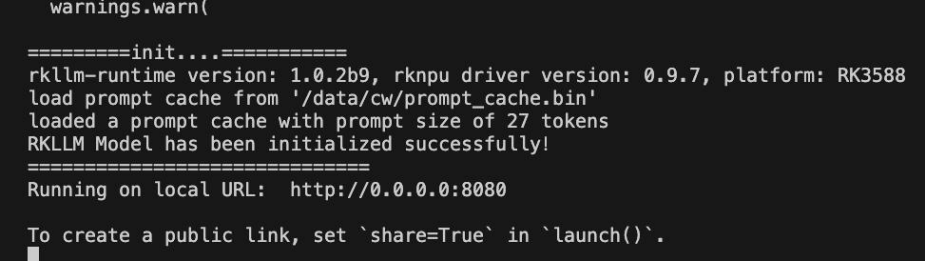
Kopierbare Abschrift des Originalprotokolls (keine ArmSoM-Messung; unkenntliches Konto nicht rekonstruiert):
warnings.warn(
=========init....===========
rkllm-runtime version: 1.0.2b9, rknpu driver version: 0.9.7, platform: RK3588
load prompt cache from '/data/cw/prompt_cache.bin'
loaded a prompt cache with prompt size of 27 tokens
RKLLM Model has been initialized successfully!
===========================
Running on local URL:  http://0.0.0.0:8080
To create a public link, set `share=True` in `launch()`.
Abbildung 3-5. Erfolgreicher Start von RKLLM-Server-Gradio im Terminal. Der Code von build_rkllm_server_gradio.sh erläutert die Bereitstellung und unterstützt flexible eigene Server. Wichtig: In Schritt 3 synchronisiert das Skript die aktuelle RKLLM Runtime automatisch nach rkllm_server/lib/librkllmrt.so. Daher referenziert gradio_server.py diese librkllmrt.so zur Laufzeit; dies ist bei eigenen Serveranpassungen zu beachten.
3.4.2.2 Server: Implementierung des RKLLM-Server-Gradio-Beispiels
Die Implementierung von RKLLM-Server-Gradio entspricht weitgehend RKLLM-Server-Flask: ctypes ruft die RKLLM-Runtime-Bibliothek direkt zur Modellinferenz auf. Der konkrete Bereitstellungsablauf ist in folgender Abbildung dargestellt:
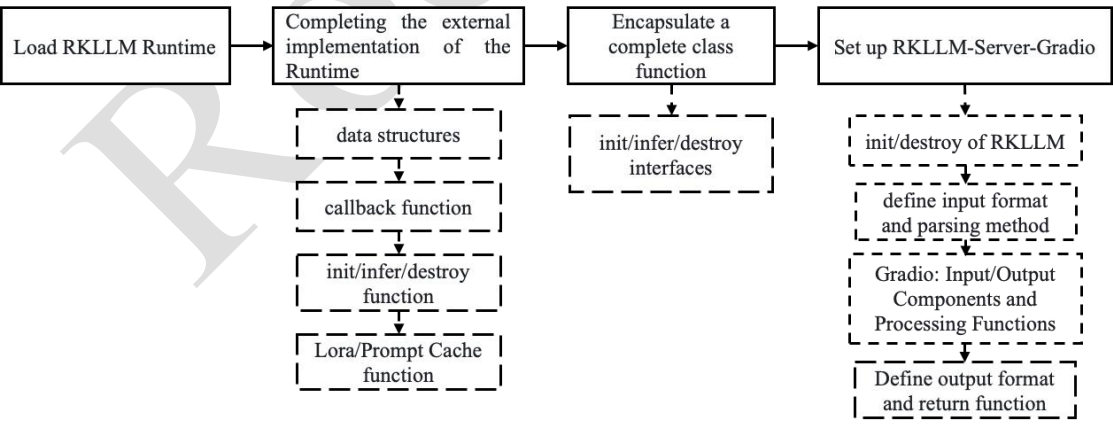
Abbildung 3-6. Ablauf der RKLLM-Server-Flask-Bereitstellungsimplementierung (Bezeichnung des englischen Originals). Der Unterschied besteht in der Verwendung von gradio zum Serveraufbau und zur Clientkommunikation über einen einfachen Webdienst. Dafür benötigt die Gradio-Oberfläche folgende spezielle Behandlung:
1) Gradio stellt die vollständige Kommunikation für Ein- und Ausgabedaten bereit; komplexe serverseitige Ein-/Ausgabelogik mit Flask muss daher nicht definiert werden.
2) Gradio basiert auf unterschiedlichen Bedienelementen. Für die Oberfläche werden Gradio-Komponenten aufgerufen und für jedes Element Auslösebedingungen, Funktionsaufruflogik sowie Datenflüsse zwischen Komponenten festgelegt.
Der Hauptcode in rkllm_server/gradio_server.py erläutert die Implementierung. Durch Änderung der RKLLM-Initialisierungsdefinitionen können andere Modelle eingebunden werden. Das Beispiel dient auch als Grundlage für eigene Serverbereitstellungen.
3.4.2.3 Client: RKLLM-Server-Gradio verwenden
Nach erfolgreicher Bereitstellung von RKLLM-Server-Gradio auf einer Linux-Platine stehen zwei Zugriffswege zur Verfügung: Oberfläche und API.
1) Oberfläche: Nach erfolgreichem Start per Bereitstellungsskript auf einem PC im lokalen Netz im Browser board_IP:8080 öffnen, beispielsweise 172.16.10.178:8080 (Abbildung 3-2 im Original). So ist schnelle Modellinteraktion möglich. Gradio integriert automatisch Markdown, HTML und weitere Syntax zur Darstellung der Modellausgaben, einschließlich Code und Markdown-Text. Beim Serveraufbau wird eine Warteschlange gestartet: Eingaben mehrerer Benutzer werden in Einreichungsreihenfolge verarbeitet und beantwortet. Solange eine Benutzerinteraktion inferiert wird (Dialogfeld hervorgehoben), nimmt der Server von diesem Benutzer keine nächste Eingabe an.
2) API: rkllm_server_demo enthält chat_api_gradio.py. Nach Installation von gradio_client auf dem PC (pip install gradio_client) kann RKLLM-Server ausschließlich über die API, ohne grafische Oberfläche, verwendet werden, wie in der
folgenden Abbildung gezeigt. Vor der Verwendung von chat_api_gradio.py die IP-Adresse im Code wie nachfolgend gezeigt durch die aktuelle Platinen-IP ersetzen.
from gradio_client import Client
client = Client("http://172.16.10.xx:8080/")
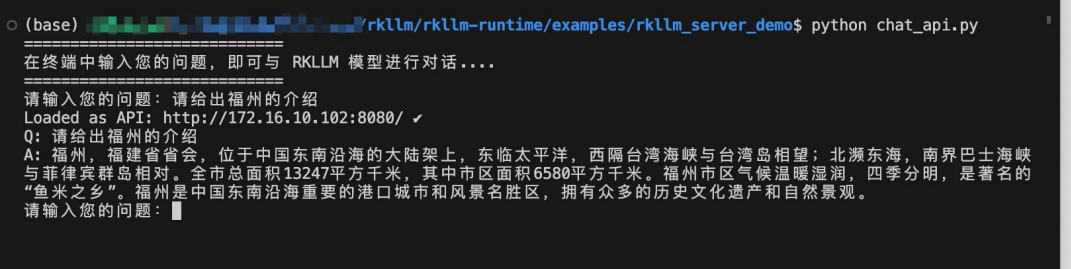
Kopierbare Abschrift des Originalprotokolls (keine ArmSoM-Messung; unkenntliches Konto nicht rekonstruiert):
(base) [原图已模糊 / blurred in original]/rkllm/rkllm-runtime/examples/rkllm_server_demo$ python chat_api.py
===========================
在终端中输入您的问题,即可与 RKLLM 模型进行对话....
===========================
请输入您的问题: 请给出福州的介绍
Loaded as API: http://172.16.10.102:8080/ ✓
Q: 请给出福州的介绍
A: 福州,福建省省会,位于中国东南沿海的大陆架上,东临太平洋,西隔台湾海峡与台湾岛相望;北濒东海,南界巴士海峡与菲律宾群岛相对。全市总面积13247平方千米,其中市区面积6580平方千米。福州市气候温暖湿润,四季分明,是著名的“鱼米之乡”。福州是中国东南沿海重要的港口城市和风景名胜区,拥有众多的历史文化遗产和自然景观。
请输入您的问题:
Abbildung 3-7. RKLLM-Server-Gradio-API-Aufruf im Terminal. Je nach Bedarf zwischen beiden Zugriffswegen wählen: Für interaktive Dienste im lokalen Netz wird die Oberfläche empfohlen, für angepasstes Zugriffsverhalten die API zur Weiterentwicklung. Wichtig: RKLLM-Server-Gradio definiert keine Sende-/Empfangsdatenstrukturen nach dem Muster der OpenAI-API und ist daher nicht mit deren Schnittstelle kompatibel. Für Erweiterungen die konkrete Implementierung in chat_api_gradio.py beachten. Bei benötigter OpenAI-API-Kompatibilität auf die RKLLM-Server-Flask-Implementierung zurückgreifen.
4 Referenzen
RKLLM: https://github.com/airockchip/rknn-llm
RKNN: https://github.com/airockchip/rknn-toolkit2
Linkverzeichnis der Originalquelle
developer.arm.com: 10-2-2020-11