
Полная техническая справка основана на RK-YH-YF-418 / V2.3.2. Она охватывает семь групп NPU: RK3566/RK3568, RK3588, RK3562, RV1103/RV1106, RK3576/RV1126B, RK2118 и RV1103B/RV1106B, а также операторы CPU и ограничения входов/выходов модели. PDF в китайском и английском каталогах имеют по 343 страницы и одинаковый SHA-256; текст обоих китайский, отдельного английского оригинала нет. Английская, русская и немецкая версии полностью переведены с китайского. Все четыре версии используют одинаковые китайские исходные рисунки; они не выдаются за англоязычные. Это только справка для адаптации ArmSoM: проверьте SoC платы, версии RKNN-Toolkit2/Compiler/Runtime, SDK/BSP, драйвер ядра, квантование, модель и zero-copy-интерфейсы. Исходник не задаёт одну версию ядра для всех операторов и не доказывает поддержку всех плат ArmSoM. Выполнение моделей, измерения производительности и аппаратная проверка не проводились.
ArmSoM Docs · RKNN-Toolkit2 · EDITORIAL-NOTES
История изменений ПО
2.1 V2.3.2
- (1) Добавлена документация RV1126B.
- (2) Добавлена документация RV1106B.
- (3) Обновлены ограничения параметров ConvDilation на всех платформах.
- (4) Обновлены ограничения оператора Resize.
2.2 V2.3.0
- (1) Добавлено описание режима mean_var оператора exNorm на RK3576/RK3588/RK3562/RK3568.
- (2) Операторы MAX/MIN поддерживают Broadcast на всех платформах.
- (3) Изменены ограничения Softmax на RK3576.
2.3 V2.2.0
- (1) Изменены ограничения softmax на всех платформах, кроме rk3568; добавлено разделение softmax.
- (2) Добавлена поддержка RMSNorm на RK3576, RK3588, RK3562 и RK3568.
2.4 V2.1.0
- (1) Добавлена документация RK2118.
- (2) Добавлена документация RV1103B.
- (3) Обновлены спецификации операторов на всех платформах.
- (4) Добавлены спецификации операторов RK3576, включая Hardmax и ConvLut.
- (5) Поддержка exConvStreaming на RK2118.
- (6) В exSDPA на RK3562/RK3576 добавлена оптимизация FlashAttentionV2.
2.5 V2.0.0‑beta
- (1) Добавлены спецификации поддерживаемых операторов RK3576.
- (2) Добавлены спецификации аппаратной поддержки exSDPAttention и exMatMul на RK3588/RK3562/RK3576.
- (3) Добавлена поддержка операторов CPU Floor, Mod, And, GatherElements и exMeanVarianceNormalization.
- (4) Добавлены спецификации поддерживаемых операторов RK2118.
Спецификации операторов NPU
3.1 RK3566/RK3568
3.1.1 Add
Выполняет поэлементное бинарное сложение (C=A+B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.1.2 AddRelu
Объединённое вычисление Add и Relu, C=Relu(A+B).
Входы
- Как у Add.
Выходы
- Как у Add.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.1.3 BatchNormalization
Выполняет пакетную нормализацию входного тензора согласно https://arxiv.org/abs/1502.03167.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- epsilon:float (по умолчанию=1e‑5)
- Вещественное число, добавляемое при делении на стандартное отклонение для предотвращения деления на 0.
- epsilon∈(0,∞]
- momentum:float
- Параметр скользящего среднего при обучении.
3.1.4 Concat
Объединяет последовательность векторов в один вдоль axis. Размеры всех векторов вне axis должны совпадать.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axisint64
- axis∈{0,1,2,3}
3.1.5 Convolution
Свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.6 DepthwiseConvolution
Разделимая свёртка по глубине
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.7 ConvolutionRelu
Объединённое вычисление Convolution и Relu, Output=Relu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.8 ConvolutionClip
Объединённое вычисление Convolution и Clip, Output=Clip(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.9 ConvolutionPRelu/LeakyRelu
Объединённое вычисление Convolution и PRelu/LeakyRelu, Output = PRelu(Conv(Input)) или Output =
LeakyRelu(Conv(Input))
Описание и ограничения совпадают с Convolution.
3.1.10 ConvolutionAdd
Объединённое вычисление Convolution и Add, Output=Add(Conv(Input0),Input1).
Описание и ограничения совпадают с Convolution.
3.1.11 ConvolutionSigmoid
Объединённое вычисление Convolution и Sigmoid, Output=Sigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.12 ConvolutionTanh
Объединённое вычисление Convolution и Tanh, Output=Tanh(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.13 ConvolutionSoftplus
Объединённое вычисление Convolution и Softplus, Output=Softplus(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.14 ConvolutionHardSigmoid
Объединённое вычисление Convolution и HardSigmoid, Output=HardSigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.15 ConvolutionHardSwish
Объединённое вычисление Convolution и HardSwish, Output=HardSwish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.16 ConvolutionElu
Объединённое вычисление Convolution и Elu, Output=Elu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.17 ConvolutionSwish
Объединённое вычисление Convolution и Swish, Output=Swish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.18 ConvolutionMish
Объединённое вычисление Convolution и Mish, Output=Mish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.1.19 ConvolutionAddRelu
Объединённое вычисление Convolution, Add и Relu, Output=Relu(Add(Conv(Input0),Input1)).
Описание и ограничения совпадают с Convolution.
3.1.20 ConvTranspose
Транспонированная свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Кроме того, для входа первого слоя
- shape:[batch,channel,height,width]
width ограничена; см. описание входов модели.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h поддерживает только 1,2,4,8.
- stride_w поддерживает только 1,2,4,8.
- pads:int(pads_top,pads_left,pads_bottom,pads_right). При настройке pad не поддерживаются: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: поддерживается только 1; num_output поддерживается тогда и только тогда, когда num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Если dilation не равно (1,1), поддерживается только kernel=(1,1).
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.21 ConvTranposeRelu
Объединённое вычисление ConvTranpose и Relu, Output=Relu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.22 ConvTranposeClip
Объединённое вычисление ConvTranpose и Clip, Output=Clip(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.23 ConvTranposePRelu/LeakyRelu
Объединённое вычисление ConvTranpose и PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) или Output=
LeakyRelu(ConvTranpose(Input))
Описание и ограничения совпадают с ConvTranspose.
3.1.24 ConvTranposeAdd
Объединённое вычисление ConvTranpose и Add, Output=Add(ConvTranpose(Input0),Input1).
Описание и ограничения совпадают с ConvTranspose.
3.1.25 ConvTranposeSigmoid
Объединённое вычисление ConvTranpose и Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.26 ConvTranposeTanh
Объединённое вычисление ConvTranpose и Tanh, Output=Tanh(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.27 ConvTranposeSoftplus
Объединённое вычисление ConvTranpose и Softplus, Output=Softplus(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.28 ConvTranposeHardSigmoid
Объединённое вычисление ConvTranpose и HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.1.29 ConvTranposeHardSwish
Объединённое вычисление ConvTranpose и HardSwish, Output=HardSwish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.30 ConvTranposeElu
Объединённое вычисление ConvTranpose и Elu, Output=Elu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.31 ConvTranposeSwish
Объединённое вычисление ConvTranpose и Swish, Output=Swish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.32 ConvTranposeMish
Объединённое вычисление ConvTranpose и Mish, Output=Mish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.1.33 Div
Выполняет поэлементное бинарное деление (C=A/B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.1.34 Expand
Расширяет входной тензор по заданным shape и правилам, подобно numpy.array(input) *numpy.ones(shape): размерности выравниваются справа; соответствующие размерности должны совпадать либо одна из них должна быть 1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Ограничения расширения размерностей
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.1.35 GRU
Вентильный рекуррентный блок (GRU, Gated Recurrent Unit). Расширения и варианты GRU называются exGRU; параметры с пометкой (extern) принадлежат только exGRU. Формулы приведены ниже:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- linear_before_reset:int
- Выбор варианта LBR:1(T)or0(F).
- direction(extern):string
- Задаёт направление вычисления GRU.
- forward: прямое направление GRU.
- reverse: обратное направление GRU.
- bidirectional: двунаправленное вычисление GRU.
- sequence_size(extern):int
- Задаёт seqsize входа GRU; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока GRU; без ограничений, рекомендуется выравнивание по 8.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.36 Gather
Выбирает по Indices элементы входа X вдоль заданной axis и объединяет их.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Indices:T2
- Индексы выбираемых элементов; rank =1.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Атрибуты
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Задаёт размерность входа, из которой выбирает Indices.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.1.37 LSTM
Сеть долгой краткосрочной памяти (LSTM, Long Short-Term Memory). Расширения и варианты LSTM называются exLSTM; параметры с пометкой (extern) принадлежат только exLSTM. Формулы приведены ниже:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2,T3
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T4,T5(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- direction(extern):string
- Задаёт направление вычисления LSTM.
- forward: прямое направление LSTM.
- reverse: обратное направление LSTM.
- bidirectional: двунаправленное вычисление LSTM.
- sequence_size(extern):int
- Задаёт seqsize входа LSTM; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока LSTM; без ограничений, рекомендуется выравнивание по 8.
- proj_size(extern):int
- proj_size при projection; projsize∈[0,hiddensize].
- Сейчас допускается только 0; projection пока не поддерживается.
- input_forget(extern):int
- Выбор варианта cifg:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- has_projection(extern):int
- Вариант projection:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
- T5:int(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.38 Max
Вычисляет поэлементный максимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.39 Min
Вычисляет поэлементный минимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.40 Mul
Выполняет поэлементное бинарное умножение (C=A*B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.1.41 MulRelu
Остальные описания совпадают с Mul.
- Поддерживаемые типы данных: как у Mul.
3.1.42 Pad
По тензору данных (data), тензору величин заполнения в начале/конце осей (pads), режиму (mode) и константе (constant_value) создаёт дополненный тензор (output).
Входы
- data:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Атрибуты
- mode:string (по умолчанию constant)
- Поддерживаемые режимы: constant,reflect.
- constant: без ограничений.
- Поддерживаемые режимы: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.1.43 MaxPool
MaxPool получает входной тензор X и выполняет максимальный пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется максимум, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64
- Приоритетный порядок хранения:0.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.44 GlobalMaxPool
GlobalMaxPool применяет максимальный пулинг к значениям каждого канала входного тензора X. Это эквивалентно MaxPool с kernel_shape, равным пространственным размерам input.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(1,7]
width∈(1,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.45 AveragePool
AveragePool получает входной тензор X и выполняет усредняющий пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется среднее всех значений, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.46 GlobalAveragePool
GlobalAveragePool применяет усредняющий пулинг к значениям каждого канала входного тензора X. Это эквивалентно AveragePool с kernel_shape, равным пространственным размерам входного тензора.
Входы*
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.47 Pow
Z =XY
Возведение в степень: получает входные данные (тензор) и показатель степени, создавая выходные данные (тензор).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Y:T2
- shape:[1]
- Сейчас поддерживаются только 0,1,2,3,0.5,‑0.5.
- shape:[1]
Выходы
- Z:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.1.48 Relu
Заменяет отрицательные значения входного тензора нулём, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.49 Clip/ReLU6
Ограничивает значения входного тензора диапазоном [0,6].
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.50 PRelu
Масштабирует отрицательные значения входного тензора обучаемым параметром, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Атрибуты
- slope: коэффициент PRelu.
- Поддерживается только один скаляр или коэффициенты по размерности C.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.51 LeakyRelu
Масштабирует отрицательные значения входного тензора фиксированным коэффициентом, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.52 Reshape
Возвращает тензор заданной формы, не изменяя входные данные и число элементов.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- shape:int
- Задаёт форму выходного тензора.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.1.53 Resize
Изменяет размер входного тензора. Обычно каждое выходное значение вычисляется как взвешенное среднее соседних значений (точек выборки) входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- roi(optional):T2
- Пока не поддерживается.
- scales(optional):T2
- Массив коэффициентов масштабирования по каждой размерности.
- sizes(optional):T3
- Целевой размер выходного тензора.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Атрибуты
- antialias:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- axes:int[]
- Настройка сейчас не поддерживается.
- coordinate_transformation_mode:strings (по умолчанию ”half_pixel”)
- Сейчас поддерживаются только half_pixel, pytorch_half_pixel и align_corners.
- cubic_coeff_a:float (по умолчанию ‑0.75)
- Настройка сейчас не поддерживается.
- exclude_outside:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- extrapolation_value:float (по умолчанию 0)
- Настройка сейчас не поддерживается.
- keep_aspect_ratio_policy:strings (по умолчанию ”stretch”)
- Настройка сейчас не поддерживается.
- mode:strings (по умолчанию ”nearest”)
- Сейчас можно настроить только nearest и linear.
- nearest_mode:strings (по умолчанию ”round_prefer_floor”)
- Настройка сейчас не поддерживается.
Поддержка: сейчас допускается только целочисленное масштабирование ширины и высоты с целыми коэффициентами 2‑8. Вход (1,c,1,1) можно увеличить до (1,c,h,w).
3.1.54 Slice
Получает срез текущего вектора по правилам срезов NumPy.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- starts:int(Tensor)
- Начальная позиция среза: без ограничений.
- ends:int(Tensor)
- Конечная позиция среза: без ограничений.
- axes:int(Tensor)
- Выбор осей среза: любые оси 0~3, включая несколько одновременно.
- steps:int(Tensor)
- Выбирает шаг по соответствующей оси среза.
- При height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc значения steps могут отличаться от 1. Иначе SliceOP может выполняться на NPU только при steps==[1,1,1,1].
3.1.55 Split
Делит вектор вдоль axis на num_outputs векторов; split задаёт размеры результатов вдоль axis.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- Один или несколько выходных векторов согласно num_outputs.
- shape: определяется разбиением.
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.1.56 Sub
- Выполняет поэлементное бинарное вычитание (C=A‑B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.1.57 Tile
Создаёт тензор повторением заданного тензора, как функция NumPy tile, но без расширения размерностей.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.1.58 Transpose
Транспонирует входной тензор.
Входы
- X:T1
- shape:[n1,c1,h1,w1]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n1,c1,h1,w1]
Выходы
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n2,c2,h2,w2]
Атрибуты
- perm, порядок транспонируемых осей: ограничения для разных perm приведены ниже (p=8192,q=2048).
- perm=[0,1,2,3]
- Без ограничений
- perm=[0,1,3,2]
- Не поддерживается
- perm=[0,2,3,1]
- Не поддерживается
- perm=[0,2,1,3]
- Не поддерживается
- perm=[0,3,1,2]
- Не поддерживается
- perm=[0,3,2,1]
- Не поддерживается
- perm=[1,0,2,3]
- Не поддерживается
- perm=[1,0,3,2]
- Не поддерживается
- perm=[1,2,0,3]
- Не поддерживается
- perm=[1,2,3,0]
- Не поддерживается
- perm=[1,3,0,2]
- Не поддерживается
- perm=[1,3,2,0]
- Не поддерживается
- perm=[2,1,0,3]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,h1%4=0)
- perm=[2,1,3,0]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,h1%4=0)
- perm=[2,0,3,1]
- Не поддерживается
- perm=[2,0,1,3]
- Не поддерживается
- perm=[2,3,1,0]
- Не поддерживается
- perm=[2,3,0,1]
- Не поддерживается
- perm=[3,0,2,1]
- Не поддерживается
- perm=[3,0,1,2]
- Не поддерживается
- perm=[3,2,0,1]
- Не поддерживается
- perm=[3,2,1,0]
- Не поддерживается
- perm=[3,1,0,2]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,w1%4=0)
- perm=[3,1,2,0]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,w1%4=0)
- perm=[0,1,2,3]
Ограничения типов данных
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.1.59 Sigmoid
Поэлементно применяет y=1/(1+exp(‑x)) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.60 Tanh
Вычисляет гиперболический тангенс элементов входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.61 Softplus
Поэлементно применяет Softplus, y=ln(exp(x)+1).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.62 HardSigmoid
Поэлементно применяет y=max(0,min(1,alpha*x+beta)) ко входному тензору, создавая выходной тензор, где
alpha=1/6,beta=0.5
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.63 HardSwish
Поэлементно применяет HardSwish: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), где alpha=1/6,beta=0.5.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.64 Elu
Поэлементно применяет f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0, создавая выходной тензор; alpha=1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.65 exSwish
Поэлементно применяет линейный блок Sigmoid. Swish также называется SiLU: y=x*sigmoid(x).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.66 exMish
Поэлементно применяет mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.67 exGelu
Поэлементно применяет y =x∗Φ(x) ко входному тензору, создавая выходной тензор. Когда Φ(x) задана как tanh,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.68 exSwooshR
Поэлементно применяет к входному тензору следующую функцию из https://arxiv.org/abs/2310.11230, создавая выходной тензор.
SwooshR(x)=log(1+exp(x-1))-0.08x-0.313261687
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.69 exSwooshL
Поэлементно применяет к входному тензору следующую функцию из https://arxiv.org/abs/2310.11230, создавая выходной тензор.
SwooshL(x)=log(1+exp(x-4))-0.08x-0.035
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.1.70 Where
Выбирает значения x_tensor или y_tensor по mask_tensor: при True берётся соответствующее значение x_tensor, иначе y_tensor.
Входы
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
Выходы
- output:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.1.71 exGlu
Функция вентильного линейного блока (Gated Linear Unit); a — первая половина входной матрицы, b — вторая.
GLU(a,b)=a⊗σ(b)
Входы
- Input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Output:T1
- shape:[batch,channel/2,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int(по умолчанию=1)
- Размерность разделения входа.
- Ограничение: поддерживается только 1.
3.1.72 exMatMul
Матричное умножение
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Входы
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Поддержка квантования
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Поддержка квантования
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- Y:T1
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Атрибуты
- c_type:strings(по умолчанию “add”)
- Выбор add или mul задаёт сложение или умножение с C.
3.1.73 exNorm
Нормализует входные данные. Сейчас поддерживаются LayerNormlization, RMSNormlization и MeanVarianceNormalization:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Здесь x — входной вектор. µ и σ2 — его среднее и дисперсия:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS — среднеквадратичное значение входного вектора:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance — эквивалентная дисперсия входного вектора:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ — малое число для предотвращения деления на ноль. W и B — необязательные параметры.
Входы
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- epsilon:float(по умолчанию 1e‑05)
- Значение epsilon для предотвращения деления на 0.
- mode:string
- Доступны три режима Normalization: layer, rms и mean_var.
- axes:int64[](по умолчанию [1])
- Оси нормализации: сейчас поддерживаются только [1] и [1,2,3].
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.1.74 exWindow
exWindow основан на window_partition и window_reverse из swin_transformer. В исходной статье входные признаки делятся на непересекающиеся окна window_size×window_size. Входные и выходные признаки должны иметь 4-мерный shape с разбиением по высоте и ширине. Ниже реализация PyTorch:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Входы
- X:T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- mode:string
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- partition: см. реализацию window_partition.
- reverse: см. реализацию window_reverse.
- partition_num_first отличается от partition тем, что H,W делятся согласно num_windows, тогда как partition делит H,W согласно window_sizes.
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-мерный вектор размера окна, задающий высоту и ширину каждого окна. На этом размере основаны вычисление внимания и извлечение признаков внутри окна.
- num_windows:listofints
- 2-мерный вектор числа окон, задающий количество окон по высоте и ширине входных признаков.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2 RK3588
3.2.1 Add
Выполняет поэлементное бинарное сложение (C=A+B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.2 AddRelu
Объединённое вычисление Add и Relu, C=Relu(A+B).
Входы
- Как у Add.
Выходы
- Как у Add.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.3 BatchNormalization
Выполняет пакетную нормализацию входного тензора согласно https://arxiv.org/abs/1502.03167.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- epsilon:float (по умолчанию=1e‑5)
- Вещественное число, добавляемое при делении на стандартное отклонение для предотвращения деления на 0.
- epsilon∈(0,∞]
- momentum:float
- Параметр скользящего среднего при обучении.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.4 Concat
Объединяет последовательность векторов в один вдоль axis. Размеры всех векторов вне axis должны совпадать.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axisint64
- axis∈{0,1,2,3}
3.2.5 Convolution
Свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.6 DepthwiseConvolution
Разделимая свёртка по глубине
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.7 ConvolutionRelu
Объединённое вычисление Convolution и Relu, Output=Relu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.8 ConvolutionClip
Объединённое вычисление Convolution и Clip, Output=Clip(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.9 ConvolutionPRelu/LeakyRelu
Объединённое вычисление Convolution и PRelu/LeakyRelu, Output = PRelu(Conv(Input)) или Output =
LeakyRelu(Conv(Input))
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.10 ConvolutionAdd
Объединённое вычисление Convolution и Add, Output=Add(Conv(Input0),Input1).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.11 ConvolutionSigmoid
Объединённое вычисление Convolution и Sigmoid, Output=Sigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.12 ConvolutionTanh
Объединённое вычисление Convolution и Tanh, Output=Tanh(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.13 ConvolutionSoftplus
Объединённое вычисление Convolution и Softplus, Output=Softplus(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.14 ConvolutionHardSigmoid
Объединённое вычисление Convolution и HardSigmoid, Output=HardSigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.15 ConvolutionHardSwish
Объединённое вычисление Convolution и HardSwish, Output=HardSwish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.16 ConvolutionElu
Объединённое вычисление Convolution и Elu, Output=Elu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.17 ConvolutionSwish
Объединённое вычисление Convolution и Swish, Output=Swish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.18 ConvolutionMish
Объединённое вычисление Convolution и Mish, Output=Mish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.19 ConvolutionAddRelu
Объединённое вычисление Convolution, Add и Relu, Output=Relu(Add(Conv(Input0),Input1)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.20 ConvTranspose
Транспонированная свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Кроме того, для входа первого слоя
- shape:[batch,channel,height,width]
width ограничена; см. описание входов модели.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h поддерживает только 1,2,4,8.
- stride_w поддерживает только 1,2,4,8.
- pads:int(pads_top,pads_left,pads_bottom,pads_right). При настройке pad не поддерживаются: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: поддерживается только 1; num_output поддерживается тогда и только тогда, когда num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Если dilation не равно (1,1), поддерживается только kernel=(1,1).
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.21 ConvTranposeRelu
Объединённое вычисление ConvTranpose и Relu, Output=Relu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.22 ConvTranposeClip
Объединённое вычисление ConvTranpose и Clip, Output=Clip(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.23 ConvTranposePRelu/LeakyRelu
Объединённое вычисление ConvTranpose и PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) или Output=
LeakyRelu(ConvTranpose(Input))
Описание и ограничения совпадают с ConvTranspose.
3.2.24 ConvTranposeAdd
Объединённое вычисление ConvTranpose и Add, Output=Add(ConvTranpose(Input0),Input1).
Описание и ограничения совпадают с ConvTranspose.
3.2.25 ConvTranposeSigmoid
Объединённое вычисление ConvTranpose и Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.26 ConvTranposeTanh
Объединённое вычисление ConvTranpose и Tanh, Output=Tanh(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.27 ConvTranposeSoftplus
Объединённое вычисление ConvTranpose и Softplus, Output=Softplus(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.28 ConvTranposeHardSigmoid
Объединённое вычисление ConvTranpose и HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.2.29 ConvTranposeHardSwish
Объединённое вычисление ConvTranpose и HardSwish, Output=HardSwish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.30 ConvTranposeElu
Объединённое вычисление ConvTranpose и Elu, Output=Elu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.31 ConvTranposeSwish
Объединённое вычисление ConvTranpose и Swish, Output=Swish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.32 ConvTranposeMish
Объединённое вычисление ConvTranpose и Mish, Output=Mish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.2.33 Div
Выполняет поэлементное бинарное деление (C=A/B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.2.34 Expand
Расширяет входной тензор по заданным shape и правилам, подобно numpy.array(input) *numpy.ones(shape): размерности выравниваются справа; соответствующие размерности должны совпадать либо одна из них должна быть 1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Ограничения расширения размерностей
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.2.35 GRU
Вентильный рекуррентный блок (GRU, Gated Recurrent Unit). Расширения и варианты GRU называются exGRU; параметры с пометкой (extern) принадлежат только exGRU. Формулы приведены ниже:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- linear_before_reset:int
- Выбор варианта LBR:1(T)or0(F).
- direction(extern):string
- Задаёт направление вычисления GRU.
- forward: прямое направление GRU.
- reverse: обратное направление GRU.
- bidirectional: двунаправленное вычисление GRU.
- sequence_size(extern):int
- Задаёт seqsize входа GRU; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока GRU; без ограничений, рекомендуется выравнивание по 8.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.36 Gather
Выбирает по Indices элементы входа X вдоль заданной axis и объединяет их.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Indices:T2
- Индексы выбираемых элементов; rank =1.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Атрибуты
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Задаёт размерность входа, из которой выбирает Indices.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.37 Hardmax
Выходы
- input:T1
- shape:[batch,channel,height,width]
axis=1,height∗width<16384;
- axis=3/‑1,channel∗height<16384; также действуют ограничения tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- Ось hardmax:1,3/‑1, то есть channel и width.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.38 LSTM
Сеть долгой краткосрочной памяти (LSTM, Long Short-Term Memory). Расширения и варианты LSTM называются exLSTM; параметры с пометкой (extern) принадлежат только exLSTM. Формулы приведены ниже:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2,T3
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T4,T5(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- direction(extern):string
- Задаёт направление вычисления LSTM.
- forward: прямое направление LSTM.
- reverse: обратное направление LSTM.
- bidirectional: двунаправленное вычисление LSTM.
- sequence_size(extern):int
- Задаёт seqsize входа LSTM; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока LSTM; без ограничений, рекомендуется выравнивание по 8.
- proj_size(extern):int
- proj_size при projection; projsize∈[0,hiddensize].
- Сейчас допускается только 0; projection пока не поддерживается.
- input_forget(extern):int
- Выбор варианта cifg:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- has_projection(extern):int
- Вариант projection:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
- T5:int(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.39 Max
Вычисляет поэлементный максимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.40 Min
Вычисляет поэлементный минимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.41 Mul
Выполняет поэлементное бинарное умножение (C=A*B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.42 MulRelu
Объединённое вычисление Mul и Relu,C=Relu(A*B).
Входы
- Как у Mul.
Выходы
- Как у Mul.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.2.43 Pad
По тензору данных (data), тензору величин заполнения в начале/конце осей (pads), режиму (mode) и константе (constant_value) создаёт дополненный тензор (output).
Входы
- data:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,
width_end]
- constant_value(optional):T3
- shape:[1]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Атрибуты
- mode:string (по умолчанию constant)
- Поддерживаемые режимы: constant,reflect.
- constant: без ограничений.
- Поддерживаемые режимы: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.44 MaxPool
MaxPool получает входной тензор X и выполняет максимальный пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется максимум, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64
- Приоритетный порядок хранения:0.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.45 GlobalMaxPool
GlobalMaxPool применяет максимальный пулинг к значениям каждого канала входного тензора X. Это эквивалентно MaxPool с kernel_shape, равным пространственным размерам input.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.46 AveragePool
AveragePool получает входной тензор X и выполняет усредняющий пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется среднее всех значений, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.47 GlobalAveragePool
GlobalAveragePool применяет усредняющий пулинг к значениям каждого канала входного тензора X. Это эквивалентно AveragePool с kernel_shape, равным пространственным размерам входного тензора.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.48 Pow
Z =XY
Возведение в степень: получает входные данные (тензор) и показатель степени, создавая выходные данные (тензор).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Y:T2
- shape:[1]
- Сейчас поддерживаются только 0,1,2,3,0.5,‑0.5.
- shape:[1]
Выходы
- Z:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.49 Relu
Заменяет отрицательные значения входного тензора нулём, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.50 Clip/ReLU6
Ограничивает значения входного тензора диапазоном [0,6].
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.51 PRelu
Масштабирует отрицательные значения входного тензора обучаемым параметром, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Атрибуты
- slope: коэффициент PRelu.
- Поддерживается только один скаляр или коэффициенты по размерности C.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.52 LeakyRelu
Масштабирует отрицательные значения входного тензора фиксированным коэффициентом, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.53 Reshape
Возвращает тензор заданной формы, не изменяя входные данные и число элементов.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- shape:int
- Задаёт форму выходного тензора.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.54 Resize
Изменяет размер входного тензора. Обычно каждое выходное значение вычисляется как взвешенное среднее соседних значений (точек выборки) входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- roi(optional):T2
- Пока не поддерживается.
- scales(optional):T2
- Массив коэффициентов масштабирования по каждой размерности.
- sizes(optional):T3
- Целевой размер выходного тензора.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Атрибуты
- antialias:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- axes:int[]
- Настройка сейчас не поддерживается.
- coordinate_transformation_mode:strings (по умолчанию ”half_pixel”)
- Сейчас поддерживаются только half_pixel, pytorch_half_pixel и align_corners.
- cubic_coeff_a:float (по умолчанию ‑0.75)
- Настройка сейчас не поддерживается.
- exclude_outside:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- extrapolation_value:float (по умолчанию 0)
- Настройка сейчас не поддерживается.
- keep_aspect_ratio_policy:strings (по умолчанию ”stretch”)
- Настройка сейчас не поддерживается.
- mode:strings (по умолчанию ”nearest”)
- Сейчас можно настроить только nearest и linear.
- nearest_mode:strings (по умолчанию ”round_prefer_floor”)
- Настройка сейчас не поддерживается.
Поддержка: сейчас допускается только целочисленное масштабирование ширины и высоты с целыми коэффициентами 2‑8. Вход (1,c,1,1) можно увеличить до (1,c,h,w).
- Совместная работа нескольких ядер: не поддерживается.
3.2.55 Slice
Получает срез текущего вектора по правилам срезов NumPy.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- starts:int(Tensor)
- Начальная позиция среза: без ограничений.
- ends:int(Tensor)
- Конечная позиция среза: без ограничений.
- axes:int(Tensor)
- Выбор осей среза: любые оси 0~3, включая несколько одновременно.
- steps:int(Tensor)
- Выбирает шаг по соответствующей оси среза.
- При height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc значения steps могут отличаться от 1. Иначе SliceOP может выполняться на NPU только при steps==[1,1,1,1].
3.2.56 Softmax
Оператор вычисляет нормализованные экспоненциальные значения входа:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- Ось softmax:1,3, то есть channel и width.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.57 exSoftmax13
Оператор вычисляет нормализованные экспоненциальные значения входа:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.58 exSoftmaxMask
Оператор вычисляет нормализованные экспоненциальные значения входа:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, без ограничений;
· axis=3/‑1,width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
- mask_value:int64
- Значения для mask:0,1.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.59 Split
Делит вектор вдоль axis на num_outputs векторов; split задаёт размеры результатов вдоль axis.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- Один или несколько выходных векторов согласно num_outputs.
- shape: определяется разбиением.
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.2.60 Sub
- Выполняет поэлементное бинарное вычитание (C=A‑B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.2.61 Tile
Создаёт тензор повторением заданного тензора, как функция NumPy tile, но без расширения размерностей.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.2.62 Transpose
Транспонирует входной тензор.
Входы
- X:T1
- shape:[n1,c1,h1,w1]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n1,c1,h1,w1]
Выходы
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n2,c2,h2,w2]
Атрибуты
- perm, порядок транспонируемых осей: ограничения для разных perm приведены ниже (p=8192,q=2048).
- perm=[0,1,2,3]
- Без ограничений
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Ограничения типов данных
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.2.63 Sigmoid
Поэлементно применяет y=1/(1+exp(‑x)) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.64 Tanh
Вычисляет гиперболический тангенс элементов входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.65 Softplus
Поэлементно применяет Softplus, y=ln(exp(x)+1).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.66 HardSigmoid
Поэлементно применяет y=max(0,min(1,alpha*x+beta)) ко входному тензору, создавая выходной тензор, где
alpha=1/6,beta=0.5
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.67 HardSwish
Поэлементно применяет HardSwish: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), где alpha=1/6,beta=0.5.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.68 Elu
Поэлементно применяет f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0, создавая выходной тензор; alpha=1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.69 exSwish
Поэлементно применяет линейный блок Sigmoid. Swish также называется SiLU: y=x*sigmoid(x).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.70 exMish
Поэлементно применяет mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.71 exGelu
Поэлементно применяет y =x∗Φ(x) ко входному тензору, создавая выходной тензор. Когда Φ(x) задана как tanh,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.72 exSwooshR
Поэлементно применяет к входному тензору следующую функцию из https://arxiv.org/abs/2310.11230, создавая выходной тензор.
SwooshR(x)=log(1+exp(x-1))-0.08x-0.313261687
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.73 exSwooshL
Поэлементно применяет к входному тензору следующую функцию из https://arxiv.org/abs/2310.11230, создавая выходной тензор.
SwooshL(x)=log(1+exp(x-4))-0.08x-0.035
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.74 Where
Выбирает значения x_tensor или y_tensor по mask_tensor: при True берётся соответствующее значение x_tensor, иначе y_tensor.
Входы
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
Выходы
- output:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.2.75 exGlu
Функция вентильного линейного блока (Gated Linear Unit); a — первая половина входной матрицы, b — вторая.
GLU(a,b)=a⊗σ(b)
Входы
- Input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Output:T1
- shape:[batch,channel/2,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int(по умолчанию=1)
- Размерность разделения входа.
- Ограничение: поддерживается только 1.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.76 exMatMul
Матричное умножение
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Входы
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Поддержка квантования
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Поддержка квантования
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- Y:T1
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Атрибуты
- c_type:strings(по умолчанию “add”)
- Выбор add или mul задаёт сложение или умножение с C.
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.2.77 exNorm
Нормализует входные данные. Сейчас поддерживаются LayerNormlization, RMSNormlization и MeanVarianceNormalization:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Здесь x — входной вектор. µ и σ2 — его среднее и дисперсия:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS — среднеквадратичное значение входного вектора:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance — эквивалентная дисперсия входного вектора:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ — малое число для предотвращения деления на ноль. W и B — необязательные параметры.
Входы
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- epsilon:float(по умолчанию 1e‑05)
- Значение epsilon для предотвращения деления на 0.
- mode:string
- Доступны три режима Normalization: layer, rms и mean_var.
- axes:int64[](по умолчанию [1])
- Оси нормализации: сейчас поддерживаются только [1] и [1,2,3].
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.2.78 exSDPAttention
Вычисляет масштабированное скалярное внимание (SDPA) между query, key и value.
Входы
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- scale(optional):T3
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.2.79 exWindow
exWindow основан на window_partition и window_reverse из swin_transformer. В исходной статье входные признаки делятся на непересекающиеся окна window_size×window_size. Входные и выходные признаки должны иметь 4-мерный shape с разбиением по высоте и ширине. Ниже реализация PyTorch:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Входы
- X:T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- mode:string
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- partition: см. реализацию window_partition.
- reverse: см. реализацию window_reverse.
- partition_num_first отличается от partition тем, что H,W делятся согласно num_windows, тогда как partition делит H,W согласно window_sizes.
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-мерный вектор размера окна, задающий высоту и ширину каждого окна. На этом размере основаны вычисление внимания и извлечение признаков внутри окна.
- num_windows:listofints
- 2-мерный вектор числа окон, задающий количество окон по высоте и ширине входных признаков.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.3 RK3562
3.3.1 Add
Выполняет поэлементное бинарное сложение (C=A+B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.3.2 AddRelu
Объединённое вычисление Add и Relu, C=Relu(A+B).
Входы
- Как у Add.
Выходы
- Как у Add.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.3.3 BatchNormalization
Выполняет пакетную нормализацию входного тензора согласно https://arxiv.org/abs/1502.03167.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- epsilon:float (по умолчанию=1e‑5)
- Вещественное число, добавляемое при делении на стандартное отклонение для предотвращения деления на 0.
- epsilon∈(0,∞]
- momentum:float
- Параметр скользящего среднего при обучении.
3.3.4 Concat
Объединяет последовательность векторов в один вдоль axis. Размеры всех векторов вне axis должны совпадать.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axisint64
- axis∈{0,1,2,3}
3.3.5 Convolution
Свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.6 DepthwiseConvolution
Разделимая свёртка по глубине
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.7 ConvolutionRelu
Объединённое вычисление Convolution и Relu, Output=Relu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.8 ConvolutionClip
Объединённое вычисление Convolution и Clip, Output=Clip(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.9 ConvolutionPRelu/LeakyRelu
Объединённое вычисление Convolution и PRelu/LeakyRelu, Output = PRelu(Conv(Input)) или Output =
LeakyRelu(Conv(Input))
Описание и ограничения совпадают с Convolution.
3.3.10 ConvolutionAdd
Объединённое вычисление Convolution и Add, Output=Add(Conv(Input0),Input1).
Описание и ограничения совпадают с Convolution.
3.3.11 ConvolutionSigmoid
Объединённое вычисление Convolution и Sigmoid, Output=Sigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.12 ConvolutionTanh
Объединённое вычисление Convolution и Tanh, Output=Tanh(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.13 ConvolutionSoftplus
Объединённое вычисление Convolution и Softplus, Output=Softplus(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.14 ConvolutionHardSigmoid
Объединённое вычисление Convolution и HardSigmoid, Output=HardSigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.15 ConvolutionHardSwish
Объединённое вычисление Convolution и HardSwish, Output=HardSwish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.16 ConvolutionElu
Объединённое вычисление Convolution и Elu, Output=Elu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.17 ConvolutionSwish
Объединённое вычисление Convolution и Swish, Output=Swish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.18 ConvolutionMish
Объединённое вычисление Convolution и Mish, Output=Mish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.3.19 ConvolutionAddRelu
Объединённое вычисление Convolution, Add и Relu, Output=Relu(Add(Conv(Input0),Input1)).
Описание и ограничения совпадают с Convolution.
3.3.20 ConvTranspose
Транспонированная свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Кроме того, для входа первого слоя
- shape:[batch,channel,height,width]
width ограничена; см. описание входов модели.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). При настройке pad не поддерживаются: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: поддерживается только 1; num_output поддерживается тогда и только тогда, когда num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Если dilation не равно (1,1), поддерживается только kernel=(1,1).
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.21 ConvTranposeRelu
Объединённое вычисление ConvTranpose и Relu, Output=Relu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.22 ConvTranposeClip
Объединённое вычисление ConvTranpose и Clip, Output=Clip(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.23 ConvTranposePRelu/LeakyRelu
Объединённое вычисление ConvTranpose и PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) или Output=
LeakyRelu(ConvTranpose(Input))
Описание и ограничения совпадают с ConvTranspose.
3.3.24 ConvTranposeAdd
Объединённое вычисление ConvTranpose и Add, Output=Add(ConvTranpose(Input0),Input1).
Описание и ограничения совпадают с ConvTranspose.
3.3.25 ConvTranposeSigmoid
Объединённое вычисление ConvTranpose и Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.26 ConvTranposeTanh
Объединённое вычисление ConvTranpose и Tanh, Output=Tanh(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.27 ConvTranposeSoftplus
Объединённое вычисление ConvTranpose и Softplus, Output=Softplus(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.28 ConvTranposeHardSigmoid
Объединённое вычисление ConvTranpose и HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.3.29 ConvTranposeHardSwish
Объединённое вычисление ConvTranpose и HardSwish, Output=HardSwish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.30 ConvTranposeElu
Объединённое вычисление ConvTranpose и Elu, Output=Elu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.31 ConvTranposeSwish
Объединённое вычисление ConvTranpose и Swish, Output=Swish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.32 ConvTranposeMish
Объединённое вычисление ConvTranpose и Mish, Output=Mish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.3.33 Div
Выполняет поэлементное бинарное деление (C=A/B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.3.34 Expand
Входы
- input1:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Ограничения расширения размерностей
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.3.35 GRU
Вентильный рекуррентный блок (GRU, Gated Recurrent Unit). Расширения и варианты GRU называются exGRU; параметры с пометкой (extern) принадлежат только exGRU. Формулы приведены ниже:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- linear_before_reset:int
- Выбор варианта LBR:1(T)or0(F).
- direction(extern):string
- Задаёт направление вычисления GRU.
- forward: прямое направление GRU.
- reverse: обратное направление GRU.
- bidirectional: двунаправленное вычисление GRU.
- sequence_size(extern):int
- Задаёт seqsize входа GRU; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока GRU; без ограничений, рекомендуется выравнивание по 8.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.36 Gather
Выбирает по Indices элементы входа X вдоль заданной axis и объединяет их.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Indices:T2
- Индексы выбираемых элементов; rank =1.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Атрибуты
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Задаёт размерность входа, из которой выбирает Indices.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.3.37 Hardmax
Выходы
- input:T1
- shape:[batch,channel,height,width]
axis=1,height∗width<16384;
- axis=3/‑1,channel∗height<16384; также действуют ограничения tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- Ось hardmax:1,3/‑1, то есть channel и width.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.3.38 LSTM
Сеть долгой краткосрочной памяти (LSTM, Long Short-Term Memory). Расширения и варианты LSTM называются exLSTM; параметры с пометкой (extern) принадлежат только exLSTM. Формулы приведены ниже:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T2
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T2
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T2(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- direction(extern):string
- Задаёт направление вычисления LSTM.
- forward: прямое направление LSTM.
- reverse: обратное направление LSTM.
- bidirectional: двунаправленное вычисление LSTM.
- sequence_size(extern):int
- Задаёт seqsize входа LSTM; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока LSTM; без ограничений, рекомендуется выравнивание по 8.
- proj_size(extern):int
- proj_size при projection; projsize∈[0,hiddensize].
- Сейчас допускается только 0; projection пока не поддерживается.
- input_forget(extern):int
- Выбор варианта cifg:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- has_projection(extern):int
- Вариант projection:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.39 Max
Вычисляет поэлементный максимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.40 Mul
Выполняет поэлементное бинарное умножение (C=A*B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.3.41 MulRelu
Объединённое вычисление Mul и Relu,C=Relu(A*B).
Входы
- Как у Mul.
Выходы
- Как у Mul.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.3.42 Pad
По тензору данных (data), тензору величин заполнения в начале/конце осей (pads), режиму (mode) и константе (constant_value) создаёт дополненный тензор (output).
Входы
- data:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Атрибуты
- mode:string (по умолчанию constant)
- Поддерживаемые режимы: constant,reflect.
- constant: без ограничений.
- Поддерживаемые режимы: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.3.43 MaxPool
MaxPool получает входной тензор X и выполняет максимальный пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется максимум, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64[]
- Приоритетный порядок хранения:0.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.44 GlobalMaxPool
GlobalMaxPool применяет максимальный пулинг к значениям каждого канала входного тензора X. Это эквивалентно MaxPool с kernel_shape, равным пространственным размерам input.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.45 AveragePool
AveragePool получает входной тензор X и выполняет усредняющий пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется среднее всех значений, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.46 GlobalAveragePool
GlobalAveragePool применяет усредняющий пулинг к значениям каждого канала входного тензора X. Это эквивалентно AveragePool с kernel_shape, равным пространственным размерам входного тензора.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.47 Pow
Z =XY
Возведение в степень: получает входные данные (тензор) и показатель степени, создавая выходные данные (тензор).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Y:T2
- shape:[1]
- Сейчас поддерживаются только 0,1,2,3,0.5,‑0.5.
- shape:[1]
Выходы
- Z:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.3.48 Relu
Заменяет отрицательные значения входного тензора нулём, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.49 Clip/ReLU6
Ограничивает значения входного тензора диапазоном [0,6].
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.50 PRelu
Масштабирует отрицательные значения входного тензора обучаемым параметром, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Атрибуты
- slope: коэффициент PRelu.
- Поддерживается только один скаляр или коэффициенты по размерности C.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.51 LeakyRelu
Масштабирует отрицательные значения входного тензора фиксированным коэффициентом, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.52 Reshape
Возвращает тензор заданной формы, не изменяя входные данные и число элементов.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- shape:int
- Задаёт форму выходного тензора.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.3.53 Resize
Изменяет размер входного тензора. Обычно каждое выходное значение вычисляется как взвешенное среднее соседних значений (точек выборки) входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- roi(optional):T2
- Пока не поддерживается.
- scales(optional):T2
- Массив коэффициентов масштабирования по каждой размерности.
- sizes(optional):T3
- Целевой размер выходного тензора.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Атрибуты
- antialias:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- axes:int[]
- Настройка сейчас не поддерживается.
- coordinate_transformation_mode:strings (по умолчанию ”half_pixel”)
- Сейчас поддерживаются только half_pixel, pytorch_half_pixel и align_corners.
- cubic_coeff_a:float (по умолчанию ‑0.75)
- Настройка сейчас не поддерживается.
- exclude_outside:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- extrapolation_value:float (по умолчанию 0)
- Настройка сейчас не поддерживается.
- keep_aspect_ratio_policy:strings (по умолчанию ”stretch”)
- Настройка сейчас не поддерживается.
- mode:strings (по умолчанию ”nearest”)
- Сейчас можно настроить только nearest и linear.
- nearest_mode:strings (по умолчанию ”round_prefer_floor”)
- Настройка сейчас не поддерживается.
Поддержка: сейчас допускается только целочисленное масштабирование ширины и высоты с целыми коэффициентами 2‑8. Вход (1,c,1,1) можно увеличить до (1,c,h,w).
3.3.54 Slice
Получает срез текущего вектора по правилам срезов NumPy.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- starts:int(Tensor)
- Начальная позиция среза: без ограничений.
- ends:int(Tensor)
- Конечная позиция среза: без ограничений.
- axes:int(Tensor)
- Выбор осей среза: любые оси 0~3, включая несколько одновременно.
- steps:int(Tensor)
- Выбирает шаг по соответствующей оси среза.
- При height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc значения steps могут отличаться от 1. Иначе SliceOP может выполняться на NPU только при steps==[1,1,1,1].
3.3.55 Softmax
Оператор вычисляет нормализованные экспоненциальные значения входа:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- Ось softmax:1,3, то есть channel и width.
3.3.56 exSoftmax13
Оператор вычисляет нормализованные экспоненциальные значения входа:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
3.3.57 exSoftmaxMask
Оператор вычисляет нормализованные экспоненциальные значения входа:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, без ограничений;
· axis=3/‑1,width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
- mask_value:int64
- Значения для mask:0,1.
3.3.58 Split
Делит вектор вдоль axis на num_outputs векторов; split задаёт размеры результатов вдоль axis.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- Один или несколько выходных векторов согласно num_outputs.
- shape: определяется разбиением.
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.3.59 Sub
- Выполняет поэлементное бинарное вычитание (C=A‑B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.3.60 Tile
Создаёт тензор повторением заданного тензора, как функция NumPy tile, но без расширения размерностей.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.3.61 Transpose
Транспонирует входной тензор.
Входы
- X:T1
- shape:[n1,c1,h1,w1]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n1,c1,h1,w1]
Выходы
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n2,c2,h2,w2]
Атрибуты
- perm, порядок транспонируемых осей: ограничения для разных perm приведены ниже (p=268435456,q=65536).
- perm=[0,1,2,3]
- Без ограничений
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Ограничения типов данных
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.3.62 Sigmoid
Поэлементно применяет y=1/(1+exp(‑x)) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.63 Tanh
Вычисляет гиперболический тангенс элементов входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.64 Softplus
Поэлементно применяет Softplus, y=ln(exp(x)+1).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.65 HardSigmoid
Поэлементно применяет y=max(0,min(1,alpha*x+beta)) ко входному тензору, создавая выходной тензор, где
alpha=1/6,beta=0.5
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.66 HardSwish
Поэлементно применяет HardSwish: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), где alpha=1/6,beta=0.5.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.67 Elu
Поэлементно применяет f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0, создавая выходной тензор; alpha=1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.68 exSwish
Поэлементно применяет линейный блок Sigmoid. Swish также называется SiLU: y=x*sigmoid(x).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.69 exMish
Поэлементно применяет mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.70 exGelu
Поэлементно применяет y =x∗Φ(x) ко входному тензору, создавая выходной тензор. Когда Φ(x) задана как tanh,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.3.71 Where
Выбирает значения x_tensor или y_tensor по mask_tensor: при True берётся соответствующее значение x_tensor, иначе y_tensor.
Входы
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
Выходы
- output:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.3.72 exGlu
Функция вентильного линейного блока (Gated Linear Unit); a — первая половина входной матрицы, b — вторая.
GLU(a,b)=a⊗σ(b)
Входы
- Input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Output:T1
- shape:[batch,channel/2,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int(по умолчанию=1)
- Размерность разделения входа.
- Ограничение: поддерживается только 1.
3.3.73 exMatMul
Матричное умножение
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Входы
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Поддержка квантования
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Поддержка квантования
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- Y:T1
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Атрибуты
- c_type:strings(по умолчанию “add”)
- Выбор add или mul задаёт сложение или умножение с C.
3.3.74 exNorm
Нормализует входные данные. Сейчас поддерживаются LayerNormlization, RMSNormlization и MeanVarianceNormalization:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Здесь x — входной вектор. µ и σ2 — его среднее и дисперсия:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS — среднеквадратичное значение входного вектора:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance — эквивалентная дисперсия входного вектора:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ — малое число для предотвращения деления на ноль. W и B — необязательные параметры.
Входы
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- epsilon:float(по умолчанию 1e‑05)
- Значение epsilon для предотвращения деления на 0.
- mode:string
- Доступны три режима Normalization: layer, rms и mean_var.
- axes:int64[](по умолчанию [1])
- Оси нормализации: сейчас поддерживаются только [1] и [1,2,3].
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.3.75 exSDPAttention
Вычисляет масштабированное скалярное внимание (SDPA) между query, key и value.
Входы
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- По умолчанию поддерживается расширение по любой размерности.
- При включённом FA поддерживаются только [b,c,1,1],[1,c,1,1] и [1,c,h,w].
- scale(optional):T3
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- FlashAttentionV2(FA): поддерживается.
- Реализация основана на https://arxiv.org/abs/2307.08691. Внутренние циклы в кэше ускоряют вычисления и снижают расход пропускной способности, но увеличивают размер модели; включайте с учётом сценария и модели.
- Версия драйвера RKNPU>=0.8.8
- Версия библиотеки RKNPU Runtime (librknnrt.so)>=2.0.0
- Поддерживаемый тип данных:float16.
3.3.76 exWindow
exWindow основан на window_partition и window_reverse из swin_transformer. В исходной статье входные признаки делятся на непересекающиеся окна window_size×window_size. Входные и выходные признаки должны иметь 4-мерный shape с разбиением по высоте и ширине. Ниже реализация PyTorch:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Входы
- X:T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- mode:string
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- partition: см. реализацию window_partition.
- reverse: см. реализацию window_reverse.
- partition_num_first отличается от partition тем, что H,W делятся согласно num_windows, тогда как partition делит H,W согласно window_sizes.
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-мерный вектор размера окна, задающий высоту и ширину каждого окна. На этом размере основаны вычисление внимания и извлечение признаков внутри окна.
- num_windows:listofints
- 2-мерный вектор числа окон, задающий количество окон по высоте и ширине входных признаков.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.4 RV1103/RV1106
3.4.1 Add
Выполняет поэлементное бинарное сложение (C=A+B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(constTensor)
3.4.2 AddRelu
Объединённое вычисление Add и Relu, C=Relu(A+B).
Входы
- Как у Add.
Выходы
- Как у Add.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.4.3 BatchNormalization
Выполняет пакетную нормализацию входного тензора согласно https://arxiv.org/abs/1502.03167.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- epsilon:float (по умолчанию=1e‑5)
- Вещественное число, добавляемое при делении на стандартное отклонение для предотвращения деления на 0.
- epsilon∈(0,∞]
- momentum:float
- Параметр скользящего среднего при обучении.
3.4.4 Concat
Объединяет последовательность векторов в один вдоль axis. Размеры всех векторов вне axis должны совпадать.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axisint64
- axis∈{0,1,2,3}
3.4.5 Convolution
Свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Ограничения типов данных
- T1:int8(Tensor)
3.4.6 DepthwiseConvolution
Разделимая свёртка по глубине
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:int8(Tensor)
3.4.7 ConvolutionRelu
Объединённое вычисление Convolution и Relu, Output=Relu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.8 ConvolutionClip
Объединённое вычисление Convolution и Clip, Output=Clip(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.9 ConvolutionPRelu/LeakyRelu
Объединённое вычисление Convolution и PRelu/LeakyRelu, Output = PRelu(Conv(Input)) или Output =
LeakyRelu(Conv(Input))
Описание и ограничения совпадают с Convolution.
3.4.10 ConvolutionAdd
Объединённое вычисление Convolution и Add, Output=Add(Conv(Input0),Input1).
Описание и ограничения совпадают с Convolution.
3.4.11 ConvolutionSigmoid
Объединённое вычисление Convolution и Sigmoid, Output=Sigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.12 ConvolutionTanh
Объединённое вычисление Convolution и Tanh, Output=Tanh(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.13 ConvolutionSoftplus
Объединённое вычисление Convolution и Softplus, Output=Softplus(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.14 ConvolutionHardSigmoid
Объединённое вычисление Convolution и HardSigmoid, Output=HardSigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.15 ConvolutionHardSwish
Объединённое вычисление Convolution и HardSwish, Output=HardSwish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.16 ConvolutionElu
Объединённое вычисление Convolution и Elu, Output=Elu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.17 ConvolutionSwish
Объединённое вычисление Convolution и Swish, Output=Swish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.18 ConvolutionMish
Объединённое вычисление Convolution и Mish, Output=Mish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.4.19 ConvolutionAddRelu
Объединённое вычисление Convolution, Add и Relu, Output=Relu(Add(Conv(Input0),Input1)).
Описание и ограничения совпадают с Convolution.
3.4.20 ConvTranspose
Транспонированная свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Кроме того, для входа первого слоя
- shape:[batch,channel,height,width]
width ограничена; см. описание входов модели.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). При настройке pad не поддерживаются: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: поддерживается только 1; num_output поддерживается тогда и только тогда, когда num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Если dilation не равно (1,1), поддерживается только kernel=(1,1).
Ограничения типов данных
- T1:int8(Tensor)
3.4.21 ConvTranposeRelu
Объединённое вычисление ConvTranpose и Relu, Output=Relu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.22 ConvTranposeClip
Объединённое вычисление ConvTranpose и Clip, Output=Clip(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.23 ConvTranposePRelu/LeakyRelu
Объединённое вычисление ConvTranpose и PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) или Output=
LeakyRelu(ConvTranpose(Input))
Описание и ограничения совпадают с ConvTranspose.
3.4.24 ConvTranposeAdd
Объединённое вычисление ConvTranpose и Add, Output=Add(ConvTranpose(Input0),Input1).
Описание и ограничения совпадают с ConvTranspose.
3.4.25 ConvTranposeSigmoid
Объединённое вычисление ConvTranpose и Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.26 ConvTranposeTanh
Объединённое вычисление ConvTranpose и Tanh, Output=Tanh(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.27 ConvTranposeSoftplus
Объединённое вычисление ConvTranpose и Softplus, Output=Softplus(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.28 ConvTranposeHardSigmoid
Объединённое вычисление ConvTranpose и HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.4.29 ConvTranposeHardSwish
Объединённое вычисление ConvTranpose и HardSwish, Output=HardSwish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.30 ConvTranposeElu
Объединённое вычисление ConvTranpose и Elu, Output=Elu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.31 ConvTranposeSwish
Объединённое вычисление ConvTranpose и Swish, Output=Swish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.32 ConvTranposeMish
Объединённое вычисление ConvTranpose и Mish, Output=Mish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.4.33 Div
Выполняет поэлементное бинарное деление (C=A/B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.4.34 Expand
Расширяет входной тензор по заданным shape и правилам, подобно numpy.array(input) *numpy.ones(shape): размерности выравниваются справа; соответствующие размерности должны совпадать либо одна из них должна быть 1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:int64(Tensor)
Ограничения расширения размерностей
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.4.35 Hardmax
Выходы
- input:T1
- shape:[batch,channel,height,width]
channel∗height∗width<=8192
- axis=1,height∗width<16384, причём height∗width равно 1 либо больше 8;
- axis=3/‑1,channel ∗ height < 16384, причём channel ∗ height равно 1 либо больше 8; также действуют ограничения tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- Ось hardmax:1,3/‑1, то есть channel и width.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.4.36 LSTM
Сеть долгой краткосрочной памяти (LSTM, Long Short-Term Memory). Расширения и варианты LSTM называются exLSTM; параметры с пометкой (extern) принадлежат только exLSTM. Формулы приведены ниже:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- initial_c:T3(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- direction(extern):string
- Задаёт направление вычисления LSTM.
- forward: прямое направление LSTM.
- reverse: обратное направление LSTM.
- bidirectional: двунаправленное вычисление LSTM.
- sequence_size(extern):int
- Задаёт seqsize входа LSTM; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока LSTM; без ограничений, рекомендуется выравнивание по 8.
- proj_size(extern):int
- proj_size при projection; projsize∈[0,hiddensize].
- Сейчас допускается только 0; projection пока не поддерживается.
- input_forget(extern):int
- Выбор варианта cifg:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- has_projection(extern):int
- Вариант projection:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:int8(Tensor)
- T2:int32(Tensor)
- T3:int(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.37 Max
Вычисляет поэлементный максимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.38 Min
Вычисляет поэлементный минимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.39 Mul
Выполняет поэлементное бинарное умножение (C=A*B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(constTensor)
3.4.40 MulRelu
Объединённое вычисление Mul и Relu,C=Relu(A*B).
Входы
- Как у Mul.
Выходы
- Как у Mul.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.4.41 Pad
По тензору данных (data), тензору величин заполнения в начале/конце осей (pads), режиму (mode) и константе (constant_value) создаёт дополненный тензор (output).
Входы
- data:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Атрибуты
- mode:string (по умолчанию constant)
- Поддерживаемые режимы: constant,reflect.
- constant: без ограничений.
- Поддерживаемые режимы: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.4.42 MaxPool
MaxPool получает входной тензор X и выполняет максимальный пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется максимум, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64[]
- Приоритетный порядок хранения:0.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.43 GlobalMaxPool
GlobalMaxPool применяет максимальный пулинг к значениям каждого канала входного тензора X. Это эквивалентно MaxPool с kernel_shape, равным пространственным размерам input.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.44 AveragePool
AveragePool получает входной тензор X и выполняет усредняющий пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется среднее всех значений, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.45 GlobalAveragePool
GlobalAveragePool применяет усредняющий пулинг к значениям каждого канала входного тензора X. Это эквивалентно AveragePool с kernel_shape, равным пространственным размерам входного тензора.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.46 Pow
Z =XY
Возведение в степень: получает входные данные (тензор) и показатель степени, создавая выходные данные (тензор).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Y:T2
- shape:[1]
- Сейчас поддерживаются только 0,1,2,3,0.5,‑0.5.
- shape:[1]
Выходы
- Z:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.4.47 Relu
Заменяет отрицательные значения входного тензора нулём, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.48 Clip/ReLU6
Ограничивает значения входного тензора диапазоном [0,6].
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.49 PRelu
Масштабирует отрицательные значения входного тензора обучаемым параметром, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Атрибуты
- slope: коэффициент PRelu.
- Поддерживается только один скаляр или коэффициенты по размерности C.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.50 LeakyRelu
Масштабирует отрицательные значения входного тензора фиксированным коэффициентом, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.51 Reshape
Возвращает тензор заданной формы, не изменяя входные данные и число элементов.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- shape:int
- Задаёт форму выходного тензора.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.4.52 Resize
Изменяет размер входного тензора. Обычно каждое выходное значение вычисляется как взвешенное среднее соседних значений (точек выборки) входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- roi(optional):T2
- Пока не поддерживается.
- scales(optional):T2
- Массив коэффициентов масштабирования по каждой размерности.
- sizes(optional):T3
- Целевой размер выходного тензора.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Атрибуты
- antialias:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- axes:int[]
- Настройка сейчас не поддерживается.
- coordinate_transformation_mode:strings (по умолчанию ”half_pixel”)
- Сейчас поддерживаются только half_pixel, pytorch_half_pixel и align_corners.
- cubic_coeff_a:float (по умолчанию ‑0.75)
- Настройка сейчас не поддерживается.
- exclude_outside:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- extrapolation_value:float (по умолчанию 0)
- Настройка сейчас не поддерживается.
- keep_aspect_ratio_policy:strings (по умолчанию ”stretch”)
- Настройка сейчас не поддерживается.
- mode:strings (по умолчанию ”nearest”)
- Сейчас можно настроить только nearest и linear.
- nearest_mode:strings (по умолчанию ”round_prefer_floor”)
- Настройка сейчас не поддерживается.
Поддержка: сейчас допускается только целочисленное масштабирование ширины и высоты с целыми коэффициентами 2‑8. Вход (1,c,1,1) можно увеличить до (1,c,h,w).
3.4.53 Slice
Получает срез текущего вектора по правилам срезов NumPy.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- starts:int(Tensor)
- Начальная позиция среза: без ограничений.
- ends:int(Tensor)
- Конечная позиция среза: без ограничений.
- axes:int(Tensor)
- Выбор осей среза: любые оси 0~3, включая несколько одновременно.
- steps:int(Tensor)
- Выбирает шаг по соответствующей оси среза.
- При height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc значения steps могут отличаться от 1. Иначе SliceOP может выполняться на NPU только при steps==[1,1,1,1].
3.4.54 Softmax
Оператор вычисляет нормализованные экспоненциальные значения входа:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- Ось softmax:1,3, то есть channel и width.
3.4.55 exSoftmax13
Оператор вычисляет нормализованные экспоненциальные значения входа:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
3.4.56 exSoftmaxMask
Оператор вычисляет нормализованные экспоненциальные значения входа:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, без ограничений;
· axis=3/‑1,width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
- mask_value:int64
- Значения для mask:0,1.
3.4.57 Split
Делит вектор вдоль axis на num_outputs векторов; split задаёт размеры результатов вдоль axis.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- Один или несколько выходных векторов согласно num_outputs.
- shape: определяется разбиением.
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.4.58 Sub
- Выполняет поэлементное бинарное вычитание (C=A‑B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(constTensor)
3.4.59 Tile
Создаёт тензор повторением заданного тензора, как функция NumPy tile, но без расширения размерностей.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.4.60 Transpose
Транспонирует входной тензор.
Входы
- X:T1
- shape:[n1,c1,h1,w1]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n1,c1,h1,w1]
Выходы
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n2,c2,h2,w2]
Атрибуты
- perm, порядок транспонируемых осей: ограничения для разных perm приведены ниже (p=8192,q=2048).
- perm=[0,1,2,3]
- Без ограничений
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Ограничения типов данных
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.4.61 Sigmoid
Поэлементно применяет y=1/(1+exp(‑x)) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.62 Tanh
Вычисляет гиперболический тангенс элементов входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.63 Softplus
Поэлементно применяет Softplus, y=ln(exp(x)+1).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.64 HardSigmoid
Поэлементно применяет y=max(0,min(1,alpha*x+beta)) ко входному тензору, создавая выходной тензор, где
alpha=1/6,beta=0.5
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.65 HardSwish
Поэлементно применяет HardSwish: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), где alpha=1/6,beta=0.5.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.66 Elu
Поэлементно применяет f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0, создавая выходной тензор; alpha=1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.67 exSwish
Поэлементно применяет линейный блок Sigmoid. Swish также называется SiLU: y=x*sigmoid(x).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.68 exMish
Поэлементно применяет mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.69 exGelu
Поэлементно применяет y =x∗Φ(x) ко входному тензору, создавая выходной тензор. Когда Φ(x) задана как tanh,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
3.4.70 Where
Выбирает значения x_tensor или y_tensor по mask_tensor: при True берётся соответствующее значение x_tensor, иначе y_tensor.
Входы
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
Выходы
- output:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.4.71 exGlu
Функция вентильного линейного блока (Gated Linear Unit); a — первая половина входной матрицы, b — вторая.
GLU(a,b)=a⊗σ(b)
Входы
- Input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Output:T1
- shape:[batch,channel/2,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int(по умолчанию=1)
- Размерность разделения входа.
- Ограничение: поддерживается только 1.
3.4.72 exMatMul
Матричное умножение
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Входы
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Поддержка квантования
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Поддержка квантования
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- Y:T1
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(Tensor)
Атрибуты
- c_type:strings(по умолчанию “add”)
- Выбор add или mul задаёт сложение или умножение с C.
3.4.73 exSDPAttention
Вычисляет масштабированное скалярное внимание (SDPA) между query, key и value.
Входы
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- По умолчанию поддерживается расширение по любой размерности.
- scale(optional):T3
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.74 exWindow
exWindow основан на window_partition и window_reverse из swin_transformer. В исходной статье входные признаки делятся на непересекающиеся окна window_size×window_size. Входные и выходные признаки должны иметь 4-мерный shape с разбиением по высоте и ширине. Ниже реализация PyTorch:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Входы
- X:T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- mode:string
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- partition: см. реализацию window_partition.
- reverse: см. реализацию window_reverse.
- partition_num_first отличается от partition тем, что H,W делятся согласно num_windows, тогда как partition делит H,W согласно window_sizes.
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-мерный вектор размера окна, задающий высоту и ширину каждого окна. На этом размере основаны вычисление внимания и извлечение признаков внутри окна.
- num_windows:listofints
- 2-мерный вектор числа окон, задающий количество окон по высоте и ширине входных признаков.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5 RK3576/RV1126B
3.5.1 Add
Выполняет поэлементное бинарное сложение (C=A+B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.2 AddRelu
Объединённое вычисление Add и Relu, C=Relu(A+B).
Входы
- Как у Add.
Выходы
- Как у Add.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.3 BatchNormalization
Выполняет пакетную нормализацию входного тензора согласно https://arxiv.org/abs/1502.03167.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- epsilon:float (по умолчанию=1e‑5)
- Вещественное число, добавляемое при делении на стандартное отклонение для предотвращения деления на 0.
- epsilon∈(0,∞]
- momentum:float
- Параметр скользящего среднего при обучении.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.4 Concat
Объединяет последовательность векторов в один вдоль axis. Размеры всех векторов вне axis должны совпадать.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axisint64
- axis∈{0,1,2,3}
3.5.5 Convolution
Свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.6 DepthwiseConvolution
Разделимая свёртка по глубине
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.7 ConvolutionRelu
Объединённое вычисление Convolution и Relu, Output=Relu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.8 ConvolutionClip
Объединённое вычисление Convolution и Clip, Output=Clip(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.9 ConvolutionPRelu/LeakyRelu
Объединённое вычисление Convolution и PRelu/LeakyRelu, Output = PRelu(Conv(Input)) или Output =
LeakyRelu(Conv(Input))
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.10 ConvolutionAdd
Объединённое вычисление Convolution и Add, Output=Add(Conv(Input0),Input1).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.11 ConvolutionSigmoid
Объединённое вычисление Convolution и Sigmoid, Output=Sigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.12 ConvolutionTanh
Объединённое вычисление Convolution и Tanh, Output=Tanh(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.13 ConvolutionSoftplus
Объединённое вычисление Convolution и Softplus, Output=Softplus(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.14 ConvolutionHardSigmoid
Объединённое вычисление Convolution и HardSigmoid, Output=HardSigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.15 ConvolutionHardSwish
Объединённое вычисление Convolution и HardSwish, Output=HardSwish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.16 ConvolutionElu
Объединённое вычисление Convolution и Elu, Output=Elu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.17 ConvolutionSwish
Объединённое вычисление Convolution и Swish, Output=Swish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.18 ConvolutionMish
Объединённое вычисление Convolution и Mish, Output=Mish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.19 ConvolutionAddRelu
Объединённое вычисление Convolution, Add и Relu, Output=Relu(Add(Conv(Input0),Input1)).
Описание и ограничения совпадают с Convolution.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.20 ConvTranspose
Транспонированная свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). При настройке pad не поддерживаются: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: поддерживается только 1; num_output поддерживается тогда и только тогда, когда num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Если dilation не равно (1,1), поддерживается только kernel=(1,1).
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.21 ConvTranposeRelu
Объединённое вычисление ConvTranpose и Relu, Output=Relu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.22 ConvTranposeClip
Объединённое вычисление ConvTranpose и Clip, Output=Clip(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.23 ConvTranposePRelu/LeakyRelu
Объединённое вычисление ConvTranpose и PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) или Output=
LeakyRelu(ConvTranpose(Input))
Описание и ограничения совпадают с ConvTranspose.
3.5.24 ConvTranposeAdd
Объединённое вычисление ConvTranpose и Add, Output=Add(ConvTranpose(Input0),Input1).
Описание и ограничения совпадают с ConvTranspose.
3.5.25 ConvTranposeSigmoid
Объединённое вычисление ConvTranpose и Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.26 ConvTranposeTanh
Объединённое вычисление ConvTranpose и Tanh, Output=Tanh(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.27 ConvTranposeSoftplus
Объединённое вычисление ConvTranpose и Softplus, Output=Softplus(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.28 ConvTranposeHardSigmoid
Объединённое вычисление ConvTranpose и HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.29 ConvTranposeHardSwish
Объединённое вычисление ConvTranpose и HardSwish, Output=HardSwish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.30 ConvTranposeElu
Объединённое вычисление ConvTranpose и Elu, Output=Elu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.31 ConvTranposeSwish
Объединённое вычисление ConvTranpose и Swish, Output=Swish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.32 ConvTranposeMish
Объединённое вычисление ConvTranpose и Mish, Output=Mish(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.5.33 Div
Выполняет поэлементное бинарное деление (C=A/B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.5.34 Expand
Расширяет входной тензор по заданным shape и правилам, подобно numpy.array(input) *numpy.ones(shape): размерности выравниваются справа; соответствующие размерности должны совпадать либо одна из них должна быть 1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Ограничения расширения размерностей
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.5.35 GRU
Вентильный рекуррентный блок (GRU, Gated Recurrent Unit). Расширения и варианты GRU называются exGRU; параметры с пометкой (extern) принадлежат только exGRU. Формулы приведены ниже:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- linear_before_reset:int
- Выбор варианта LBR:1(T)or0(F).
- direction(extern):string
- Задаёт направление вычисления GRU.
- forward: прямое направление GRU.
- reverse: обратное направление GRU.
- bidirectional: двунаправленное вычисление GRU.
- sequence_size(extern):int
- Задаёт seqsize входа GRU; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока GRU; без ограничений, рекомендуется выравнивание по 8.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.36 Gather
Выбирает по Indices элементы входа X вдоль заданной axis и объединяет их.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Indices:T2
- Индексы выбираемых элементов; rank =1.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Атрибуты
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Задаёт размерность входа, из которой выбирает Indices.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.37 Hardmax
Вычисляет активацию hardmax для входа согласно ONNX Hardmax‑13.
Hardmax(input, axis) =
  1   if i = argmax(input, axis)
  0   otherwise
Входы
- input:T
- shape:[batch,channel,height,width]; при axis=1 требуется height∗width∈[1,16384);
- При axis=3/‑1 требуется channel∗height∈[1,16384); также действуют ограничения tranpose.
- shape:[batch,channel,height,width]; при axis=1 требуется height∗width∈[1,16384);
Выходы
- output:T
- shape:[batch,channel,height,width]
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- Ось hardmax:axis∈{−1,1,3}, то есть channel и width.
3.5.38 LSTM
Сеть долгой краткосрочной памяти (LSTM, Long Short-Term Memory). Расширения и варианты LSTM называются exLSTM; параметры с пометкой (extern) принадлежат только exLSTM. Формулы приведены ниже:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2,T3
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T4,T5(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- direction(extern):string
- Задаёт направление вычисления LSTM.
- forward: прямое направление LSTM.
- reverse: обратное направление LSTM.
- bidirectional: двунаправленное вычисление LSTM.
- sequence_size(extern):int
- Задаёт seqsize входа LSTM; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока LSTM; без ограничений, рекомендуется выравнивание по 8.
- proj_size(extern):int
- proj_size при projection; projsize∈[0,hiddensize].
- Сейчас допускается только 0; projection пока не поддерживается.
- input_forget(extern):int
- Выбор варианта cifg:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- has_projection(extern):int
- Вариант projection:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
- T5:int(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.39 Max
Вычисляет поэлементный максимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.40 Greater
Вычисляет Greater для входных тензоров A и B.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.41 Min
Вычисляет поэлементный минимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.42 Mul
Выполняет поэлементное бинарное умножение (C=A*B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.43 MulRelu
Объединённое вычисление Mul и Relu,C=Relu(A*B).
Входы
- Как у Mul.
Выходы
- Как у Mul.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
3.5.44 Pad
По тензору данных (data), тензору величин заполнения в начале/конце осей (pads), режиму (mode) и константе (constant_value) создаёт дополненный тензор (output).
Входы
- data:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Атрибуты
- mode:string (по умолчанию constant)
- Поддерживаемые режимы: constant,reflect.
- constant: без ограничений.
- Поддерживаемые режимы: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.45 MaxPool
MaxPool получает входной тензор X и выполняет максимальный пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется максимум, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64[]
- Приоритетный порядок хранения:0.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.46 GlobalMaxPool
GlobalMaxPool применяет максимальный пулинг к значениям каждого канала входного тензора X. Это эквивалентно MaxPool с kernel_shape, равным пространственным размерам input.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.47 AveragePool
AveragePool получает входной тензор X и выполняет усредняющий пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется среднее всех значений, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.48 GlobalAveragePool
GlobalAveragePool применяет усредняющий пулинг к значениям каждого канала входного тензора X. Это эквивалентно AveragePool с kernel_shape, равным пространственным размерам входного тензора.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(1,7]
width∈(1,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.49 Pow
Z =XY
Возведение в степень: получает входные данные (тензор) и показатель степени, создавая выходные данные (тензор).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Y:T2
- shape:[1]
- Сейчас поддерживаются только 0,1,2,3,0.5,‑0.5.
- shape:[1]
Выходы
- Z:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.50 Relu
Заменяет отрицательные значения входного тензора нулём, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.51 Clip/ReLU6
Ограничивает значения входного тензора диапазоном [0,6].
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.52 PRelu
Масштабирует отрицательные значения входного тензора обучаемым параметром, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Атрибуты
- slope: коэффициент PRelu.
- Поддерживается только один скаляр или коэффициенты по размерности C.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.53 LeakyRelu
Масштабирует отрицательные значения входного тензора фиксированным коэффициентом, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.54 Reshape
Возвращает тензор заданной формы, не изменяя входные данные и число элементов.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- shape:int
- Задаёт форму выходного тензора.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.55 Resize
Изменяет размер входного тензора. Обычно каждое выходное значение вычисляется как взвешенное среднее соседних значений (точек выборки) входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- roi(optional):T2
- Пока не поддерживается.
- scales(optional):T2
- Массив коэффициентов масштабирования по каждой размерности.
- sizes(optional):T3
- Целевой размер выходного тензора.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Атрибуты
- antialias:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- axes:int[]
- Настройка сейчас не поддерживается.
- coordinate_transformation_mode:strings (по умолчанию ”half_pixel”)
- Сейчас поддерживаются только half_pixel, pytorch_half_pixel и align_corners.
- cubic_coeff_a:float (по умолчанию ‑0.75)
- Настройка сейчас не поддерживается.
- exclude_outside:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- extrapolation_value:float (по умолчанию 0)
- Настройка сейчас не поддерживается.
- keep_aspect_ratio_policy:strings (по умолчанию ”stretch”)
- Настройка сейчас не поддерживается.
- mode:strings (по умолчанию ”nearest”)
- Сейчас можно настроить только nearest и linear.
- nearest_mode:strings (по умолчанию ”round_prefer_floor”)
- Настройка сейчас не поддерживается.
Поддержка: сейчас допускается только целочисленное масштабирование ширины и высоты с целыми коэффициентами 2‑8. Вход (1,c,1,1) можно увеличить до (1,c,h,w).
- Совместная работа нескольких ядер: не поддерживается.
3.5.56 Slice
Получает срез текущего вектора по правилам срезов NumPy.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- starts:int(Tensor)
- Начальная позиция среза: без ограничений.
- ends:int(Tensor)
- Конечная позиция среза: без ограничений.
- axes:int(Tensor)
- Выбор осей среза: любые оси 0~3, включая несколько одновременно.
- steps:int(Tensor)
- Выбирает шаг по соответствующей оси среза.
- При height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc значения steps могут отличаться от 1. Иначе SliceOP может выполняться на NPU только при steps==[1,1,1,1].
3.5.57 Softmax
Оператор вычисляет нормализованные экспоненциальные значения входа:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.58 exSoftmax13
Оператор вычисляет нормализованные экспоненциальные значения входа:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.59 exSoftmaxMask
Оператор вычисляет нормализованные экспоненциальные значения входа:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, без ограничений;
· axis=3/‑1,width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
- mask_value:int64
- Значения для mask:0,1.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.60 Split
Делит вектор вдоль axis на num_outputs векторов; split задаёт размеры результатов вдоль axis.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- Один или несколько выходных векторов согласно num_outputs.
- shape: определяется разбиением.
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.5.61 Sub
- Выполняет поэлементное бинарное вычитание (C=A‑B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.5.62 Tile
Создаёт тензор повторением заданного тензора, как функция NumPy tile, но без расширения размерностей.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.5.63 Transpose
Транспонирует входной тензор.
Входы
- X:T1
- shape:[n1,c1,h1,w1]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n1,c1,h1,w1]
Выходы
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n2,c2,h2,w2]
Атрибуты
- perm, порядок транспонируемых осей: ограничения для разных perm приведены ниже (p=268435456,q=65536).
- perm=[0,1,2,3]
- Без ограничений
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Ограничения типов данных
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.5.64 Sigmoid
Поэлементно применяет y=1/(1+exp(‑x)) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.65 Tanh
Вычисляет гиперболический тангенс элементов входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.66 Softplus
Поэлементно применяет Softplus, y=ln(exp(x)+1).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.67 HardSigmoid
Поэлементно применяет y=max(0,min(1,alpha*x+beta)) ко входному тензору, создавая выходной тензор, где
alpha=1/6,beta=0.5
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.68 HardSwish
Поэлементно применяет HardSwish: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), где alpha=1/6,beta=0.5.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.69 Elu
Поэлементно применяет f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0, создавая выходной тензор; alpha=1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.70 exSwish
Поэлементно применяет линейный блок Sigmoid. Swish также называется SiLU: y=x*sigmoid(x).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.71 exMish
Поэлементно применяет mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.72 exGelu
Поэлементно применяет y =x∗Φ(x) ко входному тензору, создавая выходной тензор. Когда Φ(x) задана как tanh,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.73 Where
Выбирает значения x_tensor или y_tensor по mask_tensor: при True берётся соответствующее значение x_tensor, иначе y_tensor.
Входы
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- x_tensor:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- y_tensor:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
Выходы
- output:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.5.74 exGlu
Функция вентильного линейного блока (Gated Linear Unit); a — первая половина входной матрицы, b — вторая.
GLU(a,b)=a⊗σ(b)
Входы
- Input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Output:T1
- shape:[batch,channel/2,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- axis:int(по умолчанию=1)
- Размерность разделения входа.
- Ограничение: поддерживается только 1.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.75 exMatMul
Матричное умножение
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Входы
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Поддержка квантования
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Поддержка квантования
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- Y:T1
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Атрибуты
- c_type:strings(по умолчанию “add”)
- Выбор add или mul задаёт сложение или умножение с C.
Прочие возможности
- Совместная работа нескольких ядер: не поддерживается.
3.5.76 exNorm
Нормализует входные данные. Сейчас поддерживаются LayerNormlization, RMSNormlization и MeanVarianceNormalization:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Здесь x — входной вектор. µ и σ2 — его среднее и дисперсия:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS — среднеквадратичное значение входного вектора:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance — эквивалентная дисперсия входного вектора:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ — малое число для предотвращения деления на ноль. W и B — необязательные параметры.
Входы
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- epsilon:float(по умолчанию 1e‑05)
- Значение epsilon для предотвращения деления на 0.
- mode:string
- Доступны три режима Normalization: layer, rms и mean_var.
- axes:int64[](по умолчанию [1])
- Оси нормализации: сейчас поддерживаются только [1] и [1,2,3].
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.5.77 exSDPAttention
Вычисляет масштабированное скалярное внимание (SDPA) между query, key и value.
Входы
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Поддержка квантования
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- По умолчанию поддерживается расширение по любой размерности.
- При включённом FA поддерживаются только [b,c,1,1],[1,c,1,1] и [1,c,h,w].
- scale(optional):T3
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: поддерживается на RK3576 / не поддерживается на RV1126B.
- FlashAttentionV2(FA): поддерживается.
- Реализация основана на https://arxiv.org/abs/2307.08691. Внутренние циклы в кэше ускоряют вычисления и снижают расход пропускной способности, но увеличивают размер модели; включайте с учётом сценария и модели.
- Версия драйвера RKNPU>=0.9.7
- Версия библиотеки RKNPU Runtime (librknnrt.so)>=2.1.0
- Поддерживаемый тип данных:float16.
3.5.78 exWindow
exWindow основан на window_partition и window_reverse из swin_transformer. В исходной статье входные признаки делятся на непересекающиеся окна window_size×window_size. Входные и выходные признаки должны иметь 4-мерный shape с разбиением по высоте и ширине. Ниже реализация PyTorch:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Входы
- X:T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
Атрибуты
- mode:string
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- partition: см. реализацию window_partition.
- reverse: см. реализацию window_reverse.
- partition_num_first отличается от partition тем, что H,W делятся согласно num_windows, тогда как partition делит H,W согласно window_sizes.
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-мерный вектор размера окна, задающий высоту и ширину каждого окна. На этом размере основаны вычисление внимания и извлечение признаков внутри окна.
- num_windows:listofints
- 2-мерный вектор числа окон, задающий количество окон по высоте и ширине входных признаков.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.6 RK2118
3.6.1 Add
Выполняет поэлементное бинарное сложение (C=A+B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.2 AddRelu
Объединённое вычисление Add и Relu, C=Relu(A+B).
Входы
- Как у Add.
Выходы
- Как у Add.
3.6.3 BatchNormalization
Выполняет пакетную нормализацию входного тензора согласно https://arxiv.org/abs/1502.03167.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- epsilon:float (по умолчанию=1e‑5)
- Вещественное число, добавляемое при делении на стандартное отклонение для предотвращения деления на 0.
- epsilon∈(0,∞]
- momentum:float
- Параметр скользящего среднего при обучении.
3.6.4 Concat
Объединяет последовательность векторов в один вдоль axis. Размеры всех векторов вне axis должны совпадать.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:float16(Tensor)
Атрибуты
- axisint64
- axis∈{0,1,2,3}
3.6.5 Convolution
Свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Ограничения типов данных
- T1:float16(Tensor)
3.6.6 DepthwiseConvolution
Разделимая свёртка по глубине
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:float16(Tensor)
3.6.7 ConvolutionRelu
Объединённое вычисление Convolution и Relu, Output=Relu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.8 ConvolutionClip
Объединённое вычисление Convolution и Clip, Output=Clip(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.9 ConvolutionPRelu/LeakyRelu
Объединённое вычисление Convolution и PRelu/LeakyRelu, Output = PRelu(Conv(Input)) или Output =
LeakyRelu(Conv(Input))
Описание и ограничения совпадают с Convolution.
3.6.10 ConvolutionAdd
Объединённое вычисление Convolution и Add, Output=Add(Conv(Input0),Input1).
Описание и ограничения совпадают с Convolution.
3.6.11 ConvolutionSigmoid
Объединённое вычисление Convolution и Sigmoid, Output=Sigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.12 ConvolutionTanh
Объединённое вычисление Convolution и Tanh, Output=Tanh(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.13 ConvolutionSoftplus
Объединённое вычисление Convolution и Softplus, Output=Softplus(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.14 ConvolutionHardSigmoid
Объединённое вычисление Convolution и HardSigmoid, Output=HardSigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.15 ConvolutionHardSwish
Объединённое вычисление Convolution и HardSwish, Output=HardSwish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.16 ConvolutionElu
Объединённое вычисление Convolution и Elu, Output=Elu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.17 ConvolutionSwish
Объединённое вычисление Convolution и Swish, Output=Swish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.18 ConvolutionMish
Объединённое вычисление Convolution и Mish, Output=Mish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.6.19 ConvTranspose
Транспонированная свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Кроме того, для входа первого слоя
- shape:[batch,channel,height,width]
width ограничена; см. описание входов модели.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). При настройке pad не поддерживаются: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: поддерживается только 1; num_output поддерживается тогда и только тогда, когда num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Если dilation не равно (1,1), поддерживается только kernel=(1,1).
Ограничения типов данных
- T1:float16(Tensor)
3.6.20 Div
Выполняет поэлементное бинарное деление (C=A/B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.21 Expand
Расширяет входной тензор по заданным shape и правилам, подобно numpy.array(input) *numpy.ones(shape): размерности выравниваются справа; соответствующие размерности должны совпадать либо одна из них должна быть 1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:int64(Tensor)
Ограничения расширения размерностей
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.6.22 LSTM
Сеть долгой краткосрочной памяти (LSTM, Long Short-Term Memory). Расширения и варианты LSTM называются exLSTM; параметры с пометкой (extern) принадлежат только exLSTM. Формулы приведены ниже:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Входы
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
inputsize∈(0,8192]
- Поддержка квантования
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Поддержка квантования
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[batch_size]; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Выходы
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; значения больше 1 должны быть кратны 4.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Поддержка квантования
- per‑layer
Атрибуты
- direction(extern):string
- Задаёт направление вычисления LSTM.
- forward: прямое направление LSTM.
- reverse: обратное направление LSTM.
- bidirectional: двунаправленное вычисление LSTM.
- sequence_size(extern):int
- Задаёт seqsize входа LSTM; без ограничений, рекомендуется выравнивание по 4.
- hidden_size(extern):int
- hiddensize блока LSTM; без ограничений, рекомендуется выравнивание по 8.
- proj_size(extern):int
- proj_size при projection; projsize∈[0,hiddensize].
- Сейчас допускается только 0; projection пока не поддерживается.
- input_forget(extern):int
- Выбор варианта cifg:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- has_projection(extern):int
- Вариант projection:1(T)or0(F). Сейчас допускается только 0; вариант пока не поддерживается.
- input_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного входа.
- Необходимо указать заданный layout и фактические batch_size, sequence_size и hidden_size данного op.
- snc: входной shape данного layout — [seqs,batches,input_size].
- (sn)c: входной shape данного layout — [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Задаёт layout, соответствующий смыслу shape данного выхода.
- Необходимо указать заданный layout и фактические batch_size, sequence_size, hidden_size и directions данного op.
- sbnc: выходной shape данного layout — [seqs,directions,batches,hidden_size].
- (sn)c: выходной shape данного layout — [seqsbatches,directionsinput_size,1,1].
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.6.23 Max
Вычисляет поэлементный максимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.6.24 Mul
Выполняет поэлементное бинарное умножение (C=A*B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.25 MulRelu
Объединённое вычисление Mul и Relu,C=Relu(A*B).
Входы
- Как у Mul.
Выходы
- Как у Mul.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.6.26 Pad
По тензору данных (data), тензору величин заполнения в начале/конце осей (pads), режиму (mode) и константе (constant_value) создаёт дополненный тензор (output).
Входы
- data:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Атрибуты
- mode:string (по умолчанию constant)
- Поддерживаемые режимы: constant,reflect.
- constant: без ограничений.
- Поддерживаемые режимы: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.6.27 MaxPool
MaxPool получает входной тензор X и выполняет максимальный пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется максимум, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- Примечание: сочетание kernel_h=1 и kernel_w=1 не поддерживается.
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.6.28 GlobalMaxPool
GlobalMaxPool применяет максимальный пулинг к значениям каждого канала входного тензора X. Это эквивалентно MaxPool с kernel_shape, равным пространственным размерам input.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]. Примечание: сочетание kernel_h=1 и kernel_w=1 не поддерживается.
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.6.29 AveragePool
- Не поддерживается (инструмент преобразует в свёртку).
3.6.30 GlobalAveragePool
- Не поддерживается (инструмент преобразует в свёртку).
3.6.31 Pow
Z =XY
Возведение в степень: получает входные данные (тензор) и показатель степени, создавая выходные данные (тензор).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Y:T2
- shape:[1]
- Сейчас поддерживаются только 0,1,2,3,0.5,‑0.5.
- shape:[1]
Выходы
- Z:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.6.32 Relu
Заменяет отрицательные значения входного тензора нулём, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.6.33 Clip/ReLU6
Ограничивает значения входного тензора диапазоном [0,6].
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.6.34 PRelu
Масштабирует отрицательные значения входного тензора обучаемым параметром, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- slope: коэффициент PRelu.
- Поддерживается только один скаляр или коэффициенты по размерности C.
Ограничения типов данных
- T1:float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.6.35 LeakyRelu
Масштабирует отрицательные значения входного тензора фиксированным коэффициентом, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.6.36 Reshape
Возвращает тензор заданной формы, не изменяя входные данные и число элементов.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- shape:int
- Задаёт форму выходного тензора.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.6.37 Resize
Изменяет размер входного тензора. Обычно каждое выходное значение вычисляется как взвешенное среднее соседних значений (точек выборки) входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- roi(optional):T2
- Пока не поддерживается.
- scales(optional):T2
- Массив коэффициентов масштабирования по каждой размерности.
- sizes(optional):T3
- Целевой размер выходного тензора.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Атрибуты
- antialias:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- axes:int[]
- Настройка сейчас не поддерживается.
- coordinate_transformation_mode:strings (по умолчанию ”half_pixel”)
- Сейчас поддерживаются только half_pixel, pytorch_half_pixel и align_corners.
- cubic_coeff_a:float (по умолчанию ‑0.75)
- Настройка сейчас не поддерживается.
- exclude_outside:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- extrapolation_value:float (по умолчанию 0)
- Настройка сейчас не поддерживается.
- keep_aspect_ratio_policy:strings (по умолчанию ”stretch”)
- Настройка сейчас не поддерживается.
- mode:strings (по умолчанию ”nearest”)
- Сейчас можно настроить только nearest и linear.
- nearest_mode:strings (по умолчанию ”round_prefer_floor”)
- Настройка сейчас не поддерживается.
Поддержка: сейчас допускается только целочисленное масштабирование ширины и высоты с целыми коэффициентами 2‑8. Вход (1,c,1,1) можно увеличить до (1,c,h,w).
3.6.38 Slice
Получает срез текущего вектора по правилам срезов NumPy.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:float16(Tensor)
Атрибуты
- starts:int(Tensor)
- Начальная позиция среза: без ограничений.
- ends:int(Tensor)
- Конечная позиция среза: без ограничений.
- axes:int(Tensor)
- Выбор осей среза: любые оси 0~3, включая несколько одновременно.
- steps:int(Tensor)
- Выбирает шаг по соответствующей оси среза.
- При height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc значения steps могут отличаться от 1. Иначе SliceOP может выполняться на NPU только при steps==[1,1,1,1].
3.6.39 Softmax
Оператор вычисляет нормализованные экспоненциальные значения входа:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- width:· axis=1, без ограничений;
· axis=3/‑1,width∈(0,8192]
Также действуют ограничения tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
3.6.40 exSoftmax13
Оператор вычисляет нормализованные экспоненциальные значения входа:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- width:· axis=1, без ограничений;
· axis=3/‑1,width∈(0,8192]
Также действуют ограничения tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
3.6.41 exSoftmaxMask
- Ещё не поддерживается.
3.6.42 Split
Делит вектор вдоль axis на num_outputs векторов; split задаёт размеры результатов вдоль axis.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- Один или несколько выходных векторов согласно num_outputs.
- shape: определяется разбиением.
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:float16(Tensor)
Атрибуты
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.6.43 Sub
- Выполняет поэлементное бинарное вычитание (C=A‑B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.44 Tile
Создаёт тензор повторением заданного тензора, как функция NumPy tile, но без расширения размерностей.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.6.45 Transpose
Транспонирует входной тензор.
Входы
- X:T1
- shape:[n1,c1,h1,w1]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n1,c1,h1,w1]
Выходы
- Y:T1
- shape:[n2,c2,h2,w2]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n2,c2,h2,w2]
Атрибуты
- perm, порядок транспонируемых осей: ограничения для разных perm приведены ниже (p=268435456,q=65536).
- perm=[0,1,2,3]
- Без ограничений
- perm=[0,1,3,2]
- T1:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Ограничения типов данных
- T1:int16(Tensor),float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.6.46 Sigmoid
Поэлементно применяет y=1/(1+exp(‑x)) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
3.6.47 Tanh
Вычисляет гиперболический тангенс элементов входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:float16(Tensor)
3.6.48 Softplus
Поэлементно применяет Softplus, y=ln(exp(x)+1).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:float16(Tensor)
3.6.49 HardSigmoid
Поэлементно применяет y=max(0,min(1,alpha*x+beta)) ко входному тензору, создавая выходной тензор, где
alpha=1/6,beta=0.5
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
3.6.50 HardSwish
Поэлементно применяет HardSwish: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), где alpha=1/6,beta=0.5.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:float16(Tensor)
3.6.51 Elu
Поэлементно применяет f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0, создавая выходной тензор; alpha=1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
3.6.52 exSwish
Поэлементно применяет линейный блок Sigmoid. Swish также называется SiLU: y=x*sigmoid(x).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:float16(Tensor)
3.6.53 exMish
Поэлементно применяет mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
3.6.54 exGelu
Поэлементно применяет y =x∗Φ(x) ко входному тензору, создавая выходной тензор. Когда Φ(x) задана как tanh,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
3.6.55 Where
Выбирает значения x_tensor или y_tensor по mask_tensor: при True берётся соответствующее значение x_tensor, иначе y_tensor.
Входы
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
Выходы
- output:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:bool(Tensor)
- T2:float16(Tensor)
3.6.56 exConvStreaming
Для снижения задержки речевых моделей вход исходной свёртки делится на временные фрагменты. Каждый фрагмент обрабатывается свёрткой, а результаты кэшируются для следующих кадров, обеспечивая потоковую обработку аудио.
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: сейчас поддерживается width=1.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:float16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.6.57 exConvStreamingPRelu/LeakyRelu
Объединённое вычисление exConvStreaming и PRelu/LeakyRelu, Output = PRelu(exConvStreaming(Input)) или
Output=
LeakyRelu(exConvStreaming(Input))
Описание и ограничения совпадают с exConvStreaming.
3.6.58 exGlu
Функция вентильного линейного блока (Gated Linear Unit); a — первая половина входной матрицы, b — вторая.
GLU(a,b)=a⊗σ(b)
Входы
- Input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Output:T1
- shape:[batch,channel/2,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- axis:int(по умолчанию=1)
- Размерность разделения входа.
- Ограничение: поддерживается только 1.
3.6.59 exMatMul
Матричное умножение
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Входы
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Поддержка квантования
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Поддержка квантования
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- Y:T1
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(Tensor)
Атрибуты
- c_type:strings(по умолчанию “add”)
- Выбор add или mul задаёт сложение или умножение с C.
3.6.60 exWindow
exWindow основан на window_partition и window_reverse из swin_transformer. В исходной статье входные признаки делятся на непересекающиеся окна window_size×window_size. Входные и выходные признаки должны иметь 4-мерный shape с разбиением по высоте и ширине. Ниже реализация PyTorch:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Входы
- X:T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:float16(Tensor)
Атрибуты
- mode:string
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- partition: см. реализацию window_partition.
- reverse: см. реализацию window_reverse.
- partition_num_first отличается от partition тем, что H,W делятся согласно num_windows, тогда как partition делит H,W согласно window_sizes.
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-мерный вектор размера окна, задающий высоту и ширину каждого окна. На этом размере основаны вычисление внимания и извлечение признаков внутри окна.
- num_windows:listofints
- 2-мерный вектор числа окон, задающий количество окон по высоте и ширине входных признаков.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.7 RV1103B/RV1106B
3.7.1 Add
Выполняет поэлементное бинарное сложение (C=A+B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(constTensor)
3.7.2 AddRelu
Объединённое вычисление Add и Relu, C=Relu(A+B).
Входы
- Как у Add.
Выходы
- Как у Add.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.7.3 BatchNormalization
Выполняет пакетную нормализацию входного тензора согласно https://arxiv.org/abs/1502.03167.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
Атрибуты
- epsilon:float (по умолчанию=1e‑5)
- Вещественное число, добавляемое при делении на стандартное отклонение для предотвращения деления на 0.
- epsilon∈(0,∞]
- momentum:float
- Параметр скользящего среднего при обучении.
3.7.4 Concat
Объединяет последовательность векторов в один вдоль axis. Размеры всех векторов вне axis должны совпадать.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor)
Атрибуты
- axisint64
- axis∈{0,1,2,3}
3.7.5 Convolution
Свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Ограничения типов данных
- T1:int8(Tensor)
3.7.6 DepthwiseConvolution
Разделимая свёртка по глубине
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Дополнительные ограничения ширины входа первого слоя см. в описании входов модели.
- Поддержка квантования
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Ограничения типов данных
- T1:int8(Tensor)
3.7.7 ConvolutionRelu
Объединённое вычисление Convolution и Relu, Output=Relu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.8 ConvolutionClip
Объединённое вычисление Convolution и Clip, Output=Clip(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.9 ConvolutionPRelu/LeakyRelu
Объединённое вычисление Convolution и PRelu/LeakyRelu, Output = PRelu(Conv(Input)) или Output =
LeakyRelu(Conv(Input))
Описание и ограничения совпадают с Convolution.
3.7.10 ConvolutionAdd
Объединённое вычисление Convolution и Add, Output=Add(Conv(Input0),Input1).
Описание и ограничения совпадают с Convolution.
3.7.11 ConvolutionSigmoid
Объединённое вычисление Convolution и Sigmoid, Output=Sigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.12 ConvolutionTanh
Объединённое вычисление Convolution и Tanh, Output=Tanh(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.13 ConvolutionSoftplus
Объединённое вычисление Convolution и Softplus, Output=Softplus(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.14 ConvolutionHardSigmoid
Объединённое вычисление Convolution и HardSigmoid, Output=HardSigmoid(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.15 ConvolutionHardSwish
Объединённое вычисление Convolution и HardSwish, Output=HardSwish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.16 ConvolutionElu
Объединённое вычисление Convolution и Elu, Output=Elu(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.17 ConvolutionSwish
Объединённое вычисление Convolution и Swish, Output=Swish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.18 ConvolutionMish
Объединённое вычисление Convolution и Mish, Output=Mish(Conv(Input)).
Описание и ограничения совпадают с Convolution.
3.7.19 ConvTranspose
Транспонированная свёртка
Входы
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: при dilated_kernel_h>1 требуется width<16383. Кроме того, для входа первого слоя
- shape:[batch,channel,height,width]
width ограничена; см. описание входов модели.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Поддержка квантования
- per‑layer
- per‑channel
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Атрибуты
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). При настройке pad не поддерживаются: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: поддерживается только 1; num_output поддерживается тогда и только тогда, когда num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Если dilation не равно (1,1), поддерживается только kernel=(1,1).
Ограничения типов данных
- T1:int8(Tensor)
3.7.20 ConvTranposeRelu
Объединённое вычисление ConvTranpose и Relu, Output=Relu(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.7.21 ConvTranposeClip
Объединённое вычисление ConvTranpose и Clip, Output=Clip(ConvTranpose(Input)).
Описание и ограничения совпадают с ConvTranspose.
3.7.22 ConvTranposePRelu/LeakyRelu
Объединённое вычисление ConvTranpose и PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) или Output=
LeakyRelu(ConvTranpose(Input))
Описание и ограничения совпадают с ConvTranspose.
3.7.23 Div
Выполняет поэлементное бинарное деление (C=A/B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:float16(Tensor)
- T2:float(constTensor)
3.7.24 Expand
Расширяет входной тензор по заданным shape и правилам, подобно numpy.array(input) *numpy.ones(shape): размерности выравниваются справа; соответствующие размерности должны совпадать либо одна из них должна быть 1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:int64(Tensor)
Ограничения расширения размерностей
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.7.25 Max
Вычисляет поэлементный максимум входных тензоров.
Входы
- A:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Ограничения типов данных
- T1:int8(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.7.26 Mul
Выполняет поэлементное бинарное умножение (C=A*B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(constTensor)
3.7.27 MulRelu
Объединённое вычисление Mul и Relu,C=Relu(A*B).
Входы
- Как у Mul.
Выходы
- Как у Mul.
Прочие возможности
- Совместная работа нескольких ядер: поддерживается.
3.7.28 Pad
По тензору данных (data), тензору величин заполнения в начале/конце осей (pads), режиму (mode) и константе (constant_value) создаёт дополненный тензор (output).
Входы
- data:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Атрибуты
- mode:string (по умолчанию constant)
- Поддерживаемые режимы: constant,reflect.
- constant: без ограничений.
- Поддерживаемые режимы: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.7.29 MaxPool
MaxPool получает входной тензор X и выполняет максимальный пулинг согласно размеру ядра, шагу и длине pad. Для подмножеств входного тензора, заданных ядром, вычисляется максимум, а данные с пониженной дискретизацией помещаются в выходной тензор Y для дальнейшей обработки. Пространственный размер выхода зависит от явного заполнения (pads) либо автоматического (auto_pad). Здесь используется только явное заполнение.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.7.30 GlobalMaxPool
GlobalMaxPool применяет максимальный пулинг к значениям каждого канала входного тензора X. Это эквивалентно MaxPool с kernel_shape, равным пространственным размерам input.
Входы
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Выходы
- output:T1
- shape:[batch,channel,height,width]
Атрибуты
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Способ pad: поддерживается только NOTSET.
- ceil_mode:int64
- Вычисление выходного shape через ceil или floor: не поддерживается.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, учитывать ли значения pad при вычислении:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.7.31 AveragePool
- Не поддерживается (инструмент преобразует в свёртку).
3.7.32 GlobalAveragePool
- Не поддерживается (инструмент преобразует в свёртку).
3.7.33 Relu
Заменяет отрицательные значения входного тензора нулём, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.7.34 Clip/ReLU6
Ограничивает значения входного тензора диапазоном [0,6].
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.7.35 PRelu
Масштабирует отрицательные значения входного тензора обучаемым параметром, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer/per‑channel
Атрибуты
- slope: коэффициент PRelu.
- Поддерживается только один скаляр или коэффициенты по размерности C.
Ограничения типов данных
- T1:int8(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.7.36 LeakyRelu
Масштабирует отрицательные значения входного тензора фиксированным коэффициентом, оставляя положительные без изменений.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Нет
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.7.37 Reshape
Возвращает тензор заданной формы, не изменяя входные данные и число элементов.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
Атрибуты
- shape:int
- Задаёт форму выходного тензора.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
3.7.38 Resize
Изменяет размер входного тензора. Обычно каждое выходное значение вычисляется как взвешенное среднее соседних значений (точек выборки) входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- roi(optional):T2
- Пока не поддерживается.
- scales(optional):T2
- Массив коэффициентов масштабирования по каждой размерности.
- sizes(optional):T3
- Целевой размер выходного тензора.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Атрибуты
- antialias:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- axes:int[]
- Настройка сейчас не поддерживается.
- coordinate_transformation_mode:strings (по умолчанию ”half_pixel”)
- Сейчас поддерживаются только half_pixel, pytorch_half_pixel и align_corners.
- cubic_coeff_a:float (по умолчанию ‑0.75)
- Настройка сейчас не поддерживается.
- exclude_outside:int (по умолчанию 0)
- Настройка сейчас не поддерживается.
- extrapolation_value:float (по умолчанию 0)
- Настройка сейчас не поддерживается.
- keep_aspect_ratio_policy:strings (по умолчанию ”stretch”)
- Настройка сейчас не поддерживается.
- mode:strings (по умолчанию ”nearest”)
- Сейчас можно настроить только nearest и linear.
- nearest_mode:strings (по умолчанию ”round_prefer_floor”)
- Настройка сейчас не поддерживается.
Поддержка: сейчас допускается только целочисленное масштабирование ширины и высоты с целыми коэффициентами 2‑8. Вход (1,c,1,1) можно увеличить до (1,c,h,w).
3.7.39 Slice
Получает срез текущего вектора по правилам срезов NumPy.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor)
Атрибуты
- starts:int(Tensor)
- Начальная позиция среза: без ограничений.
- ends:int(Tensor)
- Конечная позиция среза: без ограничений.
- axes:int(Tensor)
- Выбор осей среза: любые оси 0~3, включая несколько одновременно.
- steps:int(Tensor)
- Выбирает шаг по соответствующей оси среза.
- При height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc значения steps могут отличаться от 1. Иначе SliceOP может выполняться на NPU только при steps==[1,1,1,1].
3.7.40 Softmax
Оператор вычисляет нормализованные экспоненциальные значения входа:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
3.7.41 exSoftmax13
Оператор вычисляет нормализованные экспоненциальные значения входа:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Атрибут “axis” задаёт размерность вычисления Softmax. Выходной тензор имеет ту же форму и содержит значения Softmax соответствующего входа.
Входы
- input:T1
- shape:[batch,channel,height,width], с ограничениями tranpose.
Выходы
- output:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor)
Атрибуты
- axis:int64
- Ось softmax:1,3, то есть channel и width.
3.7.42 exSoftmaxMask
- Ещё не поддерживается.
3.7.43 Split
Делит вектор вдоль axis на num_outputs векторов; split задаёт размеры результатов вдоль axis.
Входы
- input_tensor:T
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T
- Один или несколько выходных векторов согласно num_outputs.
- shape: определяется разбиением.
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T:int8(Tensor)
Атрибуты
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.7.44 Sub
- Выполняет поэлементное бинарное вычитание (C=A‑B) с многомерным расширением по правилам NumPy.
Входы
- A:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- [b,c,1,1]
- [scalar]
Выходы
- C:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(constTensor)
3.7.45 Tile
Создаёт тензор повторением заданного тензора, как функция NumPy tile, но без расширения размерностей.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.7.46 Transpose
Транспонирует входной тензор.
Входы
- X:T1
- shape:[n1,c1,h1,w1]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n1,c1,h1,w1]
Выходы
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Подробные ограничения приведены в списке атрибутов.
- Поддержка квантования
- per‑layer
- shape:[n2,c2,h2,w2]
Атрибуты
- perm, порядок транспонируемых осей: ограничения для разных perm приведены ниже (p=268435456,q=65536).
- perm=[0,1,2,3]
- Без ограничений
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Ограничения типов данных
- T1:int8(Tensor)
- T2:int16(Tensor)
Прочие возможности
- Совместная работа нескольких ядер: пока не поддерживается.
3.7.47 Sigmoid
Поэлементно применяет y=1/(1+exp(‑x)) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
3.7.48 Tanh
Вычисляет гиперболический тангенс элементов входного тензора.
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor)
3.7.49 Softplus
Поэлементно применяет Softplus, y=ln(exp(x)+1).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor)
3.7.50 HardSigmoid
Поэлементно применяет y=max(0,min(1,alpha*x+beta)) ко входному тензору, создавая выходной тензор, где
alpha=1/6,beta=
- (0) 5
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
3.7.51 HardSwish
Поэлементно применяет HardSwish, y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), где alpha=1/6,
beta=0.5
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor)
3.7.52 Elu
Поэлементно применяет f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0, создавая выходной тензор; alpha=1.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
3.7.53 exSwish
Поэлементно применяет линейный блок Sigmoid. Swish также называется SiLU: y=x*sigmoid(x).
Входы
- X:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Y:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor)
3.7.54 exMish
Поэлементно применяет mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) ко входному тензору, создавая выходной тензор.
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
3.7.55 exGelu
Поэлементно применяет y =x∗Φ(x) ко входному тензору, создавая выходной тензор. Когда Φ(x) задана как tanh,
$y=
- (0) 5*x*(1+Tanh(\sqrt{\frac{2}{\pi}}*(x+0.044715*x^3)))$
Входы
- input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Выходы
- output:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
3.7.56 Where
Выбирает значения x_tensor или y_tensor по mask_tensor: при True берётся соответствующее значение x_tensor, иначе y_tensor.
Входы
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения размерностей
- Ограничения расширения совпадают с оператором Expand.
Выходы
- output:T2
- shape:[batch,channel,height,width]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:bool(Tensor)
- T2:int8(Tensor)
3.7.57 exGlu
Функция вентильного линейного блока (Gated Linear Unit); a — первая половина входной матрицы, b — вторая.
GLU(a,b)=a⊗σ(b)
Входы
- Input:T1
- shape:[batch,channel,height,width]
- Поддержка квантования:per‑layer.
Выходы
- Output:T1
- shape:[batch,channel/2,height,width]
- Поддержка квантования:per‑layer.
Ограничения типов данных
- T1:int8(Tensor)
Атрибуты
- axis:int(по умолчанию=1)
- Размерность разделения входа.
- Ограничение: поддерживается только 1.
3.7.58 exMatMul
Матричное умножение
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Входы
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Поддержка квантования
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Поддержка квантования
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
- Поддержка расширения размерностей
- Поддерживается расширение по любой размерности.
- Ограничения расширения совпадают с оператором Expand.
Выходы
- Y:T1
- shape:[b,n,1,m]
- Поддержка квантования
- per‑layer
Ограничения типов данных
- T1:int8(Tensor)
- T2:float(Tensor)
Атрибуты
- c_type:strings(по умолчанию “add”)
- Выбор add или mul задаёт сложение или умножение с C.
3.7.59 exWindow
exWindow основан на window_partition и window_reverse из swin_transformer. В исходной статье входные признаки делятся на непересекающиеся окна window_size×window_size. Входные и выходные признаки должны иметь 4-мерный shape с разбиением по высоте и ширине. Ниже реализация PyTorch:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Входы
- X:T1
- shape:[batch,channel,height,width]
Выходы
- Y:T1
- shape:[batch,channel,height,width]
Ограничения типов данных
- T1:int8(Tensor)
Атрибуты
- mode:string
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- partition: см. реализацию window_partition.
- reverse: см. реализацию window_reverse.
- partition_num_first отличается от partition тем, что H,W делятся согласно num_windows, тогда как partition делит H,W согласно window_sizes.
- Поддерживаемые режимы:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-мерный вектор размера окна, задающий высоту и ширину каждого окна. На этом размере основаны вычисление внимания и извлечение признаков внутри окна.
- num_windows:listofints
- 2-мерный вектор числа окон, задающий количество окон по высоте и ширине входных признаков.
Прочие возможности
- Совместная работа нескольких ядер: ещё не поддерживается.
- Спецификации операторов 3566/3568
- Спецификации операторов 3588
- Спецификации операторов 3562
- Спецификации операторов 1103/1106
- Спецификации операторов 3576/RV1126B
- Спецификации операторов 2118
- Спецификации операторов 1103B/1106B
Спецификации операторов CPU
4.1 Примечание:
- RK2118 не поддерживает ни один оператор CPU.
- RV1106/RV1103/RV1106B/RV1103B поддерживают только часть перечисленных ниже операторов CPU.
- Concat, DataConvert, Div, exLayerNorm, Exp, Gather, ReduceL2, ReduceMax, Reshape,ScatterND,Softmax
4.2 Add
- Описание: сложение.
- Ограничения: отсутствуют.
4.3 AveragePool
- Описание: усредняющий пулинг.
- Ограничения: отсутствуют.
4.4 ArgMin
- Описание: индекс минимального значения.
- Ограничения: отсутствуют.
4.5 ArgMax
- Описание: индекс максимального значения.
- Ограничения: отсутствуют.
4.6 BatchNormalization
- Описание: пакетная нормализация.
- Ограничения: отсутствуют.
4.7 Cast
- Описание: преобразование типа данных.
- Ограничения спецификации
SRC поддерживает:float32/bool/int8/float16/int32/int64; DST поддерживает:float32/int8/int32/float16.
4.8 Clip
- Описание: слой активации с ограничением данных.
- Ограничения: отсутствуют.
4.9 Concat
- Описание: объединение.
- Ограничения: axis поддерживает только {0,1,2,3}.
4.10 Convolution
- Описание: свёртка.
- Ограничения: отсутствуют.
4.11 ConvTranspose/Deconvolution
- Описание: транспонированная свёртка.
- Ограничения: отсутствуют.
4.12 ConvTransposePad
- Описание: составной OP.
- Ограничения: отсутствуют.
4.13 Cos
- Описание: функция косинуса.
- Ограничения: отсутствуют.
4.14 DataConvert
- Описание: преобразование типа данных.
- Ограничения: поддерживается только преобразование типов bool/int8/float.
4.15 DepthToSpace
- Описание: преобразование канального и пространственных измерений.
- Ограничения: отсутствуют.
4.16 Div
- Описание: деление.
- Ограничения: отсутствуют.
4.17 Equal
- Описание: равно.
- Ограничения: отсутствуют.
4.18 Exp
- Описание: экспоненциальная функция.
- Ограничения: отсутствуют.
4.19 Flatten
- Описание: развёртывание в плоский вид.
- Ограничения: отсутствуют.
4.20 Gather
- Описание: выборка элементов.
- Ограничения: отсутствуют.
4.21 Greater
- Описание: больше.
- Ограничения: отсутствуют.
4.22 GreaterOrEqual
- Описание: больше или равно.
- Ограничения: отсутствуют.
4.23 GRU
- Описание: вентильный рекуррентный блок.
- Ограничения: отсутствуют.
4.24 exGRU
- Описание: вентильный рекуррентный блок.
- Ограничения: отсутствуют.
- Примечание: расширенный оператор ONNX.
4.25 exHardSwish
- Описание: функция активации.
- Ограничения: отсутствуют.
- Примечание: расширенный оператор ONNX.
4.26 InstanceNormalization
- Описание: нормализация экземпляра.
- Ограничения: отсутствуют.
4.27 exLayerNorm
- Описание: нормализация слоя.
- Ограничения: отсутствуют.
- Примечание: расширенный оператор ONNX.
4.28 Less
- Описание: меньше.
- Ограничения: отсутствуют.
4.29 LessOrEqual
- Описание: меньше или равно.
- Ограничения: отсутствуют.
4.30 LogSoftmax
- Описание: функция активации.
- Ограничения: batchsize поддерживает только 1.
4.31 LpNormalization
- Описание: нормализация Lp.
- Ограничения: отсутствуют.
4.32 exLRN
- Описание: нормализация локального отклика.
- Ограничения: отсутствуют.
- Примечание: расширенный оператор ONNX.
4.33 MatMul
- Описание: умножение многомерных матриц.
- Ограничения: отсутствуют (поддерживаются вычисления четырёхмерный x четырёхмерный и четырёхмерный x трёхмерный).
4.34 Max
- Описание: максимальное значение.
- Ограничения: отсутствуют.
4.35 MaxPool
- Описание: максимальный пулинг.
- Ограничения: отсутствуют.
4.36 MaxRoiPool
- Описание: максимальный пулинг области.
- Ограничения: отсутствуют.
4.37 MaxUnpool
- Описание: обратный максимальный пулинг.
- Ограничения: отсутствуют.
4.38 exMish
- Описание: функция активации.
- Ограничения: отсутствуют.
- Примечание: расширенный оператор ONNX.
4.39 Min
- Описание: минимальное значение.
- Ограничения: отсутствуют.
4.40 Mul
- Описание: умножение.
- Ограничения: отсутствуют.
4.41 Pad
- Описание: дополнение.
- Ограничения: отсутствуют.
4.42 Pow
- Описание: возведение в степень.
- Ограничения: отсутствуют.
4.43 exProposal
- Описание: сеть предложений областей.
- Ограничения: batchsize поддерживает только 1.
- Примечание: расширенный оператор ONNX.
4.44 ReduceMax
- Описание: вычисляет Max по заданным размерностям.
- Ограничения: выход не может иметь более 4 измерений.
4.45 ReduceMean
- Описание: вычисляет Mean по заданным размерностям.
- Ограничения: выход не может иметь более 4 измерений.
4.46 ReduceSum
- Описание: вычисляет Sum по заданным размерностям.
- Ограничения: выход не может иметь более 4 измерений.
4.47 ReduceMin
- Описание: вычисляет Min по заданным размерностям.
- Ограничения: выход не может иметь более 4 измерений.
4.48 Reorg
- Описание: перестановка данных.
- Ограничения: отсутствуют.
4.49 Reshape
- Описание: изменение формы данных.
- Ограничения: отсутствуют.
4.50 Resize
- Описание: масштабирует данные по ширине и высоте.
- Ограничения: поддерживаемые методы интерполяции bilinear;nearest2d.
4.51 ReverseSequence
- Описание: обращение последовательности.
- Ограничения: отсутствуют.
4.52 exRMSNorm
- Описание: нормализация по среднеквадратичному значению.
- Ограничения: отсутствуют.
- Примечание: расширенный оператор ONNX.
4.53 RoiAlign
- Описание: пулинг с выравниванием областей.
- Ограничения: поддерживается только AvgPoolMode; batchsize — только 1.
4.54 ScatterND
- Описание: доступ к данным по N-мерным индексам.
- Ограничения: отсутствуют.
4.55 Sin
- Описание: функция синуса.
- Ограничения: отсутствуют.
4.56 Slice
- Описание: срез.
- Ограничения: batchsize поддерживает только 1.
4.57 Softmax
- Описание: функция активации.
- Ограничения: batchsize поддерживает только 1.
- Примечание: соответствует ONNX OPSET11.
4.58 exSoftmax13
- Описание: функция активации.
- Ограничения: batchsize поддерживает только 1.
- Примечание: расширенный оператор ONNX, соответствующий ONNX OPSET13.
4.59 SpaceToDetph
- Описание: преобразует пространственные измерения в канальное.
- Ограничения: отсутствуют.
4.60 Split
- Описание: разделение данных.
- Ограничения: отсутствуют.
4.61 Sqrt
- Описание: квадратный корень.
- Ограничения: отсутствуют.
4.62 Squeeze
- Описание: удаление единичных размерностей данных.
- Ограничения: отсутствуют.
4.63 Sub
- Описание: вычитание.
- Ограничения: отсутствуют.
4.64 Tanh
- Описание: гиперболический тангенс.
- Ограничения: отсутствуют.
4.65 Tile
- Описание: расширение данных копированием.
- Ограничения: batchsize — только 1; broadcasting не поддерживается.
4.66 Transpose
- Описание: транспонирование.
- Ограничения: отсутствуют.
4.67 Upsample
- Описание: повышение частоты дискретизации.
- Ограничения: поддерживаемые методы интерполяции bilinear;nearest2d.
4.68 Not
- Описание: поэлементное логическое НЕ.
- Ограничения: отсутствуют.
4.69 where
- Описание: выбор данных по mask.
- Ограничения: отсутствуют.
4.70 Erf
- Описание: функция ошибок.
- Ограничения: отсутствуют.
4.71 Floor
- Описание: округление вниз.
- Ограничения: отсутствуют.
4.72 Mod
- Описание: функция остатка от деления.
- Ограничения: отсутствуют.
4.73 exMeanVarianceNormalization
- Описание: нормализация среднего и дисперсии.
- Ограничения: отсутствуют.
4.74 And
- Описание: функция И.
- Ограничения: отсутствуют.
4.75 GatherElements
- Описание: выборка элементов.
- Ограничения: отсутствуют.
4.76 Log
- Описание: функция Log.
- Ограничения: отсутствуют.
4.77 exDataConvert
- Описание: преобразование точности.
- Ограничения: отсутствуют.
4.78 SpaceToDepth
- Описание: преобразование размерностей.
- Ограничения: отсутствуют.
4.79 SoftmaxMask
- Описание: функция активации с объединением where и softmax.
- Ограничения: отсутствуют.
4.80 TransposeReshape
- Описание: составной OP.
- Ограничения: отсутствуют.
4.81 ReshapeTranspose
- Описание: составной OP.
- Ограничения: отсутствуют.
4.82 ReduceL2
- Описание: норма L2 вдоль оси.
- Ограничения: отсутствуют.
4.83 LayerNormalization
- Описание: стандартизация слоя.
- Ограничения: отсутствуют.
4.84 PassThrough
- Описание: прямое соединение.
- Ограничения: отсутствуют.
4.85 Expand
- Описание: копирование или расширение данных тензора.
- Ограничения: отсутствуют.
4.86 Sigmoid
- Описание: функция активации.
- Ограничения: отсутствуют.
4.87 Tanh
- Описание: тригонометрическая функция.
- Ограничения: отсутствуют.
4.88 Cos
- Описание: тригонометрическая функция.
- Ограничения: отсутствуют.
4.89 Sin
- Описание: тригонометрическая функция.
- Ограничения: отсутствуют.
4.90 exSwish
- Описание: функция активации.
- Ограничения: отсутствуют.
4.91 exGlu
- Описание: функция активации.
- Ограничения: отсутствуют.
4.92 exGelu
- Описание: функция активации.
- Ограничения: отсутствуют.
4.93 exWindow
- Описание: exWindow основан на window_partition и window_reverse из Swin‑Transformer.
- Ограничения: отсутствуют.
4.94 exNorm
- Описание: при mode=‘pixel‘ exNorm использует PixelNorm. Если mode не задан, exNorm
по умолчанию использует LayerNorm.
- Ограничения: отсутствуют.
4.95 Round
- Описание: насыщение данных.
- Ограничения: отсутствуют.
4.96 TopK
- Описание: получение K наибольших значений.
- Ограничения: отсутствуют.
4.97 exSwooshR
- Описание: функция активации.
- Ограничения: отсутствуют.
4.98 exSwooshL
- Описание: функция активации.
- Ограничения: отсутствуют.
4.99 OneHot
- Описание: унитарное кодирование.
- Ограничения: отсутствуют.
Ограничения входов и выходов модели
5.1 Ограничения входов модели
- (1) Эти ограничения выравнивания относятся только к API нулевого копирования, а не к обычным API.
- (2) Выравнивание входной ширины можно узнать через атрибут w_stride API нулевого копирования. Примечание: w_stride нельзя изменять.
- (3) Выравнивание требуется только для входной ширины (width) в зависимости от числа каналов (channel); прочих ограничений нет.
- (4) Если mean и scale не нужны, задайте mean=0 и scale=1.
- (5) Если channel>4, mean/scale используют для всех каналов только первые значения: mean[0] и scale[0].
- (6) Если первый слой имеет тип с плавающей точкой, операция quant отсутствует.
- (7) RV1106/RV1103/RV1103B не поддерживают операции mean/scale/quant на CPU.
- (8) Подробное использование см. в Rockchip_RKNPU_User_Guide_RKNN_SDK.
5.1.1 RK3566/RK3568
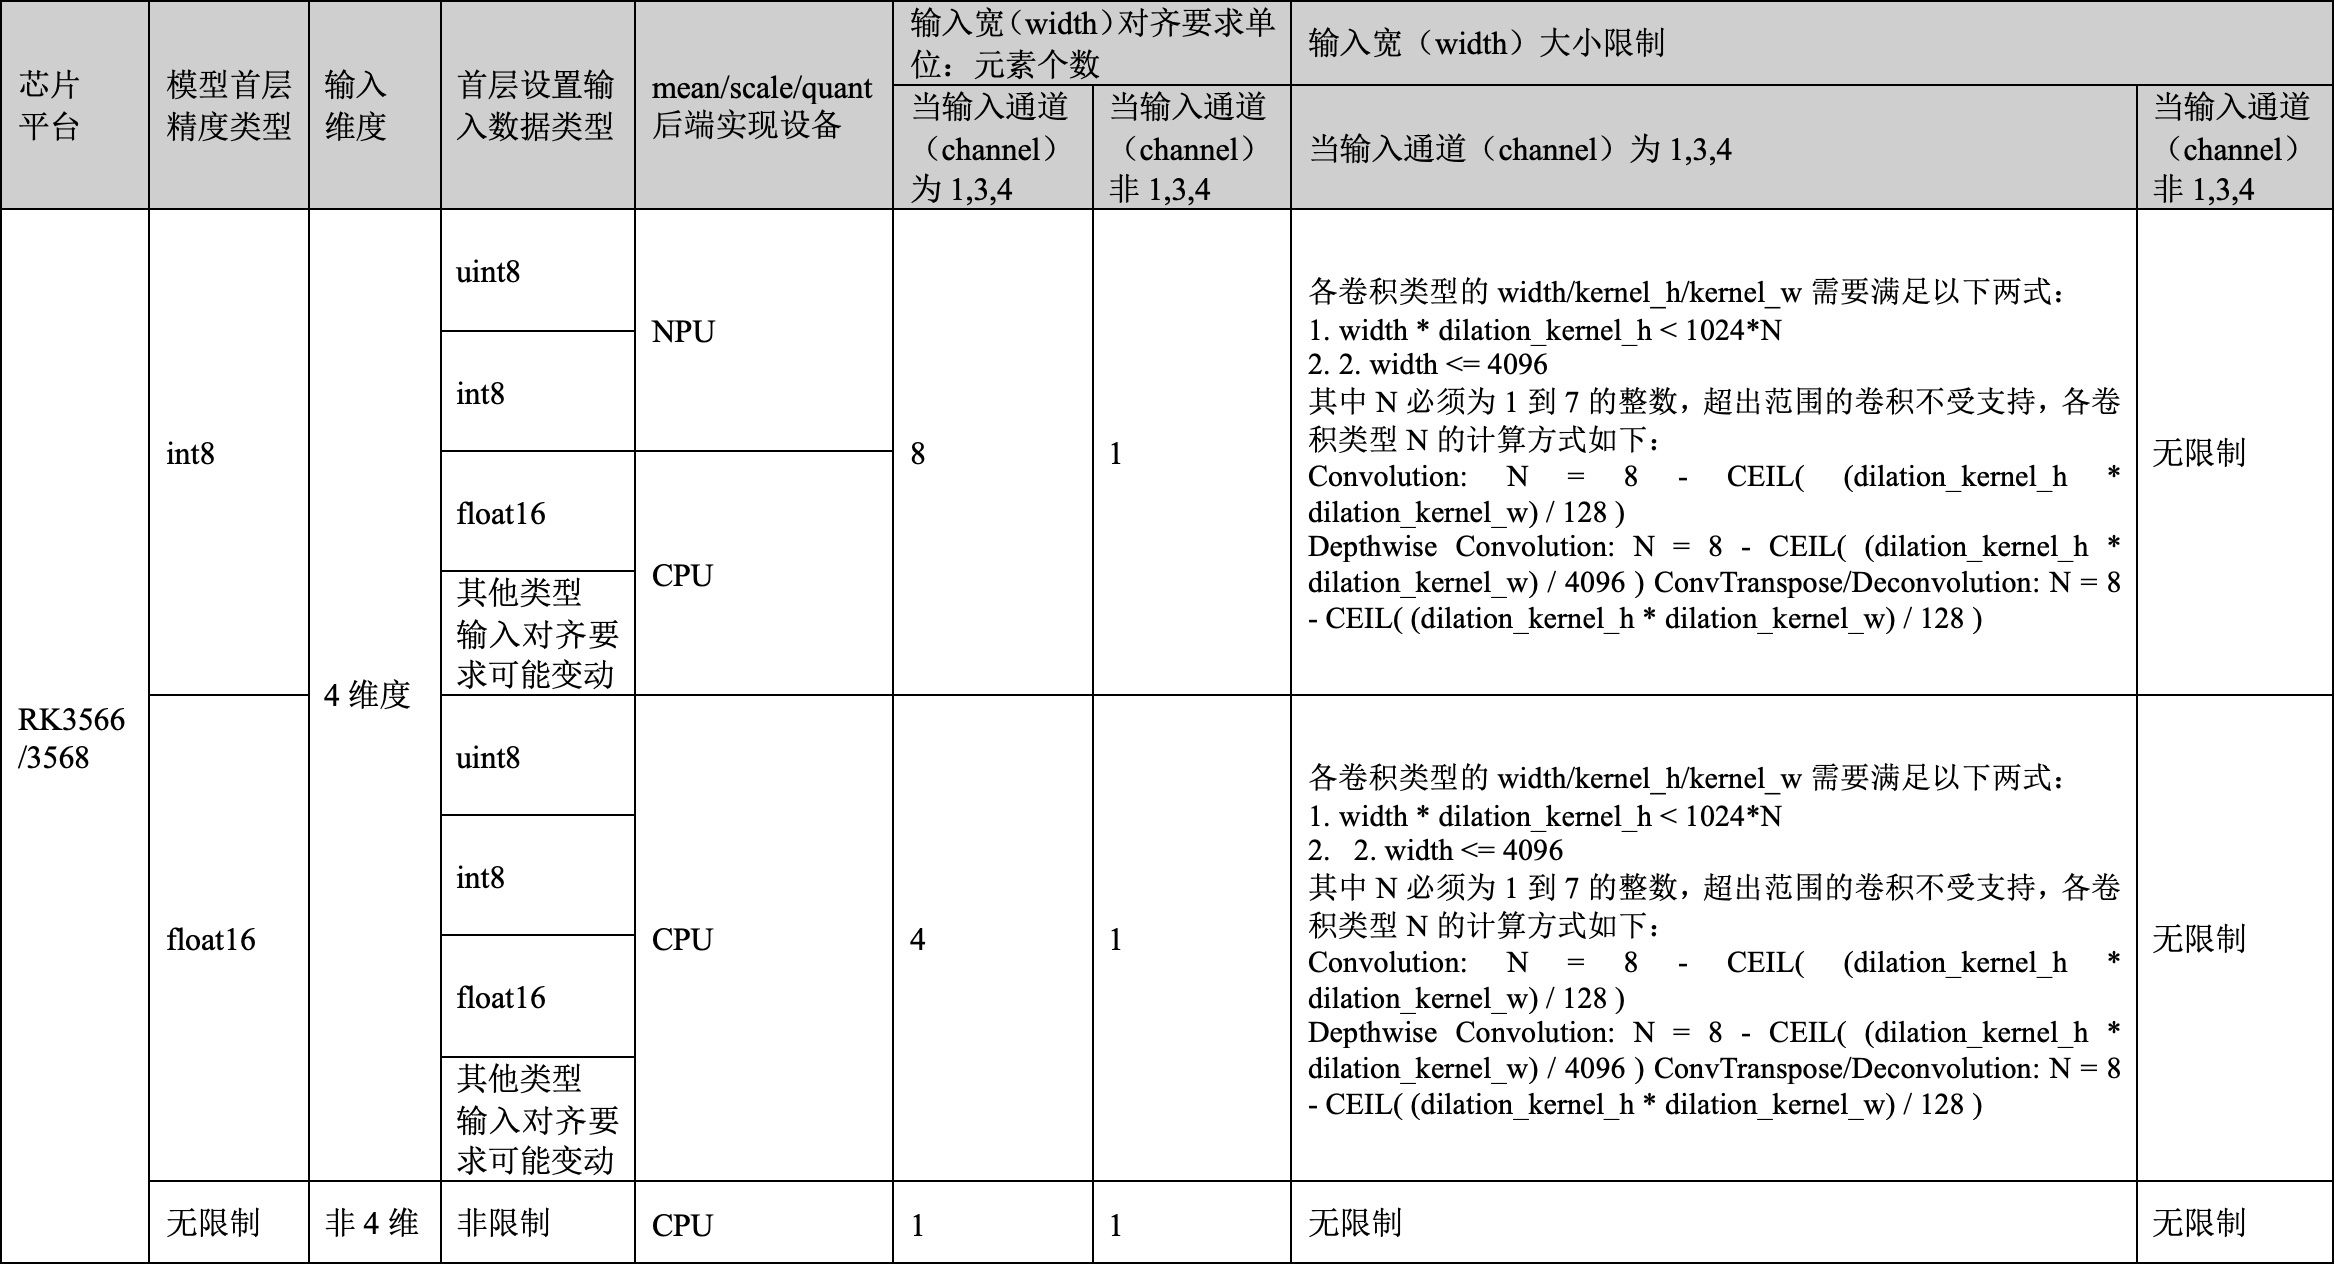
Редактируемая транскрипция оригинала (объединённые ячейки развёрнуты):
| Платформа | Точность первого слоя | Размерность входа | Заданный тип входа первого слоя | Исполнитель mean/scale/quant | Выравнивание width (элементы), channel=1,3,4 | Выравнивание width (элементы), channel≠1,3,4 | Ограничения width, channel=1,3,4 | Ограничения width, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3566/RK3568 | int8 | 4 | uint8 | NPU | 8 | 1 | A | Без ограничений |
| RK3566/RK3568 | int8 | 4 | int8 | NPU | 8 | 1 | A | Без ограничений |
| RK3566/RK3568 | int8 | 4 | float16 | CPU | 8 | 1 | A | Без ограничений |
| RK3566/RK3568 | int8 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 8 | 1 | A | Без ограничений |
| RK3566/RK3568 | float16 | 4 | uint8 | CPU | 4 | 1 | B | Без ограничений |
| RK3566/RK3568 | float16 | 4 | int8 | CPU | 4 | 1 | B | Без ограничений |
| RK3566/RK3568 | float16 | 4 | float16 | CPU | 4 | 1 | B | Без ограничений |
| RK3566/RK3568 | float16 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 4 | 1 | B | Без ограничений |
| RK3566/RK3568 | Без ограничений | Не 4-мерный | Без ограничений | CPU | 1 | 1 | Без ограничений | Без ограничений |
Для каждого типа свёртки width/kernel_h/kernel_w должны удовлетворять обоим условиям ниже. N — целое число от 1 до 7; свёртки вне диапазона не поддерживаются. Формулы N приведены ниже. Написание dilation_kernel_h/w на рисунке отличается от dilated_kernel_h/w в последней главе; сохранён вариант рисунка.
| Условие | Формула |
|---|---|
| A (1) | width * dilation_kernel_h < 1024 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| Условие | Формула |
|---|---|
| B (1) | width * dilation_kernel_h < 1024 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| B / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| B / ConvTranspose/Deconvolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
5.1.2 RK3588
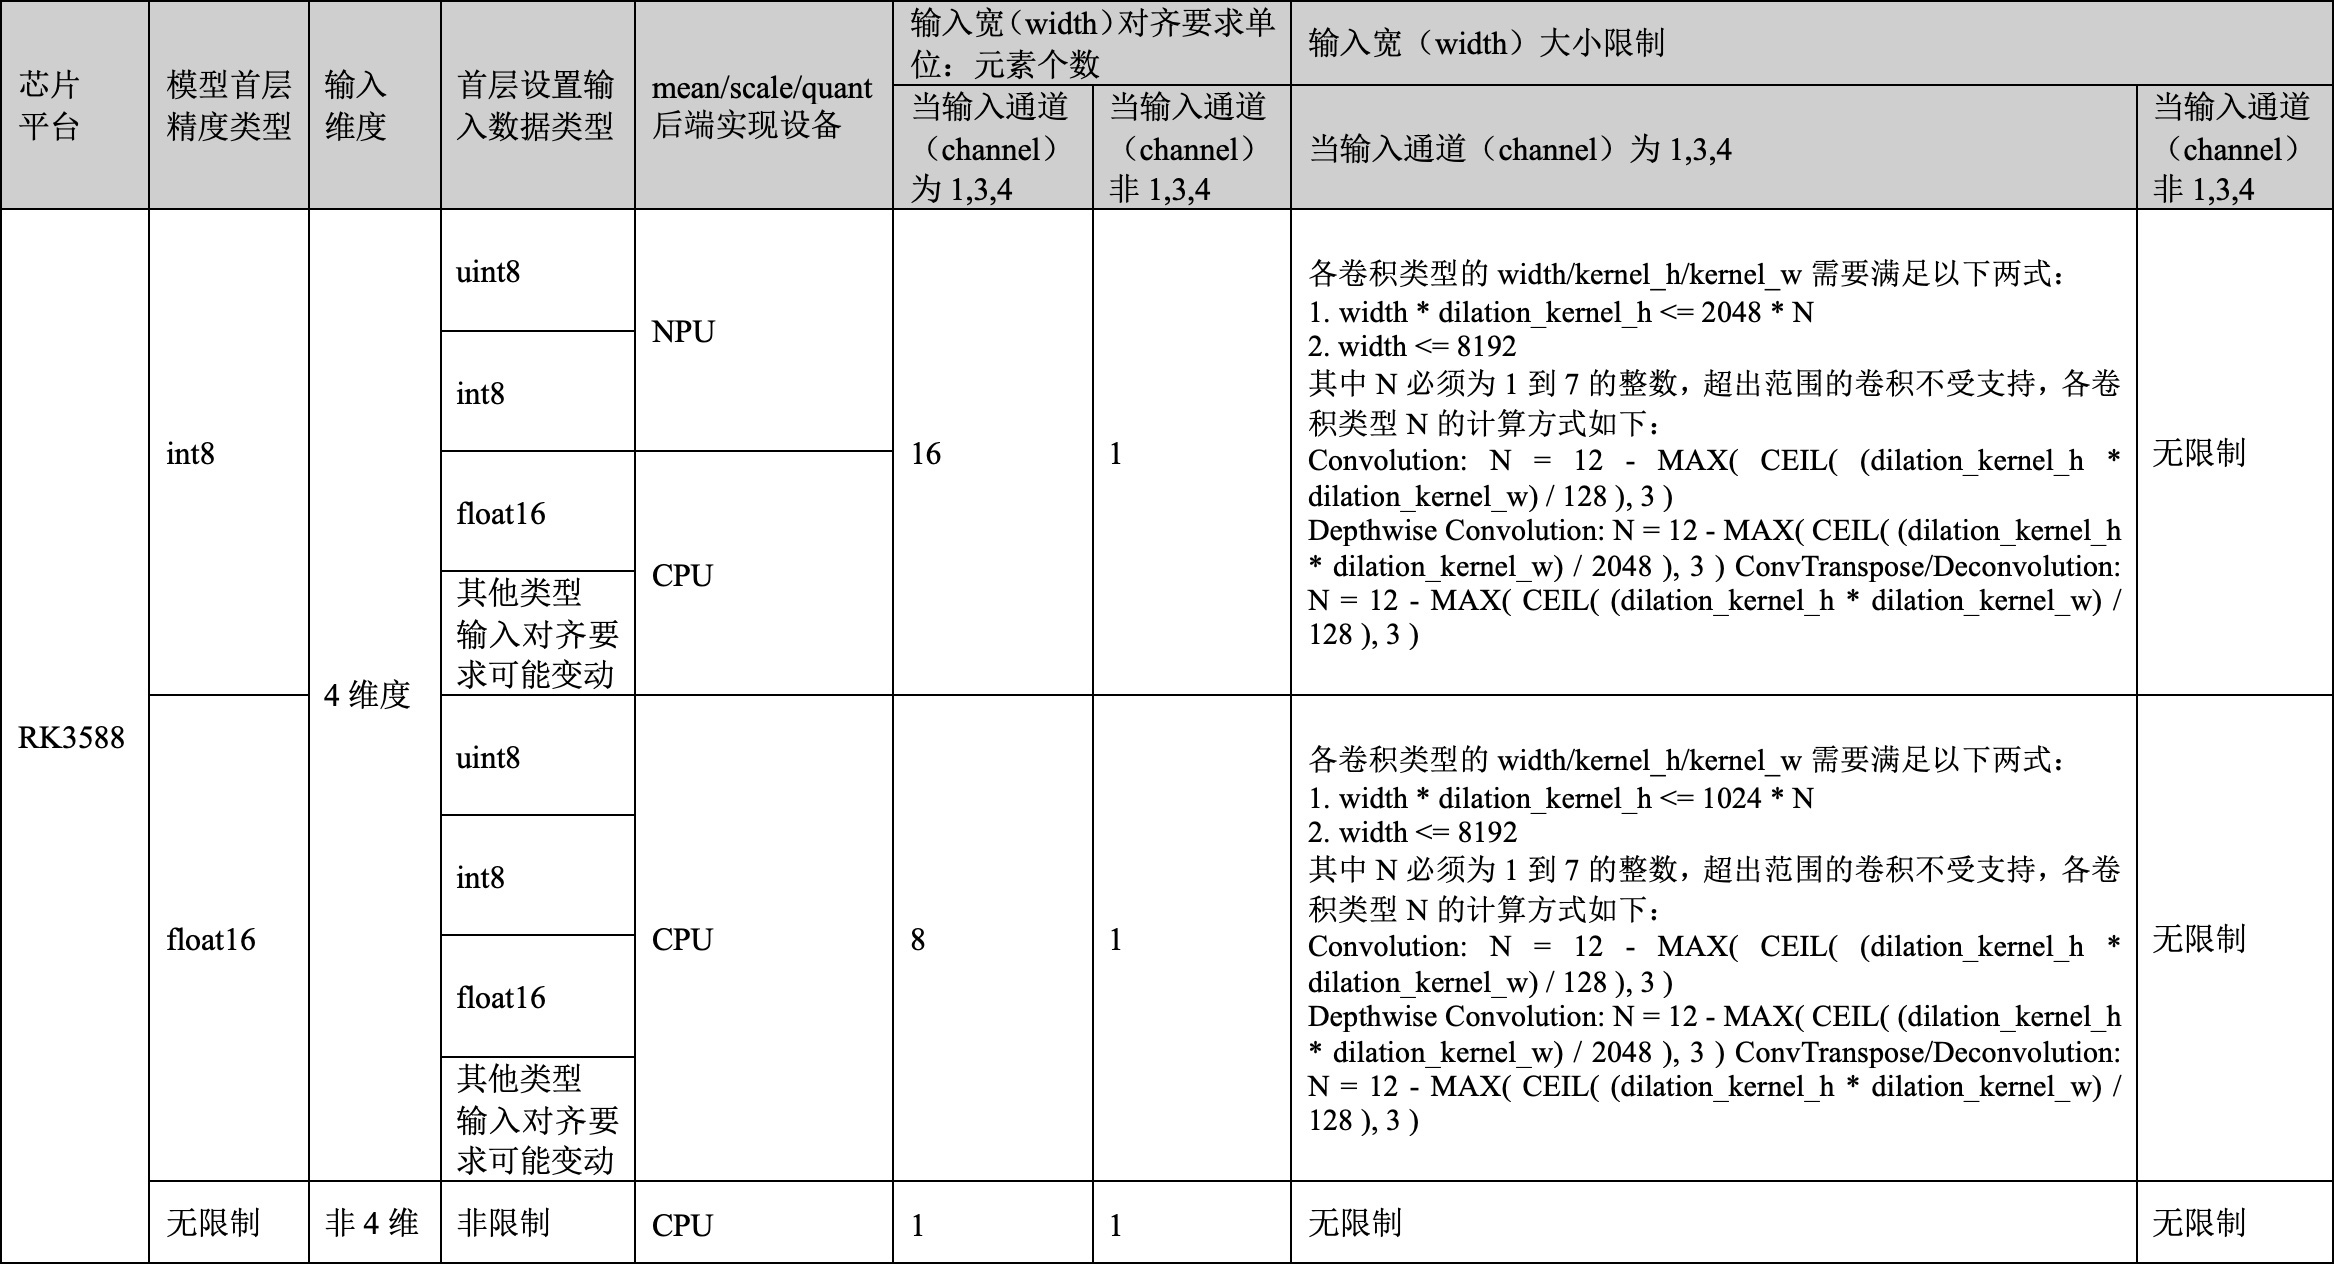
Редактируемая транскрипция оригинала (объединённые ячейки развёрнуты):
| Платформа | Точность первого слоя | Размерность входа | Заданный тип входа первого слоя | Исполнитель mean/scale/quant | Выравнивание width (элементы), channel=1,3,4 | Выравнивание width (элементы), channel≠1,3,4 | Ограничения width, channel=1,3,4 | Ограничения width, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3588 | int8 | 4 | uint8 | NPU | 16 | 1 | A | Без ограничений |
| RK3588 | int8 | 4 | int8 | NPU | 16 | 1 | A | Без ограничений |
| RK3588 | int8 | 4 | float16 | CPU | 16 | 1 | A | Без ограничений |
| RK3588 | int8 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 16 | 1 | A | Без ограничений |
| RK3588 | float16 | 4 | uint8 | CPU | 8 | 1 | B | Без ограничений |
| RK3588 | float16 | 4 | int8 | CPU | 8 | 1 | B | Без ограничений |
| RK3588 | float16 | 4 | float16 | CPU | 8 | 1 | B | Без ограничений |
| RK3588 | float16 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 8 | 1 | B | Без ограничений |
| RK3588 | Без ограничений | Не 4-мерный | Без ограничений | CPU | 1 | 1 | Без ограничений | Без ограничений |
Для каждого типа свёртки width/kernel_h/kernel_w должны удовлетворять обоим условиям ниже. N — целое число от 1 до 7; свёртки вне диапазона не поддерживаются. Формулы N приведены ниже. Написание dilation_kernel_h/w на рисунке отличается от dilated_kernel_h/w в последней главе; сохранён вариант рисунка.
| Условие | Формула |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 8192 |
| A / Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| A / Depthwise Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| A / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| Условие | Формула |
|---|---|
| B (1) | width * dilation_kernel_h <= 1024 * N |
| B (2) | width <= 8192 |
| B / Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| B / Depthwise Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| B / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
5.1.3 RV1103/RV1106
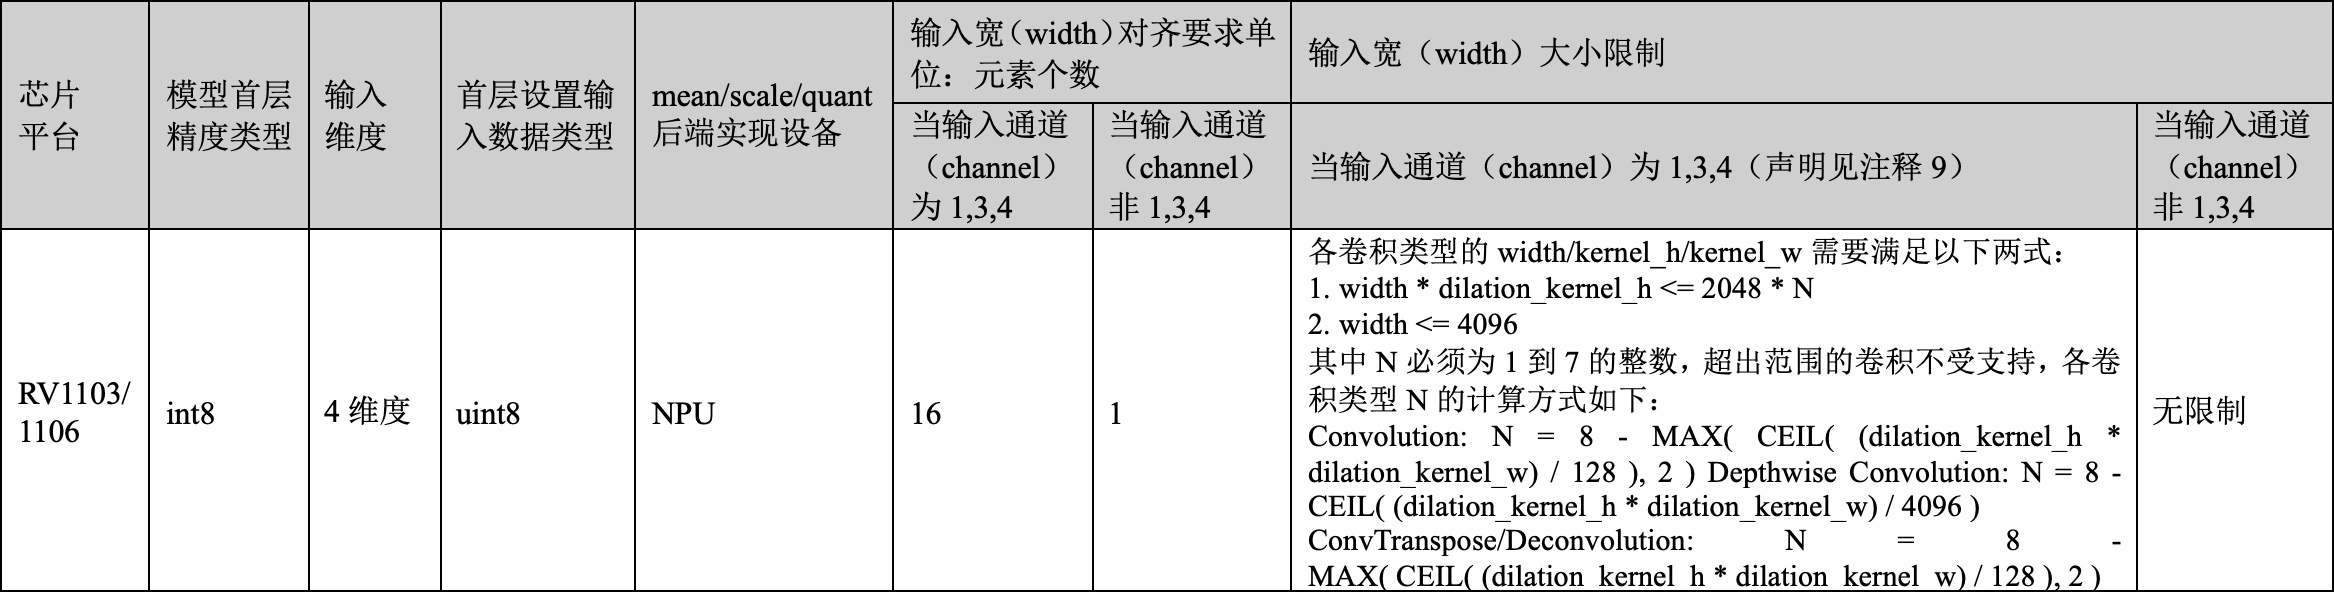
Редактируемая транскрипция оригинала (объединённые ячейки развёрнуты):
| Платформа | Точность первого слоя | Размерность входа | Заданный тип входа первого слоя | Исполнитель mean/scale/quant | Выравнивание width (элементы), channel=1,3,4 | Выравнивание width (элементы), channel≠1,3,4 | Ограничения width, channel=1,3,4 | Ограничения width, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RV1103/RV1106 | int8 | 4 | uint8 | NPU | 16 | 1 | A | Без ограничений |
Для каждого типа свёртки width/kernel_h/kernel_w должны удовлетворять обоим условиям ниже. N — целое число от 1 до 7; свёртки вне диапазона не поддерживаются. Формулы N приведены ниже. Написание dilation_kernel_h/w на рисунке отличается от dilated_kernel_h/w в последней главе; сохранён вариант рисунка.
| Условие | Формула |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
Заголовок рисунка ссылается на примечание 9, но предоставленное описание входов содержит только 1–8. Примечание 9 не найдено и не дополняется догадками.
5.1.4 RK3562
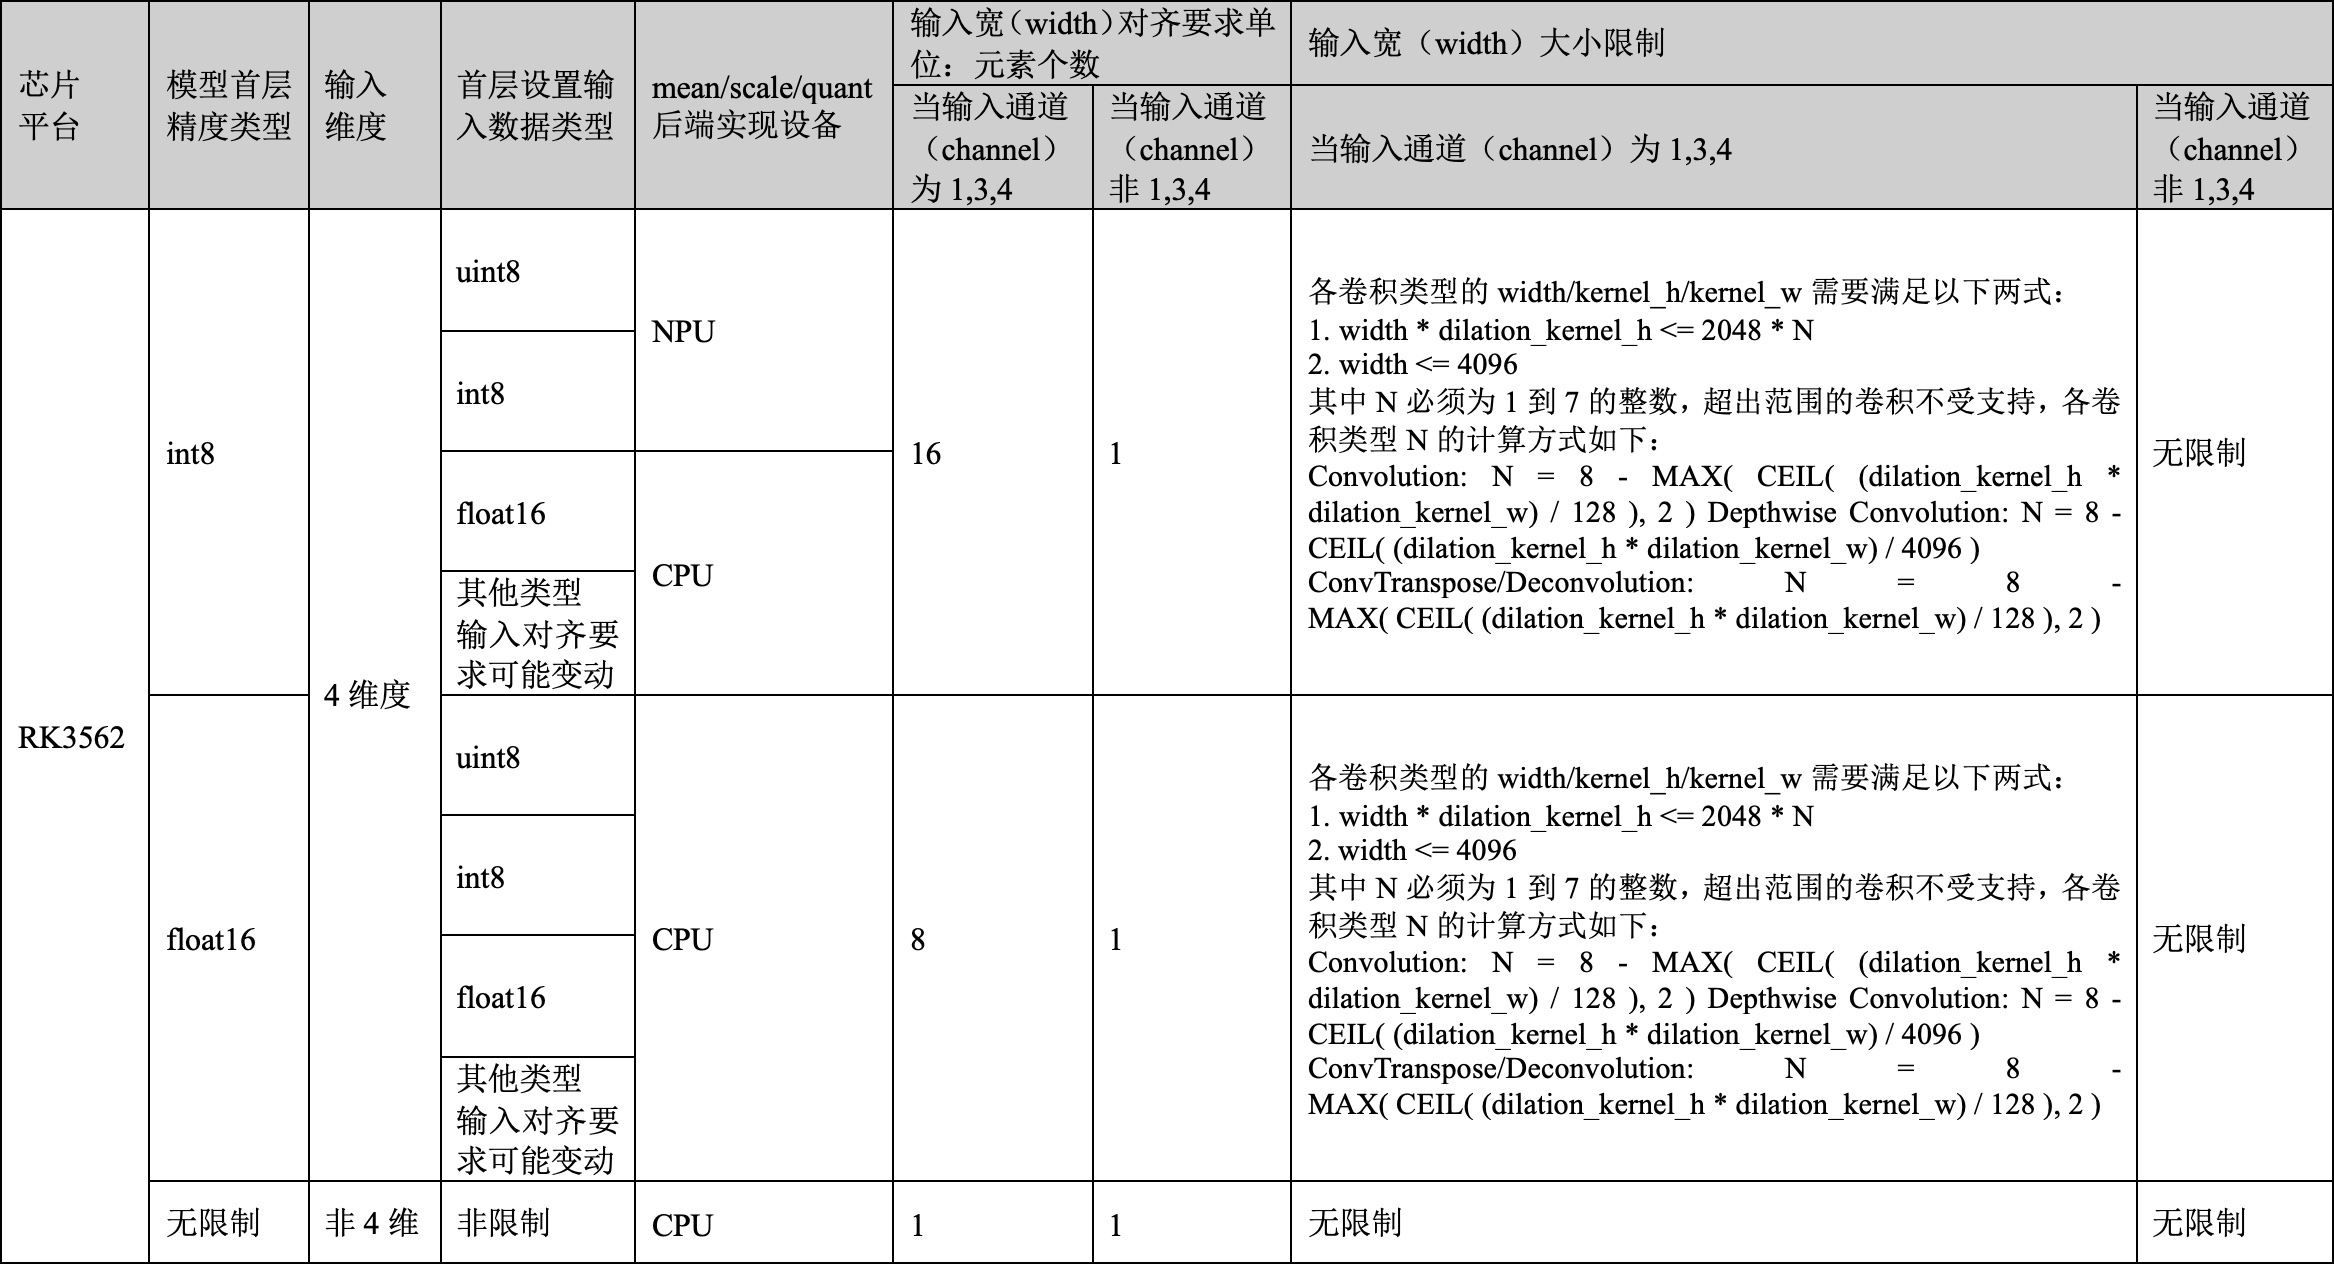
Редактируемая транскрипция оригинала (объединённые ячейки развёрнуты):
| Платформа | Точность первого слоя | Размерность входа | Заданный тип входа первого слоя | Исполнитель mean/scale/quant | Выравнивание width (элементы), channel=1,3,4 | Выравнивание width (элементы), channel≠1,3,4 | Ограничения width, channel=1,3,4 | Ограничения width, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3562 | int8 | 4 | uint8 | NPU | 16 | 1 | A | Без ограничений |
| RK3562 | int8 | 4 | int8 | NPU | 16 | 1 | A | Без ограничений |
| RK3562 | int8 | 4 | float16 | CPU | 16 | 1 | A | Без ограничений |
| RK3562 | int8 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 16 | 1 | A | Без ограничений |
| RK3562 | float16 | 4 | uint8 | CPU | 8 | 1 | B | Без ограничений |
| RK3562 | float16 | 4 | int8 | CPU | 8 | 1 | B | Без ограничений |
| RK3562 | float16 | 4 | float16 | CPU | 8 | 1 | B | Без ограничений |
| RK3562 | float16 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 8 | 1 | B | Без ограничений |
| RK3562 | Без ограничений | Не 4-мерный | Без ограничений | CPU | 1 | 1 | Без ограничений | Без ограничений |
Для каждого типа свёртки width/kernel_h/kernel_w должны удовлетворять обоим условиям ниже. N — целое число от 1 до 7; свёртки вне диапазона не поддерживаются. Формулы N приведены ниже. Написание dilation_kernel_h/w на рисунке отличается от dilated_kernel_h/w в последней главе; сохранён вариант рисунка.
| Условие | Формула |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| Условие | Формула |
|---|---|
| B (1) | width * dilation_kernel_h <= 2048 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| B / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| B / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
5.1.5 RK3576/RV1126B
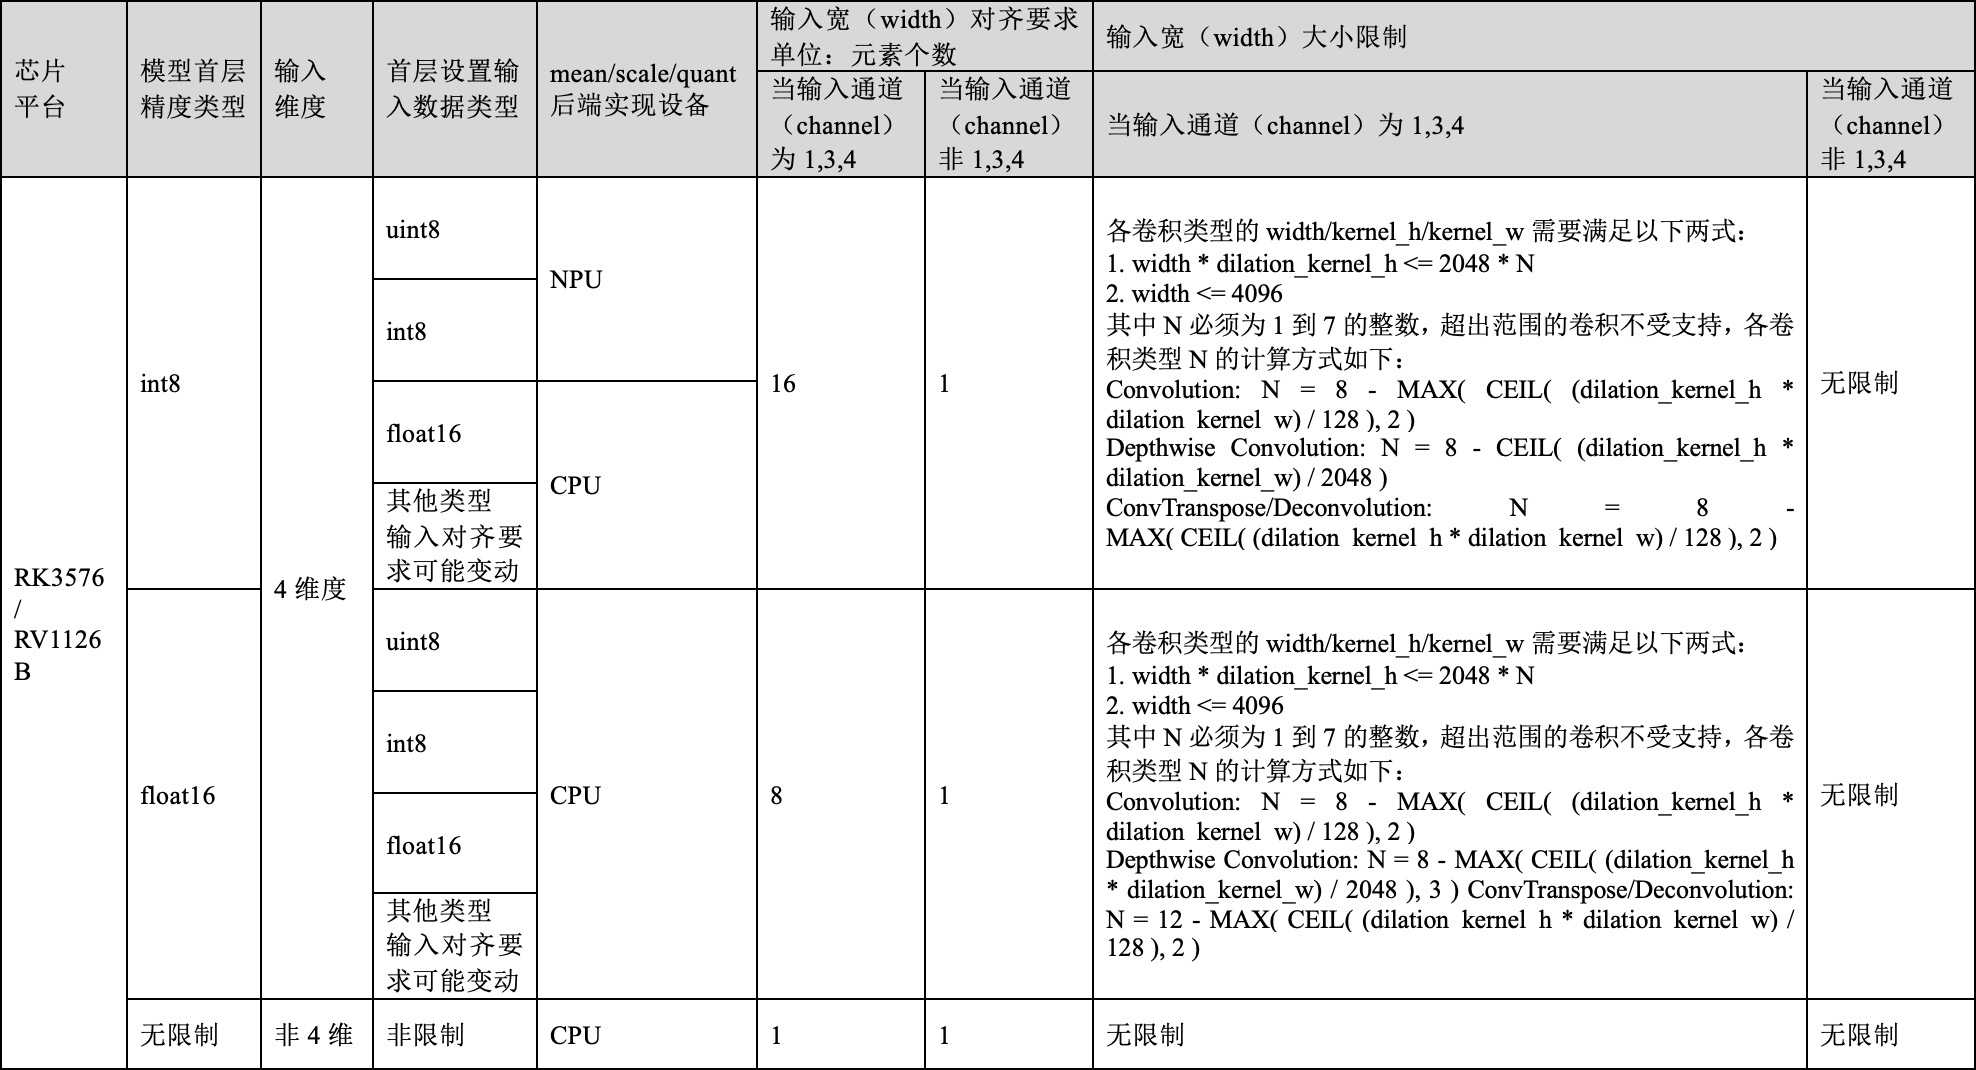
Редактируемая транскрипция оригинала (объединённые ячейки развёрнуты):
| Платформа | Точность первого слоя | Размерность входа | Заданный тип входа первого слоя | Исполнитель mean/scale/quant | Выравнивание width (элементы), channel=1,3,4 | Выравнивание width (элементы), channel≠1,3,4 | Ограничения width, channel=1,3,4 | Ограничения width, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3576/RV1126B | int8 | 4 | uint8 | NPU | 16 | 1 | A | Без ограничений |
| RK3576/RV1126B | int8 | 4 | int8 | NPU | 16 | 1 | A | Без ограничений |
| RK3576/RV1126B | int8 | 4 | float16 | CPU | 16 | 1 | A | Без ограничений |
| RK3576/RV1126B | int8 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 16 | 1 | A | Без ограничений |
| RK3576/RV1126B | float16 | 4 | uint8 | CPU | 8 | 1 | B | Без ограничений |
| RK3576/RV1126B | float16 | 4 | int8 | CPU | 8 | 1 | B | Без ограничений |
| RK3576/RV1126B | float16 | 4 | float16 | CPU | 8 | 1 | B | Без ограничений |
| RK3576/RV1126B | float16 | 4 | Прочие типы (выравнивание входа может измениться) | CPU | 8 | 1 | B | Без ограничений |
| RK3576/RV1126B | Без ограничений | Не 4-мерный | Без ограничений | CPU | 1 | 1 | Без ограничений | Без ограничений |
Для каждого типа свёртки width/kernel_h/kernel_w должны удовлетворять обоим условиям ниже. N — целое число от 1 до 7; свёртки вне диапазона не поддерживаются. Формулы N приведены ниже. Написание dilation_kernel_h/w на рисунке отличается от dilated_kernel_h/w в последней главе; сохранён вариант рисунка.
| Условие | Формула |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 2048) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| Условие | Формула |
|---|---|
| B (1) | width * dilation_kernel_h <= 2048 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| B / Depthwise Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| B / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
5.1.6 RK2118
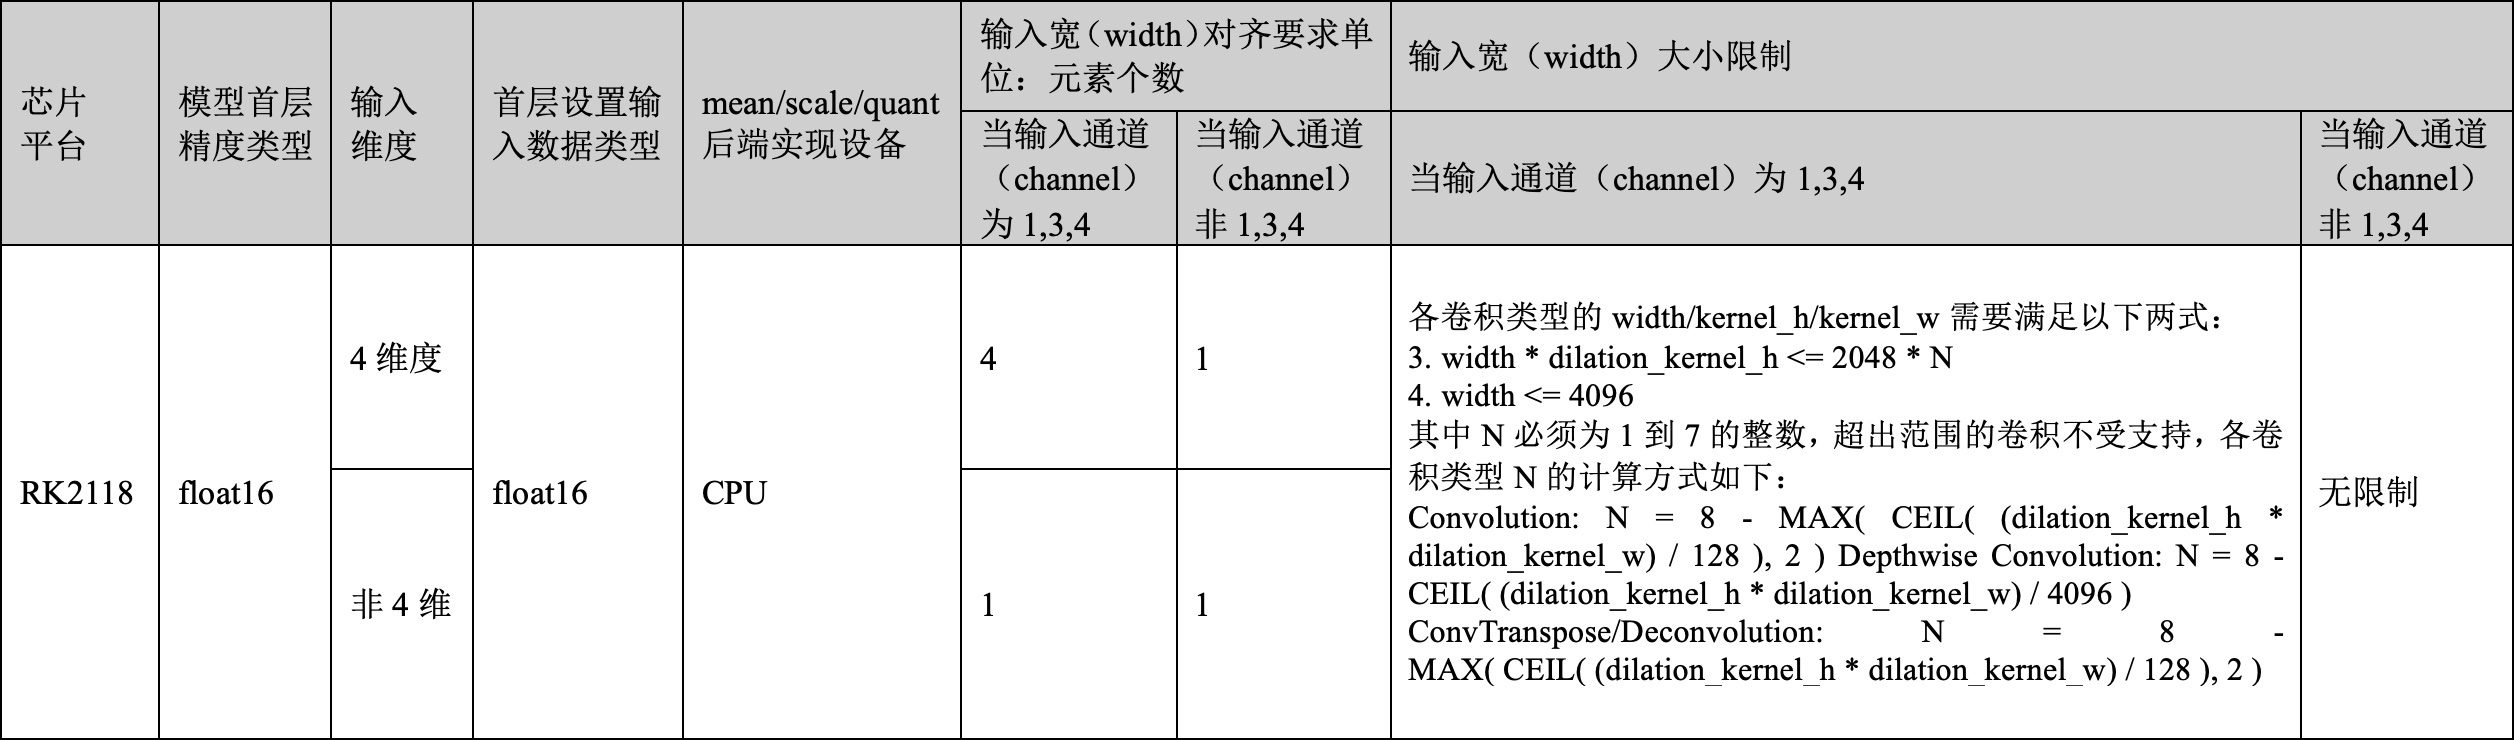
Редактируемая транскрипция оригинала (объединённые ячейки развёрнуты):
| Платформа | Точность первого слоя | Размерность входа | Заданный тип входа первого слоя | Исполнитель mean/scale/quant | Выравнивание width (элементы), channel=1,3,4 | Выравнивание width (элементы), channel≠1,3,4 | Ограничения width, channel=1,3,4 | Ограничения width, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK2118 | float16 | 4 | float16 | CPU | 4 | 1 | A | Без ограничений |
| RK2118 | float16 | Не 4-мерный | float16 | CPU | 1 | 1 | A | Без ограничений |
Для каждого типа свёртки width/kernel_h/kernel_w должны удовлетворять обоим условиям ниже. N — целое число от 1 до 7; свёртки вне диапазона не поддерживаются. Формулы N приведены ниже. Написание dilation_kernel_h/w на рисунке отличается от dilated_kernel_h/w в последней главе; сохранён вариант рисунка.
| Условие | Формула |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
5.1.7 RV1103B
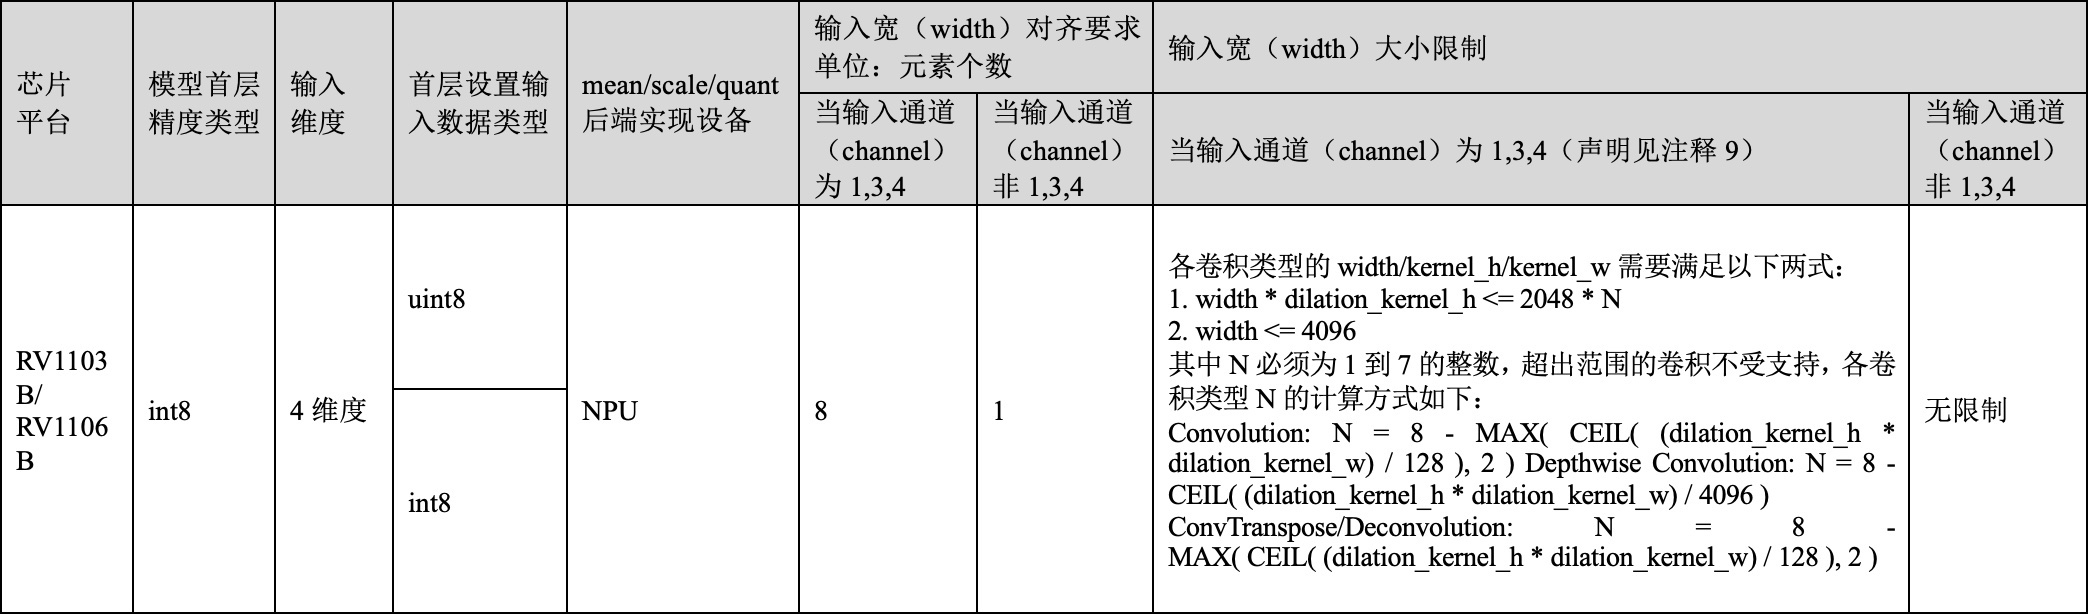
Редактируемая транскрипция оригинала (объединённые ячейки развёрнуты):
| Платформа | Точность первого слоя | Размерность входа | Заданный тип входа первого слоя | Исполнитель mean/scale/quant | Выравнивание width (элементы), channel=1,3,4 | Выравнивание width (элементы), channel≠1,3,4 | Ограничения width, channel=1,3,4 | Ограничения width, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RV1103B/RV1106B | int8 | 4 | uint8 | NPU | 8 | 1 | A | Без ограничений |
| RV1103B/RV1106B | int8 | 4 | int8 | NPU | 8 | 1 | A | Без ограничений |
Для каждого типа свёртки width/kernel_h/kernel_w должны удовлетворять обоим условиям ниже. N — целое число от 1 до 7; свёртки вне диапазона не поддерживаются. Формулы N приведены ниже. Написание dilation_kernel_h/w на рисунке отличается от dilated_kernel_h/w в последней главе; сохранён вариант рисунка.
| Условие | Формула |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
Заголовок рисунка ссылается на примечание 9, но предоставленное описание входов содержит только 1–8. Примечание 9 не найдено и не дополняется догадками.
5.2 Ограничения выходов модели
- (1) Для выходного тензора NHWC требуется выравнивание, если преобразование выхода выполняет NPU; при реализации на CPU выравнивание не требуется.
- (2) Точность выхода int8/float16 означает исходный тип данных выхода последнего слоя модели.
- (3) Для выхода NCHW, реализованного на NPU через интерфейс нулевого копирования, размер выделяемой выходной памяти определяется полученным через query значением size.
- (4) Для выхода NC1HWC2 размер выделяемой выходной памяти определяется полученным через query значением size.
5.2.1 RK3566/RK3568
| Платформа чипа | Точность выхода модели | Размерность выхода | Настройка выходного Layout | Требование выравнивания Channel | Требование выравнивания H*W |
|---|---|---|---|---|---|
| RK3566 /RK3568 |
int8 | 4 измерения | NCHW | Нет | Нет |
| RK3566 /RK3568 |
int8 | 4 измерения | NHWC | Выравнивание по 8 | Нет |
| RK3566 /RK3568 |
int8 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 16; несвёрточного типа: по 8. | H*W с выравниванием по 4 |
| RK3566 /RK3568 |
int8 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3566 /RK3568 |
float16 | 4 измерения | NCHW | Нет | Нет |
| RK3566 /RK3568 |
float16 | 4 измерения | NHWC | Выравнивание по 4 | |
| RK3566 /RK3568 |
float16 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 8; несвёрточного типа: по 4. | H*W с выравниванием по 4 |
| RK3566 /RK3568 |
float16 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3566 /RK3568 |
Без ограничений | Не 4 измерения | UNDEFINE | Нет | Нет |
5.2.2 RK3588
| Платформа чипа | Точность выхода модели | Размерность выхода | Настройка выходного Layout | Требование выравнивания Channel | Требование выравнивания H*W |
|---|---|---|---|---|---|
| RK3588 | int8 | 4 измерения | NCHW | Нет | Нет |
| RK3588 | int8 | 4 измерения | NHWC | Выравнивание по 16 | Нет |
| RK3588 | int8 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 32; несвёрточного типа: по 16. | H*W с выравниванием по 4 |
| RK3588 | int8 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3588 | float16 | 4 измерения | NCHW | Нет | Нет |
| RK3588 | float16 | 4 измерения | NHWC | Выравнивание по 8 | Нет |
| RK3588 | float16 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 16; несвёрточного типа: по 8. | H*W с выравниванием по 4 |
| RK3588 | float16 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3588 | Без ограничений | Не 4 измерения | UNDEFINE | Нет | Нет |
5.2.3 RV1103/RV1106
| Платформа чипа | Точность выхода модели | Размерность выхода | Настройка выходного Layout | Требование выравнивания Channel | Требование выравнивания H*W |
|---|---|---|---|---|---|
| RV1103 /RV1106 |
int8 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 32; несвёрточного типа: по 16. | H*W с выравниванием по 4 |
| RV1103 /RV1106 |
int8 | 4 измерения | NHWC | Нет | Нет |
5.2.4 RK3562
| Платформа чипа | Точность выхода модели | Размерность выхода | Настройка выходного Layout | Требование выравнивания Channel | Требование выравнивания H*W |
|---|---|---|---|---|---|
| RK3562 | int8 | 4 измерения | NCHW | Нет | Нет |
| RK3562 | int8 | 4 измерения | NHWC | Нет | Нет |
| RK3562 | int8 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 32; несвёрточного типа: по 16. | H*W с выравниванием по 4 |
| RK3562 | int8 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3562 | float16 | 4 измерения | NCHW | Нет | Нет |
| RK3562 | float16 | 4 измерения | NHWC | Нет | Нет |
| RK3562 | float16 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 16; несвёрточного типа: по 8. | H*W с выравниванием по 4 |
| RK3562 | float16 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3562 | Без ограничений | Не 4 измерения | UNDEFINE | Нет | Нет |
5.2.5 RK3576/RV1126B
| Платформа чипа | Точность выхода модели | Размерность выхода | Настройка выходного Layout | Требование выравнивания Channel | Требование выравнивания H*W |
|---|---|---|---|---|---|
| RK3576/ RV1126B |
int8 | 4 измерения | NCHW | Нет | Нет |
| RK3576/ RV1126B |
int8 | 4 измерения | NHWC | Нет | Нет |
| RK3576/ RV1126B |
int8 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 32; несвёрточного типа: по 16. | H*W с выравниванием по 4 |
| RK3576/ RV1126B |
int8 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3576/ RV1126B |
float16 | 4 измерения | NCHW | Нет | Нет |
| RK3576/ RV1126B |
float16 | 4 измерения | NHWC | Нет | Нет |
| RK3576/ RV1126B |
float16 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 16; несвёрточного типа: по 8. | H*W с выравниванием по 4 |
| RK3576/ RV1126B |
float16 | 4 измерения | UNDEFINE | Нет | Нет |
| RK3576/ RV1126B |
Без ограничений | Не 4 измерения | UNDEFINE | Нет | Нет |
5.2.6 RK2118
| Платформа чипа | Точность выхода модели | Размерность выхода | Настройка выходного Layout | Требование выравнивания Channel | Требование выравнивания H*W |
|---|---|---|---|---|---|
| RK2118 | float16 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 8; несвёрточного типа: по 4. | H*W с выравниванием по 4 |
| RK2118 | float16 | 4 измерения | NHWC | Нет | Нет |
| RK2118 | float16 | Не 4 измерения | UNDEFINE | Нет | Нет |
5.2.7 RV1103B/RV1106B
| Платформа чипа | Точность выхода модели | Размерность выхода | Настройка выходного Layout | Требование выравнивания Channel | Требование выравнивания H*W |
|---|---|---|---|---|---|
| RV1103B/ RV1106B |
int8 | 4 измерения | NC1HWC2 | Последний слой свёрточного типа: по 8; несвёрточного типа: по 8. | H*W с выравниванием по 4 |
| RV1103B/ RV1106B |
int8 | 4 измерения | NHWC | Нет | Нет |
Особые пояснения
Содержание
- Особые пояснения
- dilated_kernel_h
- dilated_kernel_w
6.1 dilated_kernel_h
dilated_kernel_h=kernel_h*dilations_h‑dilations_h+1
6.2 dilated_kernel_w
dilated_kernel_w=kernel_w*dilations_w‑dilations_w+1