
Diese vollständige technische Referenz folgt RK-YH-YF-418 / V2.3.2. Sie behandelt sieben NPU-Plattformgruppen: RK3566/RK3568, RK3588, RK3562, RV1103/RV1106, RK3576/RV1126B, RK2118 und RV1103B/RV1106B sowie CPU-Operatoren und Modell-Ein-/Ausgabegrenzen. Die PDFs im chinesischen und englischen Verzeichnis haben jeweils 343 Seiten und identische SHA-256-Werte; beide enthalten chinesischen Text, ein separates englisches Original existiert nicht. Englisch, Russisch und Deutsch sind vollständige Übersetzungen dieses chinesischen Originals. Alle vier Fassungen verwenden dieselben chinesischen Originalabbildungen; sie werden nicht als englische Abbildungen bezeichnet. Dies ist ausschließlich eine Referenz zur ArmSoM-Anpassung: Board-SoC, RKNN-Toolkit2/Compiler/Runtime-Versionen, SDK/BSP, Kerneltreiber, Quantisierung, Modell und Zero-Copy-Schnittstellen prüfen. Die Quelle schreibt keine einheitliche Kernelversion für alle Operatoren vor und belegt keine Unterstützung aller ArmSoM-Platinen. Keine Modellausführung, Leistungsmessung oder Hardwarevalidierung wurde vorgenommen.
ArmSoM Docs · RKNN-Toolkit2 · EDITORIAL-NOTES
Softwareänderungen
2.1 V2.3.2
- (1) Dokumentation für RV1126B ergänzt.
- (2) Dokumentation für RV1106B ergänzt.
- (3) ConvDilation-Parametergrenzen auf allen Plattformen aktualisiert.
- (4) Einschränkungen des Resize-Operators aktualisiert.
2.2 V2.3.0
- (1) Dokumentation zum mean_var-Modus von exNorm auf RK3576/RK3588/RK3562/RK3568 ergänzt.
- (2) MAX/MIN-Operatoren unterstützen Broadcast auf allen Plattformen.
- (3) Softmax-Grenzen für RK3576 geändert.
2.3 V2.2.0
- (1) softmax-Grenzen auf allen Plattformen außer rk3568 geändert; softmax-Aufteilung ergänzt.
- (2) RMSNorm-Unterstützung für RK3576, RK3588, RK3562 und RK3568 ergänzt.
2.4 V2.1.0
- (1) RK2118-Dokumentation ergänzt.
- (2) RV1103B-Dokumentation ergänzt.
- (3) Operatorspezifikationen aller Plattformen aktualisiert.
- (4) RK3576-Operatorspezifikationen einschließlich Hardmax und ConvLut ergänzt.
- (5) exConvStreaming-Unterstützung für RK2118.
- (6) FlashAttentionV2-Optimierung für exSDPA auf RK3562/RK3576 ergänzt.
2.5 V2.0.0‑beta
- (1) Spezifikationen unterstützter Operatoren für RK3576 ergänzt.
- (2) Spezifikationen der Hardwareunterstützung von exSDPAttention und exMatMul auf RK3588/RK3562/RK3576 ergänzt.
- (3) CPU-Operatorunterstützung für Floor, Mod, And, GatherElements und exMeanVarianceNormalization ergänzt.
- (4) Spezifikationen unterstützter Operatoren für RK2118 ergänzt.
Spezifikationen der NPU-Operatoren
3.1 RK3566/RK3568
3.1.1 Add
Führt elementweise binäre Addition (C=A+B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.1.2 AddRelu
Fusionierte Berechnung von Add und Relu, C=Relu(A+B).
Eingaben
- Wie bei Add.
Ausgaben
- Wie bei Add.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.1.3 BatchNormalization
Führt Batch-Normalisierung des Eingabetensors gemäß https://arxiv.org/abs/1502.03167 aus.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- epsilon:float (Standardwert=1e‑5)
- Reeller Wert, der beim Teilen durch die Standardabweichung eine Division durch 0 verhindert.
- epsilon∈(0,∞]
- momentum:float
- Parameter des gleitenden Mittelwerts beim Training.
3.1.4 Concat
Verknüpft eine Folge von Vektoren entlang axis zu einem Vektor. Alle Dimensionen außer axis müssen übereinstimmen.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axisint64
- axis∈{0,1,2,3}
3.1.5 Convolution
Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.6 DepthwiseConvolution
Tiefenseparierbare Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.7 ConvolutionRelu
Fusionierte Berechnung von Convolution und Relu, Output=Relu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.8 ConvolutionClip
Fusionierte Berechnung von Convolution und Clip, Output=Clip(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.9 ConvolutionPRelu/LeakyRelu
Fusionierte Berechnung von Convolution und PRelu/LeakyRelu, Output = PRelu(Conv(Input)) oder Output =
LeakyRelu(Conv(Input))
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.10 ConvolutionAdd
Fusionierte Berechnung von Convolution und Add, Output=Add(Conv(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.11 ConvolutionSigmoid
Fusionierte Berechnung von Convolution und Sigmoid, Output=Sigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.12 ConvolutionTanh
Fusionierte Berechnung von Convolution und Tanh, Output=Tanh(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.13 ConvolutionSoftplus
Fusionierte Berechnung von Convolution und Softplus, Output=Softplus(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.14 ConvolutionHardSigmoid
Fusionierte Berechnung von Convolution und HardSigmoid, Output=HardSigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.15 ConvolutionHardSwish
Fusionierte Berechnung von Convolution und HardSwish, Output=HardSwish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.16 ConvolutionElu
Fusionierte Berechnung von Convolution und Elu, Output=Elu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.17 ConvolutionSwish
Fusionierte Berechnung von Convolution und Swish, Output=Swish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.18 ConvolutionMish
Fusionierte Berechnung von Convolution und Mish, Output=Mish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.19 ConvolutionAddRelu
Fusionierte Berechnung von Convolution, Add und Relu, Output=Relu(Add(Conv(Input0),Input1)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.1.20 ConvTranspose
Transponierte Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzlich unterliegt die Eingabe der ersten Schicht
- shape:[batch,channel,height,width]
width unterliegt Einschränkungen; siehe Modelleingaben.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h unterstützt nur 1,2,4,8.
- stride_w unterstützt nur 1,2,4,8.
- pads:int(pads_top,pads_left,pads_bottom,pads_right). Bei pad sind folgende Fälle nicht unterstützt: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: nur 1 wird unterstützt; num_output ist genau dann unterstützt, wenn num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Bei dilation ungleich (1,1) wird nur kernel=(1,1) unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.21 ConvTranposeRelu
Fusionierte Berechnung von ConvTranpose und Relu, Output=Relu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.22 ConvTranposeClip
Fusionierte Berechnung von ConvTranpose und Clip, Output=Clip(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.23 ConvTranposePRelu/LeakyRelu
Fusionierte Berechnung von ConvTranpose und PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) oder Output=
LeakyRelu(ConvTranpose(Input))
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.24 ConvTranposeAdd
Fusionierte Berechnung von ConvTranpose und Add, Output=Add(ConvTranpose(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.25 ConvTranposeSigmoid
Fusionierte Berechnung von ConvTranpose und Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.26 ConvTranposeTanh
Fusionierte Berechnung von ConvTranpose und Tanh, Output=Tanh(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.27 ConvTranposeSoftplus
Fusionierte Berechnung von ConvTranpose und Softplus, Output=Softplus(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.28 ConvTranposeHardSigmoid
Fusionierte Berechnung von ConvTranpose und HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.1.29 ConvTranposeHardSwish
Fusionierte Berechnung von ConvTranpose und HardSwish, Output=HardSwish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.30 ConvTranposeElu
Fusionierte Berechnung von ConvTranpose und Elu, Output=Elu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.31 ConvTranposeSwish
Fusionierte Berechnung von ConvTranpose und Swish, Output=Swish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.32 ConvTranposeMish
Fusionierte Berechnung von ConvTranpose und Mish, Output=Mish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.1.33 Div
Führt elementweise binäre Division (C=A/B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.1.34 Expand
Erweitert den Eingabetensor anhand von shape und Broadcasting-Regeln, ähnlich numpy.array(input) *numpy.ones(shape): Dimensionen werden rechtsbündig ausgerichtet; korrespondierende Dimensionen müssen gleich sein oder eine davon muss 1 sein.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Broadcasting-Einschränkungen
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.1.35 GRU
Gated Recurrent Unit (GRU). Erweiterungen und Varianten heißen exGRU; mit (extern) markierte Parameter sind exGRU vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- linear_before_reset:int
- Auswahl der LBR-Variante:1(T)or0(F).
- direction(extern):string
- Legt die Berechnungsrichtung von GRU fest.
- forward: GRU in Vorwärtsrichtung.
- reverse: GRU in Rückwärtsrichtung.
- bidirectional: GRU in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der GRU-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der GRU-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.36 Gather
Wählt anhand von Indices Einträge aus X entlang der angegebenen axis aus und verknüpft sie.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Indices:T2
- Indizes der zu sammelnden Elemente; rank =1.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Attribute
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Legt die durch Indices adressierte Eingabedimension fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.1.37 LSTM
Long Short-Term Memory (LSTM). Erweiterungen und Varianten heißen exLSTM; mit (extern) markierte Parameter sind exLSTM vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2,T3
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T4,T5(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- direction(extern):string
- Legt die Berechnungsrichtung von LSTM fest.
- forward: LSTM in Vorwärtsrichtung.
- reverse: LSTM in Rückwärtsrichtung.
- bidirectional: LSTM in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der LSTM-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der LSTM-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- proj_size(extern):int
- proj_size bei projection; projsize∈[0,hiddensize].
- Derzeit auf 0 beschränkt; projection wird noch nicht unterstützt.
- input_forget(extern):int
- Auswahl der cifg-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- has_projection(extern):int
- projection-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
- T5:int(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.38 Max
Berechnet das elementweise Maximum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.39 Min
Berechnet das elementweise Minimum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.40 Mul
Führt elementweise binäre Multiplikation (C=A*B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.1.41 MulRelu
Weitere Beschreibungen wie bei Mul.
- Unterstützte Datentypen: wie bei Mul.
3.1.42 Pad
Erzeugt aus Datentensor (data), Tensor der Auffüllwerte an Achsenanfang und -ende (pads), Modus (mode) und konstantem Wert (constant_value) einen aufgefüllten Tensor (output).
Eingaben
- data:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Attribute
- mode:string (Standardwert constant)
- Unterstützte Modi: constant,reflect.
- constant: uneingeschränkt.
- Unterstützte Modi: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.1.43 MaxPool
MaxPool verarbeitet Eingabetensor X und wendet Max-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Für durch den Kernel bestimmte Teilmengen wird das Maximum berechnet und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64
- Bevorzugte Speicherreihenfolge:0.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.44 GlobalMaxPool
GlobalMaxPool wendet Max-Pooling auf die Werte jedes Kanals von Eingabetensor X an. Dies entspricht MaxPool mit kernel_shape gleich den räumlichen Dimensionen von input.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(1,7]
width∈(1,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.45 AveragePool
AveragePool verarbeitet Eingabetensor X und wendet Average-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Alle Werte der durch den Kernel bestimmten Teilmengen werden gemittelt und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.46 GlobalAveragePool
GlobalAveragePool mittelt die Werte jedes Kanals von Eingabetensor X. Dies entspricht AveragePool mit kernel_shape gleich den räumlichen Dimensionen des Eingabetensors.
Eingaben*
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.1.47 Pow
Z =XY
Potenzierung: verarbeitet Eingabedaten (Tensor) und einen Exponenten zu Ausgabedaten (Tensor).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Y:T2
- shape:[1]
- Derzeit nur 0,1,2,3,0.5,‑0.5 unterstützt.
- shape:[1]
Ausgaben
- Z:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.1.48 Relu
Setzt negative Eingabetensorwerte auf null; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.49 Clip/ReLU6
Begrenzt Eingabetensorwerte auf [0,6].
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.50 PRelu
Skaliert negative Eingabetensorwerte mit einem lernbaren Parameter; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Attribute
- slope: PRelu-Koeffizient.
- Nur ein einzelner Skalar oder Koeffizienten entlang der C-Dimension werden unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.51 LeakyRelu
Skaliert negative Eingabetensorwerte mit einem festen Faktor; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.52 Reshape
Liefert einen Tensor der angegebenen Form ohne Änderung der Eingabedaten oder Elementanzahl.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- shape:int
- Legt die Form des Ausgabetensors fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.1.53 Resize
Ändert die Größe des Eingabetensors. Im Allgemeinen wird jeder Ausgabewert als gewichteter Mittelwert einer Nachbarschaft (Abtastpositionen) im Eingabetensor berechnet.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- roi(optional):T2
- Derzeit nicht unterstützt.
- scales(optional):T2
- Array der Skalierungsfaktoren je Dimension.
- sizes(optional):T3
- Zielgröße des Ausgabetensors.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Attribute
- antialias:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- axes:int[]
- Die Einstellung wird derzeit nicht unterstützt.
- coordinate_transformation_mode:strings (Standardwert ”half_pixel”)
- Derzeit werden nur half_pixel, pytorch_half_pixel und align_corners unterstützt.
- cubic_coeff_a:float (Standardwert ‑0.75)
- Die Einstellung wird derzeit nicht unterstützt.
- exclude_outside:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- extrapolation_value:float (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- keep_aspect_ratio_policy:strings (Standardwert ”stretch”)
- Die Einstellung wird derzeit nicht unterstützt.
- mode:strings (Standardwert ”nearest”)
- Derzeit sind nur nearest und linear konfigurierbar.
- nearest_mode:strings (Standardwert ”round_prefer_floor”)
- Die Einstellung wird derzeit nicht unterstützt.
Unterstützung: derzeit nur ganzzahlige Skalierung in Breite und Höhe mit ganzzahligen Faktoren 2‑8. Eine Eingabe (1,c,1,1) kann auf (1,c,h,w) vergrößert werden.
3.1.54 Slice
Erzeugt einen Ausschnitt des aktuellen Vektors nach den Regeln von NumPy-Slicing.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- starts:int(Tensor)
- Startposition des Ausschnitts: uneingeschränkt.
- ends:int(Tensor)
- Endposition des Ausschnitts: uneingeschränkt.
- axes:int(Tensor)
- Auswahl der Slice-Achsen: beliebige Achsen 0~3, auch mehrere gleichzeitig.
- steps:int(Tensor)
- Legt die Schrittweite entlang der jeweiligen Slice-Achse fest.
- Bei height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc darf steps von 1 abweichen. Andernfalls läuft SliceOP nur bei steps==[1,1,1,1] auf der NPU.
3.1.55 Split
Teilt den Vektor entlang axis in num_outputs Vektoren; split legt deren Größen entlang axis fest.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- Ein oder mehrere Ausgabevektoren, bestimmt durch num_outputs.
- shape: durch die Aufteilung bestimmt.
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.1.56 Sub
- Führt elementweise binäre Subtraktion (C=A‑B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.1.57 Tile
Erzeugt durch Wiederholung des gegebenen Tensors einen Tensor, wie NumPy tile, jedoch ohne Broadcasting.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.1.58 Transpose
Transponiert den Eingabetensor.
Eingaben
- X:T1
- shape:[n1,c1,h1,w1]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n1,c1,h1,w1]
Ausgaben
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n2,c2,h2,w2]
Attribute
- perm, Reihenfolge der transponierten Achsen: Einschränkungen für unterschiedliche perm folgen (p=8192,q=2048).
- perm=[0,1,2,3]
- Uneingeschränkt
- perm=[0,1,3,2]
- Nicht unterstützt
- perm=[0,2,3,1]
- Nicht unterstützt
- perm=[0,2,1,3]
- Nicht unterstützt
- perm=[0,3,1,2]
- Nicht unterstützt
- perm=[0,3,2,1]
- Nicht unterstützt
- perm=[1,0,2,3]
- Nicht unterstützt
- perm=[1,0,3,2]
- Nicht unterstützt
- perm=[1,2,0,3]
- Nicht unterstützt
- perm=[1,2,3,0]
- Nicht unterstützt
- perm=[1,3,0,2]
- Nicht unterstützt
- perm=[1,3,2,0]
- Nicht unterstützt
- perm=[2,1,0,3]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,h1%4=0)
- perm=[2,1,3,0]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,h1%4=0)
- perm=[2,0,3,1]
- Nicht unterstützt
- perm=[2,0,1,3]
- Nicht unterstützt
- perm=[2,3,1,0]
- Nicht unterstützt
- perm=[2,3,0,1]
- Nicht unterstützt
- perm=[3,0,2,1]
- Nicht unterstützt
- perm=[3,0,1,2]
- Nicht unterstützt
- perm=[3,2,0,1]
- Nicht unterstützt
- perm=[3,2,1,0]
- Nicht unterstützt
- perm=[3,1,0,2]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,w1%4=0)
- perm=[3,1,2,0]
- T1,T2:c1<8192,n<8192,h1*w1<8192,(h1=w1=1,n1%4=0)or(n1=h1=1,w1%4=0)
- perm=[0,1,2,3]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.1.59 Sigmoid
Wendet y=1/(1+exp(‑x)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.60 Tanh
Berechnet den hyperbolischen Tangens jedes Eingabetensorelements.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.61 Softplus
Wendet Softplus elementweise an, y=ln(exp(x)+1).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.62 HardSigmoid
Wendet y=max(0,min(1,alpha*x+beta)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor, wobei
alpha=1/6,beta=0.5
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.63 HardSwish
Wendet HardSwish elementweise an: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), wobei alpha=1/6,beta=0.5.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.64 Elu
Wendet f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0 elementweise an, um den Ausgabetensor zu erzeugen; alpha=1.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.65 exSwish
Wendet die Sigmoid Linear Unit elementweise an. Swish heißt auch SiLU: y=x*sigmoid(x).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.66 exMish
Wendet mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.67 exGelu
Wendet y =x∗Φ(x) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor. Wenn Φ(x) auf tanh gesetzt ist,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.68 exSwooshR
Wendet die folgende Funktion aus https://arxiv.org/abs/2310.11230 elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
SwooshR(x)=log(1+exp(x-1))-0.08x-0.313261687
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.69 exSwooshL
Wendet die folgende Funktion aus https://arxiv.org/abs/2310.11230 elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
SwooshL(x)=log(1+exp(x-4))-0.08x-0.035
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.1.70 Where
Wählt Werte aus x_tensor oder y_tensor anhand von mask_tensor: Bei True wird der entsprechende x_tensor-Wert gewählt, sonst der y_tensor-Wert.
Eingaben
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- output:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.1.71 exGlu
Gated-Linear-Unit-Funktion; a ist die erste Hälfte der Eingabematrix, b die zweite.
GLU(a,b)=a⊗σ(b)
Eingaben
- Input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Output:T1
- shape:[batch,channel/2,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int(Standardwert=1)
- Dimension, entlang der die Eingabe geteilt wird.
- Einschränkung: nur 1 unterstützt.
3.1.72 exMatMul
Matrixmultiplikation
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Eingaben
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Quantisierungsunterstützung
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- Y:T1
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Attribute
- c_type:strings(Standardwert “add”)
- add oder mul legt fest, ob C addiert oder multipliziert wird.
3.1.73 exNorm
Normalisiert Eingabedaten. Derzeit werden LayerNormlization, RMSNormlization und MeanVarianceNormalization unterstützt:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Dabei ist x der Eingabevektor. µ und σ2 sind Mittelwert und Varianz des Eingabevektors:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS ist der quadratische Mittelwert des Eingabevektors:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance ist die äquivalente Varianz des Eingabevektors:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ ist ein kleiner Wert zur Vermeidung einer Division durch null. W und B sind optionale Parameter.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- epsilon:float(Standardwert 1e‑05)
- epsilon-Wert zur Vermeidung einer Division durch 0.
- mode:string
- Drei Normalization-Modi sind wählbar: layer, rms und mean_var.
- axes:int64[](Standardwert [1])
- Normalisierungsachsen: derzeit nur [1] und [1,2,3] unterstützt.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.1.74 exWindow
exWindow stammt von window_partition und window_reverse aus swin_transformer. In der Originalarbeit werden Eingabemerkmale in nicht überlappende Fenster der Größe window_size×window_size aufgeteilt. Ein- und Ausgabemerkmale müssen eine 4-dimensionale shape haben und in Höhe und Breite aufgeteilt werden. Die PyTorch-Implementierung folgt:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Eingaben
- X:T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- mode:string
- Unterstützte Modi:partition,reverse,partition_num_first.
- partition: siehe Implementierung von window_partition.
- reverse: siehe Implementierung von window_reverse.
- partition_num_first unterscheidet sich von partition dadurch, dass H,W nach num_windows aufgeteilt werden; partition teilt H,W dagegen nach window_sizes auf.
- Unterstützte Modi:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-dimensionaler Vektor der Fenstergröße, der Höhe und Breite jedes Fensters festlegt. Auf dieser Größe beruhen Aufmerksamkeitsberechnung und Merkmalsextraktion innerhalb des Fensters.
- num_windows:listofints
- 2-dimensionaler Vektor der Fensteranzahl; legt fest, in wie viele Fenster Höhe und Breite der Eingabemerkmale geteilt werden.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2 RK3588
3.2.1 Add
Führt elementweise binäre Addition (C=A+B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.2 AddRelu
Fusionierte Berechnung von Add und Relu, C=Relu(A+B).
Eingaben
- Wie bei Add.
Ausgaben
- Wie bei Add.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.3 BatchNormalization
Führt Batch-Normalisierung des Eingabetensors gemäß https://arxiv.org/abs/1502.03167 aus.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- epsilon:float (Standardwert=1e‑5)
- Reeller Wert, der beim Teilen durch die Standardabweichung eine Division durch 0 verhindert.
- epsilon∈(0,∞]
- momentum:float
- Parameter des gleitenden Mittelwerts beim Training.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.4 Concat
Verknüpft eine Folge von Vektoren entlang axis zu einem Vektor. Alle Dimensionen außer axis müssen übereinstimmen.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axisint64
- axis∈{0,1,2,3}
3.2.5 Convolution
Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.6 DepthwiseConvolution
Tiefenseparierbare Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.7 ConvolutionRelu
Fusionierte Berechnung von Convolution und Relu, Output=Relu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.8 ConvolutionClip
Fusionierte Berechnung von Convolution und Clip, Output=Clip(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.9 ConvolutionPRelu/LeakyRelu
Fusionierte Berechnung von Convolution und PRelu/LeakyRelu, Output = PRelu(Conv(Input)) oder Output =
LeakyRelu(Conv(Input))
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.10 ConvolutionAdd
Fusionierte Berechnung von Convolution und Add, Output=Add(Conv(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.11 ConvolutionSigmoid
Fusionierte Berechnung von Convolution und Sigmoid, Output=Sigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.12 ConvolutionTanh
Fusionierte Berechnung von Convolution und Tanh, Output=Tanh(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.13 ConvolutionSoftplus
Fusionierte Berechnung von Convolution und Softplus, Output=Softplus(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.14 ConvolutionHardSigmoid
Fusionierte Berechnung von Convolution und HardSigmoid, Output=HardSigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.15 ConvolutionHardSwish
Fusionierte Berechnung von Convolution und HardSwish, Output=HardSwish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.16 ConvolutionElu
Fusionierte Berechnung von Convolution und Elu, Output=Elu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.17 ConvolutionSwish
Fusionierte Berechnung von Convolution und Swish, Output=Swish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.18 ConvolutionMish
Fusionierte Berechnung von Convolution und Mish, Output=Mish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.19 ConvolutionAddRelu
Fusionierte Berechnung von Convolution, Add und Relu, Output=Relu(Add(Conv(Input0),Input1)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.20 ConvTranspose
Transponierte Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzlich unterliegt die Eingabe der ersten Schicht
- shape:[batch,channel,height,width]
width unterliegt Einschränkungen; siehe Modelleingaben.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h unterstützt nur 1,2,4,8.
- stride_w unterstützt nur 1,2,4,8.
- pads:int(pads_top,pads_left,pads_bottom,pads_right). Bei pad sind folgende Fälle nicht unterstützt: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: nur 1 wird unterstützt; num_output ist genau dann unterstützt, wenn num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Bei dilation ungleich (1,1) wird nur kernel=(1,1) unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.21 ConvTranposeRelu
Fusionierte Berechnung von ConvTranpose und Relu, Output=Relu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.22 ConvTranposeClip
Fusionierte Berechnung von ConvTranpose und Clip, Output=Clip(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.23 ConvTranposePRelu/LeakyRelu
Fusionierte Berechnung von ConvTranpose und PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) oder Output=
LeakyRelu(ConvTranpose(Input))
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.24 ConvTranposeAdd
Fusionierte Berechnung von ConvTranpose und Add, Output=Add(ConvTranpose(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.25 ConvTranposeSigmoid
Fusionierte Berechnung von ConvTranpose und Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.26 ConvTranposeTanh
Fusionierte Berechnung von ConvTranpose und Tanh, Output=Tanh(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.27 ConvTranposeSoftplus
Fusionierte Berechnung von ConvTranpose und Softplus, Output=Softplus(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.28 ConvTranposeHardSigmoid
Fusionierte Berechnung von ConvTranpose und HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.2.29 ConvTranposeHardSwish
Fusionierte Berechnung von ConvTranpose und HardSwish, Output=HardSwish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.30 ConvTranposeElu
Fusionierte Berechnung von ConvTranpose und Elu, Output=Elu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.31 ConvTranposeSwish
Fusionierte Berechnung von ConvTranpose und Swish, Output=Swish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.32 ConvTranposeMish
Fusionierte Berechnung von ConvTranpose und Mish, Output=Mish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.2.33 Div
Führt elementweise binäre Division (C=A/B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.2.34 Expand
Erweitert den Eingabetensor anhand von shape und Broadcasting-Regeln, ähnlich numpy.array(input) *numpy.ones(shape): Dimensionen werden rechtsbündig ausgerichtet; korrespondierende Dimensionen müssen gleich sein oder eine davon muss 1 sein.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Broadcasting-Einschränkungen
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.2.35 GRU
Gated Recurrent Unit (GRU). Erweiterungen und Varianten heißen exGRU; mit (extern) markierte Parameter sind exGRU vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- linear_before_reset:int
- Auswahl der LBR-Variante:1(T)or0(F).
- direction(extern):string
- Legt die Berechnungsrichtung von GRU fest.
- forward: GRU in Vorwärtsrichtung.
- reverse: GRU in Rückwärtsrichtung.
- bidirectional: GRU in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der GRU-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der GRU-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.36 Gather
Wählt anhand von Indices Einträge aus X entlang der angegebenen axis aus und verknüpft sie.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Indices:T2
- Indizes der zu sammelnden Elemente; rank =1.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Attribute
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Legt die durch Indices adressierte Eingabedimension fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.37 Hardmax
Ausgaben
- input:T1
- shape:[batch,channel,height,width]
axis=1,height∗width<16384;
- axis=3/‑1,channel∗height<16384; zusätzlich gelten die Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- hardmax-Achse:1,3/‑1, entsprechend channel und width.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.38 LSTM
Long Short-Term Memory (LSTM). Erweiterungen und Varianten heißen exLSTM; mit (extern) markierte Parameter sind exLSTM vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2,T3
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T4,T5(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- direction(extern):string
- Legt die Berechnungsrichtung von LSTM fest.
- forward: LSTM in Vorwärtsrichtung.
- reverse: LSTM in Rückwärtsrichtung.
- bidirectional: LSTM in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der LSTM-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der LSTM-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- proj_size(extern):int
- proj_size bei projection; projsize∈[0,hiddensize].
- Derzeit auf 0 beschränkt; projection wird noch nicht unterstützt.
- input_forget(extern):int
- Auswahl der cifg-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- has_projection(extern):int
- projection-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
- T5:int(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.39 Max
Berechnet das elementweise Maximum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.40 Min
Berechnet das elementweise Minimum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.41 Mul
Führt elementweise binäre Multiplikation (C=A*B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.42 MulRelu
Fusionierte Berechnung von Mul und Relu,C=Relu(A*B).
Eingaben
- Wie bei Mul.
Ausgaben
- Wie bei Mul.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.2.43 Pad
Erzeugt aus Datentensor (data), Tensor der Auffüllwerte an Achsenanfang und -ende (pads), Modus (mode) und konstantem Wert (constant_value) einen aufgefüllten Tensor (output).
Eingaben
- data:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,
width_end]
- constant_value(optional):T3
- shape:[1]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Attribute
- mode:string (Standardwert constant)
- Unterstützte Modi: constant,reflect.
- constant: uneingeschränkt.
- Unterstützte Modi: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.44 MaxPool
MaxPool verarbeitet Eingabetensor X und wendet Max-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Für durch den Kernel bestimmte Teilmengen wird das Maximum berechnet und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64
- Bevorzugte Speicherreihenfolge:0.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.45 GlobalMaxPool
GlobalMaxPool wendet Max-Pooling auf die Werte jedes Kanals von Eingabetensor X an. Dies entspricht MaxPool mit kernel_shape gleich den räumlichen Dimensionen von input.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.46 AveragePool
AveragePool verarbeitet Eingabetensor X und wendet Average-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Alle Werte der durch den Kernel bestimmten Teilmengen werden gemittelt und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.47 GlobalAveragePool
GlobalAveragePool mittelt die Werte jedes Kanals von Eingabetensor X. Dies entspricht AveragePool mit kernel_shape gleich den räumlichen Dimensionen des Eingabetensors.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.2.48 Pow
Z =XY
Potenzierung: verarbeitet Eingabedaten (Tensor) und einen Exponenten zu Ausgabedaten (Tensor).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Y:T2
- shape:[1]
- Derzeit nur 0,1,2,3,0.5,‑0.5 unterstützt.
- shape:[1]
Ausgaben
- Z:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.49 Relu
Setzt negative Eingabetensorwerte auf null; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.50 Clip/ReLU6
Begrenzt Eingabetensorwerte auf [0,6].
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.51 PRelu
Skaliert negative Eingabetensorwerte mit einem lernbaren Parameter; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Attribute
- slope: PRelu-Koeffizient.
- Nur ein einzelner Skalar oder Koeffizienten entlang der C-Dimension werden unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.52 LeakyRelu
Skaliert negative Eingabetensorwerte mit einem festen Faktor; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.53 Reshape
Liefert einen Tensor der angegebenen Form ohne Änderung der Eingabedaten oder Elementanzahl.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- shape:int
- Legt die Form des Ausgabetensors fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.54 Resize
Ändert die Größe des Eingabetensors. Im Allgemeinen wird jeder Ausgabewert als gewichteter Mittelwert einer Nachbarschaft (Abtastpositionen) im Eingabetensor berechnet.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- roi(optional):T2
- Derzeit nicht unterstützt.
- scales(optional):T2
- Array der Skalierungsfaktoren je Dimension.
- sizes(optional):T3
- Zielgröße des Ausgabetensors.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Attribute
- antialias:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- axes:int[]
- Die Einstellung wird derzeit nicht unterstützt.
- coordinate_transformation_mode:strings (Standardwert ”half_pixel”)
- Derzeit werden nur half_pixel, pytorch_half_pixel und align_corners unterstützt.
- cubic_coeff_a:float (Standardwert ‑0.75)
- Die Einstellung wird derzeit nicht unterstützt.
- exclude_outside:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- extrapolation_value:float (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- keep_aspect_ratio_policy:strings (Standardwert ”stretch”)
- Die Einstellung wird derzeit nicht unterstützt.
- mode:strings (Standardwert ”nearest”)
- Derzeit sind nur nearest und linear konfigurierbar.
- nearest_mode:strings (Standardwert ”round_prefer_floor”)
- Die Einstellung wird derzeit nicht unterstützt.
Unterstützung: derzeit nur ganzzahlige Skalierung in Breite und Höhe mit ganzzahligen Faktoren 2‑8. Eine Eingabe (1,c,1,1) kann auf (1,c,h,w) vergrößert werden.
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.2.55 Slice
Erzeugt einen Ausschnitt des aktuellen Vektors nach den Regeln von NumPy-Slicing.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- starts:int(Tensor)
- Startposition des Ausschnitts: uneingeschränkt.
- ends:int(Tensor)
- Endposition des Ausschnitts: uneingeschränkt.
- axes:int(Tensor)
- Auswahl der Slice-Achsen: beliebige Achsen 0~3, auch mehrere gleichzeitig.
- steps:int(Tensor)
- Legt die Schrittweite entlang der jeweiligen Slice-Achse fest.
- Bei height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc darf steps von 1 abweichen. Andernfalls läuft SliceOP nur bei steps==[1,1,1,1] auf der NPU.
3.2.56 Softmax
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- softmax-Achse:1,3, entsprechend channel und width.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.57 exSoftmax13
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.58 exSoftmaxMask
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, uneingeschränkt;
· axis=3/‑1,width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
- mask_value:int64
- Zu maskierende Werte:0,1.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.59 Split
Teilt den Vektor entlang axis in num_outputs Vektoren; split legt deren Größen entlang axis fest.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- Ein oder mehrere Ausgabevektoren, bestimmt durch num_outputs.
- shape: durch die Aufteilung bestimmt.
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.2.60 Sub
- Führt elementweise binäre Subtraktion (C=A‑B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.2.61 Tile
Erzeugt durch Wiederholung des gegebenen Tensors einen Tensor, wie NumPy tile, jedoch ohne Broadcasting.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.2.62 Transpose
Transponiert den Eingabetensor.
Eingaben
- X:T1
- shape:[n1,c1,h1,w1]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n1,c1,h1,w1]
Ausgaben
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n2,c2,h2,w2]
Attribute
- perm, Reihenfolge der transponierten Achsen: Einschränkungen für unterschiedliche perm folgen (p=8192,q=2048).
- perm=[0,1,2,3]
- Uneingeschränkt
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.2.63 Sigmoid
Wendet y=1/(1+exp(‑x)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.64 Tanh
Berechnet den hyperbolischen Tangens jedes Eingabetensorelements.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.65 Softplus
Wendet Softplus elementweise an, y=ln(exp(x)+1).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.66 HardSigmoid
Wendet y=max(0,min(1,alpha*x+beta)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor, wobei
alpha=1/6,beta=0.5
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.67 HardSwish
Wendet HardSwish elementweise an: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), wobei alpha=1/6,beta=0.5.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.68 Elu
Wendet f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0 elementweise an, um den Ausgabetensor zu erzeugen; alpha=1.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.69 exSwish
Wendet die Sigmoid Linear Unit elementweise an. Swish heißt auch SiLU: y=x*sigmoid(x).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.70 exMish
Wendet mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.71 exGelu
Wendet y =x∗Φ(x) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor. Wenn Φ(x) auf tanh gesetzt ist,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.72 exSwooshR
Wendet die folgende Funktion aus https://arxiv.org/abs/2310.11230 elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
SwooshR(x)=log(1+exp(x-1))-0.08x-0.313261687
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.73 exSwooshL
Wendet die folgende Funktion aus https://arxiv.org/abs/2310.11230 elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
SwooshL(x)=log(1+exp(x-4))-0.08x-0.035
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.74 Where
Wählt Werte aus x_tensor oder y_tensor anhand von mask_tensor: Bei True wird der entsprechende x_tensor-Wert gewählt, sonst der y_tensor-Wert.
Eingaben
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- output:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.2.75 exGlu
Gated-Linear-Unit-Funktion; a ist die erste Hälfte der Eingabematrix, b die zweite.
GLU(a,b)=a⊗σ(b)
Eingaben
- Input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Output:T1
- shape:[batch,channel/2,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int(Standardwert=1)
- Dimension, entlang der die Eingabe geteilt wird.
- Einschränkung: nur 1 unterstützt.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.76 exMatMul
Matrixmultiplikation
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Eingaben
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Quantisierungsunterstützung
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- Y:T1
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Attribute
- c_type:strings(Standardwert “add”)
- add oder mul legt fest, ob C addiert oder multipliziert wird.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.2.77 exNorm
Normalisiert Eingabedaten. Derzeit werden LayerNormlization, RMSNormlization und MeanVarianceNormalization unterstützt:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Dabei ist x der Eingabevektor. µ und σ2 sind Mittelwert und Varianz des Eingabevektors:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS ist der quadratische Mittelwert des Eingabevektors:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance ist die äquivalente Varianz des Eingabevektors:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ ist ein kleiner Wert zur Vermeidung einer Division durch null. W und B sind optionale Parameter.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- epsilon:float(Standardwert 1e‑05)
- epsilon-Wert zur Vermeidung einer Division durch 0.
- mode:string
- Drei Normalization-Modi sind wählbar: layer, rms und mean_var.
- axes:int64[](Standardwert [1])
- Normalisierungsachsen: derzeit nur [1] und [1,2,3] unterstützt.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.2.78 exSDPAttention
Berechnet skalierte Skalarprodukt-Aufmerksamkeit (SDPA) zwischen query, key und value.
Eingaben
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- scale(optional):T3
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.2.79 exWindow
exWindow stammt von window_partition und window_reverse aus swin_transformer. In der Originalarbeit werden Eingabemerkmale in nicht überlappende Fenster der Größe window_size×window_size aufgeteilt. Ein- und Ausgabemerkmale müssen eine 4-dimensionale shape haben und in Höhe und Breite aufgeteilt werden. Die PyTorch-Implementierung folgt:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Eingaben
- X:T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- mode:string
- Unterstützte Modi:partition,reverse,partition_num_first.
- partition: siehe Implementierung von window_partition.
- reverse: siehe Implementierung von window_reverse.
- partition_num_first unterscheidet sich von partition dadurch, dass H,W nach num_windows aufgeteilt werden; partition teilt H,W dagegen nach window_sizes auf.
- Unterstützte Modi:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-dimensionaler Vektor der Fenstergröße, der Höhe und Breite jedes Fensters festlegt. Auf dieser Größe beruhen Aufmerksamkeitsberechnung und Merkmalsextraktion innerhalb des Fensters.
- num_windows:listofints
- 2-dimensionaler Vektor der Fensteranzahl; legt fest, in wie viele Fenster Höhe und Breite der Eingabemerkmale geteilt werden.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.3 RK3562
3.3.1 Add
Führt elementweise binäre Addition (C=A+B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.3.2 AddRelu
Fusionierte Berechnung von Add und Relu, C=Relu(A+B).
Eingaben
- Wie bei Add.
Ausgaben
- Wie bei Add.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.3.3 BatchNormalization
Führt Batch-Normalisierung des Eingabetensors gemäß https://arxiv.org/abs/1502.03167 aus.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- epsilon:float (Standardwert=1e‑5)
- Reeller Wert, der beim Teilen durch die Standardabweichung eine Division durch 0 verhindert.
- epsilon∈(0,∞]
- momentum:float
- Parameter des gleitenden Mittelwerts beim Training.
3.3.4 Concat
Verknüpft eine Folge von Vektoren entlang axis zu einem Vektor. Alle Dimensionen außer axis müssen übereinstimmen.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axisint64
- axis∈{0,1,2,3}
3.3.5 Convolution
Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.6 DepthwiseConvolution
Tiefenseparierbare Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.7 ConvolutionRelu
Fusionierte Berechnung von Convolution und Relu, Output=Relu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.8 ConvolutionClip
Fusionierte Berechnung von Convolution und Clip, Output=Clip(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.9 ConvolutionPRelu/LeakyRelu
Fusionierte Berechnung von Convolution und PRelu/LeakyRelu, Output = PRelu(Conv(Input)) oder Output =
LeakyRelu(Conv(Input))
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.10 ConvolutionAdd
Fusionierte Berechnung von Convolution und Add, Output=Add(Conv(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.11 ConvolutionSigmoid
Fusionierte Berechnung von Convolution und Sigmoid, Output=Sigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.12 ConvolutionTanh
Fusionierte Berechnung von Convolution und Tanh, Output=Tanh(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.13 ConvolutionSoftplus
Fusionierte Berechnung von Convolution und Softplus, Output=Softplus(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.14 ConvolutionHardSigmoid
Fusionierte Berechnung von Convolution und HardSigmoid, Output=HardSigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.15 ConvolutionHardSwish
Fusionierte Berechnung von Convolution und HardSwish, Output=HardSwish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.16 ConvolutionElu
Fusionierte Berechnung von Convolution und Elu, Output=Elu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.17 ConvolutionSwish
Fusionierte Berechnung von Convolution und Swish, Output=Swish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.18 ConvolutionMish
Fusionierte Berechnung von Convolution und Mish, Output=Mish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.19 ConvolutionAddRelu
Fusionierte Berechnung von Convolution, Add und Relu, Output=Relu(Add(Conv(Input0),Input1)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.3.20 ConvTranspose
Transponierte Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzlich unterliegt die Eingabe der ersten Schicht
- shape:[batch,channel,height,width]
width unterliegt Einschränkungen; siehe Modelleingaben.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). Bei pad sind folgende Fälle nicht unterstützt: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: nur 1 wird unterstützt; num_output ist genau dann unterstützt, wenn num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Bei dilation ungleich (1,1) wird nur kernel=(1,1) unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.21 ConvTranposeRelu
Fusionierte Berechnung von ConvTranpose und Relu, Output=Relu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.22 ConvTranposeClip
Fusionierte Berechnung von ConvTranpose und Clip, Output=Clip(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.23 ConvTranposePRelu/LeakyRelu
Fusionierte Berechnung von ConvTranpose und PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) oder Output=
LeakyRelu(ConvTranpose(Input))
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.24 ConvTranposeAdd
Fusionierte Berechnung von ConvTranpose und Add, Output=Add(ConvTranpose(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.25 ConvTranposeSigmoid
Fusionierte Berechnung von ConvTranpose und Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.26 ConvTranposeTanh
Fusionierte Berechnung von ConvTranpose und Tanh, Output=Tanh(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.27 ConvTranposeSoftplus
Fusionierte Berechnung von ConvTranpose und Softplus, Output=Softplus(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.28 ConvTranposeHardSigmoid
Fusionierte Berechnung von ConvTranpose und HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.3.29 ConvTranposeHardSwish
Fusionierte Berechnung von ConvTranpose und HardSwish, Output=HardSwish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.30 ConvTranposeElu
Fusionierte Berechnung von ConvTranpose und Elu, Output=Elu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.31 ConvTranposeSwish
Fusionierte Berechnung von ConvTranpose und Swish, Output=Swish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.32 ConvTranposeMish
Fusionierte Berechnung von ConvTranpose und Mish, Output=Mish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.3.33 Div
Führt elementweise binäre Division (C=A/B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.3.34 Expand
Eingaben
- input1:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Broadcasting-Einschränkungen
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.3.35 GRU
Gated Recurrent Unit (GRU). Erweiterungen und Varianten heißen exGRU; mit (extern) markierte Parameter sind exGRU vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- linear_before_reset:int
- Auswahl der LBR-Variante:1(T)or0(F).
- direction(extern):string
- Legt die Berechnungsrichtung von GRU fest.
- forward: GRU in Vorwärtsrichtung.
- reverse: GRU in Rückwärtsrichtung.
- bidirectional: GRU in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der GRU-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der GRU-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.36 Gather
Wählt anhand von Indices Einträge aus X entlang der angegebenen axis aus und verknüpft sie.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Indices:T2
- Indizes der zu sammelnden Elemente; rank =1.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Attribute
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Legt die durch Indices adressierte Eingabedimension fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.3.37 Hardmax
Ausgaben
- input:T1
- shape:[batch,channel,height,width]
axis=1,height∗width<16384;
- axis=3/‑1,channel∗height<16384; zusätzlich gelten die Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- hardmax-Achse:1,3/‑1, entsprechend channel und width.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.3.38 LSTM
Long Short-Term Memory (LSTM). Erweiterungen und Varianten heißen exLSTM; mit (extern) markierte Parameter sind exLSTM vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T2
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T2
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T2(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- direction(extern):string
- Legt die Berechnungsrichtung von LSTM fest.
- forward: LSTM in Vorwärtsrichtung.
- reverse: LSTM in Rückwärtsrichtung.
- bidirectional: LSTM in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der LSTM-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der LSTM-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- proj_size(extern):int
- proj_size bei projection; projsize∈[0,hiddensize].
- Derzeit auf 0 beschränkt; projection wird noch nicht unterstützt.
- input_forget(extern):int
- Auswahl der cifg-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- has_projection(extern):int
- projection-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.39 Max
Berechnet das elementweise Maximum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.40 Mul
Führt elementweise binäre Multiplikation (C=A*B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.3.41 MulRelu
Fusionierte Berechnung von Mul und Relu,C=Relu(A*B).
Eingaben
- Wie bei Mul.
Ausgaben
- Wie bei Mul.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.3.42 Pad
Erzeugt aus Datentensor (data), Tensor der Auffüllwerte an Achsenanfang und -ende (pads), Modus (mode) und konstantem Wert (constant_value) einen aufgefüllten Tensor (output).
Eingaben
- data:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Attribute
- mode:string (Standardwert constant)
- Unterstützte Modi: constant,reflect.
- constant: uneingeschränkt.
- Unterstützte Modi: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.3.43 MaxPool
MaxPool verarbeitet Eingabetensor X und wendet Max-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Für durch den Kernel bestimmte Teilmengen wird das Maximum berechnet und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64[]
- Bevorzugte Speicherreihenfolge:0.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.44 GlobalMaxPool
GlobalMaxPool wendet Max-Pooling auf die Werte jedes Kanals von Eingabetensor X an. Dies entspricht MaxPool mit kernel_shape gleich den räumlichen Dimensionen von input.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.45 AveragePool
AveragePool verarbeitet Eingabetensor X und wendet Average-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Alle Werte der durch den Kernel bestimmten Teilmengen werden gemittelt und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.46 GlobalAveragePool
GlobalAveragePool mittelt die Werte jedes Kanals von Eingabetensor X. Dies entspricht AveragePool mit kernel_shape gleich den räumlichen Dimensionen des Eingabetensors.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.3.47 Pow
Z =XY
Potenzierung: verarbeitet Eingabedaten (Tensor) und einen Exponenten zu Ausgabedaten (Tensor).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Y:T2
- shape:[1]
- Derzeit nur 0,1,2,3,0.5,‑0.5 unterstützt.
- shape:[1]
Ausgaben
- Z:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.3.48 Relu
Setzt negative Eingabetensorwerte auf null; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.49 Clip/ReLU6
Begrenzt Eingabetensorwerte auf [0,6].
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.50 PRelu
Skaliert negative Eingabetensorwerte mit einem lernbaren Parameter; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Attribute
- slope: PRelu-Koeffizient.
- Nur ein einzelner Skalar oder Koeffizienten entlang der C-Dimension werden unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.51 LeakyRelu
Skaliert negative Eingabetensorwerte mit einem festen Faktor; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.52 Reshape
Liefert einen Tensor der angegebenen Form ohne Änderung der Eingabedaten oder Elementanzahl.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- shape:int
- Legt die Form des Ausgabetensors fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.3.53 Resize
Ändert die Größe des Eingabetensors. Im Allgemeinen wird jeder Ausgabewert als gewichteter Mittelwert einer Nachbarschaft (Abtastpositionen) im Eingabetensor berechnet.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- roi(optional):T2
- Derzeit nicht unterstützt.
- scales(optional):T2
- Array der Skalierungsfaktoren je Dimension.
- sizes(optional):T3
- Zielgröße des Ausgabetensors.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Attribute
- antialias:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- axes:int[]
- Die Einstellung wird derzeit nicht unterstützt.
- coordinate_transformation_mode:strings (Standardwert ”half_pixel”)
- Derzeit werden nur half_pixel, pytorch_half_pixel und align_corners unterstützt.
- cubic_coeff_a:float (Standardwert ‑0.75)
- Die Einstellung wird derzeit nicht unterstützt.
- exclude_outside:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- extrapolation_value:float (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- keep_aspect_ratio_policy:strings (Standardwert ”stretch”)
- Die Einstellung wird derzeit nicht unterstützt.
- mode:strings (Standardwert ”nearest”)
- Derzeit sind nur nearest und linear konfigurierbar.
- nearest_mode:strings (Standardwert ”round_prefer_floor”)
- Die Einstellung wird derzeit nicht unterstützt.
Unterstützung: derzeit nur ganzzahlige Skalierung in Breite und Höhe mit ganzzahligen Faktoren 2‑8. Eine Eingabe (1,c,1,1) kann auf (1,c,h,w) vergrößert werden.
3.3.54 Slice
Erzeugt einen Ausschnitt des aktuellen Vektors nach den Regeln von NumPy-Slicing.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- starts:int(Tensor)
- Startposition des Ausschnitts: uneingeschränkt.
- ends:int(Tensor)
- Endposition des Ausschnitts: uneingeschränkt.
- axes:int(Tensor)
- Auswahl der Slice-Achsen: beliebige Achsen 0~3, auch mehrere gleichzeitig.
- steps:int(Tensor)
- Legt die Schrittweite entlang der jeweiligen Slice-Achse fest.
- Bei height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc darf steps von 1 abweichen. Andernfalls läuft SliceOP nur bei steps==[1,1,1,1] auf der NPU.
3.3.55 Softmax
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- softmax-Achse:1,3, entsprechend channel und width.
3.3.56 exSoftmax13
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
3.3.57 exSoftmaxMask
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, uneingeschränkt;
· axis=3/‑1,width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
- mask_value:int64
- Zu maskierende Werte:0,1.
3.3.58 Split
Teilt den Vektor entlang axis in num_outputs Vektoren; split legt deren Größen entlang axis fest.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- Ein oder mehrere Ausgabevektoren, bestimmt durch num_outputs.
- shape: durch die Aufteilung bestimmt.
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.3.59 Sub
- Führt elementweise binäre Subtraktion (C=A‑B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
3.3.60 Tile
Erzeugt durch Wiederholung des gegebenen Tensors einen Tensor, wie NumPy tile, jedoch ohne Broadcasting.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.3.61 Transpose
Transponiert den Eingabetensor.
Eingaben
- X:T1
- shape:[n1,c1,h1,w1]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n1,c1,h1,w1]
Ausgaben
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n2,c2,h2,w2]
Attribute
- perm, Reihenfolge der transponierten Achsen: Einschränkungen für unterschiedliche perm folgen (p=268435456,q=65536).
- perm=[0,1,2,3]
- Uneingeschränkt
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.3.62 Sigmoid
Wendet y=1/(1+exp(‑x)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.63 Tanh
Berechnet den hyperbolischen Tangens jedes Eingabetensorelements.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.64 Softplus
Wendet Softplus elementweise an, y=ln(exp(x)+1).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.65 HardSigmoid
Wendet y=max(0,min(1,alpha*x+beta)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor, wobei
alpha=1/6,beta=0.5
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.66 HardSwish
Wendet HardSwish elementweise an: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), wobei alpha=1/6,beta=0.5.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.67 Elu
Wendet f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0 elementweise an, um den Ausgabetensor zu erzeugen; alpha=1.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.68 exSwish
Wendet die Sigmoid Linear Unit elementweise an. Swish heißt auch SiLU: y=x*sigmoid(x).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.69 exMish
Wendet mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.70 exGelu
Wendet y =x∗Φ(x) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor. Wenn Φ(x) auf tanh gesetzt ist,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.3.71 Where
Wählt Werte aus x_tensor oder y_tensor anhand von mask_tensor: Bei True wird der entsprechende x_tensor-Wert gewählt, sonst der y_tensor-Wert.
Eingaben
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- output:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.3.72 exGlu
Gated-Linear-Unit-Funktion; a ist die erste Hälfte der Eingabematrix, b die zweite.
GLU(a,b)=a⊗σ(b)
Eingaben
- Input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Output:T1
- shape:[batch,channel/2,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int(Standardwert=1)
- Dimension, entlang der die Eingabe geteilt wird.
- Einschränkung: nur 1 unterstützt.
3.3.73 exMatMul
Matrixmultiplikation
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Eingaben
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Quantisierungsunterstützung
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- Y:T1
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Attribute
- c_type:strings(Standardwert “add”)
- add oder mul legt fest, ob C addiert oder multipliziert wird.
3.3.74 exNorm
Normalisiert Eingabedaten. Derzeit werden LayerNormlization, RMSNormlization und MeanVarianceNormalization unterstützt:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Dabei ist x der Eingabevektor. µ und σ2 sind Mittelwert und Varianz des Eingabevektors:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS ist der quadratische Mittelwert des Eingabevektors:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance ist die äquivalente Varianz des Eingabevektors:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ ist ein kleiner Wert zur Vermeidung einer Division durch null. W und B sind optionale Parameter.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- epsilon:float(Standardwert 1e‑05)
- epsilon-Wert zur Vermeidung einer Division durch 0.
- mode:string
- Drei Normalization-Modi sind wählbar: layer, rms und mean_var.
- axes:int64[](Standardwert [1])
- Normalisierungsachsen: derzeit nur [1] und [1,2,3] unterstützt.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.3.75 exSDPAttention
Berechnet skalierte Skalarprodukt-Aufmerksamkeit (SDPA) zwischen query, key und value.
Eingaben
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Standardmäßig wird Broadcasting entlang beliebiger Dimensionen unterstützt.
- Bei aktiviertem FA werden nur [b,c,1,1],[1,c,1,1] und [1,c,h,w] unterstützt.
- scale(optional):T3
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- FlashAttentionV2(FA): unterstützt.
- Basiert auf https://arxiv.org/abs/2307.08691. Innere Schleifen im Cache beschleunigen die Ausführung und reduzieren die Bandbreitennutzung, vergrößern aber das Modell. Je nach Szenario und Modell über die Aktivierung entscheiden.
- RKNPU-Treiberversion>=0.8.8
- Version der RKNPU-Runtime-Bibliothek (librknnrt.so)>=2.0.0
- Unterstützter Datentyp:float16.
3.3.76 exWindow
exWindow stammt von window_partition und window_reverse aus swin_transformer. In der Originalarbeit werden Eingabemerkmale in nicht überlappende Fenster der Größe window_size×window_size aufgeteilt. Ein- und Ausgabemerkmale müssen eine 4-dimensionale shape haben und in Höhe und Breite aufgeteilt werden. Die PyTorch-Implementierung folgt:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Eingaben
- X:T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- mode:string
- Unterstützte Modi:partition,reverse,partition_num_first.
- partition: siehe Implementierung von window_partition.
- reverse: siehe Implementierung von window_reverse.
- partition_num_first unterscheidet sich von partition dadurch, dass H,W nach num_windows aufgeteilt werden; partition teilt H,W dagegen nach window_sizes auf.
- Unterstützte Modi:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-dimensionaler Vektor der Fenstergröße, der Höhe und Breite jedes Fensters festlegt. Auf dieser Größe beruhen Aufmerksamkeitsberechnung und Merkmalsextraktion innerhalb des Fensters.
- num_windows:listofints
- 2-dimensionaler Vektor der Fensteranzahl; legt fest, in wie viele Fenster Höhe und Breite der Eingabemerkmale geteilt werden.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.4 RV1103/RV1106
3.4.1 Add
Führt elementweise binäre Addition (C=A+B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(constTensor)
3.4.2 AddRelu
Fusionierte Berechnung von Add und Relu, C=Relu(A+B).
Eingaben
- Wie bei Add.
Ausgaben
- Wie bei Add.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.4.3 BatchNormalization
Führt Batch-Normalisierung des Eingabetensors gemäß https://arxiv.org/abs/1502.03167 aus.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- epsilon:float (Standardwert=1e‑5)
- Reeller Wert, der beim Teilen durch die Standardabweichung eine Division durch 0 verhindert.
- epsilon∈(0,∞]
- momentum:float
- Parameter des gleitenden Mittelwerts beim Training.
3.4.4 Concat
Verknüpft eine Folge von Vektoren entlang axis zu einem Vektor. Alle Dimensionen außer axis müssen übereinstimmen.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axisint64
- axis∈{0,1,2,3}
3.4.5 Convolution
Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Datentypbeschränkungen
- T1:int8(Tensor)
3.4.6 DepthwiseConvolution
Tiefenseparierbare Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:int8(Tensor)
3.4.7 ConvolutionRelu
Fusionierte Berechnung von Convolution und Relu, Output=Relu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.8 ConvolutionClip
Fusionierte Berechnung von Convolution und Clip, Output=Clip(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.9 ConvolutionPRelu/LeakyRelu
Fusionierte Berechnung von Convolution und PRelu/LeakyRelu, Output = PRelu(Conv(Input)) oder Output =
LeakyRelu(Conv(Input))
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.10 ConvolutionAdd
Fusionierte Berechnung von Convolution und Add, Output=Add(Conv(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.11 ConvolutionSigmoid
Fusionierte Berechnung von Convolution und Sigmoid, Output=Sigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.12 ConvolutionTanh
Fusionierte Berechnung von Convolution und Tanh, Output=Tanh(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.13 ConvolutionSoftplus
Fusionierte Berechnung von Convolution und Softplus, Output=Softplus(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.14 ConvolutionHardSigmoid
Fusionierte Berechnung von Convolution und HardSigmoid, Output=HardSigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.15 ConvolutionHardSwish
Fusionierte Berechnung von Convolution und HardSwish, Output=HardSwish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.16 ConvolutionElu
Fusionierte Berechnung von Convolution und Elu, Output=Elu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.17 ConvolutionSwish
Fusionierte Berechnung von Convolution und Swish, Output=Swish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.18 ConvolutionMish
Fusionierte Berechnung von Convolution und Mish, Output=Mish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.19 ConvolutionAddRelu
Fusionierte Berechnung von Convolution, Add und Relu, Output=Relu(Add(Conv(Input0),Input1)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.4.20 ConvTranspose
Transponierte Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzlich unterliegt die Eingabe der ersten Schicht
- shape:[batch,channel,height,width]
width unterliegt Einschränkungen; siehe Modelleingaben.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). Bei pad sind folgende Fälle nicht unterstützt: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: nur 1 wird unterstützt; num_output ist genau dann unterstützt, wenn num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Bei dilation ungleich (1,1) wird nur kernel=(1,1) unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor)
3.4.21 ConvTranposeRelu
Fusionierte Berechnung von ConvTranpose und Relu, Output=Relu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.22 ConvTranposeClip
Fusionierte Berechnung von ConvTranpose und Clip, Output=Clip(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.23 ConvTranposePRelu/LeakyRelu
Fusionierte Berechnung von ConvTranpose und PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) oder Output=
LeakyRelu(ConvTranpose(Input))
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.24 ConvTranposeAdd
Fusionierte Berechnung von ConvTranpose und Add, Output=Add(ConvTranpose(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.25 ConvTranposeSigmoid
Fusionierte Berechnung von ConvTranpose und Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.26 ConvTranposeTanh
Fusionierte Berechnung von ConvTranpose und Tanh, Output=Tanh(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.27 ConvTranposeSoftplus
Fusionierte Berechnung von ConvTranpose und Softplus, Output=Softplus(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.28 ConvTranposeHardSigmoid
Fusionierte Berechnung von ConvTranpose und HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
3.4.29 ConvTranposeHardSwish
Fusionierte Berechnung von ConvTranpose und HardSwish, Output=HardSwish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.30 ConvTranposeElu
Fusionierte Berechnung von ConvTranpose und Elu, Output=Elu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.31 ConvTranposeSwish
Fusionierte Berechnung von ConvTranpose und Swish, Output=Swish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.32 ConvTranposeMish
Fusionierte Berechnung von ConvTranpose und Mish, Output=Mish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.4.33 Div
Führt elementweise binäre Division (C=A/B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.4.34 Expand
Erweitert den Eingabetensor anhand von shape und Broadcasting-Regeln, ähnlich numpy.array(input) *numpy.ones(shape): Dimensionen werden rechtsbündig ausgerichtet; korrespondierende Dimensionen müssen gleich sein oder eine davon muss 1 sein.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int64(Tensor)
Broadcasting-Einschränkungen
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.4.35 Hardmax
Ausgaben
- input:T1
- shape:[batch,channel,height,width]
channel∗height∗width<=8192
- axis=1,height∗width<16384, und height∗width ist gleich 1 oder größer als 8;
- axis=3/‑1,channel ∗ height < 16384, und channel ∗ height ist gleich 1 oder größer als 8; zusätzlich gelten tranpose-Grenzen.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- hardmax-Achse:1,3/‑1, entsprechend channel und width.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.4.36 LSTM
Long Short-Term Memory (LSTM). Erweiterungen und Varianten heißen exLSTM; mit (extern) markierte Parameter sind exLSTM vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- initial_c:T3(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- direction(extern):string
- Legt die Berechnungsrichtung von LSTM fest.
- forward: LSTM in Vorwärtsrichtung.
- reverse: LSTM in Rückwärtsrichtung.
- bidirectional: LSTM in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der LSTM-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der LSTM-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- proj_size(extern):int
- proj_size bei projection; projsize∈[0,hiddensize].
- Derzeit auf 0 beschränkt; projection wird noch nicht unterstützt.
- input_forget(extern):int
- Auswahl der cifg-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- has_projection(extern):int
- projection-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int32(Tensor)
- T3:int(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.37 Max
Berechnet das elementweise Maximum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.38 Min
Berechnet das elementweise Minimum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.39 Mul
Führt elementweise binäre Multiplikation (C=A*B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(constTensor)
3.4.40 MulRelu
Fusionierte Berechnung von Mul und Relu,C=Relu(A*B).
Eingaben
- Wie bei Mul.
Ausgaben
- Wie bei Mul.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.4.41 Pad
Erzeugt aus Datentensor (data), Tensor der Auffüllwerte an Achsenanfang und -ende (pads), Modus (mode) und konstantem Wert (constant_value) einen aufgefüllten Tensor (output).
Eingaben
- data:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Attribute
- mode:string (Standardwert constant)
- Unterstützte Modi: constant,reflect.
- constant: uneingeschränkt.
- Unterstützte Modi: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.4.42 MaxPool
MaxPool verarbeitet Eingabetensor X und wendet Max-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Für durch den Kernel bestimmte Teilmengen wird das Maximum berechnet und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64[]
- Bevorzugte Speicherreihenfolge:0.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.43 GlobalMaxPool
GlobalMaxPool wendet Max-Pooling auf die Werte jedes Kanals von Eingabetensor X an. Dies entspricht MaxPool mit kernel_shape gleich den räumlichen Dimensionen von input.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.44 AveragePool
AveragePool verarbeitet Eingabetensor X und wendet Average-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Alle Werte der durch den Kernel bestimmten Teilmengen werden gemittelt und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.45 GlobalAveragePool
GlobalAveragePool mittelt die Werte jedes Kanals von Eingabetensor X. Dies entspricht AveragePool mit kernel_shape gleich den räumlichen Dimensionen des Eingabetensors.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.46 Pow
Z =XY
Potenzierung: verarbeitet Eingabedaten (Tensor) und einen Exponenten zu Ausgabedaten (Tensor).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Y:T2
- shape:[1]
- Derzeit nur 0,1,2,3,0.5,‑0.5 unterstützt.
- shape:[1]
Ausgaben
- Z:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.4.47 Relu
Setzt negative Eingabetensorwerte auf null; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.48 Clip/ReLU6
Begrenzt Eingabetensorwerte auf [0,6].
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.49 PRelu
Skaliert negative Eingabetensorwerte mit einem lernbaren Parameter; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Attribute
- slope: PRelu-Koeffizient.
- Nur ein einzelner Skalar oder Koeffizienten entlang der C-Dimension werden unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.50 LeakyRelu
Skaliert negative Eingabetensorwerte mit einem festen Faktor; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.51 Reshape
Liefert einen Tensor der angegebenen Form ohne Änderung der Eingabedaten oder Elementanzahl.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- shape:int
- Legt die Form des Ausgabetensors fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.4.52 Resize
Ändert die Größe des Eingabetensors. Im Allgemeinen wird jeder Ausgabewert als gewichteter Mittelwert einer Nachbarschaft (Abtastpositionen) im Eingabetensor berechnet.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- roi(optional):T2
- Derzeit nicht unterstützt.
- scales(optional):T2
- Array der Skalierungsfaktoren je Dimension.
- sizes(optional):T3
- Zielgröße des Ausgabetensors.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Attribute
- antialias:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- axes:int[]
- Die Einstellung wird derzeit nicht unterstützt.
- coordinate_transformation_mode:strings (Standardwert ”half_pixel”)
- Derzeit werden nur half_pixel, pytorch_half_pixel und align_corners unterstützt.
- cubic_coeff_a:float (Standardwert ‑0.75)
- Die Einstellung wird derzeit nicht unterstützt.
- exclude_outside:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- extrapolation_value:float (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- keep_aspect_ratio_policy:strings (Standardwert ”stretch”)
- Die Einstellung wird derzeit nicht unterstützt.
- mode:strings (Standardwert ”nearest”)
- Derzeit sind nur nearest und linear konfigurierbar.
- nearest_mode:strings (Standardwert ”round_prefer_floor”)
- Die Einstellung wird derzeit nicht unterstützt.
Unterstützung: derzeit nur ganzzahlige Skalierung in Breite und Höhe mit ganzzahligen Faktoren 2‑8. Eine Eingabe (1,c,1,1) kann auf (1,c,h,w) vergrößert werden.
3.4.53 Slice
Erzeugt einen Ausschnitt des aktuellen Vektors nach den Regeln von NumPy-Slicing.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- starts:int(Tensor)
- Startposition des Ausschnitts: uneingeschränkt.
- ends:int(Tensor)
- Endposition des Ausschnitts: uneingeschränkt.
- axes:int(Tensor)
- Auswahl der Slice-Achsen: beliebige Achsen 0~3, auch mehrere gleichzeitig.
- steps:int(Tensor)
- Legt die Schrittweite entlang der jeweiligen Slice-Achse fest.
- Bei height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc darf steps von 1 abweichen. Andernfalls läuft SliceOP nur bei steps==[1,1,1,1] auf der NPU.
3.4.54 Softmax
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- softmax-Achse:1,3, entsprechend channel und width.
3.4.55 exSoftmax13
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
3.4.56 exSoftmaxMask
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, uneingeschränkt;
· axis=3/‑1,width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
- mask_value:int64
- Zu maskierende Werte:0,1.
3.4.57 Split
Teilt den Vektor entlang axis in num_outputs Vektoren; split legt deren Größen entlang axis fest.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- Ein oder mehrere Ausgabevektoren, bestimmt durch num_outputs.
- shape: durch die Aufteilung bestimmt.
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.4.58 Sub
- Führt elementweise binäre Subtraktion (C=A‑B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(constTensor)
3.4.59 Tile
Erzeugt durch Wiederholung des gegebenen Tensors einen Tensor, wie NumPy tile, jedoch ohne Broadcasting.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.4.60 Transpose
Transponiert den Eingabetensor.
Eingaben
- X:T1
- shape:[n1,c1,h1,w1]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n1,c1,h1,w1]
Ausgaben
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n2,c2,h2,w2]
Attribute
- perm, Reihenfolge der transponierten Achsen: Einschränkungen für unterschiedliche perm folgen (p=8192,q=2048).
- perm=[0,1,2,3]
- Uneingeschränkt
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.4.61 Sigmoid
Wendet y=1/(1+exp(‑x)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.62 Tanh
Berechnet den hyperbolischen Tangens jedes Eingabetensorelements.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.63 Softplus
Wendet Softplus elementweise an, y=ln(exp(x)+1).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.64 HardSigmoid
Wendet y=max(0,min(1,alpha*x+beta)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor, wobei
alpha=1/6,beta=0.5
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.65 HardSwish
Wendet HardSwish elementweise an: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), wobei alpha=1/6,beta=0.5.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.66 Elu
Wendet f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0 elementweise an, um den Ausgabetensor zu erzeugen; alpha=1.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.67 exSwish
Wendet die Sigmoid Linear Unit elementweise an. Swish heißt auch SiLU: y=x*sigmoid(x).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.68 exMish
Wendet mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.69 exGelu
Wendet y =x∗Φ(x) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor. Wenn Φ(x) auf tanh gesetzt ist,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
3.4.70 Where
Wählt Werte aus x_tensor oder y_tensor anhand von mask_tensor: Bei True wird der entsprechende x_tensor-Wert gewählt, sonst der y_tensor-Wert.
Eingaben
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- output:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.4.71 exGlu
Gated-Linear-Unit-Funktion; a ist die erste Hälfte der Eingabematrix, b die zweite.
GLU(a,b)=a⊗σ(b)
Eingaben
- Input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Output:T1
- shape:[batch,channel/2,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int(Standardwert=1)
- Dimension, entlang der die Eingabe geteilt wird.
- Einschränkung: nur 1 unterstützt.
3.4.72 exMatMul
Matrixmultiplikation
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Eingaben
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Quantisierungsunterstützung
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- Y:T1
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(Tensor)
Attribute
- c_type:strings(Standardwert “add”)
- add oder mul legt fest, ob C addiert oder multipliziert wird.
3.4.73 exSDPAttention
Berechnet skalierte Skalarprodukt-Aufmerksamkeit (SDPA) zwischen query, key und value.
Eingaben
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Standardmäßig wird Broadcasting entlang beliebiger Dimensionen unterstützt.
- scale(optional):T3
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.4.74 exWindow
exWindow stammt von window_partition und window_reverse aus swin_transformer. In der Originalarbeit werden Eingabemerkmale in nicht überlappende Fenster der Größe window_size×window_size aufgeteilt. Ein- und Ausgabemerkmale müssen eine 4-dimensionale shape haben und in Höhe und Breite aufgeteilt werden. Die PyTorch-Implementierung folgt:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Eingaben
- X:T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- mode:string
- Unterstützte Modi:partition,reverse,partition_num_first.
- partition: siehe Implementierung von window_partition.
- reverse: siehe Implementierung von window_reverse.
- partition_num_first unterscheidet sich von partition dadurch, dass H,W nach num_windows aufgeteilt werden; partition teilt H,W dagegen nach window_sizes auf.
- Unterstützte Modi:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-dimensionaler Vektor der Fenstergröße, der Höhe und Breite jedes Fensters festlegt. Auf dieser Größe beruhen Aufmerksamkeitsberechnung und Merkmalsextraktion innerhalb des Fensters.
- num_windows:listofints
- 2-dimensionaler Vektor der Fensteranzahl; legt fest, in wie viele Fenster Höhe und Breite der Eingabemerkmale geteilt werden.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5 RK3576/RV1126B
3.5.1 Add
Führt elementweise binäre Addition (C=A+B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.2 AddRelu
Fusionierte Berechnung von Add und Relu, C=Relu(A+B).
Eingaben
- Wie bei Add.
Ausgaben
- Wie bei Add.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.3 BatchNormalization
Führt Batch-Normalisierung des Eingabetensors gemäß https://arxiv.org/abs/1502.03167 aus.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- epsilon:float (Standardwert=1e‑5)
- Reeller Wert, der beim Teilen durch die Standardabweichung eine Division durch 0 verhindert.
- epsilon∈(0,∞]
- momentum:float
- Parameter des gleitenden Mittelwerts beim Training.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.4 Concat
Verknüpft eine Folge von Vektoren entlang axis zu einem Vektor. Alle Dimensionen außer axis müssen übereinstimmen.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axisint64
- axis∈{0,1,2,3}
3.5.5 Convolution
Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.6 DepthwiseConvolution
Tiefenseparierbare Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.7 ConvolutionRelu
Fusionierte Berechnung von Convolution und Relu, Output=Relu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.8 ConvolutionClip
Fusionierte Berechnung von Convolution und Clip, Output=Clip(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.9 ConvolutionPRelu/LeakyRelu
Fusionierte Berechnung von Convolution und PRelu/LeakyRelu, Output = PRelu(Conv(Input)) oder Output =
LeakyRelu(Conv(Input))
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.10 ConvolutionAdd
Fusionierte Berechnung von Convolution und Add, Output=Add(Conv(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.11 ConvolutionSigmoid
Fusionierte Berechnung von Convolution und Sigmoid, Output=Sigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.12 ConvolutionTanh
Fusionierte Berechnung von Convolution und Tanh, Output=Tanh(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.13 ConvolutionSoftplus
Fusionierte Berechnung von Convolution und Softplus, Output=Softplus(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.14 ConvolutionHardSigmoid
Fusionierte Berechnung von Convolution und HardSigmoid, Output=HardSigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.15 ConvolutionHardSwish
Fusionierte Berechnung von Convolution und HardSwish, Output=HardSwish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.16 ConvolutionElu
Fusionierte Berechnung von Convolution und Elu, Output=Elu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.17 ConvolutionSwish
Fusionierte Berechnung von Convolution und Swish, Output=Swish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.18 ConvolutionMish
Fusionierte Berechnung von Convolution und Mish, Output=Mish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.19 ConvolutionAddRelu
Fusionierte Berechnung von Convolution, Add und Relu, Output=Relu(Add(Conv(Input0),Input1)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.20 ConvTranspose
Transponierte Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). Bei pad sind folgende Fälle nicht unterstützt: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: nur 1 wird unterstützt; num_output ist genau dann unterstützt, wenn num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Bei dilation ungleich (1,1) wird nur kernel=(1,1) unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.21 ConvTranposeRelu
Fusionierte Berechnung von ConvTranpose und Relu, Output=Relu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.22 ConvTranposeClip
Fusionierte Berechnung von ConvTranpose und Clip, Output=Clip(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.23 ConvTranposePRelu/LeakyRelu
Fusionierte Berechnung von ConvTranpose und PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) oder Output=
LeakyRelu(ConvTranpose(Input))
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.24 ConvTranposeAdd
Fusionierte Berechnung von ConvTranpose und Add, Output=Add(ConvTranpose(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.25 ConvTranposeSigmoid
Fusionierte Berechnung von ConvTranpose und Sigmoid, Output=Sigmoid(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.26 ConvTranposeTanh
Fusionierte Berechnung von ConvTranpose und Tanh, Output=Tanh(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.27 ConvTranposeSoftplus
Fusionierte Berechnung von ConvTranpose und Softplus, Output=Softplus(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.28 ConvTranposeHardSigmoid
Fusionierte Berechnung von ConvTranpose und HardSigmoid, Output=HardSigmoid(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.29 ConvTranposeHardSwish
Fusionierte Berechnung von ConvTranpose und HardSwish, Output=HardSwish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.30 ConvTranposeElu
Fusionierte Berechnung von ConvTranpose und Elu, Output=Elu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.31 ConvTranposeSwish
Fusionierte Berechnung von ConvTranpose und Swish, Output=Swish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.32 ConvTranposeMish
Fusionierte Berechnung von ConvTranpose und Mish, Output=Mish(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.5.33 Div
Führt elementweise binäre Division (C=A/B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.5.34 Expand
Erweitert den Eingabetensor anhand von shape und Broadcasting-Regeln, ähnlich numpy.array(input) *numpy.ones(shape): Dimensionen werden rechtsbündig ausgerichtet; korrespondierende Dimensionen müssen gleich sein oder eine davon muss 1 sein.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Broadcasting-Einschränkungen
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.5.35 GRU
Gated Recurrent Unit (GRU). Erweiterungen und Varianten heißen exGRU; mit (extern) markierte Parameter sind exGRU vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh
r_t = f(x_t · W_r + h_{t-1} · R_r + Wb_r + Rb_r)
z_t = f(x_t · W_z + h_{t-1} · R_z + Wb_z + Rb_z)
h_t = g(x_t · W_h + (r_t ⊙ h_{t-1}) · R_h + Rb_h + Wb_h), (WRB = 0)
h_t = g(x_t · W_h + r_t ⊙ (h_{t-1} · R_h + Rb_h)) + Wb_h, (WRB = 1)
H_t = (1-z_t) ⊙ h_t + z_t ⊙ h_{t-1}
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- linear_before_reset:int
- Auswahl der LBR-Variante:1(T)or0(F).
- direction(extern):string
- Legt die Berechnungsrichtung von GRU fest.
- forward: GRU in Vorwärtsrichtung.
- reverse: GRU in Rückwärtsrichtung.
- bidirectional: GRU in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der GRU-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der GRU-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.36 Gather
Wählt anhand von Indices Einträge aus X entlang der angegebenen axis aus und verknüpft sie.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Indices:T2
- Indizes der zu sammelnden Elemente; rank =1.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int(Tensor)
Attribute
- axis:int(Tensor)
- axis∈{0,1,2,3}
- Legt die durch Indices adressierte Eingabedimension fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.37 Hardmax
Berechnet die hardmax-Aktivierung der Eingabe gemäß ONNX Hardmax‑13.
Hardmax(input, axis) =
  1   if i = argmax(input, axis)
  0   otherwise
Eingaben
- input:T
- shape:[batch,channel,height,width]; bei axis=1 gilt height∗width∈[1,16384);
- Bei axis=3/‑1 gilt channel∗height∈[1,16384); zusätzlich gelten tranpose-Grenzen.
- shape:[batch,channel,height,width]; bei axis=1 gilt height∗width∈[1,16384);
Ausgaben
- output:T
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- hardmax-Achse:axis∈{−1,1,3}, entsprechend channel und width.
3.5.38 LSTM
Long Short-Term Memory (LSTM). Erweiterungen und Varianten heißen exLSTM; mit (extern) markierte Parameter sind exLSTM vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2,T3
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T4,T5(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- direction(extern):string
- Legt die Berechnungsrichtung von LSTM fest.
- forward: LSTM in Vorwärtsrichtung.
- reverse: LSTM in Rückwärtsrichtung.
- bidirectional: LSTM in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der LSTM-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der LSTM-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- proj_size(extern):int
- proj_size bei projection; projsize∈[0,hiddensize].
- Derzeit auf 0 beschränkt; projection wird noch nicht unterstützt.
- input_forget(extern):int
- Auswahl der cifg-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- has_projection(extern):int
- projection-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int32(Tensor)
- T4:float(Scalar)
- T5:int(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.39 Max
Berechnet das elementweise Maximum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.40 Greater
Berechnet Greater für die Eingabetensoren A und B.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.41 Min
Berechnet das elementweise Minimum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.42 Mul
Führt elementweise binäre Multiplikation (C=A*B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.43 MulRelu
Fusionierte Berechnung von Mul und Relu,C=Relu(A*B).
Eingaben
- Wie bei Mul.
Ausgaben
- Wie bei Mul.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
3.5.44 Pad
Erzeugt aus Datentensor (data), Tensor der Auffüllwerte an Achsenanfang und -ende (pads), Modus (mode) und konstantem Wert (constant_value) einen aufgefüllten Tensor (output).
Eingaben
- data:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Attribute
- mode:string (Standardwert constant)
- Unterstützte Modi: constant,reflect.
- constant: uneingeschränkt.
- Unterstützte Modi: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.45 MaxPool
MaxPool verarbeitet Eingabetensor X und wendet Max-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Für durch den Kernel bestimmte Teilmengen wird das Maximum berechnet und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
- storage_order:int64[]
- Bevorzugte Speicherreihenfolge:0.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.46 GlobalMaxPool
GlobalMaxPool wendet Max-Pooling auf die Werte jedes Kanals von Eingabetensor X an. Dies entspricht MaxPool mit kernel_shape gleich den räumlichen Dimensionen von input.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.47 AveragePool
AveragePool verarbeitet Eingabetensor X und wendet Average-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Alle Werte der durch den Kernel bestimmten Teilmengen werden gemittelt und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.48 GlobalAveragePool
GlobalAveragePool mittelt die Werte jedes Kanals von Eingabetensor X. Dies entspricht AveragePool mit kernel_shape gleich den räumlichen Dimensionen des Eingabetensors.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(1,7]
width∈(1,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.5.49 Pow
Z =XY
Potenzierung: verarbeitet Eingabedaten (Tensor) und einen Exponenten zu Ausgabedaten (Tensor).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Y:T2
- shape:[1]
- Derzeit nur 0,1,2,3,0.5,‑0.5 unterstützt.
- shape:[1]
Ausgaben
- Z:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.50 Relu
Setzt negative Eingabetensorwerte auf null; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.51 Clip/ReLU6
Begrenzt Eingabetensorwerte auf [0,6].
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.52 PRelu
Skaliert negative Eingabetensorwerte mit einem lernbaren Parameter; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Attribute
- slope: PRelu-Koeffizient.
- Nur ein einzelner Skalar oder Koeffizienten entlang der C-Dimension werden unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.53 LeakyRelu
Skaliert negative Eingabetensorwerte mit einem festen Faktor; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.54 Reshape
Liefert einen Tensor der angegebenen Form ohne Änderung der Eingabedaten oder Elementanzahl.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- shape:int
- Legt die Form des Ausgabetensors fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.55 Resize
Ändert die Größe des Eingabetensors. Im Allgemeinen wird jeder Ausgabewert als gewichteter Mittelwert einer Nachbarschaft (Abtastpositionen) im Eingabetensor berechnet.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- roi(optional):T2
- Derzeit nicht unterstützt.
- scales(optional):T2
- Array der Skalierungsfaktoren je Dimension.
- sizes(optional):T3
- Zielgröße des Ausgabetensors.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Attribute
- antialias:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- axes:int[]
- Die Einstellung wird derzeit nicht unterstützt.
- coordinate_transformation_mode:strings (Standardwert ”half_pixel”)
- Derzeit werden nur half_pixel, pytorch_half_pixel und align_corners unterstützt.
- cubic_coeff_a:float (Standardwert ‑0.75)
- Die Einstellung wird derzeit nicht unterstützt.
- exclude_outside:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- extrapolation_value:float (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- keep_aspect_ratio_policy:strings (Standardwert ”stretch”)
- Die Einstellung wird derzeit nicht unterstützt.
- mode:strings (Standardwert ”nearest”)
- Derzeit sind nur nearest und linear konfigurierbar.
- nearest_mode:strings (Standardwert ”round_prefer_floor”)
- Die Einstellung wird derzeit nicht unterstützt.
Unterstützung: derzeit nur ganzzahlige Skalierung in Breite und Höhe mit ganzzahligen Faktoren 2‑8. Eine Eingabe (1,c,1,1) kann auf (1,c,h,w) vergrößert werden.
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.5.56 Slice
Erzeugt einen Ausschnitt des aktuellen Vektors nach den Regeln von NumPy-Slicing.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- starts:int(Tensor)
- Startposition des Ausschnitts: uneingeschränkt.
- ends:int(Tensor)
- Endposition des Ausschnitts: uneingeschränkt.
- axes:int(Tensor)
- Auswahl der Slice-Achsen: beliebige Achsen 0~3, auch mehrere gleichzeitig.
- steps:int(Tensor)
- Legt die Schrittweite entlang der jeweiligen Slice-Achse fest.
- Bei height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc darf steps von 1 abweichen. Andernfalls läuft SliceOP nur bei steps==[1,1,1,1] auf der NPU.
3.5.57 Softmax
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.58 exSoftmax13
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.59 exSoftmaxMask
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
input(x, mast_t, mask_value) =
  x + (mast_t - 1) * inf   if mask_value = 0
  x + mast_t * (-inf)      elif mask_value = 1
exSoftmaxMask(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
- mask(optional):T1
- shape:[1,channel,height,width]
channel∈(0,8192]
- width:· axis=1, uneingeschränkt;
· axis=3/‑1,width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
- mask_value:int64
- Zu maskierende Werte:0,1.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.60 Split
Teilt den Vektor entlang axis in num_outputs Vektoren; split legt deren Größen entlang axis fest.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- Ein oder mehrere Ausgabevektoren, bestimmt durch num_outputs.
- shape: durch die Aufteilung bestimmt.
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor),float16(Tensor)
Attribute
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.5.61 Sub
- Führt elementweise binäre Subtraktion (C=A‑B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(constTensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.5.62 Tile
Erzeugt durch Wiederholung des gegebenen Tensors einen Tensor, wie NumPy tile, jedoch ohne Broadcasting.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.5.63 Transpose
Transponiert den Eingabetensor.
Eingaben
- X:T1
- shape:[n1,c1,h1,w1]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n1,c1,h1,w1]
Ausgaben
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n2,c2,h2,w2]
Attribute
- perm, Reihenfolge der transponierten Achsen: Einschränkungen für unterschiedliche perm folgen (p=268435456,q=65536).
- perm=[0,1,2,3]
- Uneingeschränkt
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int16(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.5.64 Sigmoid
Wendet y=1/(1+exp(‑x)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.65 Tanh
Berechnet den hyperbolischen Tangens jedes Eingabetensorelements.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.66 Softplus
Wendet Softplus elementweise an, y=ln(exp(x)+1).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.67 HardSigmoid
Wendet y=max(0,min(1,alpha*x+beta)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor, wobei
alpha=1/6,beta=0.5
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.68 HardSwish
Wendet HardSwish elementweise an: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), wobei alpha=1/6,beta=0.5.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.69 Elu
Wendet f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0 elementweise an, um den Ausgabetensor zu erzeugen; alpha=1.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.70 exSwish
Wendet die Sigmoid Linear Unit elementweise an. Swish heißt auch SiLU: y=x*sigmoid(x).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.71 exMish
Wendet mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.72 exGelu
Wendet y =x∗Φ(x) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor. Wenn Φ(x) auf tanh gesetzt ist,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.73 Where
Wählt Werte aus x_tensor oder y_tensor anhand von mask_tensor: Bei True wird der entsprechende x_tensor-Wert gewählt, sonst der y_tensor-Wert.
Eingaben
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- x_tensor:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- y_tensor:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- output:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:bool(Tensor)
- T2:int8(Tensor),float16(Tensor)
3.5.74 exGlu
Gated-Linear-Unit-Funktion; a ist die erste Hälfte der Eingabematrix, b die zweite.
GLU(a,b)=a⊗σ(b)
Eingaben
- Input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Output:T1
- shape:[batch,channel/2,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- axis:int(Standardwert=1)
- Dimension, entlang der die Eingabe geteilt wird.
- Einschränkung: nur 1 unterstützt.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.75 exMatMul
Matrixmultiplikation
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Eingaben
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Quantisierungsunterstützung
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- Y:T1
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
Attribute
- c_type:strings(Standardwert “add”)
- add oder mul legt fest, ob C addiert oder multipliziert wird.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: nicht unterstützt.
3.5.76 exNorm
Normalisiert Eingabedaten. Derzeit werden LayerNormlization, RMSNormlization und MeanVarianceNormalization unterstützt:
LayerNorm(x) = (x - µ) / sqrt(σ^2 + ϵ) · W + B
RMSNorm(x) = x / sqrt(RMS^2 + ϵ) · W + B
MeanVarianceNorm(x) = (x - µ) / sqrt(Variance + ϵ) · W + B
Dabei ist x der Eingabevektor. µ und σ2 sind Mittelwert und Varianz des Eingabevektors:
µ = (1/H) Σ_{i=1}^{H} x_i
σ^2 = (1/H) Σ_{i=1}^{H} (x_i - µ)^2
RMS ist der quadratische Mittelwert des Eingabevektors:
RMS = sqrt((1/H) Σ_{i=1}^{H} (x_i)^2)
Variance ist die äquivalente Varianz des Eingabevektors:
Variance = (1/H) Σ_{i=1}^{H} (x_i)^2 - µ^2
ϵ ist ein kleiner Wert zur Vermeidung einer Division durch null. W und B sind optionale Parameter.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- W(optional):T1
- shape:[batch,channel,height,width]
- B(optional):T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- epsilon:float(Standardwert 1e‑05)
- epsilon-Wert zur Vermeidung einer Division durch 0.
- mode:string
- Drei Normalization-Modi sind wählbar: layer, rms und mean_var.
- axes:int64[](Standardwert [1])
- Normalisierungsachsen: derzeit nur [1] und [1,2,3] unterstützt.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.5.77 exSDPAttention
Berechnet skalierte Skalarprodukt-Aufmerksamkeit (SDPA) zwischen query, key und value.
Eingaben
- query:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- key:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- value:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- mask(optional):T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Standardmäßig wird Broadcasting entlang beliebiger Dimensionen unterstützt.
- Bei aktiviertem FA werden nur [b,c,1,1],[1,c,1,1] und [1,c,h,w] unterstützt.
- scale(optional):T3
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: auf RK3576 unterstützt / auf RV1126B nicht unterstützt.
- FlashAttentionV2(FA): unterstützt.
- Basiert auf https://arxiv.org/abs/2307.08691. Innere Schleifen im Cache beschleunigen die Ausführung und reduzieren die Bandbreitennutzung, vergrößern aber das Modell. Je nach Szenario und Modell über die Aktivierung entscheiden.
- RKNPU-Treiberversion>=0.9.7
- Version der RKNPU-Runtime-Bibliothek (librknnrt.so)>=2.1.0
- Unterstützter Datentyp:float16.
3.5.78 exWindow
exWindow stammt von window_partition und window_reverse aus swin_transformer. In der Originalarbeit werden Eingabemerkmale in nicht überlappende Fenster der Größe window_size×window_size aufgeteilt. Ein- und Ausgabemerkmale müssen eine 4-dimensionale shape haben und in Höhe und Breite aufgeteilt werden. Die PyTorch-Implementierung folgt:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Eingaben
- X:T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
Attribute
- mode:string
- Unterstützte Modi:partition,reverse,partition_num_first.
- partition: siehe Implementierung von window_partition.
- reverse: siehe Implementierung von window_reverse.
- partition_num_first unterscheidet sich von partition dadurch, dass H,W nach num_windows aufgeteilt werden; partition teilt H,W dagegen nach window_sizes auf.
- Unterstützte Modi:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-dimensionaler Vektor der Fenstergröße, der Höhe und Breite jedes Fensters festlegt. Auf dieser Größe beruhen Aufmerksamkeitsberechnung und Merkmalsextraktion innerhalb des Fensters.
- num_windows:listofints
- 2-dimensionaler Vektor der Fensteranzahl; legt fest, in wie viele Fenster Höhe und Breite der Eingabemerkmale geteilt werden.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.6 RK2118
3.6.1 Add
Führt elementweise binäre Addition (C=A+B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.2 AddRelu
Fusionierte Berechnung von Add und Relu, C=Relu(A+B).
Eingaben
- Wie bei Add.
Ausgaben
- Wie bei Add.
3.6.3 BatchNormalization
Führt Batch-Normalisierung des Eingabetensors gemäß https://arxiv.org/abs/1502.03167 aus.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- epsilon:float (Standardwert=1e‑5)
- Reeller Wert, der beim Teilen durch die Standardabweichung eine Division durch 0 verhindert.
- epsilon∈(0,∞]
- momentum:float
- Parameter des gleitenden Mittelwerts beim Training.
3.6.4 Concat
Verknüpft eine Folge von Vektoren entlang axis zu einem Vektor. Alle Dimensionen außer axis müssen übereinstimmen.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:float16(Tensor)
Attribute
- axisint64
- axis∈{0,1,2,3}
3.6.5 Convolution
Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.6 DepthwiseConvolution
Tiefenseparierbare Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.7 ConvolutionRelu
Fusionierte Berechnung von Convolution und Relu, Output=Relu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.8 ConvolutionClip
Fusionierte Berechnung von Convolution und Clip, Output=Clip(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.9 ConvolutionPRelu/LeakyRelu
Fusionierte Berechnung von Convolution und PRelu/LeakyRelu, Output = PRelu(Conv(Input)) oder Output =
LeakyRelu(Conv(Input))
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.10 ConvolutionAdd
Fusionierte Berechnung von Convolution und Add, Output=Add(Conv(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.11 ConvolutionSigmoid
Fusionierte Berechnung von Convolution und Sigmoid, Output=Sigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.12 ConvolutionTanh
Fusionierte Berechnung von Convolution und Tanh, Output=Tanh(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.13 ConvolutionSoftplus
Fusionierte Berechnung von Convolution und Softplus, Output=Softplus(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.14 ConvolutionHardSigmoid
Fusionierte Berechnung von Convolution und HardSigmoid, Output=HardSigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.15 ConvolutionHardSwish
Fusionierte Berechnung von Convolution und HardSwish, Output=HardSwish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.16 ConvolutionElu
Fusionierte Berechnung von Convolution und Elu, Output=Elu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.17 ConvolutionSwish
Fusionierte Berechnung von Convolution und Swish, Output=Swish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.18 ConvolutionMish
Fusionierte Berechnung von Convolution und Mish, Output=Mish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.6.19 ConvTranspose
Transponierte Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzlich unterliegt die Eingabe der ersten Schicht
- shape:[batch,channel,height,width]
width unterliegt Einschränkungen; siehe Modelleingaben.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). Bei pad sind folgende Fälle nicht unterstützt: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: nur 1 wird unterstützt; num_output ist genau dann unterstützt, wenn num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Bei dilation ungleich (1,1) wird nur kernel=(1,1) unterstützt.
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.20 Div
Führt elementweise binäre Division (C=A/B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.21 Expand
Erweitert den Eingabetensor anhand von shape und Broadcasting-Regeln, ähnlich numpy.array(input) *numpy.ones(shape): Dimensionen werden rechtsbündig ausgerichtet; korrespondierende Dimensionen müssen gleich sein oder eine davon muss 1 sein.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:int64(Tensor)
Broadcasting-Einschränkungen
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.6.22 LSTM
Long Short-Term Memory (LSTM). Erweiterungen und Varianten heißen exLSTM; mit (extern) markierte Parameter sind exLSTM vorbehalten. Die Gleichungen folgen:
f = Sigmoid; g = Tanh; h = Tanh
i_t = f(x_t · W_i + h_{t-1} · R_i + Wb_i + Rb_i)
f_t = f(x_t · W_f + h_{t-1} · R_f + Wb_f + Rb_f)
c_t = f(x_t · W_c + h_{t-1} · R_c + Wb_c + Rb_c)
o_t = f(x_t · W_o + h_{t-1} · R_o + Wb_o + Rb_o)
C_t = f_t ⊙ C(t-1) + i_t ⊙ c_t
h_t = o_t ⊙ h(C_t)
Eingaben
- X:T1
- shape:[seq_length,batch_size,input_size]
seqlength∈(0,8192]
- batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
inputsize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- W:T1
- shape:[num_directions,4*hidden_size,input_size]
inputsize∈(0,8192]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- R:T1
- shape:[num_directions,4*hidden_size,hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- B:T2
- shape:[num_directions,8*hidden_size]
hiddensize∈(0,8192]
- numdirections:1or2
- Quantisierungsunterstützung
- per‑layer
- per‑channel
- sequence_lens:T3(optional)
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[batch_size]; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- initial_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- initial_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- Y:T1
- shape:[seq_length,num_directions,batch_size,hidden_size]
seqlength∈(0,8192]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_h:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- Y_c:T1(optional)
- shape:[num_directions,batch_size,hidden_size]
- numdirections:1or2; batchsize∈(0,8192]; Werte größer als 1 müssen Vielfache von 4 sein.
- shape:[num_directions,batch_size,hidden_size]
hiddensize∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
Attribute
- direction(extern):string
- Legt die Berechnungsrichtung von LSTM fest.
- forward: LSTM in Vorwärtsrichtung.
- reverse: LSTM in Rückwärtsrichtung.
- bidirectional: LSTM in beiden Richtungen.
- sequence_size(extern):int
- Legt seqsize der LSTM-Eingabe fest; uneingeschränkt, Ausrichtung auf 4 empfohlen.
- hidden_size(extern):int
- hiddensize der LSTM-Einheit; uneingeschränkt, Ausrichtung auf 8 empfohlen.
- proj_size(extern):int
- proj_size bei projection; projsize∈[0,hiddensize].
- Derzeit auf 0 beschränkt; projection wird noch nicht unterstützt.
- input_forget(extern):int
- Auswahl der cifg-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- has_projection(extern):int
- projection-Variante:1(T)or0(F). Derzeit auf 0 beschränkt, also noch nicht unterstützt.
- input_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Eingabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size und hidden_size des Operators müssen angegeben werden.
- snc: Eingabe-shape dieses Layouts ist [seqs,batches,input_size].
- (sn)c: Eingabe-shape dieses Layouts ist [seqs*batches,input_size,1,1].
- output_layout(extern):int
- Legt ein Layout fest, das der Bedeutung der zugehörigen Ausgabe-shape entspricht.
- Das festgelegte Layout und die tatsächlichen Werte batch_size, sequence_size, hidden_size und directions des Operators müssen angegeben werden.
- sbnc: Ausgabe-shape dieses Layouts ist [seqs,directions,batches,hidden_size].
- (sn)c: Ausgabe-shape dieses Layouts ist [seqsbatches,directionsinput_size,1,1].
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.6.23 Max
Berechnet das elementweise Maximum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.6.24 Mul
Führt elementweise binäre Multiplikation (C=A*B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.25 MulRelu
Fusionierte Berechnung von Mul und Relu,C=Relu(A*B).
Eingaben
- Wie bei Mul.
Ausgaben
- Wie bei Mul.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.6.26 Pad
Erzeugt aus Datentensor (data), Tensor der Auffüllwerte an Achsenanfang und -ende (pads), Modus (mode) und konstantem Wert (constant_value) einen aufgefüllten Tensor (output).
Eingaben
- data:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Attribute
- mode:string (Standardwert constant)
- Unterstützte Modi: constant,reflect.
- constant: uneingeschränkt.
- Unterstützte Modi: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.6.27 MaxPool
MaxPool verarbeitet Eingabetensor X und wendet Max-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Für durch den Kernel bestimmte Teilmengen wird das Maximum berechnet und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,8192]
width∈(0,8192]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- Hinweis: kernel_h=1 und kernel_w=1 zusammen werden nicht unterstützt.
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.6.28 GlobalMaxPool
GlobalMaxPool wendet Max-Pooling auf die Werte jedes Kanals von Eingabetensor X an. Dies entspricht MaxPool mit kernel_shape gleich den räumlichen Dimensionen von input.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]. Hinweis: kernel_h=1 und kernel_w=1 zusammen werden nicht unterstützt.
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.6.29 AveragePool
- Nicht unterstützt (vom Werkzeug in eine Faltung umgewandelt).
3.6.30 GlobalAveragePool
- Nicht unterstützt (vom Werkzeug in eine Faltung umgewandelt).
3.6.31 Pow
Z =XY
Potenzierung: verarbeitet Eingabedaten (Tensor) und einen Exponenten zu Ausgabedaten (Tensor).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Y:T2
- shape:[1]
- Derzeit nur 0,1,2,3,0.5,‑0.5 unterstützt.
- shape:[1]
Ausgaben
- Z:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:int8(Tensor),int32(Tensor),int64(Tensor),float16(Tensor),float(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.6.32 Relu
Setzt negative Eingabetensorwerte auf null; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.6.33 Clip/ReLU6
Begrenzt Eingabetensorwerte auf [0,6].
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.6.34 PRelu
Skaliert negative Eingabetensorwerte mit einem lernbaren Parameter; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- slope: PRelu-Koeffizient.
- Nur ein einzelner Skalar oder Koeffizienten entlang der C-Dimension werden unterstützt.
Datentypbeschränkungen
- T1:float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.6.35 LeakyRelu
Skaliert negative Eingabetensorwerte mit einem festen Faktor; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.6.36 Reshape
Liefert einen Tensor der angegebenen Form ohne Änderung der Eingabedaten oder Elementanzahl.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- shape:int
- Legt die Form des Ausgabetensors fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.6.37 Resize
Ändert die Größe des Eingabetensors. Im Allgemeinen wird jeder Ausgabewert als gewichteter Mittelwert einer Nachbarschaft (Abtastpositionen) im Eingabetensor berechnet.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- roi(optional):T2
- Derzeit nicht unterstützt.
- scales(optional):T2
- Array der Skalierungsfaktoren je Dimension.
- sizes(optional):T3
- Zielgröße des Ausgabetensors.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Attribute
- antialias:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- axes:int[]
- Die Einstellung wird derzeit nicht unterstützt.
- coordinate_transformation_mode:strings (Standardwert ”half_pixel”)
- Derzeit werden nur half_pixel, pytorch_half_pixel und align_corners unterstützt.
- cubic_coeff_a:float (Standardwert ‑0.75)
- Die Einstellung wird derzeit nicht unterstützt.
- exclude_outside:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- extrapolation_value:float (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- keep_aspect_ratio_policy:strings (Standardwert ”stretch”)
- Die Einstellung wird derzeit nicht unterstützt.
- mode:strings (Standardwert ”nearest”)
- Derzeit sind nur nearest und linear konfigurierbar.
- nearest_mode:strings (Standardwert ”round_prefer_floor”)
- Die Einstellung wird derzeit nicht unterstützt.
Unterstützung: derzeit nur ganzzahlige Skalierung in Breite und Höhe mit ganzzahligen Faktoren 2‑8. Eine Eingabe (1,c,1,1) kann auf (1,c,h,w) vergrößert werden.
3.6.38 Slice
Erzeugt einen Ausschnitt des aktuellen Vektors nach den Regeln von NumPy-Slicing.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:float16(Tensor)
Attribute
- starts:int(Tensor)
- Startposition des Ausschnitts: uneingeschränkt.
- ends:int(Tensor)
- Endposition des Ausschnitts: uneingeschränkt.
- axes:int(Tensor)
- Auswahl der Slice-Achsen: beliebige Achsen 0~3, auch mehrere gleichzeitig.
- steps:int(Tensor)
- Legt die Schrittweite entlang der jeweiligen Slice-Achse fest.
- Bei height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc darf steps von 1 abweichen. Andernfalls läuft SliceOP nur bei steps==[1,1,1,1] auf der NPU.
3.6.39 Softmax
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- width:· axis=1, uneingeschränkt;
· axis=3/‑1,width∈(0,8192]
Zusätzlich gelten die Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
3.6.40 exSoftmax13
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
- width:· axis=1, uneingeschränkt;
· axis=3/‑1,width∈(0,8192]
Zusätzlich gelten die Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
3.6.41 exSoftmaxMask
- Noch nicht unterstützt.
3.6.42 Split
Teilt den Vektor entlang axis in num_outputs Vektoren; split legt deren Größen entlang axis fest.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- Ein oder mehrere Ausgabevektoren, bestimmt durch num_outputs.
- shape: durch die Aufteilung bestimmt.
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:float16(Tensor)
Attribute
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.6.43 Sub
- Führt elementweise binäre Subtraktion (C=A‑B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.6.44 Tile
Erzeugt durch Wiederholung des gegebenen Tensors einen Tensor, wie NumPy tile, jedoch ohne Broadcasting.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.6.45 Transpose
Transponiert den Eingabetensor.
Eingaben
- X:T1
- shape:[n1,c1,h1,w1]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n1,c1,h1,w1]
Ausgaben
- Y:T1
- shape:[n2,c2,h2,w2]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n2,c2,h2,w2]
Attribute
- perm, Reihenfolge der transponierten Achsen: Einschränkungen für unterschiedliche perm folgen (p=268435456,q=65536).
- perm=[0,1,2,3]
- Uneingeschränkt
- perm=[0,1,3,2]
- T1:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Datentypbeschränkungen
- T1:int16(Tensor),float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.6.46 Sigmoid
Wendet y=1/(1+exp(‑x)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.47 Tanh
Berechnet den hyperbolischen Tangens jedes Eingabetensorelements.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.48 Softplus
Wendet Softplus elementweise an, y=ln(exp(x)+1).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.49 HardSigmoid
Wendet y=max(0,min(1,alpha*x+beta)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor, wobei
alpha=1/6,beta=0.5
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.50 HardSwish
Wendet HardSwish elementweise an: y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), wobei alpha=1/6,beta=0.5.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.51 Elu
Wendet f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0 elementweise an, um den Ausgabetensor zu erzeugen; alpha=1.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.52 exSwish
Wendet die Sigmoid Linear Unit elementweise an. Swish heißt auch SiLU: y=x*sigmoid(x).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.53 exMish
Wendet mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.54 exGelu
Wendet y =x∗Φ(x) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor. Wenn Φ(x) auf tanh gesetzt ist,
y = 0.5 * x * (1 + Tanh(sqrt(2/π) * (x + 0.044715 * x^3)))
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
3.6.55 Where
Wählt Werte aus x_tensor oder y_tensor anhand von mask_tensor: Bei True wird der entsprechende x_tensor-Wert gewählt, sonst der y_tensor-Wert.
Eingaben
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- output:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:bool(Tensor)
- T2:float16(Tensor)
3.6.56 exConvStreaming
Zur Latenzsenkung in Sprachmodellen wird die ursprüngliche Faltungseingabe in zeitliche Segmente aufgeteilt. Jedes Segment wird separat gefaltet; die Ergebnisse werden für nachfolgende Frames zwischengespeichert und ermöglichen Streaming-Audioverarbeitung.
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: derzeit wird width=1 unterstützt.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:float16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.6.57 exConvStreamingPRelu/LeakyRelu
Fusionierte Berechnung von exConvStreaming und PRelu/LeakyRelu, Output = PRelu(exConvStreaming(Input)) oder
Output=
LeakyRelu(exConvStreaming(Input))
Beschreibung und Grenzen wie bei exConvStreaming.
3.6.58 exGlu
Gated-Linear-Unit-Funktion; a ist die erste Hälfte der Eingabematrix, b die zweite.
GLU(a,b)=a⊗σ(b)
Eingaben
- Input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Output:T1
- shape:[batch,channel/2,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- axis:int(Standardwert=1)
- Dimension, entlang der die Eingabe geteilt wird.
- Einschränkung: nur 1 unterstützt.
3.6.59 exMatMul
Matrixmultiplikation
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Eingaben
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Quantisierungsunterstützung
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- Y:T1
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(Tensor)
Attribute
- c_type:strings(Standardwert “add”)
- add oder mul legt fest, ob C addiert oder multipliziert wird.
3.6.60 exWindow
exWindow stammt von window_partition und window_reverse aus swin_transformer. In der Originalarbeit werden Eingabemerkmale in nicht überlappende Fenster der Größe window_size×window_size aufgeteilt. Ein- und Ausgabemerkmale müssen eine 4-dimensionale shape haben und in Höhe und Breite aufgeteilt werden. Die PyTorch-Implementierung folgt:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Eingaben
- X:T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:float16(Tensor)
Attribute
- mode:string
- Unterstützte Modi:partition,reverse,partition_num_first.
- partition: siehe Implementierung von window_partition.
- reverse: siehe Implementierung von window_reverse.
- partition_num_first unterscheidet sich von partition dadurch, dass H,W nach num_windows aufgeteilt werden; partition teilt H,W dagegen nach window_sizes auf.
- Unterstützte Modi:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-dimensionaler Vektor der Fenstergröße, der Höhe und Breite jedes Fensters festlegt. Auf dieser Größe beruhen Aufmerksamkeitsberechnung und Merkmalsextraktion innerhalb des Fensters.
- num_windows:listofints
- 2-dimensionaler Vektor der Fensteranzahl; legt fest, in wie viele Fenster Höhe und Breite der Eingabemerkmale geteilt werden.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.7 RV1103B/RV1106B
3.7.1 Add
Führt elementweise binäre Addition (C=A+B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(constTensor)
3.7.2 AddRelu
Fusionierte Berechnung von Add und Relu, C=Relu(A+B).
Eingaben
- Wie bei Add.
Ausgaben
- Wie bei Add.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.7.3 BatchNormalization
Führt Batch-Normalisierung des Eingabetensors gemäß https://arxiv.org/abs/1502.03167 aus.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
Attribute
- epsilon:float (Standardwert=1e‑5)
- Reeller Wert, der beim Teilen durch die Standardabweichung eine Division durch 0 verhindert.
- epsilon∈(0,∞]
- momentum:float
- Parameter des gleitenden Mittelwerts beim Training.
3.7.4 Concat
Verknüpft eine Folge von Vektoren entlang axis zu einem Vektor. Alle Dimensionen außer axis müssen übereinstimmen.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor)
Attribute
- axisint64
- axis∈{0,1,2,3}
3.7.5 Convolution
Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,31]
- dilations_w∈[1,31]
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.6 DepthwiseConvolution
Tiefenseparierbare Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzliche Grenzen für die Eingangsbreite der ersten Schicht stehen in der Beschreibung der Modelleingaben.
- Quantisierungsunterstützung
- per‑layer
- shape:[batch,channel,height,width]
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,8]
kernel_w∈[1,8]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,7]
- stride_w∈[1,7]
- pads:int(pads_top,pads_left,pads_bottom,pads_right)
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.7 ConvolutionRelu
Fusionierte Berechnung von Convolution und Relu, Output=Relu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.8 ConvolutionClip
Fusionierte Berechnung von Convolution und Clip, Output=Clip(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.9 ConvolutionPRelu/LeakyRelu
Fusionierte Berechnung von Convolution und PRelu/LeakyRelu, Output = PRelu(Conv(Input)) oder Output =
LeakyRelu(Conv(Input))
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.10 ConvolutionAdd
Fusionierte Berechnung von Convolution und Add, Output=Add(Conv(Input0),Input1).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.11 ConvolutionSigmoid
Fusionierte Berechnung von Convolution und Sigmoid, Output=Sigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.12 ConvolutionTanh
Fusionierte Berechnung von Convolution und Tanh, Output=Tanh(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.13 ConvolutionSoftplus
Fusionierte Berechnung von Convolution und Softplus, Output=Softplus(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.14 ConvolutionHardSigmoid
Fusionierte Berechnung von Convolution und HardSigmoid, Output=HardSigmoid(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.15 ConvolutionHardSwish
Fusionierte Berechnung von Convolution und HardSwish, Output=HardSwish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.16 ConvolutionElu
Fusionierte Berechnung von Convolution und Elu, Output=Elu(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.17 ConvolutionSwish
Fusionierte Berechnung von Convolution und Swish, Output=Swish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.18 ConvolutionMish
Fusionierte Berechnung von Convolution und Mish, Output=Mish(Conv(Input)).
Beschreibung und Spezifikationsgrenzen wie bei Convolution.
3.7.19 ConvTranspose
Transponierte Faltung
Eingaben
- input_tensor:T1
- shape:[batch,channel,height,width]
- width: bei dilated_kernel_h>1 gilt width<16383. Zusätzlich unterliegt die Eingabe der ersten Schicht
- shape:[batch,channel,height,width]
width unterliegt Einschränkungen; siehe Modelleingaben.
- **量化支持**
  - per-layer
- weight:T1
- shape:[output_channel,input_channel,kernel_h,kernel_w]
kernel_h∈[1,31]
kernel_w∈[1,31]
- Quantisierungsunterstützung
- per‑layer
- per‑channel
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Attribute
- strides:int(strides_h,strides_w)
- stride_h∈[1,8]
- stride_w∈[1,8]
- pads:int(pads_top,pads_left,pads_bottom,pads_right). Bei pad sind folgende Fälle nicht unterstützt: kernel_h*dilations_h‑dilations_h‑pads_top<0; kernel_w*dilations_w‑dilations_w‑pads_left<0; stride_h*(height‑1)‑pads_top+1<output_h; stride_w*(width‑1)‑pads_left+1<output_w.
- pads_top∈[0,15]
- pads_left∈[0,15]
- pads_bottom∈[0,15]
- pads_right∈[0,15]
- group:int
- group: nur 1 wird unterstützt; num_output ist genau dann unterstützt, wenn num_input=num_output.
- dilations:int(dilations_h,dilations_w)
- dilations_h∈[1,32]
- dilations_w∈[1,32]
- Bei dilation ungleich (1,1) wird nur kernel=(1,1) unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.20 ConvTranposeRelu
Fusionierte Berechnung von ConvTranpose und Relu, Output=Relu(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.7.21 ConvTranposeClip
Fusionierte Berechnung von ConvTranpose und Clip, Output=Clip(ConvTranpose(Input)).
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.7.22 ConvTranposePRelu/LeakyRelu
Fusionierte Berechnung von ConvTranpose und PRelu/LeakyRelu, Output=PRelu(ConvTranpose(Input)) oder Output=
LeakyRelu(ConvTranpose(Input))
Beschreibung und Spezifikationsgrenzen wie bei ConvTranspose.
3.7.23 Div
Führt elementweise binäre Division (C=A/B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:float16(Tensor)
- T2:float(constTensor)
3.7.24 Expand
Erweitert den Eingabetensor anhand von shape und Broadcasting-Regeln, ähnlich numpy.array(input) *numpy.ones(shape): Dimensionen werden rechtsbündig ausgerichtet; korrespondierende Dimensionen müssen gleich sein oder eine davon muss 1 sein.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- shape:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int64(Tensor)
Broadcasting-Einschränkungen
- [b,c,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,1,1,w]‑>[b,c,h,w],h∈[1,8192]
- [b,c,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,1,h,1]‑>[b,c,h,w],w ∈[1,8192]
- [b,c,1,1]‑>[b,c,h,w],h∈[1,8192],w ∈[1,8192]
3.7.25 Max
Berechnet das elementweise Maximum der Eingabetensoren.
Eingaben
- A:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Datentypbeschränkungen
- T1:int8(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.7.26 Mul
Führt elementweise binäre Multiplikation (C=A*B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(constTensor)
3.7.27 MulRelu
Fusionierte Berechnung von Mul und Relu,C=Relu(A*B).
Eingaben
- Wie bei Mul.
Ausgaben
- Wie bei Mul.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: unterstützt.
3.7.28 Pad
Erzeugt aus Datentensor (data), Tensor der Auffüllwerte an Achsenanfang und -ende (pads), Modus (mode) und konstantem Wert (constant_value) einen aufgefüllten Tensor (output).
Eingaben
- data:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- pads:T2
- shape : [batch_begin, channel_begin, height_begin, width_begin, batch_end, chan‑nel_end,height_end,width_end]
- constant_value(optional):T3
- shape:[1]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int64(Tensor)
- T3:float(Scalar),int8(Scalar),float16(Scalar)
Attribute
- mode:string (Standardwert constant)
- Unterstützte Modi: constant,reflect.
- constant: uneingeschränkt.
- Unterstützte Modi: constant,reflect.
reflectchannel∈(0,8192],height∈(0,8192],width∈(0,8176]
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.7.29 MaxPool
MaxPool verarbeitet Eingabetensor X und wendet Max-Pooling anhand von Kernelgröße, Schrittweite und pad-Längen an. Für durch den Kernel bestimmte Teilmengen wird das Maximum berechnet und in den herunterabgetasteten Ausgabetensor Y zur weiteren Verarbeitung übernommen. Die räumliche Ausgabeform hängt von explizitem Padding (pads) oder automatischem Padding (auto_pad) ab. Hier wird ausschließlich explizites Padding verwendet.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.7.30 GlobalMaxPool
GlobalMaxPool wendet Max-Pooling auf die Werte jedes Kanals von Eingabetensor X an. Dies entspricht MaxPool mit kernel_shape gleich den räumlichen Dimensionen von input.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
channel∈(0,8192]
height∈(0,7]
width∈(0,7]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Attribute
- kernel_shape:int64(kernel_h,kernel_w)
- kernel_h∈(0,7]
- kernel_w∈(0,7]
- auto_pad:string
- Padding-Modus: nur NOTSET unterstützt.
- ceil_mode:int64
- Berechnung der Ausgabe-shape mit ceil oder floor: nicht unterstützt.
- strides:int64(strides_h,strides_w)
- strides_h∈(0,8]
- strides_w∈(0,8]
- count_include_pad:int64[]
- count_include_pad, ob pad-Werte in die Berechnung eingehen:1.
- pad:int64(pad_top,pad_left,pad_bottom,pad_right)
- pad_top∈[0,7]
- pad_left∈[0,7]
- pad_bottom∈[0,7]
- pad_right∈[0,7]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:float(Scalar)
3.7.31 AveragePool
- Nicht unterstützt (vom Werkzeug in eine Faltung umgewandelt).
3.7.32 GlobalAveragePool
- Nicht unterstützt (vom Werkzeug in eine Faltung umgewandelt).
3.7.33 Relu
Setzt negative Eingabetensorwerte auf null; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.7.34 Clip/ReLU6
Begrenzt Eingabetensorwerte auf [0,6].
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.7.35 PRelu
Skaliert negative Eingabetensorwerte mit einem lernbaren Parameter; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer/per‑channel
Attribute
- slope: PRelu-Koeffizient.
- Nur ein einzelner Skalar oder Koeffizienten entlang der C-Dimension werden unterstützt.
Datentypbeschränkungen
- T1:int8(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.7.36 LeakyRelu
Skaliert negative Eingabetensorwerte mit einem festen Faktor; positive Werte bleiben unverändert.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Keine
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.7.37 Reshape
Liefert einen Tensor der angegebenen Form ohne Änderung der Eingabedaten oder Elementanzahl.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
Attribute
- shape:int
- Legt die Form des Ausgabetensors fest.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
3.7.38 Resize
Ändert die Größe des Eingabetensors. Im Allgemeinen wird jeder Ausgabewert als gewichteter Mittelwert einer Nachbarschaft (Abtastpositionen) im Eingabetensor berechnet.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- roi(optional):T2
- Derzeit nicht unterstützt.
- scales(optional):T2
- Array der Skalierungsfaktoren je Dimension.
- sizes(optional):T3
- Zielgröße des Ausgabetensors.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(Tensor)
- T3:int64(Tensor)
Attribute
- antialias:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- axes:int[]
- Die Einstellung wird derzeit nicht unterstützt.
- coordinate_transformation_mode:strings (Standardwert ”half_pixel”)
- Derzeit werden nur half_pixel, pytorch_half_pixel und align_corners unterstützt.
- cubic_coeff_a:float (Standardwert ‑0.75)
- Die Einstellung wird derzeit nicht unterstützt.
- exclude_outside:int (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- extrapolation_value:float (Standardwert 0)
- Die Einstellung wird derzeit nicht unterstützt.
- keep_aspect_ratio_policy:strings (Standardwert ”stretch”)
- Die Einstellung wird derzeit nicht unterstützt.
- mode:strings (Standardwert ”nearest”)
- Derzeit sind nur nearest und linear konfigurierbar.
- nearest_mode:strings (Standardwert ”round_prefer_floor”)
- Die Einstellung wird derzeit nicht unterstützt.
Unterstützung: derzeit nur ganzzahlige Skalierung in Breite und Höhe mit ganzzahligen Faktoren 2‑8. Eine Eingabe (1,c,1,1) kann auf (1,c,h,w) vergrößert werden.
3.7.39 Slice
Erzeugt einen Ausschnitt des aktuellen Vektors nach den Regeln von NumPy-Slicing.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor)
Attribute
- starts:int(Tensor)
- Startposition des Ausschnitts: uneingeschränkt.
- ends:int(Tensor)
- Endposition des Ausschnitts: uneingeschränkt.
- axes:int(Tensor)
- Auswahl der Slice-Achsen: beliebige Achsen 0~3, auch mehrere gleichzeitig.
- steps:int(Tensor)
- Legt die Schrittweite entlang der jeweiligen Slice-Achse fest.
- Bei height*width==1&&channel%subc==0&&starts[1]%subc==0&&ends[1]%subc==0&&steps[1]<=subc darf steps von 1 abweichen. Andernfalls läuft SliceOP nur bei steps==[1,1,1,1] auf der NPU.
3.7.40 Softmax
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
Softmax(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
3.7.41 exSoftmax13
Dieser Operator berechnet normalisierte Exponentialwerte der Eingabe:
exSoftmax13(input, axis) = exp(input - max(input, axis)) / Σ_axis exp(input - max(input, axis))
Das Attribut “axis” legt die Dimension der Softmax-Berechnung fest. Der Ausgabetensor besitzt dieselbe Form und enthält die Softmax-Werte der entsprechenden Eingaben.
Eingaben
- input:T1
- shape:[batch,channel,height,width], unterliegt den Spezifikationsgrenzen von tranpose.
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor)
Attribute
- axis:int64
- softmax-Achse:1,3, entsprechend channel und width.
3.7.42 exSoftmaxMask
- Noch nicht unterstützt.
3.7.43 Split
Teilt den Vektor entlang axis in num_outputs Vektoren; split legt deren Größen entlang axis fest.
Eingaben
- input_tensor:T
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T
- Ein oder mehrere Ausgabevektoren, bestimmt durch num_outputs.
- shape: durch die Aufteilung bestimmt.
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T:int8(Tensor)
Attribute
- axis:int
- axis∈{0,1,2,3}
- num_outputs:int
- split:int(Tensor)
3.7.44 Sub
- Führt elementweise binäre Subtraktion (C=A‑B) mit multidirektionalem Broadcasting nach NumPy-Art aus.
Eingaben
- A:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
- B:T1,T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- [b,c,1,1]
- [scalar]
Ausgaben
- C:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(constTensor)
3.7.45 Tile
Erzeugt durch Wiederholung des gegebenen Tensors einen Tensor, wie NumPy tile, jedoch ohne Broadcasting.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- repeats:T2
- shape:[batch,channel,height,width]
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor),float16(Tensor)
- T2:int64(Tensor)
3.7.46 Transpose
Transponiert den Eingabetensor.
Eingaben
- X:T1
- shape:[n1,c1,h1,w1]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n1,c1,h1,w1]
Ausgaben
- Y:T1,T2
- shape:[n2,c2,h2,w2]
- Detaillierte Einschränkungen stehen in der Attributliste.
- Quantisierungsunterstützung
- per‑layer
- shape:[n2,c2,h2,w2]
Attribute
- perm, Reihenfolge der transponierten Achsen: Einschränkungen für unterschiedliche perm folgen (p=268435456,q=65536).
- perm=[0,1,2,3]
- Uneingeschränkt
- perm=[0,1,3,2]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q
- perm=[0,2,3,1]
- T1:c1<8192,h1*w1%8=0,w1*c1<p*16
- T2:c1<8192,h1*w1%8=0,w1*c1<p*8
- perm=[0,2,1,3]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1*w1<p
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1*w1<p
- perm=[0,3,1,2]
- T1,T2:h1*w1<p,w1<8192,h1*c1<p
- perm=[0,3,2,1]
- T1:h1%16=0,h1*w1<16*p,h1*w1<2*q,c1<p*16
- T2:h1%8=0,h1*w1<8*p,h1*w1<2*q,c1<p*8
- perm=[1,0,2,3]
- T1:h1*w1<16*p,n1<8192,h1*w1<p
- T2:h1*w1<8*p,n1<8192,h1*w1<p
- perm=[1,0,3,2]
- T1:h1%16=0,c1*h1*w1<16*p,h1*w1<2*q
- T2:h1%8=0,c1*h1*w1<8*p,h1*w1<2*q
- perm=[1,2,0,3]
- T1:n1*w1<p*16,c1*h1*w1<p,w1%16=0
- T2:n1*w1<p*8,c1*h1*w1p,w1%8=0
- perm=[1,2,3,0]
- T1:h1*w1<p,n1<p*16,c1*h1*w1<p*16,n1*w1<p*16
- T2:h1*w1<p,n1<p*8,c1*h1*w1<p*8,n1*w1<p*8
- perm=[1,3,0,2]
- T1:c1*w1<8192,n1*h1<p,w1%16=0
- T2:c1*w1<8192,n1*h1<p,w1%8=0
- perm=[1,3,2,0]
- T1:c1*h1*w1<p,n1*h1<p,w1<8192,w1%16=0
- T2:c1*h1*w1<p,n1*h1<p,w1<8192,w1%8=0
- perm=[2,1,0,3]
- T1,T2:c1<8192,c1*h1*w1<p,n1*w1<p
- perm=[2,1,3,0]
- T1:c1*h1*w1<p,n1*w1<p*16,c1<8192,n1*w1%4=0
- T2:c1*h1*w1<p,n1*w1<p*8,c1<8192,n1*w1%4=0
- perm=[2,0,3,1]
- T1,T2:c1<8192,c1*h1*w1<p
- perm=[2,0,1,3]
- T1:n1*c1*h1*w1<p,h1*w1%16=0
- T2:n1*c1*h1*w1<p,h1*w1%8=0
- perm=[2,3,1,0]
- T1:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%16=0
- T2:c1*h1*w1<p,n1*c1<p,h1*w1<8192,h1*w1%8=0
- perm=[2,3,0,1]
- T1,T2:h1*w1<8192,n1*c1<p
- perm=[3,0,2,1]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*w1%8=0
- perm=[3,0,1,2]
- T1:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%16=0
- T2:h1*w1<p,n1*c1<8192,c1*h1<p,n1*w1<8192,n1*h1*w1%8=0
- perm=[3,2,0,1]
- T1,T2:h1*w1<p,n1*c1<8192,n1*c1*w1<p
- perm=[3,2,1,0]
- T1:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*16,h1%16=0
- T2:c1*h1*w1<p,h1*w1<8192,2*h1*w1<q,n1*c1<p*8,h1%8=0
- perm=[3,1,0,2]
- T1,T2:h1*w1<p,c1*w1<8192,n1*h1<p
- perm=[3,1,2,0]
- T1,T2:h1*w1<p,n1*c1<8192,n1*h1<p,n1*c1*w1<p
- perm=[0,1,2,3]
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:int16(Tensor)
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: derzeit nicht unterstützt.
3.7.47 Sigmoid
Wendet y=1/(1+exp(‑x)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.48 Tanh
Berechnet den hyperbolischen Tangens jedes Eingabetensorelements.
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.49 Softplus
Wendet Softplus elementweise an, y=ln(exp(x)+1).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.50 HardSigmoid
Wendet y=max(0,min(1,alpha*x+beta)) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor, wobei
alpha=1/6,beta=
- (0) 5
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.51 HardSwish
Wendet HardSwish elementweise an, y = x * max(0, min(1, alpha * x + beta)) = x * HardSigmoid<alpha,beta>(x), wobei alpha=1/6,
beta=0.5
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.52 Elu
Wendet f(x)=alpha*(exp(x)‑1.)forx<0,f(x)=xforx>=0 elementweise an, um den Ausgabetensor zu erzeugen; alpha=1.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.53 exSwish
Wendet die Sigmoid Linear Unit elementweise an. Swish heißt auch SiLU: y=x*sigmoid(x).
Eingaben
- X:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.54 exMish
Wendet mish(x)=x*tanh(softplus(x))=x*tanh(ln(1+e^{x})) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor.
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.55 exGelu
Wendet y =x∗Φ(x) elementweise auf den Eingabetensor an und erzeugt den Ausgabetensor. Wenn Φ(x) auf tanh gesetzt ist,
$y=
- (0) 5*x*(1+Tanh(\sqrt{\frac{2}{\pi}}*(x+0.044715*x^3)))$
Eingaben
- input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Ausgaben
- output:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
3.7.56 Where
Wählt Werte aus x_tensor oder y_tensor anhand von mask_tensor: Bei True wird der entsprechende x_tensor-Wert gewählt, sonst der y_tensor-Wert.
Eingaben
- mask_tensor:T1
- shape:[batch,channel,height,width]
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- x_tensor:*T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
- y_tensor:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- output:T2
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:bool(Tensor)
- T2:int8(Tensor)
3.7.57 exGlu
Gated-Linear-Unit-Funktion; a ist die erste Hälfte der Eingabematrix, b die zweite.
GLU(a,b)=a⊗σ(b)
Eingaben
- Input:T1
- shape:[batch,channel,height,width]
- Quantisierungsunterstützung:per‑layer.
Ausgaben
- Output:T1
- shape:[batch,channel/2,height,width]
- Quantisierungsunterstützung:per‑layer.
Datentypbeschränkungen
- T1:int8(Tensor)
Attribute
- axis:int(Standardwert=1)
- Dimension, entlang der die Eingabe geteilt wird.
- Einschränkung: nur 1 unterstützt.
3.7.58 exMatMul
Matrixmultiplikation
Y =
  A · B + C   if c_type = "add"
  A · B * C   if c_type = "mul"
Eingaben
- A:T1
- shape:[b,k,1,n]
- k ∈(0,8192]
- Quantisierungsunterstützung
- per‑layer
- shape:[b,k,1,n]
- B:T1
- shape:[b,k,1,m]
- Quantisierungsunterstützung
- per‑layer
- C(optional):T1,T2
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
- Broadcasting-Unterstützung
- Broadcasting entlang beliebiger Dimensionen wird unterstützt.
- Broadcasting-Einschränkungen wie beim Operator Expand.
Ausgaben
- Y:T1
- shape:[b,n,1,m]
- Quantisierungsunterstützung
- per‑layer
Datentypbeschränkungen
- T1:int8(Tensor)
- T2:float(Tensor)
Attribute
- c_type:strings(Standardwert “add”)
- add oder mul legt fest, ob C addiert oder multipliziert wird.
3.7.59 exWindow
exWindow stammt von window_partition und window_reverse aus swin_transformer. In der Originalarbeit werden Eingabemerkmale in nicht überlappende Fenster der Größe window_size×window_size aufgeteilt. Ein- und Ausgabemerkmale müssen eine 4-dimensionale shape haben und in Höhe und Breite aufgeteilt werden. Die PyTorch-Implementierung folgt:
def window_partition(x, window_size):
  """
  Args:
    x: (B, C, H, W)
    window_size (int): window size
  Returns:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
  """
  B, C, H, W = x.shape
  x = x.view(B, C, H // window_size, window_size, W // window_size, window_size)
  windows = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, -1, window_size*window_size)
  return windows
def window_reverse(windows, window_size, H, W):
  """
  Args:
    windows: (B, C, num_windows*num_windows, window_size*window_size)
    window_size (int): Window size
    H (int): Height of image
    W (int): Width of image
  Returns:
    x: (B, C, H, W)
  """
  B,C,_,_ = windows.shape
  x = windows.view(B, C, H // window_size, W // window_size, window_size, window_size)
  x = x.permute(0, 1, 2, 4, 3, 5).contiguous().view(B, C, H, W)
  return x
Eingaben
- X:T1
- shape:[batch,channel,height,width]
Ausgaben
- Y:T1
- shape:[batch,channel,height,width]
Datentypbeschränkungen
- T1:int8(Tensor)
Attribute
- mode:string
- Unterstützte Modi:partition,reverse,partition_num_first.
- partition: siehe Implementierung von window_partition.
- reverse: siehe Implementierung von window_reverse.
- partition_num_first unterscheidet sich von partition dadurch, dass H,W nach num_windows aufgeteilt werden; partition teilt H,W dagegen nach window_sizes auf.
- Unterstützte Modi:partition,reverse,partition_num_first.
- window_sizes:listofints
- 2-dimensionaler Vektor der Fenstergröße, der Höhe und Breite jedes Fensters festlegt. Auf dieser Größe beruhen Aufmerksamkeitsberechnung und Merkmalsextraktion innerhalb des Fensters.
- num_windows:listofints
- 2-dimensionaler Vektor der Fensteranzahl; legt fest, in wie viele Fenster Höhe und Breite der Eingabemerkmale geteilt werden.
Weitere Unterstützung
- Zusammenarbeit mehrerer Kerne: noch nicht unterstützt.
- Operatorspezifikationen für 3566/3568
- Operatorspezifikationen für 3588
- Operatorspezifikationen für 3562
- Operatorspezifikationen für 1103/1106
- Operatorspezifikationen für 3576/RV1126B
- Operatorspezifikationen für 2118
- Operatorspezifikationen für 1103B/1106B
Spezifikationen der CPU-Operatoren
4.1 Hinweis:
- RK2118 unterstützt keine CPU-Operatoren.
- RV1106/RV1103/RV1106B/RV1103B unterstützen nur einen Teil der nachfolgend aufgeführten CPU-Operatoren.
- Concat, DataConvert, Div, exLayerNorm, Exp, Gather, ReduceL2, ReduceMax, Reshape,ScatterND,Softmax
4.2 Add
- Beschreibung: Addition.
- Einschränkungen: keine.
4.3 AveragePool
- Beschreibung: Average-Pooling.
- Einschränkungen: keine.
4.4 ArgMin
- Beschreibung: Index des Minimalwerts.
- Einschränkungen: keine.
4.5 ArgMax
- Beschreibung: Index des Maximalwerts.
- Einschränkungen: keine.
4.6 BatchNormalization
- Beschreibung: Batch-Normalisierung.
- Einschränkungen: keine.
4.7 Cast
- Beschreibung: Datentypkonvertierung.
- Spezifikationsgrenzen
SRC unterstützt:float32/bool/int8/float16/int32/int64; DST unterstützt:float32/int8/int32/float16.
4.8 Clip
- Beschreibung: Aktivierungsschicht mit Wertebegrenzung.
- Einschränkungen: keine.
4.9 Concat
- Beschreibung: Verkettung.
- Einschränkungen: axis unterstützt nur {0,1,2,3}.
4.10 Convolution
- Beschreibung: Faltung.
- Einschränkungen: keine.
4.11 ConvTranspose/Deconvolution
- Beschreibung: transponierte Faltung.
- Einschränkungen: keine.
4.12 ConvTransposePad
- Beschreibung: kombinierter OP.
- Einschränkungen: keine.
4.13 Cos
- Beschreibung: Kosinusfunktion.
- Einschränkungen: keine.
4.14 DataConvert
- Beschreibung: Datentypkonvertierung.
- Einschränkungen: nur Typkonvertierung bool/int8/float unterstützt.
4.15 DepthToSpace
- Beschreibung: Umwandlung zwischen Kanal- und Raumdimensionen.
- Einschränkungen: keine.
4.16 Div
- Beschreibung: Division.
- Einschränkungen: keine.
4.17 Equal
- Beschreibung: Gleichheit.
- Einschränkungen: keine.
4.18 Exp
- Beschreibung: Exponentialfunktion.
- Einschränkungen: keine.
4.19 Flatten
- Beschreibung: Abflachen.
- Einschränkungen: keine.
4.20 Gather
- Beschreibung: Gather-Operation.
- Einschränkungen: keine.
4.21 Greater
- Beschreibung: größer als.
- Einschränkungen: keine.
4.22 GreaterOrEqual
- Beschreibung: größer oder gleich.
- Einschränkungen: keine.
4.23 GRU
- Beschreibung: Gated Recurrent Unit.
- Einschränkungen: keine.
4.24 exGRU
- Beschreibung: Gated Recurrent Unit.
- Einschränkungen: keine.
- Hinweis: ONNX-Erweiterungsoperator.
4.25 exHardSwish
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
- Hinweis: ONNX-Erweiterungsoperator.
4.26 InstanceNormalization
- Beschreibung: Instanznormalisierung.
- Einschränkungen: keine.
4.27 exLayerNorm
- Beschreibung: Schichtnormalisierung.
- Einschränkungen: keine.
- Hinweis: ONNX-Erweiterungsoperator.
4.28 Less
- Beschreibung: kleiner als.
- Einschränkungen: keine.
4.29 LessOrEqual
- Beschreibung: kleiner oder gleich.
- Einschränkungen: keine.
4.30 LogSoftmax
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: batchsize unterstützt nur 1.
4.31 LpNormalization
- Beschreibung: Lp-Normalisierung.
- Einschränkungen: keine.
4.32 exLRN
- Beschreibung: lokale Antwortnormalisierung.
- Einschränkungen: keine.
- Hinweis: ONNX-Erweiterungsoperator.
4.33 MatMul
- Beschreibung: mehrdimensionale Matrixmultiplikation.
- Einschränkungen: keine (vierdimensional x vierdimensional und vierdimensional x dreidimensional werden unterstützt).
4.34 Max
- Beschreibung: Maximalwert.
- Einschränkungen: keine.
4.35 MaxPool
- Beschreibung: Max-Pooling.
- Einschränkungen: keine.
4.36 MaxRoiPool
- Beschreibung: regionales Max-Pooling.
- Einschränkungen: keine.
4.37 MaxUnpool
- Beschreibung: inverses Max-Pooling.
- Einschränkungen: keine.
4.38 exMish
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
- Hinweis: ONNX-Erweiterungsoperator.
4.39 Min
- Beschreibung: Minimalwert.
- Einschränkungen: keine.
4.40 Mul
- Beschreibung: Multiplikation.
- Einschränkungen: keine.
4.41 Pad
- Beschreibung: Padding.
- Einschränkungen: keine.
4.42 Pow
- Beschreibung: Potenzierung.
- Einschränkungen: keine.
4.43 exProposal
- Beschreibung: Region Proposal Network.
- Einschränkungen: batchsize unterstützt nur 1.
- Hinweis: ONNX-Erweiterungsoperator.
4.44 ReduceMax
- Beschreibung: berechnet Max entlang angegebener Dimensionen.
- Einschränkungen: Ausgabe mit höchstens 4 Dimensionen.
4.45 ReduceMean
- Beschreibung: berechnet Mean entlang angegebener Dimensionen.
- Einschränkungen: Ausgabe mit höchstens 4 Dimensionen.
4.46 ReduceSum
- Beschreibung: berechnet Sum entlang angegebener Dimensionen.
- Einschränkungen: Ausgabe mit höchstens 4 Dimensionen.
4.47 ReduceMin
- Beschreibung: berechnet Min entlang angegebener Dimensionen.
- Einschränkungen: Ausgabe mit höchstens 4 Dimensionen.
4.48 Reorg
- Beschreibung: Datenumordnung.
- Einschränkungen: keine.
4.49 Reshape
- Beschreibung: Änderung der Datenform.
- Einschränkungen: keine.
4.50 Resize
- Beschreibung: skaliert Daten in Breite und Höhe.
- Einschränkungen: unterstützte Interpolationsmethoden bilinear;nearest2d.
4.51 ReverseSequence
- Beschreibung: Umkehrung der Sequenz.
- Einschränkungen: keine.
4.52 exRMSNorm
- Beschreibung: RMS-Normalisierung.
- Einschränkungen: keine.
- Hinweis: ONNX-Erweiterungsoperator.
4.53 RoiAlign
- Beschreibung: Pooling mit Bereichsausrichtung.
- Einschränkungen: nur AvgPoolMode unterstützt; batchsize nur 1.
4.54 ScatterND
- Beschreibung: N-dimensional indizierter Datenzugriff.
- Einschränkungen: keine.
4.55 Sin
- Beschreibung: Sinusfunktion.
- Einschränkungen: keine.
4.56 Slice
- Beschreibung: Slicing.
- Einschränkungen: batchsize unterstützt nur 1.
4.57 Softmax
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: batchsize unterstützt nur 1.
- Hinweis: entspricht ONNX OPSET11.
4.58 exSoftmax13
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: batchsize unterstützt nur 1.
- Hinweis: ONNX-Erweiterungsoperator entsprechend ONNX OPSET13.
4.59 SpaceToDetph
- Beschreibung: wandelt Raumdimensionen in die Kanaldimension um.
- Einschränkungen: keine.
4.60 Split
- Beschreibung: Datenaufteilung.
- Einschränkungen: keine.
4.61 Sqrt
- Beschreibung: Quadratwurzel.
- Einschränkungen: keine.
4.62 Squeeze
- Beschreibung: Entfernen von Datendimensionen der Größe eins.
- Einschränkungen: keine.
4.63 Sub
- Beschreibung: Subtraktion.
- Einschränkungen: keine.
4.64 Tanh
- Beschreibung: hyperbolischer Tangens.
- Einschränkungen: keine.
4.65 Tile
- Beschreibung: Datenerweiterung durch Kopieren.
- Einschränkungen: batchsize nur 1; Broadcasting nicht unterstützt.
4.66 Transpose
- Beschreibung: Transposition.
- Einschränkungen: keine.
4.67 Upsample
- Beschreibung: Upsampling.
- Einschränkungen: unterstützte Interpolationsmethoden bilinear;nearest2d.
4.68 Not
- Beschreibung: elementweises logisches NICHT.
- Einschränkungen: keine.
4.69 where
- Beschreibung: Datenauswahl anhand einer Maske.
- Einschränkungen: keine.
4.70 Erf
- Beschreibung: Fehlerfunktion.
- Einschränkungen: keine.
4.71 Floor
- Beschreibung: Abrundungsfunktion.
- Einschränkungen: keine.
4.72 Mod
- Beschreibung: Modulo-Funktion.
- Einschränkungen: keine.
4.73 exMeanVarianceNormalization
- Beschreibung: Mittelwert-Varianz-Normalisierung.
- Einschränkungen: keine.
4.74 And
- Beschreibung: UND-Funktion.
- Einschränkungen: keine.
4.75 GatherElements
- Beschreibung: Sammeln von Elementen.
- Einschränkungen: keine.
4.76 Log
- Beschreibung: Log-Funktion.
- Einschränkungen: keine.
4.77 exDataConvert
- Beschreibung: Präzisionskonvertierung.
- Einschränkungen: keine.
4.78 SpaceToDepth
- Beschreibung: Dimensionstransformation.
- Einschränkungen: keine.
4.79 SoftmaxMask
- Beschreibung: Aktivierungsfunktion mit Fusion von where und softmax.
- Einschränkungen: keine.
4.80 TransposeReshape
- Beschreibung: kombinierter OP.
- Einschränkungen: keine.
4.81 ReshapeTranspose
- Beschreibung: kombinierter OP.
- Einschränkungen: keine.
4.82 ReduceL2
- Beschreibung: L2-Norm entlang einer Achse.
- Einschränkungen: keine.
4.83 LayerNormalization
- Beschreibung: Schichtstandardisierung.
- Einschränkungen: keine.
4.84 PassThrough
- Beschreibung: direkte Verbindung.
- Einschränkungen: keine.
4.85 Expand
- Beschreibung: Replikation oder Erweiterung von Tensordaten.
- Einschränkungen: keine.
4.86 Sigmoid
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
4.87 Tanh
- Beschreibung: trigonometrische Funktion.
- Einschränkungen: keine.
4.88 Cos
- Beschreibung: trigonometrische Funktion.
- Einschränkungen: keine.
4.89 Sin
- Beschreibung: trigonometrische Funktion.
- Einschränkungen: keine.
4.90 exSwish
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
4.91 exGlu
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
4.92 exGelu
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
4.93 exWindow
- Beschreibung: exWindow stammt von window_partition und window_reverse aus Swin‑Transformer.
- Einschränkungen: keine.
4.94 exNorm
- Beschreibung: Bei mode=‘pixel‘ verwendet exNorm PixelNorm. Ohne Angabe von mode verwendet exNorm
standardmäßig LayerNorm.
- Einschränkungen: keine.
4.95 Round
- Beschreibung: Datensättigung.
- Einschränkungen: keine.
4.96 TopK
- Beschreibung: Abruf der K höchstplatzierten Werte.
- Einschränkungen: keine.
4.97 exSwooshR
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
4.98 exSwooshL
- Beschreibung: Aktivierungsfunktion.
- Einschränkungen: keine.
4.99 OneHot
- Beschreibung: One-Hot-Kodierung.
- Einschränkungen: keine.
Beschränkungen für Modelleingaben und -ausgaben
5.1 Beschränkungen für Modelleingaben
- (1) Diese Ausrichtungsbeschränkungen gelten nur für Zero-Copy-APIs, nicht für gewöhnliche APIs.
- (2) Die Ausrichtung der Eingangsbreite lässt sich über w_stride der Zero-Copy-API abfragen. Hinweis: w_stride kann nicht geändert werden.
- (3) Nur die Eingangsbreite (width) hat abhängig von channel Ausrichtungsanforderungen; sonst bestehen keine Einschränkungen.
- (4) Werden mean und scale nicht benötigt, mean und scale auf 0 beziehungsweise 1 setzen.
- (5) Bei channel>4 verwenden mean/scale einheitlich den ersten Wert, also mean[0] und scale[0].
- (6) Bei einer ersten Schicht mit Gleitkommatyp entfällt die quant-Operation.
- (7) RV1106/RV1103/RV1103B unterstützen keine CPU-Operationen mean/scale/quant.
- (8) Einzelheiten zur Verwendung stehen in Rockchip_RKNPU_User_Guide_RKNN_SDK.
5.1.1 RK3566/RK3568
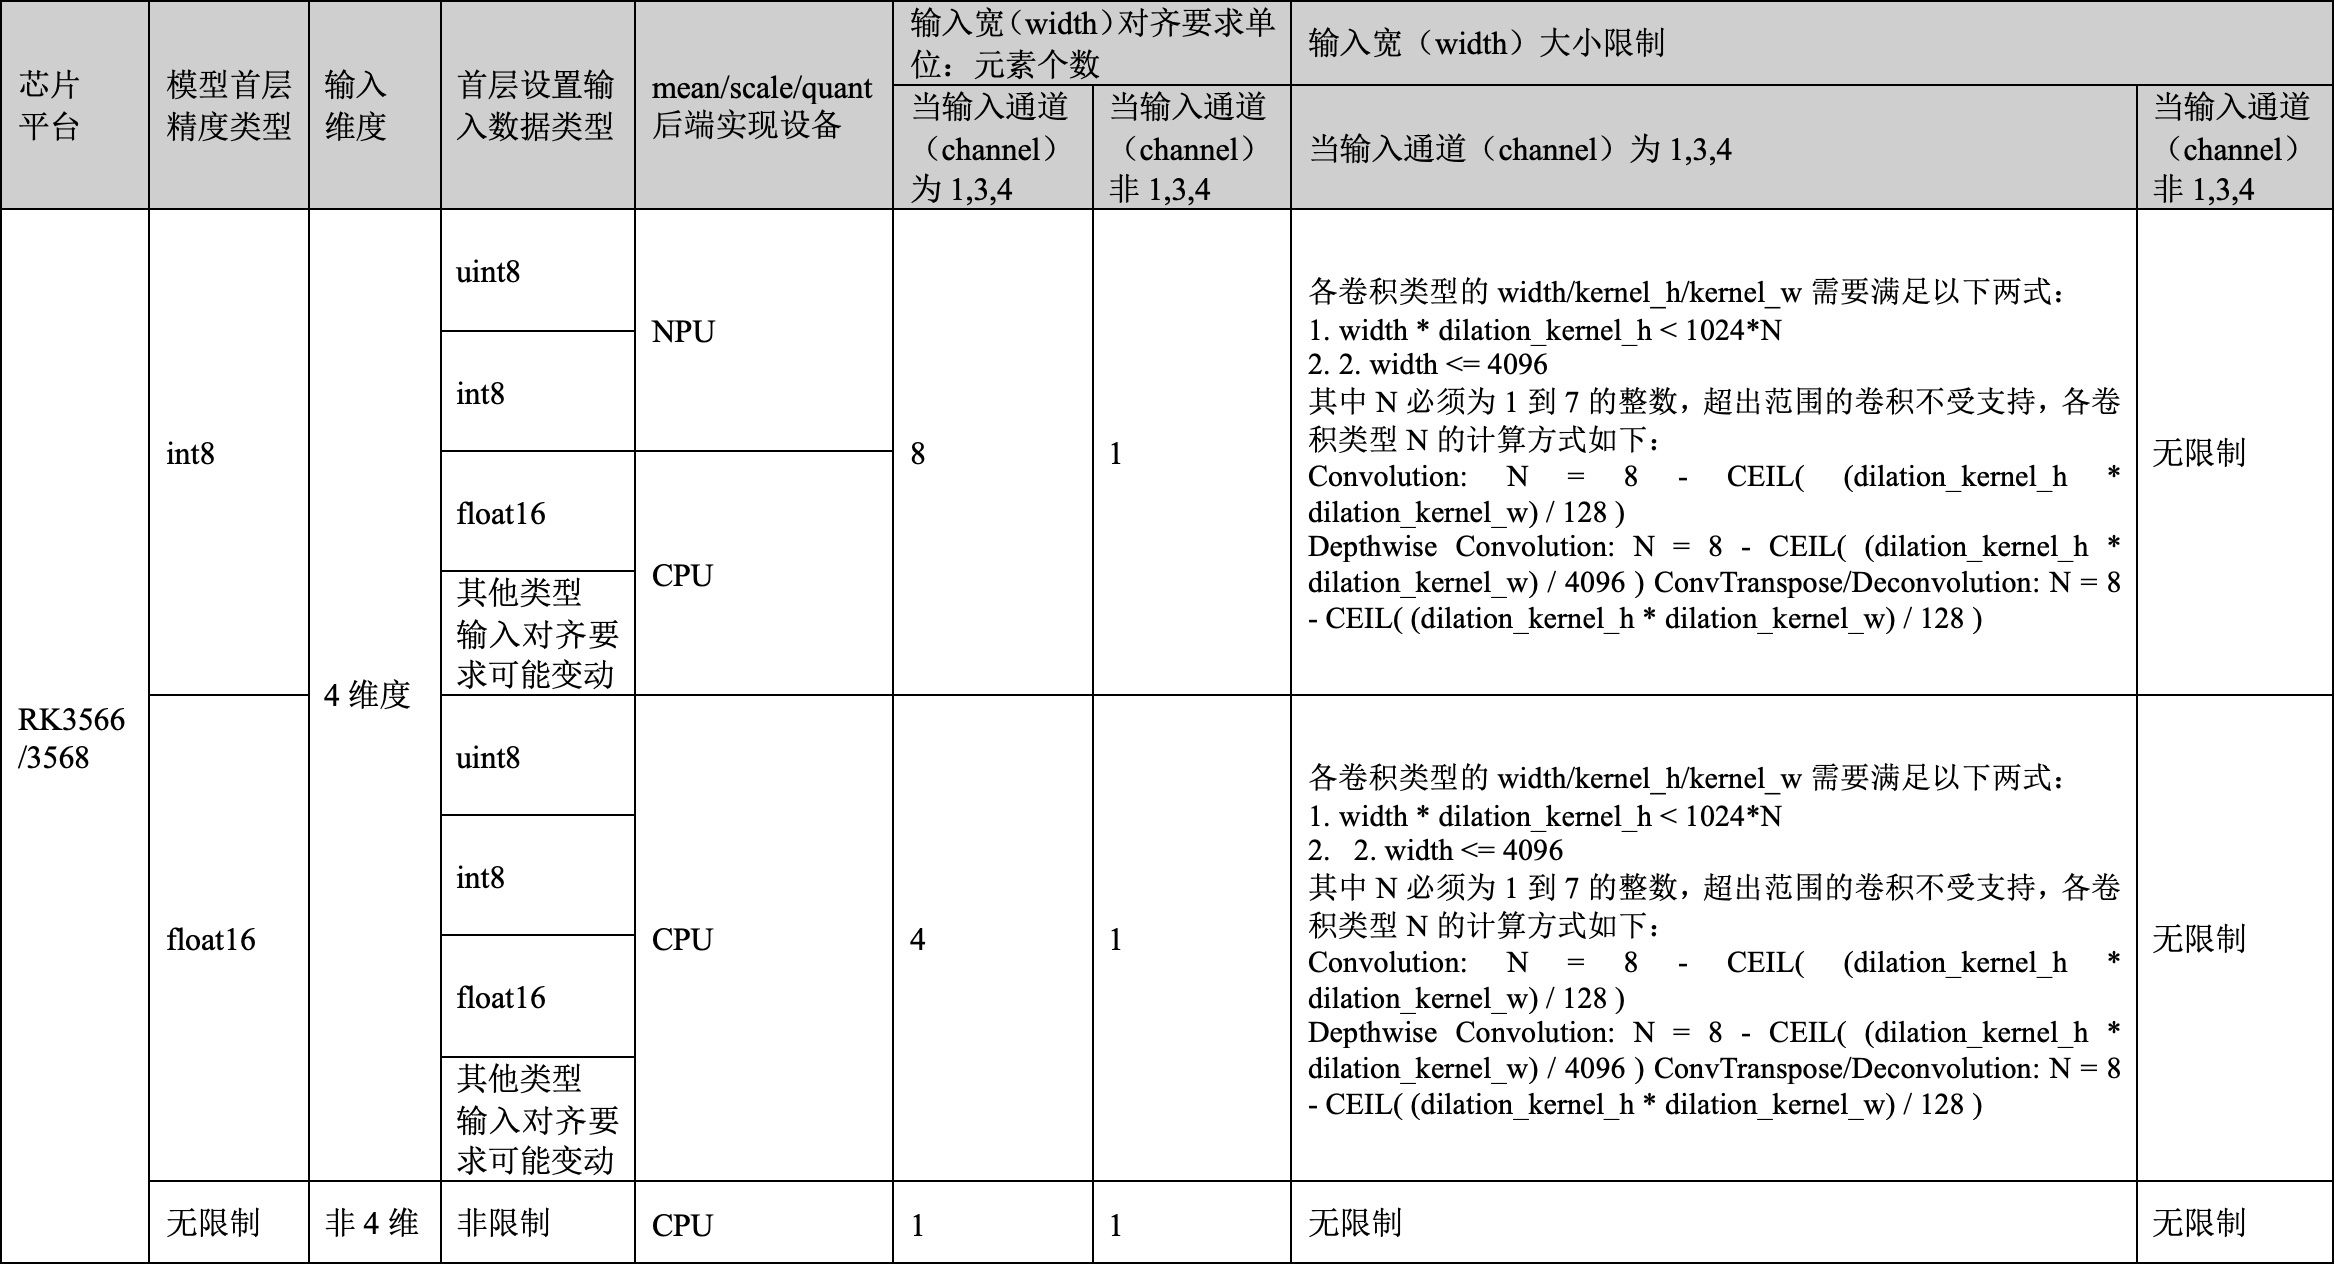
Editierbare Übertragung des Originals (verbundene Zellen aufgelöst):
| Plattform | Präzision der ersten Schicht | Eingabedimensionen | Konfigurierter Eingabetyp der ersten Schicht | mean/scale/quant-Backend | width-Ausrichtung (Elemente), channel=1,3,4 | width-Ausrichtung (Elemente), channel≠1,3,4 | width-Grenzen, channel=1,3,4 | width-Grenzen, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3566/RK3568 | int8 | 4 | uint8 | NPU | 8 | 1 | A | Uneingeschränkt |
| RK3566/RK3568 | int8 | 4 | int8 | NPU | 8 | 1 | A | Uneingeschränkt |
| RK3566/RK3568 | int8 | 4 | float16 | CPU | 8 | 1 | A | Uneingeschränkt |
| RK3566/RK3568 | int8 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 8 | 1 | A | Uneingeschränkt |
| RK3566/RK3568 | float16 | 4 | uint8 | CPU | 4 | 1 | B | Uneingeschränkt |
| RK3566/RK3568 | float16 | 4 | int8 | CPU | 4 | 1 | B | Uneingeschränkt |
| RK3566/RK3568 | float16 | 4 | float16 | CPU | 4 | 1 | B | Uneingeschränkt |
| RK3566/RK3568 | float16 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 4 | 1 | B | Uneingeschränkt |
| RK3566/RK3568 | Uneingeschränkt | Nicht 4-dimensional | Uneingeschränkt | CPU | 1 | 1 | Uneingeschränkt | Uneingeschränkt |
Für jeden Faltungstyp müssen width/kernel_h/kernel_w beide folgenden Bedingungen erfüllen. N muss eine ganze Zahl von 1 bis 7 sein; Faltungen außerhalb dieses Bereichs werden nicht unterstützt. Die N-Berechnung folgt. Die Abbildung verwendet dilation_kernel_h/w statt dilated_kernel_h/w im letzten Kapitel; die Schreibweise der Abbildung bleibt erhalten.
| Bedingung | Formel |
|---|---|
| A (1) | width * dilation_kernel_h < 1024 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| Bedingung | Formel |
|---|---|
| B (1) | width * dilation_kernel_h < 1024 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| B / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| B / ConvTranspose/Deconvolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
5.1.2 RK3588
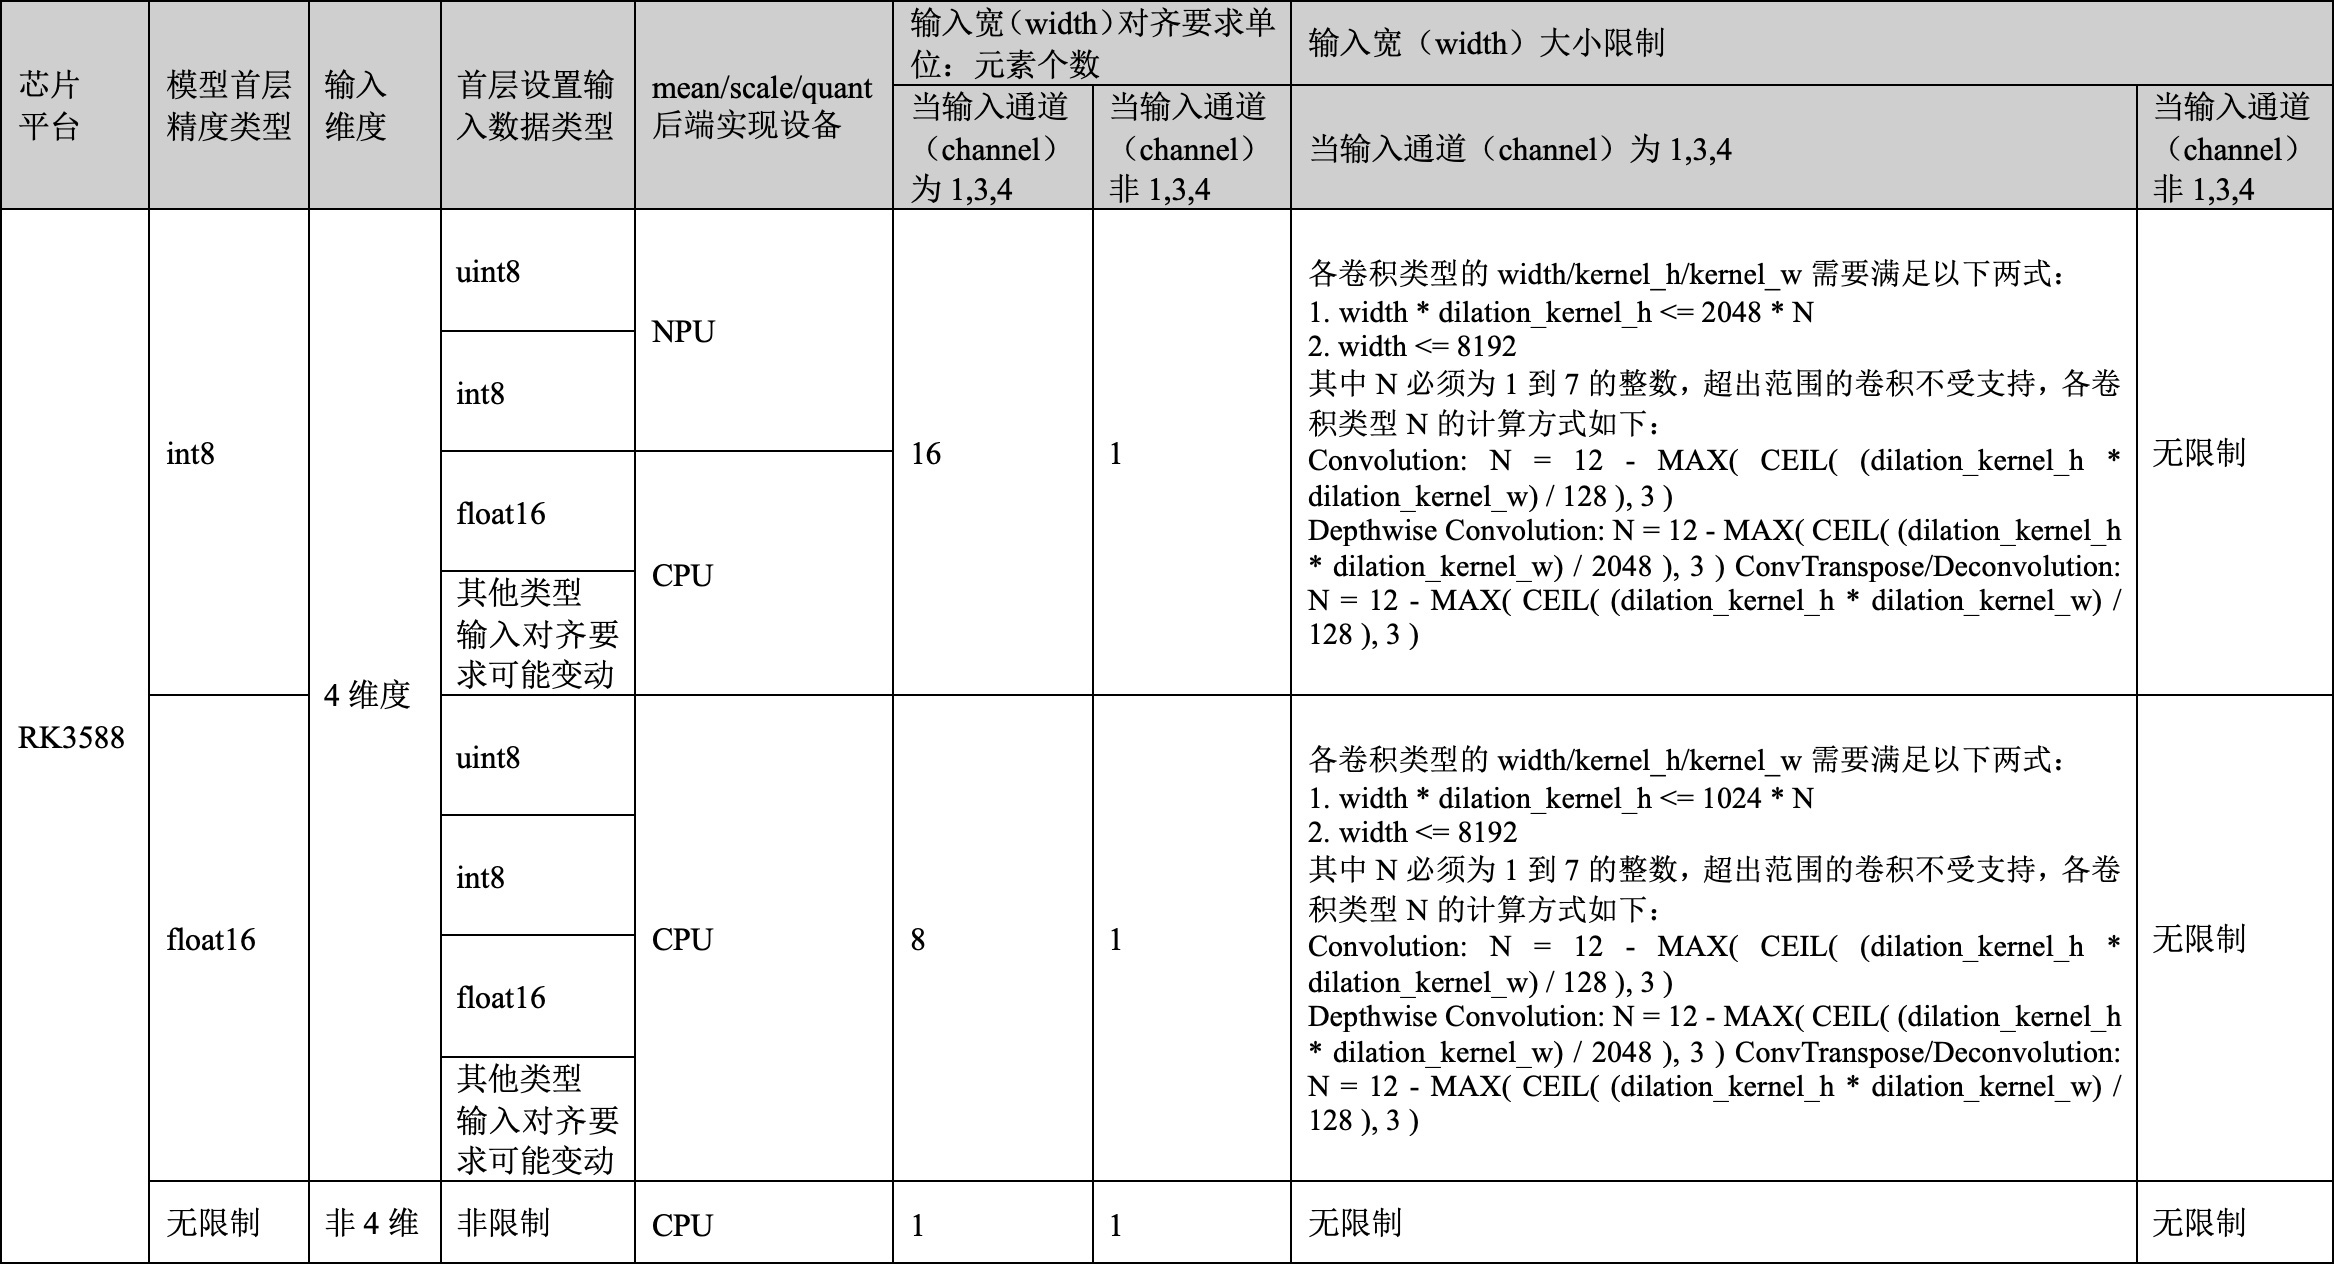
Editierbare Übertragung des Originals (verbundene Zellen aufgelöst):
| Plattform | Präzision der ersten Schicht | Eingabedimensionen | Konfigurierter Eingabetyp der ersten Schicht | mean/scale/quant-Backend | width-Ausrichtung (Elemente), channel=1,3,4 | width-Ausrichtung (Elemente), channel≠1,3,4 | width-Grenzen, channel=1,3,4 | width-Grenzen, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3588 | int8 | 4 | uint8 | NPU | 16 | 1 | A | Uneingeschränkt |
| RK3588 | int8 | 4 | int8 | NPU | 16 | 1 | A | Uneingeschränkt |
| RK3588 | int8 | 4 | float16 | CPU | 16 | 1 | A | Uneingeschränkt |
| RK3588 | int8 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 16 | 1 | A | Uneingeschränkt |
| RK3588 | float16 | 4 | uint8 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3588 | float16 | 4 | int8 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3588 | float16 | 4 | float16 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3588 | float16 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3588 | Uneingeschränkt | Nicht 4-dimensional | Uneingeschränkt | CPU | 1 | 1 | Uneingeschränkt | Uneingeschränkt |
Für jeden Faltungstyp müssen width/kernel_h/kernel_w beide folgenden Bedingungen erfüllen. N muss eine ganze Zahl von 1 bis 7 sein; Faltungen außerhalb dieses Bereichs werden nicht unterstützt. Die N-Berechnung folgt. Die Abbildung verwendet dilation_kernel_h/w statt dilated_kernel_h/w im letzten Kapitel; die Schreibweise der Abbildung bleibt erhalten.
| Bedingung | Formel |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 8192 |
| A / Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| A / Depthwise Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| A / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| Bedingung | Formel |
|---|---|
| B (1) | width * dilation_kernel_h <= 1024 * N |
| B (2) | width <= 8192 |
| B / Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| B / Depthwise Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| B / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
5.1.3 RV1103/RV1106
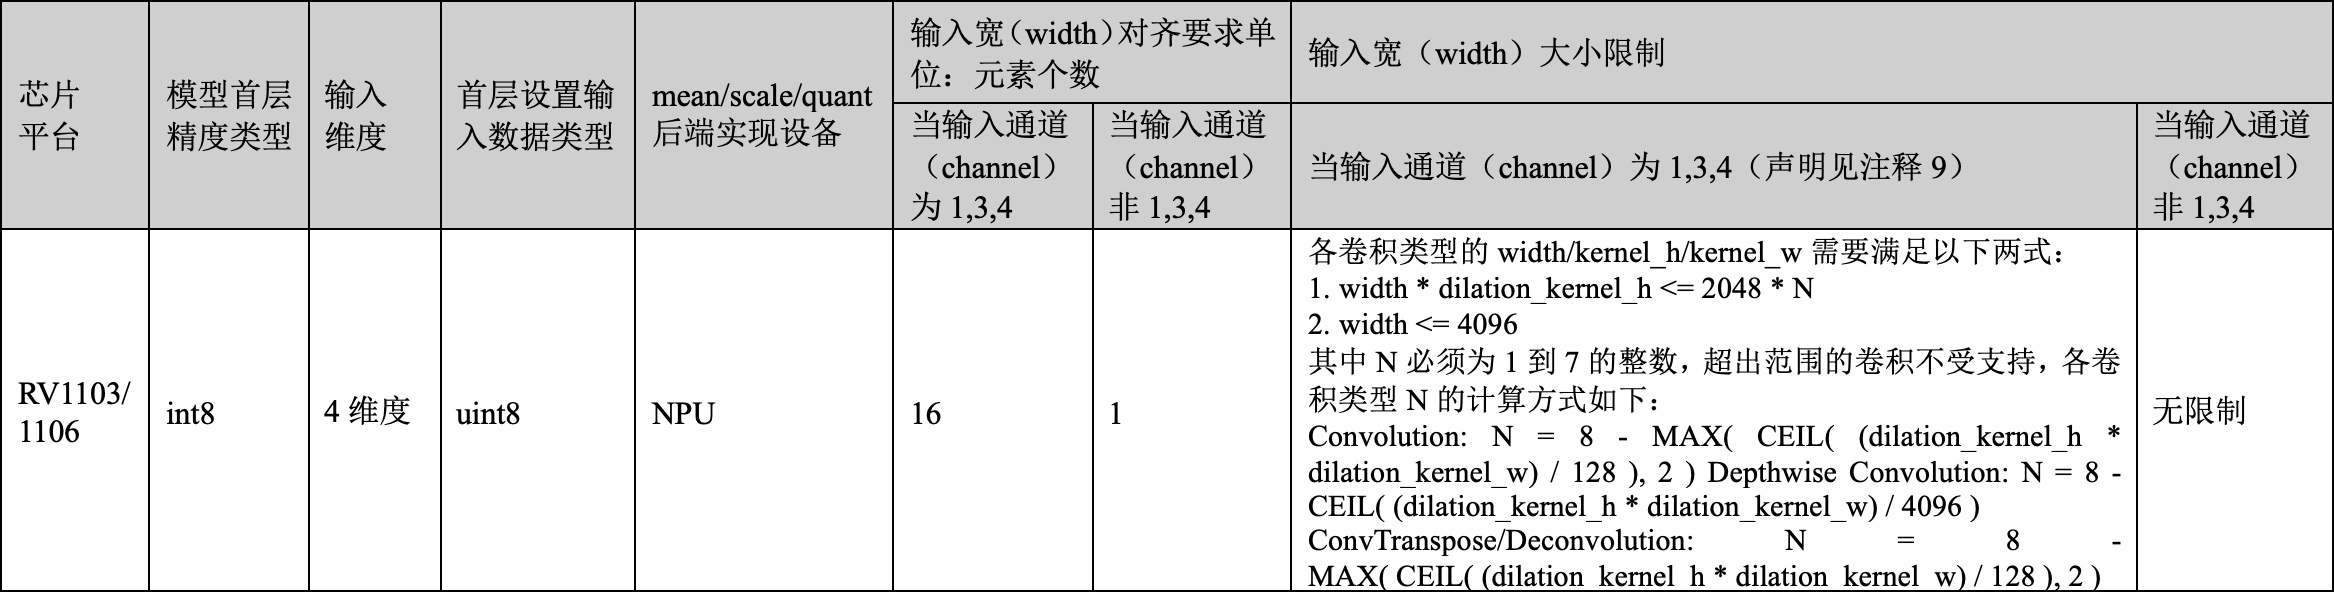
Editierbare Übertragung des Originals (verbundene Zellen aufgelöst):
| Plattform | Präzision der ersten Schicht | Eingabedimensionen | Konfigurierter Eingabetyp der ersten Schicht | mean/scale/quant-Backend | width-Ausrichtung (Elemente), channel=1,3,4 | width-Ausrichtung (Elemente), channel≠1,3,4 | width-Grenzen, channel=1,3,4 | width-Grenzen, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RV1103/RV1106 | int8 | 4 | uint8 | NPU | 16 | 1 | A | Uneingeschränkt |
Für jeden Faltungstyp müssen width/kernel_h/kernel_w beide folgenden Bedingungen erfüllen. N muss eine ganze Zahl von 1 bis 7 sein; Faltungen außerhalb dieses Bereichs werden nicht unterstützt. Die N-Berechnung folgt. Die Abbildung verwendet dilation_kernel_h/w statt dilated_kernel_h/w im letzten Kapitel; die Schreibweise der Abbildung bleibt erhalten.
| Bedingung | Formel |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
Der Originalkopf verweist auf Anmerkung 9; die vorliegenden Eingabehinweise enthalten nur 1–8. Anmerkung 9 wurde nicht gefunden und wird nicht erfunden.
5.1.4 RK3562
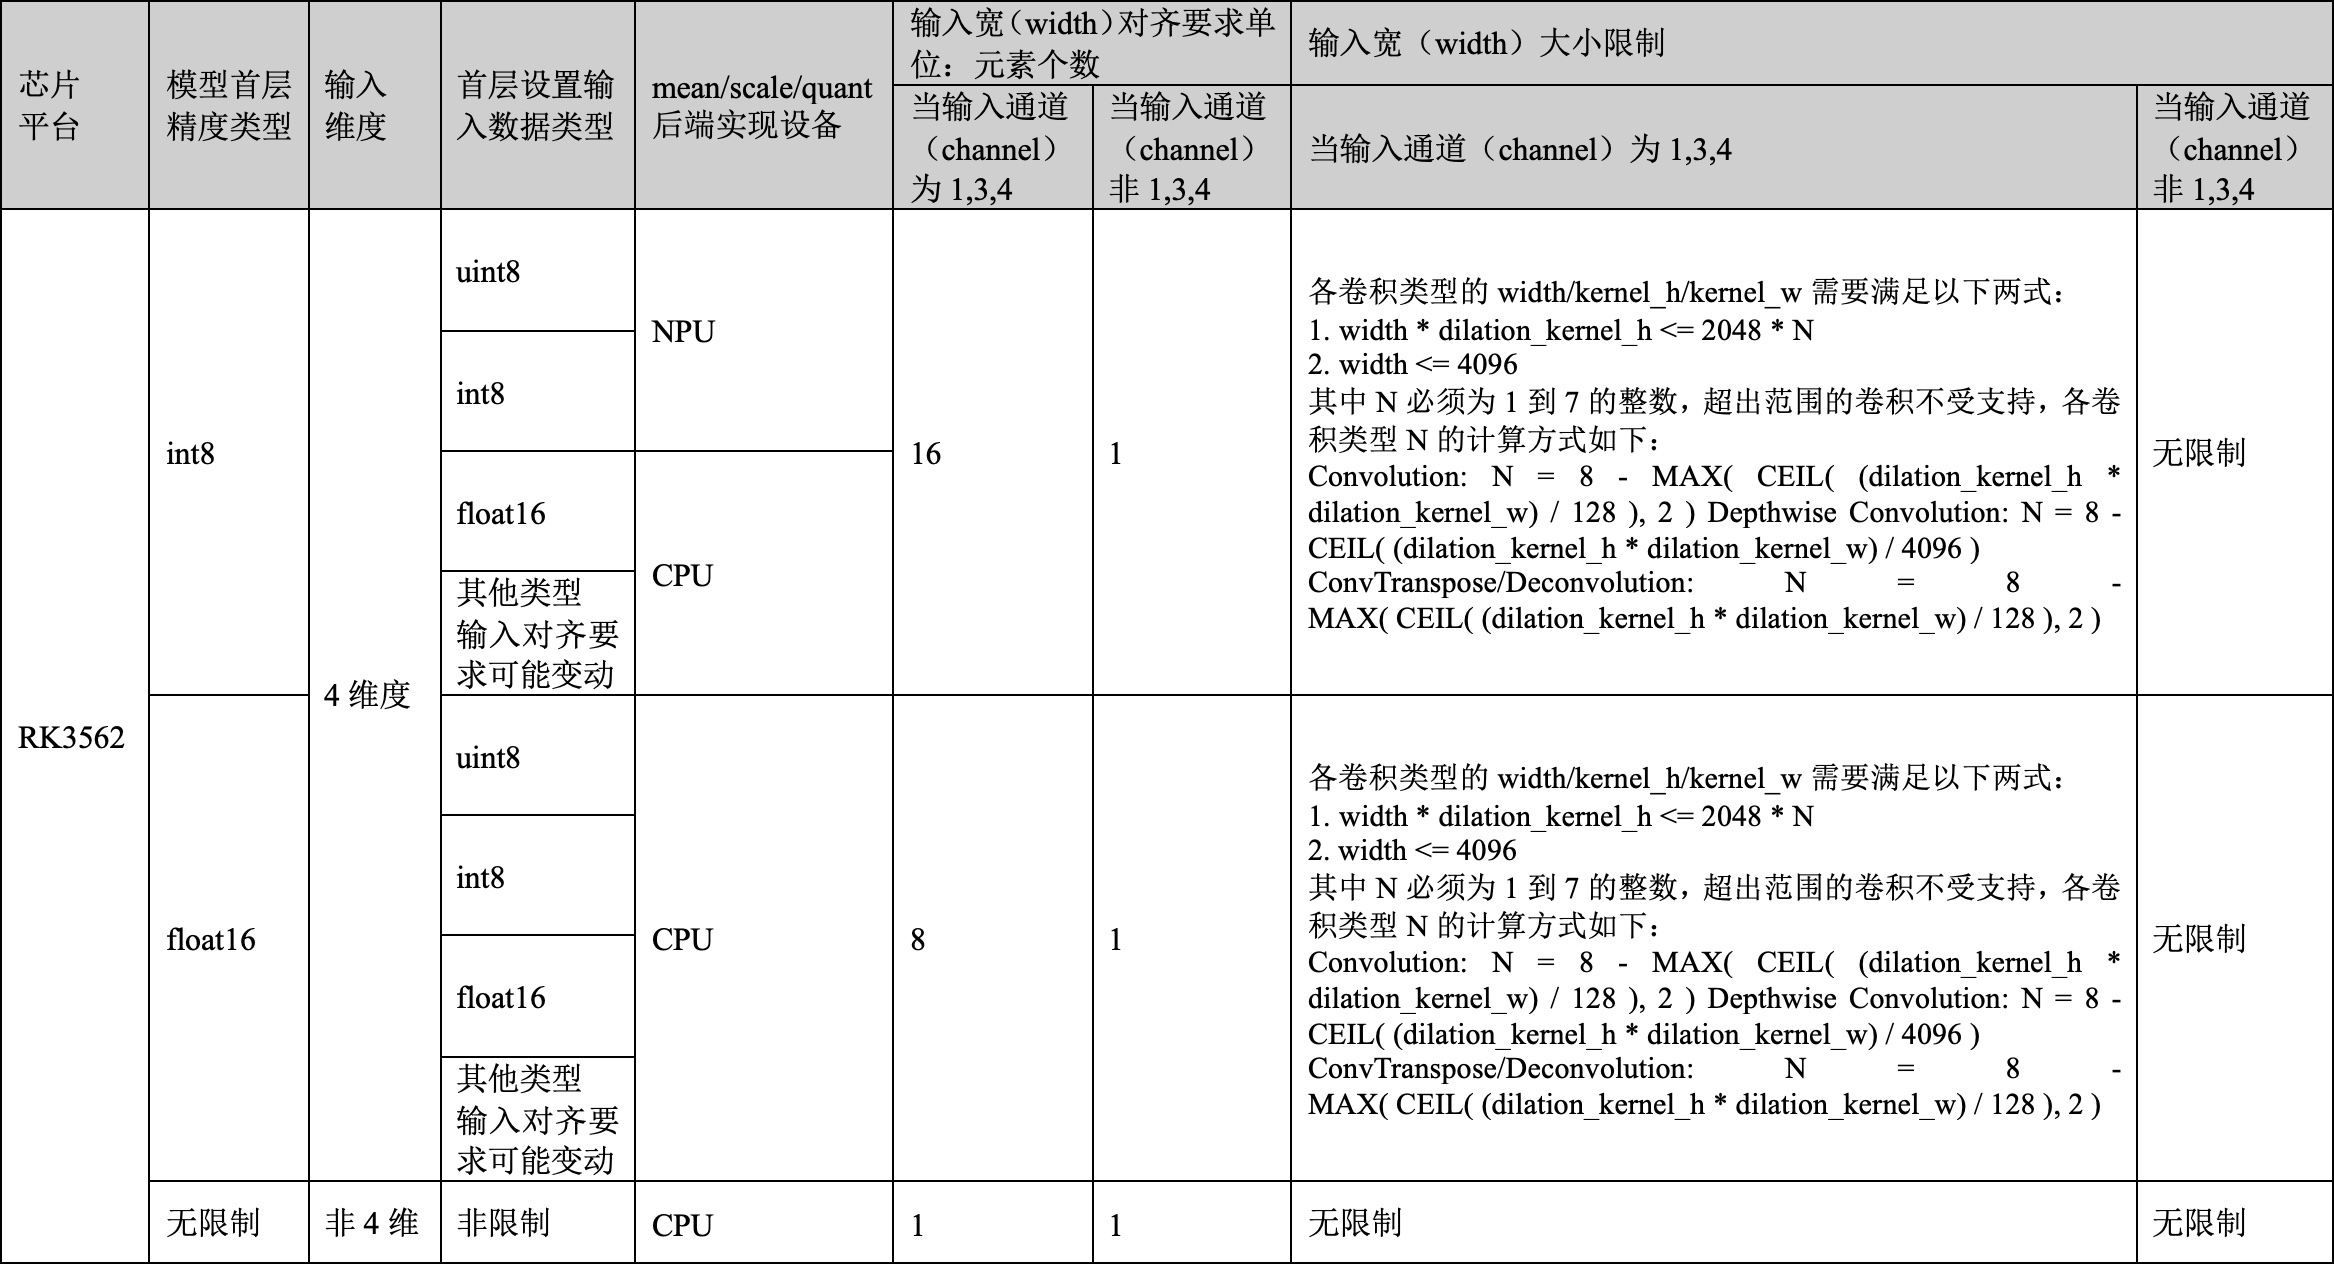
Editierbare Übertragung des Originals (verbundene Zellen aufgelöst):
| Plattform | Präzision der ersten Schicht | Eingabedimensionen | Konfigurierter Eingabetyp der ersten Schicht | mean/scale/quant-Backend | width-Ausrichtung (Elemente), channel=1,3,4 | width-Ausrichtung (Elemente), channel≠1,3,4 | width-Grenzen, channel=1,3,4 | width-Grenzen, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3562 | int8 | 4 | uint8 | NPU | 16 | 1 | A | Uneingeschränkt |
| RK3562 | int8 | 4 | int8 | NPU | 16 | 1 | A | Uneingeschränkt |
| RK3562 | int8 | 4 | float16 | CPU | 16 | 1 | A | Uneingeschränkt |
| RK3562 | int8 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 16 | 1 | A | Uneingeschränkt |
| RK3562 | float16 | 4 | uint8 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3562 | float16 | 4 | int8 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3562 | float16 | 4 | float16 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3562 | float16 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3562 | Uneingeschränkt | Nicht 4-dimensional | Uneingeschränkt | CPU | 1 | 1 | Uneingeschränkt | Uneingeschränkt |
Für jeden Faltungstyp müssen width/kernel_h/kernel_w beide folgenden Bedingungen erfüllen. N muss eine ganze Zahl von 1 bis 7 sein; Faltungen außerhalb dieses Bereichs werden nicht unterstützt. Die N-Berechnung folgt. Die Abbildung verwendet dilation_kernel_h/w statt dilated_kernel_h/w im letzten Kapitel; die Schreibweise der Abbildung bleibt erhalten.
| Bedingung | Formel |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| Bedingung | Formel |
|---|---|
| B (1) | width * dilation_kernel_h <= 2048 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| B / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| B / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
5.1.5 RK3576/RV1126B
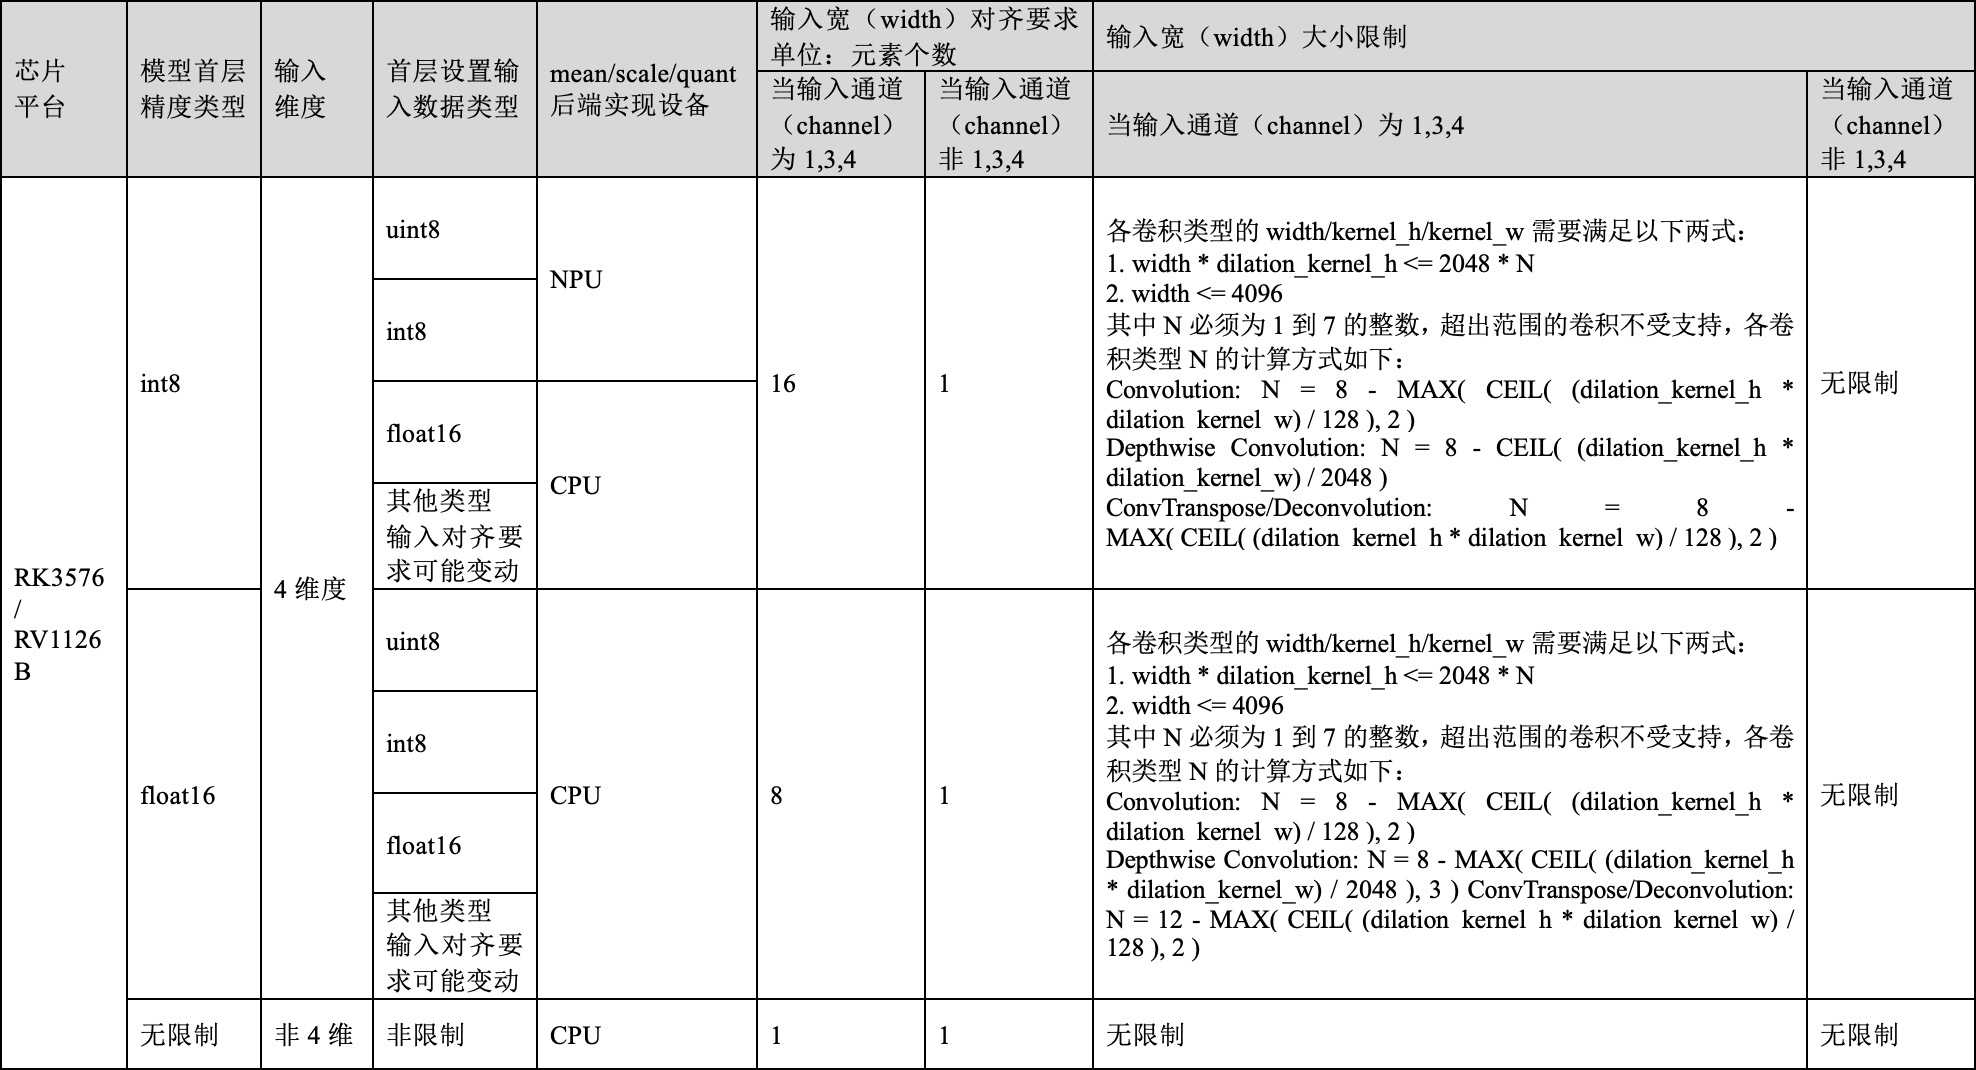
Editierbare Übertragung des Originals (verbundene Zellen aufgelöst):
| Plattform | Präzision der ersten Schicht | Eingabedimensionen | Konfigurierter Eingabetyp der ersten Schicht | mean/scale/quant-Backend | width-Ausrichtung (Elemente), channel=1,3,4 | width-Ausrichtung (Elemente), channel≠1,3,4 | width-Grenzen, channel=1,3,4 | width-Grenzen, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3576/RV1126B | int8 | 4 | uint8 | NPU | 16 | 1 | A | Uneingeschränkt |
| RK3576/RV1126B | int8 | 4 | int8 | NPU | 16 | 1 | A | Uneingeschränkt |
| RK3576/RV1126B | int8 | 4 | float16 | CPU | 16 | 1 | A | Uneingeschränkt |
| RK3576/RV1126B | int8 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 16 | 1 | A | Uneingeschränkt |
| RK3576/RV1126B | float16 | 4 | uint8 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3576/RV1126B | float16 | 4 | int8 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3576/RV1126B | float16 | 4 | float16 | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3576/RV1126B | float16 | 4 | Andere Typen (Eingabeausrichtung kann abweichen) | CPU | 8 | 1 | B | Uneingeschränkt |
| RK3576/RV1126B | Uneingeschränkt | Nicht 4-dimensional | Uneingeschränkt | CPU | 1 | 1 | Uneingeschränkt | Uneingeschränkt |
Für jeden Faltungstyp müssen width/kernel_h/kernel_w beide folgenden Bedingungen erfüllen. N muss eine ganze Zahl von 1 bis 7 sein; Faltungen außerhalb dieses Bereichs werden nicht unterstützt. Die N-Berechnung folgt. Die Abbildung verwendet dilation_kernel_h/w statt dilated_kernel_h/w im letzten Kapitel; die Schreibweise der Abbildung bleibt erhalten.
| Bedingung | Formel |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 2048) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| Bedingung | Formel |
|---|---|
| B (1) | width * dilation_kernel_h <= 2048 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| B / Depthwise Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| B / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
5.1.6 RK2118
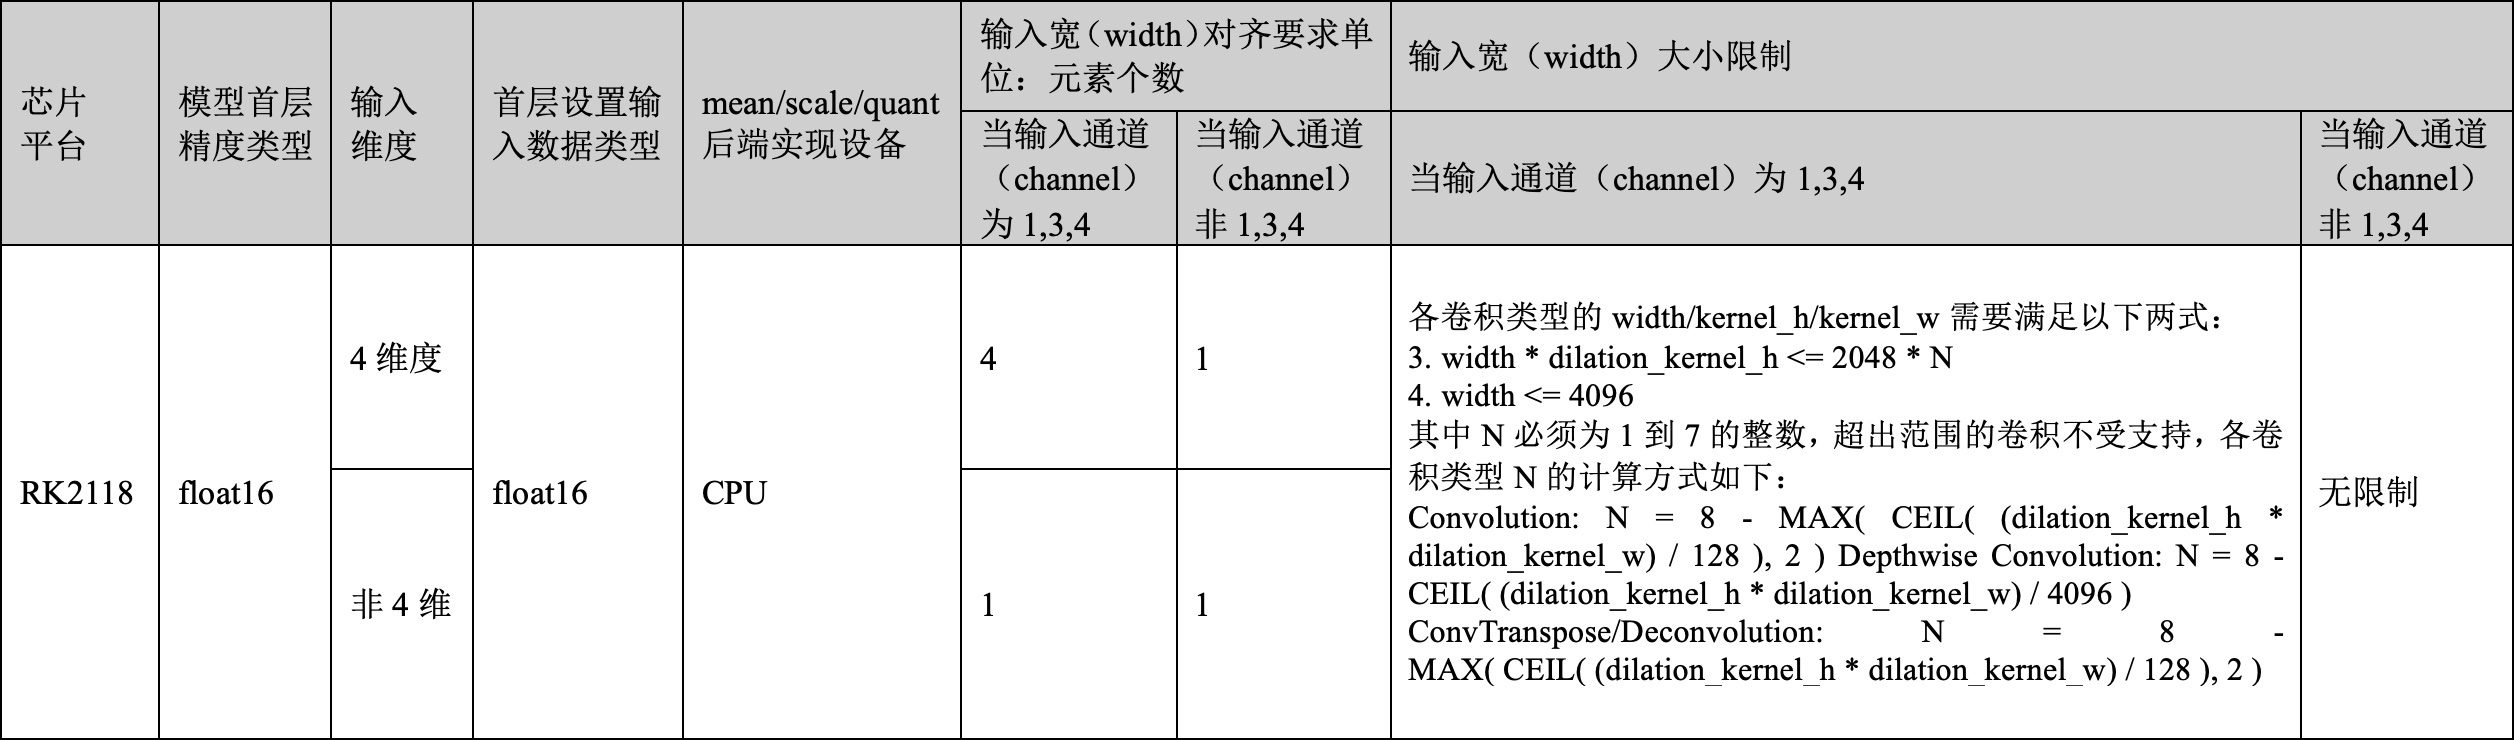
Editierbare Übertragung des Originals (verbundene Zellen aufgelöst):
| Plattform | Präzision der ersten Schicht | Eingabedimensionen | Konfigurierter Eingabetyp der ersten Schicht | mean/scale/quant-Backend | width-Ausrichtung (Elemente), channel=1,3,4 | width-Ausrichtung (Elemente), channel≠1,3,4 | width-Grenzen, channel=1,3,4 | width-Grenzen, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK2118 | float16 | 4 | float16 | CPU | 4 | 1 | A | Uneingeschränkt |
| RK2118 | float16 | Nicht 4-dimensional | float16 | CPU | 1 | 1 | A | Uneingeschränkt |
Für jeden Faltungstyp müssen width/kernel_h/kernel_w beide folgenden Bedingungen erfüllen. N muss eine ganze Zahl von 1 bis 7 sein; Faltungen außerhalb dieses Bereichs werden nicht unterstützt. Die N-Berechnung folgt. Die Abbildung verwendet dilation_kernel_h/w statt dilated_kernel_h/w im letzten Kapitel; die Schreibweise der Abbildung bleibt erhalten.
| Bedingung | Formel |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
5.1.7 RV1103B
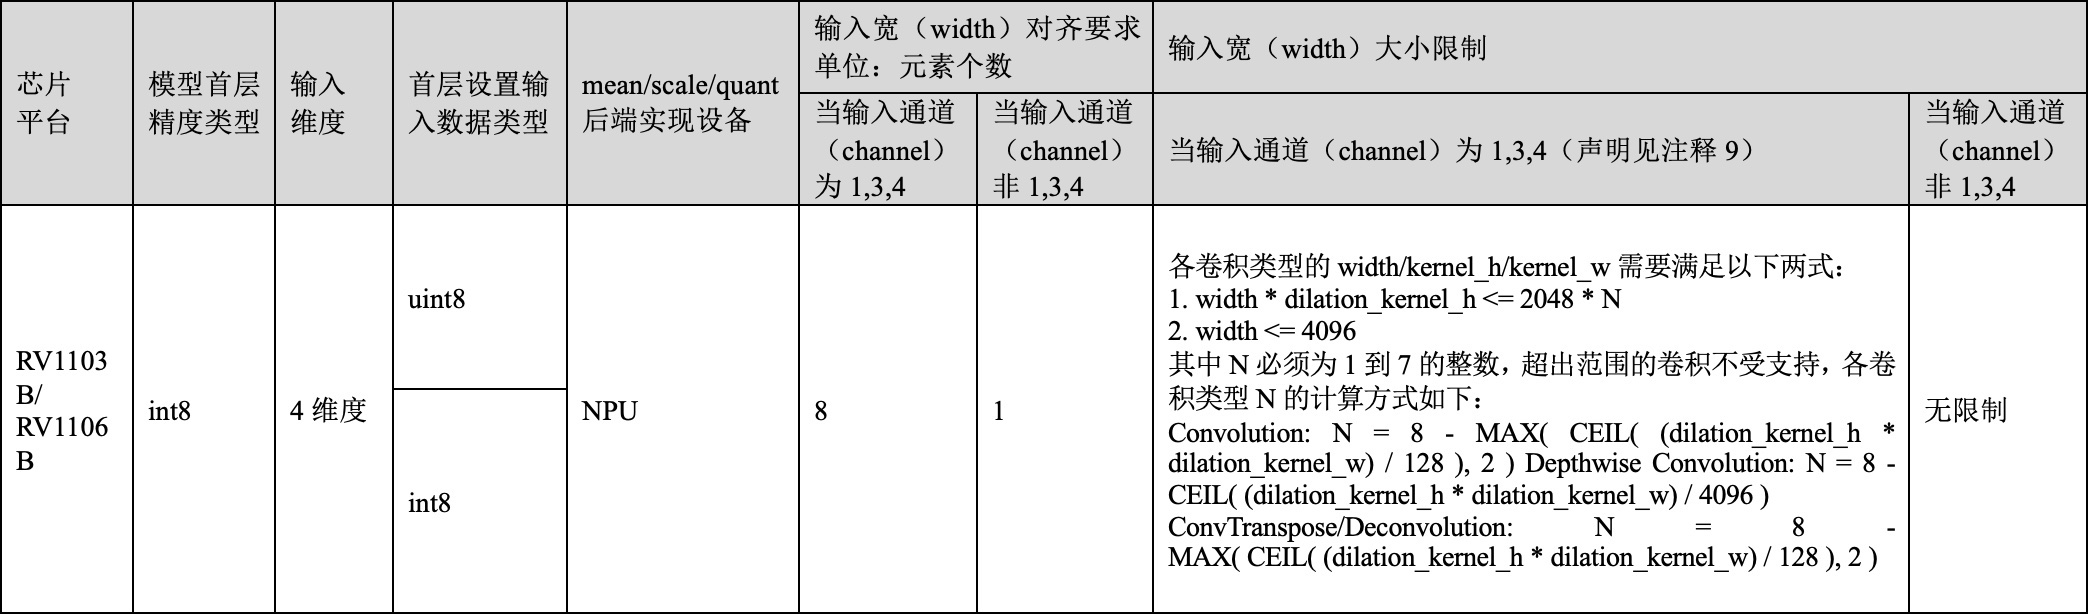
Editierbare Übertragung des Originals (verbundene Zellen aufgelöst):
| Plattform | Präzision der ersten Schicht | Eingabedimensionen | Konfigurierter Eingabetyp der ersten Schicht | mean/scale/quant-Backend | width-Ausrichtung (Elemente), channel=1,3,4 | width-Ausrichtung (Elemente), channel≠1,3,4 | width-Grenzen, channel=1,3,4 | width-Grenzen, channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RV1103B/RV1106B | int8 | 4 | uint8 | NPU | 8 | 1 | A | Uneingeschränkt |
| RV1103B/RV1106B | int8 | 4 | int8 | NPU | 8 | 1 | A | Uneingeschränkt |
Für jeden Faltungstyp müssen width/kernel_h/kernel_w beide folgenden Bedingungen erfüllen. N muss eine ganze Zahl von 1 bis 7 sein; Faltungen außerhalb dieses Bereichs werden nicht unterstützt. Die N-Berechnung folgt. Die Abbildung verwendet dilation_kernel_h/w statt dilated_kernel_h/w im letzten Kapitel; die Schreibweise der Abbildung bleibt erhalten.
| Bedingung | Formel |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
Der Originalkopf verweist auf Anmerkung 9; die vorliegenden Eingabehinweise enthalten nur 1–8. Anmerkung 9 wurde nicht gefunden und wird nicht erfunden.
5.2 Beschränkungen für Modellausgaben
- (1) Für einen NHWC-Ausgabetensor ist Ausrichtung erforderlich, wenn die NPU die Ausgabekonvertierung ausführt; bei CPU-Implementierung besteht keine Ausrichtungsanforderung.
- (2) Die Ausgabepräzision int8/float16 bezeichnet den ursprünglichen Ausgabedatentyp der letzten Modellschicht.
- (3) Bei NCHW-Ausgabe auf der NPU über eine Zero-Copy-Schnittstelle richtet sich die allokierte Ausgabespeichergröße size nach dem abgefragten size-Wert.
- (4) Bei NC1HWC2-Ausgabe richtet sich die allokierte Ausgabespeichergröße size nach dem abgefragten size-Wert.
5.2.1 RK3566/RK3568
| Chipplattform | Ausgabepräzision des Modells | Ausgabedimensionen | Ausgabe-Layout-Einstellung | Ausrichtungsanforderung für Channel | Ausrichtungsanforderung für H*W |
|---|---|---|---|---|---|
| RK3566 /RK3568 |
int8 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3566 /RK3568 |
int8 | 4 Dimensionen | NHWC | Auf 8 ausgerichtet | Keine |
| RK3566 /RK3568 |
int8 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 16 ausgerichtet; anderer Typ: auf 8 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3566 /RK3568 |
int8 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3566 /RK3568 |
float16 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3566 /RK3568 |
float16 | 4 Dimensionen | NHWC | Auf 4 ausgerichtet | |
| RK3566 /RK3568 |
float16 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 8 ausgerichtet; anderer Typ: auf 4 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3566 /RK3568 |
float16 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3566 /RK3568 |
Uneingeschränkt | Nicht 4 Dimensionen | UNDEFINE | Keine | Keine |
5.2.2 RK3588
| Chipplattform | Ausgabepräzision des Modells | Ausgabedimensionen | Ausgabe-Layout-Einstellung | Ausrichtungsanforderung für Channel | Ausrichtungsanforderung für H*W |
|---|---|---|---|---|---|
| RK3588 | int8 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3588 | int8 | 4 Dimensionen | NHWC | Auf 16 ausgerichtet | Keine |
| RK3588 | int8 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 32 ausgerichtet; anderer Typ: auf 16 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3588 | int8 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3588 | float16 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3588 | float16 | 4 Dimensionen | NHWC | Auf 8 ausgerichtet | Keine |
| RK3588 | float16 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 16 ausgerichtet; anderer Typ: auf 8 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3588 | float16 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3588 | Uneingeschränkt | Nicht 4 Dimensionen | UNDEFINE | Keine | Keine |
5.2.3 RV1103/RV1106
| Chipplattform | Ausgabepräzision des Modells | Ausgabedimensionen | Ausgabe-Layout-Einstellung | Ausrichtungsanforderung für Channel | Ausrichtungsanforderung für H*W |
|---|---|---|---|---|---|
| RV1103 /RV1106 |
int8 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 32 ausgerichtet; anderer Typ: auf 16 ausgerichtet. | H*W auf 4 ausgerichtet |
| RV1103 /RV1106 |
int8 | 4 Dimensionen | NHWC | Keine | Keine |
5.2.4 RK3562
| Chipplattform | Ausgabepräzision des Modells | Ausgabedimensionen | Ausgabe-Layout-Einstellung | Ausrichtungsanforderung für Channel | Ausrichtungsanforderung für H*W |
|---|---|---|---|---|---|
| RK3562 | int8 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3562 | int8 | 4 Dimensionen | NHWC | Keine | Keine |
| RK3562 | int8 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 32 ausgerichtet; anderer Typ: auf 16 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3562 | int8 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3562 | float16 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3562 | float16 | 4 Dimensionen | NHWC | Keine | Keine |
| RK3562 | float16 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 16 ausgerichtet; anderer Typ: auf 8 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3562 | float16 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3562 | Uneingeschränkt | Nicht 4 Dimensionen | UNDEFINE | Keine | Keine |
5.2.5 RK3576/RV1126B
| Chipplattform | Ausgabepräzision des Modells | Ausgabedimensionen | Ausgabe-Layout-Einstellung | Ausrichtungsanforderung für Channel | Ausrichtungsanforderung für H*W |
|---|---|---|---|---|---|
| RK3576/ RV1126B |
int8 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3576/ RV1126B |
int8 | 4 Dimensionen | NHWC | Keine | Keine |
| RK3576/ RV1126B |
int8 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 32 ausgerichtet; anderer Typ: auf 16 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3576/ RV1126B |
int8 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3576/ RV1126B |
float16 | 4 Dimensionen | NCHW | Keine | Keine |
| RK3576/ RV1126B |
float16 | 4 Dimensionen | NHWC | Keine | Keine |
| RK3576/ RV1126B |
float16 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 16 ausgerichtet; anderer Typ: auf 8 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK3576/ RV1126B |
float16 | 4 Dimensionen | UNDEFINE | Keine | Keine |
| RK3576/ RV1126B |
Uneingeschränkt | Nicht 4 Dimensionen | UNDEFINE | Keine | Keine |
5.2.6 RK2118
| Chipplattform | Ausgabepräzision des Modells | Ausgabedimensionen | Ausgabe-Layout-Einstellung | Ausrichtungsanforderung für Channel | Ausrichtungsanforderung für H*W |
|---|---|---|---|---|---|
| RK2118 | float16 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 8 ausgerichtet; anderer Typ: auf 4 ausgerichtet. | H*W auf 4 ausgerichtet |
| RK2118 | float16 | 4 Dimensionen | NHWC | Keine | Keine |
| RK2118 | float16 | Nicht 4 Dimensionen | UNDEFINE | Keine | Keine |
5.2.7 RV1103B/RV1106B
| Chipplattform | Ausgabepräzision des Modells | Ausgabedimensionen | Ausgabe-Layout-Einstellung | Ausrichtungsanforderung für Channel | Ausrichtungsanforderung für H*W |
|---|---|---|---|---|---|
| RV1103B/ RV1106B |
int8 | 4 Dimensionen | NC1HWC2 | Letzte Schicht vom Faltungstyp: auf 8 ausgerichtet; anderer Typ: auf 8 ausgerichtet. | H*W auf 4 ausgerichtet |
| RV1103B/ RV1106B |
int8 | 4 Dimensionen | NHWC | Keine | Keine |
Besondere Hinweise
Inhalt
- Besondere Hinweise
- dilated_kernel_h
- dilated_kernel_w
6.1 dilated_kernel_h
dilated_kernel_h=kernel_h*dilations_h‑dilations_h+1
6.2 dilated_kernel_w
dilated_kernel_w=kernel_w*dilations_w‑dilations_w+1