
Применимость к ArmSoM и источники
Это справочник по платформе Rockchip, а не отчёт об испытаниях оборудования ArmSoM. Источник — RKNN SDK User Guide V2.3.2: 165 страниц на китайском и 178 на английском. Китайская статья следует китайскому оригиналу, английская, русская и немецкая — английскому. Китайские иллюстрации используются только в китайской статье, в остальных — английские оригиналы. Перечень SoC и требования к программной среде сохранены ниже; совместимость конкретной платы ArmSoM, SDK/BSP, драйвера ядра и RKNN Runtime не проверена. Перед развёртыванием проверьте SoC платы, драйвер NPU, версии SDK/Runtime и поддержку операторов. Все показатели производительности, точности, памяти, адреса и журналы — примеры источника. Код не выполнялся, аппаратные испытания не проводились.
Источники одной версии различаются: китайская схема анализа производительности отсутствует в английском; английский текст о разреженном инференсе добавляет ограничение числа каналов весов больше 32; различается пример оценки памяти. Опечатки, противоречивые описания API, отсутствующие значения и обрезанный текст скриншотов сохранены и отмечены, а не исправлены без пояснений. Формулы даны в редактируемой записи рядом с фрагментами оригинала; round обозначает исходную операцию округления. Подробности с номерами страниц приведены в редакционных примечаниях.
EDITORIAL-NOTES · ArmSoM · RKNN-Toolkit2
1 Введение в RKNN
1.1 Инструментарий RKNN
1.1.1 Обзор программного стека RKNN
Программный стек RKNN позволяет быстро развертывать модели ИИ на чипах Rockchip. Общая структура показана ниже:
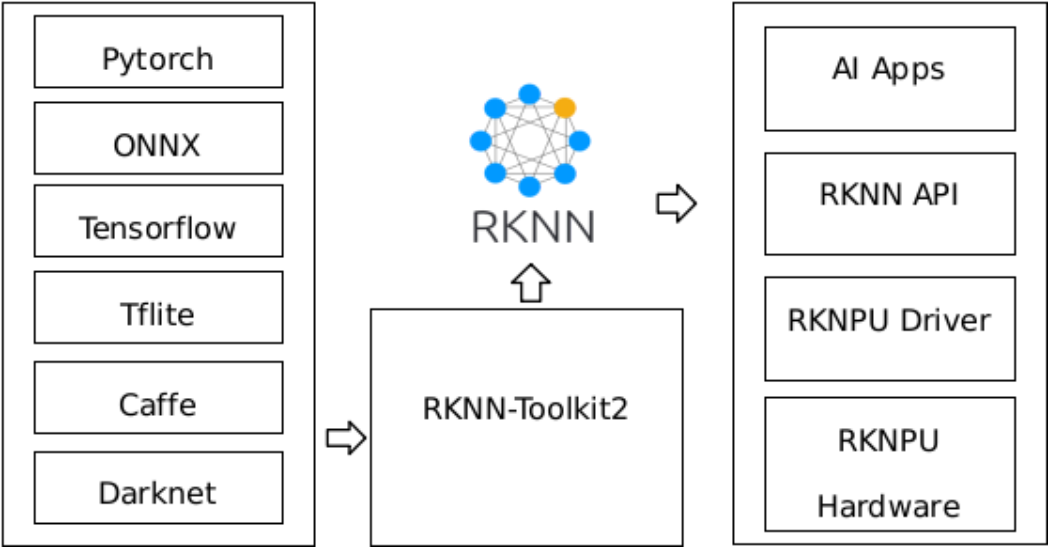
Рисунок 1-1. Программный стек RKNN
Для использования RKNPU сначала запустите RKNN-Toolkit2 на компьютере и преобразуйте обученную модель в формат RKNN. Затем разверните ее на плате разработки с помощью RKNN C API или Python.
1.1.2 Возможности RKNN-Toolkit2
RKNN-Toolkit2 — набор средств разработки для преобразования моделей, инференса и оценки моделей на компьютере. Его основная схема приведена ниже:
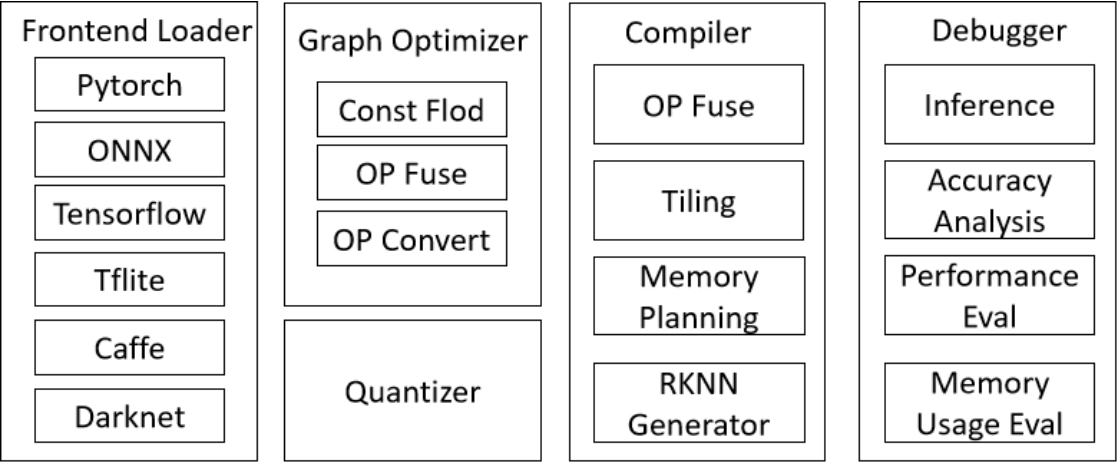
Рисунок 1-2. Программная структура RKNN-Toolkit2
Удобный интерфейс Python предоставляет следующие функции:
1. Преобразование моделей: преобразование моделей PyTorch, ONNX, TensorFlow, TensorFlow Lite, Caffe, DarkNet и других форматов в RKNN.
2. Квантование: преобразование моделей с плавающей точкой в модели с фиксированной точкой. Поддерживается также смешанное квантование.
3. Инференс модели: передача модели RKNN на выбранное устройство NPU для выполнения и получения результатов либо моделирование NPU на компьютере для запуска модели RKNN и получения результатов.
4. Оценка производительности и памяти: передача модели RKNN на выбранное устройство NPU для оценки производительности и использования памяти при выполнении на реальном устройстве.
5. Анализ точности квантования: вычисление косинусного и евклидова расстояний между результатами каждого слоя квантованной модели и модели с плавающей точкой. Это облегчает анализ возникновения ошибок квантования и помогает повысить точность квантованной модели.
6. Шифрование модели: шифрование всей модели RKNN с указанным уровнем шифрования.
1.1.3 Возможности RKNN Runtime
RKNN Runtime главным образом загружает модель RKNN и вызывает драйвер NPU для ее выполнения на NPU. При инференсе исходные данные проходят три основных этапа: предварительная обработка входа, выполнение модели на NPU и последующая обработка выхода. В зависимости от формата входа и способа квантования RKNN Runtime предоставляет два процесса: обычный API и API нулевого копирования.
Обычный API: простой и понятный набор интерфейсов инференса. Процесс показан на рисунке 1-3. Нормализация, квантование, преобразование формата расположения данных и деквантование выполняются на CPU, а инференс модели — на NPU.
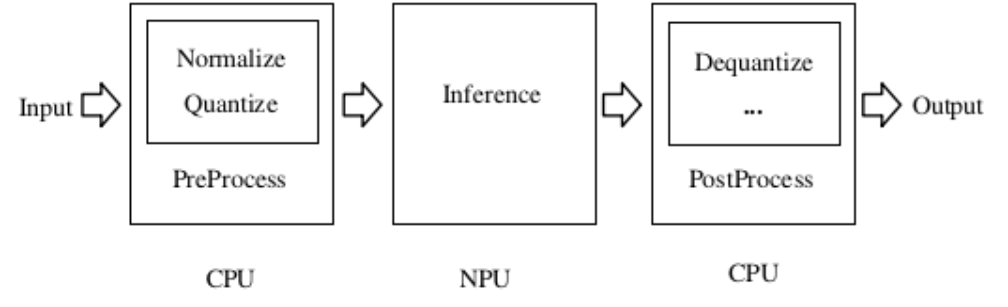
Рисунок 1-3. Обработка данных обычного API
API нулевого копирования: процесс показан на рисунке 1-4 и оптимизирует обработку обычного API. Нормализация, квантование и инференс выполняются на NPU; преобразование расположения выходных данных NPU и деквантование — на CPU или NPU. API нулевого копирования эффективнее обрабатывает входной поток и позволяет получать данные между разными IP-блоками без копирования, уменьшая нагрузку на CPU и пропускную способность DDR. Например, данные камеры или декодированные данные можно напрямую передать в NPU через этот API.
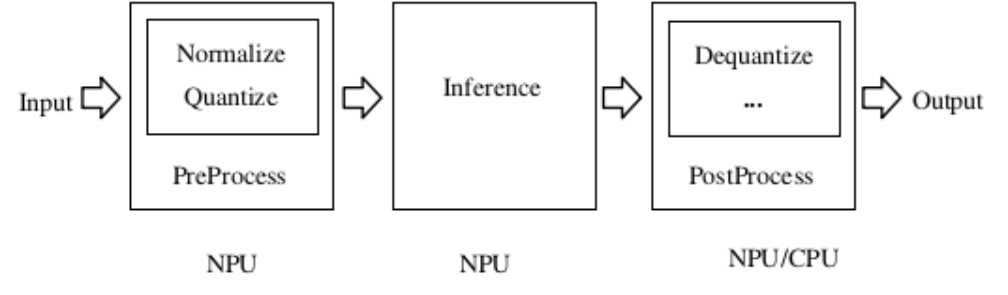
Рисунок 1-4. Обработка данных API нулевого копирования
Если входные данные имеют только виртуальный адрес, доступен только обычный API. Если имеется физический адрес или файловый дескриптор (fd), можно использовать оба API.
1.2 Процесс разработки RKNN
Блок-схема помогает понять общие этапы разработки RKNN: преобразование модели, оценка модели, развертывание и выполнение на плате.
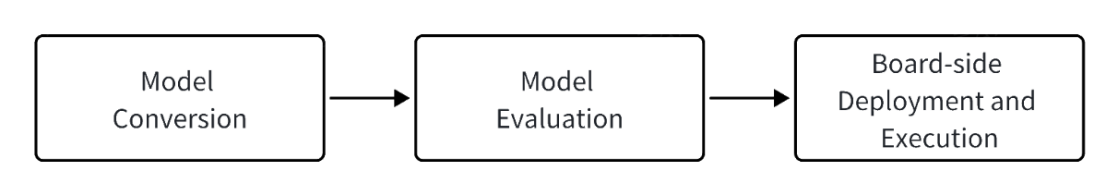
Рисунок 1-5. Процесс разработки RKNN
1.2.1 Преобразование модели
На этом этапе исходная модель глубокого обучения преобразуется в формат RKNN для эффективного инференса на платформах RKNPU. Этап включает:
Получение исходной модели: получите или обучите модель глубокого обучения в распространенной среде, например ONNX, PyTorch или TensorFlow.
Настройка модели: задайте необходимые параметры RKNN-Toolkit2, например средние значения, нормализацию, параметры квантования и целевую платформу.
Загрузка модели: импортируйте модель в RKNN-Toolkit2 подходящим интерфейсом загрузки, выбрав способ в соответствии с типом модели.
Построение модели: создайте модель RKNN через rknn.build(). Можно выбрать квантование, чтобы повысить производительность на аппаратной платформе.
Экспорт модели: сохраните модель RKNN в файл формата .rknn через rknn.export_rknn() для последующего развертывания.
Подробности приведены в разделах 3.1 и 4.2.1.
1.2.2 Оценка модели
Оценка помогает проанализировать производительность, точность квантования и использование памяти на плате. Основные операции:
Отладка модели с подключенной платой: Python связывает компьютер с платформой RKNPU для инференса и проверки модели. Это включает предварительную обработку входа и последующую обработку результатов, чтобы проверить правильность выполнения на плате.
Оценка точности: используйте rknn.accuracy_analysis() для сравнения выходов квантованной модели и модели с плавающей точкой и анализа ошибок квантования.
Оценка производительности: используйте rknn.eval_perf() для определения производительности инференса на платформе, дальнейшей оптимизации структуры модели и ускорения инференса.
Оценка памяти: используйте rknn.eval_memory(), чтобы определить использование памяти на плате, оптимизировать структуру модели и минимизировать потребление памяти.
Подробности приведены в разделах 3.2, 3.3, 4.2.2 и 4.2.3.
1.2.3 Развертывание и выполнение на плате
Этот этап охватывает фактическое развертывание и выполнение модели. Обычно он включает:
Инициализация модели: загрузите модель RKNN на платформу RKNPU и подготовьтесь к предварительной обработке.
Предварительная обработка: загрузите входные данные на платформу RKNPU и подготовьтесь к инференсу.
Инференс: передайте входные данные модели, выполните инференс и получите результаты.
Последующая обработка: получите результаты инференса, обработайте их и передайте приложению.
Освобождение модели: после инференса освободите ресурсы модели, чтобы другие задачи могли использовать модель RKNN.
Подробности приведены в разделах 3.4 и 4.2.3.
Эти три этапа образуют полный процесс разработки RKNN: преобразование, отладка, оценка и эффективное развертывание моделей ИИ на RKNPU.
1.3 Поддерживаемые аппаратные платформы
Документ относится к следующим аппаратным платформам:
RV1103, RV1103B, RV1106, RV1106B, RK2118, RK3562, серии RK3566, серии RK3568, RK3576, серии RK3588, RV1126B
Примечание: RK3566_RK3568 обозначает в этом документе серии RK3566/RK3568. RK3588 обозначает серии RK3588/RK3588S.
1.4 Термины
Модель RKNN: двоичный файл для выполнения на RKNPU с расширением .rknn.
Инференс с подключенной платой: запуск модели через API RKNN-Toolkit2, причем фактически модель выполняется на NPU платы разработки.
DRM: Direct Rendering Manager, распространенная система графического вывода в Linux.
tensor: многомерный массив данных.
fd: файловый дескриптор, представляющий буфер.
NATIVE_LAYOUT: собственное расположение данных NPU, обеспечивающее наилучшую производительность обработки при таком размещении данных в памяти.
Модель i8: квантованная модель RKNN, работающая с 8-битными целыми числами со знаком.
Модель fp16: неквантованная модель RKNN, работающая с 16-битными числами половинной точности с плавающей точкой.
2 Подготовка среды разработки
RKNN-Toolkit2 предоставляется в двух версиях: для x86 и ARM64. Установка одинакова, за исключением того, что ARM64 пока не поддерживает Docker. Кроме того, ARM64 поддерживает преобразование только моделей onnx и pytorch; другие среды в настоящее время не поддерживаются.
Различия версий x86 и ARM64:
| Фреймворк глубокого обучения | x86 | ARM64 |
|---|---|---|
| Caffe | ✔ | ✗ |
| TensorFlow | ✔ | ✗ |
| TF Lite | ✔ | ✗ |
| ONNX | ✔ | ✔ |
| DarkNet | ✔ | ✗ |
| PyTorch | ✔ | ✔ |
Различия инструментов:
| Необходимые инструменты | x86 | ARM64 |
|---|---|---|
| adb | ✔ | ✗ |
| rknn_server | ✔ | ✗ |
| rknn runtime | ✔ | ✔ |
Различия при использовании x86 и ARM64:
Основное отличие касается отладочных функций, например анализа точности и инференса. Версия ARM64 устанавливается в ARM64 Linux; для этих функций достаточно, чтобы librknnrt.so находилась в ‘/usr/lib64’. Поскольку ARM64 не поддерживает adb, она работает только на текущей плате. Для x86 необходимо обновлять и использовать rknn_server, а также обеспечить доступность adb для отладочных функций и подключения к другой плате при необходимости.
Кроме того, производительность x86 и ARM64 может различаться при анализе точности и квантовании.
Примечание: подготовка среды разработки RK2118 описана в «Rockchip_RK2118_Quick_Start_RKNN_SDK_EN».
2.1 Установка RKNN-Toolkit2
В этой главе описаны два способа установки RKNN-Toolkit2: Docker и Pip. Выберите любой удобный способ.
2.1.1 Установка через Docker
2.1.1.1 Установка Docker
Если Docker уже установлен, этот шаг можно пропустить. В противном случае установите его по официальному руководству: https://docs.docker.com/install/linux/docker-ce/ubuntu/.
Примечание: обязательно добавьте пользователя в группу docker.
# Create docker group
sudo groupadd docker
# Add the current user to the docker group
sudo usermod -aG docker $USER
# Update and activate the docker group
newgrp docker
# Verify that sudo is not needed to execute docker commands
docker run hello-world
При правильном выполнении результат будет следующим:
Unable to find image 'hello-world:latest' locally
latest: Pulling from library/hello-world
719385e32844: Pull complete
Digest: sha256:88ec0acaa3ec199d3b7eaf73588f4518c25f9d34f58ce9a0df68429c5af48e8d
Status: Downloaded newer image for hello-world:latest
Hello from Docker!
2.1.1.2 Подготовка образа
В этом разделе приведены два способа подготовки среды образа RKNN-Toolkit2; можно выбрать любой из них.
1. Создание среды образа через Dockerfile
В каталоге docker/docker_file проекта RKNN-Toolkit2 находится Dockerfile для построения среды разработки RKNN-Toolkit2. Создайте образ следующей командой:
cd docker/docker_file/ubuntu_xx_xx_cpxx
docker build -f Dockerfile_ubuntu_xx_xx_for_cpxx -t rknn-toolkit2:x.x.x-cpxx .
2. Загрузка готового образа Docker со всеми средами разработки
Загрузите файл проекта RKNN-Toolkit2 нужной версии. После распаковки в каталоге docker/docker_image находится образ Docker со всеми средами разработки.
Ссылка на сетевое хранилище: https://console.zbox.filez.com/l/I00fc3. Код доступа: rknn.
Загрузите образ, соответствующий версии Python, следующей командой:
docker load --input rknn-toolkit2-x.x.x-cpxx-docker.tar.gz
2.1.1.3 Просмотр информации об образе
После создания или загрузки образа проверьте информацию об образе Docker:
docker images
Отобразится информация об образе RKNN-Toolkit2:
REPOSITORY TAG IMAGE ID CREATED SIZE
rknn-toolkit2 x.x.x-cpxx xxxxxxxxxxxx 1 hours ago 5.89GB
2.1.1.4 Запуск образа
Запустите образ Docker следующей командой. Вы попадете в среду bash образа.
docker run -t -i --privileged -v /dev/bus/usb:/dev/bus/usb rknn-toolkit2:x.x.x-cpxx /bin/bash
Каталог examples с кодом можно подключить в среду Docker, добавив параметр -v <host src folder>: <image dst folder>.
docker run -t -i --privileged -v /dev/bus/usb:/dev/bus/usb -v /your/rknn-toolkit2-x.x.x/examples:/examples rknn-toolkit2:x.x.x-cpxx /bin/bash
2.1.1.5 Запуск демонстрационного примера
cd examples/onnx/yolov5
python test.py
После успешного выполнения скрипта результат должен выглядеть следующим образом:
class score xmin, ymin, xmax, ymax
--------------------------------------------------
person 0.884 [ 208, 244, 286, 506]
person 0.868 [ 478, 236, 559, 528]
person 0.825 [ 110, 238, 230, 534]
person 0.339 [ 79, 353, 122, 516]
bus 0.705 [ 92, 128, 554, 467]
2.1.2 Установка через Pip
2.1.2.1 Установка среды Python
Если среда Python уже установлена, этот шаг можно пропустить.
sudo apt-get update
sudo apt-get install python3 python3-dev python3-pip
sudo apt-get install libxslt1-dev zlib1g zlib1g-dev libglib2.0-0 libsm6 libgl1-mesa-glx libprotobuf-dev gcc
Если требуется установить RKNN-Toolkit2 в локальную среду, а не виртуальную среду Conda, после установки Python перейдите к шагу 2.1.2.4.
2.1.2.2 Установка Conda
Если в системе установлено несколько версий Python, рекомендуется управлять средой Python через Conda.
Проверьте наличие и версию Conda. Если она уже установлена, этот шаг можно пропустить.
conda -V
# Prompt conda: command not found means conda is not installed.
# Successful installation will display the version such as: conda X.X.X
# X.X.X means version number, such as 23.9.0.
Загрузите установочный пакет Conda:
wget -c https://github.com/conda-forge/miniforge/releases/latest/download/Miniforge3-Linux-x86_64.sh
Установите Conda:
chmod 777 Miniforge3-Linux-x86_64.sh
bash Miniforge3-Linux-x86_64.sh
Версия ARM64:
Загрузите установочный пакет Conda:
wget -c https://github.com/conda-forge/miniforge/releases/latest/download/Miniforge3-Linux-aarch64.sh
Установите Conda:
chmod 777 Miniforge3-Linux-aarch64.sh
bash Miniforge3-Linux-aarch64.sh
2.1.2.3 Создание среды Conda для RKNN-Toolkit2
Перейдите в базовую среду Conda:
source ~/miniforge3/bin/activate # Miniforge install directory path
# (base) xxx@xxx-pc:~$
Создайте среду Conda с именем RKNN-Toolkit2 и Python 3.8 — рекомендуемой версией:
conda create -n RKNN-Toolkit2 python=3.8
Активируйте среду Conda RKNN-Toolkit2:
conda activate RKNN-Toolkit2
# (RKNN-Toolkit2) xxx@xxx-pc:~$
2.1.2.4 Установка RKNN-Toolkit2
После активации среды Conda RKNN-Toolkit2 установите RKNN-Toolkit2 из источника pip либо из локального пакета wheel:
Установка из источника pip
pip install rknn-toolkit2 -i https://pypi.org/simple

# If RKNN-Toolkit2 is already installed, you can upgrade it with the following command:
pip install rknn-toolkit2 -i https://pypi.org/simple --upgrade
Установка из локального пакета wheel
# Please choose the appropriate requirements file based on the Python version and processor architecture:
# where cpxx is the Python version
pip install -r /rknn-toolkit2/packages/x86_64/requirements_cpxx.txt
# pip install -r /rknn-toolkit2/packages/arm64/arm64_requirements_cpxx.txt

# Install RKNN-Toolkit2
# Please choose the appropriate wheel package file based on the Python version and processor architecture:
# where x.x.x is the RKNN-Toolkit2 version number, cpxx is the Python version
pip install /rknn-toolkit2/packages/x86_64/rknn_toolkit2-x.x.x-cpxx-cpxx-manylinux_2_17_x86_64.manylinux2014_x86_64.whl
# pip install /rknn-toolkit2/packages/arm64/rknn_toolkit2-x.x.x-cpxx-cpxx-manylinux_2_17_aarch64.manylinux2014_aarch64.whl
Если следующая команда выполняется без ошибок, установка завершена успешно.
$ python
>>> from rknn.api import RKNN
2.2 Подготовка среды устройства NPU
2.2.1 Проверка версии драйвера NPU
Команды проверки:
dmesg | grep -i rknpu
# or
cat /sys/kernel/debug/rknpu/version
# or
cat /sys/kernel/debug/rknpu/driver_version
# or
cat /proc/debug/rknpu/driver_version
Результаты проверки:
RKNPU driver: vX.X.X
X.X.X обозначает номер версии, например 0.9.2.
В прошивке Rockchip драйвер RKNPU установлен заранее. Если приведенные команды не определяют версию NPU, в сторонней прошивке может отсутствовать драйвер RKNPU. Включите параметр CONFIG_ROCKCHIP_RKNPU=y в конфигурации ядра, пересоберите драйвер ядра и прошейте его. Рекомендуется версия драйвера RKNPU >= 0.9.2.
2.2.2 Проверка среды подключения устройства NPU
Для отладки RKNN-Toolkit2 с подключенной платой нужен RKNN Server на устройстве. Это фоновая прокси-служба, которая получает команды и данные от компьютера через USB, выполняет соответствующие интерфейсы и возвращает результаты компьютеру. Поэтому необходимо убедиться, что RKNN Server на устройстве запущен.
Примечание: версии ARM64 для отладки не нужен RKNN Server. Если RKNN Toolkit2 используется на ARM64, пропустите этот шаг.
Проверьте, выполняется ли процесс RKNN Server на плате разработки.
adb shell
ps | grep rknn_server
Результаты проверки:
702 root 1192 S grep rknn_server
Если получен идентификатор процесса RKNN Server, служба запущена нормально. Если идентификатор не найден, запустите службу вручную следующей командой и повторите проверку.
Ручной запуск RKNN Server в Android:
su
setenforce 0
nohup /vendor/bin/rknn_server >/dev/null&
Ручной запуск RKNN Server в Linux на RK356X/RK3576/RK3588/RV1126B:
nohup /usr/bin/rknn_server >/dev/null&
Ручной запуск RKNN Server в Linux на RV1103/RV1103B/RV1106/RV1106B:
nohup /oem/usr/bin/rknn_server >/dev/null&
Обычно прошивка Rockchip содержит RKNN Server, автоматически запускаемый при загрузке. Если автоматического запуска нет или отсутствуют файлы для ручного запуска, установите либо обновите RKNN Server вручную.
2.2.3 Установка и обновление RKNN Server
Если RKNN Server не установлен на плате, отсутствует библиотека Runtime или версии RKNN Server и Runtime не совпадают, их необходимо переустановить либо обновить. Основные понятия:
1. RKNN Server: фоновая прокси-служба на плате. Получает данные компьютера через USB, вызывает соответствующий интерфейс Runtime на плате и возвращает результаты компьютеру.
2. Библиотека RKNPU2 Runtime
librknnrt.so: библиотека Runtime для плат RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B.
librknnmrt.so: библиотека Runtime для плат RV1103/RV1103B/RV1106/RV1106B.
Если на плате нет RKNN Server, отсутствует библиотека Runtime или их версии не совпадают, требуется переустановка либо обновление.
Примечание:
1. Для модели RKNN с динамическими размерами входа требуются версии RKNN Server и RKNPU2 Runtime >= 1.5.0.
2. Для модели размером более 2 GB требуется rknn_server версии >=2.0.0b0.
3. Для платформ с малым объемом памяти, таких как RV1103, RV1106, RV1103B и RV1106B, рекомендуется rknn_server версии >=2.1.0.
4. Версии RKNN Server, библиотеки Runtime и RKNN-Toolkit2 должны быть согласованы. Рекомендуется установить последние версии всех компонентов.
5. Служба rknn_server на RK2118 не служит для отладки платы через RKNN-Toolkit2, а обеспечивает связь между DSP и MCU.
6. Версии ARM64 не нужен RKNN Server, поэтому обновлять и использовать его не требуется. Однако отладка зависит от библиотеки RKNPU Runtime; убедитесь, что на плате установлена ее последняя версия.
2.2.3.1 Платформа RK356X/RK3576/RK3588/RV1126B
1. Система Android
Проверьте версии RKNN Server и librknnrt.so. Если они различаются, обновите их до одной версии.
# Query rknn_server version
strings /vendor/bin/rknn_server | grep -i "rknn_server version"
# Display rknn_server version is X.X.X, such as 1.6.0
# rknn_server version: X.X.X
# Query the librknnrt.so library version

# 64-bit system
strings /vendor/lib64/librknnrt.so | grep -i "librknnrt version"
# 32-bit system
strings /vendor/lib/librknnrt.so | grep -i "librknnrt version"
# Display the librknnrt library version is X.X.X, such as 1.6.0
# librknnrt version: X.X.X
Обновите RKNN Server и librknnrt.so.
adb root
adb remount
64-битная система:
adb push runtime/Android/rknn_server/arm64/rknn_server /vendor/bin/
adb push runtime/Android/librknn_api/arm64-v8a/librknnrt.so /vendor/lib64
32-битная система:
adb push runtime/Android/rknn_server/arm/rknn_server /vendor/bin/
adb push runtime/Android/librknn_api/armeabi-v7a/librknnrt.so /vendor/lib
Перезапустите RKNN Server:
adb shell
su
chmod +x /vendor/bin/rknn_server
nohup /vendor/bin/rknn_server >/dev/null&
sync
reboot
2. Система Linux
Проверьте версии RKNN Server и librknnrt.so. Если они различаются, обновите их до одной версии.
# Check rknn_server version
strings /usr/bin/rknn_server | grep -i "rknn_server version"
# Display rknn_server version is X.X.X, such as 1.6.0
# rknn_server version: X.X.X

# Query the librknnrt.so version
strings /usr/lib/librknnrt.so | grep -i "librknnrt version"
# Display the librknnrt version is X.X.X, such as 1.6.0
# librknnrt version: X.X.X
Обновите RKNN Server и librknnrt.so.
64-битная система:
adb push runtime/Linux/rknn_server/aarch64/usr/bin/* /usr/bin
adb push runtime/Linux/librknn_api/aarch64/librknnrt.so /usr/lib64
32-битная система:
adb push runtime/Linux/rknn_server/armhf/usr/bin/* /usr/bin
adb push runtime/Linux/librknn_api/armhf/librknnrt.so /usr/lib
Перезапустите RKNN Server:
adb shell
chmod +x /usr/bin/rknn_server
nohup /usr/bin/rknn_server >/dev/null&
restart_rknn.sh
2.2.3.2 Платформа RV1103/RV1103B/RV1106/RV1106B
Проверьте версии rknn_server и librknnmrt.so. Если они различаются, обновите их до одной версии.
# Query rknn_server version
strings /oem/usr/bin/rknn_server | grep -i "rknn_server version"
# Display rknn_server version is X.X.X, such as 1.6.0
# rknn_server version: X.X.X

# Query the librknnrt.so version
strings /oem/usr/lib/librknnmrt.so | grep -i "librknnmrt version"
# Display the librknnrt version is X.X.X, such as 1.6.0
# librknnmrt version: X.X.X
Обновите RKNN Server и librknnmrt.so. RV1103, RV1103B, RV1106 и RV1106B используют одинаковые RKNN Server и librknnmrt.so.
adb push runtime/Linux/rknn_server/armhf-uclibc/usr/bin/* /oem/usr/bin
adb push runtime/Linux/librknn_api/armhf-uclibc/librknnmrt.so /oem/usr/lib
Перезапустите RKNN Server:
adb shell
chmod +x /oem/usr/bin/rknn_server
nohup /oem/usr/bin/rknn_server >/dev/null&
restart_rknn.sh
2.2.4 Просмотр подробных журналов RKNN Server
2.2.4.1 Система Android
Откройте терминал устройства и установите уровень журналирования:
adb shell
su
setenforce 0
setprop persist.vendor.rknn.server.log.level 5
Завершите текущий процесс службы RKNN Server:
kill -9 `pgrep rknn_server`
Если RKNN Server не перезапускается автоматически, запустите его вручную и просмотрите подробный журнал:
nohup /vendor/bin/rknn_server >/dev/null&
logcat
2.2.4.2 Система Linux
Откройте терминал устройства и установите уровень журналирования:
adb shell
export RKNN_SERVER_LOGLEVEL=5
Перезапустите RKNN Server для просмотра подробных журналов:
На платформе RK356X / RK3576 / RK3588 / RV1126B выполните следующую команду:
nohup /usr/bin/rknn_server >/dev/null&
На платформе RV1103 / RV1103B / RV1106 / RV1106B выполните следующие команды:
nohup /oem/usr/bin/rknn_server >/dev/null&
3 Основные инструкции по RKNN
3.1 Преобразование модели
RKNN-Toolkit2 предоставляет преобразование моделей, анализ производительности, развертывание, отладку и другие функции. Этот раздел посвящен преобразованию моделей — одной из основных функций RKNN-Toolkit2, позволяющей преобразовывать модели глубокого обучения разных сред в формат RKNN для выполнения на RKNPU. Блок-схема поможет понять процесс преобразования.
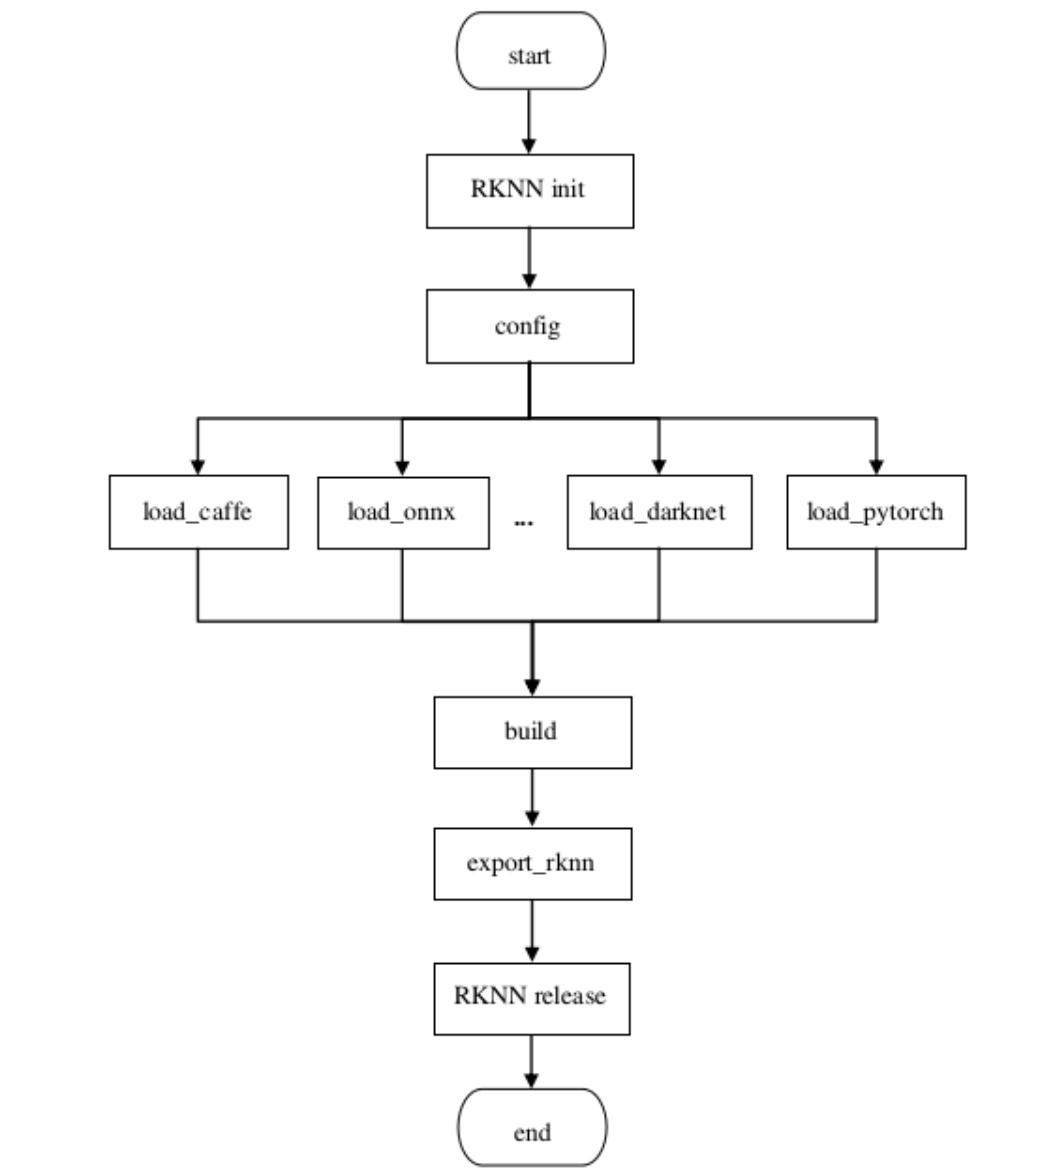
Рисунок 3-1. Процесс преобразования модели
RKNN-Toolkit2 поддерживает преобразование моделей следующих распространенных сред глубокого обучения:
Caffe (рекомендуемая версия 1.0)
TensorFlow (рекомендуемые версии 1.12.0~2.8.0)
TensorFlow Lite (рекомендуется Schema version = 3)
ONNX (рекомендуемые версии 1.7.0~1.10.0)
PyTorch (рекомендуемые версии 1.6.0~1.13.1)
Darknet (рекомендуется Commit ID = 810d7f7)
Обучите или получите предварительно обученные модели этих сред и преобразуйте их в RKNN для более эффективного развертывания и инференса на RKNPU.
3.1.1 Инициализация RKNN и освобождение объекта
Сначала необходимо инициализировать объект RKNN. Это первый шаг всего процесса.
Инициализация объекта RKNN:
Инициализируйте объект конструктором RKNN(). Можно передать параметры verbose и verbose_file.
verbose определяет, выводить ли подробный журнал на экран.
Если задан verbose_file и verbose установлен в True, журнал также записывается в указанный файл.
Пример кода:
rknn = RKNN(verbose=True, verbose_file='./mobilenet_build.log')
После завершения всех операций RKNN освободите ресурсы. Это последний шаг процесса:
Освобождение ресурсов:
Освободите объект rknn вызовом release().
Пример кода:
rknn.release()
3.1.2 Настройка Config
Перед преобразованием задайте конфигурацию, обеспечивающую правильность и производительность преобразования модели. Интерфейс rknn.config() позволяет указать средние входные значения, нормализацию, квантование и другие параметры. Некоторые распространенные параметры:
mean_values и std_values задают средние значения и нормализацию входа. Они используются при квантовании, поэтому при инференсе через C API повторно вычитать среднее и нормализовать изображение не нужно; это сокращает время развертывания.
quant_img_RGB2BGR определяет, преобразовывать ли RGB в BGR при загрузке изображения для квантования. По умолчанию false. Параметр действует при калибровке квантования, но не при инференсе; соответствующую обработку пользователь должен выполнить при подготовке входа. Подробные предостережения см. в разделе 10.3. Примечание: при quant_img_RGB2BGR= True сначала выполняется RGB2BGR, затем операции mean_values и std_values.
target_platform задает целевую платформу модели RKNN. Поддерживаются RV1103, RV1103B, RV1106, RV1106B, RV1126B, RK2118, RK3562, RK3566, RK3568, RK3576 и RK3588.
quantized_algorithm задает алгоритм расчета параметров квантования каждого слоя: normal, mmse или kl_divergence. По умолчанию normal. Подробности см. в разделах 3.1.7, 6.1 и 6.2.
quantized_method принимает layer или channel и определяет совместное использование параметров весами каждого слоя. По умолчанию channel. Подробности см. в разделах 3.1.7, 6.1 и 6.2.
optimization_level изменяет уровень оптимизации модели и позволяет отключить часть или все правила оптимизации при преобразовании. Значение по умолчанию 3 включает все оптимизации. При 2 или 1 отключаются некоторые оптимизации, способные влиять на точность отдельных моделей. При 0 отключены все оптимизации.
quantized_dtype задает тип квантования. Поддерживается INT8 с линейным асимметричным квантованием; значение по умолчанию ‘asymmetric_quantized-8’.
custom_string добавляет пользовательскую строку в модель RKNN, например информацию о версии модели. Строка доступна через запрос RKNN_QUERY_CUSTOM_STRING, что позволяет особым образом обрабатывать разные модели при развертывании. По умолчанию None.
dynamic_input поддерживает динамический вход, имитируя его по нескольким наборам форм входа, заданных пользователем. По умолчанию None. Подробности см. в разделе 5.4.
Полное описание rknn.config() см. в руководстве API; выше приведены только распространенные параметры.
Пример кода:
rknn.config(
    mean_values=[[103.94, 116.78, 123.68]],
    std_values=[[58.82, 58.82, 58.82]],
    quant_img_RGB2BGR=False,
    target_platform='rk3566')
3.1.3 Интерфейсы загрузки модели
Для каждого типа модели используйте соответствующий интерфейс загрузки. RKNN-Toolkit2 предоставляет отдельные интерфейсы для Caffe, TensorFlow, TensorFlow Lite, ONNX, PyTorch и других сред. Краткое описание интерфейсов:
Загрузка Caffe:
Загрузите модель Caffe через rknn.load_caffe().
Укажите путь к файлу модели .prototxt и файлу весов .caffemodel.
При нескольких входных слоях можно задать порядок имен этих слоев.
Пример кода:
ret = rknn.load_caffe(model='./mobilenet_v2.prototxt', blobs='./mobilenet_v2.caffemodel')
Загрузка TensorFlow:
Загрузите модель TensorFlow через rknn.load_tensorflow().
Укажите путь к файлу модели TensorFlow .pb, имя и форму входного узла, а также имя выходного узла.
Пример кода:
ret = rknn.load_tensorflow(tf_pb='./ssd_mobilenet_v1_coco_2017_11_17.pb',
              inputs=['Preprocessor/sub'],
              outputs=['concat', 'concat_1'],
              input_size_list=[[1, 300, 300, 3]])
Загрузка TensorFlow Lite:
Загрузите модель TensorFlow Lite через rknn.load_tflite().
Укажите путь к файлу модели TensorFlow с расширением .tflite.
Пример кода:
ret = rknn.load_tflite(model='./mobilenet_v1.tflite')
Загрузка ONNX:
Загрузите модель ONNX через rknn.load_onnx().
Укажите путь к файлу модели ONNX .onnx.
Пример кода:
ret = rknn.load_tflite(model='./mobilenet_v1.tflite')
Загрузка DarkNet:
Загрузите модель DarkNet через rknn.load_darknet().
Укажите путь к файлу модели DarkNet .cfg и файлу весов .weights.
Пример кода:
ret = rknn.load_darknet(model='./yolov3-tiny.cfg', weight='./yolov3.weights')
Загрузка PyTorch:
Загрузите модель PyTorch через rknn.load_pytorch().
Укажите путь к файлу модели PyTorch .pt; модель должна быть в формате torchscript.
Пример кода:
ret = rknn.load_pytorch(model='./resnet18.pt', input_size_list=[[1, 3, 224, 224]])
Выберите интерфейс загрузки, соответствующий типу модели, чтобы обеспечить ее преобразование.
3.1.4 Построение модели RKNN
После загрузки исходной модели создайте модель RKNN через rknn.build(). При этом можно выбрать квантование, уменьшающее размер модели и повышающее производительность на RKNPU. Параметры rknn.build():
do_quantization управляет квантованием модели; рекомендуется True.
dataset задает набор данных для калибровки квантования. Набор задается текстовым файлом.
Пример dataset.txt:
./imgs/ILSVRC2012_val_00000665.JPEG
./imgs/ILSVRC2012_val_00001123.JPEG
./imgs/ILSVRC2012_val_00001129.JPEG
./imgs/ILSVRC2012_val_00001284.JPEG
./imgs/ILSVRC2012_val_00003026.JPEG
./imgs/ILSVRC2012_val_00005276.JPEG
Пример кода
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
3.1.5 Экспорт модели RKNN
После построения через rknn.build() модель RKNN можно сохранить в файл .rknn для развертывания с помощью rknn.export_rknn(). Параметры этого интерфейса:
export_path — путь к экспортируемому файлу модели.
cpp_gen_cfg позволяет дополнительно создать примеры развертывания на C++.
Пример кода
ret = rknn.export_rknn(export_path='./mobilenet_v1.rknn')
Эти операции и интерфейсы охватывают преобразование модели в RKNN-Toolkit2. В зависимости от требований и сценария выбирайте конфигурацию и алгоритмы квантования, упрощающие последующее развертывание.
3.1.6 Инструмент преобразования RKNN_Convert
RKNN_CONVERT — инструмент преобразования моделей из RKNN-Toolkit2, оборачивающий описанные API. Для преобразования командами достаточно отредактировать yml-конфигурацию модели. Ниже приведены пример использования rknn_convert и поддерживаемые параметры:
python -m rknn.api.rknn_convert -t rk3588 -i ./model_config.yml -o ./output_path
Эти команды и параметры преобразуют модель в RKNN и сохраняют ее по указанному пути. Поддерживаемые параметры:
-i: путь к конфигурации модели .yml.
-o: каталог вывода преобразованной модели.
-t: target_platform; целевая платформа rv1103, rv1103b, rv1106, rv1106b, rv1126b, rk2118, rk3562, rk3566, rk3568, rk3576 или rk3588.
-e: необязательная оценка времени выполнения и использования памяти на плате. Для включения укажите -e. Обязательно подключите плату и правильно задайте target_platform, иначе возникнет ошибка. При нескольких устройствах выберите идентификатор через -d device_id.
-a: необязательная оценка точности созданной модели rknn. Для оценки в симуляторе укажите в командной строке -a “xx1.jpg xx2.jpg”. Для анализа точности используйте совместно с -d.
-v: необязательный вывод подробного журнала на экран; для включения укажите -v в командной строке.
-d: необязательный параметр. Для одного устройства adb используйте -d, для нескольких — -d device_id. Узнать device_id можно через adb devices.
Пример конфигурации yaml:
models:
  # model output name
  name: object_detection
  # Original model framework
  platform: onnx
  # Model input file path
  model_file_path: ./object_detection.onnx
  # Describe information such as input and output shapes
  subgraphs:
   # model input tensor shape
   input_size_list:
    - 1,3,512,512
   # input tensor name
   inputs:
    - data
   # output tensor name
   outputs:
    - conv6-1
    - conv6-2
    - conv6-3
  # quantification flag
  quantize: true
  # Quantify dataset file path (relative yml path)
  dataset: ./dataset.txt
  configs:
   quantized_dtype: asymmetric_quantized-8
   # rknn.config mean_values
   mean_values: [127.5,127.5,127.5]
   # rknn.config std_values
   std_values: [128.0,128.0,128.0]
   # rknn.config quant_img_RGB2BGR
   quant_img_RGB2BGR: false
   # rknn.config quantized_algorithm
   quantized_algorithm: normal
Конфигурация содержит имя модели, исходную среду, путь к файлу модели, сведения о входах и выходах и параметр квантования. Изменяйте соответствующие файлы под требования модели.
Описание конфигурации yml приведено ниже:
Таблица 3-1. Параметры yml-конфигурации преобразования модели
| Параметр | Заполняемое значение |
|---|---|
| -name | Имя выходного файла модели |
| -platform | Фреймворк исходной модели; поддерживаются tensorflow, tflite, caffe, onnx, pytorch, darknet |
| -model_file_path | Путь к исходному файлу модели; для модели из одного файла, например tensorflow, tflite, onnx, pytorch |
| -quantize | Использовать ли квантование |
| -dataset | Путь к набору данных для квантования (достаточно относительного пути). При включённом accuracy_analysis этот параметр обязателен |
| -prototxt_file_path | Файл prototxt модели при использовании caffe |
| -caffemodel_file_path | Файл caffemodel модели при использовании caffe |
| -darknet_cfg_path | Файл cfg модели при использовании darknet |
| -darknet_weights_path | Файл весов модели при использовании darknet |
| -subgraphs | Описывает формы входов и выходов и прочие сведения о модели. Обычно этот параметр и его подпараметры необязательны; кроме отдельных фреймворков, можно использовать значения модели по умолчанию |
| —-input_size_list (подпараметр) |
Форма входного тензора |
| —-inputs (подпараметр) |
Имя входного тензора |
| —-outputs (подпараметр) |
Имя выходного тензора |
| -configs | Соответствующие настройки rknn.config() |
| —-quantized_dtype (подпараметр) |
Тип квантования RKNN-Toolkit2: можно указать [asymmetric_quantized-8]. Если не указан, используется значение по умолчанию |
| —-mean_values (подпараметр) |
Средние значения входа модели. Для одного входа RGB, например [123.675,116.28,103.53]; для нескольких входов, например [[123,116,103],[255,255,255]] |
| —-std_values (подпараметр) |
Стандартные отклонения входа модели. Для одного входа RGB, например [58.395,58.295,58.391]; для нескольких входов, например [[127,127,127], [255,255,255]] |
| —- quant_img_RGB2BGR (подпараметр) |
Нужно ли выполнять RGB2BGR при загрузке изображений для квантования. По умолчанию false |
| —-quantized_algorithm (подпараметр) |
Алгоритм квантования: [‘normal’, ‘kl_divergence’, ‘mmse’]; по умолчанию normal |
| —-quantized_method (подпараметр) |
Метод квантования RKNN_toolkit2: [‘layer’, ‘channel’]; по умолчанию channel |
| —-optimization_level (подпараметр) |
Уровень оптимизации. По умолчанию 3: используются все стандартные оптимизации |
| —-model_pruning (подпараметр) |
Обрезка модели для уменьшения её размера. По умолчанию false; true включает функцию |
| —-quantize_weight (подпараметр) |
При quantize=false уменьшает размер модели rknn, квантуя часть весов. По умолчанию false; true включает функцию |
| —-single_core_mode (подпараметр) |
Генерировать ли только одноядерные модели для уменьшения размера и расхода памяти RKNN. По умолчанию false. Сейчас действует только для RK3576/RK3588. По умолчанию false. |
3.1.7 Квантование моделей в RKNN-Toolkit2
RKNN-Toolkit2 предоставляет два способа и три алгоритма квантования, выбираемые параметрами quantized_algorithm и quantized_method в rknn.config(). Ниже описаны алгоритмы и способы квантования признаков:
Три алгоритма квантования:
1. Normal: максимум и минимум диапазона квантования определяются по максимальному и минимальному значениям признаков модели с плавающей точкой. Алгоритм быстрый, но хуже работает при неравномерном распределении признаков. Обычно рекомендуется около 20–100 образцов калибровочных данных.
2. MMSE: границы диапазона определяются минимизацией среднеквадратичной ошибки между исходными числами с плавающей точкой и результатом квантования с последующим деквантованием. Это частично уменьшает потери точности из-за крупных выбросов. Итерационный перебор работает медленнее, но обычно точнее normal. Рекомендуется около 20–50 образцов; количество можно менять с учетом времени квантования.
3. KL-Divergence: числа с плавающей и фиксированной точкой в признаках представляются двумя распределениями. Изменением порогов распределения обновляются, а их сходство оценивается по KL-дивергенции для выбора максимума и минимума диапазона квантования. Алгоритм медленнее normal, но намного быстрее mmse. В некоторых случаях, например при неблагоприятном распределении признаков, результат заметно улучшается. Обычно рекомендуется около 20–100 изображений.
Два способа квантования:
1. Layer: все каналы одного слоя квантуются совместно и используют общие параметры квантования.
2. Channel: каждый канал одного слоя квантуется независимо и имеет собственные параметры. Обычно точность выше, чем при Layer.
Выбирайте алгоритм и способ квантования признаков по фактическому результату и требованиям модели. Подробные инструкции и принципы квантования см. в главе 6.
3.2 Оценка модели
3.2.1 Инференс модели
После преобразования исходной модели в RKNN выполните инференс в симуляторе или на плате и обработайте результаты для проверки правильности. Если результаты неверны, используйте анализ точности квантованной модели и проверьте предварительную и последующую обработку.
Параметры инициализации rknn.init_runtime():
target: целевая аппаратная платформа. По умолчанию None — инференс выполняется в симуляторе. Для результатов на реальной плате укажите соответствующую платформу: RV1103 / RV1103B / RV1106 / RV1106B / RV1126B / RK3562 / RK3566 / RK3568 / RK3576 / RK3588.
device_id: идентификатор устройства. По умолчанию None. Если задан target, для инференса выбирается одно устройство. При нескольких подключенных платах необходимо указать нужный ID. Для инференса через сетевой ADB сначала вручную выполните adb connect [IP], затем укажите идентификатор устройства — обычно IP-адрес либо IP-адрес с портом. Команда adb devices выводит все подключенные устройства.
perf_debug: включение режима отладки при оценке производительности. По умолчанию False; rknn.eval_perf() возвращает общее время выполнения модели. При True дополнительно выводится время каждого слоя. RV1103, RV1103B, RV1106 и RV1106B этого не поддерживают.
eval_mem: переход в режим оценки памяти. По умолчанию false. После установки True можно вызвать rknn.eval_memory(), чтобы получить использование памяти при выполнении модели.
Параметры rknn.inference():
inputs: список входов для инференса в формате ndarray.
data_format: список расположений входных данных, действующий только для четырехмерных входов. Допустимы NCHW и NHWC. По умолчанию None, что означает NHWC для всех входов.
Пример кода:
ret = rknn.init_runtime(target=platform, device_id='515e9b401c060c0b')

# Preprocess
image_src = cv2.imread(IMG_PATH)
img = preprocess(image_src)

# Inference
outputs = rknn.inference(inputs=[img])

# Postprocess
outputs = postprocess(outputs)
Примечание:
1. При ошибке «E RKNN: failed to allocate fd, ret: -1, errno: 12» во время инференса на RV1103 или RV1106 выполните RkLunch-stop.sh в терминале платы, чтобы закрыть другие приложения, занимающие память.
2. В версии ARM64 rknn.init_runtime() не поддерживает device_id.
3.2.2 Анализ точности модели
При проблемах с результатами инференса квантованной модели используйте rknn.accuracy_analysis(), чтобы проанализировать точность и проверить каждый слой операторов.
Параметры интерфейса анализа точности rknn.accuracy_analysis():
inputs: список путей к входным файлам jpg, png, bmp или npy.
output_dir: каталог сохранения, по умолчанию ‘./snapshot’.
Target: целевая аппаратная платформа, по умолчанию None. Если target задан как RV1103 / RV1103B / RV1106 / RV1106B / RV1126B / RK3562 / RK3566 / RK3568 / RK3576 / RK3588, получаются результаты каждого слоя во время выполнения и проводится анализ точности.
device_id: идентификатор устройства. По умолчанию None — анализ только в симуляторе. При заданном target выбирается одно устройство. Если подключено несколько устройств, укажите соответствующий ID. Для анализа через сетевой ADB вручную подключитесь командой adb connect [IP], затем введите идентификатор — обычно IP-адрес либо IP-адрес с номером порта.
Примечание:
1. Анализ точности может завершиться ошибкой, если модель слишком велика, а хранилища платы недостаточно. Проверьте свободное место командой df -h в терминале платы. При нехватке удалите ненужные файлы, чтобы раздел output_dir вместил результаты.
2. После загрузки через rknn.load_rknn() анализ точности недоступен, поскольку в модели RKNN отсутствует информация об исходной модели.
3. В версии ARM64 rknn.accuracy_analysis() не поддерживает device_id.
Пример кода:
ret = rknn.accuracy_analysis(inputs=[img_path], target=platform, device_id='515e9b401c060c0b')
Результаты анализа точности:
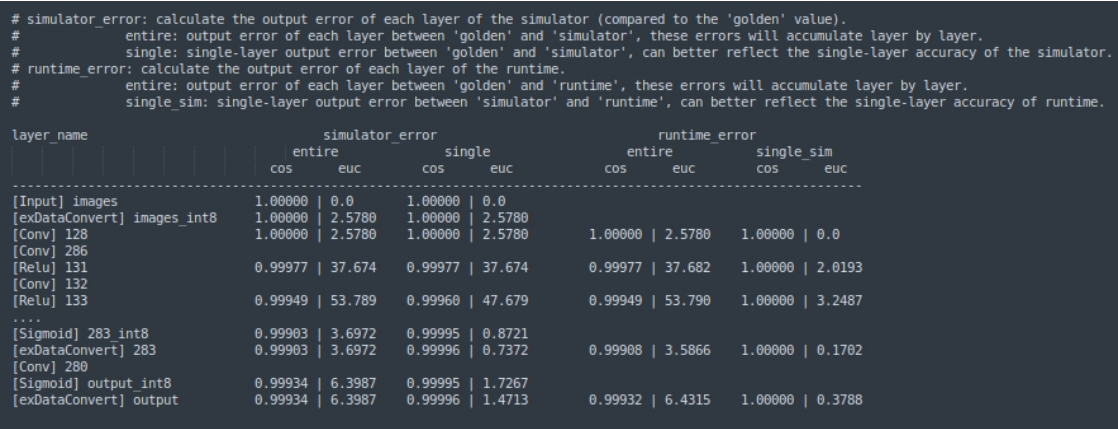
# simulator_error: calculate the output error of each layer of the simulator (compared to the 'golden' value).
# entire: output error of each layer between 'golden' and 'simulator', these errors will accumulate layer by layer.
# single: single-layer output error between 'golden' and 'simulator', can better reflect the single-layer accuracy of the simulator.
# runtime_error: calculate the output error of each layer of the runtime.
# entire: output error of each layer between 'golden' and 'runtime', these errors will accumulate layer by layer.
# single_sim: single-layer output error between 'simulator' and 'runtime', can better reflect the single-layer accuracy of runtime.
| layer_name | simulator_error entire cos | simulator_error entire euc | simulator_error single cos | simulator_error single euc | runtime_error entire cos | runtime_error entire euc | runtime_error single_sim cos | runtime_error single_sim euc |
|---|---|---|---|---|---|---|---|---|
| [Input] images | 1.00000 | 0.0 | 1.00000 | 0.0 | ||||
| [exDataConvert] images_int8 | 1.00000 | 2.5780 | 1.00000 | 2.5780 | ||||
| [Conv] 128 | 1.00000 | 2.5780 | 1.00000 | 2.5780 | 1.00000 | 2.5780 | 1.00000 | 0.0 |
| [Conv] 286 | ||||||||
| [Relu] 131 | 0.99977 | 37.674 | 0.99977 | 37.674 | 0.99977 | 37.682 | 1.00000 | 2.0193 |
| [Conv] 132 | ||||||||
| [Relu] 133 | 0.99949 | 53.789 | 0.99960 | 47.679 | 0.99949 | 53.790 | 1.00000 | 3.2487 |
| … | ||||||||
| [Sigmoid] 283_int8 | 0.99903 | 3.6972 | 0.99995 | 0.8721 | ||||
| [exDataConvert] 283 | 0.99903 | 3.6972 | 0.99996 | 0.7372 | 0.99908 | 3.5866 | 1.00000 | 0.1702 |
| [Conv] 280 | ||||||||
| [Sigmoid] output_int8 | 0.99934 | 6.3987 | 0.99995 | 1.7267 | ||||
| [exDataConvert] output | 0.99934 | 6.3987 | 0.99996 | 1.4713 | 0.99932 | 6.4315 | 1.00000 | 0.3788 |
Рисунок 3-2. Результаты анализа точности
Результаты точности разделены на четыре столбца:
| simulator_error | entire | Косинусное и евклидово расстояния между результатом симулятора от начала до текущего слоя и эталонным результатом. |
| single | При эталонном входе текущего слоя сравниваются косинусное и евклидово расстояния между результатом симулятора и эталонным результатом. | |
| runtime_error | entire | Косинусное и евклидово расстояния между фактическим и эталонным результатами от начала до конца текущего слоя. |
| single_sim | При эталонном входе текущего слоя сравниваются косинусное и евклидово расстояния между фактическим результатом слоя на плате и результатом симулятора. |
3.2.3 Оценка производительности модели
rknn.eval_perf() выводит текущие аппаратные частоты и результаты оценки производительности модели. fix_freq определяет, нужно ли попытаться зафиксировать частоты CPU/NPU/DDR. Для фиксации задайте True, иначе False; по умолчанию True. Если при инициализации perf_debug в rknn.init_runtime() установлен в True, выводится время каждого слоя и общее время; при False — только общее время.
Примечание:
1. RV1103, RV1103B, RV1106 и RV1106B не поддерживают perf_debug=True и выводят только общее время модели.
Пример кода:
ret = rknn.init_runtime(target=platform, perf_debug=True)
perf_detail = rknn.eval_perf()
Пример вывода частот после eval_perf на RK3588 приведен ниже; частоты зависят от прошивки. У RK3588 есть большие и малые ядра CPU, поэтому столбец CPU содержит несколько частот в KHz. Единицы частот NPU и DDR — Hz.
CPU Current Frequency List:
  - 1800000
  - 2256000
  - 2304000
NPU Current Frequency List:
  - 1000000000
DDR Current Frequency List:
  - 2112000000
Результат оценки производительности:
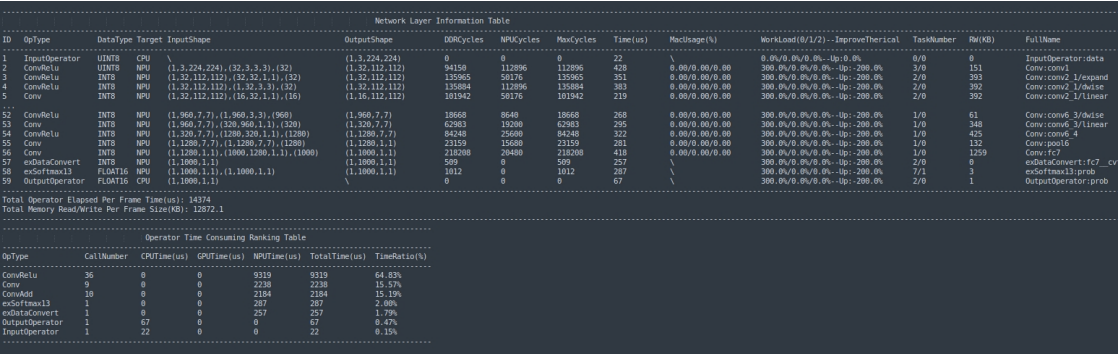
Network Layer Information Table
ID | OpType | DataType | Target | InputShape | OutputShape | DDRCycles | NPUCycles | MaxCycles | Time(us) | MacUsage(%) | WorkLoad(0/1/2)--ImproveTherical | TaskNumber | RW(KB) | FullName
1 | InputOperator | UINT8 | CPU | \ | (1,3,224,224) | 0 | 0 | 0 | 22 | \ | 0.0%/0.0%/0.0%--Up:0.0% | 0/0 | 0 | InputOperator:data
2 | ConvRelu | UINT8 | NPU | (1,3,224,224),(32,3,3,3),(32) | (1,32,112,112) | 94150 | 112896 | 112896 | 428 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 3/0 | 151 | Conv:conv1
3 | ConvRelu | INT8 | NPU | (1,32,112,112),(32,32,1,1),(32) | (1,32,112,112) | 135965 | 50176 | 135965 | 351 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 393 | Conv:conv2_1/expand
4 | ConvRelu | INT8 | NPU | (1,32,112,112),(1,32,3,3),(32) | (1,32,112,112) | 135884 | 112896 | 135884 | 383 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 392 | Conv:conv2_1/dwise
5 | Conv | INT8 | NPU | (1,32,112,112),(16,32,1,1),(16) | (1,16,112,112) | 101942 | 50176 | 101942 | 219 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 392 | Conv:conv2_1/linear
...
52 | ConvRelu | INT8 | NPU | (1,960,7,7),(1,960,3,3),(960) | (1,960,7,7) | 18668 | 8640 | 18668 | 268 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 61 | Conv:conv6_3/dwise
53 | Conv | INT8 | NPU | (1,960,7,7),(320,960,1,1),(320) | (1,320,7,7) | 62983 | 19200 | 62983 | 295 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 348 | Conv:conv6_3/linear
54 | ConvRelu | INT8 | NPU | (1,320,7,7),(1280,320,1,1),(1280) | (1,1280,7,7) | 84248 | 25600 | 84248 | 322 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 425 | Conv:conv6_4
55 | Conv | INT8 | NPU | (1,1280,7,7),(1,1280,7,7),(1280) | (1,1280,1,1) | 23159 | 15680 | 23159 | 281 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 132 | Conv:pool6
56 | Conv | INT8 | NPU | (1,1280,1,1),(1000,1280,1,1),(1000) | (1,1000,1,1) | 218208 | 20480 | 218208 | 418 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 1259 | Conv:fc7
57 | exDataConvert | INT8 | NPU | (1,1000,1,1) | (1,1000,1,1) | 509 | 0 | 509 | 257 | \ | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 0 | exDataConvert:fc7__cv
58 | exSoftmax13 | FLOAT16 | NPU | (1,1000,1,1),(1,1000,1,1) | (1,1000,1,1) | 1012 | 0 | 1012 | 287 | \ | 300.0%/0.0%/0.0%--Up:-200.0% | 7/1 | 3 | exSoftmax13:prob
59 | OutputOperator | FLOAT16 | CPU | (1,1000,1,1) | \ | 0 | 0 | 0 | 67 | \ | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 1 | OutputOperator:prob

Total Operator Elapsed Per Frame Time(us): 14374
Total Memory Read/Write Per Frame Size(KB): 12872.1

Operator Time Consuming Ranking Table
OpType | CallNumber | CPUTime(us) | GPUTime(us) | NPUTime(us) | TotalTime(us) | TimeRatio(%)
ConvRelu | 36 | 0 | 0 | 9319 | 9319 | 64.83%
Conv | 9 | 0 | 0 | 2238 | 2238 | 15.57%
ConvAdd | 10 | 0 | 0 | 2184 | 2184 | 15.19%
exSoftmax13 | 1 | 0 | 0 | 287 | 287 | 2.00%
exDataConvert | 1 | 0 | 0 | 257 | 257 | 1.79%
OutputOperator | 1 | 67 | 0 | 0 | 67 | 0.47%
InputOperator | 1 | 22 | 0 | 0 | 22 | 0.15%
Рисунок 3-3. Результаты оценки производительности
Описание некоторых параметров:
| Параметр | Описание |
|---|---|
| ID | Идентификатор каждого оператора |
| OpType | Тип каждого оператора |
| DataType | Тип входных данных |
| Target | Аппаратный исполнитель оператора (CPU/NPU/GPU) |
| InputShape | Форма входа |
| OutputShape | Форма выхода |
| DDRCycles | Такты чтения и записи DDR |
| NPUCycles | Число тактов NPU |
| MaxCycles | Максимум DDR Cycles и NPU Cycles |
| Time(us) | Время вычисления оператора (us) |
| MacUsage(%) | Загрузка MAC |
| WorkLoad(0/1/2) | Загрузка ядер 0/1/2 (только RK3588) |
| WorkLoad(0/1/2) | Загрузка ядер 0/1 (только RK3576) |
| RW(KB) | Общий объём прочитанных и записанных данных (KB) |
| FullName | Полное имя оператора |
| Total Operator Elapsed Per Frame Time(us) |
Общее время вывода модели для одного кадра |
| Total Memory Read/Write Per Frame Size(KB) |
Общий расход полосы памяти при выводе одного кадра |
| CallNumber | Число запусков оператора для одного кадра |
| CPUTime(us) | Общее время этого оператора на CPU для одного кадра |
| GPUTime(us) | Общее время этого оператора на GPU для одного кадра |
| NPUTime(us) | Общее время этого оператора на NPU для одного кадра |
| TotalTime(us) | Общее время этого оператора для одного кадра |
| TimeRatio(%) | Отношение общего времени этого оператора для одного кадра к общему времени обработки кадра |
3.2.4 Оценка использования памяти моделью
rknn.eval_memory() оценивает потребление памяти моделью. Если eval_mem в rknn.init_runtime() установлен в True, также выводится потребление памяти каждой частью.
Пример кода:
ret = rknn.init_runtime(target=platform, eval_mem=True)
memory_detail = rknn.eval_memory()
Результат оценки памяти:
======================================================
      Memory Profile Info Dump
======================================================
NPU model memory detail(bytes):
  Weight Memory: 8.67 MiB
  Internal Tensor Memory: 7.42 MiB
  Other Memory: 3.03 MiB
  Total Memory: 19.12 MiB

INFO: When evaluating memory usage, we need consider
the size of model, current model size is: 11.86 MiB
======================================================
Описание некоторых параметров:
| Total Weight Memory | Память весов модели (MB) |
|---|---|
| Total Internal Tensor Memory |
Память тензоров признаков модели (MB) |
| Other Memory | Прочая память, например конфигурация регистров и входные/выходные тензоры (MB) |
| Total Memory | Общий расход памяти модели (MB) |
3.3 Инференс на плате с демонстрационным кодом C
В этой главе описана последовательность вызовов обычного API. Для нулевого копирования см. раздел 5.2. Последовательность обычного RKNN API:
1. rknn_init() — инициализация модели;
2. rknn_query() — запрос атрибутов входов и выходов модели;
3. Предварительная обработка входа;
4. rknn_inputs_set() — настройка входных данных;
5. rknn_run() — выполнение инференса модели;
6. rknn_outputs_get() — получение выходных данных;
7. Последующая обработка выхода;
8. rknn_outputs_release() — освобождение памяти выхода;
9. rknn_destroy() — освобождение ресурсов RKNN.
Последовательность показана на рисунке 3-4. Желтым шрифтом отмечены действия пользователя, позволяющие вводить данные циклически.
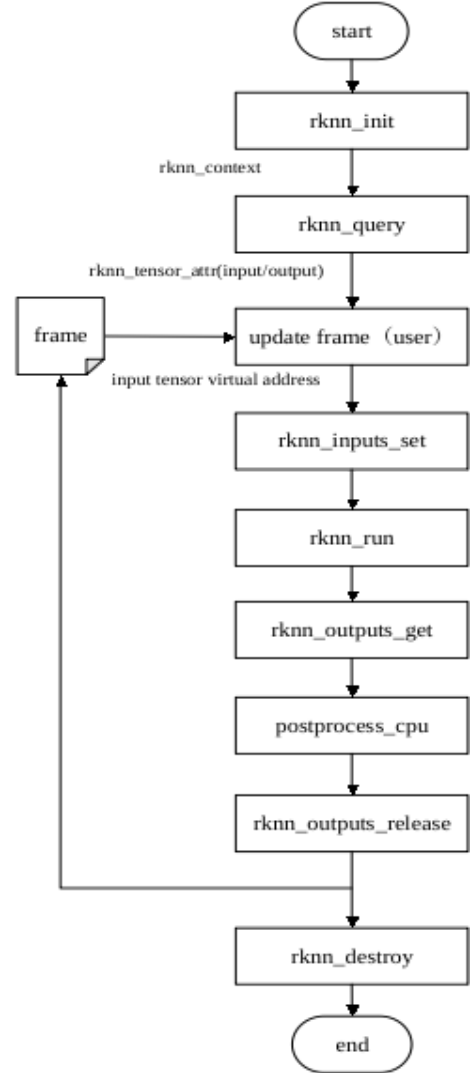
Рисунок 3-4. Процесс обычного API
Пример кода обычного API:
// Init RKNN model
ret = rknn_init(&ctx, model, model_len, 0, NULL);

// Get Model Input Output Number
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// Get Model Input Info
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
  input_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}

// Get Model Output Info
rknn_tensor_attr output_attrs[io_num.n_output];
memset(output_attrs, 0, sizeof(output_attrs));
for (int i = 0; i < io_num.n_output; i++)
{
  output_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_OUTPUT_ATTR, &(output_attrs[i]), sizeof(rknn_tensor_attr));
}

rknn_input inputs[io_num.n_input];
rknn_output outputs[io_num.n_output];
memset(inputs, 0, sizeof(inputs));
memset(outputs, 0, sizeof(outputs));

// Pre-process
// Read Image
image_buffer_t src_image;
memset(&src_image, 0, sizeof(image_buffer_t));
ret = read_image(image_path, &src_image);

// Set Input Data
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(rknn_ctx, io_num.n_input, inputs);

// Run
ret = rknn_run(rknn_ctx, nullptr);

// Get Output Data
ret = rknn_outputs_get(rknn_ctx, io_num.n_output, outputs, NULL);

// Post-process
post_process(outputs, results);

// Release RKNN Output
rknn_outputs_release(rknn_ctx, io_num.n_output, outputs);

if (rknn_ctx != 0)
{
  rknn_destroy(rknn_ctx);
}
3.4 Инференс Python на плате
RKNN-Toolkit Lite2 предоставляет Python-интерфейс инференса на плате, упрощая разработку приложений ИИ на Python.
Примечание: перед разработкой с RKNN-Toolkit Lite2 преобразуйте экспортированные модели соответствующих сред глубокого обучения в RKNN с помощью RKNN-Toolkit2. Подробности см. в разделе 3.1.
3.4.1 Требования к системной среде
Для RKNN-Toolkit Lite2 необходима следующая среда:
Таблица 3-2. Среда выполнения RKNN-Toolkit Lite2
| OS | Debian 10 / 11 (aarch64) |
|---|---|
| Версия Python | 3.7 / 3.8 / 3.9 / 3.10 / 3.11 |
| Зависимости Python | ‘numpy’ ‘ruamel.yaml’ ‘psutils’ |
3.4.2 Установка инструментов
Установите RKNN-Toolkit Lite2 командой pip3 install. Последовательность установки:
Если python3/pip3 и другие программы отсутствуют, сначала установите их через apt-get, например:
sudo apt-get update
sudo apt-get install -y python3 python3-dev python3-pip gcc
Примечание: некоторые зависимости собираются из исходного кода, для чего нужны python3-dev и gcc. Поэтому оба пакета устанавливаются на этом шаге, чтобы избежать последующих ошибок компиляции.
Установите зависимости opencv-python и numpy, например:
sudo apt-get install -y python3-opencv
sudo apt-get install -y python3-numpy
Примечание:
1. Сам RKNN-Toolkit Lite2 не зависит от opencv-python, но пример использует этот модуль для обработки изображений.
2. Установка numpy через pip3 в прошивке Debian10 может завершиться ошибкой. Рекомендуется приведенный выше способ.
Установка RKNN-Toolkit Lite2
Пакеты для платформ находятся в rknn-toolkit-lite2/packages в SDK. Перейдите в packages и выполните следующую команду установки:
# Python 3.7
pip3 install rknn_toolkit_lite2-x.y.z-cp37-cp37m-linux_aarch64.whl
# Python 3.8
pip3 install rknn_toolkit_lite2-x.y.z-cp38-cp38-linux_aarch64.whl
# Python 3.9
pip3 install rknn_toolkit_lite2-x.y.z-cp39-cp39-linux_aarch64.whl
# Python 3.10
pip3 install rknn_toolkit_lite2-x.y.z-cp310-cp310-linux_aarch64.whl
# Python 3.11
pip3 install rknn_toolkit_lite2-x.y.z-cp311-cp311-linux_aarch64.whl
3.4.3 Основной процесс RKNN-Toolkit Lite2
Основной процесс развертывания модели RKNN через RKNN-Toolkit Lite2 показан ниже:
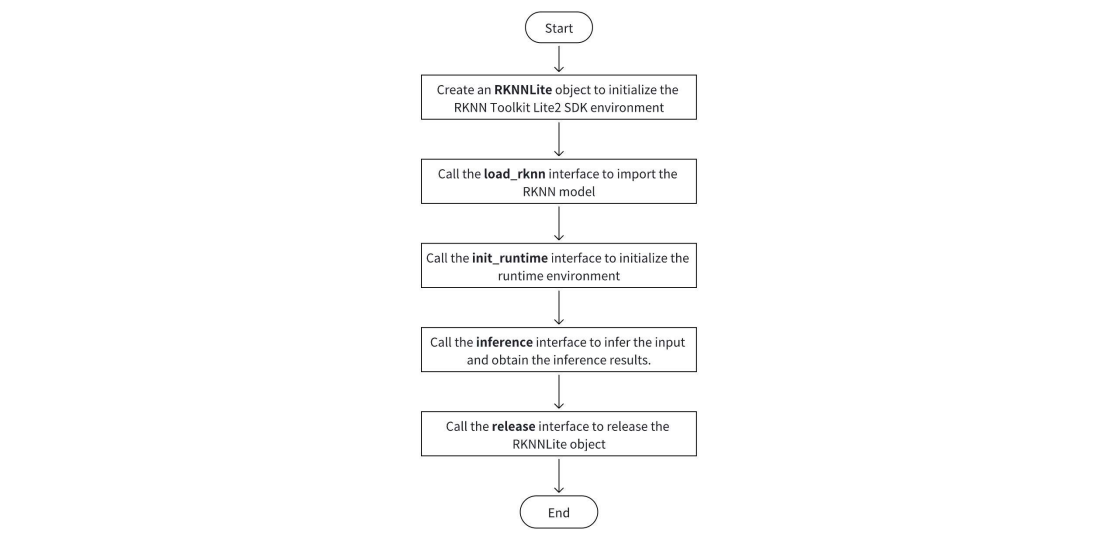
Рисунок 3-5. Процесс RKNN-Toolkit Lite2
Примечание:
1. До вызова inference загрузите и предварительно обработайте входные данные, затем задайте параметры интерфейса по сведениям о входе.
2. После вызова inference результаты обычно нужно обработать, чтобы реализовать функции приложения верхнего уровня.
3.4.4 Пример запуска RKNN-Toolkit Lite2
В SDK/rknn-toolkit-lite2/examples находится приложение классификации изображений на RKNN-Toolkit Lite2. Через его интерфейс приложение загружает модель RKNN Resnet18, обрабатывает изображение и выводит пять лучших результатов классификации (top5).
Шаги запуска примера:
1. Подготовьте плату с установленным RKNN-Toolkit Lite2;
2. Скопируйте SDK/rknn-toolkit-lite2/examples на плату;
3. Перейдите в examples/resent18 и выполните следующие команды запуска примера;
python test.py
Результат приведен ниже:
model: resnet18
-----TOP 5-----
[812]: 0.999676 [class: space shuttle]
[404]: 0.000249 [class: airliner]
[657]: 0.000014 [class: missile]
[833]: 0.000009 [class: bullet train, bullet | submarine, pigboat, sub, U-boat]
[466]: 0.000009 [class: bullet train, bullet | submarine, pigboat, sub, U-boat]
3.4.5 Подробное описание API RKNN-Toolkit Lite2
В этой главе подробно описано использование всех API RKNN-Toolkit Lite2.
3.4.5.1 Инициализация и освобождение RKNNLite
При работе с RKNN-Toolkit Lite2 вызовите RKNNLite() для инициализации объекта RKNNLite. После использования освободите ресурсы методом объекта rknn_lite.release().
При инициализации RKNNLite можно задать verbose и verbose_file для подробного журналирования. verbose управляет выводом на экран. Если задан verbose_file и verbose имеет значение true, журнал также записывается в указанный файл.
Пример кода:
# Output detailed log information to the screen and write it to the inference.log file
rknn_lite = RKNNLite(verbose=True, verbose_file='./inference.log')
# Only print detailed log information on the screen
rknn_lite = RKNNLite(verbose=True)
…
rknn_lite.release()
3.4.5.2 Загрузка модели RKNN
| API | load_rknn |
|---|---|
| Описание | Загрузить модель RKNN |
| Параметр | Путь к модели RKNN |
| Возвращаемое значение | 0: успешно -1: ошибка |
Пример кода:
# Load the resnet18.rknn model from the current directory
ret = rknn_lite.load_rknn('./resnet_18.rknn')
3.4.5.3 Инициализация init_runtime
init_runtime необходимо вызвать до инференса модели.
| API | init_runtime |
|---|---|
| Описание | Инициализировать среду выполнения |
| Параметр | core_mask: настройка ядер NPU. Варианты: - RKNNLite.NPU_CORE_AUTO: автоматически выбирается свободное ядро NPU - RKNNLite.NPU_CORE_0: выполнение на NPU0 - RKNNLite.NPU_CORE_1: выполнение на NPU1 - RKNNLite.NPU_CORE_2: выполнение на NPU2 - RKNNLite.NPU_CORE_0_1: выполнение на NPU0 и NPU1 одновременно - RKNNLite.NPU_CORE_0_1_2: выполнение на NPU0, NPU1 и NPU2 одновременно - RKNNLite.NPU_CORE_ALL: выполнение на всех ядрах NPU По умолчанию NPU_CORE_AUTO — автоматическое планирование. Примечание: параметр действует только для RK3576/RK3588. |
| Возвращаемое значение | 0: успешно -1: ошибка |
Пример кода:
# to initialize the init_runtime
ret = rknn_lite.init_runtime(core_mask=RKNNLite.NPU_CORE_AUTO)
if ret != 0:
  print('Init runtime environment failed')
  exit(ret)
3.4.5.4 Инференс модели
| API | inference |
|---|---|
| Описание | Выполнить вывод для заданного входа и вернуть результат |
| Параметр | inputs: входные данные, например изображения OpenCV (четырёхмерный вход необходимо вручную расширить до 4 измерений). Тип list; элементы списка — ndarray. |
| data_format: формат данных; тип list, для каждого входа допустимы “nhwc”, “nchw”; действует только для четырёхмерного входа. По умолчанию None. Если параметр не задан, буфер четырёхмерного входа организуется как NHWC, а прочих входов — в формате, требуемом моделью. Если параметр задан, нечетырёхмерный вход по-прежнему должен соответствовать формату модели независимо от “nhwc” или “nchw”; четырёхмерный — указанному формату. Для моделей с несколькими входами укажите все входы. | |
| Возвращаемое значение | results: результаты вывода; тип Python list, элементы — ndarray |
Ниже приведен пример кода инференса для классификации:
# Get input data
img = cv2.imread('./space_shuttle_224.jpg')
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
img = np.expand_dims(img, 0)

# Inference
outputs = rknn_lite.inference(inputs=[img])

# Show the classification results
show_top5(outputs)
3.4.5.5 Запрос версии SDK
| API | get_sdk_version |
|---|---|
| Описание | Получить версии среды выполнения, драйвера и модели RKNN. Примечание: до вызова необходимо загрузить модель и инициализировать среду выполнения. |
| Параметр | None |
| Возвращаемое значение | sdk_version: сведения о версиях среды выполнения, драйвера и моделей RKNN; тип Python string |
Пример кода:
# Get SDK version information
……
sdk_version = rknn_lite.get_sdk_version()
……
Возвращаемая информация:
==============================================
RKNN VERSION:
 API: 1.5.2 (71720f3fc@2023-08-21T09:29:52)
 DRV: 0.7.2
==============================================
3.4.5.6 Запрос платформ, доступных для выполнения модели
| API | list_support_target_platform |
|---|---|
| Описание | Запросить платформы чипов, на которых может работать заданная модель RKNN |
| Параметр | rknn_model: путь к модели RKNN. Если путь не задан, платформы, поддерживаемые RKNN-Toolkit Lite2, выводятся по категориям |
| Возвращаемое значение | support_target_platform: платформы чипов, на которых может работать модель. Если путь пуст или отсутствует, возвращается None |
Пример кода:
rknn_lite.list_support_target_platform(rknn_model=’mobilenet_v1.rknn’)
Результат приведен ниже:
**************************************************
Target platforms filled in RKNN model: ['rk3566']
Target platforms supported by this RKNN model: ['RK3566', 'RK3568']
**************************************************
3.5 API умножения матриц
Matmul API — отдельный набор C API в Runtime для умножения матриц на NPU. RV1103/RV1103B/RV1106/RV1106B/RK2118 пока не поддерживаются. Умножение матриц — важная операция линейной алгебры, определяемая следующим образом:
C=AB,
где A — матрица M×K, B — матрица K×N, C — матрица M×N.
3.5.1 Возможности и применение
Matmul API в основном применяется для вычисления параметров в глубоком обучении. Например, умножение матриц широко используется в основных модулях Transformer — механизме self-attention и слоях сети прямого распространения. Поэтому эффективность умножения матриц критична для общей производительности Transformer. Возможности:
Эффективность: низкоуровневая реализация Matmul API использует RKNPU, обеспечивая высокую производительность и низкое энергопотребление.
Гибкость: загружать модель RKNN не нужно. Поддерживаются распространенные на периферийных устройствах входные типы int4, int8 и float16, отдельный интерфейс выделения памяти и механизм внешней памяти. Пользователь может управлять и повторно использовать входную и выходную память матриц.
3.5.2 Схема Matmul API
При компиляции подключите заголовок rknn_matmul_api.h: в нем определены структуры и интерфейсы Matmul API.
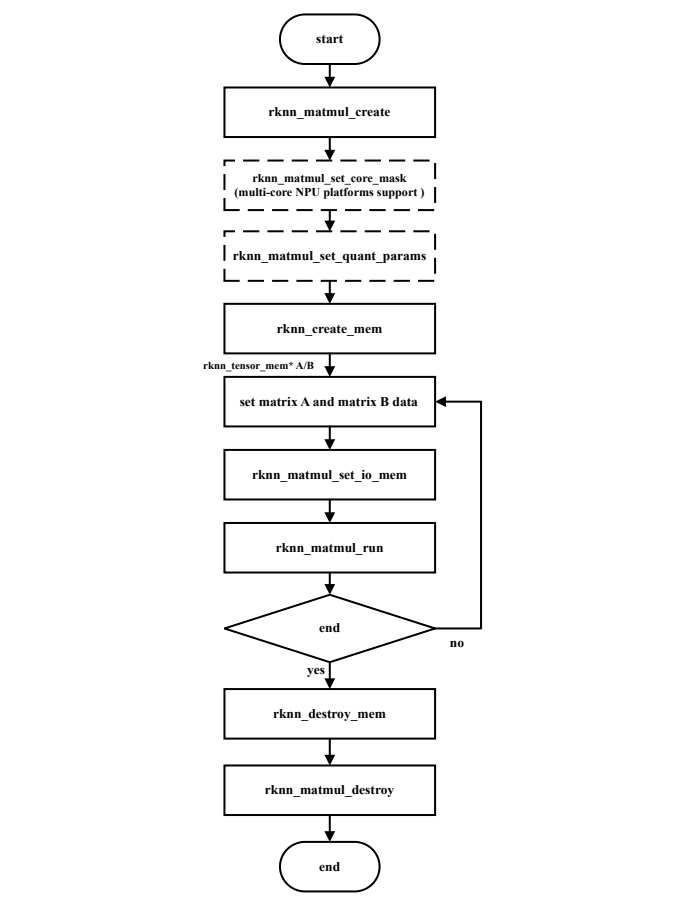
Рисунок 3-6. Основной процесс Matmul API
Шаги использования Matmul API:
1. Создайте контекст: настройте rknn_matmul_info, включая M, K, N, типы и расположение данных входных и выходных матриц и другую информацию. Вызовите rknn_matmul_create для инициализации контекста. После инициализации получите указатель rknn_matmul_io_attr со сведениями о тензорах входных и выходных матриц.
2. Выберите ядро NPU, только на многоядерных платформах: вызовите rknn_matmul_set_core_mask и задайте маску нужного ядра. Без этого вызова на многоядерной NPU по умолчанию автоматически выбирается свободное ядро.
3. Задайте параметры квантования матриц A, B и C: вызовите rknn_matmul_set_quant_params со структурой rknn_quant_params, содержащей соответствующие значения. Без этого вызова для каждой матрицы действуют scale=1.0 и zero_point=0.
4. Создайте входную и выходную память через rknn_create_mem в соответствии с размерами тензоров матриц.
5. Заполните входные матрицы A и B согласно форме и типу данных. Задайте параметры квантования в соответствии со способом квантования.
6. Настройте входную и выходную память: rknn_matmul_set_io_mem записывает заполненную входную матрицу и выходную память в контекст. Помимо адреса памяти интерфейс преобразует расположение данных согласно настройке layout. Его нужно вызывать после заполнения или изменения входных данных; этим он отличается от rknn_set_io_mem в API нулевого копирования.
7. После настройки памяти выполните умножение матриц вызовом rknn_matmul_run.
8. После умножения прочитайте результат из выходной памяти в соответствии с заданным layout.
9. По завершении освободите память через rknn_destroy_mem, а контекст — через rknn_matmul_destroy.
3.5.3 Расширенное использование Matmul API
При создании контекста задайте структуру rknn_matmul_info со спецификацией умножения: размерами, типами и расположением данных входных и выходных матриц. B_layout и AC_layout задают высокопроизводительное расположение. Определение структуры приведено в таблице:
Таблица 3-3. Поля rknn_matmul_info
| Поле | Тип данных | Описание |
|---|---|---|
| M | int32_t | Число строк матрицы A |
| K | int32_t | Число столбцов матрицы A |
| N | int32_t | Число столбцов матрицы B |
| type | rknn_matmul_type | Типы входных и выходных матриц: RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32: A — float16, B — float16, C — float32; RKNN_INT8_MM_INT8_TO_INT32: A — int8, B — int8, C — int32; RKNN_INT8_MM_INT8_TO_INT8: A — int8, B — int8, C — int8; RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16: A — float16, B — float16, C — float16; RKNN_FLOAT16_MM_INT8_TO_FLOAT32: A — float16, B — int8, C — float32; RKNN_FLOAT16_MM_INT8_TO_FLOAT16: A — float16, B — int8, C — float16; RKNN_FLOAT16_MM_INT4_TO_FLOAT32: A — float16, B — int4, C — float32; RKNN_FLOAT16_MM_INT4_TO_FLOAT16: A — float16, B — int4, C — float16; RKNN_INT8_MM_INT8_TO_FLOAT32: A — int8, B — int8, C — float32; RKNN_INT4_MM_INT4_TO_INT16: A — int4, B — int4, C — int16; RKNN_INT8_MM_INT4_TO_INT32: A — int8, B — int4, C — int32; |
| B_layout | int16_t | Размещение данных матрицы B. RKNN_MM_LAYOUT_NORM: исходная форма KxN; RKNN_MM_LAYOUT_NATIVE: высокопроизводительная компоновка; RKNN_MM_LAYOUT_TP_NORM: форма после транспонирования, то есть NxK. |
| B_quant_type | int16_t | Метод квантования матрицы B. RKNN_QUANT_TYPE_PER_LAYER_SYM: симметричное квантование матрицы B по слоям; RKNN_QUANT_TYPE_PER_LAYER_ASYM: асимметричное квантование матрицы B по слоям; RKNN_QUANT_TYPE_PER_CHANNEL_SYM: симметричное квантование матрицы B по каналам; RKNN_QUANT_TYPE_PER_CHANNEL_ASYM: асимметричное квантование матрицы B по каналам; RKNN_QUANT_TYPE_PER_GROUP_SYM: симметричное квантование матрицы B по группам; RKNN_QUANT_TYPE_PER_GROUP_ASYM: асимметричное квантование матрицы B по группам; |
| AC_layout | int16_t | Размещение данных матриц A и C. RKNN_MM_LAYOUT_NORM: исходные формы; RKNN_MM_LAYOUT_NATIVE: высокопроизводительная компоновка. Спецификация приведена в 3.5.4. |
| AC_quant_type | int16_t | Размещение данных матриц A и C. RKNN_MM_LAYOUT_NORM: исходные формы; RKNN_MM_LAYOUT_NATIVE: высокопроизводительная компоновка. |
| iommu_domain_id | int32_t | Индекс домена адресного пространства IOMMU, в котором находится контекст матриц. Адресное пространство IOMMU соответствует контексту один к одному, размер каждого пространства — 4GB. Параметр применяется главным образом, когда размеры матриц A, B, C велики и выделенная NPU память в одном домене превышает 4GB: требуется переключение в другой домен. |
| group_size | int16_t | Число элементов группы; действует только при включённом групповом квантовании. |
| reserved | int8_t[] | Зарезервированные поля |
Исходная форма A — MxK, B — KxN, C — MxN.
3.5.3.1 Умножение матриц с заданными параметрами квантования
Если результат умножения высокой разрядности нужно квантовать в низкую разрядность, например для A и B типа int8 и C типа int8, задайте параметры квантования матриц. Они состоят из scale и zero_point и представлены rknn_quant_params. Параметры A и C устанавливаются через rknn_matmul_set_quant_params. После успешной установки параметры B в режиме Per-Channel можно прочитать через rknn_matmul_get_quant_params. Структура rknn_quant_params описана ниже:
Таблица 3-4. Структура rknn_quant_params
| Поле | Тип данных | Описание |
|---|---|---|
| name | char[] | Имя матрицы |
| scale | float* | Начальный адрес массива параметров квантования scale |
| scale_len | int32_t | Длина массива параметров квантования scale |
| zp | int32_t* | Начальный адрес массива параметров квантования zero_point |
| zp_len | int32_t | Длина массива параметров квантования zero_point |
Matmul поддерживает Per-Layer, Per-Channel и Per-Group с такими параметрами:
Per-Layer: длина массивов scale и zp равна 1.
Per-Channel: длина массивов scale и zp равна N.
Per-Group: длина массивов scale и zp равна N*K/group_size. Число элементов группы задается group_size, а элементы одной группы используют общие параметры квантования group_size — так сформулировано в оригинале.
Поддерживаются симметричное и асимметричное квантование. При симметричном все zp равны 0, при асимметричном не все zp равны 0.
3.5.3.2 Умножение матриц с динамической формой входа
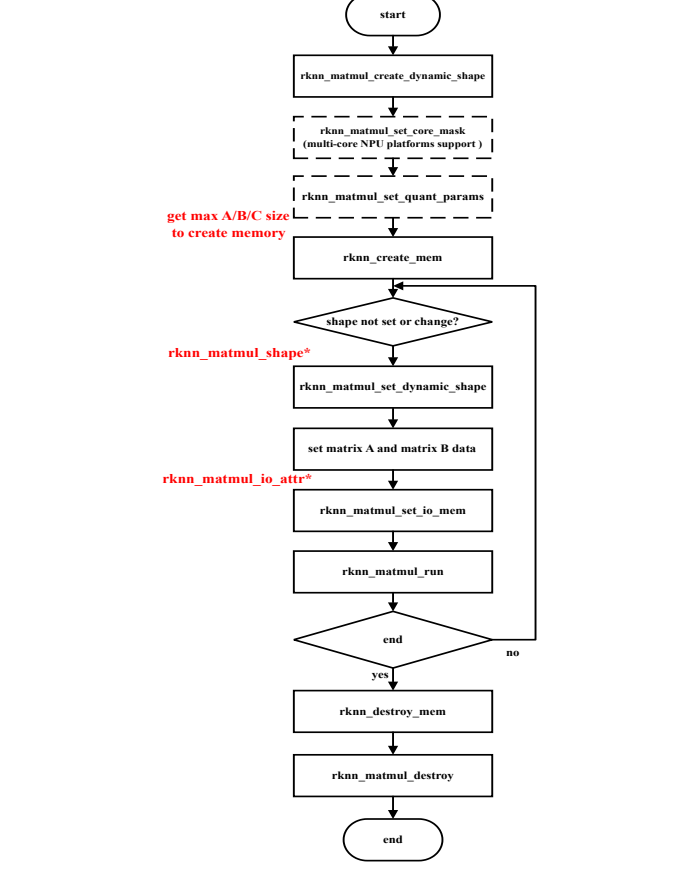
Рисунок 3-7. Вызовы Matmul API с динамической формой входа
Процесс для динамической формы входа показан выше. Он отличается от основного процесса Matmul API следующим:
1. Создайте контекст: задайте число и значения форм, а также rknn_matmul_info с типами и расположением данных входных и выходных матриц. M, K и N в rknn_matmul_info для динамической формы задавать не нужно. Вызовите rknn_matmul_create_dynamic_shape для инициализации контекста. После нее получите
массив структур rknn_matmul_io_attr со сведениями о входных и выходных тензорах для всех конфигураций формы.
2. Создайте входную и выходную память: определите максимальный размер тензора из массива rknn_matmul_io_attr и вызовите rknn_create_mem с максимальными размерами входной и выходной матриц.
3. Задайте текущую форму входа через rknn_matmul_set_dynamic_shape, передав указатель rknn_matmul_shape.
4. Настройте память через rknn_matmul_set_io_mem: заполненная входная матрица и выходная память записываются в контекст. rknn_tensor_mem* указывает на ранее созданную память максимального размера, а rknn_matmul_tensor_attr* содержит атрибуты матриц для текущей формы.
3.5.4 Высокопроизводительное расположение данных
NPU имеет специализированную аппаратную архитектуру, поэтому чтение исходных форм MxK и KxN и запись C в форме MxN не наиболее эффективны. Специальное расположение повышает производительность. AC_layout определяет использование высокопроизводительного layout матрицами A и C, B_layout — матрицей B.
Пусть исходные формы A, B и C равны MxK, KxN и MxN. Требуемое расположение:
1. При AC_layout=RKNN_MM_LAYOUT_NORM и B_layout=RKNN_MM_LAYOUT_NORM формы A, B и C равны [M,K], [K,N] и [M,N].
2. При AC_layout=RKNN_MM_LAYOUT_NATIVE и B_layout=RKNN_MM_LAYOUT_NATIVE расположение A, B и C для разных чипов и типов данных приведено ниже. Результаты деления в таблице округляются вверх, избыточная часть заполняется 0.
3. При B_layout=RKNN_MM_LAYOUT_NORM форма B — [K,N], а при B_layout=RKNN_MM_LAYOUT_TP_NORM — [N,K]. Второй вариант эффективнее при выполнении.
Таблица 3-5. Высокопроизводительные формы A, B и C на разных чипах
| Форма | RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 |
|---|---|---|---|---|
| A(int4) | не поддерживается | не поддерживается | [K/32,M,32] | [K/32,M,32] |
| B(int4) | не поддерживается | не поддерживается | [N/64,K/32,64,32]* | [N/64,K/32,64,32] |
| C(int16) | не поддерживается | не поддерживается | [N/8,M,8] | [N/8,M,8] |
| A(int8) | [K/16,M,16] | [K/8, M, 8] | [K/16,M,16] | [K/16,M,16] |
| B(int8) | [N/16,K/32,16,32] | [N/16,K/32,16,32] | [N/32,K/32,32,32]* | [N/32,K/32,32,32] |
| C(int32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
| A(float16) | [K/8,M,8] | [K/4,M,4] | [K/8,M,8] | [K/8,M,8] |
| B(float16) | [N/8,K/32,8,32] | [N/8,K/16,8,16] | [N/16,K/32,16,32] | [N/16,K/32,16,32] |
| C(float32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
Примечание
Таблица предполагает одинаковые типы A и B. RK3576/RV1126B поддерживает входы разных типов. В таком случае высокопроизводительное расположение B совпадает с расположением B для одинаковых типов, соответствующим типу C. Например, если A имеет тип int4, B — float16, C — float32, высокопроизводительное расположение B равно [N/16,K/32,16,32]. Интерфейс rknn_B_normal_layout_to_native_layout преобразует исходную форму B в высокопроизводительное расположение.
На примере RK3566/RK3568 и int8 соответствие элементов A при преобразовании [M,K] в [K/8,M,8] показано ниже:
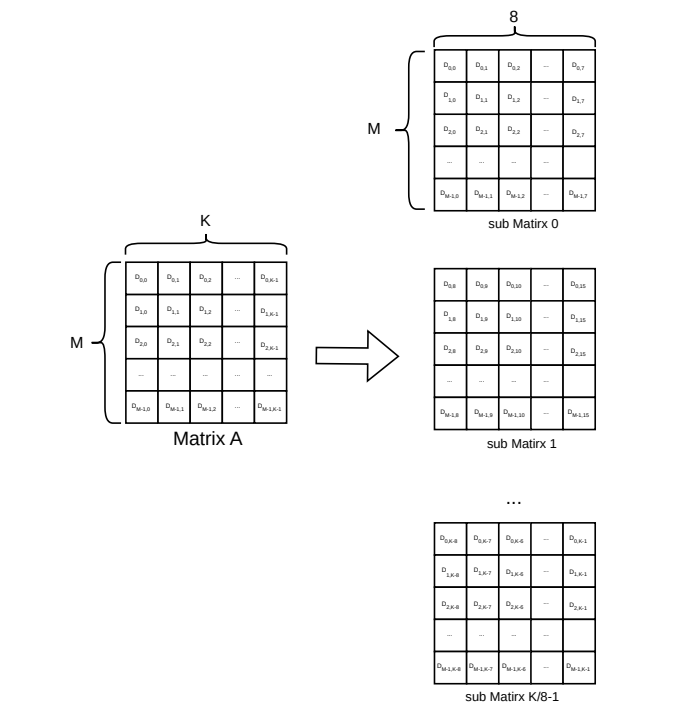
Рисунок 3-8. Соответствие элементов int8-матрицы A при преобразовании [M,K] в [K/8,M,8]
Элементу (i, j) матрицы A соответствует Di, j. Слева показана матрица shape=[M,K]; справа сверху вниз расположены K/8 подматриц, каждая shape=[M,8].
Пример преобразования A или C из исходной формы в высокопроизводительную:
template <typename Ti, typename To>
void norm_layout_to_perf_layout(Ti *src, To *dst, int32_t M, int32_t K, int32_t subK)
{
  int outter_size = (int)std::ceil(K * 1.0f / subK);
  for (int i = 0; i < outter_size; i++)
  {
    for (int m = 0; m < M; m++)
    {
      for (int j = 0; j < subK; j++)
      {
        int ki = i * subK + j;
        if (ki >= K)
        {
          dst[i * M * subK + m * subK + j] = 0;
        }
        else
        {
          dst[i * M * subK + m * subK + j] = src[m * K + ki];
        }
      }
    }
  }
}
Для RK3566/RK3568 соответствие элементов int8-матрицы B при преобразовании [K,N] в [N/16,K/32,16,32] показано ниже:
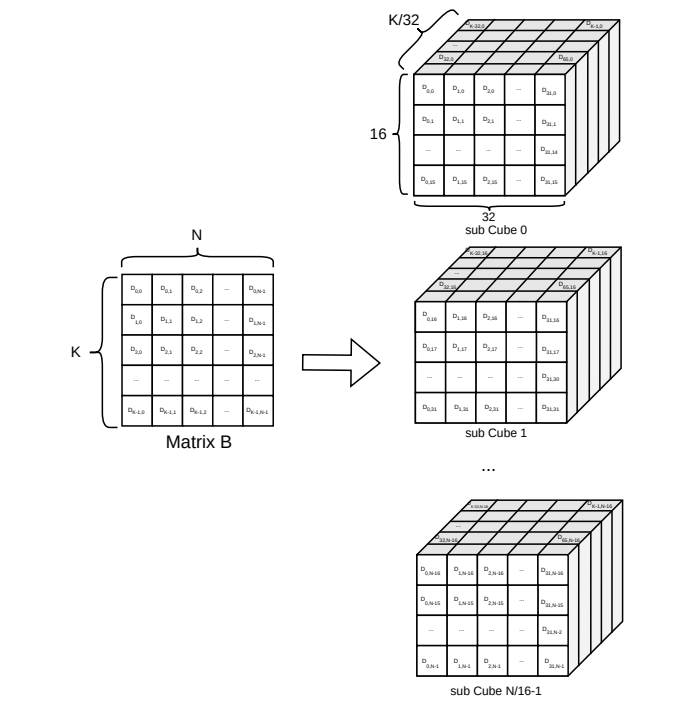
Рисунок 3-9. Соответствие элементов int8-матрицы B при преобразовании [K,N] в [N/16,K/32,16,32]
Элементу (i, j) матрицы B соответствует Di, j. Слева матрица shape=[K,N]; каждый куб справа имеет shape=[K/32,16,32]. Сверху вниз всего N/16 кубов.
Пример преобразования B из исходной формы в высокопроизводительную:
template <typename Ti, typename To>
void norm_layout_to_native_layout(Ti *src, To *dst, int32_t K, int32_t N, int32_t subN, int32_t subK)
{
  int N_remain = (int)std::ceil(N * 1.0f / subN);
  int K_remain = (int)std::ceil(K * 1.0f / subK);
  for (int i = 0; i < N_remain; i++)
  {
    for (int j = 0; j < K_remain; j++)
    {
      for (int n = 0; n < subN; n++)
      {
        int ni = i * subN + n;
        for (int k = 0; k < subK; k++)
        {
          int ki = j * subK + k;
          if (ki < K && ni < N)
          {
            dst[((i * K_remain + j) * subN + n) * subK + k] = src[ki * N + ni];
          }
          else
          {
            dst[((i * K_remain + j) * subN + n) * subK + k] = 0;
          }
        }
      }
    }
  }
}
Примечание
Полный пример Matmul API: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_matmul_api_demo
3.5.4.1 Ограничения спецификации матриц
Matmul API реализован на аппаратной архитектуре NPU и подчиняется ее ограничениям. Ограничения параметров:
AC_layout и B_layout задаются независимо. Оригинал утверждает поддержку RKNN_MM_LAYOUT_NORM или RKNN_MM_LAYOUT_TP_NORM для обоих параметров на всех платформах, а затем указывает, что RKNN_MM_LAYOUT_TP_NORM поддерживается везде, кроме RK3566/RK3568. Это противоречие оригинала сохранено и требует проверки.
MATMUL поддерживает разные разрядности входа и выхода. Поддерживаемые каждой платформой типы матриц сведены в таблицу:
Таблица 3-6. Типы данных A, B и C, поддерживаемые Matmul
| Номер | RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 |
|---|---|---|---|---|
| 1 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 |
| 2 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 |
| 3 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_INT8_MM_INT8_TO_INT32 | ||
| 4 | RKNN_FLOAT16_MM_INT8_TO_FLOAT32 | RKNN_INT8_MM_INT8_TO_FLOAT32 | ||
| 5 | RKNN_FLOAT16_MM_INT4_TO_FLOAT16 | RKNN_INT8_MM_INT8_TO_INT8 | ||
| 6 | RKNN_FLOAT16_MM_INT4_TO_FLOAT32 | RKNN_INT4_MM_INT4_TO_INT16 | ||
| 7 | RKNN_INT8_MM_INT4_TO_INT32 |
Формат float16 соответствует IEEE-754. Подробнее см. IEEE-754 half.
Ограничения размеров K и N:
Таблица 3-7. Ограничения K и N для каждой платформы
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| Ограничение размера K (int4) |
не поддерживается | не поддерживается | * | выравнивание по 32 |
| Ограничение размера K (int8) |
K <= 10240 и K mod 32 = 0 |
K <= 10240 и K mod 32 = 0 |
выравнивание по 32 | выравнивание по 32 |
| Ограничение размера K (float16) |
K <= 10240 и K mod 32 = 0 |
K <= 10240 и K mod 32 = 0 |
выравнивание по 32 | выравнивание по 32 |
| Ограничение размера N (int4) |
не поддерживается | не поддерживается | * | N <= 8192 и N mod 64 = 0 |
| Ограничение размера N (int8) |
N <= 4096 и N mod 16 = 0 |
N <= 4096 и N mod 16 = 0 |
N <= 4096 и N mod 32 = 0 |
N <= 4096 и N mod 32 = 0 |
| Ограничение размера N (float16) |
N <= 4096 и N mod 16 = 0 |
N <= 4096 и N mod 16 = 0 |
N <= 4096 и N mod 32 = 0 |
N <= 4096 и N mod 32 = 0 |
Примечание
* означает, что ограничения размера и выравнивания совпадают с ограничениями B, соответствующими типу A на той же платформе. Например, для B в RKNN_FLOAT16_MM_INT4_TO_FLOAT32 ограничения совпадают с RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32.
Для RK3588:
При K > 8192 данные B делятся на T сегментов.
int T = std::ceil(K / 8192);
Например: normal layout -> native layout, K = 20488, N = 4096, T = 3; данные делятся на 3 сегмента.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
Форма K,N при преобразовании:
                     (8196, 4096) (4096 / subN, 8196 / subK, subN, subK)
 (K, N) = (20488, 4096)->(8196, 4096)->(4096 / subN, 8196 / subK, subN, subK)
         normal layout (4096, 4096) (4096 / subN, 4096 / subK, subN, subK)
                   T normal layout T native layout
Для прямого преобразования данных рекомендуется rknn_B_normal_layout_to_native_layout.
Для RK3576/RV1126B:
При K > 4096 данные B делятся на T сегментов.
int T = std::ceil(K / 4096);
Например: normal layout -> native layout, K = 10240, N = 2048, T = 3; данные делятся на 3 сегмента.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
Форма K,N при преобразовании:
                        (4096, 2048) (2048 / subN, 4096 / subK, subN, subK)
(K, N) = (10240, 2048) -> (4096, 2048) -> (2048 / subN, 4096 / subK, subN, subK)
        normal layout (2048, 2048) (2048 / subN, 2048 / subK, subN, subK)
                     T normal layout T native layout
Для прямого преобразования данных рекомендуется rknn_B_normal_layout_to_native_layout.
4 Примеры
RKNN предоставляет примеры разных моделей, включая MobileNet и YOLOv5. Исходный код находится в https://github.com/airockchip/rknn_model_zoo/tree/main/examples.
Ниже используются RK3588 Linux, Ubuntu22.04 и Python3.8 в среде Conda. Установка среды разработки описана в главе 2. Развертывание на других платформах см. в Rockchip_RKNPU_Quick_Start_RKNN_SDK.
4.1 Пример развертывания MobileNet
На примере MobileNet показан быстрый старт преобразования, запуска с подключенной платой, оценки и развертывания модели на плате.
4.1.1 Преобразование модели
1. Перейдите в rknn_model_zoo/examples/mobilenet/python:
cd rknn_model_zoo/examples/mobilenet/python
2. Преобразуйте модель и выполните инференс изображения:
python mobilenet.py --model ../model/mobilenetv2-12.onnx --target rk3588
Команда выполняет инференс в симуляторе на компьютере. По умолчанию преобразованная модель сохраняется в rknn_model_zoo/examples/mobilenet/model/mobilenet_v2.rknn.
4.1.2 Запуск модели на устройстве
1. Перейдите в rknn_model_zoo/examples/mobilenet/python:
cd rknn_model_zoo/examples/mobilenet/python
2. Запустите модель на устройстве:
python mobilenet.py --target rk3588 --npu_device_test
После этой команды инференс модели выполняется на устройстве.
Вывод:
-----TOP 5-----
[494] score=0.99 class="n03017168 chime, bell, gong"
[469] score=0.00 class="n02939185 caldron, cauldron"
[653] score=0.00 class="n03764736 milk can"
[747] score=0.00 class="n04023962 punching bag, punch bag, punching ball, punchball"
[505] score=0.00 class="n03063689 coffeepot"
4.1.3 Оценка модели
RKNN предоставляет оценку точности в симуляторе и на устройстве, времени выполнения и памяти, помогая оптимизировать и развертывать модели RKNN.
4.1.3.1 Оценка точности
1. Перейдите в rknn_model_zoo/examples/mobilenet/python:
cd rknn_model_zoo/examples/mobilenet/python
2. Выполните анализ точности модели:
python mobilenet.py --target rk3588 --accuracy_analysis --npu_device_test
Результаты анализа точности модели:
# simulator_error: calculate the output error of each layer of the simulator (compared to the 'golden' value).
# entire: output error of each layer between 'golden' and 'simulator', these errors will accumulate layer by layer.
# single: single-layer output error between 'golden' and 'simulator', can better reflect the single-layer accuracy of the simulator.
layer_name simulator_error
                  entire single
                cos euc cos euc
---------------------------------------------------------------
...
[Conv] 464 0.99202 | 4.1079 0.99998 | 0.1981
[Conv] output_conv 0.99308 | 13.235 0.99992 | 1.4133
[Reshape] output_int8 0.99308 | 13.235 0.99993 | 1.3043
[exDataConvert] output 0.99308 | 13.235 0.99993 | 1.3043

# runtime_error: calculate the output error of each layer of the runtime.
# entire: output error of each layer between 'golden' and 'runtime', these errors will accumulate layer by layer.
# single_sim: single-layer output error between 'simulator' and 'runtime', can better reflect the single-layer accuracy of runtime.
layer_name runtime_error
                  entire single_sim
                cos euc cos euc
---------------------------------------------------------------
...
[Conv] 464 0.99210 | 4.2718 1.00000 | 0.0
[Conv] output_conv 0.99203 | 14.847 1.00000 | 0.2007
[Reshape] output_int8
[exDataConvert] output 0.99203 | 14.847 1.00000 | 0.0
4.1.3.2 Оценка времени выполнения
1. Перейдите в rknn_model_zoo/examples/mobilenet/python:
cd rknn_model_zoo/examples/mobilenet/python
2. Оцените время выполнения модели:
python mobilenet.py --target rk3588 --eval_perf
Результаты оценки времени выполнения:
---------------------------------------------------------------
    Network Layer Information Table
---------------------------------------------------------------
ID OpType DataType Target Time(us) ...
---------------------------------------------------------------
1 InputOperator UINT8 CPU 17
2 ConvClip UINT8 NPU 331
3 ConvClip INT8 NPU 429
4 Conv INT8 NPU 292
....
55 Conv INT8 NPU 374
56 Reshape INT8 CPU 61
57 OutputOperator INT8 CPU 11
---------------------------------------------------------------
Total Operator Elapsed Per Frame Time(us): 12631
Total Memory Read/Write Per Frame Size(KB): 10563
---------------------------------------------------------------

---------------------------------------------------------------
    Operator Time Consuming Ranking Table
---------------------------------------------------------------
OpType CallNumber ... NPUTime(us) TotalTime(us) TimeRatio(%)
---------------------------------------------------------------
ConvClip 35 8436 8436 66.79%
Conv 9 2093 2093 16.57%
ConvAdd 10 2013 2013 15.94%
Reshape 1 0 61 0.48%
InputOperator 1 0 17 0.13%
OutputOperator 1 0 11 0.09%
---------------------------------------------------------------
4.1.3.3 Оценка памяти
1. Перейдите в rknn_model_zoo/examples/mobilenet/python:
cd rknn_model_zoo/examples/mobilenet/python
2. Оцените использование памяти моделью:
python mobilenet.py --target rk3588 --eval_memory
Результаты оценки памяти модели:
---------------------------------------------------------------
    Network Layer Information Table
---------------------------------------------------------------
ID OpType DataType Target Time(us) ...
---------------------------------------------------------------
1 InputOperator UINT8 CPU 17
2 ConvClip UINT8 NPU 331
3 ConvClip INT8 NPU 429
4 Conv INT8 NPU 292
....
55 Conv INT8 NPU 374
56 Reshape INT8 CPU 61
57 OutputOperator INT8 CPU 11
---------------------------------------------------------------
Total Operator Elapsed Per Frame Time(us): 12631
Total Memory Read/Write Per Frame Size(KB): 10563
---------------------------------------------------------------

---------------------------------------------------------------
    Operator Time Consuming Ranking Table
---------------------------------------------------------------
OpType CallNumber ... NPUTime(us) TotalTime(us) TimeRatio(%)
---------------------------------------------------------------
ConvClip 35 8436 8436 66.79%
Conv 9 2093 2093 16.57%
ConvAdd 10 2013 2013 15.94%
Reshape 1 0 61 0.48%
InputOperator 1 0 17 0.13%
OutputOperator 1 0 11 0.09%
---------------------------------------------------------------
4.1.4 Развертывание модели на устройстве
1. Задайте путь к кросс-компилятору gcc в скрипте build-linsx.sh проекта rknn_model_zoo; имя скрипта сохранено как в оригинале.
GCC_COMPILER=~/opts/gcc-linaro-6.3.1-2017.05-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu
Загрузка и установка кросс-компилятора gcc описаны в Rockchip_RKNPU_Quick_Start_RKNN_SDK.
2. Компиляция
cd rknn_model_zoo
./build-linux.sh -t rk3588 -a aarch64 -d mobilenet
3. Передайте исполняемый файл на плату:
adb push install/rk3588_linux_aarch64/rknn_mobilenet_demo /userdata/
4. Запустите модель на устройстве:
adb shell

cd /userdata/rknn_mobilenet_demo
export LD_LIBRARY_PATH=./lib
./rknn_mobilenet_demo model/mobilenet_v2.rknn model/bell.jpg
Вывод:
-----TOP 5-----
[494] score=0.993227 class=n03017168 chime, bell, gong
[469] score=0.002560 class=n02939185 caldron, cauldron
[747] score=0.000466 class=n04023962 punching bag, punch bag, punching ball, punchball
[792] score=0.000466 class=n04208210 shovel
[618] score=0.000405 class=n03633091 ladle
4.2 Пример развертывания YOLOv5
4.2.1 Преобразование модели
1. Загрузите модель.
cd rknn_model_zoo/examples/yolov5/model
./download_model.sh
2. Преобразуйте модель:
cd rknn_model_zoo/examples/yolov5/python
python convert.py ../model/yolov5s_relu.onnx rk3588 i8 ../model/yolov5.rknn
Преобразованная модель сохраняется в rknn_model_zoo/examples/yolov5/model/yolov5.rknn.
4.2.2 Запуск модели на устройстве
1. Перейдите в rknn_model_zoo/examples/yolov5/python:
cd rknn_model_zoo/examples/yolov5/python
2. Запустите модель на устройстве:
python yolov5.py --model_path ../model/yolov5.rknn --target rk3588 --img_show
По умолчанию входное изображение — model/bus.jpg. Результат показан ниже:
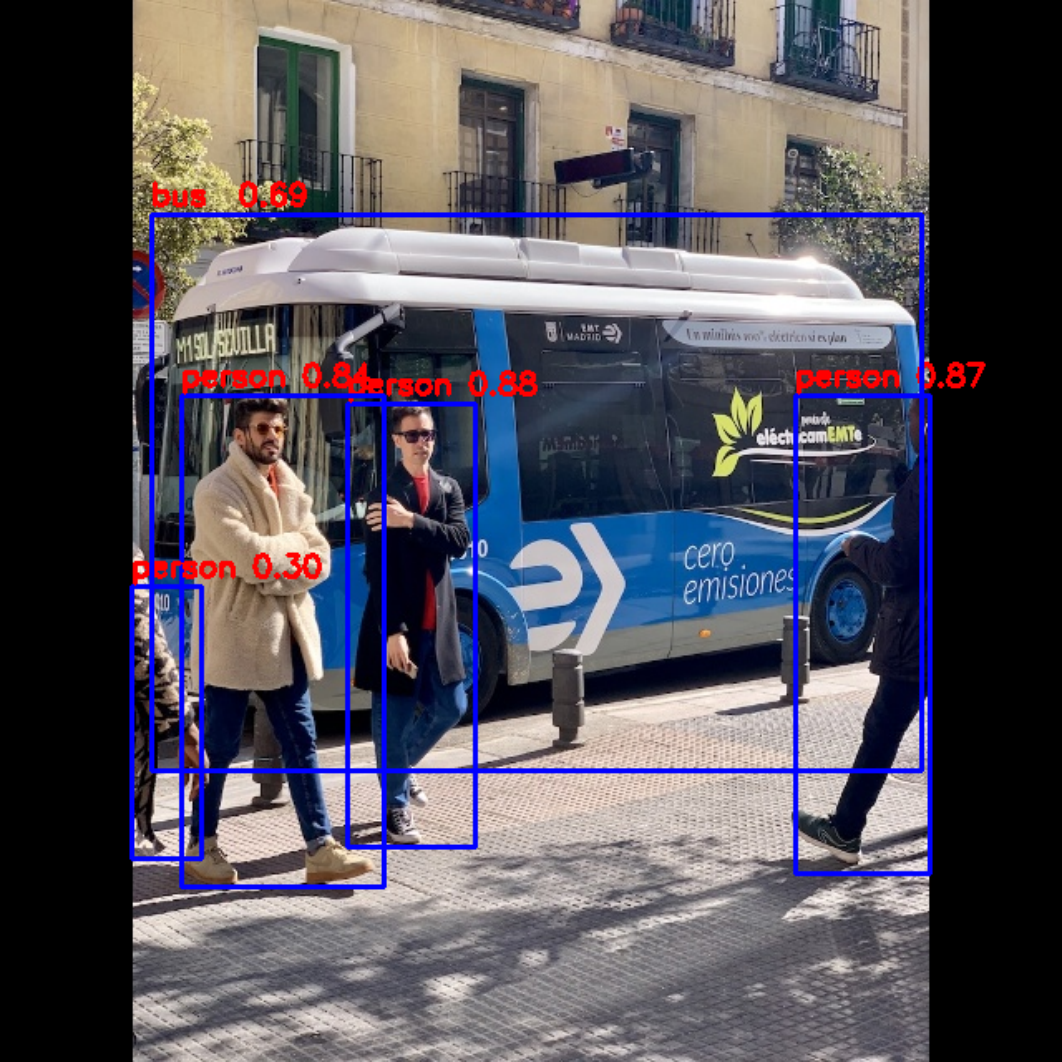
Рисунок 4-1. Результат RKNN в демонстрационном примере Python
4.2.3 Развертывание модели на устройстве
1. Задайте путь к кросс-компилятору gcc в скрипте build-linsx.sh проекта rknn_model_zoo; имя скрипта сохранено как в оригинале.
GCC_COMPILER=~/opts/gcc-linaro-6.3.1-2017.05-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu
Загрузка и установка кросс-компилятора gcc описаны в Rockchip_RKNPU_Quick_Start_RKNN_SDK.
2. Компиляция:
cd rknn_model_zoo
./build-linux.sh -t rk3588 -a aarch64 -d yolov5
3. Передайте исполняемый файл на устройство:
adb push install/rk3588_linux_aarch64/rknn_yolov5_demo /userdata/
4. Запустите модель на устройстве:
adb shell
cd userdata/rknn_yolov5_demo
export LD_LIBRARY_PATH=./lib
./rknn_yolov5_demo model/yolov5.rknn model/bus.jpg
5. Скопируйте результат с платы для локального просмотра. Выполните в терминале локального компьютера:
adb pull /userdata/rknn_yolov5_demo/out.png .
Выходное изображение:
Рисунок 4-2. Результат RKNN в демонстрационном примере C
5 Расширенные инструкции RKNN
5.1 Форматы данных
RKNN использует четыре формата данных: NHWC, NCHW, NC1HWC2 и UNDEFINE. NHWC и NCHW распространены в глубоком обучении и дополнительно не рассматриваются. Этот раздел посвящен хранению и преобразованию NC1HWC2, предназначенного для аппаратуры RKNPU.
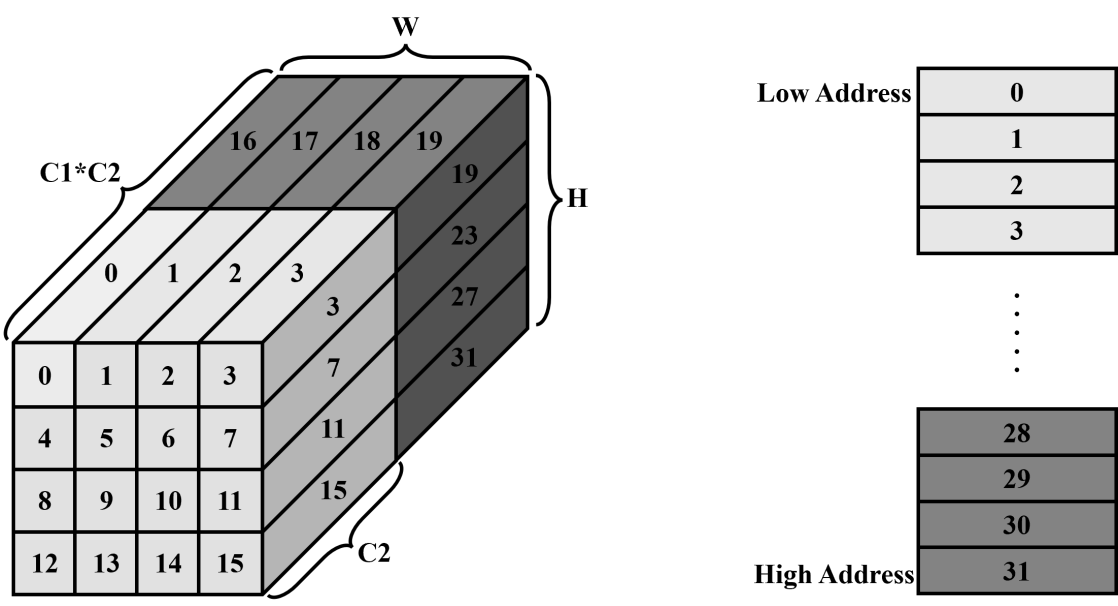
Рисунок 5-1. Формат и хранение RKNPU NC1HWC2
На рисунке 5-1 число 0 обозначает хранение блока C2, размер которого определяется платформой. Ограничения C2 приведены в таблице 5-1; C1 равен C/C2 с округлением вверх. Порядок хранения NC1HWC2 соответствует росту чисел на рисунке: сначала 0–15, затем 16–31. Например, на RK3568 признакам int8 формы (1, 13, 4, 4) соответствует NC1HWC2 (1, 2, 4, 4, 8): C2=8, C1=2. В блоках C2 с номерами 16–31 действительны только первые пять элементов каждого блока; оставшиеся три — недействительное заполнение для выравнивания.
Таблица 5-1. C2 на аппаратных платформах RKNPU
| RV1103/RV1106 | RV1103B/RV1106B | RK2118 | RK3562 | RK3566/RK3568 | RK3576/RK3588/RV1126B | |
|---|---|---|---|---|---|---|
| int8 | 16 | 8 | / | 16 | 8 | 16 |
| float16 | 8 | / | 4 | 8 | 4 | 8 |
Далее рассмотрено преобразование NC1HWC2 в NCHW и NHWC в памяти. На RK3568 согласно требованиям выравнивания признакам int8 (1, 13, 2, 2) соответствует NC1HWC2 (1, 2, 2, 2, 8). Хранение показано ниже; красным выделено недействительное заполнение.
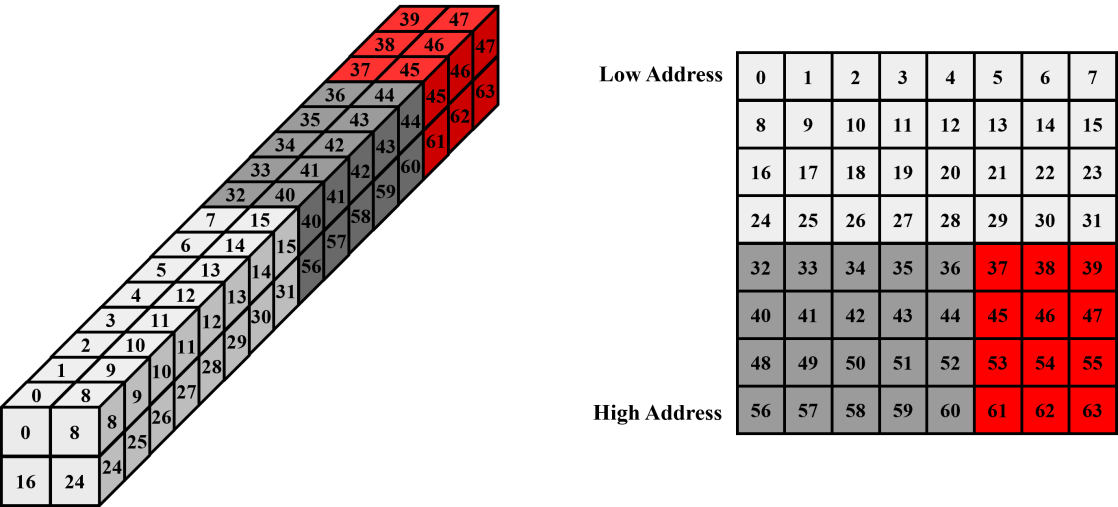
Рисунок 5-2. Развернутое расположение NC1HWC2
После удаления недействительных данных и преобразования в NCHW, то есть (1, 13, 2, 2), расположение в памяти следующее:
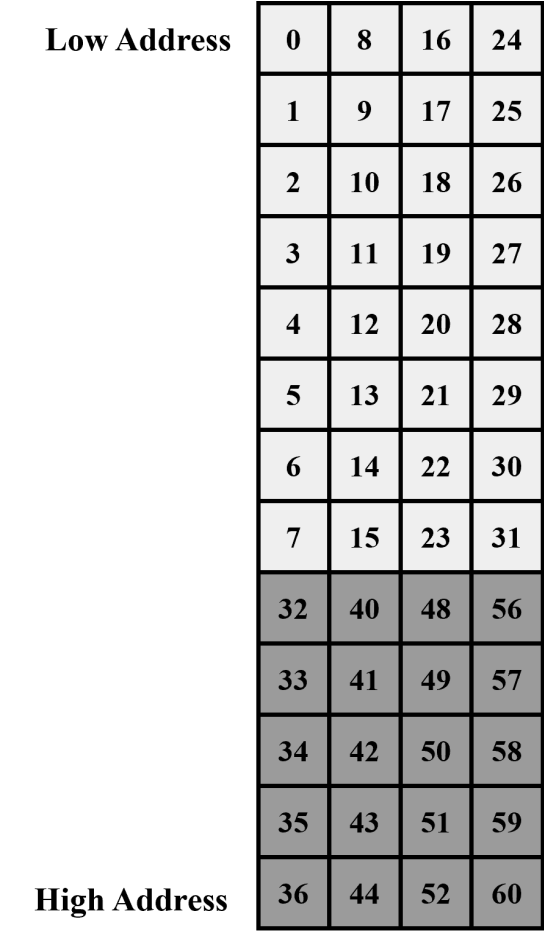
Рисунок 5-3. Расположение NCHW
После удаления недействительных данных и преобразования в NHWC, то есть (1, 2, 2, 13), расположение в памяти следующее:
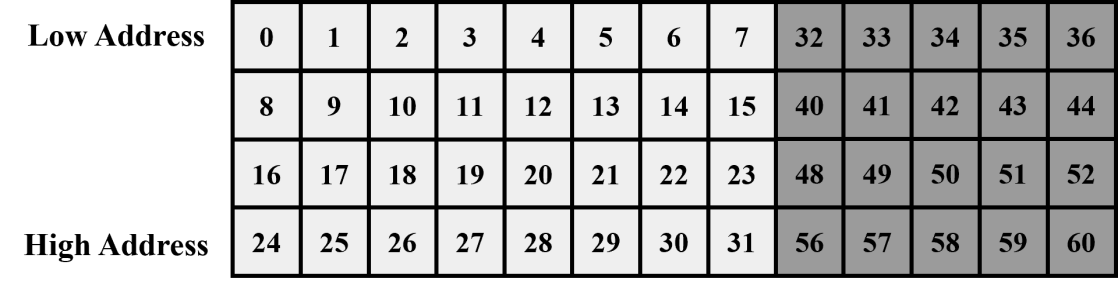
Рисунок 5-4. Расположение NHWC
Пример кода преобразования:
1. NC1HWC2 в NCHW: преобразование данных int8 NC1HWC2 в int8 NCHW.
/*
 *src: represents the address of NC1HWC2 tensor
 *dst: represents the address of the NCHW tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NCHW
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NCHW(const int8_t* src, int8_t* dst, int* dims, int channel, int h, int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int c = 0; c < channel; ++c) {
    int plane = c / C2;
    const int8_t* src_c = plane * hw_src * C2 + src;
    int offset = c % C2;
    for (int cur_h = 0; cur_h < h; ++cur_h)
      for (int cur_w = 0; cur_w < w; ++cur_w) {
      int cur_hw = cur_h * w + cur_w;
      dst[c * hw_dst + cur_h * w + cur_w] = src_c[C2 * cur_hw + offset];
      }
    }
  }

  return 0;
}
2. NC1HWC2 в NHWC: преобразование данных int8 NC1HWC2 в int8 NHWC.
/*
 *src: represents the address of NC1HWC2 tensor
 *dst: represents the address of the NCHW tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NCHW
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NHWC(const int8_t* src, int8_t* dst, int* dims, int channel, int h, int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int cur_h = 0; cur_h < h; ++cur_h) {
      for (int cur_w = 0; cur_w < w; ++cur_w) {
        int cur_hw = cur_h * dims[3] + cur_w;
        for (int c = 0; c < channel; ++c) {
          int plane = c / C2;
          const auto* src_c = plane * hw_src * C2 + src;
          int offset = c % C2;
          dst[cur_h * w * channel + cur_w * channel + c] = src_c[C2 * cur_hw + offset];
        }
      }
    }
  }
  return 0;
}
5.2 Интерфейс нулевого копирования RKNN Runtime
5.2.1 Введение в нулевое копирование
На RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B доступны обычный API и API нулевого копирования; RV1103/RV1103B/RV1106/RV1106B поддерживают только последний. Примеры нулевого копирования находятся в examples/rknn_zero_copy проекта rknpu2. Подробности и исходный код: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2.
При инференсе RKNN исходные данные проходят обработку входа, выполнение модели на NPU и обработку выхода. В зависимости от входного формата и способа квантования используются обычный API или нулевое копирование, как показано на
рисунках 5-5 и 5-6. При каждом обновлении кадра обычный API копирует внешние данные во входную память NPU во время выполнения. Нулевое копирование напрямую использует заранее выделенную память NPU или другой подсистемы, например DRM, снижая расходы на копирование и пропускную способность и повышая производительность. Если вход имеет только виртуальный адрес, доступен лишь обычный API. При физическом адресе или fd доступны оба API. Обычный API и API нулевого копирования нельзя вызывать совместно.
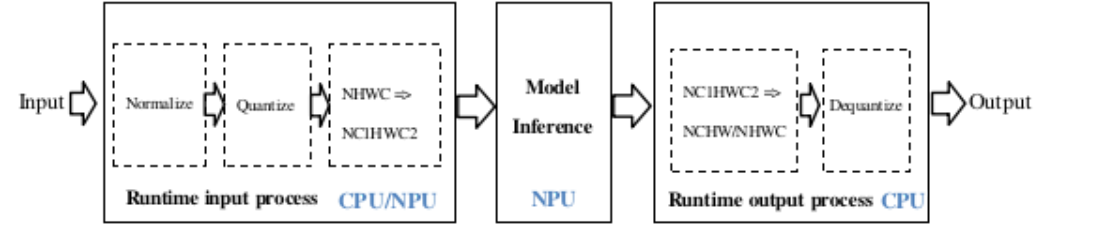
Рисунок 5-5. Обработка данных обычного API
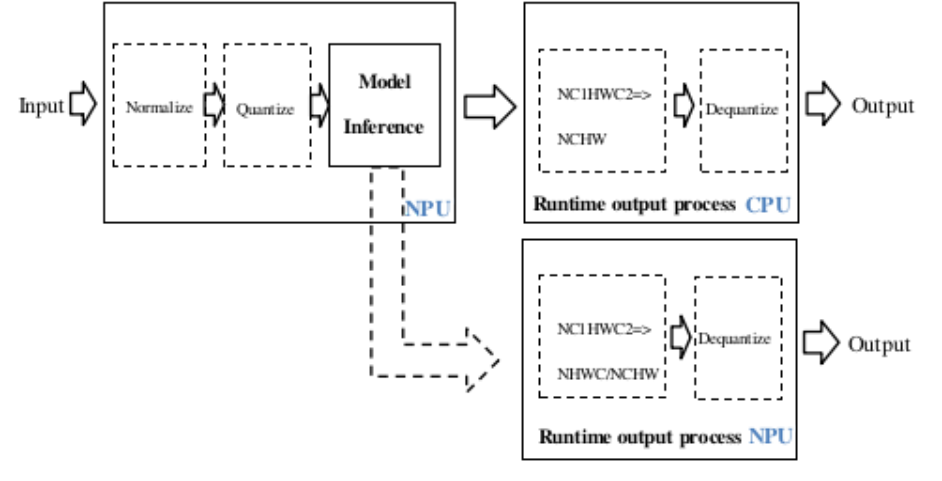
Рисунок 5-6. Обработка данных API нулевого копирования
Обычный API
На рисунке 5-5 нормализация, квантование, преобразование формата и деквантование выполняются на CPU, а инференс — на NPU. Если вход удовлетворяет выравниванию нулевого копирования, нормализация и квантование выполняются на NPU, но CPU все равно копирует вход в буфер модели.
API нулевого копирования
Процесс на рисунке 5-6 оптимизирует обычный API. Нормализация, квантование и инференс выполняются на NPU; преобразование формата выхода и деквантование — на CPU или NPU. Входной поток обрабатывается эффективнее обычного API.
Условия нулевого копирования приведены в таблице:
Таблица 5-2. Выравнивание входа для нулевого копирования
| Размерность входа | Требования к выравниванию входа | |
|---|---|---|
| RV1103B/RV1106B/RK3566/RK3568 | RV1103/RV1106/RV1126B/RK3562/RK3576/RK3588 | |
| 4 измерения; число каналов — 1, 3, 4 | Ширина выровнена по 8 байтам | Ширина выровнена по 16 байтам |
| Не 4 измерения | Общий размер выровнен по 8 байтам | Общий размер выровнен по 16 байтам |
5.2.2 Процесс нулевого копирования C API
API нулевого копирования использует rknn_tensor_memory. До инференса структуру нужно создать и настроить, а после — прочитать сведения о памяти. В зависимости от внешнего выделения памяти модели (вход/выход/веса/промежуточные результаты) и ее представления (fd, физический адрес и т. п.) существуют три типовых процесса на рисунках 5-7–5-9. Красным показаны специальные интерфейсы и структуры нулевого копирования, курсивом — структуры, передаваемые между вызовами.
1. Входная и выходная память выделяется Runtime
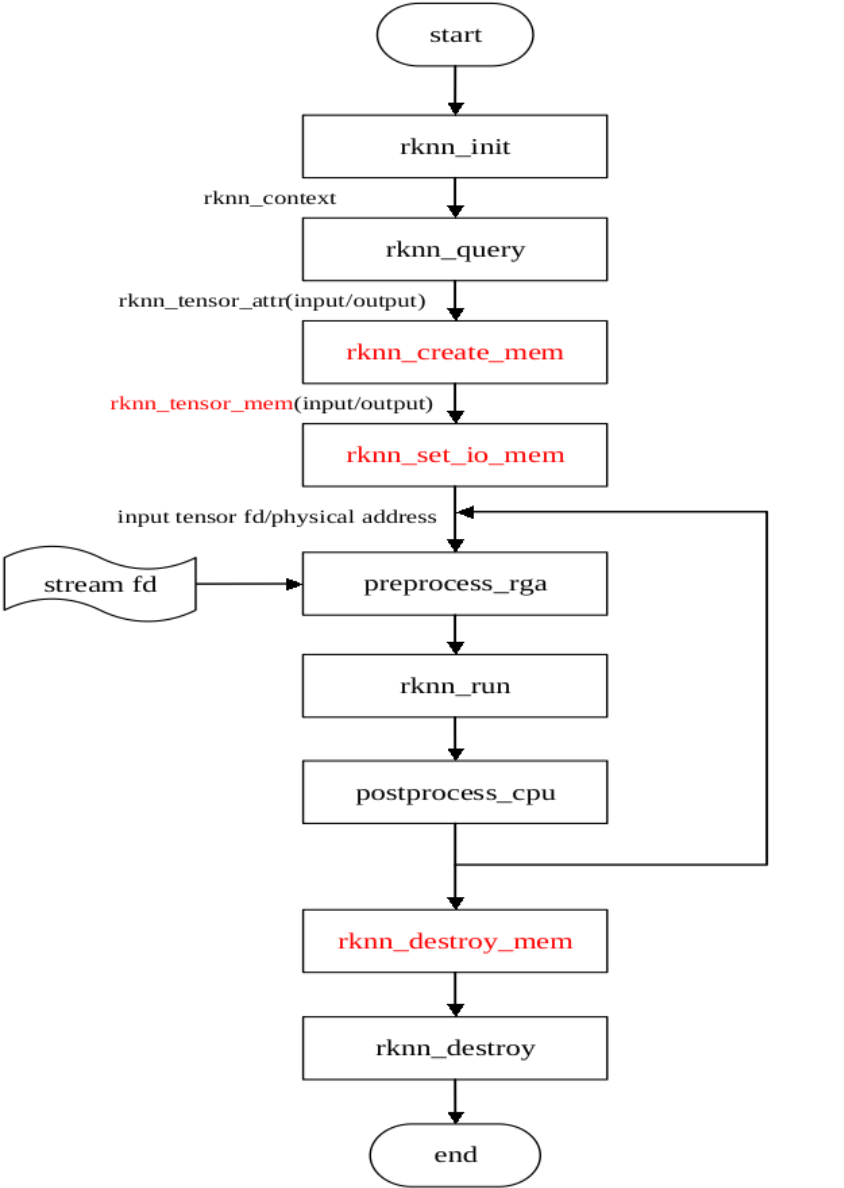
Рисунок 5-7. Нулевое копирование с внутренним выделением входа и выхода
На рисунке 5-7 Runtime создает rknn_tensor_memory через rknn_create_mem(), а rknn_set_io_mem() задает структуры входной и выходной памяти.
Структура, созданная rknn_create_mem(), содержит файловый дескриптор и физический адрес. RGA использует память, выделенную NPU. preprocess_rga() обозначает интерфейс RGA, stream_fd — его исходный входной буфер, postprocess_cpu() — последующую обработку на CPU.
2. Входная и выходная память выделяется извне
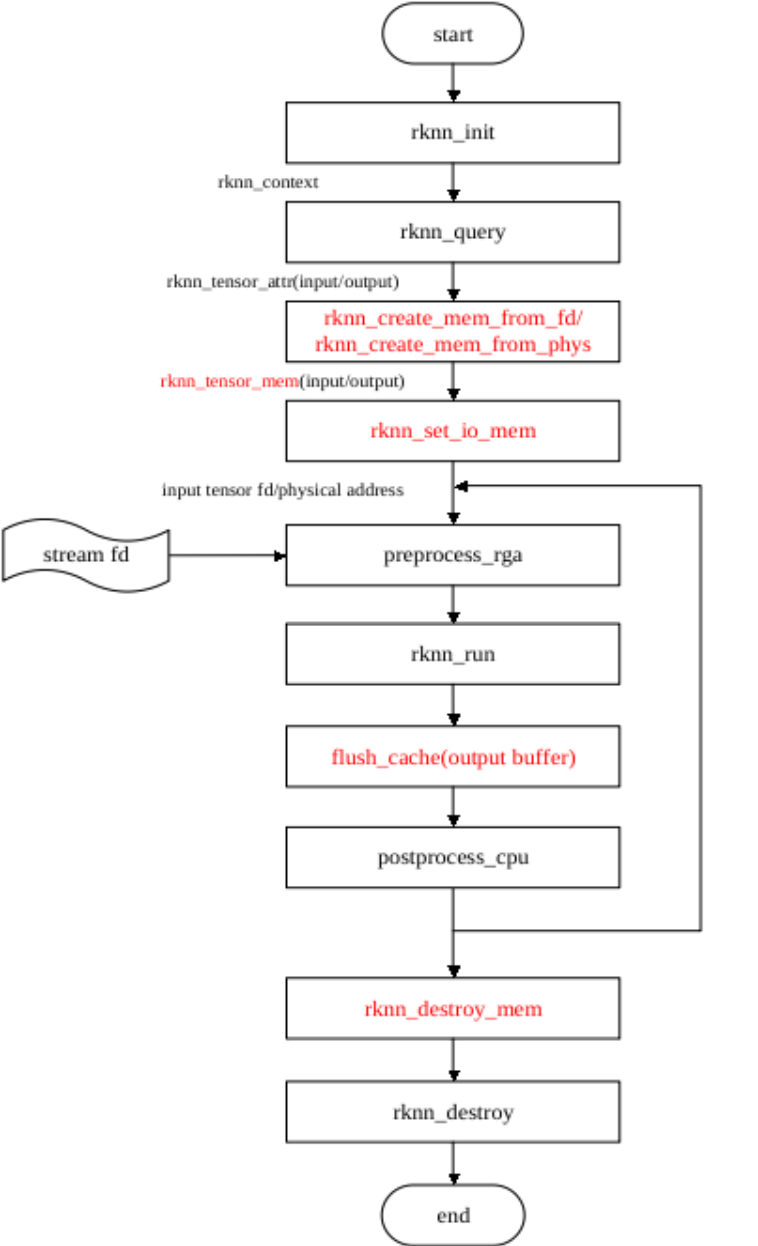
Рисунок 5-8. Нулевое копирование с внешним выделением входа и выхода
На рисунке 5-8 внешняя память представляется rknn_tensor_memory через rknn_create_mem_from_fd()/rknn_create_mem_from_phys(), затем rknn_set_io_mem() задает вход и выход. flush_cache означает, что пользователь должен вызвать соответствующий типу памяти интерфейс сброса выходного кэша.
3. Вход, выход, веса и внутренние тензоры выделяются извне
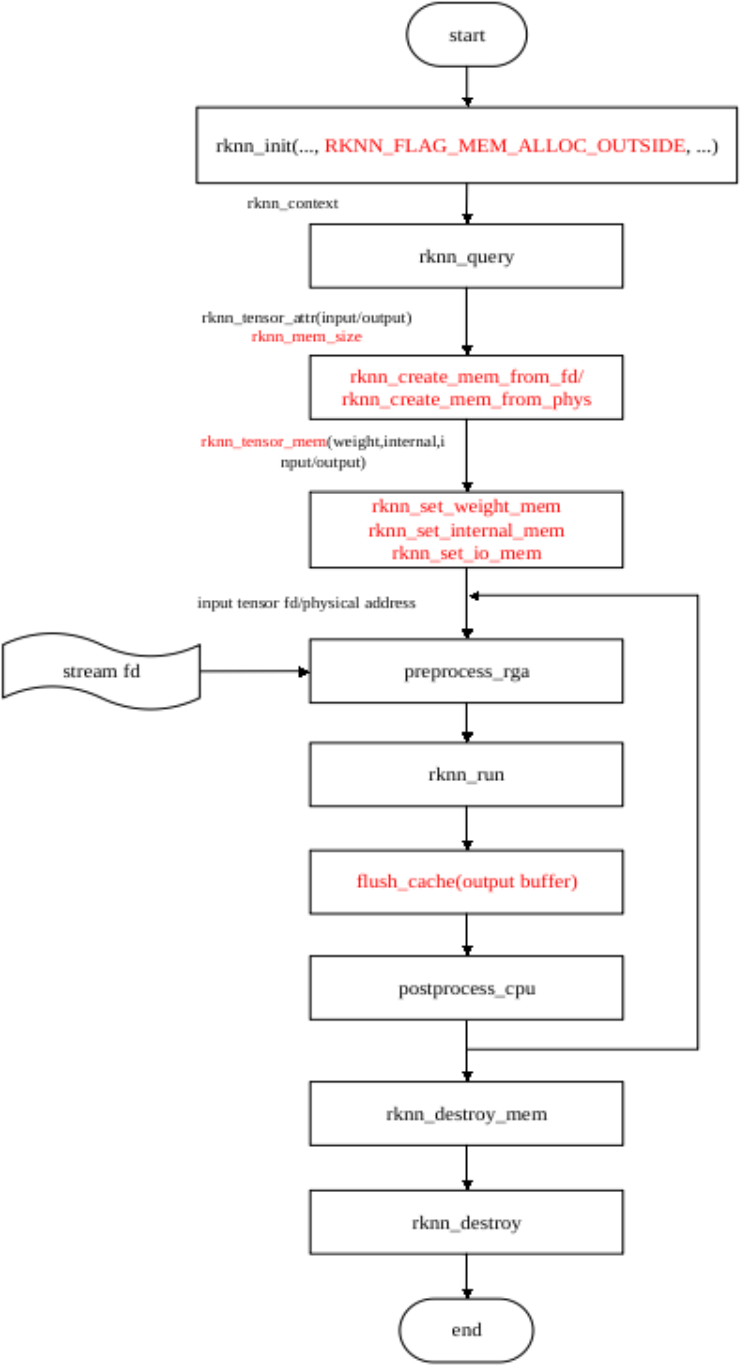
Рисунок 5-9. Нулевое копирование с внешней памятью входа, выхода, весов и внутренних тензоров
На рисунке 5-9 внешняя память входа, выхода, весов и промежуточных результатов представляется через rknn_create_mem_from_fd()/rknn_create_mem_from_phys() как rknn_tensor_memory. rknn_set_io_mem() задает вход и выход; rknn_set_weight_mem()/rknn_set_internal_mem() — веса и внутренние результаты.
5.2.3 Использование C API нулевого копирования
Ниже рассмотрен процесс нулевого копирования с внутренним выделением входа и выхода, названный в оригинале рисунком 5-6:
rknn_query()
Вход:
Запросите атрибуты через RKNN_QUERY_NATIVE_INPUT_ATTR, а не RKNN_QUERY_INPUT_ATTR. Предварительная обработка зависит от полученного формата/layout. Запрошенные таким образом layout и тип оптимальны для аппаратуры.
Варианты входа rknn_query():
1. При RKNN_TENSOR_NCHW вход обычно четырехмерный, типа bool или int64. Передаваемые в NPU данные также должны иметь NCHW.
2. При RKNN_TENSOR_NHWC вход обычно четырехмерный, типа float32/float16/int8/uint8, с 1, 3 или 4 каналами. Данные передаются в NHWC. При pass_through=1 ширину может потребоваться выровнять по stride в соответствии с запрошенным w_stride.
3. При RKNN_TENSOR_NC1HWC2 вход обычно четырехмерный, типа float16/int8, а число каналов не равно 1, 3 или 4. При pass_through=0 данные передаются в NHWC, и интерфейс преобразует их в NC1HWC2 на CPU. При pass_through=1 данные должны иметь NC1HWC2, и преобразование выполняет пользователь извне.
4. При RKNN_TENSOR_UNDEFINED вход обычно не четырехмерный. Данные передаются в NPU в формате входа модели ONNX. NPU не выполняет mean/std и преобразование layout.
Если требуемый вход отличается от полученной структуры rknn_tensor_attr, ее можно изменить. Поддерживаемые изменения типов приведены в таблице 5-3. Важно: если запрос вернул uint8, а нужен float32, увеличьте size в четыре раза и измените тип на RKNN_TENSOR_FLOAT32. Такой вариант не оптимален для аппаратуры: интерфейс внутренне вызывает CPU для преобразования типа.
Таблица 5-3. Изменяемые типы входных данных
| Тип входных данных, полученный через rknn_query | |||||||
|---|---|---|---|---|---|---|---|
| bool | int8 | float16 | int16 | int32 | int64 | ||
| Тип входных данных, изменённый пользователем | bool | Y | |||||
| int8 | Y | ||||||
| uint8 | Y | Y | |||||
| float32 | Y | Y | |||||
| float16 | Y | ||||||
| int16 | Y | ||||||
| int32 | Y | ||||||
| int64 | Y |
Выход:
Запросите атрибуты через RKNN_QUERY_NATIVE_OUTPUT_ATTR, а не RKNN_QUERY_OUTPUT_ATTR. Обработка зависит от полученного формата/layout. Запрошенные таким образом layout и тип оптимальны для аппаратуры.
Для четырехмерного выхода в NHWC используйте RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR. Он напрямую запрашивает native-выход NPU в NHWC.
Варианты выхода rknn_query():
1. При RKNN_TENSOR_NC1HWC2 выход обычно четырехмерный, а
тип данных — float16/int8. Если нужен NCHW, преобразуйте NC1HWC2 в NCHW извне.
2. При RKNN_TENSOR_UNDEFINED выход обычно не четырехмерный, а
тип данных — float16/int8. Внешнее преобразование layout не требуется.
3. При RKNN_TENSOR_NCHW выход обычно четырехмерный, с типом
float16/int8. Внешнее преобразование layout не требуется.
4. При RKNN_TENSOR_NHWC выход обычно четырехмерный, с типом
float16/int8. Обычно это результат запроса layout через RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR.
Если требуемый выход отличается от полученной структуры rknn_tensor_attr, ее можно изменить согласно таблицам 5-4 и 5-5. Важно: если выходной тип int8, а нужен float32, увеличьте size в четыре раза и измените тип на RKNN_TENSOR_FLOAT32. Такое изменение не оптимально для аппаратуры: интерфейс выполняет преобразование типа на CPU.
Таблица 5-4. Изменяемые типы выходных данных
| Тип выходных данных, полученный через rknn_query | |||||||
|---|---|---|---|---|---|---|---|
| bool | int8 | float16 | int16 | int32 | int64 | ||
| Тип выходных данных, изменённый пользователем | bool | Y | |||||
| int8 | Y | ||||||
| uint8 | |||||||
| float32 | Y | Y | |||||
| float16 | Y | ||||||
| int16 | Y | ||||||
| int32 | Y | ||||||
| int64 | Y |
Таблица 5-5. Расположение выхода
| Компоновка выхода, полученная через rknn_query | |||||
|---|---|---|---|---|---|
| NC1HWC2 | NCHW | NHWC | UNDEFINED | ||
| Компоновка выхода, заданная пользователем | NC1HWC2 | Y | |||
| NCHW | Y | Y | |||
| NHWC | Y | ||||
| UNDEFINED | Y |
Конфигурации выхода NPU с нулевым копированием для RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B приведены в таблице 5-6, для RV1103/RV1103B/RV1106/RV1106B — в таблице 5-7.
Таблица 5-6. Выход NPU с нулевым копированием на RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B
| Тип модели | Тип выходных данных | Размерность выхода | Поддерживаемая компоновка выхода |
|---|---|---|---|
| Модель int8 | int8/float16/float32 | 4 измерения | NCHW/NC1HWC2/NHWC |
| Не 4 измерения | UNDEFINE | ||
| Модель float16 | float16/float32 | 4 измерения | NCHW/NC1HWC2/NHWC |
| Не 4 измерения | UNDEFINE |
Таблица 5-7. Выход NPU с нулевым копированием на RV1103/RV1103B/RV1106/RV1106B
| Model type | Output data type | Output dimensions | Supported output layout |
|------------|------------------|-------------------|-------------------------|
| int8 Model | int8/float16 | 4 dimensions | NCHW/NC1HWC2/NHWC |
| | | Not 4 dimensions | UNDEFINE |
rknn_create_mem
API нулевого копирования использует rknn_tensor_memory: до инференса структуру создают и настраивают, после — читают ее сведения о памяти. Если layout и тип из RKNN_QUERY_NATIVE_INPUT_ATTR/RKNN_QUERY_NATIVE_OUTPUT_ATTR не меняются, память создают непосредственно по size_with_stride. При изменении layout или типа размер памяти корректируют соответственно. Например, для преобразования выходного int8 в float32 размер увеличивают в четыре раза.
rknn_set_io_mem
rknn_set_io_mem() задает rknn_tensor_mem со сведениями о входной/выходной памяти модели. Как и rknn_init(), его достаточно вызвать один раз в начале, после чего rknn_run() выполняется многократно.
5.3 Настройка многоядерной NPU
RK3588 повышает вычислительную мощность с помощью 3 ядер NPU, RK3576 — 2 ядер. В этом разделе подробно описана настройка многоядерной NPU для повышения эффективности инференса.
Примечание: многоядерное выполнение подходит для вычислительно тяжелых сетей. Для небольших сетей улучшение незначительно; переключение между одним и несколькими ядрами может даже снизить производительность, поскольку требует участия CPU.
5.3.1 Настройка многоядерного выполнения
В приложении Python ядра NPU для модели задаются параметром core_mask интерфейса init_runtime() в RKNN-Toolkit2 или RKNN-Toolkit Lite2. Подробное описание параметра:
В приложении Python ядра NPU для модели задаются параметром core_mask интерфейса init_runtime() в RKNN-Toolkit2 или RKNN-Toolkit Lite2. Подробное описание параметра:
Таблица 5-8. Параметр core_mask интерфейса init_runtime
| Параметр | Описание |
|---|---|
| core_mask | Настройка ядер NPU при выполнении модели. Поддерживаются: - NPU_CORE_AUTO: автоматически выбирается свободное ядро NPU - NPU_CORE_0: выполнение на NPU0 - NPU_CORE_1: выполнение на NPU1 - NPU_CORE_2: выполнение на NPU2 - NPU_CORE_0_1: выполнение на NPU0 и NPU1 одновременно - NPU_CORE_0_1_2: выполнение на NPU0, NPU1 и NPU2 одновременно - NPU_CORE_ALL: число используемых ядер выбирается в зависимости от платформы По умолчанию NPU_CORE_AUTO. Примечание: в RKNN-Toolkit Lite2 перед значением добавляется RKNNLite, например RKNNLite.NPU_CORE_AUTO; в RKNN-Toolkit2 — RKNN, например RKNN.NPU_CORE_AUTO. |
Настройка ядра NPU в RKNN-Toolkit2, пример:
# Init runtime environment
print('--> Init runtime environment')
ret = rknn.init_runtime(target='rk3588', core_mask=RKNN.NPU_CORE_0)
if ret != 0:
  print('Init runtime environment failed!')
  exit(ret)
print('done')
Настройка ядра NPU в RKNN-Toolkit Lite2, пример:
......
# Init runtime environment
print('--> Init runtime environment')
ret = rknn_lite.init_runtime(core_mask=RKNNLite.NPU_CORE_0)
if ret != 0:
  print('Init runtime environment failed')
  exit(ret)
print('done')
......
В приложениях C/C++ ядро NPU для модели задается через rknn_set_core_mask(). Описание параметра core_mask:
Таблица 5-9. Параметр core_mask интерфейса rknn_set_core_mask
| Параметр | Описание |
|---|---|
| core_mask | Настройка ядер NPU при выполнении модели. Поддерживаются: - RKNN_NPU_CORE_AUTO: автоматически выбирается свободное ядро NPU - RKNN_NPU_CORE_0: выполнение на NPU0 - RKNN_NPU_CORE_1: выполнение на NPU1 - RKNN_NPU_CORE_2: выполнение на NPU2 - RKNN_NPU_CORE_0_1: выполнение на NPU0 и NPU1 одновременно - RKNN_NPU_CORE_0_1_2: выполнение на NPU0, NPU1 и NPU2 одновременно - RKNN_NPU_CORE_ALL: число используемых ядер выбирается в зависимости от платформы |
Пример настройки ядра NPU через C/C++ API:
// rknn_context ctx;
rknn_core_mask core_mask = RKNN_NPU_CORE_0;
int ret = rknn_set_core_mask(ctx, core_mask);
5.3.2 Проверка многоядерного выполнения
В этом разделе подробно рассмотрено поведение модели RKNN в многоядерном режиме.
Для инференса на подключенном RKNPU через RKNN-Toolkit2 задайте perf_debug=True в rknn.init_runtime(), затем вызовите rknn.eval_perf() для вывода сведений о каждом слое. Пример:
# Init runtime environment
ret = rknn.init_runtime(target='rk3588', device_id='29d5dd97766a5c27', perf_debug=True)
if ret != 0:
  print('Init runtime environment failed!')
  exit(ret)

# Eval performance
rknn.eval_perf()
При выполнении непосредственно на устройстве установите RKNN_LOG_LEVEL в 4 или выше перед запуском приложения. Будут выведены сведения о каждом слое. Настройка:
# Using the python interface provided by RKNN-Toolkit Lite2, just set verbose to True when creating the RKNNLite object.
rknnlite = RKNNLite(verbose=True)

# Using the C/C++ interface, you need to set the following environment variables before running the binary program
export RKNN_LOG_LEVEL=4
Для модели lenet после этих настроек терминал выводит журнал, подобный следующему. Для удобства показа удалены поля InputShape, OutputShape, DDR Cycles, NPU Cycles, Total Cycles, Time(us), MacUsage(%), Task Number, Lut Number, RW(kb), FullName и другие:
ID OpType DataType Target WorkLoad(0/1/2)-ImproveTherical
1 InputOperator UINT8 CPU 100.0%/0.0%/0.0% - Up:0.0%
2 Conv UINT8 NPU 50.0%/50.0%/0.0% - Up:50.0%
3 MaxPool INT8 NPU 100.0%/0.0%/0.0% - Up:0.0%
4 Conv INT8 NPU 50.0%/50.0%/0.0% - Up:50.0%
5 MaxPool INT8 NPU 100.0%/0.0%/0.0% - Up:0.0%
6 ConvRelu INT8 NPU 48.1%/51.9%/0.0% - Up:48.1%
7 Conv INT8 NPU 100.0%/0.0%/0.0% - Up:0.0%
8 Softmax INT8 CPU 0.0%/0.0%/0.0% - Up:0.0%
9 OutputOperator FLOAT16 CPU 0.0%/0.0%/0.0% - Up:0.0%
Total Operator Elapsed Time(us): 591
Total Memory RW Amount(MB): 0
Столбец WorkLoad(0/1/2)-ImproveTherical выводится только для многоядерных NPU. Он показывает распределение задач каждого слоя по ядрам и теоретическое ускорение. Например, «50.0%/50.0%/0.0% - Up:50.0%» означает 50% вычислений на Core0 и 50% на Core1, с теоретическим улучшением на 50% относительно одного ядра. Если улучшения нет, например «100.0%/0.0%/0.0% - Up:0.0%», возможны причины:
Нагрузка слоя меньше гранулярности распределения задач многоядерной NPU, поэтому слой выполняется на одном ядре.
Драйвер NPU пока не реализует многоядерное разделение для этого оператора; поддержка ожидается в следующих версиях. В оригинале перечислены поддерживаемые операторы: Conv, DepthwiseConvolution, Add, Concat, Relu, Clip, Relu6, ThresholdedRelu, PRelu и LeakyRelu.
5.3.3 Улучшение многоядерной производительности
Для повышения производительности попробуйте:
Установить максимальные частоты CPU/DDR/NPU.
Привязать приложение к большому ядру CPU.
Привязать прерывание NPU к тому же большому ядру CPU.
Команды фиксации частоты зависят от прошивки; см. раздел 8.1.1.
Для последних двух пунктов пример привязки к CPU4 приведен в скрипте:
interrupts=$(cat /proc/interrupts | grep npu)
interrupts_array=($interrupts)

irq1=$(echo ${interrupts_array[0]} | awk -F ':' '{print $1}')
irq2=$(echo ${interrupts_array[14]} | awk -F ':' '{print $1}')
irq3=$(echo ${interrupts_array[28]} | awk -F ':' '{print $1}')

for irq in $irq1 $irq2 $irq3; do
 echo 4 > /proc/irq/$irq/smp_affinity_list
done

taskset 10 ./rknn_benchmark lenet.rknn "" 10 3 # The taskset mask value corresponding to CPU4 is 0x10
Скрипт выполняет следующие действия:
Выполняет cat /proc/interrupts | grep npu и извлекает три номера прерываний, удаляя двоеточия.
Циклом задает smp_affinity_list каждого прерывания в 4 — идентификатор CPU4.
Выполняет taskset 10 ./rknn_benchmark lenet.rknn "" 10 3. Параметр taskset для CPU4 равен 10. Описание taskset: https://man7.org/linux/man-pages/man1/taskset.1.html.
После этого прерывание NPU и rknn_benchmark выполняются на CPU4, устраняя расходы переключения ядер при обработке прерывания NPU.
5.4 Динамическая форма
5.4.1 Введение в динамическую форму
Динамическая форма позволяет менять форму входных данных во время выполнения, обрабатывая переменные размеры и повышая гибкость модели. Когда RKNN поддерживал только статические формы, для нескольких входных форм требовались отдельные модели и контексты инференса. С динамической формой достаточно одной модели RKNN размером, близким к статической, и одного контекста, что экономит Flash и DDR. Это важно для обработки изображений и последовательностей. Типичные сценарии:
Переменная длина последовательности, например NLP-модели BERT и GPT.
Переменные пространственные размеры, например сегментация и перенос стиля.
Изменяемый размер batch в пакетных моделях.
Обнаружение объектов с переменным числом выходов.
5.4.2 Требования к версии RKNN SDK и платформе
Версия RKNN-Toolkit2 >=1.5.0
Версия RKNPU Runtime (librknnrt.so) >=1.5.0
Функция поддерживается на RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B.
5.4.3 Создание модели RKNN с динамической формой
Создание модели с динамической формой через Python-интерфейс RKNN-Toolkit2:
1. Убедитесь, что модель поддерживает динамическую форму.
RKNN-Toolkit2 может расширить статическую модель до динамической. Сначала убедитесь, что операторы или структура подграфов не ограничивают изменение формы. Например, форма константы неизменяема, и инструмент сообщит об ошибке преобразования. Если расширение не поддерживается, измените структуру по сообщению об ошибке и переобучите модель. Рекомендуется исходная модель с динамической формой.
2. Задайте используемые формы входа.
Аппаратура NPU не допускает произвольных форм: необходимо заранее задать ограниченное число входных форм. У многовходной модели число форм каждого входа должно совпадать. Пример Python для преобразования Caffe:
dynamic_input = [
  [[1,3,224,224]], # set the first shape for all inputs
  [[1,3,192,192]], # set the second shape for all inputs
  [[1,3,160,160]], # set the third shape for all inputs
]

# Pre-process config
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82],
      quant_img_RGB2BGR=True, dynamic_input=dynamic_shapes)
Настройка создает модель с тремя формами: [1,3,224,224], [1,3,192,192] и [1,3,160,160]. Формы dynamic_input соответствуют layout исходной среды. Для RGB-классификации 224x224 вход TensorFlow/TFLite имеет [1,224,224,3], а ONNX — [1,3,224,224].
3. Квантование
После задания форм для квантования нужен калибровочный набор. Инструмент использует набор форм с максимальной суммой размеров всех входов. Например, первый вход имеет формы [1,224] и [1,112], второй — [1,40] и [1,80]. Оригинал печатает суммы как «1224+140=264» и «1112+180=192»; знаки умножения визуально отсутствуют, поэтому запись сохранена как спорное место оригинала. Первая группа больше, и для квантования используются [1,224] и [1,40].
Для калибровочных jpg/png допустимы разные разрешения: перед квантованием opencv resize масштабирует изображение до максимального разрешения.
Для npy необходимо использовать форму максимального разрешения. После квантования все формы модели используют один набор параметров квантования при инференсе.
Максимальная входная форма также выводится при rknn.config:
W config: The 'dynamic_input' function has been enabled, the MaxShape is dynamic_input[0] = [[1,224],[1,40]]!
The following functions are subject to the MaxShape:
1. The quantified dataset needs to be configured according to MaxShape
2. The eval_perf or eval_memory return the results of MaxShape
4. Инференс или анализ точности
Для инференса или анализа точности используйте одну из групп форм шага 2. Интерфейсы такие же, как у статической модели RKNN, и повторно не описываются.
Полный пример динамической формы: https://github.com/airockchip/rknn-toolkit2/tree/master/rknn-toolkit2/examples/functions/dynamic_shape
5.4.4 Развертывание через C API
После получения модели с динамической формой разверните ее через RKNPU2 C API. В зависимости от интерфейса используются обычный API или нулевое копирование.
5.4.4.1 Обычный API
Процесс развертывания динамической модели через обычный API:
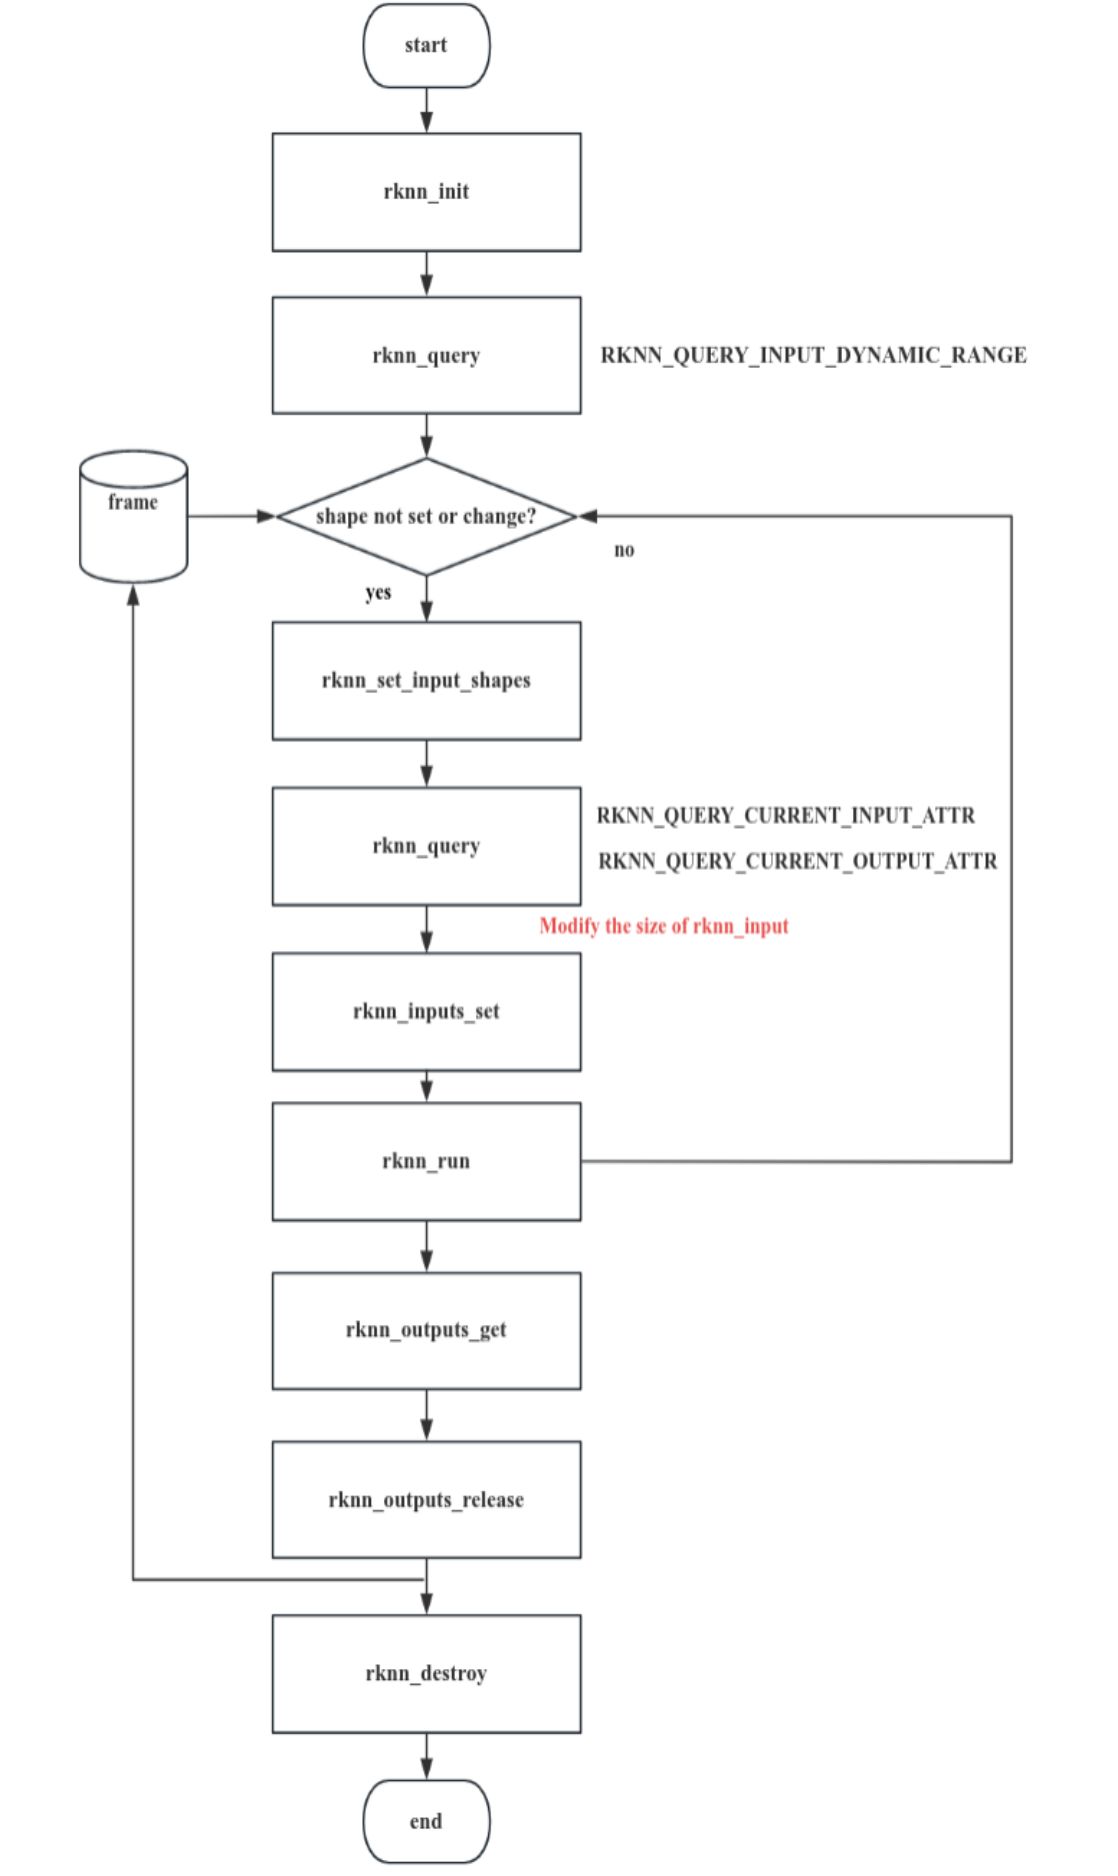
Рисунок 5-10. Вызовы обычного API для динамической формы входа
После загрузки модели форму входа можно менять во время выполнения. rknn_query() возвращает поддерживаемые формы каждого входа в rknn_input_range: имя, layout, число и значения форм. Затем rknn_set_input_shapes() принимает указатель на массив rknn_tensor_attr со всеми входными формами и задает текущую форму. Повторный rknn_query() позволяет получить формы входа и выхода после установки.
Далее выполните обычный процесс инференса. При каждой смене формы установите новую форму, подготовьте соответствующие данные и повторно вызовите rknn_inputs_set(). Если форма не меняется, повторять rknn_set_input_shapes() не нужно.
1. Инициализация
Инициализируйте динамическую модель через rknn_init().
При инициализации контекста действуют ограничения:
Совместное использование весов с флагом RKNN_FLAG_SHARE_WEIGHT_MEM не поддерживается.
Повторное использование контекста не поддерживается; см. rknn_dup_context.
2. Запрос поддерживаемых форм входа модели RKNN
После инициализации rknn_query() возвращает список форм каждого входа как rknn_input_range с именем, layout, количеством и конкретными формами. Пример C:
// Query the input shape supported by the model
rknn_input_range dyn_range[io_num.n_input];
memset(dyn_range, 0, io_num.n_input * sizeof(rknn_input_range));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
  dyn_range[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_INPUT_DYNAMIC_RANGE, &dyn_range[i],
sizeof(rknn_input_range));
  if (ret != RKNN_SUCC)
  {
    fprintf(stderr, "rknn_query error! ret=%d\n", ret);
    return -1;
  }
  dump_input_dynamic_range(&dyn_range[i]);
}
Примечание: у многовходных моделей формы соответствуют друг другу по порядку. Первая форма первого входа сочетается с первой формой второго; перекрестные сочетания недопустимы. Например, A имеет [1,224] и [1,112], B — [1,40] и [1,80]. Поддерживаются только:
Форма A = [1,224], форма B=[1,40]
Форма A = [1,112], форма B=[1,80]
3. Установка формы входа
При первом вводе данных или смене формы вызовите rknn_set_input_shapes(). После загрузки динамической модели этот интерфейс позволяет менять форму во время выполнения. Передайте массив rknn_tensor_attr для всех входов; поля dims, n_dims и fmt каждого элемента описывают текущую форму инференса. Пример C:
/**
 dynamic inputs shape range:
 index=0, name=data, shape_number=2, range=[[1, 224, 224, 3],[1, 112, 224, 3]], fmt = NHWC
**/
input_attrs[0].dims[0] = 1;
input_attrs[0].dims[1] = 224;
input_attrs[0].dims[2] = 224;
input_attrs[0].dims[3] = 3;
input_attrs[0].fmt=RKNN_TENSOR_NHWC;
ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
if (ret < 0) {
  fprintf(stderr, "rknn_set_input_shapes error! ret=%d\n", ret);
  return -1;
}
Здесь io_num.n_input — число входов, input_attrs — массив rknn_tensor_attr входов модели.
Примечание: заданная форма должна присутствовать в списке шага 2.
После установки формы повторно вызовите rknn_query для получения текущих форм входа и выхода. Пример C:
// Get the input and output shape of the current inference
rknn_tensor_attr cur_input_attrs[io_num.n_input];
memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
  cur_input_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]),
sizeof(rknn_tensor_attr));
  if (ret < 0)
  {
    printf("rknn_init error! ret=%d\n", ret);
    return -1;
  }
  dump_tensor_attr(&cur_input_attrs[i]);
}

rknn_tensor_attr cur_output_attrs[io_num.n_output];
memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_output; i++)
{
  cur_output_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &(cur_output_attrs[i]),
sizeof(rknn_tensor_attr));
  if (ret != RKNN_SUCC)
  {
    printf("rknn_query fail! ret=%d\n", ret);
    return -1;
  }
  dump_tensor_attr(&cur_output_attrs[i]);
}
Примечание:
rknn_set_input_shapes требует четырехмерный тензор с fmt=NHWC либо нечетырехмерный с fmt=UNDEFINED.
До вызова rknn_set_input_shapes сведения о формах, запрошенные командами с префиксом RKNN_QUERY_CURRENT, недействительны.
4. Инференс
После установки текущей формы предположим, что сведения о входном тензоре находятся в cur_input_attrs. Пример C для обычного API:
// Set input information
rknn_input inputs[io_num.n_input];
memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
for (int i = 0; i < io_num.n_input; i++)
{
  int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] :
cur_input_attrs[i].dims[2];
  int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] :
cur_input_attrs[i].dims[3];
  cv::resize(imgs[i], imgs[i], cv::Size(width, height));
  inputs[i].index = i;
  inputs[i].pass_through = 0;
  inputs[i].type = RKNN_TENSOR_UINT8;
  inputs[i].fmt = RKNN_TENSOR_NHWC;
  inputs[i].buf = imgs[i].data;
  inputs[i].size = imgs[i].total() * imgs[i].channels();
}

// After converting the input data into the correct format, put it into the input buffer
ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
if (ret < 0)
{
  printf("rknn_input_set fail! ret=%d\n", ret);
  return -1;
}

// Inferences
printf("Begin perf ...\n");
double total_time = 0;
for (int i = 0; i < loop_count; ++i)
{
  int64_t start_us = getCurrentTimeUs();
  ret = rknn_run(ctx, NULL);
  int64_t elapse_us = getCurrentTimeUs() - start_us;
  if (ret < 0)
  {
    printf("rknn run error %d\n", ret);
    return -1;
  }
  total_time += elapse_us / 1000.f;
  printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f * 1000.f / elapse_us);
}
printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);

// Get output results
rknn_output outputs[io_num.n_output];
memset(outputs, 0, io_num.n_output * sizeof(rknn_output));
for (uint32_t i = 0; i < io_num.n_output; ++i)
{
  outputs[i].want_float = 1;
  outputs[i].index = i;
  outputs[i].is_prealloc = 0;
}

ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0)
{
  printf("rknn_outputs_get fail! ret=%d\n", ret);
  return ret;
}

//Release the output buffer
ret = rknn_outputs_release(ctx, io_num.n_output, outputs);
5.4.4.2 API нулевого копирования
В API нулевого копирования после инициализации запросите формы через rknn_query() и выделите входную и выходную память через rknn_create_mem(). Затем передайте в rknn_set_input_shapes() массив rknn_tensor_attr с формами всех входов, задав текущую форму. Повторите rknn_query() для получения установленных форм входа и выхода. Вызовите rknn_set_io_mem() для настройки памяти. При каждом изменении формы задайте ее, подготовьте данные и снова вызовите rknn_set_io_mem(). Без изменения формы повторять rknn_set_input_shapes() не требуется. Типовой процесс показан ниже:
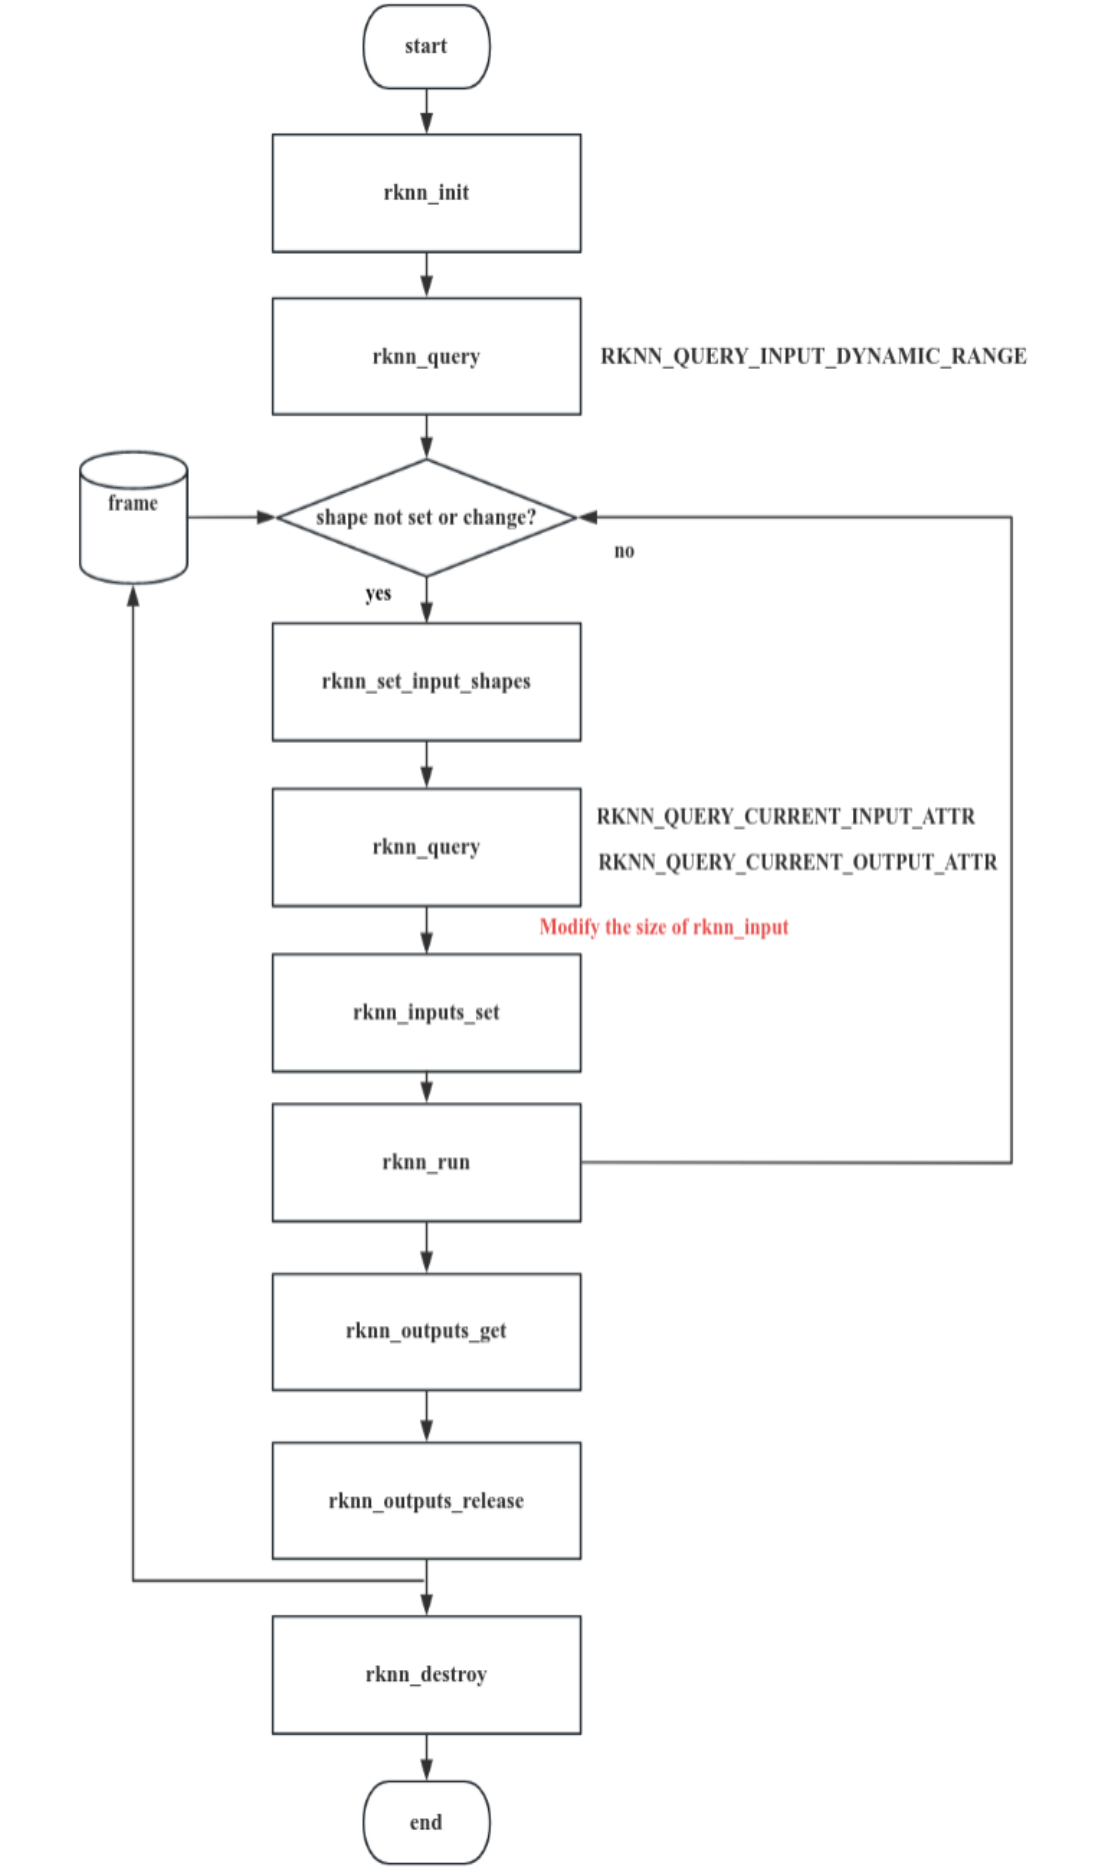
Рисунок 5-11. Нулевое копирование для динамической формы входа
Инициализация, запрос и установка формы аналогичны обычному API и повторно не описываются. Отличаются интерфейсы после установки формы. Пример C для нулевого копирования:
// Create the largest input tensor memory
rknn_tensor_mem *input_mems[io_num.n_input];
for (int i = 0; i < io_num.n_input; i++) {
  // default input type is int8 (normalize and quantize need compute in outside)
  // if set uint8, will fuse normalize and quantize to npu
  input_attrs[i].type = RKNN_TENSOR_UINT8;
  // default fmt is NHWC, npu only support NHWC in zero copy mode
  input_attrs[i].fmt = RKNN_TENSOR_NHWC;
  input_mems[i] = rknn_create_mem(ctx, input_attrs[i].size_with_stride);
...
// Create the largest output tensor memory
rknn_tensor_mem *output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
  // default output type is depend on model, this require float32 to compute top5
  // allocate float32 output tensor
  int output_size = output_attrs[i].size * sizeof(float);
  output_mems[i] = rknn_create_mem(ctx, output_size);
...
// Load the input and set the model input shape. This is called once each time the input shape is switched.
for (int s = 0; s < shape_num; ++s) {
  for (int i = 0; i < io_num.n_input; i++) {
    for (int j = 0; j < input_attrs[i].n_dims; ++j) {
      input_attrs[i].dims[j] = shape_range[i].dyn_range[s][j];
  ....
  ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
  if (ret < 0) {
    fprintf(stderr, "rknn_set_input_shape error! ret=%d\n", ret);
    return -1;
  ...
  // Get the input and output shape of the current inference
  printf("current input tensors:\n");
  rknn_tensor_attr cur_input_attrs[io_num.n_input];
  memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
  for (uint32_t i = 0; i < io_num.n_input; i++) {
    cur_input_attrs[i].index = i;
    // query info
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));

    if (ret < 0) {
      printf("rknn_init error! ret=%d\n", ret);
      return -1;
  dump_tensor_attr(&cur_input_attrs[i]);
  ...
  printf("current output tensors:\n");
  rknn_tensor_attr cur_output_attrs[io_num.n_output];
  memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
  for (uint32_t i = 0; i < io_num.n_output; i++) {
    cur_output_attrs[i].index = i;
    // query info
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &(cur_output_attrs[i]),
sizeof(rknn_tensor_attr));
     if (ret != RKNN_SUCC) {
       printf("rknn_query fail! ret=%d\n", ret);
       return -1;
   dump_tensor_attr(&cur_output_attrs[i]);
   ...
   // Specify the number of NPU cores, only 3588/3576 is supported
   rknn_set_core_mask(ctx, (rknn_core_mask)core_mask);

   // Set input information
   rknn_input inputs[io_num.n_input];
   memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
   std::vector<cv::Mat> resize_imgs;
   resize_imgs.resize(io_num.n_input);
   for (int i = 0; i < io_num.n_input; i++) {
     int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] :
 cur_input_attrs[i].dims[2];
     int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] :
 cur_input_attrs[i].dims[3];
     int stride = cur_input_attrs[i].w_stride;
     cv::resize(imgs[i], resize_imgs[i], cv::Size(width, height));
     int input_size = resize_imgs[i].total() * resize_imgs[i].channels();
     // Copy external data to zero-copy input buffer
     if (width == stride)
       memcpy(input_mems[i]->virt_addr, resize_imgs[i].data, input_size);
     else {
       int height = cur_input_attrs[i].dims[1];
       int channel = cur_input_attrs[i].dims[3];
       // copy from src to dst with stride
       uint8_t *src_ptr = resize_imgs[i].data;
       uint8_t *dst_ptr = (uint8_t *)input_mems[i]->virt_addr;
       // width-channel elements
       int src_wc_elems = width * channel;
       int dst_wc_elems = stride * channel;
       for (int b = 0; b < cur_input_attrs[i].dims[0]; b++) {
         for (int h = 0; h < height; ++h) {
           memcpy(dst_ptr, src_ptr, src_wc_elems);
           src_ptr += src_wc_elems;
           dst_ptr += dst_wc_elems;
    ....
   // Update input zero-copy buffer
   for (int i = 0; i < io_num.n_input; i++) {
     cur_input_attrs[i].type = RKNN_TENSOR_UINT8;
     ret = rknn_set_io_mem(ctx, input_mems[i], &cur_input_attrs[i]);
     if (ret < 0) {
       printf("rknn_set_io_mem fail! ret=%d\n", ret);
       return -1;
   ....
   // Update output zero-copy buffer
   for (uint32_t i = 0; i < io_num.n_output; ++i) {
     // default output type is depend on model, this require float32 to compute top5
     cur_output_attrs[i].type = RKNN_TENSOR_FLOAT32;
     cur_output_attrs[i].fmt = RKNN_TENSOR_NCHW;
     // set output memory and attribute
     ret = rknn_set_io_mem(ctx, output_mems[i], &cur_output_attrs[i]);
     if (ret < 0) {
       printf("rknn_set_io_mem fail! ret=%d\n", ret);
      return -1;
  ....
  // Inference
  printf("Begin perf ...\n");
  double total_time = 0;
  for (int i = 0; i < loop_count; ++i) {
    int64_t start_us = getCurrentTimeUs();
    ret = rknn_run(ctx, NULL);
    int64_t elapse_us = getCurrentTimeUs() - start_us;
    if (ret < 0) {
      printf("rknn run error %d\n", ret);
      return -1;
    ...
    total_time += elapse_us / 1000.f;
    printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f * 1000.f / elapse_us);
  ...
  printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);
Примечание:
1. Форма и размер входного буфера rknn_set_io_mem() при динамической форме:
После инициализации, но до rknn_set_input_shapes(), rknn_query() с RKNN_QUERY_INPUT_ATTR и RKNN_QUERY_OUTPUT_ATTR обычно возвращает максимальные формы входа и выхода. Эти размеры можно использовать при выделении памяти. У многовходной модели некоторые формы могут не быть максимальными; тогда найдите максимальные размеры среди всех поддерживаемых форм и выделите соответствующую память.
Для нечетырехмерного входа используйте fmt=UNDEFINED; размер буфера исходной формы рассчитывается по форме и типу входа.
Для четырехмерного входа поддерживается fmt=NHWC или NC1HWC2. Через соответствующие поля rknn_query получите форму и размер и передайте буфер соответствующего NHWC- или NC1HWC2-layout.
rknn_query() с RKNN_QUERY_CURRENT_INPUT_ATTR/RKNN_QUERY_CURRENT_OUTPUT_ATTR возвращает вход/выход исходной модели в NHWC или UNDEFINED. RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR/RKNN_QUERY_CURRENT_NATIVE_OUTPUT_ATTR возвращает оптимальные для NPU вход/выход в NHWC или NC1HWC2.
2. Для буфера NHWC в rknn_set_io_mem() задайте shape и fmt в rknn_tensor_attr по RKNN_QUERY_CURRENT_INPUT_ATTR. Для NC1HWC2 используйте сведения RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR.
Полный пример динамической формы C API: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_dynamic_shape_input_demo
5.5 Пользовательские операторы
5.5.1 Введение
RKNN SDK позволяет определять и выполнять пользовательские операторы при инференсе RKNN. Они расширяют и оптимизируют модель для CPU или GPU, эффективнее используют аппаратуру и ускоряют инференс. Для правильности и производительности необходимо глубоко понимать вычислительные принципы глубокого обучения и целевую платформу. Поддерживаются только пользовательские операторы моделей ONNX.
Работа с пользовательскими операторами включает два основных этапа:
Зарегистрируйте операторы в RKNN-Toolkit2 и экспортируйте модель RKNN.
Реализуйте оператор на C, загрузите, зарегистрируйте и выполните его через RKNN API.
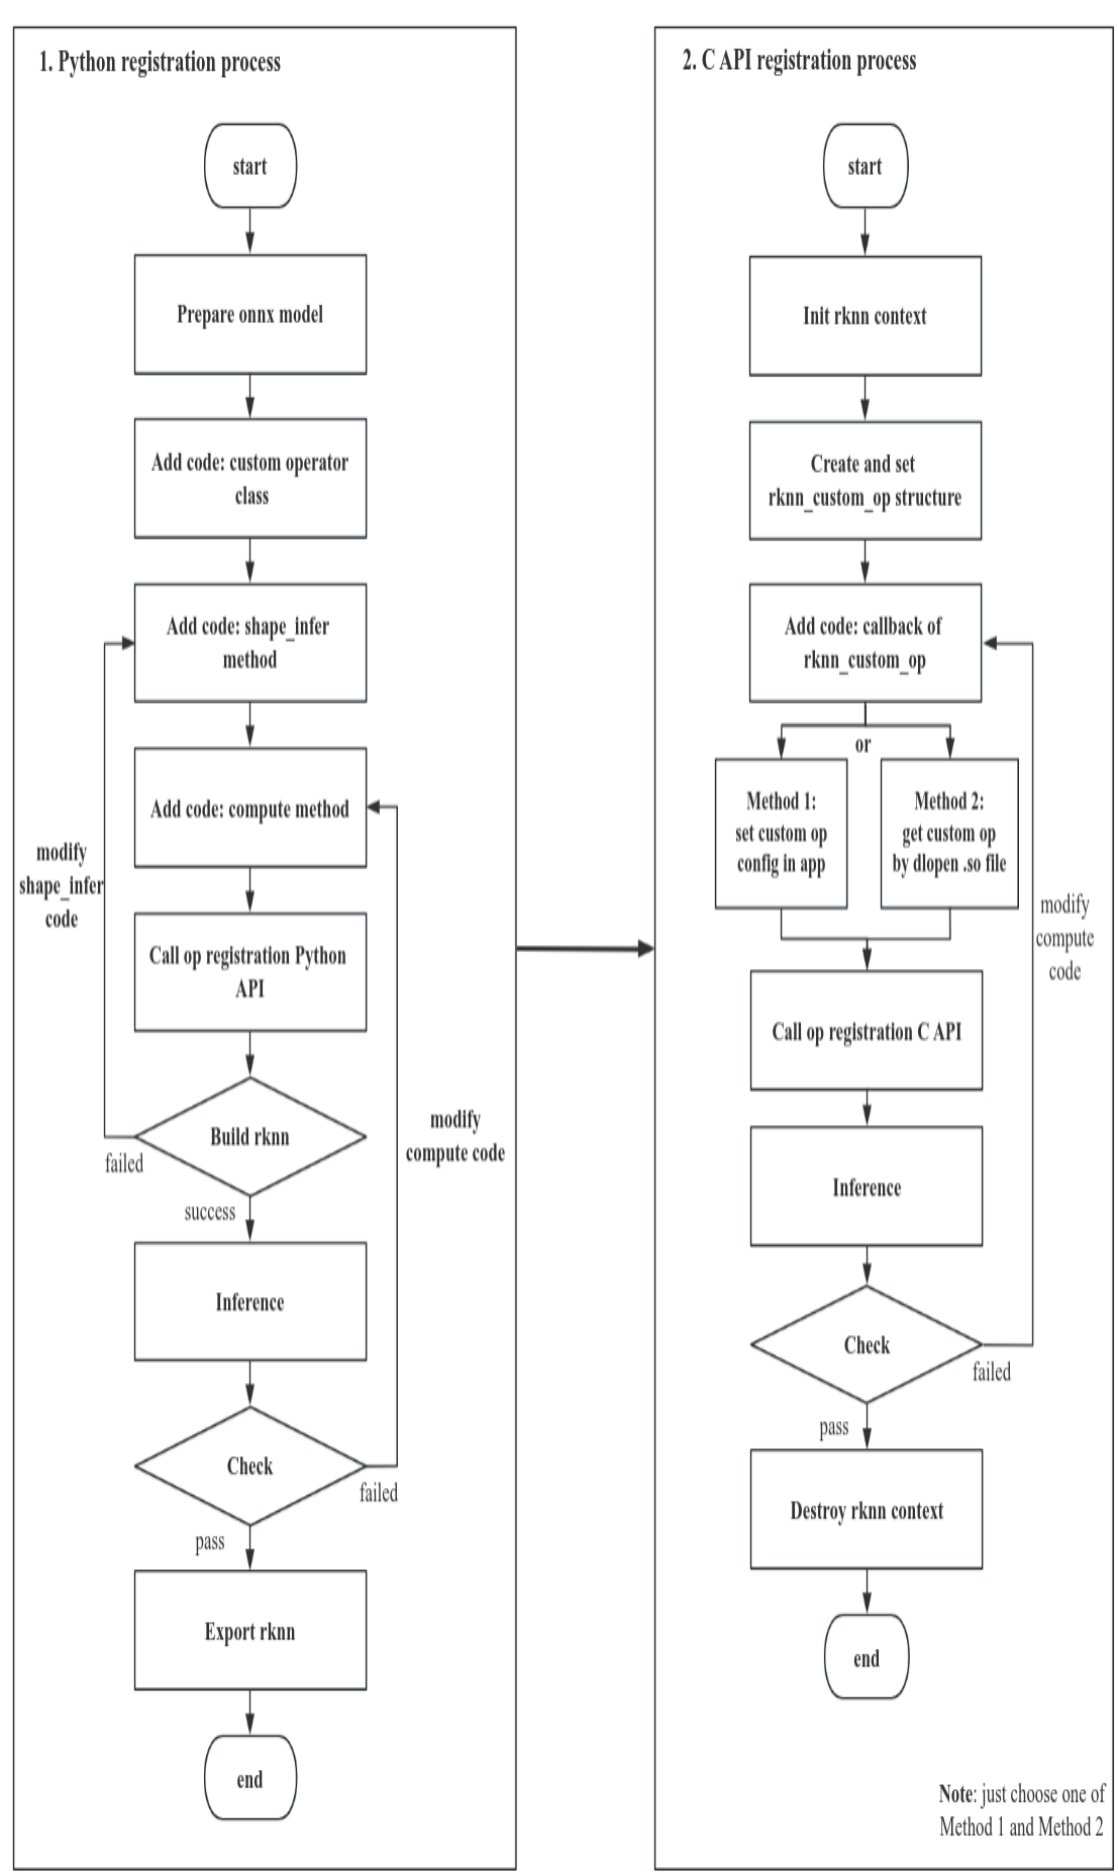
Рисунок 5-12. Полный процесс регистрации пользовательских операторов
5.5.2 Общий процесс
5.5.2.1 Регистрация операторов в RKNN-Toolkit2 и экспорт модели RKNN
1. Подготовьте onnx-модель: по спецификации ONNX задайте тип op, имя, атрибуты, число входов/выходов пользовательского оператора и вставьте его в нужную позицию графа. Создайте и экспортируйте модель через API пакета onnx.
2. Реализуйте Python-класс оператора, прежде всего shape_infer() и compute(), и зарегистрируйте его через rknn.reg_custom_op().
3. После успешного rknn.build() выполните инференс; при ошибке проверьте shape_infer() шага 2. Запустите симуляцию. Если результат правильный, экспортируйте модель через rknn.export_rknn(); иначе проверьте compute() шага 2.
5.5.2.2 Реализация оператора на C, загрузка, регистрация и выполнение через RKNN API
1. Реализуйте оператор на C на основе rknn_custom_op из rknn_custom_op.h, затем заполните сведения rknn_custom_op.
2. Зарегистрируйте сведения rknn_custom_op через rknn_register_custom_ops().
3. Постройте и выполните модель по процессу обычного API или нулевого копирования. Для проверки оператора можно включить подробный журнал и dump модели.
5.5.2.3 Инференс или анализ точности с подключенным устройством через RKNN-Toolkit2
Для анализа точности модели с пользовательским оператором на подключенной плате скомпилируйте его callback-функции в .so, поместите файл по указанному пути и перезапустите rknn_server. Подробности см. в разделе 5.5.4.4.
5.5.3 Процесс Python
Пользовательские операторы поддерживаются только моделями onnx; можно добавлять нестандартные для ONNX операторы, поддерживаемые RKNN.
Такой оператор отсутствует в стандартном списке ONNX. Помимо ONNX spec он должен соответствовать правилам:
op_type не должен совпадать со стандартным оператором ONNX. Рекомендуется префикс cst.
Оператор должен быть связан с другими операторами с определенными формами, типами и прочими характеристиками входов/выходов.
Входные атрибуты поддерживают отдельные значения или массивы bool, int32, float32 и int64.
Константные входы поддерживают bool, int32, float32 и int64. Это типы неквантованной модели ONNX.
Поскольку оператор не входит в ONNX SPEC, модель с ним нужно создать и экспортировать через ONNX API либо API другой среды.
В качестве простого примера изменим определение Softmax и создадим ONNX-модель с нестандартным оператором cstSoftmax:
import onnx

path="test_softmax.onnx"
model=onnx.load(path)

for node in model.graph.node:
  if node.op_type =="Softmax":
    node.op_type = "cstSoftmax"
    ... # Modify the attribute definition of cstSoftmax, etc
onnx.save(model, "./test_softmax_custom.onnx")
После создания модели откройте ее в Netron и проверьте соответствие оператора требованиям. Затем реализуйте класс, например для пользовательского Softmax:
import numpy as np
from rknn.api.custom_op import get_node_attr
class cstSoftmax:
  op_type = 'cstSoftmax'
  def shape_infer(self, node, in_shapes, in_dtypes):
    out_shapes = in_shapes.copy()
    out_dtypes = in_dtypes.copy()
    return out_shapes, out_dtypes
  def compute(self, node, inputs):
    x = inputs[0]
    axis = get_node_attr(node, 'axis')
    x_max = np.max(x, axis=axis, keepdims=True)
    tmp = np.exp(x - x_max)
    s = np.sum(tmp, axis=axis, keepdims=True)
    outputs = [tmp / s]
    return outputs
Пользовательский оператор должен быть классом Python.
Класс должен содержать строковую переменную op_type, совпадающую с именем типа оператора в ONNX.
Класс должен содержать shape_infer(self, node, in_shapes, in_dtypes); имена функции и параметров должны точно совпадать, иначе возникнет ошибка. Функция выводит формы оператора. node — объект узла ONNX с атрибутами и сведениями о входах/выходах. in_shapes — формы всех входов в формате [shape_0, shape_1, …], каждая shape также является списком. in_dtypes — типы всех входов в формате [dtype_0, dtype_1, …], каждый dtype имеет тип numpy dtype. Функция возвращает формы и dtype всех выходов в тех же форматах, что in_shapes и in_dtypes.
Класс должен содержать compute(self, node, inputs); имена функции и параметров должны совпадать, иначе возникнет ошибка. Функция выполняет оператор. node — объект ONNX с атрибутами и сведениями о входах/выходах; inputs — данные входов в формате [array_0, array_1, …], элементы — numpy ndarray. Возвращаются все выходные данные в том же формате, что inputs.
Для получения пользовательских атрибутов используйте from rknn.api.custom_op import get_node_attr.
Зарегистрируйте готовый класс через rknn.reg_custom_op(), затем вызовите rknn.build() для преобразования и создания RKNN. Класс обеспечивает функции преобразования и инференса модели. Пример с пользовательским Softmax:
from rknn.api import RKNN
# Create RKNN object
rknn = RKNN(verbose=True)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82], quant_img_RGB2BGR=True,
target_platform='rk3566')
print('done')

print('--> Register cstSoftmax op')
ret = rknn.reg_custom_op(cstSoftmax())
if ret != 0:
  print('Register cstSoftmax op failed!')
  exit(ret)
print('done')

print('--> Loading model')
ret = rknn.load_onnx(model='mobilenet_v2.onnx')
if ret != 0:
  print('Load model failed!')
  exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
if ret != 0:
  print('Build model failed!')
  exit(ret)
print('done')
rknn.reg_custom_op() вызывается между rknn.config() и rknn.load_xxx().
5.5.4 Развертывание через C API
Получив модель с пользовательскими операторами, используйте C API для развертывания. Структуры и интерфейсы находятся в rknn_custom_op.h; подключите этот заголовок. Процесс показан ниже:
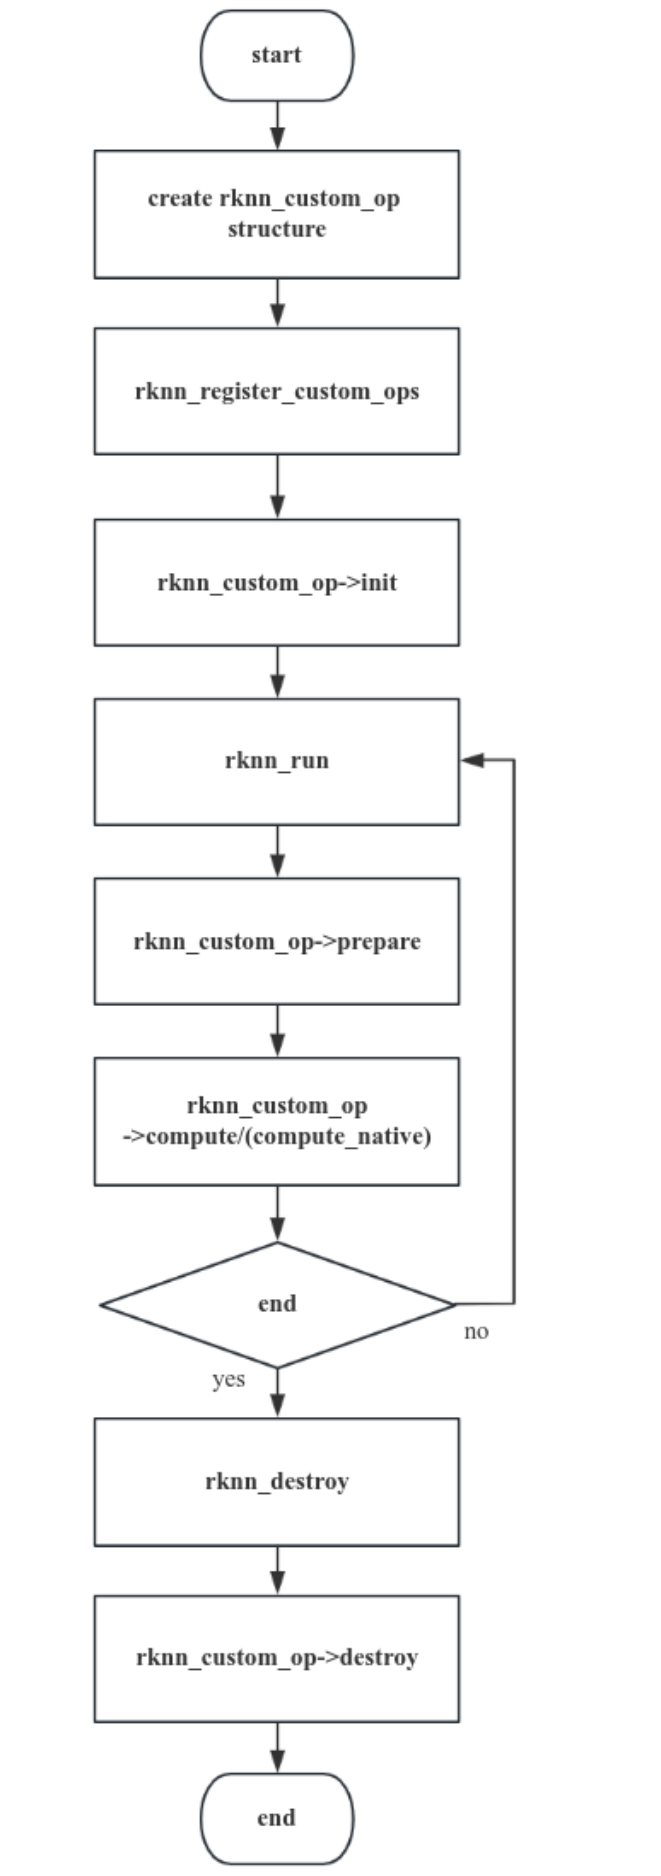
Рисунок 5-13. Вызовы C API для регистрации пользовательских операторов
5.5.4.1 Инициализация структуры пользовательского оператора
После создания контекста rknn создайте rknn_custom_op и задайте следующие сведения:
version: версия оператора.
target: исполнительная среда оператора; поддерживаются CPU и GPU.
op_type: тип оператора, совпадающий с типом в модели ONNX.
cl_kernel_name: имя функции cl_kernel кода OpenCL; обязательно при регистрации GPU-оператора.
cl_kernel_source: полный путь к .cl-файлу либо строка ядра OpenCL. При cl_source_size=0 это путь к .cl, при cl_source_size>0 — строка кода OpenCL. Обязательно для GPU-оператора.
cl_source_size: размер cl_kernel_source. Специальное значение 0 означает, что cl_kernel_source является путем.
cl_build_options: строка параметров компиляции ядра OpenCL; обязательно для GPU-оператора.
init: необязательный callback, однократно вызываемый в rknn_register_custom_ops.
prepare: необязательный callback предварительной обработки. Каждый rknn_run выполняет сначала prepare, затем compute/compute_native.
compute: обязательный вычислительный callback. Входы и выходы — NCHW float32; если вход/выход ONNX имеет тип int64, данные будут int64.
compute_native: зарезервировано; установите NULL.
destroy: необязательный callback, выполняемый один раз в rknn_destory; написание имени сохранено из оригинала.
Параметры callback-функций init/prepare/compute:
rknn_custom_op_context* op_ctx: контекст callback-функции оператора.
rknn_custom_op_tensor* inputs: данные и сведения входных тензоров.
uint32_t n_inputs: число входов оператора.
rknn_custom_op_tensor* outputs: данные и сведения выходных тензоров.
uint32_t n_outputs: число выходов оператора.
destroy имеет только один параметр: rknn_custom_op_context* op_ctx.
rknn_custom_op_context
Содержит target (устройство исполнения), контекст GPU, частный контекст оператора и priv_data. Разработчик управляет присваиванием, чтением, записью и уничтожением priv_data. Контекст GPU содержит указатели cl_context, cl_command_queue и cl_kernel, из которых соответствующие объекты OpenCL получают приведением типов.
priv_data — необязательный указатель. Обычно ресурс создают в init(), его адрес сохраняют в priv_data, используют в prepare()/compute() и освобождают в destroy().
rknn_custom_op_tensor
Описывает входной/выходной тензор: имя, форму, размер, параметры квантования, виртуальный базовый адрес, fd, смещение данных и другие сведения.
В compute() не нужно выделять память входных и выходных тензоров: данные по виртуальному адресу уже подготовлены. Эффективный адрес тензора = виртуальный базовый адрес + смещение данных. virt_addr члена mem — базовый адрес, offset члена mem — смещение в байтах. Во время callback адрес входа указывает на выход предыдущего оператора, а адрес выхода — на данные, которые получит следующий оператор.
rknn_custom_op_attr
Для получения атрибутов вызовите rknn_custom_op_get_op_attr() с полем атрибута. Результат представлен rknn_custom_op_attr. Его void-буфер, dtype и число элементов описывают участок памяти. Приведением типа указателя в C/C++ согласно dtype можно получить массив нужного числового типа.
5.5.4.1.1 Callback Init
Используется для разбора сведений оператора либо инициализации временных и входных/выходных буферов, например выделения временной памяти. Пример init:
Оператор CPU:
/**
* cpu kernel init callback for custom op
*/
int custom_op_init_callback(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
              rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("custom_op_init_callback\n");
  // create tmp buffer
  float* tmp_buffer = (float*)malloc(inputs[0].attr.n_elems * sizeof(float));
  op_ctx->priv_data = tmp_buffer;
  return 0;
}
Оператор GPU:
/**
* opencl kernel init callback for custom op
* */
int relu_init_callback_gpu(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
             rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("relu_init_callback_gpu\n");
  // 获取opencl context
  cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

  // create tmp cl buffer
  cl_mem* memObject = (cl_mem*)malloc(sizeof(cl_mem) * 2);
  memObject[0] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, inputs[0].attr.size, NULL, NULL);
  memObject[1] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, outputs[0].attr.size, NULL, NULL);
  op_ctx->priv_data = memObject;
  return 0;
}
5.5.4.1.2 Callback Prepare
Этот callback вызывается для каждого кадра инференса; в оригинале также указано, что он пока зарезервирован для будущего использования.
5.5.4.1.3 Callback Compute
Это вычислительная функция пользовательского оператора. Разработчик должен реализовать обработку входов/выходов формата NCHW или UNDEFINED с типом float32.
1. Compute callback (CPU)
Пример compute CPU-оператора для softmax:
/**
* float32 kernel implemetation sample for custom op
* */
int compute_custom_softmax_float32(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t
n_inputs,
                 rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  unsigned char* in_ptr = (unsigned char*)inputs[0].mem.virt_addr + inputs[0].mem.offset;
  unsigned char* out_ptr = (unsigned char*)outputs[0].mem.virt_addr + outputs[0].mem.offset;
  int axis = 0;
  const float* in_data = (const float*)in_ptr;
  float* out_data = (float*)out_ptr;
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  rknn_custom_op_attr op_attr;
  rknn_custom_op_get_op_attr(op_ctx, "axis", &op_attr);
  if (op_attr.n_elems == 1 && op_attr.dtype == RKNN_TENSOR_INT64) {
    axis = ((int64_t*)op_attr.data)[0];
  }

  printf("op name = %s, axis = %d\n", name.c_str(), axis);
  float* tmp_buffer = (float*)op_ctx->priv_data;
  // kernel implemetation for custom op
  {
    int inside = 1;
    int outside = 1;
    int channel = 1;

    while (axis < 0) {
      axis += inputs[0].attr.n_dims;
    }

    for (int i = 0; i < axis; i++) {
      outside *= inputs[0].attr.dims[i];
    }
    channel = inputs[0].attr.dims[axis];
    for (int i = axis; i < inputs[0].attr.n_dims; i++) {
      inside *= inputs[0].attr.dims[i];
    }
    for (int y = 0; y < outside; y++) {
      const float* src_y = in_data + y * inside;
      float* dst_y = out_data + y * inside;
      float max_data = -FLT_MAX;
      float sum_data = 0.0f;

      for (int i = 0; i < inside; ++i) {
        max_data = fmaxf(max_data, src_y[i]);
      }
      for (int i = 0; i < inside; ++i) {
        tmp_buffer[i] = expf(src_y[i] - max_data);
        sum_data += tmp_buffer[i];
      }
      for (int i = 0; i < inside; ++i) {
        dst_y[i] = tmp_buffer[i] / sum_data;
      }
    }
  }
  return 0;
}
2. Compute callback (GPU)
Для GPU в callback выполняются следующие шаги:
Получите cl_context, cl_command_queue и cl_kernel из gpu_ctx в rknn_custom_op_context с соответствующим приведением типов.
При необходимости создайте cl_mem-буфер входа или выхода оператора.
Задайте аргументы функции cl_kernel.
Входной буфер ядра OpenCL поддерживает только float; другие типы не поддерживаются.
При нулевом копировании clImportMemoryARM отображает память входного тензора в cl_mem OpenCL. Вход уже содержит данные, повторное копирование не требуется. Это можно выполнить в init, сохранив cl_mem в priv_data, а затем извлечь и использовать priv_data в compute.
Выполните cl_kernel в блокирующем режиме.
Входные данные ядра CL имеют формат NCHW.
Если после GPU данные читает CPU, перед чтением обновите кэш выходного тензора через rknn_mem_sync.
Пример вычислительной функции GPU для пользовательского слоя relu:
/**
* opencl kernel init callback for custom op
* */
int compute_custom_relu_float32(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t
num_inputs,
                rknn_custom_op_tensor* outputs, uint32_t num_outputs)
{
   std::string name = "";
   rknn_custom_op_attr op_name;
   rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
   if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
     name = (char*)op_name.data;
   }

   // // save input npy
   // char output_path[PATH_MAX];
   // sprintf(output_path, "%s/cpu_input%d.npy", ".", 0);
   // save_npy(output_path, (float*)in_data, &inputs[0].attr);

   // get context
   cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

   // get command queue
   cl_command_queue queue = (cl_command_queue)op_ctx->gpu_ctx.cl_command_queue;

   // get kernel
   cl_kernel kernel = (cl_kernel)op_ctx->gpu_ctx.cl_kernel;

   // import input/output buffer
   const cl_import_properties_arm props[3] = {
     CL_IMPORT_TYPE_ARM,
     CL_IMPORT_TYPE_DMA_BUF_ARM,
     0,
   };

   cl_int status;
   cl_mem inObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props, &inputs[0].mem.fd,
                     inputs[0].mem.offset + inputs[0].mem.size, &status);
   if (status != CL_SUCCESS) {
     printf("Tensor: %s clImportMemoryARM failed\n", inputs[0].attr.name);
   }
   cl_mem outObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props, &outputs[0].mem.fd,
                     outputs[0].mem.offset + outputs[0].mem.size, &status);
   if (status != CL_SUCCESS) {
     printf("Tensor: %s clImportMemoryARM failed\n", outputs[0].attr.name);
   }

   int in_type_bytes = get_type_bytes(inputs[0].attr.type);
   int out_type_bytes = get_type_bytes(outputs[0].attr.type);
   int in_offset = inputs[0].mem.offset / in_type_bytes;
   int out_offset = outputs[0].mem.offset / out_type_bytes;
   unsigned int elems = inputs[0].attr.n_elems;

   // set kernel args
   int argIndex = 0;
   clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &inObject);
   clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &outObject);
   clSetKernelArg(kernel, argIndex++, sizeof(int), &in_offset);
   clSetKernelArg(kernel, argIndex++, sizeof(int), &out_offset);
   clSetKernelArg(kernel, argIndex++, sizeof(unsigned int), &elems);

   // set global worksize
   const size_t global_work_size[3] = {elems, 1, 1};
  // enqueueNDRangeKernel
  clEnqueueNDRangeKernel(queue, kernel, 1, NULL, global_work_size, NULL, 0, NULL, NULL);

  // finish command queue
  clFinish(queue);

  // //cpu access data after sync to device
  // rknn_mem_sync(&outputs[0].mem, RKNN_MEMORY_SYNC_FROM_DEVICE);
  // // save output npy
  // char output_path[PATH_MAX];
  // sprintf(output_path, "%s/cpu_output%d.npy", ".", 0);
  // unsigned char* out_data = (unsigned char*)outputs[0].mem.virt_addr+outputs[0].mem.offset;
  // save_npy(output_path, (float*)out_data, &inputs[0].attr);
  return 0;
}
5.5.4.1.4 Callback Destroy
Освобождает временные либо входные/выходные буферы пользовательского оператора. Пример освобождения временного буфера:
Оператор CPU
/**
* cpu kernel destroy callback for custom op
*/
int custom_op_destroy_callback(rknn_custom_op_context* op_ctx)
{
  printf("custom_op_destroy_callback\n");
  // clear tmp buffer
  free(op_ctx->priv_data);
  return 0;
}
Оператор GPU
/**
* opencl kernel destroy callback for custom op
*/
int relu_destroy_callback_gpu(rknn_custom_op_context* op_ctx)
{
  // clear tmp buffer
  printf("relu_destroy_callback_gpu\n");
  cl_mem* memObject = (cl_mem*)op_ctx->priv_data;
  clReleaseMemObject(memObject[0]);
  clReleaseMemObject(memObject[1]);
  free(memObject);
  return 0;
}
5.5.4.2 Регистрация пользовательского оператора
После настройки rknn_custom_op зарегистрируйте его в rknn_context через rknn_register_custom_ops(). Можно одновременно зарегистрировать несколько операторов.
После реализации compute CPU-оператора зарегистрируйте cstSoftmax и ArgMax, например:
Оператор CPU
// CPU operators
rknn_custom_op user_op[2];
memset(user_op, 0, 2 * sizeof(rknn_custom_op));
strncpy(user_op[0].op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op[0].version = 1;
user_op[0].target = RKNN_TARGET_TYPE_CPU;
user_op[0].init = custom_op_init_callback;
user_op[0].compute = compute_custom_softmax_float32;
user_op[0].destroy = custom_op_destroy_callback;

strncpy(user_op[1].op_type, "ArgMax", RKNN_MAX_NAME_LEN - 1);
user_op[1].version = 1;
user_op[1].target = RKNN_TARGET_TYPE_CPU;
user_op[1].init = custom_op_init_callback;
user_op[1].compute = compute_custom_argmax_float32;
user_op[1].destroy = custom_op_destroy_callback;

ret = rknn_register_custom_ops(ctx, user_op, 2);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
Оператор GPU
Ядро OpenCL GPU-оператора регистрируется строкой-константой или путем к файлу. При cl_source_size=0 в rknn_custom_op поле cl_kernel_source обозначает путь; при cl_source_size>0 — строку функции ядра. Пример строки ядра relu:
char* cl_kernel_source = "#pragma OPENCL EXTENSION cl_arm_printf : enable"
  "#pragma OPENCL EXTENSION cl_khr_fp16 : enable "
  " __kernel void relu_float(__global const float* input, __global float* output, int "
  "in_offset, int out_offset, const unsigned int elems) "
  "{"
  " int gid = get_global_id(0);"
  " if (gid < elems) {"
  " float in_value = input[in_offset + gid];"
  " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
  " }"
  "}"
  "__kernel void relu_half(__global const half* input, __global half* output, int in_offset, "
  "int out_offset, const unsigned int elems)"
  "{"
  " int gid = get_global_id(0);"
  " if (gid < elems) {"
  " half in_value = input[in_offset + gid];"
  " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
  " }"
  "}";
После реализации ядра OpenCL и GPU callback compute заполните массив rknn_custom_op и зарегистрируйте GPU-оператор. Пример:
// GPU operators
rknn_custom_op user_op[1];
memset(user_op, 0, sizeof(rknn_custom_op));
strncpy(user_op->op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op->version = 1;
user_op->target = RKNN_TARGET_TYPE_GPU;
user_op->init = relu_init_callback_gpu;
user_op->compute = compute_custom_relu_float32;
user_op->destroy = relu_destroy_callback_gpu;
#ifdef LOAD_FROM_PATH
user_op->cl_kernel_source = "./custom_op.cl";
user_op->cl_source_size = 0;
#else
user_op->cl_kernel_source = cl_kernel_source;
user_op->cl_source_size = strlen(cl_kernel_source);
#endif
strcpy(user_op->cl_kernel_name, "relu_float");

ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
До регистрации четко определите op_type, подготовьте сведения оператора и массив rknn_custom_op. Каждый тип регистрируется один раз; несколько операторов того же типа в сети не требуют повторной регистрации.
5.5.4.3 Инференс модели
После регистрации всех операторов выполните инференс через обычный API или API нулевого копирования.
5.5.4.4 Анализ точности с подключенным устройством
Для отладки пользовательских операторов с подключенной платой нужен rknn_server версии >= 1.6.0.
При отладке rknn_server через dlopen открывает скомпилированную пользователем библиотеку плагина из указанного каталога и получает сведения оператора. Для регистрации в библиотеке реализуйте get_rknn_custom_op().
Для анализа точности модели с такими операторами на подключенном устройстве:
1. Реализуйте get_rknn_custom_op() и необходимые callback-функции, затем скомпилируйте библиотеку для системы. Имя должно начинаться с librkcst_, например librkcst_relu.so.
2. Поместите плагин в /vendor/lib64/ для Android arm64-v8a либо /usr/lib/rknpu/op_plugins для Linux.
3. Выполните анализ точности с компьютера через Python-интерфейс RKNN-Toolkit2.
Пример get_rknn_custom_op:
/**
 * To obtain operator information to be registered, a plugin library must have one and only one of this function.
 */
RKNN_CUSTOM_OP_EXPORT rknn_custom_op* get_rknn_custom_op()
{
  // register a custom op
  memset(&user_op, 0, sizeof(rknn_custom_op));
  strncpy(user_op.op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
  user_op.version = 1;
  user_op.target = RKNN_TARGET_TYPE_CPU;
  user_op.init = custom_op_init_callback;
  user_op.compute = compute_custom_softmax_float32;
  user_op.destroy = custom_op_destroy_callback;
  return &user_op;
}
Для экспорта символа get_rknn_custom_op добавьте функции атрибут RKNN_CUSTOM_OP_EXPORT.
rknn_server вызывает dlopen для получения дескрипторов всех библиотек so в заданном каталоге, затем dlsym для указателя get_rknn_custom_op. Вызов указателя возвращает структуру оператора. Пример:
std::vector<std::string> get_all_plugin_paths(std::string plugin_dir)
{
  std::vector<std::string> plugin_paths;
  if (access(plugin_dir.c_str(), 0) != 0) {
    fprintf(stderr, "Can not access plugin directory: %s, please check it!\n", plugin_dir.c_str());
  }

  DIR* dir;
  struct dirent* ent;
  const char* prefix = RKNN_CSTOP_PLUGIN_PREFIX; // All library file names should start with this prefix

  if ((dir = opendir(plugin_dir.c_str())) != NULL) {
    while ((ent = readdir(dir)) != NULL) {
      if (ent->d_type == DT_REG) {
        const char* filename = ent->d_name;
        size_t len = strlen(filename);

        if (len > 10 && strncmp(filename, prefix, strlen(prefix)) == 0) {
          printf("Found plugin: %s file in %s\n", filename, plugin_dir.c_str());
          plugin_paths.push_back(plugin_dir + "/" + filename);
        }
      }
    }
    closedir(dir);
  } else {
    fprintf(stderr, "Unable to open directory");
  }
  return plugin_paths;
}

// the default path of the custom operator plugin libraries
std::string plugin_dir =
#if defined(__ANDROID__)
# if defined(__aarch64__)
  "/vendor/lib64/";
# else
  "/vendor/lib/";
# endif // __aarch64__
#elif defined(__linux__)
  "/usr/lib/rknpu/op_plugins/";
#endif

std::vector<std::string> plugin_paths = get_all_plugin_paths(plugin_dir);
std::vector<void*> so_handles;
for (auto path : plugin_paths) {
  printf("load plugin %s\n", path.c_str());
  void* plugin_lib = dlopen(path.c_str(), RTLD_NOW);
  char* error = dlerror();
  if (error != NULL) {
    fprintf(stderr, "dlopen %s fail: %s.\nPlease try to set 'export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:%s'\n",
        path.c_str(), error, plugin_dir.c_str());
    dlclose(plugin_lib);
    return -1;
  }
  printf("dlopen %s successfully!\n", path.c_str());
  get_custom_op_func custom_op_func = (get_custom_op_func)dlsym(plugin_lib, "get_rknn_custom_op");
  error = dlerror();
  if (error != NULL) {
    fprintf(stderr, "dlsym fail: %s\n", error);
    dlclose(plugin_lib);
    return -1;
  }

  rknn_custom_op* user_op = custom_op_func();
  ret = rknn_register_custom_ops(ctx, user_op, 1);
  if (ret < 0) {
    printf("rknn_register_custom_ops fail! ret = %d\n", ret);
    return -1;
  }
  so_handles.push_back(plugin_lib);
}
Замечания о библиотеке плагина:
Одна библиотека плагина регистрирует только один пользовательский оператор. Для нескольких операторов создайте несколько библиотек.
Имя библиотеки должно начинаться с librkcst_ и заканчиваться .so.
Для плагина на C++ добавьте следующие макросы до и после определения функции, чтобы C-интерфейс правильно открывал ее символы:
#ifdef __cplusplus
extern "C" {
#endif

//code

#ifdef __cplusplus
} // extern "C"
#endif
Если dlopen не загружает библиотеку, проверьте LD_LIBRARY_PATH и наличие каталога плагина в указанном пути.
5.6 Работа с несколькими batch
5.6.1 Принцип Multi-Batch
NPU RK3588 содержит три ядра, RK3576 — два. Для эффективного пакетного инференса предусмотрен Multi-Batch. При включении внутренне вызывается rknn_dup_context: копируется только Internal, а Weight используется совместно. При rknn_batch_size=2 выполняется одно копирование, при rknn_batch_size >=3 — два, поскольку одновременно работают только 3 ядра, а лишние копии расходовали бы память. core_mask каждого контекста устанавливается в 0 для автоматического распределения по ядрам. rknn_run() создает внутренний пул потоков; три потока одновременно выполняют три контекста.
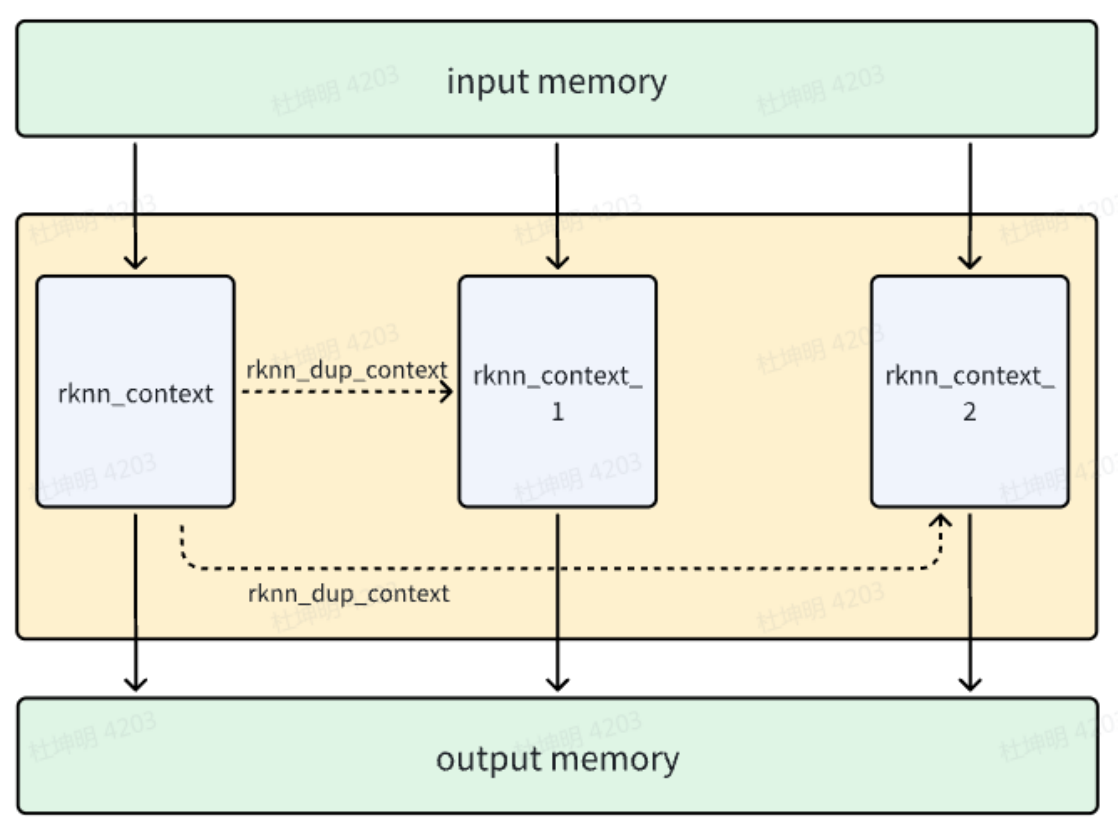
Рисунок 5-14. Внутренний принцип Multi-Batch
5.6.2 Использование Multi-Batch
Порядок использования Multi-Batch:
1. Включите Multi-Batch в Python:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', rknn_batch_size=3)
Для оптимальной производительности rknn_batch_size рекомендуется кратным 3 на RK3588 и кратным 2 на RK3576.
2. Рекомендуется интерфейс нулевого копирования.
5.6.3 Входы и выходы Multi-Batch
При включенном Multi-Batch запрошенные размеры входа и выхода в rknn_batch_size раз больше, чем без него. Каждый контекст вычисляет свое входное смещение, читает данные и выполняет инференс, затем вычисляет выходное смещение и записывает результат. Например, для второго batch входное смещение равно input_size/rknn_batch_size, выходное — output_size/rknn_batch_size.
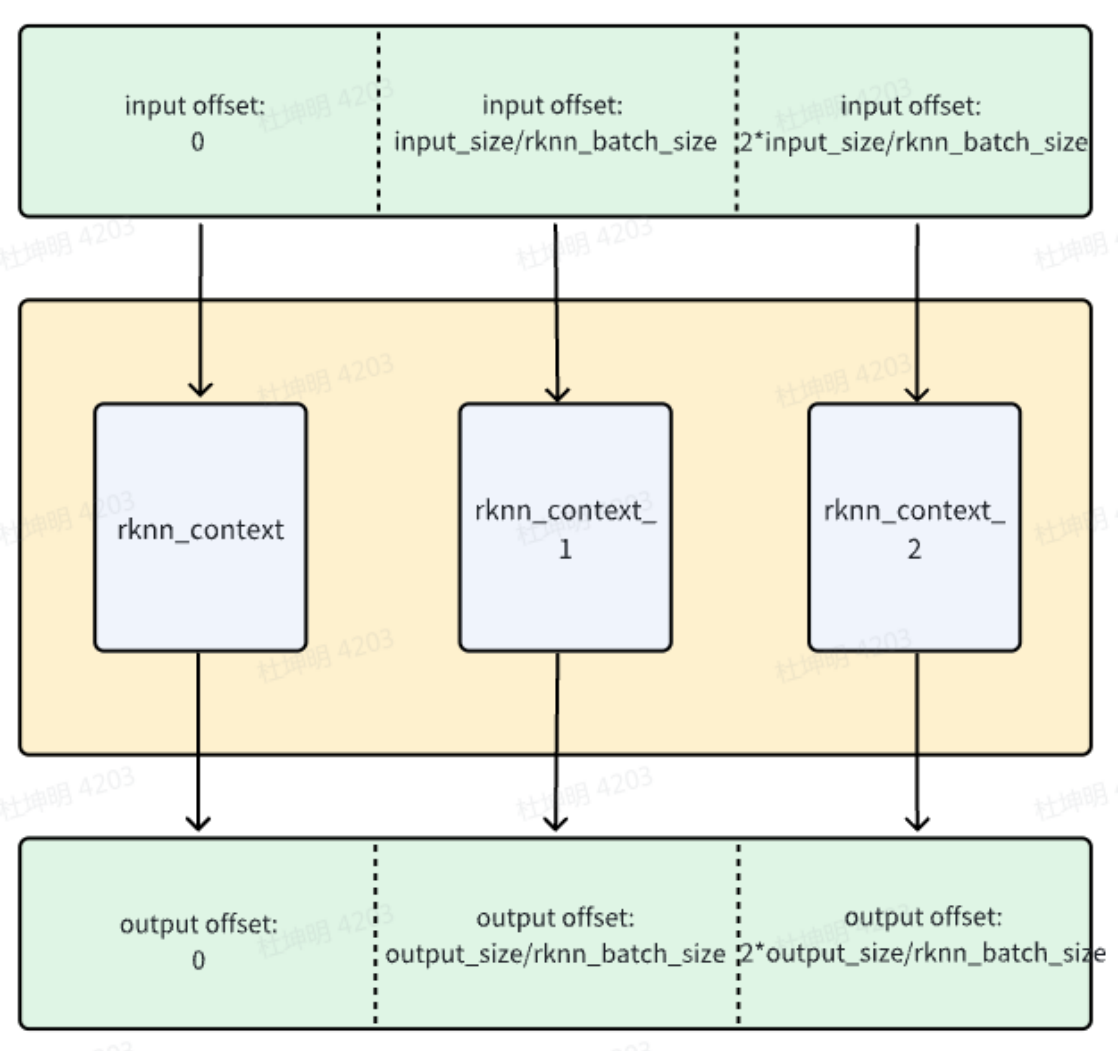
Рисунок 5-15. Внутренние смещения входа и выхода Multi-Batch
5.7 SRAM NPU RK3588/RK3576
RK3588 содержит 1MB SRAM, из которых 956KB доступны IP-блокам SoC и могут быть выделены RKNPU.
RK3576 содержит 512KB SRAM, из которых 480KB доступны IP-блокам SoC и могут быть выделены RKNPU.
SRAM снижает нагрузку RKNPU на пропускную способность DDR, но может влиять на время инференса.
5.7.1 Требования к среде RKNPU
5.7.1.1 Требования к ядру
Версия драйвера RKNPU >=0.8.0
В конфигурации ядра включите CONFIG_ROCKCHIP_RKNPU_SRAM=y.
Путь конфигурации Android:
<path-to-your-kernel>/arch/arm64/configs/rockchip_defconfig
Путь конфигурации Linux:
<path-to-your-kernel>/arch/arm64/configs/rockchip_linux_defconfig
В соответствующем DTS ядра выделите системную SRAM для RKNPU.
Выделите необходимый объем: максимум 956KB на RK3588 и 480KB на RK3576. Размер должен быть выровнен на 4K.
Примечание: SRAM по умолчанию может быть выделена другим IP-блокам, например кодеку. Области разных блоков не должны перекрываться, иначе одновременное чтение и запись повредят данные.
Пример выделения RKNPU 956KB на RK3588 и 480KB на RK3576:
RK3588:
syssram: sram@ff001000 {
  compatible = "mmio-sram";
  reg = <0x0 0xff001000 0x0 0xef000>;

  #address-cells = <1>;
  #size-cells = <1>;
  ranges = <0x0 0x0 0xff001000 0xef000>;
  /* Allocate RKNPU SRAM /
  / start address and size should be 4k algin */
  rknpu_sram: rknpu_sram@0 {
    reg = <0x0 0xef000>; // 956KB
  };
};
Подключите выделенную SRAM к узлу RKNPU, изменив dtsi:
<path-to-your-kernel>/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
rknpu: npu@fdab0000 {
  compatible = "rockchip,rk3588-rknpu";
  /* ... /
  / Add reference RKNPU sram */
  rockchip,sram = <&rknpu_sram>;
  status = "disabled";
};
RK3576:
sram: sram@3ff88000 {
  compatible = "mmio-sram";
  reg = <0x0 0x3ff88000 0x0 0x78000>;

  #address-cells = <1>;
  #size-cells = <1>;
  ranges = <0x0 0x0 0x3ff88000 0x78000>;
  /* Allocate RKNPU SRAM /
  / start address and size should be 4k algin */
  rknpu_sram: rknpu-sram@0 {
      reg = <0x0 0x78000>; // 480KB
  };
};
Подключите выделенную SRAM к узлу RKNPU, изменив dtsi:
<path-to-your-kernel>/arch/arm64/boot/dts/rockchip/rk3576.dtsi
rknpu: npu@27700000 {
  compatible = "rockchip,rk3576-rknpu";
  /* ... /
  / Add reference RKNPU sram */
  rockchip,sram = <&rknpu_sram>;
  status = "disabled";
};
5.7.1.2 Требования к версии RKNN SDK
Версия RKNPU Runtime (librknnrt.so) >=1.6.0
5.7.2 Использование
Задайте RKNN_FLAG_ENABLE_SRAM в flags вызова rknn_init(), чтобы включить SRAM для контекста.
Например:
ret = rknn_init(&ctx, rknn_model, size, RKNN_FLAG_ENABLE_SRAM, NULL);
При RKNN_FLAG_ENABLE_SRAM из доступной системной SRAM выделяется максимально возможный объем для Internal Tensor модели.
Примечание:
Если участок SRAM занят одним контекстом rknn, другие контексты не могут повторно использовать его. RKNN_FLAG_SHARE_SRAM в rknn_api.h еще не реализован.
Если контекст не занимает всю SRAM, остаток доступен другим контекстам rknn.
5.7.3 Отладка
5.7.3.1 Проверка включения SRAM
Проверьте включение SRAM в загрузочном журнале ядра, где приведены диапазон адресов и размер SRAM для RKNPU:
rk3588_s:/ # dmesg | grep rknpu -i
RKNPU fdab0000.npu: RKNPU: sram region: [0x00000000ff001000, 0x00000000ff0f0000), sram size: 0xef000
5.7.3.2 Запрос использования SRAM
Использование SRAM можно запросить через узлы.
Битовая карта неиспользованной SRAM; каждая точка соответствует 4K:
rk3588_s:/ # cat /sys/kernel/debug/rknpu/mm
SRAM bitmap: "*" - used, "." - free (1bit = 4KB)
[000] [................................]
[001] [................................]
[002] [................................]
[003] [................................]
[004] [................................]
[005] [................................]
[006] [................................]
[007] [...............]
SRAM total size: 978944, used: 0, free: 978944
# Unit is Byte
Битовая карта после использования 512KB SRAM:
rk3588_s:/ # cat /sys/kernel/debug/rknpu/mm
SRAM bitmap: "*" - used, "." - free (1bit = 4KB)
[000] [********************************]
[001] [********************************]
[002] [********************************]
[003] [********************************]
[004] [................................]
[005] [................................]
[006] [................................]
[007] [...............]
SRAM total size: 978944, used: 524288, free: 454656
# Unit is Byte
5.7.3.3 Запрос размера SRAM через RKNN API
Запросите размер SRAM через RKNN_QUERY_MEM_SIZE интерфейса rknn_query().
typedef struct _rknn_mem_size {
  uint32_t total_weight_size;
  uint32_t total_internal_size;
  uint64_t total_dma_allocated_size;
  uint32_t total_sram_size;
  uint32_t free_sram_size;
  uint32_t reserved[10];
} rknn_mem_size;
total_sram_size — общий объем SRAM, выделенный системой для RKNPU, в байтах.
free_sram_size — оставшийся доступный объем SRAM для RKNPU, в байтах.
5.7.3.4 Запрос занятой моделью SRAM
До запуска приложения RKNN на устройстве задайте следующую переменную среды для вывода прогнозируемого использования SRAM:
export RKNN_LOG_LEVEL=3
Послойное использование SRAM, выделенной для Internal, показано в журнале:
---------------------------------------------------------------------------
Total allocated Internal SRAM Size: 524288, Addr: [0xff3e0000, 0xff460000)
---------------------------------------------------------------------------
---------------------------------------------------------------------+----------------------------------+-----------
ID User Tensor DataType OrigShape NativeShape | [Start End) Size | SramHit
---------------------------------------------------------------------+----------------------------------+-----------
1 ConvRelu input0 INT8 (1,3,224,224) (1,1,224,224,3) | 0xff3b0000 0xff3d4c00 0x00024c00 | \
2 ConvRelu output2 INT8 (1,32,112,112) (1,2,112,112,16) | 0xff404c00 0xff466c00 0x00062000 |
0x0005b400
3 ConvRelu output4 INT8 (1,32,112,112) (1,4,112,112,16) | 0xff466c00 0xff52ac00 0x000c4000 |
0x00000000
4 ConvRelu output6 INT8 (1,64,112,112) (1,4,112,112,16) | 0xff52ac00*0xff5eec00 0x000c4000 |
0x00000000
5 ConvRelu output8 INT8 (1,64,56,56) (1,4,56,56,16) | 0xff3e0000 0xff411000 0x00031000 |
0x00031000
6 ConvRelu output10 INT8 (1,128,56,56) (1,8,56,56,16) | 0xff411000 0xff473000 0x00062000 |
0x0004f000
7 ConvRelu output12 INT8 (1,128,56,56) (1,8,56,56,16) | 0xff473000 0xff4d5000 0x00062000 |
0x00000000
8 ConvRelu output14 INT8 (1,128,56,56) (1,8,56,56,16) | 0xff3e0000 0xff442000 0x00062000 |
0x00062000
9 ConvRelu output16 INT8 (1,128,28,28) (1,8,28,28,16) | 0xff442000 0xff45a800 0x00018800 |
0x00018800
10 ConvRelu output18 INT8 (1,256,28,28) (1,16,28,28,16) | 0xff3e0000 0xff411000 0x00031000 |
0x00031000
11 ConvRelu output20 INT8 (1,256,28,28) (1,16,28,28,16) | 0xff411000 0xff442000 0x00031000 |
0x00031000
12 ConvRelu output22 INT8 (1,256,28,28) (1,16,28,28,16) | 0xff3e0000 0xff411000 0x00031000 |
0x00031000
13 ConvRelu output24 INT8 (1,256,14,14) (1,16,14,14,16) | 0xff411000 0xff41d400 0x0000c400 |
0x0000c400
14 ConvRelu output26 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
15 ConvRelu output28 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
16 ConvRelu output30 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
17 ConvRelu output32 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
18 ConvRelu output34 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
19 ConvRelu output36 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
20 ConvRelu output38 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
21 ConvRelu output40 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
22 ConvRelu output42 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
23 ConvRelu output44 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
24 ConvRelu output46 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
25 ConvRelu output48 INT8 (1,512,7,7) (1,33,7,7,16) | 0xff3f8800 0xff3ff000 0x00006800 | 0x00006800
26 ConvRelu output50 INT8 (1,1024,7,7) (1,67,7,7,16) | 0xff3e0000 0xff3ed000 0x0000d000 |
0x0000d000
27 ConvRelu output52 INT8 (1,1024,7,7) (1,67,7,7,16) | 0xff3ed000 0xff3fa000 0x0000d000 |
0x0000d000
28 AveragePool output54 INT8 (1,1024,7,7) (1,67,7,7,16) | 0xff3e0000 0xff3ed000 0x0000d000 |
0x0000d000
29 Conv output55 INT8 (1,1024,1,1) (1,64,1,1,16) | 0xff3ed000 0xff3ed400 0x00000400 | 0x00000400
30 Softmax output56 INT8 (1,1000,1,1) (1,64,1,1,16) | 0xff3e0000 0xff3e0400 0x00000400 |
0x00000400
31 OutputOperator output57 FLOAT (1,1000,1,1) (1,1000,1,1) | 0xff3ae000 0xff3aefa0 0x00000fa0 | \
---------------------------------------------------------------------+----------------------------------+-----------
----------------------------------------
Total Weight Memory Size: 4260864
Total Internal Memory Size: 2157568
Predict Internal Memory RW Amount: 11068320
Predict Weight Memory RW Amount: 4260832
Predict SRAM Hit RW Amount: 6688768
----------------------------------------
SRAM Hit в таблице — объем SRAM тензора текущего слоя, то есть объем чтения/записи DDR, который экономится относительно режима без SRAM.
Predict SRAM Hit RW Amount — прогноз чтения и записи SRAM всей модели, показывающий экономию чтения/записи DDR на кадр относительно режима без SRAM.
Примечание: в Linux журнал направляется в терминал, в Android — в logcat.
5.8 Прореживание модели
Прореживание бывает с потерями и без потерь. RKNN-Toolkit2 использует вариант без потерь: размер модели и объем вычислений уменьшаются без снижения точности с плавающей точкой. Точность квантованной модели может даже улучшиться.
Без потерь прореживаются не все модели. Метод использует разреженность весов для удаления весов и каналов признаков, не влияющих на результат, уменьшая размер и вычисления. При model_pruning=True в rknn.config() модель автоматически прореживается при преобразовании согласно разреженности весов.
При успешном прореживании выводится результат:
I model_pruning results:

I Weight: -1.12145 MB (-6.9%)

I GFLOPs: -0.15563 (-13.4%)
Здесь удалено 1.12145 MB весов, то есть 6.9%, а объем вычислений уменьшен на 0.15563 GFLOPs, то есть 13.4%.
При недостаточной разреженности обработка не выполняется и сообщение не выводится. Поэтому эта настройка не мешает обычному преобразованию модели.
5.9 Шифрование модели
Шифрование — дополнительная обработка после создания RKNN. Структуру модели, экспортированной rknn.export_rknn(), можно просмотреть сторонними инструментами, например Netron. После шифрования Netron и подобные инструменты не смогут просматривать структуру и получать веса, что защищает модель. Зашифрованная модель используется так же, как незашифрованная; изменения инференса на RKNPU не нужны. Защита паролем в оригинале рассматривается как будущая возможность.
Использование:
# Create RKNN object
rknn = RKNN()
# Export encrypted RKNN model
crypt_level= 1
ret = rknn.export_encrypted_rknn_model("input.rknn", "encrypt.rknn", crypt_level)
if ret != 0:
  print('Encrypt RKNN model failed!')
crypt_level задает уровень 1, 2 или 3; по умолчанию 1. Чем выше уровень, тем выше защищенность и больше время расшифровки, и наоборот.
Поддерживаемые платформы: RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B.
5.10 Согласованность кэшируемой памяти
Если CPU и NPU обращаются к одной кэшируемой памяти, CPU сохраняет данные в кэше. Несогласованность данных DDR, читаемых NPU, с кэшем CPU вызывает ошибки чтения. Поэтому интерфейс обновления кэша должен обеспечивать согласованность данных CPU и NPU. Здесь описаны направление синхронизации и использование rknn_mem_sync.
5.10.1 Направление синхронизации кэшируемой памяти
После записи CPU перед доступом NPU данные кэша CPU должны быть синхронизированы в DDR: направление CPU→NPU. После записи NPU перед чтением CPU нужно обеспечить согласованность DDR и кэша CPU: направление NPU→CPU. RKNN C API предоставляет перечисление rknn_mem_sync_mode для выбора направления. Структура:
/*
  The mode to sync cacheable rknn memory.
*/
typedef enum _rknn_mem_sync_mode {
RKNN_MEMORY_SYNC_TO_DEVICE = 0x1, /* the mode used for consistency of device access after CPU accesses
data. */
RKNN_MEMORY_SYNC_FROM_DEVICE = 0x2, /* the mode used for consistency of CPU access after device
accesses data. */
RKNN_MEMORY_SYNC_BIDIRECTIONAL =
  RKNN_MEMORY_SYNC_TO_DEVICE | RKNN_MEMORY_SYNC_FROM_DEVICE, /* the mode used for
consistency of data access
between device and CPU in both directions. */
} rknn_mem_sync_mode;
RKNN_MEMORY_SYNC_TO_DEVICE: синхронизация от CPU к NPU.
RKNN_MEMORY_SYNC_FROM_DEVICE: синхронизация от NPU к CPU.
RKNN_MEMORY_SYNC_BIDIRECTIONAL: двунаправленная синхронизация NPU и CPU. Используется, если направление данных неизвестно.
Если направление известно, рекомендуется однонаправленное обновление кэша CPU, чтобы избежать потерь производительности от лишних операций.
5.10.2 Синхронизация кэшируемой памяти
Определив направление, синхронизируйте память через rknn_mem_sync. Форма интерфейса:
int rknn_mem_sync(rknn_context context, rknn_tensor_mem* mem, rknn_mem_sync_mode mode);
Здесь context — контекст (на платформах, отличных от RV1103/RV1103B/RV1106/RV1106B, по умолчанию NULL), mem — указатель типа rknn_tensor_mem*, возвращаемый rknn_create_mem, а mode задаёт направление синхронизации данных.
5.11 Разреженный инференс модели
Эта функция автоматически разреживает веса модели Torch при обучении и использует RKNN для разреженного инференса, сокращая время выполнения. В настоящее время поддерживается только RK3576.
5.11.1 Принцип разреживания
При обучении выбранные веса обнуляются по заданному пользователем правилу. Предусмотрены разреживание 4:2 по входному направлению, 4:2 по выходному направлению, 16:4 по направлениям вход–выход и 16:4 по направлениям выход–вход. Принцип 4:2 по входному направлению показан на рисунке 5-16: из четырёх последовательных весов вдоль входного направления два обнуляются. Если размер по указанному направлению не кратен 4, выполняется дополнение. Для действия разреживания число каналов весов должно превышать 32.
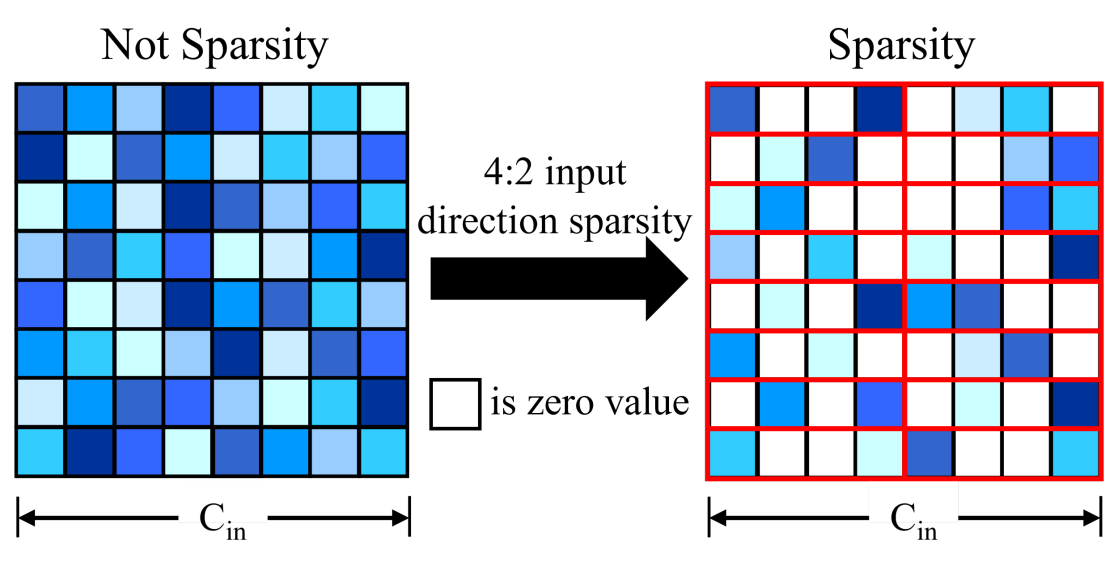
Рисунок 5-16. Принцип разреживания 4:2 по входному направлению
Четыре типа разреживания весов описаны в таблице 5-10. Входное и выходное направления относятся к весам. Например, форма весов двумерной свёртки — C_out × C_in × K_h × K_w; входное направление — C_in, выходное — C_out. При разреженности 75% исходная предобученная модель может быть как плотной, так и разреженной. Для уменьшения потери точности рекомендуется использовать предобученную модель с разреживанием 4:2 по входному или выходному направлению.
Таблица 5-10. Способы разреживания весов модели
| Метод разреживания | Степень разреженности | Описание |
|---|---|---|
| Разреживание 4:2 по входному направлению | 50% | Разреживание весов по входному направлению |
| Разреживание 4:2 по выходному направлению | 50% | Разреживание весов по выходному направлению |
| Разреживание 16:4 по входному, затем выходному направлению | 75% | Сначала разреживание 4:2 по входному, затем 4:2 по выходному направлению |
| Разреживание 16:4 по выходному, затем входному направлению | 75% | Сначала разреживание 4:2 по выходному, затем 4:2 по входному направлению |
5.11.2 Обучение разреженной модели
1. Убедитесь, что cuda доступна, и установите пакет autosparsity.
pip install autosparsity-1.0-cp38-cp38m-linux_x86_64.whl
Пакет установки autosparsity находится по адресу https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/packages
2. Пример автоматического разреживания 4:2 по входному направлению для resnet50 из torchvision:
import torch
import torchvision.models as models
from autosparsity.sparsity import sparsity_model

if __name__ == "__main__":
  model = models.resnet50(pretrained=True).cuda()
  optimizer = None
  mode = 0
  sparsity_model(model, optimizer, mode)
  model.eval()
  x = torch.randn((1,3,224,224)).cuda()
  torch.onnx.export(
  model, x, 'resnet50.onnx', input_names=['inputs'], output_names=['outputs']
  )
Для разреживания собственной модели достаточно добавить вызов sparsity_model перед обучением. Пример:
# insert model autosparsity code before training
import torch
import torchvision.models as models
from autosparsity.sparsity import sparsity_model

...

model = models.resnet34(pretrained=True).cuda()
mode = 0
sparsity_model(model, optimizer, mode)

# normal training
x, y = DataLoader(args)
for epoch in range(epochs):
  y_pred = model(x)
  loss = loss_func(y_pred, y)
  loss.backward()
  optimizer.step()
  ...
Примечание: обучение с разреживанием опирается на уже обученную исходную модель. Поэтому сначала обучите модель с хорошим результатом, а затем выполните разреженное обучение на её основе.
Параметры функции sparsity_model:
Таблица 5-11. Параметры функции sparsity_model
| Параметры | Описание |
|---|---|
| model | Исходная обученная модель |
| optimizer | Исходный оптимизатор; по умолчанию None |
| mode | Метод разреживания; значения 0, 1, 2, 3, по умолчанию 0. 0: разреживание 4:2 по входному направлению (50%); 1: разреживание 4:2 по выходному направлению (50%); 2: разреживание 16:4 по входному, затем выходному направлению (75%); 3: разреживание 16:4 по выходному, затем входному направлению (75%). |
| verbose | Уровень журналирования: 0, 1, 2; по умолчанию 2. 0: ошибки; 1: ошибки и предупреждения; 2: ошибки, предупреждения и информация. |
| whitelist | Список модулей, поддерживающих разреживание: 1d conv, 2d conv, 3d conv, linear, MultiheadAttention. По умолчанию [torch.nn.Linear, torch.nn.Conv2d]. |
| allowed_layer_names | Имена слоёв, которым разрешено разреживание. Если пользователь задаёт параметр, разреживаются только разрешённые слои. По умолчанию None. |
| disallowed_layer_names | Имена слоёв, для которых разреживание запрещено. Указанные пользователем слои пропускаются. По умолчанию []. |
| fast | True включает быстрый метод вычисления маски; по умолчанию False. Стандартный метод расчёта маски может не работать для некоторых моделей; при ошибке разреживания попробуйте True. |
5.11.3 Использование разреженного инференса RKNN
Разреженный инференс включается параметром sparse_infer интерфейса config() в RKNN-Toolkit2. Значения — True/False, по умолчанию False. Пример включения:
rknn.config(target_platform=’rk3576’, sparse_infer=True)
Полный пример Python: https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/examples
Для развёртывания через C API сначала в RKNN-Toolkit2 задайте sparse_infer=True в config() и создайте RKNN-модель с разреженным инференсом. Затем используйте обычную последовательность общего API или интерфейса нулевого копирования.
При инференсе Python задайте verbose=True при создании объекта RKNN, чтобы вывести разреженность каждого слоя. При использовании C API установите переменную среды RKNN_LOG_LEVEL=4. Примеры журналов:
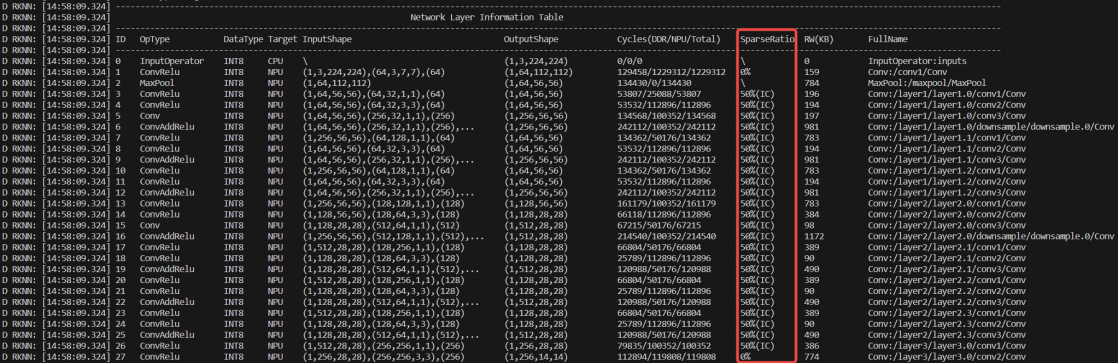
| Log prefix | ID | OpType | DataType | Target | InputShape | OutputShape | Cycles(DDR/NPU/Total) | SparseRatio | RW(KB) | FullName |
|---|---|---|---|---|---|---|---|---|---|---|
| D RKNN: [14:58:09.324] | 0 | InputOperator | INT8 | CPU | \ | (1,3,224,224) | 0/0/0 | \ | 0 | InputOperator:inputs |
| D RKNN: [14:58:09.324] | 1 | ConvRelu | INT8 | NPU | (1,3,224,224),(64,3,7,7),(64) | (1,64,112,112) | 129458/1229312/1229312 | 0% | 159 | Conv:/conv1/Conv |
| D RKNN: [14:58:09.324] | 2 | MaxPool | INT8 | NPU | (1,64,112,112) | (1,64,56,56) | 134430/0/134430 | \ | 784 | MaxPool:/maxpool/MaxPool |
| D RKNN: [14:58:09.324] | 3 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,1,1),(64) | (1,64,56,56) | 53807/25088/53807 | 50%(IC) | 196 | Conv:/layer1/layer1.0/conv1/Conv |
| D RKNN: [14:58:09.324] | 4 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 53532/112896/112896 | 50%(IC) | 194 | Conv:/layer1/layer1.0/conv2/Conv |
| D RKNN: [14:58:09.324] | 5 | Conv | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256) | (1,256,56,56) | 134568/100352/134568 | 50%(IC) | 197 | Conv:/layer1/layer1.0/conv3/Conv |
| D RKNN: [14:58:09.324] | 6 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 242112/100352/242112 | 50%(IC) | 981 | Conv:/layer1/layer1.0/downsample/downsample.0/Conv |
| D RKNN: [14:58:09.324] | 7 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 134362/50176/134362 | 50%(IC) | 783 | Conv:/layer1/layer1.1/conv1/Conv |
| D RKNN: [14:58:09.324] | 8 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 53532/112896/112896 | 50%(IC) | 194 | Conv:/layer1/layer1.1/conv2/Conv |
| D RKNN: [14:58:09.324] | 9 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 242112/100352/242112 | 50%(IC) | 981 | Conv:/layer1/layer1.1/conv3/Conv |
| D RKNN: [14:58:09.324] | 10 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 134362/50176/134362 | 50%(IC) | 783 | Conv:/layer1/layer1.2/conv1/Conv |
| D RKNN: [14:58:09.324] | 11 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 53532/112896/112896 | 50%(IC) | 194 | Conv:/layer1/layer1.2/conv2/Conv |
| D RKNN: [14:58:09.324] | 12 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 242112/100352/242112 | 50%(IC) | 981 | Conv:/layer1/layer1.2/conv3/Conv |
| D RKNN: [14:58:09.324] | 13 | ConvRelu | INT8 | NPU | (1,256,56,56),(128,128,1,1),(128) | (1,128,56,56) | 161179/100352/161179 | 50%(IC) | 783 | Conv:/layer2/layer2.0/conv1/Conv |
| D RKNN: [14:58:09.324] | 14 | ConvRelu | INT8 | NPU | (1,128,56,56),(128,64,3,3),(128) | (1,128,28,28) | 66118/112896/112896 | 50%(IC) | 384 | Conv:/layer2/layer2.0/conv2/Conv |
| D RKNN: [14:58:09.324] | 15 | Conv | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512) | (1,512,28,28) | 67215/50176/67215 | 50%(IC) | 98 | Conv:/layer2/layer2.0/conv3/Conv |
| D RKNN: [14:58:09.324] | 16 | ConvAddRelu | INT8 | NPU | (1,256,56,56),(512,128,1,1),(512),… | (1,512,28,28) | 214540/100352/214540 | 50%(IC) | 1172 | Conv:/layer2/layer2.0/downsample/downsample.0/Conv |
| D RKNN: [14:58:09.324] | 17 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 66804/50176/66804 | 50%(IC) | 389 | Conv:/layer2/layer2.1/conv1/Conv |
| D RKNN: [14:58:09.324] | 18 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 25789/112896/112896 | 50%(IC) | 90 | Conv:/layer2/layer2.1/conv2/Conv |
| D RKNN: [14:58:09.324] | 19 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 120988/50176/120988 | 50%(IC) | 490 | Conv:/layer2/layer2.1/conv3/Conv |
| D RKNN: [14:58:09.324] | 20 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 66804/50176/66804 | 50%(IC) | 389 | Conv:/layer2/layer2.2/conv1/Conv |
| D RKNN: [14:58:09.324] | 21 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 25789/112896/112896 | 50%(IC) | 90 | Conv:/layer2/layer2.2/conv2/Conv |
| D RKNN: [14:58:09.324] | 22 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 120988/50176/120988 | 50%(IC) | 490 | Conv:/layer2/layer2.2/conv3/Conv |
| D RKNN: [14:58:09.324] | 23 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 66804/50176/66804 | 50%(IC) | 389 | Conv:/layer2/layer2.3/conv1/Conv |
| D RKNN: [14:58:09.324] | 24 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 25789/112896/112896 | 50%(IC) | 90 | Conv:/layer2/layer2.3/conv2/Conv |
| D RKNN: [14:58:09.324] | 25 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 120988/50176/120988 | 50%(IC) | 490 | Conv:/layer2/layer2.3/conv3/Conv |
| D RKNN: [14:58:09.324] | 26 | ConvRelu | INT8 | NPU | (1,512,28,28),(256,256,1,1),(256) | (1,256,28,28) | 79835/100352/100352 | 50%(IC) | 386 | Conv:/layer3/layer3.0/conv1/Conv |
| D RKNN: [14:58:09.324] | 27 | ConvRelu | INT8 | NPU | (1,256,28,28),(256,256,3,3),(256) | (1,256,14,14) | 112894/119808/119808 | 0% | 774 | Conv:/layer3/layer3.0/conv2/Conv |
Рисунок 5-17. Журнал Python для разреживания 4:2 по входному направлению
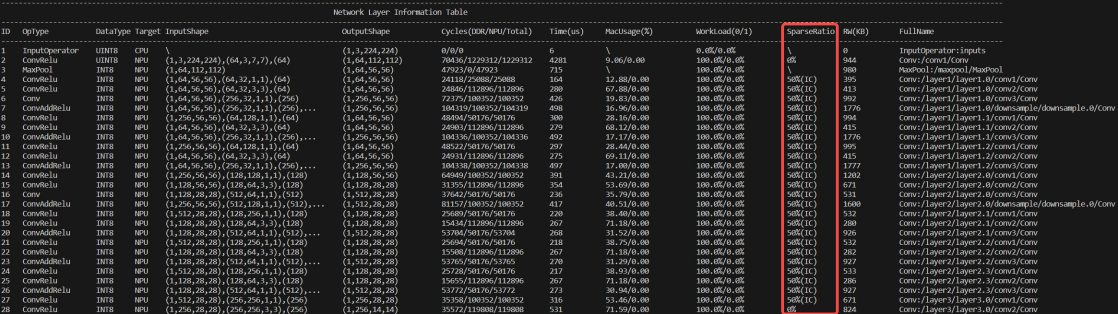
| ID | OpType | DataType | Target | InputShape | OutputShape | Cycles(DDR/NPU/Total) | Time(us) | MacUsage(%) | WorkLoad(0/1) | SparseRatio | RW(KB) | FullName |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | InputOperator | UINT8 | CPU | \ | (1,3,224,224) | 0/0/0 | 6 | \ | 0.0%/0.0% | \ | 0 | InputOperator:inputs |
| 2 | ConvRelu | INT8 | NPU | (1,3,224,224),(64,3,7,7),(64) | (1,64,112,112) | 70436/1229312/1229312 | 4281 | 9.06/0.00 | 100.0%/0.0% | 0% | 944 | Conv:/conv1/Conv |
| 3 | MaxPool | INT8 | NPU | (1,64,112,112) | (1,64,56,56) | 47923/0/47923 | 715 | \ | 100.0%/0.0% | \ | 980 | MaxPool:/maxpool/MaxPool |
| 4 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,1,1),(64) | (1,64,56,56) | 24118/25088/25088 | 164 | 12.88/0.00 | 100.0%/0.0% | 50%(IC) | 395 | Conv:/layer1/layer1.0/conv1/Conv |
| 5 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 24846/112896/112896 | 280 | 67.88/0.00 | 100.0%/0.0% | 50%(IC) | 413 | Conv:/layer1/layer1.0/conv2/Conv |
| 6 | Conv | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256) | (1,256,56,56) | 72375/100352/100352 | 426 | 19.83/0.00 | 100.0%/0.0% | 50%(IC) | 992 | Conv:/layer1/layer1.0/conv3/Conv |
| 7 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 104319/100352/104319 | 498 | 16.96/0.00 | 100.0%/0.0% | 50%(IC) | 1776 | Conv:/layer1/layer1.0/downsample/downsample.0/Conv |
| 8 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 48494/50176/50176 | 300 | 28.16/0.00 | 100.0%/0.0% | 50%(IC) | 994 | Conv:/layer1/layer1.1/conv1/Conv |
| 9 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 24903/112896/112896 | 279 | 68.12/0.00 | 100.0%/0.0% | 50%(IC) | 415 | Conv:/layer1/layer1.1/conv2/Conv |
| 10 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 104336/100352/104336 | 492 | 17.17/0.00 | 100.0%/0.0% | 50%(IC) | 1776 | Conv:/layer1/layer1.1/conv3/Conv |
| 11 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 48522/50176/50176 | 297 | 28.44/0.00 | 100.0%/0.0% | 50%(IC) | 995 | Conv:/layer1/layer1.2/conv1/Conv |
| 12 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 24931/112896/112896 | 275 | 69.11/0.00 | 100.0%/0.0% | 50%(IC) | 415 | Conv:/layer1/layer1.2/conv2/Conv |
| 13 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 104338/100352/104338 | 497 | 17.00/0.00 | 100.0%/0.0% | 50%(IC) | 1777 | Conv:/layer1/layer1.2/conv3/Conv |
| 14 | ConvRelu | INT8 | NPU | (1,256,56,56),(128,128,1,1),(128) | (1,128,56,56) | 64949/100352/100352 | 391 | 43.21/0.00 | 100.0%/0.0% | 50%(IC) | 1202 | Conv:/layer2/layer2.0/conv1/Conv |
| 15 | ConvRelu | INT8 | NPU | (1,128,56,56),(128,64,3,3),(128) | (1,128,28,28) | 31355/112896/112896 | 354 | 53.69/0.00 | 100.0%/0.0% | 50%(IC) | 671 | Conv:/layer2/layer2.0/conv2/Conv |
| 16 | Conv | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512) | (1,512,28,28) | 37642/50176/50176 | 236 | 35.79/0.00 | 100.0%/0.0% | 50%(IC) | 531 | Conv:/layer2/layer2.0/conv3/Conv |
| 17 | ConvAddRelu | INT8 | NPU | (1,256,56,56),(512,128,1,1),(512),… | (1,512,28,28) | 81157/100352/100352 | 417 | 40.51/0.00 | 100.0%/0.0% | 50%(IC) | 1600 | Conv:/layer2/layer2.0/downsample/downsample.0/Conv |
| 18 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 25689/50176/50176 | 220 | 38.40/0.00 | 100.0%/0.0% | 50%(IC) | 532 | Conv:/layer2/layer2.1/conv1/Conv |
| 19 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 15434/112896/112896 | 267 | 71.18/0.00 | 100.0%/0.0% | 50%(IC) | 280 | Conv:/layer2/layer2.1/conv2/Conv |
| 20 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 53704/50176/53704 | 268 | 31.52/0.00 | 100.0%/0.0% | 50%(IC) | 926 | Conv:/layer2/layer2.1/conv3/Conv |
| 21 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 25694/50176/50176 | 218 | 38.75/0.00 | 100.0%/0.0% | 50%(IC) | 532 | Conv:/layer2/layer2.2/conv1/Conv |
| 22 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 15508/112896/112896 | 267 | 71.18/0.00 | 100.0%/0.0% | 50%(IC) | 282 | Conv:/layer2/layer2.2/conv2/Conv |
| 23 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 53765/50176/53765 | 270 | 31.29/0.00 | 100.0%/0.0% | 50%(IC) | 927 | Conv:/layer2/layer2.2/conv3/Conv |
| 24 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 25728/50176/50176 | 217 | 38.93/0.00 | 100.0%/0.0% | 50%(IC) | 533 | Conv:/layer2/layer2.3/conv1/Conv |
| 25 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 15655/112896/112896 | 267 | 71.18/0.00 | 100.0%/0.0% | 50%(IC) | 286 | Conv:/layer2/layer2.3/conv2/Conv |
| 26 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 53772/50176/53772 | 273 | 30.94/0.00 | 100.0%/0.0% | 50%(IC) | 927 | Conv:/layer2/layer2.3/conv3/Conv |
| 27 | ConvRelu | INT8 | NPU | (1,512,28,28),(256,256,1,1),(256) | (1,256,28,28) | 35358/100352/100352 | 316 | 53.46/0.00 | 100.0%/0.0% | 50%(IC) | 671 | Conv:/layer3/layer3.0/conv1/Conv |
| 28 | ConvRelu | INT8 | NPU | (1,256,28,28),(256,256,3,3),(256) | (1,256,14,14) | 35572/119808/119808 | 531 | 71.59/0.00 | 100.0%/0.0% | 0% | 824 | Conv:/layer3/layer3.0/conv2/Conv |
Рисунок 5-18. Журнал C API для разреживания 4:2 по входному направлению
Поле SparseRation обозначает степень разреженности: 4:2 по входному направлению соответствует 50%(IC), 4:2 по выходному — 50%(OC), оба варианта 16:4 (вход–выход и выход–вход) — 75%. Значение 0% означает отсутствие разреживания. Написание SparseRation сохранено из оригинала.
5.11.4 Ограничения разреженного инференса RKNN
Разреженный инференс реализован аппаратной архитектурой NPU. Из-за аппаратных ограничений RK3576 сейчас поддерживает только 2d Conv с group=1. Остальные ограничения приведены ниже.
Таблица 5-12. Ограничения разреженного инференса RK3576
| Число каналов | Тип данных | |
|---|---|---|
| Разреживание 4:2 по входному направлению | Вход и выход выровнены по 32 | Int8; Float16 не поддерживается |
| Разреживание 4:2 по выходному направлению | Вход и выход выровнены по 32 | Int8; Float16 не поддерживается |
| Разреживание 16:4 по входному, затем выходному направлению | Вход и выход выровнены по 32 | Int8; Float16 не поддерживается |
| Разреживание 16:4 по выходному, затем входному направлению | Вход и выход выровнены по 32 | Int8; Float16 не поддерживается |
5.12 Codegen
В RKNN-Toolkit2 2.0.0 добавлен интерфейс Codegen для генерации кода развёртывания модели и упрощения начала работы. Он построен поверх CAPI с нулевым копированием; стиль интерфейса соответствует примерам RKNN_Model_Zoo. Сгенерированный код позволяет непосредственно измерять производительность и проверять точность инференса, а также служит основой для собственной разработки.
Пример использования:
ret = rknn.codegen(output_path='./rknn_app_demo',
          inputs=['../../caffe/mobilenet_v2/dog_224x224.jpg'], overwrite=True)
Перед codegen необходимо вызвать rknn.export для сохранения RKNN-модели. Имя rknn.export сохранено из текста оригинала.
output_path задаёт каталог вывода; его имя выбирает пользователь.
Inputs содержит список путей входных данных модели и может быть пустым. Поддерживаются jpg/png/npy. Для npy размерности данных должны соответствовать размерностям входа модели.
При overwrite=True файлы в каталоге output_path перезаписываются. Значение по умолчанию — False.
Для компиляции и тестирования сгенерированного кода следуйте README.md в созданном каталоге.
Если inputs содержит допустимые данные, пример после инференса оценивает различия результатов CAPI и симулятора RKNN-Toolkit2, сравнивая косинусное сходство каждого выхода.
Ограничений по аппаратной платформе NPU нет; на плате требуется Linux или Android.
Поддерживаются квантованные и неквантованные модели.
5.13 Редактирование ONNX
После преобразования некоторых моделей в RKNN могут оставаться лишние операции, обычно reshape и transpose у входов и выходов, снижающие производительность. Интерфейс onnx_edit в RKNN-Toolkit2 изменяет определения входных и выходных размерностей ONNX-модели, чтобы при последующем преобразовании получить более производительную RKNN-модель с меньшим числом лишних reshape и transpose.
5.13.1 Описание интерфейса
Пример использования:
from rknn.utils import onnx_edit
ret = onnx_edit(model = './concat_block.onnx',
  export_path = './concat_block_edited.onnx',
  inputs_transform = {'k_in': 'a,b,c,d->1,ad,b,c'},
  outputs_transform = {'k_cache': 'a,b,c,d->1,ab,c,d'},
  dataset = './dataset.txt'
)
Model задаёт изменяемую модель; обязательный параметр.
Export_path задаёт путь создаваемой модели; обязательный параметр.
Inputs_transform — словарь формул преобразования входов: ключ — имя узла, значение — формула. Необязательный параметр, по умолчанию пустой словарь.
Outputs_transform — словарь формул преобразования выходов. Необязательный параметр, по умолчанию пустой словарь.
Dataset задаёт файл со списком путей входных данных, в том же формате, что dataset у rknn.build. Если он указан, onnx_edit изменяет не только определения входов и выходов, но и соответствующие данные набора, создавая новый набор на одном уровне каталога с export_path. Его можно использовать для проверки и квантования новой модели. Параметр необязателен, по умолчанию пуст.
5.13.2 Формулы преобразования
В inputs_transform и outputs_transform интерфейса onnx_edit задаются формулы, по синтаксису похожие на оператор einsum. Например, ‘a,b,c,d->1,ad,b,c’ преобразует исходные размерности ‘a,b,c,d’ в ‘1,ad,b,c’. Правила записи:
Формула состоит из двух частей, разделённых ‘->’: слева исходная символьная форма, справа преобразованная.
Допустимы только символы [a-z], ‘,’ и ‘1’. Другие цифры не поддерживаются, поскольку одинаковые числовые символы не позволяют определить контекст transpose.
Символы [a-z] независимы и не имеют порядка: ‘a,b->b,a’ и ‘c,a->a,c’ обозначают одно преобразование.
Исходная форма слева разделяется запятыми на n частей; n должно соответствовать числу измерений модели. Для входа [32,4,1,64] допустимы ‘a,b,c,d’ или ‘a,b,1,d’.
Каждый исходный символ, кроме ‘1’, должен присутствовать в преобразованной форме. Например, ‘a,1,c,d->ac,d,1’ допустимо, а ‘a,1,c,d->ac,1’ — нет: отсутствует ‘d’.
В преобразованную форму можно вставить любое число ‘1’ для добавления измерений, например ‘a,b,c-> a,1,cb,1,1’.
Для разбиения измерения исходная форма допускает несколько букв и присваивания. Например, при входе [32,4,1,64] формула ‘ab,c,d,qk[a=2,k =8]->aq,cd,1,kb’ разбивает 32 на 2x16 и 64 на 8x8, затем выполняет transpose и reshape. Часть ‘[ ]’ содержит присваивания, разделённые запятыми. Некоторые значения можно не задавать: они выводятся автоматически. Если a=2 и из модели известно ab=32, выводится b=16. Недопустимая полученная размерность вызывает ошибку: при ab=32 и a=5 получается b=6.4, но размерность должна быть целым числом.
5.13.3 Примеры формул преобразования
Преобразование 3-мерного входа в 4-мерный: ‘a,b,c->a,b,1,c’
Преобразование 5-мерного входа в 4-мерный: ‘a,b,c,d,e->ab,c,d,e’
Операция transpose(0,3,1,2): ‘a,b,c,d->a,d,b,c’
Перестановка и объединение измерений: ‘a,b,c,d->d,acb,1’
Разбиение, перестановка и объединение измерений: ‘a,bc,de,f[b=2,d=4]->ab,fe,dc,1’
6 Введение в квантование
6.1 Основы квантования
6.1.1 Определение квантования
Квантование модели — преобразование параметров и операций модели глубокого обучения с плавающей точкой в представление с фиксированной точкой, например из FLOAT32 в INT8. Оно уменьшает потребление памяти, сжимает модель и ускоряет инференс, но может приводить к некоторой потере точности.
6.1.2 Принцип вычислений при квантовании
На примере линейного асимметричного квантования преобразование чисел с плавающей точкой в знаковые числа с фиксированной точкой рассчитывается следующим образом:
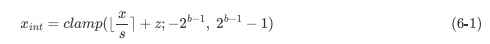
x_int = clamp(round(x / s) + z; -2^(b-1), 2^(b-1) - 1)
Здесь x — число с плавающей точкой, x_int — квантованное число с фиксированной точкой, round(·) — округление, s — масштаб квантования, z — нулевая точка, b — разрядность квантования, например 8 для INT8. clamp — операция ограничения диапазона, определяемая следующим образом:
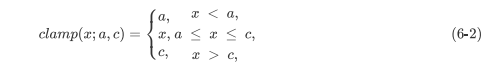
clamp(x; a, c) = a, if x < a
                 x, if a <= x <= c
                 c, if x > c
Преобразование чисел с фиксированной точкой в числа с плавающей точкой называется деквантованием и определяется следующим образом:

x ≈ x_hat = s (x_int - z)
Для заданного диапазона квантования (q_min) и диапазона ограничения (c_min) параметры s и z рассчитываются по следующим формулам:
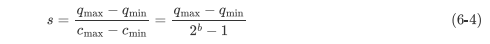
s = (q_max - q_min) / (c_max - c_min) = (q_max - q_min) / (2^b - 1)
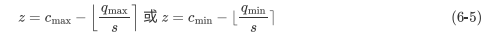
z = c_max - round(q_max / s) OR z = c_min - round(q_min / s)
Диапазон ограничения определяется типом данных квантования: например, для INT8 он составляет (-128, 127). Диапазон квантования определяется выбранным алгоритмом; подробности см. в разделе 6.1.6 «Алгоритмы квантования».
6.1.3 Ошибка квантования
Квантование вносит определённую потерю точности. Согласно (6-1), ошибка состоит из ошибки округления и ошибки ограничения, то есть операций round(·) и clamp. Ошибка округления лежит в диапазоне (−s/2, s/2). Если число x слишком велико, а масштаб s слишком мал, квантованное число может выйти за диапазон ограничения, вызывая ошибку ограничения. Теоретически увеличение s уменьшает ошибку ограничения, но увеличивает ошибку округления. Поэтому для баланса этих ошибок нужно выбирать подходящие масштаб и нулевую точку, минимизирующие ошибку квантования.
6.1.4 Линейное симметричное и линейное асимметричное квантование
При линейном квантовании интервалы между числами с фиксированной точкой одинаковы. Например, линейное квантование INT8 равномерно делит диапазон на 256 чисел. При симметричном квантовании нулевая точка определяется типом данных и находится в центре симметрии диапазона квантованных чисел; например, для INT8 она равна 0. При асимметричном квантовании нулевая точка вычисляется по (6-5) и обычно не совпадает с центром симметрии диапазона.
Симметричное квантование — упрощённый вариант асимметричного. Теоретически асимметричное квантование лучше обрабатывает неравномерные распределения данных, поэтому на практике оно широко применяется.
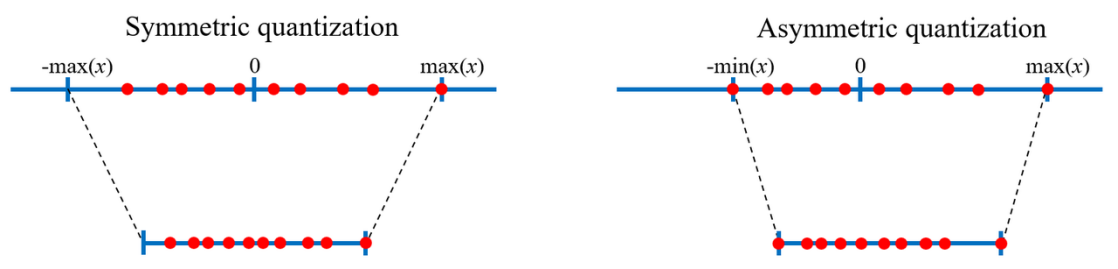
Рисунок 6-1 Линейное симметричное и асимметричное квантование
6.1.5 Послойное и поканальное квантование
Послойное квантование (Per-Layer) рассматривает все каналы слоя как одно целое с общими параметрами квантования. Поканальное квантование (Per-Channel) независимо квантует каждый канал слоя, используя его собственные параметры. Оно лучше сохраняет информацию каждого канала, учитывает различия каналов и даёт лучшие результаты квантования.
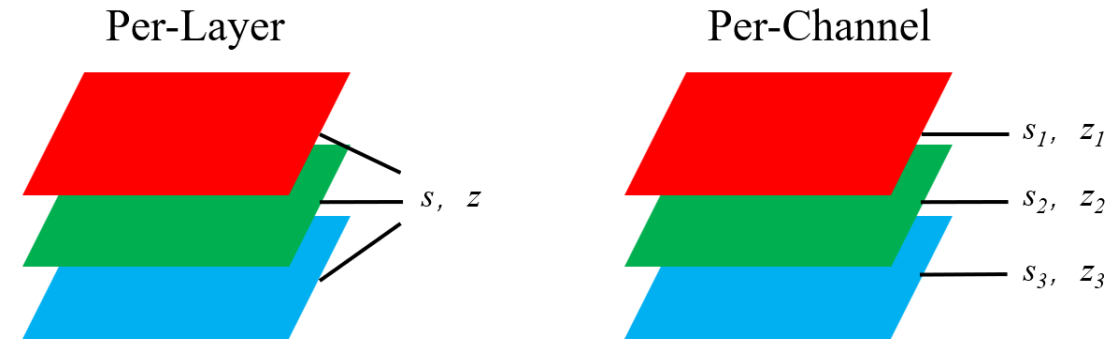
Рисунок 6-2 Послойное и поканальное квантование
Примечание: в RKNN-Toolkit2 поканальное квантование применяется только к весам; активации и промежуточные значения по-прежнему квантуются послойно.
6.1.6 Алгоритмы квантования
Масштаб и нулевая точка — ключевые параметры ошибки квантования; вычисление диапазона играет решающую роль в их определении. Здесь рассматриваются три алгоритма определения диапазона: Normal, KL-Divergence и MMSE.
Normal непосредственно задаёт границы диапазона по максимальному и минимальному значениям чисел с плавающей точкой. Из принципа в разделе 6.1.2 следует, что Normal не вносит ошибки ограничения, но чувствителен к выбросам: большие выбросы могут вызвать существенную ошибку округления.

q_min = min V

q_max = max V
Здесь V — тензор чисел с плавающей точкой.
KL-Divergence вычисляет распределения чисел с плавающей и фиксированной точкой, изменяет их различными порогами и выбирает границы диапазона, минимизируя KL-дивергенцию для максимального сходства распределений. Минимизация различия распределений позволяет лучше учитывать неравномерные данные и ослабляет влияние немногочисленных выбросов.

arg min_(q_min,q_max) H(Ψ(V), Ψ(V_int))
Здесь H(·) — формула KL-дивергенции, Ψ(·) — функция, преобразующая данные в дискретное распределение, а V_int — тензор квантованных чисел с фиксированной точкой.
MMSE (Minimum Mean Square Error) определяет границы диапазона, минимизируя среднеквадратичную ошибку между исходными числами с плавающей точкой и результатом их квантования с последующим деквантованием. Он частично уменьшает потерю точности от больших выбросов. Приближённое решение ищется переборным итерационным методом, поэтому алгоритм медленнее и требует больше памяти. Однако точность обычно выше, чем у Normal.
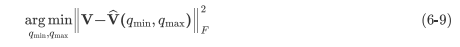
arg min_(q_min,q_max) ||V - V_hat(q_min, q_max)||_F^2
Здесь V̂(q_min, q_max) — результат квантования и деквантования, а ‖·‖_F — норма Фробениуса.
6.2 Настройка квантования
6.2.1 Типы данных квантования
RKNN-Toolkit2 поддерживает INT8 как тип данных квантования.
6.2.2 Рекомендации по алгоритмам квантования
Normal работает быстро и подходит для общих сценариев.
KL-Divergence немного медленнее Normal. Он повышает точность для моделей с неравномерными распределениями и может уменьшить потерю точности от немногочисленных выбросов.
MMSE медленнее и потребляет больше памяти. По сравнению с KL-Divergence он лучше уменьшает потери от выбросов. Для моделей, подходящих для квантования, можно попробовать MMSE для повышения точности. В большинстве сценариев MMSE точнее Normal и KL-Divergence.
По умолчанию применяется Normal. При проблемах точности можно попробовать KL-Divergence и MMSE.
6.2.3 Рекомендации по калибровочному набору
Калибровочный набор используется для вычисления диапазона активаций. Он должен охватывать разные распределения данных реального сценария применения. Например, для классификатора нужны изображения разных категорий этого сценария. Обычно рекомендуется 20-200 изображений; количество можно менять с учётом времени работы алгоритма. Увеличение набора увеличивает время квантования, но не обязательно повышает точность.
6.2.4 Способ настройки квантования
Настройка квантования RKNN-Toolkit2 выполняется через rknn.config() и rknn.build(). Метод задаётся через rknn.config(), а включение квантования и путь к калибровочному набору — через rknn.build().
rknn.config() содержит следующие параметры квантования:
quantized_dtype: тип данных квантования. Сейчас поддерживается только линейное асимметричное INT8; по умолчанию ‘asymmetric_quantized-8’.
quantized_algorithm: алгоритм Normal, KL-Divergence или MMSE. Значения: ‘normal’, ‘kl_divergence’, ‘mmse’; по умолчанию ‘normal’.
quantized_method: послойное или поканальное квантование. Значения: ‘layer’ и ‘channel’; по умолчанию ‘channel’.
rknn.build() содержит следующие параметры квантования:
do_quantization: включать ли квантование; по умолчанию ‘False’.
dataset: путь к калибровочному набору; по умолчанию ‘None’.
Поддерживается текстовый файл .txt с путями к изображениям jpg/png или файлам npy для калибровки. Каждая строка содержит один путь, например:
a.jpg
b.jpg
При нескольких входах соответствующие файлы разделяются пробелом:
a0.jpg a1.jpg
b0.jpg b1.jpg
6.3 Смешанное квантование
Смешанное квантование использует разные типы данных для разных слоёв. Для слоёв, плохо подходящих для квантования, выбирается более высокая точность, уменьшающая потери. Однако смешанная точность создаёт дополнительные накладные расходы и требует определить типы квантования отдельных слоёв.
6.3.1 Применение смешанного квантования
Для лучшего баланса производительности и точности RKNN-Toolkit2 предоставляет смешанное квантование. По результатам анализа точности пользователь может вручную задать, должен ли квантоваться каждый слой.
Поддерживаются следующие способы использования:
Перевод выбранных квантованных слоёв в неквантованные вычисления FLOAT16. (Производительность неквантованных вычислений на NPU ниже, поэтому скорость инференса уменьшается.)
Можно также изменять параметры квантования каждого слоя. (Изменять эти параметры не рекомендуется.)
6.3.2 Порядок использования смешанного квантования
Использование смешанного квантования состоит из четырёх шагов.
1. Загрузить исходную модель и создать конфигурацию квантования, временный файл модели и файл данных. Порядок вызовов интерфейсов:
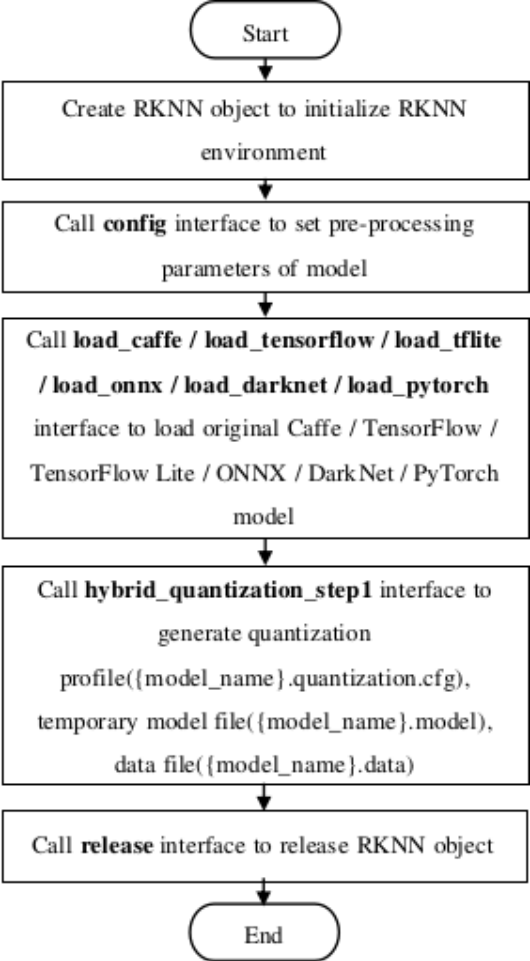
Рисунок 6-3 Шаг 1 смешанного квантования
2. Изменить конфигурационный файл, созданный на первом шаге.
После вызова hybrid_quantization_step1 на первом шаге в текущем каталоге создаётся {model_name}.quantization.cfg. Формат файла:
custom_quantize_layers:
  Conv__350:0: float16
  Conv__358:0: float16
  ....
quantize_parameters:
  ....
  FeatureExtractor/MobilenetV2/Conv/Relu6:0:
    qtype: asymmetric_quantized
    qmethod: layer
    dtype: int8
    min:
    - 0.0
    max:
    - 6.0
    scale:
    - 0.023529411764705882
    zero_point:
    - -128
  ....
В разделе “custom_quantize_layers” можно добавить пользовательские слои квантования: после имени тензора указать тип квантования. Тип операций соответствующего слоя будет изменён на заданный. Сейчас доступен тип “float16”.
Раздел “quantize_parameters” содержит параметры каждого тензора в формате “tensor_name: quantization_properties_and_parameters”. “min” и “max” — границы диапазона квантования. Имена выходных тензоров можно найти в результатах анализа точности либо открыв временный файл {model_name}.model в Netron.
3. Создать модель RKNN. Порядок вызовов интерфейсов:
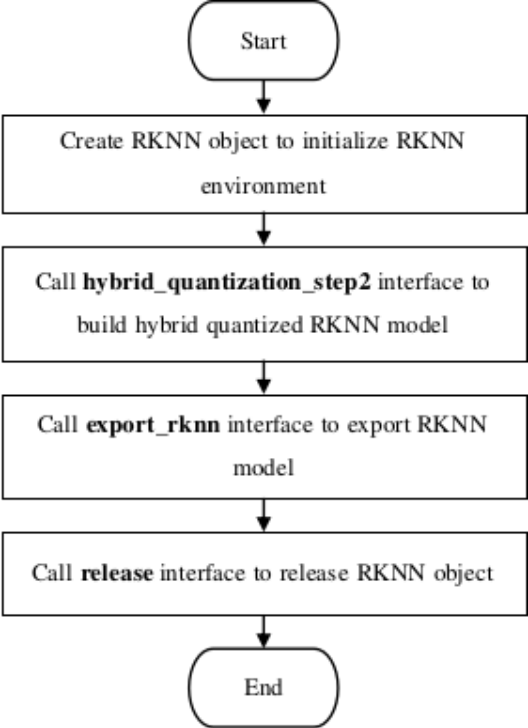
Рисунок 6-4 Шаг 3 смешанного квантования
4. Выполнить инференс моделью RKNN, созданной на третьем шаге.
Примечание: в проекте RKNN-Toolkit2 есть пример смешанного квантования в каталоге “examples/functions/hybrid_quant”. Его можно использовать как образец.
6.3.3 Автоматическое смешанное квантование
Чтобы упростить смешанное квантование и устранить переполнение модели, RKNN-Toolkit2 предоставляет автоматический режим. Через auto_hybrid модель смешанного квантования автоматически корректируется во время квантования по порогам евклидова и косинусного расстояния. Для неквантованных моделей проверяется переполнение fp16 каждого слоя; слои с переполнением переводятся на int16.
Сейчас поддерживаются следующие сценарии:
1. При квантовании модель автоматически корректируется по порогам евклидова и косинусного расстояния. Сейчас поддерживается только автоматический переход с квантования int8 на fp16.
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', auto_hybrid=True)
Пороги задаются параметрами auto_hybrid_cos_thresh и auto_hybrid_euc_thresh интерфейса config. По умолчанию порог косинусного расстояния равен 0.98, евклидова — None, то есть отключён. Поэтому по умолчанию на fp16 переводятся только операторы с показателем точности по косинусному расстоянию ниже порога. При включённом евклидовом пороге на fp16 переводятся операторы, у которых косинусное расстояние ниже своего порога или евклидово расстояние выше своего порога.
2. Для неквантованных моделей каждый слой проверяется на переполнение fp16, а слои с переполнением переводятся на int16. Нужно предоставить набор данных для вычисления диапазона значений каждого слоя.
ret = rknn.build(do_quantization=False, dataset='./dataset.txt', auto_hybrid=True)
По заданному входу послойно вычисляются максимум и минимум. Если они превышают верхнюю или нижнюю границу fp16, оператор соответствующего слоя переводится на int16.
6.4 Обучение с учётом квантования (QAT)
6.4.1 Введение в QAT
Quantization-Aware Training (QAT) направлено на устранение потери точности при низкоразрядном квантовании. Такая потеря возникает при переходе от диапазона чисел с плавающей точкой к фиксированной точке. При QAT ошибка квантования включается в функцию потерь обучения, что позволяет обучать модель с параметрами квантования.
Сравнение с квантованием после обучения (PTQ), предоставляемым RKNN-Toolkit2:
| Метод квантования |
Повторное обучение в исходном фреймворке |
Набор данных | Изменение весов |
Функция потерь | Производительность |
|---|---|---|---|---|---|
| Квантование после обучения (PTQ) |
Нет | Небольшое количество неразмеченных данных |
Нет | Не относится | Оптимальная |
| Обучение с учётом квантования (QAT) |
Да | Полный обучающий набор данных |
Да | Ошибка квантования включается в функцию потерь обучения. |
Если есть операторы, не поддерживающие QAT, производительность немного ниже PTQ. |
6.4.2 Принцип QAT
При QAT веса хранятся и вычисления выполняются с плавающей точкой, обеспечивая корректное обратное распространение и эффективное обучение. В отличие от обычного обучения, в квантуемые места модели вставляются модули FakeQuantize, имитирующие потерю точности при переходе к фиксированной точке. Это позволяет функции потерь учитывать и оптимизировать квантование, обеспечивая точные результаты после преобразования модели в фиксированную точку.
QAT широко применяется и поддерживается основными фреймворками инференса. Подробные инструкции доступны по следующим ссылкам.
Pytorch - https://pytorch.org/blog/quantization-in-practice/#quantization-aware-training-qat
Paddle - https://paddleslim.readthedocs.io/zh-cn/develop/api_cn/dygraph/quanter/qat.html
Tensorflow - https://www.tensorflow.org/model_optimization/guide/quantization/training
6.4.3 Рекомендации по применению QAT
QAT требует дополнительного кода обучения и может конфликтовать с возможностями некоторых открытых репозиториев. Поэтому его рекомендуется рассматривать, когда выполнены оба условия:
Проверка точности по главе 7 подтвердила, что PTQ RKNN не удовлетворяет требованиям точности.
Проверка смешанного квантования по главе 6.3 подтвердила, что оно не удовлетворяет требованиям точности и производительности.
6.4.4 Пример реализации и настройки QAT
Ниже приведена документация QAT различных фреймворков. При практическом использовании руководствуйтесь официальными инструкциями.
PyTorch: https://pytorch.org/docs/stable/quantization.html (PyTorch имеет несколько наборов интерфейсов квантования. RKNN поддерживает модели, созданные интерфейсом FX, в частности prepare_qat_fx и связанными интерфейсами.)
Paddle: https://www.paddlepaddle.org.cn/tutorials/projectdetail/3949129#anchor-14
TensorFlow: https://www.tensorflow.org/model_optimization/guide/quantization/training
На примере PyTorch показаны процесс реализации QAT и важные замечания.
# for 1.10 <= torch <= 1.13
import torch
class M(torch.nn.Module):
 def __init__(self):
 super().__init__()
 self.conv = torch.nn.Conv(3, 8, 3, 1)

 def forward(self, x):
 x = self.conv(x)
 return x

# initialize a floating point model
float_model = M().train()

from torch.quantization import quantize_fx, QConfig, FakeQuantize, MovingAverageMinMaxObserver, MovingAveragePerChannelMinMaxObserver

qconfig = QConfig(activation=FakeQuantize.with_args(observer=
        MovingAverageMinMaxObserver,
        quant_min=0,
        quant_max=255,
        reduce_range=False), # reudece_range -> the default is True

 weight=FakeQuantize.with_args(observer=
      MovingAveragePerChannelMinMaxObserver,
      quant_min=-128,
      quant_max=127,
      dtype=torch.qint8,
      qscheme=torch.per_channel_affine,
      #qscheme->the default is torch.per_channel_symmetric
      reduce_range=False))
qconfig_dict = {"": qconfig}
model_qat = quantize_fx.prepare_qat_fx(float_model, qconfig_dict)

# define the training loop for quantization aware training
def train_loop(model, train_data):
 model.train()
 for image, target in data_loader:
  ...
# Run training
train_loop(model_qat, train_loop)

model_qat = quantize_fx.convert_fx(model_qat)
В приведённом коде все операции соответствуют официальным примерам, кроме настройки qconfig под оборудование RKNN. В qconfig внесены два основных изменения:
Для квантования активаций reduce_range задан как False. При False эффективный диапазон составляет от -128 до 127; при True — от -64 до 63, что ухудшает квантование. Оборудование RKNN поддерживает reduce_range = False.
Для квантования весов qscheme задан как torch.per_channel_affine. Значение по умолчанию torch.per_channel_symmetric фиксирует zero_point на 0, но RKNN поддерживает ненулевую zero_point. Поэтому выбран torch.per_channel_affine.
6.4.5 Операторы, поддерживаемые QAT
На примере PyTorch: сначала Conv и Linear с весами квантуются по правилам QAT, затем проверяются остальные операторы. Если они отвечают обычным правилам квантования, применяется обычное квантование. Оператор, не удовлетворяющий ни QAT, ни обычным правилам, сохраняет вычисления FP32.
Поддержка различается между фреймворками. Подробности для используемых фреймворка и версии доступны по ссылкам:
Pytorch: https://github.com/pytorch/pytorch/blob/main/torch/ao/quantization/quantization_mappings.py
Paddle: https://github.com/PaddlePaddle/Paddle/blob/86df789a567f1285101c57b6e3ada4b952c58f48/python/paddle/quantization/config.py
Tensorflow: https://www.tensorflow.org/model_optimization/api_docs/python/tfmot/quantization/keras/QuantizeConfig
6.4.6 Обработка операторов с плавающей точкой в модели QAT
Если оператор QAT-модели нельзя квантовать, используются вычисления с плавающей точкой. При преобразовании таких операторов в RKNN различают два случая.
1. Предшествующий и последующий операторы квантуемы:
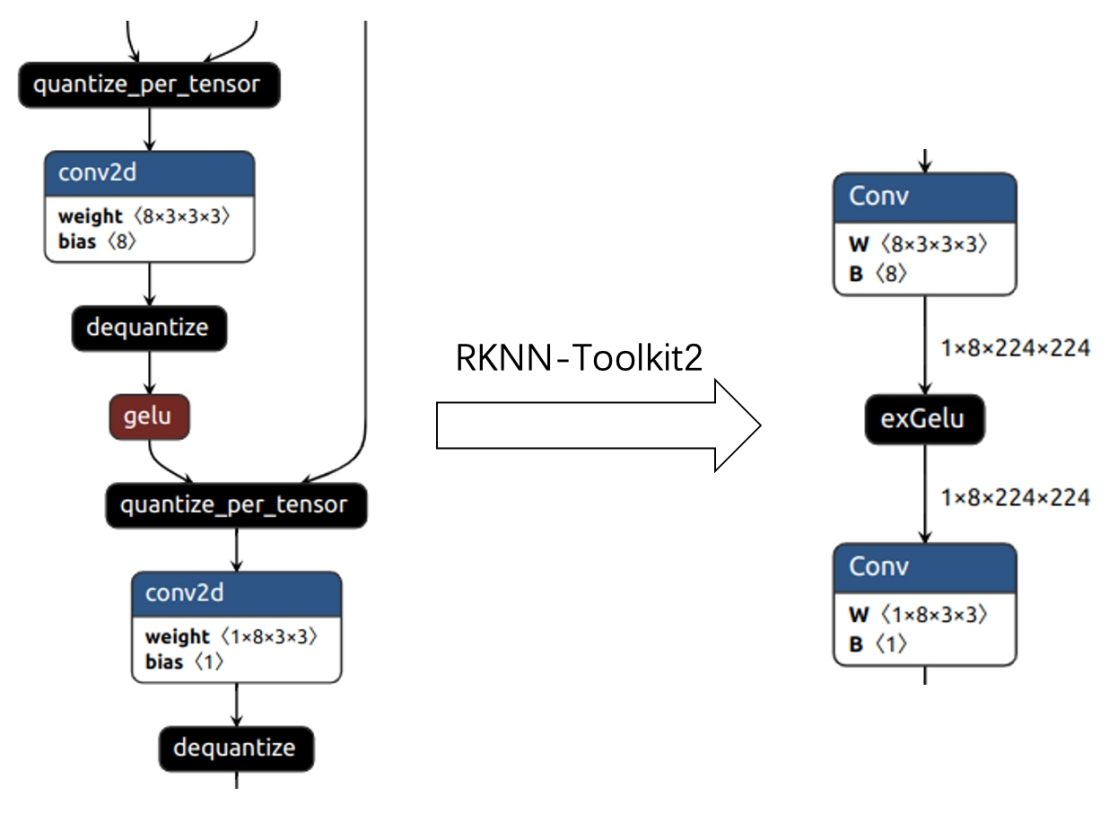
Рисунок 6-5 До и после QAT OP находятся квантуемые операторы
Слева gelu исходной модели работает с плавающей точкой, а предшествующий и последующий conv2d квантованы. При загрузке через RKNN-Toolkit2 оператор между двумя квантованными операторами также квантуется, повышая производительность без потери точности. Справа показана структура полученной модели RKNN.
1. До или после находятся неквантуемые операторы:
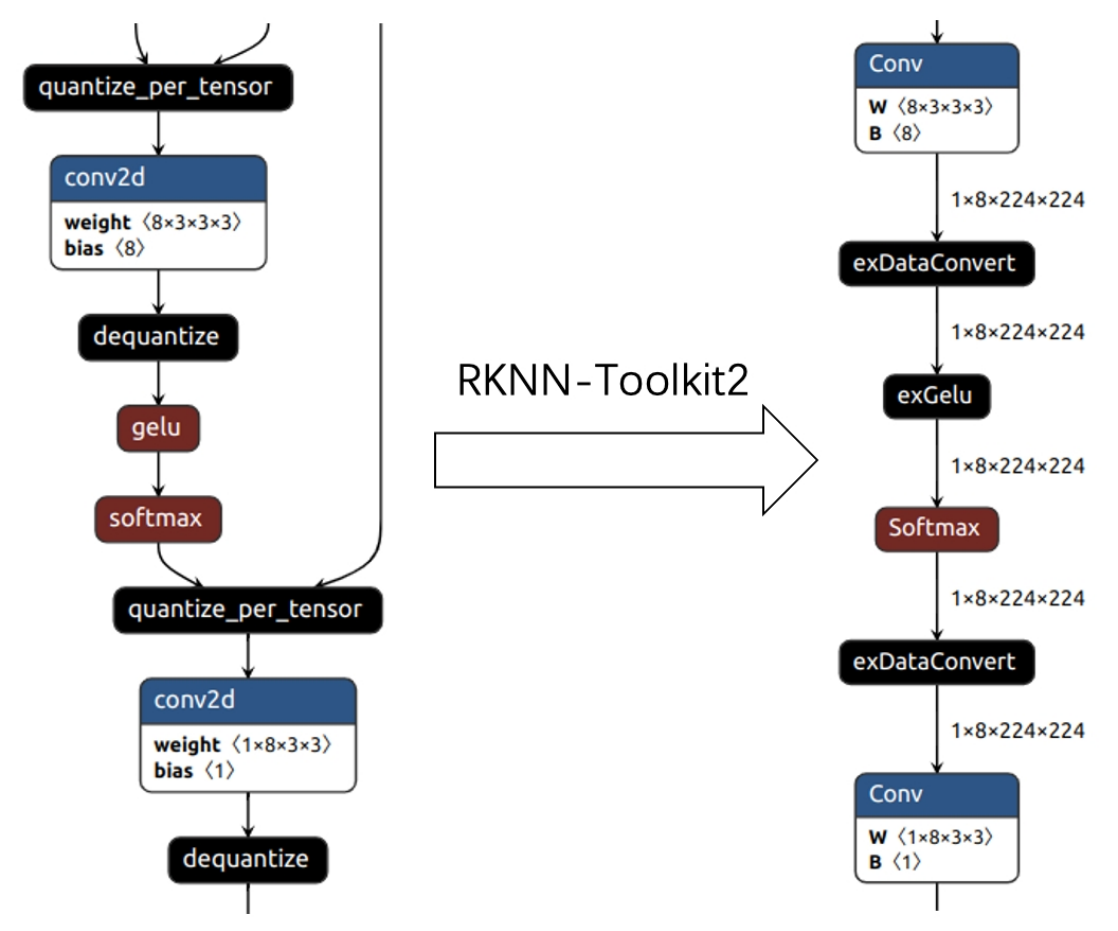
Рисунок 6-6 До и после QAT OP находятся неквантуемые операторы
Слева gelu и softmax исходной модели работают с плавающей точкой, а соседние conv2d квантованы. При загрузке через RKNN-Toolkit2 у gelu и softmax отсутствуют параметры квантования, поэтому они остаются с плавающей точкой. Справа в полученной модели RKNN перед exGelu вставлен оператор деквантования exDataConvert, а после Softmax — оператор квантования exDataConvert. Эти дополнительные преобразования увеличивают задержку.
6.4.7 Практические выводы по QAT
1. Настройки QAT
Для лучших результатов QAT часто требует настройки с учётом оборудования. Для RKNPU рекомендуется задавать qconfig по инструкциям к коду раздела 6.4.4.
2. Коррекция сохранённых в модели параметров квантования
Например, параметры оператора sigmoid, записанные в модели, могут отличаться от фактически используемых при инференсе. В официальном коде (https://github.com/pytorch/pytorch/blob/main/aten/src/ATen/native/quantized/cpu/qsigmoid.cpp) они корректируются во время инференса: min задаётся как 0, а max как [В оригинале значение max не приведено.]
3. Для учёта этого RKNN-Toolkit2 корректирует параметры таких операторов при преобразовании модели, приближая результаты к исходному инференсу PyTorch.
7 Диагностика точности
Диагностика точности обычно охватывает симулятор и среду выполнения на плате. Правильный результат симулятора необходим для правильного инференса на плате. Поэтому сначала следует добиться корректной работы симулятора, а затем проверять плату.
В этой главе приведены рекомендации и решения для обоих случаев. На рисунке показана последовательность проверки:
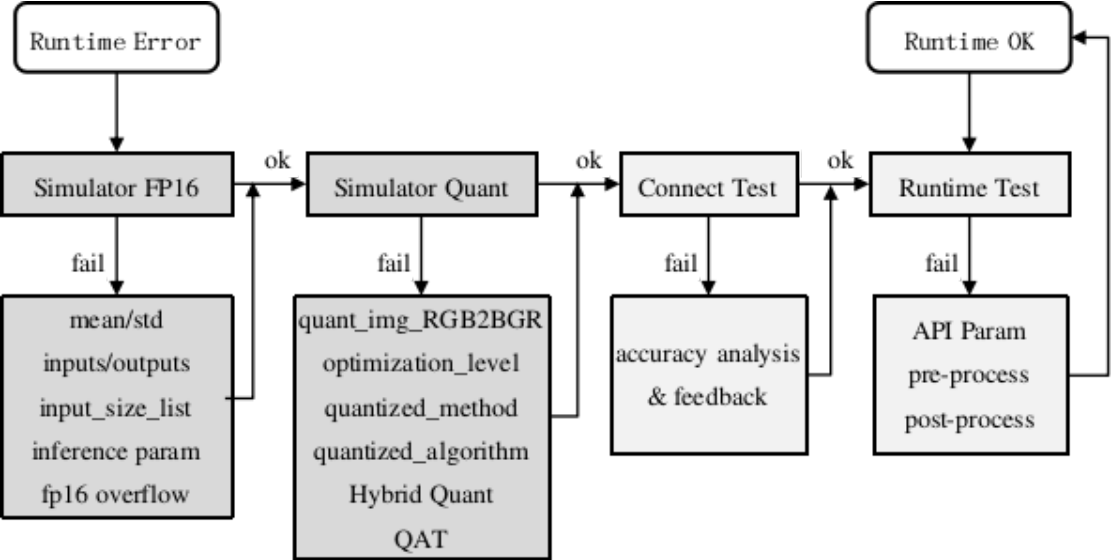
Рисунок 7-1 Этапы анализа точности
Диагностика симулятора делится на проверку точности FP16 и точности квантования (тёмные блоки рисунка).
Диагностика среды выполнения делится на проверку с подключённой платой и проверку runtime (светлые блоки).
Косинусное расстояние может служить базовым критерием точности, но окончательное влияние квантования нужно проверять на наборе данных.
7.1 Проверка точности симулятора
Правильный инференс симулятора — условие правильной работы на плате; поэтому в первую очередь нужно проверить симулятор.
Симулятор RKNN-Toolkit2 выполняет FP16- или квантованный инференс. Правильные результаты FP16 необходимы для правильного квантованного инференса. При проблемах квантования сначала проверяют FP16, затем точность квантования.
7.1.1 Точность FP16 в симуляторе
RKNPU сейчас не поддерживает вычисления FP32, поэтому без квантования симулятор использует FP16. Чтобы преобразовать исходную модель в FP16 RKNN, вызовите rknn.build() с do_quantization = False. Затем выполните rknn.init_runtime(target=None) и rknn.inference() для симуляции FP16 и получения результатов.
При неверной выходной информации FP16 выполните следующие проверки:
Ошибка конфигурации
Основные настройки модели сосредоточены в rknn.config(), но на точность FP16 могут влиять и отдельные параметры других API. Главные параметры:
mean_values / std_values: параметры нормализации. В исходной модели нормализация обычно выполняется при предварительной обработке входа. В RKNN она может входить в сам инференс; при квантовании калибровочный набор сначала нормализуется. Если исходная модель использует нормализацию, эти параметры должны совпадать с её параметрами.
input_size_list: неверные формы входных узлов в rknn.load_tensorflow(), rknn.load_pytorch() или rknn.load_onnx() приводят к неверному инференсу.
inputs / outputs: неверные имена входных или выходных узлов в rknn.load_tensorflow() и rknn.load_onnx() приводят к неверному инференсу.
Параметры inference: основные входные параметры rknn.inference() — inputs и data_format.
В Python изображения обычно читают через cv2.imread(), который возвращает BGR. Если вход исходной модели — BGR (как у большинства моделей caffe), перестановка RGB не нужна. Если вход — RGB, выполните cv2.cvtColor(img, cv2.COLOR_BGR2RGB). Изображение cv2.imread() 3-мерное, а большинство моделей ожидают 4 измерения, поэтому перед rknn.inference() добавьте измерение через np.expand_dims(img, 0). Раскладка cv2.imread() — NHWC, и data_format по умолчанию также NHWC, поэтому задавать data_format не требуется.
Если данные прочитаны не через cv2.imread(), определите их раскладку и правильно задайте data_format. Форма данных должна соответствовать исходной модели. Для изображений также должен совпадать порядок RGB.
Проверка параметров крайне важна: неверная конфигурация — частая причина неправильных результатов FP16. Порядок проверки:
1. Выполнить исходную модель в исходном фреймворке и сохранить результаты.
2. Преобразовать и выполнить модель через RKNN-Toolkit2 с теми же входными данными в FP16: do_quantization = False в rknn.build(), target = None в rknn.init_runtime(). Сохранить результаты симулятора.
3. Сравнить результаты. Если они достаточно близки (можно использовать косинусное расстояние), настройки корректны.
4. При расхождении проверить перечисленные параметры.
Если настройки верны, но результаты различаются, тензоры модели могут выходить за диапазон FP16.
Выход за диапазон FP16
При переходе с FP32 на FP16 промежуточные тензоры могут переполняться. Обычно модель использует FP32; значения вне диапазона FP16 (-65504~65504) вызывают переполнение и аномальные результаты.
Для проверки переполнения используйте rknn.accuracy_analysis(…, target=None), см. анализ точности модели. Аномальные значения, например ‘inf’, в колонках entire или single группы simulator_error могут означать переполнение FP16. Попробуйте изменить структуру, например добавить BN-слои, чтобы все тензоры укладывались в FP16.
Если настройки верны, переполнения FP16 нет, но результаты различаются, возможна ошибка реализации симулятора. Передайте воспроизводимый пример модели команде Rockchip NPU для анализа и исправления.
7.1.2 Точность квантования в симуляторе
После исключения проблем FP16 квантовать модель можно через rknn.build() с do_quantization = True. Затем выполните rknn.accuracy_analysis(…, target=None), см. анализ точности модели, для проверки квантования в симуляторе.
Если точность в колонке entire группы simulator_error существенно упала, но в single нет отдельного слоя с сильным падением, проверьте следующие области:
Ошибки конфигурации
Как и для FP16, неверные настройки вызывают проблемы квантования. Даже при корректных настройках FP16 нужно дополнительно проверить параметры квантования ниже.
quant_img_RGB2BGR: выполнять ли RGB2BGR при загрузке изображений квантования; обычно применяется к caffe. Подробнее см. описание quant_img_RGB2BGR. Настройка должна соответствовать порядку каналов обучающих изображений, иначе точность может существенно снизиться.
optimization_level: уровень оптимизации, по умолчанию 3 — приоритет скорости. Включаются правила, немного влияющие на точность ради производительности. При снижении уровня, например до 0, эти правила отключаются.
dataset: калибровочный набор rknn.build(), используемый для расчёта scale/zero_point каждого тензора. Сильное отличие набора от реального сценария может снизить точность. Слишком большое или малое количество изображений также влияет на точность; обычно выбирают 20–200 изображений.
Параметры квантования обычно проверяют следующим образом:
1. Выполнить квантованный инференс и сравнить с исходной моделью в её фреймворке. Если различие невелико, параметры quant_img_RGB2BGR и dataset можно считать в основном корректными.
2. Если различие остаётся заметным:
Если исходная модель ожидает BGR, что часто бывает у caffe, задайте quant_img_RGB2BGR = True. Порядок RGB можно проверить в коде обработки входа, использованном на предыдущем этапе проверки FP16.
Сначала используйте для квантования одно изображение — оставьте одну строку в dataset.txt — и выполните инференс на нём. Значительное улучшение точности указывает на неудачный выбор прежнего калибровочного набора. Подберите изображения, лучше соответствующие сценарию применения. Если улучшение невелико, причина может быть не в dataset.
Если изначально использовалось только одно изображение, то есть одна строка dataset.txt, попробуйте увеличить набор примерно до 20–200 изображений.
После проверки этих настроек полностью неверных результатов квантования быть не должно. Если они сохраняются, перепроверьте настройки. Если конфигурация верна, но точность недостаточна, попробуйте изменить методы и алгоритмы квантования.<br>Методы и алгоритмы квантования
Некоторые модели плохо подходят для квантования. Попробуйте другие методы и алгоритмы. Основные методы — layer и channel, задаваемые quantized_method в rknn.config() (по умолчанию channel). Алгоритмы normal, kl_divergence и mmse выбираются через quantized_algorithm в rknn.config() (по умолчанию normal). Порядок действий:
1. Если использовался layer, попробуйте channel. Поканальное квантование часто значительно точнее послойного.
2. Если уже используется channel, но точности недостаточно, смените normal на kl_divergence или mmse. Время квантования может значительно вырасти, но точность обычно лучше normal; производительность при выполнении не ухудшается.
Если entire в simulator_error остаётся неудовлетворительным, а single показывает сильное падение точности отдельных слоёв, причиной может быть неудачное распределение их весов. Например, сильно неравномерные веса Conv теряют точность после квантования. Для улучшения можно применить смешанное квантование:
1. Через анализ точности найдите слои с большим падением и запишите имена их выходных тензоров. Поскольку ошибки накапливаются послойно, ранние слои сильнее влияют на итог. Учитывайте и потерю в single группы simulator_error, и положение слоя.
2. Внесите полученные имена тензоров в конфигурацию смешанного квантования; см. соответствующий раздел.
3. Завершите смешанное квантование и проверьте точность. Для сравнения изменений можно снова использовать интерфейс анализа.
Обычно смешанное квантование улучшает точность. Если улучшение недостаточно, охватите больше слоёв, но это снизит скорость инференса. Необходимо соблюдать баланс точности и скорости. Отдельный вариант для последнего слоя с потерей точности — перенести его операцию в постобработку, чтобы избежать проблемы квантования этого слоя.
QAT (обучение с учётом квантования):
Если после смешанного квантования точность всё ещё мала либо она достаточна, но производительность не устраивает, можно переобучить модель с QAT. Экспортируйте её вместе с параметрами квантования, например в ONNX, PyTorch или TensorFlow Lite. Подробнее см. раздел об обучении с учётом квантования (QAT).
7.2 Проверка точности среды выполнения
Даже при корректном симуляторе развёртывание C API на плате может давать неверные результаты. Обычно причин три: ошибка runtime платы, неправильное использование RKNPU2 C API или неверная пред-/постобработка модели.
Сначала используйте режим с подключённой платой, чтобы быстро проверить возможную ошибку runtime. Если он работает правильно, проверяйте развёртывание C API.
7.2.1 Точность при подключённой плате
1. Настройте среду отладки с платой, как описано в настройке среды NPU, подключите плату к ПК через USB и выполните инференс RKNN-Toolkit2 с target в rknn.init_runtime(), например target=’rk3566’. Проверьте примерную корректность результата: симулятор не полностью воспроизводит NPU, поэтому абсолютного совпадения может не быть.
2. Значительное отличие от симулятора предварительно указывает на ошибку runtime платы. Выполните анализ точности с подключённой платой: rknn.accuracy_analysis() с target, например target=’rk3566’; см. анализ точности модели. После завершения будут выведены результаты каждого слоя.
3. Проверьте single_sim группы runtime_error. Низкое косинусное cos или высокое евклидово euc расстояние, выделенное жёлтым/красным, может увеличивать разницу entire между runtime_error и simulator_error. Возможно, реализация этого слоя в runtime теряет точность или работает аномально. Передайте результаты анализа и воспроизводимую модель команде Rockchip NPU для исправления.
7.2.2 Точность runtime
Если режим с подключённой платой корректен, но приложение нет, проблема может находиться в пользовательском C/C++ коде, использующем RKNN C API. Проверьте настройки интерфейсов и пред-/постобработку: они должны полностью совпадать с симулятором. Порядок проверки:
1. Проверить настройки и данные входа
Проверьте вход C API. Если при преобразовании RKNN-Toolkit2 уже заданы среднее и дисперсия, повторная нормализация в C/C++ не нужна. Для 3-мерного входа порядок каналов должен соответствовать обучению; для 4-мерного fmt=NHWC, для не4-мерного fmt=UNDEFINED. В обычном API размер входного буфера равен числу элементов тензора, умноженному на число байтов элемента. Для zero-copy размер памяти rknn_create_mem и формат данных см. в разделе использования RKNN Runtime Zero-Copy.
После проверки настроек проверьте данные входного слоя. До запуска приложения задайте RKNN_LOG_LEVEL=5. Послойные результаты сохраняются как numpy-файлы в /data/dumps (Android) или /userdata/dumps (Linux). Проверьте файл с InputOperator. Для обычного API он содержит результат нормализации входа, для zero-copy — данные до нормализации.
2. Проверить настройки и данные выхода
После проверки входа проверьте выход. В обычном API want_float=1 возвращает float32, want_float=0 — квантованный тип либо FP16 для неквантованных данных. Для zero-copy размер памяти и формат входных данных, создаваемых rknn_create_mem(), см. в разделе использования RKNN Runtime Zero-Copy.
Откройте созданный послойный numpy-файл с OutputOperator и проверьте выход. Если вход подтверждён, но выход неверен, возможна ошибка обработки конкретного входного/выходного типа в runtime. Передайте анализ и воспроизводимую модель команде Rockchip NPU для исправления.
8 Оптимизация производительности
8.1 Порядок анализа производительности модели
8.1.1 Проверка среды выполнения
Перед анализом и оптимизацией установите одинаковые исходные условия тестовой среды. Только при совпадении условий данные имеют смысл. Например, инференс одной модели на разных частотах может сильно различаться; это нельзя характеризовать средним временем кадра одного пакета.
При проверке и настройке среды учитывайте следующие аспекты:
Проверка и установка частот CPU, DDR и NPU
Фиксированные частоты напрямую влияют на скорость; более высокие частоты обычно дают лучшую производительность. Однако зависимость нелинейна, а повышение частоты увеличивает энергопотребление.
Команды фиксации частот: https://github.com/airockchip/rknn_model_zoo/blob/main/scaling_frequency.sh
Либо включите режим производительности следующей командой:
echo performance | tee $(find /sys/ -name *governor) /dev/null || true
Проверка версии драйвера ядра NPU
Оптимизации некоторых функций и операторов могут зависеть от версии драйвера. Новые версии содержат свежие низкоуровневые оптимизации. Проверьте, достаточно ли свежий драйвер используется. Рекомендуется версия 0.8.8 или новее; это не обязательное требование.
Версию драйвера можно проверить командами:
cat /sys/kernel/debug/rknpu/version # for RK3566/RK3568/RK3588/RK3562/RK3576
cat /proc/rknpu/version # for RV1106/RV1106B/RV1103/RV1103B/RV1126B
Примечание: RK2118 пока не поддерживает запрос версии NPU.<br>Проверка загрузки NPU
Загрузка NPU — доля времени выполнения задач за единицу времени. Она отражает активность NPU. Низкая загрузка означает длительное ожидание новых задач. Проверьте время копирования входов/выходов, пред-/постобработку и другие факторы приложения. Многопоточность также может повысить загрузку NPU.
Загрузка NPU не равна фактической утилизации MAC. Последняя отражает эффективность исполнения задач аппаратными вычислительными блоками.
Команда запроса загрузки NPU:
cat /sys/kernel/debug/rknpu/load
# or
cat /proc/debug/rknpu/load
Примечание: RK2118 пока не поддерживает запрос загрузки NPU.
8.1.2 Анализ времени развёртывания
Общее время делится на работу приложения, копирование входов/выходов и инференс модели. Распределение времени помогает определить приоритеты оптимизации. Каждый этап можно измерить временными метками в приложении.
Время приложения:
Это время инференс-процесса, не связанное с NPU: обычно предобработка, постобработка и логика программы. Пользователь полностью контролирует эту часть. Если её доля велика, помимо упрощения и оптимизации кода можно ускорить отдельные операции специализированным оборудованием.
Например, матричные умножения и сложения можно ускорить через Matmul API с участием NPU, а масштабирование изображений — через RGA.
Время копирования входов/выходов:
Обычный API копирует данные между входной/выходной памятью и памятью NPU; это время можно вывести при вызове API. Оно зависит от DDR и CPU. Для малых данных затраты невелики, для больших ими нельзя пренебрегать. Поэтому рекомендуется zero-copy API.
При zero-copy NPU напрямую обращается к входной/выходной памяти. Подробнее см. раздел интерфейса RKNN Runtime Zero-Copy.
Время инференса:
Время инференса NPU зависит от размера модели, версии оптимизаций компилятора и других факторов. Время, выводимое RKNN LOG, различается при разных RKNN_LOG_LEVEL, поскольку вывод журнала сам занимает время.
Обычно для измерения одного кадра задают уровень LOG 1 и усредняют несколько запусков.
8.2 Анализ производительности
8.2.1 Получение профиля
Чтобы узнать время каждого слоя, перед запуском программы задайте следующую команду для подробного вывода:
export RKNN_LOG_LEVEL=4
./run_rknn_test ./test.rknn ./input.jpg
На Android подробные журналы после запуска можно получить через logcat.
При использовании RKNN-Toolkit2 время каждого слоя получают следующим способом:
rknn.init_runtime(target=platform, perf_debug=True)
rknn.eval_perf()
Можно получить следующий отчёт анализа производительности:
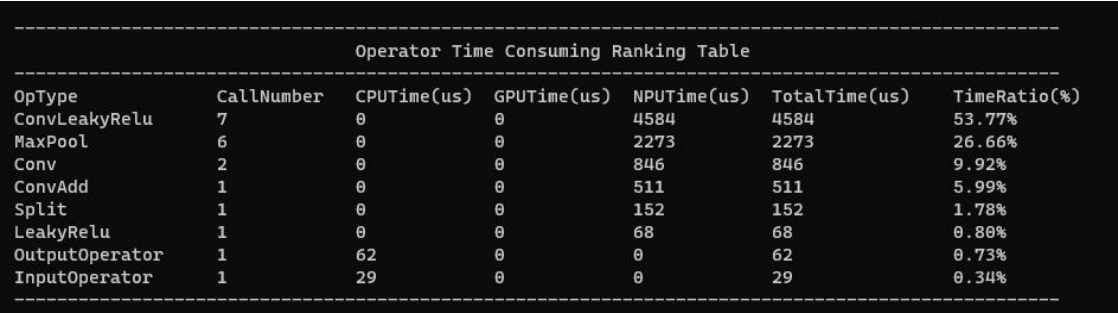
| OpType | CallNumber | CPUTime(us) | GPUTime(us) | NPUTime(us) | TotalTime(us) | TimeRatio(%) |
|---|---|---|---|---|---|---|
| ConvLeakyRelu | 7 | 0 | 0 | 4584 | 4584 | 53.77% |
| MaxPool | 6 | 0 | 0 | 2273 | 2273 | 26.66% |
| Conv | 2 | 0 | 0 | 846 | 846 | 9.92% |
| ConvAdd | 1 | 0 | 0 | 511 | 511 | 5.99% |
| Split | 1 | 0 | 0 | 152 | 152 | 1.78% |
| LeakyRelu | 1 | 0 | 0 | 68 | 68 | 0.80% |
| OutputOperator | 1 | 62 | 0 | 0 | 62 | 0.73% |
| InputOperator | 1 | 29 | 0 | 0 | 29 | 0.34% |
Рисунок 8-1 Отчёт анализа производительности
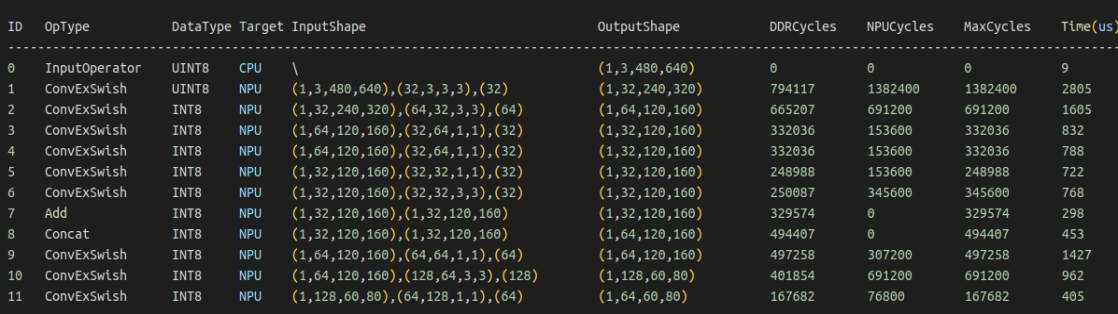
| ID | OpType | DataType | Target | InputShape | OutputShape | DDRCycles | NPUCycles | MaxCycles | Time(us) |
|---|---|---|---|---|---|---|---|---|---|
| 0 | InputOperator | UINT8 | CPU | \ | (1,3,480,640) | 0 | 0 | 0 | 9 |
| 1 | ConvExSwish | INT8 | NPU | (1,3,480,640),(32,3,3,3),(32) | (1,32,240,320) | 794117 | 1382400 | 1382400 | 2805 |
| 2 | ConvExSwish | INT8 | NPU | (1,32,240,320),(64,32,3,3),(64) | (1,64,120,160) | 665207 | 691200 | 691200 | 1605 |
| 3 | ConvExSwish | INT8 | NPU | (1,64,120,160),(32,64,1,1),(32) | (1,32,120,160) | 332036 | 153600 | 332036 | 832 |
| 4 | ConvExSwish | INT8 | NPU | (1,64,120,160),(32,64,1,1),(32) | (1,32,120,160) | 332036 | 153600 | 332036 | 788 |
| 5 | ConvExSwish | INT8 | NPU | (1,32,120,160),(32,32,1,1),(32) | (1,32,120,160) | 248988 | 153600 | 248988 | 722 |
| 6 | ConvExSwish | INT8 | NPU | (1,32,120,160),(32,32,3,3),(32) | (1,32,120,160) | 250087 | 345600 | 345600 | 768 |
| 7 | Add | INT8 | NPU | (1,32,120,160),(1,32,120,160) | (1,32,120,160) | 329574 | 0 | 329574 | 298 |
| 8 | Concat | INT8 | NPU | (1,32,120,160),(1,32,120,160) | (1,64,120,160) | 494407 | 0 | 494407 | 453 |
| 9 | ConvExSwish | INT8 | NPU | (1,64,120,160),(64,64,1,1),(64) | (1,64,120,160) | 497258 | 307200 | 497258 | 1427 |
| 10 | ConvExSwish | INT8 | NPU | (1,64,120,160),(128,64,3,3),(128) | (1,128,60,80) | 401859 | 691200 | 691200 | 962 |
| 11 | ConvExSwish | INT8 | NPU | (1,128,60,80),(64,128,1,1),(64) | (1,64,60,80) | 167682 | 76800 | 167682 | 405 |
Рисунок 8-2 Отчёт анализа производительности
Общий и послойный профили позволяют быстро найти нужные сведения и выбрать дальнейшую стратегию оптимизации. После получения профиля анализируют время слоёв для поиска длительных операторов, влияние операторов вне NPU и узкие места операторов NPU. Далее эти проверки описаны подробно.
8.2.2 Послойный анализ времени
В колонке Times можно найти длительные операторы и оптимизировать их первыми. Колонка Op Type показывает, относятся ли они к одному OpType, чтобы оптимизировать их совместно.
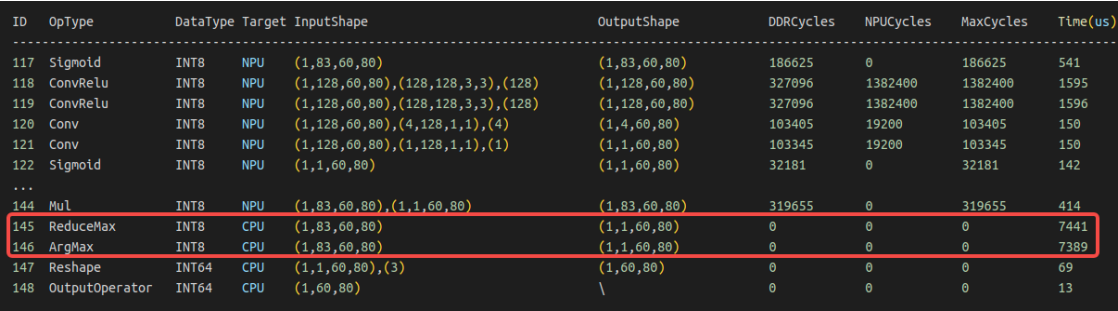
| ID | OpType | DataType | Target | InputShape | OutputShape | DDRCycles | NPUCycles | MaxCycles | Time(us) |
|---|---|---|---|---|---|---|---|---|---|
| 117 | Sigmoid | INT8 | NPU | (1,83,60,80) | (1,83,60,80) | 186625 | 0 | 186625 | 541 |
| 118 | ConvRelu | INT8 | NPU | (1,128,60,80),(128,128,3,3),(128) | (1,128,60,80) | 327096 | 1382400 | 1382400 | 1595 |
| 119 | ConvRelu | INT8 | NPU | (1,128,60,80),(128,128,3,3),(128) | (1,128,60,80) | 327096 | 1382400 | 1382400 | 1596 |
| 120 | Conv | INT8 | NPU | (1,128,60,80),(4,128,1,1),(4) | (1,4,60,80) | 103405 | 19200 | 103405 | 150 |
| 121 | Conv | INT8 | NPU | (1,128,60,80),(1,128,1,1),(1) | (1,1,60,80) | 103345 | 19200 | 103345 | 150 |
| 122 | Sigmoid | INT8 | NPU | (1,1,60,80) | (1,1,60,80) | 32181 | 0 | 32181 | 142 |
| … | … | … | … | … | … | … | … | … | … |
| 144 | Mul | INT8 | NPU | (1,83,60,80),(1,1,60,80) | (1,83,60,80) | 319655 | 0 | 319655 | 414 |
| 145 | ReduceMax | INT8 | CPU | (1,83,60,80) | (1,1,60,80) | 0 | 0 | 0 | 7441 |
| 146 | ArgMax | INT8 | CPU | (1,83,60,80) | (1,1,60,80) | 0 | 0 | 0 | 7389 |
| 147 | Reshape | INT64 | CPU | (1,1,60,80),(3) | (1,60,80) | 0 | 0 | 0 | 69 |
| 148 | OutputOperator | INT64 | CPU | (1,60,80) | \ | 0 | 0 | 0 | 13 |
Рисунок 8-3 Анализ длительных операторов
Длительный оператор не обязательно неэффективен. При высокой утилизации Mac следует уменьшить его размер для снижения времени. Низкая утилизация требует особого внимания.
8.2.3 Влияние операторов CPU
На рисунке часть длительных операторов выполняется на CPU. Перенос на NPU может значительно сократить их влияние. Большинство пользовательских проблем производительности решается переносом CPU-операторов на NPU, поэтому их времени следует уделять особое внимание.
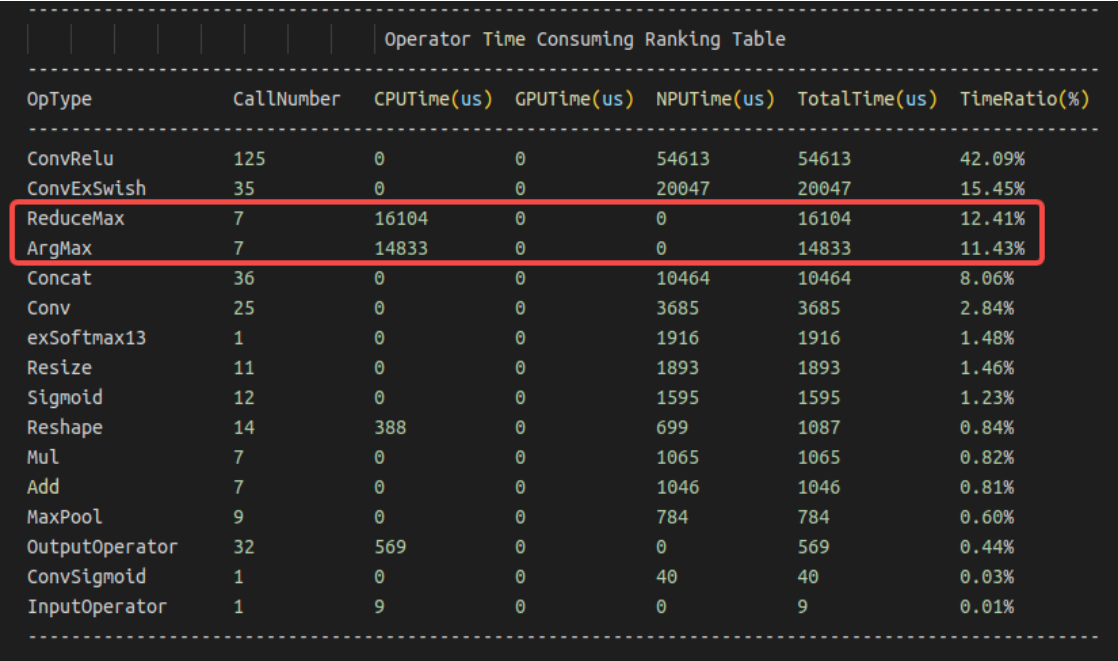
| OpType | CallNumber | CPUTime(us) | GPUTime(us) | NPUTime(us) | TotalTime(us) | TimeRatio(%) |
|---|---|---|---|---|---|---|
| ConvRelu | 125 | 0 | 0 | 54613 | 54613 | 42.09% |
| ConvExSwish | 35 | 0 | 0 | 20047 | 20047 | 15.45% |
| ReduceMax | 7 | 16104 | 0 | 0 | 16104 | 12.41% |
| ArgMax | 7 | 14833 | 0 | 0 | 14833 | 11.43% |
| Concat | 36 | 0 | 0 | 10464 | 10464 | 8.06% |
| Conv | 25 | 0 | 0 | 3685 | 3685 | 2.84% |
| exSoftmax13 | 1 | 0 | 0 | 1916 | 1916 | 1.48% |
| Resize | 11 | 0 | 0 | 1893 | 1893 | 1.46% |
| Sigmoid | 12 | 0 | 0 | 1595 | 1595 | 1.23% |
| Reshape | 14 | 388 | 0 | 699 | 1087 | 0.84% |
| Mul | 7 | 0 | 0 | 1065 | 1065 | 0.82% |
| Add | 7 | 0 | 0 | 1046 | 1046 | 0.81% |
| MaxPool | 9 | 0 | 0 | 784 | 784 | 0.60% |
| OutputOperator | 32 | 569 | 0 | 0 | 569 | 0.44% |
| ConvSigmoid | 1 | 0 | 0 | 40 | 40 | 0.03% |
| InputOperator | 1 | 9 | 0 | 0 | 9 | 0.01% |
Рисунок 8-4 Анализ производительности операторов CPU
Операторы обычно выполняются вне NPU по следующим причинам:
Размер оператора превышает ограничение; см. ограничения размеров в OpList.
Оператор пока не поддерживается NPU. Проверьте OpList; можно создать issue в проекте Github.
Аппаратные ограничения NPU не позволяют поддержку; рассмотрите эквивалентную реализацию алгоритма через другие поддерживаемые варианты NPU.
8.2.4 Анализ узких мест операторов NPU
При длительном выполнении NPU-оператора по DDR Cycles/NPU Cycles/Total Cycles можно определить теоретическое ограничение: пропускная способность или вычислительная мощность. DDR Cycles — циклы чтения/записи, пересчитанные на частоту NPU, поэтому их можно напрямую сравнивать с NPU Cycle.
Как показано ниже:
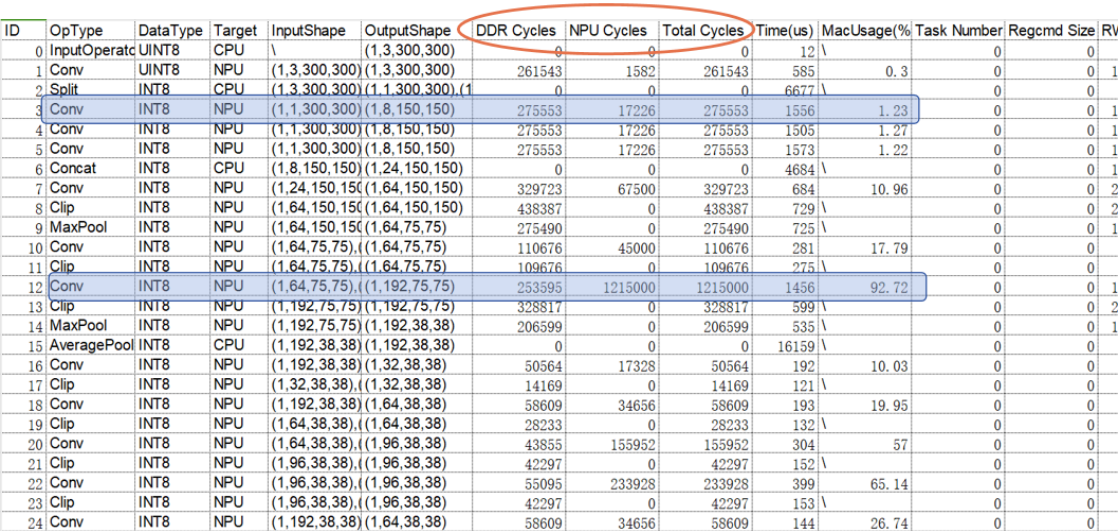
| ID | OpType | DataType | Target | InputShape | OutputShape | DDR Cycles | NPU Cycles | Total Cycles | Time(us) | MacUsage(% [clipped] | Task Number | Regcmd Size | RW [clipped] |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | InputOperat [clipped] | UINT8 | CPU | \ | (1,3,300,300) | 0 | 0 | 0 | 12 | \ | 0 | 0 | [clipped] |
| 1 | Conv | UINT8 | NPU | (1,3,300,300) | (1,3,300,300) | 261543 | 1582 | 261543 | 585 | 0.3 | 0 | 0 | 1 [clipped] |
| 2 | Split | INT8 | CPU | (1,3,300,300) | (1,1,300,300),(1 [clipped] | 0 | 0 | 0 | 6677 | \ | 0 | 0 | [clipped] |
| 3 | Conv | INT8 | NPU | (1,1,300,300) | (1,8,150,150) | 275553 | 17226 | 275553 | 1556 | 1.23 | 0 | 0 | 1 [clipped] |
| 4 | Conv | INT8 | NPU | (1,1,300,300) | (1,8,150,150) | 275553 | 17226 | 275553 | 1505 | 1.27 | 0 | 0 | 1 [clipped] |
| 5 | Conv | INT8 | NPU | (1,1,300,300) | (1,8,150,150) | 275553 | 17226 | 275553 | 1573 | 1.22 | 0 | 0 | 1 [clipped] |
| 6 | Concat | INT8 | CPU | (1,8,150,150) [clipped] | (1,24,150,150) | 0 | 0 | 0 | 4684 | \ | 0 | 0 | 1 [clipped] |
| 7 | Conv | INT8 | NPU | (1,24,150,150) | (1,64,150,150) | 329723 | 67500 | 329723 | 684 | 10.96 | 0 | 0 | 2 [clipped] |
| 8 | Clip | INT8 | NPU | (1,64,150,150) | (1,64,150,150) | 438387 | 0 | 438387 | 729 | \ | 0 | 0 | 2 [clipped] |
| 9 | MaxPool | INT8 | NPU | (1,64,150,150) | (1,64,75,75) | 275490 | 0 | 275490 | 725 | \ | 0 | 0 | 1 [clipped] |
| 10 | Conv | INT8 | NPU | (1,64,75,75) | (1,64,75,75) | 110676 | 45000 | 110676 | 281 | 17.79 | 0 | 0 | [clipped] |
| 11 | Clip | INT8 | NPU | (1,64,75,75) | (1,64,75,75) | 109676 | 0 | 109676 | 275 | \ | 0 | 0 | [clipped] |
| 12 | Conv | INT8 | NPU | (1,64,75,75) | (1,192,75,75) | 253595 | 1215000 | 1215000 | 1456 | 92.72 | 0 | 0 | 1 [clipped] |
| 13 | Clip | INT8 | NPU | (1,192,75,75) | (1,192,75,75) | 328817 | 0 | 328817 | 599 | \ | 0 | 0 | 2 [clipped] |
| 14 | MaxPool | INT8 | NPU | (1,192,75,75) | (1,192,38,38) | 206599 | 0 | 206599 | 535 | \ | 0 | 0 | 1 [clipped] |
| 15 | AveragePool [clipped] | INT8 | CPU | (1,192,38,38) | (1,192,38,38) | 0 | 0 | 0 | 16159 | \ | 0 | 0 | [clipped] |
| 16 | Conv | INT8 | NPU | (1,192,38,38) | (1,32,38,38) | 50564 | 17328 | 50564 | 192 | 10.03 | 0 | 0 | [clipped] |
| 17 | Clip | INT8 | NPU | (1,32,38,38) | (1,32,38,38) | 14169 | 0 | 14169 | 121 | \ | 0 | 0 | [clipped] |
| 18 | Conv | INT8 | NPU | (1,192,38,38) | (1,64,38,38) | 58609 | 34656 | 58609 | 139 | 19.95 | 0 | 0 | [clipped] |
| 19 | Clip | INT8 | NPU | (1,64,38,38) | (1,64,38,38) | 28233 | 0 | 28233 | 132 | \ | 0 | 0 | [clipped] |
| 20 | Conv | INT8 | NPU | (1,64,38,38) | (1,96,38,38) | 43855 | 155952 | 155952 | 304 | 57 | 0 | 0 | [clipped] |
| 21 | Clip | INT8 | NPU | (1,96,38,38) | (1,96,38,38) | 42297 | 0 | 42297 | 152 | \ | 0 | 0 | [clipped] |
| 22 | Conv | INT8 | NPU | (1,96,38,38) | (1,96,38,38) | 55095 | 233928 | 233928 | 399 | 65.14 | 0 | 0 | [clipped] |
| 23 | Clip | INT8 | NPU | (1,96,38,38) | (1,96,38,38) | 42297 | 0 | 42297 | 153 | \ | 0 | 0 | [clipped] |
| 24 | Conv | INT8 | NPU | (1,192,38,38) | (1,64,38,38) | 58609 | 34656 | 58609 | 144 | 26.74 | 0 | 0 | [clipped] |
Рисунок 8-5 Анализ производительности операторов NPU
В третьем слое DDR Cycles намного больше NPU Cycles: чтение/запись требует больше циклов, чем вычисления. Значит, Conv ограничен пропускной способностью.
В двенадцатом слое DDR Cycles намного меньше NPU Cycles: чтение/запись требует меньше циклов, чем вычисления. Значит, Conv ограничен вычислительной мощностью.
Сейчас колонка NPU Cycles показывает циклы только для Conv; другие типы операторов планируется добавить позже.
8.3 Ускорение квантованием
Квантование существенно уменьшает вычисления и расход пропускной способности. Кроме того, вычислительная мощность INT8 у NPU значительно выше FP16, поэтому модель может сильно ускориться. Рекомендуется развёртывать квантованные модели; способы описаны во введении в квантование.
8.4 Оптимизация графа
Оптимизация графа позволяет координировать улучшения модели в целом. После выявления длительных операторов или подграфов граф можно преобразовывать разными способами. Основные цели — убрать избыточные операторы, перенести операции на NPU и использовать эффективные для оборудования операторы. Цели иногда противоречат друг другу: перенос на NPU может потребовать дополнительных операторов. Это формально увеличивает их число, но оправдано улучшением общей производительности инференса.
RKNN-Toolkit2 уже частично оптимизирует граф при преобразовании модели. Однако этот процесс не универсален: в неучтённых сценариях остаются лишние операции. Пользователь может предварительно оптимизировать граф по идеям этого раздела. Методы носят ознакомительный, необязательный характер и применяются гибко по ситуации.
8.4.1 Перенос OP на NPU
Операторы вне NPU можно заменять эквивалентными преобразованиями графа на поддерживаемые NPU операторы.
Ниже на примере shufflenetv2_0.5 перемешивание каналов заменяется свёрткой. Веса 0/1 обеспечивают перестановку данных. Если Transpose и Reshape не реализуются на NPU, их можно включить в Conv для выполнения перестановки.
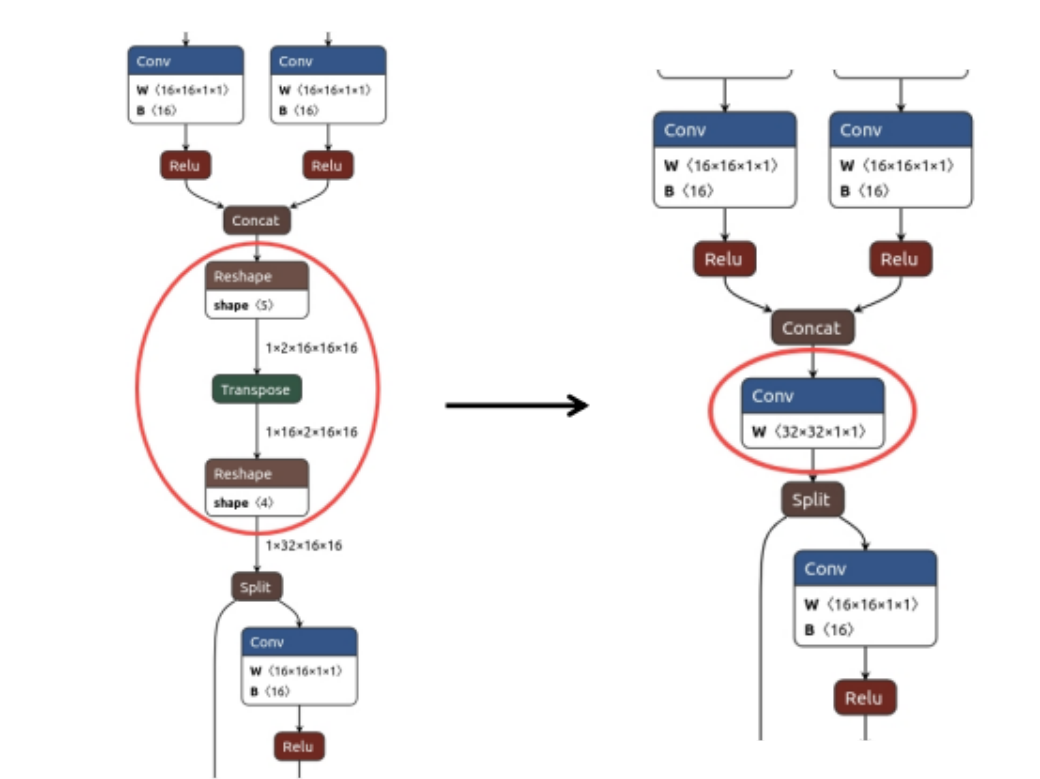
Рисунок 8-6 Перестановка с помощью свёртки
8.4.2 Аппаратное слияние при проектировании сети и оптимизации графа
NPU поддерживает слияние некоторых операторов. Их порядок можно скорректировать под правила аппаратного слияния.
Оптимизация графа в RKNN не охватывает все случаи. Некоторые теоретически сливаемые структуры не объединяются в итоговом графе. Пользователь может вручную изменить алгоритм для устранения проблемы.
Например, перестановка Transpose и Clip без изменения правильности вычислений позволяет слить Conv и Clip и повысить производительность.
Рисунок 8-7 Оптимизация и слияние графа операторов
Правила аппаратного слияния:
| Поддерживаемые правила слияния | Правила слияния, запланированные на будущее |
|---|---|
| Conv+Relu | Activation+Add(Mul) |
| Conv+PRelu(LeakyRelu) | Add(Mul)+Activation |
| Conv+Clip | Conv+Mul |
| Conv+Sigmoid(Tanh/Elu/Silu…) | Conv+Activation+Mul |
| Conv+Add | Conv+Activation+Pooling |
| Conv+Activation+Add | Conv+Activation+Add(Mul)+Pooling |
8.4.3 Преобразование подграфа
Иногда алгоритм ради наглядности не учитывает производительность при развёртывании, создавая сложный избыточный граф. Эквивалентные преобразования участка графа уменьшают число вычислительных шагов.
Ниже эквивалентное преобразование Yolov5-nano объединяет несколько сложных Slice с Conv в новый Conv и значительно упрощает граф.
Источник решения: https://github.com/ultralytics/yolov5/issues/4825
Рисунок 8-8 Эквивалентное преобразование графа
8.4.4 «Приведение подобных» и «Вынесение общего множителя»
Последовательные повторные операции можно объединить в один оператор, например Reshape, Transpose, Slice, некоторые Add/Mul/Sub/Div.
Ниже сходные операторы объединяются простым изменением порядка в графе.
Рисунок 8-9 Объединение подобных операторов
В некоторых структурах общие части можно выделить в одну операцию, изменив порядок однотипных операций.
Например, перестановка операторов позволяет вынести reshape отдельно и выполнить его только один раз.
Рисунок 8-10 Объединение повторяющихся операторов
8.5 Оптимизация отдельных операторов
Оптимизация операторов более адресная: изменение конкретных операторов дополнительно повышает производительность. Важен выбор размеров, наиболее эффективных для оборудования. Операторы близкого масштаба могут сильно различаться по времени при выровненных и невыровненных размерах: для последних аппаратуре нужны дополнительные операции для корректности. Поэтому размеры существенно влияют на скорость. Ниже приведены идеи оптимизации.
8.5.1 Размеры OP, удобные для DDR (необязательно)
Определённые выровненные размеры повышают эффективность NPU и чтения/записи DDR. При одинаковой пропускной способности более удобный доступ лучше использует DDR и повышает производительность. Ниже приведены необязательные рекомендации по размерам.
Требования к выравниванию каналов
Требования приведены в таблице ниже.
Таблица 8-1 RK3566/RK3568
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Каналы входа |
Каналы выхода |
Каналы входа и выхода |
Каналы входа и выхода |
| Int8 | 32 | 16 | 32 | 8 |
| Int16 | 16 | 8 | 16 | 4 |
| Float16 | 16 | 8 | 16 | 4 |
| BFloat16 | 16 | 8 | 16 | 4 |
Таблица 8-2 RK3588/RK3576/RV1126B
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Каналы входа |
Каналы выхода |
Каналы входа и выхода |
Каналы входа и выхода |
| Int8 | 32 | 32 | 64 | 16 |
| Int16 | 32 | 16 | 32 | 8 |
| Float16 | 32 | 16 | 32 | 8 |
| BFloat16 | 32 | 16 | 32 | 8 |
| TFloat32 | 16 | 16 | 16 | 4 |
Таблица 8-3 RV1106/RV1103
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Каналы входа |
Каналы выхода |
Каналы входа и выхода |
Каналы входа и выхода |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 16 | 16 | 16 | 8 |
Таблица 8-4 RK3562
| Conv | Depthwise Conv | Другие OP | ||
|---|---|---|---|---|
| Тип данных | Каналы входа |
Каналы выхода |
Каналы входа и выхода |
Каналы входа и выхода |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 32 | 8 | 16 | 8 |
| Float16 | 32 | 8 | 16 | 8 |
| BFloat16 | 32 | 8 | 16 | 8 |
| TFloat32 | 16 | 8 | 8 | 4 |
Выравнивание по 4 при Height * Width > 1
При одинаковом размере оператор с большей Width и меньшей Height удобнее для DDR. На рисунке справа свёртка эффективнее, чем слева.
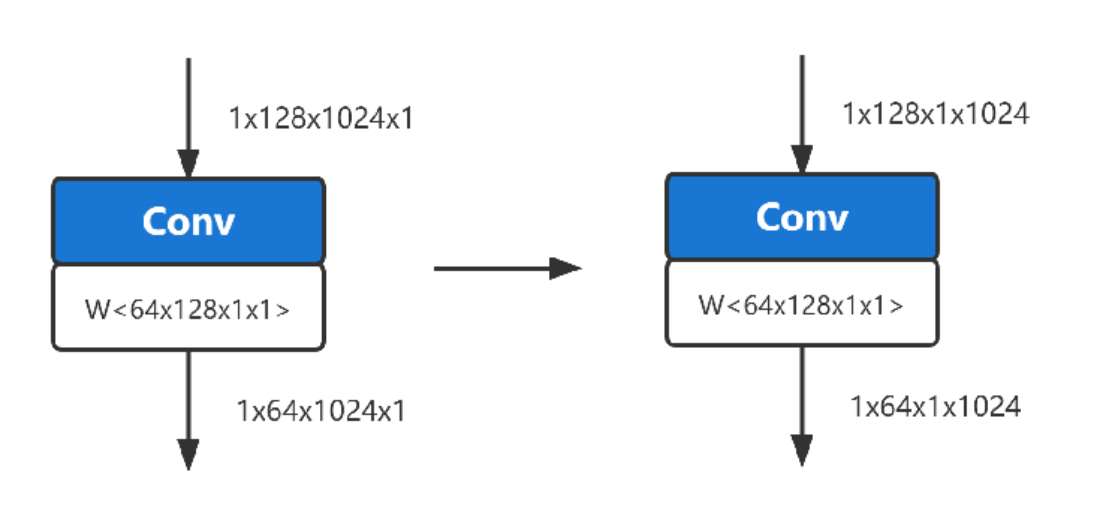
Рисунок 8-11 Сравнение свёрток одинакового размера
8.5.2 Проектирование операторов с высокой утилизацией
Для высокого использования вычислительных ресурсов нужно избегать неэффективных операторов и выбирать размеры, обеспечивающие высокую утилизацию. Далее перечислены нежелательные операторы и рассмотрена связь размера свёртки с утилизацией.
Избегайте неэффективных операторов
По возможности уменьшайте количество следующих трёх типов операторов.
Таблица 8-5 Три типа неэффективных операторов
| Перенос данных | Преобразование размеров | Функция активации, отличная от Relu |
|---|---|---|
| Transpose | Resize | Sigmoid |
| Reshape | Tile | Tanh |
| Split | Pooling | Softplus |
| Concat | Pad | Hardswish |
Связь размера свёртки с утилизацией
На свёртку влияют и вычислительная мощность, и пропускная способность. Поэтому при оценке производительности часто используют утилизацию MAC как показатель использования аппаратной вычислительной мощности.
Эта связь рассматривается как ориентир при проектировании моделей. Ниже приведены приблизительные рекомендации на основе эмпирических данных:
Обозначения: KH — высота ядра, KW — ширина ядра, KC — число каналов ядра, type_bytes — разрядность веса, делённая на 8, Ksize — KW или KH, Kstride — шаг в направлении KW или KH.
Если число каналов входного и выходного Tensor свёртки отвечает требованиям выравнивания (см. таблицу в 8.4.1), утилизация выше.
При числе каналов входного Tensor < 256 утилизация относительно высокая. При > 512 она постепенно снижается с ростом числа каналов.
Для размера весов утилизация относительно высока при KH* KW * KC * type_bytes < 6K Bytes. После превышения некоторого размера она заметно падает.
Чем больше отношение Ksize / Kstride, тем выше утилизация. Например, Ksize=3, Kstride=1 лучше, чем Ksize=2, Kstride=1.
Утилизация снижается при Height * Width выходного Tensor < 16.
Чем больше Channel выходного Tensor, тем выше утилизация.
Выше отдельные размеры рассматривались независимо. Реальная утилизация MAC свёртки в развёрнутой модели определяется сочетанием многих факторов.
8.5.3 Слияние подграфов
RKNN сопоставляет определённые связи графа пользовательским операторам, как показано ниже. Если слияния не произошло, проверьте, не отличается ли структура соединений от ожидаемой.
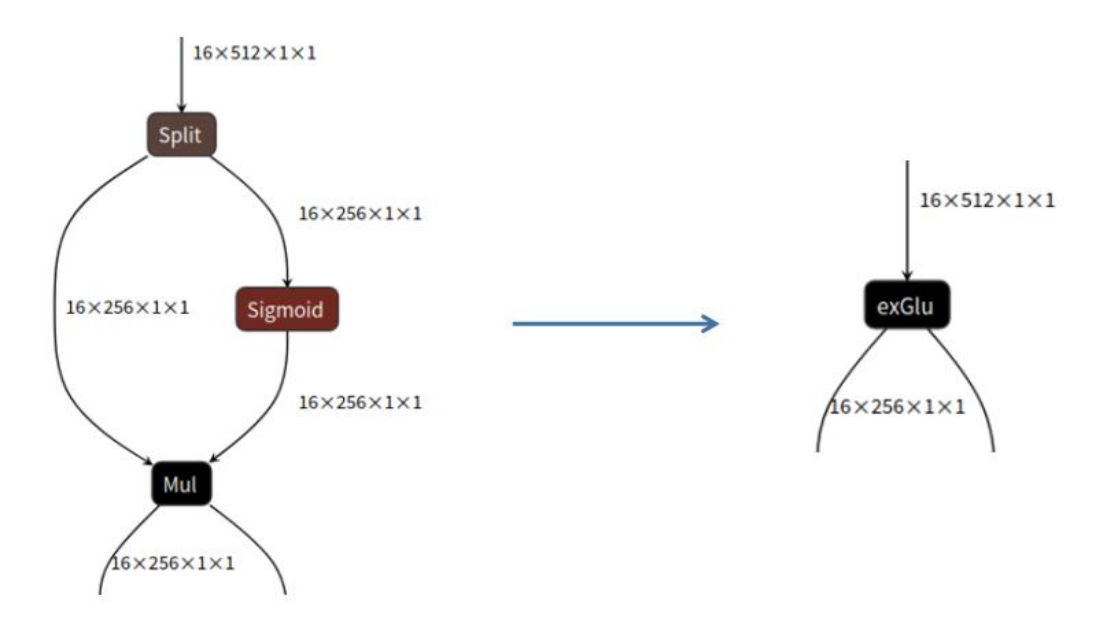
Рисунок 8-12 Слияние подграфа Glu
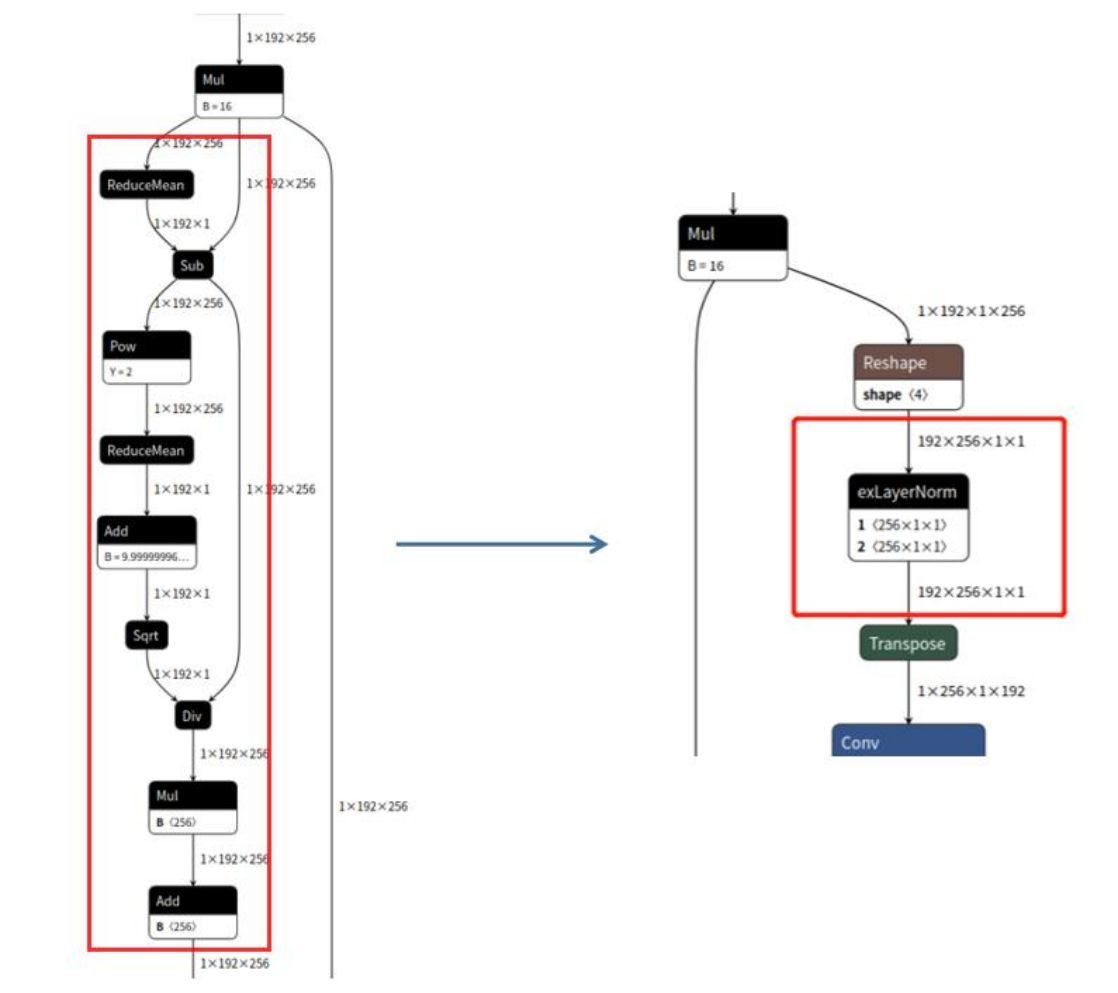
Рисунок 8-13 Слияние подграфа LayerNorm
Поддерживаемые правила слияния:
Split + Sigmoid + Mul -> GLU
ReduceMean + Sub + Pow + ReduceMean + Add + Sqrt + Div (+ Mul + Add) -> LayerNorm
9 Оптимизация использования памяти
9.1 Состав памяти и методы анализа
9.1.1 Состав памяти при выполнении модели RKNN
Память времени выполнения RKNN в основном состоит из четырёх частей: веса и внутренние тензоры, конфигурации регистров, входные тензоры и выходные тензоры. Обычно память создаётся при rknn_init.
9.1.2 Анализ памяти модели
После rknn_init() при необходимости проверить выделенную модели память или выделить веса внешним способом вызовите rknn_query с RKNN_QUERY_MEM_SIZE. Так запрашиваются веса и внутренняя память модели без входов/выходов, а также занятые при инференсе DMA- и SRAM-память. Для SRAM возвращается 0, если она не включена либо функция отсутствует.
Пример кода:
 rknn_context ctx = 0;
 // Load RKNN Model
 int ret = rknn_init(&ctx, model_path, 0, NULL, NULL);
 if (ret < 0) {
  printf("rknn_init fail! ret=%d\n", ret);
  return -1;
 }

 // Get weight and internal mem size
 rknn_mem_size mem_size;
 ret = rknn_query(ctx, RKNN_QUERY_MEM_SIZE, &mem_size, sizeof(mem_size));
 if (ret != RKNN_SUCC) {
  printf("rknn_query fail! ret=%d\n", ret);
  return -1;
 }
 printf("total weight size: %d, total internal size: %d\n", mem_size.total_weight_size, mem_size.total_internal_size);
9.2 Использование памяти, выделенной извне
9.2.1 Внешнее выделение памяти входов и выходов
Как описано в процессе C API Zero-Copy, при использовании zero-copy API можно выделить входные и выходные тензоры извне, затем передать эту память NPU. Подробный порядок приведён на блок-схеме C API Zero-Copy. Внешнее выделение требует именно zero-copy API. Такой способ предназначен прежде всего для случаев, когда приложение само выделяет память NPU вместо вызова rknn_create_mem().
Внешняя память описывается физическим адресом или fd; используются главным образом следующие два интерфейса:
rknn_create_mem_from_phys(): создаёт структуру rknn_tensor_mem по физическому адресу.
rknn_create_mem_from_fd(): создаёт структуру rknn_tensor_mem по fd.
Ниже показан пример выделения памяти через mpi mmz. rknn_create_mem_from_phys() использует физический адрес внешней памяти для создания структуры rknn_tensor_mem с информацией о физической памяти.
......

// Create input tensor memory
rknn_tensor_mem* input_mems[1];
// default input type is int8 (normalize and quantize need compute in outside)
// if set uint8, will fuse normalize and quantize to npu
input_attrs[0].type = input_type;
// default fmt is NHWC, npu only support NHWC in zero copy mode
input_attrs[0].fmt = input_layout;

input_mems[0] = rknn_create_mem_from_phys(ctx, input_phys, input_virt, input_attrs[0].size_with_stride);

......

// Create output tensor memory
rknn_tensor_mem* output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
  output_mems[i] = rknn_create_mem_from_phys(ctx, output_physs[i], output_virts[i], output_attrs[i].size);
}

// Set input tensor memory
ret = rknn_set_io_mem(ctx, input_mems[0], &input_attrs[0]);
if (ret < 0) {
  printf("rknn_set_io_mem fail! ret=%d\n", ret);
  return -1;
}

// Set output tensor memory
for (uint32_t i = 0; i < io_num.n_output; ++i) {
  // set output memory and attribute
  ret = rknn_set_io_mem(ctx, output_mems[i], &output_attrs[i]);
  if (ret < 0) {
    printf("rknn_set_io_mem fail! ret=%d\n", ret);
    return -1;
  }
}
Кроме физического адреса внешнюю память можно подключить через fd. Пример кода:
int mb_flags = RK_MMZ_ALLOC_TYPE_CMA | RK_MMZ_ALLOC_UNCACHEABLE;

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, mem_size.total_weight_size, mb_flags);
if (ret < 0) {
  printf("RK_MPI_MMZ_Alloc failed, ret: %d\n", ret);
  return ret;
}
void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
if (weight_virt == NULL) {
  printf("RK_MPI_MMZ_Handle2VirAddr failed!\n");
  return -1;
}
int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
if (weight_fd < 0) {
  printf("RK_MPI_MMZ_Handle2Fd failed!\n");
  return -1;
}
weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);
9.2.2 Внешнее выделение памяти модели
Как отмечалось в разделе о составе и анализе памяти, память модели разделена на внутреннюю память и память весов. Чтобы использовать внешнюю память, приложение задаёт память весов через rknn_set_weight_mem(), а внутреннюю — через rknn_set_internal_mem(). Пример кода:
// Load RKNN Model
ret = rknn_init(&ctx, model_virt, model_size, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
TIME_END(rknn_init);
if (ret < 0) {
  printf("rknn_init fail! ret=%d\n", ret);
  return -1;
}

//query and inset input / output tensor
......

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, SIZE_ALIGN_128(mem_size.total_weight_size), mb_flags);
void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);

weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);

ret = rknn_set_weight_mem(ctx, weight_mem);
if (ret < 0) {
  printf("rknn_set_weight_mem fail! ret=%d\n", ret);
  return -1;
}
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);

// Allocate internal memory in outside
MB_BLK internal_mb;
rknn_tensor_mem* internal_mem;
ret = RK_MPI_MMZ_Alloc(&internal_mb, SIZE_ALIGN_128(mem_size.total_internal_size), mb_flags);
void* internal_virt = RK_MPI_MMZ_Handle2VirAddr(internal_mb);
int internal_fd = RK_MPI_MMZ_Handle2Fd(internal_mb);

internal_mem = rknn_create_mem_from_fd(ctx, internal_fd, internal_virt, mem_size.total_internal_size, 0);
ret = rknn_set_internal_mem(ctx, internal_mem);
if (ret < 0) {
  printf("rknn_set_internal_mem fail! ret=%d\n", ret);
  return -1;
}
printf("internal mb info: virt = %p, fd = %d, size: %d\n", internal_virt, internal_fd, mem_size.total_internal_size);
9.3 Повторное использование внутренней памяти
RKNN API позволяет управлять NPU-памятью извне. Флаг RKNN_FLAG_MEM_ALLOC_OUTSIDE указывает, что память промежуточных признаков модели выделяется внешним способом. Типичные применения:
При развёртывании пользователь выделяет всю NPU-память сам, что позволяет согласованно распределить память всей системы.
При последовательном запуске нескольких моделей память промежуточных признаков повторно используется разными контекстами; особенно полезно для RV1103/RV1106 с очень ограниченной памятью.
В исходной схеме Internal Tensor модели 1 больше, чем модели 2. При последовательном выполнении приложение может выделить для обеих моделей один общий участок 0x00000000~0x000c4000. После инференса модели 1 модель 2 использует тот же участок для чтения/записи Internal Tensor, экономя память. Это схематические адреса исходника, не проверенные адреса платы.
Рисунок 9-1. Два Internal Tensor разных моделей используют общее адресное пространство
Пусть пути моделей 1 и 2 — model_path_a и model_path_b. Пример кода:
rknn_init(&ctx_a, model_path_a, 0, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_a, RKNN_QUERY_MEM_SIZE, &mem_size_a, sizeof(mem_size_a));

rknn_init(&ctx_b, model_path_b, 0, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_b, RKNN_QUERY_MEM_SIZE, &mem_size_b, sizeof(mem_size_b));

// Get the largest internal size of the two models
max_internal_size = MAX(mem_size_a.total_internal_size, mem_size_b.total_internal_size);
internal_mem_max = rknn_create_mem(ctx_a, max_internal_size);
// Set a model internal memory
internal_mem_a = rknn_create_mem_from_fd(ctx_a, internal_mem_max->fd,
internal_mem_max->virt_addr, mem_size_a.total_internal_size, 0);
rknn_set_internal_mem(ctx_a, internal_mem_a);
// Set b model internal memory
internal_mem_b = rknn_create_mem_from_fd(ctx_b, internal_mem_max->fd,
internal_mem_max->virt_addr, mem_size_b.total_internal_size, 0);
rknn_set_internal_mem(ctx_b, internal_mem_b);
9.4 Повторное использование контекста RKNN в нескольких потоках
В многопоточной программе одну модель могут выполнять несколько потоков одновременно. Если каждый создаёт собственный контекст, расход памяти велик. Поэтому приложение может рассмотреть совместное использование контекста, чтобы избежать повторного выделения RKNN-контекста и уменьшить память времени выполнения.
RKNN API предоставляет интерфейс повторного использования контекста:
int rknn_dup_context(rknn_context* context_in,rknn_context* context_out)
context_in — уже инициализированный контекст; context_out — контекст, повторно использующий context_in.
На следующей схеме структуры моделей двух контекстов одинаковы, поэтому возможно повторное использование контекстов.
Рисунок 9-2. Повторное использование контекстов для двух одинаковых моделей
9.5 Общие веса моделей с разным разрешением
Если веса моделей с разными разрешениями одинаковы, они могут совместно использовать память весов. В RKNPU SDK <= 1.5.0 это позволяет динамически переключать разрешения при небольшом расходе памяти; после 1.5.0 источник указывает замену данного механизма функцией dynamic shape.
На следующей схеме веса моделей A и B полностью совпадают.
Рисунок 9-3. Общие веса двух моделей с разными разрешениями
Совместное использование весов моделей с разными разрешениями реализуется так:
1. При преобразовании RKNN одну модель задайте как master с remove_weight=False в rknn.config, другую — как slave с remove_weight=True. Master-модель RKNN содержит веса; slave-модель не содержит весов свёрточного типа.
2. При развёртывании сначала инициализируйте master-модель RKNN, затем slave. Для slave используйте RKNN_FLAG_SHARE_WEIGHT_MEM и добавьте параметр rknn_init_extend с контекстом master-модели. Пусть пути моделей — model_A и model_B. Пример кода:
rknn_context context_A;
rknn_context context_B;
ret = rknn_init(&context_A,model_A,0,0,NULL);
...
rknn_init_extend extend;
extend.ctx = context_A;
ret = rknn_init(&context_B,model_B,0,RKNN_FLAG_SHARE_WEIGHT_MEM,&extend);
10 Устранение неполадок
10.1 Проблемы окружения NPU SDK
Совместимость версий
Драйвер ядра NPU и Runtime
Рекомендуется обновить драйвер ядра NPU до версии 0.9.2 или новее. При возникновении проблем попробуйте установить последнюю версию драйвера ядра NPU.
Модель RKNN (версия определяется RKNN-Toolkit2) и Runtime:
Таблица 10-1 Соответствие версий модели RKNN и Runtime
| Версия модели RKNN | Версия Runtime |
|---|---|
| 1.2.0 | >=1.2.0 и <=1.5.0 |
| 1.3.0 | >=1.3.0 и <=1.5.0 |
| 1.4.0 | >=1.4.0 и <=1.5.0 |
| 1.5.0 | 1.5.0 |
| 1.5.2 | >=1.5.2 |
| 1.6.0 | >=1.5.2 |
| 2.0.0 | >=2.0.0 |
| 2.1.0 | >=2.1.0 |
Как обновить драйвер ядра NPU
Для обновления драйвера NPU рекомендуется обновить всю прошивку. Соответствующую прошивку должен предоставить производитель платы.
Использование NPU в Docker
При запуске контейнера Docker сопоставьте ресурсы NPU с указанными путями. Пример команд:
docker run -t -i --privileged -v /dev/dri/renderD129:/dev/dri/renderD129 -v /proc/device-tree/compatible:/proc/device-tree/compatible -v /usr/lib/librknnrt.so:/usr/lib/librknnrt.so ai_application:v1.0.0 /bin/bash
Пояснения параметров:
/dev/dri/renderD129 — узел устройства NPU RK3588. Runtime использует этот узел для включения NPU.
/proc/device-tree/compatible содержит модель SOC. Такие компоненты, как RKNN-Toolkit Lite2, получают из этого файла сведения о текущем SOC.
/usr/lib/librknnrt.so — файл Runtime. RKNN-Toolkit Lite2 и RKNPU2 C API используют его для доступа к ресурсам NPU.
ai_application:v1.0.0 означает <имя образа Docker>:<версия>.
10.2 Проблемы установки RKNN-Toolkit2
Слишком строгие зависимости мешают установке RKNN-Toolkit2
Если все зависимые библиотеки установлены, но версии некоторых из них не соответствуют требованиям, попробуйте добавить –no-deps после команды установки, чтобы отключить проверку окружения при установке Python wheel:
pip install rknn-toolkit2*.whl --no-deps
Зависимость от PyTorch
Рекомендуемые версии PyTorch: 1.6.0, 1.9.0, 1.10 или 1.13.1.
Функция загрузки моделей PyTorch зависит от библиотеки PyTorch. Модели PyTorch делятся на модели с плавающей точкой и квантованные модели (включая QAT и PTQ).
Для моделей, экспортированных PyTorch 1.6.0, рекомендуется понизить версию PyTorch, используемую RKNN-Toolkit2, чтобы избежать ошибок загрузки.
Для квантованных моделей (QAT, PTQ) рекомендуется экспорт через PyTorch 1.10~1.13.1 и обновление PyTorch, от которого зависит RKNN-Toolkit2, до 1.10~1.13.1.
Итак, версия PyTorch для экспорта модели должна по возможности совпадать с версией PyTorch, используемой RKNN-Toolkit2.
Зависимость от TensorFlow
Рекомендуемые версии TensorFlow: 2.6.2, 2.8.0.
Загрузка моделей TensorFlow в RKNN-Toolkit2 зависит от библиотеки TensorFlow. Совместимость между версиями TensorFlow ограничена, поэтому другие версии могут вызывать ошибки загрузки моделей в RKNN-Toolkit2. Рекомендуется по возможности использовать при экспорте ту же версию Tensorflow, от которой зависит RKNN-Toolkit2.
Проблемы из-за версии TensorFlow обычно проявляются на этапе rknn.load_tensorflow(); сообщение об ошибке указывает путь к зависимой библиотеке TensorFlow.
Правила именования установочного пакета RKNN-Toolkit2
На примере выпуска 1.5.2 имя wheel-пакета RKNN-Toolkit2 формируется следующим образом:
rknn_toolkit2-1.5.2+b642f30c-cp38-cp38-linux_x86_64.whl
rknn_toolkit2: имя инструмента.
1.5.2: версия.
b642f30c: идентификатор commit.
cp<xx>-cp<xx>: поддерживаемая версия Python; например, cp38-cp38 означает Python 3.8.
linux_x86_64: тип системы и архитектура CPU.
Несоответствие типа системы, архитектуры CPU или версии Python приводит к сбою установки RKNN-Toolkit2.
Есть ли версия RKNN-Toolkit2 для ARM Linux?
Версии для ARM Linux нет. Для инференса через Python в ARM Linux можно установить RKNN-Toolkit-lite2, поддерживающий такой режим.
Сбой установки библиотеки bfloat16
При установке библиотеки bfloat16 возникла следующая ошибка:
Оригинальный скриншот обрезан; перенесён только видимый текст. Невидимые части не восстановлены предположениями.
bfloat16.cc:2013:57: note: expected a type, got ‘bfloat16’
bfloat16.cc:2013:57: error: type/value mismatch at argument 2 in templa
e, class Functor> struct greenwaves::{anonymous}::UnaryUFunc’
bfloat16.cc:2013:57: note: expected a type, got ‘bfloat16’
bfloat16.cc:2015:67: error: ‘>>’ should be ‘> >’ within a nested templa
RegisterUFunc<BinaryUFunc<bfloat16, bfloat16, ufuncs::NextAfter>>(
                                                               ^
bfloat16.cc:2015:58: error: type/value mismatch at argument 1 in templa
e, class Functor> struct greenwaves::{anonymous}::BinaryUFunc’
RegisterUFunc<BinaryUFunc<bfloat16, bfloat16, ufuncs::NextAfter>>(
Рисунок 10-1 Журнал сбоя установки зависимой библиотеки bfloat16
Смените источник pip на Alibaba либо обновите RKNN-Toolkit2 до 1.5.0 или новее (начиная с 1.5.0 зависимость от bfloat16 удалена).
10.3 Описание параметров преобразования модели
В этом разделе описывается применение часто используемых параметров преобразования модели.
Параметры, определяемые моделью
При преобразовании модели интерфейсы rknn.config() и rknn.build() влияют на результат. Указание входных и выходных узлов через rknn.load_onnx и rknn.load_tensorflow() также влияет на результат, как и размеры входов, задаваемые через rknn.load_pytorch() и rknn.load_tensorflow().
Основные шаги преобразования модели:
1. Подготовьте данные квантования и файл dataset.txt.
2. Определите платформу NPU, например RK3566 или RV1106, и задайте target_platform в rknn.config().
3. Если вход — 3-канальное изображение, а данные квантования имеют формат изображения (jpg, png), уточните, использует ли модель RGB или BGR, и задайте quant_img_RGB2BGR в rknn.config().
4. Уточните параметры нормализации при обучении модели, чтобы задать mean_values и std_values в rknn.config.
5. Уточните размер входа модели и заполните соответствующие параметры интерфейса load, например input_size_list в rknn.load_pytorch().
6. Определите требуемую разрядность квантования, чтобы задать quantized_dtype в rknn.config(). Если квантование не требуется или загружается уже квантованная модель, этот шаг можно пропустить.
7. Определите алгоритм квантования модели, чтобы задать quantized_algorithm в rknn.config(). Если квантование не требуется или загружается уже квантованная модель, этот шаг можно пропустить.
8. Определите, требуется ли квантование, чтобы задать do_quantization в rknn.build(). При включённом квантовании параметр dataset в rknn.build() должен указывать данные квантования.
Межплатформенная совместимость моделей RKNN
Для платформы, заданной target_platform в rknn.config(), действуют следующие отношения совместимости:
Модель RKNN для RK3566 можно использовать на RK3568.
Модель RKNN для RK3588 можно использовать на RK3588s.
Модель RKNN для RV1106 можно использовать на RV1103.
Формат и требования к данным квантования
Данные квантования имеют два формата: изображения (jpg, png), читаемые RKNN-Toolkit2 через OpenCV, и npy, читаемый через numpy.
Если вход модели — не изображение RGB/BGR, рекомендуется предоставлять данные квантования в формате numpy npy.
Формат dataset.txt для модели с несколькими входами
Для квантования модели файл dataset.txt должен задавать пути к данным. Одна строка представляет один набор входов. Если входов несколько, их записывают в одной строке через пробел.
Пример модели с одним входом и двумя наборами данных квантования:
sampleA.npy
sampleB.npy
Пример модели с тремя входами и двумя наборами данных квантования:
sampleA_in0.npy sampleA_in1.npy sampleA_in2.npy
sampleB_in0.npy sampleB_in1.npy sampleB_in2.npy
Проверка quant_img_RGB2BGR в rknn.config()
При использовании изображений (jpg, png) для квантования нужно учитывать quant_img_RGB2BGR.
Если модель обучалась на RGB, установите quant_img_RGB2BGR=False либо не задавайте его. Для инференса через Python API и RKNPU2 CAPI также подавайте RGB-изображения.
Если модель обучалась на BGR, установите quant_img_RGB2BGR=True. Для инференса через Python API и RKNPU2 CAPI подавайте BGR-изображения. quant_img_RGB2BGR влияет только на чтение изображений при квантовании.
Если данные квантования сохранены в numpy npy, рекомендуется не использовать quant_img_RGB2BGR во избежание путаницы.
Порядок применения mean, std и quant_img_RGB2BGR в rknn.config()
quant_img_RGB2BGR влияет лишь на чтение изображений на этапе квантования, но не на другие этапы.
Поэтому в интерфейсах инференса RKNN-Toolkit2 Python API и RKNPU2 C API из входных данных сначала вычитают Mean, затем делят на std и передают в модель RKNN.
Настройка mean_values и std_values в rknn.config() для модели с числом входных каналов, отличным от 3, или с несколькими входами.
Формат настройки mean_values и std_values одинаков. Рассмотрим mean_values.
Если вход имеет N каналов, значение mean_values равно [[channel_1, channel_2, channel_3, channel_4, …, channel_n]].
При нескольких входах значение mean_values равно [[channel_1, channel_2, channel_3, channel_4, …, channel_n], [channel_1, channel_2, channel_3, channel_4, …, channel_n]].
Алгоритм квантования и выбор числа изображений
RKNN-Toolkit2 предоставляет три алгоритма калибровки параметров квантования через quantized_algorithm в rknn.config(): normal, mmse и kl_divergence. По умолчанию используется normal.
normal — базовый алгоритм квантования.
mmse итеративно обрабатывает результаты промежуточных слоёв и ограничивает значения весов определённым диапазоном для повышения точности инференса. Повышение точности не гарантируется; по сравнению с normal квантование требует больше памяти и времени.
kl_divergence требует больше времени, чем normal, но значительно меньше, чем mmse. В некоторых сценариях с неравномерным распределением признаков он даёт лучшие результаты.
Рекомендуется сначала использовать normal. Если точность после квантования неудовлетворительна, попробуйте mmse или kl_divergence.
Для normal и kl_divergence рекомендуется 20-200 наборов данных; для mmse — 20-50.
Различия входов и выходов при инференсе квантованных и неквантованных моделей
При использовании общего RKNPU2 C API (без pass_through и zero_copy) тип входных данных, например uint8 или float, не зависит от того, квантована ли модель. Выход можно автоматически преобразовать в float32 или сохранить формат модели. При использовании Python-интерфейса инференса имеются отличия, приведённые ниже:
Таблица 10-2 Отличия Python-интерфейса инференса от общего C API
| После квантования модели | Python-интерфейс инференса (rknn.inference()) | C API инференса (rknn.run()) (без pass_through и zero_copy) |
|---|---|---|
| Ограничения типа входа | Нет ограничений. Вход rknn.inference() — список массивов numpy с атрибутом типа данных. Вход автоматически преобразуется в тип, требуемый моделью RKNN. |
Нет ограничений. Параметр rknn_tensor_type структуры rknn_inputs может задавать RKNN_TENSOR_FLOAT32, RKNN_TENSOR_FLOAT16, RKNN_TENSOR_INT8, RKNN_TENSOR_UIN8, RKNN_TENSOR_INT16 согласно реальным входным данным. После задания вход автоматически преобразуется в тип, требуемый моделью RKNN. |
| Меняется ли тип выходных данных? | Не меняется. Независимо от квантования Python-интерфейс rknn.inference() всегда возвращает float. Другой тип задать нельзя. |
Меняется. В RKNPU2 C API атрибут rknn outputs можно задать как want_float=1 для получения float. После квантования want_float=0 возвращает тип, заданный моделью. Например, при квантовании i8 выход имеет тип int8. |
| Меняется ли формат входа (NCHW, NHWC)? | Не меняется. Независимо от квантования параметр data_format в rknn.inference() можно задавать как nchw или nhwc по необходимости. |
Меняется. Независимо от квантования параметр rknn_tensor_format структуры rknn inputs можно задавать как NCHW или NHWC по необходимости. |
Есть ли режим онлайн-предкомпиляции?
RKNN-Toolkit2 поддерживает только экспорт офлайн-предкомпилированных моделей, но не онлайн-предкомпилированных моделей, доступных в RKNN-Toolkit1. Поэтому выбора между этими режимами нет.
Можно ли использовать модель, преобразованную RKNN-Toolkit, на RK3566?
Нет.
Модели RKNN, преобразованные RKNN-Toolkit, предназначены для RK1806 / RK1808 / RK3399Pro / RV1109 / RV1126. Для RK3566 нужна модель, преобразованная RKNN-Toolkit2. Модели RKNN-Toolkit2 подходят для RK2118/ RV1103B/ RV1103 / RV1106B / RV1106 / RV1126B / RK3562 / RK3566 / RK3568 / RK3576/ RK3588.
Инструкции по RKNN-Toolkit приведены в проекте: https://github.com/airockchip/rknn-toolkit
Инструкции по RKNN-Toolkit2 приведены в проекте: https://github.com/airockchip/rknn-toolkit2
10.4 Вопросы о фреймворках глубокого обучения
10.4.1 Фреймворки глубокого обучения и версии, поддерживаемые RKNN-Toolkit2
См. раздел 3.1.
10.4.2 Список поддерживаемых операторов каждого фреймворка
Уровень поддержки разных фреймворков в RKNN-Toolkit2 различается. Подробности приведены в документе RKNNToolkit2_OP_Support по ссылке:
https://github.com/airockchip/rknn-toolkit2/blob/master/doc/
10.4.3 Вопросы о преобразовании моделей ONNX
Ошибка «Error parsing message» при загрузке модели
Например, преобразование модели examples/onnx/resnet50v2 завершается с сообщением:
E load_onnx: Catch exception when loading onnx model: /rknn_resnet_demo/resnet50v2.onnx!

E lod_onnx: Traceback (most recent call last):

E load_onnx: File "rknn/api/rknn_base.py", line 1094, in rknn.api.rknn_base.RKNNBase.load_onnx

E load_onnx: File "/usr/local/lib/python3.6/dist-packages/onnx/__init__.py", line 115, in load_model

……

E load_onnx: google.protobuf.message.DecoderError: Error parsing message
Возможно, resnet50v2.onnx повреждён или загружен не полностью. Скачайте модель заново и проверьте MD5, например:
22ed6e6a8fb9192f0980acca0c941414 resnet50v2.onnx
Поддерживается ли динамическая форма входа?
Например, вход ONNX [-1, 3, -1, -1] означает, что batch, height и width не фиксированы. RKNN-Toolkit2 до версии 1.5.2 не поддерживает динамическую форму входа.
Версии 1.5.2 и новее поддерживают их через dynamic_input в rknn.config(); подробности см. в разделе 5.4.
Ошибка при задании собственного выходного узла
Например, вызов rknn.load_onnx() с параметром outputs приводит к следующей ошибке:
E load_onnx: the '378' in outputs=['378', '439', '500'] is invalied!
Журнал сообщает, что выходной узел 378 недействителен. Параметр outputs должен содержать правильное имя выходного узла.
10.4.4 Вопросы о преобразовании моделей Pytorch
Ошибка загрузки модели Pytorch: у torch._C нет атрибута _jit_pass_inline
Журнал ошибки:
'torch._C' has no attribute '_jit_pass_inline'
Обновите PyTorch до 1.6.0 или новее.
Формат сохранения моделей Pytorch
Сейчас поддерживаются только модели, экспортированные через torch.jit.trace(). torch.save() сохраняет лишь словарь весов без структуры сети; такой файл нельзя корректно импортировать и преобразовать в RKNN.
Сбой PytorchStreamReader при преобразовании
Журнал ошибки:
E Catch exception when loading pytorch model: ./mobilenet0.25_Final.pth!

E Traceback (most recent call last):

……

E cpp_module = torch._C.import_ir_module(cu, f, map_location, extra_files)

E RuntimeError: [enforce fail at inline container.cc:137]. PytorchStreamReader failed reading zip archive: faild
finding central directory frame #0 ……
Причина — отсутствие сведений о структуре сети в модели PyTorch.
Файл .pth обычно содержит только веса. Для экспорта модели со структурой сети сначала инициализируйте соответствующую структуру и загрузите веса .pth через net.load_state_dict(). Затем зафиксируйте структуру и веса через torch.jit.trace(). Сохраните трассированную модель в .pt с помощью torch.jit.save(); rknn.load_pytorch() сможет преобразовать её в RKNN.
KeyError при преобразовании
Журнал ошибки:
E Traceback (most recent call last):

……

E KeyError: 'aten::softmax'
Сообщение вида KeyError: ‘aten::xxx’ означает, что текущая версия не поддерживает этот оператор. При обновлениях RKNN-Toolkit2 такие ошибки исправляются; используйте последнюю версию.
Ошибка «Syntax error in input! LexToken(xxx)» при преобразовании
Журнал ошибки:
WARNING: Token 'COMMENT' defined, but not used

WARNING: There is 1 unused token

!!!!! Illegal character '"'

Syntax error in input! LexToken(NAMED_IDENTIFIER, 'fc', 1, 27)

!!!!! Illegal character '"'
Причин может быть несколько. Проверяйте в следующем порядке:
1) Сеть создана без наследования torch.nn.module. Создайте её на основе класса torch.nn.module и затем сформируйте pt-файл через torch.jit.trace().
2) Обновите RKNN-Toolkit2 до 1.4.0 или новее. Для torch рекомендуются 1.6.0, 1.9.0, 1.10.0 или 1.13.1.
10.4.5 Вопросы о преобразовании моделей Tensorflow
Ошибка модели Tensorflow1.x
При загрузке модели tensorflow1.x через rknn.load_tensorflow() появляется сообщение:
E load_tensorflow: Catch exception when loading tensorflow model: ./yolov3_mobilenetv2.pb!

E load_tensorflow: Traceback (most recent call last):

……

E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects to be colocated with unknown node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'

E load_tensorflow: During handling of the above exception, another exception occurred:

E load_tensorflow: Traceback (most recent call last):

E load_tensorflow: File "rknn/api/rknn_base.py", line 990, in rknn.api.rknn_base.RKNNBase.load_tensorflow

……

E load_tensorflow: return func(*args, **kwargs)

E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
431, in import_graph_def

E load_tensorflow: raise ValueError(str(e))

E load_tensorflow: ValueError: Node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects
to be colocated with unknown node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'
Рекомендации:
Если установлен TensorFlow 1.x, обновите его до TensorFlow 2.x.
Обновите RKNN-Toolkit2/RKNPU2 до последней версии.
Ошибка TransformGraph
Журнал ошибки:
Traceback (most recent call last):

File "test.py", line 80, in <module>

input_size_list=[[1, 368, 368, 3]])

File "/usr/local/lib/python3.6/site-packages/rknn/api/rknn.py", line 68, in load_tensorflow

input_size_list=input_size_list, outputs=outputs)

File "rknn/api/rknn_base.py", line 940, in rknn.api.rknn_base.RKNNBase.load_tensorflow
File "/usr/local/lib/python3.6/dist-packages/tensorflow/tools/graph_transforms/__init__", line 51, in
TransformGraph.transforms_string, status)

File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/errors_impl.py". ;ome 548, in __exit__

C_api.TF_GetCode(self.status.status)

Tensorflow.python.framework.error_impl.InvalidArgumentError: Beta input to batch norm has bad shape: [24]
Причины:
1) RKNN-Toolkit2 вызывает собственную функцию TensorFlow TransformGraph для оптимизации модели, но вызов завершается ошибкой.
2) Возможно, версия TensorFlow, использованная при экспорте, несовместима с установленной версией.
Рекомендации:
Экспортируйте модель с помощью TensorFlow 1.14.0 либо найдите аналогичную модель в другом фреймворке глубокого обучения.
Ошибка «Shape must be rank 4 but is rank 0»
При загрузке модели pb следующей командой:
  rknn.load_tensorflow(tf_pb='./model.pb',

  inputs=["X","Y"],

  outputs=['generator/xs'],

  input_size_list=1, INPUT_SIZE, INPUT_SIZE, 3)
Возникает ошибка:
  E load_tensorflow: Catch exception when loading tensorflow model: ./model.pb!

  E load_tensorflow: Traceback (most recent call last):

  E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
427, in import_graph_def

  E load_tensorflow: graph._c_graph, serialized, options) # pylint: disable=protected-access

  E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Shape must be rank 4 but is
rank 0 for 'generator/conv2d_3/Conv2D' (op: 'Conv2D') with input shapes: [], [7,7,3,32].
Возможно, модель имеет несколько входов, а input_size_list в rknn.load_tensorflow() заполнен не по спецификации. См. следующий пример в examples/functions/multi_input_test:
  rknn.load_tensorflow(tf_pb='./conv_128.pb',

  inputs=['input1', 'input2', 'input3', 'input4'],

  outputs=['output'],

  input_size_list=[[1, 128, 128, 3], [1, 128, 128, 3],

  [1, 128, 128, 3], [1, 128, 128, 1]])
Диагностика ошибок загрузки модели
Сначала убедитесь, что исходный фреймворк корректно загружает и вызывает модель.
Затем обновите RKNN-Toolkit2 до последней версии. Неподдерживаемые слои или операторы должны быть указаны в отладочном журнале. При необходимости вызовите RKNN(verbose=True), чтобы получить более подробные журналы преобразования.
Если проблема остаётся, передайте версию RKNN-Toolkit2 и подробный журнал ошибок команде разработки Rockchip NPU.
10.5 Проблемы квантования модели
Влияние квантования на размер модели
Возможны два случая. Если импортируется квантованная модель, do_quantization=False в rknn.build() использует её параметры квантования. Если импортируется модель с плавающей точкой, квантование не выполняется, но веса преобразуются из float32 в float16 почти без потери точности. В обоих случаях размер модели и занимаемое ею пространство уменьшаются.
Должны ли изображения для квантования иметь тот же размер, что и вход модели?
Не обязательно.
RKNN-Toolkit2 автоматически изменяет размеры изображений. Однако это может изменить информацию изображения и повлиять на точность квантования, поэтому лучше использовать изображения требуемого входного размера.
Если калибровочные данные — не изображения, например npy, их форма должна совпадать с входом модели.
Нужно ли менять калибровочные данные согласно rknn_batch_size?
Не нужно.
Параметр rknn_batch_size в rknn.build() меняет только размерность batch экспортируемой модели RKNN — с 1 на rknn_batch_size — и не влияет на квантование. Поэтому данные калибровки готовят как для модели без пакетной обработки.
При квантовании программа преобразования зависает или принудительно завершается
В ходе квантования RKNN-Toolkit2 выделяет участки системной памяти, из-за чего программа может зависнуть или быть завершена системой.
Решение: увеличьте оперативную память компьютера или виртуальную память (раздел swap).
10.6 Проблемы преобразования модели
Типичные ошибки преобразования
Ошибки преобразования, подобные приведённым ниже, вероятно, вызваны дефектом текущей версии. Попробуйте обновить RKNN-Toolkit2 до последней версии.
Ошибка вида infer_shapes
  (op_type:Mul, name:Where_2466_mul): Inferred elem type differs from existing elem type: (FLOAT) vs
(INT64)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1555, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 5409, in rknn.api.graph_optimizer.GraphOptimizer.run

  E build: File "rknn/api/graph_optimizer.py", line 5123, in
rknn.api.graph_optimizer.GraphOptimizer._fuse_ops

  E build: File "rknn/api/ir_graph.py", line 180, in rknn.api.ir_graph.IRGraph.rebuild

  E build: File "rknn/api/ir_graph.py", line 140, in rknn.api.ir_graph.IRGraph._clean_model

  E build: File "rknn/api/ir_graph.py", line 56, in rknn.api.ir_graph.IRGraph.infer_shapes

  E build: File "/home/anaconda3/envs/rk2/lib/python3.6/site-packages/onnx/shape_inference.py", line 35, in
infer_shapes

  E build: inferred_model_str = C.infer_shapes(model_str, check_type)

  E build: RuntimeError: Inferred elem type differs from existing elem type: (FLOAT) vs (INT64)
или:
  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 6256, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops

  E build: File "rknn/api/ir_graph.py", line 285, in rknn.api.ir_graph.IRGraph.rebuild

  E build: File "rknn/api/ir_graph.py", line 149, in rknn.api.ir_graph.IRGraph._clean_model

  E build: File "rknn/api/ir_graph.py", line 62, in rknn.api.ir_graph.IRGraph.infer_shapes

  E build: File "/usr/local/lib/python3.6/dist-packages/onnx/shape_inference.py", line 35, in infer_shapes

  E build: inferred_model_str = C.infer_shapes(model_str, check_type)
  E build: RuntimeError: Inferred shape and existing shape differ in rank: (0) vs (3)
или:
  (op_type:ReduceMax, name:ReduceMax_18): Interred shape and existing shape differ in rank: (3) vs (0)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  ……

  E build: RuntimeError: Interred shape and existing shape differ in rank: (3) vs (0)
Ошибка вида _p_fuse_two_mul
  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 6197, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops

  E build: File "rknn/api/graph_optimizer.py", line 204, in rknn.api.graph_optimizer._p_fuse_two_mul

  E build: ValueError: non-broadcastable output operand with shape () doesn't match the broadcast shape
(3,2)
Ошибка вида «Segmentation fault»
Например, ошибка преобразования модели picodet:
 I _fold_constant remove nodes = ['Shape_0', 'Gather_4', 'Shape_1', 'Gather_6', 'Unsqueeze_0',
'Concat_8', 'Cast_3']

Segmentation fault (Core dumped)
Ошибка вида _p_fuse_mul_into_conv
E build: Catch exception when building RKNN model:

……
E build: ValueError: non broadcastable output operand whith shape (1,258,1,256) doesn`t match the
broadcast shape (80256,258,1,256)
Как определить, поддерживается ли оператор в RKNN
Попробуйте преобразовать модель. Если оператор не поддерживается, появится соответствующее сообщение.
Также можно обратиться к двум документам поддержки операторов:
doc/RKNNToolKit2_OP_Support-x.x.x.md в выпуске RKNN-Toolkit2 содержит общий список поддержки для каждого фреймворка.
doc/RKNN_Compiler_Support_Operator_List_vx.x.x.pdf в выпуске RKNPU2 содержит подробные спецификации операторов RKNN.
Сообщение о том, что ‘expand’ не поддерживается
Рекомендации:
1. Новая версия уже поддерживает ‘Expand’ на CPU; попробуйте обновить RKNN-Toolkit2 / RKNPU2 до последней версии.
2. Измените модель, заменив ‘Expand’ на ‘Repeat’.
Сообщение «Meet unsupported dims in reducesum»
При преобразовании появляется «Meet unsupported dims in reducesum, dims: 6», как показано ниже:
D RKNN: [14:54:19.434] >>>>>> start: N4rknn17RKNNInitCastConstE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn17RKNNInitCastConstE

D RKNN: [14:54:19.434] >>>>>> start: N4rknn20RKNNMultiSurfacePassE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn20RKNNMultiSurfacePassE

D RKNN: [14:54:19.434] >>>>>> start: N4rknn14RKNNTilingPassE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn14RKNNTilingPassE

D RKNN: [14:54:19.434] >>>>>> start: N4rknn23RKNNProfileAnalysisPassE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn23RKNNProfileAnalysisPassE

D RKNN: [14:54:19.434] >>>>>> start: OpEmit

E RKNN: [14:54:19.438] Meet unsupported dims in reducesum, dims: 6

Aborted (core dumped)
В настоящее время RKNN не поддерживает 6-мерные операторы. В большинстве случаев поддерживаются только 4 измерения; для других размерностей есть ограничения.
Ошибка преобразования из-за NonMaxSuppression
RKNN пока не поддерживает операторы постобработки, такие как NonMaxSuppression.
Подграф постобработки можно удалить, например:
rknn.load_onnx(model='picodet_xxx.onnx', outputs=['concat_4.tmp_0', 'tmp_16'])
Удалённые подграфы обрабатываются отдельно на CPU.
Ошибка вида «invalid expand shape»
Например, при преобразовании rvm_mobilenetv3_fp32.onnx возникает следующая ошибка:
[E:onnxruntime:, sequential_executor.cc:333 Execute] Non-zero status code returned while running Expand node.
Name:'Expand_294' Status Message: invalid expand shape

E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/graph_optimizer.py", line 5529, in rknn.api.graph_optimizer.GraphOptimizer.fold_constant

E build: File "rknn/api/session.py", line 69, in rknn.api.session.Session.run

E build: File "/home/cx/work/tools/Anaconda3/envs/rknn/lib/python3.8/site-packages/onnxruntime/capi/onnxruntime_inference_collection.py", line 124, in run

E build: return self._sess.run(output_names, input_feed, run_options)

E build: onnxruntime.capi.onnxruntime_pybind11_state.InvalidArgument: [ONNXRuntimeError] : 2 :
INVALID_ARGUMENT : Non-zero status code returned while running Expand node. Name:'Expand_294' Status
Message: invalid expand shape
Входное значение downsample_ratio меняет размер внутренних признаков модели, поэтому такой граф по сути динамический. Рекомендуется изменить логику downsample_ratio, чтобы входное значение не управляло формой внутренних признаков. Если нужен динамический граф, после обновления RKNN-Toolkit2 до 1.5.2 можно использовать dynamic_shape для его имитации. При этом всё равно нужно изменить логику downsample_ratio: входное значение не должно управлять внутренней формой. Сейчас dynamic_shape поддерживает только изменение формы входа.
Ошибка mean_values в rknn.config()
Параметры mean/std заданы так:
rknn.config(mean_values=[128, 128, 128], std_values=[128, 128, 128])
Выдаётся ошибка:
--> Loading model

transpose_input for input_1: shape must be rank 4, ignored

E load_tflite: The len of mean_values ([128, 128, 128]) for input 0 is wrong, expect 32!
Возможно, вход модели — не 3-канальное изображение, например форма равна 1x32. В таком случае:
Задайте mean_values / std_values согласно числу входных каналов.
Если модель не требует mean/std, параметры mean_values / std_values в rknn.config можно не задавать; mean/std обычно применимы только к изображениям.
Ошибка при числе измерений модели больше 4 (5 или 6)
Если модель содержит операторы с более чем 4 измерениями, например 5 или 6, возникает следующая ошибка:
E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1580, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/rknn_base.py", line 341, in rknn.api.rknn_base.RKNNBase._generate_rknn

E build: File "rknn/api/rknn_base.py", line 307, in rknn.api.rknn_base.RKNNBase._biild_rknn

E build: IndexError: vector::_M_range_check: __n (which is 4) >= this->size() (which is 4)
RKNN сейчас не поддерживает операторы с размерностью выше 4; такие узлы можно удалить вручную.
Поддерживает ли RKNN динамическую свёртку?
В настоящее время RK3588/RK3576/RV1126B поддерживают динамическую свёртку с group=1. Остальные платформы пока не поддерживаются.
Ошибка «Not support input data type ‘float16’»
Веса модели, обученной в Pytorch, имеют тип float16; при преобразовании в RKNN возникает ошибка:
--> Building model

E build: Not support input data type 'float16'

W build: ==================== WARN(3) =================

E rknn-toolkit2 version: 1.3.0-11912b58

E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/graph_optimizer.py", line 5524, in rknn.api.graph_optimizer.GraphOptimzer.fold_constant

E build: File "rknn/api/load_checker.py", line 63, in rknn.api.load_checker.create_random_data

E build: File "rknn/api/rknn_log.py", line 113, in rknn.api.rknn_log.RKNNLog.e

E build: ValueError: Not support input data type 'float16'!
RKNN-Toolkit2 пока не поддерживает модели Pytorch с весами float16; их нужно перевести в float32.
Ошибка, связанная с динамическим графом
Если при преобразовании модели возникает ошибка следующего вида:
E build: ValueError: The Op of 'NonZero' is not support! it will cause the graph to be a dynamic graph!
Это означает, что оператор делает граф динамическим. Модель нужно изменить вручную, заменив оператор другим или удалив его.
Размер модели RKNN
После преобразования модель RKNN может быть больше исходной; размер может зависеть даже от формы входа. Это нормально: кроме весов и структуры графа RKNN содержит множество конфигураций регистров NPU. Для повышения эффективности выполнения также могут выполняться разбиение операторов и другие операции, увеличивающие размер модели.
10.7 Инференс в симуляторе или на устройстве
Терминология
Инференс в симуляторе: RKNN-Toolkit2 предоставляет на Linux x86_64 симулятор для выполнения моделей без отладочной платы. Его результаты могут отличаться от результатов платы; предпочтительнее инференс через подключённую плату или непосредственно на ней.
Инференс через подключённую плату: плата подключена к PC, а модель запускается и результаты получаются через Python API RKNN-Toolkit2.
Инференс на плате: результаты получают через C API RKNPU2.
Результаты симулятора отличаются от результатов подключённой платы
Это может означать, что результаты на плате неверны.
Из-за различий аппаратуры и драйверов полное совпадение результатов симулятора и платы не гарантируется. Однако слишком большая разница, вероятно, вызвана ошибкой драйвера платы. Сообщите о ней команде RK NPU для анализа и отладки.
Как работает инференс через подключённую плату
RKNN-Toolkit2 связывается с rknn_server на плате. Модель и входные данные передаются с PC на плату, где RKNPU2 C API выполняет инференс. Затем результат отправляется обратно на PC.
Различия результатов инференса через подключённую плату и непосредственно на плате
Инференс через подключённую плату основан на RKNPU2 C API, поэтому теоретически результаты должны совпадать. При большой разнице проверьте предобработку, тип данных и расположение данных (NCHW, NHWC).
Очень небольшие различия нормальны: они могут возникать из-за разных библиотек чтения изображений, преобразования типов и т. п.
Инференс непосредственно на плате быстрее, чем через подключённую плату
Инференс через подключённую плату включает дополнительные копирование и передачу данных, поэтому уступает прямому запуску RKNPU2 C API на плате. Реальную производительность NPU следует оценивать по инференсу через RKNPU2 C API непосредственно на плате.
Получение более подробного журнала
При инференсе через подключённую плату инициализация и запуск модели выполняются главным образом на плате, где создаётся и основная часть журнала.
Для подробной отладочной информации войдите в ОС платы через последовательный порт. Выполните две следующие команды настройки переменных окружения для журналирования. Не закрывайте окно последовательного порта и запустите инференс через подключённую плату: сообщения об ошибках платы появятся в этом окне.
export RKNN_LOG_LEVEL=5

restart_rknn.sh
Расположение данных для пакетного инференса
Расположение входных данных rknn.inference можно задать как NCHW или NHWC через 1data_format=’NCHW’ либо data_format=’NHWC’. По умолчанию используется NHWC.
В rknn-toolkit2 модели ONNX с 4D-входами при преобразовании обычно используют NCHW. Однако при инференсе RKNN по умолчанию используется NHWC, и инструментарий внутри преобразует NCHW в NHWC. Если явно задать data_format=’NCHW’, это преобразование пропускается и вход используется как есть в NCHW. Примеры см. в обсуждении GitHub: https://github.com/airockchip/rknn-toolkit2/issues/220.
10.8 Типичные проблемы оценки модели
Точность квантования ниже ожидаемой
См. главу 7 этого документа.
Квантованные модели каких фреймворков поддерживаются?
RKNN-Toolkit2 1.4 и новее поддерживает квантованные модели TensorFlow, TensorFlow Lite и PyTorch.
Не удаётся подключиться к устройству при инференсе через плату
При rknn.accuracy_analysis возникает ошибка:
  E accuracy_analysis: Connect to Device Failure (-1)

  E accuracy_analysis: Catch exception when init runtime!

  E accuracy_analysis: Traceback (most recent call last):

  E accuracy_analysis: File "rknn/api/rknn_base.py", line 2001, in rknn.api.rknn_base.RKNNBase.init_runtime

  E accuracy_analysis: File "rknn/api/rknn_runtime.py", line 194, in
rknn.api.rknn_runtime.RKNNRuntime.__init__

  E accuracy_analysis: File "rknn/api/rknn_platform.py", line 331, in rknn.api.rknn_platform.start_ntp_or_adb
Или при rknn.inference возникает ошибка:
  I target set by user is: rk3568

  I Starting ntp or adb, target is RK3568

  I Device [0c6a9900ef4871e1] not found in ntb device list.

  I Start adb…
  I Connect to Device success!

  I NPUTransfer: Starting NPU Transfer Client, Transfer version 2.1.0 (b5861e7@2020-11-23T11:50:36)

  D NPUTransfer: Transfer spec = local:transfer_proxy

  D NPUTransfer: ERROR: socket read fd = 3, n = -1: Connection reset by peer

  D NPUTransfer: Transfer client closed fd = 3

  E RKNNAPI: rknn_init, server connect fail! ret = -9(ERROR_PIPE)!

  E init_runtime: Catch exception when init_runtime!

  E init_runtime: Traceback (most recent call last):

  E init_runtime: File "rknn/api/rknn_base.py", line 2001, in rknn.api.rknn_base.RKNNBase.init_runtime

  E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

  E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_DEVICE_UNAVAILABLE
Возможно, на плате не запущена служба rknn_server. Запустите её согласно разделу 2.2.
rknn_init возвращает RKNN_ERROR_MODEL_INVALID
Журнал ошибки:
E RKNNAPI: rknn_init, msg_load_ack fail, ack = 1(ACK_FAIL), expect 0(ACK_SUCC)!

D NPUTransfer: Transfer client closed, fd = 4

E init_runtime: Catch exception when init runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 2011, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_MODEL_INVALID
Эта ошибка обычно возникает в следующих случаях:
При создании rknn-модели нужно учитывать соответствие версий RKNN-Toolkit2 и драйверов. Рекомендуется обновить RKNN-Toolkit2 / RKNPU2 и прошивку платы до последних версий.
Неверно задан target_platform. Если target_platform в rknn.config() не указан, модель работает только на RK3566/RK3568. Для других платформ, например RK3588/RK3588S/RV1103/RV1106/RK3562, при вызове rknn.config() нужно задать соответствующий target_platform.
Если ошибка возникает в Docker, возможно, процесс npu_transfer_proxy на хосте не завершился и нарушает связь. Выйдите из контейнера, завершите npu_transfer_proxy на хосте, затем снова войдите в контейнер и запустите скрипт инференса.
Возможна проблема с моделью RKNN. Подключитесь к плате через последовательный порт, задайте RKNN_LOG_LEVEL=5 и выполните restart_rknn.sh. Затем запустите программу, сохраните подробный журнал и передайте команде Rockchip NPU.
rknn_init возвращает RKNN_ERR_DEVICE_UNAVAILABLE
Журнал ошибки:
E RKNNAPI: rknn_init, msg_ioctl_ack fail, data_len = 104985, except 102961!

D NPUTransfer: Transfer client closed, fd = 3

E init_runtime: Catch exception when init_runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 1961, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 360, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_DEVICE_UNAVAILABLE
Проверьте следующее:
Убедитесь, что RKNN-Toolkit2 / RKNPU2 и прошивка устройств обновлены до последних версий. Как узнать версии компонентов, см. в разделе 2.2.
Также убедитесь, что adb devices или rknn.list_devices() обнаруживает устройство, а target и device_id в rknn.init_runtime() заданы правильно.
Ошибка Runtime «Invalid RKNN model version 6»
  Loading model …

  E RKNN: [09:13:25.728] 6, 1

  E RKNN: [09:13:25.728] Invalid RKNN model version 6

  E RKNN: [06:28:39.049] rknn_init, load model failed!

  Exception: RKNN init failed. error code: RKNN_ERR_FAIL
Причина:
Версия Runtime несовместима с моделями RKNN.
Рекомендация:
Обновите RKNN-Toolkit2 и Runtime до одной версии.
Ошибка Runtime «Invalid RKNN format»
В Runtime возникает ошибка:
Loading model …

E RKNN: [06:28:39.048] parseRKNN from buffer: Invalid RKNN format!

E RKNN: [06:28:39.049] rknn_init, load model failed!

rknn_init error ret=-1
Причины:
1) При преобразовании модели target_platform задан неверно или не задан; по умолчанию используется rk3566.
2) Версия Runtime несовместима с RKNN-Toolkit2.
Рекомендации:
1) Задайте правильный target_platform.
2) Обновите RKNN-Toolkit2 и Runtime до одной версии.
rknn.inference медленнее rknn.eval_perf
rknn.inference использует PC и adb для инференса через подключённую плату, поэтому есть фиксированные накладные расходы на передачу данных. Скорость отличается от теоретической оценки rknn.eval_perf.
Для более реалистичной частоты кадров рекомендуется тестировать RKNPU2 C API непосредственно на плате.
Поддержка нескольких batch в rknn.inference()
Обновите RKNN-Toolkit2 до 1.4.0 или новее и укажите число входных изображений при построении RKNN-модели. Подробности см. в описании rknn.build в RKNN-Toolkit2 API Reference.
Кроме того, если rknn_batch_size больше 1, например равен 4, код инференса Python:
outputs = rknn.inference(inputs=[img])
нужно изменить на:
img = np.expand_dims(img, 0)

img = np.concatenate((img, img, img, img), axis=0)

outputs = rknn.inference(inputs=[img])
Полный пример: examples/functions/multi_batch/
Запуск нескольких моделей RKNN
Для двух и более моделей создайте несколько объектов RKNN. Каждый объект соответствует одной модели и играет роль контекста. Модели независимо инициализируются, выполняют инференс и получают результаты в собственных контекстах. На NPU они исполняются последовательно.
Инференс длится очень долго и выдаёт неверный результат
Если инференс занимает более 20s и результат неверен, обычно это ошибка ‘NPU Hang’. Попробуйте обновить RKNN-Toolkit2 / RKNPU2 до последней версии.
Неверный результат платы при 3-мерном входе
Если при 3-мерном входе симулятор даёт правильный результат, а подключённая плата — неверный, причиной может быть неполная поддержка таких входов текущей NPU. Поддержку 3 измерений планируется улучшить.
Рекомендации:
Измените вход модели на 4D.
Попробуйте обновить RKNN-Toolkit2 / RKNPU2 до последней версии.
Результат платы неверен и меняется при каждом запуске
Если симулятор выдаёт правильные и стабильные результаты, а подключённая плата — неверные и каждый раз разные, возможна ошибка драйвера ядра NPU на плате. Обновите этот драйвер одновременно с RKNN-Toolkit2 / RKNPU2 до последних версий.
При большом числе Resize точность падает
Если ONNX-модель содержит много Resize, после преобразования в RKNN точность может снизиться. Возможные причины:
1. NPU пока не поддерживает Resize на аппаратном уровне (поддержка планируется), поэтому RKNN-Toolki2 преобразует Reszie в ConvTranspose, что немного снижает точность.
2. Несколько последовательных Resize могут накапливать ошибки и сильнее снижать точность.
Рекомендации:
1. Пока по возможности избегайте Resize: например, замените его ConvTranspose и обучите модель заново.
2. Добавьте optimization_level=2 в rknn.config. Тогда Resize будет выполняться на CPU без потери точности, но производительность снизится.
Все результаты равны ‘nan’ при do_quantization = False
При do_quantization=True в rknn.build результаты нормальны, а при False становятся ‘nan’. Возможная причина: do_quantization=False задаёт вычисления RKNN в fp16, но выход промежуточного слоя, например свёртки, может выходить за диапазон fp16 (65536), например -51597~75642.
Рекомендация:
При обучении обеспечьте, чтобы выходы промежуточных слоёв не превышали диапазон fp16. Обычно это решается добавлением слоя BN.
Результаты QAT-модели и RKNN-модели различаются
После обучения классификатора QAT в Pytroch и преобразования в RKNN результаты инференса Pytorch и RKNN могут различаться. Возможно, при инференсе Pytorch не задано engine=’qnnpack’, тогда как RKNN ближе к qnnpack.
Как получить расход памяти при работе модели
Используйте rknn.eval_memory. Поле ‘total’ в журнале означает общий занимаемый объём.
Различия между perf_debug=True и False
При perf_debug=True добавляется отладочный код для сбора сведений по слоям, а некоторые механизмы параллелизма могут отключаться. Поэтому выполнение дольше, чем при perf_debug=False.
Основное назначение perf_debug=True — выявить самые затратные слои модели и на этой основе спланировать оптимизацию.
После перезапуска Docker инференс зависает на инициализации окружения
При перезапуске Docker npu_transfer_proxy завершается некорректно, поэтому rknn_server на плате не замечает разрыва соединения с хостом. Перезапустите плату, чтобы сбросить состояние соединения rknn_server.
10.9 Вопросы по использованию C API
Освобождает ли rknn_outputs_release() массив rknn_output?
rknn_outputs_release() используется вместе с rknn_outputs_get() и освобождает только буфер в массиве rknn_output. Аналогичная ситуация у rknn_destroy_mem().
Как выделить память правильного размера через rknn_create_mem?
Для входов действует правило: у квантованной модели rknn_create_mem() выделяет память по size_with_stride из rknn_tensor_attr; у неквантованной — по n_bytes_type * n_elems.
Для выходов rknn_create_mem() выделяет память по n_bytes_type * n_elems.
Как заполнять входные данные?
В общем API для 4-мерного входа fmt=NHWC: порядок заполнения [batch, height, width, channel]. Для входа, отличного от 4D, fmt=UNDEFINED, то есть данные следуют исходной форме модели.
В zero-copy API для входа 4D fmt может быть NHWC/NC1HWC2. Заполнение при fmt=NC1HWC2 описано в разделе «RKNN Runtime Zero Copy». Для входа, отличного от 4D, fmt=UNDEFINED, то есть используется исходная форма модели.
Как использовать pass_through?
Формат входа получают командой RKNN_NATIVE_INPUT_ATTR функции rknn_query(). Для 4-мерной формы при числе каналов 1, 3 или 4 требуется NHWC, при других значениях — NC1HWC2. Для формы, отличной от 4 измерений, рекомендуется UNDEFINED.
Кроме того, в режиме pass_through квантованные модели обычно задают dtype входного Tensor как INT8, а неквантованные — как FLOAT16.
Как устранить ошибку «failed to submit»?
Если ошибка возникает на первом слое свёртки при zero-copy, возможно, для входного тензора выделено недостаточно памяти. Используйте size_with_stride из атрибутов тензора для выделения.
Если ошибка возникает в промежуточном NPU-слое, возможна неверная конфигурация модели. В журнале можно найти ссылку на последний SDK. Рекомендуется обновить инструментарий либо назначить этот слой CPU при преобразовании RKNN-модели.
Как устранить «Meet unsupport xxx operator»?
При такой ошибке запуска демонстрации на плате её Runtime (librknnrt.so) обычно не поддерживает оператор. Сначала обновите инструментарий RKNN, заново преобразуйте модель и повторите запуск демонстрации.
Если ошибка остаётся в последней версии, нужно самостоятельно добавить реализацию оператора. См. раздел 5.5 о пользовательских операторах либо сообщите команде RKNN через redmine.
Поддерживает ли модель с динамической формой внешне выделенную память в zero-copy?
Версии до 1.6.0 этого не поддерживают. Более поздние версии позволяют инициализировать контекст с флагом RKNN_FLAG_MEM_ALLOC_OUTSIDE.
Оценка производительности пользовательского оператора в Runtime
Задайте RKNN_LOG_LEVEL=4 или выше и запустите тестовый пример C API. Он выведет производительность каждого слоя, включая пользовательский оператор.
Примечание: время пользовательского оператора включает действия внутри обратного вызова compute. Для GPU-оператора это, например, время clImportMemoryARM, преобразований расположения и типов входных и выходных данных, а также выполнения самого GPU-ядра OpenCL.
11 Справочные материалы
RKNN: https://github.com/airockchip/rknn-toolkit2
RKNN_Model_Zoo: https://github.com/airockchip/rknn_model_zoo
RGA: https://github.com/airockchip/librga